
Corso
Lavorare con l'API di OpenAI
3 ore
184.5K
Il panorama dei dati in continua evoluzione, insieme ai rapidi progressi dell’AI generativa negli ultimi due anni, ha ridefinito la direzione della ricerca semantica, aumentando sempre di più la popolarità delle applicazioni di ricerca semantica.
La ricerca e il recupero consistono nel trovare e ottenere informazioni o dati specifici da un database più ampio o da una raccolta in base a criteri di query. I progressi dell’AI hanno alimentato la richiesta di metodologie di ricerca più accurate, sensibili al contesto ed efficienti, portando alla diffusione delle applicazioni di ricerca semantica ovunque.
La ricerca semantica supera i limiti delle ricerche tradizionali basate su keyword comprendendo l’intento e il significato contestuale delle query, fornendo così risultati più pertinenti e precisi.
Per creare un’applicazione di ricerca semantica end-to-end, è necessario comprendere diversi concetti chiave come Embeddings, Basi di dati vettoriali, Metriche di distanza, ecc., e imparare anche a usare prodotti/servizi come Pinecone e i modelli GPT di OpenAI per sviluppare e distribuire applicazioni di ricerca semantica end-to-end.
Alla fine di questo blog, avrai una comprensione completa dei principi della ricerca semantica, degli embeddings e del ruolo delle basi di dati vettoriali, e imparerai infine come implementare la ricerca semantica in Python usando:
Se vuoi imparare di più con esercizi pratici, dai un’occhiata al nostro corso Vector Databases for Embeddings with Pinecone.
L’Embedding è un concetto fondamentale nel machine learning. Colma il divario tra il mondo complesso e sfumato del linguaggio e della comprensione umana e la rappresentazione matematica precisa del mondo umano in numeri.
I dati non strutturati, come testo, immagini, file audio e video, non seguono un formato organizzato specifico, creando difficoltà di archiviazione e processamento nei database convenzionali. La loro analisi per applicazioni di machine learning e AI richiede spesso la trasformazione in rappresentazioni numeriche multidimensionali tramite embeddings vettoriali. Il processo di conversione dei dati non strutturati in vettori numerici multidimensionali si chiama Embedding.
Gli embeddings sono rappresentazioni numeriche multidimensionali di testi, immagini o qualsiasi tipo di dato non strutturato, che consentono alle macchine di apprendere la complessità della comunicazione umana, le relazioni tra concetti o i pattern nei dati in modo computazionalmente efficiente e ricco di contesto.
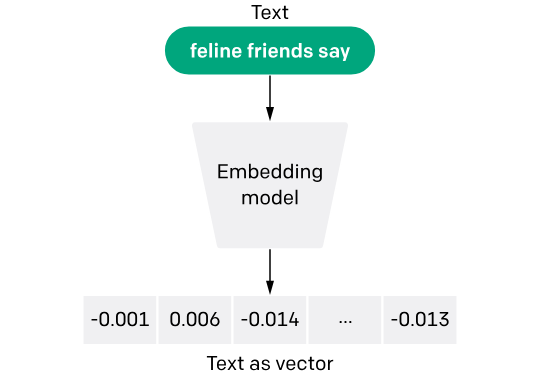
Modello di embedding di testo e codice di OpenAI (Fonte immagine)
L’idea alla base dei modelli di embedding è che elementi simili possono essere rappresentati da punti vicini tra loro in uno spazio ad alta dimensionalità. Questo consente di catturare relazioni complesse all’interno dei dati, come sinonimi, analogie o persino collegamenti più astratti, riducendo l’enorme complessità del linguaggio umano o di altri tipi di dati in una forma con cui le macchine possono lavorare.
Per esempio, nei dati testuali, le parole vengono trasformate in vettori (numeri), che sono essenzialmente array di numeri. Questi vettori racchiudono l’essenza del significato delle parole, del loro uso e del contesto all’interno della comprensione del modello linguistico.
La lunghezza del vettore, come restituita dal modello di embedding, dipende dal modello che stai usando. Per esempio, se utilizzi il modello di embedding di OpenAI, la lunghezza del vettore sarà sempre "1536".
Dietro le quinte, il modello di embedding è semplicemente una grande rete neurale addestrata su un corpus di dati estremamente ampio. Il modello impara ad assegnare vettori ai dati di input in modo che la relazione geometrica tra questi vettori rifletta le relazioni semantiche o concettuali tra le istanze dei dati.
Ad esempio, in un modello di embedding ben addestrato, il vettore che rappresenta la parola "king" meno il vettore per "man" più il vettore per "woman" potrebbe risultare in un vettore molto vicino a quello che rappresenta "queen". Questa capacità di eseguire operazioni aritmetiche con significati è una potente dimostrazione di come gli embeddings catturino la semantica sottostante del linguaggio.
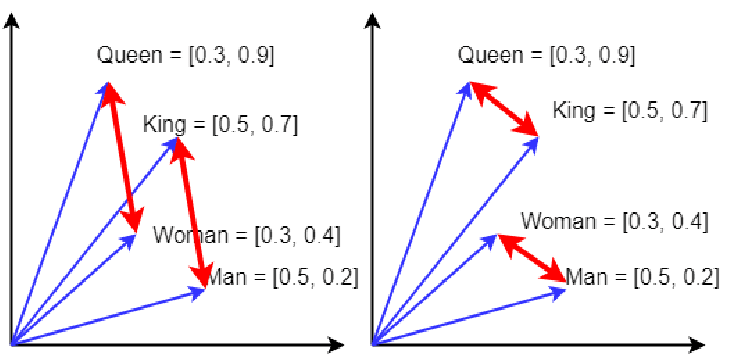
Il classico esempio king + woman − man ≈ queen degli embeddings di parole neurali (Fonte immagine)
Volendo, puoi addestrare un tuo modello di embedding, ma ciò può richiedere la raccolta di enormi quantità di dati e risorse per addestrare una gigantesca rete neurale, con costi di milioni di dollari e tempi di diversi mesi.
L’alternativa più pratica è usare un modello di embedding pre-addestrato. Ci sono molti modelli open source su Hugging Face che puoi scaricare e usare in locale, oppure puoi usare modelli proprietari forniti da aziende come OpenAI, Anthropic, Cohere, ecc.
In questo blog useremo il modello di OpenAI "text-embedding-ada-002", offerto a un prezzo contenuto (0,00010 $ per 1K token). Questo significa che un libro di 1000 pagine costerà all’incirca meno di 1 $.
Gli embeddings sono fondamentali per una moltitudine di applicazioni in vari domini. Nella ricerca semantica, permettono ai sistemi di andare oltre il semplice matching di keyword, consentendo il recupero di risultati correlati per contesto alla query, anche se le parole esatte non compaiono nel contenuto. Questa capacità migliora drasticamente la pertinenza e l’accuratezza dei risultati, rendendo la scoperta delle informazioni più intuitiva ed efficiente.
Gli embeddings non si limitano al testo. Gli embeddings di immagini, ad esempio, abilitano progressi simili nella computer vision, consentendo alle macchine di riconoscere oggetti, scene e attività in immagini e video comprendendoli in uno spazio vettoriale ad alta dimensionalità. Questa comprensione non riguarda solo l’identificazione dei pixel, ma la cogliere l’essenza di ciò che quei pixel rappresentano.
I modelli di embedding non sono solo trasformativi, ma estremamente utili poiché convertono la complessità dei dati del mondo reale in un linguaggio (vettori numerici) che le macchine possono comprendere e su cui possono agire, abilitando un’ampia gamma di applicazioni basate su una profonda comprensione semantica e su un’elaborazione intelligente dei dati.
Per approfondire gli Embeddings, consulta il blog Introduction to Text Embeddings with the OpenAI API.
Le basi di dati vettoriali rappresentano una categoria relativamente nuova di archiviazione dati non relazionale, sempre più popolare grazie ai recenti progressi dell’AI generativa e dei large language model.
A differenza dei database relazionali tradizionali che organizzano i dati in righe e colonne, o di altri archivi non relazionali come i Document Database che organizzano i dati come oggetti json o xml, le basi di dati vettoriali sono progettate per archiviare e gestire in modo efficiente dati vettoriali multidimensionali.
Una base di dati vettoriale è un database specializzato, ottimizzato per memorizzare e interrogare vettori. I vettori sono essenzialmente array di numeri che rappresentano punti dati in uno spazio multidimensionale.
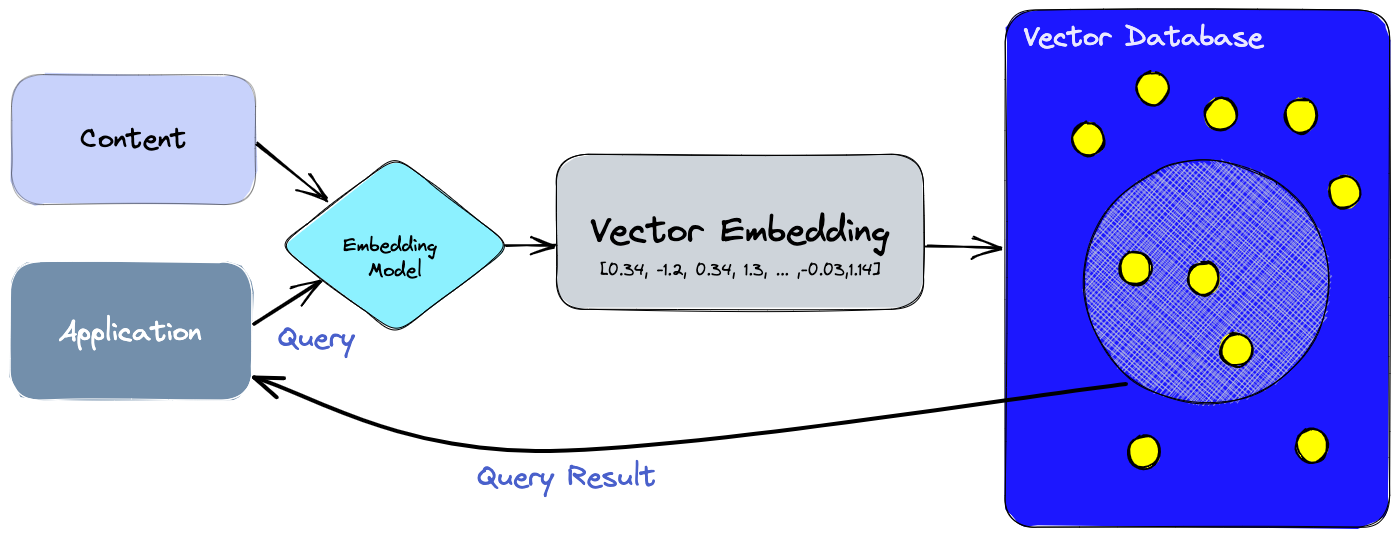
Il principale vantaggio delle basi di dati vettoriali è la capacità di eseguire ricerche di similarità in modo efficiente. Significa che possono trovare rapidamente gli elementi nel database "più vicini" a un elemento di query dato, secondo una metrica di distanza o similarità.
Questa capacità è cruciale per applicazioni come i sistemi di raccomandazione, dove potresti voler trovare prodotti simili a quelli che piacciono a un utente, o nelle applicazioni di ricerca semantica, dove l’obiettivo è trovare documenti semanticamente correlati a una frase di query.
Le basi di dati vettoriali usano una varietà di algoritmi per indicizzare e cercare tra i vettori, spesso basandosi su tecniche di Approximate Nearest Neighbor (ANN).
La ricerca semantica rappresenta un passo avanti significativo nel migliorare il modo in cui i motori di ricerca comprendono ed elaborano le query degli utenti. A differenza dei metodi tradizionali che si concentrano sulle corrispondenze letterali tra il testo della query e il contenuto dei documenti, la ricerca semantica approfondisce l’intento e il significato contestuale alla base di una query.
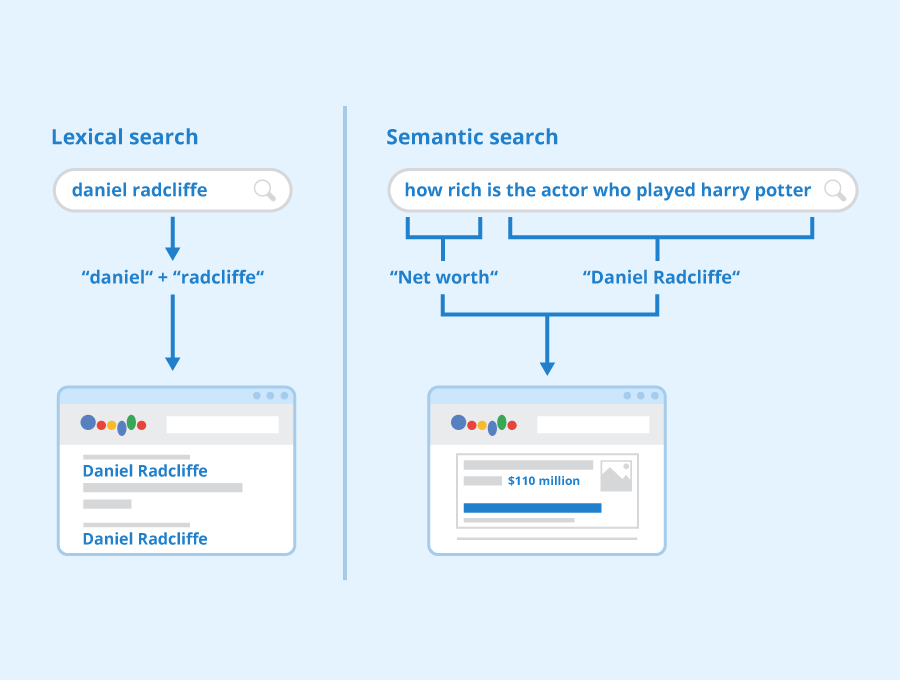
Ricerca lessicale vs. ricerca semantica (Fonte immagine)
L’evoluzione delle tecnologie di ricerca verso la ricerca semantica nell’ultimo decennio è stata guidata da diversi fattori. La ricerca vocale, alimentata da assistenti virtuali come Siri, Alexa e Google Assistant, si basa fortemente sull’elaborazione del linguaggio naturale per comprendere ed eseguire i comandi degli utenti.
La natura conversazionale delle ricerche vocali richiede una comprensione del contesto, spingendo i motori di ricerca a cogliere il significato di intere frasi o espressioni più lunghe.
La complessità del linguaggio umano è un grande ostacolo per le applicazioni tradizionali di ricerca lessicale, che la ricerca semantica sta superando piuttosto rapidamente. Esistono migliaia di parole in inglese con significati molteplici, e il significato reale dipende dal contesto in cui la parola è usata. Queste parole sono note come poliseme.
Per esempio, una parola come "table" può indicare un mobile o una tabella di dati, a seconda del contesto.
L’ascesa dei large language model (LLM) multimodali è uno dei principali motori dell’esplosione di popolarità delle applicazioni di ricerca semantica. La ricerca semantica, che mira a comprendere l’intento di chi cerca e il significato contestuale dei termini così come appaiono nello spazio dati ricercabile, è notevolmente potenziata dalle capacità degli LLM multimodali.
Man mano che questi modelli evolvono, non solo comprendono e generano testo, ma interpretano e creano contenuti in vari formati, inclusi immagini, audio e video. Questi progressi permettono ricerche che vanno oltre il semplice matching di keyword per comprendere le sfumature del linguaggio, le sottigliezze dei diversi media e le relazioni complesse tra concetti.
Per esempio, si può porre una query in linguaggio naturale e il sistema può restituire risultati non solo testuali, ma anche immagini pertinenti, clip video o frammenti audio, tutti compresi e selezionati dall’AI per corrispondere all’intento della query.
La ricerca semantica ha un’ampia gamma di applicazioni in diversi settori, offrendo vantaggi sostanziali nel migliorare pertinenza e precisione dei risultati:
Ti interessa saperne di più sulle basi di dati vettoriali? Dai un’occhiata a questa guida completa alle migliori basi di dati vettoriali.
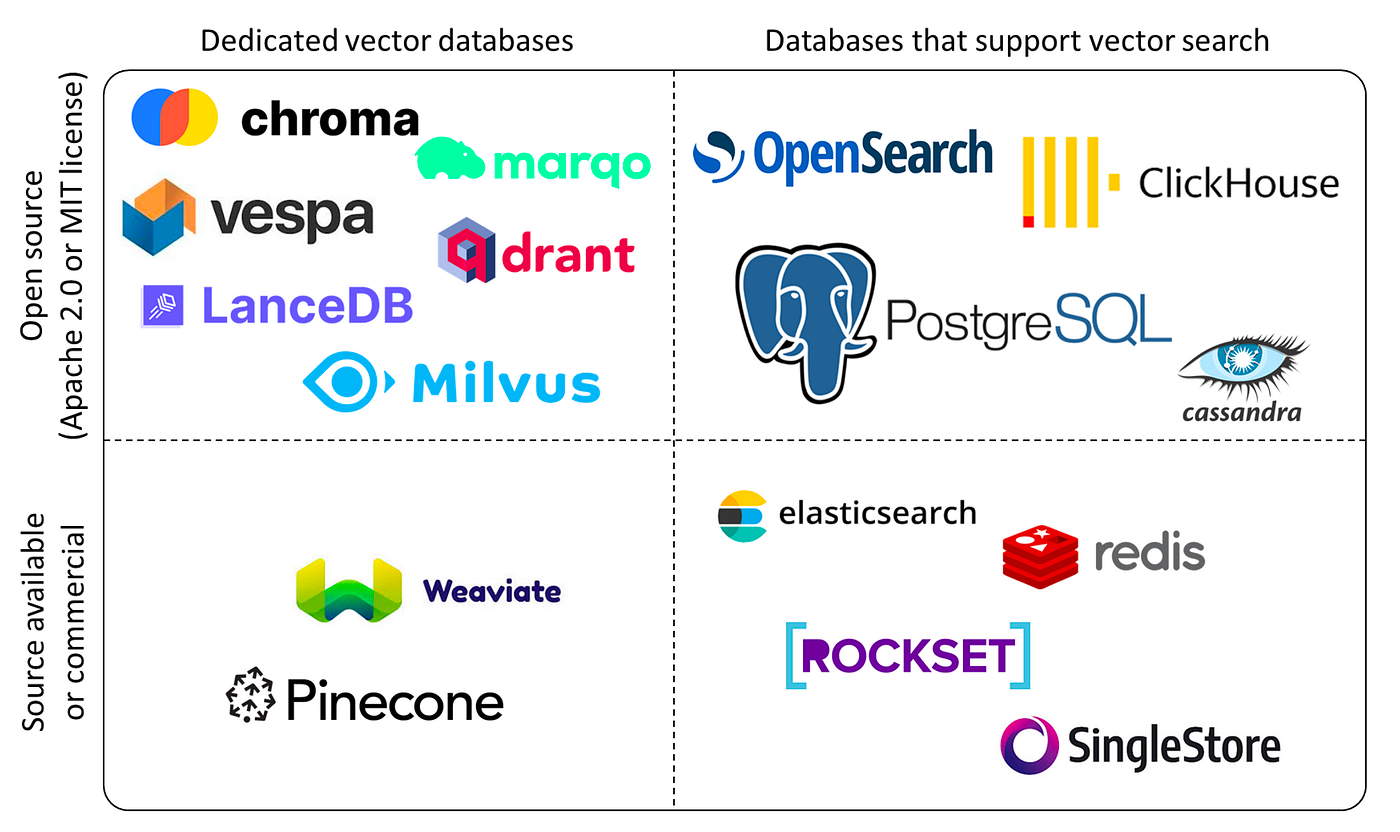
Il panorama delle basi di dati vettoriali (Fonte immagine)
Pinecone è una base di dati vettoriale specializzata progettata per gestire dati complessi e ad alta dimensionalità. Offre funzionalità avanzate di ricerca e indicizzazione, consentendo a data engineer e data scientist di costruire ed eseguire con efficienza progetti di machine learning su larga scala.
Se vuoi approfondire Pinecone, consulta su Datacamp Mastering Vector Databases with Pinecone Tutorial: A Comprehensive Guide.
OpenAI offre accesso a tutti i modelli tramite la sua API di piattaforma. Questo include i popolari modelli GPT, DALL-E e Whisper, oltre a tre modelli di embedding.
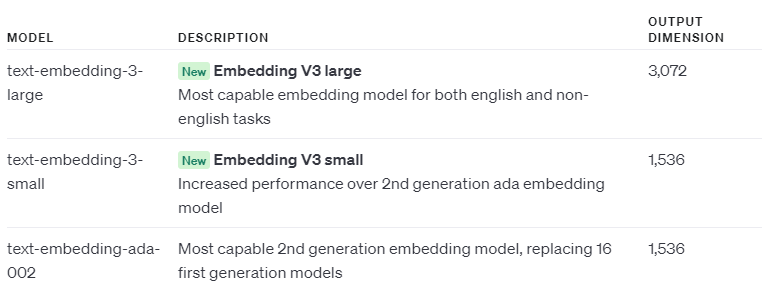
Queste API possono essere utilizzate tramite richieste HTTP, consentendo la compatibilità con qualsiasi linguaggio di programmazione in grado di comunicare via HTTP.
Chi usa Python può anche utilizzare la libreria openai per interagire con queste API, rendendo l’utilizzo ancora più semplice. Questa libreria si installa con pip install openai.
Usare l’API di OpenAI in Python con la libreria openai richiede pochissimo codice.
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Fitness & Health."},
    {"role": "user", "content": "Explain what is Keto diet?"}
  ]
)


print(completion.choices[0].message)Output: (troncato)
ChatCompletionMessage(content="The ketogenic diet, commonly known as the keto diet, is a low-carbohydrate, high-fat diet. The diet is named after ketosis, a metabolic state where your body starts burning fat for energy instead of carbohydrates. This is accomplished by drastically reducing your intake of carbohydrates and increasing your intake of fats….", role='assistant', function_call=None, tool_calls=None)
Scopri come ChatGPT e i large language model stanno rivoluzionando il panorama digitale! Esplora la cheat sheet di Datacamp per padroneggiare le basi per sfruttare una delle API di AI più potenti disponibili: l’OpenAI API.
Dopo esserti registrato a un account OpenAI, vai semplicemente su https://platform.openai.com/api-keys
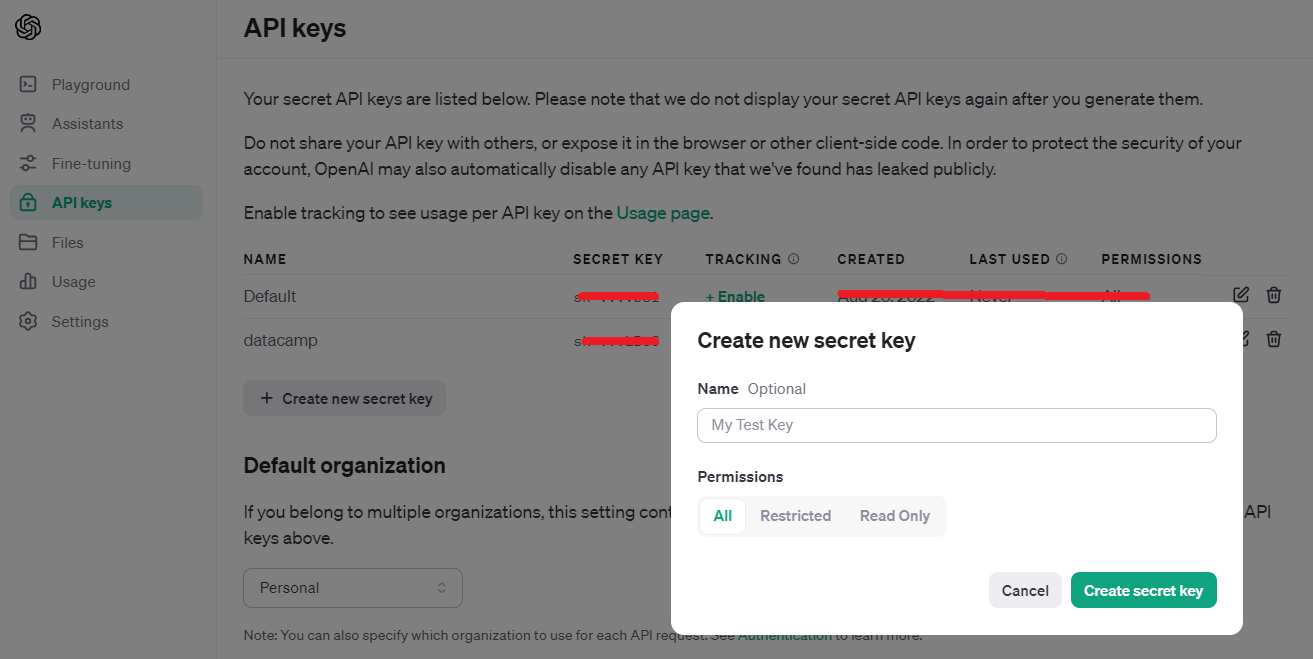
API Keys platform.openai.com
Per Pinecone, accedi al tuo account e fai clic su API Keys. Puoi fare clic sul pulsante "Click API Key" nell’angolo in alto a destra.
A differenza di OpenAI, con Pinecone non è necessario copiare la chiave API al momento della generazione, perché sotto la colonna Actions c’è un’icona di copia che puoi usare in qualsiasi momento.
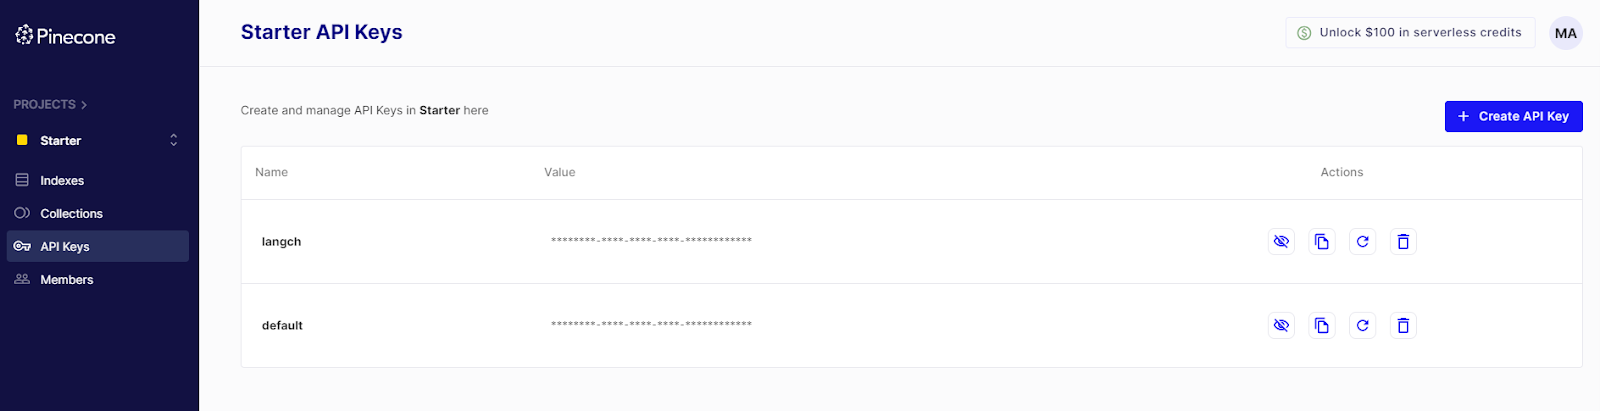
API Keys - Pinecone
Dopo aver ottenuto le chiavi API di OpenAI e Pinecone, assegnale a variabili nel Notebook o impostale come variabili d’ambiente usando il modulo os di Python.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Per implementare questo tutorial ti servono le seguenti librerie installate con pip. Devi usare esattamente queste versioni, altrimenti il codice qui sotto non funzionerà.
!pip install pinecone-client==3.0.0
!pip install pinecone-datasets==0.7.0
!pip install openai==0.28La libreria pinecone-datasets include diversi dataset con embeddings precomputati usando il modello embedding-ada-002 di OpenAI.
Per questo esempio useremo il dataset "wikipedia-simple-text-embedding-ada-002-100K", campionando solo 5.000 dei suoi 100.000 documenti e i relativi embeddings.
import pinecone_datasets

# load dataset from pinecone
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')

# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)

# sample 5k documents
dataset.documents.drop(dataset.documents.index[5_000:], inplace=True)
dataset.head()
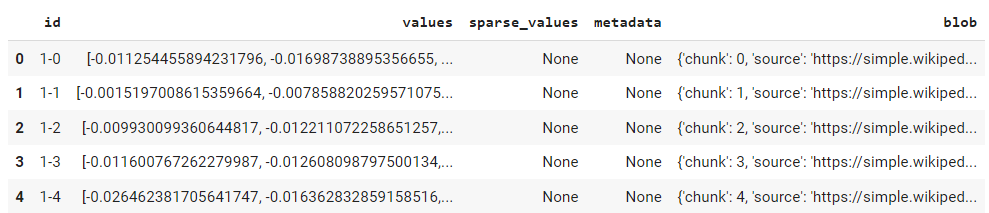
Dataset di esempio
In Pinecone, un indice rappresenta l’unità organizzativa più alta per i dati vettoriali. Gestisce l’archiviazione dei vettori, elabora le query sui vettori memorizzati ed esegue varie operazioni sui dati vettoriali che contiene.
from pinecone import Pinecone, ServerlessSpec

# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)

# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')

# set index name
index_name = 'semantic-search-demo'

# we create a new index
pc.create_index(
        index_name,
        dimension=1536,  # dimensionality of text-embedding-ada-002
        metric='cosine',
        spec=spec
    )
Il codice sopra inizializza l’istanza Pinecone, creando un indice chiamato semantic-search-demo. A questo punto potrai vedere questo indice anche nella UI.
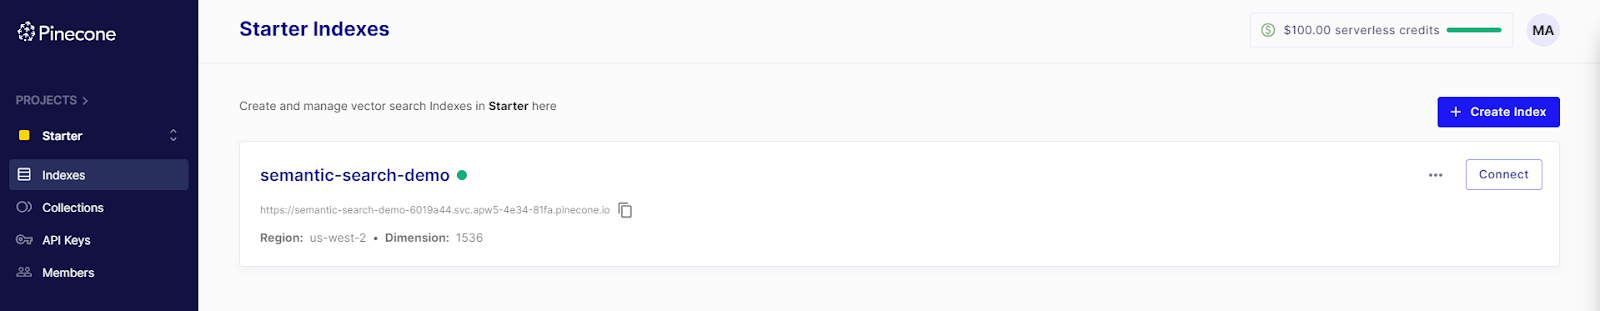
Dato che i nostri dati includono già le rappresentazioni embedded, possiamo saltare il processo di embedding e passare direttamente all’inserimento dei dati nel nuovo indice.
Per i dataset senza rappresentazioni embedded, esegui prima l’embedding dei dati grezzi usando l’API di OpenAI (consulta il punto 5 qui sotto per le istruzioni).
index = pc.Index(index_name)
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Dopo l’esecuzione corretta del codice, puoi visualizzare i dati anche nell’interfaccia utente.
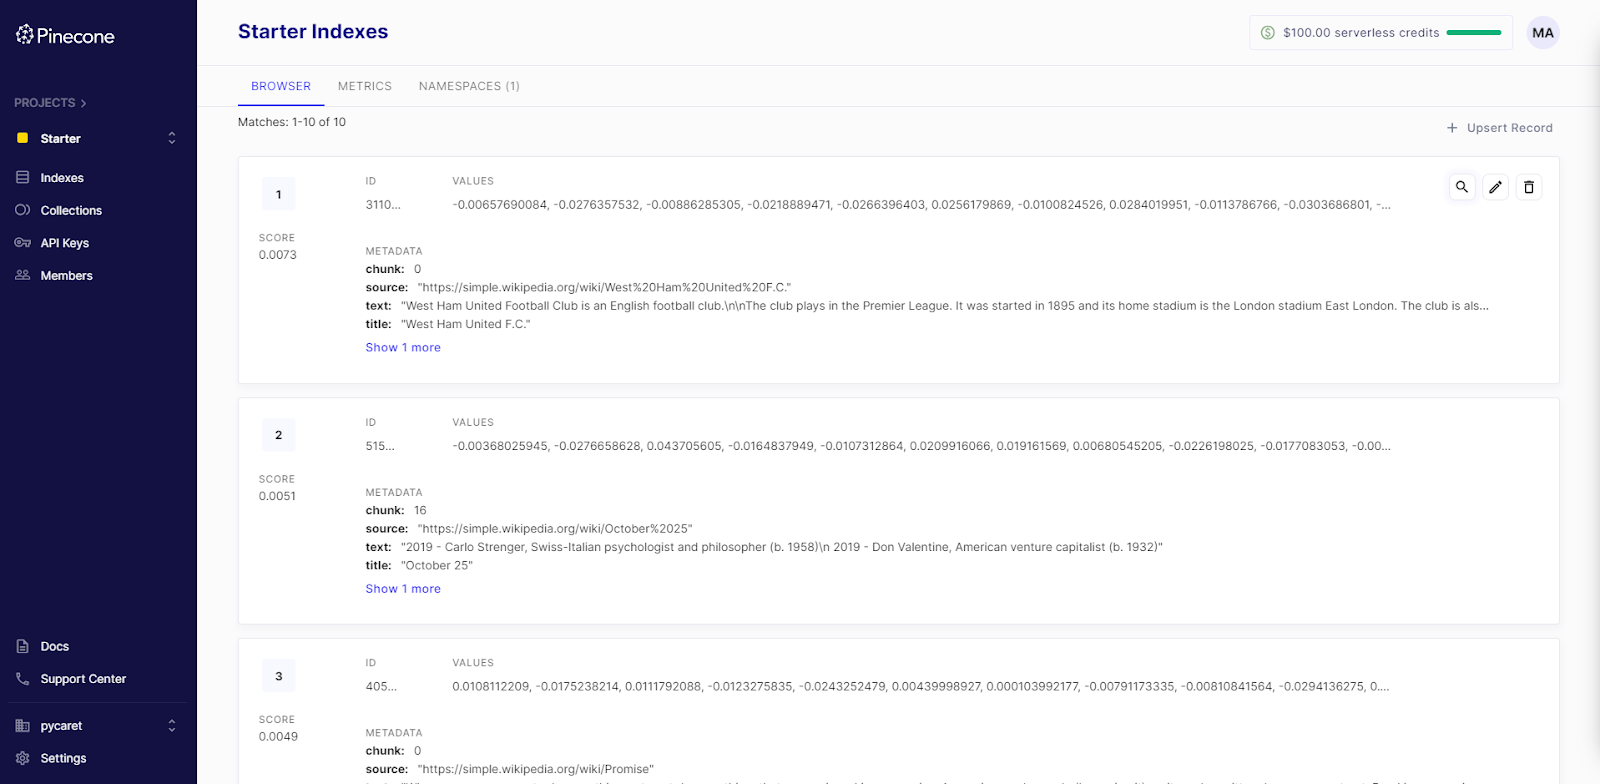
I nuovi dati o le nuove query devono essere trasformati in embedding con lo stesso modello per garantire il matching delle dimensioni del vettore. Poiché il nostro dataset usa text-embedding-ada-002, creeremo una funzione che utilizza l’API di OpenAI per trasformare in embedding le nuove query usando questo stesso modello.
import openai
openai.api_key = OPENAI_API_KEY


def get_embedding(text_to_embed):
  # Embed a line of text
  response = openai.Embedding.create(
      model= "text-embedding-ada-002",
      input=[text_to_embed]
  )
  # Extract the AI output embedding as a list of floats
  embedding = response['data'][0]['embedding']

return embeddingquery = "What are some easter related events in Western Christianity?"
result = get_embedding(query)
print(len(result))
print(result)Output:
1536
[0.014745471067726612, -0.03282099589705467, -0.006603493355214596, -0.0025058642495423555,.........]
La lunghezza di result è 1536, in linea con la dimension specificata durante la creazione dell’indice.
L’invio di una query di ricerca è piuttosto semplice:
query_result = index.query(vector=result, top_k=3, include_metadata=True)
print(query_result)Output:
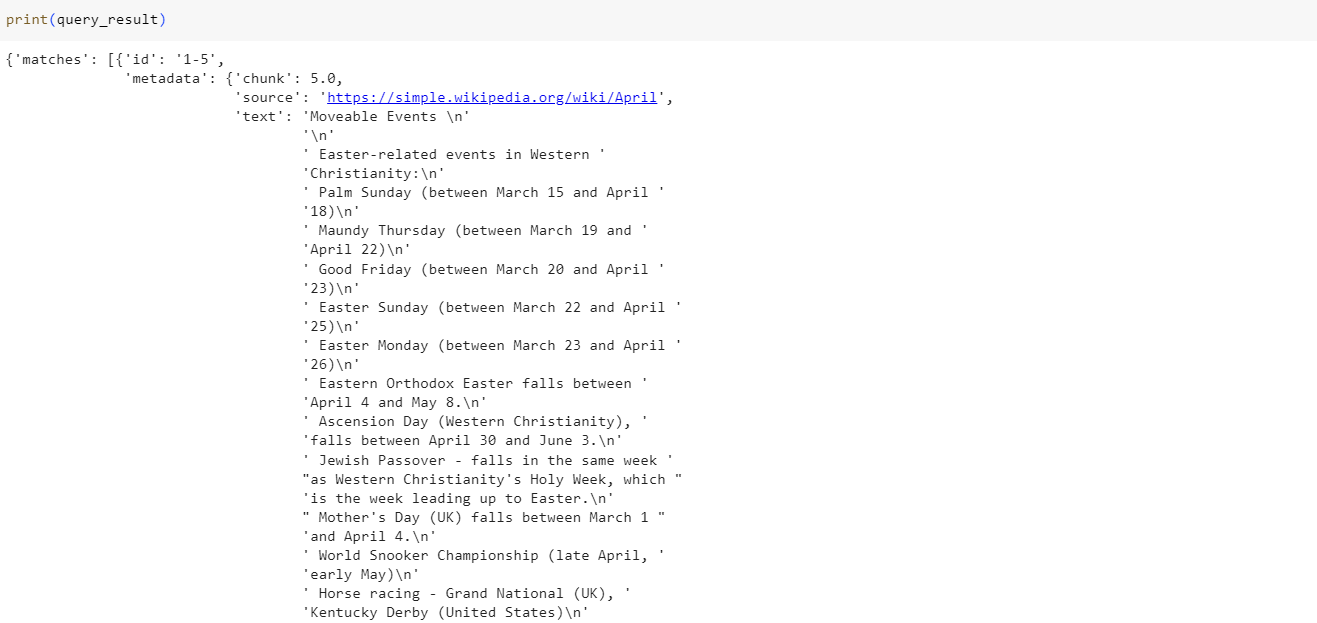
query_result produce un dizionario con un elenco dei 3 migliori match corrispondenti alla query dell’utente. Questi Top N match possono ora essere utilizzati per attività a valle, come fornire contesto ai prompt in scenari di Retrieval Augmented Generation (RAG) o per creare chatbot.
In questo tutorial abbiamo introdotto diversi concetti chiave sottostanti, come embedding e basi di dati vettoriali, per comprendere la meccanica completa delle applicazioni di ricerca semantica.
Con l’avvento dell’AI generativa e la continua evoluzione degli LLM multimodali, la potenza della ricerca semantica si è ampliata, offrendo una precisione senza precedenti e una comprensione della complessità e delle sfumature dei dati non strutturati.
Sfruttando le capacità di Pinecone, una base di dati vettoriale all’avanguardia, e i sofisticati modelli di embedding forniti da OpenAI, sviluppatori e data scientist hanno ora a disposizione gli strumenti per creare applicazioni di ricerca semantica che superano le metodologie tradizionali basate su keyword.
Attraverso questa guida, abbiamo anche esplorato l’importanza degli embeddings nel colmare il divario tra la complessità del linguaggio umano e le rappresentazioni numeriche necessarie per il machine learning, mostrando come queste rappresentazioni consentano alle macchine di cogliere le sottigliezze del contesto e dell’intento.
È chiaro che il futuro della ricerca risiede nella comprensione del linguaggio e delle altre forme di dati non strutturati alimentata dall’AI. Che si tratti di e-commerce, content discovery, customer support o knowledge management, i principi e le pratiche delineati in questo blog offrono una base per sfruttare la potenza della ricerca semantica e creare esperienze di ricerca più intelligenti, reattive e incentrate sull’utente.
Se vuoi imparare di più sulla creazione di applicazioni di ricerca semantica con Pinecone, consulta il code-along Semantic Search with Pinecone, oppure se ti interessa approfondire le funzionalità alla base di popolari applicazioni di AI come ChatGPT, dai un’occhiata al corso Working with the OpenAI API. Inoltre, non dimenticare di dare un’occhiata al nostro corso Vector Databases for Embeddings with Pinecone.
Scopri di più su come lavorare con OpenAI!
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



