Curso
Trabajar con la API de OpenAI
3 h
172.6K
El panorama de los datos cambia constantemente y, junto con el rápido avance de la IA generativa en los dos últimos años, ha reorientado la búsqueda semántica y ha disparado la popularidad de sus aplicaciones.
Buscar y recuperar información es el proceso de localizar y obtener datos concretos dentro de una base de datos o colección más amplia a partir de unos criterios de consulta. Los avances en IA han impulsado la demanda de metodologías de búsqueda más precisas, con conciencia de contexto y eficientes, lo que ha dado lugar a la proliferación de aplicaciones de búsqueda semántica.
La búsqueda semántica supera las limitaciones de las búsquedas tradicionales basadas en palabras clave al comprender la intención y el significado contextual de las consultas, ofreciendo resultados más pertinentes y precisos.
Para crear una aplicación de búsqueda semántica extremo a extremo, es clave entender conceptos como embeddings, bases de datos vectoriales, métricas de distancia, etc., y aprender a utilizar productos y servicios como Pinecone y los modelos GPT de OpenAI para construir y desplegar aplicaciones de búsqueda semántica completas.
Al final de este blog, habrás comprendido a fondo los principios de la búsqueda semántica, los embeddings y el papel de las bases de datos vectoriales; además, aprenderás a implementar la búsqueda semántica en Python usando:
Si te apetece aprender más con ejercicios prácticos, echa un vistazo a nuestro curso Vector Databases for Embeddings with Pinecone.
Un embedding es un concepto fundamental en el aprendizaje automático. Tiende un puente entre el mundo complejo y matizado del lenguaje y la comprensión humanos y su representación matemática precisa como números.
Los datos no estructurados, como texto, imágenes, audio y vídeo, no siguen un formato organizado, lo que complica su almacenamiento y procesamiento en bases de datos convencionales. Para su análisis en aplicaciones de machine learning e IA suele ser necesario transformarlos en representaciones numéricas multidimensionales mediante embeddings vectoriales. Al proceso de convertir datos no estructurados en vectores numéricos multidimensionales se le llama embedding.
Los embeddings son representaciones numéricas multidimensionales de texto, imágenes o cualquier tipo de dato no estructurado que permiten a las máquinas aprender la complejidad de la comunicación humana, las relaciones entre conceptos o los patrones dentro de los datos de forma computacionalmente eficiente y rica en contexto.
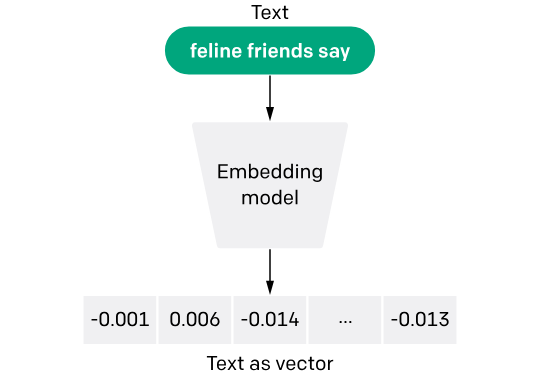
Modelo de embedding de texto y código de OpenAI (fuente de la imagen)
La idea clave de los modelos de embedding es que los elementos similares se pueden representar con puntos cercanos entre sí en un espacio de alta dimensión. Este concepto permite capturar relaciones intrincadas en los datos, como sinónimos, analogías o conexiones más abstractas, reduciendo la enorme complejidad del lenguaje humano u otros tipos de datos a una forma con la que las máquinas pueden trabajar.
Por ejemplo, en datos de texto, las palabras se transforman en vectores (números), que son esencialmente arrays de números. Estos vectores condensan la esencia del significado de las palabras, su uso y su contexto dentro del entendimiento del modelo de lenguaje.
La longitud del vector que devuelve el modelo de embedding depende del modelo que utilices. Por ejemplo, si usas el modelo de embeddings de OpenAI, la longitud del vector será siempre "1536".
Detrás de bambalinas, un modelo de embedding no es más que una gran red neuronal entrenada con un corpus de datos enorme. El modelo aprende a asignar vectores a los datos de entrada de manera que la relación geométrica entre esos vectores refleje las relaciones semánticas o conceptuales entre las instancias de datos.
Por ejemplo, en un buen modelo de embedding, el vector que representa la palabra "king" menos el vector de "man" más el vector de "woman" puede dar como resultado un vector muy cercano al que representa "queen". Esta capacidad de realizar operaciones aritméticas con significados demuestra de forma potente cómo los embeddings capturan la semántica subyacente del lenguaje.
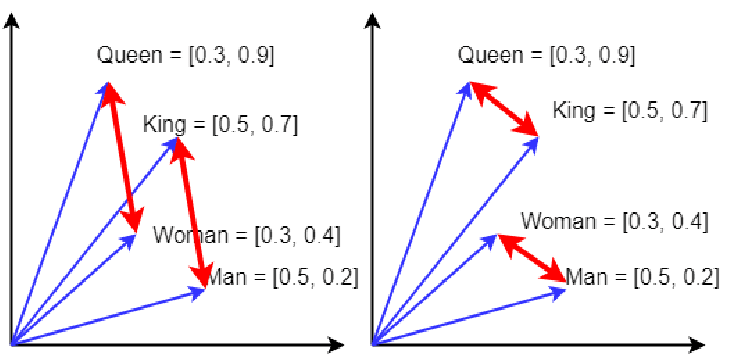
El ejemplo clásico king + woman − man ≈ queen de embeddings de palabras (fuente de la imagen)
Si quieres, puedes entrenar tu propio modelo de embedding, pero eso puede requerir recopilar una cantidad ingente de datos y recursos para entrenar una red neuronal gigantesca que podría costar millones de dólares y tardar varios meses.
La alternativa más práctica es usar algún modelo de embedding preentrenado. Hay muchos modelos de código abierto disponibles en Hugging Face que puedes descargar y usar localmente, o puedes usar modelos propietarios de empresas como OpenAI, Anthropic, Cohere, etc.
En este blog utilizaremos el modelo de OpenAI "text-embedding-ada-002", con un precio muy asequible (0,00010 $ por cada 1.000 tokens). Esto significa que un libro de 1.000 páginas costará aproximadamente menos de 1 $.
Los embeddings son esenciales en multitud de aplicaciones y sectores. En la búsqueda semántica permiten ir más allá de la coincidencia literal de palabras clave, recuperando resultados que están relacionados contextualmente con la consulta aunque el contenido no utilice exactamente las mismas palabras. Esta capacidad mejora drásticamente la relevancia y precisión de los resultados, haciendo el descubrimiento de información más intuitivo y eficiente.
Los embeddings no se limitan al texto. Los embeddings de imagen, por ejemplo, permiten avances similares en visión por computador, ayudando a que las máquinas reconozcan objetos, escenas y actividades en imágenes y vídeos al interpretarlos en un espacio vectorial de alta dimensión. No se trata solo de identificar píxeles, sino de captar la esencia de lo que representan.
Los modelos de embedding no solo son transformadores, sino también extremadamente útiles, porque convierten la complejidad de los datos del mundo real a un lenguaje (vectores numéricos) que las máquinas pueden entender y sobre el que pueden actuar, habilitando un amplio abanico de aplicaciones que dependen de una comprensión semántica profunda y de un procesamiento inteligente de datos.
Para saber más sobre embeddings, consulta la introducción a los embeddings de texto con la API de OpenAI.
Las bases de datos vectoriales son una categoría relativamente nueva de almacenamiento de datos no relacional que está ganando popularidad gracias a los recientes avances en IA generativa y en los grandes modelos de lenguaje.
A diferencia de las bases de datos relacionales tradicionales que organizan los datos en filas y columnas, o de otros almacenes no relacionales como las bases de documentos, que guardan datos como objetos JSON o XML, las bases vectoriales están diseñadas para almacenar y gestionar de forma eficiente datos vectoriales multidimensionales.
Una base de datos vectorial es una base especializada optimizada para almacenar y consultar vectores. Los vectores son, en esencia, arrays de números que representan puntos de datos en un espacio multidimensional.
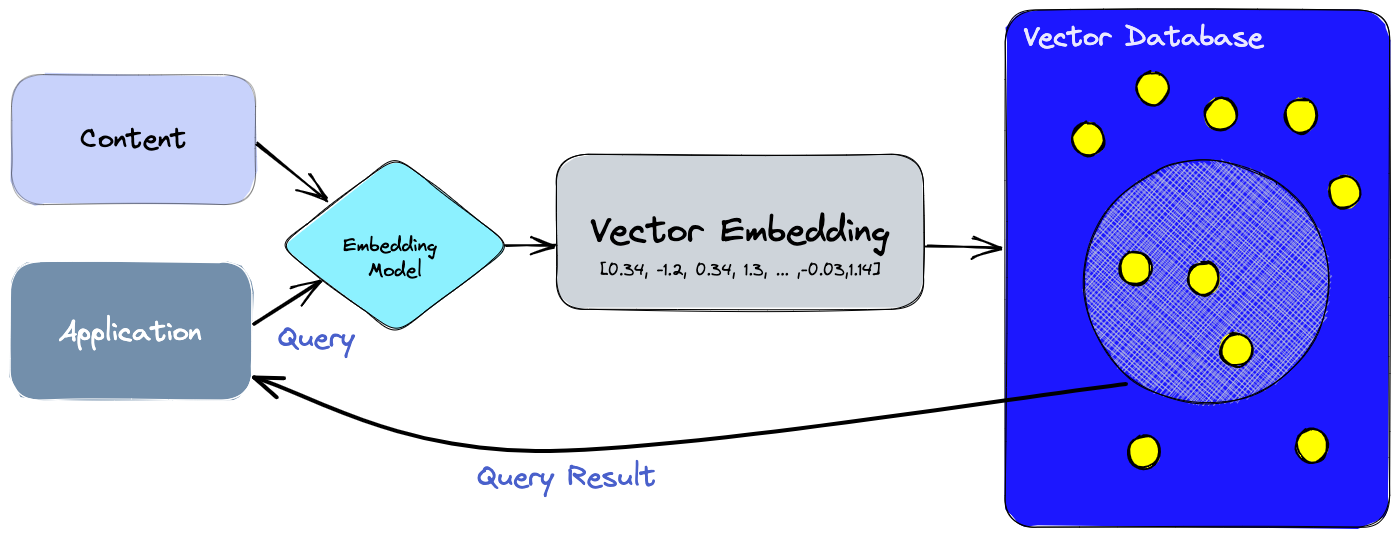
La gran ventaja de las bases de datos vectoriales es su capacidad para realizar búsquedas por similitud de forma eficiente. Esto significa que pueden encontrar rápidamente en la base los elementos «más cercanos» a un elemento de consulta dado, según alguna medida de distancia o similitud.
Esta capacidad es crucial para aplicaciones como los sistemas de recomendación, donde quieres encontrar productos similares a los que le gustan a una persona usuaria, o en aplicaciones de búsqueda semántica, cuyo objetivo es encontrar documentos semánticamente relacionados con una frase de consulta.
Las bases vectoriales usan diversos algoritmos para indexar y buscar vectores, a menudo basados en técnicas de búsqueda de vecinos más cercanos aproximados (ANN).
La búsqueda semántica supone un gran salto en cómo los motores de búsqueda entienden y procesan las consultas de los usuarios. A diferencia de los métodos tradicionales que se centran en coincidencias literales entre el texto de la consulta y el contenido de los documentos, la búsqueda semántica profundiza en la intención y el significado contextual detrás de una consulta.
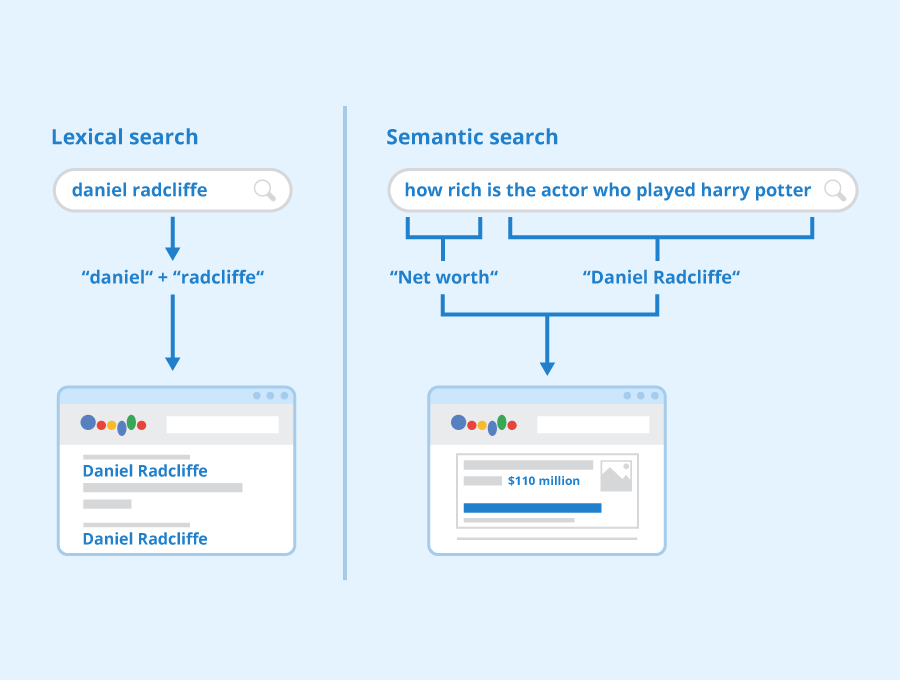
Búsqueda léxica vs. búsqueda semántica (fuente de la imagen)
La evolución hacia la búsqueda semántica en la última década se ha visto impulsada por varios factores. La búsqueda por voz, con asistentes como Siri, Alexa y Google Assistant, depende en gran medida del procesamiento del lenguaje natural para entender y ejecutar las órdenes.
La naturaleza conversacional de las búsquedas por voz exige comprender el contexto, lo que requiere que los motores capten el significado de oraciones completas o frases más largas.
La complejidad del lenguaje humano es una barrera importante para las aplicaciones de búsqueda léxica tradicionales, y la búsqueda semántica la está superando rápidamente. Hay miles de palabras en inglés con múltiples significados cuyo sentido real depende del contexto en el que se usen: son palabras polisémicas.
Por ejemplo, la palabra "table" puede referirse a un mueble o a una disposición de datos, según el contexto.
El auge de los grandes modelos de lenguaje multimodales (LLM) es uno de los motores principales de la popularidad explosiva de las aplicaciones de búsqueda semántica. La búsqueda semántica, cuyo objetivo es entender la intención de quien busca y el significado contextual de los términos tal y como aparecen en el espacio de datos consultable, está mejorando significativamente gracias a las capacidades de los LLM multimodales.
A medida que estos modelos evolucionan, no solo entienden y generan texto, sino que también interpretan y crean contenido en distintos formatos, incluidas imágenes, audio y vídeo. Estos avances permiten que las búsquedas vayan más allá de las palabras clave y comprendan los matices del lenguaje, las sutilezas de los diferentes medios y las relaciones complejas entre conceptos.
Por ejemplo, se puede realizar una consulta en lenguaje natural y el sistema devolver resultados no solo en texto, sino también imágenes, clips de vídeo o fragmentos de audio relevantes, todo ello entendido y curado por la IA para ajustarse a la intención de la consulta.
La búsqueda semántica tiene una amplia variedad de aplicaciones en distintos ámbitos y aporta beneficios sustanciales al mejorar la relevancia y precisión de los resultados:
¿Quieres saber más sobre bases de datos vectoriales? Echa un vistazo a esta guía completa con las mejores bases vectoriales.
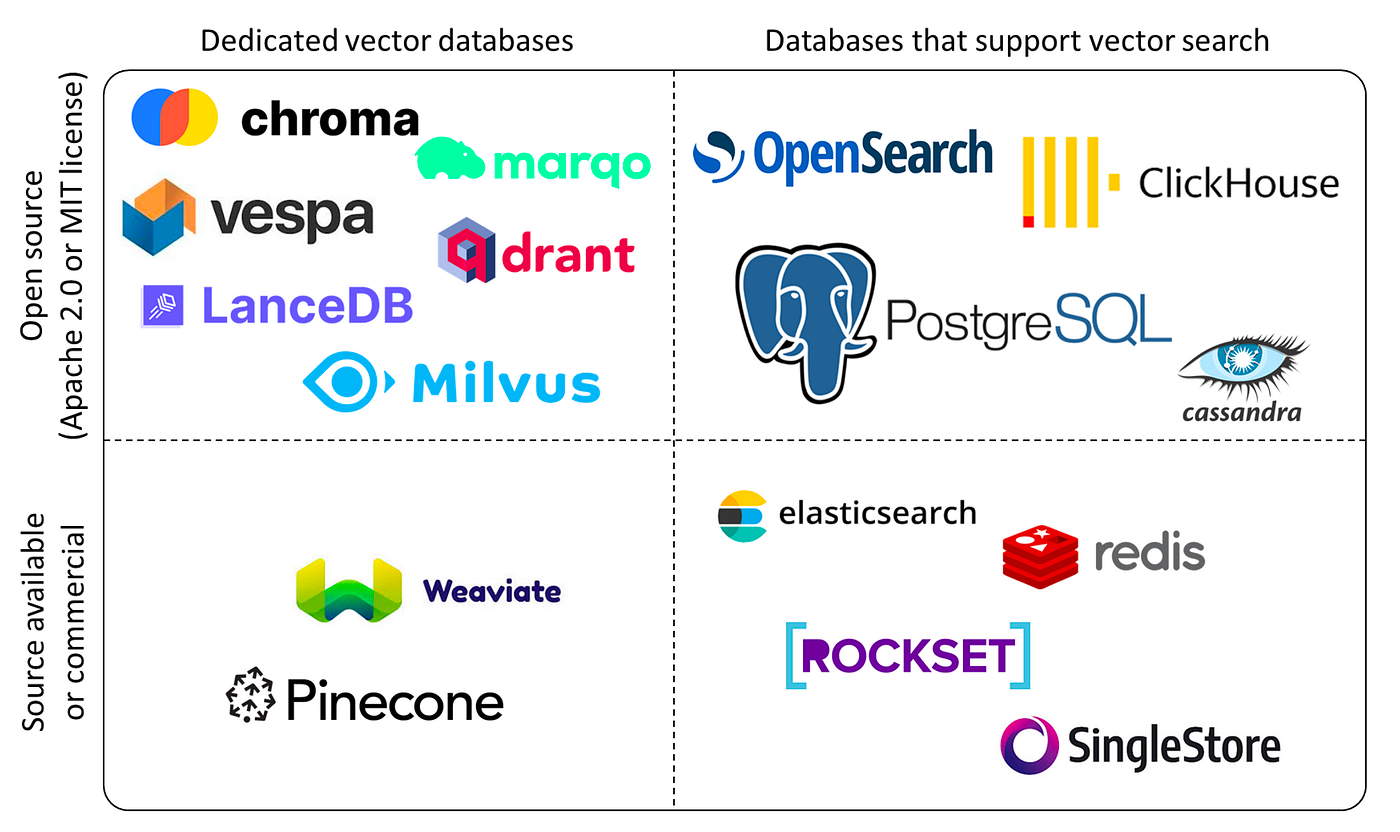
El panorama de las bases de datos vectoriales (fuente de la imagen)
Pinecone es una base de datos vectorial especializada para manejar datos complejos y de alta dimensión. Ofrece capacidades avanzadas de búsqueda e indexación que permiten a ingenieros y científicos de datos construir y ejecutar proyectos de machine learning a gran escala con eficiencia.
Si quieres profundizar en Pinecone, consulta en Datacamp Mastering Vector Databases with Pinecone Tutorial: A Comprehensive Guide.
OpenAI ofrece acceso a todos sus modelos a través de su API de plataforma. Incluye los populares modelos GPT, DALL-E y Whisper, además de tres modelos de embeddings.
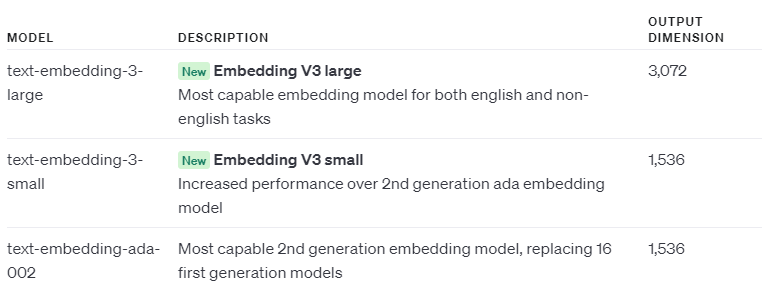
Estas APIs se pueden usar mediante solicitudes HTTP, por lo que son compatibles con cualquier lenguaje de programación capaz de comunicarse por HTTP.
Quienes usan Python también pueden utilizar la librería openai para interactuar con estas APIs, lo que lo hace aún más simple. Puedes instalarla con pip install openai.
Usar la API de OpenAI en Python con la librería openai requiere muy poco código.
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Fitness & Health."},
    {"role": "user", "content": "Explain what is Keto diet?"}
  ]
)


print(completion.choices[0].message)Salida: (truncada)
ChatCompletionMessage(content="The ketogenic diet, commonly known as the keto diet, is a low-carbohydrate, high-fat diet. The diet is named after ketosis, a metabolic state where your body starts burning fat for energy instead of carbohydrates. This is accomplished by drastically reducing your intake of carbohydrates and increasing your intake of fats….", role='assistant', function_call=None, tool_calls=None)
¡Descubre cómo ChatGPT y los grandes modelos de lenguaje están revolucionando el mundo digital! Sumérgete en la chuleta de Datacamp para dominar lo esencial y aprovechar una de las APIs de IA más potentes: la API de OpenAI.
Tras registrarte en OpenAI, ve a https://platform.openai.com/api-keys
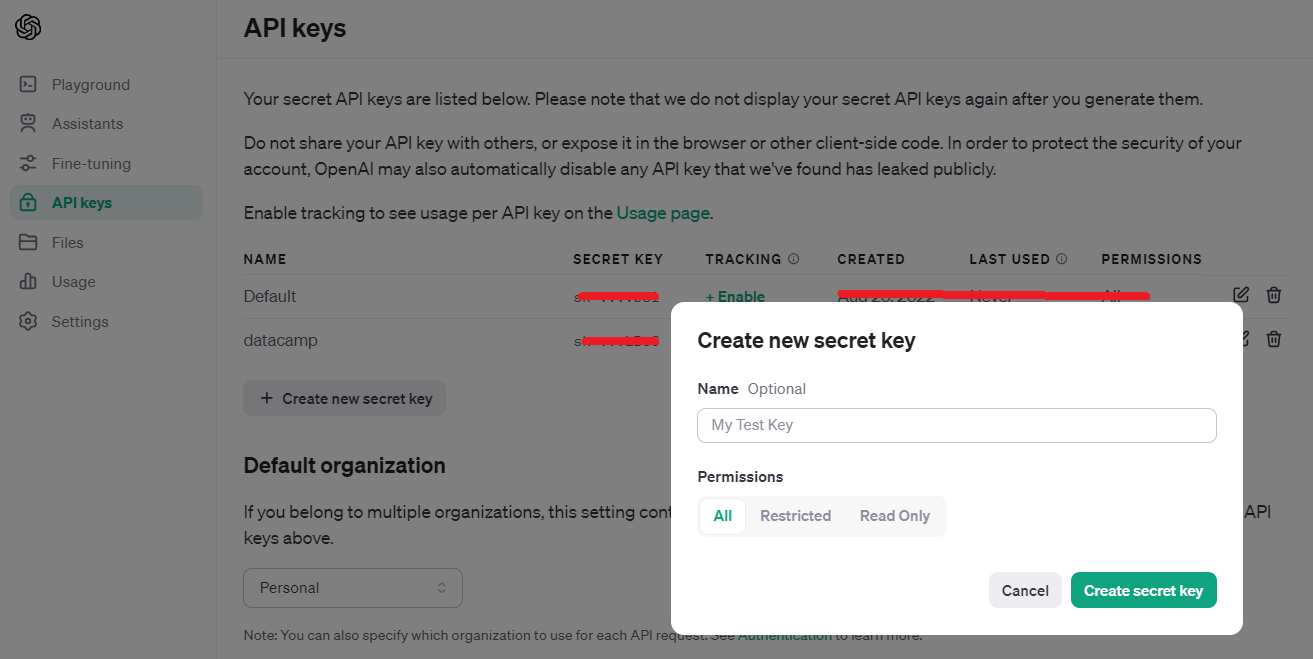
API Keys platform.openai.com
Para Pinecone, inicia sesión y haz clic en API Keys. Puedes pulsar el botón "Click API Key" en la esquina derecha.
A diferencia de OpenAI, en Pinecone no es estrictamente necesario copiar la clave cuando la generas, porque hay un icono de copia en la columna Actions que puedes usar cuando quieras.
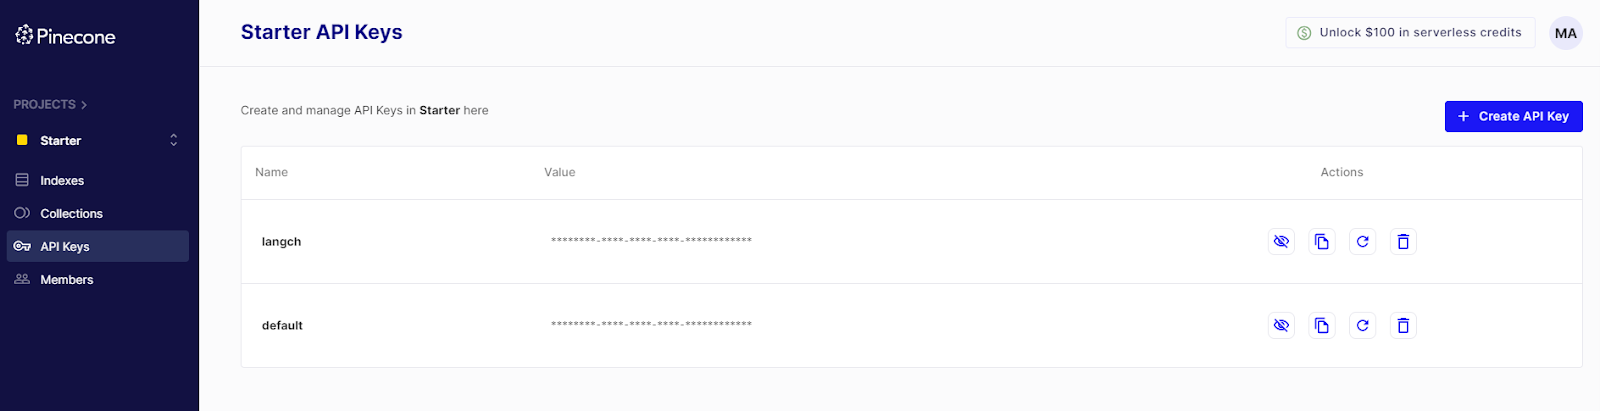
API Keys - Pinecone
Después de obtener las claves de API de OpenAI y Pinecone, asígnalas a variables en el Notebook o configúralas como variables de entorno con el módulo os de Python.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Para seguir este tutorial, instala las siguientes librerías con pip. Debes usar exactamente estas versiones; de lo contrario, el código no funcionará.
!pip install pinecone-client==3.0.0
!pip install pinecone-datasets==0.7.0
!pip install openai==0.28La librería pinecone-datasets incluye varios datasets pre-embebidos con el modelo embedding-ada-002 de OpenAI.
En este ejemplo usaremos el dataset "wikipedia-simple-text-embedding-ada-002-100K", tomando una muestra de 5.000 de sus 100.000 documentos y sus embeddings.
import pinecone_datasets

# load dataset from pinecone
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')

# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)

# sample 5k documents
dataset.documents.drop(dataset.documents.index[5_000:], inplace=True)
dataset.head()
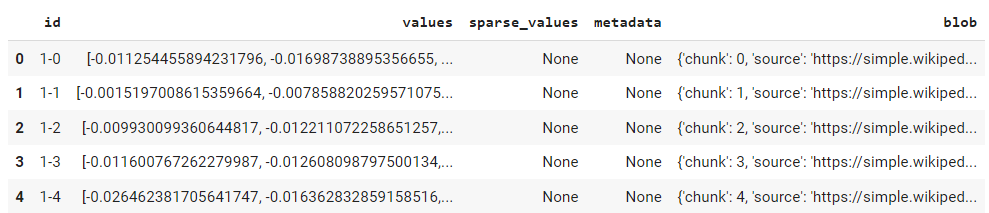
Conjunto de datos de ejemplo
En Pinecone, un índice es la unidad organizativa principal para los datos vectoriales. Se encarga de almacenar vectores, procesar consultas sobre ellos y realizar diversas operaciones sobre los datos vectoriales que contiene.
from pinecone import Pinecone, ServerlessSpec

# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)

# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')

# set index name
index_name = 'semantic-search-demo'

# we create a new index
pc.create_index(
        index_name,
        dimension=1536,  # dimensionality of text-embedding-ada-002
        metric='cosine',
        spec=spec
    )
El código anterior inicializa la instancia de Pinecone y crea un índice llamado semantic-search-demo. En este punto ya verás el índice en la interfaz.
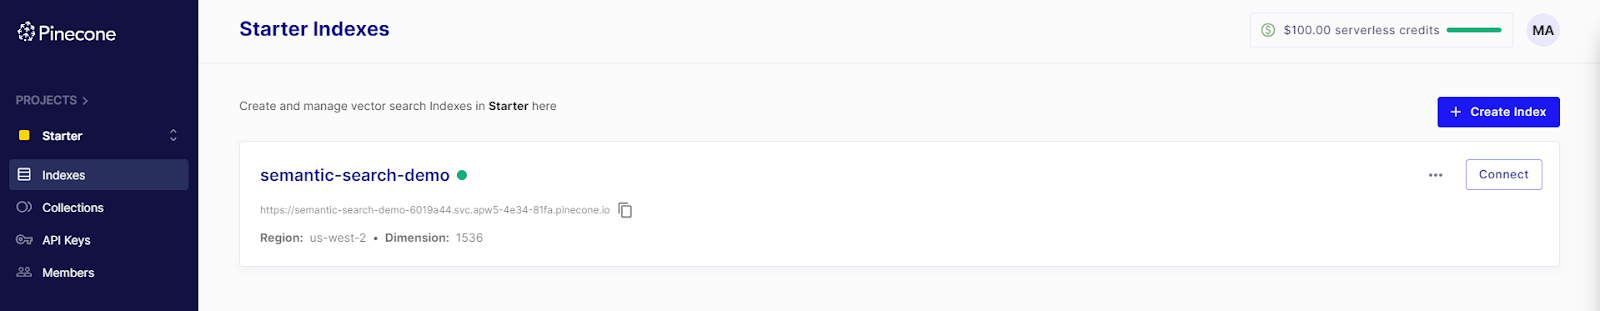
Dado que nuestros datos ya incluyen representaciones embebidas, podemos saltarnos el proceso de embedding y pasar directamente a insertar los datos en el índice recién creado.
Si trabajas con datasets sin embeddings, primero tendrás que generar los embeddings de los datos en bruto usando la API de OpenAI (consulta el paso 5).
index = pc.Index(index_name)
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Cuando el código termine correctamente, también podrás ver los datos en la interfaz.
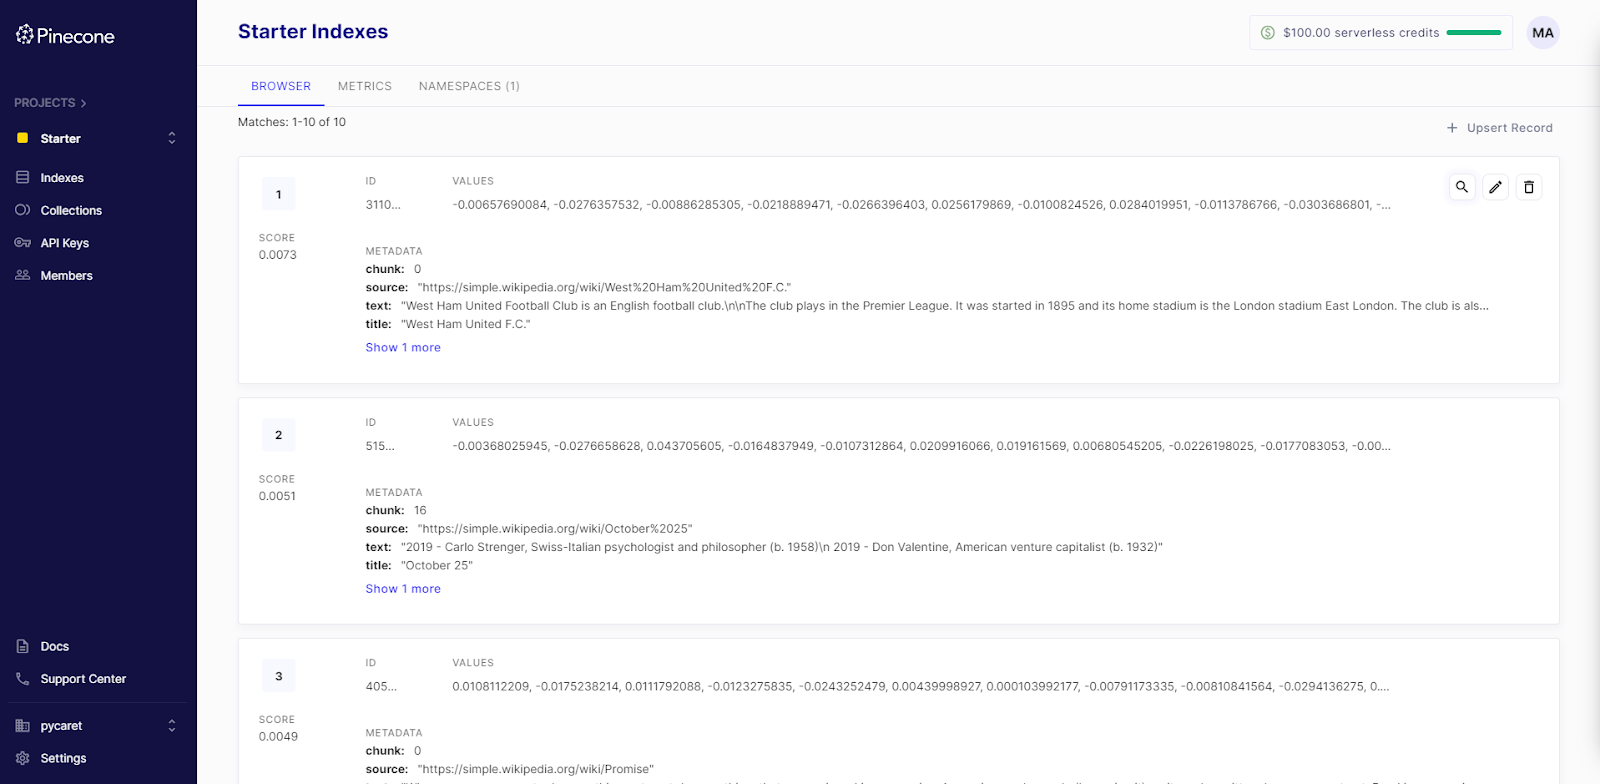
Los datos nuevos o las consultas deben convertirse a embeddings con el mismo modelo para asegurar que las dimensiones del vector coinciden. Como nuestro dataset usa text-embedding-ada-002, crearemos una función que use la API de OpenAI para generar embeddings de nuevas consultas con ese mismo modelo.
import openai
openai.api_key = OPENAI_API_KEY


def get_embedding(text_to_embed):
  # Embed a line of text
  response = openai.Embedding.create(
      model= "text-embedding-ada-002",
      input=[text_to_embed]
  )
  # Extract the AI output embedding as a list of floats
  embedding = response['data'][0]['embedding']

return embeddingquery = "What are some easter related events in Western Christianity?"
result = get_embedding(query)
print(len(result))
print(result)Salida:
1536
[0.014745471067726612, -0.03282099589705467, -0.006603493355214596, -0.0025058642495423555,.........]
La longitud de result es 1536, en línea con la dimension especificada al crear el índice.
Enviar una consulta de búsqueda es muy sencillo:
query_result = index.query(vector=result, top_k=3, include_metadata=True)
print(query_result)Salida:
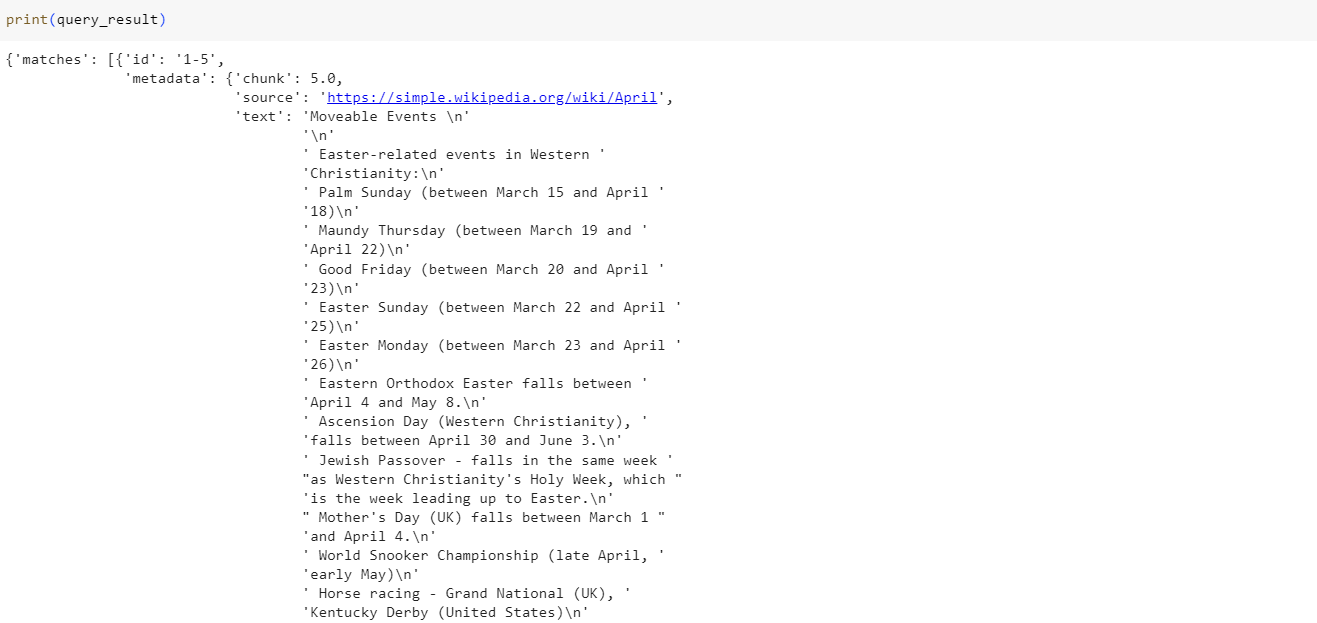
El objeto query_result devuelve un diccionario con una lista de las 3 mejores coincidencias respecto a la consulta del usuario. Estas N mejores coincidencias pueden usarse en tareas posteriores, como aportar contexto a prompts en escenarios de RAG (Generación aumentada con recuperación) o para construir chatbots.
En este tutorial hemos presentado varios conceptos clave —como los embeddings y las bases de datos vectoriales— para entender el funcionamiento completo de las aplicaciones de búsqueda semántica.
Con la llegada de la IA generativa y la evolución constante de los LLM multimodales, el potencial de la búsqueda semántica se ha ampliado, ofreciendo una precisión sin precedentes y una mejor comprensión de la complejidad y los matices de los datos no estructurados.
Aprovechando las capacidades de Pinecone, una base de datos vectorial de vanguardia, y los sofisticados modelos de embeddings de OpenAI, los desarrolladores y científicos de datos tienen a su alcance las herramientas para crear aplicaciones de búsqueda semántica que trascienden las metodologías tradicionales basadas en palabras clave.
A lo largo de esta guía también hemos visto la importancia de los embeddings para salvar la distancia entre la complejidad del lenguaje humano y las representaciones numéricas necesarias para el machine learning, y cómo permiten a las máquinas captar los matices de contexto e intención.
Está claro que el futuro de la búsqueda pasa por comprender el lenguaje y otras formas de datos no estructurados, impulsado por la IA. Ya sea para comercio electrónico, descubrimiento de contenido, soporte al cliente o gestión del conocimiento, los principios y prácticas de este blog ofrecen una base sólida para aprovechar la búsqueda semántica y crear experiencias de búsqueda más inteligentes, ágiles y centradas en el usuario.
Si quieres aprender más sobre cómo crear aplicaciones de búsqueda semántica con Pinecone, consulta el code-along de Semantic Search with Pinecone; o, si te interesa la funcionalidad que sustenta aplicaciones populares de IA como ChatGPT, echa un vistazo al curso Working with the OpenAI API. Y no olvides revisar nuestro curso Vector Databases for Embeddings with Pinecone.
¡Aprende más sobre cómo trabajar con OpenAI!
Curso
Curso
programa
Tutorial
Arunn Thevapalan
13 min
Tutorial
Zoumana Keita
7 min
Tutorial
Zoumana Keita
12 min
Tutorial
Zoumana Keita
14 min
Tutorial
Moez Ali
12 min
Tutorial
Adel Nehme
9 min