
Khóa học
Làm việc với OpenAI API
3 giờ
184.5K
Bối cảnh dữ liệu luôn thay đổi, cùng với tiến bộ vượt bậc của Trí tuệ nhân tạo sinh trong hai năm qua, đã định hình lại hướng đi của tìm kiếm ngữ nghĩa, ngày càng thúc đẩy sự phổ biến của các ứng dụng tìm kiếm ngữ nghĩa.
Tìm kiếm và truy xuất là quy trình xác định và lấy thông tin hoặc dữ liệu cụ thể từ một cơ sở dữ liệu hoặc bộ sưu tập lớn hơn dựa trên tiêu chí truy vấn. Sự phát triển của AI đã làm gia tăng nhu cầu về các phương pháp tìm kiếm chính xác hơn, nhận biết ngữ cảnh và hiệu quả hơn, dẫn đến sự xuất hiện của các ứng dụng tìm kiếm ngữ nghĩa ở khắp nơi.
Tìm kiếm ngữ nghĩa vượt lên trên những hạn chế của tìm kiếm dựa trên từ khóa truyền thống bằng cách hiểu ý định và nghĩa theo ngữ cảnh của truy vấn, từ đó đưa ra kết quả phù hợp và chính xác hơn.
Để xây dựng một ứng dụng tìm kiếm ngữ nghĩa end-to-end, bạn cần hiểu một số khái niệm then chốt như Embedding, Cơ sở dữ liệu vector, Khoảng cách đo lường (Distance Metrics), v.v., đồng thời học cách sử dụng các sản phẩm/dịch vụ như Pinecone và GPT của OpenAI để xây dựng và triển khai ứng dụng tìm kiếm ngữ nghĩa end-to-end.
Kết thúc bài viết này, bạn sẽ nắm được toàn diện các nguyên lý của tìm kiếm ngữ nghĩa, embedding, vai trò của cơ sở dữ liệu vector, và cuối cùng là học cách triển khai tìm kiếm ngữ nghĩa trong Python bằng:
Nếu bạn muốn tìm hiểu thêm thông qua các bài thực hành, hãy xem khóa học Vector Databases for Embeddings with Pinecone.
Embedding là một khái niệm cốt lõi trong học máy. Nó bắc cầu giữa thế giới ngôn ngữ và hiểu biết phong phú, tinh tế của con người với biểu diễn toán học chính xác của thế giới đó bằng các con số.
Dữ liệu phi cấu trúc như văn bản, hình ảnh, âm thanh và video không tuân theo một định dạng có tổ chức cụ thể, gây khó khăn cho việc lưu trữ và xử lý trong các cơ sở dữ liệu truyền thống. Phân tích loại dữ liệu này cho các ứng dụng máy học và AI thường đòi hỏi phải chuyển đổi thành các biểu diễn số đa chiều thông qua vector embedding. Quá trình chuyển đổi dữ liệu phi cấu trúc thành các vector số đa chiều được gọi là Embedding.
Embeddings là các biểu diễn số đa chiều của văn bản, hình ảnh hoặc bất kỳ loại dữ liệu phi cấu trúc nào, giúp máy móc học được độ phức tạp của giao tiếp con người, mối quan hệ giữa các khái niệm hoặc các mẫu trong dữ liệu theo cách hiệu quả về tính toán và giàu ngữ cảnh.
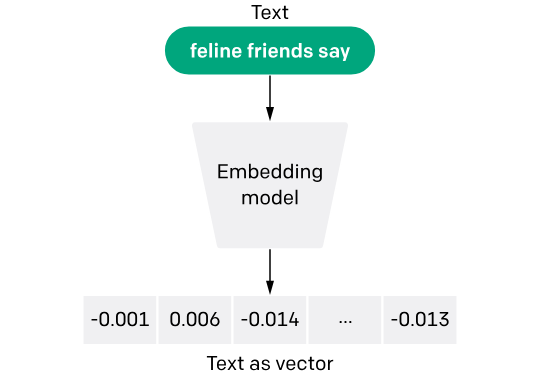
Mô hình embedding văn bản và mã của OpenAI (Nguồn ảnh)
Ý tưởng cốt lõi đằng sau các mô hình embedding là những mục tương tự có thể được biểu diễn bằng các điểm gần nhau trong một không gian nhiều chiều. Khái niệm này cho phép nắm bắt các mối quan hệ phức tạp trong dữ liệu, như từ đồng nghĩa, phép loại suy, hay thậm chí những kết nối trừu tượng hơn, bằng cách giảm bớt độ phức tạp khổng lồ của ngôn ngữ con người hoặc các dạng dữ liệu khác về một hình thức mà máy có thể xử lý.
Chẳng hạn, trong dữ liệu văn bản, các từ được chuyển thành vector (các con số), về bản chất là mảng số. Các vector này cô đọng bản chất về ý nghĩa, cách dùng và ngữ cảnh của từ trong khuôn khổ hiểu biết của mô hình ngôn ngữ.
Độ dài của vector do mô hình embedding trả về phụ thuộc vào mô hình bạn sử dụng. Ví dụ, nếu bạn dùng mô hình embedding của OpenAI, độ dài vector sẽ luôn là `1536`.
Đằng sau hậu trường, mô hình embedding chỉ là một Mô hình Mạng nơ-ron khổng lồ được huấn luyện trên một kho dữ liệu cực lớn. Mô hình học cách gán vector cho dữ liệu đầu vào sao cho mối quan hệ hình học giữa các vector phản chiếu mối quan hệ ngữ nghĩa hoặc khái niệm giữa các mẫu dữ liệu.
Ví dụ, trong một mô hình embedding được huấn luyện tốt, vector biểu diễn từ "king" trừ đi vector của "man" cộng với vector của "woman" có thể cho ra vector rất gần với vector biểu diễn "queen". Khả năng thực hiện các phép toán mang ý nghĩa này là minh chứng mạnh mẽ cho cách embeddings nắm bắt ngữ nghĩa tiềm ẩn của ngôn ngữ.
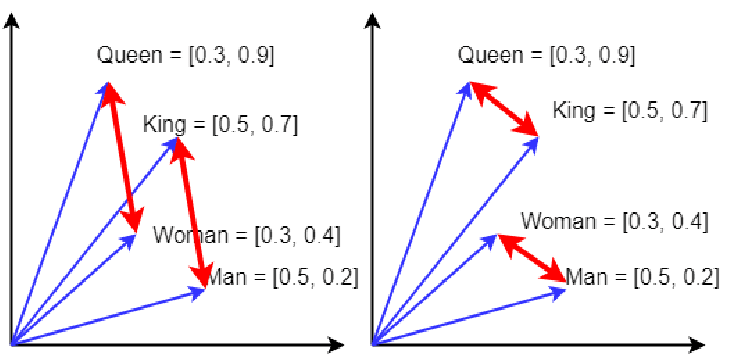
Ví dụ kinh điển king + woman − man ≈ queen của word embeddings (Nguồn ảnh)
Bạn hoàn toàn có thể tự huấn luyện mô hình embedding, nhưng điều đó có thể đòi hỏi thu thập một lượng dữ liệu rất lớn và tài nguyên để huấn luyện một mô hình mạng nơ-ron khổng lồ, tốn hàng triệu đô la và mất vài tháng để huấn luyện.
Phương án khác thực tế hơn là sử dụng một mô hình embedding đã được huấn luyện sẵn. Có nhiều mô hình embedding nguồn mở trên Hugging Face mà bạn có thể tải về và dùng cục bộ, hoặc bạn có thể sử dụng các mô hình độc quyền do các công ty như OpenAI, Anthropic, Cohere, v.v. cung cấp.
Trong bài viết này, chúng ta sẽ sử dụng mô hình `text-embedding-ada-002` của OpenAI, có mức giá phải chăng ($0.00010 cho mỗi 1K token). Điều này có nghĩa là một cuốn sách 1000 trang sẽ có chi phí xấp xỉ dưới $1.
Embeddings rất quan trọng đối với vô số ứng dụng trên nhiều lĩnh vực. Trong tìm kiếm ngữ nghĩa, chúng cho phép hệ thống vượt ra ngoài đối sánh từ khóa đơn thuần, giúp truy xuất các kết quả liên quan theo ngữ cảnh với truy vấn, ngay cả khi nội dung không dùng đúng từ ngữ. Khả năng này nâng cao đáng kể mức độ phù hợp và độ chính xác của kết quả tìm kiếm, giúp việc khám phá thông tin trở nên trực quan và hiệu quả hơn.
Embeddings không chỉ giới hạn ở văn bản. Embedding hình ảnh, chẳng hạn, mang lại những tiến bộ tương tự trong thị giác máy tính, cho phép máy nhận diện đối tượng, bối cảnh và hoạt động trong hình ảnh và video bằng cách hiểu chúng trong không gian vector nhiều chiều. Sự hiểu biết này không chỉ là nhận dạng điểm ảnh, mà là nắm bắt bản chất của những gì các điểm ảnh đó đại diện.
Các mô hình embedding không chỉ mang tính chuyển đổi mà còn vô cùng hữu ích vì chúng chuyển hóa độ phức tạp của dữ liệu thế giới thực sang một “ngôn ngữ” (vector số) mà máy có thể hiểu và hành động, mở đường cho nhiều ứng dụng dựa trên hiểu biết ngữ nghĩa sâu và xử lý dữ liệu thông minh.
Để tìm hiểu thêm về Embeddings, hãy xem bài Giới thiệu về Text Embeddings với OpenAI API.
Cơ sở dữ liệu vector là một danh mục lưu trữ dữ liệu phi quan hệ tương đối mới, ngày càng phổ biến nhờ những tiến bộ gần đây trong AI sinh và các mô hình ngôn ngữ lớn.
Không giống các cơ sở dữ liệu quan hệ truyền thống tổ chức dữ liệu theo hàng và cột, hay các dạng lưu trữ phi quan hệ khác như Cơ sở dữ liệu tài liệu tổ chức dữ liệu dưới dạng đối tượng json hoặc xml, cơ sở dữ liệu vector được thiết kế để lưu trữ và xử lý dữ liệu vector đa chiều một cách hiệu quả.
Một cơ sở dữ liệu vector là cơ sở dữ liệu chuyên dụng, tối ưu cho việc lưu trữ và truy vấn các vector. Vector về bản chất là các mảng số biểu diễn các điểm dữ liệu trong không gian đa chiều.
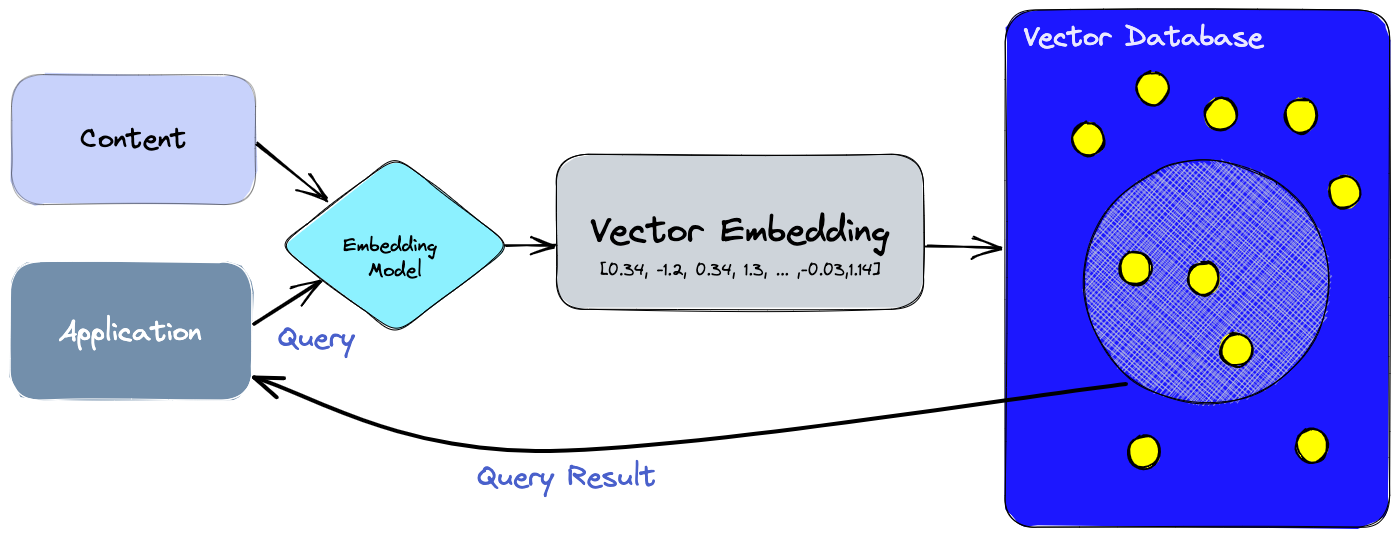
Ưu điểm then chốt của cơ sở dữ liệu vector là khả năng thực hiện tìm kiếm theo độ tương đồng một cách hiệu quả. Điều này có nghĩa là chúng có thể nhanh chóng tìm các mục trong cơ sở dữ liệu “gần nhất” với một mục truy vấn, theo một thước đo khoảng cách hay độ tương đồng nào đó.
Khả năng này rất quan trọng đối với các ứng dụng như hệ thống gợi ý, nơi bạn muốn tìm sản phẩm tương tự với những gì người dùng thích, hoặc trong ứng dụng tìm kiếm ngữ nghĩa, nơi mục tiêu là tìm các tài liệu liên quan về mặt ngữ nghĩa với cụm truy vấn.
Cơ sở dữ liệu vector sử dụng nhiều thuật toán để lập chỉ mục và tìm kiếm vector, thường dựa vào các kỹ thuật tìm kiếm Láng giềng gần đúng (ANN).
Tìm kiếm ngữ nghĩa đánh dấu một bước tiến lớn trong việc cải thiện cách công cụ tìm kiếm hiểu và xử lý truy vấn của người dùng. Khác với các phương pháp truyền thống tập trung vào đối sánh từng chữ giữa truy vấn và nội dung tài liệu, tìm kiếm ngữ nghĩa đi sâu vào ý định và nghĩa theo ngữ cảnh đằng sau truy vấn.
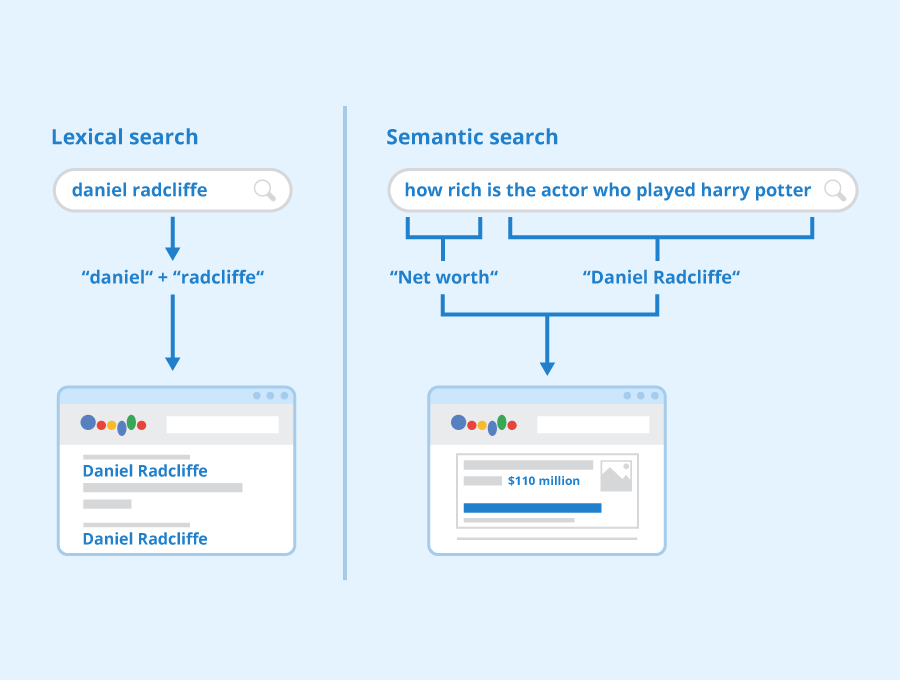
Tìm kiếm từ vựng vs. Tìm kiếm ngữ nghĩa (Nguồn ảnh)
Sự tiến hóa của công nghệ tìm kiếm hướng tới tìm kiếm ngữ nghĩa trong thập kỷ qua được thúc đẩy bởi nhiều yếu tố. Tìm kiếm bằng giọng nói, vận hành bởi các trợ lý ảo như Siri, Alexa và Google Assistant, phụ thuộc rất nhiều vào xử lý ngôn ngữ tự nhiên để hiểu và thực thi yêu cầu của người dùng.
Tính đối thoại của các truy vấn bằng giọng nói đòi hỏi sự hiểu biết về ngữ cảnh, buộc công cụ tìm kiếm phải nắm bắt ý nghĩa đằng sau cả câu hoặc cụm từ dài.
Độ phức tạp của ngôn ngữ con người là rào cản lớn đối với các ứng dụng tìm kiếm dựa trên từ vựng truyền thống, điều mà tìm kiếm ngữ nghĩa đang nhanh chóng vượt qua. Có hàng nghìn từ trong tiếng Anh mang nhiều nghĩa và nghĩa thực phụ thuộc vào ngữ cảnh sử dụng. Những từ này được gọi là từ đa nghĩa.
Ví dụ, từ "table" có thể chỉ một món đồ nội thất hoặc một cách sắp xếp dữ liệu, tùy theo ngữ cảnh.
Sự trỗi dậy của các mô hình ngôn ngữ lớn đa phương thức (LLM) là động lực hàng đầu phía sau làn sóng phổ biến của các ứng dụng tìm kiếm ngữ nghĩa. Tìm kiếm ngữ nghĩa, với mục tiêu hiểu ý định người tìm kiếm và nghĩa theo ngữ cảnh của các thuật ngữ khi chúng xuất hiện trong không gian dữ liệu có thể tìm kiếm, đang được tăng cường đáng kể bởi năng lực của các LLM đa phương thức.
Khi các mô hình này phát triển, chúng không chỉ hiểu và tạo văn bản mà còn diễn giải và tạo nội dung trên nhiều định dạng, bao gồm hình ảnh, âm thanh và video. Những tiến bộ này có nghĩa là việc tìm kiếm giờ đây có thể vượt ra ngoài đối sánh từ khóa đơn thuần để nắm bắt sắc thái của ngôn ngữ, tính tinh tế của các phương tiện khác nhau và các mối quan hệ phức tạp giữa các khái niệm.
Chẳng hạn, một truy vấn có thể được đưa ra bằng ngôn ngữ tự nhiên, và hệ thống có thể trả về kết quả không chỉ là văn bản mà còn gồm hình ảnh, đoạn video hoặc trích âm thanh liên quan, tất cả đều được AI hiểu và tuyển chọn để phù hợp với ý định của truy vấn.
Tìm kiếm ngữ nghĩa có phạm vi ứng dụng rộng rãi trên nhiều lĩnh vực, mang lại lợi ích đáng kể trong việc nâng cao mức độ phù hợp và độ chính xác của kết quả tìm kiếm:
Bạn quan tâm tìm hiểu thêm về Cơ sở dữ liệu vector? Hãy xem Hướng dẫn toàn diện về các cơ sở dữ liệu vector tốt nhất.
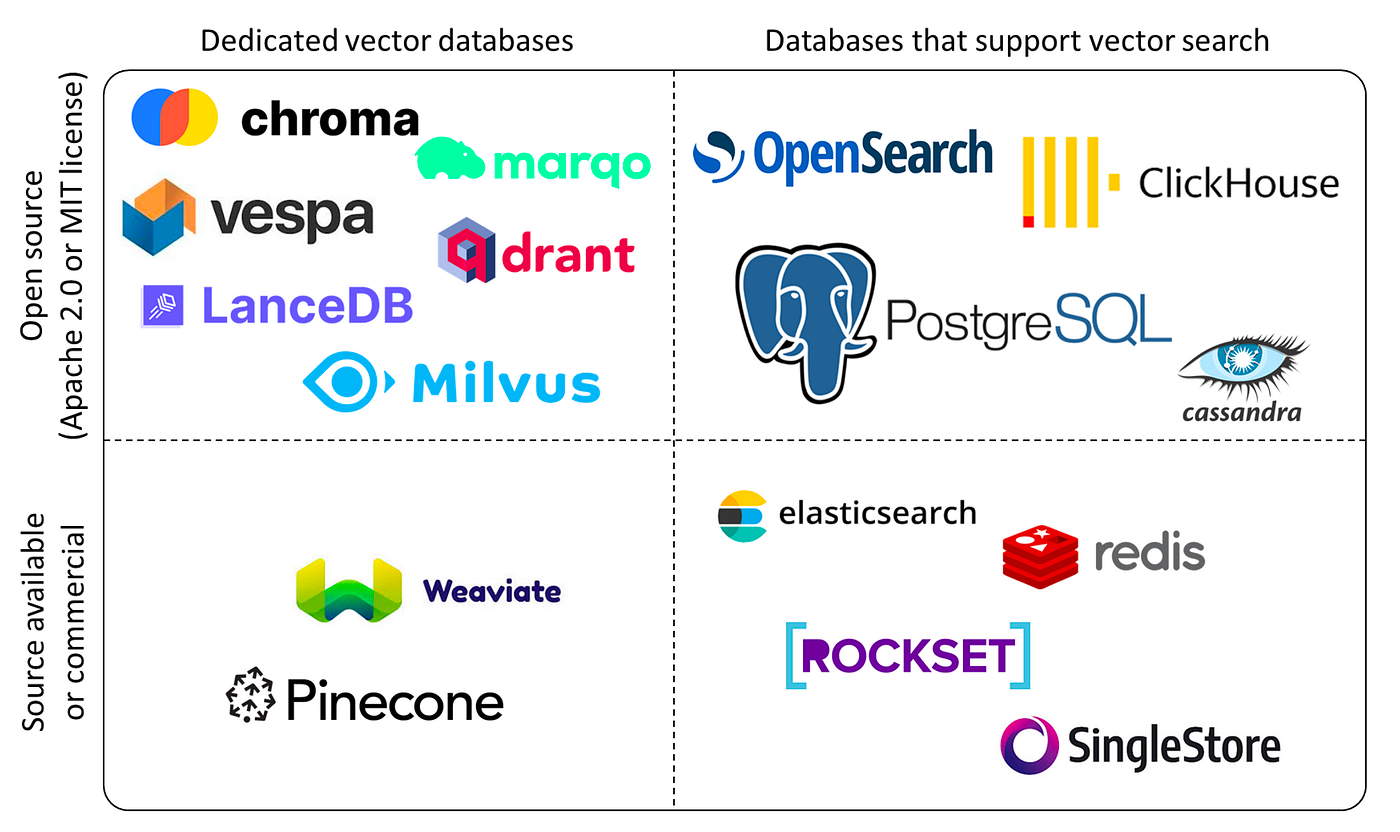
Bức tranh cơ sở dữ liệu vector (Nguồn ảnh)
Pinecone là cơ sở dữ liệu vector chuyên dụng được thiết kế để xử lý dữ liệu phức tạp, nhiều chiều. Nó cung cấp khả năng tìm kiếm và lập chỉ mục tiên tiến, cho phép kỹ sư dữ liệu và nhà khoa học dữ liệu xây dựng và vận hành các dự án học máy quy mô lớn một cách hiệu quả.
Nếu bạn muốn tìm hiểu sâu hơn về Pinecone, hãy xem Mastering Vector Databases with Pinecone Tutorial: A Comprehensive Guide trên Datacamp.
OpenAI cung cấp quyền truy cập tất cả mô hình qua nền tảng API. Điều này bao gồm các mô hình phổ biến như GPT, DALL-E và Whisper, cùng với ba mô hình embedding.
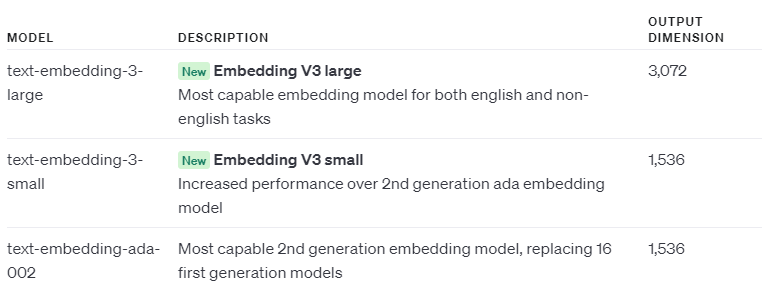
Những API này có thể tương tác qua các yêu cầu HTTP, cho phép tương thích với bất kỳ ngôn ngữ lập trình nào có khả năng giao tiếp HTTP.
Người dùng Python cũng có thể dùng thư viện openai để tương tác với các API này, giúp việc sử dụng đơn giản và dễ dàng hơn. Thư viện có thể cài đặt bằng pip install openai.
Sử dụng OpenAI API trong Python với thư viện openai chỉ cần một lượng mã tối thiểu.
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Fitness & Health."},
    {"role": "user", "content": "Explain what is Keto diet?"}
  ]
)


print(completion.choices[0].message)
Đầu ra: (rút gọn)
ChatCompletionMessage(content="The ketogenic diet, commonly known as the keto diet, is a low-carbohydrate, high-fat diet. The diet is named after ketosis, a metabolic state where your body starts burning fat for energy instead of carbohydrates. This is accomplished by drastically reducing your intake of carbohydrates and increasing your intake of fats….", role='assistant', function_call=None, tool_calls=None)
Khám phá cách ChatGPT và các mô hình ngôn ngữ lớn đang cách mạng hóa bức tranh số! Khám phá cheat sheet để làm chủ những điều cốt lõi trong việc tận dụng một trong những API AI mạnh mẽ nhất - OpenAI API của Datacamp.
Sau khi bạn đăng ký tài khoản OpenAI, chỉ cần truy cập https://platform.openai.com/api-keys
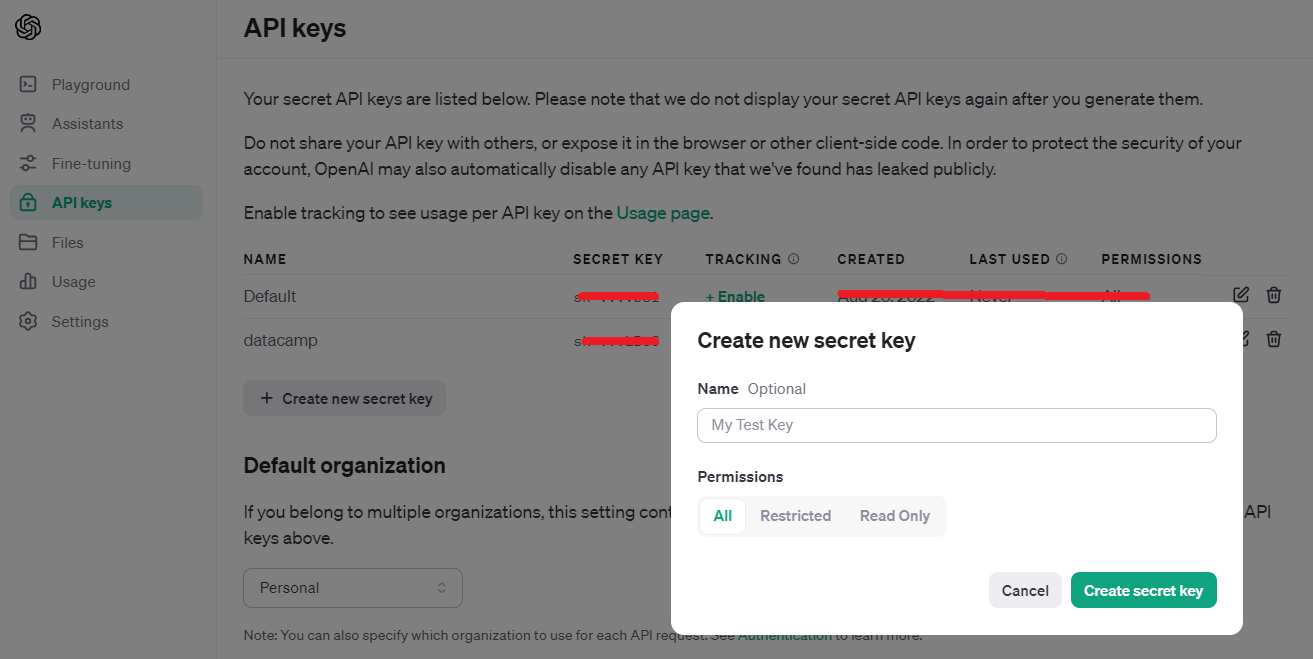
API Keys platform.openai.com
Với Pinecone, đăng nhập vào tài khoản của bạn và nhấp vào API Keys. Bạn có thể nhấp nút `Click API Key` ở góc phải.
Khác với OpenAI, với Pinecone, bạn không nhất thiết phải sao chép API key ngay khi tạo vì có biểu tượng sao chép dưới cột Actions mà bạn có thể dùng bất cứ lúc nào.
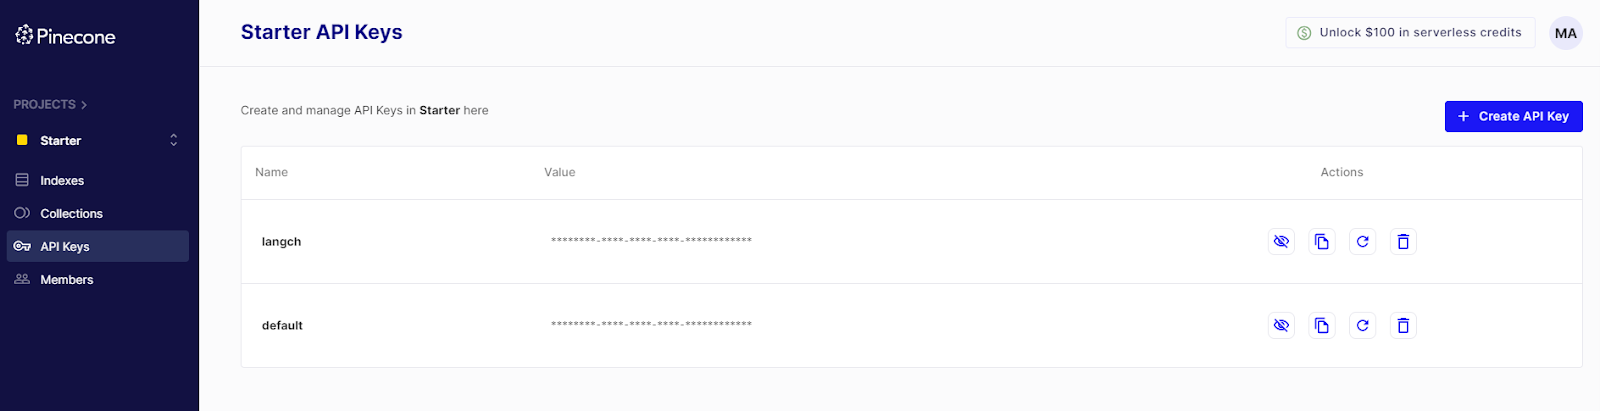
API Keys - Pinecone
Sau khi lấy API key của OpenAI và Pinecone, gán chúng vào biến trong Notebook hoặc đặt làm biến môi trường bằng mô-đun os của Python.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Để triển khai hướng dẫn này, bạn cần cài các thư viện sau bằng pip. Bạn phải dùng đúng phiên bản, nếu không mã phía dưới sẽ không hoạt động.
!pip install pinecone-client==3.0.0
!pip install pinecone-datasets==0.7.0
!pip install openai==0.28Thư viện pinecone-datasets bao gồm một số tập dữ liệu đã được embedding sẵn bằng mô hình embedding-ada-002 của OpenAI.
Trong ví dụ này, chúng ta sẽ dùng tập `wikipedia-simple-text-embedding-ada-002-100K`, chỉ lấy mẫu 5.000 trong số 100.000 tài liệu và embedding của chúng.
import pinecone_datasets

# load dataset from pinecone
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')

# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)

# sample 5k documents
dataset.documents.drop(dataset.documents.index[5_000:], inplace=True)
dataset.head()
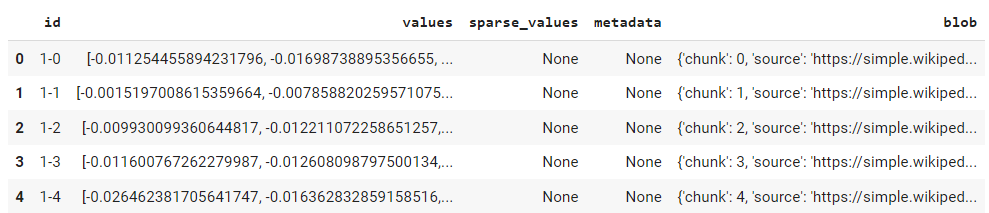
Tập dữ liệu mẫu
Trong Pinecone, index là đơn vị tổ chức cao nhất cho dữ liệu vector. Nó xử lý lưu trữ vector, xử lý truy vấn cho các vector đã lưu và thực hiện nhiều thao tác khác nhau trên dữ liệu vector mà nó nắm giữ.
from pinecone import Pinecone, ServerlessSpec

# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)

# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')

# set index name
index_name = 'semantic-search-demo'

# we create a new index
pc.create_index(
        index_name,
        dimension=1536,  # dimensionality of text-embedding-ada-002
        metric='cosine',
        spec=spec
    )
Đoạn mã trên khởi tạo thực thể Pinecone, tạo một index tên semantic-search-demo. Tại thời điểm này, bạn cũng sẽ thấy index này trên giao diện UI.
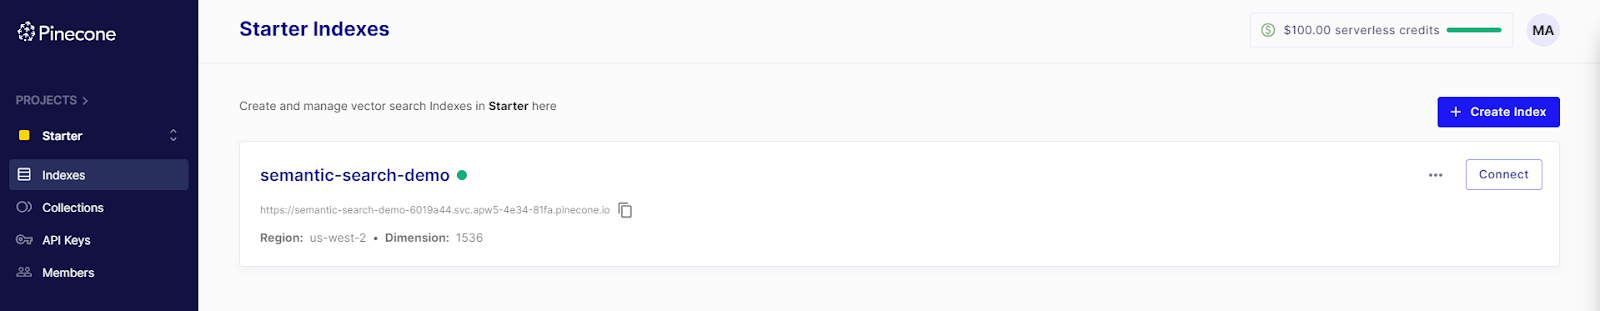
Vì dữ liệu của chúng ta đã bao gồm các biểu diễn embedding, chúng ta có thể bỏ qua bước tạo embedding và tiến thẳng đến việc chèn dữ liệu vào index vừa tạo.
Với các tập dữ liệu không có biểu diễn embedding, trước tiên hãy embedding dữ liệu thô bằng OpenAI API (xem bước 5 bên dưới để biết hướng dẫn).
index = pc.Index(index_name)
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Sau khi mã chạy thành công, bạn cũng có thể xem dữ liệu trên giao diện người dùng.
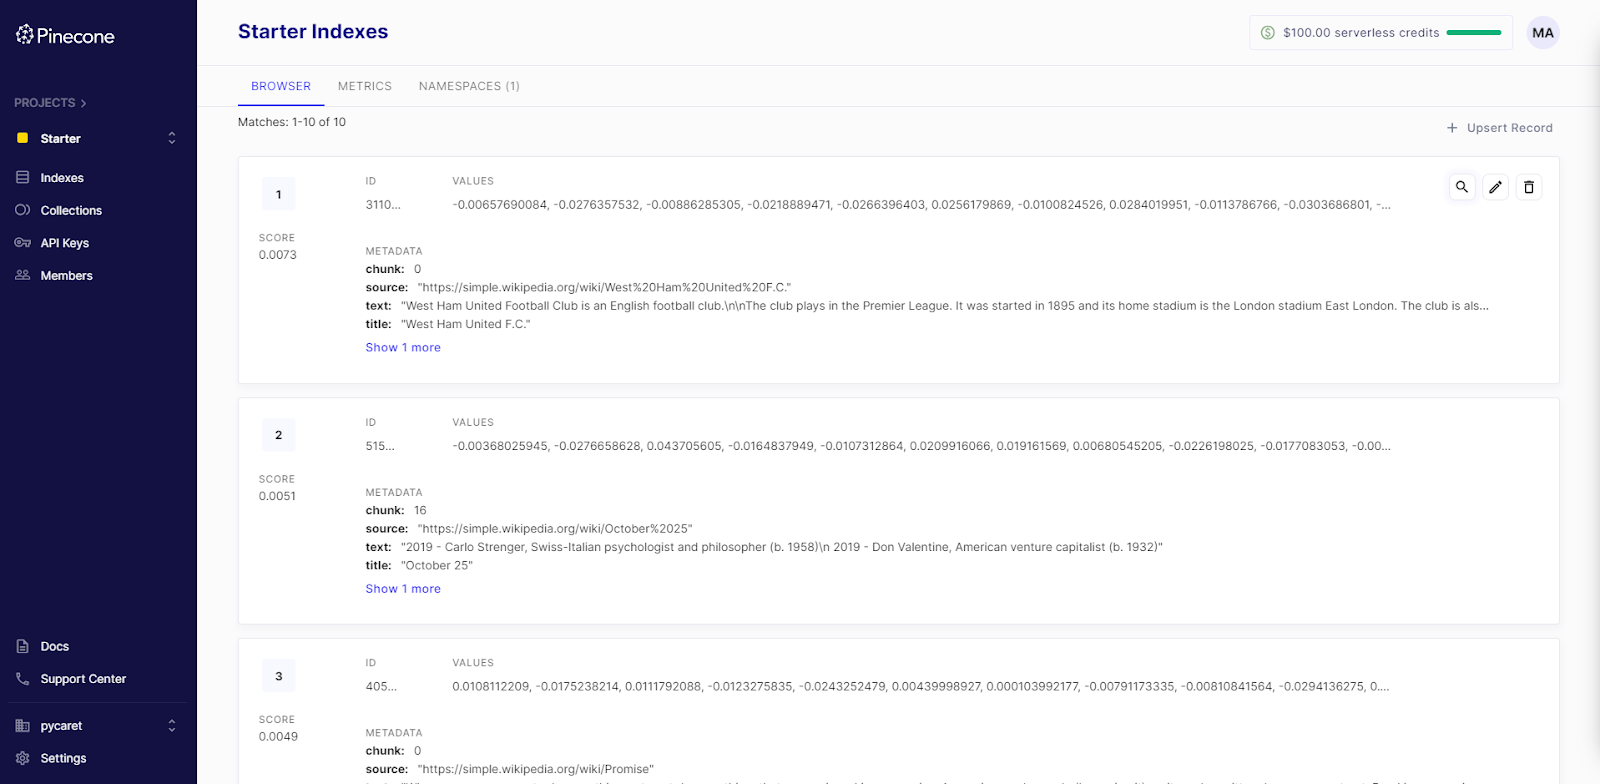
Dữ liệu hoặc truy vấn mới cần được embedding bằng cùng một mô hình để đảm bảo kích thước vector khớp nhau. Vì tập dữ liệu của chúng ta dùng text-embedding-ada-002, chúng ta sẽ tạo một hàm sử dụng OpenAI API để embedding các truy vấn mới bằng chính mô hình này.
import openai
openai.api_key = OPENAI_API_KEY


def get_embedding(text_to_embed):
  # Embed a line of text
  response = openai.Embedding.create(
      model= "text-embedding-ada-002",
      input=[text_to_embed]
  )
  # Extract the AI output embedding as a list of floats
  embedding = response['data'][0]['embedding']

return embeddingquery = "What are some easter related events in Western Christianity?"
result = get_embedding(query)
print(len(result))
print(result)Đầu ra:
1536
[0.014745471067726612, -0.03282099589705467, -0.006603493355214596, -0.0025058642495423555,.........]
Độ dài của result là 1536, phù hợp với dimension đã chỉ định khi tạo index.
Gửi một truy vấn tìm kiếm khá đơn giản:
query_result = index.query(vector=result, top_k=3, include_metadata=True)
print(query_result)
Đầu ra:
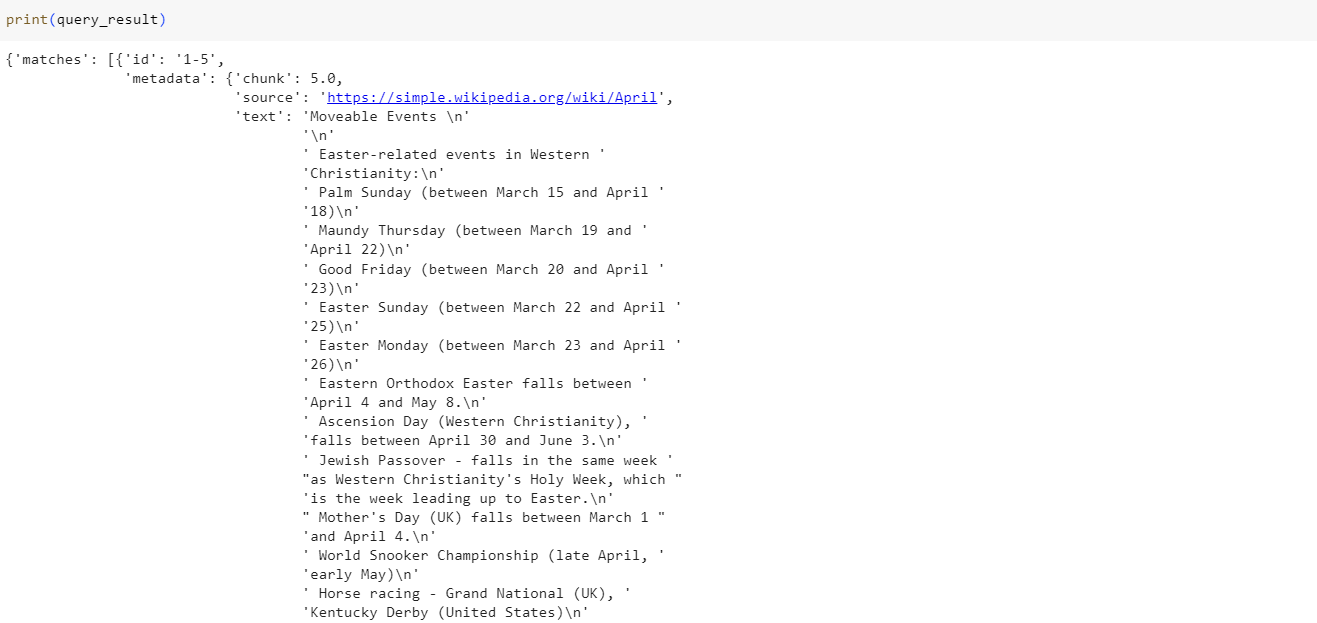
query_result trả về một dictionary chứa danh sách 3 kết quả khớp hàng đầu tương ứng với truy vấn của người dùng. Những kết quả Top N này giờ có thể dùng cho các tác vụ phía sau, như cung cấp ngữ cảnh cho prompt trong kịch bản Retrieval Augmented Generation (RAG) hoặc xây dựng Chatbot.
Trong hướng dẫn này, chúng ta đã giới thiệu một số khái niệm nền tảng quan trọng như embedding và cơ sở dữ liệu vector để hiểu toàn bộ cơ chế của các ứng dụng tìm kiếm ngữ nghĩa.
Với sự xuất hiện của AI sinh và sự phát triển không ngừng của các LLM đa phương thức, sức mạnh của tìm kiếm ngữ nghĩa đã mở rộng, mang lại độ chính xác chưa từng có và khả năng thấu hiểu sự phức tạp, tinh tế của dữ liệu phi cấu trúc.
Bằng cách tận dụng năng lực của Pinecone, một cơ sở dữ liệu vector tiên tiến, và các mô hình embedding tinh vi do OpenAI cung cấp, các nhà phát triển và nhà khoa học dữ liệu hiện có trong tay công cụ để tạo ra các ứng dụng tìm kiếm ngữ nghĩa vượt qua phương pháp tìm kiếm dựa trên từ khóa truyền thống.
Qua hướng dẫn này, chúng ta cũng đã khám phá tầm quan trọng của embeddings trong việc bắc cầu giữa độ phức tạp của ngôn ngữ con người và các biểu diễn số cần thiết cho học máy, làm sáng tỏ cách những biểu diễn này giúp máy móc nắm bắt sắc thái của ngữ cảnh và ý định.
Rõ ràng tương lai của tìm kiếm nằm ở khả năng thấu hiểu ngôn ngữ và các dạng dữ liệu phi cấu trúc khác được vận hành bởi AI. Dù là thương mại điện tử, khám phá nội dung, hỗ trợ khách hàng, hay quản trị tri thức, những nguyên tắc và thực hành được trình bày trong bài viết này mang đến bản thiết kế nền tảng để khai thác sức mạnh của tìm kiếm ngữ nghĩa nhằm tạo ra trải nghiệm tìm kiếm thông minh, linh hoạt và lấy người dùng làm trung tâm hơn.
Nếu bạn muốn tìm hiểu thêm về xây dựng ứng dụng Tìm kiếm ngữ nghĩa bằng Pinecone, hãy xem Semantic Search with Pinecone code-along, hoặc nếu bạn quan tâm tìm hiểu thêm về các chức năng nền tảng của những ứng dụng AI phổ biến như ChatGPT, hãy xem khóa học Working with the OpenAI API. Và đừng quên xem khóa học Vector Databases for Embeddings with Pinecone.
Tìm hiểu thêm về làm việc với OpenAI!
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
