Jika Anda seorang data scientist atau analis data yang akrab dengan basis data relasional dan non-relasional seperti SQL dan MongoDB, bersiaplah menyelami dunia baru manajemen data yang menarik. Dalam tutorial ini, Anda akan mempelajari jenis penyimpanan data baru yang disebut basis data vektor, yaitu tipe basis data khusus yang dirancang untuk menangani dan memproses data vektor secara efisien. Dalam tutorial Pinecone ini, kita akan meninjau secara khusus platform basis data vektor Pinecone.
Untuk mempelajari lebih lanjut tentang Pinecone, pastikan untuk mengikuti kursus kami, Vector Databases for Embeddings with Pinecone.
Apa itu Basis Data Vektor?
Dalam basis data tradisional, data biasanya disimpan dalam baris dan kolom, cocok untuk data terstruktur. Namun, seiring dataset menjadi semakin kompleks dan berdimensi tinggi, kebutuhan akan solusi yang lebih khusus pun muncul. Di sinilah basis data vektor unggul. Alih-alih berurusan dengan struktur data tradisional, basis data vektor dioptimalkan untuk menangani vektor — representasi matematis dari titik data dalam ruang multi-dimensi.
Data vektor banyak digunakan di berbagai bidang, termasuk pembelajaran mesin, ilmu data, biologi komputasional, dan NLP. Vektor dapat merepresentasikan fitur numerik, koordinat, embedding, teks, gambar, dan banyak lagi. Dengan meningkatnya aplikasi berbasis AI, kebutuhan untuk menangani dataset yang telah diverktorisasi secara efisien melonjak, dan Basis Data Vektor menjadi alat krusial dalam konteks ini.
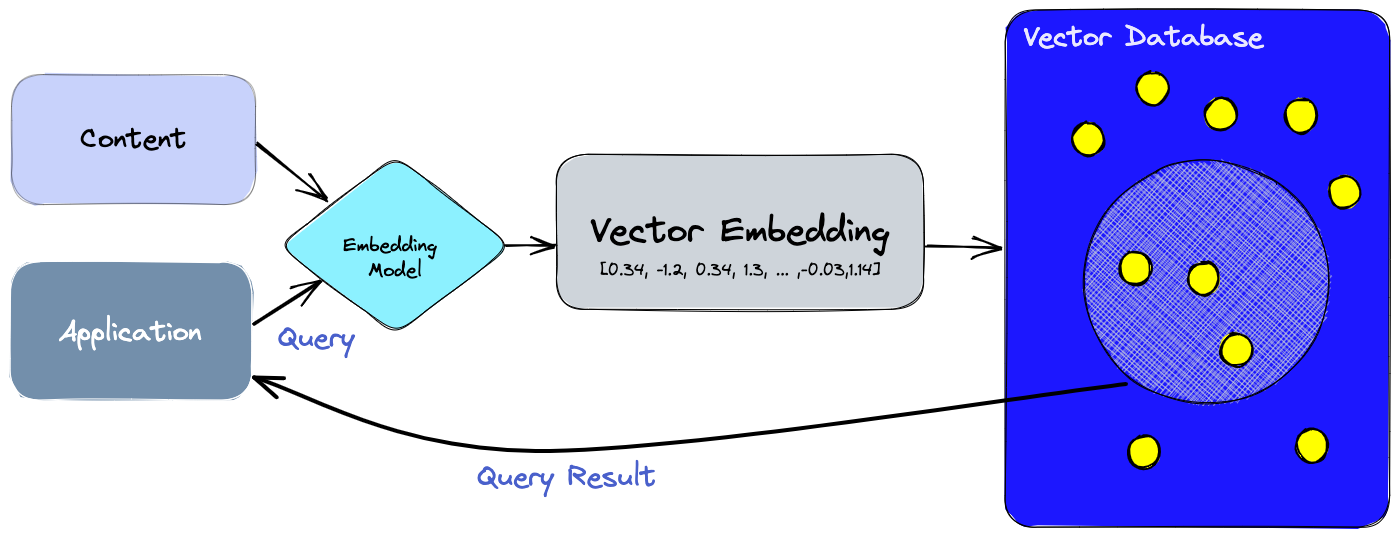
Apa itu Pinecone?
Pinecone adalah platform basis data vektor terkelola yang dibangun khusus untuk menghadapi tantangan unik terkait data berdimensi tinggi. Dilengkapi dengan kemampuan pengindeksan dan pencarian mutakhir, Pinecone memberdayakan data engineer dan data scientist untuk membangun dan mengimplementasikan aplikasi pembelajaran mesin skala besar yang secara efektif memproses dan menganalisis data berdimensi tinggi.
Fitur utama Pinecone
Mari kita lihat apa yang membuat Pinecone begitu berguna:
Layanan sepenuhnya terkelola
Sebagai platform yang sepenuhnya terkelola, Pinecone menangani semua hal terkait infrastruktur dan pemeliharaan. Ini memungkinkan pengembang memusatkan upaya pada pengembangan dan penerapan aplikasi pembelajaran mesin mereka tanpa harus khawatir tentang kompleksitas infrastruktur dan operasional.
Skalabilitas
Pinecone menunjukkan skalabilitas yang luar biasa, mampu mengelola miliaran vektor berdimensi tinggi dengan mudah dan menawarkan kemampuan penskalaan horizontal. Ini membuatnya sangat cocok untuk menangani beban kerja pembelajaran mesin yang paling menuntut sekalipun.
Pemasukan data real-time
Pinecone mendukung pemasukan data secara real-time dengan mulus, memungkinkan pengguna menyimpan dan mengindeks data baru saat tersedia tanpa mengalami downtime atau gangguan.
Pencarian latensi rendah
Dengan memanfaatkan algoritme pengindeksan yang canggih, Pinecone menghadirkan hasil pencarian berlatensi rendah untuk kueri tetangga terdekat dan operasi pencarian kemiripan. Ini memastikan hasil yang cepat dan presisi untuk aplikasi yang sensitif terhadap waktu.
Integrasi tanpa hambatan
API Pinecone dirancang dengan cermat agar sederhana dan intuitif, menyederhanakan proses integrasi dengan alur kerja pembelajaran mesin dan pipeline data yang sudah ada.
Memahami Data Tak Terstruktur dan Embedding Vektor
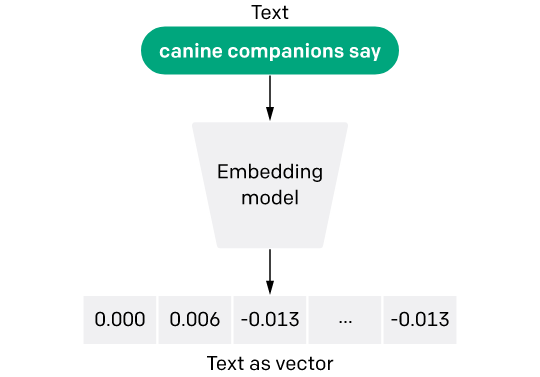
Model Embedding Teks - Sumber Gambar
Data tak terstruktur mengacu pada data yang tidak memiliki format yang telah ditentukan atau terorganisasi, sehingga menyulitkan basis data tradisional untuk menyimpan dan memprosesnya secara efisien. Contoh data tak terstruktur mencakup teks, gambar, audio, dan file video.
Data tak terstruktur tidak memiliki struktur yang kaku, sehingga sulit dianalisis langsung menggunakan metode tradisional. Oleh karena itu, agar dapat menggunakan data tak terstruktur untuk aplikasi pembelajaran mesin dan AI, data tersebut diubah dan disimpan ke dalam representasi numerik multi-dimensi menggunakan embedding vektor.
Embedding memainkan peran penting dalam bidang kecerdasan buatan, menawarkan teknik yang kuat untuk mengubah data berdimensi tinggi, seperti kata, gambar, atau preferensi pengguna, menjadi representasi numerik yang ringkas. Embedding numerik ini memungkinkan model AI memproses dan memahami informasi kompleks secara efisien.
Memahami embedding menjadi lebih mudah jika memikirkannya sebagai kamus khusus untuk suatu tugas tertentu. Misalnya, dalam proyek text mining, embedding membantu kita memahami makna semantik kata dengan menganalisis hubungannya dengan kata lain. Proses ini menghasilkan daftar embedding yang dapat diperlakukan sebagai kamus khusus tugas, menyediakan representasi vektor numerik yang mencerminkan makna semantik kata. Kemiripan dan hubungan antar kata diukur oleh jarak antara embedding yang sesuai, memungkinkan model AI memahami konteks dan signifikansi kata.
Signifikansi embedding terletak pada kemampuannya mengurangi dimensi data, sehingga lebih mudah dikelola oleh model pembelajaran mesin untuk menangani masukan besar seperti vektor jarang yang merepresentasikan kata atau item. Dengan menggunakan embedding, kita dapat menghindari keterbatasan one-hot encoding, di mana setiap kategori diubah menjadi variabel dummy terpisah, yang dapat menyebabkan matriks masukan menjadi sangat besar untuk tugas tertentu.
Jika Anda ingin mempelajari lebih dalam cara kerja Word Embeddings, lihat tutorial kami LDA2vec: Word Embeddings in Topic Models.
Rekap:
- Basis data vektor adalah tipe basis data khusus yang dirancang untuk menangani dan memproses data vektor secara efisien
- Pinecone adalah layanan basis data vektor yang sepenuhnya terkelola
- Data tak terstruktur adalah data yang tidak memiliki format yang telah ditentukan atau terorganisasi, seperti gambar, teks, audio, atau video
- Embedding adalah teknik yang kuat untuk mengubah data berdimensi tinggi menjadi representasi numerik yang ringkas
Bagaimana Cara Kerja Basis Data Vektor?
Anda pasti sudah akrab dengan cara kerja basis data tradisional, yang menyimpan data skalar seperti string dan angka dalam baris dan kolom. Namun, basis data vektor beroperasi secara berbeda, bekerja dengan vektor dan menggunakan metode optimasi serta pengkuerian yang berbeda.
Dalam basis data tradisional, kueri biasanya mencari kecocokan persis di dalam basis data. Di sisi lain, basis data vektor menggunakan metrik kemiripan untuk menemukan vektor yang paling cocok dengan kueri kita.
Basis data vektor memanfaatkan kombinasi algoritme yang secara kolektif dikenal sebagai pencarian Approximate Nearest Neighbor (ANN). Algoritme ini mengoptimalkan proses pencarian melalui teknik seperti hashing, kuantisasi, atau pencarian berbasis graf.
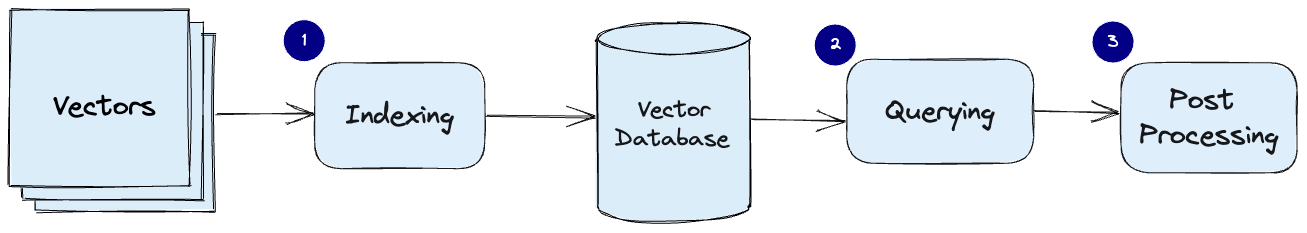
Pipeline umum untuk basis data vektor (Sumber Gambar)
Ingin belajar cara menggunakan OpenAI API untuk membuat embedding teks lalu menyimpannya di basis data vektor seperti Pinecone? Temukan penerapannya dalam klasifikasi teks, penelusuran informasi, dan deteksi kemiripan semantik di pengantar Text Embeddings dengan OpenAI API di DataCamp.
Mulai Menggunakan Pinecone
Untuk memulai, kunjungi saja pinecone.io dan daftar akun gratis.
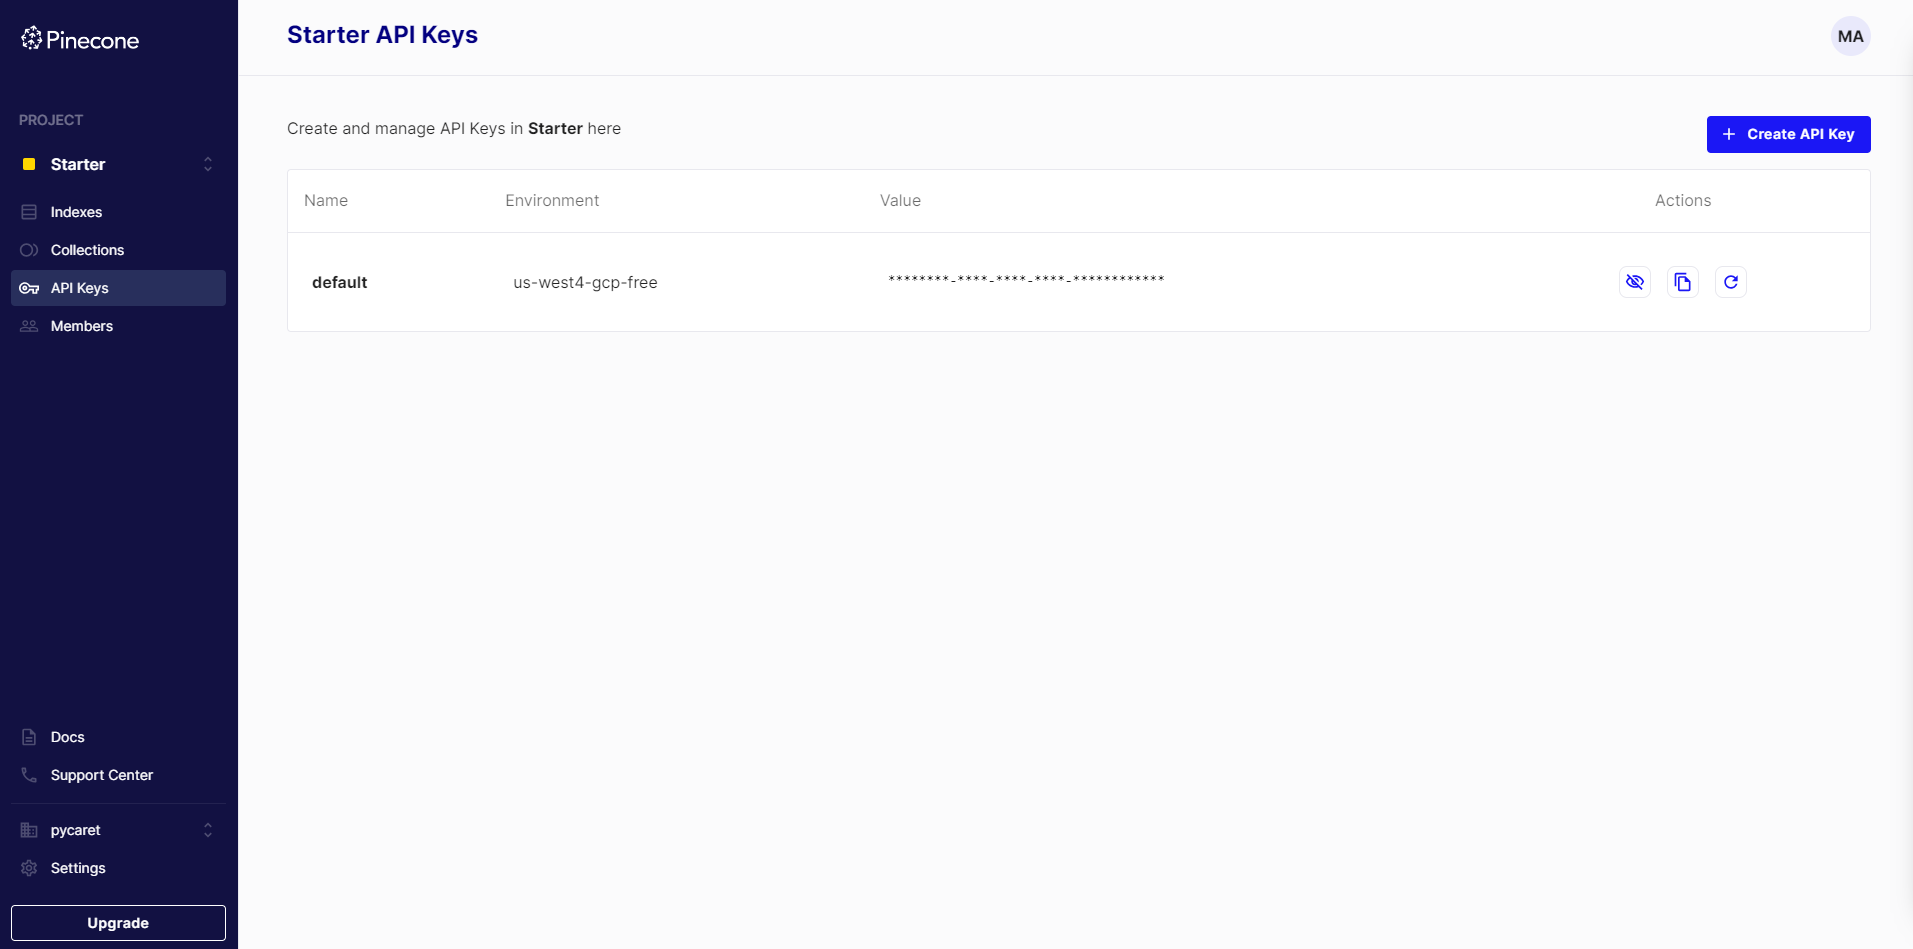
Setelah berhasil mendaftar, klik API Keys di menu dan salin environment serta kunci API Anda. Ini akan digunakan saat bekerja dengan klien Python dari Pinecone.
Anda juga dapat memasang klien Python untuk Pinecone menggunakan pip.
pip install pinecone-clientKonsep Kunci di Pinecone
Sebelum kita masuk lebih jauh, mari telusuri beberapa istilah dan konsep kunci yang perlu Anda ketahui:
Indeks Pinecone
Di Pinecone, sebuah indeks merepresentasikan struktur organisasi tingkat atas untuk data vektor. Indeks bertugas menerima dan menyimpan vektor, menangani kueri pada vektor yang tersimpan, dan melakukan berbagai operasi vektor dalam datanya. Setiap indeks berjalan pada satu atau lebih pod untuk memastikan fungsionalitas yang efisien.
Pod
Pod adalah unit perangkat keras yang telah dikonfigurasi sebelumnya yang menampung layanan Pinecone. Setiap indeks di Pinecone berjalan pada satu atau beberapa pod, dan penambahan pod umumnya menghasilkan kapasitas penyimpanan yang lebih besar, latensi yang lebih rendah, dan throughput yang lebih baik. Selain itu, pengguna memiliki fleksibilitas untuk membuat pod dengan ukuran bervariasi sesuai kebutuhan spesifik.
Metrik Jarak
Metrik Jarak adalah teknik matematis yang digunakan untuk menilai kemiripan antara dua vektor dalam suatu ruang vektor. Dalam basis data vektor, ukuran ini berperan penting untuk membandingkan vektor yang tersimpan dengan vektor kueri tertentu guna mengidentifikasi yang paling mirip.
Anda dapat memilih berbagai metrik saat membuat indeks vektor:
- Kemiripan kosinus. Ukuran ini mengevaluasi kosinus dari sudut antara dua vektor dalam ruang vektor. Skalanya berkisar dari -1 hingga 1, di mana 1 menandakan vektor identik, 0 merepresentasikan vektor ortogonal, dan -1 menunjukkan vektor yang bertolak belakang.
- Jarak Euclidean. Ukuran ini menghitung jarak garis lurus antara dua vektor dalam ruang vektor. Nilainya berkisar dari 0 hingga tak berhingga, di mana 0 menunjukkan vektor identik, dan nilai yang lebih besar menandakan vektor semakin tidak mirip.
- Dot product. Ukuran ini menghitung hasil kali magnitudo dua vektor dan kosinus sudut di antara keduanya. Skalanya membentang dari -∞ hingga ∞, di mana nilai positif menunjukkan vektor mengarah ke arah yang sama, 0 merepresentasikan vektor ortogonal, dan nilai negatif menandakan vektor mengarah berlawanan.
Cara Memverifikasi Kunci API Pinecone
Untuk menggunakan Pinecone dari Python, diperlukan kunci API. Anda dapat menemukan kunci API dengan mengakses konsol Pinecone dan memilih "API Keys." Pada tampilan yang sama, Anda juga dapat menemukan informasi tentang environment yang terkait dengan proyek Anda.
import pinecone
pinecone.init(api_key="API_KEY", environment = 'ENVIRONMENT')
Cara Membuat Indeks Pinecone
Untuk membuat indeks di Pinecone, jalankan saja:
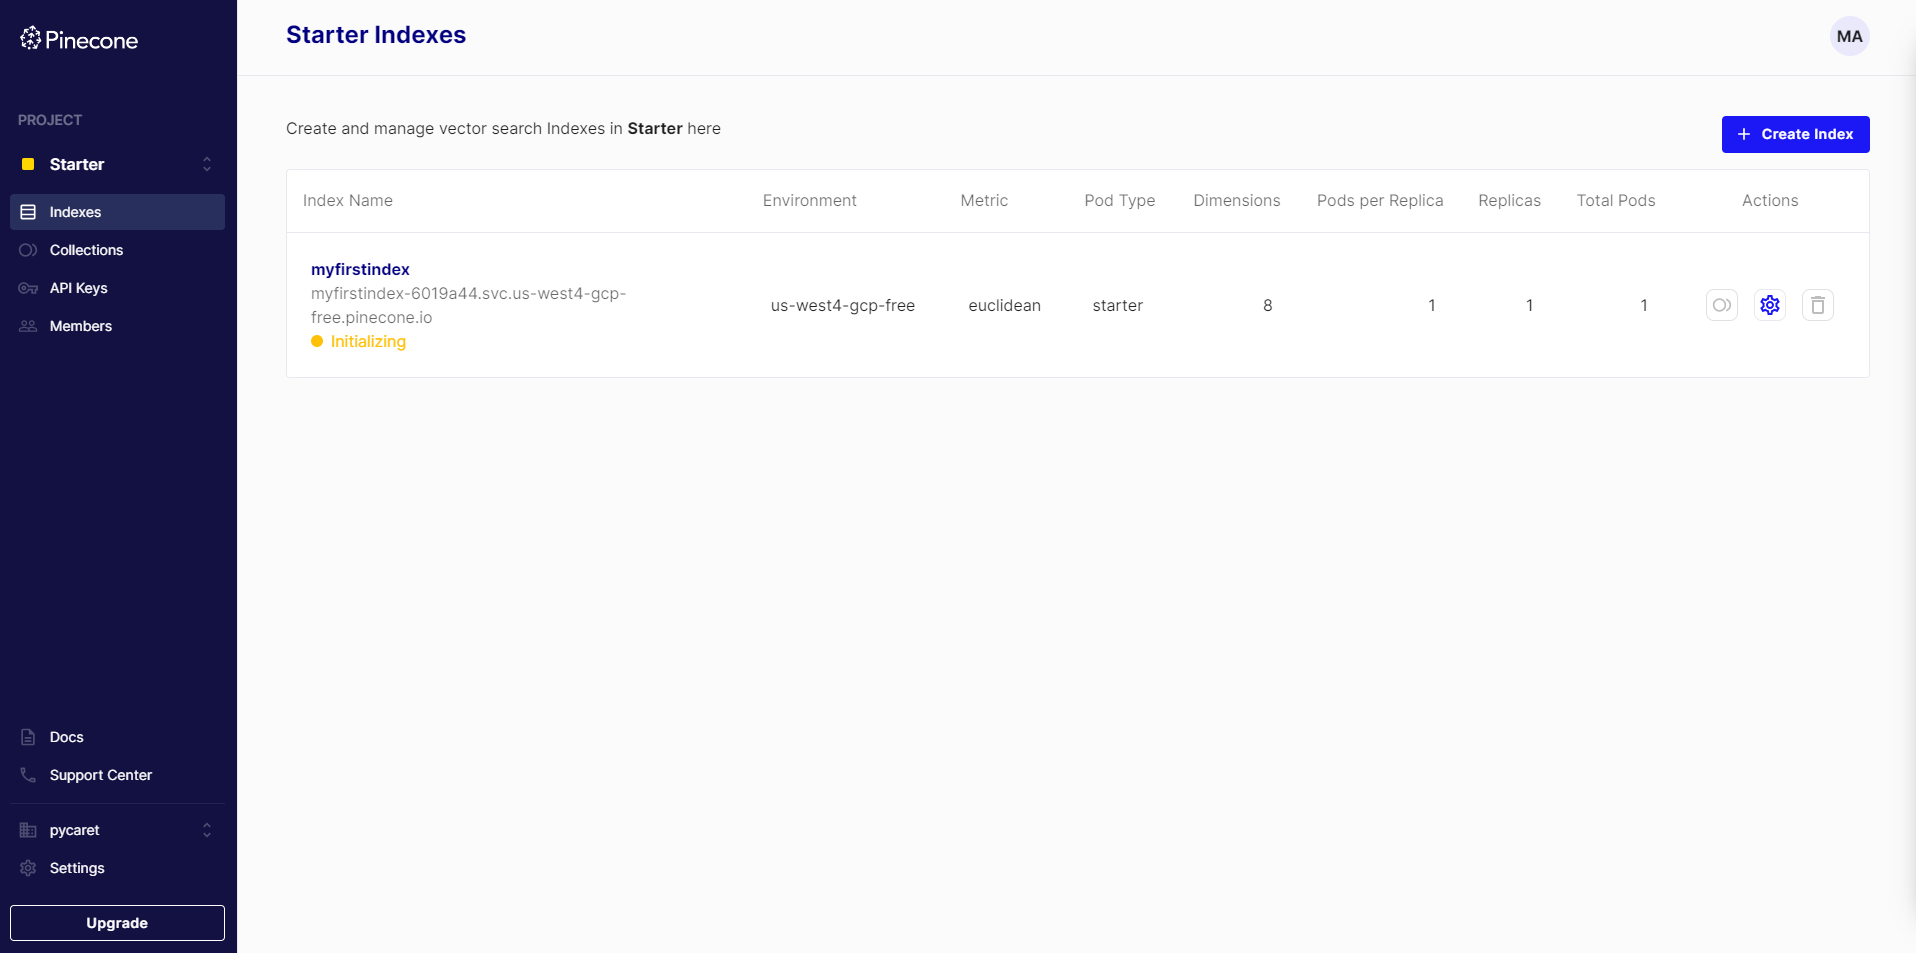
pinecone.create_index("myfirstindex", dimension=8, metric="euclidean")Segera setelah Anda menjalankan perintah ini, Anda akan melihat sebuah indeks Pinecone diinisialisasi di konsol Anda:
Penyisipan Data dan Kueri di Pinecone
Untuk menambahkan vektor ke indeks, operasi upsert dapat digunakan. Operasi upsert menambahkan vektor baru ke indeks atau memperbarui vektor yang sudah ada jika vektor dengan ID yang sama sudah ada. Dengan perintah berikut, Anda dapat melakukan upsert lima vektor berdimensi 8 ke dalam indeks Anda.
index = pinecone.Index("myfirstindex")

index.upsert([
    ("A", [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1]),
    ("B", [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]),
    ("C", [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]),
    ("D", [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]),
    ("E", [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5])
])
Jika Anda menuju ke konsol, Anda akan melihat lima vektor yang baru saja kita tambahkan.
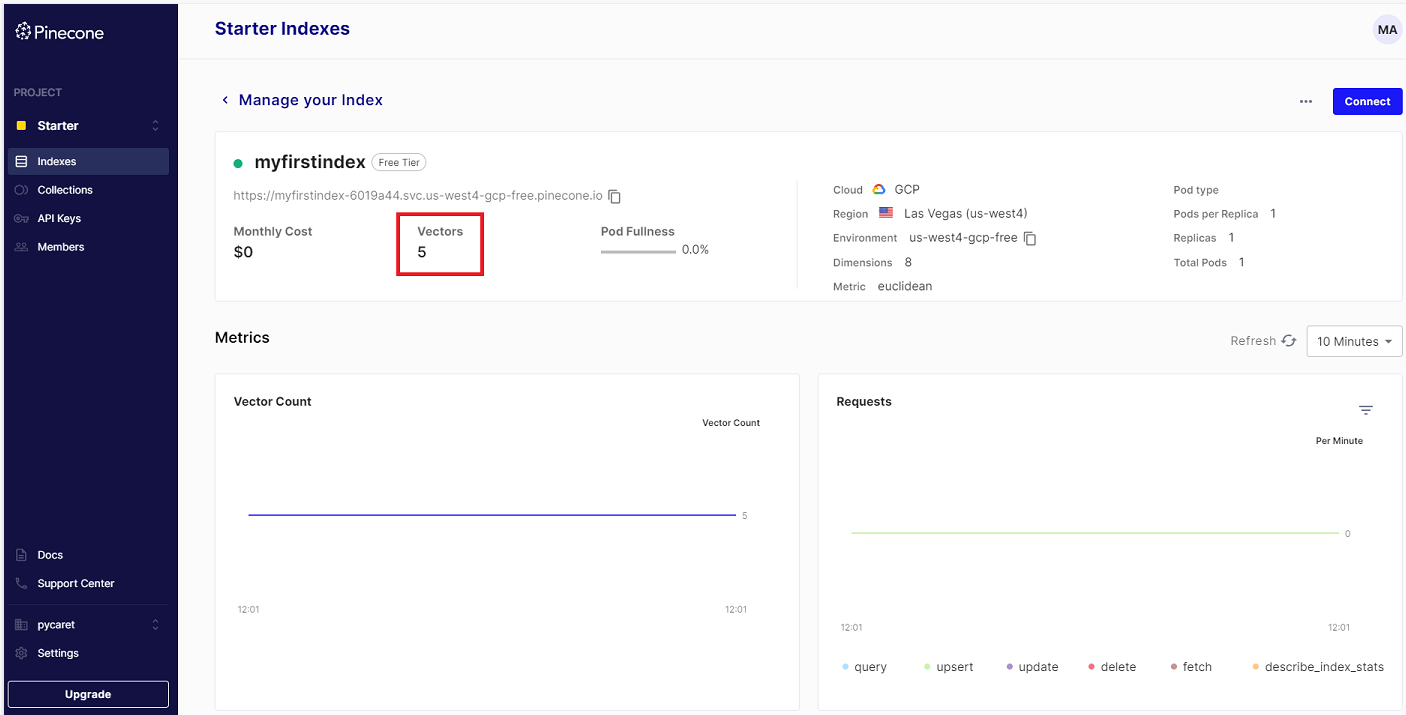
Untuk memeriksa dimensi vektor, Anda dapat menjalankan:
index.describe_index_stats()
>>> {'dimension': 8,
>>>  'index_fullness': 0.0,
>>>  'namespaces': {'': {'vector_count': 5}},
>>>  'total_vector_count': 5}
Cara Mengkueri Indeks dan Mendapatkan Vektor Serupa di Pinecone
Pada contoh di bawah ini, indeks diqueri untuk mengambil tiga (3) vektor teratas yang menunjukkan kemiripan tertinggi dengan sebuah vektor contoh berdimensi 8. Kueri menggunakan metrik jarak Euclidean seperti yang ditetapkan saat pembuatan indeks.
index.query(
  vector=[0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3],
  top_k=3,
  include_values=True
)
>>> {'matches': [{'id': 'C',
>>> 'score': 0.0,
>>> 'values': [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]},
>>> {'id': 'D',
>>> 'score': 0.0799999237,
>>> 'values': [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]},
>>> {'id': 'B',
>>> 'score': 0.0800000429,
>>> 'values': [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]}],
>>> 'namespace': ''}
Menghapus Indeks di Pinecone
Saat indeks tidak lagi diperlukan, Anda dapat menggunakan operasi delete_index untuk menghapus indeks tersebut.
pinecone.delete_index("myfirstindex")Kesimpulan
Tutorial ini memberikan wawasan tentang dunia basis data vektor dan Pinecone. Basis data vektor menawarkan solusi khusus untuk menangani data berdimensi tinggi secara efisien, yang menjadi semakin esensial dalam ranah pembelajaran mesin, ilmu data, dan aplikasi berbasis AI.
Sebagai platform basis data vektor terkelola, Pinecone menonjol sebagai alat yang kuat bagi data engineer dan scientist, menawarkan skalabilitas, kemampuan pencarian berlatensi rendah, dan pemasukan data real-time. Dengan integrasi yang mulus dan API yang ramah pengguna, Pinecone menyederhanakan proses membangun dan menerapkan aplikasi pembelajaran mesin berskala besar.
Tutorial ini juga membahas konsep data tak terstruktur dan bagaimana Embedding Vektor berperan penting dalam mengubah data tersebut menjadi representasi numerik yang ringkas untuk analisis.
Jika Anda tertarik dengan gagasan basis data vektor dan merasa memiliki use case untuk ini, lihat kursus praktik langsung kami, Vector Databases for Embeddings with Pinecone. Anda juga dapat mencoba Weaviate — basis data vektor open-source di Python. Jika Anda ingin mempelajari lebih lanjut tentang ini, ikuti Webinar Vector Databases for Data Science with Weaviate in Python di Datacamp.



