
Cours
Travailler avec l'API OpenAI
3 h
173.1K
L’écosystème des données évolue en permanence et, avec les avancées fulgurantes de l’IA générative au cours des deux dernières années, la recherche sémantique a pris un nouvel élan, faisant grimper la popularité des applications de recherche sémantique.
La recherche et la récupération consistent à localiser et obtenir des informations précises au sein d’une base de données ou d’un corpus volumineux à partir d’une requête donnée. Les progrès de l’IA ont accru l’exigence de méthodes de recherche plus précises, contextuelles et efficaces, entraînant l’essor d’applications de recherche sémantique dans tous les secteurs.
La recherche sémantique dépasse les limites des approches traditionnelles fondées sur des mots-clés en comprenant l’intention et le contexte des requêtes, pour fournir des résultats plus pertinents et plus précis.
Pour concevoir une application de recherche sémantique de bout en bout, il faut maîtriser plusieurs notions clés comme les embeddings, les bases de données vectorielles, les métriques de distance, etc., et savoir utiliser des services comme Pinecone et les modèles GPT d’OpenAI pour construire et déployer ces applications.
À l’issue de cet article, vous aurez une compréhension complète des principes de la recherche sémantique, des embeddings et du rôle des bases vectorielles, et vous apprendrez à implémenter une recherche sémantique en Python avec :
Si vous souhaitez aller plus loin avec des exercices pratiques, découvrez notre cours Vector Databases for Embeddings with Pinecone.
L’embedding est un concept central en apprentissage automatique. Il fait le lien entre la richesse nuancée du langage humain et sa représentation mathématique précise sous forme de nombres.
Les données non structurées — textes, images, audio, vidéos — ne suivent pas un format organisé, ce qui complique leur stockage et leur traitement dans des bases de données classiques. Leur analyse pour des usages de machine learning et d’IA nécessite souvent une transformation en représentations numériques multidimensionnelles via des vecteurs d’embedding. Le processus de conversion de données non structurées en vecteurs numériques multidimensionnels est appelé embedding.
Les embeddings sont des représentations numériques multidimensionnelles de textes, d’images ou de tout type de données non structurées. Ils permettent aux machines d’apprendre la complexité de la communication humaine, les relations entre concepts et les schémas sous-jacents aux données, de manière à la fois efficace sur le plan calculatoire et riche en contexte.
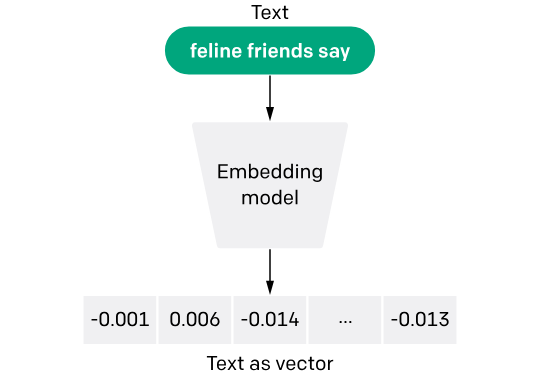
Modèle d’embeddings de texte et de code d’OpenAI (source de l’image)
L’idée clé derrière les modèles d’embeddings est que des éléments similaires peuvent être représentés par des points proches les uns des autres dans un espace de grande dimension. Ce principe permet de capturer des relations fines au sein des données — synonymies, analogies, connexions plus abstraites — en réduisant la complexité du langage ou d’autres types de données dans une forme exploitable par les machines.
Par exemple, pour des données textuelles, les mots sont transformés en vecteurs (des tableaux de nombres). Ces vecteurs encapsulent l’essence de la signification, de l’usage et du contexte des mots au sein de la compréhension d’un modèle de langage.
La longueur du vecteur renvoyée par le modèle d’embedding dépend du modèle utilisé. Par exemple, avec le modèle d’embedding d’OpenAI, la longueur du vecteur est toujours de `1536`.
Sous le capot, un modèle d’embedding est un vaste réseau de neurones entraîné sur un corpus gigantesque. Il apprend à associer des vecteurs aux données d’entrée de sorte que la géométrie entre vecteurs reflète les relations sémantiques ou conceptuelles entre les instances de données.
Par exemple, dans un bon modèle d’embedding, le vecteur du mot "king" moins celui de "man" plus celui de "woman" donne un vecteur très proche de celui de "queen". Cette arithmétique sémantique illustre la capacité des embeddings à capturer la sémantique du langage.
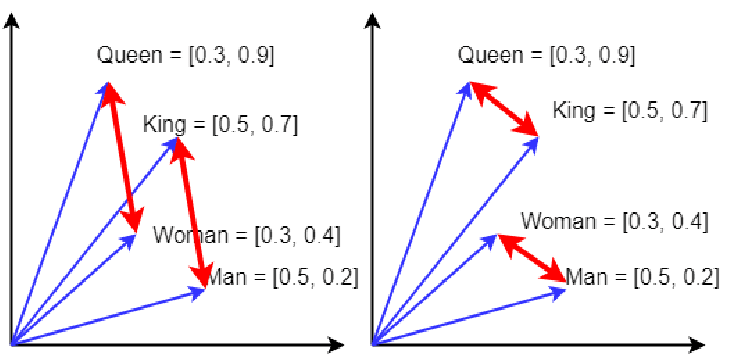
L’exemple classique king + woman − man ≈ queen pour les embeddings de mots neuronaux (source)
Vous pouvez entraîner votre propre modèle d’embedding, mais cela exige d’immenses volumes de données et des ressources considérables pour entraîner un réseau de neurones massif, ce qui peut coûter des millions de dollars et prendre plusieurs mois.
L’alternative la plus pragmatique consiste à utiliser un modèle pré-entraîné. De nombreux modèles open source sont disponibles sur Hugging Face et peuvent être téléchargés pour un usage local ; vous pouvez également recourir à des modèles propriétaires proposés par des entreprises comme OpenAI, Anthropic, Cohere, etc.
Dans cet article, nous utiliserons le modèle d’OpenAI `text-embedding-ada-002`, proposé à un tarif modeste (0,00010 $ pour 1 000 tokens). Concrètement, un livre de 1 000 pages coûtera moins d’1 $ environ.
Les embeddings sont essentiels dans une multitude d’applications. En recherche sémantique, ils permettent d’aller au-delà de la simple correspondance de mots-clés en retrouvant des résultats liés au contexte de la requête, même si les termes exacts n’apparaissent pas dans le contenu. Cette capacité améliore nettement la pertinence et la précision des résultats, rendant la découverte d’information plus intuitive et efficace.
Les embeddings ne se limitent pas au texte. Les embeddings d’images, par exemple, permettent des avancées similaires en vision par ordinateur, en aidant les systèmes à reconnaître objets, scènes et activités dans des images et vidéos via une compréhension en espace vectoriel de grande dimension. Il ne s’agit pas seulement d’analyser des pixels, mais bien de saisir l’essence de ce qu’ils représentent.
Ces modèles transforment la complexité des données du monde réel en un langage (vecteurs numériques) compréhensible par les machines, ouvrant la voie à de nombreuses applications fondées sur une compréhension sémantique fine et un traitement intelligent des données.
Pour en savoir plus sur les embeddings, consultez le billet Introduction to Text Embeddings with the OpenAI API.
Les bases de données vectorielles constituent une catégorie relativement récente de stockage non relationnel, devenue populaire avec l’essor de l’IA générative et des grands modèles de langage.
À la différence des bases relationnelles (lignes/colonnes) ou d’autres magasins non relationnels comme les bases de documents (données en objets JSON ou XML), les bases vectorielles sont conçues pour stocker et manipuler efficacement des données vectorielles multidimensionnelles.
Une base de données vectorielle est spécialisée dans le stockage et l’interrogation de vecteurs, c’est-à-dire de tableaux de nombres représentant des points dans un espace multidimensionnel.
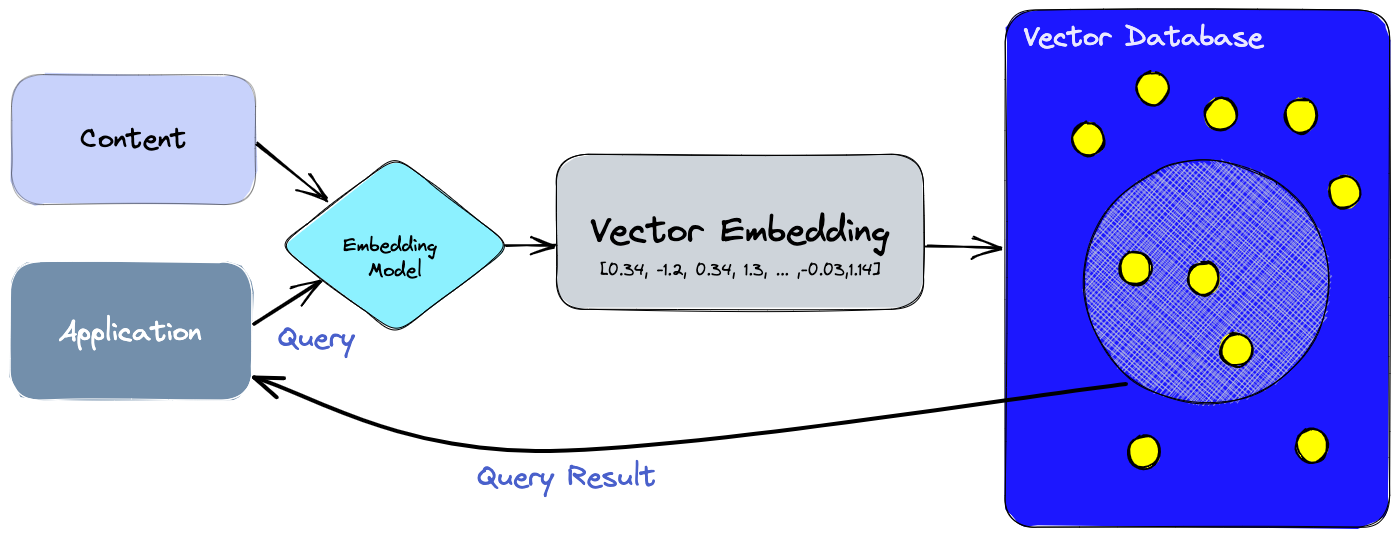
Le grand atout des bases vectorielles est leur capacité à exécuter rapidement des recherches par similarité. Elles identifient en un instant les éléments les plus "proches" d’un élément requêté, selon une mesure de distance ou de similarité.
C’est crucial pour les systèmes de recommandation (trouver des produits similaires à ceux appréciés par l’utilisateur) ou les applications de recherche sémantique (retrouver des documents pertinents vis-à-vis d’une requête donnée).
Les bases vectorielles s’appuient sur divers algorithmes d’indexation et de recherche, souvent basés sur des techniques de recherche des plus proches voisins approximatifs (ANN).
La recherche sémantique marque une avancée majeure dans la compréhension et le traitement des requêtes par les moteurs de recherche. Contrairement aux méthodes classiques axées sur les concordances littérales entre requêtes et documents, elle s’attache à l’intention et au sens contextuel.
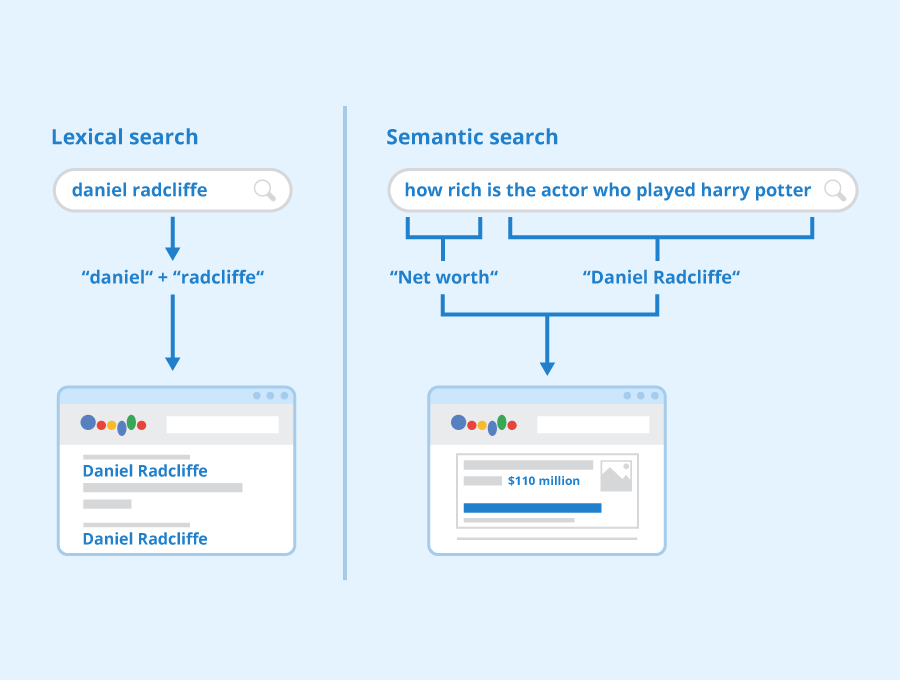
Recherche lexicale vs recherche sémantique (source de l’image)
L’évolution vers la recherche sémantique au cours de la dernière décennie s’explique par plusieurs facteurs. La recherche vocale, portée par Siri, Alexa ou Google Assistant, repose fortement sur le traitement du langage naturel pour comprendre et exécuter les demandes.
La dimension conversationnelle des requêtes vocales impose une compréhension du contexte, obligeant les moteurs à saisir le sens de phrases complètes ou de formulations longues.
La complexité du langage humain constitue un obstacle majeur pour les recherches lexicales traditionnelles, que la recherche sémantique surmonte rapidement. En anglais, des milliers de mots sont polysémiques, leur signification dépendant du contexte d’usage.
Par exemple, le mot "table" peut désigner un meuble ou un tableau de données selon le contexte.
La montée en puissance des grands modèles de langage multimodaux (LLM) est l’un des principaux moteurs de la popularité des applications de recherche sémantique. L’objectif — comprendre l’intention de l’utilisateur et le sens contextuel des termes dans l’espace de recherche — est largement renforcé par les capacités de ces LLM multimodaux.
Ces modèles savent non seulement comprendre et générer du texte, mais aussi interpréter et produire du contenu sous divers formats : images, audio, vidéos. Les recherches dépassent ainsi l’appariement de mots-clés pour saisir les nuances du langage, les subtilités des médias et les relations complexes entre concepts.
Par exemple, une requête en langage naturel peut retourner non seulement des résultats textuels, mais aussi des images, des vidéos ou des extraits audio pertinents, tous sélectionnés par l’IA pour correspondre à l’intention de la requête.
La recherche sémantique s’applique à de nombreux domaines et améliore sensiblement la pertinence et la précision des résultats :
Vous souhaitez en savoir plus sur les bases de données vectorielles ? Consultez ce guide complet des meilleures bases vectorielles.
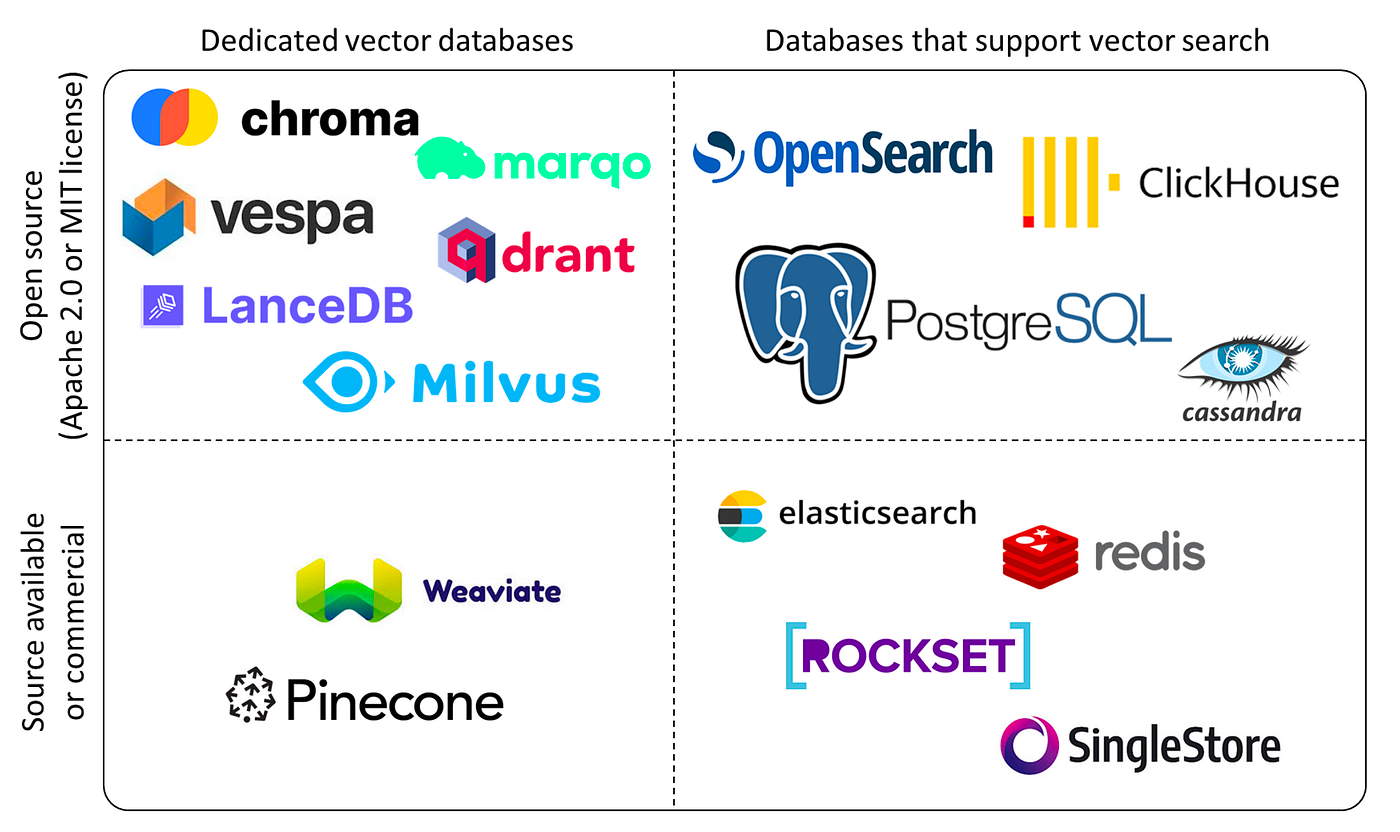
Le paysage des bases de données vectorielles (source)
Pinecone est une base vectorielle spécialisée pour gérer des données complexes et de haute dimension. Elle offre des capacités avancées d’indexation et de recherche, permettant aux data engineers et data scientists de concevoir et d’exécuter des projets de machine learning à grande échelle efficacement.
Pour approfondir Pinecone, consultez Mastering Vector Databases with Pinecone Tutorial: A Comprehensive Guide sur DataCamp.
OpenAI donne accès à tous ses modèles via son API plateforme : GPT, DALL-E, Whisper, ainsi que trois modèles d’embeddings.
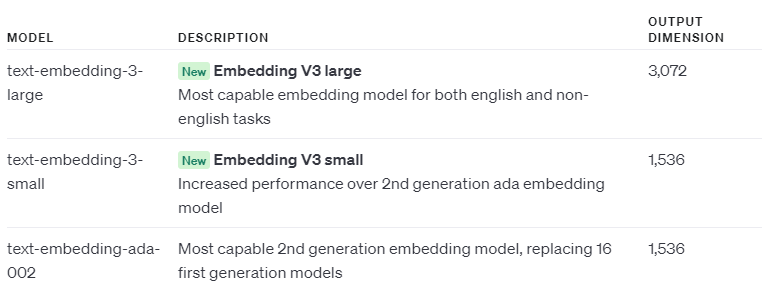
Ces API s’utilisent via des requêtes HTTP, ce qui les rend compatibles avec tout langage capable de communiquer en HTTP.
En Python, vous pouvez utiliser la bibliothèque openai pour interagir avec ces API, ce qui simplifie encore l’usage. Installez-la avec pip install openai.
Exploiter l’API OpenAI en Python avec la bibliothèque openai nécessite très peu de code.
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Fitness & Health."},
    {"role": "user", "content": "Explain what is Keto diet?"}
  ]
)


print(completion.choices[0].message)
Sortie : (tronquée)
ChatCompletionMessage(content="The ketogenic diet, commonly known as the keto diet, is a low-carbohydrate, high-fat diet. The diet is named after ketosis, a metabolic state where your body starts burning fat for energy instead of carbohydrates. This is accomplished by drastically reducing your intake of carbohydrates and increasing your intake of fats….", role='assistant', function_call=None, tool_calls=None)
Découvrez comment ChatGPT et les grands modèles de langage transforment le numérique ! Parcourez la cheat sheet DataCamp pour maîtriser l’essentiel et tirer parti de l’une des API d’IA les plus puissantes : l’OpenAI API.
Après avoir créé votre compte OpenAI, rendez-vous simplement sur https://platform.openai.com/api-keys
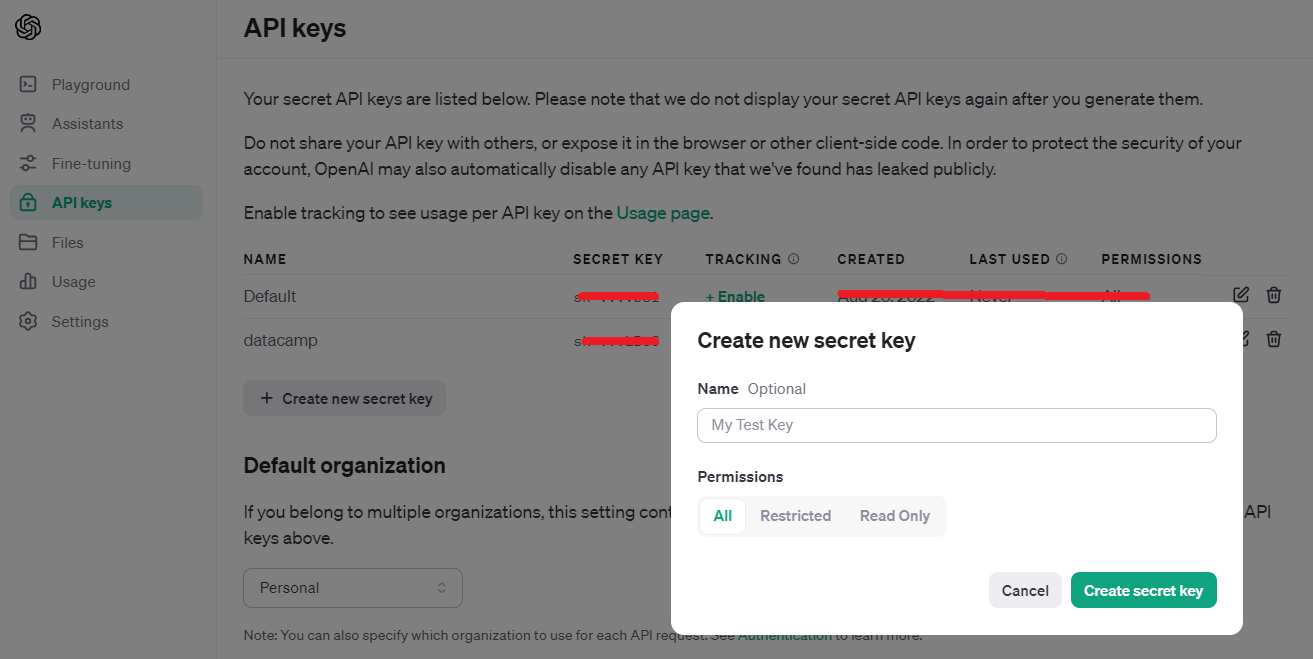
API Keys platform.openai.com
Pour Pinecone, connectez-vous à votre compte et cliquez sur API Keys. Vous pouvez cliquer sur le bouton `Click API Key` dans le coin droit.
Contrairement à OpenAI, avec Pinecone, vous n’avez pas nécessairement besoin de copier la clé API au moment de sa création : une icône de copie est disponible dans la colonne Actions à tout moment.
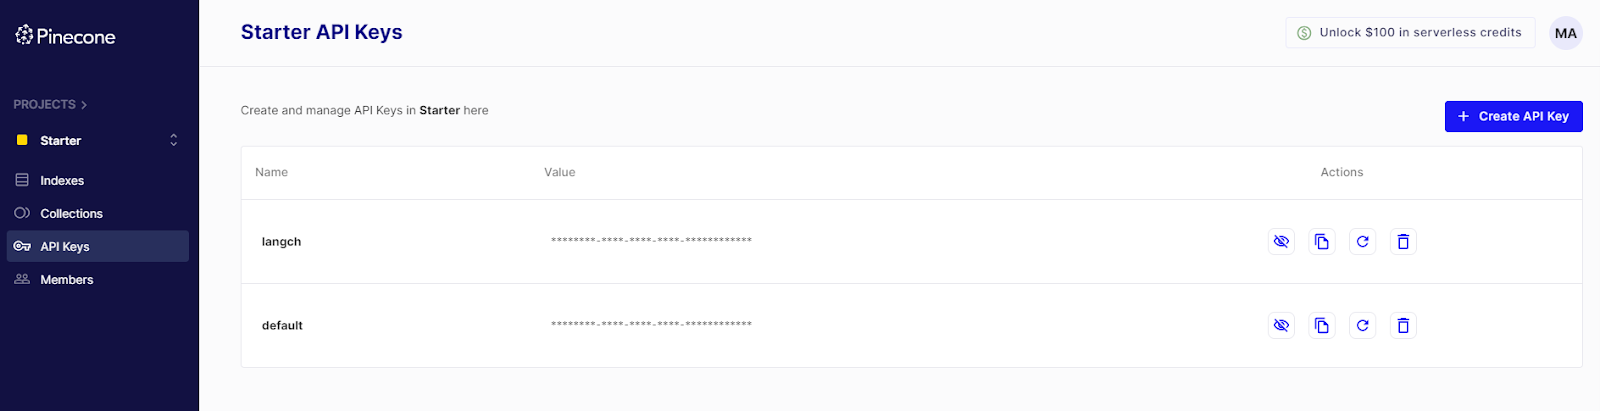
API Keys - Pinecone
Une fois les clés d’API OpenAI et Pinecone obtenues, affectez-les à des variables dans votre Notebook ou définissez-les comme variables d’environnement via le module os de Python.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Pour suivre ce tutoriel, installez les bibliothèques suivantes avec pip. Utilisez exactement ces versions, sinon le code ci-dessous ne fonctionnera pas.
!pip install pinecone-client==3.0.0
!pip install pinecone-datasets==0.7.0
!pip install openai==0.28La bibliothèque pinecone-datasets inclut plusieurs jeux de données déjà vectorisés avec le modèle embedding-ada-002 d’OpenAI.
Pour cet exemple, nous utiliserons le jeu de données `wikipedia-simple-text-embedding-ada-002-100K`, en échantillonnant seulement 5 000 de ses 100 000 documents et leurs embeddings.
import pinecone_datasets

# load dataset from pinecone
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')

# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)

# sample 5k documents
dataset.documents.drop(dataset.documents.index[5_000:], inplace=True)
dataset.head()
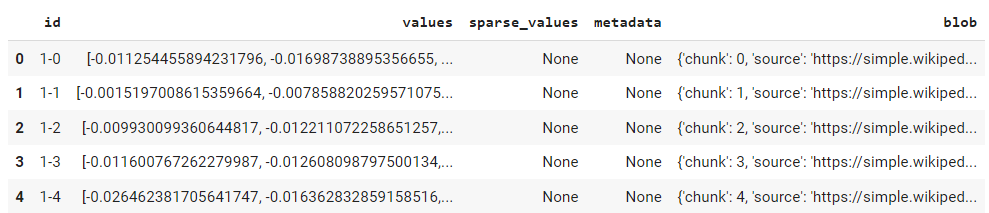
Jeu de données d’exemple
Dans Pinecone, un index représente l’unité d’organisation principale pour les données vectorielles. Il gère le stockage des vecteurs, le traitement des requêtes et diverses opérations sur ces données.
from pinecone import Pinecone, ServerlessSpec

# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)

# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')

# set index name
index_name = 'semantic-search-demo'

# we create a new index
pc.create_index(
        index_name,
        dimension=1536,  # dimensionality of text-embedding-ada-002
        metric='cosine',
        spec=spec
    )
Ce code initialise l’instance Pinecone et crée un index nommé semantic-search-demo. Vous pourrez aussitôt le visualiser dans l’interface.
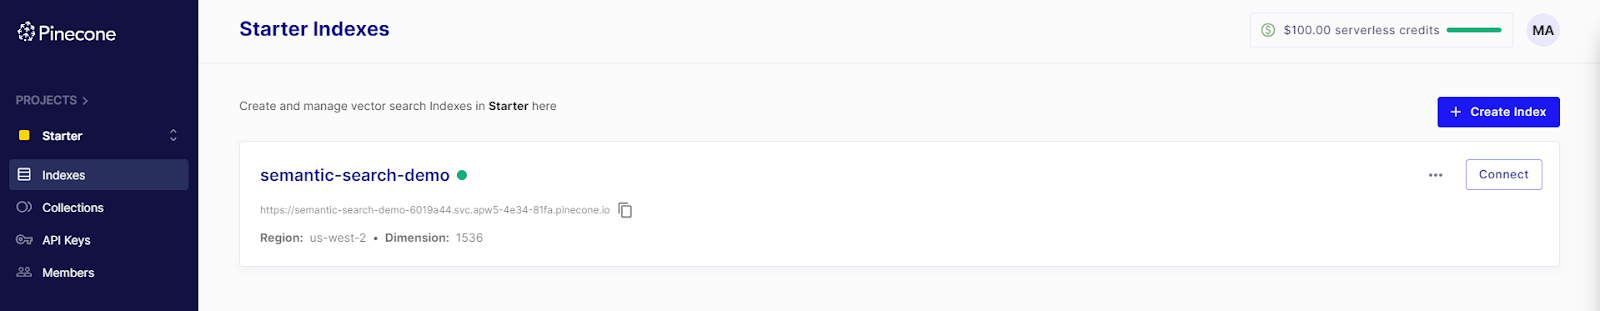
Étant donné que nos données comprennent déjà les représentations vectorielles, nous pouvons ignorer l’étape d’embedding et insérer directement les données dans le nouvel index.
Pour des ensembles sans embeddings, vectorisez d’abord les données brutes via l’API OpenAI (voir l’étape 5 ci-dessous).
index = pc.Index(index_name)
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Une fois l’exécution terminée, vous pouvez également visualiser les données dans l’interface.
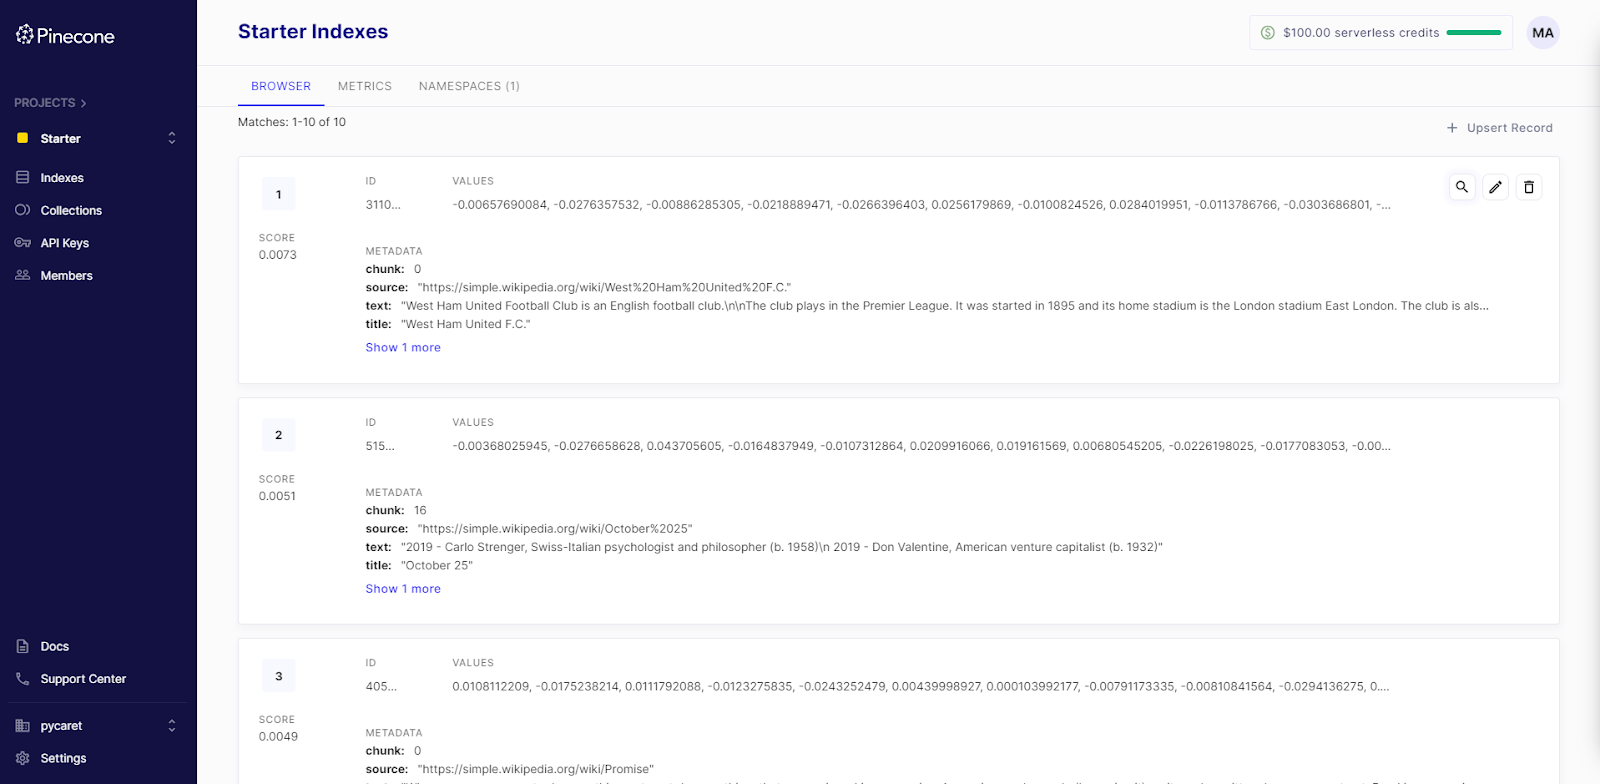
Les nouvelles données ou requêtes doivent être vectorisées avec le même modèle pour garantir des dimensions identiques. Puisque notre dataset utilise text-embedding-ada-002, nous allons créer une fonction qui s’appuie sur l’API OpenAI pour vectoriser les nouvelles requêtes avec ce même modèle.
import openai
openai.api_key = OPENAI_API_KEY


def get_embedding(text_to_embed):
  # Embed a line of text
  response = openai.Embedding.create(
      model= "text-embedding-ada-002",
      input=[text_to_embed]
  )
  # Extract the AI output embedding as a list of floats
  embedding = response['data'][0]['embedding']

return embeddingquery = "What are some easter related events in Western Christianity?"
result = get_embedding(query)
print(len(result))
print(result)Sortie :
1536
[0.014745471067726612, -0.03282099589705467, -0.006603493355214596, -0.0025058642495423555,.........]
La longueur de result est 1536, en cohérence avec la dimension spécifiée lors de la création de l’index.
Envoyer une requête de recherche est très simple :
query_result = index.query(vector=result, top_k=3, include_metadata=True)
print(query_result)
Sortie :
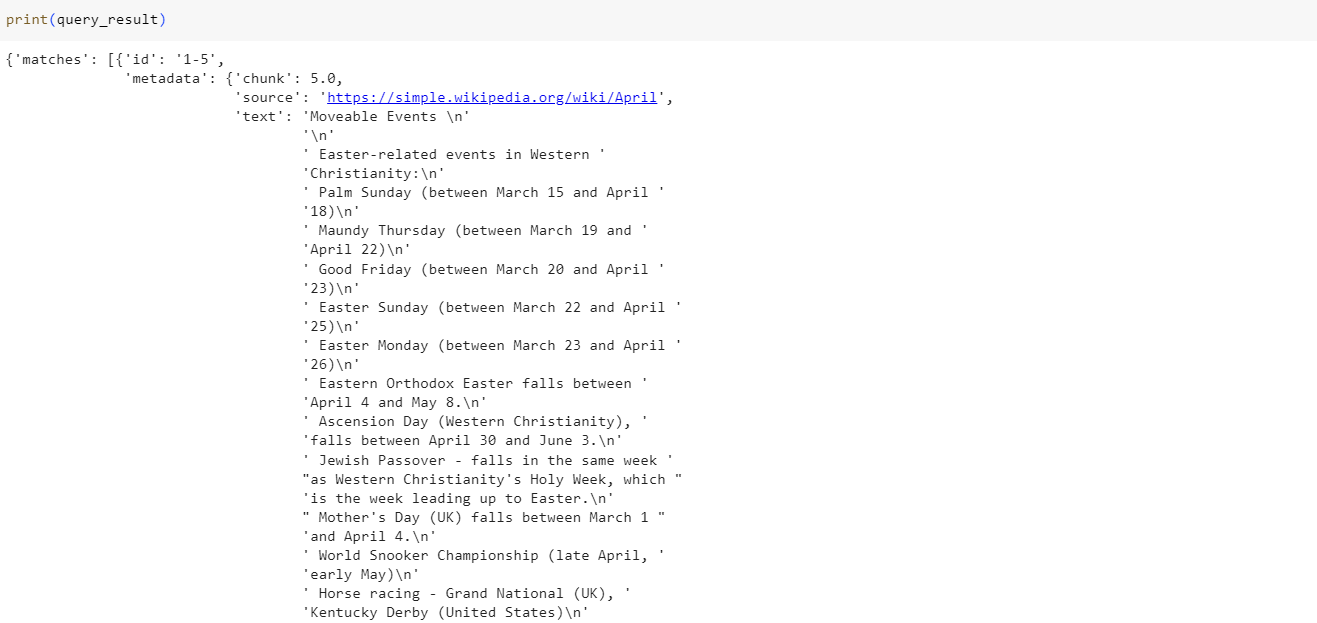
La variable query_result produit un dictionnaire contenant la liste des 3 meilleures correspondances avec la requête de l’utilisateur. Ces N meilleurs résultats peuvent ensuite servir à des tâches aval, par exemple pour fournir du contexte à des invites dans des scénarios de RAG (Retrieval Augmented Generation) ou pour créer des chatbots.
Dans ce tutoriel, nous avons présenté plusieurs notions fondamentales — embeddings et bases de données vectorielles — pour comprendre le fonctionnement complet des applications de recherche sémantique.
Avec l’essor de l’IA générative et l’évolution continue des LLM multimodaux, la recherche sémantique gagne en puissance et offre une précision inédite pour appréhender la complexité et les nuances des données non structurées.
En tirant parti de Pinecone, une base vectorielle de pointe, et des modèles d’embeddings d’OpenAI, les développeurs et data scientists disposent désormais des outils nécessaires pour concevoir des applications de recherche sémantique qui dépassent les approches basées sur les mots-clés.
Ce guide a également montré comment les embeddings comblent le fossé entre la complexité du langage humain et les représentations numériques requises pour le machine learning, permettant aux machines de saisir les subtilités du contexte et de l’intention.
L’avenir de la recherche repose clairement sur la compréhension du langage et d’autres formes de données non structurées, portée par l’IA. Qu’il s’agisse d’e-commerce, de découverte de contenu, de support client ou de gestion des connaissances, les principes et pratiques exposés ici constituent une base solide pour exploiter la recherche sémantique et créer des expériences de recherche plus intelligentes, réactives et centrées sur l’utilisateur.
Pour aller plus loin dans la création d’applications de recherche sémantique avec Pinecone, consultez le code-along Semantic Search with Pinecone. Si vous souhaitez découvrir les mécanismes qui sous-tendent des applications d’IA populaires comme ChatGPT, explorez le cours Working with the OpenAI API. Et n’oubliez pas notre cours Vector Databases for Embeddings with Pinecone.
En savoir plus sur l’utilisation d’OpenAI !
Cours
Cours
Cursus