
Kurs
Arbeiten mit der OpenAI-API
3 Std.
174.3K
Die sich ständig wandelnde Datenlandschaft und der rasante Fortschritt in der Generativen KI in den letzten zwei Jahren haben die semantische Suche neu ausgerichtet und ihre Anwendungen immer populärer gemacht.
Suchen und Abrufen bedeutet, gezielt Informationen oder Daten anhand von Abfragekriterien in einer größeren Datenbank oder Sammlung zu finden und zu beziehen. Der Fortschritt in der KI hat das Bedürfnis nach genaueren, kontextsensitiven und effizienteren Suchmethoden verstärkt und zur Verbreitung semantischer Suchanwendungen geführt.
Semantische Suche überwindet die Grenzen klassischer, rein schlüsselwortbasierter Suche, indem sie Absicht und Kontext einer Anfrage versteht – und so relevantere und präzisere Ergebnisse liefert.
Um eine End-to-End-Anwendung für semantische Suche zu bauen, solltest du zentrale Konzepte wie Embeddings, Vektordatenbanken, Distanzmetriken usw. verstehen und lernen, wie du Produkte/Services wie Pinecone und OpenAI’s GPT nutzt, um semantische Suche von Ende zu Ende zu entwickeln und bereitzustellen.
Am Ende dieses Blogs hast du ein umfassendes Verständnis der Grundlagen der semantischen Suche, von Embeddings und der Rolle von Vektordatenbanken – und lernst schließlich, wie du semantische Suche in Python umsetzt mit:
Wenn du Lust auf praktisches Ausprobieren hast, schau dir unseren Kurs Vector Databases for Embeddings with Pinecone an.
Ein Embedding ist ein Kernkonzept im Machine Learning. Es schlägt die Brücke zwischen der komplexen, nuancierten Welt menschlicher Sprache und dem präzisen, mathematischen Zahlenraum, der diese Welt für Maschinen abbildet.
Unstrukturierte Daten wie Text, Bilder, Audio und Video folgen keinem festen, organisierten Format und sind deshalb in klassischen Datenbanken schwer zu speichern und zu verarbeiten. Für Analysen in Machine-Learning- und KI-Anwendungen müssen sie oft in mehrdimensionale numerische Repräsentationen überführt werden – mittels Vektorembeddings. Der Prozess, unstrukturierte Daten in mehrdimensionale numerische Vektoren umzuwandeln, heißt Embedding.
Embeddings sind mehrdimensionale numerische Repräsentationen von Texten, Bildern oder anderen unstrukturierten Daten. Sie ermöglichen es Maschinen, die Komplexität menschlicher Kommunikation, die Beziehungen zwischen Konzepten oder Muster in Daten zu erfassen – rechen effizient und dennoch kontextreich.
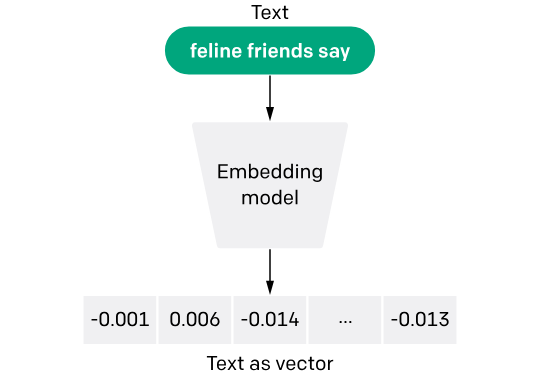
OpenAI’s Text- und Code-Embedding-Modell (Bildquelle)
Die Grundidee hinter Embedding-Modellen: Ähnliche Elemente werden als Punkte dargestellt, die in einem hochdimensionalen Raum nahe beieinander liegen. So lassen sich feine Beziehungen in Daten abbilden – etwa Synonyme, Analogien oder abstraktere Verbindungen –, indem die enorme Komplexität menschlicher Sprache oder anderer Datentypen in eine Form überführt wird, mit der Maschinen arbeiten können.
Bei Textdaten werden Wörter beispielsweise in Vektoren (Zahlenarrays) verwandelt. Diese Vektoren fassen Bedeutung, Verwendung und Kontext der Wörter im Verständnis des Sprachmodells zusammen.
Die Länge des Vektors, die vom Embedding-Modell zurückgegeben wird, hängt vom verwendeten Modell ab. Wenn du zum Beispiel OpenAI’s Embedding-Modell nutzt, hat der Vektor immer die Länge `1536`.
Hinter den Kulissen ist ein Embedding-Modell im Kern ein großes neuronales Netz, das auf einem extrem großen Korpus trainiert wurde. Das Modell lernt, Eingabedaten so mit Vektoren zu versehen, dass die geometrischen Beziehungen der Vektoren die semantischen bzw. konzeptuellen Beziehungen der Daten widerspiegeln.
In einem gut trainierten Embedding-Modell ergibt zum Beispiel der Vektor für "king" minus der Vektor für "man" plus der Vektor für "woman" einen Vektor, der sehr nah am Vektor für "queen" liegt. Diese "Vektor-Arithmetik mit Bedeutungen" zeigt eindrucksvoll, wie Embeddings Semantik erfassen.
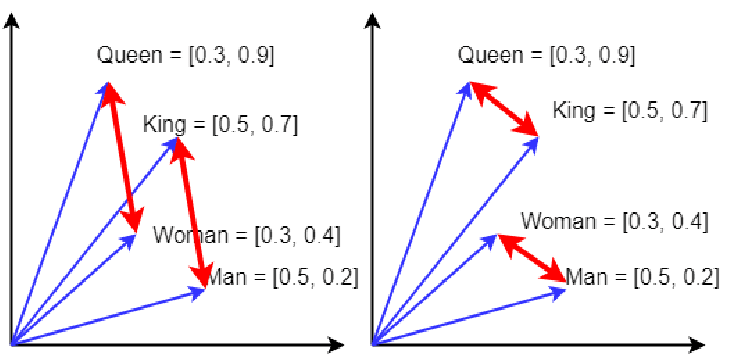
Das klassische Beispiel: king + woman − man ≈ queen (neuronale Wort-Embeddings) (Bildquelle)
Du kannst eigene Embedding-Modelle trainieren, brauchst dafür aber sehr viele Daten und Ressourcen – das Training riesiger Netze kann Millionen kosten und Monate dauern.
Praktischer ist die Nutzung vortrainierter Embedding-Modelle. Viele Open-Source-Modelle findest du bei Hugging Face und kannst sie lokal verwenden. Oder du nutzt proprietäre Modelle von Anbietern wie OpenAI, Anthropic, Cohere usw.
In diesem Blog nutzen wir OpenAI’s `text-embedding-ada-002`-Modell, das günstig bepreist ist ($0,00010 pro 1.000 Token). Ein Buch mit 1.000 Seiten kostet damit grob weniger als 1 US-Dollar.
Embeddings sind in vielen Domänen unverzichtbar. In der semantischen Suche erlauben sie Systeme, über simples Keyword-Matching hinauszugehen und Ergebnisse zu finden, die kontextuell zur Anfrage passen – auch wenn die exakten Wörter im Inhalt nicht vorkommen. Das steigert Relevanz und Genauigkeit spürbar und macht Informationssuche intuitiver und effizienter.
Embeddings beschränken sich nicht auf Text. Bild-Embeddings ermöglichen ähnliche Fortschritte im Computer Vision: Maschinen erkennen Objekte, Szenen und Aktivitäten in Bildern und Videos, indem sie diese in einem hochdimensionalen Vektorraum verstehen – nicht nur als Pixel, sondern in ihrem Bedeutungsgehalt.
Embedding-Modelle sind nicht nur transformativ, sondern auch enorm nützlich, weil sie die Komplexität realer Daten in eine für Maschinen verständliche Sprache (numerische Vektoren) übersetzen – Grundlage für zahlreiche Anwendungen, die auf tiefem semantischem Verständnis und intelligenter Datenverarbeitung beruhen.
Mehr zu Embeddings findest du im Introduction to Text Embeddings with the OpenAI API-Blog.
Vektordatenbanken sind eine noch junge Kategorie nicht-relationaler Datenspeicher, deren Popularität durch die jüngsten Fortschritte in Generativer KI und großen Sprachmodellen stark wächst.
Im Unterschied zu relationalen Datenbanken mit Zeilen und Spalten oder anderen nicht-relationalen Stores wie Dokumentdatenbanken, die Daten als JSON- oder XML-Objekte organisieren, sind Vektordatenbanken darauf ausgelegt, mehrdimensionale Vektordaten effizient zu speichern und zu verarbeiten.
Eine Vektordatenbank ist eine spezialisierte Datenbank, optimiert für das Speichern und Abfragen von Vektoren. Vektoren sind im Grunde Zahlenarrays, die Datenpunkte in einem mehrdimensionalen Raum repräsentieren.
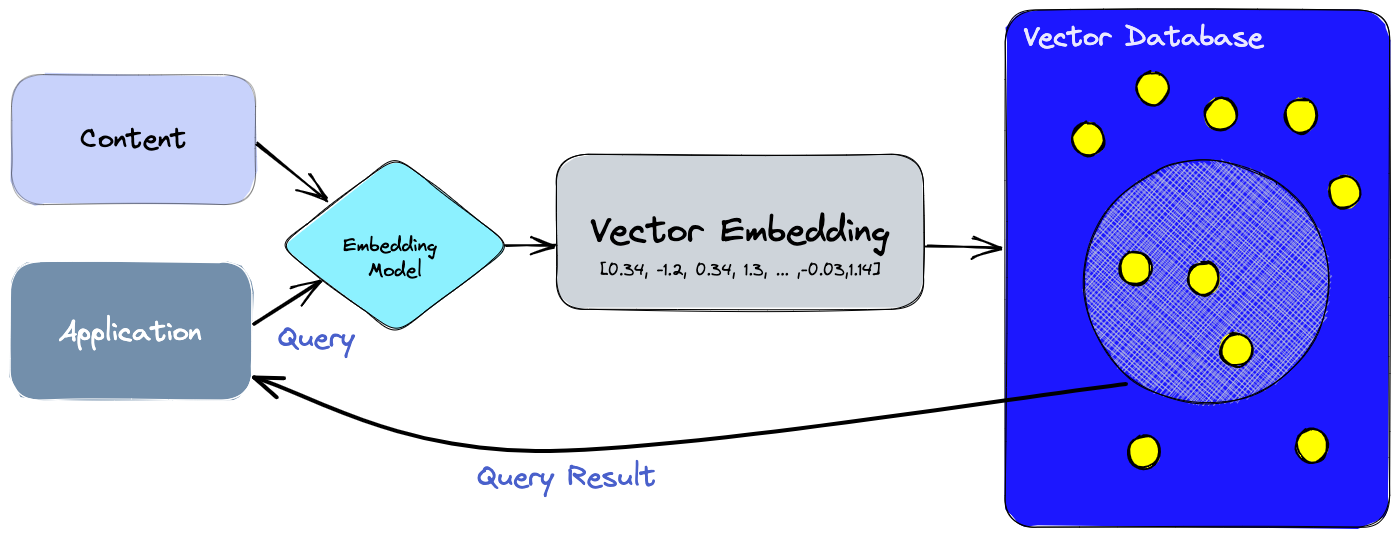
Der größte Vorteil von Vektordatenbanken ist ihre Fähigkeit, Ähnlichkeitssuchen effizient durchzuführen. Sie finden also schnell Elemente in der Datenbank, die gemäß einer Distanz- oder Ähnlichkeitsmetrik dem Anfrageobjekt am nächsten sind.
Das ist essenziell für Empfehlungssysteme, die z. B. ähnliche Produkte wie die bevorzugten eines Nutzers finden sollen, oder in semantischen Suchanwendungen, die Dokumente ermitteln, die semantisch zu einer Suchphrase passen.
Vektordatenbanken nutzen verschiedene Algorithmen zum Indexieren und Suchen, oft auf Basis von Approximate-Nearest-Neighbor-(ANN)-Techniken.
Semantische Suche ist ein großer Sprung nach vorn, wie Suchmaschinen Anfragen verstehen und verarbeiten. Anders als traditionelle Methoden, die auf wörtliche Übereinstimmungen zwischen Query-Text und Dokumentinhalt setzen, erfasst semantische Suche Absicht und Kontext hinter einer Anfrage.
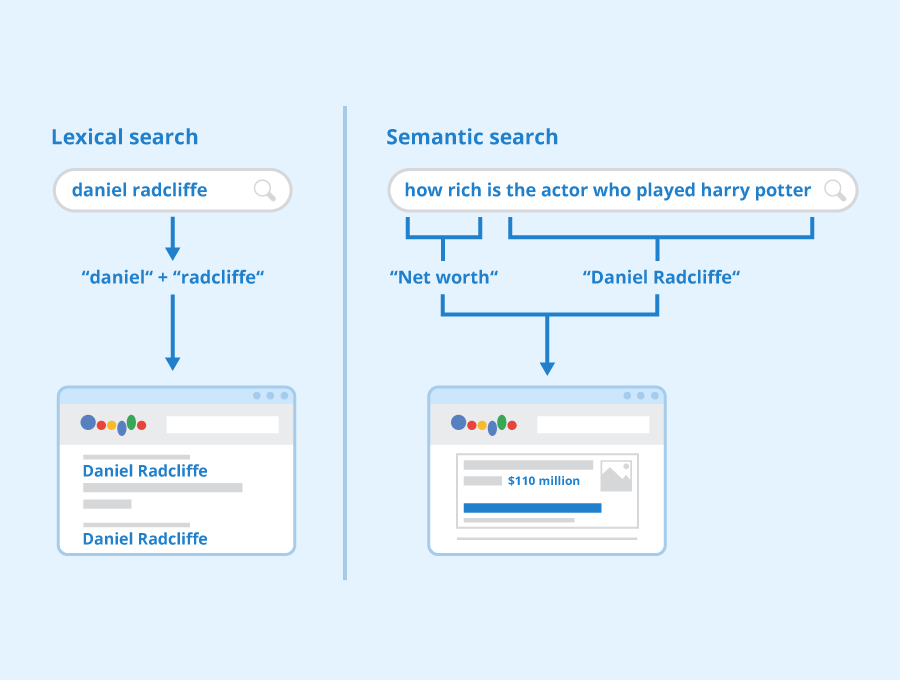
Lexikalische vs. semantische Suche (Bildquelle)
Der Wandel hin zur semantischen Suche im letzten Jahrzehnt hat mehrere Gründe. Sprachsuche mit Assistenten wie Siri, Alexa und Google Assistant stützt sich stark auf Natural Language Processing, um Nutzeranfragen zu verstehen und auszuführen.
Die dialogische Natur von Sprachsuchen erfordert Kontextverständnis – Suchmaschinen müssen die Bedeutung ganzer Sätze oder längerer Phrasen erfassen.
Die Komplexität menschlicher Sprache ist ein großes Hindernis für traditionelle, lexikalbasierte Suche – das die semantische Suche zügig abbaut. Im Englischen gibt es Tausende Wörter mit mehreren Bedeutungen, deren tatsächliche Bedeutung vom Kontext abhängt. Diese Wörter nennt man Polyseme.
So kann "table" je nach Kontext ein Möbelstück oder eine Datenübersicht meinen.
Multimodale LLMs treiben die Popularität semantischer Suche massiv. Ziel der semantischen Suche ist es, Absichten zu verstehen und die kontextuelle Bedeutung von Begriffen in einem durchsuchbaren Datenraum zu erfassen – und genau hier legen multimodale LLMs zu.
Diese Modelle verstehen und generieren nicht nur Text, sondern interpretieren und erzeugen Inhalte in unterschiedlichen Formaten – darunter Bilder, Audio und Video. Dadurch geht Suche weit über Keyword-Matching hinaus und erfasst Nuancen der Sprache, Medienspezifika und komplexe Konzeptbeziehungen.
Eine natürliche Sprachabfrage kann etwa Ergebnisse liefern, die neben Text auch passende Bilder, Videoclips oder Audioschnipsel enthalten – kuratiert von der KI passend zur Suchabsicht.
Semantische Suche hat in vielen Bereichen starke Wirkung, weil sie Relevanz und Präzision der Ergebnisse erhöht:
Du willst mehr über Vektordatenbanken wissen? Hier ist der umfassende Guide zu den besten Vektordatenbanken.
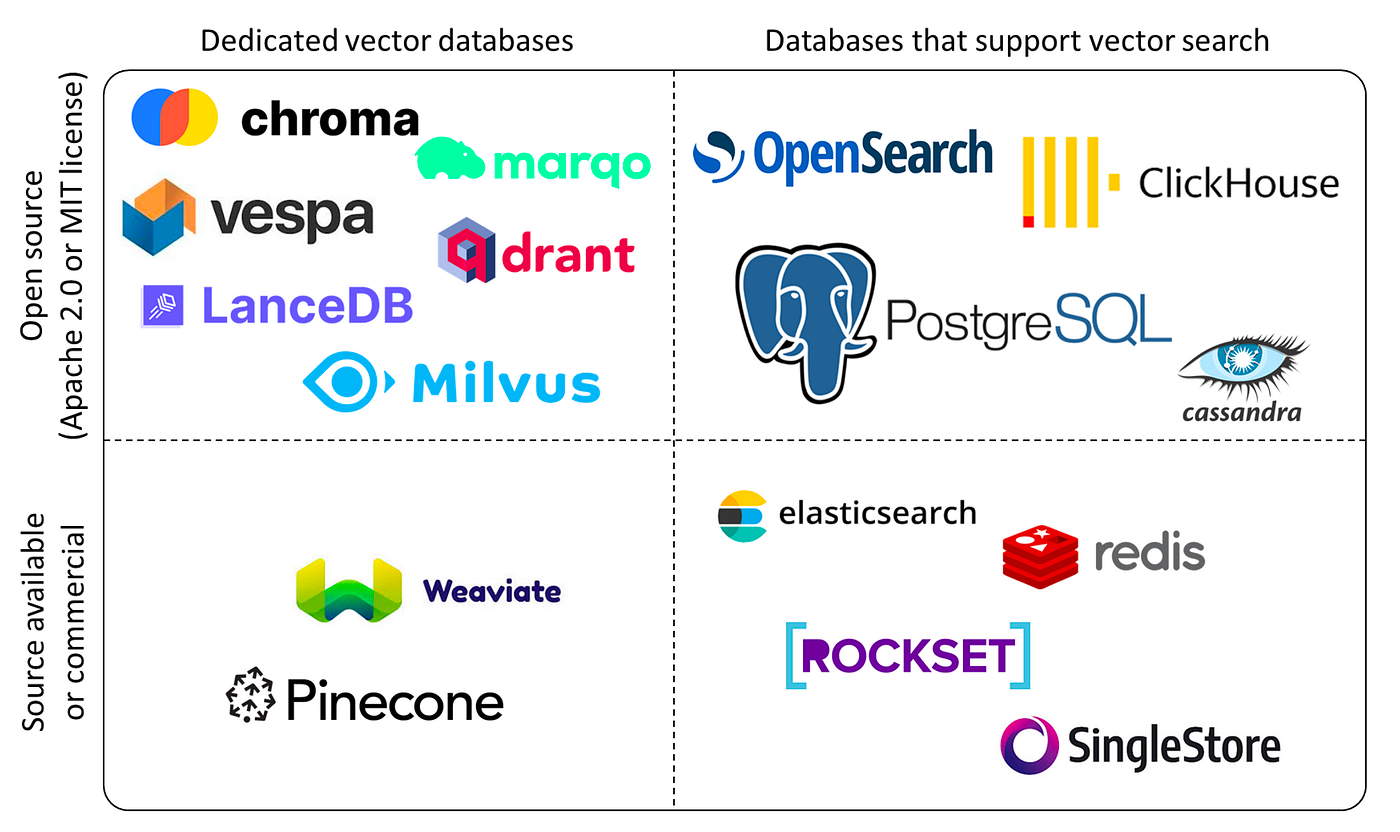
Die Landschaft der Vektordatenbanken (Bildquelle)
Pinecone ist eine spezialisierte Vektordatenbank für komplexe, hochdimensionale Daten. Sie bietet leistungsfähige Such- und Indexierfunktionen und ermöglicht Dateningenieurinnen und -ingenieuren sowie Data Scientists, große ML-Projekte effizient zu entwickeln und zu betreiben.
Wenn du tiefer einsteigen willst, lies Mastering Vector Databases with Pinecone Tutorial: A Comprehensive Guide auf DataCamp.
OpenAI stellt über seine Platform API Zugriff auf alle Modelle bereit – darunter die bekannten GPT-, DALL-E- und Whisper-Modelle sowie drei Embedding-Modelle.
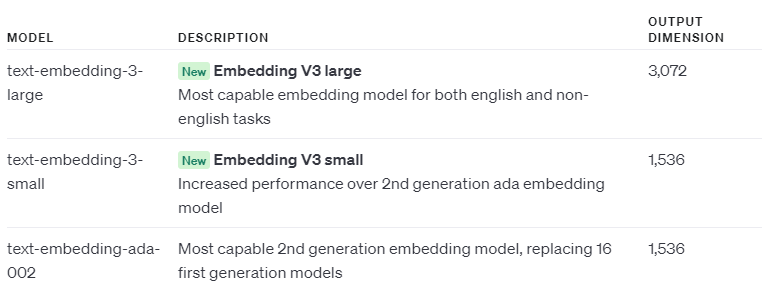
Die APIs lassen sich per HTTP ansprechen – und damit aus jeder Programmiersprache nutzen, die HTTP beherrscht.
In Python kannst du zusätzlich die openai-Bibliothek verwenden, was die Nutzung noch einfacher macht. Installation per pip install openai.
Mit der openai-Bibliothek brauchst du in Python nur sehr wenig Code, um die OpenAI API zu verwenden.
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Fitness & Health."},
    {"role": "user", "content": "Explain what is Keto diet?"}
  ]
)


print(completion.choices[0].message)Ausgabe: (gekürzt)
ChatCompletionMessage(content="The ketogenic diet, commonly known as the keto diet, is a low-carbohydrate, high-fat diet. The diet is named after ketosis, a metabolic state where your body starts burning fat for energy instead of carbohydrates. This is accomplished by drastically reducing your intake of carbohydrates and increasing your intake of fats….", role='assistant', function_call=None, tool_calls=None)
Entdecke, wie ChatGPT und große Sprachmodelle die digitale Welt verändern! Tauche ein in das DataCamp-Cheat Sheet und lerne die Essentials einer der mächtigsten KI-APIs – der OpenAI API.
Nachdem du ein OpenAI-Konto erstellt hast, rufe einfach https://platform.openai.com/api-keys auf.
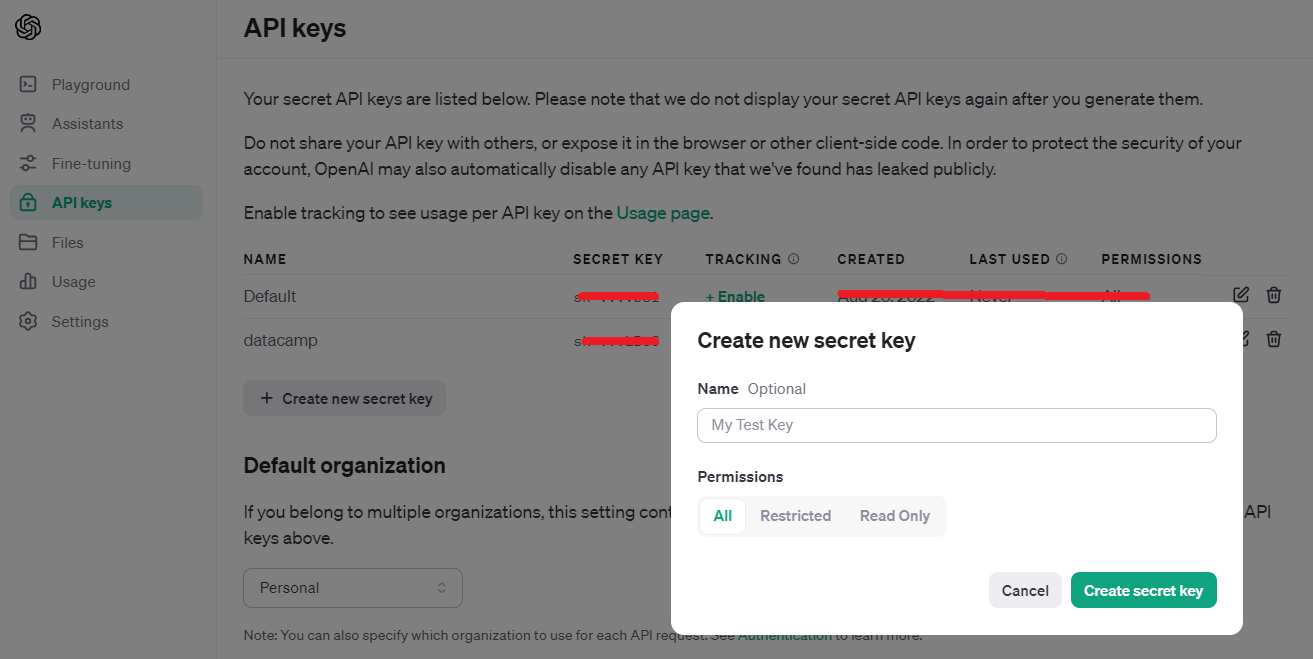
API Keys platform.openai.com
Für Pinecone meldest du dich an und klickst auf API Keys. Über die Schaltfläche `Click API Key` oben rechts erstellst du einen Schlüssel.
Anders als bei OpenAI musst du den Pinecone-Schlüssel nicht sofort kopieren – im Bereich Actions gibt es ein Kopier-Icon, mit dem du ihn jederzeit übernehmen kannst.
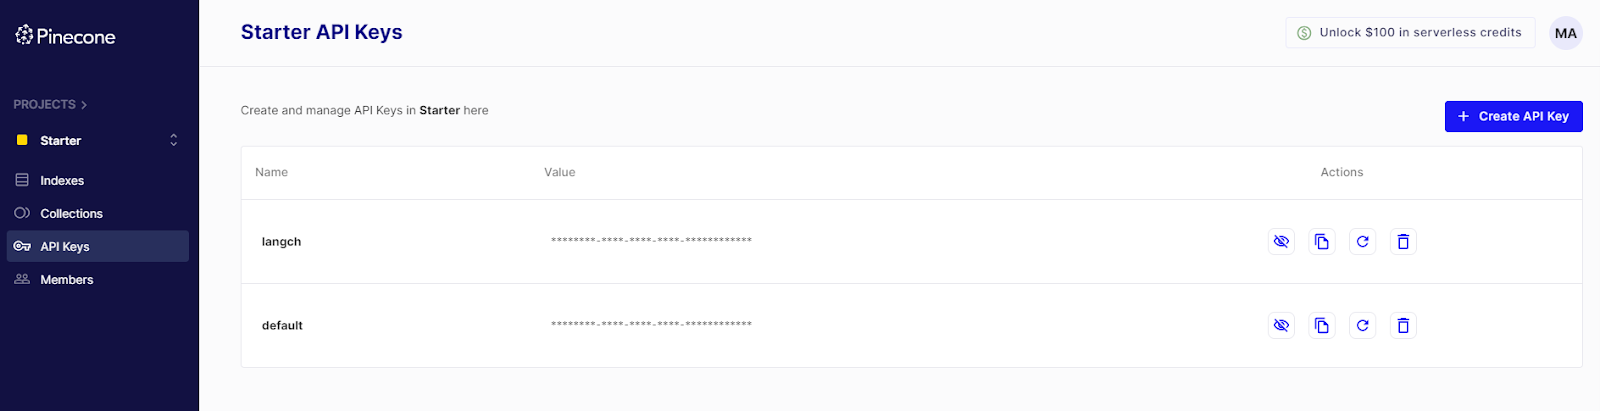
API Keys – Pinecone
Nachdem du die OpenAI- und Pinecone-API-Keys erhalten hast, weise sie in deinem Notebook Variablen zu oder setze sie als Umgebungsvariablen mit dem Python-Modul os.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Für dieses Tutorial brauchst du folgende Bibliotheken, per pip und in genau diesen Versionen – sonst funktioniert der Code unten nicht.
!pip install pinecone-client==3.0.0
!pip install pinecone-datasets==0.7.0
!pip install openai==0.28Die Bibliothek pinecone-datasets enthält mehrere Datensätze, die bereits mit OpenAI’s embedding-ada-002 vor-embedded wurden.
Für dieses Beispiel nutzen wir den Datensatz `wikipedia-simple-text-embedding-ada-002-100K` und ziehen eine Stichprobe von 5.000 der 100.000 Dokumente samt Embeddings.
import pinecone_datasets

# load dataset from pinecone
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')

# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)

# sample 5k documents
dataset.documents.drop(dataset.documents.index[5_000:], inplace=True)
dataset.head()
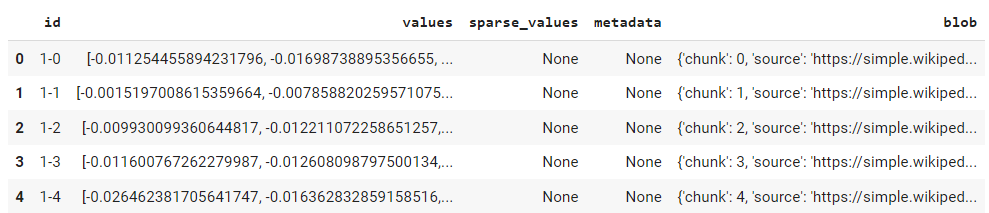
Beispieldatensatz
In Pinecone ist ein Index die höchste Organisationsebene für Vektordaten. Er speichert Vektoren, beantwortet Abfragen dazu und führt verschiedene Operationen auf diesen Daten aus.
from pinecone import Pinecone, ServerlessSpec

# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)

# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')

# set index name
index_name = 'semantic-search-demo'

# we create a new index
pc.create_index(
        index_name,
        dimension=1536,  # dimensionality of text-embedding-ada-002
        metric='cosine',
        spec=spec
    )
Der Code initialisiert die Pinecone-Instanz und erstellt einen Index namens semantic-search-demo. Du siehst ihn ab jetzt auch im UI.
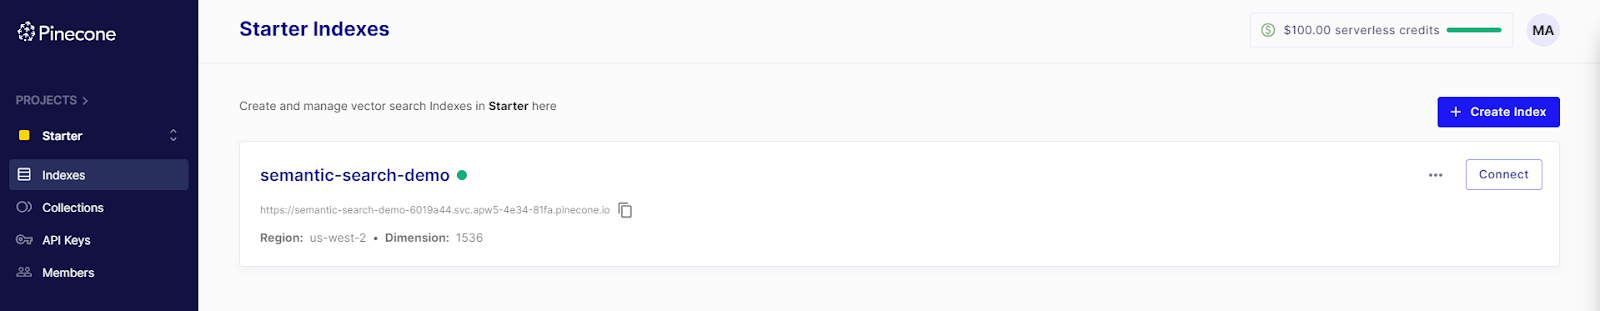
Da unsere Daten bereits Embeddings enthalten, können wir den Embedding-Schritt überspringen und direkt in den neuen Index einfügen.
Für Datensätze ohne Embeddings musst du die Rohdaten zuerst mit der OpenAI API einbetten (siehe Schritt 5).
index = pc.Index(index_name)
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Nach erfolgreicher Ausführung kannst du die Daten auch im UI sehen.
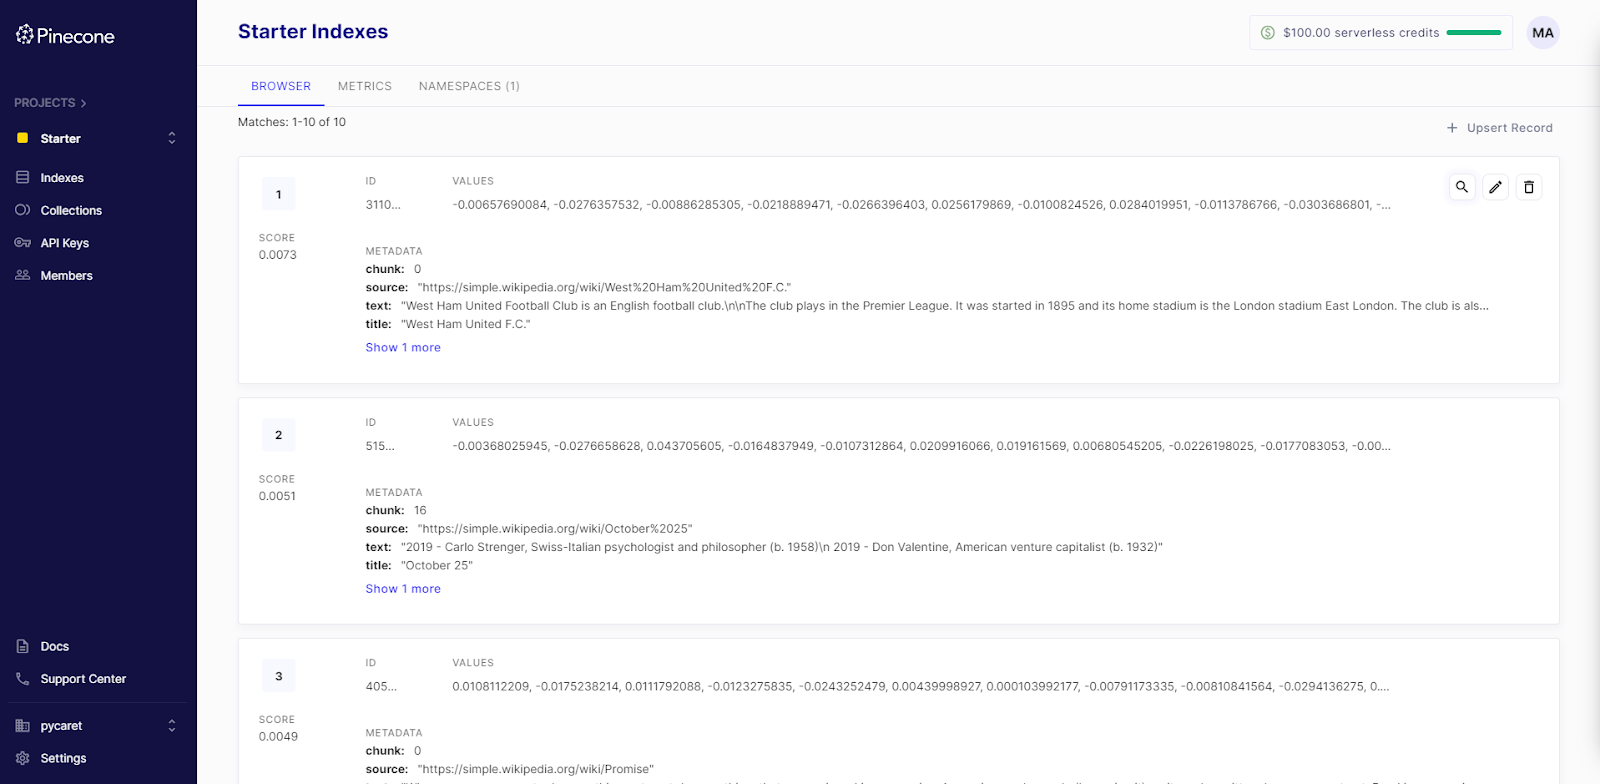
Neue Daten oder Queries müssen mit demselben Modell eingebettet werden, damit die Vektordimensionen übereinstimmen. Da unser Datensatz text-embedding-ada-002 nutzt, erstellen wir eine Funktion, die neue Anfragen genau mit diesem Modell über die OpenAI API einbettet.
import openai
openai.api_key = OPENAI_API_KEY


def get_embedding(text_to_embed):
  # Embed a line of text
  response = openai.Embedding.create(
      model= "text-embedding-ada-002",
      input=[text_to_embed]
  )
  # Extract the AI output embedding as a list of floats
  embedding = response['data'][0]['embedding']

return embeddingquery = "What are some easter related events in Western Christianity?"
result = get_embedding(query)
print(len(result))
print(result)Ausgabe:
1536
[0.014745471067726612, -0.03282099589705467, -0.006603493355214596, -0.0025058642495423555,.........]
Die Länge von result ist 1536 und stimmt damit mit der beim Index-Erstellen gesetzten dimension überein.
Eine Suchabfrage zu senden ist ganz einfach:
query_result = index.query(vector=result, top_k=3, include_metadata=True)
print(query_result)Ausgabe:
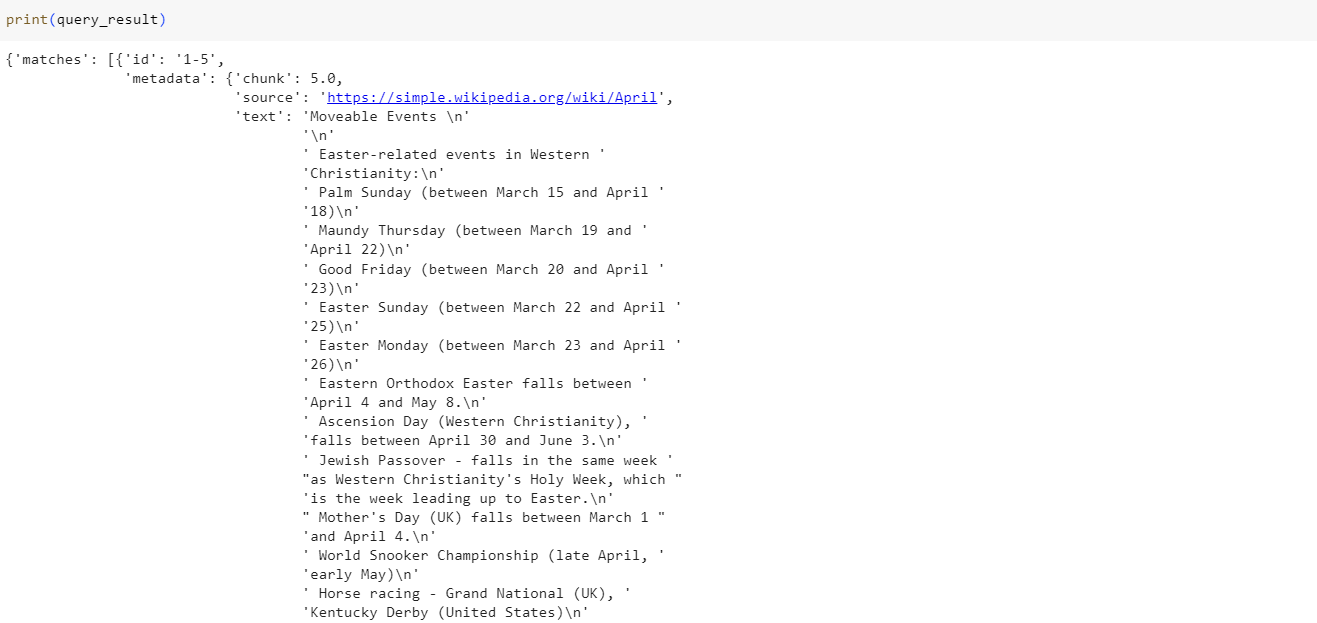
query_result liefert ein Dictionary mit einer Liste der drei besten Treffer zur Nutzeranfrage. Diese Top-N-Treffer kannst du in nachgelagerten Tasks verwenden – etwa als Kontext für Prompts in Retrieval-Augmented-Generation-(RAG)-Szenarien oder beim Bau von Chatbots.
In diesem Tutorial haben wir zentrale Grundlagen wie Embeddings und Vektordatenbanken vorgestellt, um die Funktionsweise semantischer Suchanwendungen ganzheitlich zu verstehen.
Mit Generativer KI und der stetigen Weiterentwicklung multimodaler LLMs wächst die Leistungsfähigkeit semantischer Suche – und ermöglicht bislang unerreichte Präzision im Verständnis der Komplexität unstrukturierter Daten.
Dank Pinecone, einer modernen Vektordatenbank, und den leistungsfähigen Embedding-Modellen von OpenAI haben Entwicklerinnen, Entwickler und Data Scientists heute die nötigen Werkzeuge, um Suchanwendungen zu bauen, die klassische Keyword-Suche klar hinter sich lassen.
Wir haben gezeigt, wie Embeddings die Lücke zwischen der Komplexität menschlicher Sprache und den numerischen Repräsentationen für Machine Learning schließen – und so Maschinen befähigen, Nuancen von Kontext und Absicht zu erfassen.
Die Zukunft der Suche liegt im Verständnis von Sprache und anderen unstrukturierten Daten – angetrieben von KI. Ob E-Commerce, Content-Discovery, Kundenservice oder Wissensmanagement: Die hier vorgestellten Prinzipien sind ein solides Fundament, um die Kraft der semantischen Suche zu nutzen und intelligentere, reaktionsschnellere und nutzerzentrierte Sucherlebnisse zu schaffen.
Wenn du mehr über semantische Suche mit Pinecone lernen willst, schau dir das Semantic Search with Pinecone Code-along an. Interessiert dich die Technik hinter populären KI-Anwendungen wie ChatGPT? Dann ist der Kurs Working with the OpenAI API für dich. Und vergiss nicht unseren Kurs Vector Databases for Embeddings with Pinecone.
Erfahre mehr über die Arbeit mit OpenAI!
Kurs
Kurs
Lernpfad
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Sejal Jaiswal
9 Min.


