Program
Ilmuwan Pembelajaran Mesin dalam Python
85 jam
Gradient descent adalah salah satu algoritme terpenting dalam seluruh bidang machine learning dan deep learning. Ini adalah algoritme optimisasi yang sangat kuat untuk melatih model regresi linear, regresi logistik, dan jaringan saraf. Jika Anda mulai terjun ke machine learning, memahami algoritme gradient descent secara mendalam adalah hal yang mutlak.
Data science berkaitan dengan menemukan pola dan perilaku kompleks dalam analisis big data. Ini disebut "pola", yaitu motif yang berulang. Melalui machine learning, ini berarti melatih algoritme untuk mendeteksi pola dalam analisis data agar melakukan suatu tugas dengan lebih baik. Artinya, mengajarkan perangkat lunak untuk menjalankan tugas atau membuat prediksi secara mandiri. Untuk melakukannya, data scientist memilih dan melatih algoritme untuk melakukan analisis data. Tujuannya tentu untuk meningkatkan ketepatan prediksi seiring waktu.
Akibatnya, machine learning sangat bertumpu pada pelatihan algoritme. Semakin sering algoritme ini terekspos ke data, semakin mereka belajar menjalankan tugas tanpa instruksi spesifik; mereka belajar dari pengalaman. Kita menggunakan berbagai jenis algoritme dalam machine learning. Di antaranya, gradient descent adalah salah satu yang paling berguna dan populer.
Gradient descent adalah algoritme optimisasi. Ia digunakan untuk menemukan nilai minimum sebuah fungsi dengan lebih cepat. Definisi gradient descent cukup sederhana. Ini adalah algoritme untuk menemukan minimum dari fungsi cembung. Untuk melakukannya, algoritme ini mengubah parameter fungsi tersebut secara iteratif. Ini adalah algoritme yang digunakan, misalnya, dalam regresi linear.
Fungsi cembung adalah fungsi yang tampak seperti lembah indah dengan minimum global di tengahnya. Sebaliknya, fungsi non-cembung memiliki beberapa minimum lokal, dan algoritme gradient descent sebaiknya tidak digunakan pada fungsi-fungsi ini karena berisiko terjebak pada minimum pertama yang ditemui.
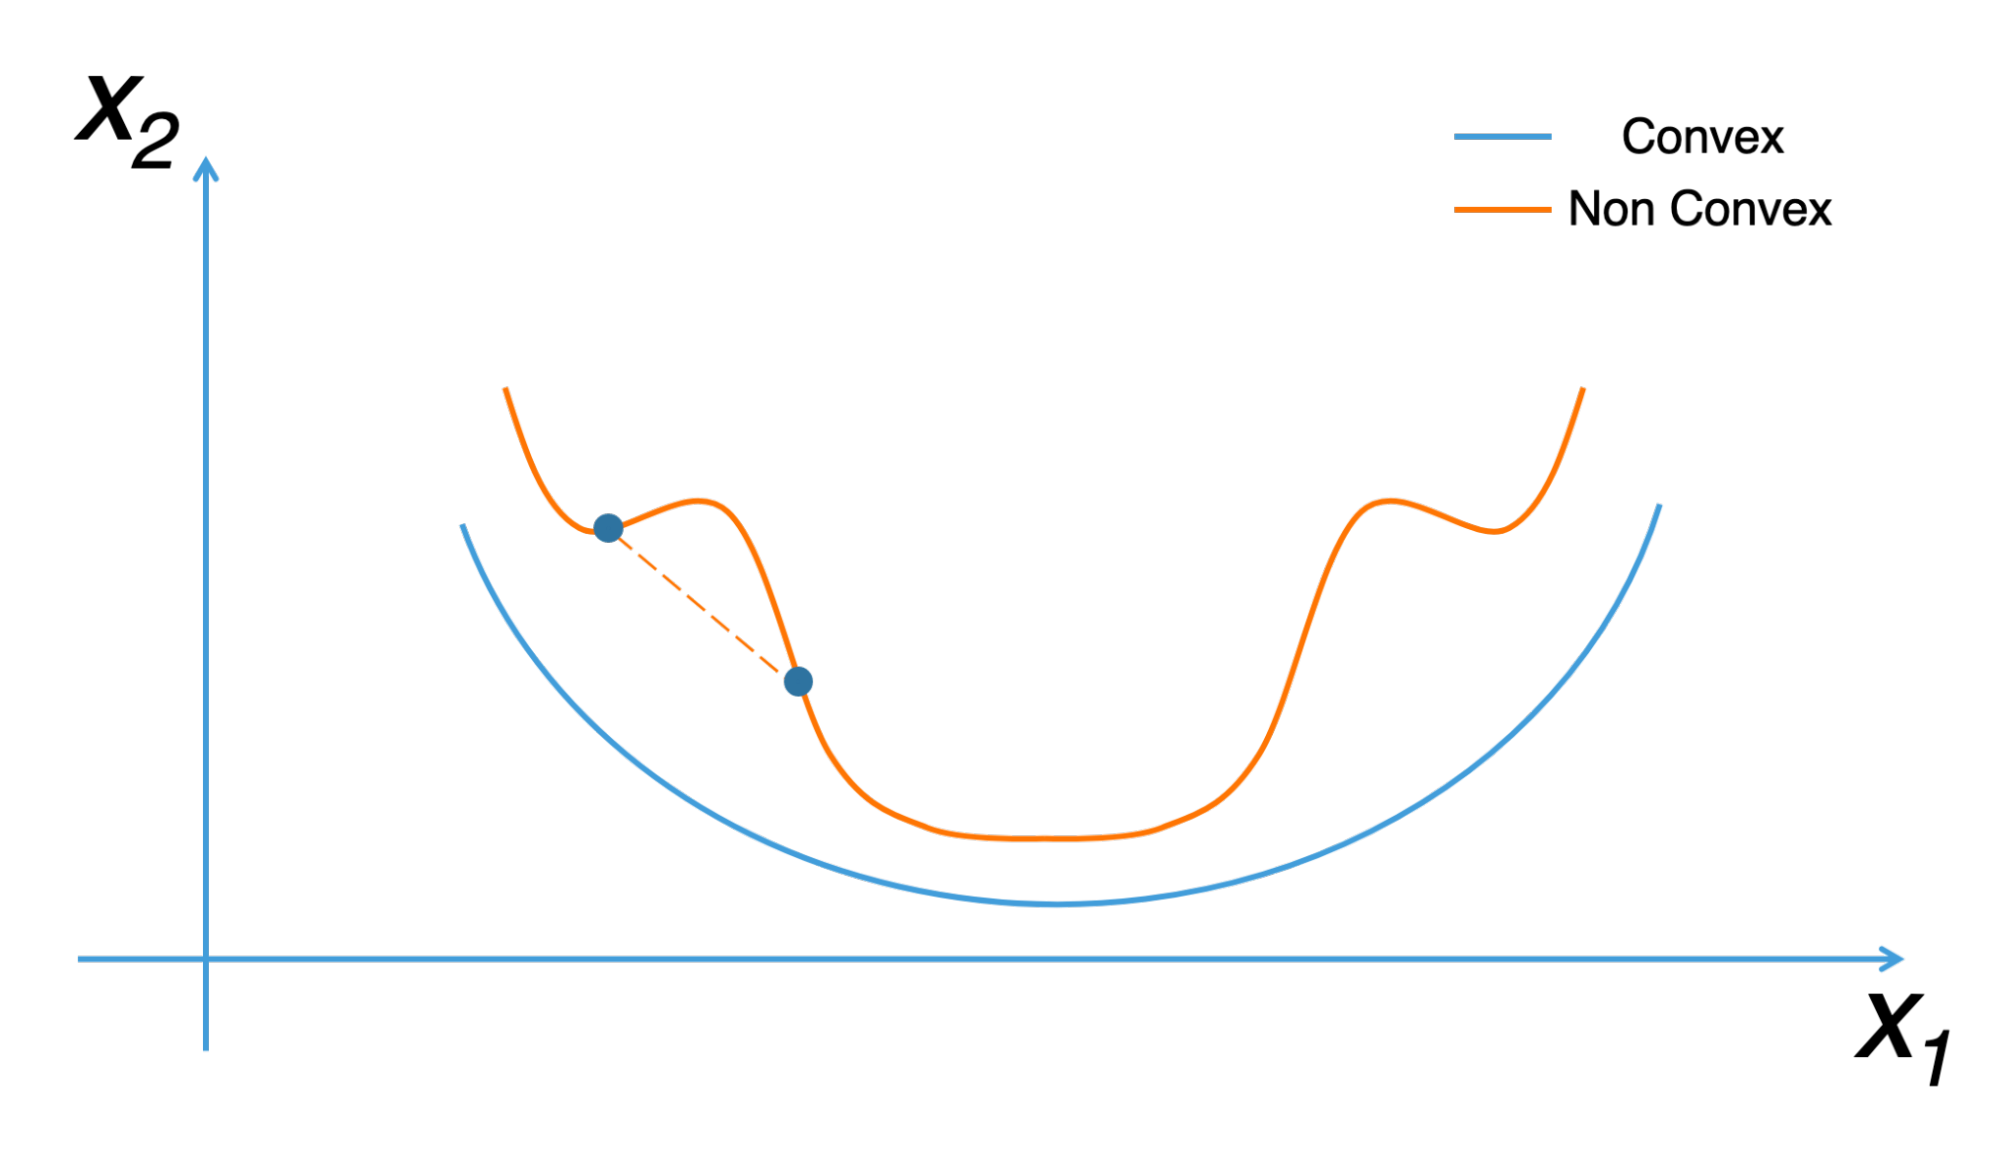
Gradient descent juga disebut sebagai “algoritme turunan paling curam”. Ini sangat penting dalam machine learning, di mana ia digunakan untuk meminimalkan fungsi biaya. Fungsi ini digunakan untuk menentukan model prediksi terbaik dalam analisis data. Semakin kecil biayanya, semakin baik mesin mampu membuat prediksi yang tepat.
Ada tiga jenis descent yang dikenal luas. Mari kita lihat lebih dekat:
Juga dikenal sebagai vanilla gradient descent, batch gradient descent menghitung galat untuk setiap contoh dalam dataset pelatihan. Namun, ini dilakukan hanya setelah tiap contoh pelatihan dievaluasi secara menyeluruh. Proses ini dapat dianalogikan sebagai satu siklus. Ada juga yang menyebutnya satu era pelatihan.
Batch descent memiliki beberapa keunggulan. Secara khusus, efisiensi komputasinya sangat praktis karena menghasilkan konvergensi yang stabil dan gradien galat yang stabil. Meski begitu, batch gradient descent juga memiliki kekurangan. Terkadang, gradien galat yang stabil dapat mengarah pada keadaan konvergensi yang kurang menguntungkan. Selain itu, ia juga memerlukan keberadaan dataset pelatihan di algoritme dan memori.
Stochastic gradient descent memberikan pembaruan parameter secara individual untuk setiap contoh pelatihan. Ini memungkinkan perhatian diberikan pada setiap contoh, sehingga prosesnya minim galat. Bergantung pada masalahnya, ini dapat membantu SGD menjadi lebih cepat dibandingkan batch gradient descent. Pembaruan yang rutin memberi kita laju perbaikan yang lebih rinci.
Namun, pembaruan ini mahal secara komputasi, terutama dibandingkan pendekatan yang digunakan oleh descent bertahap. Selain itu, frekuensi pembaruan dapat menyebabkan gradien yang bising dan dapat mencegah laju galat turun. Alih-alih menurun mulus, laju galat dapat melonjak-lonjak dan menjadi masalah dalam jangka panjang.
Para peneliti menggunakan mini-batch gradient descent sebagai metode awal. Mengapa? Karena ini merupakan perpaduan sempurna antara konsep stochastic descent dan batch descent. Ia membagi dataset (pelatihan) menjadi batch dan melakukan pembaruan untuk setiap batch, menciptakan keseimbangan antara efisiensi BGD dan kekokohan SGD.
Ukuran mini-batch yang populer berkisar dari lima puluh hingga dua ratus lima puluh enam, tetapi seperti banyak metode machine learning lainnya, tidak ada aturan baku karena bervariasi menurut aplikasi. Metode ini kerap digunakan sebagai opsi dasar untuk melatih jaringan saraf. Ini juga merupakan jenis descent yang populer di ranah deep learning.
Dalam machine learning, kita menggunakan algoritme gradient descent pada masalah supervised learning untuk meminimalkan fungsi biaya, yang merupakan fungsi cembung (misalnya, mean square error).
Berkat algoritme ini, mesin belajar dengan menemukan model terbaik. Ingat bahwa meminimalkan fungsi biaya berarti menemukan parameter a, b, c, dan seterusnya yang menghasilkan galat terkecil antara model kita dan titik y pada dataset. Setelah fungsi biaya diminimalkan, ini membuka jalan untuk membangun program pengenalan suara yang akurat, program visi komputer, dan aplikasi untuk memprediksi harga pasar saham.
Anda dapat melihat mengapa algoritme gradient descent itu fundamental: mesin belajar darinya.
Untuk menggambarkan cara kerja dan kegunaan algoritme ini, sering digunakan analogi pegunungan. Bayangkan seseorang tersesat di pegunungan. Pada dasarnya, ia harus menemukan jalan pulang dengan terlebih dahulu mencari arah turunan yang paling curam. Setelah mengikuti arah tersebut sejauh jarak tertentu, metode ini diulang hingga mencapai lembah (nilai terendah). Dalam machine learning, gradient descent terdiri dari mengulang metode ini dalam sebuah loop hingga menemukan minimum untuk fungsi biaya. Itulah mengapa ia disebut algoritme iteratif dan mengapa ia membutuhkan banyak perhitungan.
Berikut strategi 2 langkah yang akan membantu Anda jika Anda tersesat di pegunungan:
Dengan mengulang langkah 1 dan 2 dalam sebuah loop, Anda pasti akan menuju ke minimum lembah. Strategi ini tidak lain adalah algoritme gradient descent.
Kita mulai dari titik awal acak lalu mengukur nilai kemiringan di titik tersebut. Dalam matematika, kemiringan diukur dengan menghitung turunan dari fungsi.
Kita kemudian bergerak sejauh jarak tertentu d ke arah lereng yang menurun, tetapi tidak 300 meter kali ini. Jarak ini disebut “learning rate.” Hasil dari operasi ini adalah mengubah nilai parameter model kita (koordinat kita di lembah berubah saat kita bergerak).
Algoritme gradient descent terutama digunakan di bidang machine learning dan deep learning. Yang terakhir ini dapat dianggap sebagai versi yang disempurnakan dari machine learning. Ia memungkinkan pendeteksian pola yang paling halus. Disiplin ini memerlukan dasar matematika yang kuat dan latar belakang Python.
Bahasa pemrograman ini memiliki beberapa pustaka yang memudahkan penerapan machine learning. Disiplin ini sangat berguna untuk menganalisis volume data yang besar secara akurat dan cepat. Ia memungkinkan analisis prediktif berdasarkan tren atau kejadian masa lalu.
Machine learning adalah salah satu ilmu yang sangat terkait dengan big data dari sisi peluang pemanfaatannya. Ia memungkinkan kita melampaui keterbatasan kecerdasan manusia dalam menganalisis aliran data yang besar. Dengan besarnya kumpulan data yang tersedia secara daring, kecerdasan buatan (AI) dapat belajar sendiri tanpa campur tangan manusia. Machine learning digunakan, misalnya, di bidang perangkat terhubung. Berkat ini, AI dapat beradaptasi dengan kebiasaan penghuni rumah terhubung dan menjalankan tugasnya dengan mempertimbangkan kebiasaan tersebut.
Misalnya, AI dapat menyesuaikan pemanas ruangan sesuai cuaca. Ilmu ini juga memungkinkan hadirnya robot penyedot debu yang semakin canggih. Gradient descent melalui machine learning berada di jantung kemajuan besar kecerdasan buatan. Dalam praktiknya, ada banyak aplikasi gradient descent oleh para insinyur dan spesialis AI.
Ini berguna untuk mesin telusur seperti Google, dan mesin rekomendasi populer seperti YouTube, Netflix, atau Amazon. Berdasarkan data yang dikumpulkan dari pengguna, algoritme akan mencoba memahami minat pengguna internet. Ini memungkinkan mereka menawarkan hasil pencarian yang relevan dan rekomendasi yang lebih baik.
Machine learning telah memungkinkan komputer untuk memahami dan memroses bahasa manusia. Aplikasi inilah yang melahirkan asisten digital seperti Alexa, Google Assistant, dan Siri. Machine learning dan penerapan gradient descent juga sangat berguna bagi pengembang video game. Tujuannya di sini adalah memungkinkan AI unggul dalam tugas-tugas yang paling manusiawi agar orang dapat fokus pada aktivitas bernilai tinggi. Kecerdasan buatan dan machine learning memungkinkan perusahaan mengantisipasi kebutuhan pelanggan dan tren masa depan.
Gradient descent adalah algoritme yang digunakan dalam regresi linear karena kompleksitas komputasinya. Rumus matematika umum untuk gradient descent adalah xt+1 = xt - η∆xt, dengan η mewakili learning rate dan ∆xt arah penurunan. Gradient descent adalah algoritme yang berlaku untuk fungsi cembung. Dengan mengambil ƒ sebagai fungsi cembung yang akan diminimalkan, tujuannya adalah memperoleh ƒ(xt+1) ≤ ƒ (xt) pada setiap iterasi.
Gagasannya di sini adalah menggunakan algoritme yang secara bertahap menghitung minimum dari suatu fungsi matematika. Ketika dihadapkan pada persamaan tertentu, ini adalah cara terbaik untuk menyelesaikannya. Saat membahas gradient descent, kita juga harus memahami konsep fungsi biaya. Dalam mode supervised, fungsi ini memungkinkan pengukuran margin galat antara taksiran dan nilai sebenarnya. Rumus untuk menghitung gradien kuadrat rata-rata dalam kasus masalah regresi linear adalah sebagai berikut:
Penerapan gradient descent juga menggunakan konsep learning rate. Ini adalah hiperparameter yang memungkinkan pengendalian penyesuaian bobot jaringan terhadap gradien loss. Perlu dicatat bahwa learning rate yang optimal sangat penting untuk memperoleh minimum dengan lebih cepat dan efisien. Nilainya tidak boleh terlalu tinggi atau terlalu rendah.
Seiring nilai menurun, ini menunjukkan bahwa kita secara bertahap bergerak menyusuri lereng ke bawah. Beberapa metode optimisasi menggunakan algoritme gradient descent, seperti RMSprop, Adam, dan SGD. Agar tidak melakukan kesalahan saat menggunakan algoritme ini, disarankan untuk memilih parameternya dengan cermat. Perlu juga diingat bahwa minimum yang ditemukan mungkin bukan minimum global.
Fungsi utama gradien adalah mengukur perubahan setiap bobot terhadap perubahan galat. Anggap gradien sebagai kemiringan suatu fungsi. Kemiringan akan semakin curam saat gradien semakin besar—ini menguntungkan bagi model karena dapat belajar lebih cepat. Namun, model akan berhenti belajar jika kemiringan menjadi nol. Secara matematis, gradien dapat digambarkan sebagai turunan hingga terhadap masukan-masukannya.
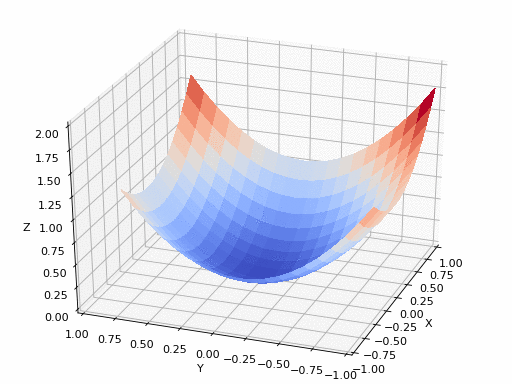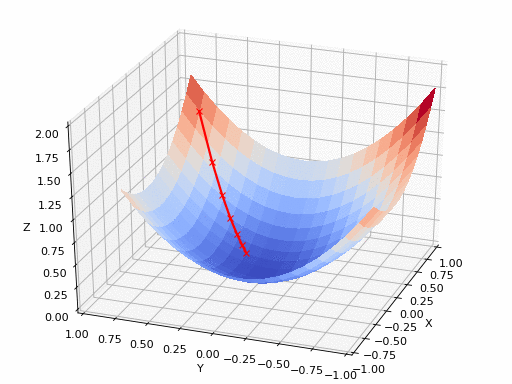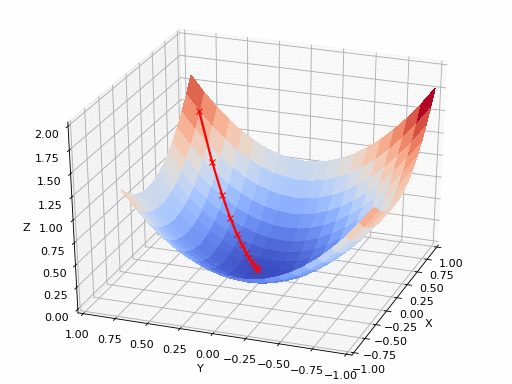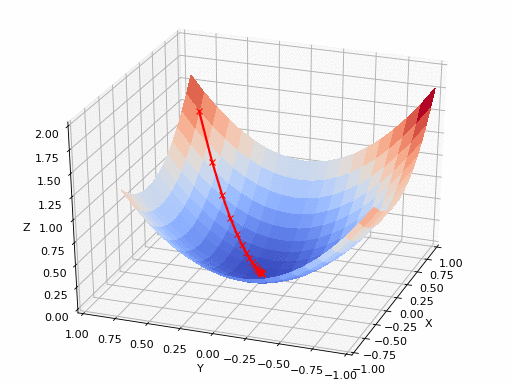
Dalam bagian implementasi, kita akan menulis dua fungsi. Satu akan menjadi fungsi biaya yang mengambil keluaran aktual dan keluaran prediksi sebagai masukan dan mengembalikan loss. Yang kedua adalah fungsi gradient descent yang sebenarnya, yang mengambil variabel independen dan variabel target (dependen) sebagai masukan dan menemukan garis terbaik menggunakan algoritme gradient descent.
Jumlah iterasi, learning rate, dan ambang penghentian adalah parameter penyetelan algoritme gradient descent dan dapat diatur oleh pengguna. Dalam fungsi utama, kita akan menginisialisasi data acak yang berhubungan secara linear, dan menerapkan algoritme gradient descent pada data untuk menemukan garis terbaik. Bobot dan bias optimal yang ditemukan menggunakan algoritme gradient descent kemudian digunakan untuk menggambar garis best fit di fungsi utama.
#Importing libraries
import numpy as np
import matplotlib as pyplot

def mean_squared_error(y_true, y_predicted):

   # Calculating the loss or cost
   cost = np.sum((y_true-y_predicted)**2) / len(y_true)
   return cost

# Gradient descent function
# Here iterations, learning rate, stopping threshold are hyperparameters that can be tuned
def gradient_descent((x, y, iterations = 1000, learning_rate = 0.0001, stopping_theshold = 1e-6):

   #Initialzing rate, bias, learning rate, and iterations
   current_rate = 0.1
   current_bias = 0.01
   iterations = iterations
   learning_rate = learning_rate
   n = float(len(x))

   costs = []
   weights = []
   previous_cost = None

   # Estimation of optimal parameters
   for i in range(iterations):

      # Making predictions
      y_predicted = (current_weight * x) + current_bias

      # Calculating the current cost
      current_cost = mean_squared_error(y, y_predicted)

      # If the change in cost is less than or equal to stopping threshold we stop the gradient descent
      if previous_cost and abs(previous_cost - current_cost) <= stopping_threshold:
         break

      previous_cost = current_cost

      costs.append(current_cost)
      weights.append(current_weight)

      # Calculating the gradients
      weight_derivative = -(2/n) * sum(x * (y-y_predicted))
      bias_derivative = -(2/n) * sum(y-y_predicted)

      # Updating weights and bias
      current_weight = current_weight - (learning_rate * weight_derivative)
      current_bias = current_bias - (learning_rate * bias_derivative)

      # Printing the parameters for each 1000th iteration
      print(f"Iteration {i+1}: Cost {current_cost}, Weight \n {current_weight}, Bias {current_bias}")

   # Visualizing the weights and cost for all iterations
   plt.figure(figsize = = (8,6))
   plt.plot(weights, cost)
   plt.scatter(weights, cost, marker = 'o', color = 'red')
   plt.title("Cost vs Weights")
   plt.ylabel("Cost")
   plt.xlabel("Weights")
   plt.show()

   return current_weight, current_bias

def main()

   # Data
   X = np.array(32.5, 53.4, 61.5, 47.4, 59.8,
   55.1, 52.2, 39.2, 48.1, 52.5,
   45.4, 54.3, 44.1, 58.1, 56.7,
   48.9, 44.6, 60.2, 45.6, 38.8])
   Y = np.array(31.7, 68.7, 62.5, 71.5, 87.2,
   78.2, 79.6, 59.1, 75.3, 71.3,
   55.1, 82.4, 62.0, 75.3, 81.4,
   60.7, 82.8, 97.3, 48.8, 56.8])

   # Estimating weight and bias using gradient descent
   estimated_weight, estimated_bias = gradient_descent(X, Y, iterations = 2000)
   print(f"Estimated Weight: {estimated weight}\nEstimated Bias: {estimated bias}")

   # Making predictions using estimated parameters
   Y_pred = estimated_weight*X = estimated_bias

   #Plotting the regression line
   plt.figure(figsize = 8,6)
   plt.scatter(X, Y, marker = 'o', color = 'red')
   plt.plot([min(X), max(X)], [min(Y_pred), max(Y_pred)], color = 'blue')
   plt.ylabel("X")
   plt.xlabel("Y")
   plt.show()

if __name__=="__main__":
   main()
Keluaran kode di bawah ini akan seperti berikut:
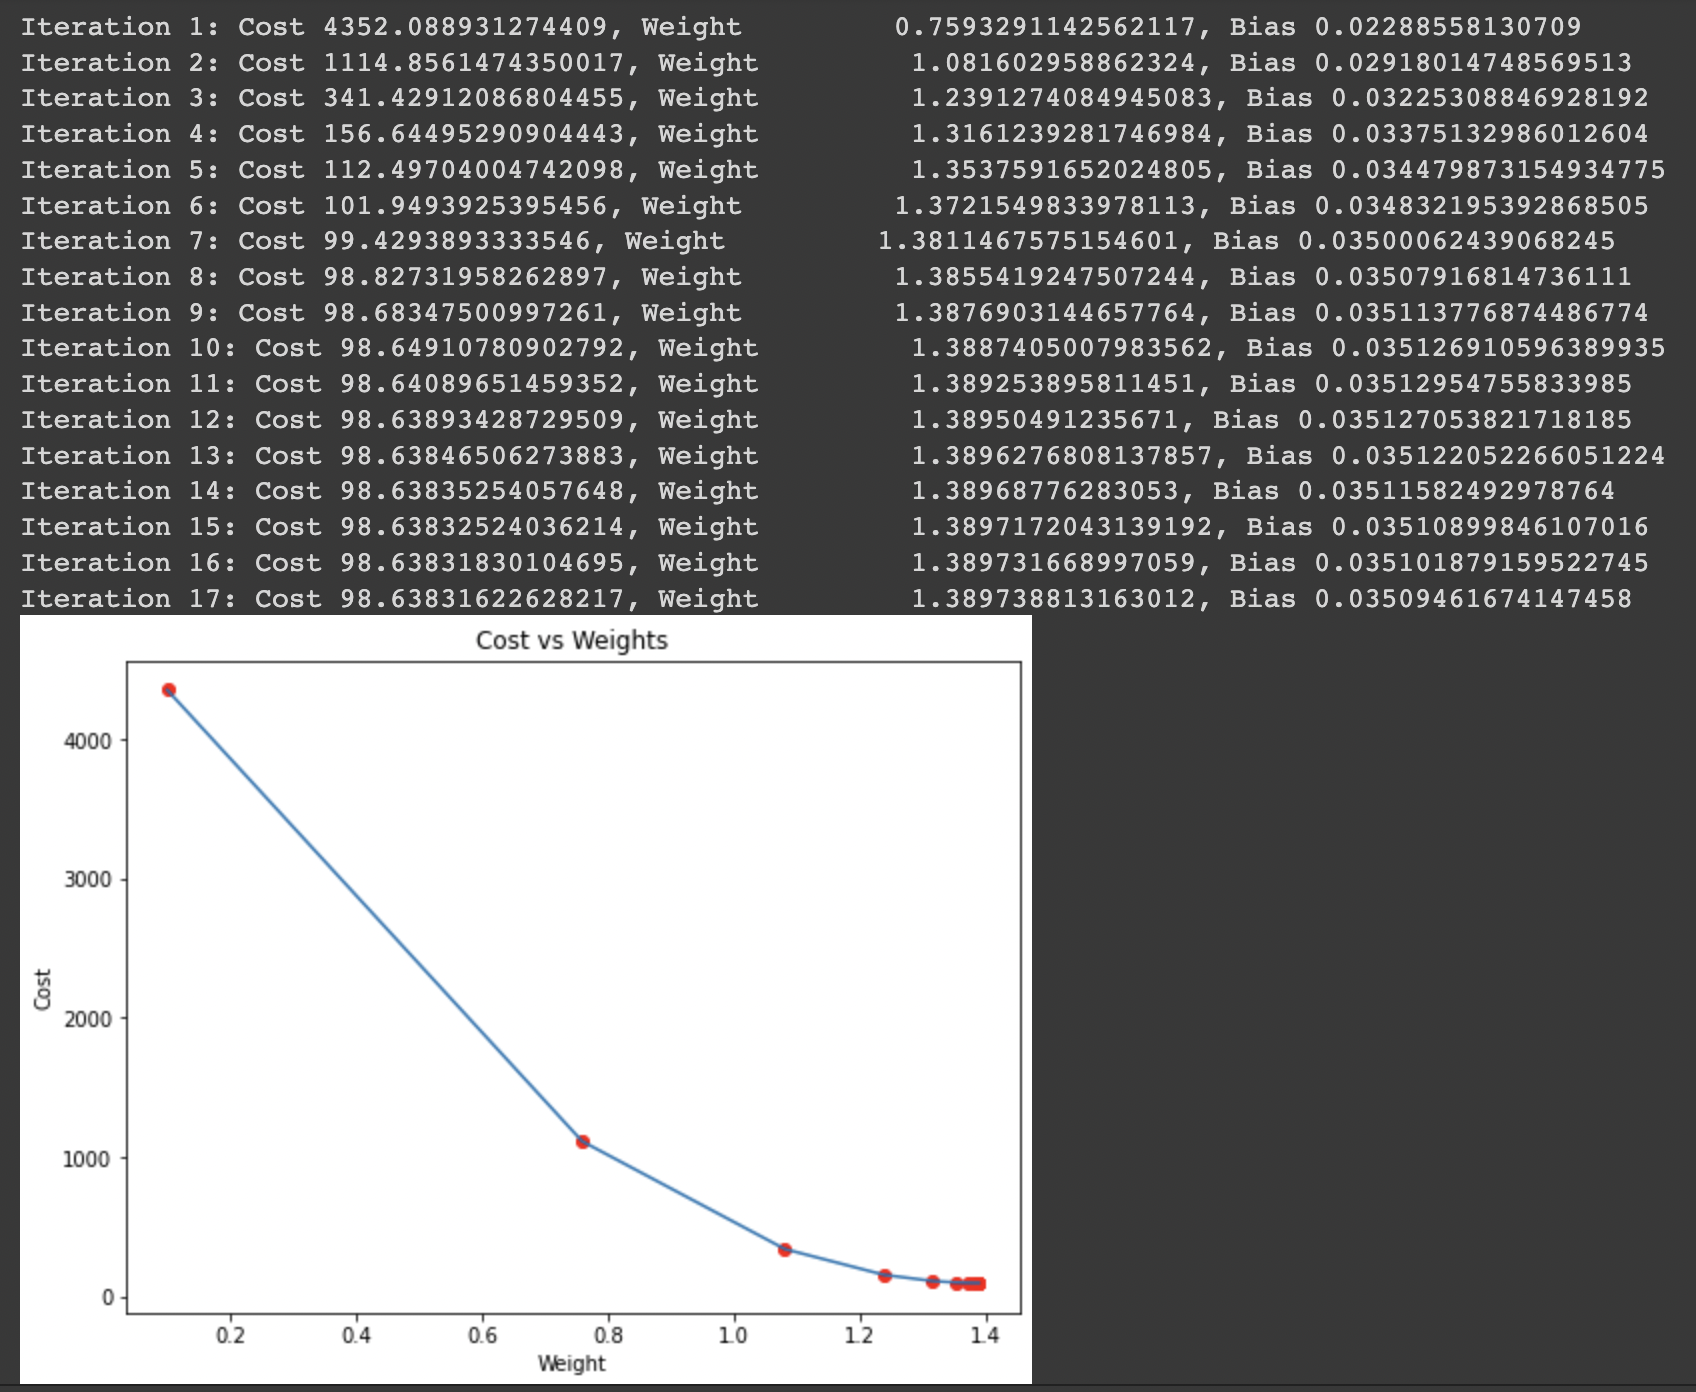
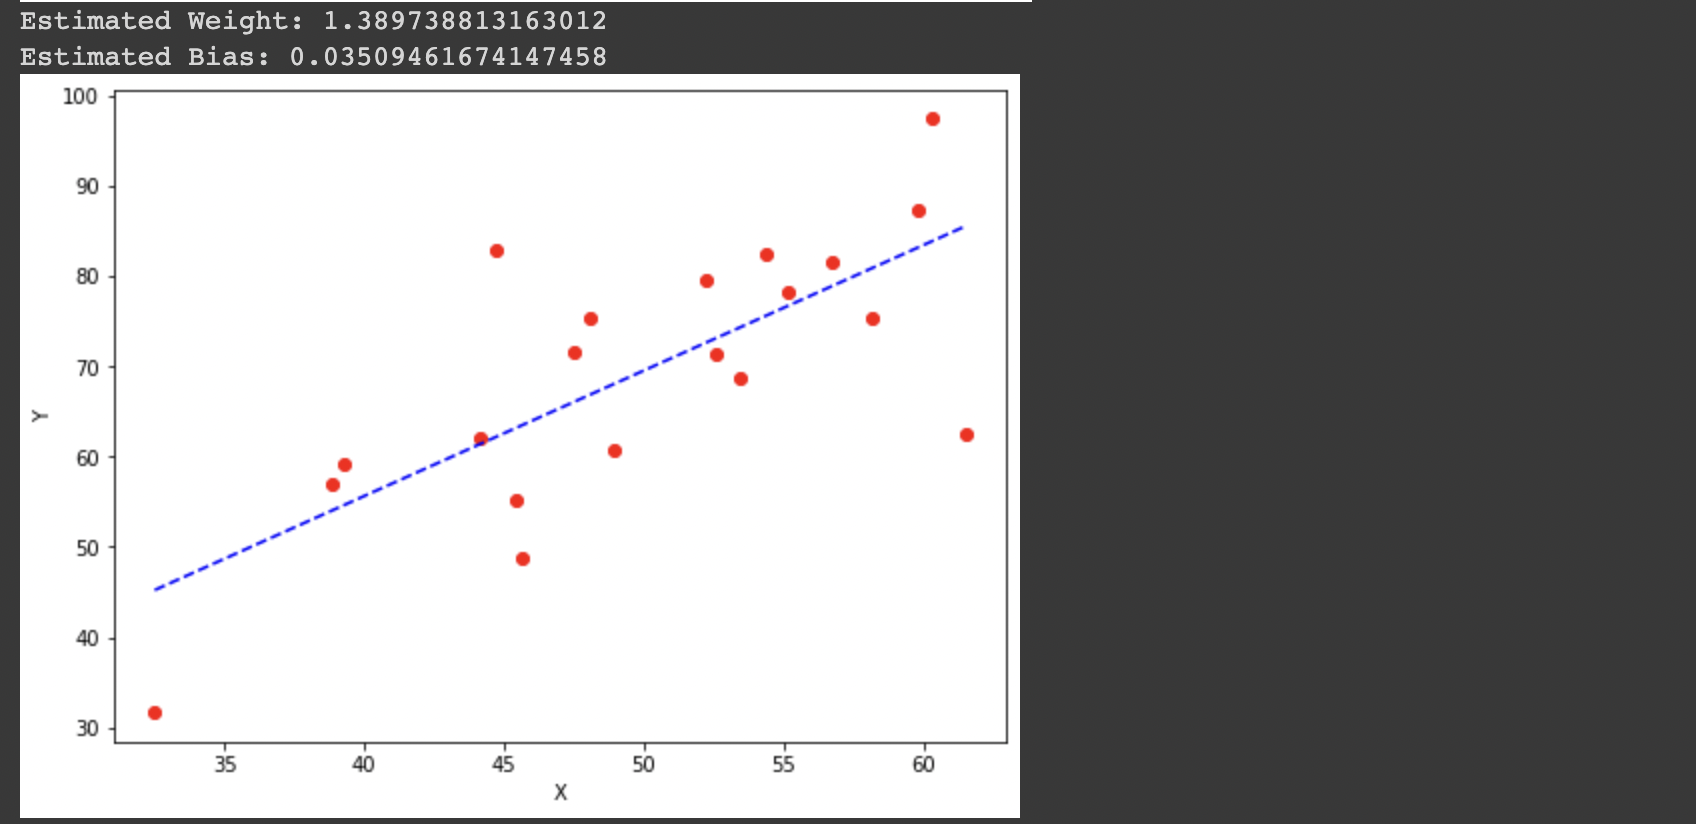
Anda dapat menguji dan menjalankan kode di atas dengan notebook ini.
Elemen lain yang penting untuk ditekankan adalah learning rate. Dalam machine learning, faktor seperti ini disebut hiperparameter karena bukan parameter model secara langsung, tetapi tetap berdampak pada kinerja akhir model (sama seperti parameter model).
Learning rate (sering dilambangkan α atau kadang η) menunjukkan kecepatan koefisien berubah. Kuantitas ini bisa tetap atau berubah. Salah satu metode yang saat ini populer adalah Adam, yang memiliki learning rate yang menyesuaikan seiring waktu.
Ada banyak skenario yang perlu diantisipasi dan dipertimbangkan saat menggunakan gradient descent:
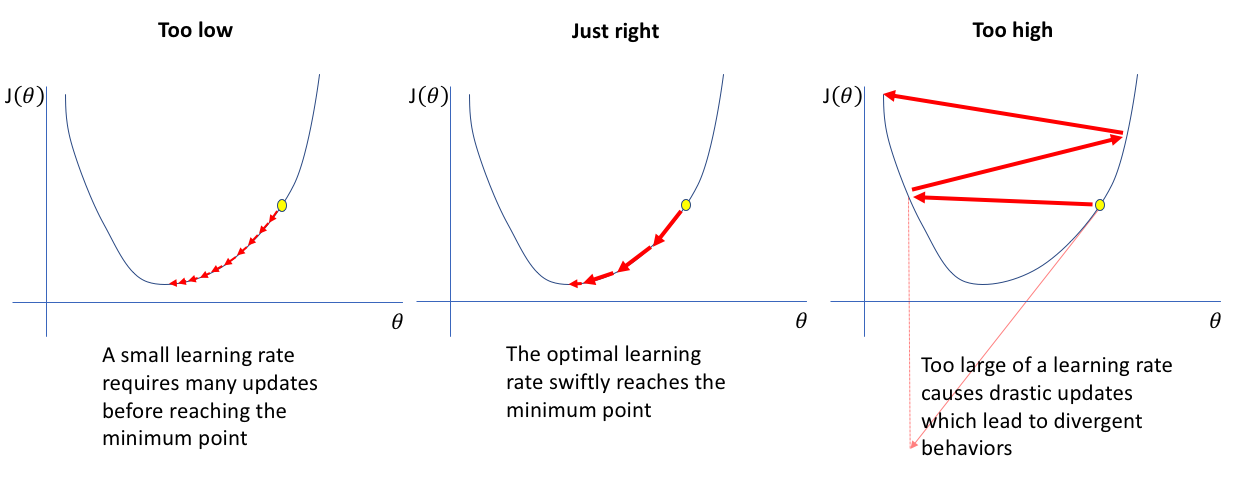
Jika learning rate terlalu besar, Anda akan melangkah terlalu jauh dalam gradient descent. Keuntungannya, Anda turun dengan cepat menuju minimum fungsi biaya, tetapi Anda berisiko melewatkan minimum tersebut dengan berosilasi di sekitarnya tanpa henti. Dalam analogi lembah, ini seperti Anda bergerak beberapa kilometer setiap kali, sehingga melewati tempat berlindung tanpa menyadarinya.
Untuk menghindari kasus sebelumnya, Anda mungkin tergoda memilih learning rate yang sangat rendah. Namun jika terlalu kecil, Anda berisiko membutuhkan waktu tak berhingga sebelum berkumpul ke minimum fungsi biaya. Ini seperti memilih bergerak milimeter demi milimeter di pegunungan untuk menemukan titik terendah di lembah.
Menetapkan learning rate pada nilai yang tepat sangat penting agar penurunan lereng mencapai minimum lokal. Karena itu, sebaiknya tidak ditetapkan terlalu tinggi atau terlalu rendah. Ini penting karena mencapai minimum bisa menjadi rumit dengan langkah yang terlalu panjang. Jika kita menetapkan learning rate ke nilai yang lebih rendah, gradient descent pada akhirnya mungkin mencapai minimumnya. Namun, ini bisa memakan waktu.
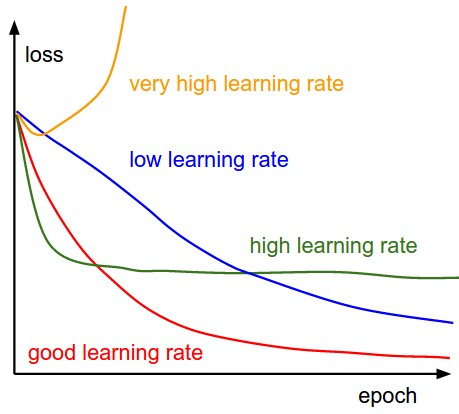
Sayangnya, tidak ada rumus ajaib untuk menemukan learning rate yang tepat. Sebagian besar waktu, Anda harus mencoba-coba dan menguji beberapa nilai sebelum menemukan yang pas. Ini disebut hyperparameter tuning, dan ada berbagai strategi untuk melakukannya dengan benar.
Cara yang bagus untuk memastikan operasi penurunan lereng berjalan optimal adalah dengan memplot fungsi biaya saat optimisasi berlangsung. Masukkan jumlah pengulangan pada sumbu X, dan nilai fungsi biaya pada sumbu Y. Ini akan membantu Anda melihat nilai fungsi biaya setelah setiap iterasi gradient descent sekaligus melacak kecocokan learning rate. Anda juga dapat mencoba nilai yang berbeda dan memplotnya bersama-sama.
Fungsi biaya akan menurun setelah setiap iterasi jika gradient descent berjalan optimal. Gradient descent berkonvergensi ketika tidak lagi mampu mengurangi fungsi biaya, dan tetap pada tingkat yang sama. Jumlah iterasi yang diperlukan untuk konvergensi sangat bervariasi. Terkadang membutuhkan lima puluh iterasi, terkadang bisa mencapai dua atau tiga juta. Sulit untuk memperkirakan jumlah iterasi sebelumnya.
Beberapa algoritme dapat memberi tahu Anda secara otomatis jika telah terjadi konvergensi dalam gradient descent. Namun, akan lebih baik untuk menetapkan ambang konvergensi di awal, yang juga cukup sulit diperkirakan. Ini adalah alasan penting mengapa plot sederhana paling baik untuk uji konvergensi.
Sementara para ilmuwan menggunakan gradient descent untuk menemukan nilai parameter suatu fungsi guna meminimalkan biaya fungsi, para programmer menggunakannya sebagai algoritme optimisasi saat melatih model machine learning. Gradient descent secara iteratif menyesuaikan sebagian parameternya untuk meminimalkan fungsi tertentu berdasarkan fungsi cembung.
Gradient descent mungkin adalah strategi optimisasi yang paling dikenal digunakan dalam deep learning dan machine learning. Data scientist sering menggunakannya saat ada kesempatan untuk menggabungkan tiap algoritme dengan model pembelajaran. Memahami algoritme gradient descent relatif sederhana, dan mengimplementasikannya bahkan lebih sederhana. Untuk menyelami lebih jauh ranah deep learning, lihat katalog lengkap kursus machine learning kami.
Belajar bersama DataCamp
Program
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



