
Program
Ilmuwan Pembelajaran Mesin dalam Python
85 jam
Bayangkan Anda mencoba mencari titik terendah di antara perbukitan sambil ditutup mata. Karena hanya mengandalkan sentuhan, Anda hanya bisa merasakan tanah di sekitar Anda untuk menentukan arah menurun. Inilah yang pada dasarnya dilakukan algoritma machine learning saat mereka mencoba menemukan solusi terbaik untuk suatu masalah.
Mereka memformulasikan masalah menjadi sebuah fungsi matematis yang input dan output-nya merepresentasikan permukaan berbukit. Menemukan nilai minimum dari fungsi ini berarti Anda telah mencapai solusi terbaik atas masalah tersebut. Salah satu algoritma paling populer untuk proses ini adalah Stochastic Gradient Descent (SGD).
Dalam tutorial ini, Anda akan mempelajari semua yang perlu diketahui tentang algoritma ini, termasuk intuisi awal tanpa matematika, detail matematisnya, dan cara mengimplementasikannya di Python.
Stochastic Gradient Descent (SGD) adalah teknik optimisasi yang digunakan dalam machine learning untuk meminimalkan galat pada model prediktif. Berbeda dari gradient descent biasa yang menggunakan seluruh dataset untuk menghitung gradien dan memperbarui parameter model, SGD memperbarui parameter menggunakan hanya satu titik data setiap kali. Ini membuatnya lebih cepat dan efisien untuk dataset besar, meskipun bisa lebih berisik dan kurang stabil. SGD membantu menemukan nilai optimal untuk parameter model guna meningkatkan akurasi prediksi.
Hal pertama yang perlu kita pahami sejak awal adalah bahwa stochastic gradient descent (SGD) bukanlah algoritma machine learning. Melainkan, ini hanyalah teknik optimisasi yang dapat diterapkan pada algoritma ML.
Lalu, apa itu optimisasi? Untuk memahaminya, mari kita mulai dari tahap pernyataan masalah dalam machine learning.
Misalkan kita mencoba memprediksi harga berlian berdasarkan nilai karatnya (satu karat adalah 0,2 gram). Ini adalah masalah regresi karena model menghasilkan nilai numerik.
Untuk menyelesaikan masalah ini, kita memiliki beragam algoritma, namun mari kita pilih Regresi Linier Sederhana, yang memiliki rumus sederhana f(x) = mx + b di mana:
b adalah harga dasar berlianm adalah kenaikan harga per karatx adalah nilai karat berlianf(x) adalah harga berlian yang diprediksiPersamaan linier ini merepresentasikan model kita. Tujuan kita adalah menemukan nilai terbaik untuk m dan b yang membuat prediksi kita seakurat mungkin di seluruh berlian dalam dataset.
Jika kita memiliki fitur lain dalam dataset, seperti volume berlian, rumus kita akan berubah menjadi f(x1, x2) = m1*x1 + m2*x2 + b, di mana:
b adalah harga dasar berlianm1 adalah kenaikan harga per karatm2 adalah kenaikan harga per satuan volumex1 adalah nilai karat berlianx2 adalah volume berlianf(x) adalah harga berlian yang diprediksiSekarang, kita perlu menemukan nilai optimal untuk m1, m2, dan b.
Secara umum, semua model machine learning memiliki persamaan seperti di atas dengan satu atau lebih parameter. Dengan demikian, definisi optimisasi dalam konteks ini menjadi: “Diberikan model dan dataset ini, temukan nilai optimal untuk parameter-parameter dalam persamaan.”
Ada banyak algoritma optimisasi yang dapat melakukan tugas ini, seperti Stochastic Gradient Descent yang menjadi fokus tutorial kita. Namun untuk benar-benar memahami cara kerja SGD, mari tinjau beberapa gagasan fundamental di baliknya.
Untuk memahami SGD, kita perlu mempelajari algoritma gradient descent biasa (GD), yang berbagi banyak gagasan dasar dengan versi stokastiknya. Gradient descent sederhana dimulai dari konsep galat dalam machine learning.
Algoritma ML biasanya menebak jawaban yang benar atas suatu masalah. Kita menyebut jawaban ini sebagai prediksi dan tidak selalu akurat. Jadi, kita memperkenalkan istilah baru yaitu “galat” atau “loss” yang merepresentasikan selisih antara jawaban sebenarnya dan prediksi model. Tujuan kita adalah membangun model yang meminimalkan galat ini.
Jika model kita f(x) menebak $10.000 untuk berlian yang sebenarnya berharga $12.000, maka galatnya adalah $2.000. Kita harus menyesuaikan model untuk mengurangi galat ini. Namun prediksi model harus baik untuk berlian mana pun, bukan hanya satu. Jadi, kita memerlukan cara untuk menggabungkan galat semua berlian dalam dataset. Di sinilah fungsi biaya (cost function) berperan.
Fungsi biaya menggabungkan semua galat individu menjadi satu angka yang merepresentasikan kinerja keseluruhan model kita. Biaya keseluruhan yang lebih rendah berarti prediksi model kita lebih baik.
Fungsi biaya berubah tergantung pada jenis masalah yang kita selesaikan.
Dalam masalah regresi, model memprediksi nilai numerik seperti berapa harga berlian atau berapa waktu yang dibutuhkan untuk berenang satu putaran. Dalam klasifikasi, model memprediksi kategori suatu objek. Misalnya, apakah jamur dapat dimakan atau tidak, atau apakah objek dalam gambar adalah kucing, anjing, atau kuda?
Ada jenis masalah lain, namun poin pentingnya adalah masing-masing membutuhkan fungsi biaya yang berbeda. Dalam tutorial ini, kita akan berfokus pada Mean Squared Error (MSE), yang sering digunakan dalam regresi.
Perbedaan antara nilai aktual (ground truth) dan prediksi model disebut galat atau loss. Konsekuensinya, fungsi yang menggabungkan semua galat atau loss ini disebut error function, loss function, atau cost function. Berbagai sumber mungkin menggunakan istilah ini secara bergantian; tutorial ini akan menggunakan istilah loss function mulai sekarang.
Dalam masalah regresi, umum dijumpai grafik yang memplot nilai aktual (ground truth) terhadap prediksi model.
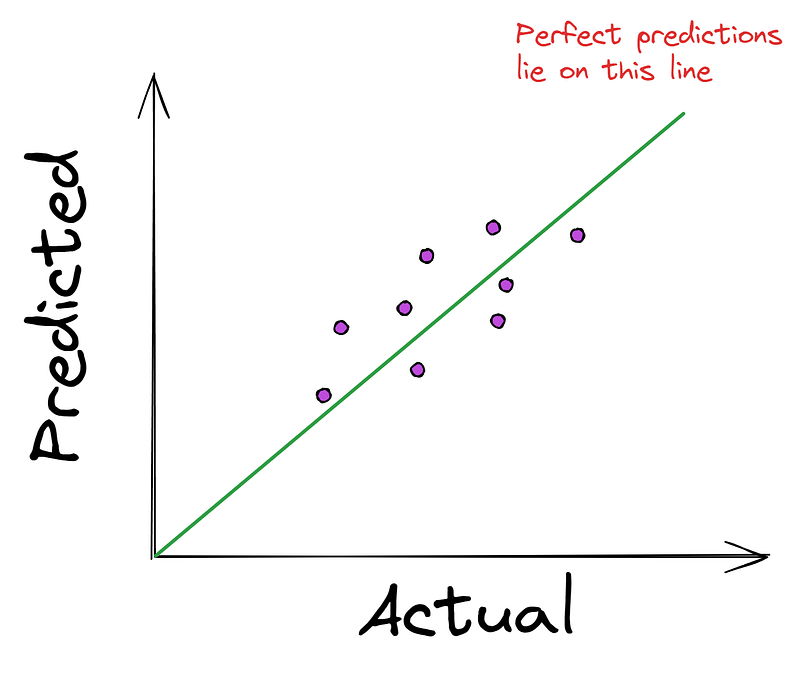
Semakin dekat titik-titik ke garis lurus, semakin baik prediksi model. Karena itu, sebagian besar algoritma regresi berusaha meminimalkan jarak rata-rata dari titik-titik ke garis sempurna. Dan seperti disebutkan sebelumnya, peminimalan terjadi menggunakan fungsi biaya seperti Mean Squared Error (MSE).
MSE mengambil nilai aktual dan prediksi sebagai input dan menghasilkan jarak kuadrat rata-rata ke garis sempurna.
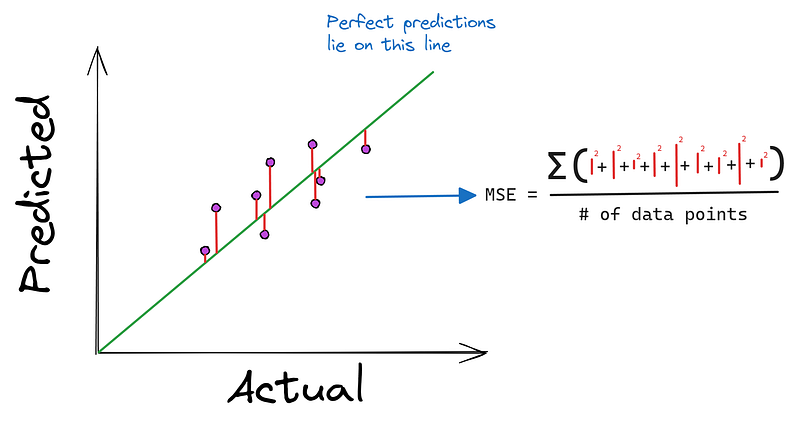
Anda mungkin bertanya, “Mengapa menguadratkan selisih alih-alih mengambil nilai absolutnya?” Alasan pertama adalah sangat mudah mencari turunan dari fungsi kuadrat. Selain itu, menguadratkan selisih menekankan galat yang lebih besar, memberi penalti pada model untuk prediksi terburuknya.
Itulah mengapa MSE lebih disukai dibanding fungsi alternatif seperti Mean Absolute Error (MAE), yang sekilas tampak lebih sederhana tetapi lebih sulit didiferensiasi.
Bagian selanjutnya dalam teka-teki gradient descent adalah gradien itu sendiri. Mari kembali ke analogi “menuruni bukit” untuk memahaminya lebih baik.
Kita berdiri di puncak bukit dengan mata tertutup dan ingin mencapai dasar secepat mungkin. Jika kita menuangkan air di kaki kita, ke mana arahnya mengalir? Air akan mengalir menuruni bukit ke arah turunan paling curam.
Inilah yang tepatnya diberitahukan gradien, tetapi dalam arah sebaliknya. Gradien menunjuk ke atas bukit—ke arah pendakian paling curam. Saat kita mencoba meminimalkan galat, kita cukup bergerak ke arah yang berlawanan dari gradien untuk menemukan jalan tercepat turun.
Secara matematis, gradien memberi tahu kita bagaimana keluaran suatu fungsi berubah saat kita mengubah masukannya. Lebih spesifik, gradien menunjuk ke arah di mana fungsi meningkat paling cepat.
Dalam konteks machine learning, saat kita mencoba meminimalkan galat menggunakan loss function, gradien menjadi panduan untuk menemukan jalur tercepat dalam mengurangi galat tersebut.
Gradien direpresentasikan sebagai vektor—satu untuk setiap parameter input dari fungsi kita. Setiap angka dalam vektor ini memberi tahu seberapa besar fungsi akan berubah jika kita melakukan penyesuaian kecil pada parameter yang bersesuaian.
Jadi, bagaimana Anda menemukan gradien suatu fungsi?
Untuk fungsi satu variabel seperti f(x) = x ** 2, gradien adalah turunan fungsi, yang diberikan sebagai vektor dengan satu elemen - [2x].
Untuk fungsi multivariabel seperti f(x1, x2) = x1 ** 3 - x2 ** 2, gradien berisi turunan parsial dari fungsi terhadap setiap input. Jadi, untuk fungsi kedua, vektor gradiennya adalah [3x1 ** 2, 2*x2].
Kembali ke MSE, yang memiliki rumus berikut:
MSE = (1/n) * Σ(y - f(x))² di mana:
f(x) adalah mx + bm dan b adalah variabel fungsix adalah nilai karat berliann adalah jumlah titik datay adalah harga aktual berlianJadi, gradiennya adalah turunan parsial dari MSE terhadap m dan b:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
The gradient = [∂/∂m (MSE), ∂/∂b (MSE)]
Jangan terlalu khawatir tentang rumus-rumus ini. Gagasan utamanya adalah bahwa rumus tersebut memberi tahu kita bagaimana mean squared error berubah jika kita mengubah m atau b sedikit saja.
Sekarang, kita memiliki semua yang dibutuhkan untuk mengeksekusi gradient descent atau, dengan kata lain, mencapai dasar bukit seefisien mungkin. Namun apakah kita melompat ke arah itu atau mengambil langkah kecil? Nah, itu ditentukan oleh gradien, bukan? Besarnya gradien memberi tahu kita seberapa jauh kita turun di setiap langkah.
Tetapi misalkan gradiennya begitu besar sehingga alih-alih mencapai dasar, kita justru melewati dan berakhir di puncak bukit lain dalam satu langkah. Mengejutkannya, ini sering terjadi dalam gradient descent, sehingga kita memperkenalkan parameter yang disebut ukuran langkah, yang mengendalikan efek gradien.
Sebelum melangkah, kita cukup mengalikan gradien dengan ukuran langkah, yang menurunkan magnitudonya. Misalnya, jika gradien kita menyarankan langkah 3,56 menurun, ukuran langkah 0,1 mengubah jarak menjadi 0,356.
Memang akan butuh waktu lebih lama untuk mencapai dasar, tetapi sekarang kita tidak berisiko melewatinya sama sekali.
Learning rate adalah sebutan lazim untuk ukuran langkah dalam machine learning dan biasanya bernilai antara 0,001 hingga 0,3.
Jadi, mari kita lihat versi matematis dari proses ini.
Pertama, kita memberi parameter m dan b pada model kita nilai acak:
m = 0.215  # Generated randomly
b = 0.059
Dengan ini, kita menghitung MSE awal pada seluruh dataset:
MSE = (1/n) * Σ(y - (0.215 * x + 0.059))² = ...Sekarang, untuk menurunkan galat ini, kita perlu mengambil langkah kecil ke arah yang berlawanan dari gradien, atau dengan kata lain, kita perlu memperbarui m dan b menggunakan gradien dan learning rate:
m_new = 0.215 - alpha * (∂/∂m (MSE))
b_new = 0.059 - alpha * (∂/∂b (MSE))
Sebagian besar referensi menggunakan alpha atau α (huruf Yunani) untuk menyatakan learning rate.
Setelah kita memperoleh nilai baru untuk m dan b, kita menghitung MSE lagi:
MSE_new = (1/n) * Σ(y - (m_new * x + b_new))²Sekarang, kita menghitung gradien lagi dan melanjutkan dengan cara ini hingga mencapai kondisi penghentian.
Pelajari secara visual bagaimana learning rate memengaruhi pelatihan dengan melihat artikel gradient descent ini.
Karena mata kita tertutup, kita tidak benar-benar bisa melihat kapan kita telah mencapai dasar, terutama saat mengambil langkah-langkah kecil.
Jadi, kita memerlukan beberapa kondisi untuk menghentikan penurunan. Biasanya, aturan berikut digunakan:
Aturan-aturan ini ditetapkan oleh Anda, engineer ML, saat melakukan gradient descent. Implementasi Python dari algoritma ini biasanya memiliki argumen untuk mengatur aturan-aturan ini dan kita akan melihat beberapa di antaranya nanti.
Kelebihan:
Tantangan:
Pada bagian selanjutnya, kita akan melihat bagaimana Stochastic Gradient Descent mengatasi sebagian tantangan ini, khususnya untuk dataset besar.
Setelah Anda memahami gradient descent biasa, SGD menjadi sangat mudah dipahami.
Meski gradient descent adalah salah satu algoritma optimisasi paling elegan, algoritma ini memiliki kelemahan signifikan saat menangani dataset besar. Ingat bahwa pada setiap langkah, kita menghitung gradien menggunakan semua titik data dalam dataset:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
Di sini, x dan y adalah array yang berisi semua nilai karat dan harga aktual berlian. Ini berarti kita akan menggunakan informasi setiap berlian untuk memperbarui parameter pada setiap langkah.
Seperti yang bisa Anda bayangkan, ini menjadi mahal secara komputasi dan memakan waktu saat kita memiliki jutaan titik data. Di era big data, keterbatasan ini dapat membuat gradient descent biasa menjadi tidak praktis untuk banyak masalah machine learning di dunia nyata.
“Stokastik” berarti “ditentukan secara acak”, dan itulah yang dilakukan SGD: memperkenalkan keacakan ke dalam proses optimisasi kita.
Alih-alih menggunakan semua titik data untuk menghitung gradien, SGD secara acak memilih satu titik data pada setiap langkah. Titik tunggal ini digunakan untuk menghitung estimasi gradien dan memperbarui parameter.
Karena SGD hanya melihat satu titik data pada satu waktu, ia dapat melakukan pembaruan parameter lebih sering. Ini memungkinkannya menelusuri permukaan galat (bukit) lebih cepat, terutama untuk dataset besar.
Namun, kecepatan ini datang dengan biaya. Karena kita menggunakan satu titik data untuk mengestimasi gradien seluruh dataset, estimasi kita jauh lebih berisik. Artinya, jalur kita menuruni permukaan galat menjadi kurang mulus dan lebih tidak menentu.
Untuk melakukan SGD, pertama-tama kita mendefinisikan sebuah fungsi biaya stokastik.
Alih-alih menghitung Mean Squared Error atas semua titik data, kini kita melihat galat kuadrat untuk satu titik yang dipilih secara acak:
Cost = (y - f(x))²Di mana y adalah harga aktual dari berlian yang dipilih secara acak, dan f(x) = mx + b adalah harga yang kita prediksi untuk berlian tersebut.
Lalu, kita menghitung gradien stokastik dari fungsi biaya ini terhadap parameter kita m dan b:
∂/∂m (Cost) = -2x(y - (mx + b))
∂/∂b (Cost) = -2(y - (mx + b))
The stochastic gradient = [∂/∂m (Cost), ∂/∂b (Cost)]
Dengan menggunakan gradien stokastik ini, kita memperbarui parameter dengan cara yang sama seperti gradient descent biasa:
m_new = m_old - learning_rate * ∂/∂m (Cost)
b_new = b_old - learning_rate * ∂/∂b (Cost)
Gagasan kunci dalam SGD adalah bahwa setiap langkah melibatkan satu titik data yang dipilih secara acak. Aturan kapan menghentikan penurunan tetap sama seperti pada gradient descent biasa.
Dalam praktiknya, SGD murni di mana parameter diperbarui untuk setiap contoh pelatihan jarang digunakan. Alasannya adalah pembaruan algoritma memiliki varians yang terlalu tinggi, yang dapat menyebabkan loss function berfluktuasi sehingga lebih sulit berkonsentrasi ke minimum yang tepat.
Gradient descent biasa kuat dan memberikan hasil yang lebih stabil, tetapi seperti disebutkan, ia menggunakan semua titik data pada setiap langkah, sehingga tidak praktis untuk dataset saat ini.
Untuk menyeimbangkan stabilitas dan kecepatan, mini-batch gradient descent sering digunakan, terutama pada jaringan saraf. Dalam mini-batch GD, alih-alih menggunakan satu sampel acak, sebuah batch sampel digunakan saat melakukan pembaruan parameter. Ukuran batch yang umum adalah 16, 32, 64, dan seterusnya.
Jadi, jika Anda menggunakan ukuran batch 1, maka itu adalah SGD. Jika ukuran batch sama dengan ukuran dataset, Anda memiliki gradient descent biasa. Ukuran batch selain nilai-nilai tersebut memberi Anda mini-batch gradient descent.
Berikut tabel yang merangkum perbedaannya dan kapan menggunakan masing-masing:
| Jenis | Frekuensi Pembaruan | Efisiensi Komputasi | Kebutuhan Memori | Stabilitas Konvergensi | Kasus Penggunaan Terbaik |
| Gradient Descent (GD) | Seluruh dataset per pembaruan | Paling lambat karena menggunakan seluruh dataset | Membutuhkan seluruh dataset di memori | Paling stabil, tetapi paling lambat | Dataset kecil di mana stabilitas sangat penting |
| Stochastic Gradient Descent (SGD) | Satu contoh per pembaruan | Paling cepat, memproses satu contoh pada satu waktu | Kebutuhan memori rendah | Varians tinggi, bisa berfluktuasi | Dataset besar yang membutuhkan pembaruan cepat |
| Mini-Batch Gradient Descent | Batch contoh per pembaruan | Menyeimbangkan efisiensi dan kecepatan, lebih efisien dari GD, lebih lambat dari SGD | Membutuhkan memori untuk satu batch | Lebih stabil daripada SGD, kurang stabil dibanding GD | Dataset besar yang membutuhkan keseimbangan stabilitas dan efisiensi |
Salah satu konsep penting dalam jenis algoritma optimisasi apa pun adalah epoch. Istilah ini mengacu pada satu kali putaran lengkap melalui seluruh dataset pelatihan.
Dalam satu epoch, algoritma memproses setiap sampel dalam dataset pelatihan tepat satu kali. Untuk setiap sampel (atau mini-batch sampel), model membuat prediksi, menghitung loss, dan memperbarui bobot sesuai gradien loss. Satu epoch menandai satu siklus peningkatan untuk model. Setelah setiap epoch, Anda biasanya dapat mengamati bagaimana kinerja model berubah.
Pelatihan biasanya melibatkan banyak epoch (setidaknya 10 direkomendasikan). Jumlah epoch adalah hiperparameter yang dapat Anda atur. Sering kali, data diacak sebelum setiap epoch untuk mencegah model mempelajari urutan contoh pelatihan.
Dalam analogi eksplorasi bukit dengan mata tertutup, sebuah epoch adalah satu eksplorasi lengkap seluruh lanskap. Selama setiap epoch, Anda:
Setelah setiap eksplorasi penuh, Anda mulai lagi dari posisi baru. Banyak epoch memberi model kesempatan berulang untuk mengeksplorasi lanskap loss, meningkatkan peluang menemukan minimum yang baik.
Namun, banyak epoch tidak menjamin menemukan minimum global, dan keseluruhan proses dapat dipengaruhi oleh faktor-faktor seperti titik awal atau kompleksitas lanskap loss.
Pada bagian ini, kita akan mengimplementasikan SGD dengan dukungan ukuran batch (mini-batch GD) hanya menggunakan Numpy.
Pertama, mari impor pustaka yang diperlukan:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Kita akan menggunakan 10.000 titik data dari dataset Diamonds yang tersedia di Seaborn. Kita hanya akan mengambil fitur carat dan kolom price sebagai target:
# Load the data
dataset_size = 10_000
diamonds = sns.load_dataset('diamonds')
# Extract the target and the feature
xy = diamonds[['carat', 'price']].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
(10000, 2)
Sekarang, mari kita bagi data menjadi set pelatihan dan pengujian, dengan ukuran pelatihan 80% dari total.
# Split the data
np.random.shuffle(xy)
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(8000, 2)
Lalu, mari kita definisikan fungsi model kita:
def model(m, x, b):
   """Simple linear model"""
   return m * x + b
Kita melakukan regresi linier sederhana dengan hanya dua variabel independen m dan b.
Kita juga harus mendefinisikan loss function MSE:
def loss(y_true, y_pred):
   """Mean squared error"""
   return np.mean((y_true - y_pred) ** 2)
Sekarang, kita mendefinisikan fungsi bernama stochastic_gradient_descent yang menerima enam argumen:
x dan y merepresentasikan fitur tunggal dan target dalam masalah kitaepochs menunjukkan berapa kali kita ingin melakukan penurunan (lebih lanjut tentang ini nanti)learning_rate adalah ukuran langkahbatch_size untuk mengendalikan seberapa sering kita melakukan pembaruan parameterstopping_threshold menetapkan nilai minimum penurunan loss pada setiap langkahdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD dengan dukungan untuk mini-batch.
"""Untuk memulai, kita menginisialisasi parameter yang ingin dioptimalkan dengan nilai acak dan menetapkan loss ke tak terhingga:
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infLalu, kita memulai loop for menggunakan parameter epochs. Di dalam loop, kita mengacak data agar perhitungan lebih andal:
for i in range(epochs):
# Shuffle the data
indices = np.random.permutation(n)
x = x[indices]
y = y[indices]Kemudian, perhitungan gradien sebenarnya dimulai di dalam loop for yang lain.
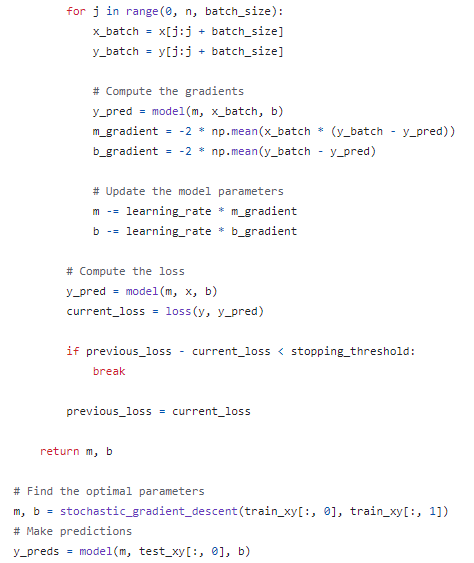
for j in range(0, n, batch_size):
x_batch = x[j:j + batch_size]
y_batch = y[j:j + batch_size]Kita mengekstrak batch dari x dan y dan menghitung gradien:
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)Kita menggunakan fungsi model yang kita buat sebelumnya untuk membuat prediksi dengan nilai m dan b saat ini. Lalu, kita mencari turunan parsial yang membentuk gradien menggunakan rumus yang disebutkan pada bagian sebelumnya.
Menggunakan turunan parsial dan learning rate, kita memperbarui parameter:
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientBerikut adalah kode lengkap sejauh ini:
def stochastic_gradient_descent(
   x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
   """
   SGD dengan dukungan untuk mini-batch.
   """
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x)
previous_loss = np.inf
for i in range(epochs):
   # Shuffle the data
   indices = np.random.permutation(n)
   x = x[indices]
   y = y[indices]
for j in range(0, n, batch_size):
   x_batch = x[j:j + batch_size]
   y_batch = y[j:j + batch_size]
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientMelanjutkan fungsi di luar loop bagian dalam, kita menghitung loss untuk epoch tersebut:
# Compute the loss
y_pred = model(m, x, b)
current_loss = loss(y, y_pred)
Jika current_loss lebih kecil daripada stopping_threshold kita menghentikan seluruh proses:
if previous_loss - current_loss < stopping_threshold:
   break
previous_loss = current_loss
Jika tidak, kita set previous_loss ke current_loss. Pada akhirnya, kita mengembalikan parameter m dan b yang telah dioptimalkan:
return m, bSaya telah menempelkan seluruh kode ke GitHub gist ini agar Anda dapat melihat gambaran lengkapnya.
Mari uji seberapa baik parameter yang ditemukan dengan menjalankan model pada set uji:
# Find the optimal parameters
m, b = stochastic_gradient_descent(train_xy[:, 0], train_xy[:, 1])
# Make predictions
y_preds = model(m, test_xy[:, 0], b)
# Compute and print the loss
mean_squared_error = loss(test_xy[:, 1], y_preds)
mean_squared_error ** 0.5
1595.3955619759456
Akar kuadrat MSE sekitar $1.600, yang berarti model kita meleset sekitar $1.600 rata-rata. Untuk meningkatkan galat, kita dapat menambah jumlah epoch atau menggunakan dataset yang lebih besar.
Implementasi SGD pada bagian sebelumnya masih kasar dan tidak efisien. Implementasi itu hanya untuk memperkokoh intuisi yang telah kita bangun di bagian sebelumnya melalui penelusuran kode.
Dalam praktik, Anda hampir tidak pernah mengimplementasikan SGD secara manual tetapi menggunakan versi yang sudah tersedia di framework populer.
Sebagai contoh, Scikit-learn menyediakan estimator SGDRegressor dan SGDClassifier untuk melatih berbagai algoritma ML seperti:
dengan SGD sebagai algoritma optimisasi.
from sklearn.linear_model import SGDRegressor, SGDClassifier
# SGD for Linear Regression with 1000 epochs
regressor = SGDRegressor(loss='squared_loss', max_iter=1000)
Di PyTorch, tersedia sebagai kelas SGD di dalam modul optim:
import torch.optim as optim
optimizer = optim.SGD(model.parameters(), lr=0.01)
Untuk mempelajari pelatihan model dan mengoptimalkannya di PyTorch, lihat kursus Introduction to PyTorch dari DataCamp.
Di Keras, SGD tersedia dengan nama yang sama:
from tensorflow.keras.optimizers import SGD
optimizer = SGD(learning_rate=0.01)
Untuk mempelajari pelatihan model dan mengoptimalkannya di TensorFlow, lihat kursus Introduction to TensorFlow dari DataCamp.
Ada banyak praktik terbaik dan tips untuk menggunakan SGD atau algoritma serupa. Di bawah ini, kami uraikan beberapa di antaranya:
Hari ini, kita telah mempelajari salah satu algoritma optimisasi kunci dalam machine learning—Stochastic Gradient Descent.
Pertama, kita membangun intuisi dan gagasan dasarnya dengan mempertimbangkan algoritma gradient descent biasa. Kita banyak menggunakan analogi perbukitan di mana kita mencoba menemukan dasar sambil ditutup mata.
Kita telah mempelajari bahwa SGD dan GD biasa berbeda pada jumlah titik data yang digunakan saat melakukan pembaruan parameter. Untuk memperkokoh intuisi dan mengulas detail matematisnya, kita telah mengimplementasikan SGD di Numpy.
Harap ingat bahwa SGD hanyalah bagian dari keseluruhan proses pelatihan ML. Untuk mempelajari lebih lanjut tentang perannya, lihat sumber berikut:
Kursus Teratas DataCamp
Program
Program
Program
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




