Programma
Scienziato specializzato in apprendimento automatico in Python
85 ore
La discesa del gradiente è uno degli algoritmi più importanti in tutto il machine learning e deep learning. È un algoritmo di ottimizzazione estremamente potente che può addestrare modelli di regressione lineare, regressione logistica e reti neurali. Se stai iniziando con il machine learning, è quindi fondamentale capire a fondo l'algoritmo della discesa del gradiente.
La data science riguarda la scoperta di schemi e comportamenti complessi nell'analisi di grandi quantità di dati. Questi sono chiamati "pattern", cioè motivi ricorrenti. Con il machine learning, si tratta di addestrare algoritmi a riconoscere pattern nei dati per svolgere meglio un compito specifico. Significa insegnare al software a eseguire un compito o fare previsioni in modo autonomo. Per farlo, il data scientist seleziona e addestra algoritmi per eseguire l'analisi dei dati. L'obiettivo è, naturalmente, migliorare le previsioni nel tempo.
Di conseguenza, il machine learning si basa in gran parte sull'addestramento degli algoritmi. Più questi algoritmi sono esposti ai dati, più imparano a svolgere un compito senza istruzioni specifiche; imparano dall'esperienza. Nel machine learning usiamo diversi tipi di algoritmi. Tra questi, la discesa del gradiente è uno dei più utili e popolari.
La discesa del gradiente è un algoritmo di ottimizzazione. Viene usato per trovare più rapidamente il valore minimo di una funzione. La definizione di discesa del gradiente è piuttosto semplice: è un algoritmo per trovare il minimo di una funzione convessa. Per farlo, modifica iterativamente i parametri della funzione in questione. È un algoritmo utilizzato, ad esempio, nella regressione lineare.
Una funzione convessa assomiglia a una bella valle con un minimo globale al centro. Al contrario, una funzione non convessa ha diversi minimi locali e l'algoritmo di discesa del gradiente non dovrebbe essere usato su queste funzioni, con il rischio di bloccarsi al primo minimo incontrato.
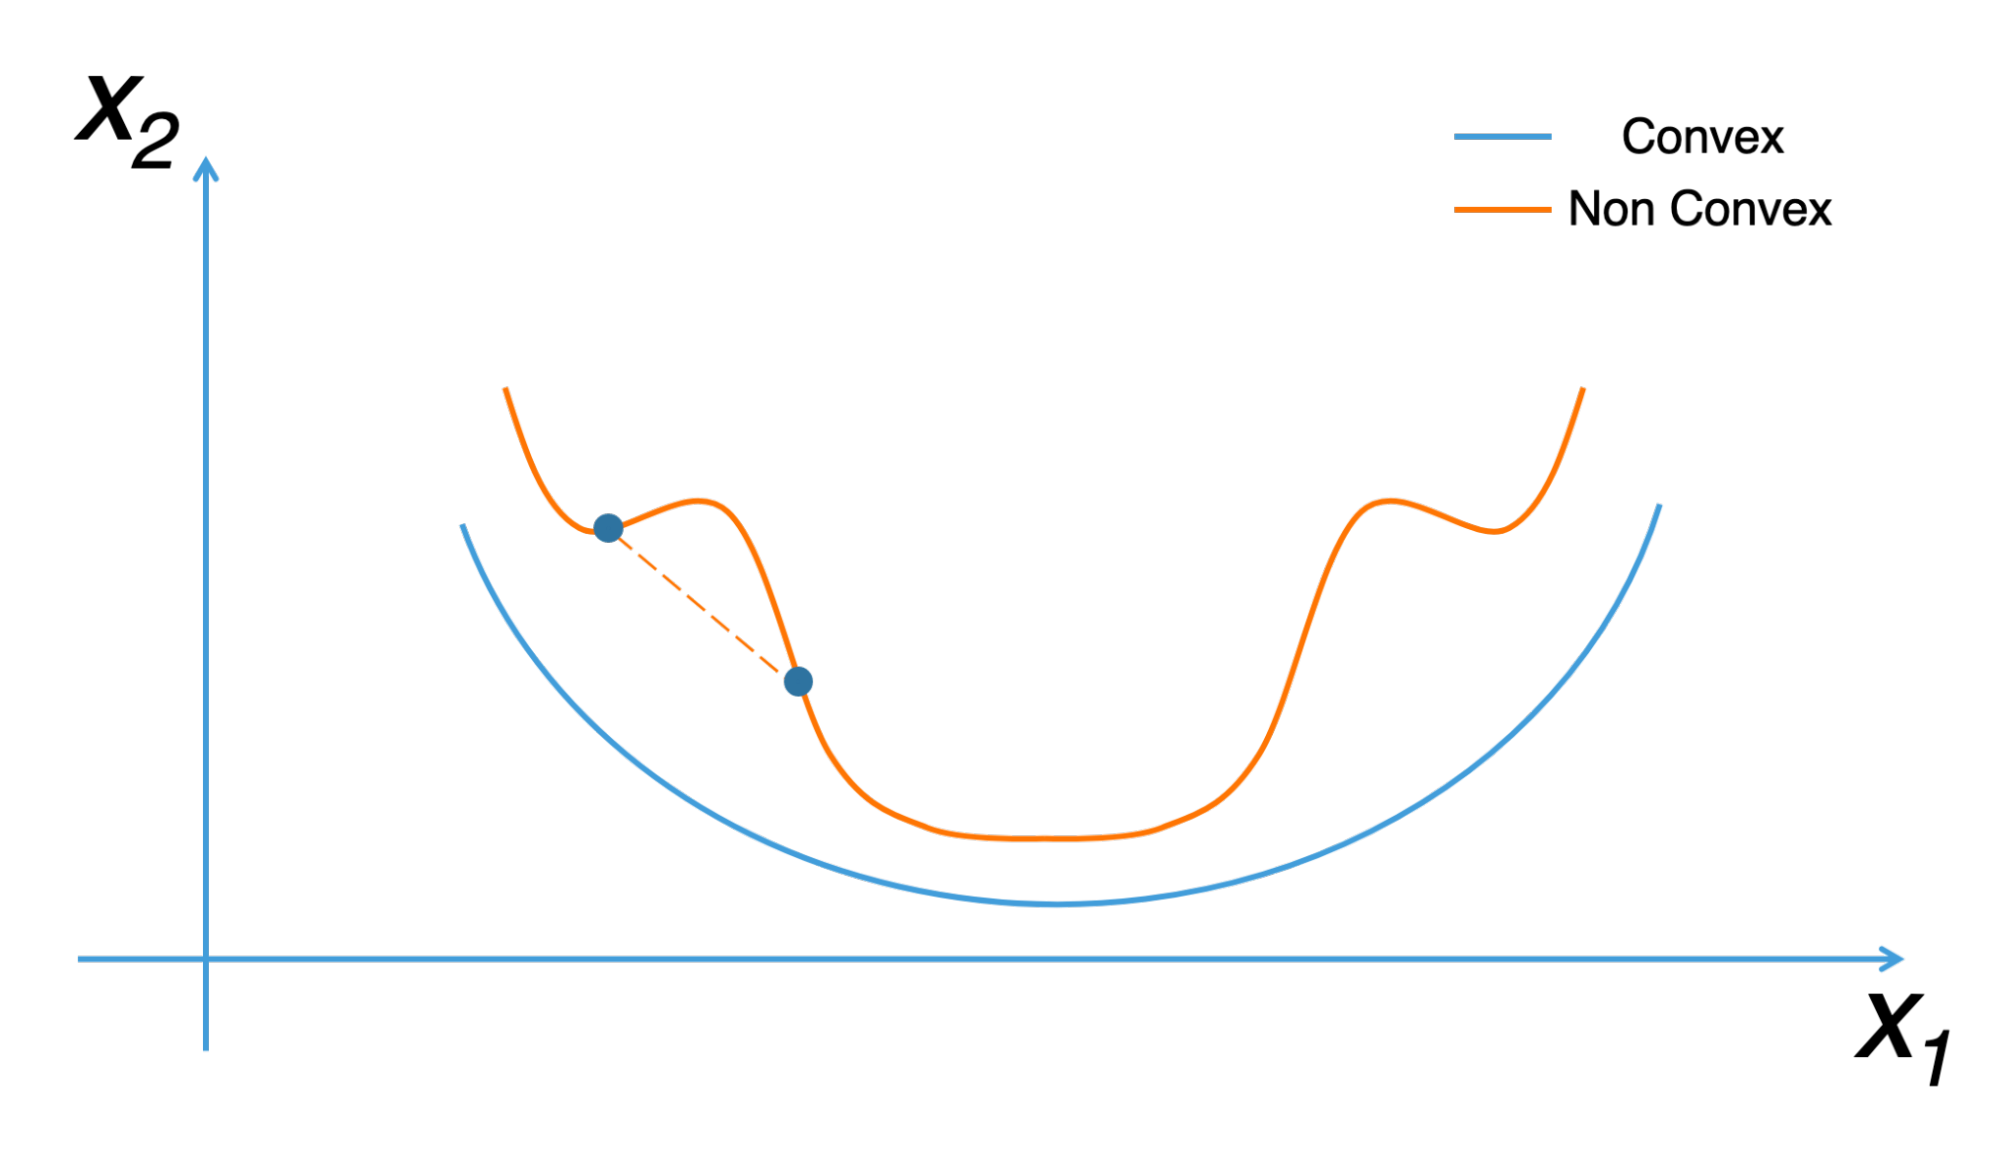
La discesa del gradiente è anche chiamata “algoritmo della massima pendenza discendente”. È molto importante nel machine learning, dove viene usata per minimizzare una funzione di costo. Quest'ultima serve a determinare il miglior modello di previsione nell'analisi dei dati. Più il costo è minimizzato, più la macchina sarà in grado di fare buone previsioni.
Esistono tre tipi noti di discesa. Vediamoli più da vicino:
Conosciuta anche come vanilla gradient descent, la batch gradient descent calcola gli errori per ogni esempio nel dataset di addestramento. Tuttavia, lo fa solo dopo che ogni esempio di addestramento è stato valutato con rigore. È corretto paragonare questo processo a un ciclo. Alcuni lo chiamano anche un'epoca di addestramento.
La discesa batch ha diversi vantaggi. In particolare, la sua efficienza computazionale è estremamente pratica perché sviluppa una convergenza stabile e un gradiente di errore stabile. Detto ciò, presenta anche alcuni svantaggi. A volte, il gradiente di errore stabile può portare a uno stato di convergenza sfavorevole. Inoltre, richiede la presenza del dataset di addestramento nell'algoritmo e in memoria.
La discesa del gradiente stocastica fornisce aggiornamenti dei parametri per ciascun esempio di addestramento. Consente di prestare attenzione a ogni esempio, garantendo che il processo sia esente da errori. A seconda del problema, questo può aiutare la SGD a risultare più veloce rispetto alla batch gradient descent. I suoi aggiornamenti regolari ci forniscono tassi di miglioramento dettagliati.
Detto questo, questi aggiornamenti sono costosi dal punto di vista computazionale, soprattutto se confrontati con l'approccio usato dalla discesa a passi. Inoltre, la frequenza degli aggiornamenti può causare gradienti rumorosi e potrebbe impedire la diminuzione del tasso di errore. Invece, il tasso di errore salta e diventa problematico nel lungo periodo.
Gli scienziati usano la mini-batch gradient descent come metodo di partenza. Perché? Perché è una perfetta combinazione dei concetti di discesa stocastica e discesa batch. Divide i dataset di addestramento in batch ed esegue un aggiornamento per ciascun batch, creando un equilibrio tra l'efficienza della BGD e la robustezza della SGD.
I mini-batch più comuni vanno da cinquanta a duecentocinquantasei, ma, come molte altre tecniche di machine learning, non ci sono regole rigide: varia da applicazione ad applicazione. Si usa come opzione di base per addestrare reti neurali. È anche un tipo popolare di discesa della collina nel panorama del deep learning.
Nel machine learning, usiamo l'algoritmo della discesa del gradiente in problemi di apprendimento supervisionato per minimizzare la funzione di costo, che è una funzione convessa (per esempio, l'errore quadratico medio).
Grazie a questo algoritmo, la macchina impara trovando il modello migliore. Ricorda che minimizzare la funzione di costo significa trovare i parametri a, b, c, ecc., che danno gli errori più piccoli tra il nostro modello e i punti y del dataset. Una volta minimizzata la funzione di costo, questo apre la strada alla costruzione di programmi accurati di riconoscimento vocale, visione artificiale e applicazioni per prevedere il prezzo del mercato azionario.
Capisci quindi perché l'algoritmo della discesa del gradiente è fondamentale: è da qui che la macchina impara.
Per illustrare meglio il funzionamento e l'utilità di questo algoritmo, spesso si usa l'analogia della montagna. Immaginiamo una persona che si è persa in montagna. In sostanza, si tratta di ritrovare la strada cercando prima la direzione con la pendenza più ripida verso il basso. Dopo aver seguito questa direzione per una certa distanza, il metodo va ripetuto finché non si raggiunge una valle (il valore più basso). Nel machine learning, la discesa del gradiente consiste nel ripetere questo metodo in un ciclo finché non si trova un minimo per la funzione di costo. Per questo si parla di algoritmo iterativo e per questo richiede molti calcoli.
Ecco una strategia in 2 passaggi utile se ti perdi in montagna:
Ripetendo i passi 1 e 2 in un ciclo, sei sicuro di convergere verso il minimo della valle. Questa strategia non è altro che l'algoritmo della discesa del gradiente.
Partiamo da un punto iniziale casuale e poi misuriamo il valore della pendenza in quel punto. In matematica, si misura una pendenza calcolando la derivata della funzione.
Procediamo quindi per una certa distanza d nella direzione della pendenza, che scende, ma non 300 metri questa volta. Questa distanza si chiama “learning rate”. Il risultato di questa operazione è la modifica del valore dei parametri del nostro modello (le nostre coordinate nella valle cambiano quando ci muoviamo).
L'algoritmo della discesa del gradiente è usato soprattutto nei campi del machine learning e del deep learning. Quest'ultimo può essere considerato una versione evoluta del machine learning: permette di rilevare i pattern più sottili. Sono discipline che richiedono una solida base di matematica e di Python.
Questo linguaggio di programmazione ha diverse librerie che facilitano l'applicazione del machine learning. Questa disciplina è molto utile per analizzare grandi volumi di dati in modo accurato e rapido. Consente analisi predittive basate su tendenze o eventi passati.
Il machine learning è una delle scienze strettamente collegate al big data in termini di opportunità da sfruttare. Permette di superare i limiti dell'intelligenza umana nell'analisi di grandi flussi di dati. Con i vasti dataset disponibili online, l'intelligenza artificiale (AI) può imparare da sola senza intervento umano. Il machine learning è usato, per esempio, nel campo degli oggetti connessi. Grazie ad esso, un'AI può adattarsi alle abitudini degli occupanti di una casa connessa ed eseguire i suoi compiti tenendo conto di queste abitudini.
Per esempio, l'AI può regolare il riscaldamento di una stanza in base al meteo. È questa scienza che ci permette anche di avere robot aspirapolvere sempre più sofisticati. La discesa del gradiente, attraverso il machine learning, è al cuore dei grandi progressi dell'intelligenza artificiale. In pratica, ci sono molte applicazioni della discesa del gradiente da parte di ingegneri e specialisti di AI.
È utile per motori di ricerca come Google e per i popolari motori di raccomandazione come YouTube, Netflix o Amazon. In base ai dati raccolti dagli utenti, gli algoritmi cercheranno di capire gli interessi dell'utente. Ciò consentirà di offrire risultati di ricerca pertinenti e raccomandazioni migliori.
Il machine learning ha permesso ai computer di comprendere e processare il linguaggio umano. È questa applicazione che ha dato vita ad assistenti digitali come Alexa, Google Assistant e Siri. Il machine learning e le applicazioni della discesa del gradiente sono molto utili anche per gli sviluppatori di videogiochi. Qui l'obiettivo è permettere alle AI di eccellere nei compiti più umani, così che le persone possano concentrarsi su attività a maggior valore aggiunto. Intelligenza artificiale e machine learning consentono alle aziende di anticipare le esigenze dei clienti e le tendenze future.
La discesa del gradiente è un algoritmo usato nella regressione lineare a causa della complessità computazionale. La formula matematica generale della discesa del gradiente è xt+1 = xt - η∆xt, con η che rappresenta il learning rate e ∆xt la direzione di discesa. La discesa del gradiente è un algoritmo applicabile a funzioni convesse. Indicando con ƒ una funzione convessa da minimizzare, l'obiettivo sarà ottenere ƒ(xt+1) ≤ ƒ (xt) a ogni iterazione.
L'idea qui è usare questo algoritmo che calcolerà gradualmente il minimo di una funzione matematica. Di fronte a certe equazioni, è il modo migliore per risolverle. Quando parliamo di discesa del gradiente, dobbiamo anche comprendere la nozione di funzione di costo. In modalità supervisionata, questa funzione consente di misurare il margine d'errore tra una stima e il valore reale. La formula per calcolare il gradiente quadratico medio nel caso di un problema di regressione lineare è la seguente:
L'applicazione della discesa del gradiente usa anche la nozione di learning rate. È un iperparametro che consente di controllare l'aggiustamento dei pesi della rete rispetto al gradiente della perdita. Va notato che un learning rate ottimale è molto importante per ottenere un minimo in modo più rapido ed efficiente. Non deve essere né troppo alto né troppo basso.
Man mano che il valore scende, mostra che ci si sta spostando gradualmente lungo la pendenza verso il basso. Diversi metodi di ottimizzazione usano l'algoritmo della discesa del gradiente, come RMSprop, Adam e SGD. Per non commettere errori nell'uso di questo algoritmo, si raccomanda di scegliere con cura i suoi parametri. Bisogna anche tenere presente che il minimo trovato potrebbe non essere un minimo globale.
La funzione primaria di un gradiente è misurare la variazione di ciascun peso rispetto alla variazione degli errori. Pensa ai gradienti come alla pendenza di una funzione. Più il gradiente è alto, più la pendenza è ripida: questa è una condizione favorevole per i modelli perché possono imparare rapidamente. Tuttavia, il modello smetterà di imparare se la pendenza diventa zero. In termini matematici, un gradiente può essere descritto come una derivata finita rispetto ai suoi input.
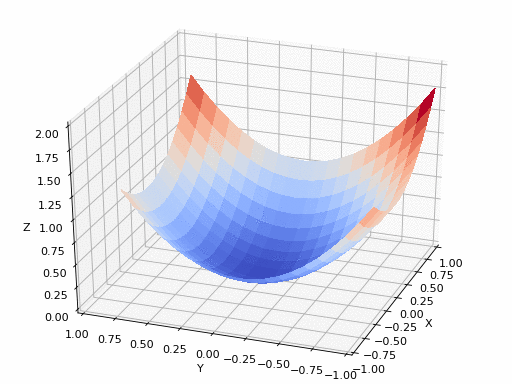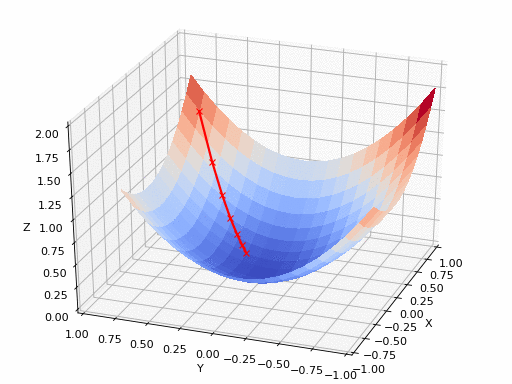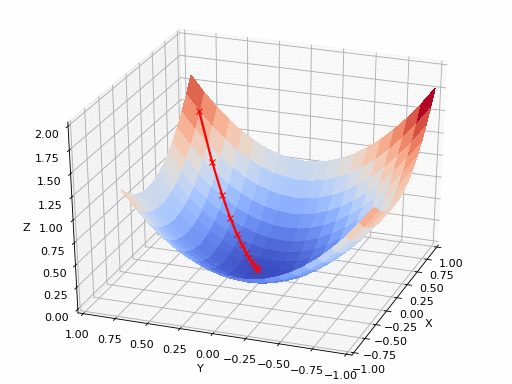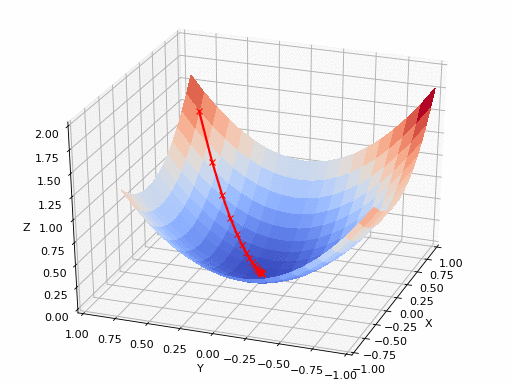
Nella parte di implementazione, scriveremo due funzioni. Una sarà la funzione di costo che prende in input l'output reale e quello predetto e restituisce la perdita. La seconda sarà la funzione vera e propria di discesa del gradiente che prende in input la variabile indipendente e la variabile target (dipendente) e trova la retta di miglior adattamento usando l'algoritmo della discesa del gradiente.
Iterazioni, learning rate e soglia di arresto sono i parametri di tuning dell'algoritmo della discesa del gradiente e possono essere impostati dall'utente. Nella funzione principale, inizializzeremo dati linearmente correlati casuali e applicheremo l'algoritmo della discesa del gradiente sui dati per trovare la retta di miglior adattamento. Il peso e il bias ottimali trovati con l'algoritmo della discesa del gradiente vengono quindi usati per tracciare la retta di best fit nella funzione principale.
#Importing libraries
import numpy as np
import matplotlib as pyplot

def mean_squared_error(y_true, y_predicted):

   # Calculating the loss or cost
   cost = np.sum((y_true-y_predicted)**2) / len(y_true)
   return cost

# Gradient descent function
# Here iterations, learning rate, stopping threshold are hyperparameters that can be tuned
def gradient_descent((x, y, iterations = 1000, learning_rate = 0.0001, stopping_theshold = 1e-6):

   #Initialzing rate, bias, learning rate, and iterations
   current_rate = 0.1
   current_bias = 0.01
   iterations = iterations
   learning_rate = learning_rate
   n = float(len(x))

   costs = []
   weights = []
   previous_cost = None

   # Estimation of optimal parameters
   for i in range(iterations):

      # Making predictions
      y_predicted = (current_weight * x) + current_bias

      # Calculating the current cost
      current_cost = mean_squared_error(y, y_predicted)

      # If the change in cost is less than or equal to stopping threshold we stop the gradient descent
      if previous_cost and abs(previous_cost - current_cost) <= stopping_threshold:
         break

      previous_cost = current_cost

      costs.append(current_cost)
      weights.append(current_weight)

      # Calculating the gradients
      weight_derivative = -(2/n) * sum(x * (y-y_predicted))
      bias_derivative = -(2/n) * sum(y-y_predicted)

      # Updating weights and bias
      current_weight = current_weight - (learning_rate * weight_derivative)
      current_bias = current_bias - (learning_rate * bias_derivative)

      # Printing the parameters for each 1000th iteration
      print(f"Iteration {i+1}: Cost {current_cost}, Weight \n {current_weight}, Bias {current_bias}")

   # Visualizing the weights and cost for all iterations
   plt.figure(figsize = = (8,6))
   plt.plot(weights, cost)
   plt.scatter(weights, cost, marker = 'o', color = 'red')
   plt.title("Cost vs Weights")
   plt.ylabel("Cost")
   plt.xlabel("Weights")
   plt.show()

   return current_weight, current_bias

def main()

   # Data
   X = np.array(32.5, 53.4, 61.5, 47.4, 59.8,
   55.1, 52.2, 39.2, 48.1, 52.5,
   45.4, 54.3, 44.1, 58.1, 56.7,
   48.9, 44.6, 60.2, 45.6, 38.8])
   Y = np.array(31.7, 68.7, 62.5, 71.5, 87.2,
   78.2, 79.6, 59.1, 75.3, 71.3,
   55.1, 82.4, 62.0, 75.3, 81.4,
   60.7, 82.8, 97.3, 48.8, 56.8])

   # Estimating weight and bias using gradient descent
   estimated_weight, estimated_bias = gradient_descent(X, Y, iterations = 2000)
   print(f"Estimated Weight: {estimated weight}\nEstimated Bias: {estimated bias}")

   # Making predictions using estimated parameters
   Y_pred = estimated_weight*X = estimated_bias

   #Plotting the regression line
   plt.figure(figsize = 8,6)
   plt.scatter(X, Y, marker = 'o', color = 'red')
   plt.plot([min(X), max(X)], [min(Y_pred), max(Y_pred)], color = 'blue')
   plt.ylabel("X")
   plt.xlabel("Y")
   plt.show()

if __name__=="__main__":
   main()
L'output del codice seguente sarà il seguente:
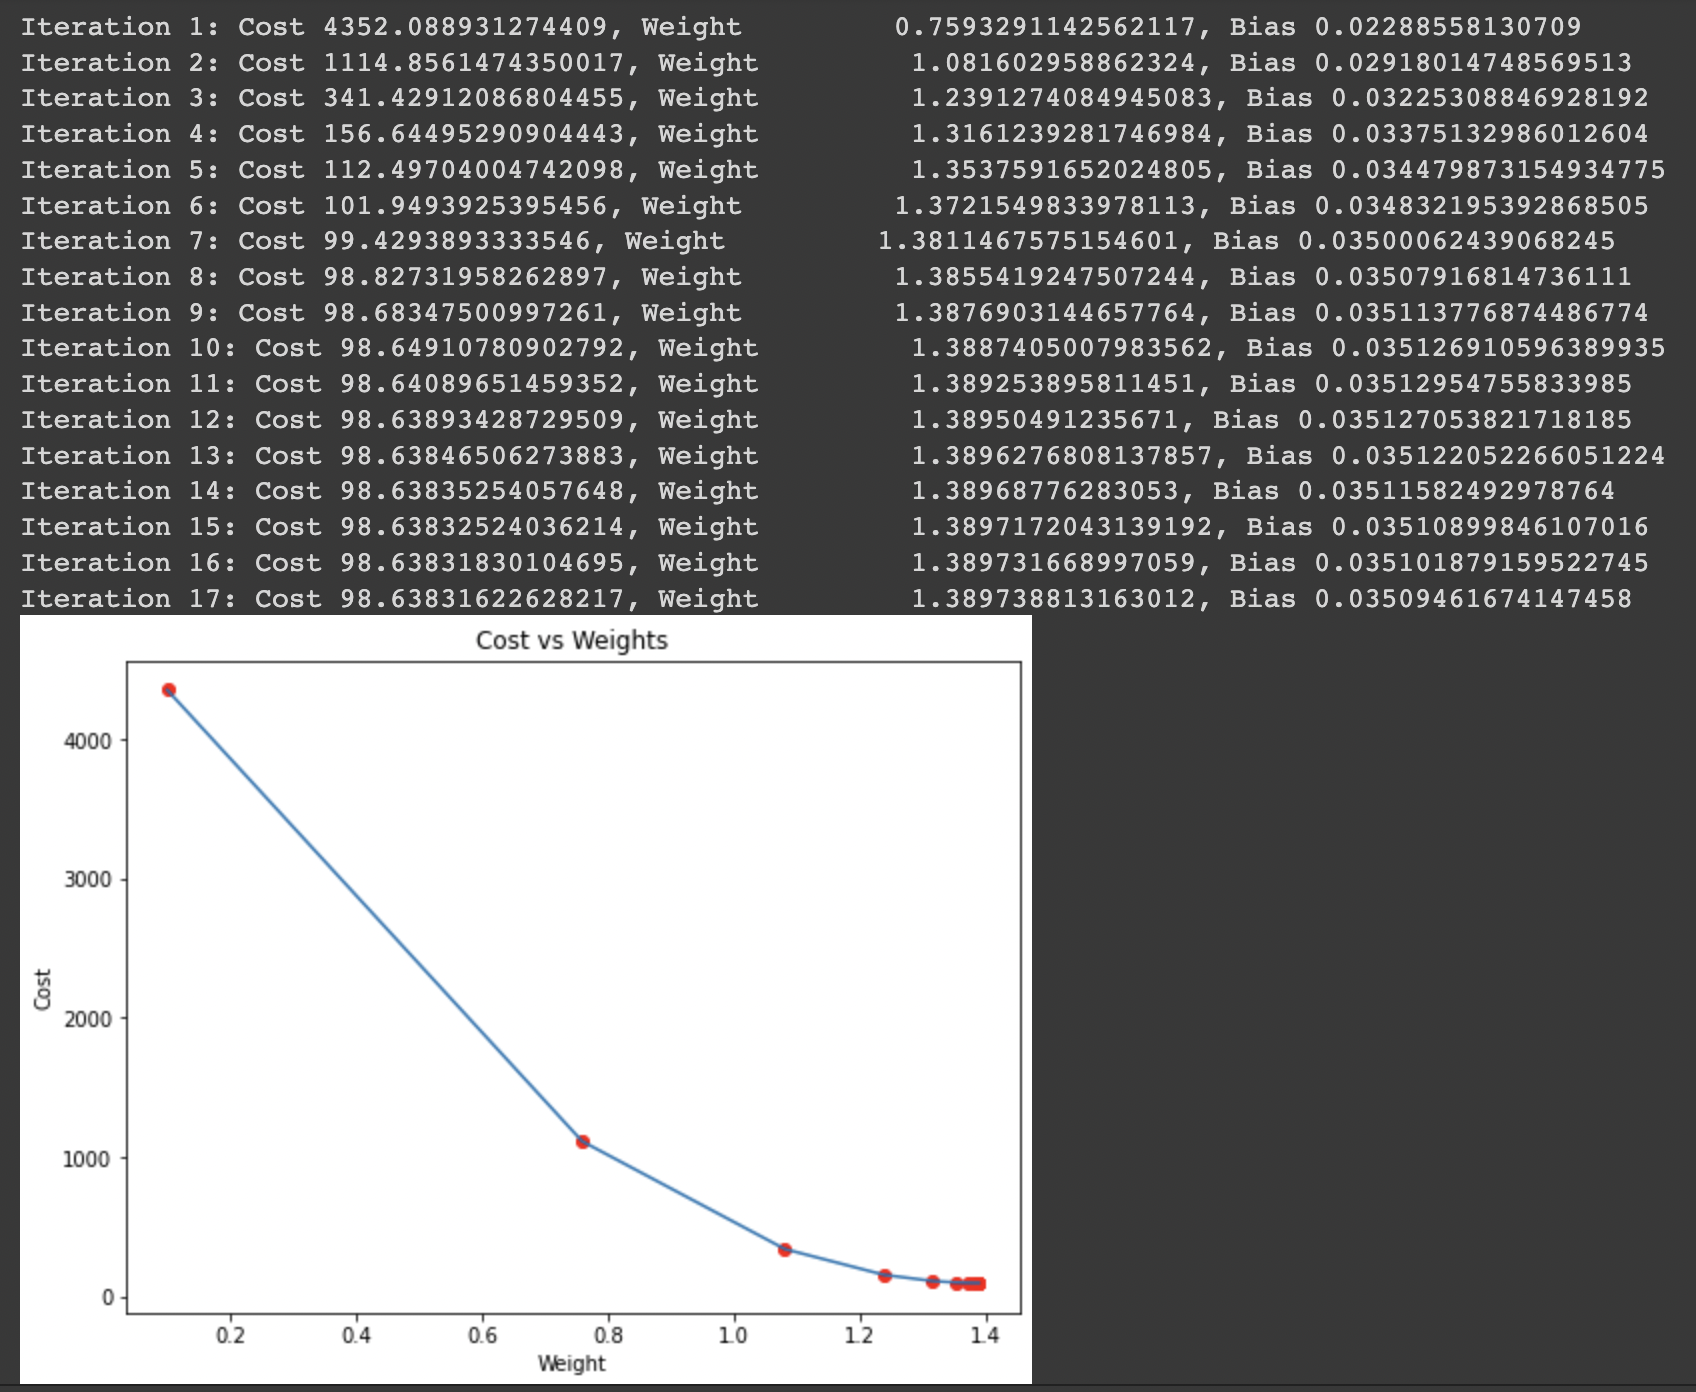
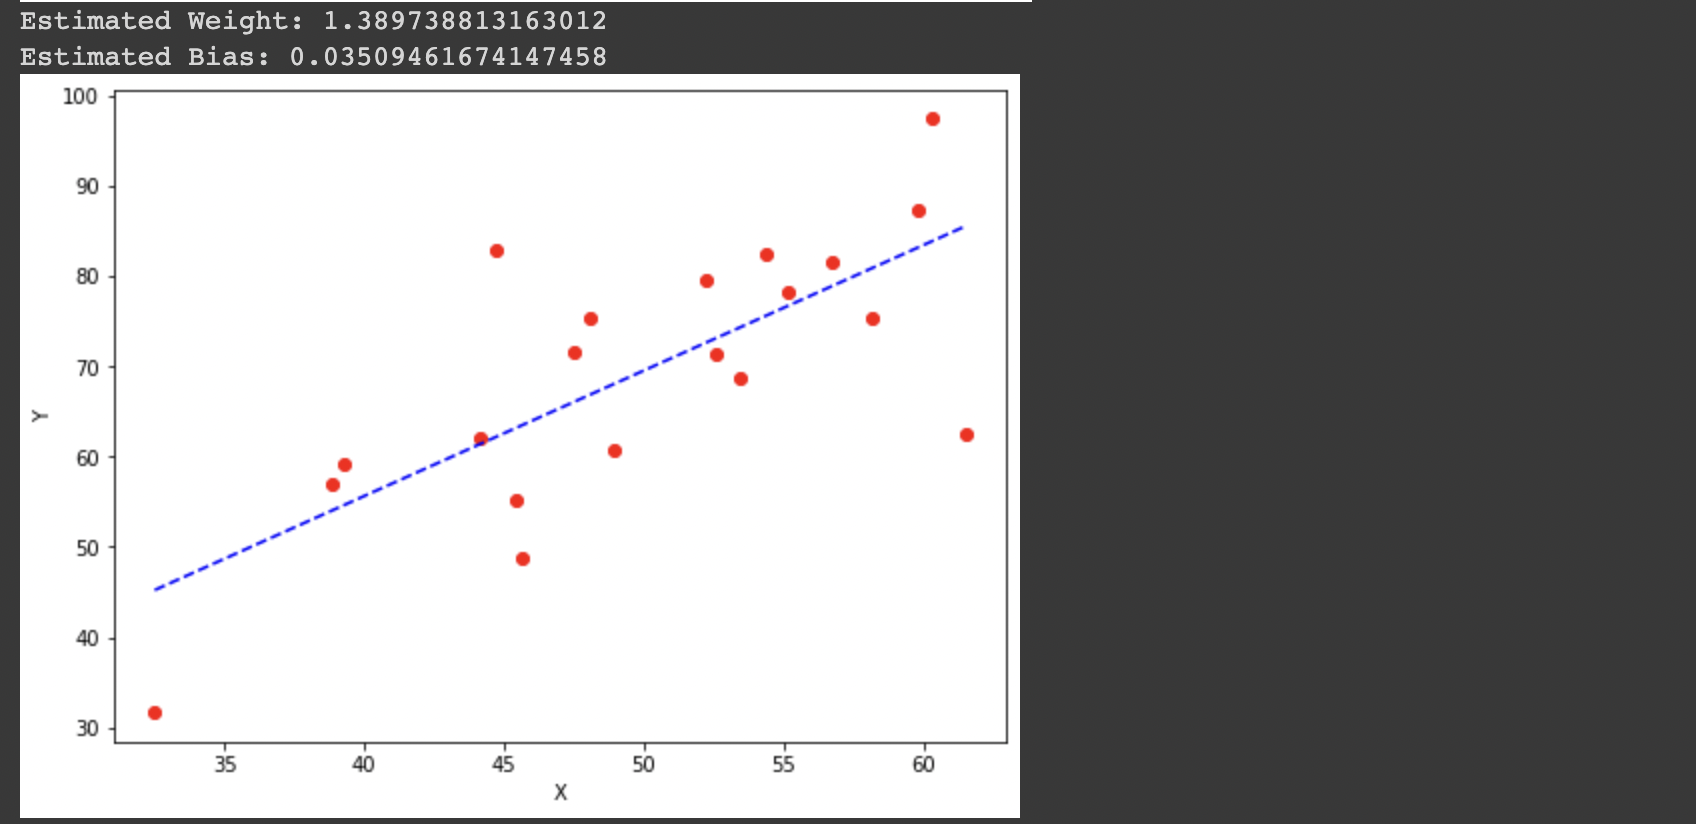
Puoi testare ed eseguire il codice qui sopra con questo notebook.
Un altro elemento importante da sottolineare è il learning rate. Nel machine learning, chiamiamo questo tipo di fattore iperparametro perché non è propriamente un parametro del nostro modello, ma ha comunque un impatto sulle prestazioni finali del modello (proprio come i parametri del modello).
Il learning rate (spesso indicato con α o talvolta η) indica la velocità con cui evolvono i coefficienti. Questa quantità può essere fissa o variabile. Uno dei metodi più popolari al momento si chiama Adam, che ha un learning rate che si adatta nel tempo.
Ci sono molti scenari da prevedere e da considerare quando si usa la discesa del gradiente:
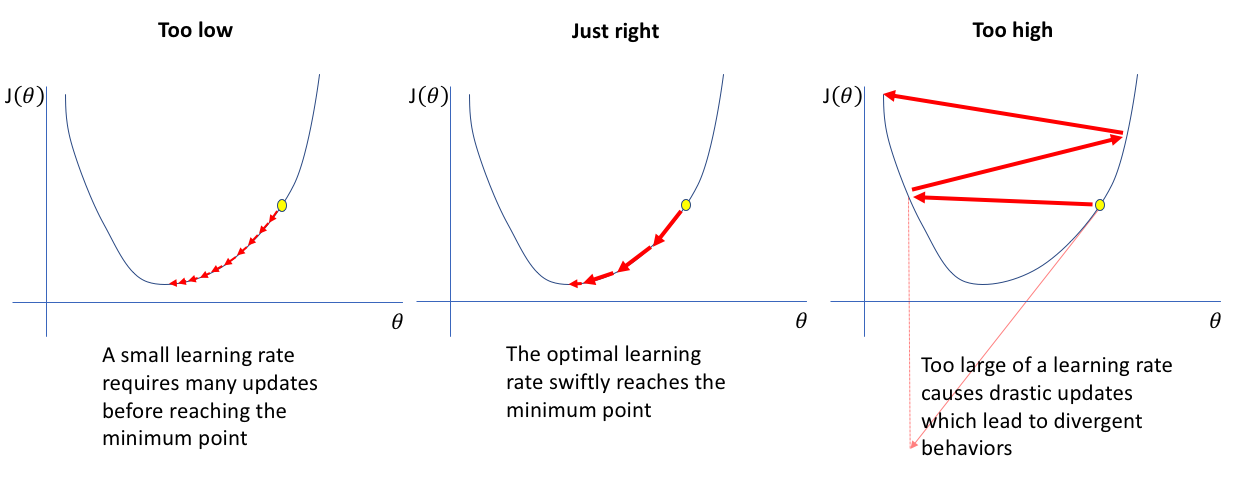
Se il learning rate è troppo grande, farai passi troppo ampi nella discesa del gradiente. Questo ha il vantaggio di scendere rapidamente verso il minimo della funzione di costo, ma rischi di mancare questo minimo oscillandoci attorno all'infinito. Nell'analogia della valle, è come se ti muovessi di diversi chilometri ogni volta, passando oltre il rifugio senza accorgertene.
Per evitare il caso precedente, potresti essere tentato di scegliere un learning rate molto basso. Ma se è troppo basso, rischi di impiegare un tempo infinito prima di convergere al minimo della funzione di costo. È un po' come scegliere di avanzare millimetro per millimetro sulla montagna per trovare il punto più basso della valle.
È essenziale impostare i learning rate su valori appropriati per aiutare la discesa delle pendenze a raggiungere i minimi locali. Quindi, è meglio non impostarli troppo alti o troppo bassi. Questo è fondamentale perché raggiungere il minimo potrebbe diventare complicato con passi troppo lunghi. Se invece impostiamo i learning rate su valori più bassi, la discesa del gradiente potrebbe alla fine raggiungere i suoi minimi locali. Tuttavia, potrebbe richiedere tempo.
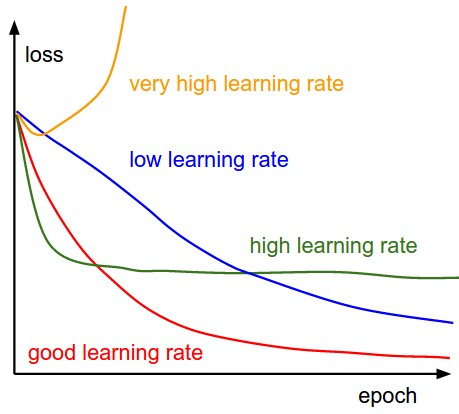
Sfortunatamente, non esiste una formula magica per trovare il learning rate giusto. Nella maggior parte dei casi, devi procedere per tentativi e provare diversi valori prima di trovare quello corretto. Questo si chiama tuning degli iperparametri e ci sono diverse strategie per farlo in modo adeguato.
Un ottimo modo per assicurarsi che la discesa della pendenza funzioni al meglio è tracciare la funzione di costo mentre l'ottimizzazione è in corso. Metti il numero di ripetizioni sull'asse X e il valore della funzione di costo sull'asse Y. Questo ti aiuterà a vedere il valore della funzione di costo dopo ogni iterazione della discesa del gradiente, permettendoti di monitorare l'adeguatezza del learning rate. Puoi anche provare valori diversi e tracciarli insieme.
La funzione di costo diminuirà dopo ogni iterazione se la discesa del gradiente funziona in modo ottimale. La discesa del gradiente converge quando non riesce a ridurre la funzione di costo e rimane allo stesso livello. Il numero di iterazioni necessarie perché la discesa del gradiente converga varia notevolmente. A volte ne servono cinquanta, altre volte possono essere due o tre milioni. È difficile stimare in anticipo il numero di iterazioni.
Alcuni algoritmi possono dirti automaticamente se c'è stata convergenza nella discesa del gradiente. Tuttavia, è meglio stabilire in anticipo una soglia di convergenza, cosa che è anch'essa piuttosto difficile da stimare. Questo è un motivo importante per cui dei semplici grafici sono la soluzione migliore per i test di convergenza.
Mentre gli scienziati usano la discesa del gradiente per trovare i valori dei parametri di una funzione al fine di minimizzare i costi, i programmatori usano la discesa del gradiente come algoritmo di ottimizzazione durante l'addestramento dei modelli di machine learning. La discesa del gradiente regola iterativamente alcuni dei suoi parametri per minimizzare una particolare funzione basata su funzioni convesse.
La discesa del gradiente è probabilmente la strategia di ottimizzazione più riconosciuta usata nel deep learning e nel machine learning. I data scientist la usano spesso quando c'è la possibilità di combinare ogni algoritmo con modelli di apprendimento. Capire l'algoritmo della discesa del gradiente è relativamente semplice e implementarlo è ancora più semplice. Per approfondire il mondo del deep learning, dai un'occhiata al nostro catalogo completo di corsi di machine learning.
Impara con DataCamp
Programma
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



