Leerpad
Wetenschapper op het gebied van machine learning in Python
85 uur
Gradient descent is een van de belangrijkste algoritmen in alle machine learning en deep learning. Het is een zeer krachtig optimalisatie-algoritme dat lineaire regressie-, logistische regressie- en neurale netwerkmodellen kan trainen. Als je met machine learning aan de slag gaat, is het dus essentieel om het gradient-descent-algoritme grondig te begrijpen.
Data science draait om het ontdekken van complexe patronen en gedragingen in bigdata-analyses. Dit zijn zogeheten "patronen", oftewel terugkerende motieven. Met machine learning komt het neer op het trainen van algoritmen om patronen in data te herkennen zodat ze een specifieke taak beter uitvoeren. Dat betekent software leren om autonoom een taak uit te voeren of voorspellingen te doen. Hiervoor selecteert en traint de data scientist algoritmen om data te analyseren. Het doel is natuurlijk dat hun voorspellingen in de loop van de tijd verbeteren.
Machine learning is dus grotendeels gebaseerd op het trainen van algoritmen. Hoe meer deze algoritmen aan data worden blootgesteld, hoe beter ze leren een taak uit te voeren zonder specifieke instructies; ze leren door ervaring. We gebruiken verschillende soorten algoritmen in machine learning. Daarvan is gradient descent een van de nuttigste en populairste.
Gradient descent is een optimalisatie-algoritme. Het wordt gebruikt om sneller de minimale waarde van een functie te vinden. De definitie van gradient descent is vrij eenvoudig: het is een algoritme om het minimum van een convexe functie te vinden. Dit doet het door de parameters van de betreffende functie iteratief te wijzigen. Het wordt bijvoorbeeld gebruikt bij lineaire regressie.
Een convexe functie lijkt op een mooie vallei met een globaal minimum in het midden. Omgekeerd heeft een niet-convexe functie meerdere lokale minima, en het gradient-descent-algoritme zou je op zulke functies beter niet gebruiken, omdat je het risico loopt vast te komen zitten in het eerste minimum dat je tegenkomt.
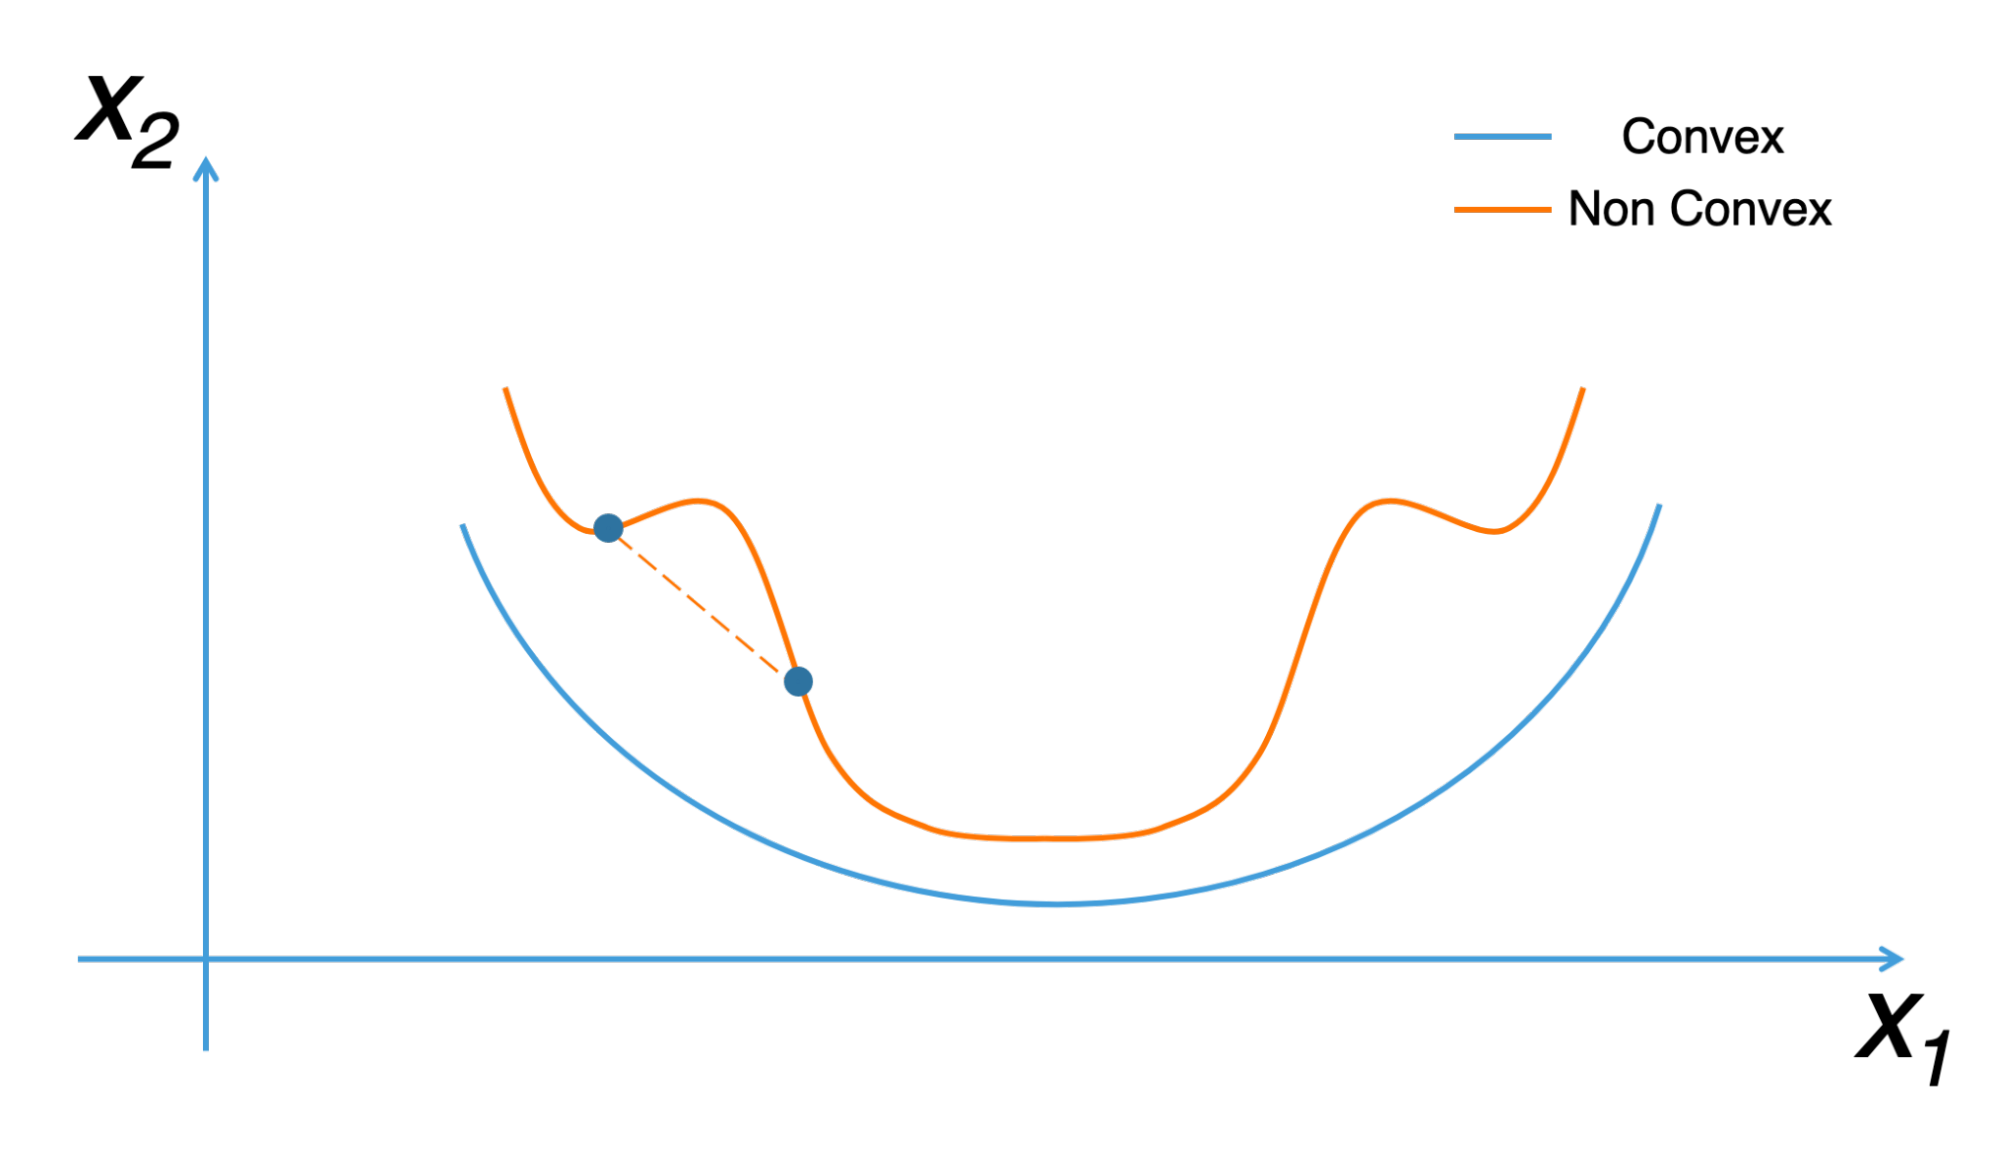
Gradient descent wordt ook wel “het algoritme van de steilste afdaling” genoemd. Het is heel belangrijk in machine learning, waar het wordt gebruikt om een kostenfunctie te minimaliseren. Die wordt gebruikt om het beste voorspellingsmodel in een data-analyse te bepalen. Hoe meer de kosten worden geminimaliseerd, hoe beter de machine goede voorspellingen kan doen.
Er zijn drie bekende soorten descent. Laten we ze van dichtbij bekijken:
Batch gradient descent, ook wel vanilla gradient descent genoemd, berekent de fouten voor elk voorbeeld in de trainingsdataset. Het doet dit echter pas nadat elk trainingsvoorbeeld grondig is geëvalueerd. Je kunt dit proces vergelijken met een cyclus. Sommigen noemen het ook wel een trainingsepoch.
Batch descent heeft verschillende voordelen. Met name de rekenefficiëntie is erg praktisch omdat het zorgt voor stabiele convergentie en een stabiele foutgradiënt. Toch zijn er ook nadelen. Soms kan de stabiele foutgradiënt leiden tot een ongunstige convergentiestatus. Daarnaast vereist het dat de volledige trainingsdataset in het algoritme en het geheugen aanwezig is.
Stochastic gradient descent voert individuele parameterupdates uit voor elk trainingsvoorbeeld. Daardoor krijgt elk voorbeeld aandacht, wat helpt om fouten te voorkomen. Afhankelijk van het probleem kan dit ervoor zorgen dat SGD sneller is dan batch gradient descent. De regelmatige updates geven ons gedetailleerde verbeteringspercentages.
Maar deze updates zijn rekenintensief, zeker vergeleken met de aanpak van batchgewijze descent. Bovendien kan de frequentie van de updates leiden tot noisey gradiënten en kan de fout niet goed dalen. In plaats daarvan springt de fout en wordt het op de lange termijn problematisch.
Onderzoekers gebruiken mini-batch gradient descent vaak als uitgangspunt. Waarom? Omdat het een perfecte mix is van de concepten van stochastische en batch-descent. Het verdeelt (trainings)datasets in batches en voert voor elke batch een update uit, waardoor een balans ontstaat tussen de efficiëntie van BGD en de robuustheid van SGD.
Gangbare mini-batchgroottes variëren van vijftig tot tweehonderdzesenvijftig, maar zoals bij veel andere ML-methoden zijn er geen harde regels; het verschilt per toepassing. Het is een veelgebruikte basisoptie voor het trainen van neurale netwerken. Het is ook een populair type afdaling in het deep-learninglandschap.
In machine learning gebruiken we het gradient-descent-algoritme in supervised learning-problemen om de kostenfunctie te minimaliseren, die een convexe functie is (bijvoorbeeld de mean squared error).
Dankzij dit algoritme leert de machine door het beste model te vinden. Onthoud dat het minimaliseren van de kostenfunctie betekent dat je de parameters a, b, c, enz. vindt die de kleinste fouten geven tussen ons model en de y-punten van de dataset. Zodra de kostenfunctie is geminimaliseerd, ontstaat de mogelijkheid om nauwkeurige spraakherkenningsprogramma’s, computervisietoepassingen en modellen te bouwen die de beurskoers voorspellen.
Je ziet waarom het gradient-descent-algoritme fundamenteel is: de machine leert ermee.
Om de werking en het nut van dit algoritme beter te illustreren, gebruiken we vaak de berg-analogie. Stel je iemand voor die is verdwaald in de bergen. Het komt er in de basis op neer dat je de weg terugvindt door eerst de richting met de steilste afdaling te zoeken. Nadat je die richting een bepaalde afstand hebt gevolgd, herhaal je deze methode totdat je een vallei bereikt (de laagste waarde). In machine learning bestaat gradient descent uit het herhalen van deze methode in een lus totdat je een minimum voor de kostenfunctie vindt. Daarom heet het een iteratief algoritme en vergt het veel rekenwerk.
Hier is een tweestappenstrategie die je helpt als je verdwaald bent in de bergen:
Door stappen 1 en 2 te blijven herhalen, convergeer je zeker naar het minimum van de vallei. Deze strategie is niets meer of minder dan het gradient-descent-algoritme.
We beginnen vanuit een willekeurig startpunt en meten dan de waarde van de helling op dat punt. In de wiskunde meet je een helling door de afgeleide van de functie te berekenen.
Vervolgens gaan we een bepaalde afstand d vooruit in de richting van de helling, die naar beneden gaat, maar nu niet 300 meter. Deze afstand heet de “learning rate”. Het resultaat is dat we de waarde van de parameters van ons model aanpassen (onze coördinaten in de vallei veranderen wanneer we bewegen).
Het gradient-descent-algoritme wordt vooral gebruikt in machine learning en deep learning. Dat laatste kun je zien als een verbeterde versie van machine learning. Het maakt het mogelijk de meest subtiele patronen te detecteren. Dit zijn disciplines die een stevige wiskundige basis en kennis van Python vereisen.
Deze programmeertaal heeft verschillende libraries die de toepassing van machine learning vergemakkelijken. Deze discipline is erg nuttig om grote hoeveelheden data nauwkeurig en snel te analyseren. Ze maakt voorspellende analyses mogelijk op basis van trends of gebeurtenissen uit het verleden.
Machine learning is een van de vakgebieden die nauw verbonden zijn met big data qua kansen om te benutten. Het helpt de grenzen van menselijke intelligentie te overstijgen bij de analyse van grote datastromen. Met de enorme datasets die online beschikbaar zijn, kan kunstmatige intelligentie (AI) zelfstandig leren zonder menselijke tussenkomst. Machine learning wordt bijvoorbeeld gebruikt bij connected devices. Dankzij ML kan een AI zich aanpassen aan de gewoonten van de bewoners van een smart home en taken uitvoeren met die gewoonten in gedachten.
Zo kan AI bijvoorbeeld de verwarming van een kamer aanpassen aan het weer. Deze wetenschap zorgt er ook voor dat robotstofzuigers steeds geavanceerder worden. Gradient descent via machine learning staat centraal in de grote doorbraken in kunstmatige intelligentie. In de praktijk zijn er talloze toepassingen van gradient descent door ingenieurs en AI-specialisten.
Het is nuttig voor zoekmachines zoals Google en populaire aanbevelingssystemen zoals YouTube, Netflix of Amazon. Op basis van door gebruikers verzamelde data proberen algoritmen de interesses van de internetgebruiker te begrijpen. Zo kunnen ze relevantere zoekresultaten en betere aanbevelingen bieden.
Machine learning heeft computers in staat gesteld menselijke taal te begrijpen en te verwerken. Deze toepassing gaf geboorte aan digitale assistenten zoals Alexa, Google Assistant en Siri. Machine learning en toepassingen van gradient descent zijn ook erg nuttig voor videogamedevelopers. Het doel hier is om AI’s uit te laten blinken in de meest menselijke taken, zodat mensen zich kunnen richten op activiteiten met hoge toegevoegde waarde. Kunstmatige intelligentie en machine learning stellen bedrijven in staat om de behoeften van hun klanten en toekomstige trends te anticiperen.
Gradient descent wordt gebruikt bij lineaire regressie vanwege de rekencomplexiteit. De algemene wiskundige formule voor gradient descent is xt+1= xt- η∆xt, waarbij η de learning rate voorstelt en ∆xt de daalrichting. Gradient descent is een algoritme dat toepasbaar is op convexe functies. Als we ƒ nemen als een convexe functie die moet worden geminimaliseerd, is het doel om bij elke iteratie ƒ(xt+1) ≤ ƒ (xt) te verkrijgen.
Het idee is om dit algoritme te gebruiken dat geleidelijk het minimum van een wiskundige functie berekent. Bij bepaalde vergelijkingen is dit de beste manier om ze op te lossen. Bij gradient descent hoort ook het begrip kostenfunctie. In een supervised setting meet deze functie de foutmarge tussen een schatting en de werkelijke waarde. De formule om de mean squared error te berekenen in het geval van een lineair regressieprobleem is als volgt:
Bij de toepassing van gradient descent gebruiken we ook het begrip learning rate. Dit is een hyperparameter die de aanpassing van de netwerkgewichten ten opzichte van de verliesgradiënt regelt. Een optimale learning rate is erg belangrijk om sneller en efficiënter een minimum te bereiken. Hij mag niet te hoog en niet te laag zijn.
Als de waarde daalt, laat dat zien dat je geleidelijk langs de helling naar beneden beweegt. Verschillende optimalisatiemethoden gebruiken het gradient-descent-algoritme, zoals RMSprop, Adam en SGD. Om fouten te voorkomen bij het gebruik van dit algoritme, is het aan te raden je parameters zorgvuldig te kiezen. Houd er ook rekening mee dat het gevonden minimum mogelijk geen globaal minimum is.
De primaire functie van een gradiënt is het meten van de verandering in elk gewicht ten opzichte van de verandering in de fouten. Zie gradiënten als de helling van een functie. Hoe hoger de gradiënt, hoe steiler de helling — dit is gunstig voor modellen omdat ze dan snel kunnen leren. Het model stopt echter met leren als de helling nul wordt. Wiskundig kun je een gradiënt beschrijven als een eindige afgeleide ten opzichte van zijn inputs.
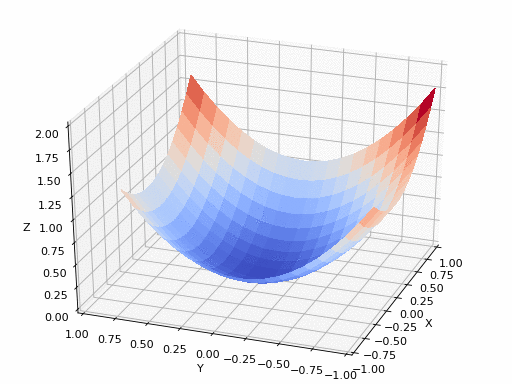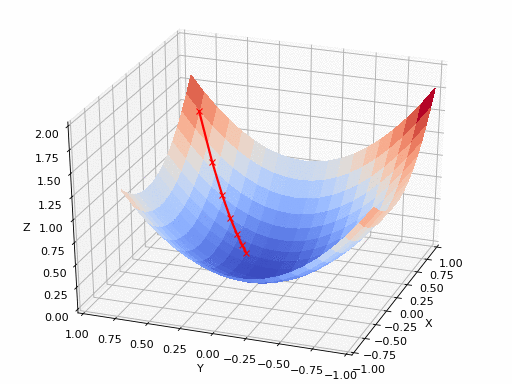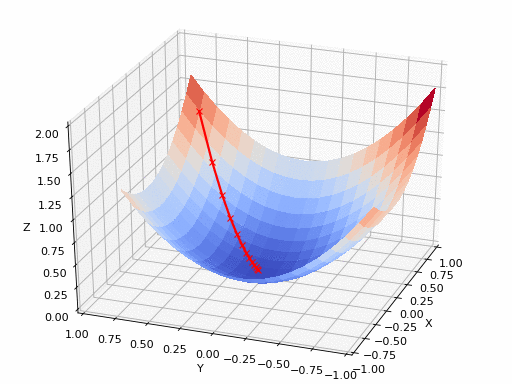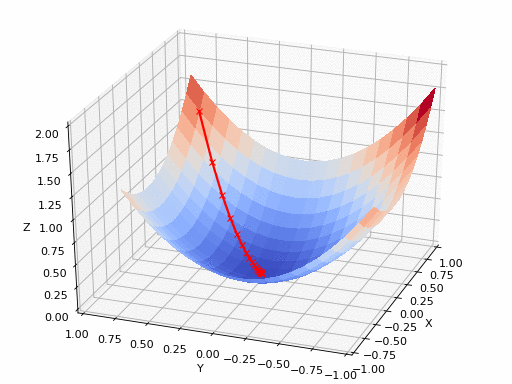
In de implementatiefase schrijven we twee functies. Eén is de kostenfunctie die de werkelijke output en de voorspelde output als input neemt en de loss teruggeeft. De tweede is de daadwerkelijke gradient-descent-functie die de onafhankelijke variabele en de doelvariabele (afhankelijke variabele) als input neemt en met het gradient-descent-algoritme de best passende lijn vindt.
Het aantal iteraties, de learning rate en de stopdrempel zijn de tuningparameters van het gradient-descent-algoritme en kunnen door de gebruiker worden ingesteld. In de main-functie initialiseren we willekeurige lineair gerelateerde data en passen we het gradient-descent-algoritme toe op de data om de best passende lijn te vinden. Het optimale gewicht en de bias die met het gradient-descent-algoritme zijn gevonden, worden vervolgens gebruikt om in de main-functie de lijn van de beste fit te tekenen.
#Importing libraries
import numpy as np
import matplotlib as pyplot

def mean_squared_error(y_true, y_predicted):

   # Calculating the loss or cost
   cost = np.sum((y_true-y_predicted)**2) / len(y_true)
   return cost

# Gradient descent function
# Here iterations, learning rate, stopping threshold are hyperparameters that can be tuned
def gradient_descent((x, y, iterations = 1000, learning_rate = 0.0001, stopping_theshold = 1e-6):

   #Initialzing rate, bias, learning rate, and iterations
   current_rate = 0.1
   current_bias = 0.01
   iterations = iterations
   learning_rate = learning_rate
   n = float(len(x))

   costs = []
   weights = []
   previous_cost = None

   # Estimation of optimal parameters
   for i in range(iterations):

      # Making predictions
      y_predicted = (current_weight * x) + current_bias

      # Calculating the current cost
      current_cost = mean_squared_error(y, y_predicted)

      # If the change in cost is less than or equal to stopping threshold we stop the gradient descent
      if previous_cost and abs(previous_cost - current_cost) <= stopping_threshold:
         break

      previous_cost = current_cost

      costs.append(current_cost)
      weights.append(current_weight)

      # Calculating the gradients
      weight_derivative = -(2/n) * sum(x * (y-y_predicted))
      bias_derivative = -(2/n) * sum(y-y_predicted)

      # Updating weights and bias
      current_weight = current_weight - (learning_rate * weight_derivative)
      current_bias = current_bias - (learning_rate * bias_derivative)

      # Printing the parameters for each 1000th iteration
      print(f"Iteration {i+1}: Cost {current_cost}, Weight \n {current_weight}, Bias {current_bias}")

   # Visualizing the weights and cost for all iterations
   plt.figure(figsize = = (8,6))
   plt.plot(weights, cost)
   plt.scatter(weights, cost, marker = 'o', color = 'red')
   plt.title("Cost vs Weights")
   plt.ylabel("Cost")
   plt.xlabel("Weights")
   plt.show()

   return current_weight, current_bias

def main()

   # Data
   X = np.array(32.5, 53.4, 61.5, 47.4, 59.8,
   55.1, 52.2, 39.2, 48.1, 52.5,
   45.4, 54.3, 44.1, 58.1, 56.7,
   48.9, 44.6, 60.2, 45.6, 38.8])
   Y = np.array(31.7, 68.7, 62.5, 71.5, 87.2,
   78.2, 79.6, 59.1, 75.3, 71.3,
   55.1, 82.4, 62.0, 75.3, 81.4,
   60.7, 82.8, 97.3, 48.8, 56.8])

   # Estimating weight and bias using gradient descent
   estimated_weight, estimated_bias = gradient_descent(X, Y, iterations = 2000)
   print(f"Estimated Weight: {estimated weight}\nEstimated Bias: {estimated bias}")

   # Making predictions using estimated parameters
   Y_pred = estimated_weight*X = estimated_bias

   #Plotting the regression line
   plt.figure(figsize = 8,6)
   plt.scatter(X, Y, marker = 'o', color = 'red')
   plt.plot([min(X), max(X)], [min(Y_pred), max(Y_pred)], color = 'blue')
   plt.ylabel("X")
   plt.xlabel("Y")
   plt.show()

if __name__=="__main__":
   main()
De output van de onderstaande code ziet er als volgt uit:
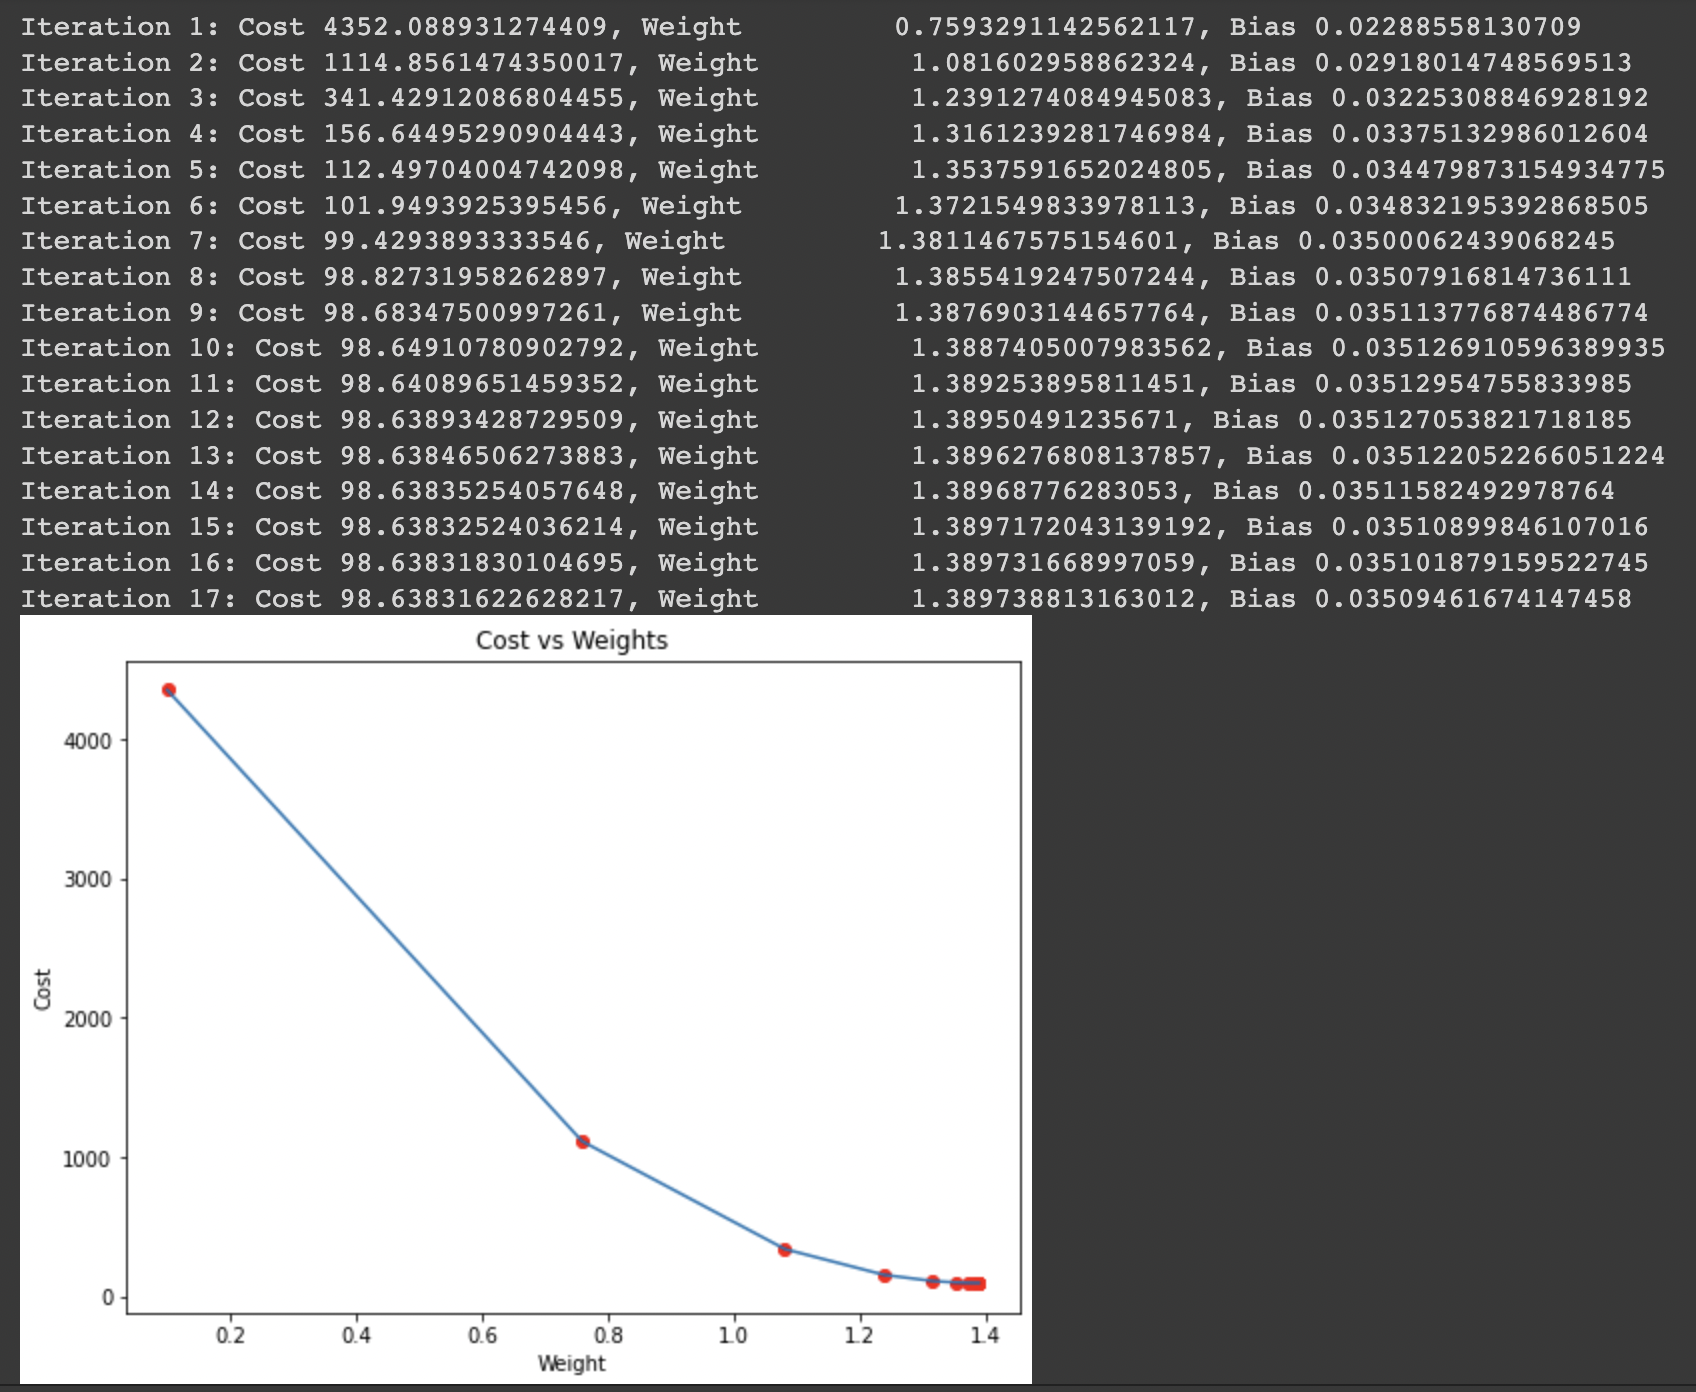
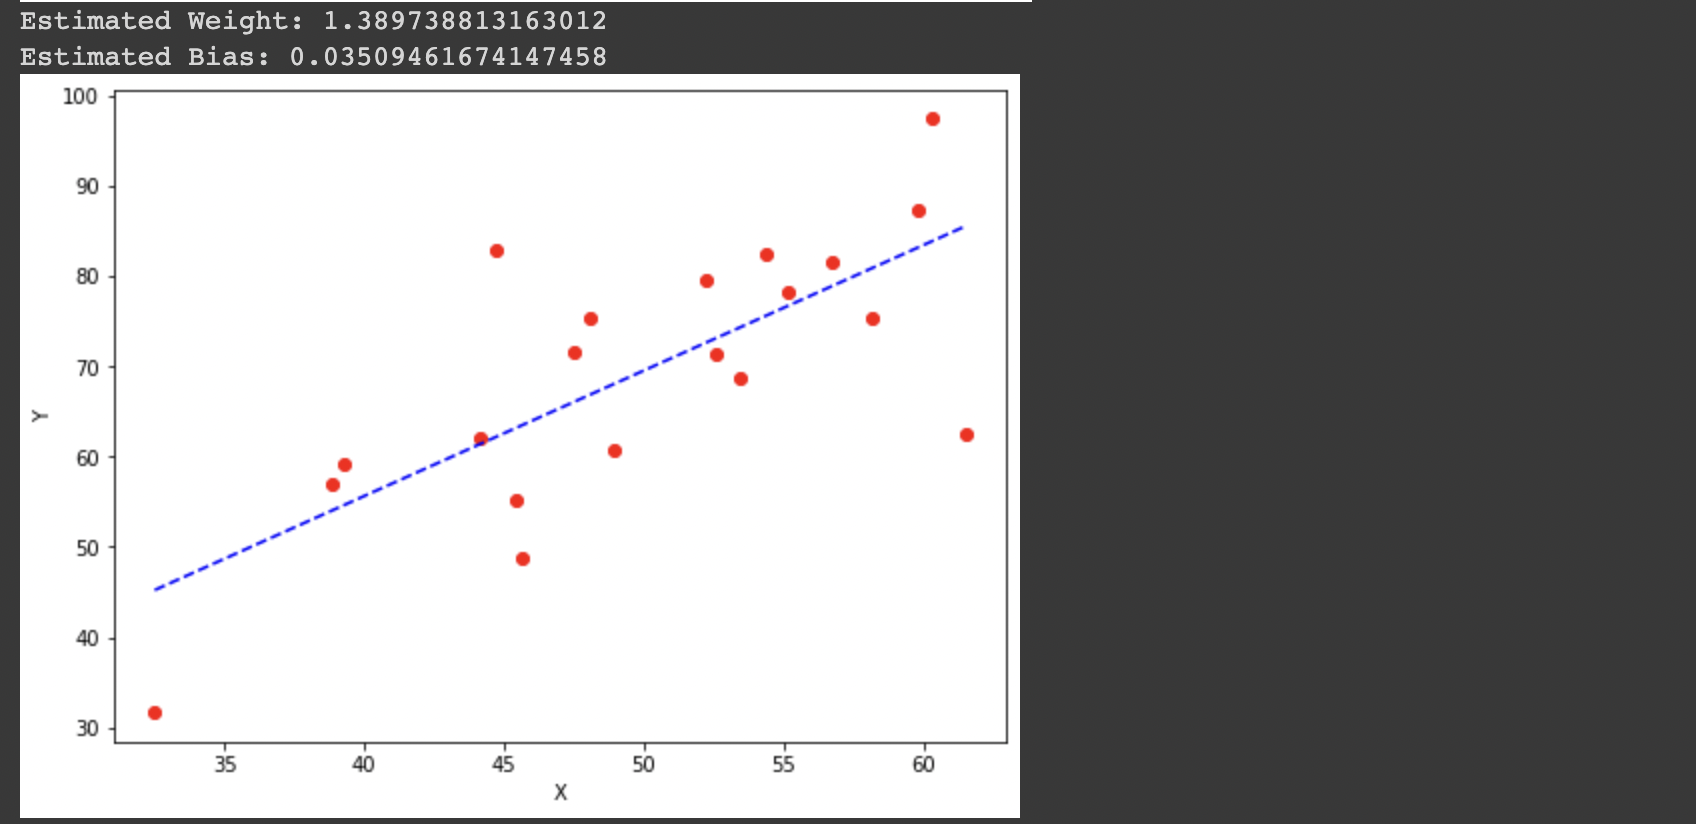
Je kunt de bovenstaande code testen en uitvoeren met dit notebook.
Een ander belangrijk element om te benadrukken is de learning rate. In machine learning noemen we dit soort factor een hyperparameter, omdat het niet strikt genomen een parameter van ons model is, maar wel invloed heeft op de uiteindelijke prestaties (net als de modelparameters).
De learning rate (vaak aangeduid met α of soms η) geeft de snelheid aan waarmee de coëfficiënten veranderen. Deze hoeveelheid kan vast of variabel zijn. Een van de populairste methoden van het moment is Adam, met een learning rate die in de tijd schaalt.
Er zijn veel scenario’s om te verwachten en mee rekening te houden bij het gebruik van gradient descent:
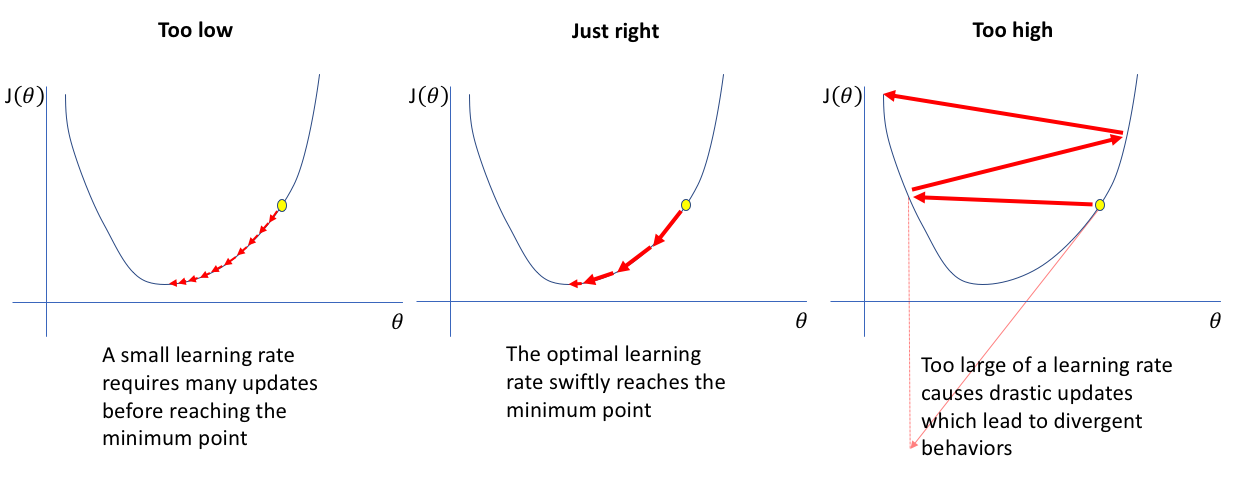
Als de learning rate te groot is, zet je te grote stappen in de gradient descent. Dat heeft als voordeel dat je snel afdaalt naar het minimum van de kostenfunctie, maar je loopt het risico dit minimum te missen door er eindeloos omheen te blijven oscilleren. In de vallei-analogie is het alsof je elke keer meerdere kilometers loopt en zo ongemerkt het onderkomen voorbijgaat.
Om het vorige geval te vermijden, zou je in de verleiding kunnen komen om een zeer lage learning rate te kiezen. Maar als die te klein is, loop je het risico oneindig veel tijd nodig te hebben voordat je convergeert naar het minimum van de kostenfunctie. Het is een beetje alsof je millimeter voor millimeter de berg af gaat om het laagste punt in de vallei te vinden.
Het is essentieel om learning rates op geschikte waarden in te stellen zodat de afdaling lokale minima kan bereiken. Stel ze dus niet te hoog en niet te laag in. Dit is belangrijk omdat het bereiken van het minimum ingewikkeld kan worden met te grote stappen. Als we de learning rate lager zetten, kan gradient descent uiteindelijk zijn lokale minima bereiken. Het kan alleen wat langer duren.
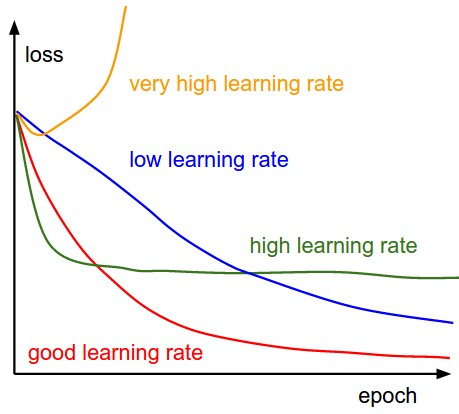
Helaas is er geen magische formule om de juiste learning rate te vinden. Meestal moet je zoeken en meerdere waarden proberen voordat je de juiste hebt. Dit heet hyperparametertuning, en er zijn verschillende strategieën om dit goed te doen.
Een goede manier om een optimale werking van de afdaling te waarborgen, is de kostenfunctie te plotten terwijl de optimalisatie bezig is. Zet het aantal herhalingen op de X-as en de waarde van de kostenfunctie op de Y-as. Dit helpt je om de waarde van de kostenfunctie na elke gradient-descent-iteratie te zien en tegelijk te volgen of de learning rate passend is. Je kunt ook verschillende waarden proberen en samen plotten.
De kostenfunctie zal na elke iteratie dalen als gradient descent optimaal werkt. Gradient descent convergeert wanneer het er niet meer in slaagt de kostenfunctie te verlagen en op hetzelfde niveau blijft. Het aantal iteraties dat nodig is om te convergeren varieert sterk. Soms zijn er vijftig iteraties nodig, en andere keren wel twee of drie miljoen. Het is lastig dit aantal vooraf in te schatten.
Sommige algoritmen kunnen je automatisch vertellen of er een convergentie is opgetreden. Toch is het beter om vooraf een convergentiedrempel vast te stellen, wat ook moeilijk te schatten is. Dit is een belangrijke reden waarom eenvoudige grafieken het beste zijn voor convergentietests.
Wetenschappers gebruiken gradient descent om de waarden van de parameters van een functie te vinden om de kosten te minimaliseren, terwijl programmeurs gradient descent inzetten als optimalisatie-algoritme bij het trainen van machinelearningmodellen. Gradient descent past iteratief enkele parameters aan om een bepaalde functie te minimaliseren op basis van convexe functies.
Gradient descent is waarschijnlijk de meest bekende optimalisatiestrategie in deep learning en machine learning. Data scientists gebruiken het vaak wanneer ze een algoritme met leermodellen kunnen combineren. Het begrijpen van het gradient-descent-algoritme is relatief eenvoudig, en de implementatie nog eenvoudiger. Wil je dieper duiken in deep learning, bekijk dan ons volledige aanbod van machinelearningcursussen.
Leer met DataCamp
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

