programa
Científico especializado en machine learning en Python
85 h
El descenso de gradiente es uno de los algoritmos más importantes de todo el machine learning y el deep learning. Es un algoritmo de optimización muy potente que puede entrenar modelos de regresión lineal, regresión logística y redes neuronales. Si estás empezando en machine learning, entender a fondo el algoritmo de descenso de gradiente es imprescindible.
La ciencia de datos consiste en descubrir patrones y comportamientos complejos mediante el análisis de grandes volúmenes de datos. Hablamos de "patrones", es decir, motivos recurrentes. Con el machine learning, entrenamos algoritmos para detectar estos patrones en los datos y así realizar mejor una tarea concreta. En otras palabras: enseñamos al software a realizar una tarea o hacer predicciones de forma autónoma. Para ello, la persona especialista en datos selecciona y entrena algoritmos para analizar datos, con el objetivo de mejorar sus predicciones con el tiempo.
Por tanto, el machine learning se basa en gran medida en el entrenamiento de algoritmos. Cuanto más expongas estos algoritmos a datos, más aprenden a realizar una tarea sin instrucciones explícitas; aprenden por experiencia. En machine learning usamos diferentes tipos de algoritmos. Entre ellos, el descenso de gradiente es de los más útiles y populares.
El descenso de gradiente es un algoritmo de optimización. Se utiliza para encontrar con rapidez el valor mínimo de una función. Su definición es sencilla: es un algoritmo para hallar el mínimo de una función convexa. Para conseguirlo, cambia iterativamente los parámetros de la función en cuestión. Es un algoritmo que, por ejemplo, se usa en regresión lineal.
Una función convexa se asemeja a un valle, con un mínimo global en el centro. En cambio, una función no convexa tiene varios mínimos locales, y no conviene usar descenso de gradiente en estas funciones porque corres el riesgo de quedarte atrapado en el primer mínimo que encuentres.
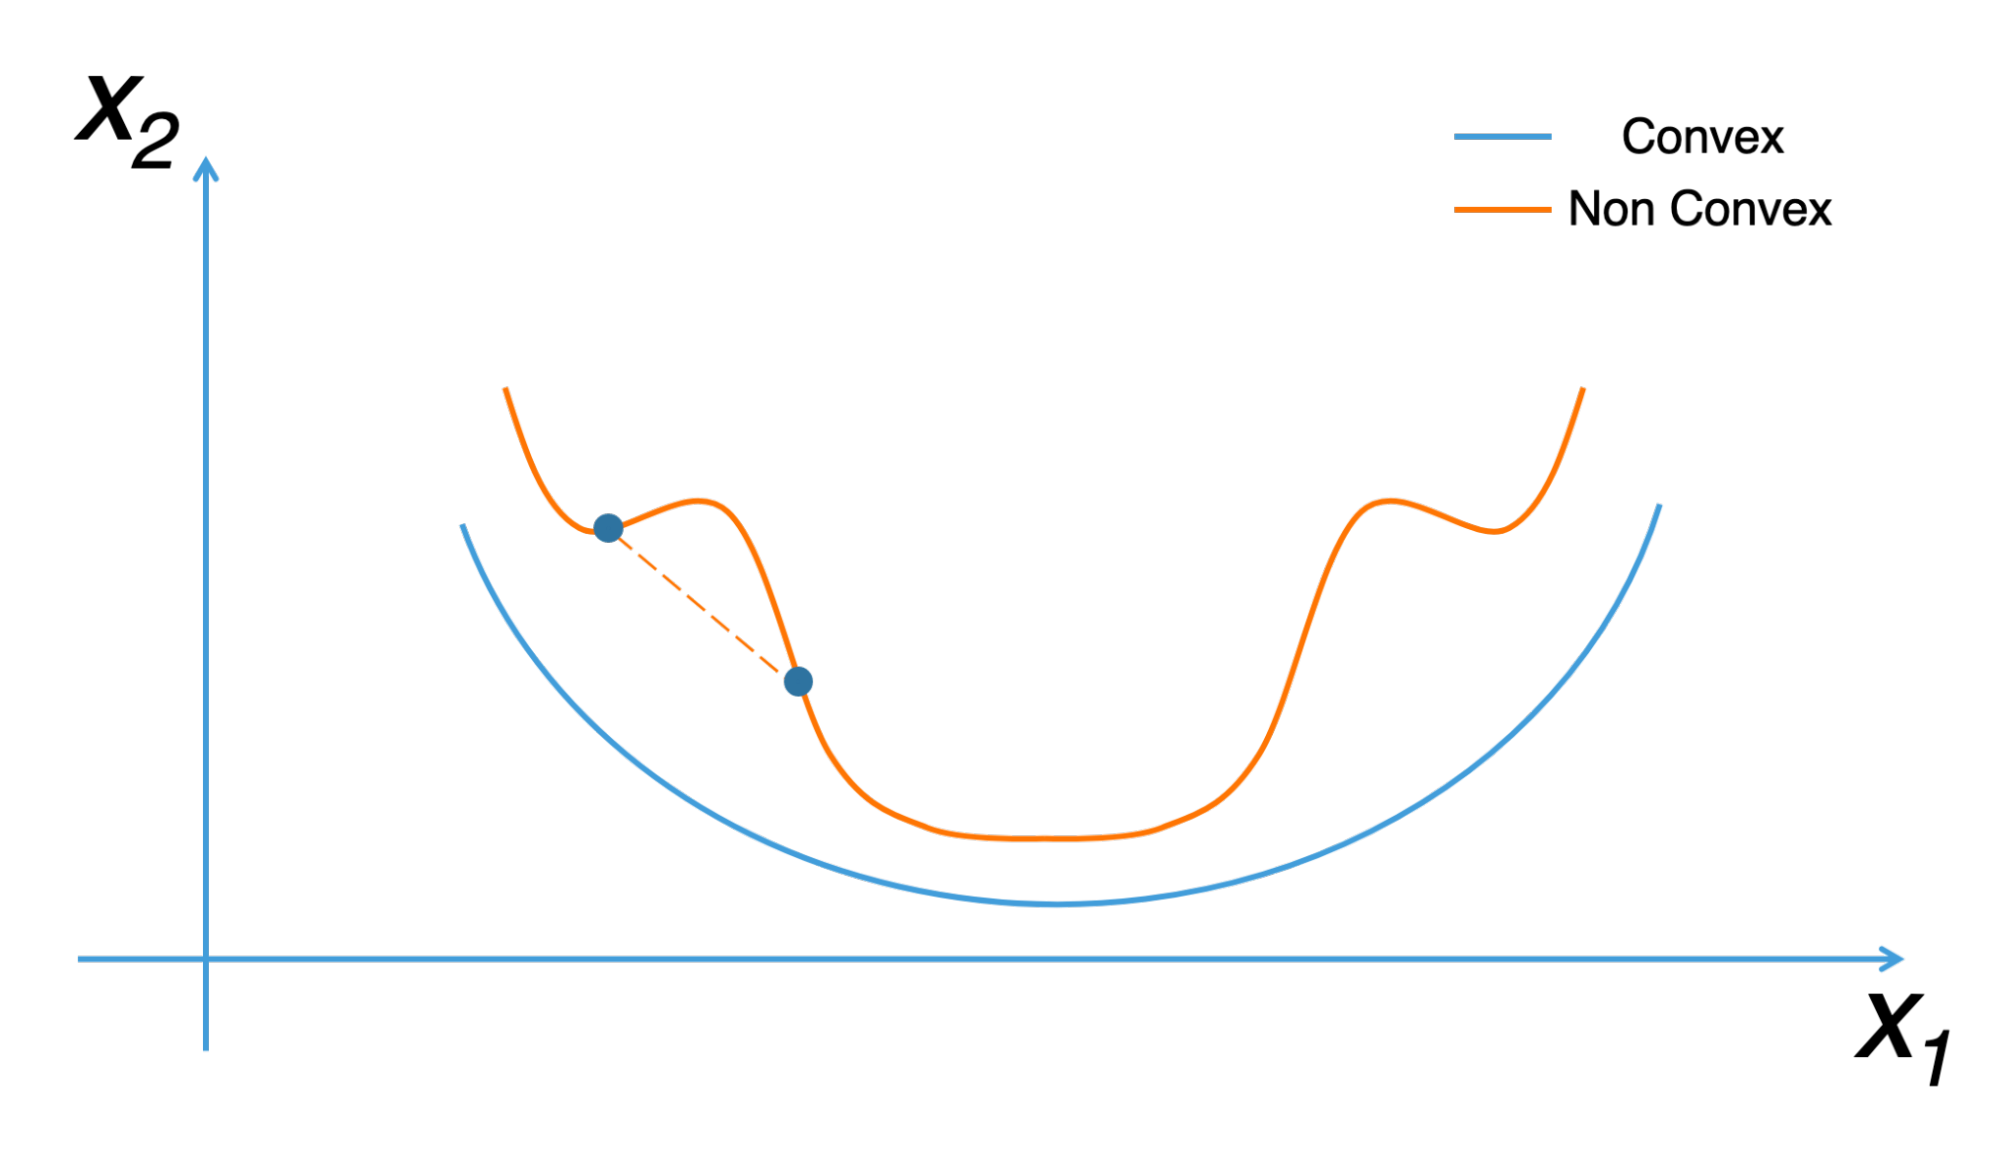
El descenso de gradiente también se conoce como "algoritmo de la pendiente más pronunciada". Es clave en machine learning, donde se usa para minimizar una función de coste. Esta sirve para determinar el mejor modelo de predicción en un análisis de datos. Cuanto más se minimiza el coste, mejores serán las predicciones del modelo.
Existen tres variantes muy conocidas. Veámoslas con más detalle:
También llamado descenso de gradiente por lotes o vanilla gradient descent, calcula los errores para cada ejemplo del conjunto de entrenamiento, pero solo actualiza tras evaluar rigurosamente todos los ejemplos. Puede compararse a un ciclo completo, lo que algunos llaman una época de entrenamiento.
El descenso por lotes tiene varias ventajas. En particular, su eficiencia computacional y su convergencia estable, con un gradiente de error también estable. Ahora bien, esta estabilidad puede llevar a veces a una convergencia a estados poco favorables. Además, necesita tener el conjunto de entrenamiento disponible en memoria.
El descenso de gradiente estocástico realiza actualizaciones de parámetros para cada ejemplo de entrenamiento de forma individual. Presta atención a cada ejemplo y ayuda a reducir errores puntuales. Según el problema, esto puede hacerlo más rápido que el descenso por lotes. Sus actualizaciones frecuentes nos dan señales de mejora muy detalladas.
Dicho esto, estas actualizaciones son costosas computacionalmente en comparación con el enfoque por lotes. Además, su frecuencia puede generar gradientes ruidosos y dificultar la disminución del error: en lugar de bajar de forma suave, el error salta y a largo plazo puede ser problemático.
El descenso de gradiente con mini-lotes es a menudo el punto de partida. ¿Por qué? Porque combina lo mejor del enfoque estocástico y el por lotes. Divide el conjunto de entrenamiento en lotes más pequeños y realiza una actualización por cada mini-lote, equilibrando la eficiencia del BGD con la robustez del SGD.
Los tamaños de mini-lote más comunes van de cincuenta a doscientos cincuenta y seis, pero como en muchos métodos de machine learning, no hay reglas fijas: depende de la aplicación. Es la opción básica para entrenar redes neuronales y un método muy usado en deep learning.
En machine learning, usamos el descenso de gradiente en problemas de aprendizaje supervisado para minimizar la función de coste, que suele ser convexa (por ejemplo, el error cuadrático medio).
Gracias a este algoritmo, el modelo aprende encontrando la mejor configuración. Minimizar la función de coste significa encontrar los parámetros a, b, c, etc., que producen los errores más pequeños entre nuestro modelo y los valores y del conjunto de datos. Una vez minimizada, se abren las puertas a construir sistemas precisos de reconocimiento de voz, visión por computador o aplicaciones de predicción bursátil.
Por eso el descenso de gradiente es fundamental: permite que el modelo aprenda.
Para entender su funcionamiento, suele usarse la analogía de la montaña. Imagina a una persona perdida en la sierra. Para volver, busca primero la dirección con la pendiente más pronunciada hacia abajo. Tras avanzar cierta distancia, repite el proceso hasta llegar al valle (el valor más bajo). En machine learning, el descenso de gradiente repite este método en bucle hasta hallar un mínimo de la función de coste. Es un algoritmo iterativo y requiere mucho cálculo.
Aquí tienes una estrategia en 2 pasos para orientarte si te pierdes en la montaña:
Repitiendo los pasos 1 y 2 en bucle, acabarás llegando al punto más bajo del valle. Esa estrategia es, en esencia, el algoritmo de descenso de gradiente.
Partimos de un punto inicial aleatorio y medimos la pendiente en ese punto. En matemáticas, la pendiente se mide calculando la derivada de la función.
Avanzamos una cierta distancia d en la dirección de bajada, pero no 300 metros esta vez. A esa distancia la llamamos "tasa de aprendizaje". El efecto es modificar el valor de los parámetros del modelo (nuestras coordenadas en el valle cambian al movernos).
El algoritmo de descenso de gradiente se utiliza sobre todo en machine learning y deep learning. Este último puede considerarse una evolución del primero: detecta patrones más sutiles. Son disciplinas que requieren una base sólida de matemáticas y conocimientos de Python.
Este lenguaje tiene varias librerías que facilitan la aplicación del machine learning. Es muy útil para analizar grandes volúmenes de datos con precisión y rapidez, y permite hacer análisis predictivos a partir de tendencias o eventos pasados.
El machine learning está estrechamente ligado al big data por sus posibilidades de explotación. Ayuda a superar los límites de la inteligencia humana en el análisis de grandes flujos de datos. Con los enormes conjuntos de datos disponibles en línea, la inteligencia artificial (IA) puede aprender por sí sola sin intervención humana. El machine learning se usa, por ejemplo, en el ámbito del Internet de las cosas. Gracias a él, una IA puede adaptarse a los hábitos de las personas en una casa conectada y ejecutar tareas teniéndolos en cuenta.
Por ejemplo, la IA puede ajustar la calefacción de una estancia según el tiempo. También es la tecnología detrás de robots aspiradores cada vez más sofisticados. El descenso de gradiente, a través del machine learning, está en el centro de grandes avances de la IA. En la práctica, ingenieros y especialistas en IA lo aplican en multitud de casos.
Es útil para motores de búsqueda como Google y para sistemas de recomendación como YouTube, Netflix o Amazon. A partir de los datos de los usuarios, los algoritmos tratan de entender sus intereses para ofrecer resultados y recomendaciones más relevantes.
El machine learning ha permitido que los ordenadores comprendan y procesen el lenguaje humano. De ahí nacen asistentes digitales como Alexa, Google Assistant y Siri. También es muy útil para desarrolladores de videojuegos. El objetivo es que las IAs destaquen en tareas humanas para que las personas se centren en actividades de mayor valor. La IA y el machine learning permiten a las empresas anticipar necesidades de sus clientes y tendencias futuras.
El descenso de gradiente se utiliza en regresión lineal por su complejidad computacional. La fórmula general es xt+1 = xt − η∆xt, donde η es la tasa de aprendizaje y ∆xt la dirección de descenso. Es aplicable a funciones convexas. Si tomamos ƒ como función convexa a minimizar, buscamos que ƒ(xt+1) ≤ ƒ(xt) en cada iteración.
La idea es usar este algoritmo para aproximar poco a poco el mínimo de una función. En ciertos casos, es la mejor manera de resolver ecuaciones. Al hablar de descenso de gradiente, también entra en juego la función de coste. En aprendizaje supervisado, mide el margen de error entre una estimación y el valor real. La fórmula para el error cuadrático medio en un problema de regresión lineal es la siguiente:
La aplicación del descenso de gradiente también usa la tasa de aprendizaje. Es un hiperparámetro que controla el ajuste de los pesos de la red respecto al gradiente de la pérdida. Una tasa de aprendizaje adecuada es crucial para alcanzar un mínimo de forma rápida y eficiente: ni demasiado alta ni demasiado baja.
Si el valor desciende, indica que avanzamos por la pendiente de bajada. Varios métodos de optimización utilizan descenso de gradiente, como RMSprop, Adam y SGD. Para no cometer errores al usarlo, conviene elegir bien sus parámetros. Y recuerda: el mínimo hallado puede no ser el mínimo global.
La función principal de un gradiente es medir el cambio de cada peso frente al cambio en los errores. Piensa en los gradientes como la pendiente de una función. Cuanto mayor es el gradiente, más pronunciada la pendiente: condición favorable para que los modelos aprendan con rapidez. Sin embargo, si la pendiente llega a cero, el modelo deja de aprender. En términos matemáticos, un gradiente es una derivada finita con respecto a sus entradas.
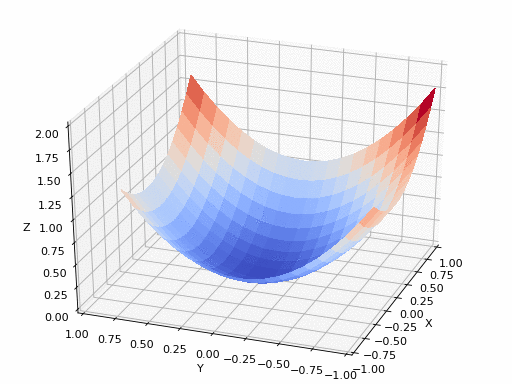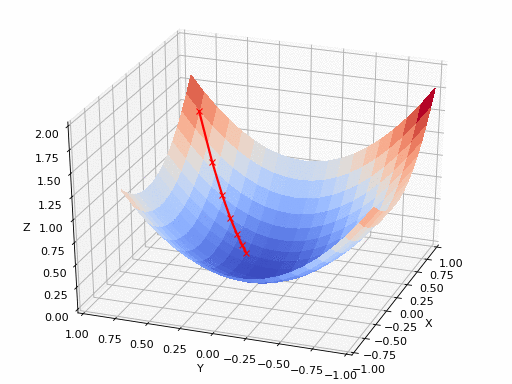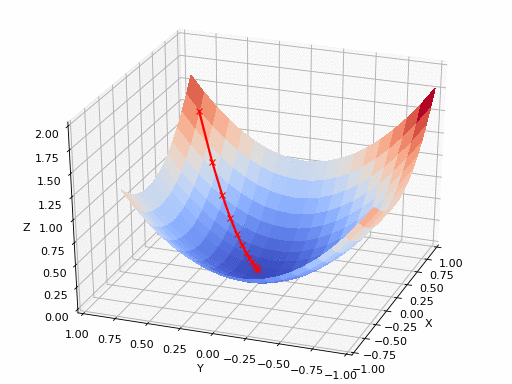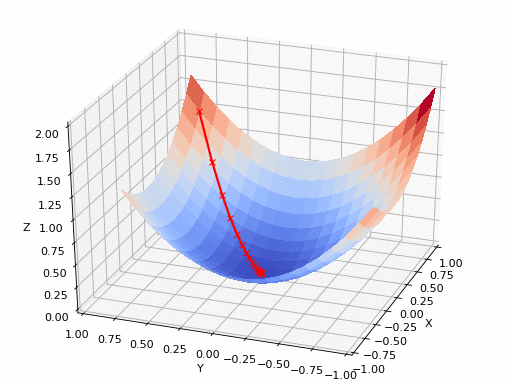
En la implementación escribiremos dos funciones. Una será la función de coste, que toma como entrada la salida real y la predicha y devuelve la pérdida. La segunda será la función de descenso de gradiente, que toma la variable independiente y la variable objetivo (dependiente) y encuentra la recta de mejor ajuste usando el algoritmo.
Las iteraciones, la tasa de aprendizaje y el umbral de parada son parámetros de ajuste del algoritmo y los puede definir la persona usuaria. En la función principal, inicializaremos datos linealmente relacionados al azar y aplicaremos el descenso de gradiente para encontrar la mejor recta de ajuste. El peso y el sesgo óptimos obtenidos se usan después para dibujar la línea de mejor ajuste en la función principal.
#Importing libraries
import numpy as np
import matplotlib as pyplot

def mean_squared_error(y_true, y_predicted):

   # Calculating the loss or cost
   cost = np.sum((y_true-y_predicted)**2) / len(y_true)
   return cost

# Gradient descent function
# Here iterations, learning rate, stopping threshold are hyperparameters that can be tuned
def gradient_descent((x, y, iterations = 1000, learning_rate = 0.0001, stopping_theshold = 1e-6):

   #Initialzing rate, bias, learning rate, and iterations
   current_rate = 0.1
   current_bias = 0.01
   iterations = iterations
   learning_rate = learning_rate
   n = float(len(x))

   costs = []
   weights = []
   previous_cost = None

   # Estimation of optimal parameters
   for i in range(iterations):

      # Making predictions
      y_predicted = (current_weight * x) + current_bias

      # Calculating the current cost
      current_cost = mean_squared_error(y, y_predicted)

      # If the change in cost is less than or equal to stopping threshold we stop the gradient descent
      if previous_cost and abs(previous_cost - current_cost) <= stopping_threshold:
         break

      previous_cost = current_cost

      costs.append(current_cost)
      weights.append(current_weight)

      # Calculating the gradients
      weight_derivative = -(2/n) * sum(x * (y-y_predicted))
      bias_derivative = -(2/n) * sum(y-y_predicted)

      # Updating weights and bias
      current_weight = current_weight - (learning_rate * weight_derivative)
      current_bias = current_bias - (learning_rate * bias_derivative)

      # Printing the parameters for each 1000th iteration
      print(f"Iteration {i+1}: Cost {current_cost}, Weight \n {current_weight}, Bias {current_bias}")

   # Visualizing the weights and cost for all iterations
   plt.figure(figsize = = (8,6))
   plt.plot(weights, cost)
   plt.scatter(weights, cost, marker = 'o', color = 'red')
   plt.title("Cost vs Weights")
   plt.ylabel("Cost")
   plt.xlabel("Weights")
   plt.show()

   return current_weight, current_bias

def main()

   # Data
   X = np.array(32.5, 53.4, 61.5, 47.4, 59.8,
   55.1, 52.2, 39.2, 48.1, 52.5,
   45.4, 54.3, 44.1, 58.1, 56.7,
   48.9, 44.6, 60.2, 45.6, 38.8])
   Y = np.array(31.7, 68.7, 62.5, 71.5, 87.2,
   78.2, 79.6, 59.1, 75.3, 71.3,
   55.1, 82.4, 62.0, 75.3, 81.4,
   60.7, 82.8, 97.3, 48.8, 56.8])

   # Estimating weight and bias using gradient descent
   estimated_weight, estimated_bias = gradient_descent(X, Y, iterations = 2000)
   print(f"Estimated Weight: {estimated weight}\nEstimated Bias: {estimated bias}")

   # Making predictions using estimated parameters
   Y_pred = estimated_weight*X = estimated_bias

   #Plotting the regression line
   plt.figure(figsize = 8,6)
   plt.scatter(X, Y, marker = 'o', color = 'red')
   plt.plot([min(X), max(X)], [min(Y_pred), max(Y_pred)], color = 'blue')
   plt.ylabel("X")
   plt.xlabel("Y")
   plt.show()

if __name__=="__main__":
   main()
La salida del siguiente código será:
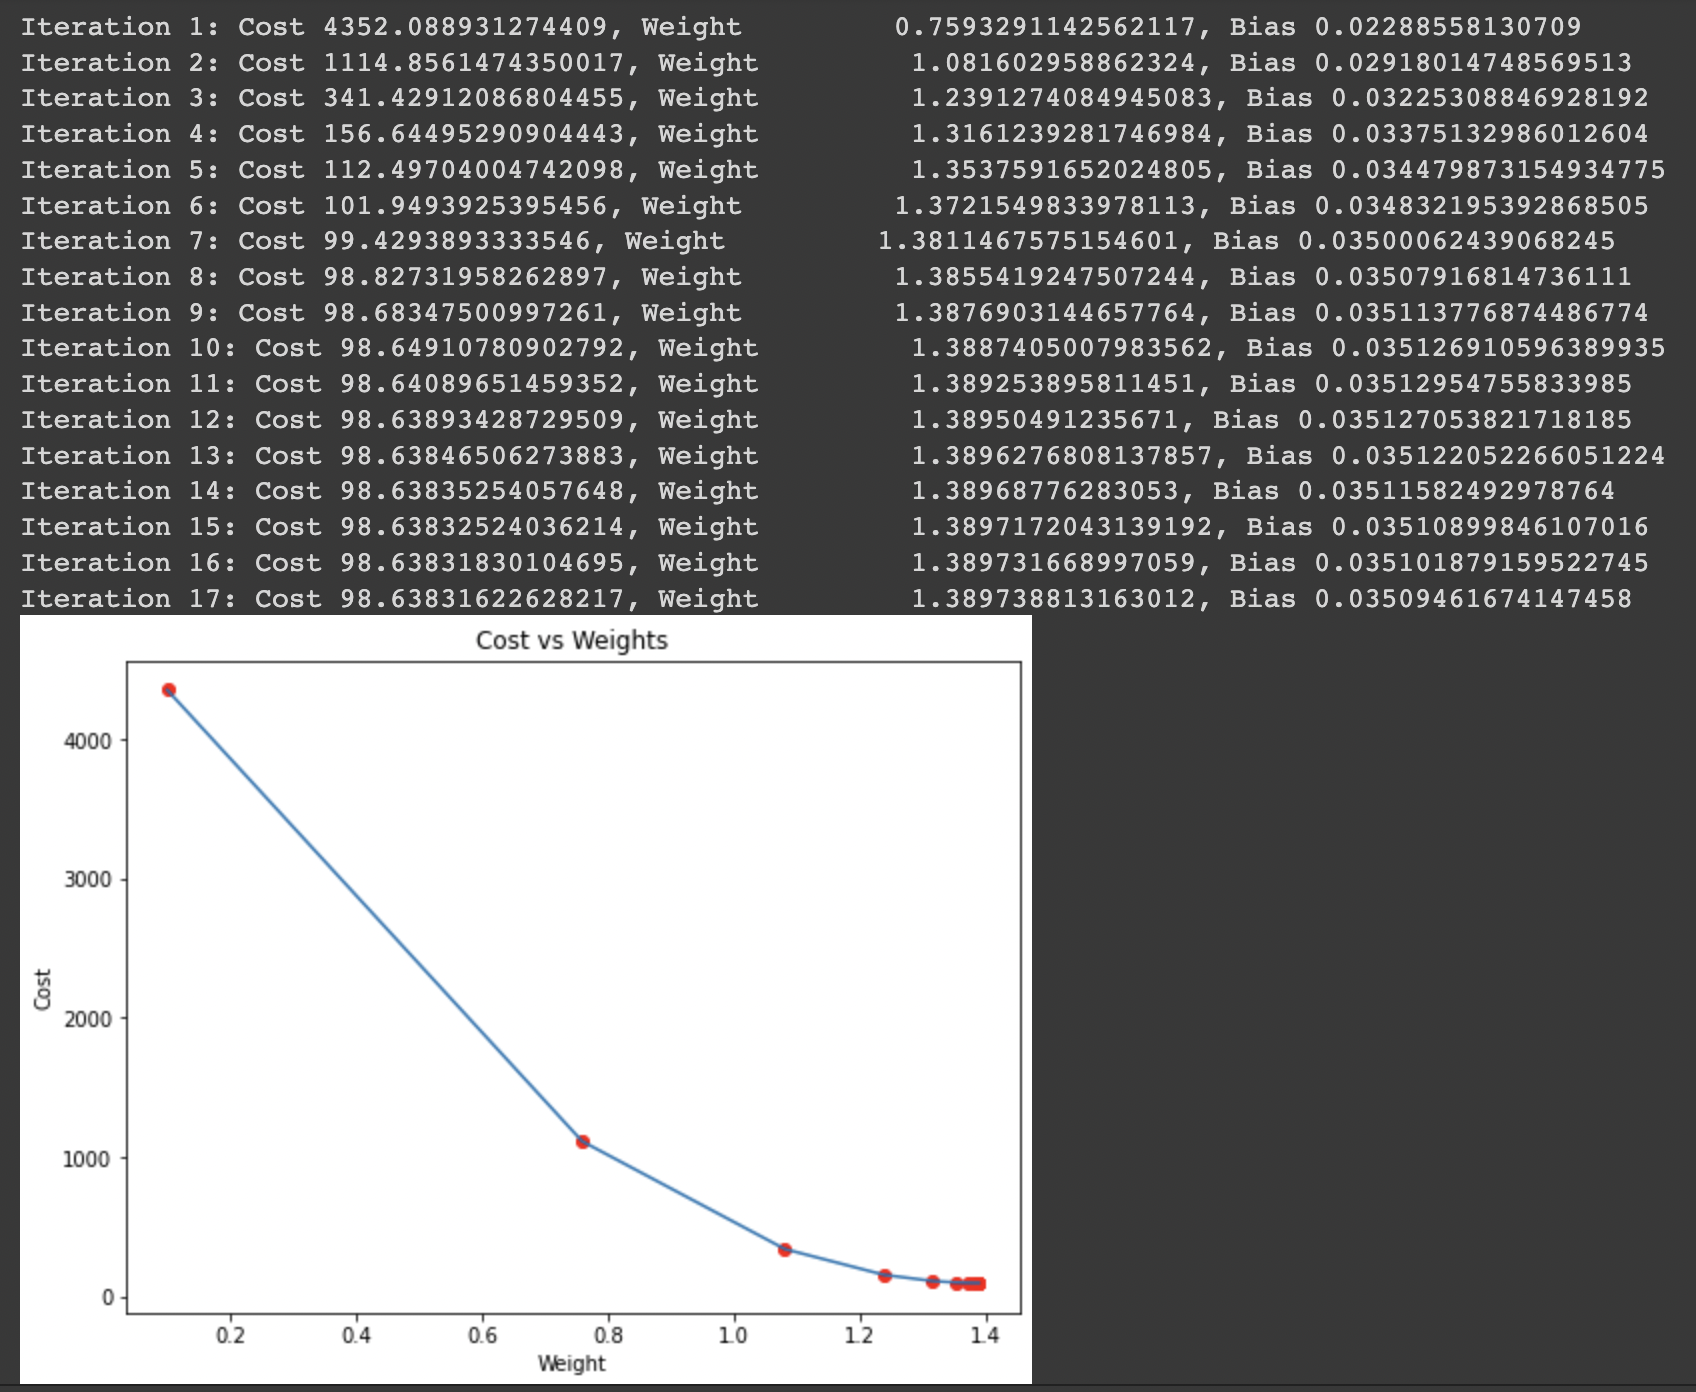
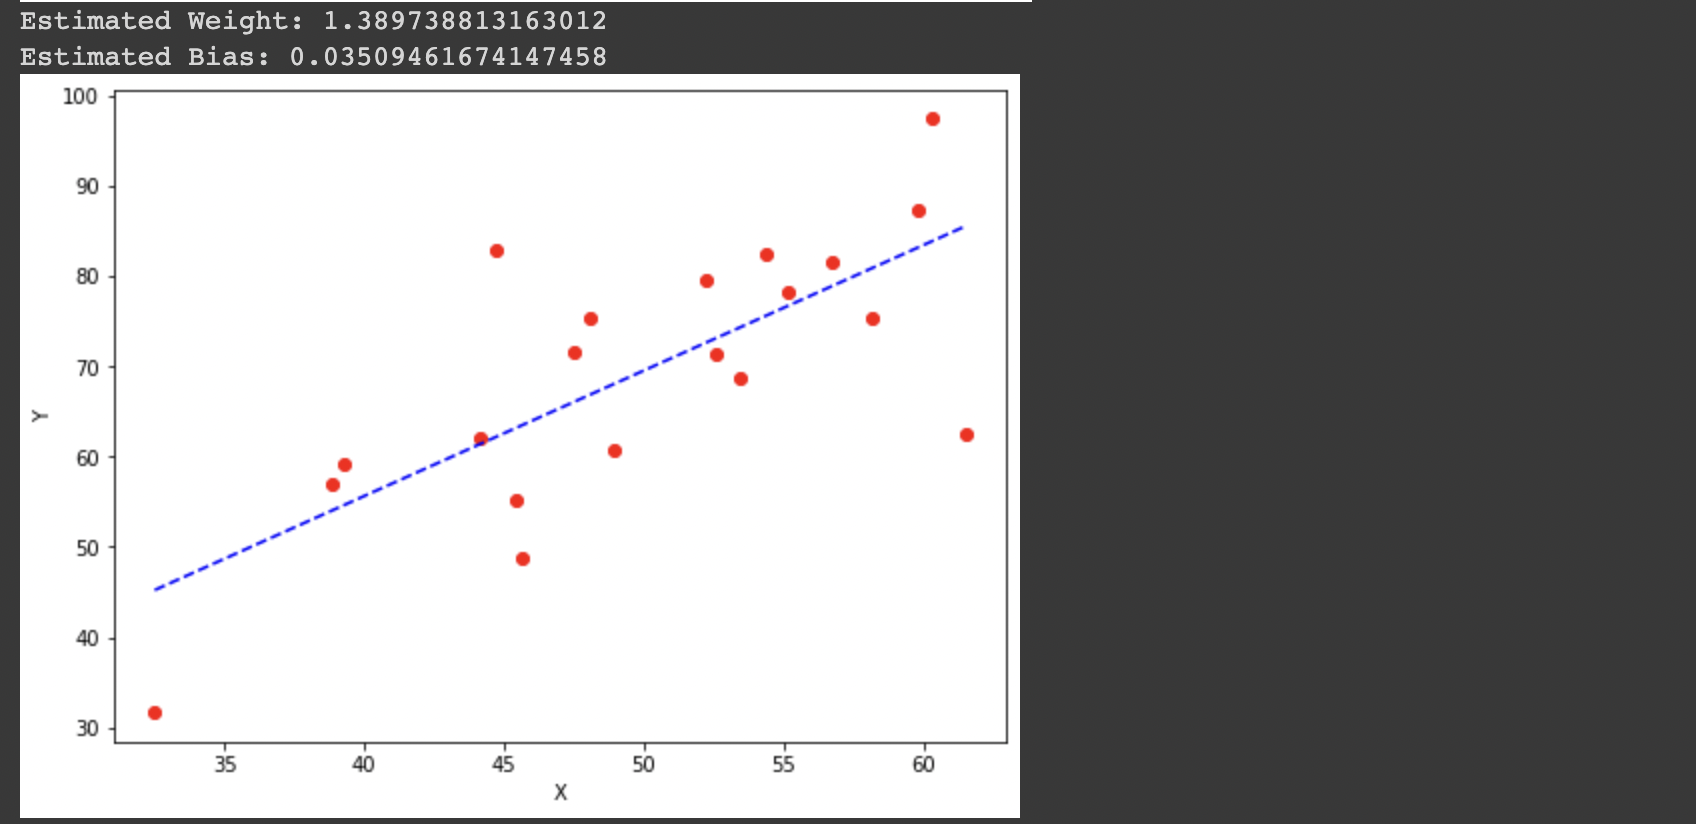
Puedes probar y ejecutar el código anterior en este notebook.
Otro elemento importante es la tasa de aprendizaje. En machine learning, a este tipo de factor lo llamamos hiperparámetro porque, aunque no es un parámetro del modelo en sí, sí impacta en su rendimiento final (igual que los parámetros del modelo).
La tasa de aprendizaje (a menudo representada como α o η) indica la velocidad a la que evolucionan los coeficientes. Puede ser fija o variable. Uno de los métodos más populares hoy es Adam, que ajusta la tasa de aprendizaje a lo largo del tiempo.
Hay muchos escenarios que prever y tener en cuenta al usar descenso de gradiente:
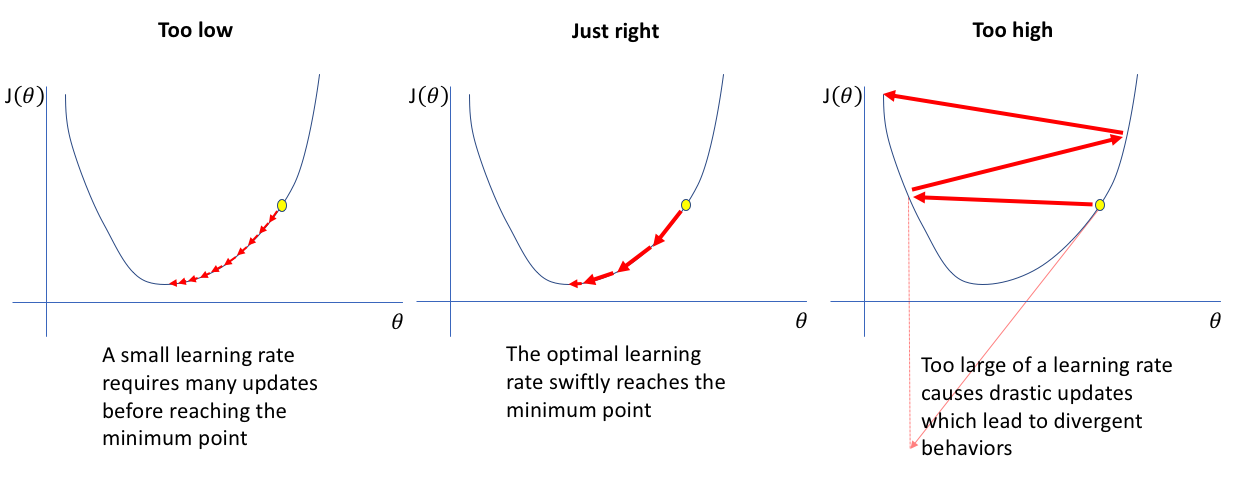
Si la tasa de aprendizaje es muy grande, darás pasos demasiado grandes. Esto tiene la ventaja de bajar rápido hacia el mínimo de la función de coste, pero corres el riesgo de saltártelo y oscilar alrededor de él indefinidamente. En la analogía del valle, es como avanzar varios kilómetros cada vez y pasar de largo el refugio sin darte cuenta.
Para evitar lo anterior, podrías elegir una tasa muy pequeña. Pero si es demasiado baja, puedes tardar una eternidad en converger al mínimo. Es como avanzar milímetro a milímetro por la ladera para encontrar el punto más bajo del valle.
Es esencial fijarlas en valores adecuados para que la bajada por la pendiente alcance mínimos locales. No deben ser ni demasiado altas ni demasiado bajas. Con pasos demasiado largos, llegar al mínimo se complica; con valores más pequeños, el descenso puede llegar al mínimo, pero tardará más.
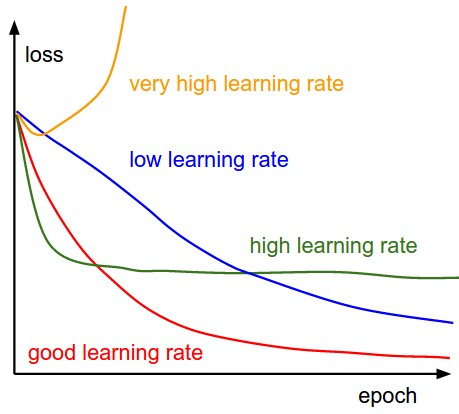
Por desgracia, no hay una fórmula mágica. La mayoría de las veces toca probar varios valores hasta dar con el adecuado. A esto lo llamamos ajuste de hiperparámetros, y existen diferentes estrategias para hacerlo bien.
Una buena práctica para asegurar un funcionamiento óptimo es representar la función de coste mientras optimizas. Pon el número de iteraciones en el eje X y el valor de la función de coste en el eje Y. Así verás cómo evoluciona tras cada iteración y podrás evaluar si la tasa de aprendizaje es adecuada. También puedes probar valores distintos y dibujarlos juntos.
Si el descenso de gradiente funciona bien, la función de coste disminuirá tras cada iteración. Decimos que converge cuando deja de reducirla y se mantiene estable. El número de iteraciones necesarias para converger varía mucho: a veces bastan cincuenta, otras pueden ser dos o tres millones. Es difícil estimarlo de antemano.
Algunos algoritmos pueden indicarte automáticamente si ha habido convergencia. Aun así, es recomendable fijar un umbral de convergencia por adelantado, aunque también es difícil de estimar. Por eso, en muchos casos, unas simples gráficas son la mejor herramienta para comprobar la convergencia.
Mientras que las personas científicas usan el descenso de gradiente para encontrar los valores de los parámetros que minimizan los costes de una función, quienes programan lo emplean como algoritmo de optimización al entrenar modelos de machine learning. El descenso de gradiente ajusta iterativamente algunos parámetros para minimizar una función, idealmente convexa.
El descenso de gradiente es probablemente la estrategia de optimización más reconocida en deep learning y machine learning. Las personas especialistas en datos lo utilizan a menudo porque se integra bien con multitud de modelos. Entender el algoritmo es relativamente sencillo, e implementarlo, aún más. Si quieres profundizar en deep learning, explora nuestro catálogo completo de cursos de machine learning.
Aprende con DataCamp
programa
Curso
Curso
blog
Abid Ali Awan
15 min
blog
Zoumana Keita
14 min
blog
Natassha Selvaraj
15 min
Tutorial
Joanne Xiong
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Kurtis Pykes
8 min





