Program
Makine Öğrenimi Bilimcisi Python'da
85 sa
Gradyan inişi, tüm makine öğrenimi ve derin öğrenme alanındaki en önemli algoritmalardan biridir. Doğrusal regresyon, lojistik regresyon ve sinir ağı modellerini eğitebilen son derece güçlü bir optimizasyon algoritmasıdır. Makine öğrenimine yeni başlıyorsanız, gradyan inişi algoritmasını derinlemesine anlamanız bu nedenle çok önemlidir.
Veri bilimi, büyük veri analizi içinde karmaşık örüntü ve davranışları keşfetmekle ilgilidir. Bunlara “örüntüler” yani yinelenen motifler denir. Makine öğrenimi yoluyla amaç, belirli bir görevi daha iyi yerine getirmek için algoritmaları veri analizindeki örüntüleri tespit edecek şekilde eğitmektir. Bu, yazılıma bir görevi özerk biçimde yapmayı ya da tahminlerde bulunmayı öğretmek demektir. Bunu yapmak için veri bilimci, veri analizi gerçekleştirecek algoritmaları seçer ve eğitir. Amaç elbette zamanla tahminleri iyileştirmektir.
Dolayısıyla, makine öğrenimi büyük ölçüde algoritmaların eğitimine dayanır. Bu algoritmalar veriye ne kadar çok maruz kalırsa, belirli talimatlar olmadan bir görevi yapmayı o kadar çok öğrenir; deneyimle öğrenirler. Makine öğreniminde farklı türde algoritmalar kullanırız. Bunlar arasında gradyan inişi en yararlı ve en popüler olanlardan biridir.
Gradyan inişi bir optimizasyon algoritmasıdır. Bir fonksiyonun minimum değerini daha hızlı bulmak için kullanılır. Gradyan inişinin tanımı oldukça basittir. Dışbükey (konveks) bir fonksiyonun minimumunu bulmaya yarayan bir algoritmadır. Bunu yapmak için, söz konusu fonksiyonun parametrelerini yinelemeli olarak değiştirir. Örneğin doğrusal regresyonda kullanılan bir algoritmadır.
Konveks bir fonksiyon, ortasında küresel bir minimum bulunan güzel bir vadiye benzeyen bir fonksiyondur. Buna karşılık, konveks olmayan bir fonksiyon birden çok yerel minimum içerir ve gradyan inişi algoritması bu tür fonksiyonlarda ilk karşılaşılan minimumda takılma riski nedeniyle kullanılmamalıdır.
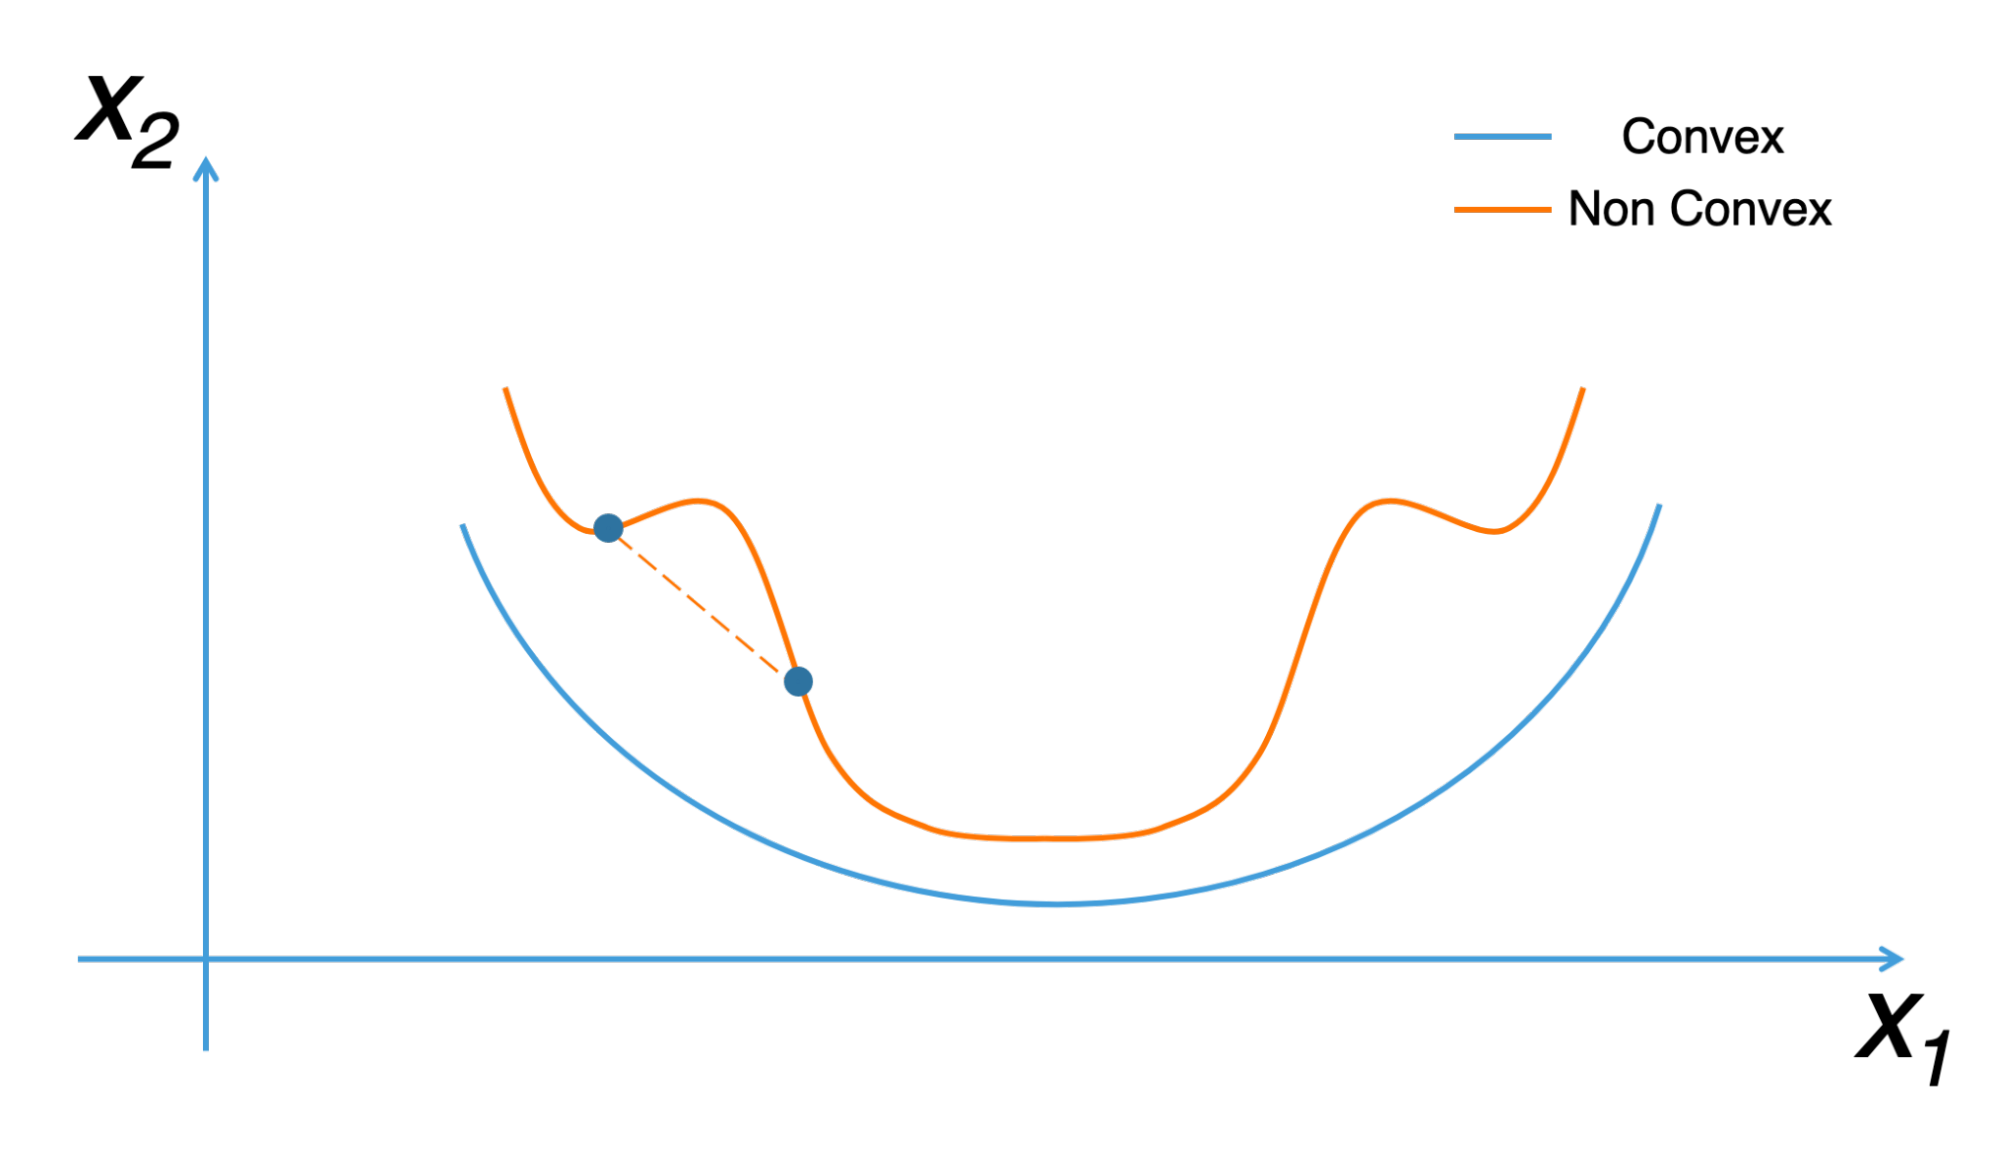
Gradyan inişi, “en dik aşağı eğim algoritması” olarak da adlandırılır. Makine öğreniminde çok önemlidir; burada bir maliyet fonksiyonunu en aza indirmek için kullanılır. Bu fonksiyon, veri analizinde en iyi tahmin modelini belirlemek için kullanılır. Maliyet ne kadar azaltılırsa, makine o kadar iyi tahmin yapabilir.
Üç iyi bilinen iniş türü bulacaksınız. Yakından bakalım:
Sıklıkla vanilla gradyan inişi olarak da bilinen yığın gradyan inişi, eğitim veri setindeki her örnek için hataları hesaplar. Ancak bunu, her eğitim örneği titizlikle değerlendirildikten sonra yapar. Bu süreci bir döngüye benzetmek yerindedir. Bazıları buna bir eğitim dönemi de der.
Yığın inişin çeşitli avantajları vardır. Özellikle, hesaplama verimliliği son derece pratiktir; çünkü kararlı bir yakınsama ve kararlı bir hata gradyanı geliştirir. Bununla birlikte, yığın gradyan inişinin bazı dezavantajları da vardır. Bazen kararlı hata gradyanı elverişsiz bir yakınsama durumuna yol açabilir. Ayrıca, algoritmada ve bellekte eğitim veri setinin bulunmasını gerektirir.
Stokastik gradyan inişi, her eğitim örneği için bireysel parametre güncellemeleri sağlar. Her örneğe dikkat edilmesine olanak tanıyarak sürecin hatasız olmasını hedefler. Probleme bağlı olarak, bu durum SGD'nin yığın gradyan inişine kıyasla daha hızlı olmasına yardımcı olabilir. Düzenli güncellemeler ayrıntılı iyileşme oranları sunar.
Ancak bu güncellemeler, adım adım yaklaşımda kullanılan yönteme kıyasla özellikle hesaplama açısından maliyetlidir. Ayrıca, güncellemelerin sıklığı gürültülü gradyanlara neden olabilir ve hata oranının düşmesini engelleyebilir. Bunun yerine hata oranı sıçrar ve uzun vadede sorun yaratır.
Bilim insanları mini-yığın gradyan inişini başlangıç yöntemi olarak kullanır. Neden? Çünkü stokastik iniş ile yığın iniş kavramlarının mükemmel bir karışımıdır. Veri setlerini (eğitim) yığınlara böler ve her yığın için bir güncelleme yapar; böylece BGD'nin verimliliği ile SGD'nin dayanıklılığı arasında denge kurar.
Popüler mini-yığın boyutları elliden iki yüz elli altıya kadar değişir; ancak pek çok makine öğrenimi yönteminde olduğu gibi, uygulamaya göre değiştiğinden net kurallar yoktur. Sinir ağlarını eğitmek için temel bir seçenek olarak kullanılır. Derin öğrenme dünyasında da popüler bir tepe inişi türüdür.
Makine öğreniminde, gradyan inişi algoritmasını, maliyet fonksiyonunu (örneğin, ortalama kare hata gibi konveks bir fonksiyon) en aza indirmek için denetimli öğrenme problemlerinde kullanırız.
Bu algoritma sayesinde makine en iyi modeli bularak öğrenir. Maliyet fonksiyonunun en aza indirilmesinin, modelimiz ile veri setindeki y noktaları arasındaki hataları en küçük yapan a, b, c vb. parametreleri bulmak olduğunu unutmayın. Maliyet fonksiyonu en aza indirildiğinde, bu doğru ses tanıma programları, bilgisayarla görme programları ve hisse senedi fiyatını tahmin eden uygulamalar geliştirmeye kapı aralar.
Görüldüğü gibi, gradyan inişi algoritması temel önemdedir: makine ondan öğrenir.
Bu algoritmanın işleyişini ve faydasını daha iyi anlatmak için sıklıkla dağ analojisi kullanılır. Dağlarda yolunu kaybetmiş birini hayal edelim. Esasen, önce en dik aşağı eğimin bulunduğu yönü bularak geri dönüş yolunu aramak söz konusudur. Bu yönde bir mesafe katettikten sonra, bu yöntem bir vadiye (en düşük değere) ulaşıncaya kadar tekrarlanmalıdır. Makine öğreniminde, gradyan inişi, maliyet fonksiyonu için bir minimum bulunana kadar bu yöntemin döngü halinde tekrarlanmasından ibarettir. Bu nedenle yinelemeli bir algoritma olarak adlandırılır ve çok sayıda hesaplama gerektirir.
Dağlarda kaybolduysanız işinize yarayacak 2 aşamalı bir strateji:
1 ve 2. adımları döngüsel olarak tekrar ederek, vadinin minimumuna yakınsayacağınızdan emin olursunuz. Bu strateji, gradyan inişi algoritmasından başka bir şey değildir.
Rastgele bir başlangıç noktasından başlar ve o noktadaki eğimin değerini ölçeriz. Matematikte, bir fonksiyonun türevini hesaplayarak eğimi ölçersiniz.
Sonra eğimin aşağı yönünde belli bir mesafe d ilerleriz; ama bu kez 300 metre değil. Bu mesafeye “öğrenme oranı” denir. Bu işlemin sonucu, modelimizin parametre değerlerini değiştirmektir (vadide hareket ettikçe koordinatlarımız değişir).
Gradyan inişi algoritması çoğunlukla makine öğrenimi ve derin öğrenme alanlarında kullanılır. Derin öğrenme, makine öğreniminin gelişmiş bir versiyonu olarak görülebilir. En ince örüntülerin tespit edilmesini sağlar. Bu disiplinler, güçlü bir matematik altyapısı ve Python bilgisi gerektirir.
Bu programlama dili, makine öğreniminin uygulanmasını kolaylaştıran çeşitli kütüphanelere sahiptir. Büyük veri hacimlerini hızlı ve doğru şekilde analiz etmek için son derece kullanışlıdır. Geçmiş eğilim veya olaylara dayalı öngörücü analiz yapılmasına olanak tanır.
Makine öğrenimi, kullanım imkanları bakımından büyük veriyle yakından ilişkili bilimlerden biridir. Büyük veri akışlarının analizinde insan zekâsının sınırlarını aşmayı sağlar. Çevrimiçi ortamda mevcut geniş veri setleri sayesinde, yapay zekâ (YZ) insan müdahalesi olmadan kendi kendine öğrenebilir. Makine öğrenimi örneğin nesnelerin interneti alanında kullanılır. Bu sayede bir YZ, akıllı bir evde yaşayanların alışkanlıklarına uyum sağlayabilir ve görevlerini bu alışkanlıkları dikkate alarak yerine getirebilir.
Örneğin YZ, bir odanın ısısını havaya göre ayarlayabilir. Giderek daha sofistike robot süpürgelere sahip olmamızı sağlayan da bu bilimdir. Makine öğrenimi aracılığıyla gradyan inişi, yapay zekâdaki büyük ilerlemelerin merkezinde yer alır. Uygulamada, mühendisler ve YZ uzmanları tarafından gradyan inişinin pek çok kullanımı vardır.
Google gibi arama motorları ve YouTube, Netflix ya da Amazon gibi popüler öneri motorları için faydalıdır. Kullanıcılardan toplanan verilere dayanarak algoritmalar, internet kullanıcısının ilgi alanlarını anlamaya çalışır. Bu da onlara ilgili arama sonuçları ve daha iyi öneriler sunmalarını sağlar.
Makine öğrenimi, bilgisayarların insan dilini anlamasını ve işlemesini mümkün kılmıştır. Alexa, Google Assistant ve Siri gibi dijital asistanların doğmasını sağlayan uygulama budur. Makine öğrenimi ve gradyan inişi uygulamaları, video oyunu geliştiricileri için de çok kullanışlıdır. Buradaki amaç, insanların daha yüksek katma değerli faaliyetlere odaklanabilmesi için YZ'lerin en insani görevlerde mükemmelleşmesini sağlamaktır. Yapay zekâ ve makine öğrenimi, şirketlerin müşterilerinin ihtiyaçlarını ve gelecekteki eğilimleri öngörmelerini sağlar.
Gradyan inişi, hesaplama karmaşıklığı nedeniyle doğrusal regresyonda kullanılan bir algoritmadır. Gradyan inişi için genel matematiksel formül xt+1= xt- η∆xt'dir; burada η öğrenme oranını, ∆xt ise iniş yönünü temsil eder. Gradyan inişi, konveks fonksiyonlara uygulanabilir bir algoritmadır. Minimize edilecek konveks bir fonksiyon olarak ƒ alındığında, amaç her yinelemede ƒ(xt+1) ≤ ƒ (xt) elde etmektir.
Buradaki fikir, bir matematiksel fonksiyonun minimumunu kademeli olarak hesaplayacak bu algoritmayı kullanmaktır. Bazı denklemlerle karşılaşıldığında, bunları çözmenin en iyi yolu budur. Gradyan inişinden bahsederken maliyet fonksiyonu kavramını da anlamak gerekir. Denetimli modda bu fonksiyon, bir tahmin ile gerçek değer arasındaki hata payını ölçmeyi sağlar. Doğrusal regresyon probleminde ortalama kare gradyanı hesaplama formülü şöyledir:
Gradyan inişinin uygulanması, öğrenme oranı kavramını da kullanır. Bu, ağ ağırlıklarının kayıp gradyanına göre ayarlanmasını kontrol etmeyi sağlayan bir hiperparametredir. Daha hızlı ve verimli şekilde bir minimum elde etmek için en uygun öğrenme oranının çok önemli olduğu unutulmamalıdır. Ne çok yüksek ne de çok düşük olmalıdır.
Değer aşağı indikçe, aşağı eğim boyunca kademeli olarak ilerlediğinizi gösterir. RMSprop, Adam ve SGD gibi birçok optimizasyon yöntemi gradyan inişi algoritmasını kullanır. Bu algoritmayı kullanırken hata yapmamak için parametrelerinizi dikkatle seçmeniz önerilir. Ayrıca bulunan minimumun küresel minimum olarak kabul edilmeyebileceğini akılda tutmak gerekir.
Bir gradyanın birincil işlevi, her bir ağırlığın hatalardaki değişime karşı değişimini ölçmektir. Gradyanları bir fonksiyonun eğimi olarak düşünün. Gradyan ne kadar yüksekse eğim o kadar diktir — bu, modeller için elverişli bir durumdur; çünkü hızlı öğrenebilirler. Ancak eğim sıfır olursa model öğrenmeyi durdurur. Matematiksel olarak, bir gradyan girdilerine göre sonlu bir türev olarak tanımlanabilir.
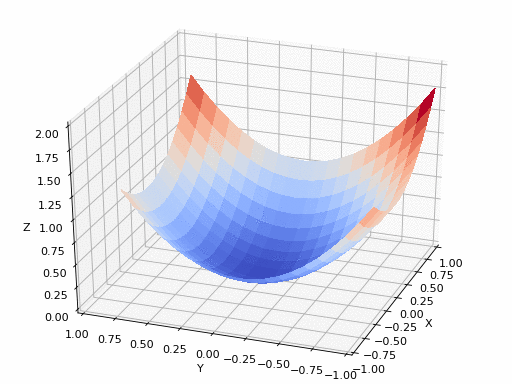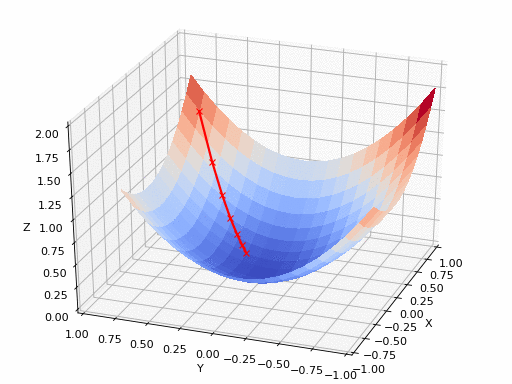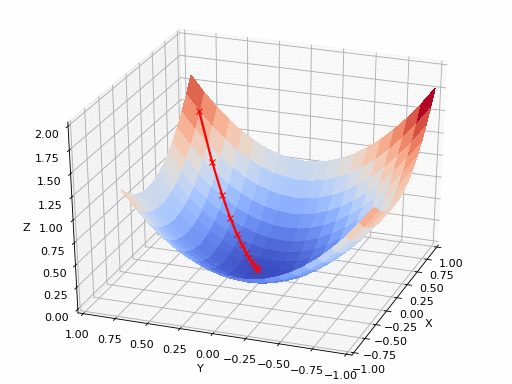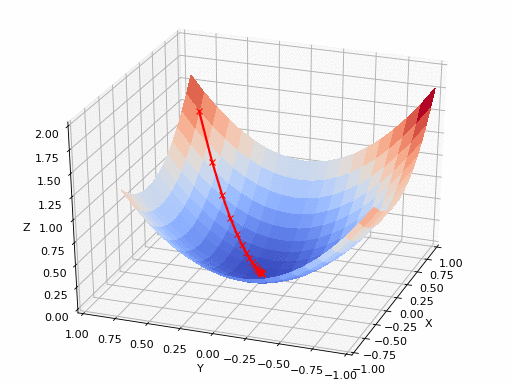
Uygulama kısmında iki fonksiyon yazacağız. Biri, gerçek çıktı ile tahmin edilen çıktıyı girdi olarak alan ve kaybı döndüren maliyet fonksiyonu olacak. İkincisi ise, bağımsız değişkeni ve hedef değişkeni (bağımlı değişken) girdi olarak alıp gradyan inişi algoritmasını kullanarak en iyi uyan doğruyu bulan asıl gradyan inişi fonksiyonu olacak.
Yineleme sayısı, öğrenme oranı ve durdurma eşiği, gradyan inişi algoritmasının ayar parametreleridir ve kullanıcı tarafından belirlenebilir. Ana fonksiyonda, rastgele doğrusal ilişkili veriler başlatacak ve veriler üzerinde gradyan inişi algoritmasını uygulayarak en iyi uyan doğruyu bulacağız. Gradyan inişi algoritmasıyla bulunan optimal ağırlık ve sapma (bias) daha sonra ana fonksiyonda en iyi uyan doğruyu çizmek için kullanılır.
#Importing libraries
import numpy as np
import matplotlib as pyplot

def mean_squared_error(y_true, y_predicted):

   # Calculating the loss or cost
   cost = np.sum((y_true-y_predicted)**2) / len(y_true)
   return cost

# Gradient descent function
# Here iterations, learning rate, stopping threshold are hyperparameters that can be tuned
def gradient_descent((x, y, iterations = 1000, learning_rate = 0.0001, stopping_theshold = 1e-6):

   #Initialzing rate, bias, learning rate, and iterations
   current_rate = 0.1
   current_bias = 0.01
   iterations = iterations
   learning_rate = learning_rate
   n = float(len(x))

   costs = []
   weights = []
   previous_cost = None

   # Estimation of optimal parameters
   for i in range(iterations):

      # Making predictions
      y_predicted = (current_weight * x) + current_bias

      # Calculating the current cost
      current_cost = mean_squared_error(y, y_predicted)

      # If the change in cost is less than or equal to stopping threshold we stop the gradient descent
      if previous_cost and abs(previous_cost - current_cost) <= stopping_threshold:
         break

      previous_cost = current_cost

      costs.append(current_cost)
      weights.append(current_weight)

      # Calculating the gradients
      weight_derivative = -(2/n) * sum(x * (y-y_predicted))
      bias_derivative = -(2/n) * sum(y-y_predicted)

      # Updating weights and bias
      current_weight = current_weight - (learning_rate * weight_derivative)
      current_bias = current_bias - (learning_rate * bias_derivative)

      # Printing the parameters for each 1000th iteration
      print(f"Iteration {i+1}: Cost {current_cost}, Weight \n {current_weight}, Bias {current_bias}")

   # Visualizing the weights and cost for all iterations
   plt.figure(figsize = = (8,6))
   plt.plot(weights, cost)
   plt.scatter(weights, cost, marker = 'o', color = 'red')
   plt.title("Cost vs Weights")
   plt.ylabel("Cost")
   plt.xlabel("Weights")
   plt.show()

   return current_weight, current_bias

def main()

   # Data
   X = np.array(32.5, 53.4, 61.5, 47.4, 59.8,
   55.1, 52.2, 39.2, 48.1, 52.5,
   45.4, 54.3, 44.1, 58.1, 56.7,
   48.9, 44.6, 60.2, 45.6, 38.8])
   Y = np.array(31.7, 68.7, 62.5, 71.5, 87.2,
   78.2, 79.6, 59.1, 75.3, 71.3,
   55.1, 82.4, 62.0, 75.3, 81.4,
   60.7, 82.8, 97.3, 48.8, 56.8])

   # Estimating weight and bias using gradient descent
   estimated_weight, estimated_bias = gradient_descent(X, Y, iterations = 2000)
   print(f"Estimated Weight: {estimated weight}\nEstimated Bias: {estimated bias}")

   # Making predictions using estimated parameters
   Y_pred = estimated_weight*X = estimated_bias

   #Plotting the regression line
   plt.figure(figsize = 8,6)
   plt.scatter(X, Y, marker = 'o', color = 'red')
   plt.plot([min(X), max(X)], [min(Y_pred), max(Y_pred)], color = 'blue')
   plt.ylabel("X")
   plt.xlabel("Y")
   plt.show()

if __name__=="__main__":
   main()
Aşağıdaki kodun çıktısı şu şekilde olacaktır:
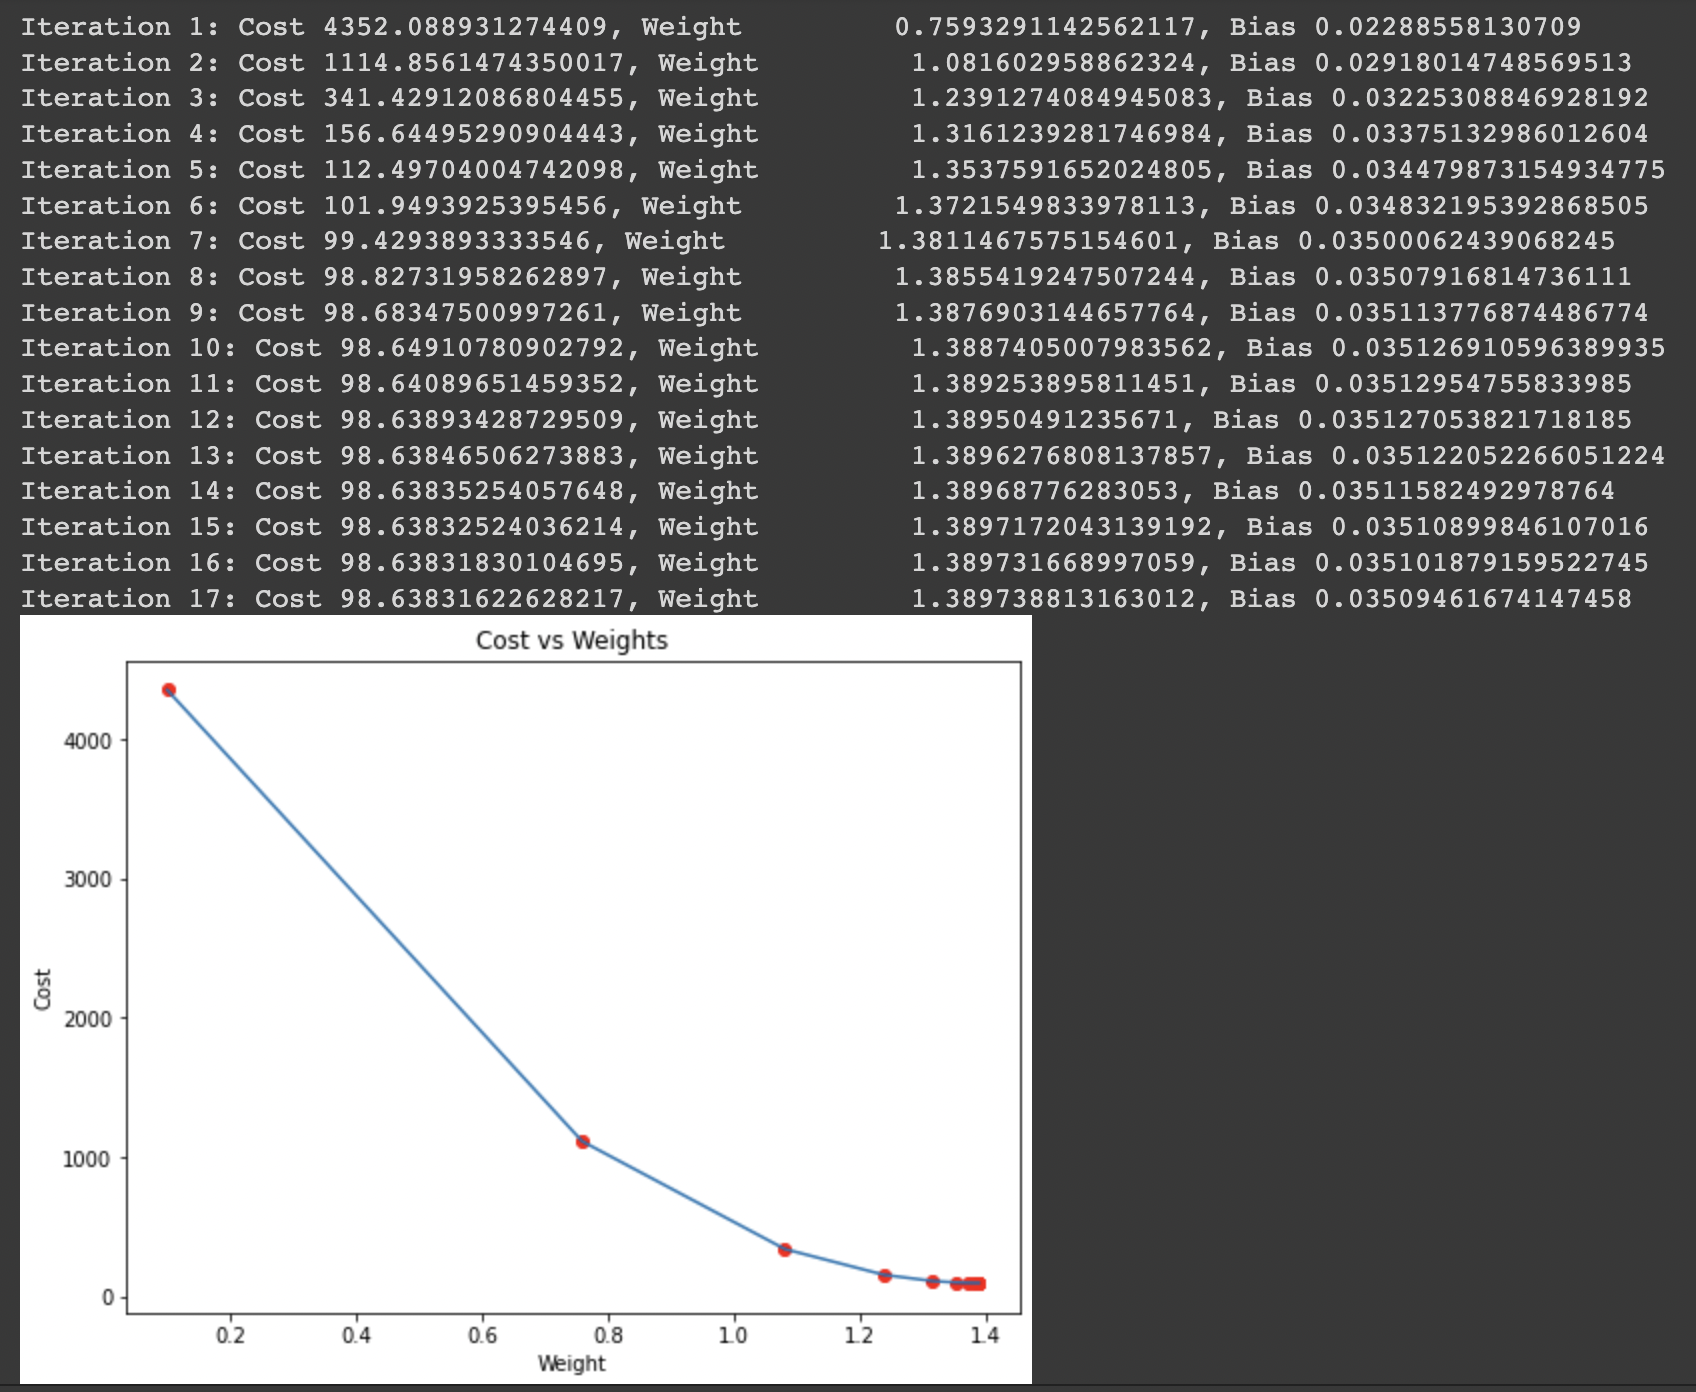
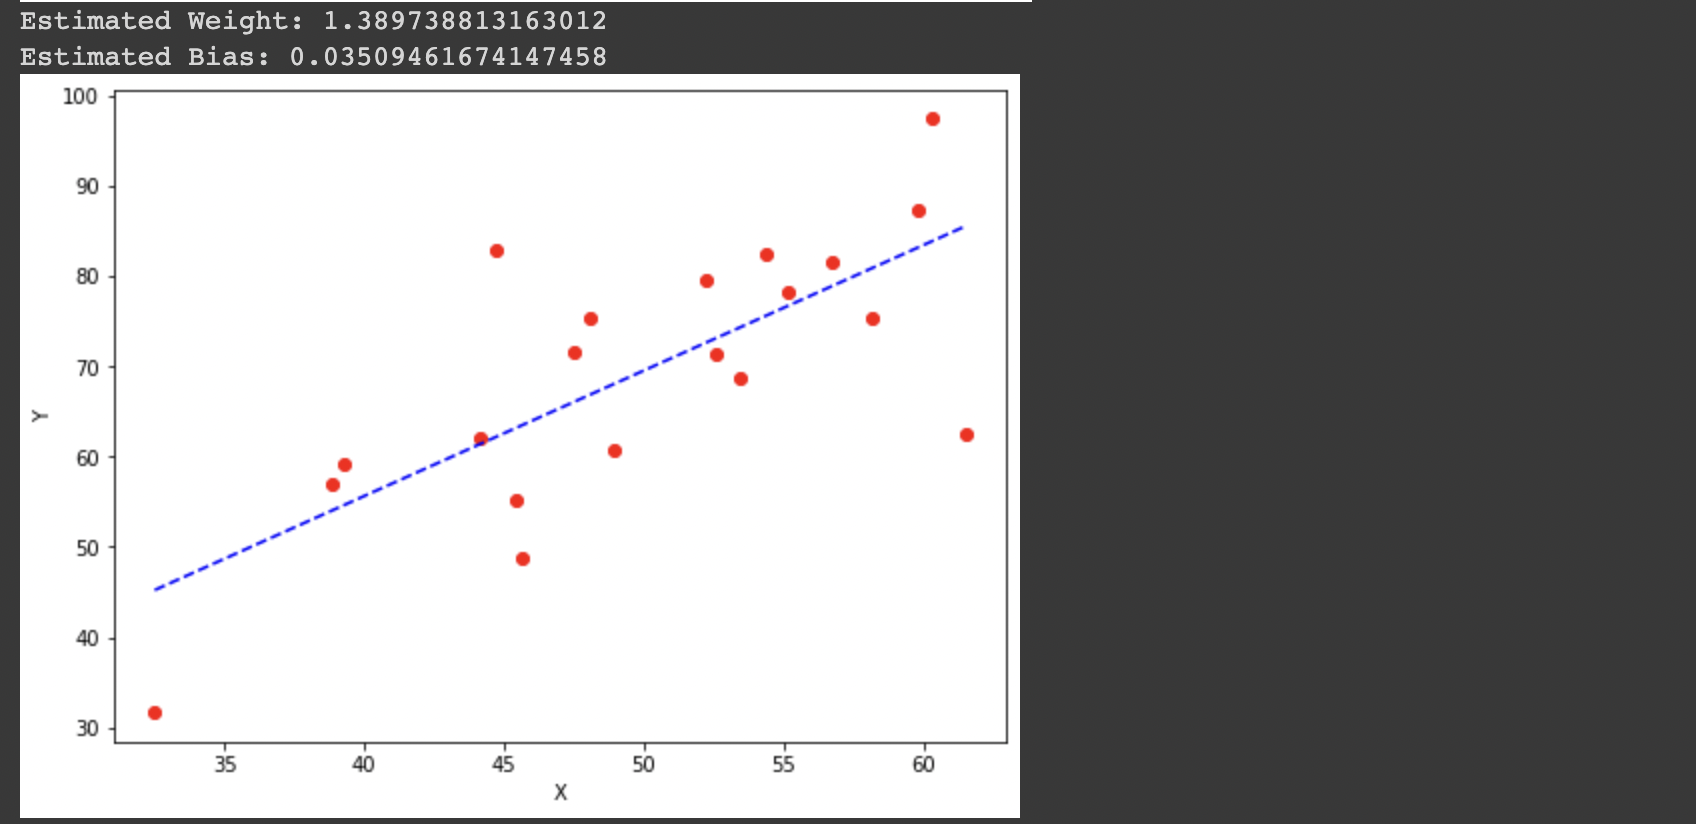
Yukarıdaki kodu bu defter
ile test edip çalıştırabilirsiniz.Vurgulanması gereken bir diğer unsur öğrenme oranıdır. Makine öğreniminde, bu tür bir faktöre hiperparametre deriz; çünkü modelimizin bir parametresi olmasa da (model parametreleri gibi) modelimizin nihai performansı üzerinde etkisi vardır.
Öğrenme oranı (genellikle α veya bazen η ile gösterilir), katsayıların hangi hızla değiştiğini belirtir. Bu büyüklük sabit ya da değişken olabilir. Şu anda en popüler yöntemlerden biri, zamanla ölçeklenen bir öğrenme oranına sahip olan Adam'dır.
Gradyan inişini kullanırken beklenmesi ve dikkate alınması gereken birçok senaryo vardır:
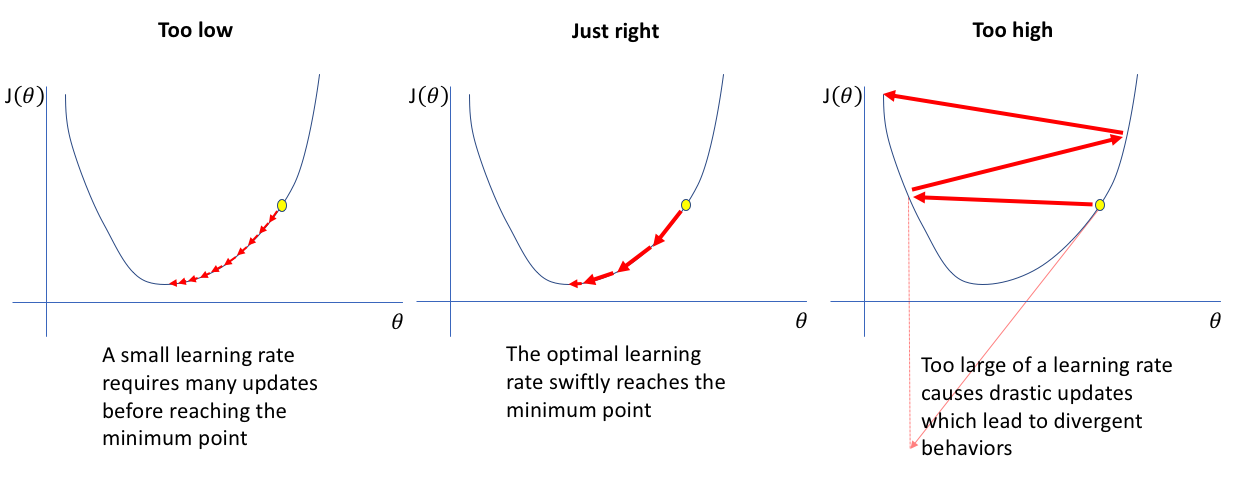
Öğrenme oranı çok büyükse, gradyan inişinde çok büyük adımlar atarsınız. Bu, maliyet fonksiyonunun minimumuna hızlıca inme avantajına sahiptir; ancak sonsuza dek etrafında salınıp minimumu ıskalama riski vardır. Vadi analojisinde, her seferinde birkaç kilometre giderek, barınağın yanından fark etmeden geçip gitmeye benzer.
Önceki durumu önlemek için çok düşük bir öğrenme oranı seçmeye meyledebilirsiniz. Ancak çok düşükse, maliyet fonksiyonunun minimumuna yakınsamak sonsuz zaman alabilir. Vadinin en düşük noktasını bulmak için dağda milimetre milimetre ilerlemeyi seçmeye benzer.
Eğim inişinin yerel minimumlara ulaşmasına yardımcı olmak için öğrenme oranlarını uygun değerlere ayarlamak esastır. Bu nedenle onları ne çok yüksek ne de çok düşük ayarlamamak en iyisidir. Bu önemlidir; çünkü adımlar çok uzun olursa minimuma ulaşmak zorlaşabilir. Dolayısıyla öğrenme oranlarını daha düşük değerlere ayarlarsak, gradyan inişi eninde sonunda yerel minimumlarına ulaşabilir. Ancak bu zaman alabilir.
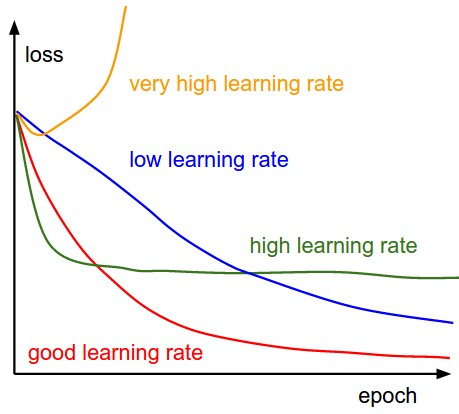
Ne yazık ki doğru öğrenme oranını bulmak için sihirli bir formül yoktur. Çoğu zaman, doğru değeri bulmadan önce deneme-yanılma yapmanız ve birkaç değer denemeniz gerekir. Buna hiperparametre ayarlama denir ve bunu doğru şekilde yapmak için farklı stratejiler vardır.
Eğim inişinin en iyi şekilde çalıştığından emin olmanın harika bir yolu, optimizasyon sürerken maliyet fonksiyonunu çizdirmektir. X eksenine yineleme sayısını, Y eksenine ise maliyet fonksiyonunun değerini koyun. Bu, her gradyan inişi yinelemesinden sonra maliyet fonksiyonunun değerini görmenizi ve öğrenme oranının doğruluğunu takip etmenizi sağlar. Farklı değerleri deneyip birlikte de çizebilirsiniz.
Gradyan inişi optimal şekilde çalışıyorsa maliyet fonksiyonu her yinelemeden sonra azalacaktır. Gradyan inişi, maliyet fonksiyonunu daha fazla azaltamadığında ve aynı seviyede kaldığında yakınsar. Gradyan inişinin yakınsaması için gereken yineleme sayısı büyük ölçüde değişir. Bazen elli yineleme yeterliyken, bazen iki ya da üç milyon olabilir. Yineleme sayısını önceden tahmin etmek zordur.
Bazı algoritmalar, gradyan inişinde yakınsama olup olmadığını size otomatik olarak söyleyebilir. Ancak önceden bir yakınsama eşiği belirlemek daha iyi olur; bu da tahmin edilmesi oldukça zor bir değerdir. Bu, yakınsama testleri için basit çizimlerin neden en iyisi olduğuna dair önemli bir nedendir.
Bilim insanları, bir fonksiyonun maliyetlerini en aza indirmek için fonksiyonun parametrelerinin değerlerini bulmak üzere gradyan inişini kullanırken, programcılar makine öğrenimi modellerini eğitirken gradyan inişini bir optimizasyon algoritması olarak kullanırlar. Gradyan inişi, konveks fonksiyonlara dayalı belirli bir fonksiyonu en aza indirmek için bazı parametrelerini yinelemeli olarak ayarlar.
Gradyan inişi, derin öğrenme ve makine öğreniminde kullanılan muhtemelen en bilinen optimizasyon stratejisidir. Veri bilimciler, her algoritmayı öğrenme modelleriyle birleştirme şansı olduğunda sıklıkla bunu kullanır. Gradyan inişi algoritmasını anlamak nispeten basittir ve uygulaması daha da basittir. Derin öğrenme alanına daha derinlemesine dalmak için tam makine öğrenimi kursları katalogumuzu inceleyin.
DataCamp ile öğrenin
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



