Lộ trình
Chuyên gia Khoa học Học máy trong Python
85 giờ
Gradient descent là một trong những thuật toán quan trọng nhất trong toàn bộ machine learning và deep learning. Đây là một thuật toán tối ưu hóa cực kỳ mạnh mẽ có thể huấn luyện các mô hình hồi quy tuyến tính, hồi quy logistic và mạng nơ-ron. Nếu bạn bắt đầu với machine learning, việc hiểu sâu thuật toán gradient descent là điều bắt buộc.
Khoa học dữ liệu là tìm ra các mẫu và hành vi phức tạp trong phân tích dữ liệu lớn. Đây được gọi là “mẫu”, tức là các mô-típ lặp lại. Thông qua machine learning, vấn đề là huấn luyện các thuật toán phát hiện mẫu trong phân tích dữ liệu để thực hiện một tác vụ cụ thể tốt hơn. Điều này có nghĩa là dạy phần mềm tự thực hiện một tác vụ hoặc tự động đưa ra dự đoán. Để làm được điều đó, nhà khoa học dữ liệu lựa chọn và huấn luyện các thuật toán để phân tích dữ liệu. Mục tiêu, dĩ nhiên, là cải thiện dự đoán theo thời gian.
Do đó, machine learning phần lớn dựa vào việc huấn luyện các thuật toán. Càng tiếp xúc với dữ liệu, các thuật toán càng học được cách thực hiện tác vụ mà không cần hướng dẫn cụ thể; chúng học qua trải nghiệm. Chúng ta dùng nhiều loại thuật toán trong machine learning. Trong số đó, gradient descent là một trong những thuật toán hữu ích và phổ biến nhất.
Gradient descent là một thuật toán tối ưu hóa. Nó được dùng để tìm giá trị nhỏ nhất của một hàm nhanh hơn. Định nghĩa của gradient descent khá đơn giản. Đây là một thuật toán để tìm cực tiểu của một hàm lồi. Để làm điều đó, nó lặp lại việc thay đổi các tham số của hàm đang xét. Đây là một thuật toán, ví dụ, được dùng trong hồi quy tuyến tính.
Một hàm lồi trông như một thung lũng đẹp với cực tiểu toàn cục ở giữa. Ngược lại, một hàm không lồi có nhiều cực tiểu cục bộ, và không nên dùng thuật toán gradient descent trên các hàm này vì có nguy cơ mắc kẹt ở cực tiểu đầu tiên gặp phải.
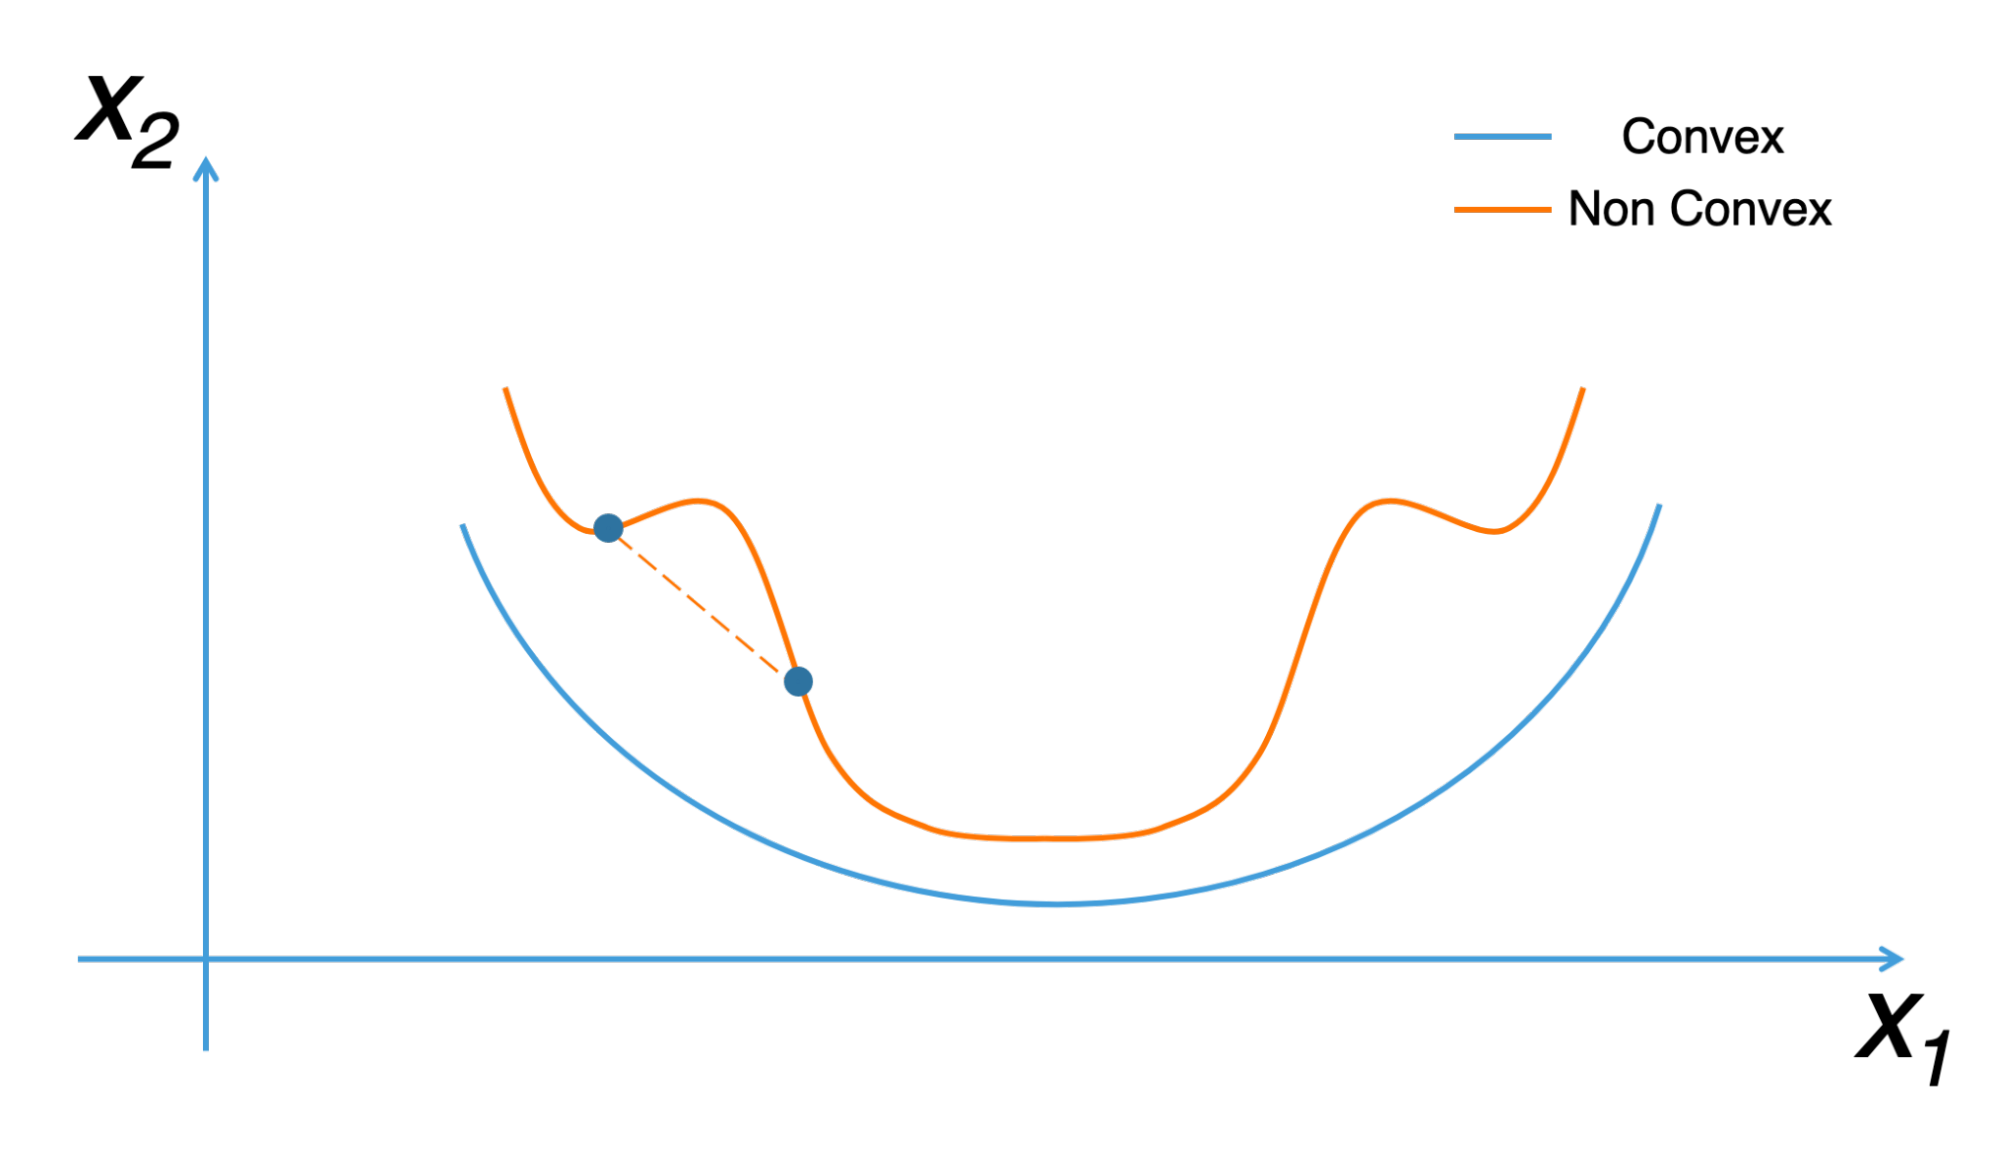
Gradient descent còn được gọi là “thuật toán dốc xuống sâu nhất”. Nó rất quan trọng trong machine learning, nơi nó được dùng để tối thiểu hóa một hàm chi phí. Hàm này dùng để xác định mô hình dự đoán tốt nhất trong phân tích dữ liệu. Chi phí được tối thiểu hóa càng nhiều, máy càng có khả năng đưa ra dự đoán tốt.
Có ba kiểu giảm dốc nổi tiếng. Hãy xem kỹ từng kiểu:
Còn được gọi là vanilla gradient descent, batch gradient descent tính sai số cho từng mẫu trong tập dữ liệu huấn luyện. Tuy nhiên, nó chỉ thực hiện sau khi từng mẫu huấn luyện đã được đánh giá nghiêm ngặt. Có thể so sánh quá trình này với một chu kỳ. Một số người cũng gọi đây là một kỷ nguyên huấn luyện.
Batch descent có một số ưu điểm. Đặc biệt, hiệu quả tính toán của nó cực kỳ thực tiễn vì nó tạo ra hội tụ ổn định và gradient sai số ổn định. Dẫu vậy, batch gradient descent cũng có một số nhược điểm. Đôi khi, gradient sai số ổn định có thể dẫn đến trạng thái hội tụ bất lợi. Ngoài ra, nó cũng cần sự hiện diện của toàn bộ tập dữ liệu huấn luyện trong thuật toán và bộ nhớ.
Stochastic gradient descent cung cấp cập nhật tham số riêng lẻ cho từng mẫu huấn luyện. Nó cho phép tập trung vào từng mẫu, đảm bảo quá trình không có lỗi. Tùy thuộc vào bài toán, điều này có thể giúp SGD nhanh hơn so với batch gradient descent. Những cập nhật đều đặn của nó cho chúng ta tốc độ cải thiện chi tiết.
Tuy nhiên, các cập nhật này tốn kém về tính toán, đặc biệt khi so với cách tiếp cận theo từng bước của batch. Thêm nữa, tần suất cập nhật có thể gây gradient nhiễu và có thể ngăn tỷ lệ lỗi giảm xuống. Thay vào đó, tỷ lệ lỗi nhảy lên xuống và trở nên vấn đề về lâu dài.
Các nhà khoa học sử dụng mini-batch gradient descent như một phương pháp khởi đầu. Vì sao? Bởi nó là sự kết hợp hoàn hảo giữa khái niệm của stochastic descent và batch descent. Nó chia (dữ liệu huấn luyện) thành từng lô và thực hiện cập nhật cho mỗi lô, tạo sự cân bằng giữa hiệu quả của BGD và độ vững của SGD.
Kích thước mini-batch phổ biến dao động từ năm mươi đến hai trăm năm mươi sáu, nhưng giống nhiều phương pháp machine learning khác, không có quy tắc cố định vì còn tùy ứng dụng. Mọi người dùng nó như lựa chọn cơ bản để huấn luyện mạng nơ-ron. Đây cũng là kiểu “giảm đồi” phổ biến trong bối cảnh deep learning.
Trong machine learning, chúng ta dùng thuật toán gradient descent trong các bài toán học có giám sát để tối thiểu hóa hàm chi phí, vốn là một hàm lồi (ví dụ, sai số bình phương trung bình).
Nhờ thuật toán này, máy học bằng cách tìm mô hình tốt nhất. Hãy nhớ rằng tối thiểu hóa hàm chi phí đồng nghĩa với việc tìm các tham số a, b, c, v.v. sao cho sai số giữa mô hình và các điểm y trong tập dữ liệu là nhỏ nhất. Khi hàm chi phí được tối thiểu hóa, điều này mở ra cánh cửa để xây dựng các chương trình nhận dạng giọng nói, thị giác máy tính chính xác, và ứng dụng dự đoán giá cổ phiếu.
Bạn có thể thấy vì sao thuật toán gradient descent là nền tảng: máy học từ chính nó.
Để minh họa rõ hơn cách hoạt động và tính hữu ích của thuật toán này, chúng ta thường dùng phép ẩn dụ ngọn núi. Hãy tưởng tượng một người bị lạc trên núi. Về cơ bản, việc cần làm là tìm đường quay lại bằng cách trước tiên tìm hướng có độ dốc đi xuống lớn nhất. Sau khi đi theo hướng đó một quãng nhất định, cần lặp lại phương pháp này cho đến khi tới một thung lũng (giá trị thấp nhất). Trong machine learning, gradient descent gồm việc lặp lại phương pháp này trong vòng lặp cho đến khi tìm được cực tiểu của hàm chi phí. Vì vậy, nó được gọi là thuật toán lặp và cần rất nhiều phép tính.
Đây là chiến lược 2 bước giúp bạn khi bị lạc trên núi:
Bằng cách lặp đi lặp lại bước 1 và 2, bạn chắc chắn sẽ hội tụ về điểm thấp nhất của thung lũng. Chiến lược này chính là thuật toán gradient descent.
Chúng ta bắt đầu từ một điểm khởi đầu ngẫu nhiên rồi đo giá trị độ dốc tại điểm đó. Trong toán học, bạn đo độ dốc bằng cách tính đạo hàm của hàm.
Sau đó, chúng ta tiến thêm một quãng d theo hướng dốc đi xuống, nhưng không phải 300 mét lần này. Quãng này được gọi là “tốc độ học”. Kết quả của thao tác này là thay đổi giá trị các tham số của mô hình (tọa độ trong thung lũng thay đổi khi chúng ta di chuyển).
Thuật toán gradient descent chủ yếu được dùng trong lĩnh vực machine learning và deep learning. Deep learning có thể được coi là phiên bản nâng cao của machine learning. Nó cho phép phát hiện các mẫu tinh vi nhất. Đây là những lĩnh vực đòi hỏi nền tảng toán học vững và kiến thức Python.
Ngôn ngữ lập trình này có nhiều thư viện hỗ trợ áp dụng machine learning. Lĩnh vực này rất hữu ích để phân tích khối lượng dữ liệu lớn một cách chính xác và nhanh chóng. Nó cho phép phân tích dự báo dựa trên các xu hướng hay sự kiện trong quá khứ.
Machine learning là một trong những khoa học gắn liền chặt chẽ với big data về cơ hội khai thác. Nó cho phép vượt qua giới hạn trí tuệ con người trong phân tích dòng dữ liệu lớn. Với các tập dữ liệu khổng lồ sẵn có trực tuyến, trí tuệ nhân tạo (AI) có thể tự học mà không cần can thiệp của con người. Machine learning được dùng, ví dụ, trong lĩnh vực đồ vật kết nối. Nhờ đó, một AI có thể thích nghi với thói quen của cư dân trong ngôi nhà thông minh và thực hiện nhiệm vụ có tính đến những thói quen này.
Chẳng hạn, AI có thể điều chỉnh nhiệt độ phòng theo thời tiết. Chính khoa học này cũng giúp chúng ta có những robot hút bụi ngày càng tinh vi. Gradient descent thông qua machine learning là cốt lõi của các tiến bộ lớn trong AI. Trên thực tế, có rất nhiều ứng dụng gradient descent bởi kỹ sư và chuyên gia AI.
Nó hữu ích cho các công cụ tìm kiếm như Google, và các hệ thống gợi ý phổ biến như YouTube, Netflix hay Amazon. Dựa trên dữ liệu thu thập từ người dùng, các thuật toán sẽ cố gắng hiểu sở thích của người dùng Internet. Điều này cho phép đưa ra kết quả tìm kiếm phù hợp và gợi ý tốt hơn.
Machine learning đã giúp máy tính hiểu và xử lý ngôn ngữ con người. Ứng dụng này đã sinh ra các trợ lý số như Alexa, Google Assistant và Siri. Machine learning và các ứng dụng của gradient descent cũng rất hữu ích cho nhà phát triển trò chơi điện tử. Mục tiêu là giúp AI vượt trội ở những tác vụ mang tính con người nhất để con người tập trung vào hoạt động giá trị cao. Trí tuệ nhân tạo và machine learning cho phép doanh nghiệp dự đoán nhu cầu khách hàng và xu hướng tương lai.
Gradient descent là một thuật toán được dùng trong hồi quy tuyến tính do độ phức tạp tính toán. Công thức toán học tổng quát cho gradient descent là xt+1 = xt - η∆xt, với η là tốc độ học và ∆xt là hướng giảm. Gradient descent là một thuật toán áp dụng cho các hàm lồi. Lấy ƒ là một hàm lồi cần tối thiểu hóa, mục tiêu sẽ là đạt ƒ(xt+1) ≤ ƒ (xt) tại mỗi vòng lặp.
Ý tưởng ở đây là dùng thuật toán này để dần dần tính cực tiểu của một hàm toán học. Khi gặp một số phương trình, đây là cách tốt nhất để giải. Khi nói về gradient descent, chúng ta cũng cần hiểu khái niệm hàm chi phí. Ở chế độ có giám sát, hàm này cho phép đo biên độ sai số giữa một ước lượng và giá trị thực. Công thức tính gradient bình phương trung bình trong bài toán hồi quy tuyến tính như sau:
Việc áp dụng gradient descent cũng dùng khái niệm tốc độ học. Đây là một siêu tham số cho phép kiểm soát điều chỉnh trọng số mạng so với gradient mất mát. Cần lưu ý rằng một tốc độ học tối ưu rất quan trọng để đạt cực tiểu nhanh và hiệu quả hơn. Nó không nên quá cao cũng không quá thấp.
Khi giá trị giảm xuống, điều đó cho thấy ta đang dần di chuyển theo sườn dốc đi xuống. Nhiều phương pháp tối ưu sử dụng thuật toán gradient descent, như RMSprop, Adam và SGD. Để không mắc lỗi khi dùng thuật toán này, nên lựa chọn cẩn thận các tham số. Cũng cần ghi nhớ rằng cực tiểu tìm được có thể không phải là cực tiểu toàn cục.
Chức năng chính của một gradient là đo mức thay đổi của từng trọng số so với thay đổi của sai số. Hãy coi gradient như độ dốc của một hàm. Gradient càng lớn, độ dốc càng đứng — đây là điều kiện thuận lợi cho mô hình vì chúng có thể học nhanh. Tuy nhiên, mô hình sẽ ngừng học nếu độ dốc trở về 0. Về mặt toán học, có thể mô tả gradient như một đạo hàm hữu hạn theo đầu vào của nó.
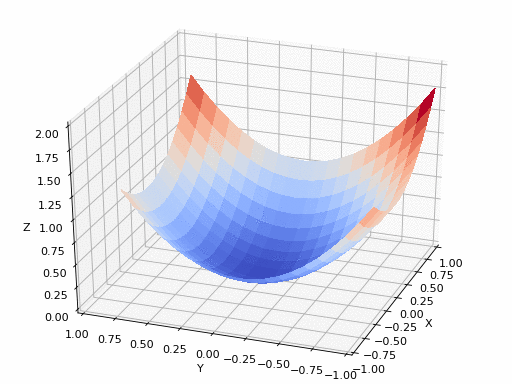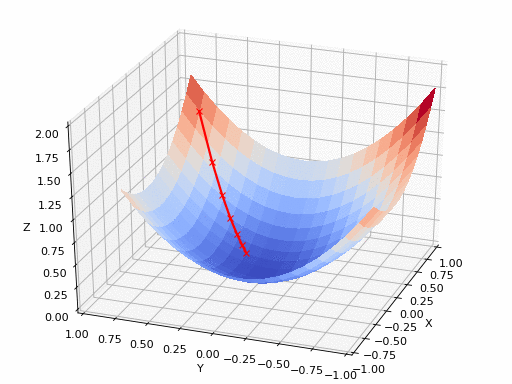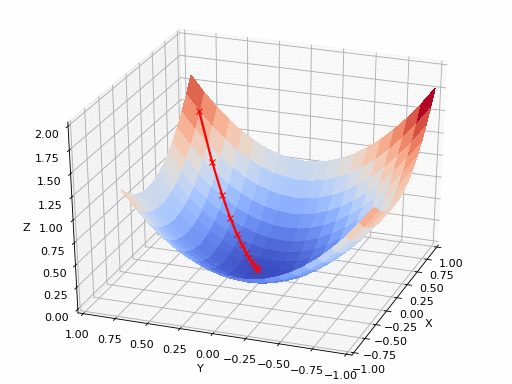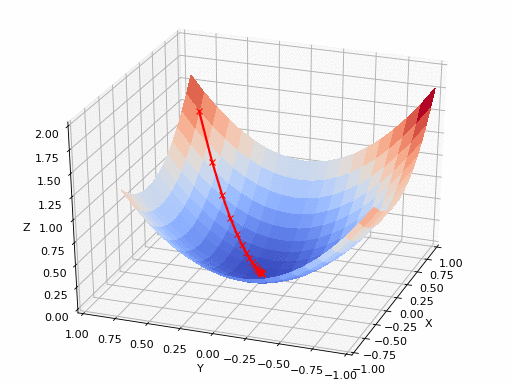
Trong phần triển khai, chúng ta sẽ viết hai hàm. Một hàm là hàm chi phí nhận đầu ra thực và đầu ra dự đoán làm đầu vào và trả về mất mát. Hàm thứ hai là hàm gradient descent thực tế nhận biến độc lập và biến mục tiêu (biến phụ thuộc) làm đầu vào và tìm đường thẳng khớp tốt nhất bằng thuật toán gradient descent.
Số vòng lặp, tốc độ học và ngưỡng dừng là các tham số tinh chỉnh của thuật toán gradient descent và có thể được người dùng đặt. Trong hàm chính, chúng ta sẽ khởi tạo dữ liệu ngẫu nhiên có quan hệ tuyến tính, và áp dụng thuật toán gradient descent lên dữ liệu để tìm đường thẳng khớp tốt nhất. Trọng số và độ lệch tối ưu tìm được bằng thuật toán gradient descent sau đó được dùng để vẽ đường khớp tốt nhất trong hàm chính.
#Importing libraries
import numpy as np
import matplotlib as pyplot

def mean_squared_error(y_true, y_predicted):

   # Calculating the loss or cost
   cost = np.sum((y_true-y_predicted)**2) / len(y_true)
   return cost

# Gradient descent function
# Here iterations, learning rate, stopping threshold are hyperparameters that can be tuned
def gradient_descent((x, y, iterations = 1000, learning_rate = 0.0001, stopping_theshold = 1e-6):

   #Initialzing rate, bias, learning rate, and iterations
   current_rate = 0.1
   current_bias = 0.01
   iterations = iterations
   learning_rate = learning_rate
   n = float(len(x))

   costs = []
   weights = []
   previous_cost = None

   # Estimation of optimal parameters
   for i in range(iterations):

      # Making predictions
      y_predicted = (current_weight * x) + current_bias

      # Calculating the current cost
      current_cost = mean_squared_error(y, y_predicted)

      # If the change in cost is less than or equal to stopping threshold we stop the gradient descent
      if previous_cost and abs(previous_cost - current_cost) <= stopping_threshold:
         break

      previous_cost = current_cost

      costs.append(current_cost)
      weights.append(current_weight)

      # Calculating the gradients
      weight_derivative = -(2/n) * sum(x * (y-y_predicted))
      bias_derivative = -(2/n) * sum(y-y_predicted)

      # Updating weights and bias
      current_weight = current_weight - (learning_rate * weight_derivative)
      current_bias = current_bias - (learning_rate * bias_derivative)

      # Printing the parameters for each 1000th iteration
      print(f"Iteration {i+1}: Cost {current_cost}, Weight \n {current_weight}, Bias {current_bias}")

   # Visualizing the weights and cost for all iterations
   plt.figure(figsize = = (8,6))
   plt.plot(weights, cost)
   plt.scatter(weights, cost, marker = 'o', color = 'red')
   plt.title("Cost vs Weights")
   plt.ylabel("Cost")
   plt.xlabel("Weights")
   plt.show()

   return current_weight, current_bias

def main()

   # Data
   X = np.array(32.5, 53.4, 61.5, 47.4, 59.8,
   55.1, 52.2, 39.2, 48.1, 52.5,
   45.4, 54.3, 44.1, 58.1, 56.7,
   48.9, 44.6, 60.2, 45.6, 38.8])
   Y = np.array(31.7, 68.7, 62.5, 71.5, 87.2,
   78.2, 79.6, 59.1, 75.3, 71.3,
   55.1, 82.4, 62.0, 75.3, 81.4,
   60.7, 82.8, 97.3, 48.8, 56.8])

   # Estimating weight and bias using gradient descent
   estimated_weight, estimated_bias = gradient_descent(X, Y, iterations = 2000)
   print(f"Estimated Weight: {estimated weight}\nEstimated Bias: {estimated bias}")

   # Making predictions using estimated parameters
   Y_pred = estimated_weight*X = estimated_bias

   #Plotting the regression line
   plt.figure(figsize = 8,6)
   plt.scatter(X, Y, marker = 'o', color = 'red')
   plt.plot([min(X), max(X)], [min(Y_pred), max(Y_pred)], color = 'blue')
   plt.ylabel("X")
   plt.xlabel("Y")
   plt.show()

if __name__=="__main__":
   main()
Đầu ra của đoạn mã dưới đây sẽ như sau:
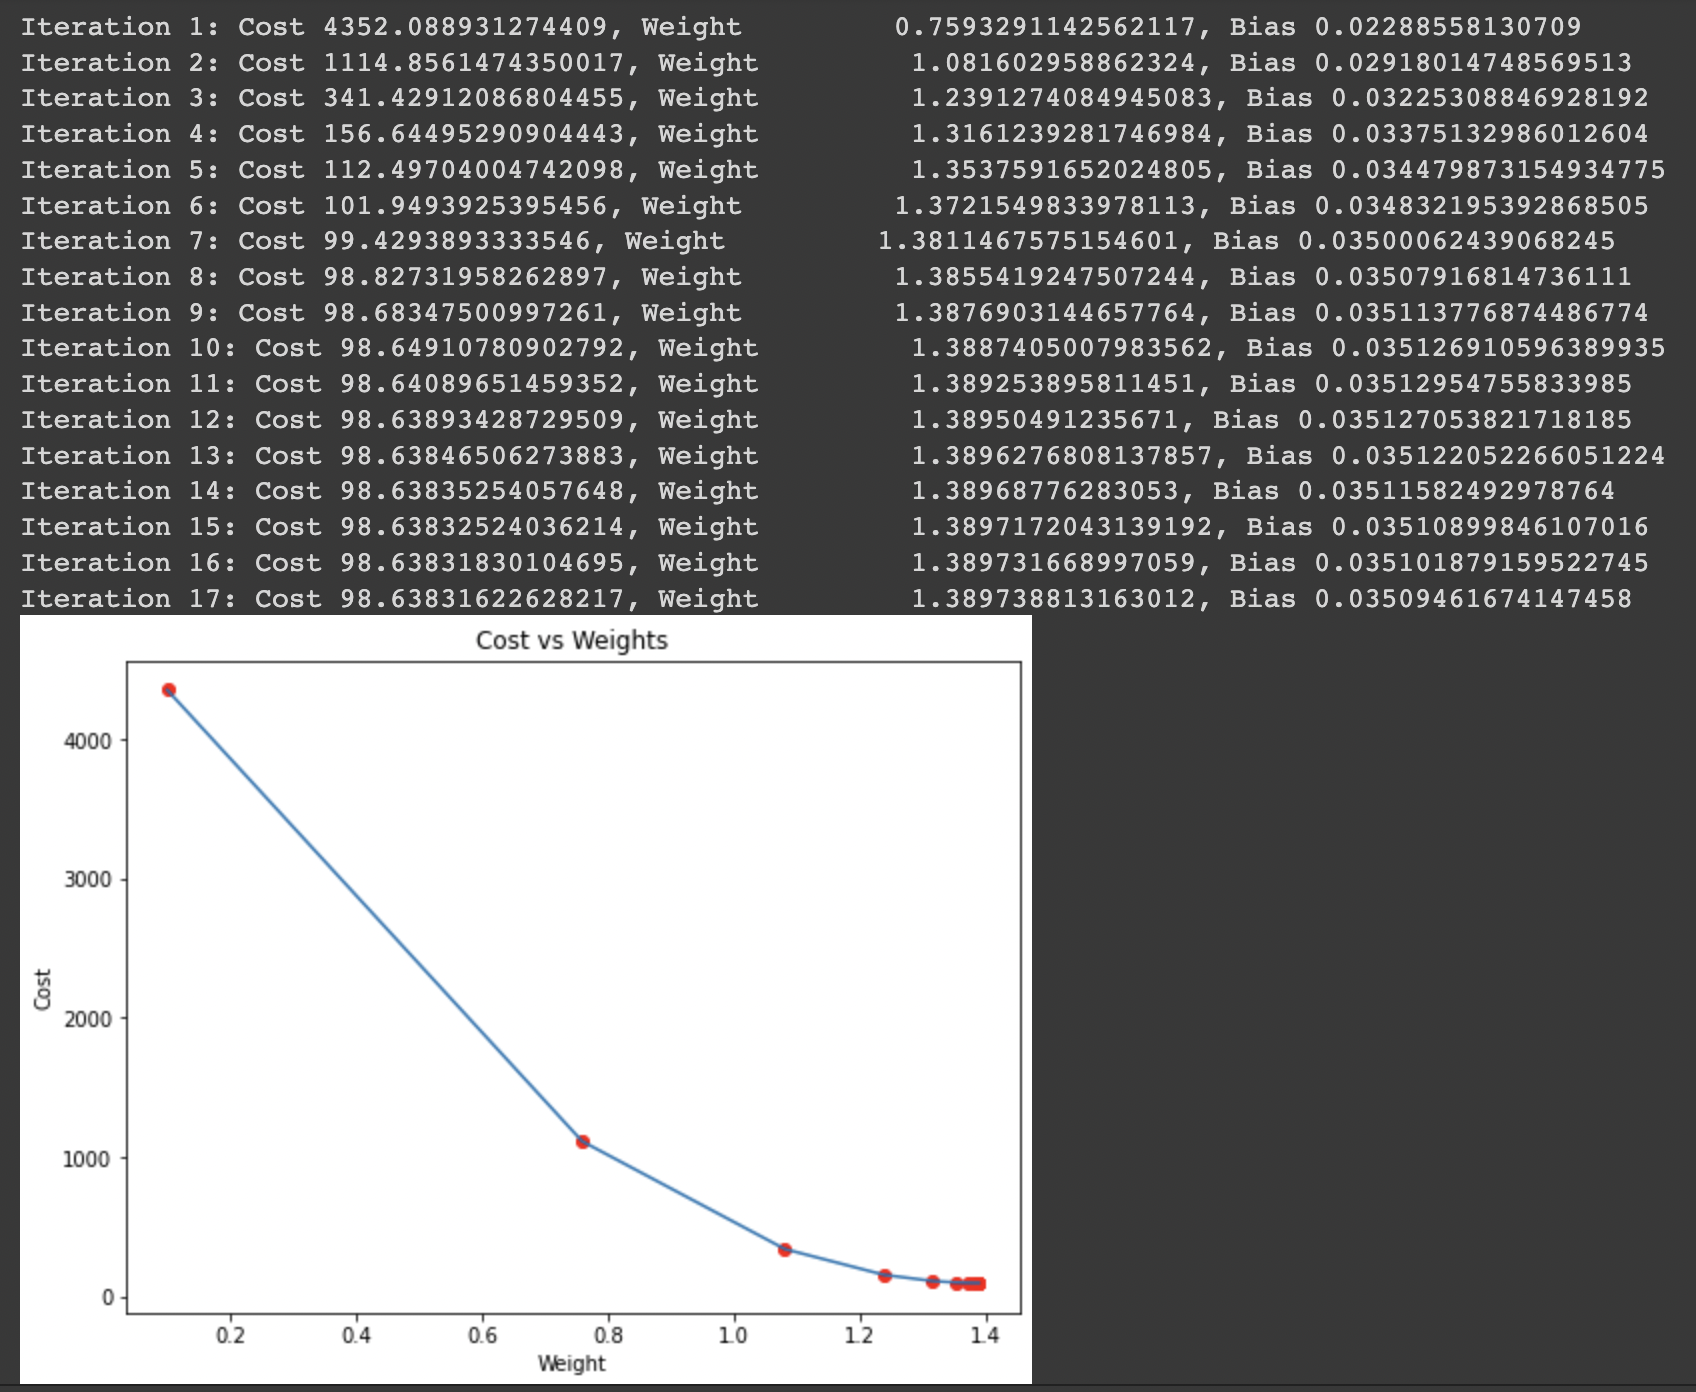
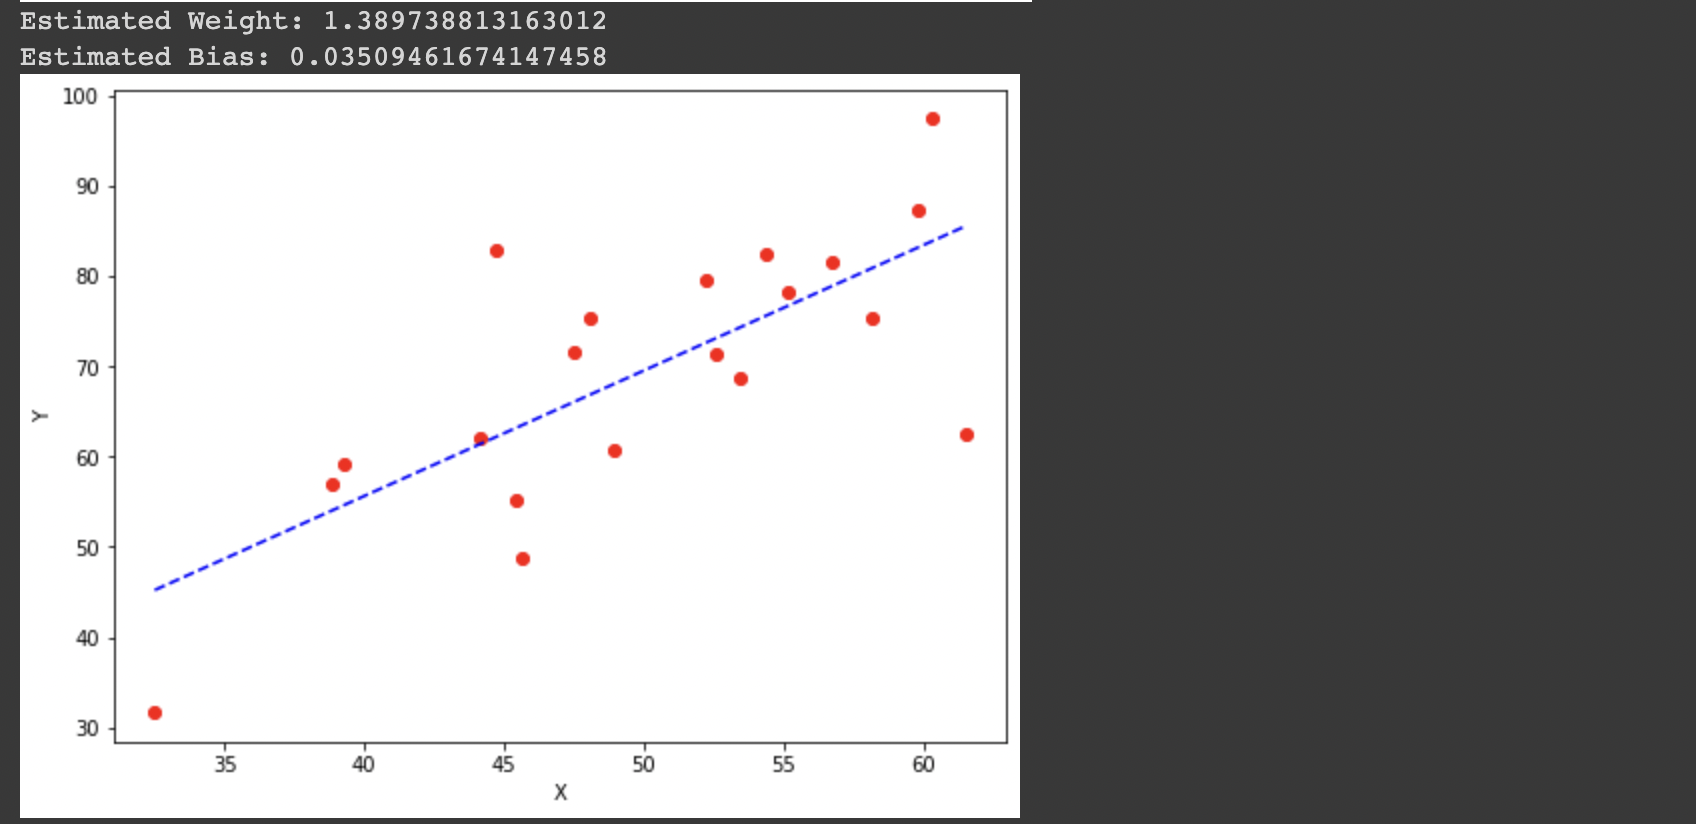
Bạn có thể thử và chạy mã trên bằng notebook này.
Một yếu tố quan trọng khác cần nhấn mạnh là tốc độ học. Trong machine learning, chúng ta gọi loại yếu tố này là siêu tham số vì nó không hẳn là tham số của mô hình, nhưng vẫn tác động đến hiệu năng cuối cùng của mô hình (giống như các tham số mô hình).
Tốc độ học (thường ký hiệu α hoặc đôi khi η) cho biết tốc độ các hệ số thay đổi. Đại lượng này có thể cố định hoặc biến thiên. Một trong những phương pháp phổ biến hiện nay là Adam, có tốc độ học thay đổi theo thời gian.
Có nhiều kịch bản cần dự liệu và cân nhắc khi sử dụng gradient descent:
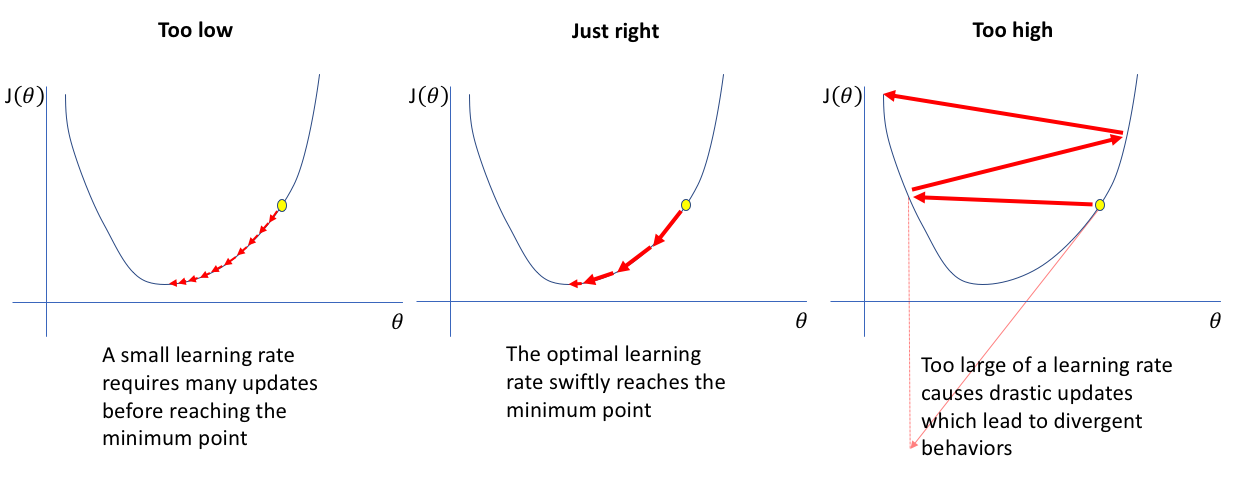
Nếu tốc độ học quá lớn, bạn sẽ tạo ra những bước nhảy quá dài trong gradient descent. Ưu điểm là đi xuống cực tiểu của hàm chi phí nhanh, nhưng bạn có nguy cơ bỏ lỡ cực tiểu này do dao động quanh nó đến vô hạn. Trong ẩn dụ thung lũng, giống như mỗi lần bạn di chuyển vài km, vô tình đi qua nơi trú ẩn mà không nhận ra.
Để tránh trường hợp trước, bạn có thể muốn chọn tốc độ học thật thấp. Nhưng nếu quá thấp, bạn có nguy cơ mất thời gian vô tận trước khi hội tụ về cực tiểu của hàm chi phí. Nó giống như chọn đi từng milimét trên núi để tìm điểm thấp nhất trong thung lũng.
Việc đặt tốc độ học ở giá trị phù hợp là điều thiết yếu để giúp giảm dốc đạt được cực tiểu cục bộ. Do đó, tốt nhất không đặt quá cao hoặc quá thấp. Điều này quan trọng vì việc đạt cực tiểu có thể trở nên phức tạp với những bước quá dài. Nếu đặt tốc độ học thấp hơn, gradient descent có thể cuối cùng chạm tới cực tiểu cục bộ. Tuy nhiên, điều này có thể mất thời gian.
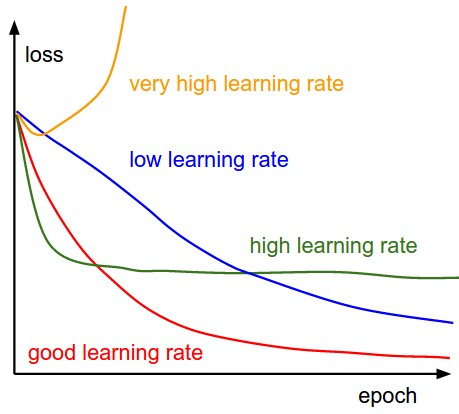
Đáng tiếc là không có công thức kỳ diệu nào để tìm tốc độ học phù hợp. Phần lớn thời gian, bạn phải dò dẫm và thử nhiều giá trị trước khi tìm được giá trị đúng. Điều này gọi là tinh chỉnh siêu tham số, và có nhiều chiến lược để thực hiện đúng cách.
Một cách tuyệt vời để đảm bảo vận hành tối ưu của giảm dốc là vẽ hàm chi phí trong khi tối ưu đang diễn ra. Đưa số lần lặp lên trục X, và giá trị hàm chi phí lên trục Y. Điều này giúp bạn thấy giá trị hàm chi phí sau mỗi vòng lặp gradient descent, đồng thời theo dõi độ phù hợp của tốc độ học. Bạn cũng có thể thử các giá trị khác nhau và vẽ cùng nhau.
Hàm chi phí sẽ giảm sau mỗi vòng lặp nếu gradient descent hoạt động tối ưu. Gradient descent hội tụ khi nó không còn giảm được hàm chi phí và duy trì ở cùng mức. Số vòng lặp cần để gradient descent hội tụ thay đổi đáng kể. Đôi khi cần 50 vòng lặp, lúc khác có thể lên tới hai hay ba triệu. Rất khó ước lượng trước số vòng lặp.
Một số thuật toán có thể tự động cho bạn biết liệu gradient descent đã hội tụ hay chưa. Tuy nhiên, tốt hơn là thiết lập trước một ngưỡng hội tụ, điều này cũng khá khó ước lượng. Đây là lý do quan trọng vì sao các biểu đồ đơn giản là tốt nhất để kiểm tra hội tụ.
Trong khi các nhà khoa học dùng gradient descent để tìm giá trị các tham số của một hàm nhằm tối thiểu hóa chi phí, lập trình viên dùng gradient descent như một thuật toán tối ưu khi huấn luyện mô hình machine learning. Gradient descent điều chỉnh dần một số tham số của nó để tối thiểu hóa một hàm cụ thể dựa trên các hàm lồi.
Gradient descent có lẽ là chiến lược tối ưu hóa được biết đến nhiều nhất trong deep learning và machine learning. Các nhà khoa học dữ liệu thường dùng nó khi có cơ hội kết hợp mỗi thuật toán với các mô hình học. Hiểu thuật toán gradient descent tương đối đơn giản, và triển khai còn đơn giản hơn. Để đào sâu hơn vào thế giới deep learning, hãy xem toàn bộ danh mục khóa học machine learning của chúng tôi.
Học với DataCamp
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
