Lernpfad
Wissenschaftler für maschinelles Lernen in Python
85 Std.
Gradient Descent ist eines der wichtigsten Verfahren im gesamten Machine Learning und Deep Learning. Es ist ein äußerst wirkungsvoller Optimierungsalgorithmus, mit dem sich Modelle wie lineare Regression, logistische Regression und neuronale Netze trainieren lassen. Wenn du in Machine Learning einsteigen willst, solltest du den Gradient-Descent-Algorithmus daher wirklich im Detail verstehen.
Data Science dreht sich darum, in großen Daten komplexe Muster und Zusammenhänge aufzuspüren. Durch Machine Learning werden Algorithmen so trainiert, dass sie solche Muster erkennen und eine Aufgabe immer besser ausführen. Das heißt: Wir bringen Software bei, Aufgaben und Vorhersagen eigenständig zu erledigen. Dafür wählt und trainiert die Data Scientist Algorithmen für die Datenanalyse – mit dem Ziel, die Vorhersagen im Zeitverlauf zu verbessern.
Machine Learning basiert daher maßgeblich auf dem Training von Algorithmen. Je mehr Daten ein Algorithmus sieht, desto besser löst er eine Aufgabe ohne explizite Anweisungen – er lernt aus Erfahrung. Es gibt viele Algorithmustypen im Machine Learning, und Gradient Descent zählt zu den nützlichsten und beliebtesten.
Gradient Descent ist ein Optimierungsverfahren, das den Minimalwert einer Funktion effizient findet. Vereinfacht gesagt: Es ist ein Algorithmus, um das Minimum einer konvexen Funktion zu bestimmen, indem die Parameter der Funktion iterativ angepasst werden. Ein klassisches Einsatzfeld ist die lineare Regression.
Eine konvexe Funktion ähnelt einem Tal mit einem globalen Minimum in der Mitte. Nicht-konvexe Funktionen besitzen mehrere lokale Minima; hier kann Gradient Descent in einem lokalen Minimum steckenbleiben und findet womöglich nicht das globale Minimum.
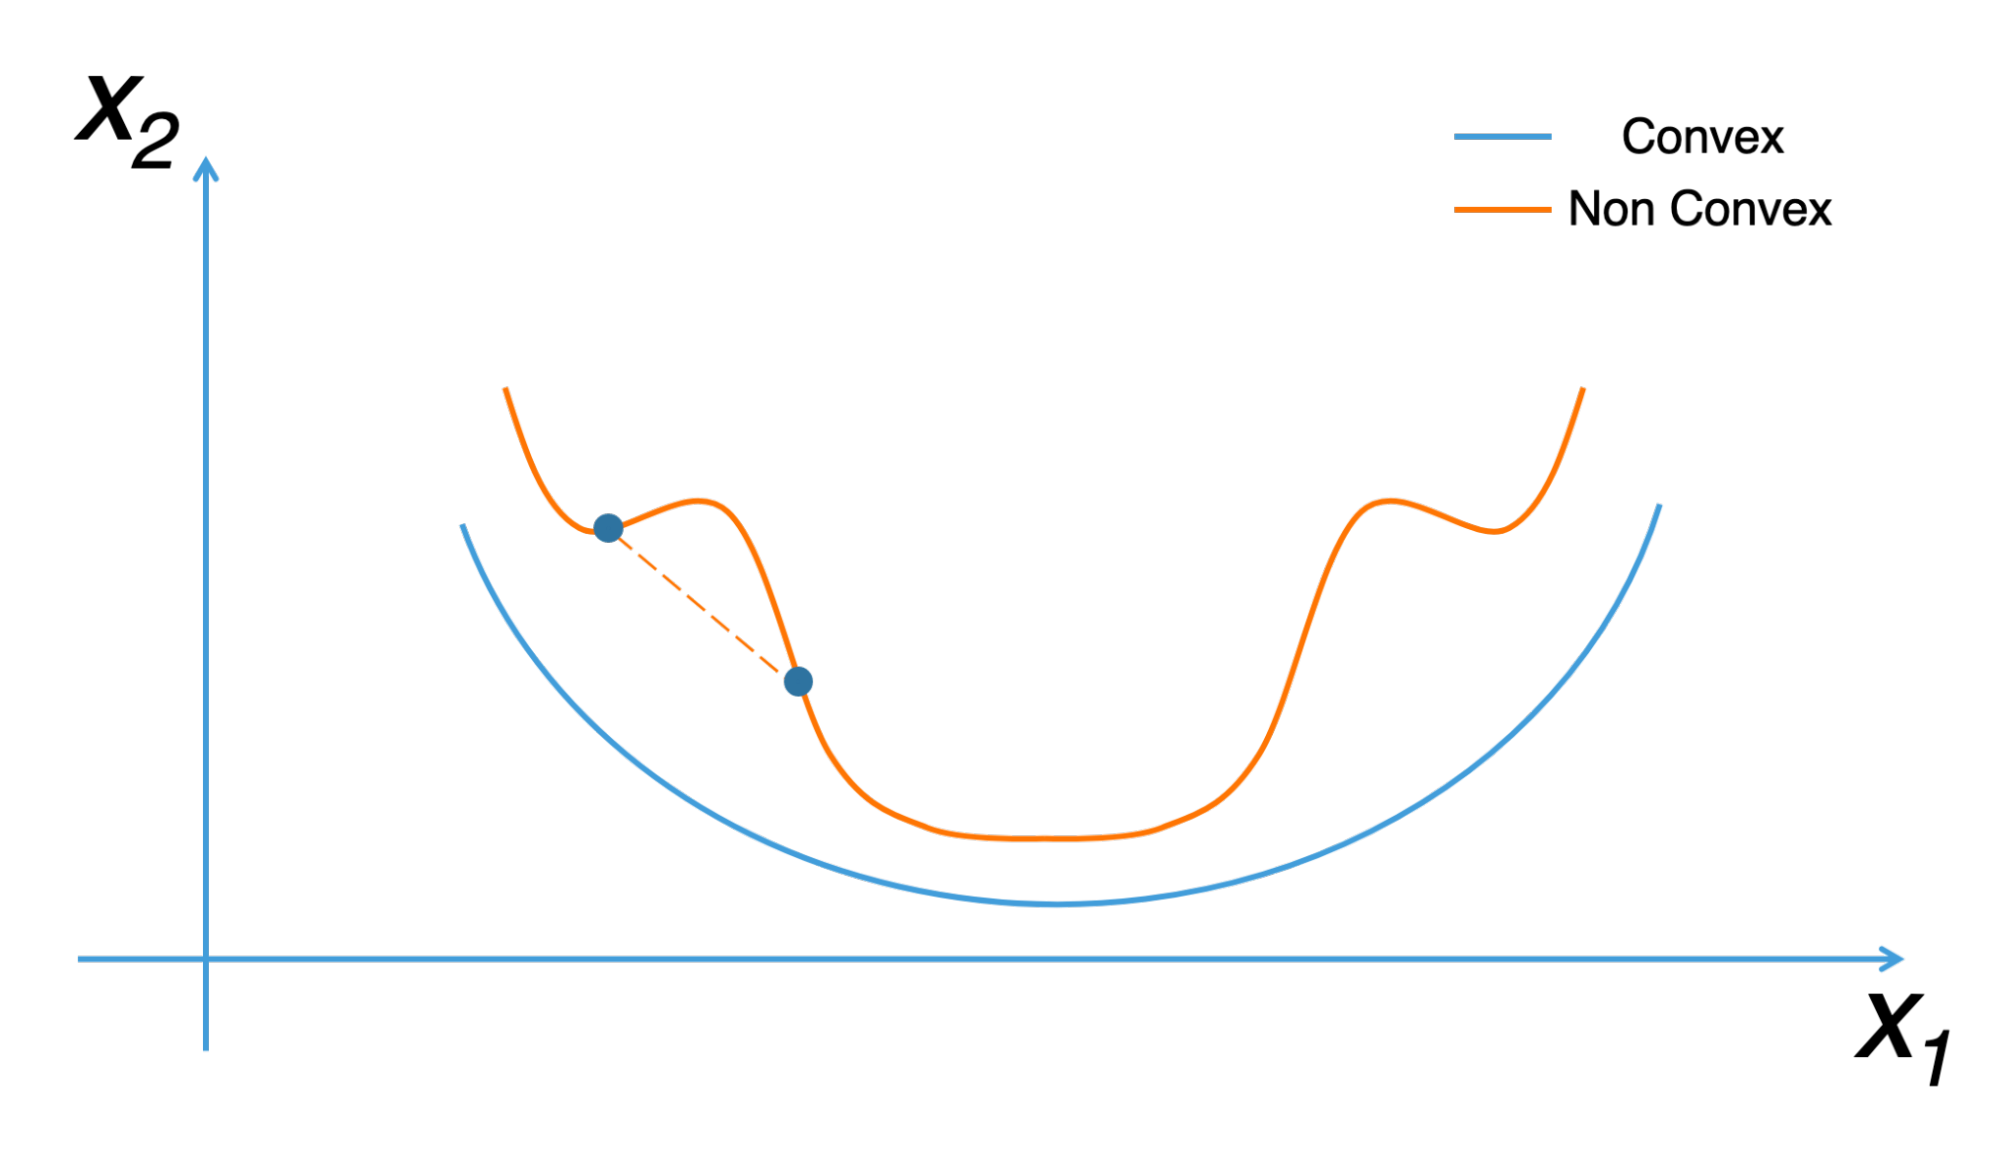
Gradient Descent wird auch als „Verfahren des steilsten Abstiegs“ bezeichnet. Im Machine Learning ist es zentral, um eine Kostenfunktion zu minimieren. Deren Minimierung hilft, das beste Vorhersagemodell zu finden. Je kleiner die Kosten, desto besser die Prognosen.
Es gibt drei gängige Varianten. Schauen wir sie uns an:
Auch „Vanilla Gradient Descent“ genannt: Batch Gradient Descent berechnet die Fehler über alle Beispiele im Trainingsdatensatz und aktualisiert die Parameter erst, nachdem alle Beispiele ausgewertet wurden. Das entspricht einem vollständigen Trainingszyklus (auch Epoche genannt).
Vorteile sind insbesondere die effiziente Berechnung sowie eine stabile Konvergenz und ein glatter Fehlerverlauf. Nachteile: Die Stabilität kann in ungünstige Konvergenzzustände führen, und es erfordert, dass der gesamte Trainingsdatensatz in den Speicher und den Rechenablauf passt.
Stochastic Gradient Descent (SGD) aktualisiert die Parameter nach jedem einzelnen Trainingsbeispiel. Dadurch wird jedes Beispiel unmittelbar berücksichtigt, was je nach Problem schneller sein kann als Batch Gradient Descent. Die häufigen Updates liefern feingranulare Verbesserungen.
Allerdings sind diese Updates rechenintensiver als bei der Batch-Variante. Zudem führen die häufigen Aktualisierungen zu „rauschigen“ Gradienten, was den Fehler schwanken lassen kann, anstatt stetig zu sinken.
Mini-Batch Gradient Descent kombiniert die Stärken beider Ansätze: Der Trainingsdatensatz wird in Batches aufgeteilt, und für jeden Batch erfolgt ein Update. So entsteht ein guter Kompromiss aus Effizienz (wie bei BGD) und Robustheit (wie bei SGD).
Gängige Batchgrößen liegen oft zwischen 50 und 256, variieren aber je nach Anwendung. Mini-Batches sind der Standard beim Training neuronaler Netze und im Deep Learning weit verbreitet.
In überwachten Lernaufgaben nutzen wir Gradient Descent, um eine Kostenfunktion zu minimieren, häufig eine konvexe Funktion wie den mittleren quadratischen Fehler.
So findet das Modell die besten Parameter. Minimieren heißt: Wir suchen a, b, c etc., die die Abweichung zwischen Modell und Zielwerten y im Datensatz am kleinsten machen. Gelingt das, entstehen präzise Anwendungen – etwa in Sprach- und Bilderkennung oder für Aktienkursprognosen.
Darum ist Gradient Descent so grundlegend: Das Modell lernt dadurch.
Zur Veranschaulichung dient oft das Berg-Tal-Bild: Eine Person hat sich im Gebirge verirrt und sucht den Weg ins Tal. Sie blickt sich um, folgt der Richtung mit der steilsten Abwärtsneigung für eine gewisse Strecke und wiederholt dies, bis der Talboden erreicht ist. Genau dieses iterative Vorgehen nutzt Gradient Descent zur Minimierung der Kostenfunktion – es ist ein iterativer, rechenintensiver Algorithmus.
Eine 2-Schritte-Strategie für das „Tal“-Problem:
Wiederholst du diese zwei Schritte, konvergierst du zum Minimum des Tals. Das ist im Kern Gradient Descent.
Ausgehend von einem zufälligen Startpunkt bestimmen wir die Steigung an dieser Stelle – mathematisch über die Ableitung der Funktion.
Anschließend bewegen wir uns um eine Distanz d in Richtung des Abstiegs – hier nicht 300 Meter, sondern die sogenannte „Lernrate“. Dadurch ändern sich die Parameterwerte unseres Modells (unsere Koordinaten im Tal verschieben sich).
Vor allem im Machine Learning und Deep Learning. Deep Learning kann man als vertiefte Form von Machine Learning sehen und erkennt besonders feine Muster. Für beides sind solide Mathematik- und Python-Kenntnisse hilfreich.
Python bietet zahlreiche Bibliotheken, die ML-Anwendungen erleichtern. Damit lassen sich große Datenmengen schnell und präzise analysieren und Vorhersagen aus historischen Mustern ableiten.
Machine Learning ist eng mit Big Data verknüpft. Mit den verfügbaren Massendaten kann Künstliche Intelligenz (KI) ohne ständige menschliche Eingriffe lernen. Beispiele sind vernetzte Geräte: Eine KI passt sich den Gewohnheiten in Smart Homes an und steuert Aufgaben entsprechend.
So kann KI etwa die Heizung je nach Wetterlage regeln. Auch Saugroboter werden dadurch immer leistungsfähiger. Gradient Descent steht bei vielen KI-Durchbrüchen im Zentrum. Praktisch gibt es unzählige Anwendungen – von Ingenieurwesen bis Produktentwicklung.
Suchmaschinen wie Google oder Empfehlungssysteme von YouTube, Netflix und Amazon profitieren davon. Aus Nutzungsdaten leiten Algorithmen Interessen ab und liefern relevantere Ergebnisse und Empfehlungen.
ML hat Computer befähigt, menschliche Sprache zu verstehen und zu verarbeiten – Grundlage für Assistenten wie Alexa, Google Assistant und Siri. Auch in Games hilft ML mit Gradient Descent, KI-Agenten zu stärken, damit Menschen sich auf Aufgaben mit höherem Mehrwert konzentrieren können. Unternehmen nutzen KI und ML, um Kundenbedürfnisse und Trends vorauszusehen.
Wegen der Rechenkomplexität kommt Gradient Descent häufig bei der linearen Regression zum Einsatz. Die allgemeine Formel lautet x_{t+1} = x_t - η Δx_t, wobei η die Lernrate und Δx_t die Abstiegsrichtung ist. Ziel bei einer zu minimierenden konvexen Funktion ƒ ist, pro Iteration ƒ(x_{t+1}) ≤ ƒ(x_t) zu erreichen.
Die Idee: Das Minimum einer Funktion wird schrittweise angenähert. Zentral ist dabei die Kostenfunktion. In überwachten Szenarien misst sie den Fehler zwischen Schätzung und wahrem Wert. Für lineare Regression nutzt man typischerweise den mittleren quadratischen Fehler.
Ebenso wichtig ist die Lernrate: ein Hyperparameter, der steuert, wie stark die Gewichte in Richtung des Verlustgradienten angepasst werden. Eine gute Wahl beschleunigt und stabilisiert die Konvergenz – zu groß oder zu klein ist problematisch.
Sinkt der Funktionswert, bewegen wir uns entlang der Abwärtsrichtung. Optimierungsverfahren wie RMSprop, Adam und SGD bauen auf Gradient Descent auf. Wähle die Hyperparameter sorgfältig – und behalte im Blick, dass ein gefundenes Minimum lokal sein kann.
Der Gradient misst, wie stark sich der Fehler bei Änderung eines Gewichts verändert – anschaulich: die Steigung der Funktion. Große Gradienten bedeuten steile Hänge und schnelles Lernen; wird die Steigung null, lernt das Modell nicht weiter. Mathematisch ist der Gradient die Ableitung in Bezug auf die Eingaben.
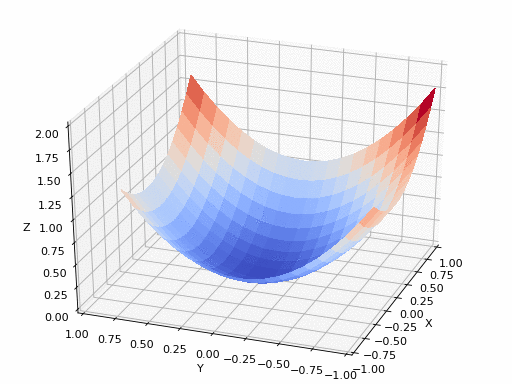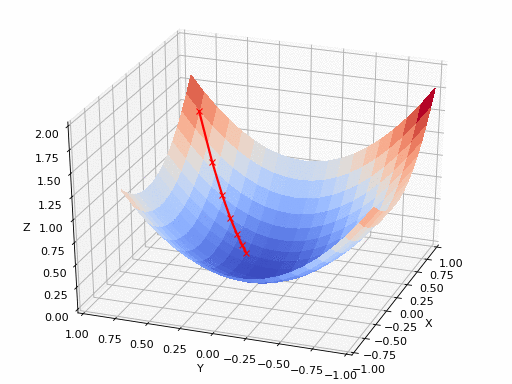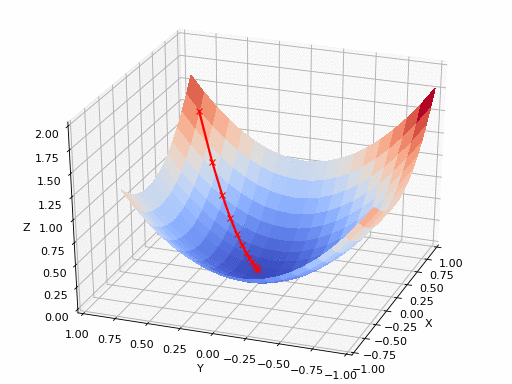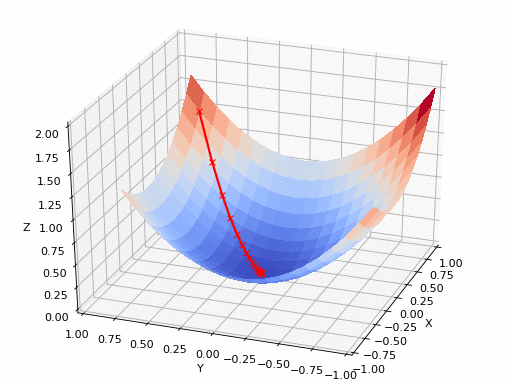
In der Implementierung schreiben wir zwei Funktionen: eine Kostenfunktion, die aus Ist- und Prognosewerten den Verlust berechnet, und eine Gradient-Descent-Funktion, die aus unabhängiger Variable und Zielvariable die beste Ausgleichsgerade bestimmt.
Iterationen, Lernrate und Abbruchschwelle sind Tuning-Parameter und frei wählbar. In der main-Funktion erzeugen wir zufällige, linear zusammenhängende Daten und finden per Gradient Descent die bestpassende Gerade. Das optimierte Gewicht und der Bias dienen anschließend zur Visualisierung der Regressionsgeraden.
# Import von Bibliotheken
import numpy as np
import matplotlib.pyplot as plt

def mean_squared_error(y_true, y_pred):
    # Verlust/Kosten berechnen
    return np.sum((y_true - y_pred) ** 2) / len(y_true)

# Gradient-Descent-Funktion
# Iterationen, Lernrate und Abbruchschwelle sind einstellbare Hyperparameter
def gradient_descent(x, y, iterations=1000, learning_rate=0.0001, stopping_threshold=1e-6):
    # Initialisierung von Gewicht, Bias und weiteren Variablen
    current_weight = 0.1
    current_bias = 0.01
    n = float(len(x))

    costs = []
    weights = []
    previous_cost = None

    # Schätzung der optimalen Parameter
    for i in range(iterations):
        # Vorhersagen berechnen
        y_pred = current_weight * x + current_bias

        # Aktuelle Kosten berechnen
        current_cost = mean_squared_error(y, y_pred)

        # Abbruch, wenn die Kostenänderung kleiner/gleich der Schwelle ist
        if previous_cost is not None and abs(previous_cost - current_cost) <= stopping_threshold:
            break

        previous_cost = current_cost
        costs.append(current_cost)
        weights.append(current_weight)

        # Gradienten berechnen
        weight_grad = -(2 / n) * np.sum(x * (y - y_pred))
        bias_grad = -(2 / n) * np.sum(y - y_pred)

        # Gewichte und Bias aktualisieren
        current_weight -= learning_rate * weight_grad
        current_bias -= learning_rate * bias_grad

        # Pro 1000. Iteration ausgeben
        if (i + 1) % 1000 == 0:
            print(f"Iteration {i+1}: Cost {current_cost}, Weight {current_weight}, Bias {current_bias}")

    # Kostenverlauf visualisieren
    plt.figure(figsize=(8, 6))
    plt.plot(weights, costs)
    plt.scatter(weights, costs, marker='o', color='red')
    plt.title("Cost vs Weights")
    plt.ylabel("Cost")
    plt.xlabel("Weights")
    plt.show()

    return current_weight, current_bias

def main():
    # Daten
    X = np.array([32.5, 53.4, 61.5, 47.4, 59.8,
                  55.1, 52.2, 39.2, 48.1, 52.5,
                  45.4, 54.3, 44.1, 58.1, 56.7,
                  48.9, 44.6, 60.2, 45.6, 38.8])
    Y = np.array([31.7, 68.7, 62.5, 71.5, 87.2,
                  78.2, 79.6, 59.1, 75.3, 71.3,
                  55.1, 82.4, 62.0, 75.3, 81.4,
                  60.7, 82.8, 97.3, 48.8, 56.8])

    # Gewicht und Bias per Gradient Descent schätzen
    estimated_weight, estimated_bias = gradient_descent(X, Y, iterations=2000)
    print(f"Estimated Weight: {estimated_weight}\nEstimated Bias: {estimated_bias}")

    # Vorhersagen berechnen
    Y_pred = estimated_weight * X + estimated_bias

    # Regressionsgerade plotten
    plt.figure(figsize=(8, 6))
    plt.scatter(X, Y, marker='o', color='red')
    plt.plot([min(X), max(X)], [min(Y_pred), max(Y_pred)], color='blue')
    plt.ylabel("Y")
    plt.xlabel("X")
    plt.show()

if __name__ == "__main__":
    main()
Die Ausgabe des folgenden Codes sieht so aus:
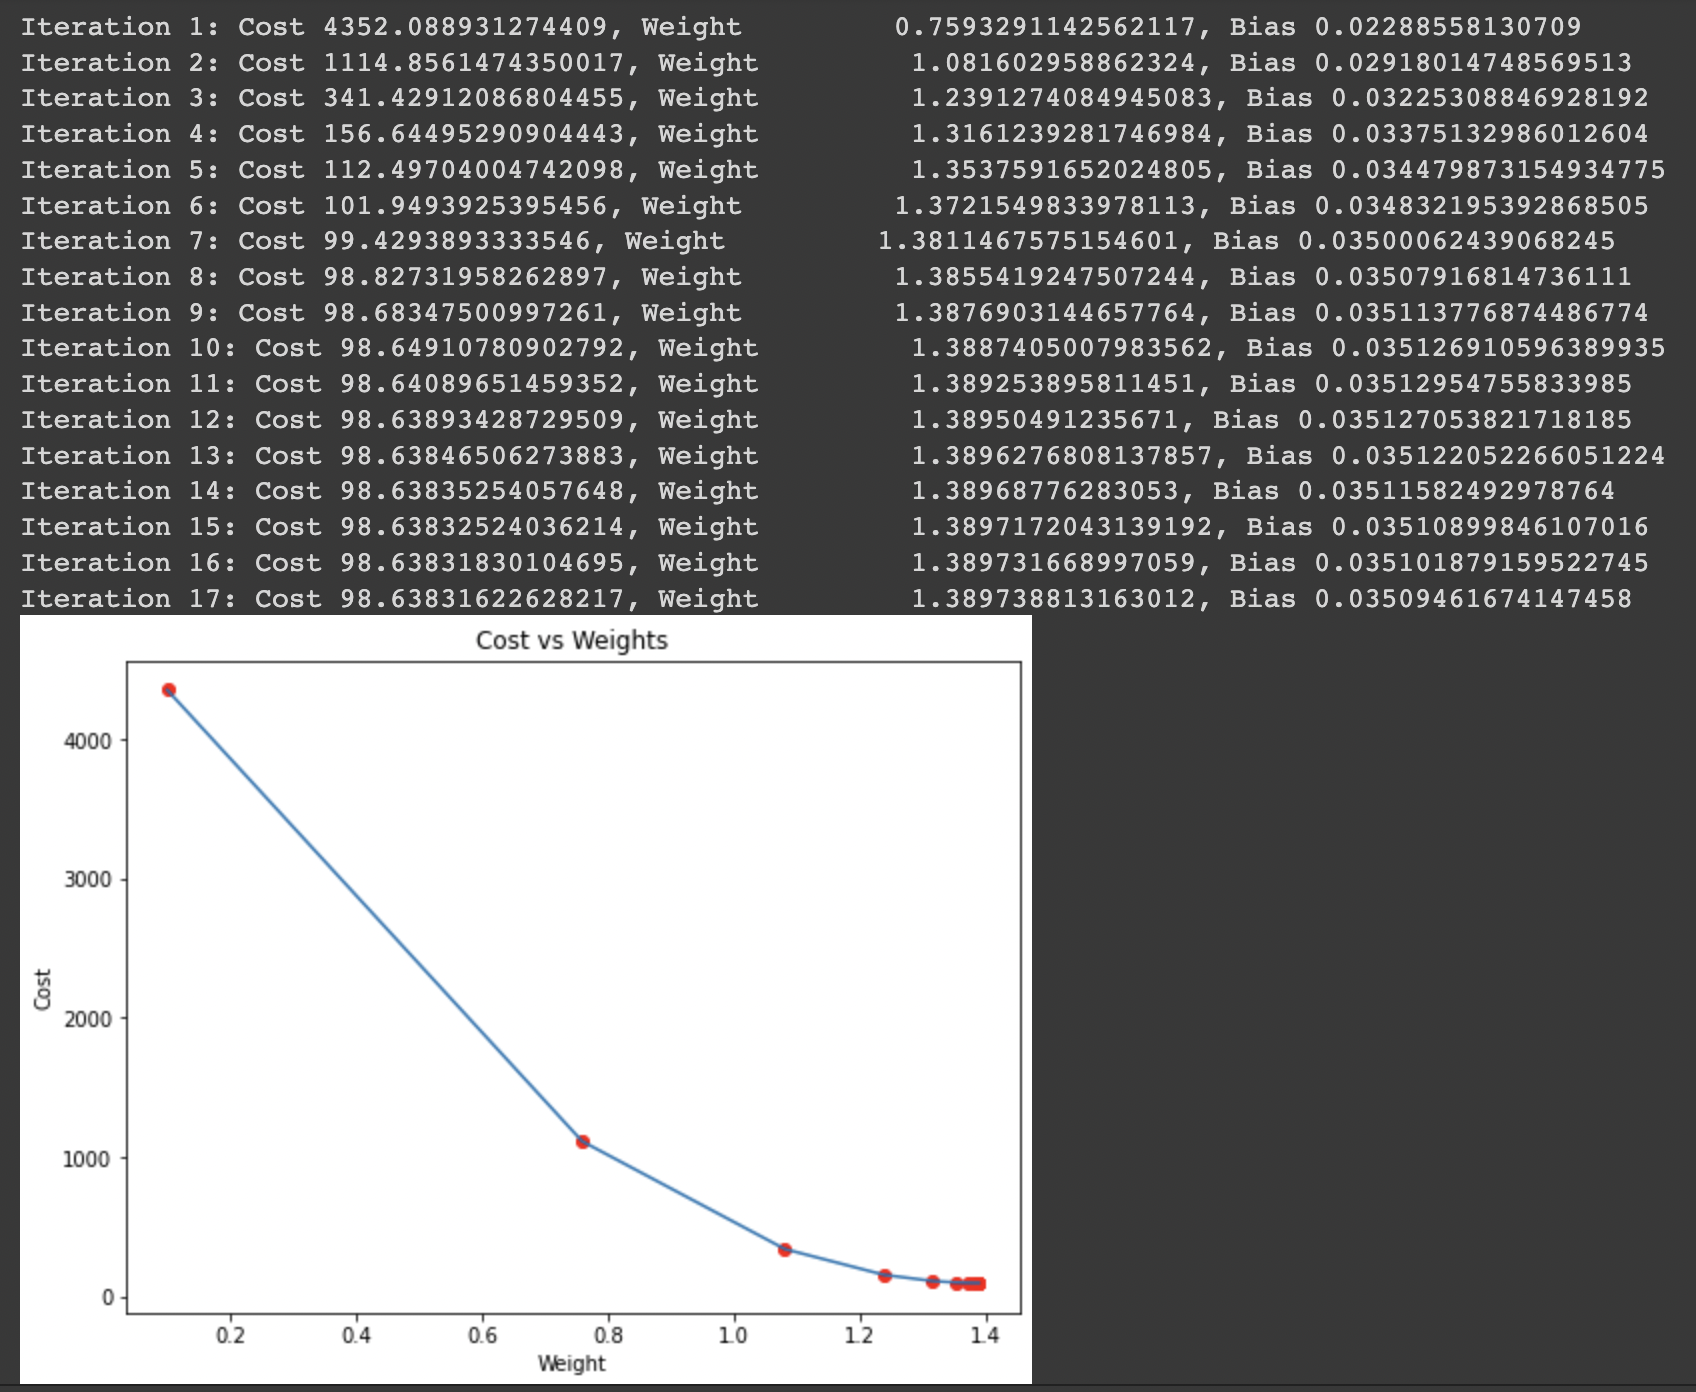
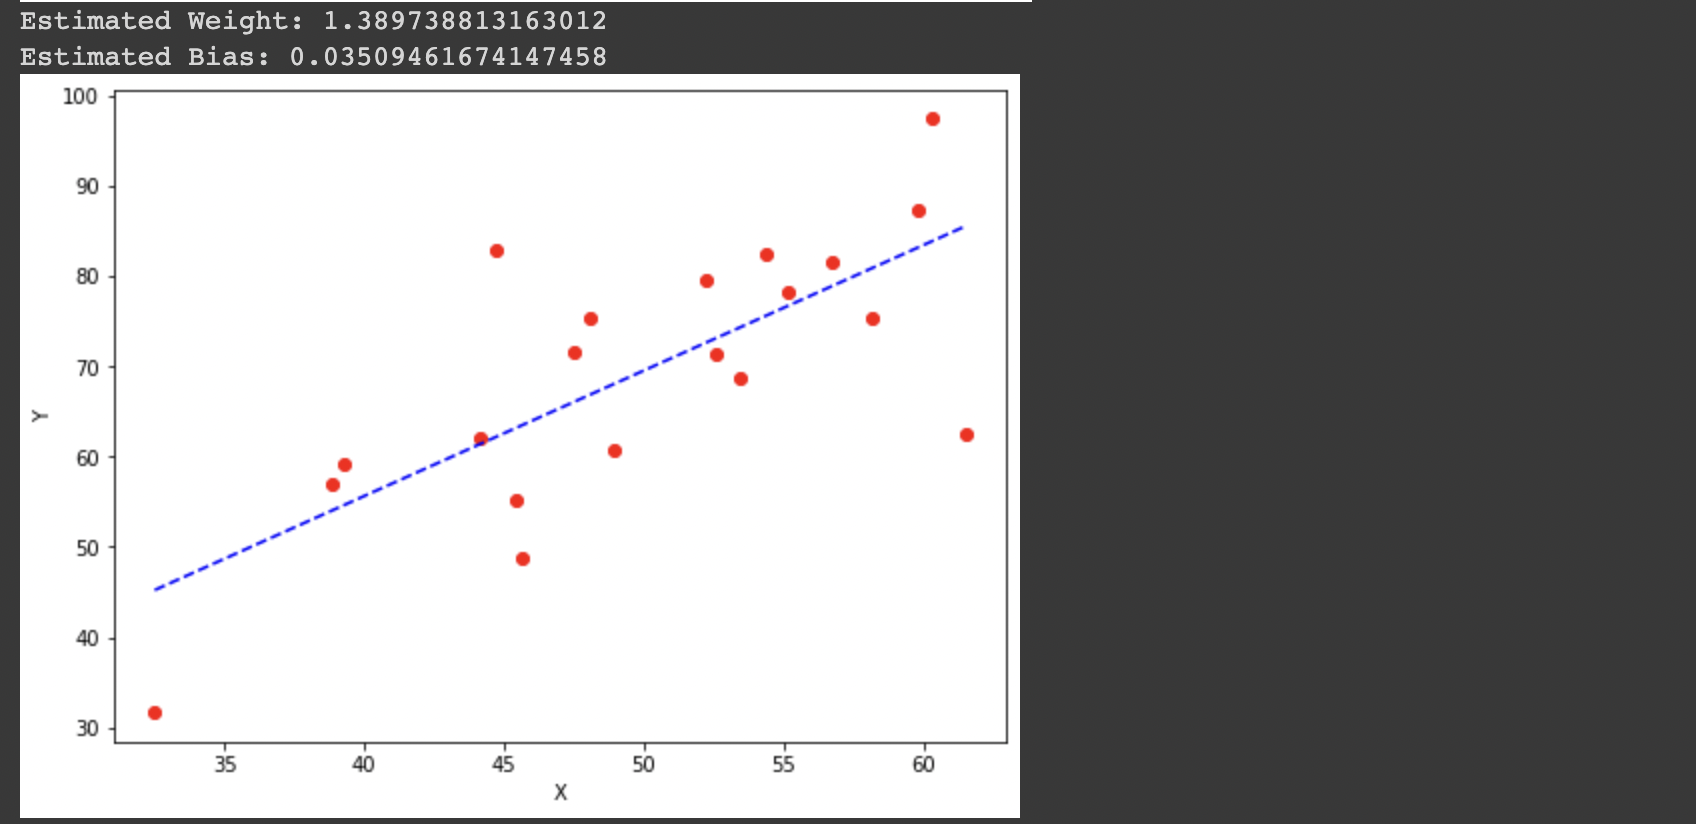
Du kannst den obigen Code in diesem Notebook testen und ausführen.
Die Lernrate ist ein Hyperparameter: Sie ist kein direkter Modellparameter, beeinflusst aber die Performance des Modells erheblich – ähnlich stark wie die Modellparameter selbst.
Die Lernrate (häufig mit α oder η bezeichnet) bestimmt, wie schnell sich die Koeffizienten ändern. Sie kann fest oder variabel sein. Ein populäres Verfahren ist Adam, dessen effektive Lernrate sich im Zeitverlauf anpasst.
Beim Einsatz von Gradient Descent solltest du verschiedene Szenarien im Blick behalten:
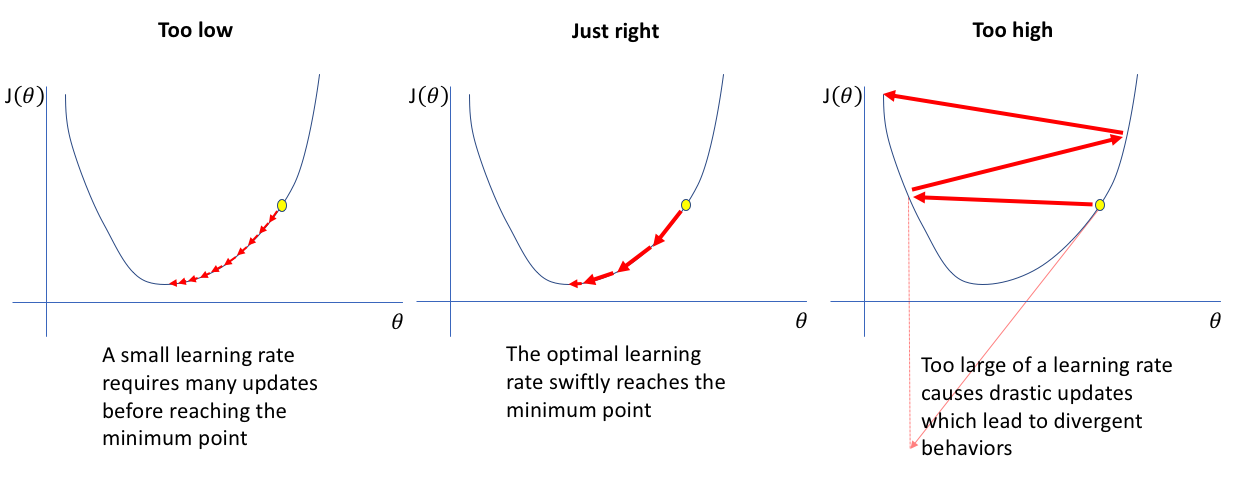
Ist die Lernrate zu groß, sind die Schritte zu weit. Das kann zwar schnell abwärts gehen, aber das Minimum wird womöglich ständig überschritten und nie erreicht. In der Tal-Analogie läufst du immer wieder am Schutzhaus vorbei.
Eine sehr kleine Lernrate vermeidet Überschwingen, kann aber extrem lange dauern, bis das Minimum erreicht wird – als würdest du Millimeter für Millimeter zum tiefsten Punkt vorankommen.
Nur mit sinnvoll gewählten Lernraten erreicht der Abstieg lokale Minima zügig und stabil. Zu große Schritte erschweren die Minimierung, zu kleine verlangsamen sie massiv. Oft ist eine moderate Lernrate der beste Startpunkt.
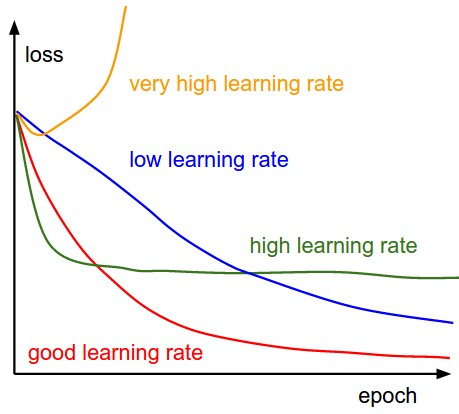
Eine Patentlösung gibt es nicht. Meist testet man mehrere Werte und vergleicht – Hyperparameter-Tuning. Es hilft, während des Trainings die Kostenfunktion zu protokollieren und zu plotten: Iterationen auf der X-Achse, Kosten auf der Y-Achse. So erkennst du, ob die Lernrate zu schnellen, stabilen Verbesserungen führt. Teste mehrere Werte und vergleiche die Kurven.
Im Idealfall sinkt die Kostenfunktion nach jeder Iteration. Konvergenz ist erreicht, wenn sie nicht weiter fällt. Wie viele Iterationen dafür nötig sind, variiert stark – von Dutzenden bis zu Millionen. Das ist vorab schwer zu schätzen.
Manche Algorithmen erkennen Konvergenz automatisch. Häufig ist es aber sinnvoll, eine Abbruchschwelle zu definieren – auch das ist nicht trivial. Einfache Plots sind daher oft die beste praktische Kontrolle.
Wissenschaftlerinnen und Wissenschaftler nutzen Gradient Descent, um Parameter so zu finden, dass die Kostenfunktion minimiert wird. In der Praxis dient es als zentrales Optimierungsverfahren beim Training von Machine-Learning-Modellen: Parameter werden iterativ angepasst, um eine (konvexe) Zielfunktion zu minimieren.
Gradient Descent ist vermutlich die bekannteste Optimierungsstrategie im Machine Learning und Deep Learning. Data Scientists setzen sie breit ein, weil sie mit vielen Lernmodellen kombinierbar ist. Das Grundprinzip ist leicht zu verstehen, die Implementierung ebenfalls. Wenn du tiefer ins Deep Learning einsteigen willst, sieh dir unseren kompletten Katalog an Machine-Learning-Kursen an.
Lerne mit DataCamp
Lernpfad
Kurs
Kurs