Cursus
Chercheur en apprentissage automatique en Python
85 h
La descente de gradient est l’un des algorithmes les plus importants de tout l’apprentissage automatique et du deep learning. C’est un algorithme d’optimisation extrêmement puissant qui permet d’entraîner des modèles de régression linéaire, de régression logistique et des réseaux de neurones. Si vous débutez en machine learning, il est donc indispensable de comprendre en profondeur l’algorithme de descente de gradient.
La data science consiste à découvrir des structures et des comportements complexes à partir de l’analyse de grands volumes de données. On parle de « motifs », c’est-à-dire de régularités qui se répètent. Grâce au machine learning, il s’agit d’entraîner des algorithmes à détecter ces motifs pour accomplir une tâche donnée de manière plus performante : on apprend au logiciel à réaliser une tâche ou à faire des prédictions de façon autonome. Pour cela, la ou le data scientist sélectionne et entraîne des algorithmes d’analyse de données, avec pour objectif d’améliorer leurs prédictions au fil du temps.
L’apprentissage automatique repose donc largement sur l’entraînement d’algorithmes. Plus ils sont exposés aux données, mieux ils apprennent à effectuer une tâche sans instructions explicites ; ils apprennent par expérience. Parmi les différents algorithmes utilisés, la descente de gradient est l’un des plus utiles et des plus répandus.
La descente de gradient est un algorithme d’optimisation. Elle sert à trouver plus rapidement la valeur minimale d’une fonction. Sa définition est assez simple : c’est un algorithme pour trouver le minimum d’une fonction convexe, en modifiant itérativement les paramètres de la fonction. Elle est par exemple utilisée en régression linéaire.
Une fonction convexe ressemble à une belle vallée avec un minimum global au centre. À l’inverse, une fonction non convexe comporte plusieurs minima locaux ; utiliser la descente de gradient dessus expose au risque de rester bloqué au premier minimum rencontré.
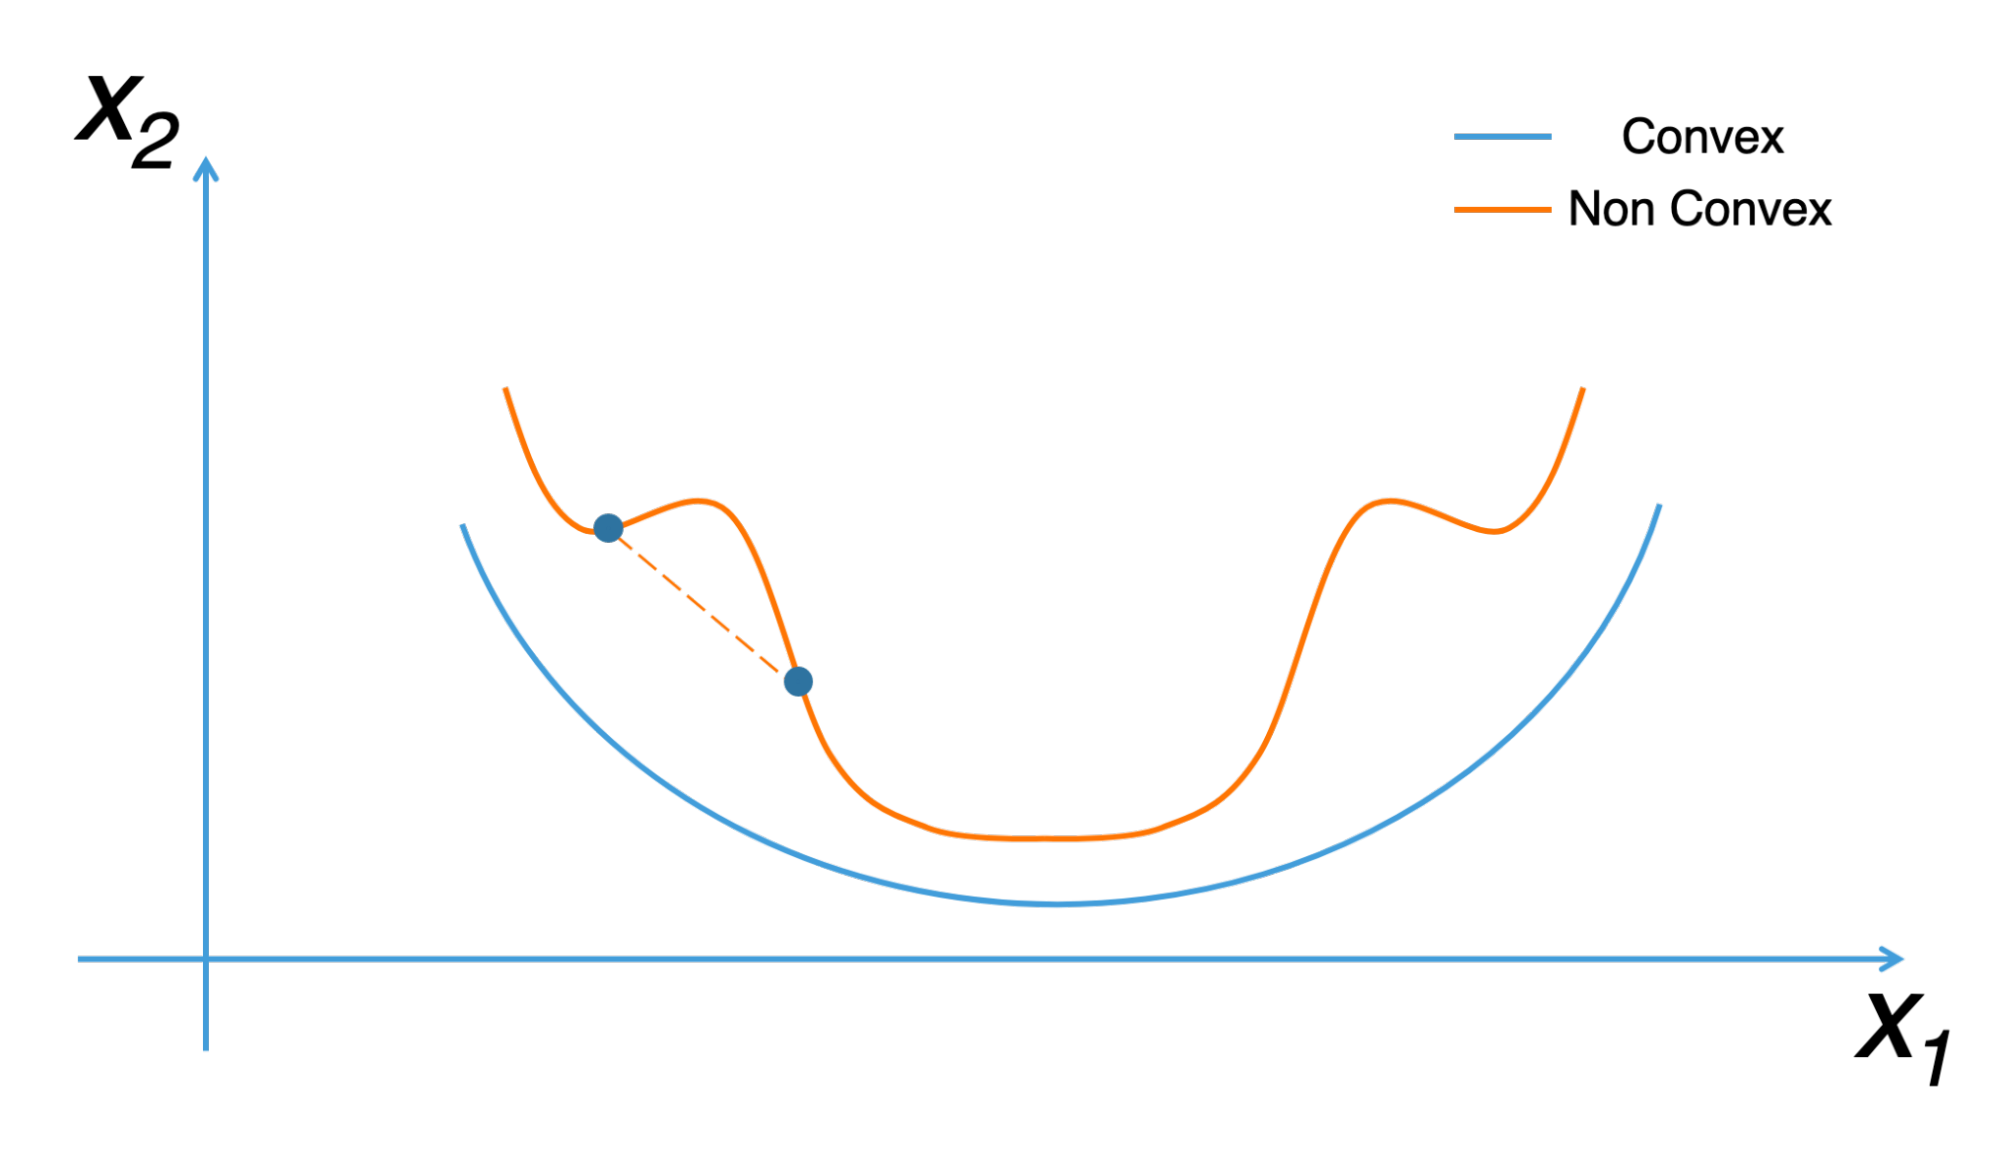
La descente de gradient est aussi appelée « algorithme de la plus forte pente ». Elle est essentielle en machine learning, où elle sert à minimiser une fonction de coût, utilisée pour déterminer le meilleur modèle de prédiction. Plus le coût est faible, plus le modèle saura faire de bonnes prédictions.
On distingue trois variantes courantes. Regardons-les de plus près :
Aussi appelée vanilla gradient descent, la descente de gradient par lot calcule les erreurs sur l’ensemble des exemples du jeu d’entraînement, mais n’effectue la mise à jour qu’après avoir évalué tous les exemples. On peut l’assimiler à un cycle complet, parfois appelé « époque » d’entraînement.
La descente par lot présente plusieurs atouts : son efficacité de calcul favorise une convergence stable et un gradient d’erreur régulier. Elle a toutefois des limites : cette stabilité peut mener à une convergence défavorable, et elle nécessite de charger l’intégralité des données d’entraînement en mémoire.
La descente de gradient stochastique (SGD) met à jour les paramètres pour chaque exemple d’entraînement, un par un. Elle prête ainsi une attention fine à chaque observation, ce qui peut accélérer l’apprentissage selon le problème, comparé au traitement par lot. Ses mises à jour fréquentes offrent une granularité d’amélioration plus détaillée.
En contrepartie, ces mises à jour sont coûteuses en calcul et peuvent introduire du bruit dans le gradient, ce qui empêche parfois l’erreur de décroître régulièrement : l’erreur « saute » et peut devenir problématique à long terme.
La descente de gradient par mini-lots est souvent le point de départ recommandé, car elle combine les avantages des approches stochastique et par lot. Elle segmente les données d’entraînement en mini-lots et réalise une mise à jour par mini-lot, trouvant un équilibre entre l’efficacité de BGD et la robustesse de SGD.
Les tailles de mini-lots les plus utilisées vont d’une cinquantaine à deux cent cinquante-six, mais comme souvent en machine learning, il n’existe pas de règle universelle : cela dépend des cas d’usage. C’est l’option de base pour entraîner des réseaux de neurones et elle est très répandue en deep learning.
En machine learning, on utilise la descente de gradient en apprentissage supervisé pour minimiser la fonction de coût, souvent convexe (par exemple l’erreur quadratique moyenne).
Grâce à cet algorithme, le modèle apprend en trouvant les meilleurs paramètres. Minimiser la fonction de coût revient à déterminer les paramètres a, b, c, etc., qui produisent les plus petites erreurs entre notre modèle et les valeurs y du jeu de données. Une fois le coût minimisé, on peut construire des systèmes performants de reconnaissance vocale, de vision par ordinateur ou de prévision de cours boursiers.
Vous comprenez ainsi pourquoi la descente de gradient est fondamentale : c’est par elle que le modèle apprend.
Pour illustrer son fonctionnement, on utilise souvent l’analogie de la montagne. Imaginez une personne égarée en montagne qui cherche à retrouver la vallée : elle commence par repérer la direction de la pente la plus forte vers le bas, avance d’une certaine distance, puis répète l’opération jusqu’à atteindre la vallée (la valeur la plus basse). En machine learning, la descente de gradient répète ce procédé en boucle jusqu’à trouver un minimum pour la fonction de coût. C’est un algorithme itératif, gourmand en calcul.
Voici une stratégie en deux étapes qui vous sortira d’affaire si vous êtes perdu en montagne :
En répétant ces deux étapes, vous convergerez vers le fond de la vallée. C’est exactement l’algorithme de descente de gradient.
On part d’un point initial aléatoire, puis on mesure la pente en ce point. Mathématiquement, la pente se mesure en calculant la dérivée de la fonction.
On progresse ensuite d’une certaine distance d dans la direction de la pente descendante — pas 300 mètres cette fois. Cette distance s’appelle le « taux d’apprentissage ». Cette opération modifie la valeur des paramètres de notre modèle (nos coordonnées dans la vallée changent quand on se déplace).
L’algorithme est surtout utilisé en machine learning et en deep learning — ce dernier pouvant être vu comme une extension plus puissante du machine learning, capable de détecter des motifs plus subtils. Ces disciplines requièrent de solides bases en mathématiques et en Python.
Ce langage dispose de nombreuses bibliothèques qui facilitent la mise en œuvre du machine learning. Il est très utile pour analyser rapidement et précisément de grands volumes de données et réaliser des analyses prédictives à partir de tendances ou d’événements passés.
Étroitement lié au big data, le machine learning dépasse les limites humaines pour l’analyse de flux massifs. Avec les vastes jeux de données disponibles, l’intelligence artificielle (IA) peut apprendre sans intervention humaine. Le machine learning est, par exemple, utilisé dans les objets connectés : une IA s’adapte aux habitudes des occupants d’une maison connectée et exécute ses tâches en conséquence.
Elle peut ainsi ajuster le chauffage d’une pièce selon la météo. C’est aussi grâce à ces approches que les robots aspirateurs deviennent plus sophistiqués. La descente de gradient, via le machine learning, est au cœur des grandes avancées de l’IA, avec de très nombreuses applications concrètes pour les ingénieurs et spécialistes.
Elle est utile pour les moteurs de recherche comme Google et pour les systèmes de recommandation populaires comme YouTube, Netflix ou Amazon. À partir des données des utilisateurs, les algorithmes infèrent leurs centres d’intérêt afin de proposer des résultats et recommandations pertinents.
Le machine learning a permis aux ordinateurs de comprendre et de traiter le langage humain, donnant naissance à des assistants numériques comme Alexa, Google Assistant et Siri. Les applications de la descente de gradient sont également précieuses en jeu vidéo, pour doter les IA de comportements humains et libérer du temps sur des tâches à plus forte valeur. IA et machine learning aident les entreprises à anticiper les besoins de leurs clients et les tendances à venir.
La descente de gradient est souvent utilisée en régression linéaire pour des raisons de complexité de calcul. Sa formule générale s’écrit : xt+1 = xt − η ∆xt, où η est le taux d’apprentissage et ∆xt la direction de descente. L’algorithme s’applique à des fonctions convexes ; si l’on cherche à minimiser f, l’objectif est d’avoir f(xt+1) ≤ f(xt) à chaque itération.
L’idée est de calculer progressivement le minimum d’une fonction. En apprentissage supervisé, on utilise une fonction de coût pour mesurer l’écart entre une estimation et la valeur réelle. Dans un problème de régression linéaire, on travaille classiquement avec l’erreur quadratique moyenne.
L’application de la descente de gradient s’appuie sur la notion de taux d’apprentissage, hyperparamètre qui contrôle l’ajustement des poids du réseau par rapport au gradient de la perte. Un taux approprié est crucial pour atteindre rapidement et efficacement un minimum : ni trop élevé, ni trop faible.
Quand la valeur diminue à chaque pas, on progresse bien le long de la pente descendante. Plusieurs méthodes d’optimisation utilisent la descente de gradient, notamment RMSprop, Adam et SGD. Pour éviter les erreurs, choisissez vos hyperparamètres avec soin et gardez à l’esprit que le minimum trouvé peut être local, pas nécessairement global.
La fonction principale du gradient est de mesurer la variation de chaque poids au regard de la variation de l’erreur. Pensez au gradient comme à la pente d’une fonction : plus le gradient est grand, plus la pente est raide — condition favorable, car le modèle apprend vite. Mais si la pente devient nulle, l’apprentissage s’arrête. Mathématiquement, un gradient est une dérivée (éventuellement approchée) par rapport aux entrées.
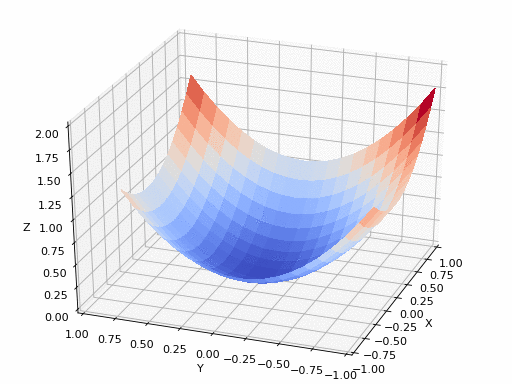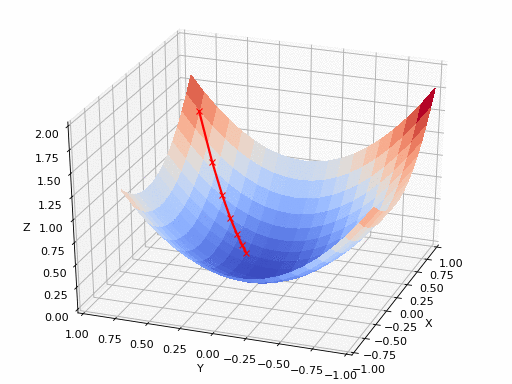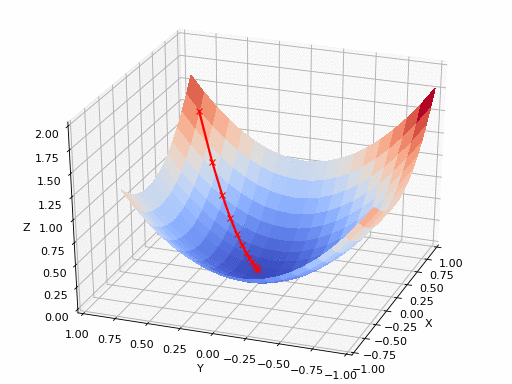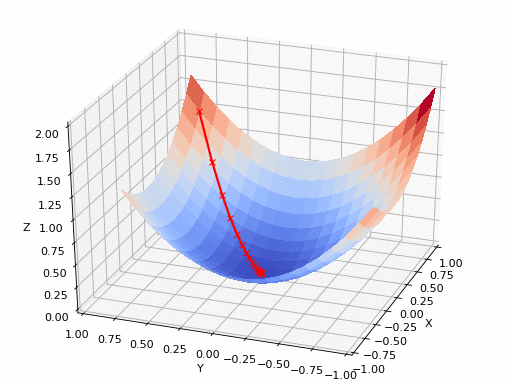
Côté implémentation, on écrira deux fonctions : une fonction de coût qui prend en entrée la sortie réelle et la sortie prédite et renvoie la perte ; puis la fonction de descente de gradient, qui prend la variable indépendante et la variable cible (dépendante) en entrée et calcule la droite d’ajustement optimale via la descente de gradient.
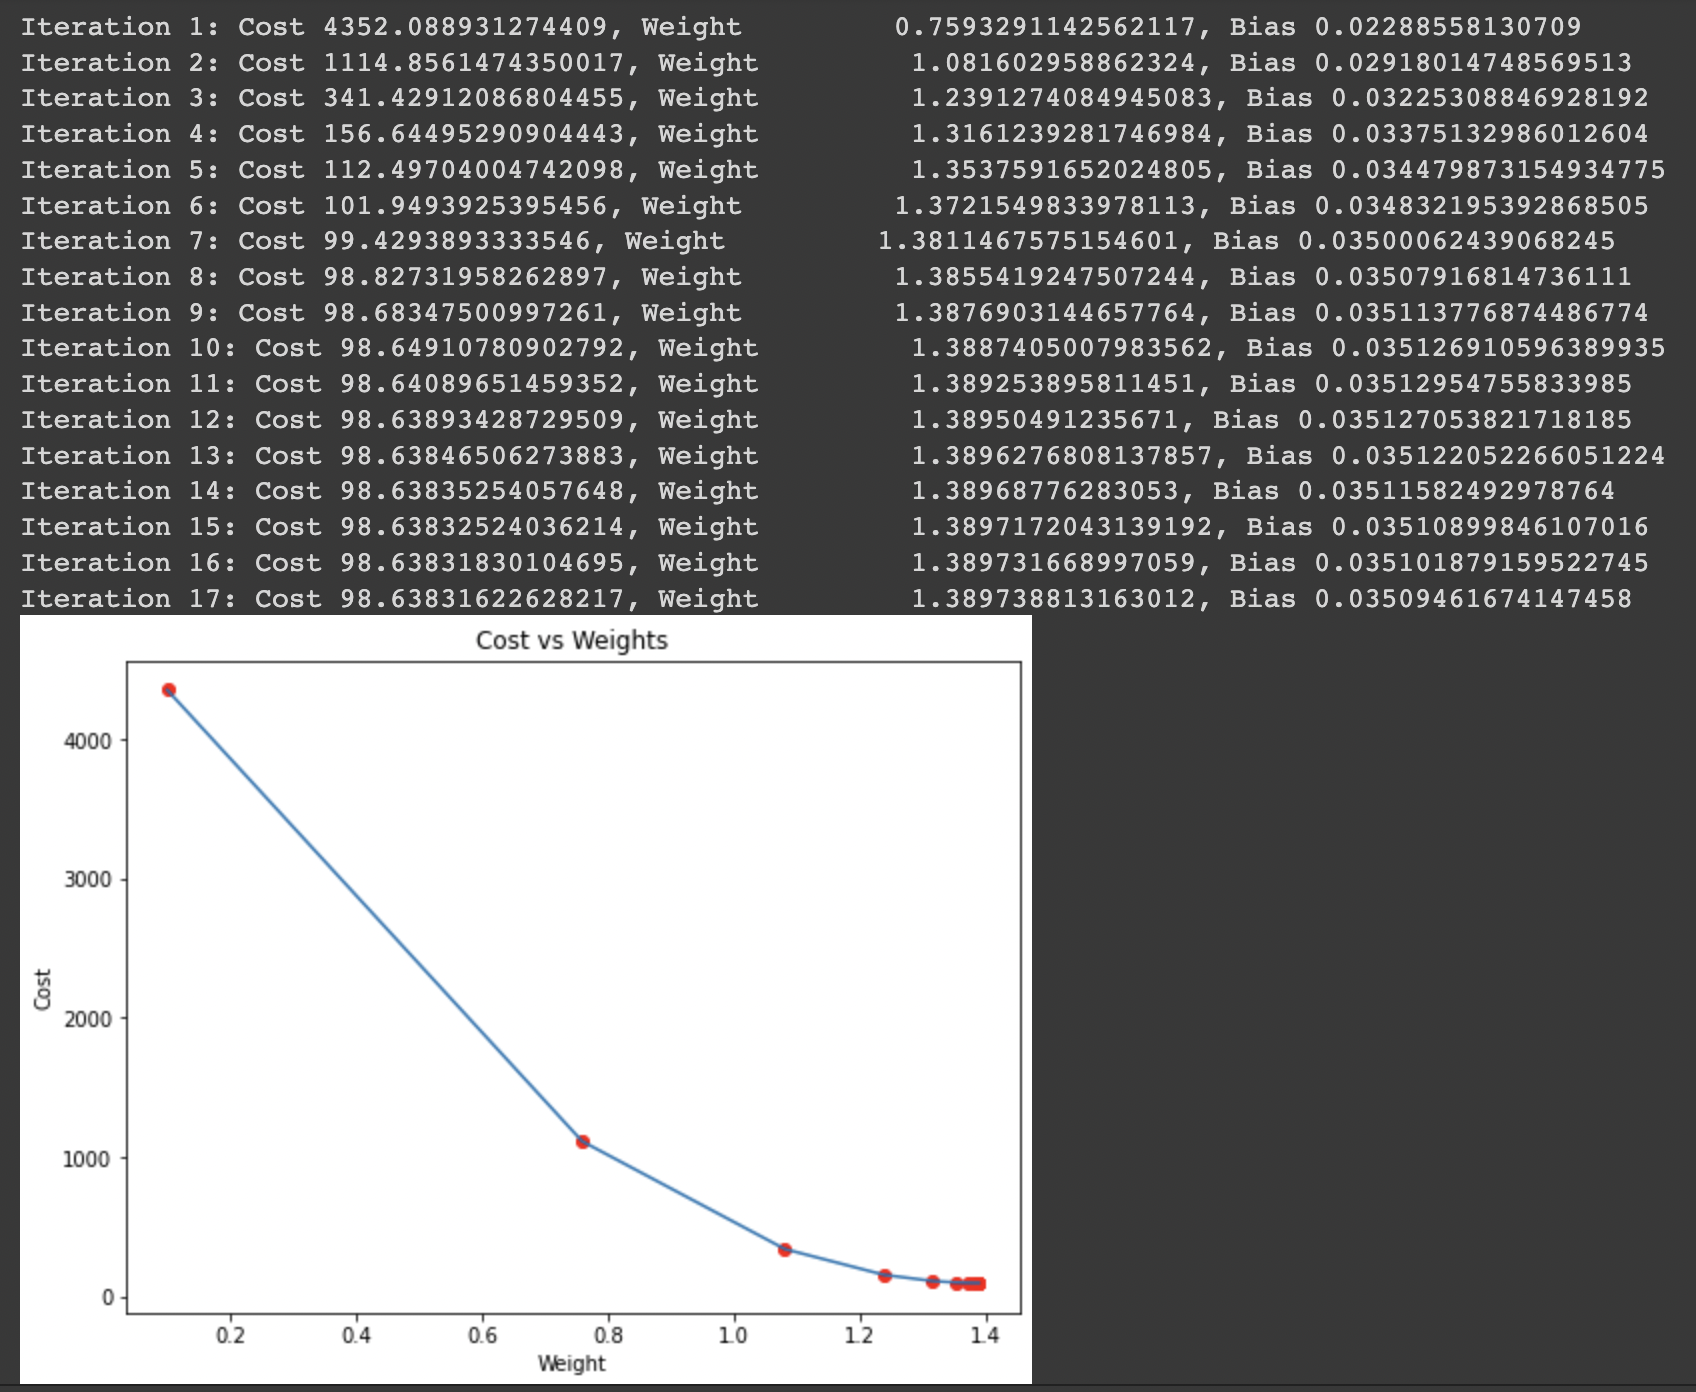
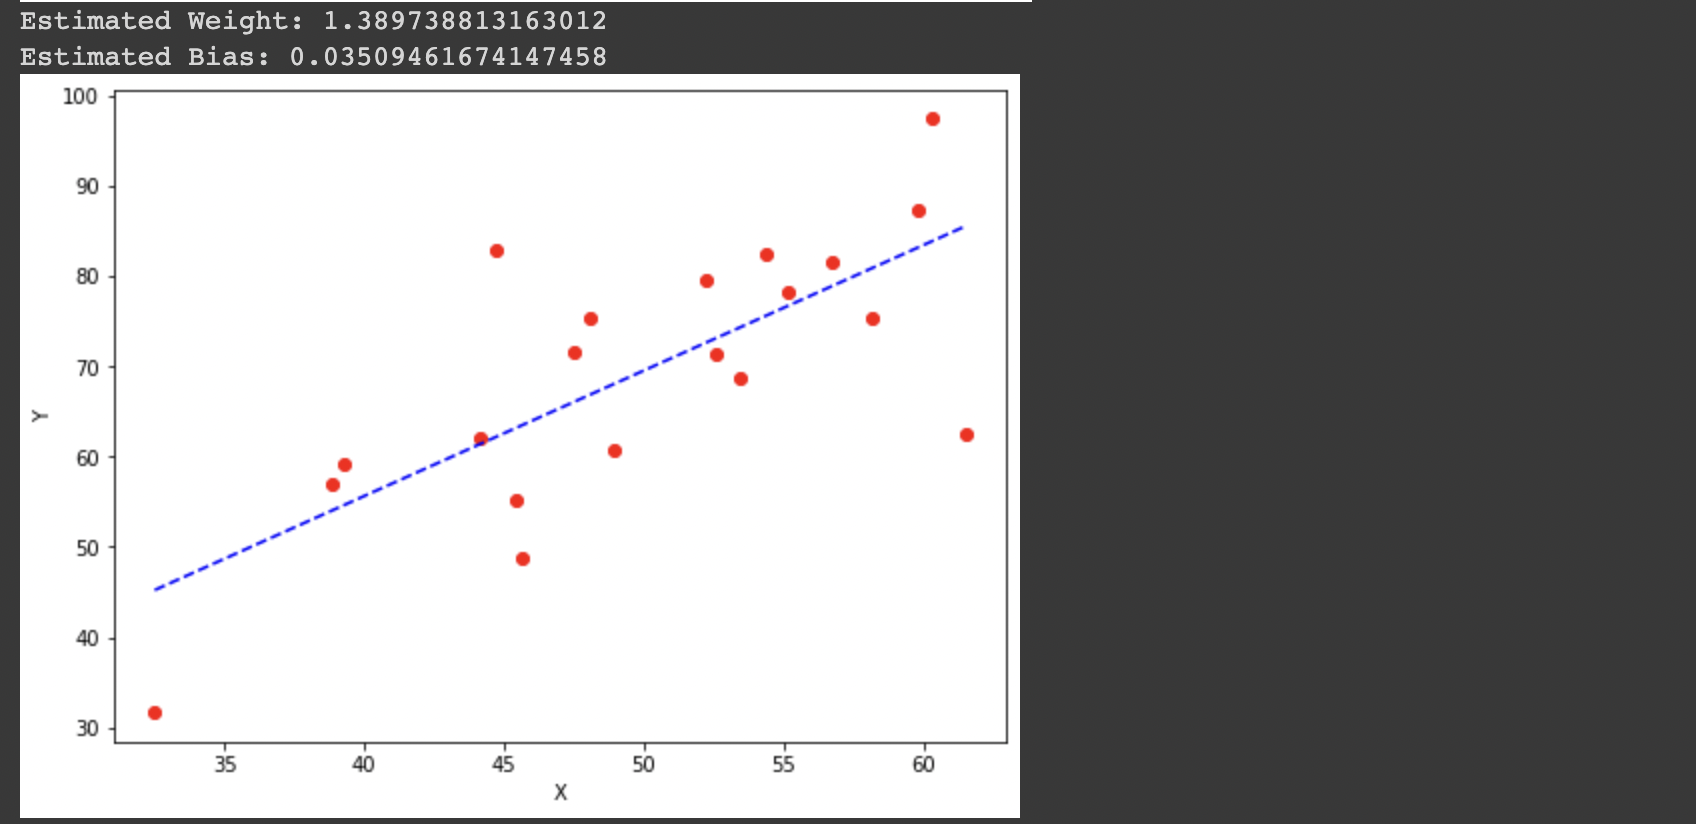
Le nombre d’itérations, le taux d’apprentissage et le seuil d’arrêt sont les hyperparamètres de la descente de gradient et peuvent être définis par l’utilisateur. Dans la fonction principale, on initialise des données linéairement corrélées aléatoires, puis on applique la descente de gradient pour trouver la meilleure droite d’ajustement. Le poids et le biais optimaux ainsi obtenus servent ensuite à tracer la droite des moindres carrés.
# Import des bibliothèques
import numpy as np
import matplotlib.pyplot as plt

def mean_squared_error(y_true, y_pred):
    # Calcul de la perte (coût)
    cost = np.sum((y_true - y_pred) ** 2) / len(y_true)
    return cost

# Fonction de descente de gradient
# iterations, learning_rate, stopping_threshold sont des hyperparamètres ajustables
def gradient_descent(x, y, iterations=1000, learning_rate=0.0001, stopping_threshold=1e-6):
    # Initialisation du poids, du biais et des paramètres
    current_weight = 0.1
    current_bias = 0.01
    n = float(len(x))

    costs = []
    weights = []
    previous_cost = None

    # Estimation des paramètres optimaux
    for i in range(iterations):
        # Prédictions
        y_pred = (current_weight * x) + current_bias

        # Coût courant
        current_cost = mean_squared_error(y, y_pred)

        # Arrêt si la variation du coût est inférieure au seuil
        if previous_cost is not None and abs(previous_cost - current_cost) <= stopping_threshold:
            break

        previous_cost = current_cost

        costs.append(current_cost)
        weights.append(current_weight)

        # Gradients
        weight_derivative = -(2 / n) * np.sum(x * (y - y_pred))
        bias_derivative = -(2 / n) * np.sum(y - y_pred)

        # Mise à jour des paramètres
        current_weight = current_weight - (learning_rate * weight_derivative)
        current_bias = current_bias - (learning_rate * bias_derivative)

        # Affichage tous les 1000 itérations
        if (i + 1) % 1000 == 0:
            print(f"Iteration {i+1}: Cost {current_cost}, Weight {current_weight}, Bias {current_bias}")

    # Visualisation du coût en fonction du poids
    plt.figure(figsize=(8, 6))
    plt.plot(weights, costs)
    plt.scatter(weights, costs, marker='o', color='red')
    plt.title("Cost vs Weights")
    plt.ylabel("Cost")
    plt.xlabel("Weights")
    plt.show()

    return current_weight, current_bias

def main():
    # Données (exemple)
    X = np.array([32.5, 53.4, 61.5, 47.4, 59.8,
                  55.1, 52.2, 39.2, 48.1, 52.5,
                  45.4, 54.3, 44.1, 58.1, 56.7,
                  48.9, 44.6, 60.2, 45.6, 38.8])
    Y = np.array([31.7, 68.7, 62.5, 71.5, 87.2,
                  78.2, 79.6, 59.1, 75.3, 71.3,
                  55.1, 82.4, 62.0, 75.3, 81.4,
                  60.7, 82.8, 97.3, 48.8, 56.8])

    # Estimation du poids et du biais par descente de gradient
    estimated_weight, estimated_bias = gradient_descent(X, Y, iterations=2000)
    print(f"Estimated Weight: {estimated_weight}\nEstimated Bias: {estimated_bias}")

    # Prédictions avec les paramètres estimés
    Y_pred = estimated_weight * X + estimated_bias

    # Tracé de la droite de régression
    plt.figure(figsize=(8, 6))
    plt.scatter(X, Y, marker='o', color='red')
    plt.plot([np.min(X), np.max(X)], [np.min(Y_pred), np.max(Y_pred)], color='blue')
    plt.xlabel("X")
    plt.ylabel("Y")
    plt.show()

if __name__ == "__main__":
    main()
La sortie du code sera similaire à ceci :
Vous pouvez tester et exécuter le code ci-dessus dans ce notebook.
Autre point essentiel : le taux d’apprentissage. En machine learning, on parle d’hyperparamètre, car il n’est pas un paramètre du modèle à proprement parler, mais il influe fortement sur la performance finale (au même titre que les paramètres du modèle).
Le taux d’apprentissage (souvent noté α ou η) indique la vitesse d’évolution des coefficients. Il peut être fixe ou variable. Une des méthodes populaires aujourd’hui est Adam, dont le taux d’apprentissage s’adapte au fil du temps.
De nombreux scénarios sont possibles lorsqu’on utilise la descente de gradient :
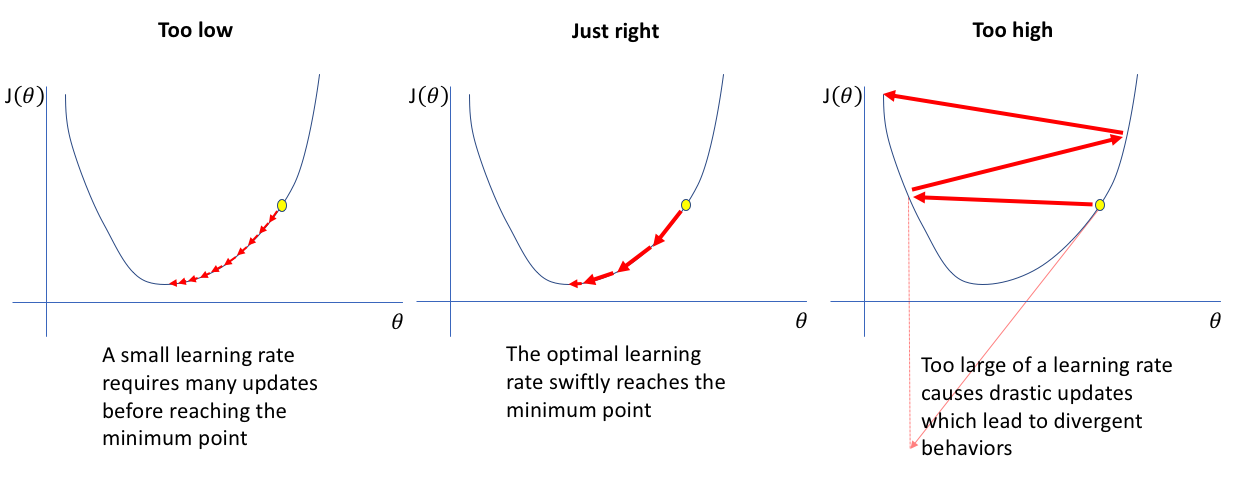
Si le taux est trop grand, les pas effectués seront trop importants. Avantage : on descend vite vers le minimum de la fonction de coût. Risque : on manque ce minimum en oscillant indéfiniment autour. Dans l’analogie de la vallée, c’est comme parcourir plusieurs kilomètres d’un coup et passer devant l’abri sans le voir.
Pour éviter ce cas, on pourrait choisir un taux très bas. Mais s’il est trop faible, la convergence vers le minimum prendra un temps excessif. C’est un peu comme avancer millimètre par millimètre pour atteindre le point le plus bas de la vallée.
Il est crucial de régler le taux d’apprentissage à une valeur appropriée pour permettre d’atteindre un (ou le) minimum. Trop grand ou trop petit complique la convergence. Avec un taux réduit, la descente peut finir par atteindre un minimum local, mais cela peut prendre du temps.
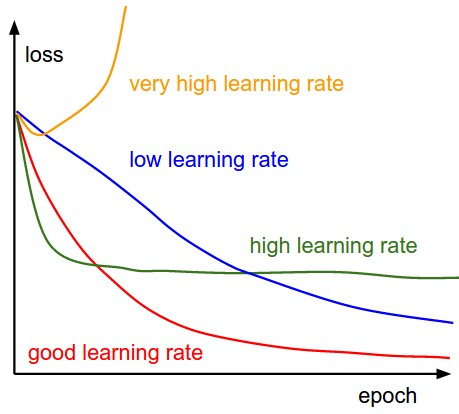
Il n’existe pas de formule magique. La plupart du temps, il faut expérimenter et tester plusieurs valeurs — c’est le réglage d’hyperparamètres — en utilisant des stratégies dédiées.
Une bonne pratique consiste à tracer la fonction de coût au fil de l’optimisation : nombre d’itérations en abscisse et valeur de la fonction de coût en ordonnée. Vous visualiserez la valeur du coût après chaque itération et pourrez juger si le taux d’apprentissage est adapté, voire comparer plusieurs valeurs.
Si la descente de gradient fonctionne correctement, la fonction de coût diminue à chaque itération. Elle converge lorsqu’elle ne parvient plus à la réduire et stagne. Le nombre d’itérations nécessaires varie énormément : parfois une cinquantaine, parfois deux ou trois millions. Difficile de l’anticiper.
Certains algorithmes détectent automatiquement la convergence, mais il reste utile de définir un seuil d’arrêt en amont — lui aussi délicat à estimer. C’est l’une des raisons pour lesquelles des tracés simples sont très efficaces pour évaluer la convergence.
Les scientifiques utilisent la descente de gradient pour trouver les valeurs des paramètres qui minimisent une fonction de coût ; les développeurs l’emploient comme algorithme d’optimisation pendant l’entraînement des modèles de machine learning. La descente de gradient ajuste itérativement certains paramètres pour minimiser une fonction, idéalement convexe.
C’est probablement la stratégie d’optimisation la plus répandue en deep learning et en machine learning. Les data scientists l’adoptent volontiers, quel que soit le modèle sous-jacent. Comprendre la descente de gradient est relativement simple, et l’implémenter l’est encore plus. Pour aller plus loin en deep learning, parcourez notre catalogue complet de cours en machine learning.
Apprenez avec DataCamp
Cursus
Cours
Cours