
Cursus
Dimensionality Reduction in Python
4 uur
37.2K
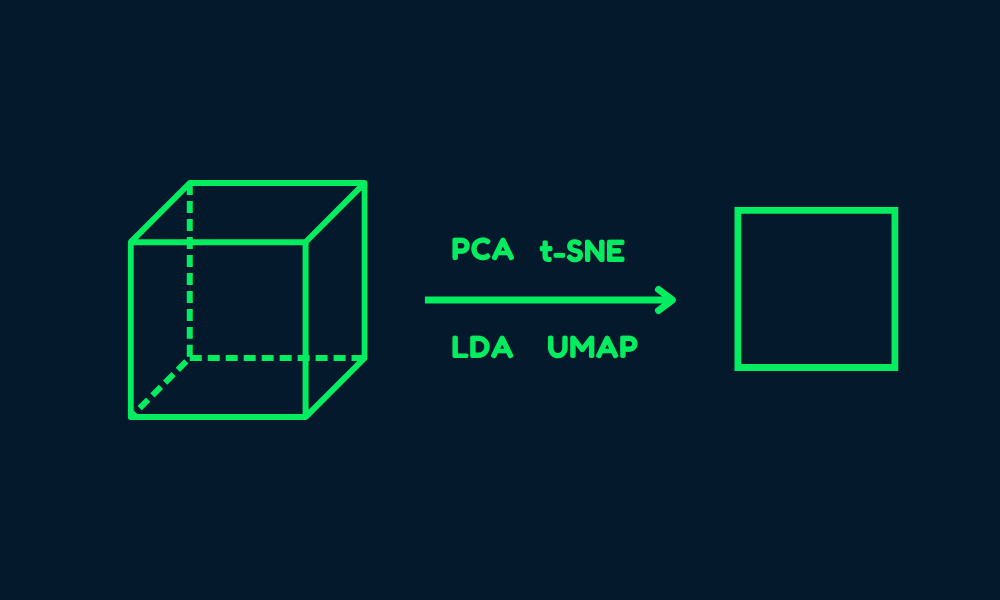
Dimensionaliteitsreductie is een krachtige techniek in machine learning en data-analyse waarbij gegevens met veel dimensies worden getransformeerd naar een ruimte met minder dimensies, terwijl zo veel mogelijk belangrijke informatie behouden blijft. Hoog-dimensionale data verwijst naar datasets met een groot aantal features of variabelen, wat aanzienlijke uitdagingen kan opleveren voor machinelearningmodellen.
In deze tutorial leer je waarom we dimensionaliteitsreductie zouden moeten gebruiken, welke soorten technieken er zijn en hoe je deze toepast op een eenvoudige afbeeldingsdataset. We visualiseren de data ook in 2D en vergelijken de beelden in een ruimte met lagere dimensies.
Ben je nieuw in machine learning en wil je de ML-concepten onder de knie krijgen? Volg dan de Become a Machine Learning Scientist in Python-carrièretrack en werk toe naar een rol als machine learning scientist.
Afbeelding door de auteur
Data met veel dimensies is rijk aan informatie, maar bevat vaak overbodige of irrelevante features. Dit kan tot meerdere problemen leiden:
Dimensionaliteitsreductie pakt deze problemen aan door de data te vereenvoudigen en toch de belangrijkste kenmerken te behouden. Dit verbetert niet alleen de modelprestaties, maar maakt de data ook makkelijker te interpreteren en te visualiseren.
Technieken voor dimensionaliteitsreductie kunnen ook worden geclassificeerd op basis van de aanname of de datastructuur lineair of niet-lineair is.
Lineaire methoden gaan ervan uit dat de data in een lineaire deelruimte ligt. Deze technieken zijn rekenkundig efficiënt en werken goed wanneer de structuur van de data van nature lineair is.
Enkele voorbeelden:
Volg de Principal Component Analysis (PCA) in Python-tutorial om te leren hoe je zonder supervisie informatie uit data haalt met de Breast Cancer- en CIFAR-10-dataset.
Niet-lineaire methoden worden gebruikt wanneer de data op een niet-lineair manifold ligt. Deze technieken zijn beter geschikt om complexe structuren in de data vast te leggen.
Enkele voorbeelden:
Technieken voor dimensionaliteitsreductie kunnen grofweg worden ingedeeld in twee typen: featureselectie en feature-extractie.
Featureselectie draait om het identificeren en behouden van alleen de meest relevante features uit de dataset. Dit proces transformeert de data niet, maar selecteert een subset van de oorspronkelijke features.
Gebruikelijke methoden zijn onder andere:
Feature-extractie, ook wel featureprojectie genoemd, transformeert de data naar een lagere-dimensionale ruimte door nieuwe features te creëren die combinaties zijn van de oorspronkelijke. Deze aanpak is vooral nuttig wanneer de oorspronkelijke features sterk gecorreleerd of redundant zijn.
Populaire methoden voor feature-extractie zijn:
In deze gids leren we hoe je technieken voor dimensionaliteitsreductie toepast in Python.
We beginnen met het importeren van de benodigde Python-pakketten en het laden van de digits-dataset uit sklearn.datasets.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.manifold import TSNE
from sklearn.preprocessing import StandardScaler


# Load the digits dataset
digits = load_digits()
X = digits.data   # shape (1797, 64)
y = digits.target # labels for digits (0 through 9)

print("Data shape:", X.shape)
print("Labels shape:", y.shape)
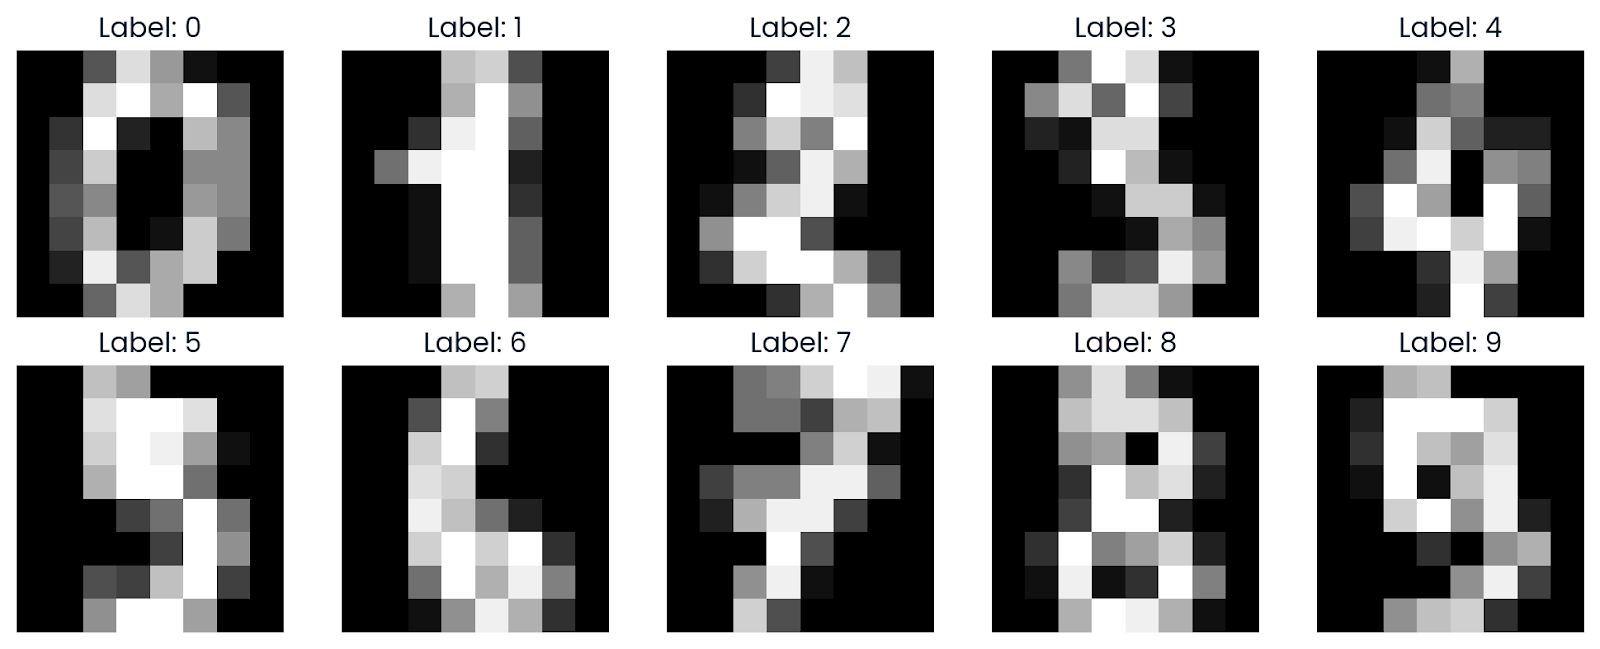
Deze dataset bevat 1.797 grijswaardenafbeeldingen van handgeschreven cijfers (0–9), elk weergegeven als een 8x8-afbeelding (64 pixels). De data is afgevlakt tot een featurevector van 64 dimensies per afbeelding.
Data shape: (1797, 64)
Labels shape: (1797,)We visualiseren nu een paar voorbeelden uit de dataset om een beter beeld te krijgen. Met Matplotlib tonen we afbeeldingen die zijn teruggevormd naar hun oorspronkelijke 8x8-raster.
def plot_digits(images, labels, n_rows=2, n_cols=5):
    fig, axes = plt.subplots(n_rows, n_cols, figsize=(10, 4))
    axes = axes.ravel()
    for i in range(n_rows * n_cols):
        axes[i].imshow(images[i].reshape(8, 8), cmap='gray')
        axes[i].set_title(f"Label: {labels[i]}")
        axes[i].axis('off')
    plt.tight_layout()
    plt.show()

plot_digits(X, y)
Zoals je ziet, wordt een raster met afbeeldingen weergegeven waarop je kunt zien hoe de cijfers van 0 tot 9 er in grijswaarden uitzien.
t-SNE is een populaire techniek voor dimensionaliteitsreductie om hoog-dimensionale data in 2D of 3D te visualiseren. Het is bijzonder effectief in het behouden van lokale structuren in de data.
Lees de blog Introduction to t-SNE: Nonlinear Dimensionality Reduction and Data Visualization om te leren hoe je hoog-dimensionale data visualiseert in een lage-dimensionale ruimte met een niet-lineaire reductietechniek.
Voordat we t-SNE toepassen, schalen we de data met StandardScaler om de featurewaarden te normaliseren.
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Vervolgens selecteren we een subset van 500 samples voor snellere berekening en draaien we het t-SNE-algoritme op die subset.
Hier zijn de argumenten van de TSNE-functie met uitleg:
n_samples = 500
X_sub = X_scaled[:n_samples]
y_sub = y[:n_samples]

tsne = TSNE(n_components=2,
            perplexity=30,
            n_iter=1000,
            random_state=42)
X_tsne = tsne.fit_transform(X_sub)

print("t-SNE result shape:", X_tsne.shape)
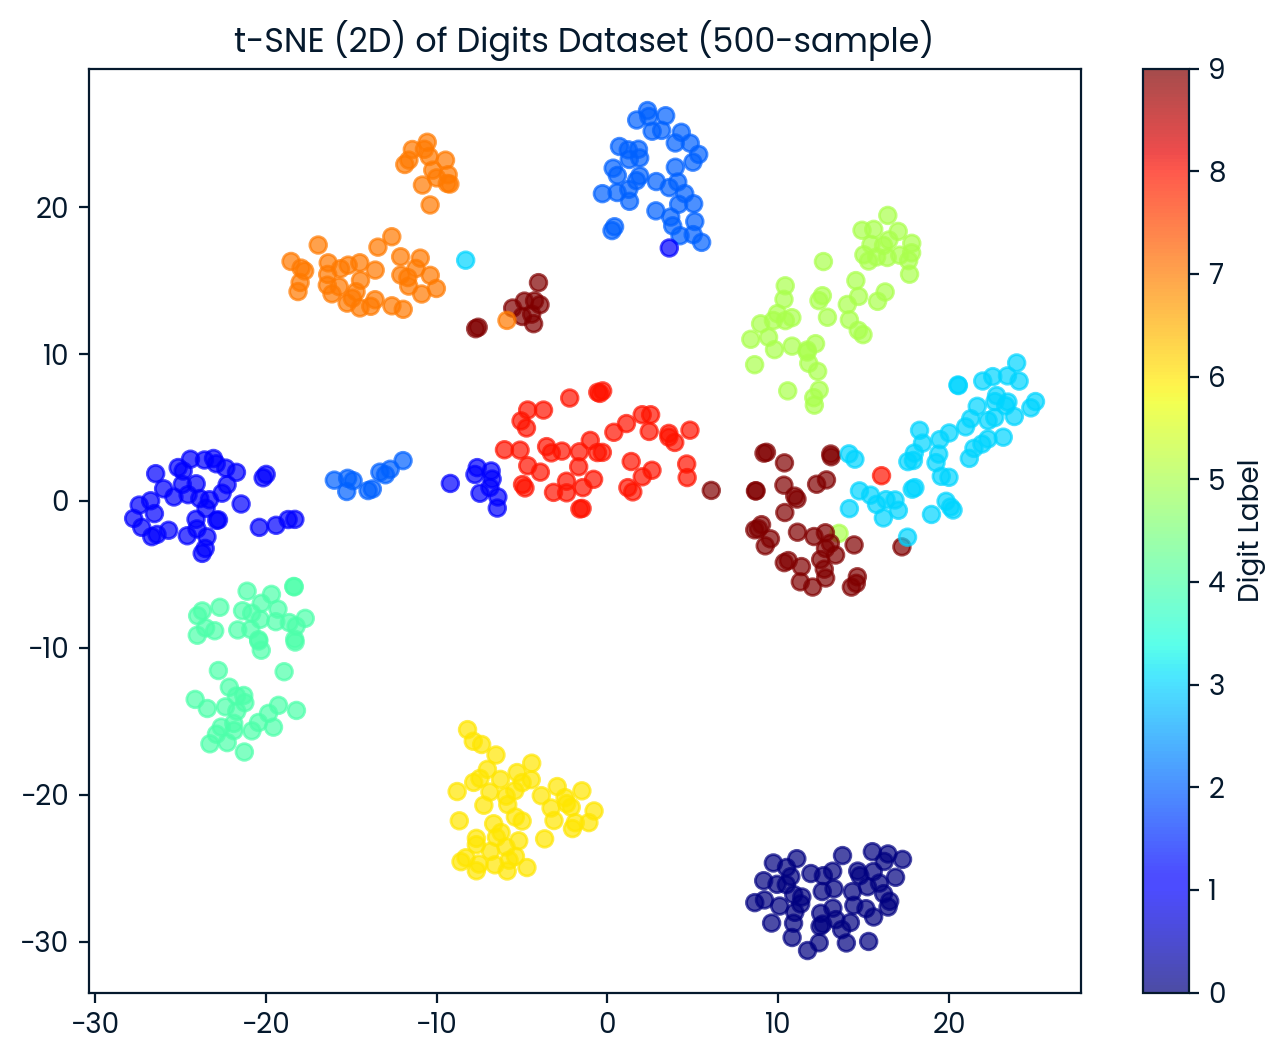
De dimensionaliteitsreductie is gelukt: we hebben nu 500 samples die elk in 2 dimensies zijn weergegeven.
t-SNE result shape: (500, 2)We visualiseren nu de 2D t-SNE-dataset. Elk punt is ingekleurd op basis van het cijferlabel, zodat we kunnen zien hoe goed t-SNE de verschillende cijferklassen scheidt.
plt.figure(figsize=(8, 6))
scatter = plt.scatter(X_tsne[:, 0], X_tsne[:, 1],
                      c=y_sub, cmap='jet', alpha=0.7)
plt.colorbar(scatter, label='Digit Label')
plt.title('t-SNE (2D) of Digits Dataset (500-sample)')
plt.show()
t-SNE heeft de cijfers effectief gescheiden in 10 duidelijke groepen, met enige overlap tussen groepen.
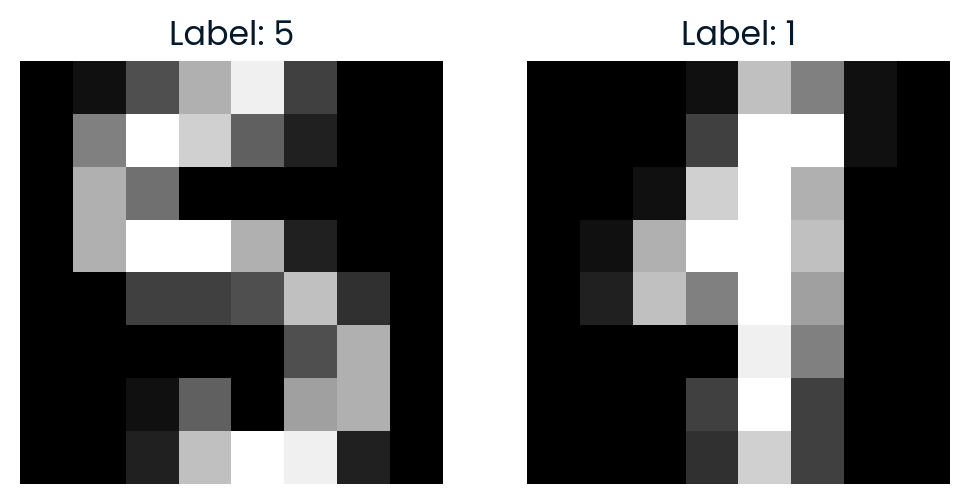
Om de t-SNE-ruimte verder te verkennen, selecteren we willekeurig twee punten en berekenen we de Euclidische afstand tussen die punten in de 2D t-SNE-ruimte. We visualiseren ook de afbeeldingen om te zien hoe vergelijkbaar ze zijn.
import random

idx1, idx2 = random.sample(range(X_tsne.shape[0]), 2)

point1, point2 = X_tsne[idx1], X_tsne[idx2]
dist_tsne = np.linalg.norm(point1 - point2)

print(f"Comparing images #{idx1} and #{idx2}")
print(f"Distance in t-SNE space: {dist_tsne:.4f}")
print(f"Label of image #{idx1}: {y_sub[idx1]}")
print(f"Label of image #{idx2}: {y_sub[idx2]}")

# Plot the original images
fig, axes = plt.subplots(1, 2, figsize=(6, 3))
axes[0].imshow(X[idx1].reshape(8, 8), cmap='gray')
axes[0].set_title(f"Label: {y_sub[idx1]}")
axes[0].axis('off')

axes[1].imshow(X[idx2].reshape(8, 8), cmap='gray')
axes[1].set_title(f"Label: {y_sub[idx2]}")
axes[1].axis('off')

plt.show()
De afstand in de t-SNE-ruimte weerspiegelt hoe ongelijk de twee afbeeldingen zijn in de gereduceerde 2D-representatie.
Comparing images #291 and #90
Distance in t-SNE space: 35.7666
Label of image #291: 5
Label of image #90: 1
Lukt het niet om de bovenstaande code te draaien? Bekijk dan de DataLab-werkruimte voor verdere hulp.
Dimensionaliteitsreductie speelt een cruciale rol in toepassingen in de echte wereld door de efficiëntie, nauwkeurigheid en interpreteerbaarheid van machinelearningmodellen te verbeteren en betere visualisatie en analyse van complexe datasets mogelijk te maken.
In deze tutorial hebben we het concept van dimensionaliteitsreductie, het doel, de methoden en de typen verkend. Tot slot hebben we geleerd hoe je met t-SNE beelddata transformeert naar een ruimte met lagere dimensies voor visualisatie en analyse.
Volg de Dimensionality Reduction in Python-cursus om het concept van dimensionaliteitsreductie in je data te begrijpen en de technieken in Python onder de knie te krijgen.
Topcursussen op DataCamp
Cursus
Leerpad
Leerpad
blog
Adel Nehme
15 min

