
Khóa học
Giảm Chiều Dữ Liệu với Python
4 giờ
37.2K
Giảm chiều dữ liệu là một kỹ thuật mạnh mẽ trong học máy và phân tích dữ liệu, liên quan đến việc biến đổi dữ liệu có số chiều cao sang không gian có số chiều thấp hơn trong khi vẫn giữ lại càng nhiều thông tin quan trọng càng tốt. Dữ liệu có số chiều cao đề cập đến các tập dữ liệu có nhiều đặc trưng hoặc biến, có thể gây ra những thách thức đáng kể cho các mô hình học máy.
Trong hướng dẫn này, chúng ta sẽ tìm hiểu lý do nên sử dụng giảm chiều dữ liệu, các loại kỹ thuật giảm chiều và cách áp dụng chúng cho một tập dữ liệu hình ảnh đơn giản. Chúng ta cũng sẽ trực quan hóa dữ liệu trong không gian 2D và so sánh các hình ảnh trong không gian có số chiều thấp hơn.
Nếu bạn mới bắt đầu với học máy và muốn nắm vững các khái niệm, hãy tham gia lộ trình nghề nghiệp Trở thành Nhà khoa học Học máy với Python và từng bước trở thành một nhà khoa học học máy.
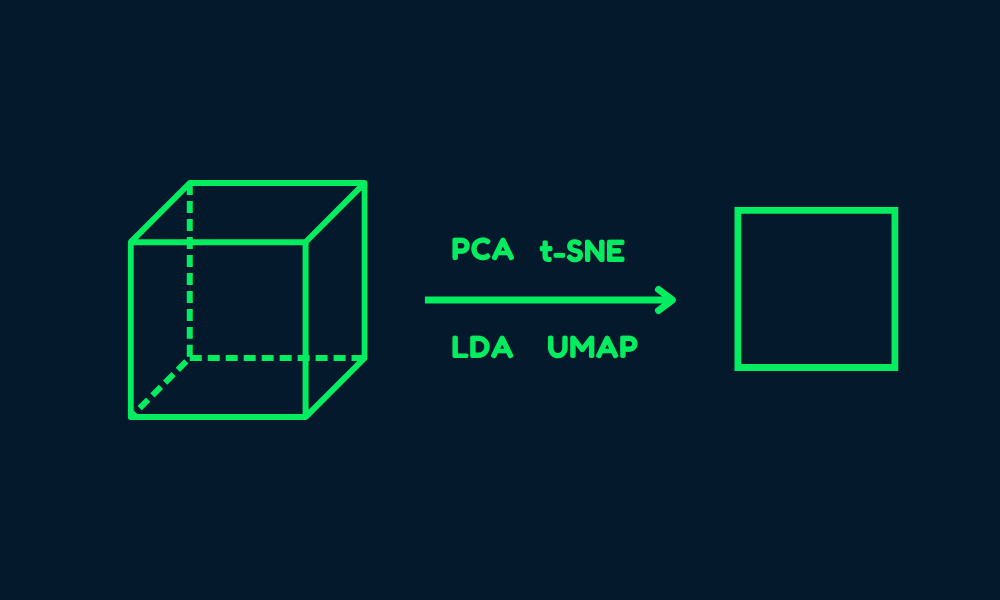
Hình ảnh: Tác giả
Dữ liệu có số chiều cao, dù giàu thông tin, thường chứa các đặc trưng dư thừa hoặc không liên quan. Điều này có thể dẫn đến một số vấn đề:
Giảm chiều dữ liệu giải quyết những vấn đề này bằng cách đơn giản hóa dữ liệu trong khi vẫn giữ các đặc trưng quan trọng nhất. Điều này không chỉ cải thiện hiệu năng mô hình mà còn giúp dữ liệu dễ diễn giải và trực quan hóa hơn.
Các kỹ thuật giảm chiều cũng có thể được phân loại dựa trên giả định cấu trúc tuyến tính hay phi tuyến trong dữ liệu.
Các phương pháp tuyến tính giả định dữ liệu nằm trong một không gian con tuyến tính. Những kỹ thuật này hiệu quả về mặt tính toán và hoạt động tốt khi cấu trúc dữ liệu vốn dĩ tuyến tính.
Một số ví dụ:
Hãy theo dõi hướng dẫn Phân tích Thành phần Chính (PCA) trong Python để học cách trích xuất thông tin từ dữ liệu không giám sát bằng các tập dữ liệu Breast Cancer và CIFAR-10.
Các phương pháp phi tuyến được sử dụng khi dữ liệu nằm trên một đa tạp phi tuyến. Những kỹ thuật này phù hợp hơn để nắm bắt các cấu trúc phức tạp trong dữ liệu.
Một số ví dụ:
Các kỹ thuật giảm chiều có thể được phân loại rộng thành hai nhóm: Chọn lọc đặc trưng và Trích xuất đặc trưng.
Chọn lọc đặc trưng liên quan đến việc xác định và giữ lại chỉ những đặc trưng liên quan nhất từ tập dữ liệu. Quá trình này không biến đổi dữ liệu mà chọn một tập con của các đặc trưng gốc.
Các phương pháp phổ biến gồm:
Trích xuất đặc trưng, còn gọi là chiếu đặc trưng, biến đổi dữ liệu vào không gian có số chiều thấp hơn bằng cách tạo ra các đặc trưng mới là tổ hợp của các đặc trưng gốc. Cách tiếp cận này đặc biệt hữu ích khi các đặc trưng gốc có tương quan cao hoặc dư thừa.
Các phương pháp trích xuất đặc trưng phổ biến gồm:
Trong hướng dẫn này, chúng ta sẽ học cách áp dụng các kỹ thuật giảm chiều bằng Python.
Chúng ta sẽ bắt đầu bằng cách nhập các gói Python cần thiết và tải tập dữ liệu chữ số từ sklearn.datasets.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.manifold import TSNE
from sklearn.preprocessing import StandardScaler


# Load the digits dataset
digits = load_digits()
X = digits.data   # shape (1797, 64)
y = digits.target # labels for digits (0 through 9)

print("Data shape:", X.shape)
print("Labels shape:", y.shape)
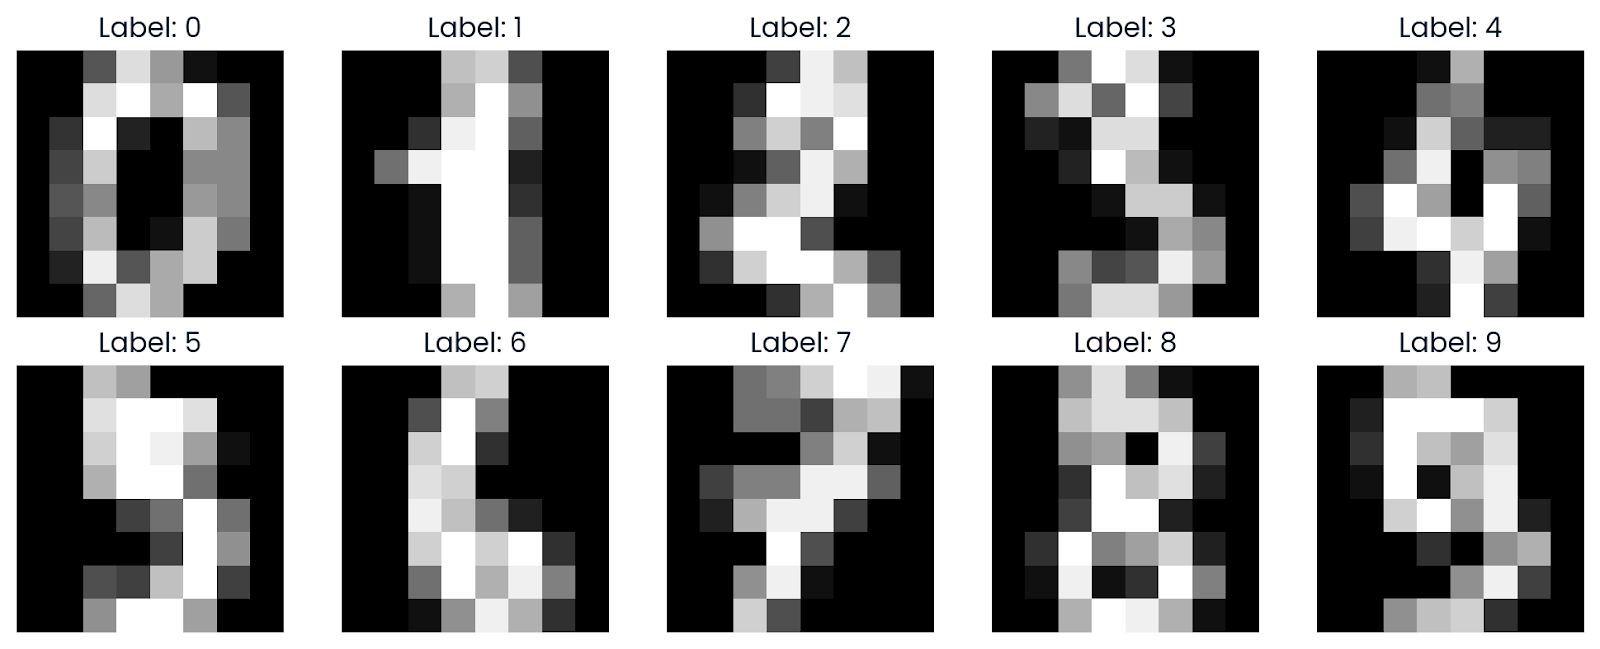
Tập dữ liệu này chứa 1.797 ảnh xám của các chữ số viết tay (0–9), mỗi ảnh được biểu diễn dưới dạng ảnh 8x8 (64 điểm ảnh). Dữ liệu được dẹt thành một véc-tơ đặc trưng 64 chiều cho mỗi ảnh.
Data shape: (1797, 64)
Labels shape: (1797,)Bây giờ chúng ta sẽ trực quan hóa một vài mẫu từ tập dữ liệu để hiểu rõ hơn. Sử dụng Matplotlib, chúng ta sẽ hiển thị các ảnh đã được định dạng lại về lưới 8x8 ban đầu.
def plot_digits(images, labels, n_rows=2, n_cols=5):
    fig, axes = plt.subplots(n_rows, n_cols, figsize=(10, 4))
    axes = axes.ravel()
    for i in range(n_rows * n_cols):
        axes[i].imshow(images[i].reshape(8, 8), cmap='gray')
        axes[i].set_title(f"Label: {labels[i]}")
        axes[i].axis('off')
    plt.tight_layout()
    plt.show()

plot_digits(X, y)
Như có thể thấy, nó hiển thị một lưới ảnh, cho thấy các chữ số từ 0 đến 9 trông như thế nào ở thang xám.
t-SNE là một kỹ thuật giảm chiều phổ biến để trực quan hóa dữ liệu nhiều chiều trong 2D hoặc 3D. Nó đặc biệt hiệu quả trong việc bảo toàn các cấu trúc cục bộ trong dữ liệu.
Đọc bài blog Giới thiệu về t-SNE: Giảm Chiều Phi Tuyến và Trực quan hóa Dữ liệu để học cách trực quan hóa dữ liệu nhiều chiều trong không gian có số chiều thấp bằng một kỹ thuật giảm chiều phi tuyến.
Trước khi áp dụng t-SNE, chúng ta chuẩn hóa dữ liệu bằng StandardScaler để chuẩn hóa các giá trị đặc trưng.
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Sau đó, chúng ta chọn một tập con 500 mẫu để tính toán nhanh hơn và chạy thuật toán t-SNE trên tập con này.
Dưới đây là các tham số của hàm TSNE kèm giải thích:
n_samples = 500
X_sub = X_scaled[:n_samples]
y_sub = y[:n_samples]

tsne = TSNE(n_components=2,
            perplexity=30,
            n_iter=1000,
            random_state=42)
X_tsne = tsne.fit_transform(X_sub)

print("t-SNE result shape:", X_tsne.shape)
Việc giảm chiều đã thành công, vì hiện chúng ta có 500 mẫu, mỗi mẫu được biểu diễn trong 2 chiều.
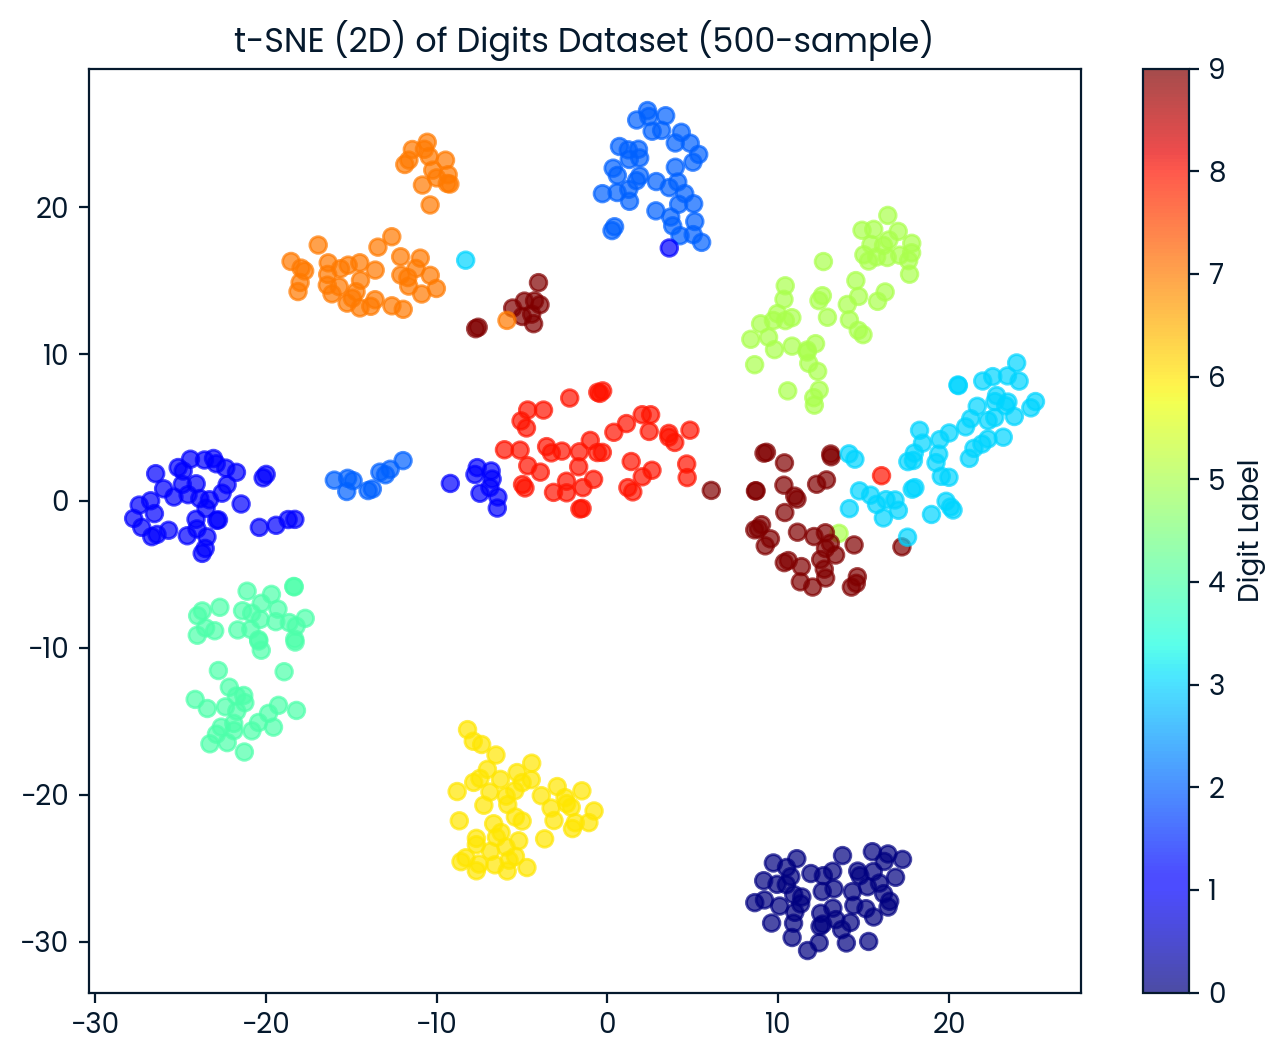
t-SNE result shape: (500, 2)Bây giờ chúng ta trực quan hóa tập dữ liệu t-SNE 2D. Mỗi điểm được tô màu theo nhãn chữ số của nó, cho phép quan sát mức độ t-SNE tách biệt các lớp chữ số khác nhau.
plt.figure(figsize=(8, 6))
scatter = plt.scatter(X_tsne[:, 0], X_tsne[:, 1],
                      c=y_sub, cmap='jet', alpha=0.7)
plt.colorbar(scatter, label='Digit Label')
plt.title('t-SNE (2D) of Digits Dataset (500-sample)')
plt.show()
t-SNE đã tách biệt hiệu quả các chữ số thành 10 nhóm riêng, với một số chồng lấn giữa các nhóm.
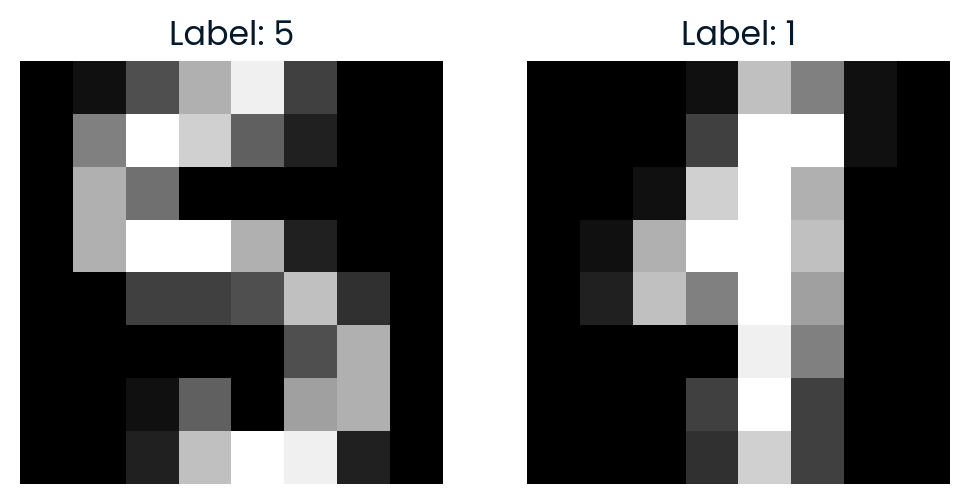
Để khám phá sâu hơn không gian t-SNE, chúng ta chọn ngẫu nhiên hai điểm và tính khoảng cách Euclid giữa chúng trong không gian t-SNE 2D. Chúng ta cũng sẽ trực quan hóa các ảnh để xem chúng giống nhau đến mức nào.
import random

idx1, idx2 = random.sample(range(X_tsne.shape[0]), 2)

point1, point2 = X_tsne[idx1], X_tsne[idx2]
dist_tsne = np.linalg.norm(point1 - point2)

print(f"Comparing images #{idx1} and #{idx2}")
print(f"Distance in t-SNE space: {dist_tsne:.4f}")
print(f"Label of image #{idx1}: {y_sub[idx1]}")
print(f"Label of image #{idx2}: {y_sub[idx2]}")

# Plot the original images
fig, axes = plt.subplots(1, 2, figsize=(6, 3))
axes[0].imshow(X[idx1].reshape(8, 8), cmap='gray')
axes[0].set_title(f"Label: {y_sub[idx1]}")
axes[0].axis('off')

axes[1].imshow(X[idx2].reshape(8, 8), cmap='gray')
axes[1].set_title(f"Label: {y_sub[idx2]}")
axes[1].axis('off')

plt.show()
Khoảng cách trong không gian t-SNE phản ánh mức độ không giống nhau của hai ảnh trong biểu diễn 2D đã giảm chiều.
Comparing images #291 and #90
Distance in t-SNE space: 35.7666
Label of image #291: 5
Label of image #90: 1
Nếu bạn gặp khó khăn khi chạy đoạn mã trên, vui lòng xem không gian làm việc DataLab để được hỗ trợ thêm.
Giảm chiều dữ liệu đóng vai trò then chốt trong các ứng dụng thực tế bằng cách cải thiện hiệu quả, độ chính xác và khả năng diễn giải của các mô hình học máy, đồng thời cho phép trực quan hóa và phân tích tốt hơn các tập dữ liệu phức tạp.
Trong hướng dẫn này, chúng ta đã khám phá khái niệm giảm chiều dữ liệu, mục đích, phương pháp và các loại. Cuối cùng, chúng ta đã học cách sử dụng kỹ thuật t-SNE để biến đổi dữ liệu hình ảnh vào không gian có số chiều thấp hơn nhằm trực quan hóa và phân tích.
Hãy tham gia khóa học Giảm Chiều Dữ Liệu trong Python để hiểu khái niệm giảm số chiều trong dữ liệu của bạn và thành thạo các kỹ thuật thực hiện điều đó trong Python.
Những khóa học hàng đầu trên DataCamp
Khóa học
Lộ trình
Lộ trình
blog
Matt Crabtree
10 phút
