
Corso
Riduzione della dimensionalità in Python
4 ore
37.2K
La riduzione della dimensionalità è una potente tecnica nel machine learning e nell'analisi dei dati che consiste nel trasformare dati ad alta dimensionalità in uno spazio a dimensionalità inferiore, mantenendo quante più informazioni importanti possibile. Per dati ad alta dimensionalità si intendono dataset con un gran numero di caratteristiche o variabili, che possono creare sfide significative per i modelli di machine learning.
In questo tutorial vedremo perché dovremmo usare la riduzione della dimensionalità, i tipi di tecniche disponibili e come applicarle a un semplice dataset di immagini. Visualizzeremo anche i dati in uno spazio 2D e confronteremo le immagini in uno spazio a dimensionalità inferiore.
Se sei alle prime armi con il machine learning e vuoi padroneggiarne i concetti, segui il percorso di carriera Become a Machine Learning Scientist in Python e lavora per diventare uno scienziato del machine learning.
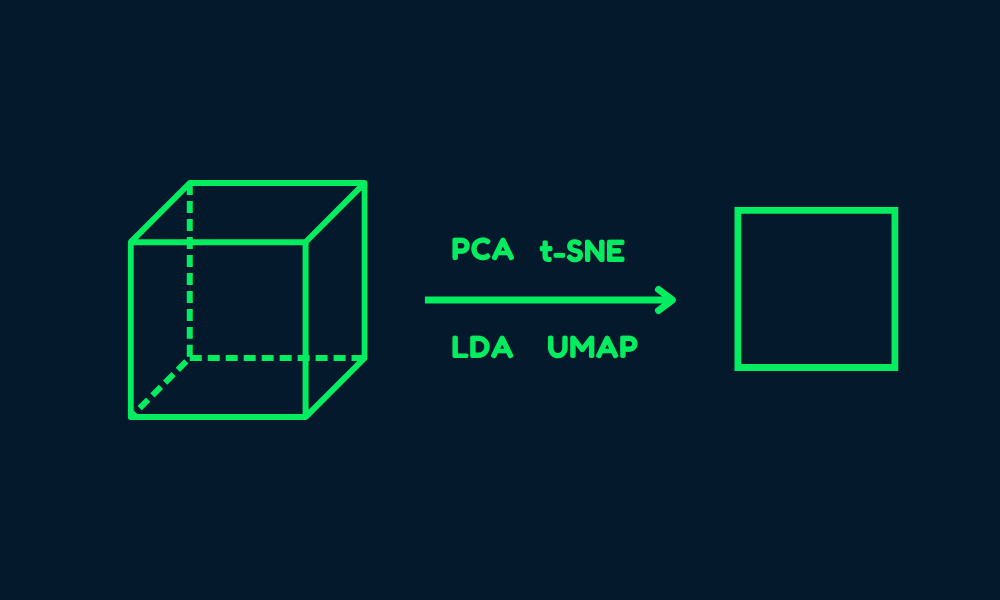
Immagine dell'autore
I dati ad alta dimensionalità, pur essendo ricchi di informazioni, spesso contengono caratteristiche ridondanti o irrilevanti. Questo può portare a diversi problemi:
La riduzione della dimensionalità affronta questi problemi semplificando i dati e mantenendone le caratteristiche più importanti. Questo non solo migliora le prestazioni dei modelli, ma rende anche i dati più facili da interpretare e visualizzare.
Le tecniche di riduzione della dimensionalità possono essere classificate anche in base al fatto che assumano una struttura lineare o non lineare nei dati.
I metodi lineari assumono che i dati giacciano in un sottospazio lineare. Queste tecniche sono computazionalmente efficienti e funzionano bene quando la struttura dei dati è intrinsecamente lineare.
Ecco alcuni esempi:
Segui il tutorial Principal Component Analysis (PCA) in Python per imparare a estrarre informazioni dai dati senza supervisione usando i dataset Breast Cancer e CIFAR-10.
I metodi non lineari si usano quando i dati giacciono su una varietà non lineare. Queste tecniche sono più adatte a catturare strutture complesse nei dati.
Ecco alcuni esempi:
Le tecniche di riduzione della dimensionalità possono essere ampiamente suddivise in due tipi: selezione delle caratteristiche e estrazione delle caratteristiche.
La selezione delle caratteristiche consiste nell'identificare e mantenere solo le caratteristiche più rilevanti del dataset. Questo processo non trasforma i dati, ma seleziona un sottoinsieme delle caratteristiche originali.
Metodi comuni includono:
L'estrazione delle caratteristiche, nota anche come proiezione delle caratteristiche, trasforma i dati in uno spazio a dimensionalità inferiore creando nuove caratteristiche come combinazioni di quelle originali. Questo approccio è particolarmente utile quando le caratteristiche originali sono altamente correlate o ridondanti.
Metodi popolari di estrazione includono:
In questa guida impareremo ad applicare tecniche di riduzione della dimensionalità in Python.
Inizieremo importando i pacchetti Python necessari e caricando il dataset digits da sklearn.datasets.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.manifold import TSNE
from sklearn.preprocessing import StandardScaler


# Load the digits dataset
digits = load_digits()
X = digits.data   # shape (1797, 64)
y = digits.target # labels for digits (0 through 9)

print("Data shape:", X.shape)
print("Labels shape:", y.shape)
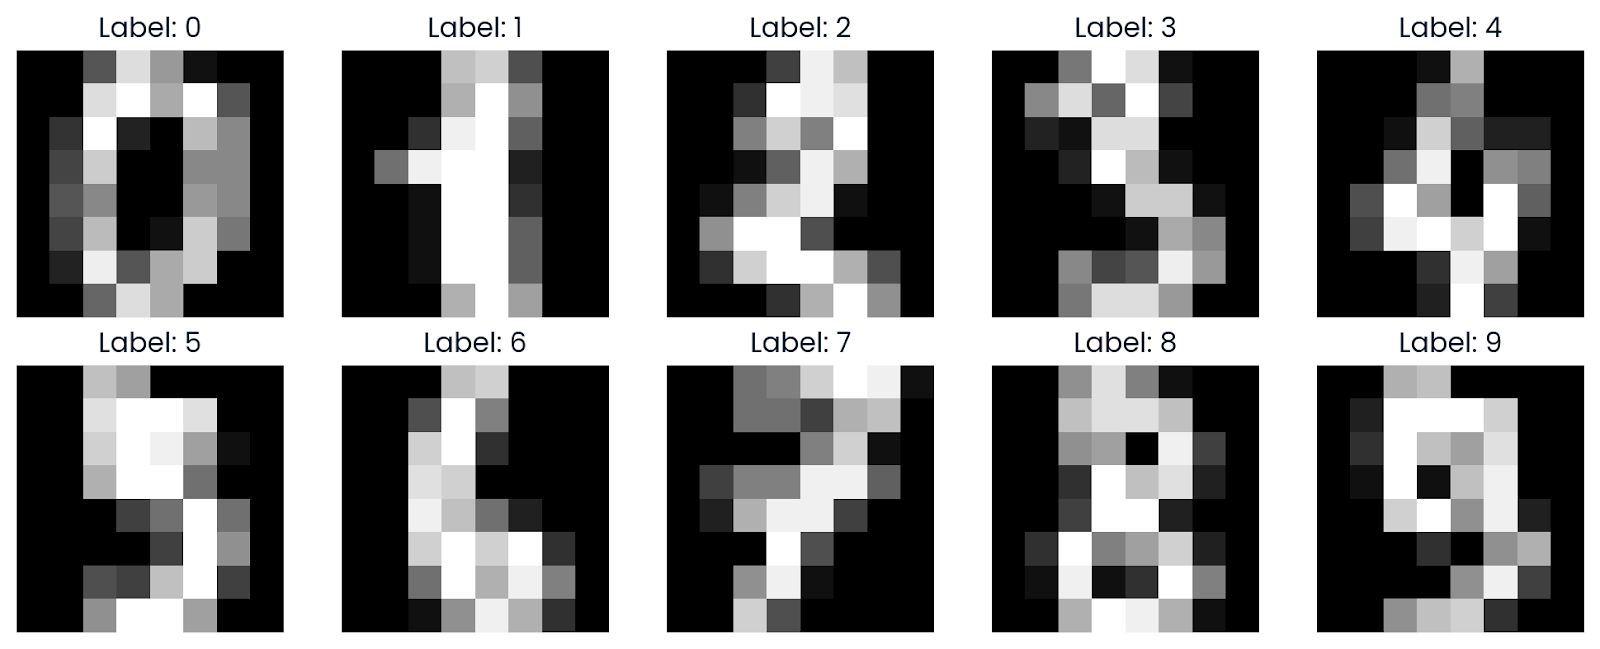
Questo dataset contiene 1.797 immagini in scala di grigi di cifre scritte a mano (0–9), ciascuna rappresentata come un'immagine 8x8 (64 pixel). I dati sono appiattiti in un vettore di caratteristiche a 64 dimensioni per ogni immagine.
Data shape: (1797, 64)
Labels shape: (1797,)Ora visualizzeremo alcuni campioni del dataset per comprenderlo meglio. Con Matplotlib mostreremo immagini riconvertite al loro formato a griglia 8x8 originale.
def plot_digits(images, labels, n_rows=2, n_cols=5):
    fig, axes = plt.subplots(n_rows, n_cols, figsize=(10, 4))
    axes = axes.ravel()
    for i in range(n_rows * n_cols):
        axes[i].imshow(images[i].reshape(8, 8), cmap='gray')
        axes[i].set_title(f"Label: {labels[i]}")
        axes[i].axis('off')
    plt.tight_layout()
    plt.show()

plot_digits(X, y)
Come possiamo vedere, viene mostrata una griglia di immagini che illustra come appaiono le cifre in scala di grigi da 0 a 9.
t-SNE è una tecnica popolare di riduzione della dimensionalità per visualizzare dati ad alta dimensionalità in 2D o 3D. È particolarmente efficace nel preservare le strutture locali nei dati.
Leggi l'articolo Introduction to t-SNE: Nonlinear Dimensionality Reduction and Data Visualization per imparare a visualizzare dati ad alta dimensionalità in uno spazio a bassa dimensionalità usando una tecnica di riduzione non lineare.
Prima di applicare t-SNE, ridimensioniamo i dati usando StandardScaler per normalizzare i valori delle caratteristiche.
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Poi selezioniamo un sottoinsieme di 500 campioni per un calcolo più veloce ed eseguiamo l'algoritmo t-SNE su questo sottoinsieme.
Ecco gli argomenti della funzione TSNE con spiegazione:
n_samples = 500
X_sub = X_scaled[:n_samples]
y_sub = y[:n_samples]

tsne = TSNE(n_components=2,
            perplexity=30,
            n_iter=1000,
            random_state=42)
X_tsne = tsne.fit_transform(X_sub)

print("t-SNE result shape:", X_tsne.shape)
La riduzione della dimensionalità è andata a buon fine: ora abbiamo 500 campioni, ciascuno rappresentato in 2 dimensioni.
t-SNE result shape: (500, 2)Ora visualizziamo il dataset t-SNE 2D. Ogni punto è colorato in base alla sua etichetta di cifra, permettendoci di osservare quanto bene t-SNE separi le diverse classi di cifre.
plt.figure(figsize=(8, 6))
scatter = plt.scatter(X_tsne[:, 0], X_tsne[:, 1],
                      c=y_sub, cmap='jet', alpha=0.7)
plt.colorbar(scatter, label='Digit Label')
plt.title('t-SNE (2D) of Digits Dataset (500-sample)')
plt.show()
t-SNE ha separato efficacemente le cifre in 10 gruppi distinti, con qualche sovrapposizione tra i gruppi.
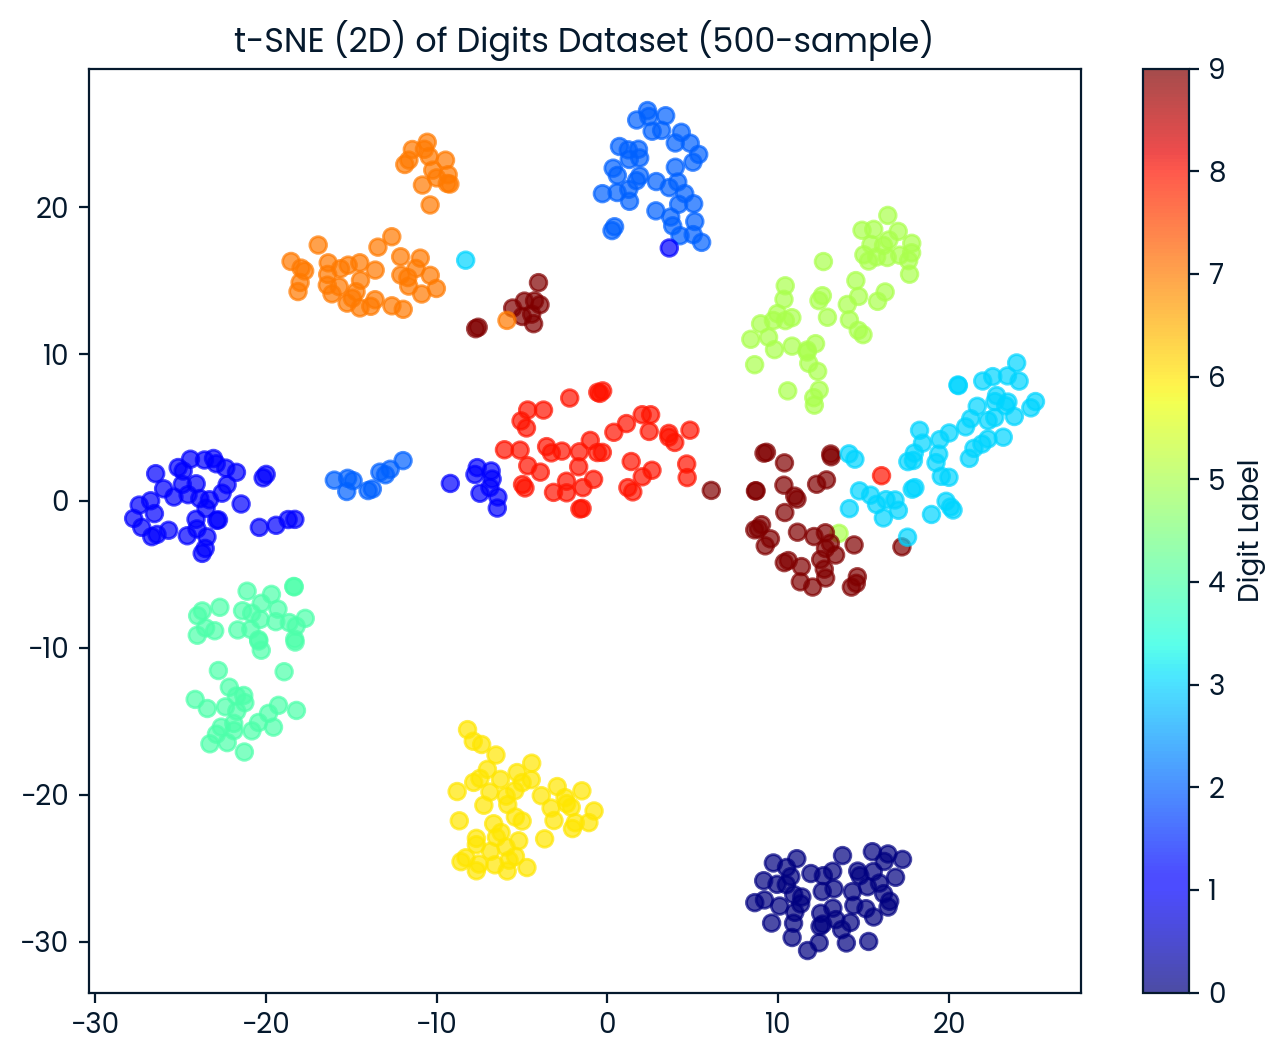
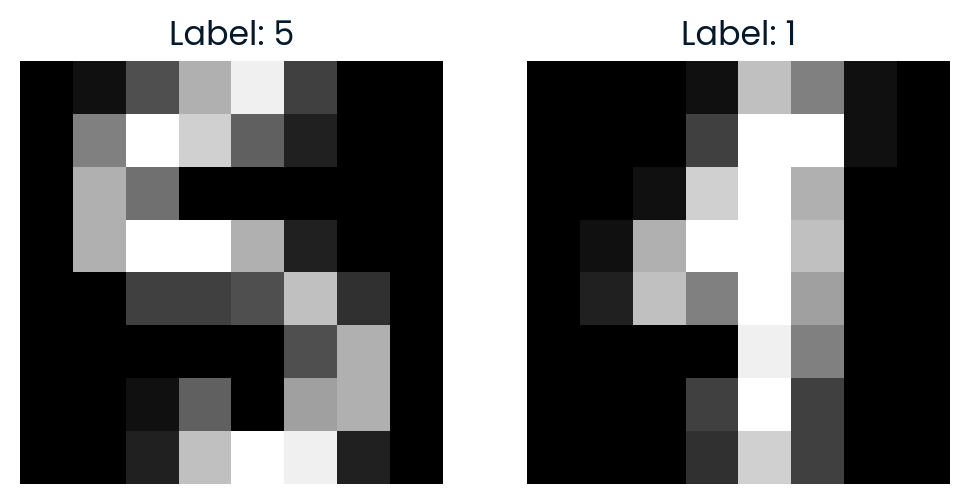
Per esplorare ulteriormente lo spazio t-SNE, selezioniamo casualmente due punti e calcoliamo la distanza euclidea tra loro nello spazio 2D di t-SNE. Visualizzeremo anche le immagini per vedere quanto sono simili.
import random

idx1, idx2 = random.sample(range(X_tsne.shape[0]), 2)

point1, point2 = X_tsne[idx1], X_tsne[idx2]
dist_tsne = np.linalg.norm(point1 - point2)

print(f"Comparing images #{idx1} and #{idx2}")
print(f"Distance in t-SNE space: {dist_tsne:.4f}")
print(f"Label of image #{idx1}: {y_sub[idx1]}")
print(f"Label of image #{idx2}: {y_sub[idx2]}")

# Plot the original images
fig, axes = plt.subplots(1, 2, figsize=(6, 3))
axes[0].imshow(X[idx1].reshape(8, 8), cmap='gray')
axes[0].set_title(f"Label: {y_sub[idx1]}")
axes[0].axis('off')

axes[1].imshow(X[idx2].reshape(8, 8), cmap='gray')
axes[1].set_title(f"Label: {y_sub[idx2]}")
axes[1].axis('off')

plt.show()
La distanza nello spazio t-SNE riflette quanto siano diverse le due immagini nella rappresentazione 2D ridotta.
Comparing images #291 and #90
Distance in t-SNE space: 35.7666
Label of image #291: 5
Label of image #90: 1
Se riscontri difficoltà nell'eseguire il codice qui sopra, consulta lo spazio di lavoro DataLab per ulteriore assistenza.
La riduzione della dimensionalità svolge un ruolo cruciale nelle applicazioni reali, migliorando l'efficienza, l'accuratezza e l'interpretabilità dei modelli di machine learning, oltre a consentire una migliore visualizzazione e analisi di dataset complessi.
In questo tutorial abbiamo esplorato il concetto di riduzione della dimensionalità, il suo scopo, i metodi e i tipi. Infine, abbiamo imparato a usare la tecnica t-SNE per trasformare dati di immagini in uno spazio a dimensionalità inferiore per visualizzazione e analisi.
Segui il corso Dimensionality Reduction in Python per capire il concetto di riduzione della dimensionalità nei tuoi dati e padroneggiare le tecniche per farlo in Python.
I migliori corsi DataCamp
Corso
Programma
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



