
Kursus
Memahami Kecerdasan Buatan
2 jam
427.3K
Munculnya model bahasa besar telah mengubah berbagai industri, membawa kekuatan teknologi seperti GPT-3.5 dan GPT-4 dari OpenAI ke beragam aplikasi. Namun, biaya tinggi dan kekhawatiran kerahasiaan data sering kali menghalangi calon pengguna. Di sinilah model open-source seperti Vicuna-13B berperan, menawarkan kinerja serupa tanpa biaya besar dan risiko terhadap informasi sensitif.
Untuk mempelajari lebih lanjut tentang GPT-3.5 dan GPT-4, tutorial kami Menggunakan GPT-3.5 dan GPT-4 melalui OpenAI API di Python adalah titik awal yang baik untuk memahami cara bekerja dengan paket OpenAI Python untuk bercakap-cakap dengan ChatGPT secara terprogram.
Vicuna-13B adalah model percakapan open-source yang dilatih dari fine-tuning model LLaMa 13B menggunakan percakapan yang dibagikan pengguna dan dikumpulkan dari ShareGPT.
Evaluasi awal dengan GPT-4 sebagai juri menunjukkan Vicuna-13B mencapai lebih dari 90% kualitas chatGPT dan Google Bard, lalu melampaui model lain seperti LLaMa dan Alpaca dalam lebih dari 90% kasus. Alur kerja fine-tuning dan evaluasi secara keseluruhan diilustrasikan di bawah ini:
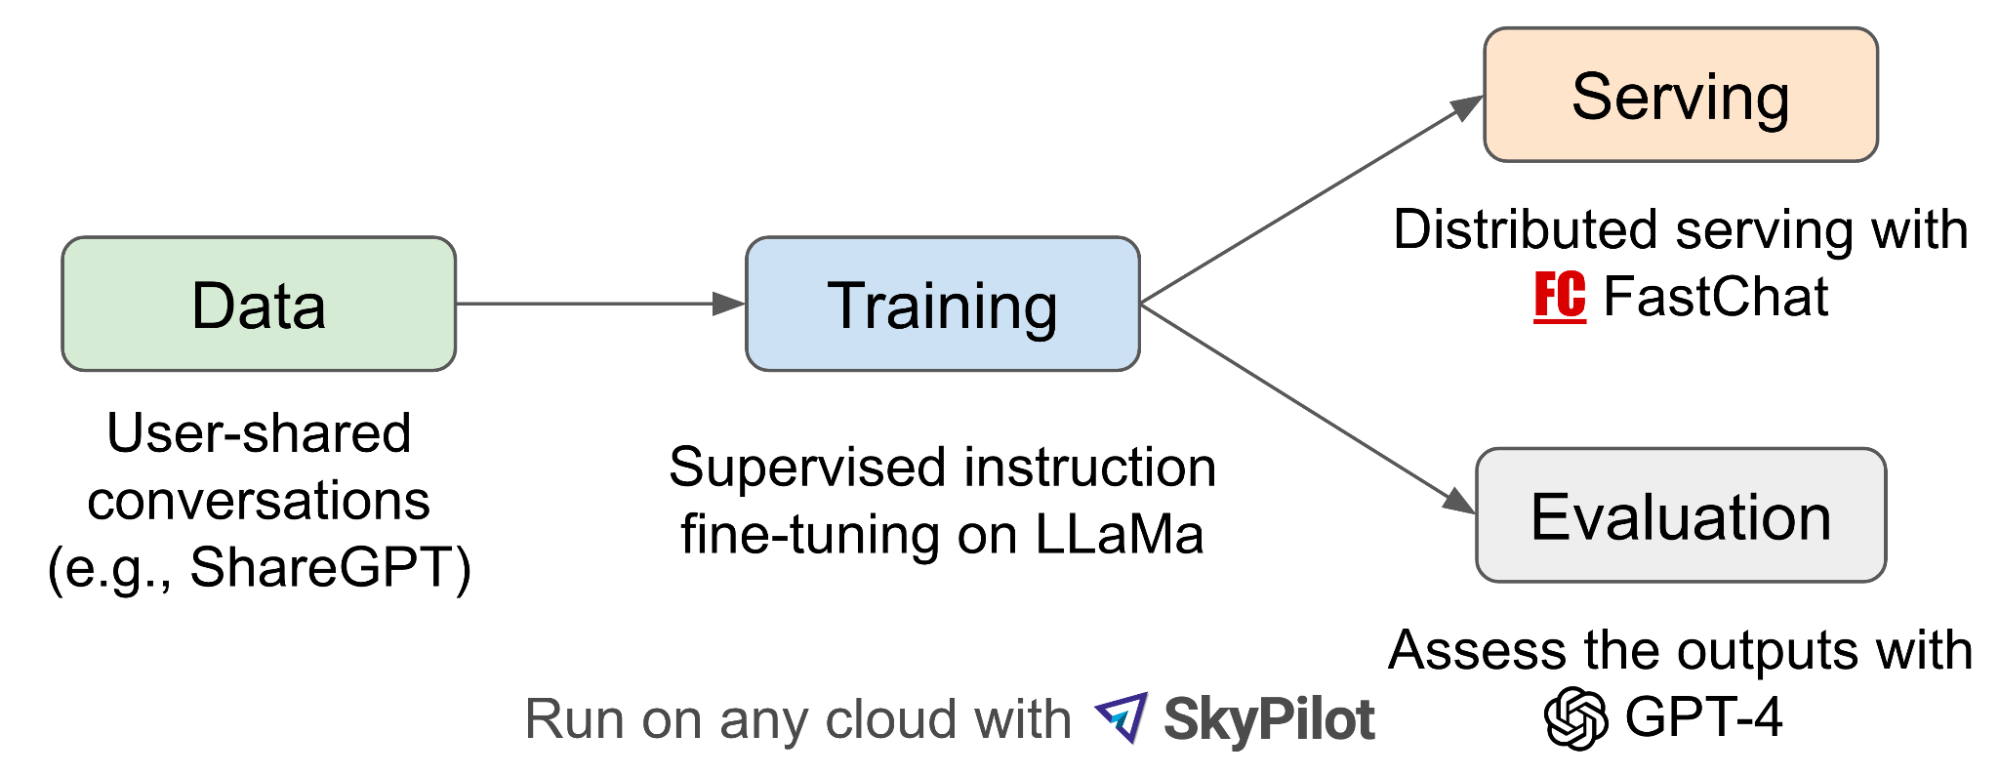
Alur kerja fine-tuning dan evaluasi Vicuna-13B (sumber)
Meskipun ini menyoroti kekuatan Vicuna-13B, model ini memiliki keterbatasannya sendiri dan tidak terbatas pada tugas seperti matematika dan penalaran.
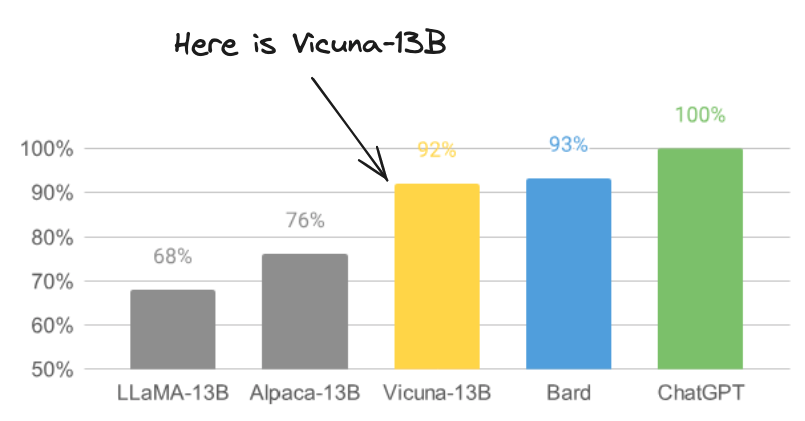
Gambar dari LMSYSORG yang dimodifikasi oleh penulis
Sebagai chatbot cerdas, aplikasi Vicuna-13B sangat banyak, dan beberapa di antaranya digambarkan di bawah ini dalam berbagai industri, seperti layanan pelanggan, kesehatan, pendidikan, keuangan, dan perjalanan/hospitalitas.
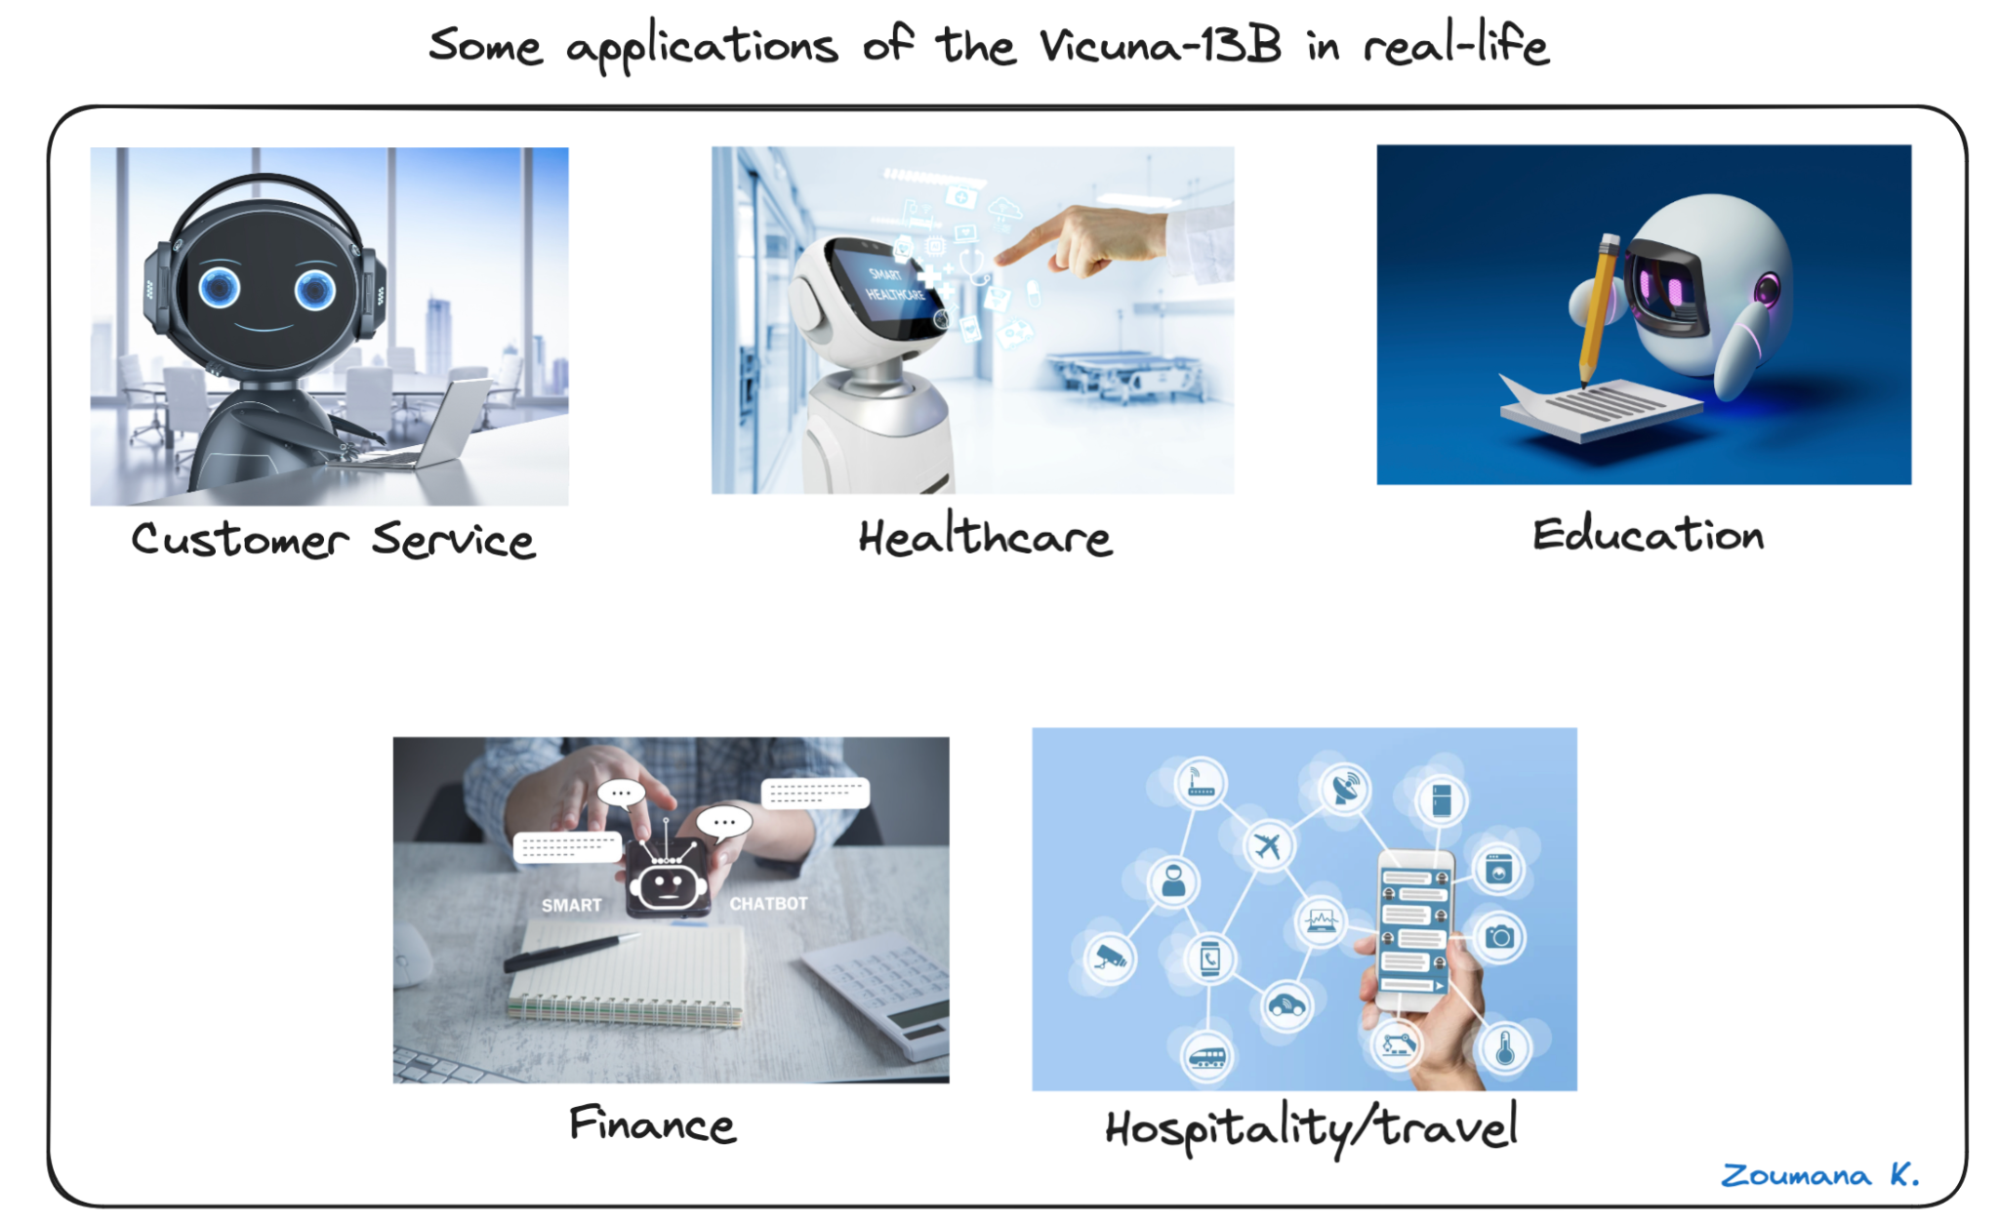
Lima aplikasi berbeda Vicuna-13 dalam kehidupan nyata
Daftar di atas tidak lengkap, dan artikel kami Bagaimana NLP mengubah masa depan Data Science membahas bagaimana NLP mendorong masa depan data science dan machine learning, aplikasi masa depannya, risikonya, dan cara menguranginya.
Berdasarkan aplikasi dunia nyata ini, tidak diragukan lagi ada permintaan besar untuk agen percakapan bertenaga AI seperti Vicuna-13B di berbagai industri utama.
Karena itu, menguasai cara menerapkan dan mengintegrasikan teknologi semacam ini ke dalam alur kerja industri menjadi keterampilan yang semakin penting karena semakin banyak perusahaan menggunakan teknologi ini untuk memperkuat keterlibatan pelanggan, menghasilkan lebih banyak prospek, dan secara keseluruhan meningkatkan laba atas investasi.
Kabar baiknya, tujuan utama tutorial ini adalah membantu Anda mengembangkan keterampilan yang diperlukan untuk menjalankan model Vicuna-13B dan dapat mengintegrasikannya ke dalam alur kerja sistem informasi bisnis apa pun.
Sebelum menyelami proses menjalankan model Vicuna-13B, penting untuk menyiapkan prasyarat dengan benar, yang mencakup:
Setelah persyaratan ini terpenuhi, kita akan memiliki pemahaman yang lebih baik tentang format input dan output serta dapat menjalankan model dengan sukses.
Memahami format input dan output Vicuna-13B dengan lebih baik dapat memberikan pengetahuan minimum bagi pengembang tentang faktor-faktor yang dapat memengaruhi pengambilan keputusan model.
Bagian ini menjelaskan parameter utama yang diperlukan dalam input beserta format output yang diharapkan dari model Vicuna-13B.
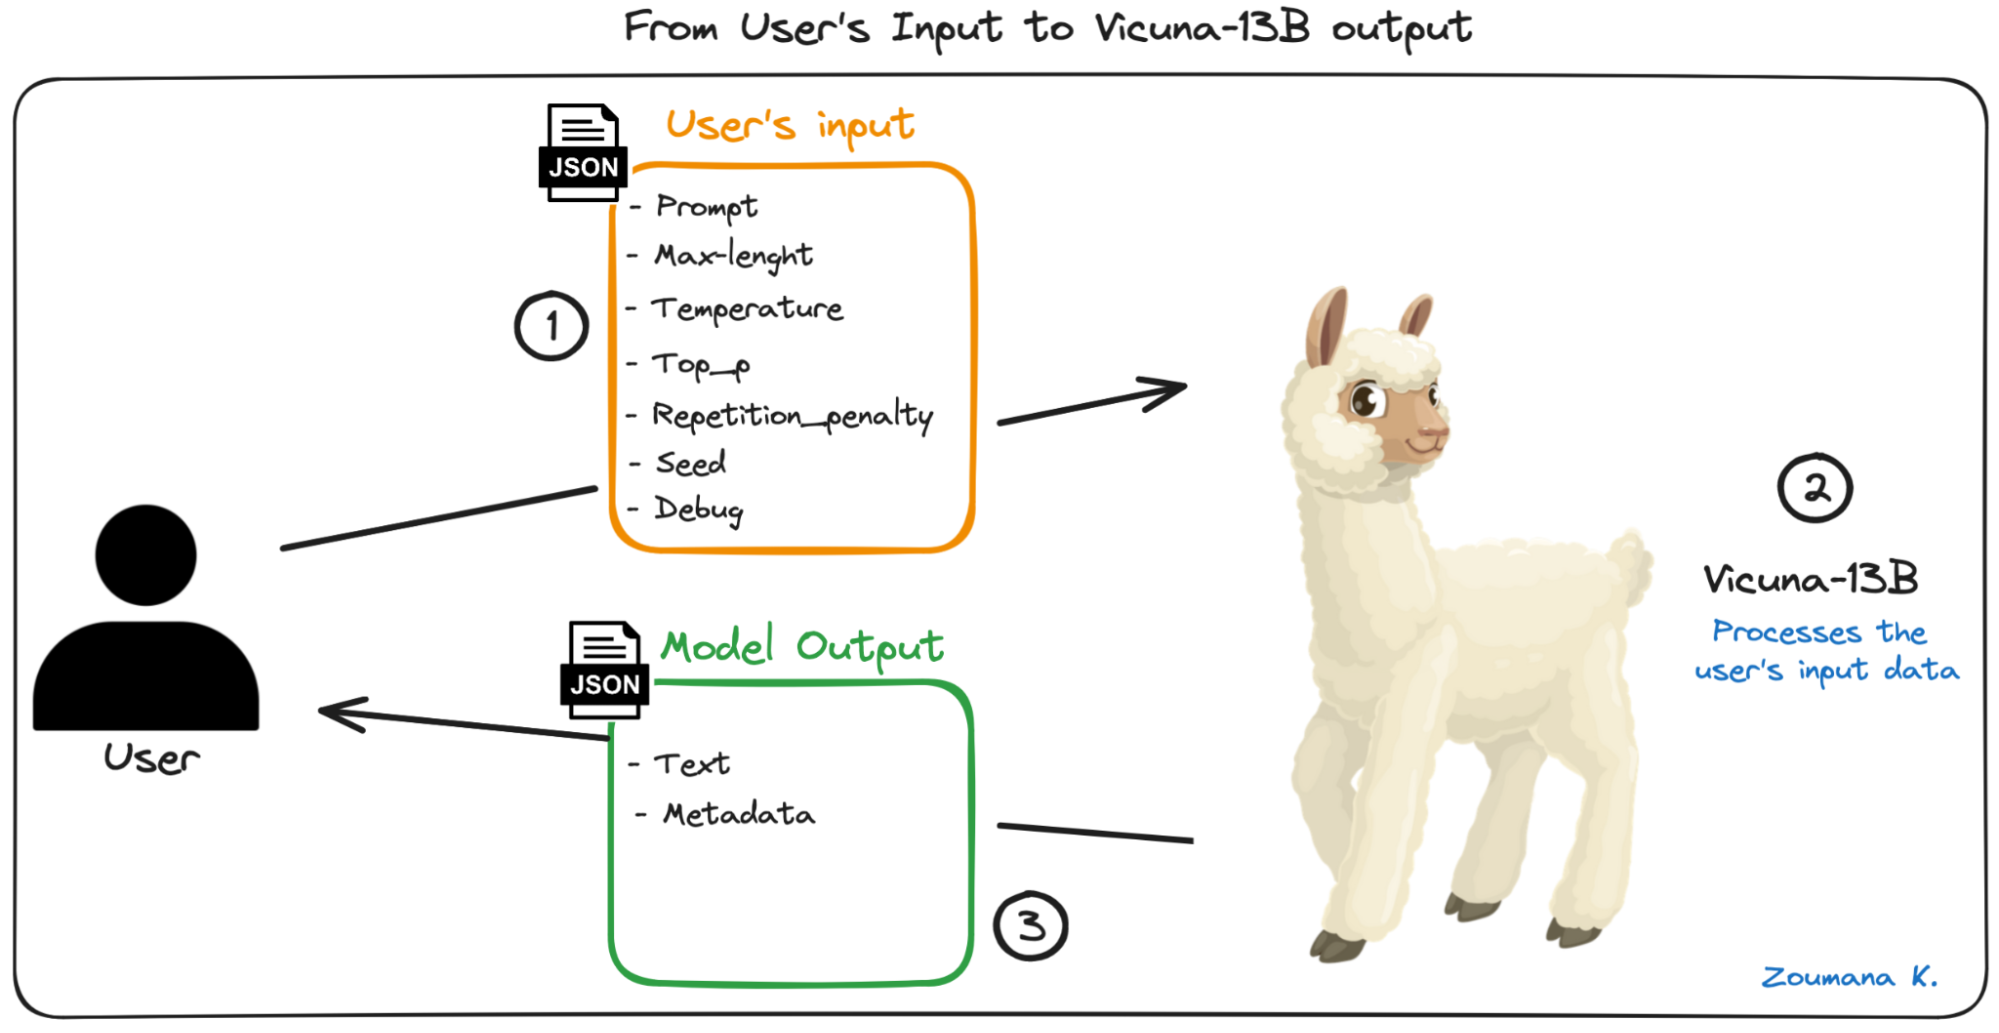
Alur kerja minimalis dari alur kerja end-to-end
Mari pahami alur kerja di atas. Pertama, pengguna mengirimkan input yang diinginkan, yang mencakup prompt, yaitu permintaan tekstual utama yang mungkin ingin pengguna dapatkan jawabannya.
Prompt disertakan bersama parameter tambahan berikut:
Setelah mengirimkan prompt dengan parameter di atas, model Vicuna-13B melakukan pemrosesan yang relevan di balik layar untuk menghasilkan output yang diperlukan, yang sesuai dengan skema berikut:
Sekarang setelah kita lebih memahami input dan output, kita dapat melanjutkan dengan mengidentifikasi pustaka utama untuk berhasil menjalankan model vicuna.
Semua perintah di bagian ini dijalankan dari terminal. Menggunakan pernyataan conda create, kita membuat lingkungan virtual bernama vicuna-env.
conda create --name vicuna-envSetelah berhasil membuat lingkungan virtual, kita mengaktifkan lingkungan virtual di atas menggunakan pernyataan conda activate, sebagai berikut dari :
conda activate vicuna-envPernyataan di atas akan menampilkan nama variabel lingkungan dalam tanda kurung di awal terminal sebagai berikut:
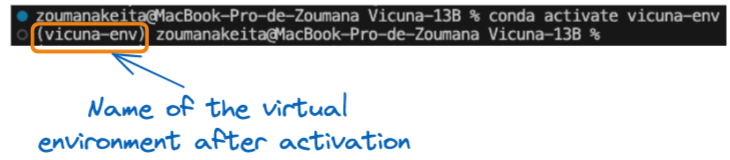
Nama lingkungan virtual setelah aktivasi
Pustaka di atas dapat diinstal dengan dua cara. Pertama, dengan menjalankan pip install secara manual untuk setiap pustaka, dan ini bisa memakan waktu saat menangani jumlah pustaka yang signifikan serta tidak optimal ketika bekerja di tingkat industri.
Cara kedua adalah opsi terbaik dan menggunakan file requirements.txt yang berisi masing-masing pustaka yang diperlukan. Di bawah ini adalah isi file requirements.txt, bersama dengan instalasinya menggunakan satu perintah pip install.
# Content of the requirements.txt file

llama-cpp-python==0.1.48
fastapi
uvicorn[standard]
Ketiga pustaka dapat diinstal sebagai berikut:
pip install -r requirements.txtDari platform Hugging Face, kita dapat mengunduh bobot model Vicuna seperti yang ditunjukkan di bawah ini:
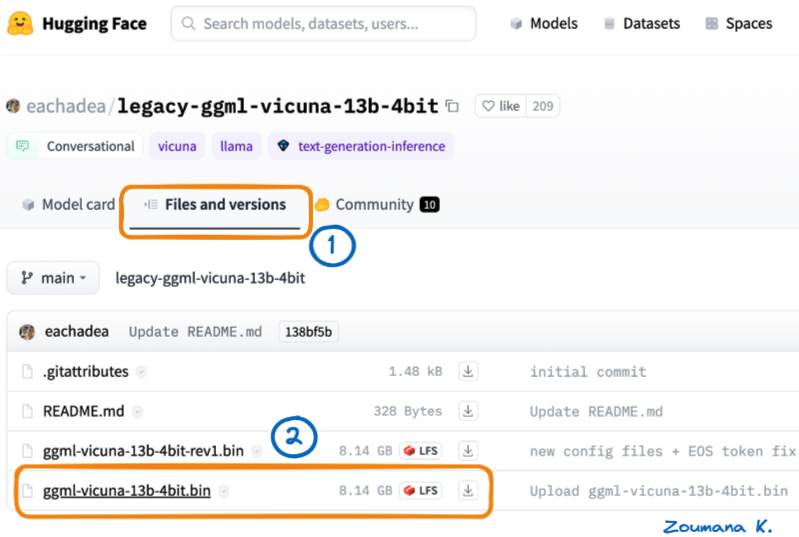
Dua langkah utama untuk mengunduh bobot Vicuna-13B dari Hugging Face
Untuk organisasi kode yang lebih baik, kita dapat memindahkan bobot model yang diunduh ke folder model baru.
Meskipun semua prasyarat telah dipenuhi untuk menjalankan model melalui command line, menerapkan API yang terhubung dengan model adalah pendekatan yang lebih praktis. Ini akan membuat model lebih mudah diakses oleh lebih banyak pengguna.
Untuk mencapainya, kita memerlukan langkah-langkah berikut:
Struktur keseluruhan kode sumber diberikan di bawah ini, dan kode lengkap tersedia di GitHub.
------ model
         |------- ggml-vicuna-13b-4bit.bin

------ requirements.txt
------ vicuna_app.py
ggml-vicuna-13b-4bit.bin adalah bobot model yang diunduh di folder modelrequirements.txt berisi dependensi untuk menjalankan modelvicuna_app.py berisi kode Python untuk membuat API, yang menjadi fokus utama bagian ini.Dalam kasus kita, diperlukan dua rute utama berikut. Sebelumnya, kita perlu mengimpor pustaka yang relevan, memuat model, dan membuat instance modul FastAPI.
# Import the libraries
from fastapi import FastAPI, HTTPException
from llama_cpp import Llama

# Load the model
vicuna_model_path = "./model/ggml-vicuna-13b-4bit.bin"
vicuna_model = Llama(model_path=vicuna_model_path)

app = FastAPI()"/” mengembalikan format JSON berikut “Message”: “Welcome to the Vicuna Demo FastAPI” melalui fungsi home() yang tidak menerima parameter.# Define the default route
@app.get("/")
def home():
return {"Message": "Welcome to the Vicuna Demo FastAPI"}/vicuna_says” bertanggung jawab memicu fungsi answer_prompt(), yang menerima prompt pengguna sebagai parameter, dan mengembalikan respons JSON yang berisi hasil model Vicuna dan beberapa metadata tambahan.@app.post("/vicuna_says")
def answer_prompt(user_prompt):
if (not (user_prompt)):
raise HTTPException(status_code=400,
detail="Please Provide a valid text message")
response = vicuna_model(user_prompt)
return {"Answer": response}Kita akhirnya dapat menjalankan API dengan instruksi berikut dari command line, dari lokasi file vicuna_app.py.
uvicorn vicuna_app:app --reloaduvicorn memulai server unicorn.vicuna_app: mengacu pada python vicuna_app.py. Ini adalah yang di sebelah kiri tanda “:”.app: mengacu pada objek yang dibuat di dalam file vicuna_app.py dengan instruksi app = FastAPI(). Jika nama filenya main.py instruksinya akan uvicorn main:app --reload--reload: opsi yang digunakan untuk memulai ulang server setelah ada perubahan kode. Perlu diingat bahwa ini hanya digunakan saat tahap pengembangan, bukan saat tahap deployment.Berikut hasil yang kita dapatkan dari menjalankan perintah sebelumnya, dan kita dapat melihat bahwa server berjalan di localhost pada port 8000 (http://127.0.0.1:8000)
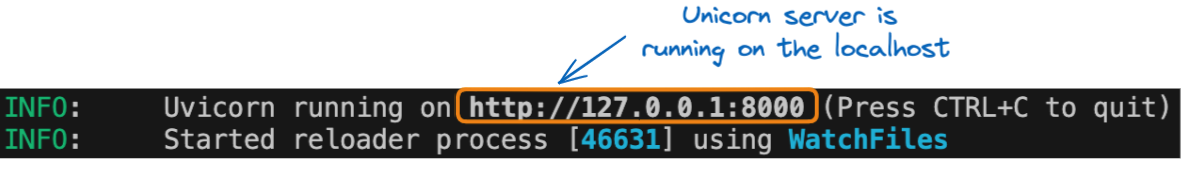
Url API yang berjalan di localhost
Mengakses rute default sangat mudah. Cukup ketik URL berikut pada browser apa pun.
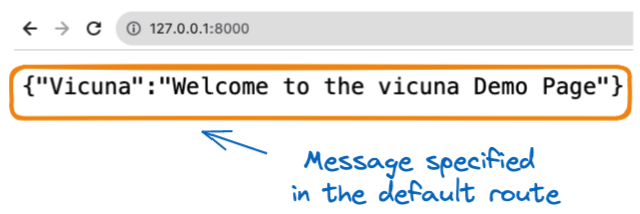
Respons dari rute default
Ini bagian yang menarik. URL http://127.0.0.1:8000/docs menyediakan dashboard lengkap untuk berinteraksi dengan API, dan hasilnya ditunjukkan di bawah.
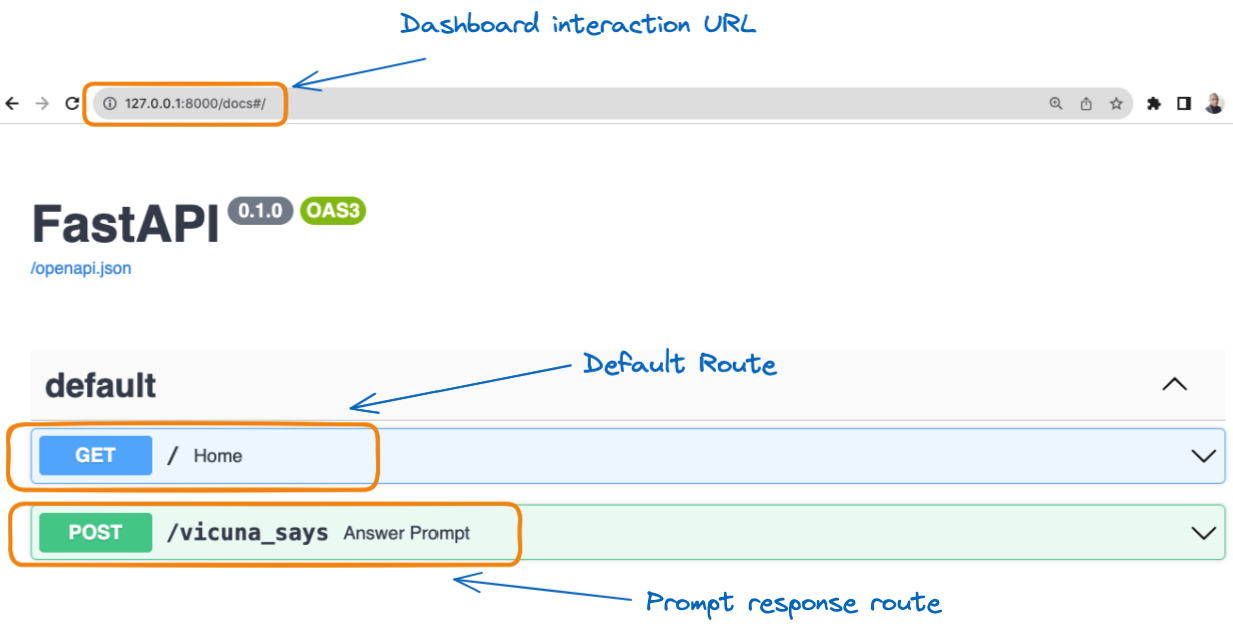
Visualisasi grafis dari dua rute
Dari Gambar sebelumnya, saat kita memilih /vicuna_says pada kotak hijau, kita mendapatkan panduan lengkap untuk berinteraksi dengan API kita, seperti ditunjukkan di bawah.
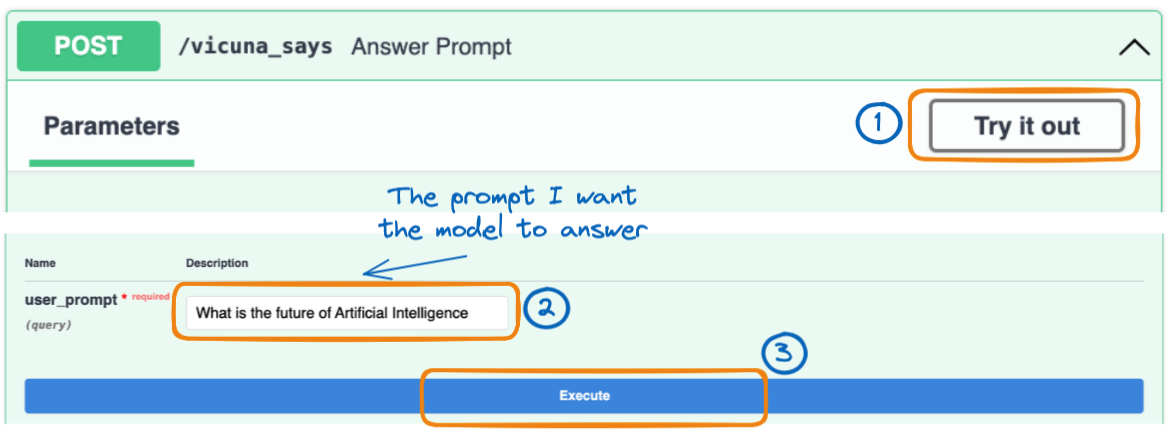
Tiga langkah utama untuk mengeksekusi prompt pengguna
Cukup pilih tab Try it out dan berikan pesan yang ingin Anda prediksi di area text_message.
Kita akhirnya mendapatkan hasil berikut setelah memilih tombol Execute.
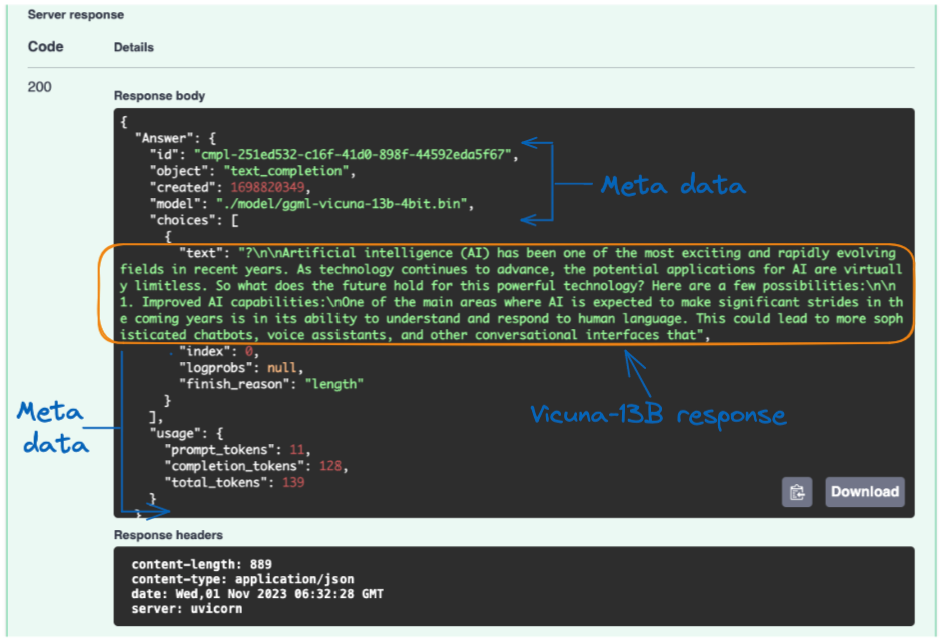
Respons server dari model Vicuna terhadap pertanyaan pengguna
Respons model Vicuna disajikan pada kolom “text”, dan hasilnya terlihat cukup mengesankan.
Metadata tambahan disertakan, seperti model yang digunakan, tanggal pembuatan respons, jumlah token dalam prompt, dan jumlah token dalam respons, untuk menyebut beberapa.
Menerapkan model sekuat ini meningkatkan pengalaman pengguna dan efisiensi operasional dalam beberapa cara yang patut dicatat, dan tidak terbatas pada yang di bawah ini:
Secara keseluruhan, deployment memfasilitasi penggunaan model vicuna-13B yang lebih mudah diakses, andal, dan serbaguna, memperluas penerapannya bagi berbagai pengguna dan aplikasi.
Saat bekerja dengan model Vicuna-13B, beberapa praktik terbaik dan tips dapat membantu pengembang mengoptimalkan pengalaman, hasil, dan mengatasi masalah umum.
Dengan mengikuti praktik terbaik dan tips ini, mereka dapat memastikan pengalaman yang lebih mulus dan hasil yang lebih baik saat bekerja dengan model Vicuna-13B.
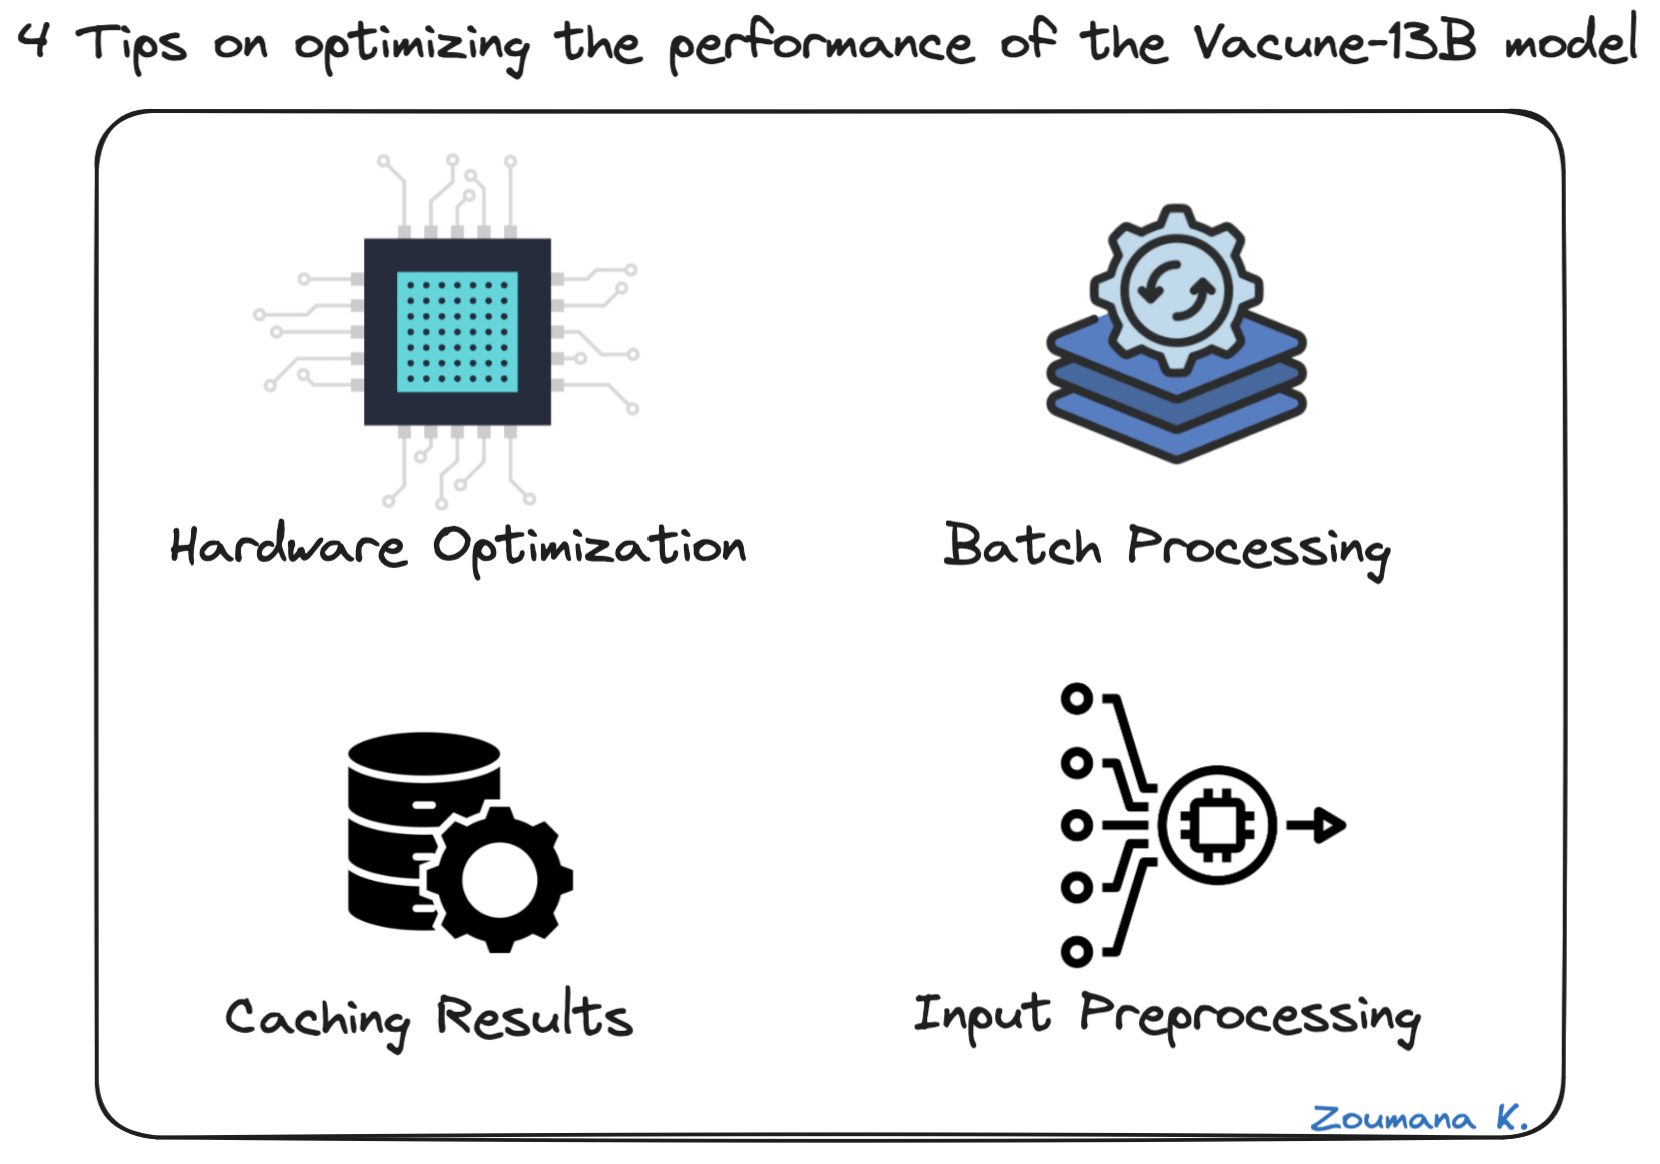
4 tips untuk mengoptimalkan kinerja model Vicuna-13B
Beralih dari optimasi kinerja, penting juga untuk mahir memecahkan masalah umum yang mungkin muncul selama penggunaan Vicuna-13B, dan di bawah ini empat contohnya:
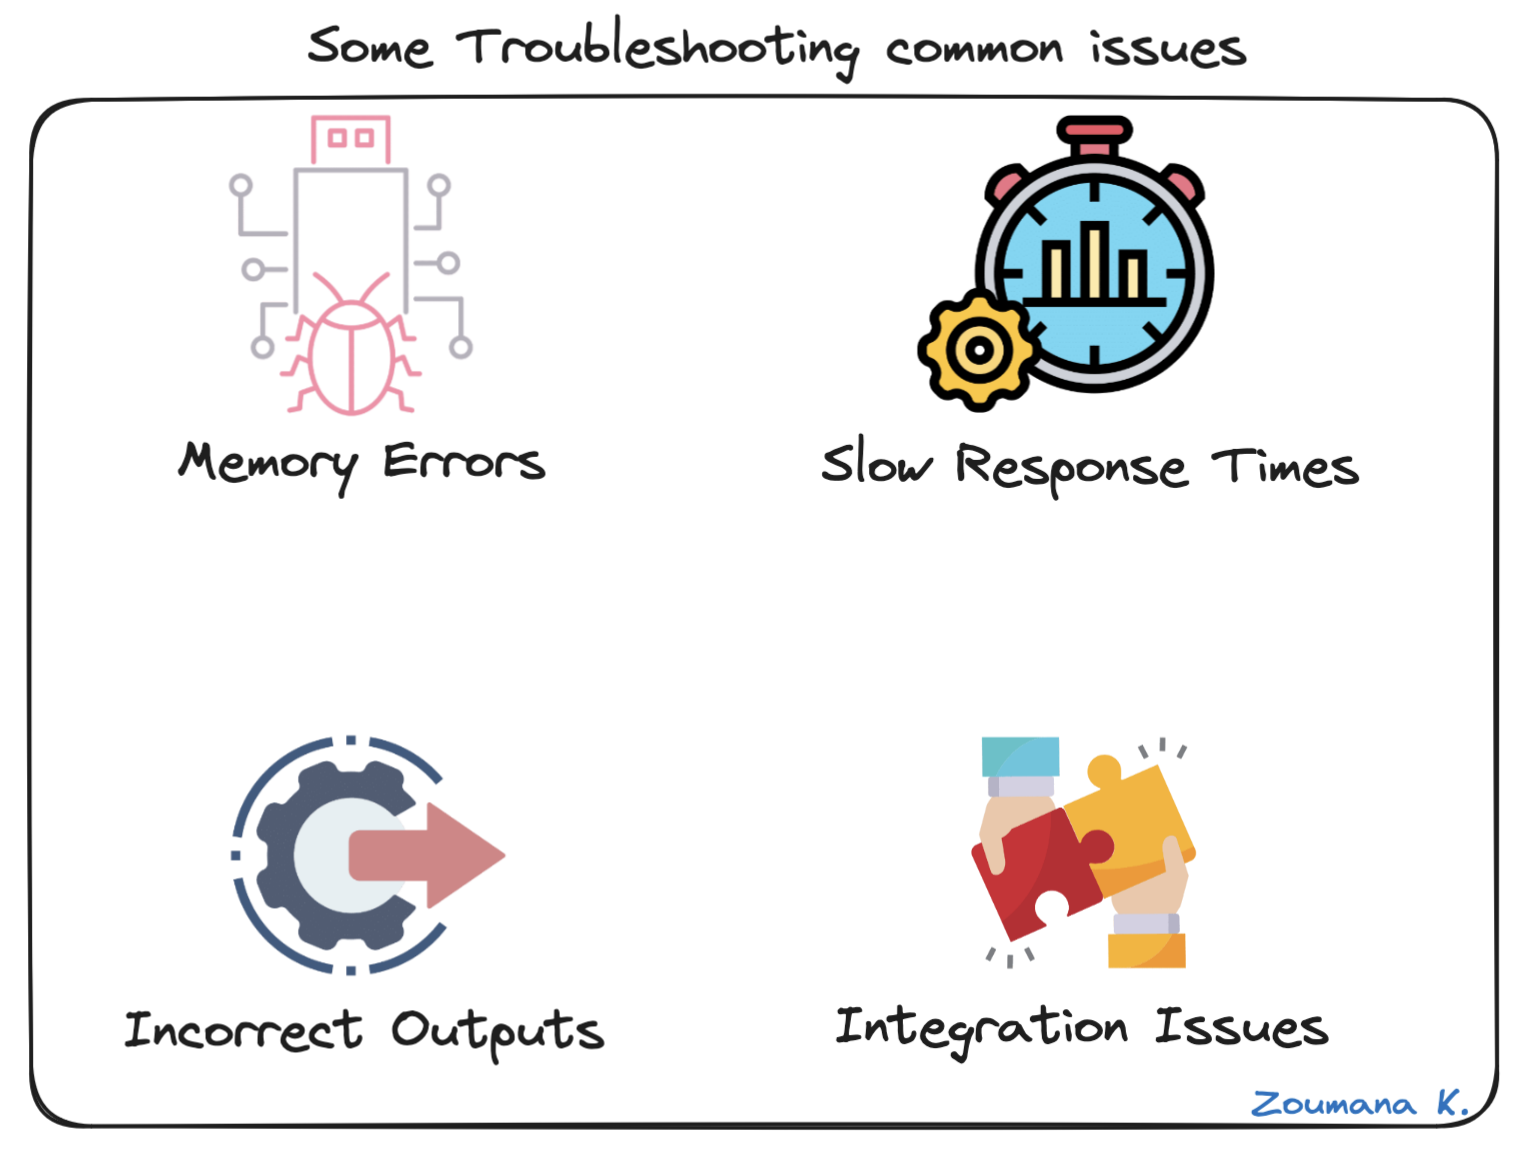
Beberapa masalah pemecahan masalah umum
Singkatnya, artikel ini telah memberikan gambaran komprehensif tentang menyiapkan dan memanfaatkan model Vicuna-13B. Kami membahas prasyarat yang diperlukan, termasuk perangkat keras, perangkat lunak, dan mendapatkan bobot LLaMa yang penting untuk menjalankan model dengan sukses.
Instruksi terperinci diberikan untuk menyiapkan lingkungan kerja, memasang perangkat lunak yang diperlukan, dan menyiapkan bobot Vicuna-13B, menekankan pentingnya bobot dalam model bahasa.
Selain itu, kami membahas pengemasan dan deployment Vicuna-13B, menyoroti bagaimana deployment memfasilitasi penggunaannya sebagai antarmuka web dan API.
Terakhir, wawasan praktis tentang berinteraksi dengan Vicuna-13B, contoh kemampuannya, dan praktik terbaik untuk mengoptimalkan kinerjanya serta memecahkan masalah umum juga dibagikan.
Siap menyelami lebih dalam dunia AI dan machine learning? Tingkatkan keterampilan Anda dengan kerangka deep learning andal yang digunakan para profesional AI. Ikuti kursus Deep Learning dengan PyTorch hari ini.
Mulai Perjalanan AI Anda Hari Ini!
Kursus
Program
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




