
कोर्स
Understanding Artificial Intelligence
2 घंटा
426.1K
बड़े भाषा मॉडलों का उभरना विभिन्न उद्योगों के लिए रूपांतरकारी रहा है, जिससे OpenAI के GPT-3.5 और GPT-4 जैसी तकनीकों की शक्ति अनेक अनुप्रयोगों तक पहुँची है। हालांकि, उच्च लागत और डेटा गोपनीयता संबंधी चिंताएँ अक्सर संभावित अपनाने वालों को हतोत्साहित करती हैं। यहीं पर Vicuna-13B जैसे ओपन-सोर्स मॉडल काम आते हैं, जो मिलते-जुलते प्रदर्शन के साथ संवेदनशील सूचनाओं के जोखिम और भारी खर्च से बचाते हैं।
GPT-3.5 और GPT-4 के बारे में अधिक जानने के लिए, हमारा ट्यूटोरियल Using GPT-3.5 and GPT-4 via the OpenAI API in Python एक अच्छा शुरुआती बिंदु है, जिससे आप समझ सकेंगे कि OpenAI Python पैकेज के साथ प्रोग्रामेटिक रूप से ChatGPT से बातचीत कैसे करें।
Vicuna-13B एक ओपन-सोर्स संवादात्मक मॉडल है, जिसे ShareGPT से एकत्रित उपयोगकर्ता-साझा वार्तालापों का उपयोग करते हुए LLaMa 13B मॉडल को फाइन-ट्यून करके प्रशिक्षित किया गया है।
GPT-4 को जज के रूप में इस्तेमाल करते हुए की गई प्रारंभिक मूल्यांकन में दिखाया गया कि Vicuna-13B ने ChatGPT और Google Bard की गुणवत्ता का 90% से अधिक प्राप्त किया, और फिर 90% से अधिक मामलों में LLaMa और Alpaca जैसे अन्य मॉडलों से बेहतर प्रदर्शन किया। संपूर्ण फाइन-ट्यूनिंग और मूल्यांकन वर्कफ़्लो नीचे दर्शाया गया है:
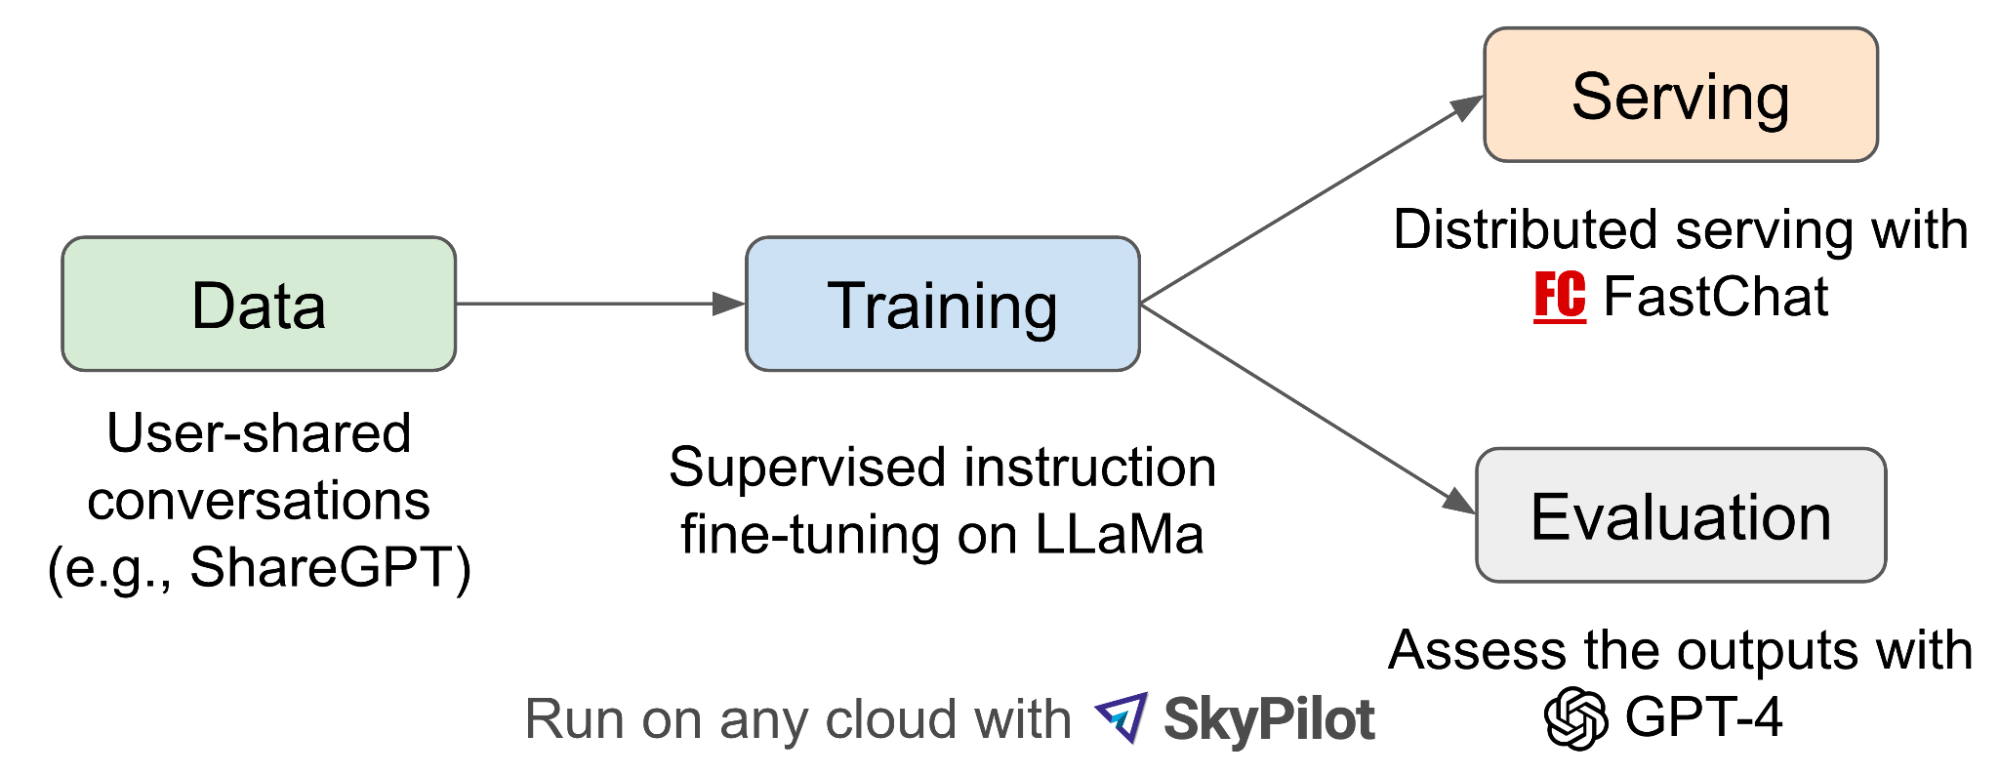
Vicuna-13B फाइन-ट्यूनिंग और मूल्यांकन वर्कफ़्लो (स्रोत)
यह Vicuna-13B की शक्ति को उजागर करता है, लेकिन इसकी अपनी सीमाएँ भी हैं और यह गणित तथा तर्क जैसे कार्यों तक सीमित नहीं है।
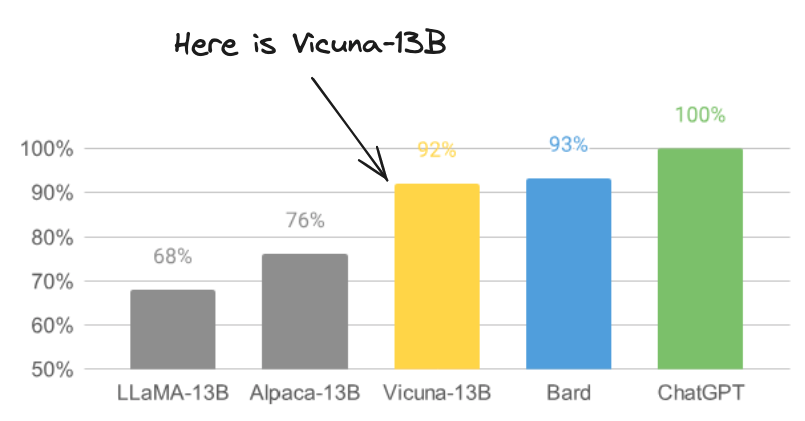
LMSYSORG से छवि, लेखक द्वारा संशोधित
एक बुद्धिमान चैटबॉट के रूप में, Vicuna-13B के अनुप्रयोग अनगिनत हैं, और नीचे विभिन्न उद्योगों—जैसे ग्राहक सेवा, स्वास्थ्य सेवा, शिक्षा, वित्त, और यात्रा/आतिथ्य—में इनके कुछ उदाहरण दर्शाए गए हैं।
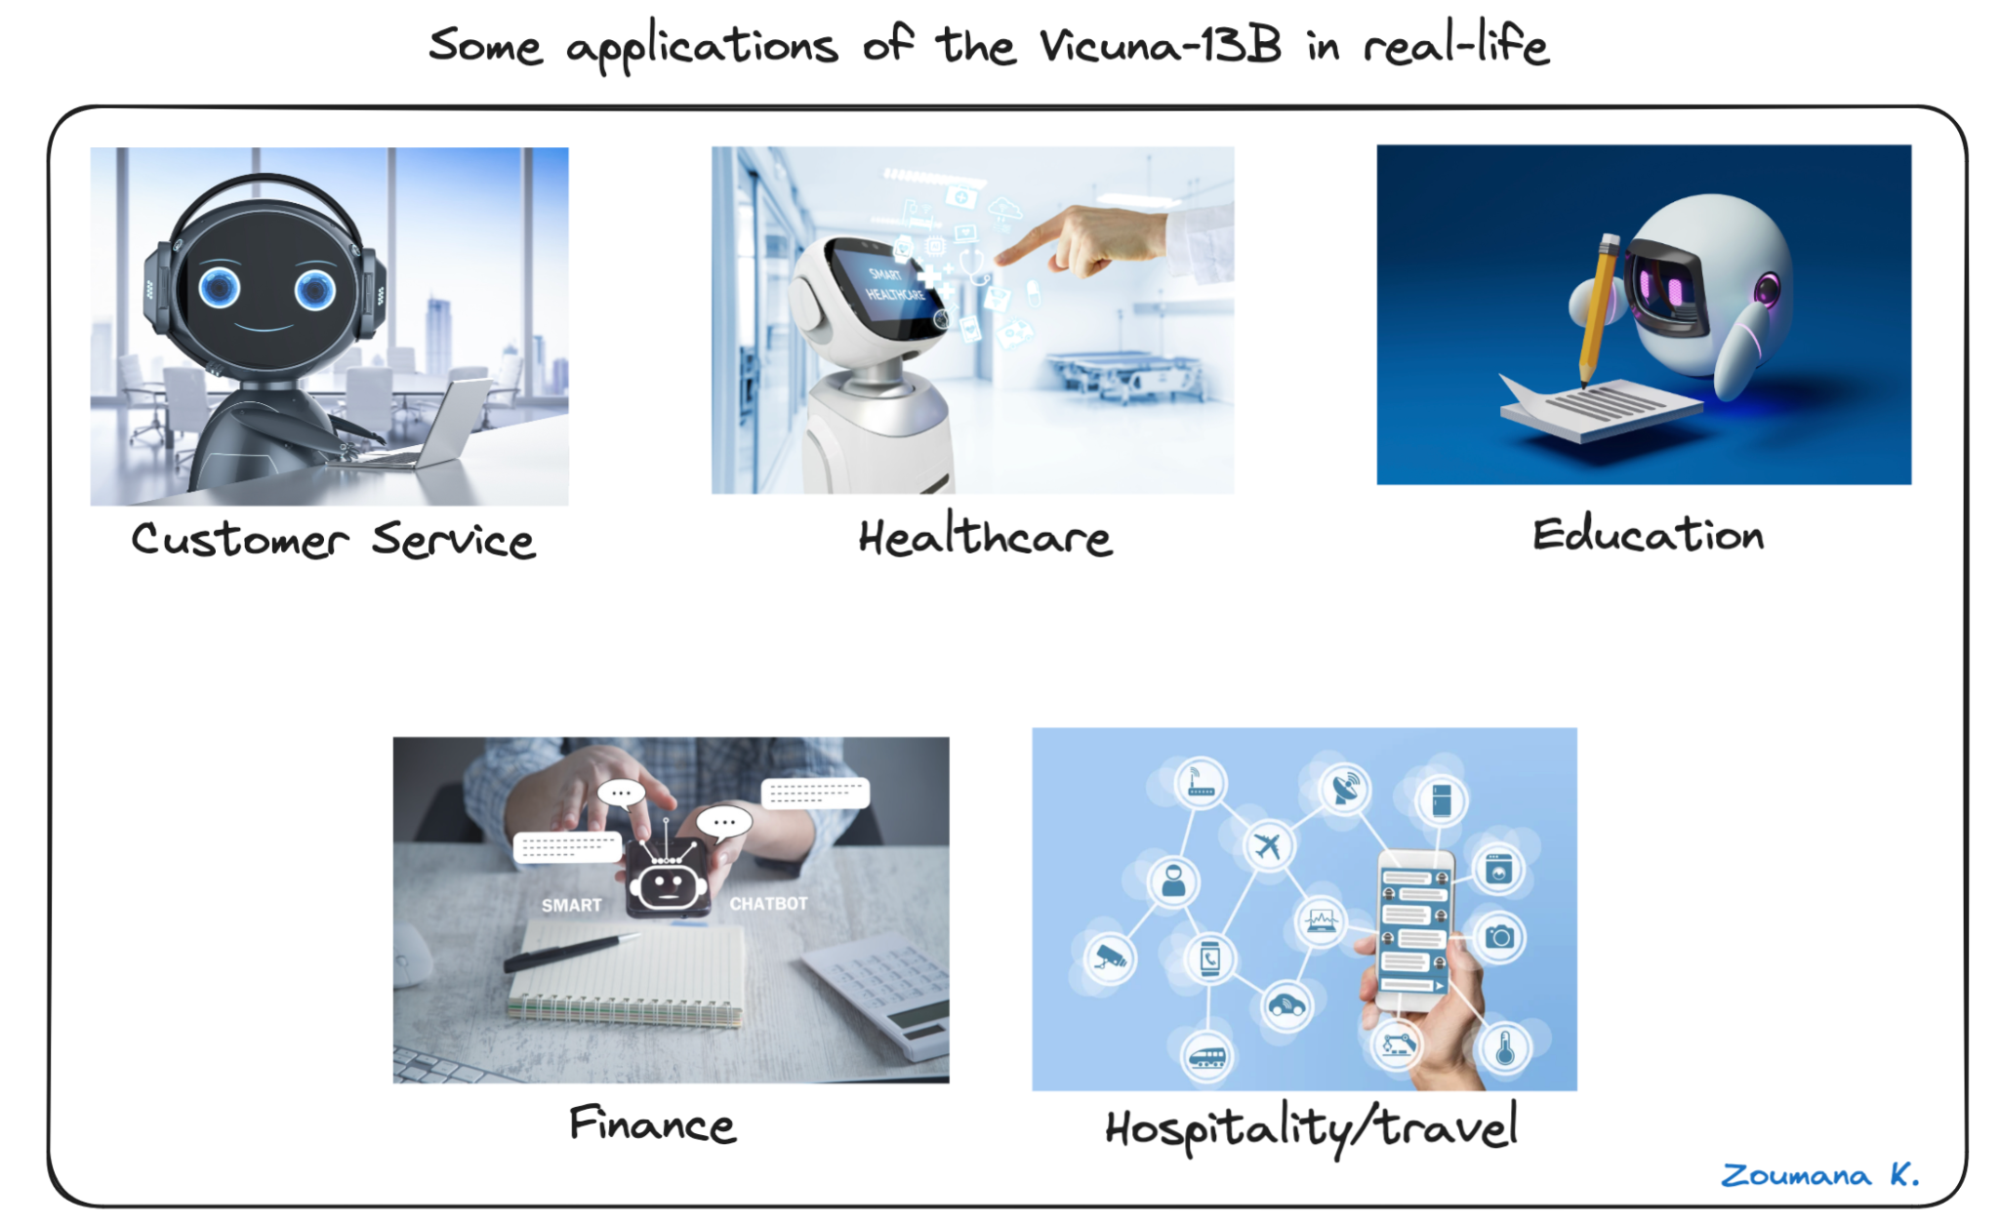
वास्तविक जीवन में Vicuna-13 के पाँच विभिन्न उपयोग
ऊपर दी गई सूची संपूर्ण नहीं है, और हमारा लेख How NLP is changing the future of Data Science यह बताता है कि NLP डेटा साइंस और मशीन लर्निंग के भविष्य को कैसे आगे बढ़ा रहा है, इसके भविष्य के उपयोग, जोखिम, और उन्हें कैसे कम किया जाए।
इन वास्तविक जीवन के उपयोगों के आधार पर, इसमें कोई संदेह नहीं कि प्रमुख उद्योगों में Vicuna-13B जैसे AI-संचालित संवाद एजेंटों की अत्यधिक माँग है।
इसलिए, ऐसी तकनीक को लागू करने और उद्योग के वर्कफ़्लो में एकीकृत करने का कौशल सीखना लगातार अधिक महत्वपूर्ण होता जा रहा है, क्योंकि अधिक कंपनियाँ ग्राहक संलग्नता बढ़ाने, अधिक लीड उत्पन्न करने और समग्र रूप से निवेश पर रिटर्न बढ़ाने के लिए इन तकनीकों का उपयोग कर रही हैं।
अच्छी खबर यह है कि इस ट्यूटोरियल का मुख्य उद्देश्य आपको Vicuna-13B मॉडल चलाने और उसे किसी भी व्यावसायिक सूचना प्रणाली के वर्कफ़्लो में एकीकृत करने के लिए आवश्यक कौशल विकसित करने में मदद करना है।
Vicuna-13B मॉडल के रनिंग प्रोसेस में उतरने से पहले, आवश्यक पूर्वापेक्षाएँ सही तरीके से सेट करना महत्वपूर्ण है, जिनमें शामिल हैं:
एक बार ये आवश्यकताएँ पूरी हो जाने पर, हमें इनपुट और आउटपुट फ़ॉर्मेट की बेहतर समझ होगी और हम मॉडल को सफलतापूर्वक चला पाएँगे।
Vicuna-13B के इनपुट और आउटपुट फ़ॉर्मेट की अच्छी समझ डेवलपर को उन कारकों के बारे में न्यूनतम जानकारी दे सकती है जो मॉडल के निर्णय-निर्माण को प्रभावित कर सकते हैं।
यह अनुभाग इनपुट में आवश्यक मुख्य पैरामीटरों के साथ-साथ Vicuna-13B मॉडल के अपेक्षित आउटपुट फ़ॉर्मेट को समझाता है।
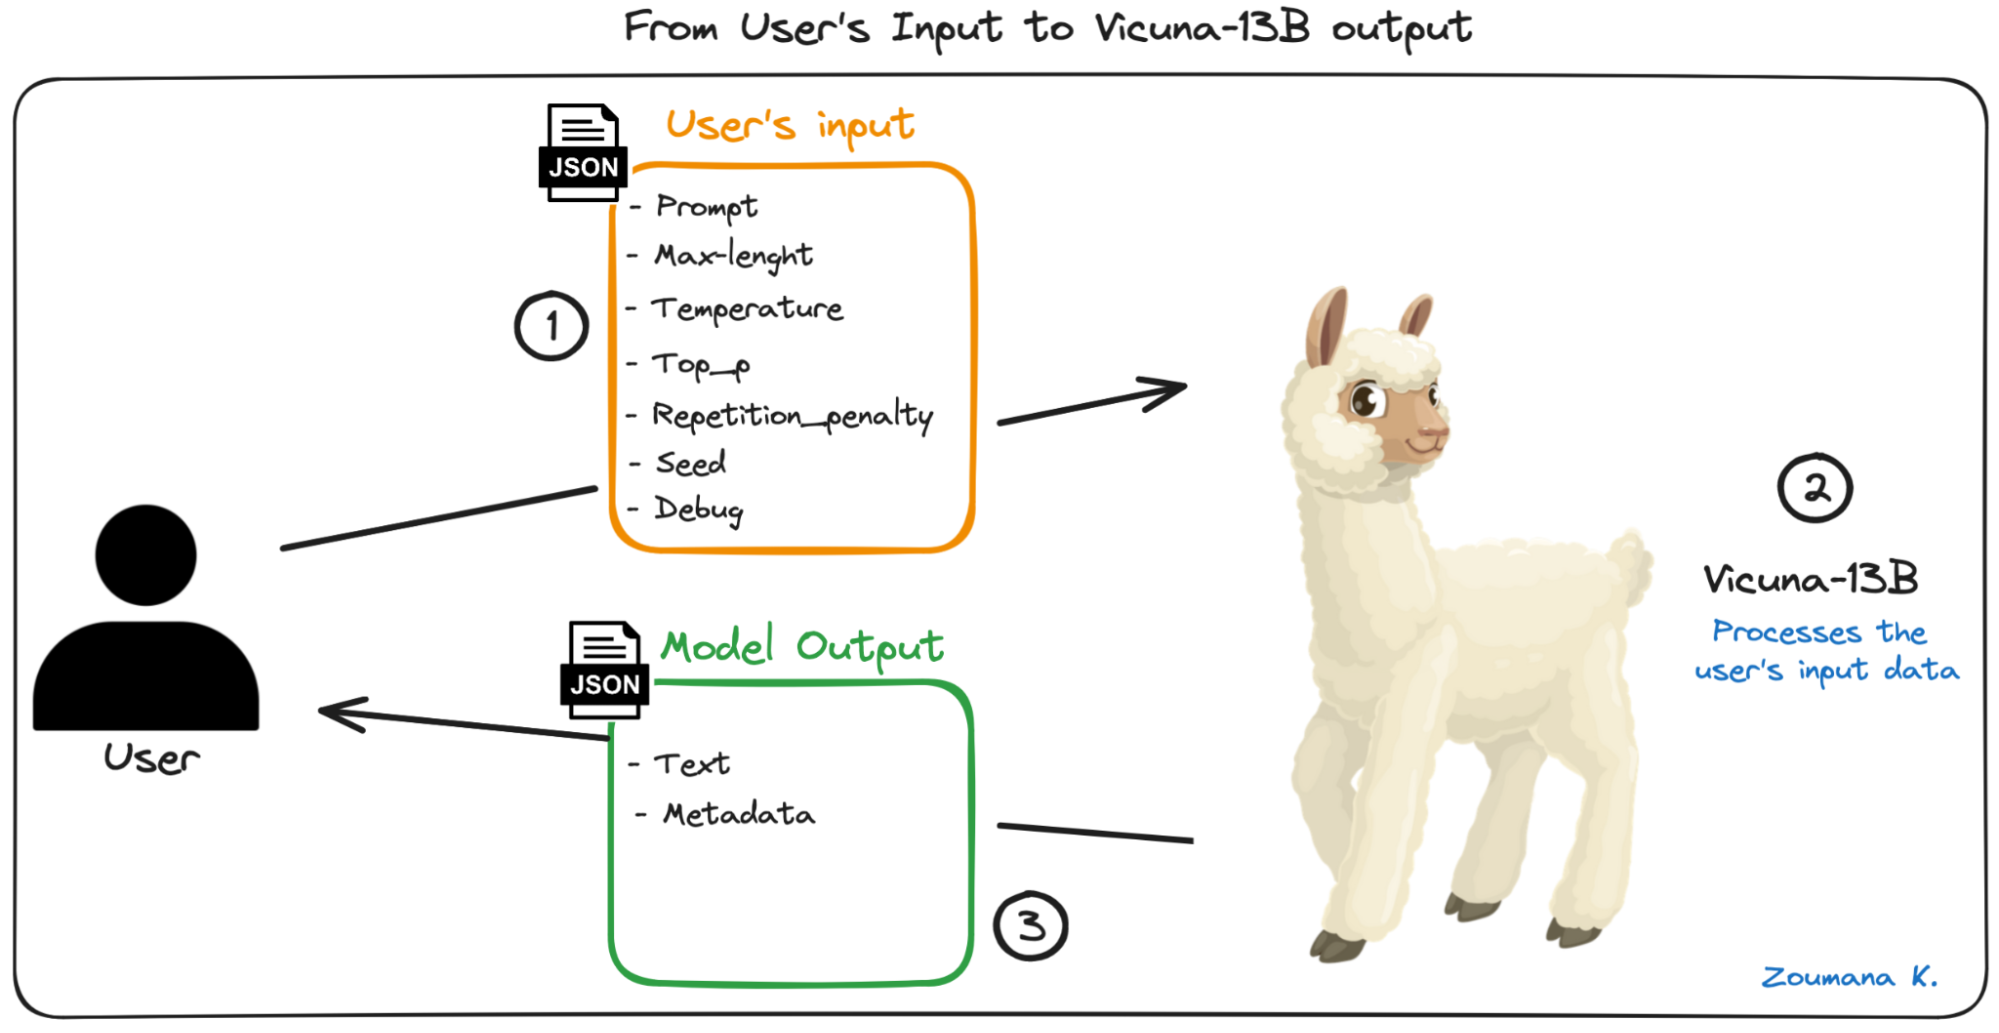
एंड-टू-एंड वर्कफ़्लो का मिनिमलिस्ट वर्कफ़्लो
आइए ऊपर दिए वर्कफ़्लो को समझें। सबसे पहले, उपयोगकर्ता इच्छित इनपुट जमा करता है, जिसमें प्रॉम्प्ट शामिल होता है—यानी वह मुख्य पाठ्य अनुरोध, जिसका उत्तर उपयोगकर्ता चाहता है।
प्रॉम्प्ट के साथ निम्न अतिरिक्त पैरामीटर दिए जाते हैं:
उपरोक्त पैरामीटरों के साथ प्रॉम्प्ट जमा करने के बाद, Vicuna-13B मॉडल पर्दे के पीछे आवश्यक प्रोसेसिंग करके अपेक्षित आउटपुट उत्पन्न करता है, जो निम्न स्कीमा के अनुरूप होता है:
अब जब हमें इनपुट और आउटपुट की बेहतर समझ है, तो हम Vicuna मॉडल को सफलतापूर्वक चलाने के लिए आवश्यक मुख्य लाइब्रेरियों की पहचान कर सकते हैं।
इस अनुभाग के सभी कमांड टर्मिनल से चलाए जाते हैं। conda create स्टेटमेंट का उपयोग करके, हम vicuna-env नामक एक वर्चुअल वातावरण बनाते हैं।
conda create --name vicuna-envवर्चुअल वातावरण सफलतापूर्वक बनाने के बाद, हम नीचे दिए अनुसार conda activate स्टेटमेंट का उपयोग करके उक्त वर्चुअल वातावरण को सक्रिय करते हैं:
conda activate vicuna-envउपरोक्त स्टेटमेंट टर्मिनल की शुरुआत में ब्रैकेट के बीच वातावरण के नाम को इस प्रकार दिखाएगा:
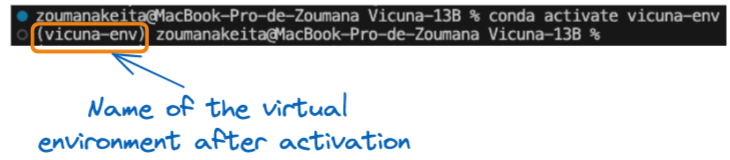
सक्रियण के बाद वर्चुअल वातावरण का नाम
उपरोक्त लाइब्रेरियाँ दो तरीकों से स्थापित की जा सकती हैं। पहला तरीका है प्रत्येक लाइब्रेरी के लिए अलग-अलग pip install चलाना—यह तब समयसाध्य हो सकता है जब लाइब्रेरियों की संख्या अधिक हो, और औद्योगिक स्तर पर यह सर्वोत्तम नहीं है।
दूसरा तरीका सर्वोत्तम है—इसमें requirements.txt फ़ाइल का उपयोग होता है, जिसमें सभी आवश्यक लाइब्रेरियाँ सूचीबद्ध होती हैं। नीचे requirements.txt फ़ाइल की सामग्री और एकल pip install कमांड से स्थापना दिखाई गई है।
# Content of the requirements.txt file

llama-cpp-python==0.1.48
fastapi
uvicorn[standard]
सभी तीनों लाइब्रेरियाँ इस प्रकार स्थापित की जा सकती हैं:
pip install -r requirements.txtHugging Face प्लेटफ़ॉर्म से हम नीचे दिखाए अनुसार Vicuna मॉडल वेट्स डाउनलोड कर सकते हैं:
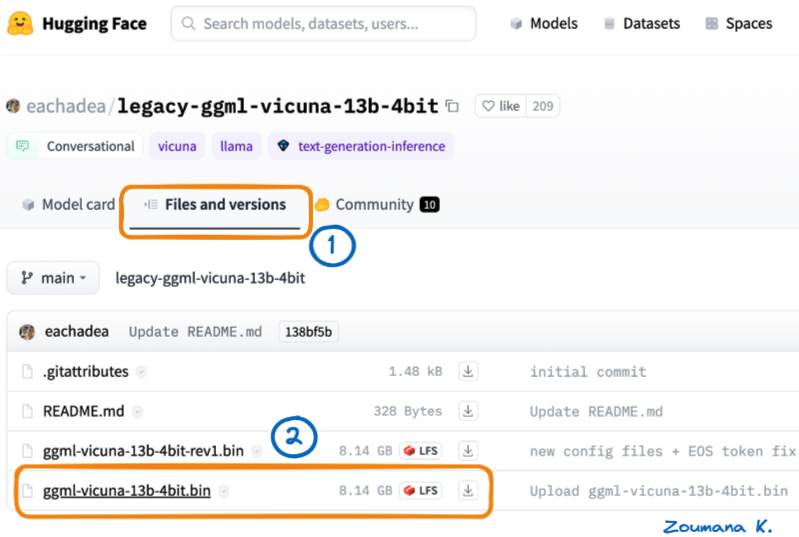
Hugging Face से Vicuna-13B वेट डाउनलोड करने के दो मुख्य कदम
कोड के बेहतर संगठन के लिए, हम डाउनलोड किए गए मॉडल के वेट्स को एक नए model फ़ोल्डर में स्थानांतरित कर सकते हैं।
हालाँकि कमांड लाइन से मॉडल चलाने के लिए सभी पूर्वापेक्षाएँ पूरी हो चुकी हैं, फिर भी मॉडल के साथ इंटरफ़ेस करने वाली API परिनियोजित करना अधिक व्यावहारिक तरीका है। इससे मॉडल अधिक व्यापक उपयोगकर्ता समूह के लिए आसानी से सुलभ हो जाएगा।
इस स्तर तक पहुँचने के लिए हमें निम्न कदमों की आवश्यकता है:
स्रोत कोड की समग्र संरचना नीचे दी गई है, और पूरा कोड GitHub पर उपलब्ध है।
------ model
         |------- ggml-vicuna-13b-4bit.bin

------ requirements.txt
------ vicuna_app.py
ggml-vicuna-13b-4bit.bin मॉडल फ़ोल्डर में डाउनलोड किया गया मॉडल वेट हैrequirements.txt में मॉडल चलाने के लिए आवश्यक निर्भरताएँ हैंvicuna_app.py में API बनाने का Python कोड है, जो इस अनुभाग का मुख्य फोकस है।हमारे मामले में, निम्न दो मुख्य रूट्स आवश्यक हैं। उससे पहले, हमें प्रासंगिक लाइब्रेरियों को इम्पोर्ट करना है, मॉडल को लोड करना है, और FastAPI मॉड्यूल का एक इंस्टेंस बनाना है।
# Import the libraries
from fastapi import FastAPI, HTTPException
from llama_cpp import Llama

# Load the model
vicuna_model_path = "./model/ggml-vicuna-13b-4bit.bin"
vicuna_model = Llama(model_path=vicuna_model_path)

app = FastAPI()"/” “Message”: “Welcome to the Vicuna Demo FastAPI” का निम्न JSON फ़ॉर्मेट home() फ़ंक्शन के माध्यम से लौटाता है, जो कोई पैरामीटर नहीं लेता।# Define the default route
@app.get("/")
def home():
return {"Message": "Welcome to the Vicuna Demo FastAPI"}"/vicuna_says" जो answer_prompt() फ़ंक्शन को ट्रिगर करता है; यह उपयोगकर्ता के प्रॉम्प्ट को पैरामीटर के रूप में लेता है और Vicuna मॉडल के परिणाम तथा कुछ अतिरिक्त मेटाडेटा सहित JSON प्रतिक्रिया लौटाता है।@app.post("/vicuna_says")
def answer_prompt(user_prompt):
if (not (user_prompt)):
raise HTTPException(status_code=400,
detail="Please Provide a valid text message")
response = vicuna_model(user_prompt)
return {"Answer": response}हम अंततः कमांड लाइन से, vicuna_app.py फ़ाइल के स्थान से, नीचे दिए निर्देश के साथ API चला सकते हैं।
uvicorn vicuna_app:app --reloaduvicorn यूनिकॉर्न सर्वर शुरू करता है।vicuna_app: यह Python की vicuna_app.py फ़ाइल को संदर्भित करता है। यह ":" चिह्न के बाएँ भाग में आता है।app: vicuna_app.py फ़ाइल के अंदर app = FastAPI() निर्देश से बनाया गया ऑब्जेक्ट है। यदि फ़ाइल का नाम main.py होता, तो निर्देश होता: uvicorn main:app --reload--reload: कोई भी कोड परिवर्तन होने पर सर्वर को पुनः आरंभ करने के लिए उपयोग किया जाने वाला विकल्प। ध्यान रखें कि इसे केवल विकास चरण में उपयोग करना चाहिए, परिनियोजन के दौरान नहीं।पिछला कमांड चलाने से हमें जो परिणाम मिलता है, वह नीचे दिखाया गया है, और हम देख सकते हैं कि सर्वर localhost पर पोर्ट 8000 (http://127.0.0.1:8000) पर चल रहा है।
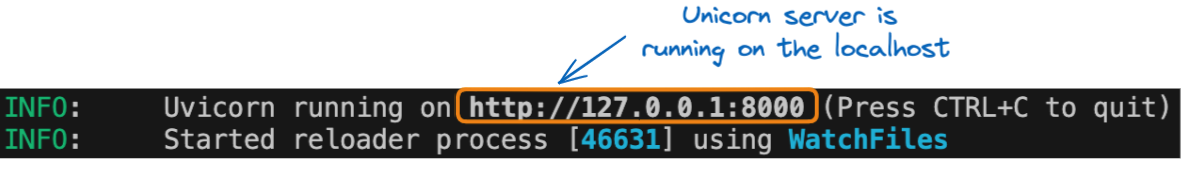
localhost पर चल रही API का URL
डिफॉल्ट रूट तक पहुँचना सीधा है। किसी भी ब्राउज़र में निम्न URL टाइप करें।
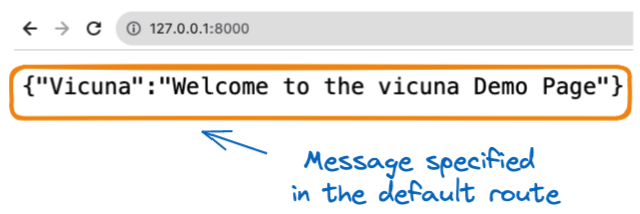
डिफॉल्ट रूट से प्राप्त प्रतिक्रिया
यहाँ एक दिलचस्प हिस्सा है। URL http://127.0.0.1:8000/docs API के साथ इंटरैक्ट करने के लिए एक पूर्ण डैशबोर्ड प्रदान करता है, और नीचे परिणाम दिया गया है।
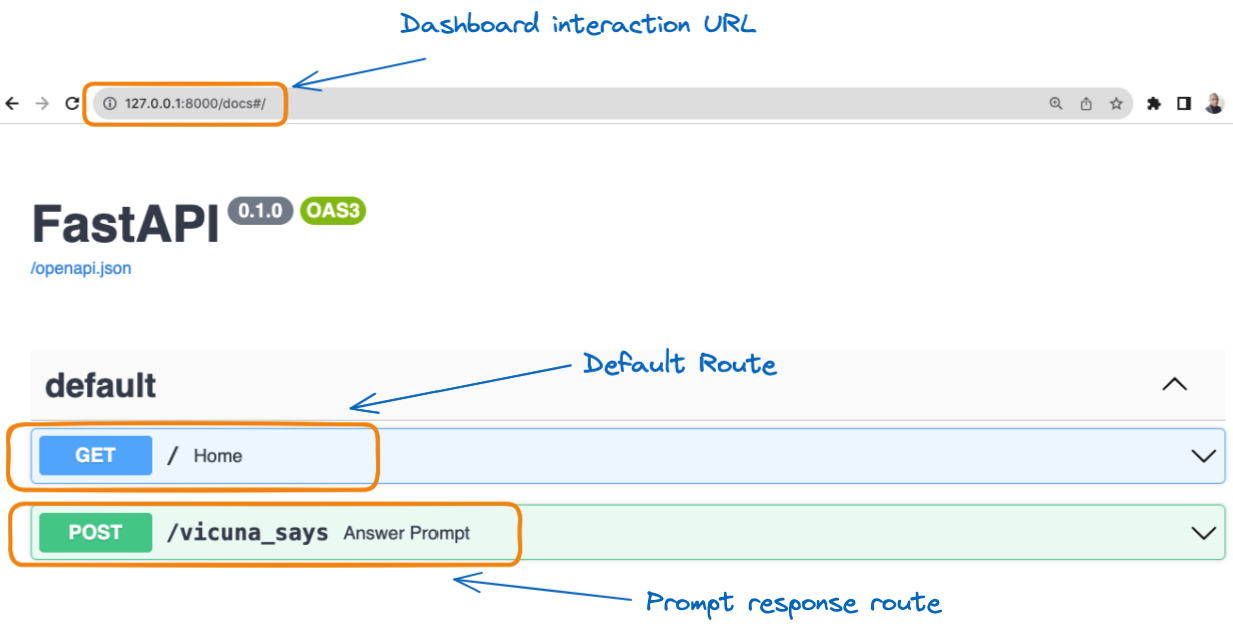
दो रूट्स का ग्राफिकल विज़ुअलाइज़ेशन
पिछली छवि से, जब हम हरे बॉक्स में /vicuna_says चुनते हैं, तो हमें अपनी API के साथ इंटरैक्ट करने के लिए पूर्ण गाइड मिलता है, जैसा कि नीचे दिखाया गया है।
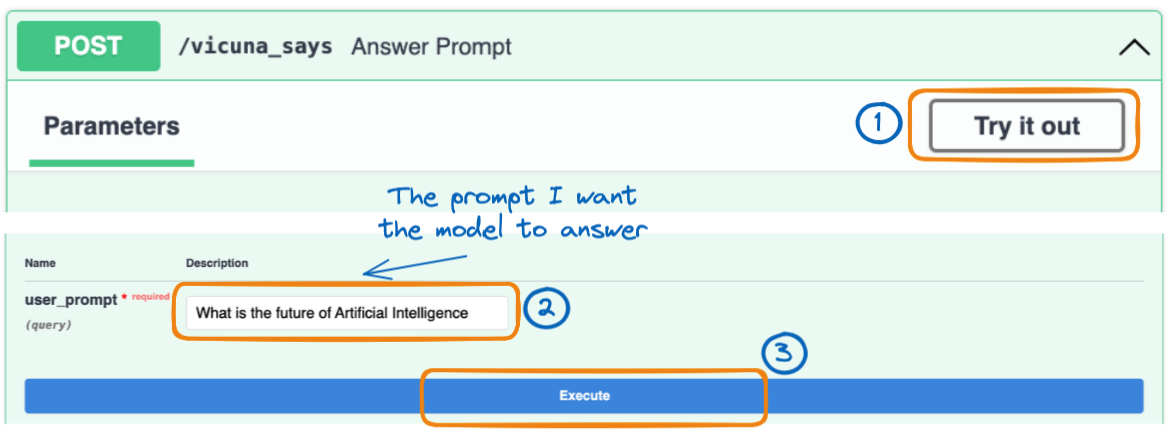
उपयोगकर्ता के प्रॉम्प्ट को निष्पादित करने के तीन मुख्य चरण
बस Try it out टैब चुनें और text_message ज़ोन में वह संदेश दें जिसके लिए आप प्रेडिक्शन चाहते हैं।
अंत में, Execute बटन चुनने के बाद हमें निम्न परिणाम मिलता है।
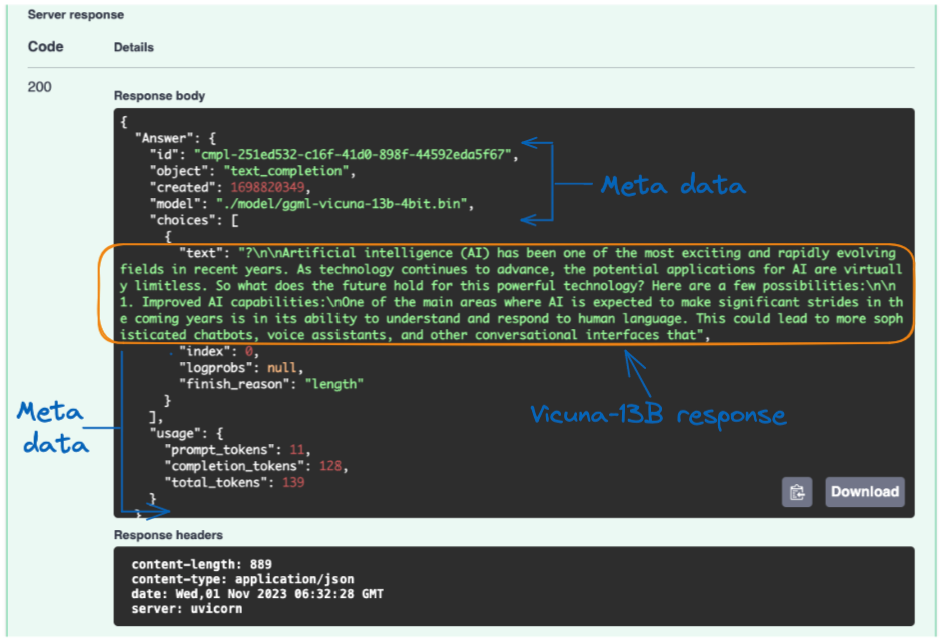
उपयोगकर्ता की क्वेरी पर Vicuna मॉडल से सर्वर प्रतिक्रिया
Vicuna मॉडल की प्रतिक्रिया “text” फ़ील्ड में दी जाती है, और परिणाम काफ़ी प्रभावशाली दिखता है।
अतिरिक्त मेटाडेटा भी प्रदान किया गया है, जैसे उपयोग किया गया मॉडल, प्रतिक्रिया निर्माण तिथि, प्रॉम्प्ट में टोकन्स की संख्या, और प्रतिक्रिया में टोकन्स की संख्या, आदि।
ऐसे शक्तिशाली मॉडल की तैनाती कई महत्वपूर्ण तरीकों से उपयोगकर्ता अनुभव और परिचालन दक्षता को बढ़ाती है, और नीचे दिए गए बिंदुओं तक सीमित नहीं है:
कुल मिलाकर, तैनाती vicuna-13B मॉडल के अधिक सुलभ, विश्वसनीय और बहुमुखी उपयोग को सुगम बनाती है, जिससे यह विभिन्न उपयोगकर्ताओं और अनुप्रयोगों के लिए और अधिक उपयोगी हो जाता है।
Vicuna-13B मॉडल के साथ काम करते समय, कुछ सर्वोत्तम अभ्यास और सुझाव डेवलपर्स को अपने अनुभव, परिणामों को अनुकूलित करने और आम समस्याओं का समाधान करने में मदद कर सकते हैं।
इन सर्वोत्तम अभ्यासों और सुझावों का पालन करके, वे Vicuna-13B मॉडल के साथ काम करते समय अधिक सुगम अनुभव और बेहतर परिणाम सुनिश्चित कर सकते हैं।
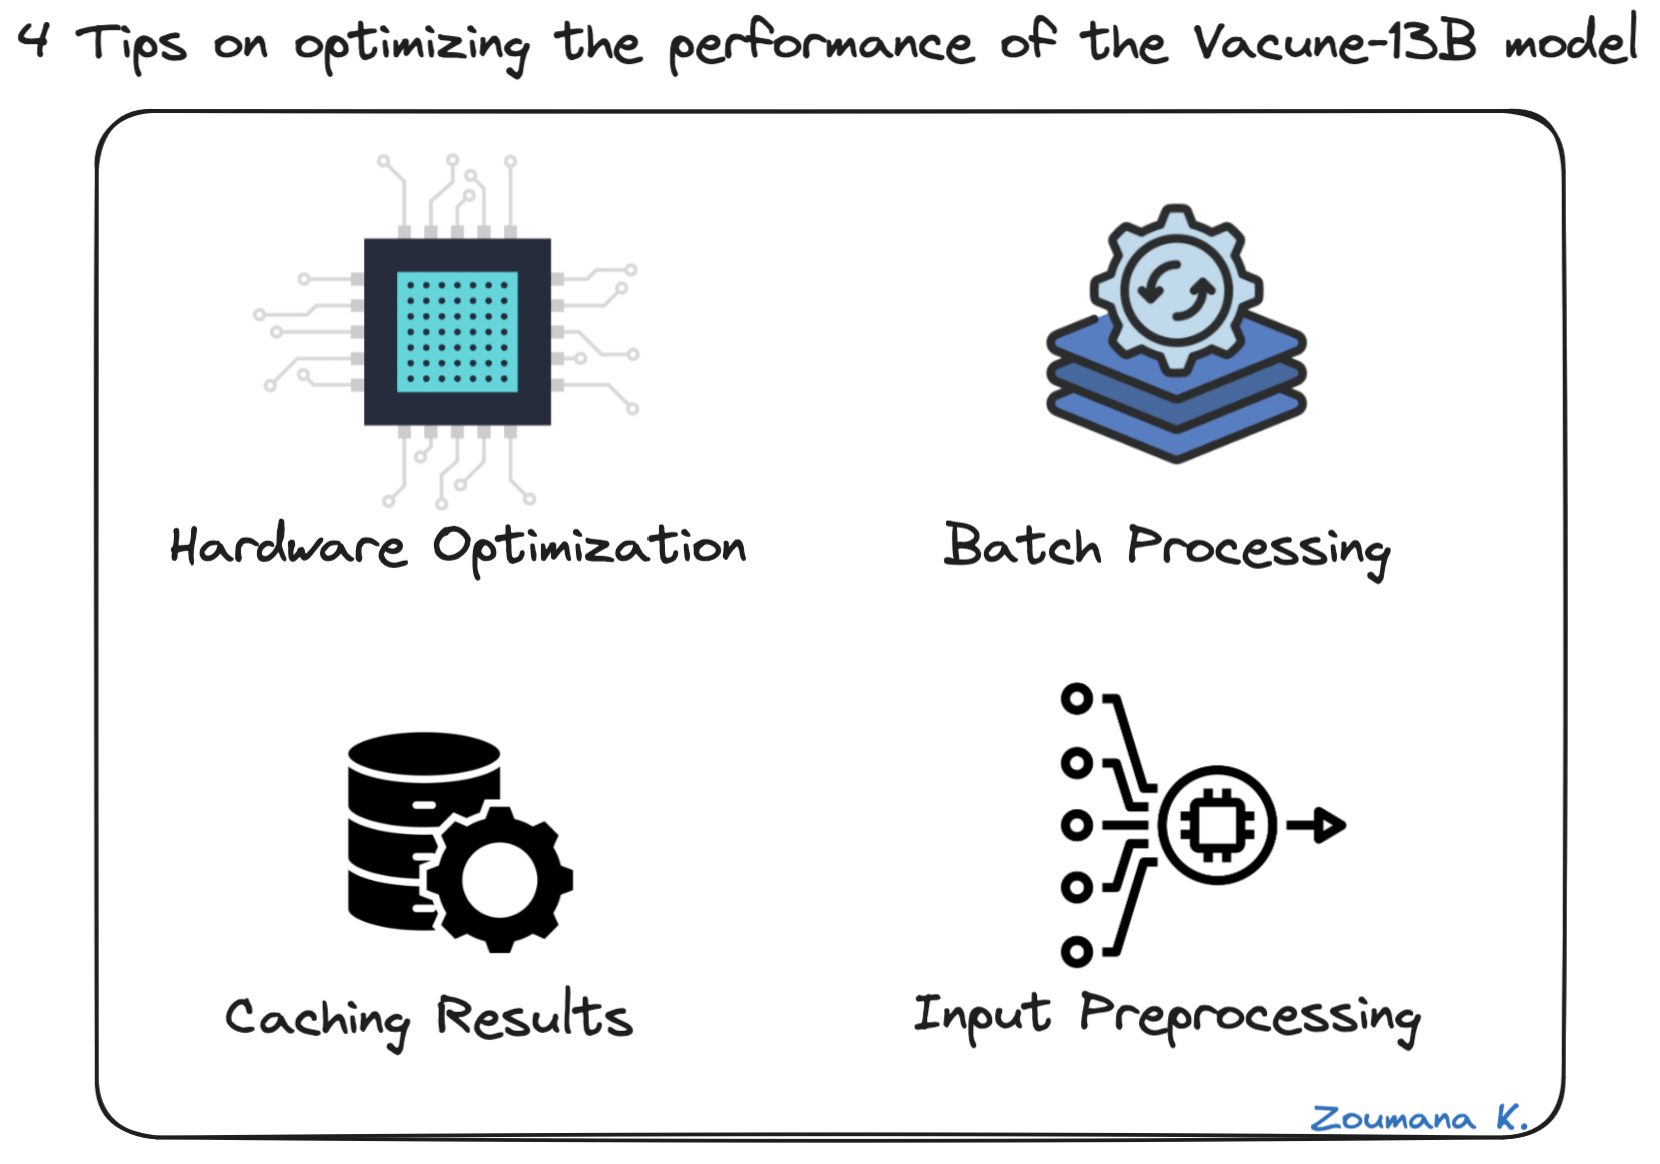
Vicuna-13B मॉडल के प्रदर्शन को अनुकूलित करने के 4 सुझाव
प्रदर्शन अनुकूलन से आगे बढ़ते हुए, Vicuna-13B के उपयोग के दौरान उत्पन्न हो सकने वाली सामान्य समस्याओं का समाधान करने में दक्ष होना भी महत्वपूर्ण है, और नीचे चार उदाहरण दिए गए हैं:
कुछ सामान्य ट्रबलशूटिंग समस्याएँ
संक्षेप में, इस लेख ने Vicuna-13B मॉडल को सेटअप और उपयोग करने का एक व्यापक अवलोकन प्रदान किया है। हमने आवश्यक पूर्वापेक्षाएँ कवर कीं, जिनमें हार्डवेयर, सॉफ़्टवेयर, और मॉडल को सफलतापूर्वक चलाने के लिए आवश्यक LLaMa वेट्स प्राप्त करना शामिल है।
कार्य परिवेश सेटअप, आवश्यक सॉफ़्टवेयर स्थापित करने, और Vicuna-13B के वेट्स सेट करने के लिए विस्तृत निर्देश दिए गए, तथा भाषा मॉडलों में वेट्स के महत्व पर जोर दिया गया।
इसके अलावा, हमने Vicuna-13B की पैकेजिंग और तैनाती पर चर्चा की, यह रेखांकित करते हुए कि तैनाती कैसे इसे वेब इंटरफ़ेस और API के रूप में उपयोग करने में सहायक होती है।
अंत में, Vicuna-13B के साथ इंटरैक्ट करने पर व्यावहारिक अंतर्दृष्टियाँ, इसकी क्षमताओं के उदाहरण, और इसके प्रदर्शन को अनुकूलित करने तथा सामान्य समस्याओं का समाधान करने के लिए सर्वोत्तम अभ्यास भी साझा किए गए।
AI और मशीन लर्निंग की दुनिया में और गहराई तक जाने के लिए तैयार हैं? AI पेशेवरों द्वारा उपयोग किए जाने वाले शक्तिशाली डीप लर्निंग फ़्रेमवर्क के साथ अपने कौशल को निखारें। आज ही Deep Learning with PyTorch कोर्स से जुड़ें।
आज ही अपनी AI यात्रा शुरू करें!
कोर्स
लर्निंग पाथ
कोर्स