

Cours
Comprendre l'intelligence artificielle
2 h
431.6K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleL’essor des grands modèles de langage a transformé de nombreux secteurs, en apportant la puissance de technologies comme GPT-3.5 et GPT-4 d’OpenAI à une foule d’applications. Cependant, leur coût élevé et les enjeux de confidentialité des données freinent souvent l’adoption. C’est là que les modèles open source comme Vicuna-13B entrent en jeu : des performances proches, sans les dépenses importantes ni les risques liés aux données sensibles.
Pour en savoir plus sur GPT-3.5 et GPT-4, notre tutoriel Using GPT-3.5 and GPT-4 via the OpenAI API in Python est un bon point de départ pour comprendre comment utiliser le package Python d’OpenAI et dialoguer avec ChatGPT par programmation.
Vicuna-13B est un modèle conversationnel open source affiné à partir de LLaMa 13B, en s’appuyant sur des conversations partagées par des utilisateurs et collectées via ShareGPT.
Une évaluation préliminaire, avec GPT-4 en tant que juge, a montré que Vicuna-13B atteint plus de 90 % de la qualité de chatGPT et Google Bard, et surpasse d’autres modèles comme LLaMa et Alpaca dans plus de 90 % des cas. Le flux global de fine-tuning et d’évaluation est illustré ci-dessous :
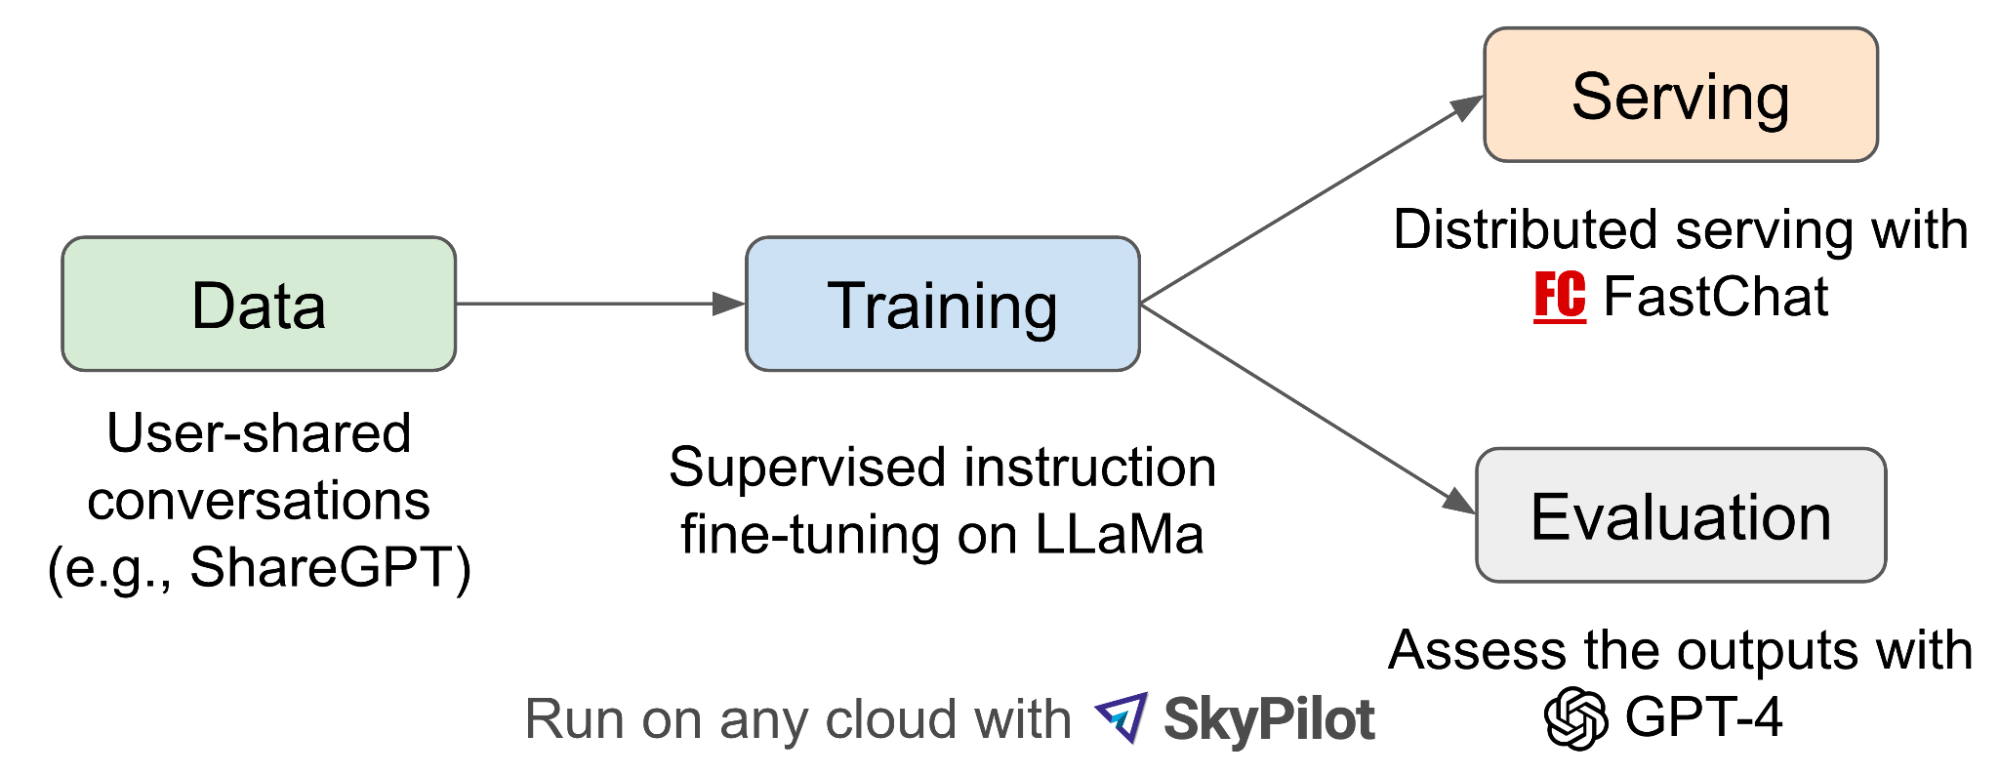
Flux de fine-tuning et d’évaluation de Vicuna-13B (source)
Si cela met en avant la robustesse de Vicuna-13B, le modèle présente aussi des limites et n’excelle pas sur des tâches comme les mathématiques et le raisonnement.
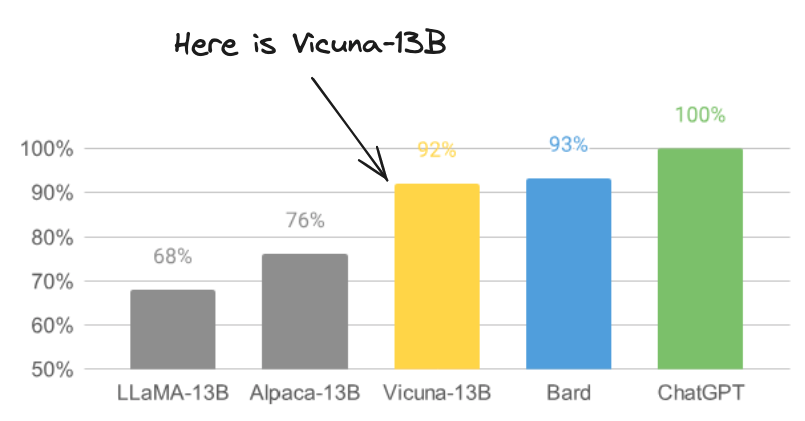
Image de LMSYSORG modifiée par l’auteur
En tant que chatbot intelligent, les cas d’usage de Vicuna-13B sont innombrables. Voici quelques exemples dans différents secteurs : service client, santé, éducation, finance et voyage/hôtellerie.
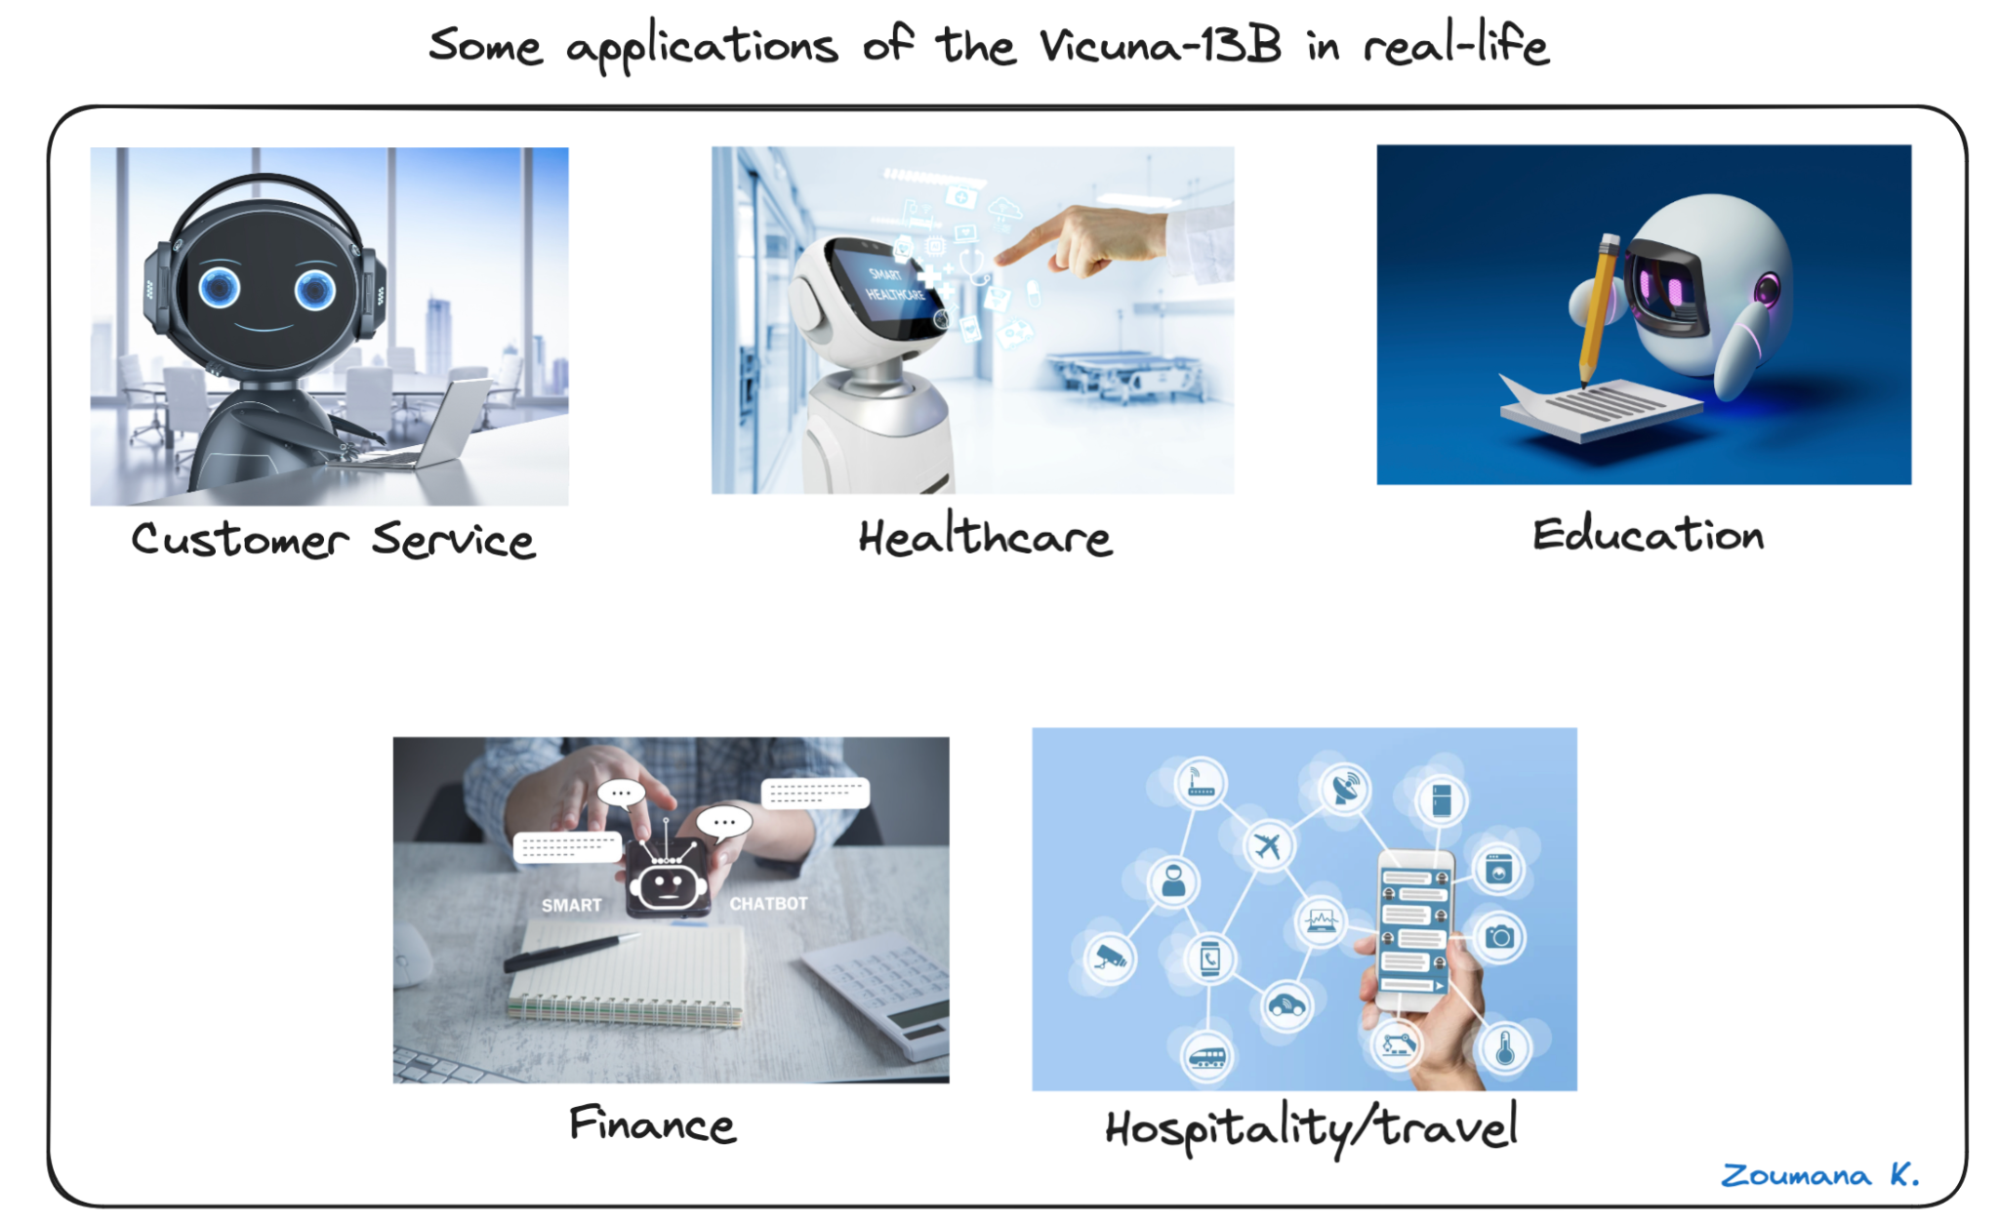
Cinq applications concrètes de Vicuna-13
Cette liste est loin d’être exhaustive. Notre article How NLP is changing the future of Data Science explore comment le NLP façonne l’avenir de la data science et du machine learning, ses usages à venir, les risques et comment les atténuer.
Au vu de ces cas concrets, la demande pour des agents conversationnels dopés à l’IA comme Vicuna-13B est forte dans la plupart des secteurs.
Maîtriser l’implémentation et l’intégration de ces technologies dans les workflows métiers devient donc une compétence clé, à mesure que les entreprises s’en emparent pour améliorer l’engagement client, générer plus de leads et optimiser leur retour sur investissement.
Bonne nouvelle : l’objectif de ce tutoriel est précisément de vous aider à développer les compétences nécessaires pour exécuter Vicuna-13B et l’intégrer à n’importe quel système d’information.
Avant de se lancer dans l’exécution de Vicuna-13B, il est essentiel de préparer les prérequis suivants :
Une fois ces éléments en place, vous comprendrez mieux les formats d’entrée et de sortie et pourrez exécuter le modèle avec succès.
Bien cerner les formats d’entrée et de sortie de Vicuna-13B donne au développeur la base nécessaire pour anticiper les facteurs qui influencent la prise de décision du modèle.
Cette section détaille les principaux paramètres d’entrée requis ainsi que le format de sortie attendu.
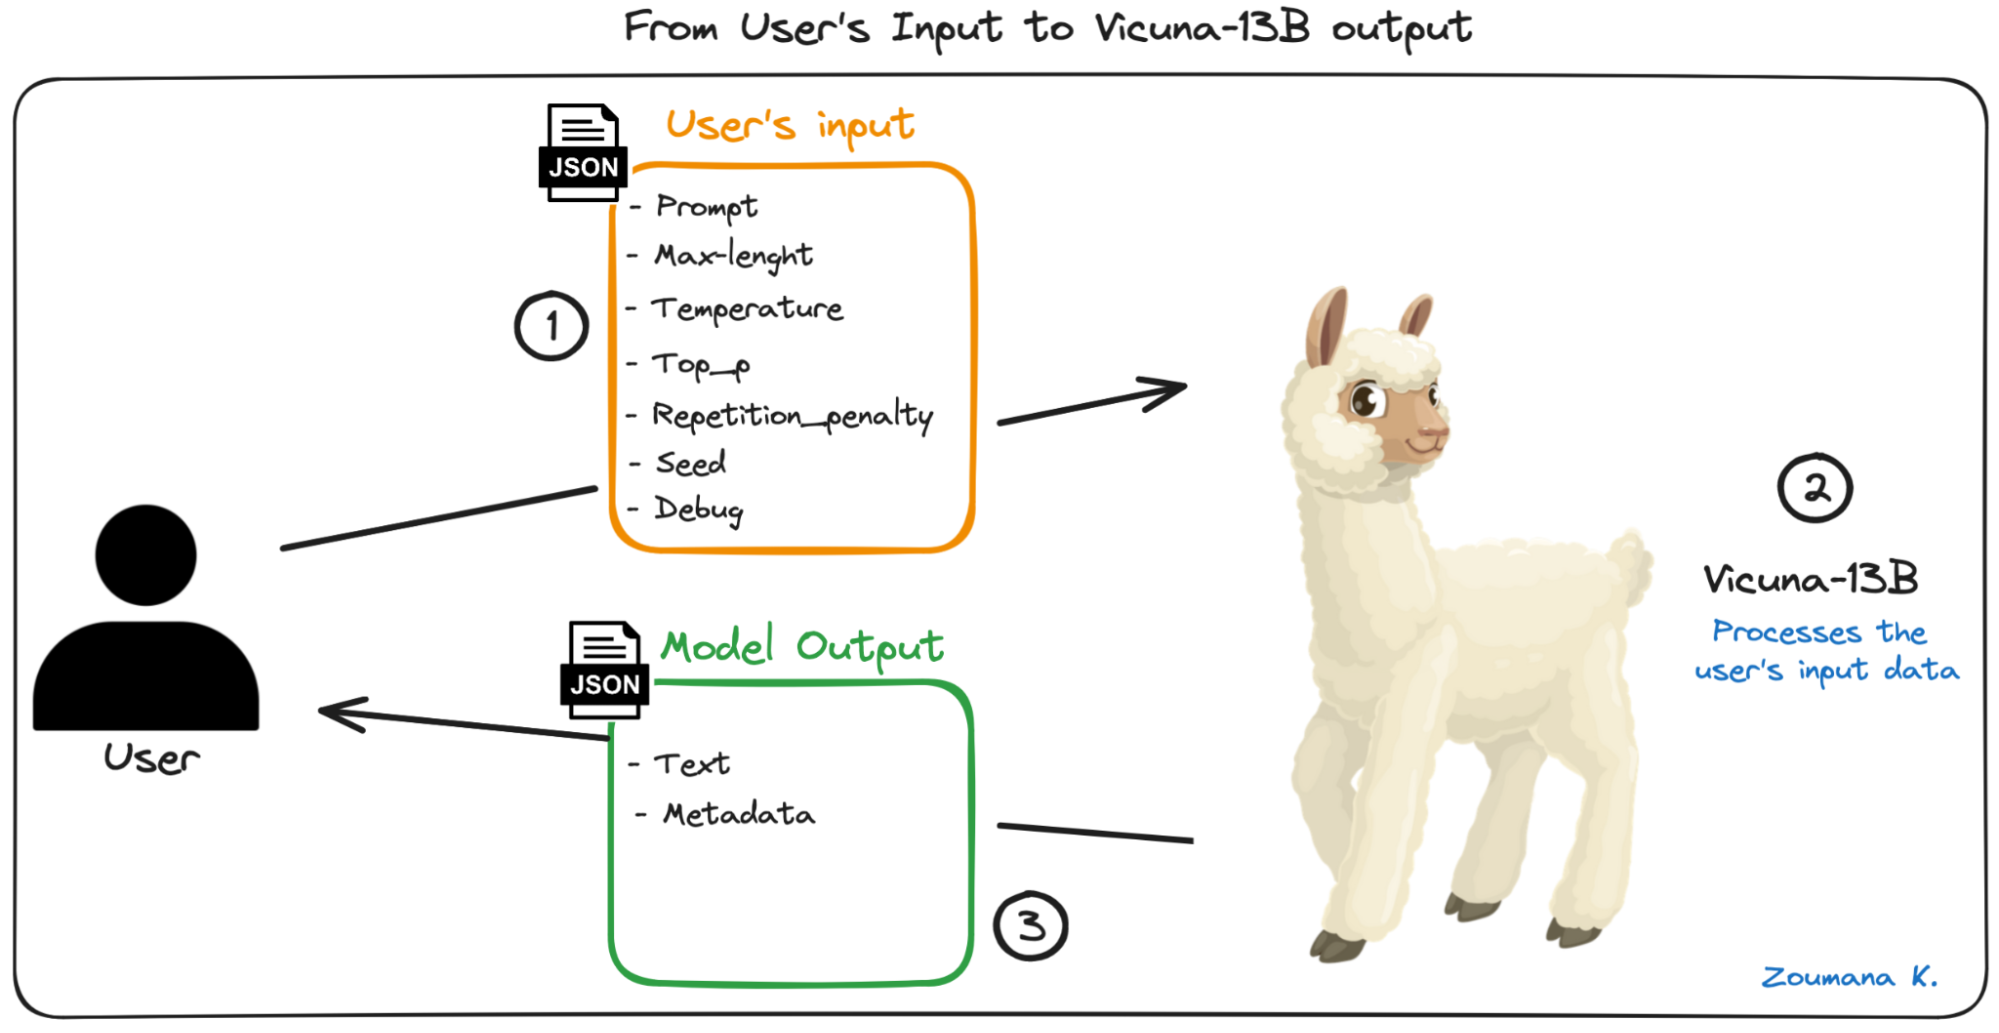
Workflow minimaliste de bout en bout
Décryptons le schéma : l’utilisateur soumet d’abord son entrée, qui comprend l’invite (prompt), c’est-à-dire la requête textuelle principale à laquelle il souhaite une réponse.
L’invite est fournie avec les paramètres suivants :
Après l’envoi de l’invite avec ces paramètres, Vicuna-13B effectue le traitement nécessaire et génère une sortie conforme au schéma suivant :
Maintenant que les formats d’entrée et de sortie sont plus clairs, identifions les principales bibliothèques pour exécuter le modèle Vicuna.
Toutes les commandes de cette section se lancent depuis un terminal. À l’aide de conda create, nous créons un environnement virtuel nommé vicuna-env.
conda create --name vicuna-envAprès avoir créé l’environnement virtuel, on l’active avec la commande conda activate :
conda activate vicuna-envLa ligne de commande doit alors afficher le nom de l’environnement entre crochets au début du terminal, comme ci-dessous :
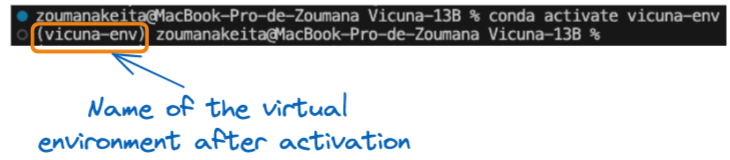
Nom de l’environnement virtuel après activation
Deux approches sont possibles. La première consiste à exécuter manuellement pip install pour chaque bibliothèque : chronophage et peu optimale en contexte industriel.
La seconde, recommandée, repose sur un fichier requirements.txt listant les dépendances. Voici son contenu et l’installation via une seule commande pip install.
# Contenu du fichier requirements.txt

llama-cpp-python==0.1.48
fastapi
uvicorn[standard]
L’installation des trois bibliothèques se fait ainsi :
pip install -r requirements.txtDepuis la plateforme Hugging Face, téléchargez les poids du modèle Vicuna comme illustré ci-dessous :
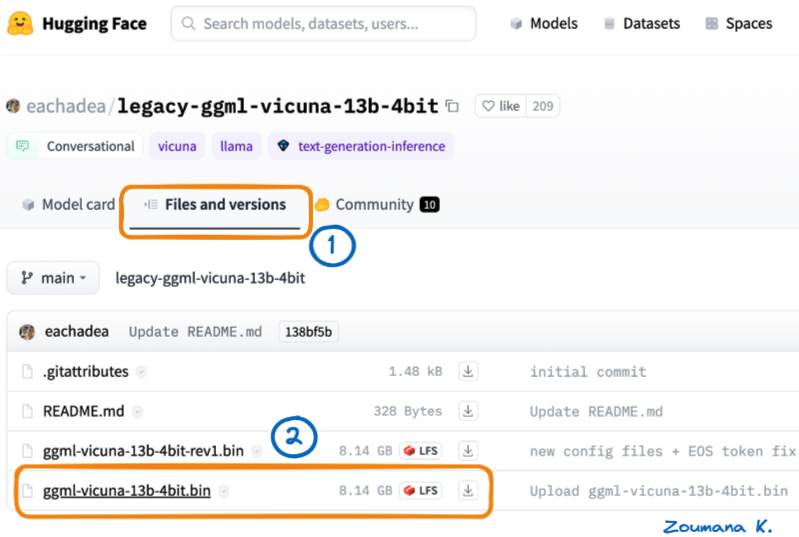
Deux étapes pour télécharger les poids de Vicuna-13B depuis Hugging Face
Pour mieux organiser le code, déplacez les poids téléchargés dans un dossier model dédié.
Même si tout est prêt pour exécuter le modèle en ligne de commande, déployer une API qui l’expose est plus pratique et le rend accessible à davantage d’utilisateurs.
Pour y parvenir, voici les étapes :
La structure globale du code source est donnée ci-dessous. Le code complet est disponible sur GitHub.
------ model
         |------- ggml-vicuna-13b-4bit.bin

------ requirements.txt
------ vicuna_app.py
ggml-vicuna-13b-4bit.bin : poids du modèle téléchargé, placé dans le dossier modelrequirements.txt : dépendances nécessaires à l’exécutionvicuna_app.py : code Python de création de l’API, cœur de cette section.Deux routes principales suffisent ici. Avant cela, importons les bibliothèques, chargeons le modèle et créons l’instance FastAPI.
# Import des bibliothèques
from fastapi import FastAPI, HTTPException
from llama_cpp import Llama

# Chargement du modèle
vicuna_model_path = "./model/ggml-vicuna-13b-4bit.bin"
vicuna_model = Llama(model_path=vicuna_model_path)

app = FastAPI()"/" renvoie le JSON "Message": "Welcome to the Vicuna Demo FastAPI" via la fonction home() sans paramètre.# Définition de la route par défaut
@app.get("/")
def home():
return {"Message": "Welcome to the Vicuna Demo FastAPI"}"/vicuna_says" déclenche la fonction answer_prompt(), qui prend l’invite de l’utilisateur en paramètre et renvoie une réponse JSON avec le résultat du modèle Vicuna et des métadonnées.@app.post("/vicuna_says")
def answer_prompt(user_prompt):
if (not (user_prompt)):
raise HTTPException(status_code=400,
detail="Please Provide a valid text message")
response = vicuna_model(user_prompt)
return {"Answer": response}Nous pouvons maintenant lancer l’API avec la commande suivante, depuis le répertoire contenant vicuna_app.py.
uvicorn vicuna_app:app --reloaduvicorn démarre le serveur ASGI Uvicorn.vicuna_app : correspond au fichier Python vicuna_app.py, à gauche des deux-points.app : c’est l’objet créé dans vicuna_app.py via app = FastAPI(). Si le fichier s’appelait main.py, la commande serait uvicorn main:app --reload.--reload : redémarre automatiquement le serveur à chaque modification du code. À réserver au développement, pas à la production.Voici le résultat après exécution : le serveur tourne en local sur le port 8000 (http://127.0.0.1:8000)
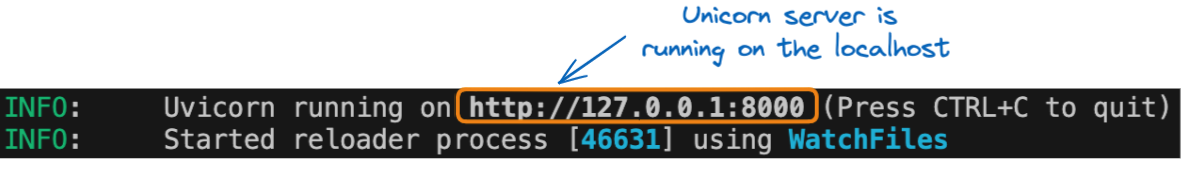
URL de l’API en local
Accéder à la route par défaut est trivial : saisissez simplement l’URL suivante dans votre navigateur.
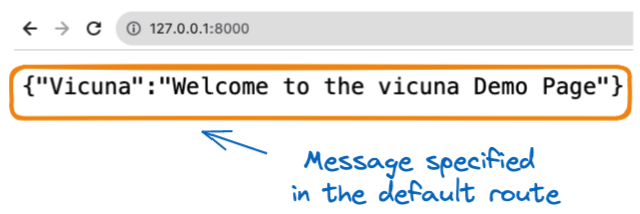
Réponse de la route par défaut
Autre point intéressant : l’URL http://127.0.0.1:8000/docs fournit une interface complète pour interagir avec l’API, comme ci-dessous.
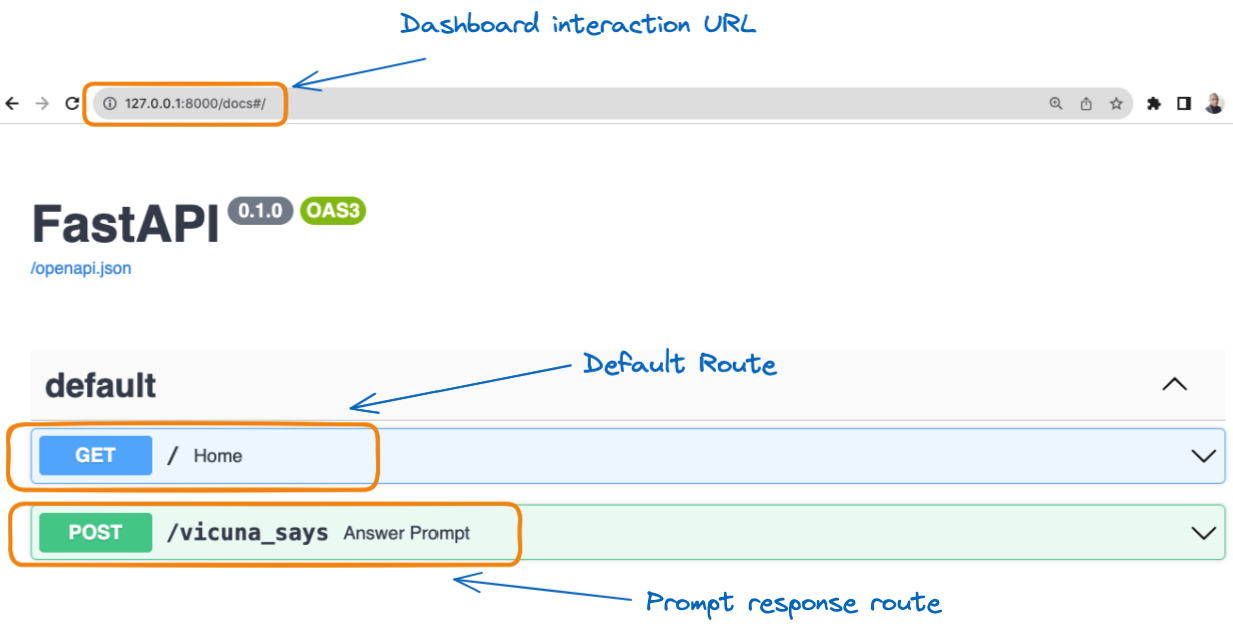
Visualisation graphique des deux routes
En sélectionnant /vicuna_says (encadré vert), on obtient le guide d’utilisation détaillé de l’API, comme suit.
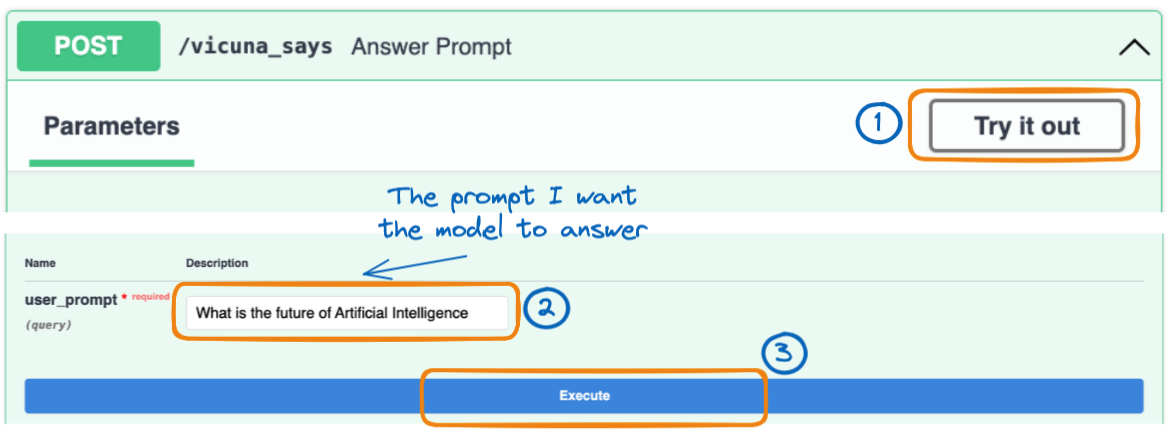
Les trois étapes pour exécuter l’invite utilisateur
Cliquez sur Try it out et saisissez votre message dans la zone text_message.
Après avoir cliqué sur Execute, vous obtenez le résultat suivant.
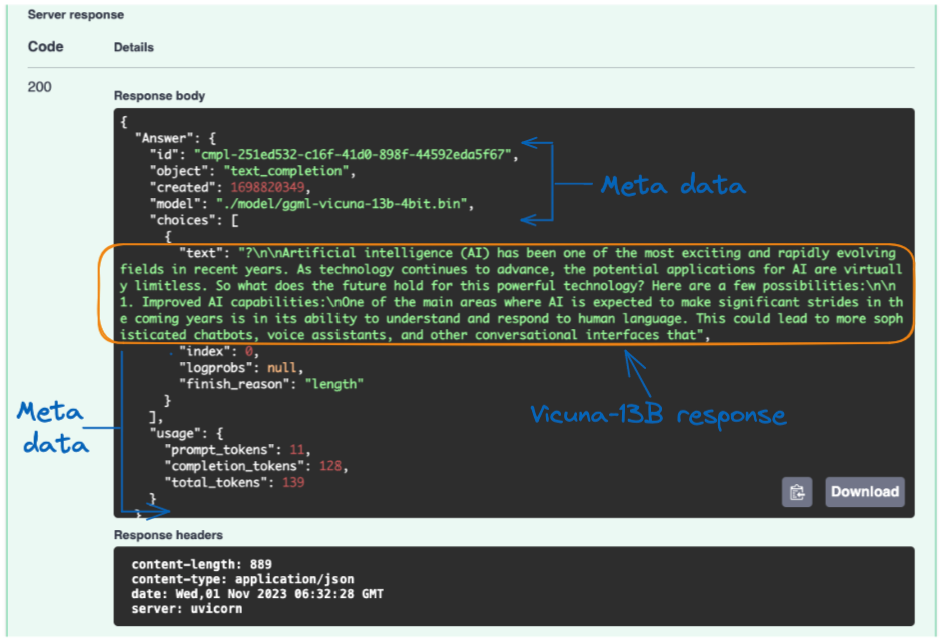
Réponse du serveur Vicuna à la requête utilisateur
La réponse du modèle Vicuna apparaît dans le champ « text » ; le résultat est convaincant.
Des métadonnées complémentaires sont fournies : modèle utilisé, date de création de la réponse, nombre de tokens dans l’invite et dans la réponse, etc.
Déployer un modèle aussi puissant améliore l’expérience utilisateur et l’efficacité opérationnelle de plusieurs façons, notamment :
En bref, le déploiement rend l’usage de Vicuna-13B plus accessible, fiable et polyvalent, et élargit son champ d’application.
Pour travailler efficacement avec Vicuna-13B, quelques bonnes pratiques et conseils aident à optimiser les performances et à résoudre les problèmes fréquents.
En suivant ces recommandations, vous gagnerez en fluidité d’usage et en qualité de résultats avec Vicuna-13B.
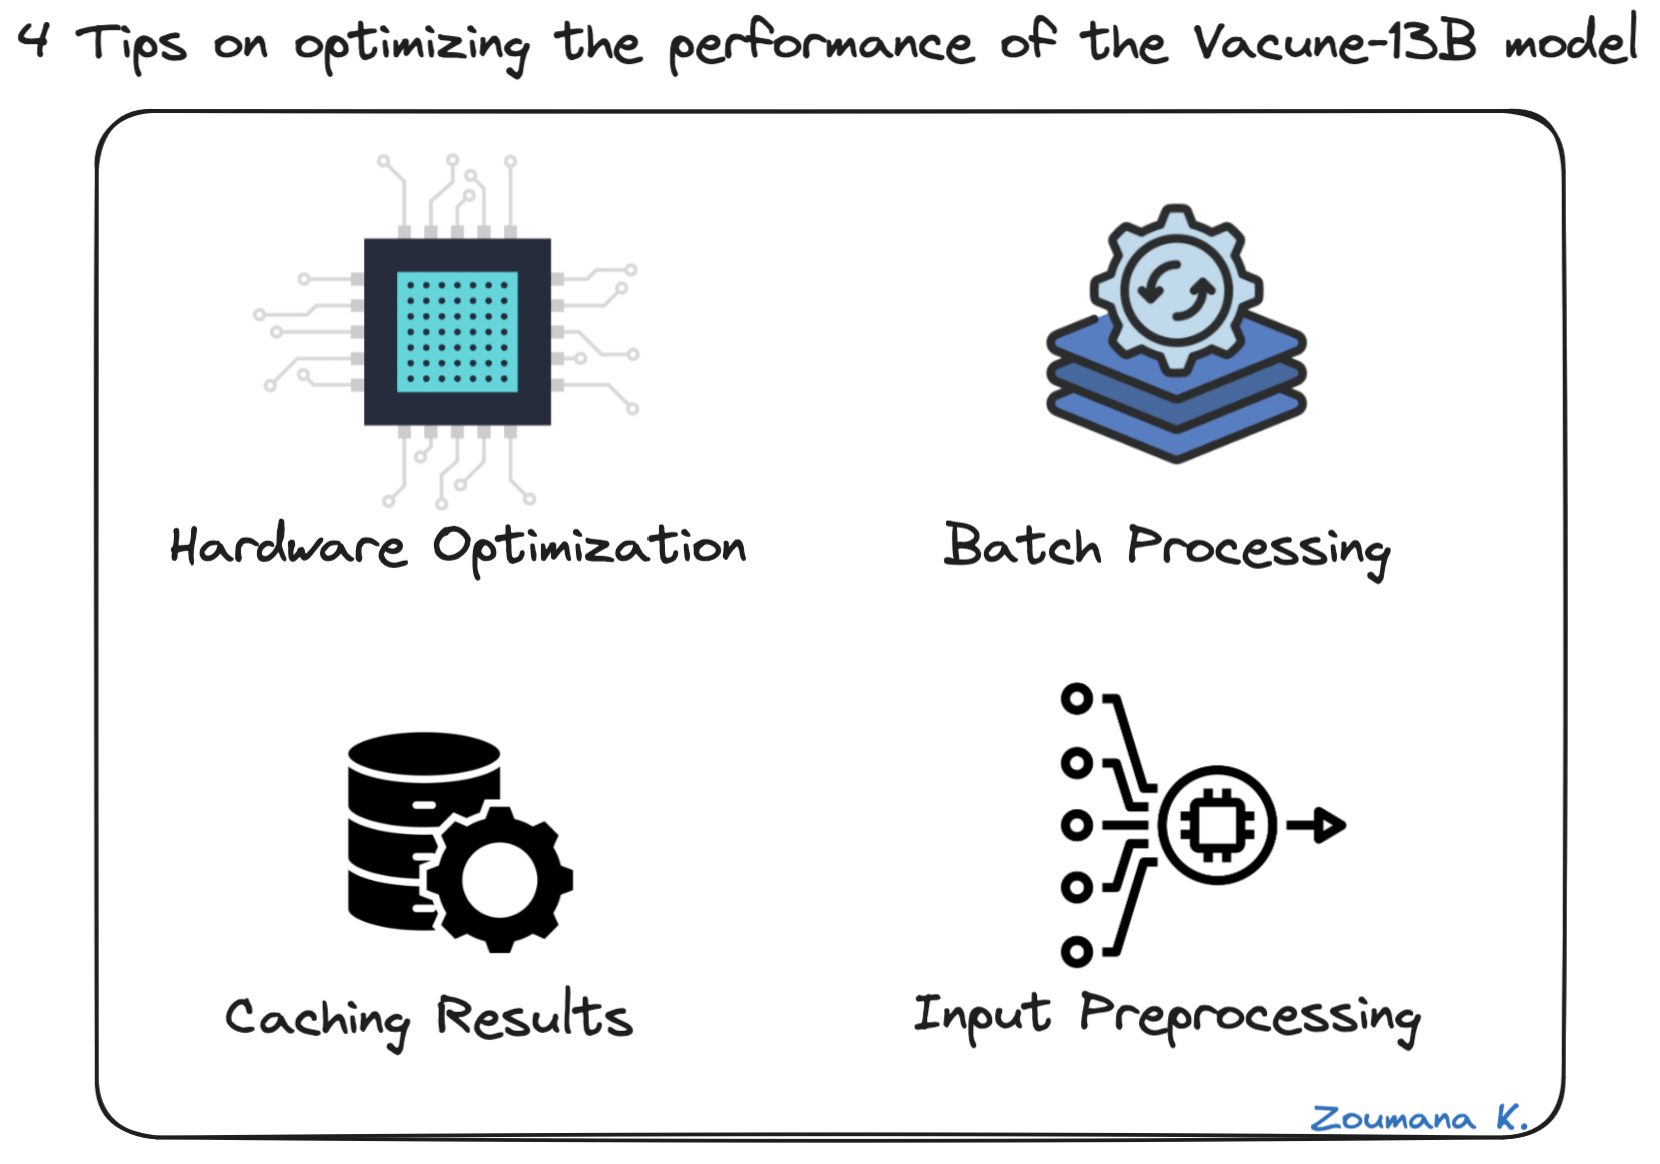
4 conseils pour optimiser les performances de Vicuna-13B
Au-delà de l’optimisation, il est crucial de savoir résoudre les problèmes fréquemment rencontrés avec Vicuna-13B. Voici quatre exemples :
Quelques problèmes de dépannage courants
En résumé, cet article propose une vue d’ensemble complète de la mise en place et de l’utilisation de Vicuna-13B. Nous avons couvert les prérequis matériels et logiciels, ainsi que l’obtention des poids LLaMa indispensables à l’exécution du modèle.
Nous avons détaillé la création de l’environnement de travail, l’installation des dépendances et la configuration des poids de Vicuna-13B, en soulignant le rôle central des poids dans les modèles de langage.
Nous avons également abordé le packaging et le déploiement de Vicuna-13B, en montrant comment le déploiement facilite son utilisation via une interface web et une API.
Enfin, nous avons partagé des conseils pratiques pour interagir avec Vicuna-13B, des exemples de ses capacités, ainsi que des bonnes pratiques pour optimiser ses performances et dépanner les problèmes courants.
Envie d’aller plus loin dans l’IA et le machine learning ? Développez vos compétences avec le framework de deep learning plébiscité par les professionnels. Rejoignez dès aujourd’hui le cours Deep Learning with PyTorch.
Commencez votre parcours IA dès aujourd’hui !
Cours
Cursus
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Zoumana Keita
15 min
Tutoriel
Tutoriel
Adel Nehme
3 min
Tutoriel
Matt Crabtree
5 min
Tutoriel
Moez Ali
6 min
Tutoriel
DataCamp Team
3 min





