Curso
Entendendo a inteligência artificial
2 h
421.7K
O surgimento dos modelos de linguagem de grande porte transformou setores inteiros, levando o poder de tecnologias como o GPT-3.5 e o GPT-4 da OpenAI para diversas aplicações. Porém, o alto custo e preocupações com confidencialidade dos dados muitas vezes afastam potenciais adotantes. É aí que entram modelos de código aberto como o Vicuna-13B, oferecendo desempenho semelhante sem o custo elevado e com menos risco para informações sensíveis.
Para saber mais sobre GPT-3.5 e GPT-4, nosso tutorial Using GPT-3.5 and GPT-4 via the OpenAI API in Python é um bom ponto de partida para entender como usar o pacote Python da OpenAI e conversar programaticamente com o ChatGPT.
Vicuna-13B é um modelo conversacional de código aberto treinado a partir do fine-tuning do LLaMa 13B usando conversas compartilhadas por usuários coletadas do ShareGPT.
Uma avaliação preliminar usando o GPT-4 como juiz mostrou o Vicuna-13B alcançando mais de 90% da qualidade do ChatGPT e do Google Bard, superando outros modelos como LLaMa e Alpaca em mais de 90% dos casos. O fluxo geral de fine-tuning e avaliação está ilustrado abaixo:
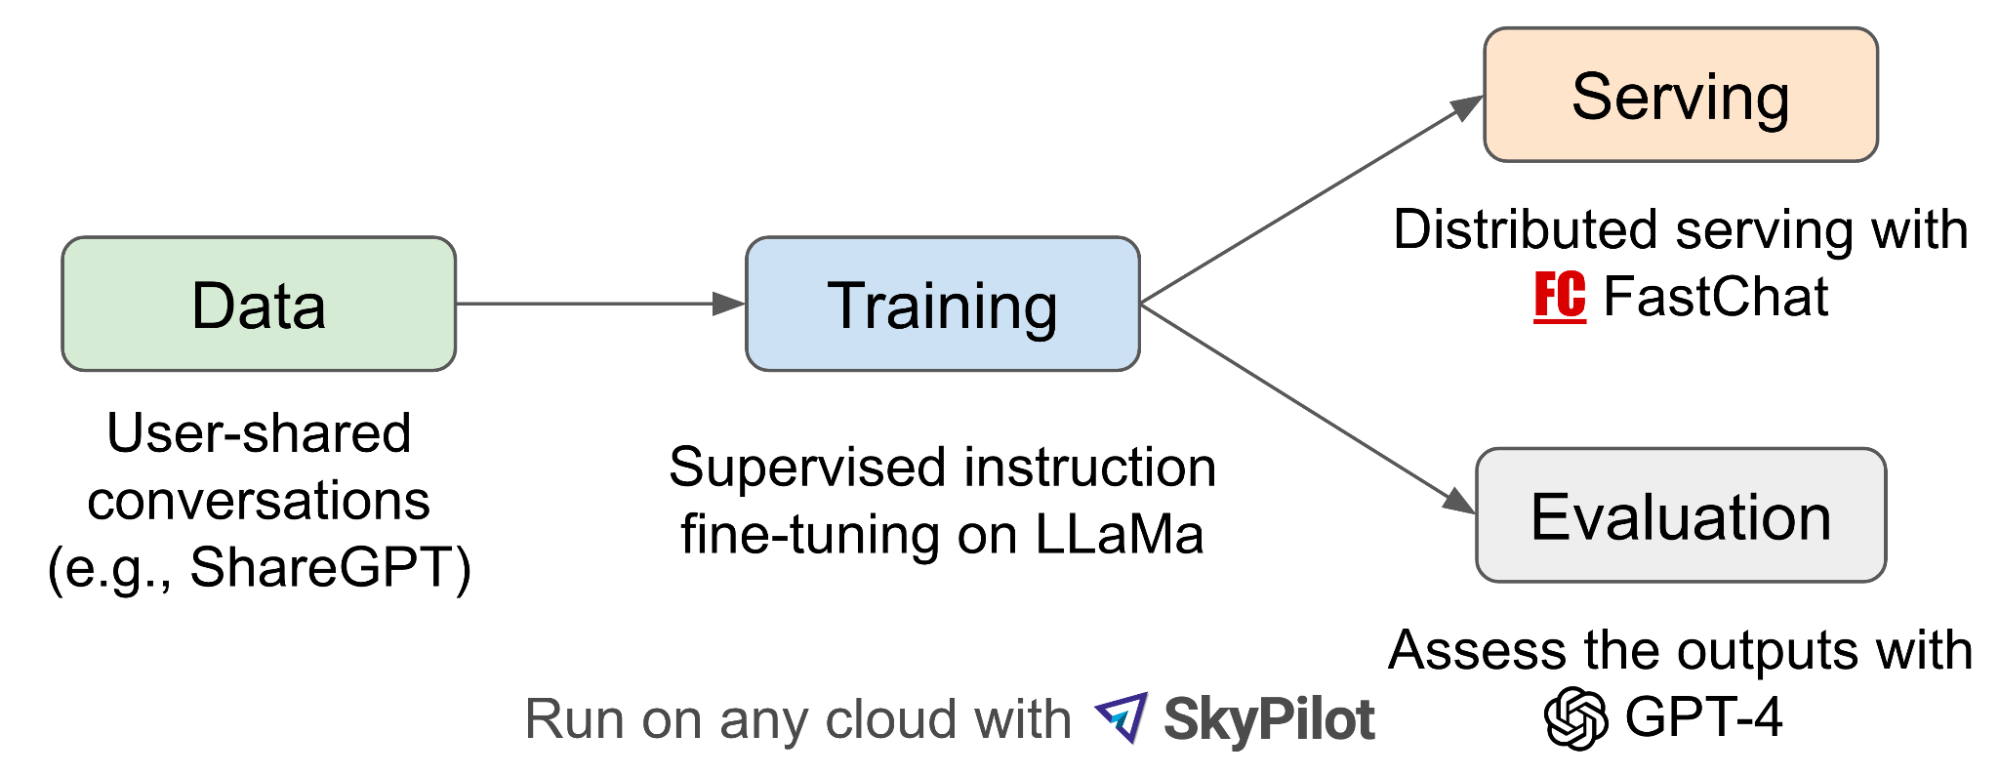
Fluxo de fine-tuning e avaliação do Vicuna-13B (fonte)
Embora isso destaque a força do Vicuna-13B, ele tem suas próprias limitações e não é limitado a tarefas como matemática e raciocínio.
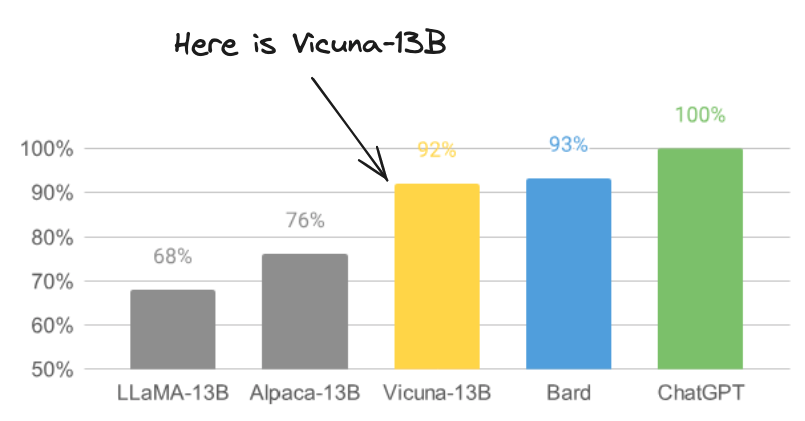
Imagem do LMSYSORG modificada pelo autor
Como um chatbot inteligente, as aplicações do Vicuna-13B são inúmeras. Algumas delas estão ilustradas abaixo em diferentes setores, como atendimento ao cliente, saúde, educação, finanças e turismo/hotelaria.
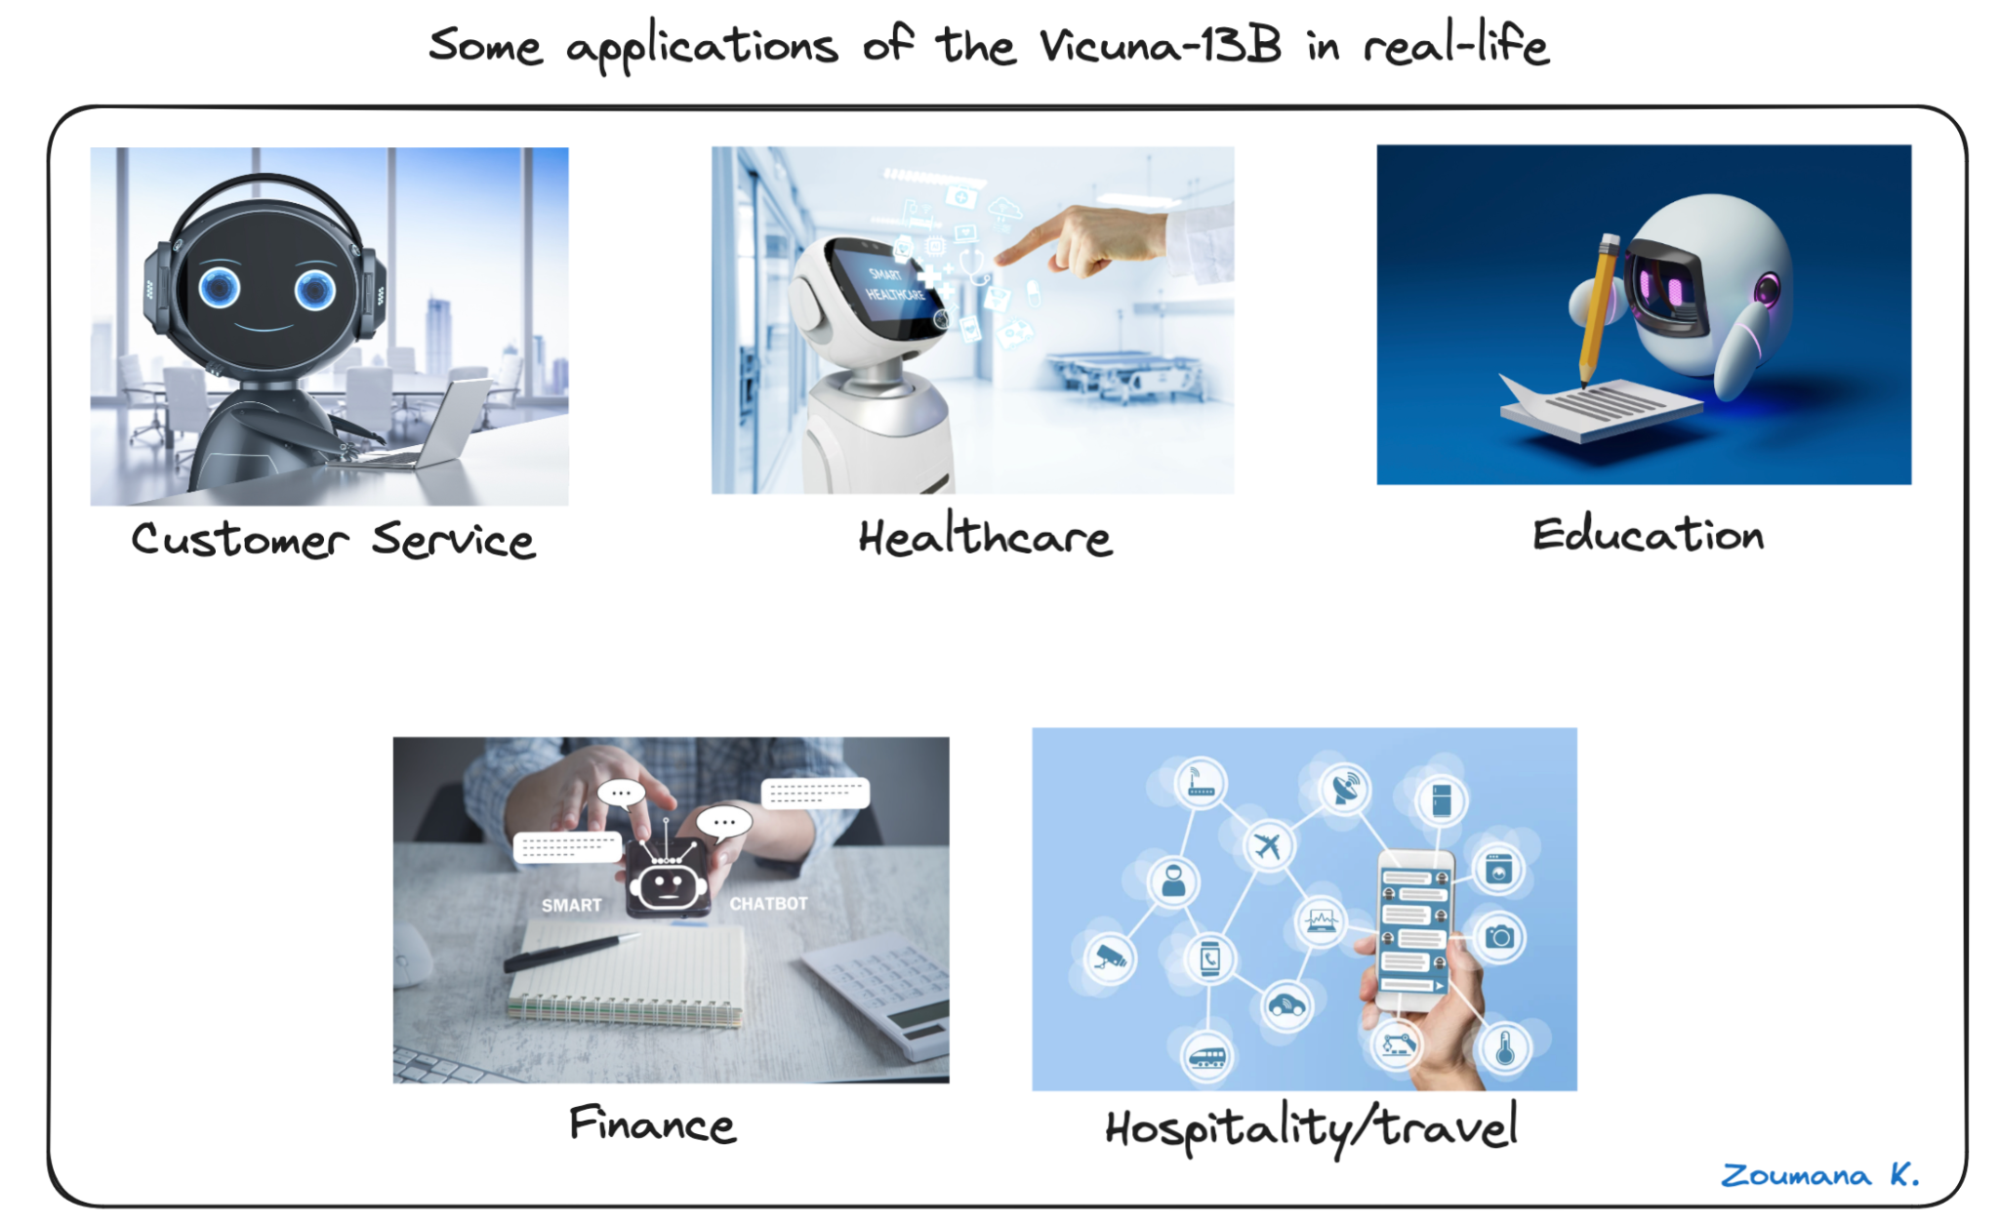
Cinco aplicações do Vicuna-13 na vida real
A lista acima não é exaustiva. Nosso artigo How NLP is changing the future of Data Science discute como o NLP está impulsionando o futuro da ciência de dados e do machine learning, suas aplicações futuras, riscos e como mitigá-los.
Com base nessas aplicações do mundo real, não há dúvida de que existe uma grande demanda por agentes conversacionais com IA como o Vicuna-13B em diversos setores.
Por isso, dominar como implementar e integrar essa tecnologia ao fluxo de trabalho da empresa está se tornando uma habilidade cada vez mais valiosa, já que mais companhias usam essas soluções para fortalecer o relacionamento com clientes, gerar mais leads e, no geral, aumentar o retorno sobre o investimento.
A boa notícia é que o objetivo deste tutorial é justamente ajudar você a desenvolver as habilidades necessárias para executar o modelo Vicuna-13B e integrá-lo a qualquer fluxo de sistemas de informação do negócio.
Antes de partir para a execução do modelo Vicuna-13B, é importante configurar corretamente os pré-requisitos, que incluem:
Depois de atender a esses requisitos, teremos uma noção melhor dos formatos de entrada e saída e poderemos executar o modelo com sucesso.
Compreender melhor o formato de entrada e saída do Vicuna-13B dá ao desenvolvedor um conhecimento mínimo dos fatores que podem afetar as decisões do modelo.
Esta seção explica os principais parâmetros exigidos na entrada, junto com o formato de saída esperado do Vicuna-13B.
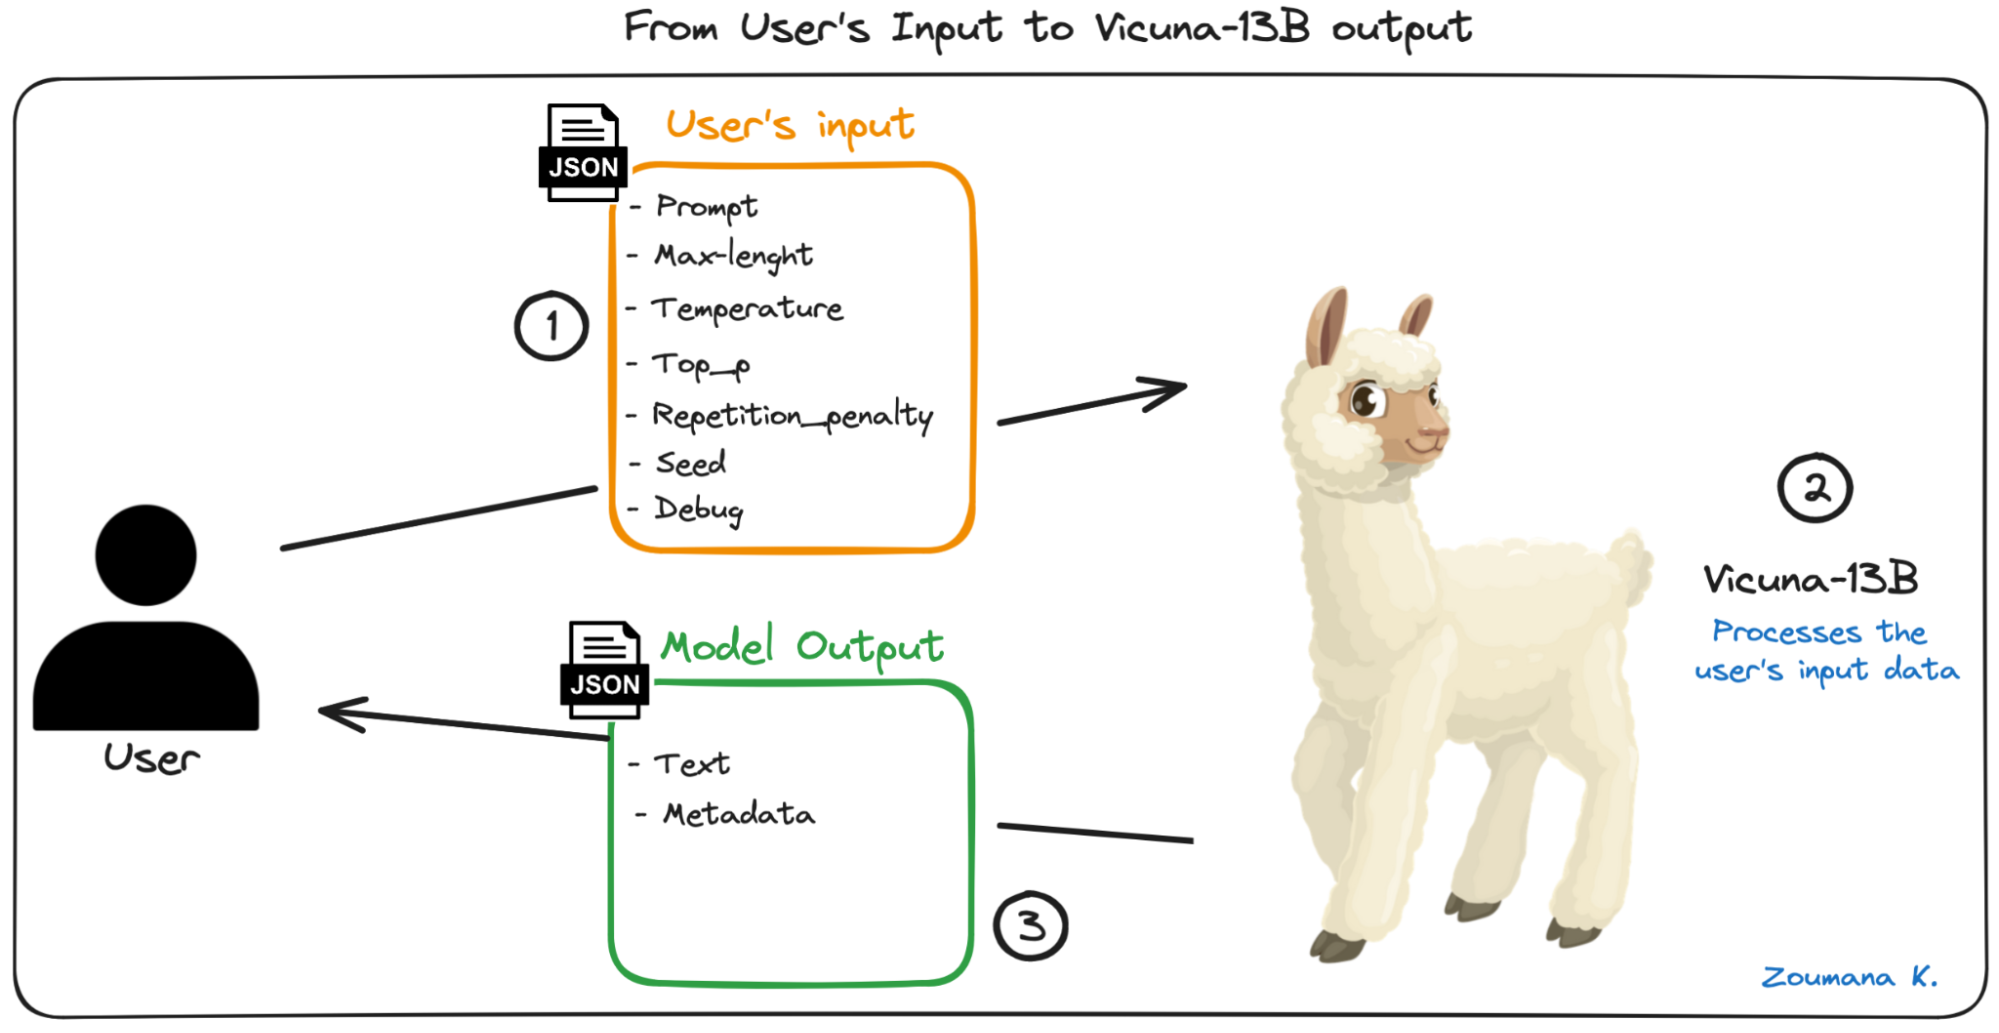
Fluxo minimalista do processo ponta a ponta
Vamos entender o fluxo acima. Primeiro, o usuário envia a entrada desejada, que inclui o prompt, ou seja, a solicitação textual principal para a qual se deseja uma resposta.
O prompt é fornecido junto com os seguintes parâmetros adicionais:
Depois de enviar o prompt com os parâmetros acima, o Vicuna-13B faz o processamento necessário para gerar a saída, que segue o seguinte esquema:
Agora que entendemos melhor a entrada e a saída, podemos identificar as principais bibliotecas para executar o modelo Vicuna com sucesso.
Todos os comandos desta seção são executados no terminal. Com o comando conda create, criamos um ambiente virtual chamado vicuna-env.
conda create --name vicuna-envDepois de criar o ambiente virtual, ativamos o ambiente acima com o comando conda activate, da seguinte forma:
conda activate vicuna-envO comando acima deve exibir o nome do ambiente entre colchetes no início do terminal, como segue:
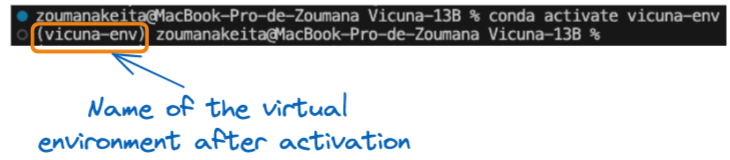
Nome do ambiente virtual após a ativação
As bibliotecas acima podem ser instaladas de duas maneiras. A primeira é executando manualmente o pip install para cada biblioteca, o que pode consumir tempo quando há muitas dependências e não é o ideal em contexto corporativo.
A segunda é a melhor opção: usar um arquivo requirements.txt contendo todas as bibliotecas necessárias. Abaixo está o conteúdo do arquivo e a instalação com um único comando pip install.
# Conteúdo do arquivo requirements.txt

llama-cpp-python==0.1.48
fastapi
uvicorn[standard]
As três bibliotecas podem ser instaladas assim:
pip install -r requirements.txtNa plataforma Hugging Face, podemos baixar os pesos do modelo Vicuna, como mostrado abaixo:
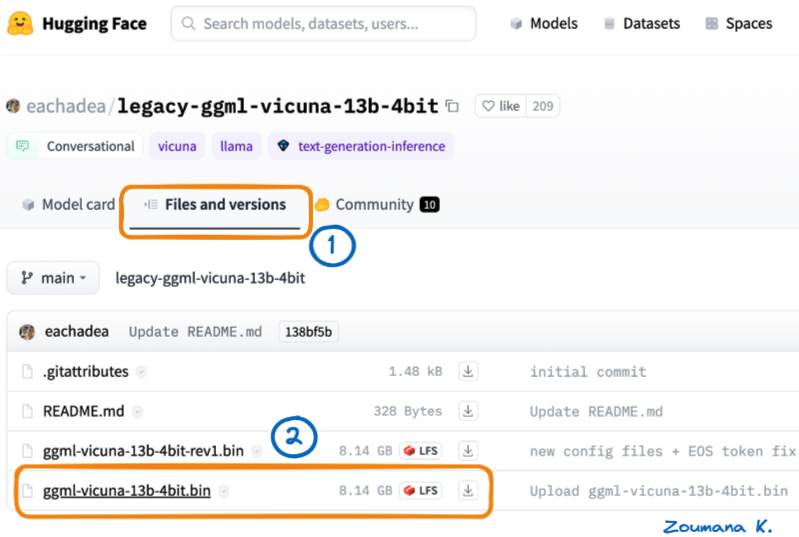
Duas etapas para baixar o Vicuna-13B no Hugging Face
Para organizar melhor o código, podemos mover o arquivo de pesos baixado para uma nova pasta model.
Embora todos os pré-requisitos tenham sido atendidos para executar o modelo via linha de comando, disponibilizá-lo por meio de uma API é uma abordagem mais prática. Isso torna o modelo facilmente acessível a um público muito maior.
Para chegar lá, precisamos dos seguintes passos:
A estrutura geral do código-fonte está abaixo, e o código completo está disponível no GitHub.
------ model
         |------- ggml-vicuna-13b-4bit.bin

------ requirements.txt
------ vicuna_app.py
ggml-vicuna-13b-4bit.bin é o arquivo de pesos do modelo baixado, dentro da pasta modelrequirements.txt contém as dependências para executar o modelovicuna_app.py contém o código Python para criar a API, foco principal desta seção.No nosso caso, são necessárias duas rotas principais. Antes disso, precisamos importar as bibliotecas relevantes, carregar o modelo e criar uma instância do FastAPI.
# Importar as bibliotecas
from fastapi import FastAPI, HTTPException
from llama_cpp import Llama

# Carregar o modelo
vicuna_model_path = "./model/ggml-vicuna-13b-4bit.bin"
vicuna_model = Llama(model_path=vicuna_model_path)

app = FastAPI()"/" retorna o JSON "Message": "Welcome to the Vicuna Demo FastAPI" por meio da função home(), que não recebe parâmetros.# Definir a rota padrão
@app.get("/")
def home():
return {"Message": "Welcome to the Vicuna Demo FastAPI"}"/vicuna_says" é responsável por acionar a função answer_prompt(), que recebe o prompt do usuário como parâmetro e retorna uma resposta em JSON com o resultado do modelo Vicuna e algumas metadados adicionais.@app.post("/vicuna_says")
def answer_prompt(user_prompt):
if (not (user_prompt)):
raise HTTPException(status_code=400,
detail="Please Provide a valid text message")
response = vicuna_model(user_prompt)
return {"Answer": response}Por fim, podemos executar a API com o comando abaixo na linha de comando, a partir da pasta onde está o arquivo vicuna_app.py.
uvicorn vicuna_app:app --reloaduvicorn: inicia o servidor Uvicorn.vicuna_app: corresponde ao arquivo Python vicuna_app.py (à esquerda dos dois-pontos).app: é o objeto criado dentro do arquivo vicuna_app.py com app = FastAPI(). Se o arquivo se chamasse main.py, o comando seria uvicorn main:app --reload.--reload: opção que reinicia o servidor a cada mudança de código. Use apenas em desenvolvimento, não em produção.Abaixo está o resultado ao executar o comando anterior: o servidor está rodando no localhost na porta 8000 (http://127.0.0.1:8000)
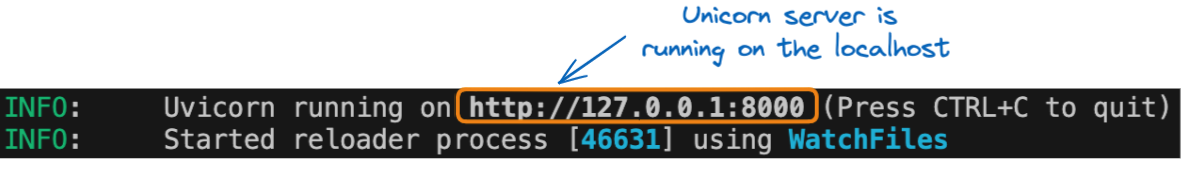
URL da API rodando em localhost
Acessar a rota padrão é simples. Basta digitar a seguinte URL em qualquer navegador.
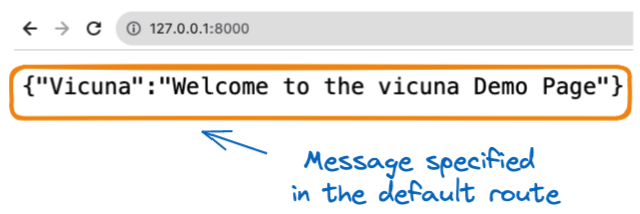
Resposta da rota padrão
Aqui vai uma parte interessante. A URL http://127.0.0.1:8000/docs oferece um painel completo para interagir com a API, conforme abaixo.
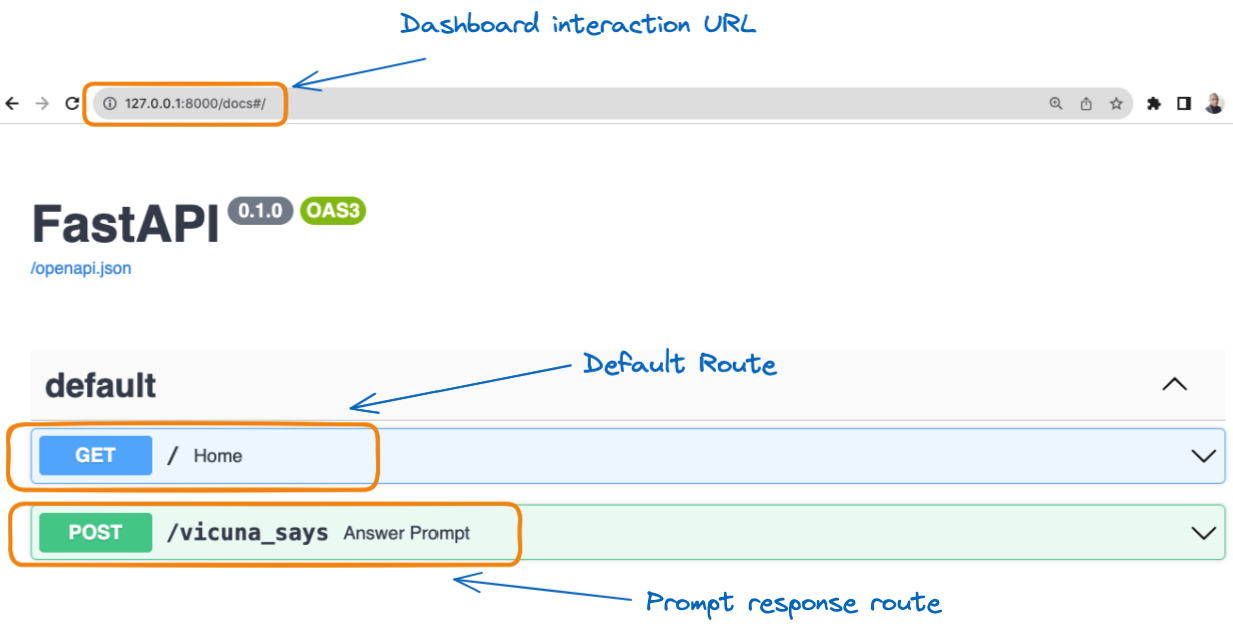
Visualização gráfica das duas rotas
Na imagem anterior, ao selecionar /vicuna_says na caixa verde, vemos um guia completo para interagir com a API, como abaixo.
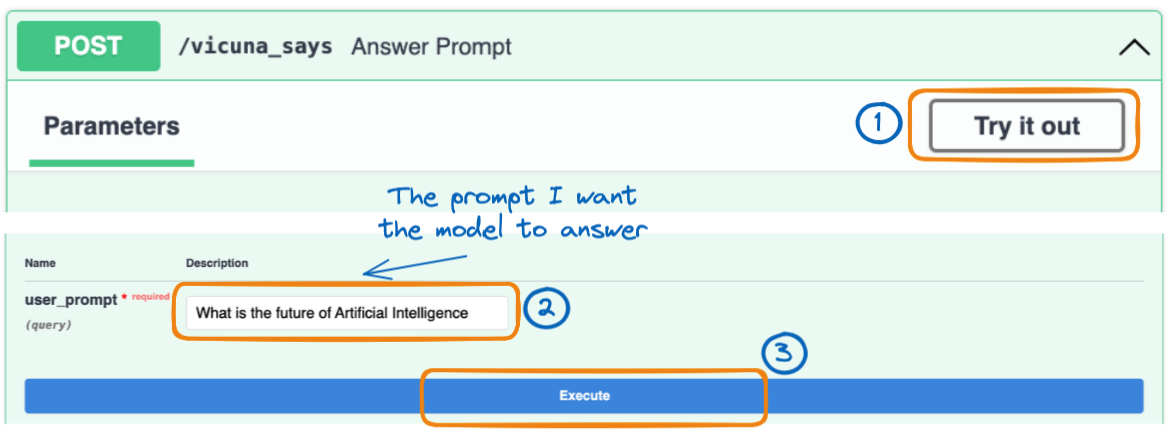
As três etapas para executar o prompt do usuário
Basta selecionar a aba Try it out e fornecer a mensagem para a qual você quer a previsão no campo text_message.
Por fim, obtemos o seguinte resultado ao clicar no botão Execute.
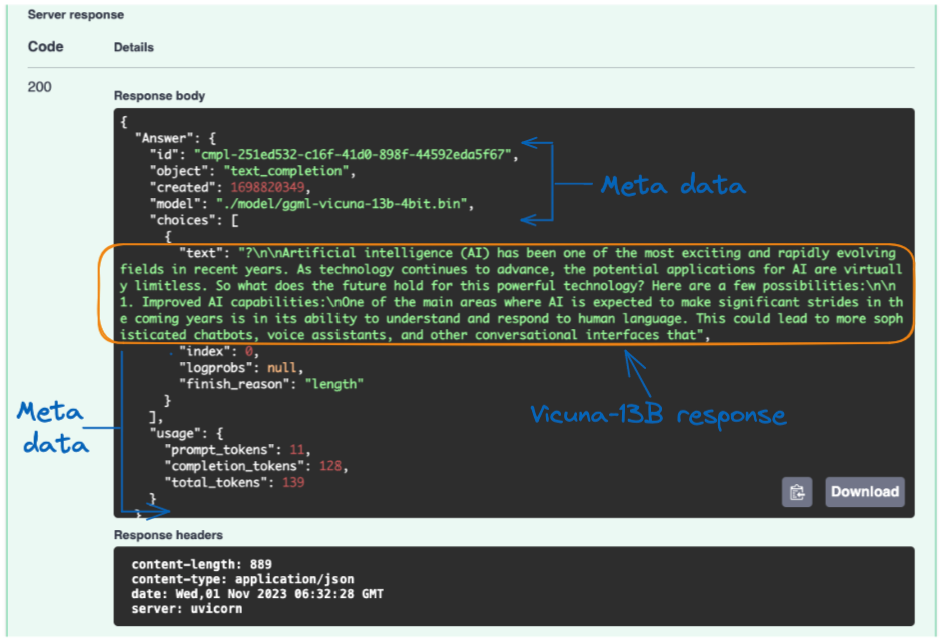
Resposta do servidor do modelo Vicuna para a consulta do usuário
A resposta do modelo Vicuna vem no campo “text”, e o resultado é bem impressionante.
Também são fornecidas metainformações, como o modelo utilizado, a data de criação da resposta, o número de tokens no prompt e o número de tokens na resposta, entre outras.
Fazer o deploy de um modelo poderoso como este melhora a experiência do usuário e a eficiência operacional de várias formas, incluindo as abaixo:
Em resumo, o deploy torna o uso do Vicuna-13B mais acessível, confiável e versátil, ampliando sua aplicabilidade para diferentes usuários e aplicações.
Ao trabalhar com o Vicuna-13B, algumas boas práticas e dicas ajudam desenvolvedores a otimizar a experiência, melhorar resultados e resolver problemas comuns.
Seguindo estas recomendações, você garante uma experiência mais fluida e melhores resultados ao usar o Vicuna-13B.
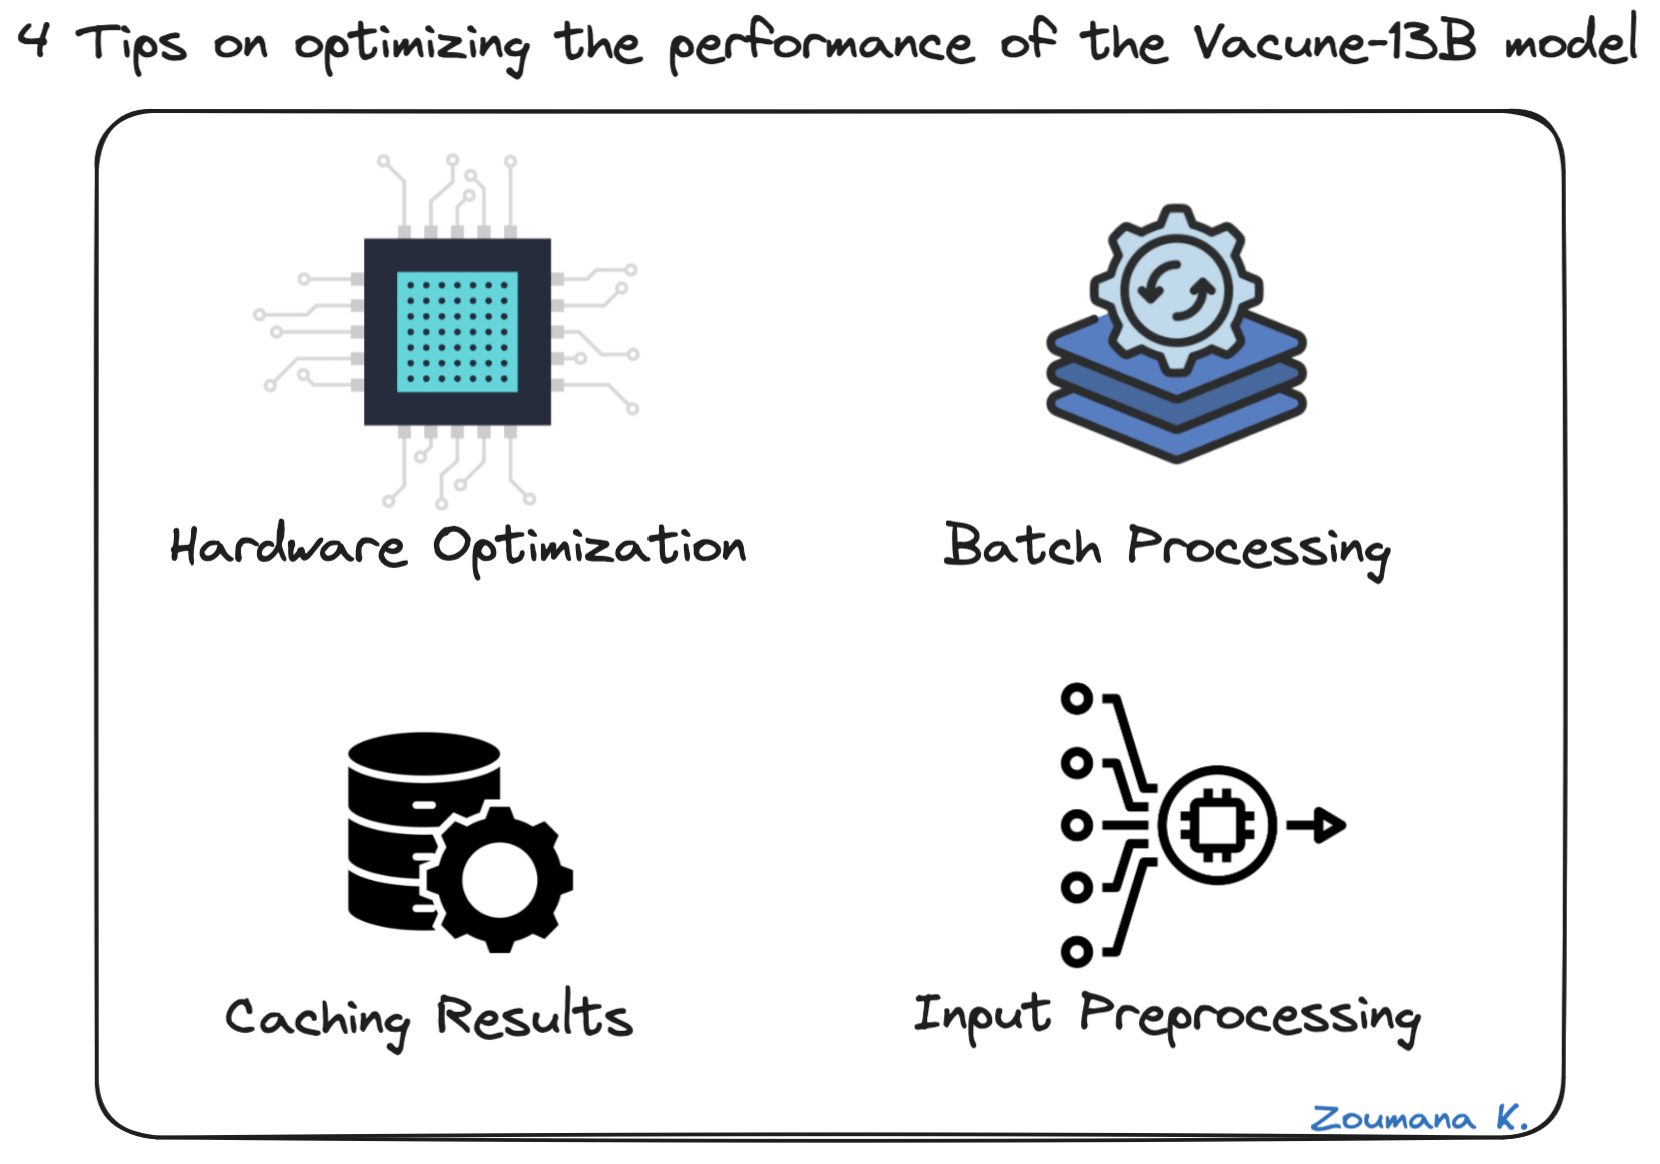
4 dicas para otimizar o desempenho do Vicuna-13B
Além da otimização de desempenho, é importante saber solucionar problemas recorrentes que podem surgir no uso do Vicuna-13B. Quatro exemplos:
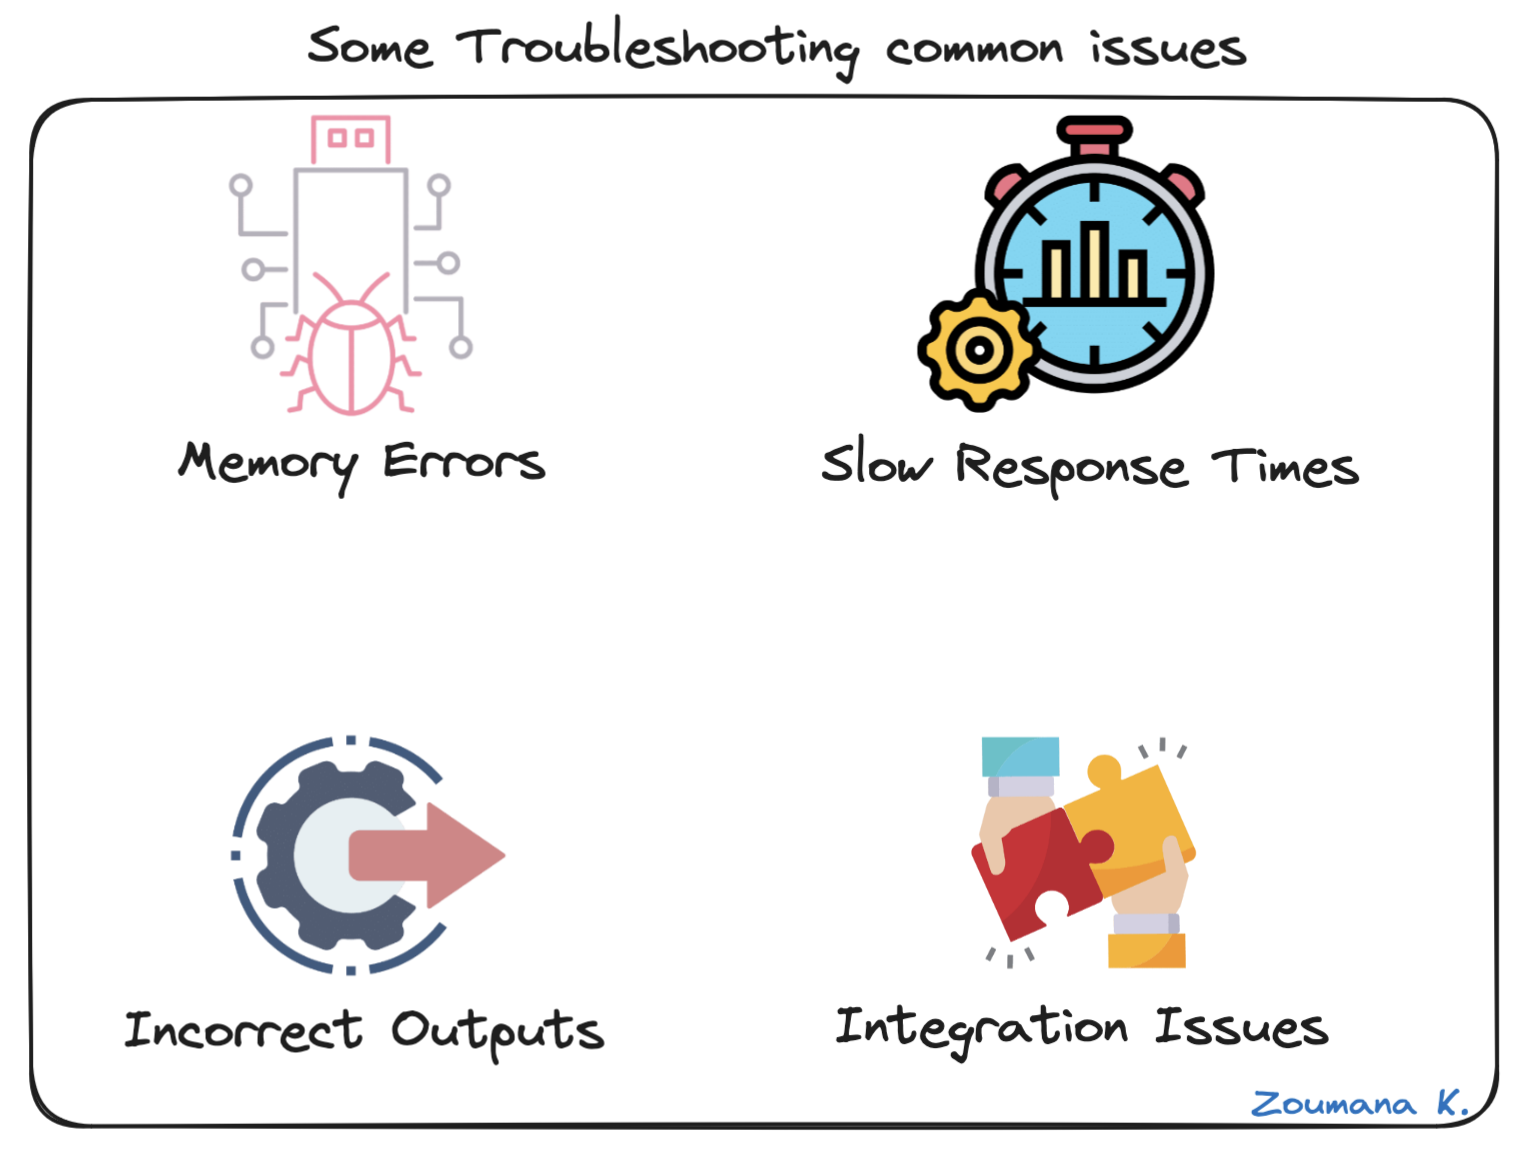
Alguns problemas comuns de troubleshooting
Em resumo, este artigo trouxe uma visão abrangente sobre como configurar e utilizar o Vicuna-13B. Cobrimos os pré-requisitos necessários, incluindo hardware, software e a obtenção dos pesos do LLaMa, essenciais para executar o modelo com sucesso.
Fornecemos instruções detalhadas para preparar o ambiente de trabalho, instalar o software necessário e configurar os pesos do Vicuna-13B, enfatizando a importância dos weights em modelos de linguagem.
Também abordamos o empacotamento e o deploy do Vicuna-13B, destacando como o deploy facilita seu uso via interface web e API.
Por fim, compartilhamos insights práticos para interagir com o Vicuna-13B, exemplos de suas capacidades, além de boas práticas para otimizar o desempenho e solucionar problemas comuns.
Quer se aprofundar no mundo da IA e do machine learning? Potencialize suas habilidades com o framework de deep learning usado por profissionais de IA. Inscreva-se hoje no curso Deep Learning with PyTorch.
Comece sua jornada em IA hoje!
Curso
Programa
Curso
Tutorial
Moez Ali
11 min
Tutorial
Moez Ali
13 min
Tutorial
Zoumana Keita
11 min
Tutorial
Ryan Ong
12 min
Tutorial
Abid Ali Awan
8 min
Tutorial
Zoumana Keita
7 min