
Cursus
Artificial Intelligence begrijpen
2 uur
427K
De opkomst van grote taalmodellen heeft sectoren getransformeerd en de kracht van technologieën zoals GPT-3.5 en GPT-4 van OpenAI naar uiteenlopende toepassingen gebracht. Toch schrikken de hoge kosten en zorgen over dataconfidentialiteit potentiële gebruikers vaak af. Daar komen open-sourcemodellen zoals Vicuna-13B in beeld: ze bieden vergelijkbare prestaties zonder de hoge kosten en het risico voor gevoelige informatie.
Wil je meer weten over GPT-3.5 en GPT-4? Onze tutorial GPT-3.5 en GPT-4 gebruiken via de OpenAI API in Python is een goed startpunt om te leren werken met het OpenAI Python-pakket en om programmatic met ChatGPT te praten.
Vicuna-13B is een open-source conversatiemodel dat is getraind door het LLaMa 13B-model te fine-tunen met door gebruikers gedeelde gesprekken die zijn verzameld via ShareGPT.
Een voorlopige evaluatie waarbij GPT-4 als jurylid fungeerde, liet zien dat Vicuna-13B meer dan 90% van de kwaliteit van chatGPT en Google Bard behaalde, en vervolgens modellen zoals LLaMa en Alpaca in meer dan 90% van de gevallen overtrof. De algehele fine-tuning- en evaluatieworkflow is hieronder weergegeven:
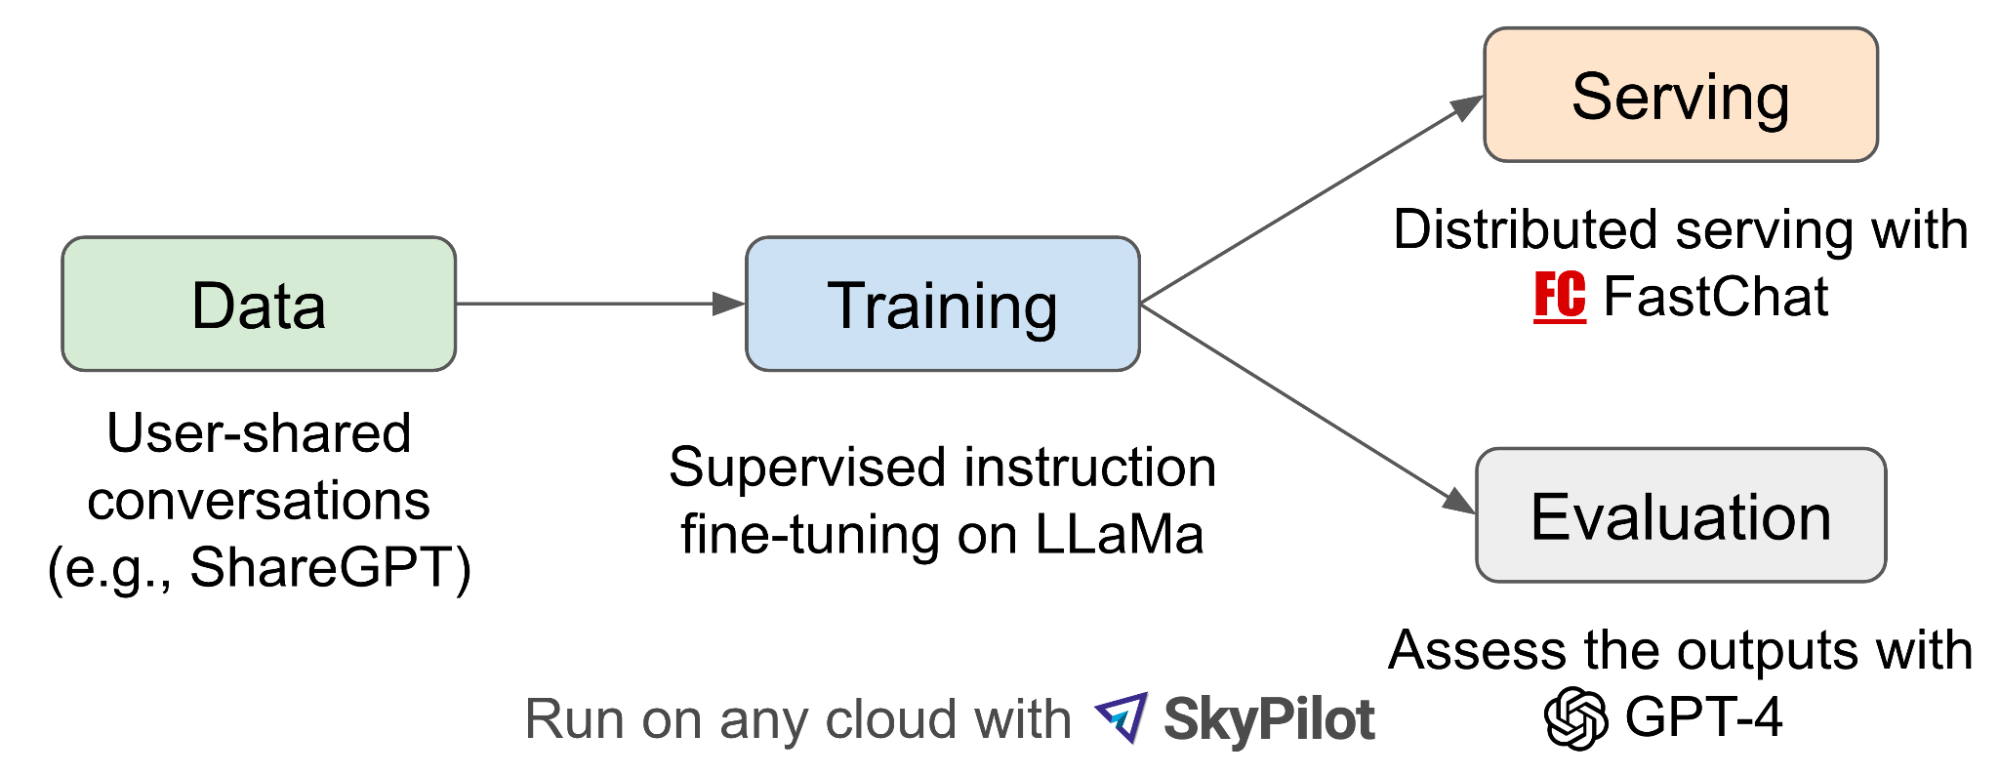
Vicuna-13B fine-tuning en evaluatieworkflow (bron)
Hoewel dit de kracht van Vicuna-13B benadrukt, heeft het ook zijn beperkingen en is het niet beperkt tot taken zoals wiskunde en redeneren.
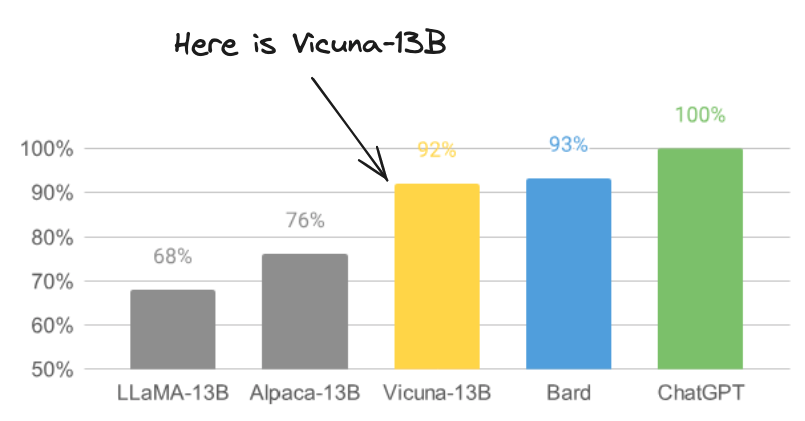
Afbeelding van LMSYSORG bewerkt door auteur
Als slimme chatbot zijn de toepassingen van Vicuna-13B ontelbaar. Hieronder zie je enkele voorbeelden in verschillende sectoren, zoals klantenservice, gezondheidszorg, onderwijs, financiën en reizen/hospitality.
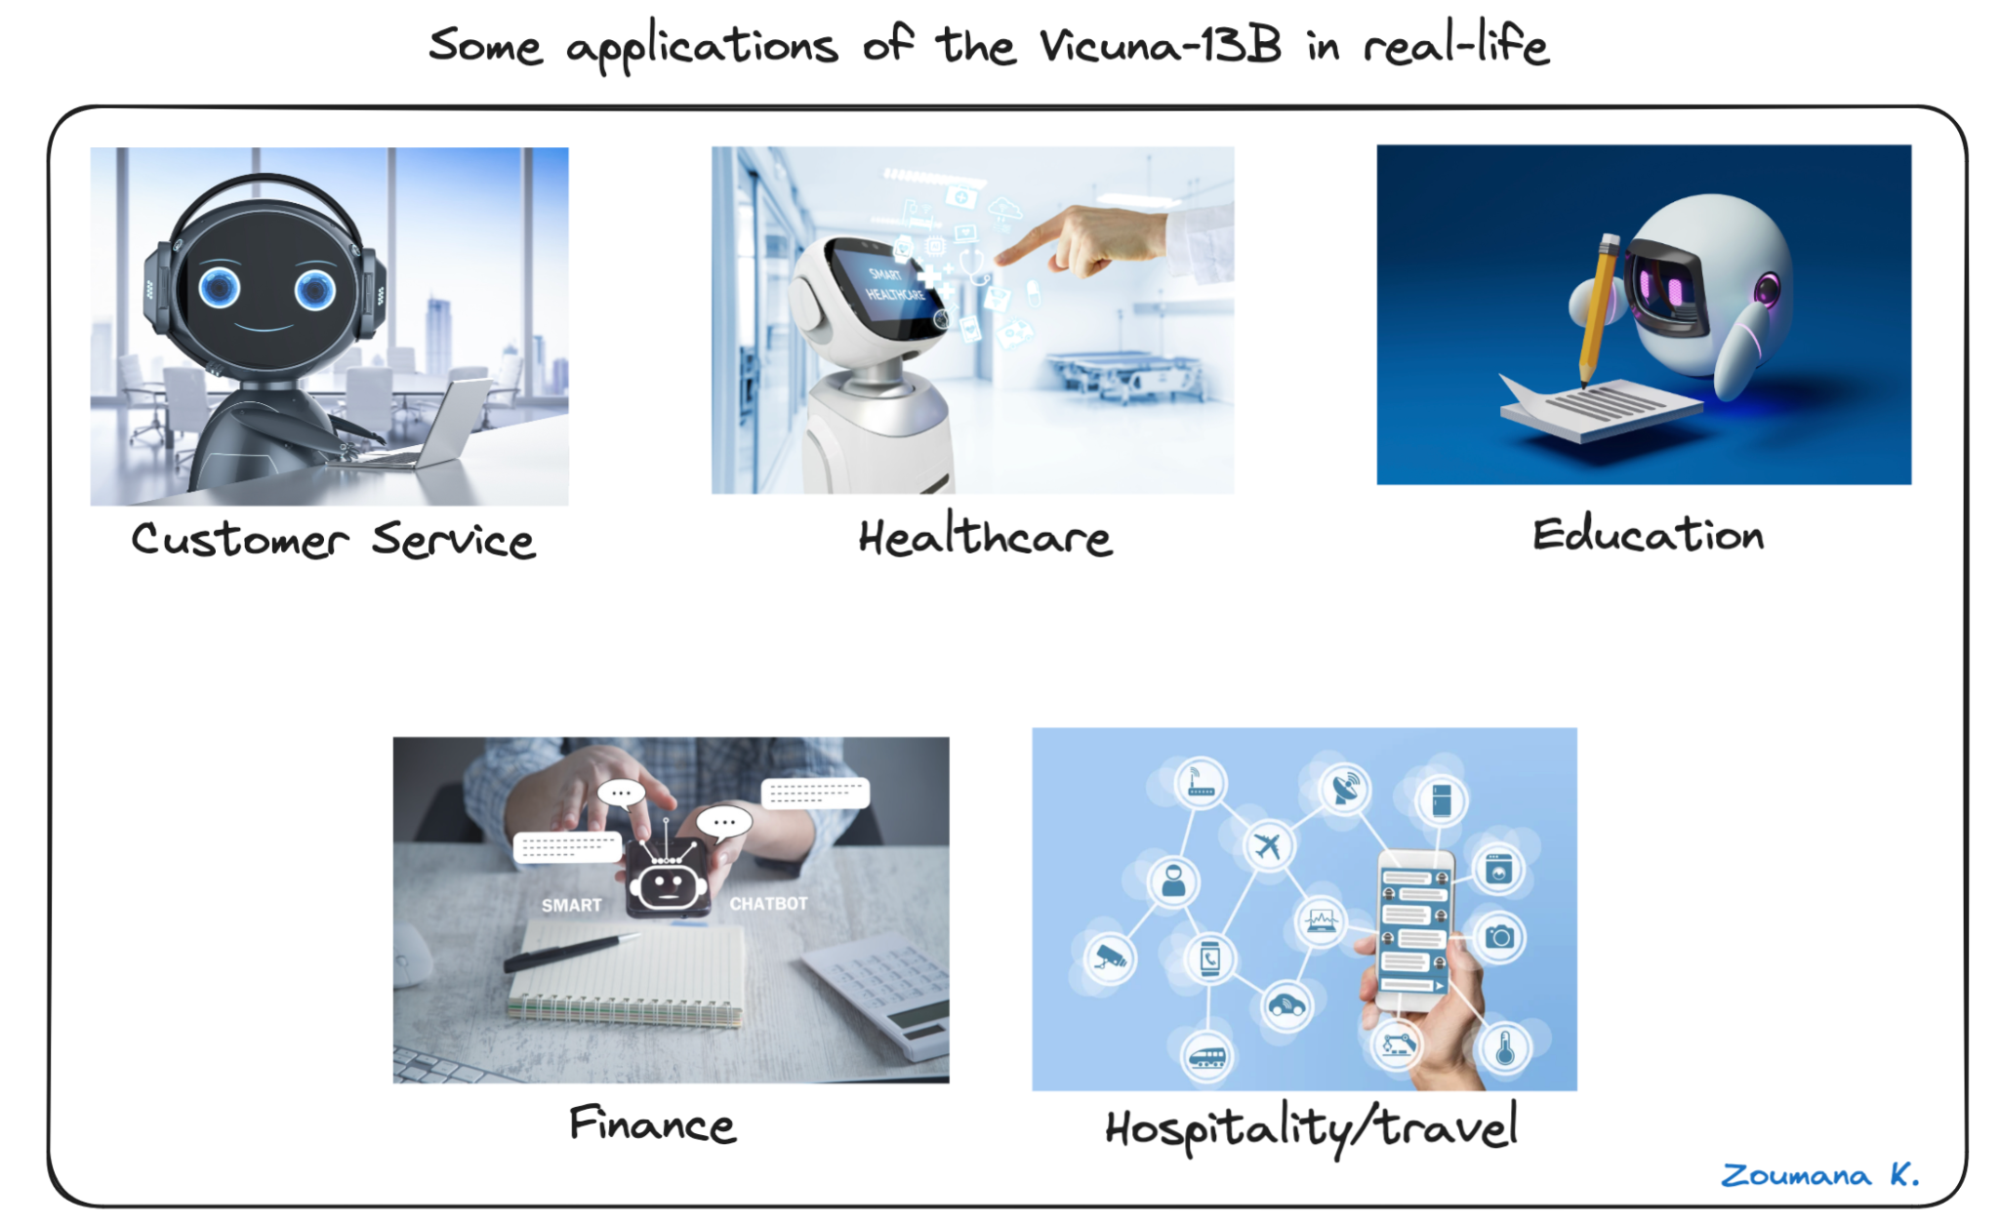
Vijf verschillende toepassingen van Vicuna-13 in het echte leven
Bovenstaande lijst is niet uitputtend. In ons artikel Hoe NLP de toekomst van data science verandert bespreken we hoe NLP de toekomst van data science en machine learning aanstuurt, de toekomstige toepassingen, risico’s en hoe je die kunt beperken.
Gebaseerd op deze real-life toepassingen is het duidelijk dat er een enorme vraag is naar door AI aangedreven conversatieagents zoals Vicuna-13B in grote sectoren.
Daarom wordt het beheersen van de implementatie en integratie van zulke technologie in een bedrijfsworkflow een steeds belangrijkere vaardigheid, nu meer bedrijven deze technologieën inzetten om klantinteracties te versterken, meer leads te genereren en hun rendement te verhogen.
Het goede nieuws: het doel van deze tutorial is je te helpen de vereiste skills te ontwikkelen om het Vicuna-13B-model te draaien en het te kunnen integreren in elke bedrijfsinformatiesysteem-workflow.
Voordat we ingaan op het draaien van het Vicuna-13B-model, is het belangrijk om de vereisten goed in te richten. Dat omvat:
Zodra aan deze vereisten is voldaan, begrijpen we beter de input- en outputformaten en kunnen we het model succesvol draaien.
Een beter begrip van het input- en outputformaat van Vicuna-13B geeft de ontwikkelaar basiskennis van de factoren die de besluitvorming van het model kunnen beïnvloeden.
In deze sectie bespreken we de belangrijkste vereiste parameters in de input en het verwachte outputformaat van het Vicuna-13B-model.
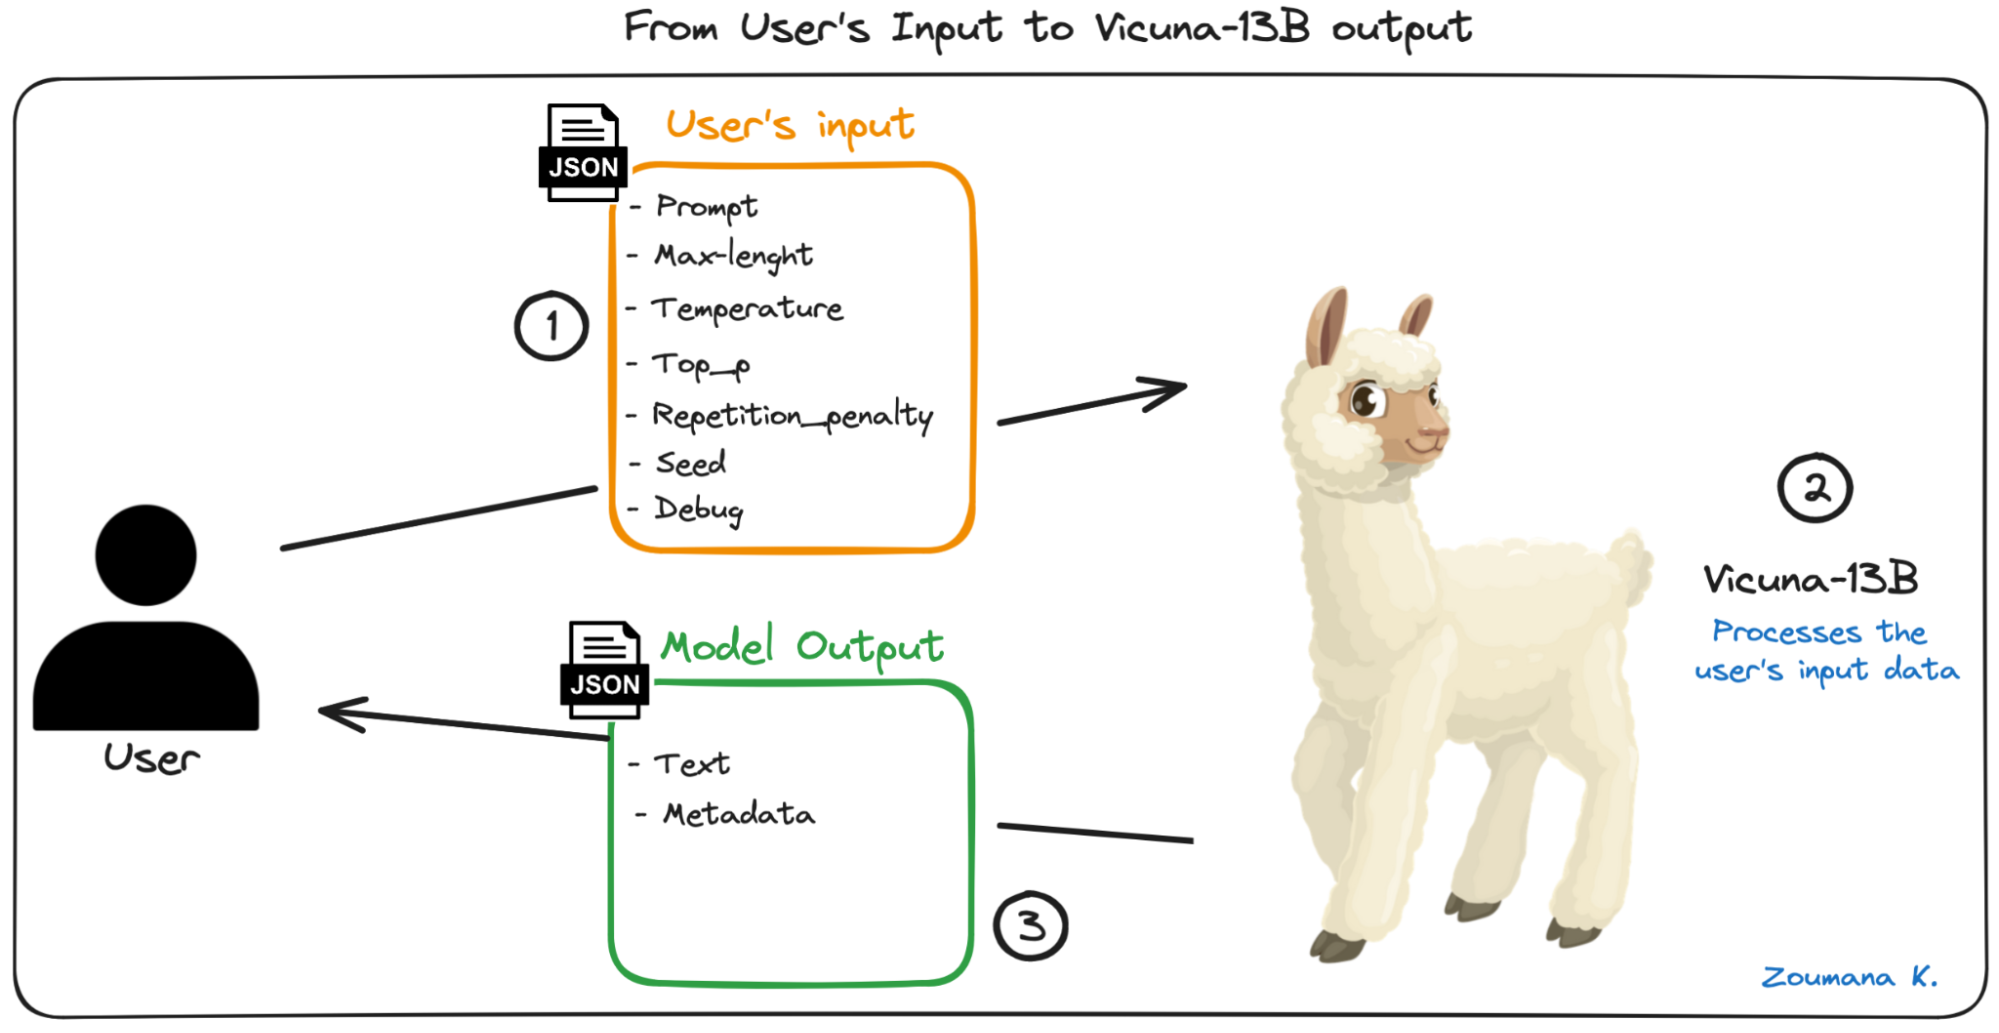
Minimalistische workflow van de end-to-end-workflow
Laten we de bovenstaande workflow begrijpen. Eerst voert de gebruiker de gewenste input in, inclusief de prompt, de hoofdvraag in tekstvorm waarop de gebruiker antwoord wil.
De prompt wordt aangevuld met de volgende parameters:
Na het indienen van de prompt met bovenstaande parameters voert het Vicuna-13B-model de benodigde verwerking uit om de vereiste output te genereren, volgens het volgende schema:
Nu we het input- en outputformaat beter begrijpen, kunnen we de belangrijkste libraries identificeren om het Vicuna-model succesvol te draaien.
Alle opdrachten in deze sectie voer je uit in een terminal. Met het commando conda create maken we een virtuele omgeving met de naam vicuna-env.
conda create --name vicuna-envNa het succesvol aanmaken van de virtuele omgeving activeren we die met het commando conda activate, als volgt:
conda activate vicuna-envBovenstaand commando zou de naam van de omgevingsvariabele tussen haakjes aan het begin van de terminal moeten tonen, als volgt:
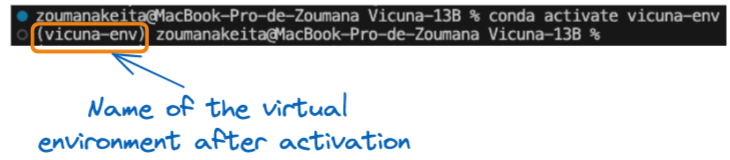
Naam van de virtuele omgeving na activatie
De bovenstaande libraries kun je op twee manieren installeren. De eerste is door handmatig pip install uit te voeren voor elke library. Dat kan tijdrovend zijn bij veel libraries en is niet optimaal op industrieel niveau.
De tweede manier is de beste optie en gebruikt een requirements.txt-bestand met alle vereiste libraries. Hieronder staat de inhoud van het requirements.txt-bestand en de installatie met één enkel pip install-commando.
# Content of the requirements.txt file

llama-cpp-python==0.1.48
fastapi
uvicorn[standard]
Alle drie de libraries kun je als volgt installeren:
pip install -r requirements.txtVia het Hugging Face-platform kunnen we de gewichten van het Vicuna-model downloaden, zoals hieronder getoond:
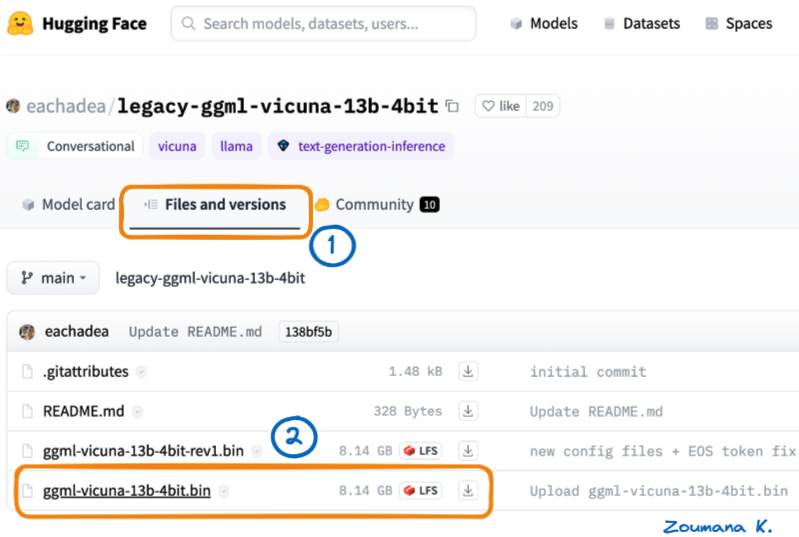
Twee hoofd-stappen om Vicuna-13B-gewichten te downloaden van Hugging Face
Voor een betere organisatie van de code kunnen we het gedownloade modelgewicht verplaatsen naar een nieuwe map model.
Hoewel alle vereisten zijn ingevuld om het model via de command line te draaien, is het uitrollen van een API die met het model communiceert een praktischer aanpak. Zo wordt het model eenvoudiger toegankelijk voor een breder publiek.
Om dat niveau te bereiken, hebben we de volgende stappen nodig:
De algehele structuur van de broncode staat hieronder. De complete code is beschikbaar op GitHub.
------ model
         |------- ggml-vicuna-13b-4bit.bin

------ requirements.txt
------ vicuna_app.py
ggml-vicuna-13b-4bit.bin is het gedownloade modelgewicht in de modelmaprequirements.txt bevat de afhankelijkheden om het model te draaienvicuna_app.py bevat de Python-code om de API te maken; dat is de hoofdzaak van deze sectie.In ons geval zijn de volgende twee hoofdroutes nodig. Daarvoor moeten we eerst de relevante libraries importeren, het model laden en een instantie van het FastAPI-module maken.
# Import the libraries
from fastapi import FastAPI, HTTPException
from llama_cpp import Llama

# Load the model
vicuna_model_path = "./model/ggml-vicuna-13b-4bit.bin"
vicuna_model = Llama(model_path=vicuna_model_path)

app = FastAPI()"/” retourneert het volgende JSON-formaat “Message”: “Welcome to the Vicuna Demo FastAPI” via de functie home(), die geen parameter aanneemt.# Define the default route
@app.get("/")
def home():
return {"Message": "Welcome to the Vicuna Demo FastAPI"}/vicuna_says” die verantwoordelijk is voor het triggeren van de functie answer_prompt(), die als parameter de prompt van de gebruiker aanneemt en een JSON-respons retourneert met het resultaat van het Vicuna-model en extra metadata.@app.post("/vicuna_says")
def answer_prompt(user_prompt):
if (not (user_prompt)):
raise HTTPException(status_code=400,
detail="Please Provide a valid text message")
response = vicuna_model(user_prompt)
return {"Answer": response}We kunnen de API nu draaien met het volgende commando in de command line, vanuit de locatie van het bestand vicuna_app.py.
uvicorn vicuna_app:app --reloaduvicorn start de Uvicorn-server.vicuna_app: komt overeen met het Pythonbestand vicuna_app.py. Dit staat links van de “:”.app: is het object dat in vicuna_app.py is aangemaakt met app = FastAPI(). Als de bestandsnaam main.py was, zou het commando uvicorn main:app --reload zijn.--reload: optie om de server te herstarten na codewijzigingen. Gebruik dit alleen tijdens ontwikkeling, niet tijdens productie.Hier is het resultaat van het bovenstaande commando: we zien dat de server draait op localhost op poort 8000 (http://127.0.0.1:8000)
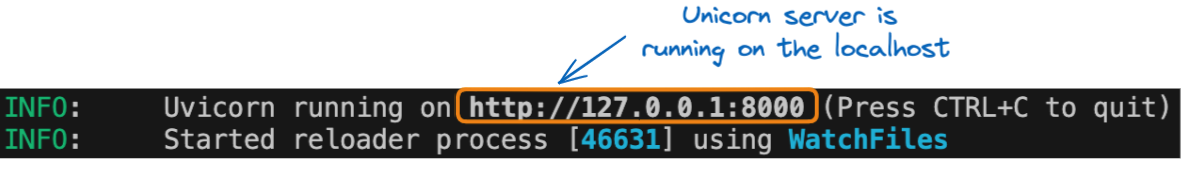
URL van de API die lokaal draait
De standaardroute openen is eenvoudig. Typ de volgende URL in een willekeurige browser.
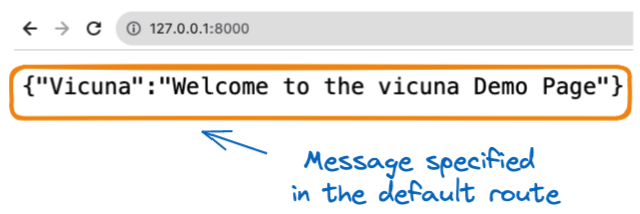
Respons van de standaardroute
Nu een interessant deel. De URL http://127.0.0.1:8000/docs biedt een compleet dashboard om met de API te interageren. Hieronder zie je het resultaat.
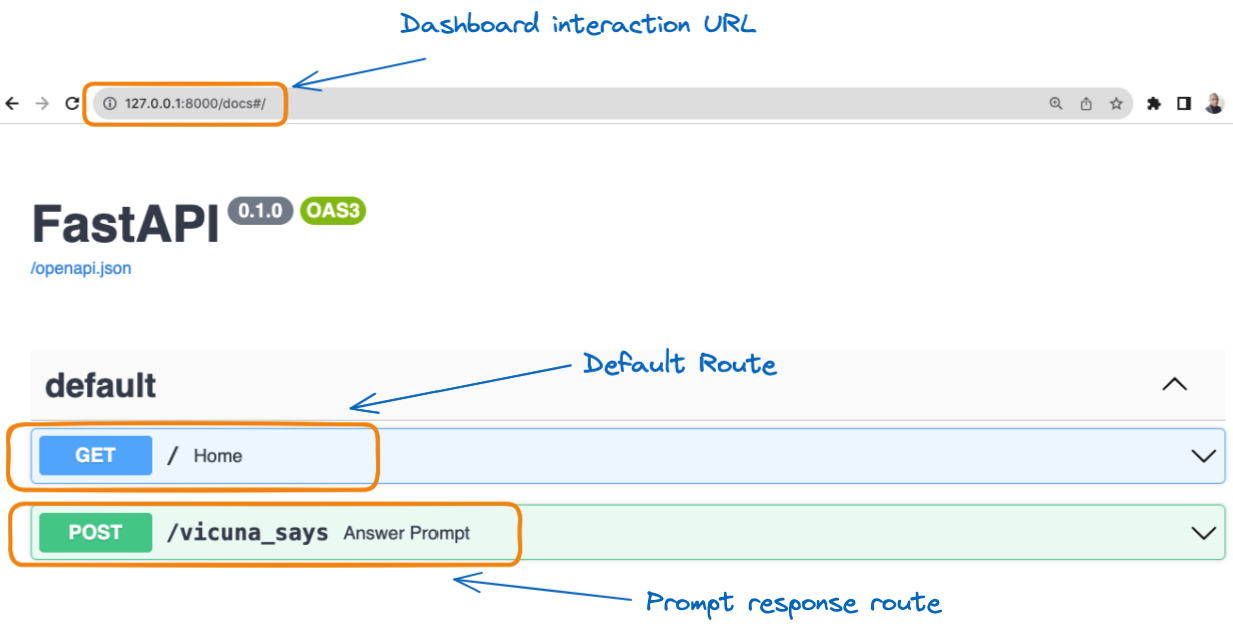
Grafische visualisatie van de twee routes
Op de vorige afbeelding: als we /vicuna_says in het groene vak selecteren, krijgen we de complete gids om met onze API te werken, zoals hieronder getoond.
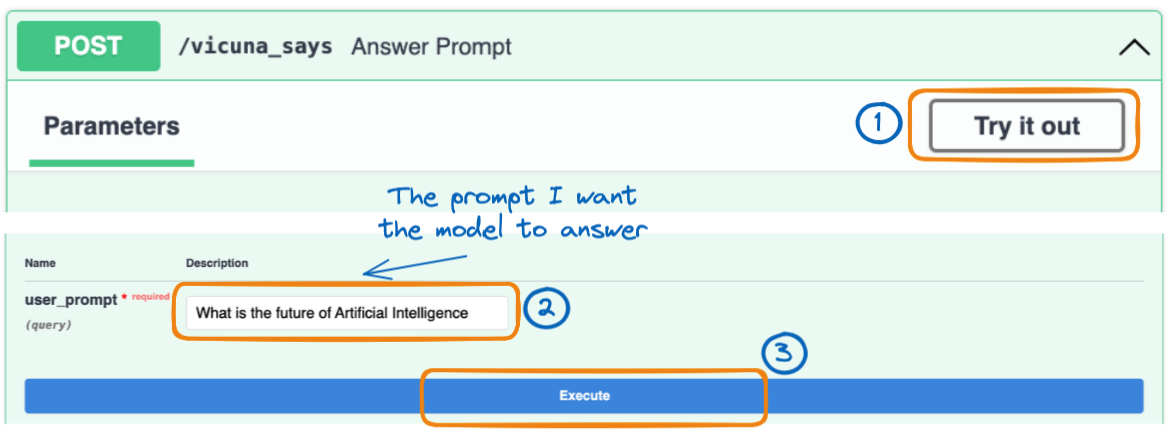
De drie hoofd-stappen om de prompt van de gebruiker uit te voeren
Selecteer gewoon het tabblad Try it out en geef het bericht op waarvoor je een voorspelling wilt in het veld text_message.
Na het selecteren van Execute krijgen we het volgende resultaat.
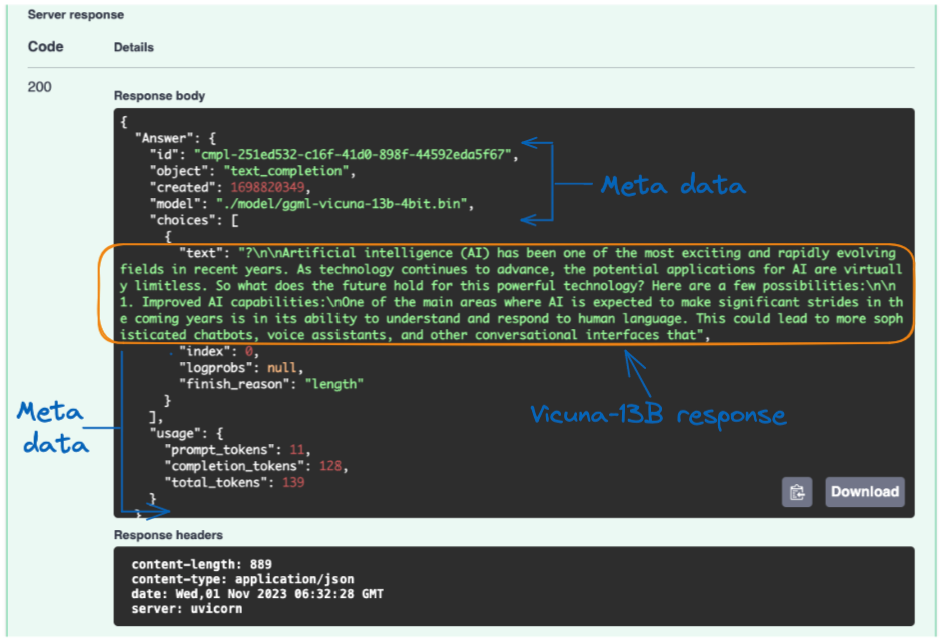
Serverrespons van het Vicuna-model op de vraag van de gebruiker
De respons van het Vicuna-model staat in het veld “text”, en het resultaat ziet er indrukwekkend uit.
Er wordt extra metadata gegeven, zoals het gebruikte model, de aanmaakdatum van de respons, het aantal tokens in de prompt en het aantal tokens in de respons, om er een paar te noemen.
Het uitrollen van zo’n krachtig model verbetert de gebruikerservaring en operationele efficiëntie op verschillende manieren, onder meer de volgende:
Kortom, uitrol maakt het gebruik van het Vicuna-13B-model toegankelijker, betrouwbaarder en veelzijdiger, waardoor het breder inzetbaar is voor verschillende gebruikers en toepassingen.
Bij het werken met het Vicuna-13B-model helpen enkele best practices en tips ontwikkelaars om hun ervaring en resultaten te optimaliseren en veelvoorkomende problemen op te lossen.
Door deze best practices en tips te volgen, zorg je voor een soepelere ervaring en betere resultaten met het Vicuna-13B-model.
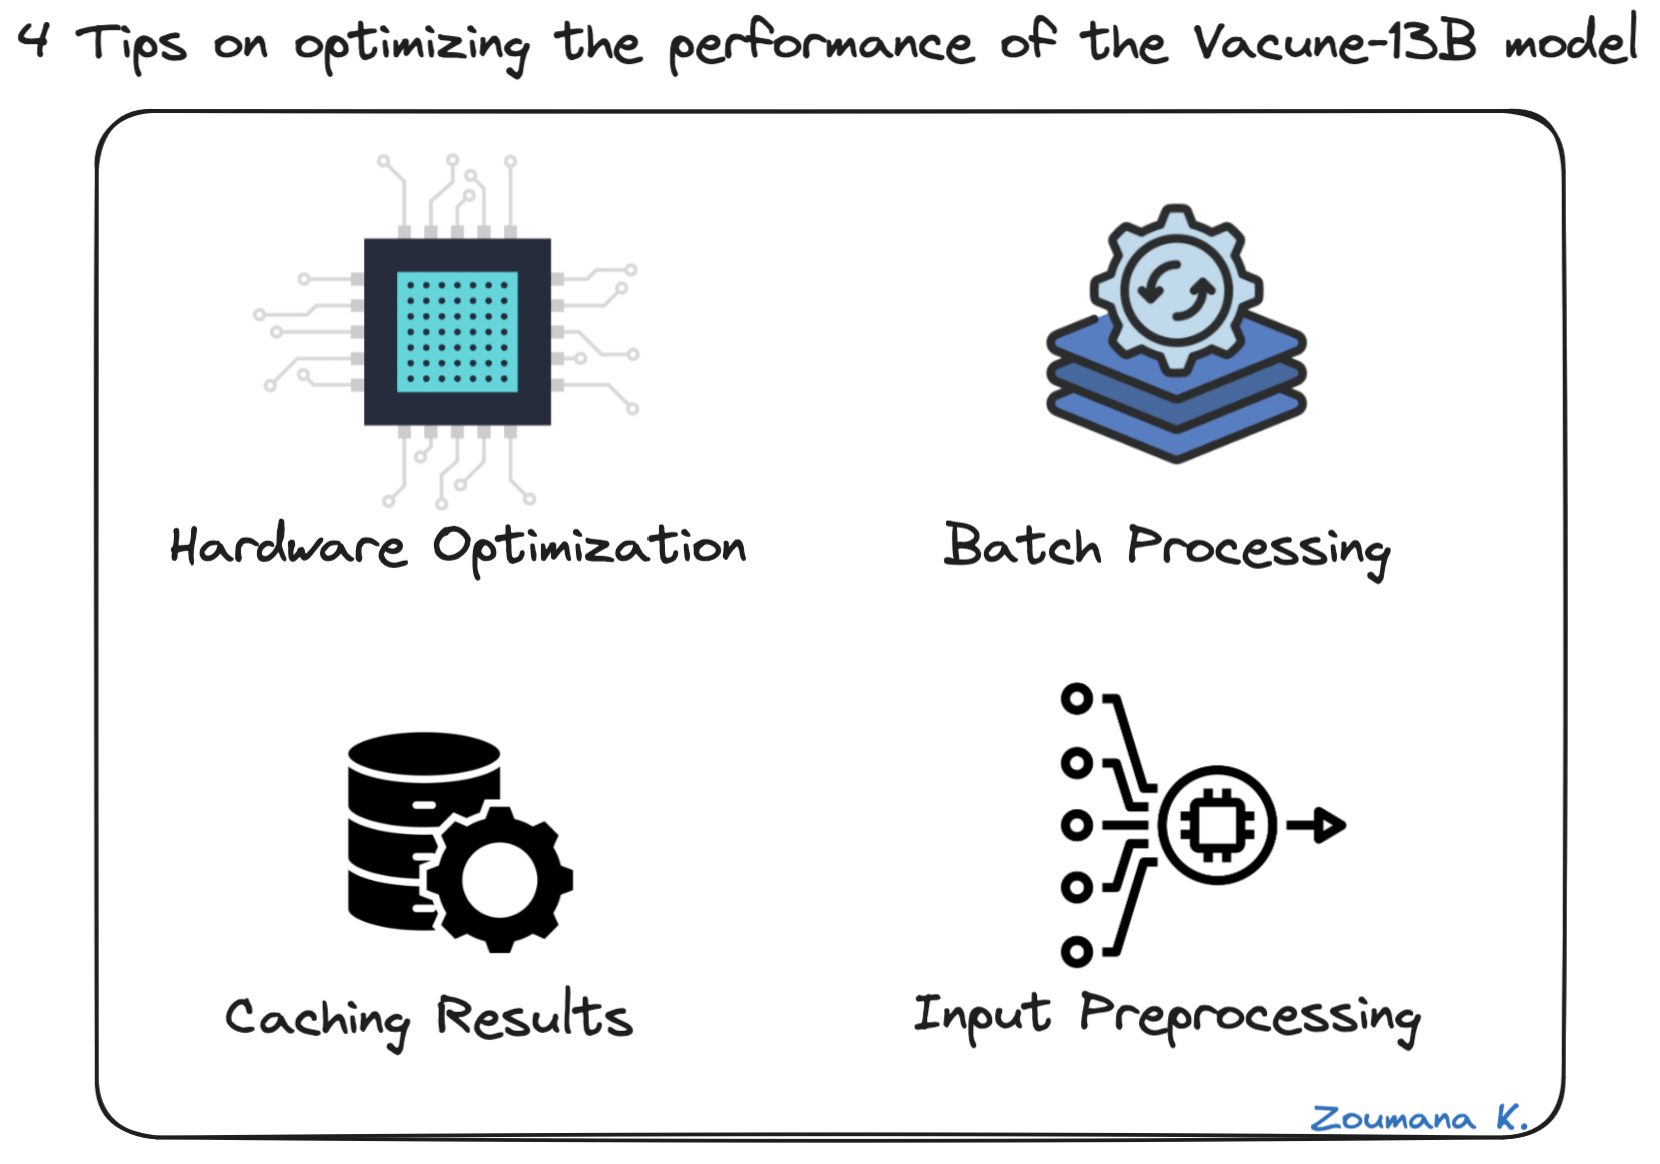
4 tips om de prestaties van het Vicuna-13B-model te optimaliseren
Naast prestatie-optimalisatie is het belangrijk om veelvoorkomende problemen die kunnen optreden bij het gebruik van Vicuna-13B te kunnen troubleshooten. Hieronder vier voorbeelden:
Enkele veelvoorkomende troubleshooting-problemen
Samengevat heeft dit artikel een uitgebreid overzicht gegeven van het opzetten en gebruiken van het Vicuna-13B-model. We behandelden de benodigde vereisten, waaronder hardware, software en het verkrijgen van de LLaMa-gewichten die essentieel zijn om het model succesvol te draaien.
We gaven gedetailleerde instructies voor het inrichten van de werkomgeving, het installeren van de vereiste software en het instellen van de gewichten van Vicuna-13B, met nadruk op het belang van gewichten in taalmodellen.
Daarnaast gingen we in op het packagen en deployen van Vicuna-13B en hoe deployment het gebruik als webinterface en API faciliteert.
Tot slot deelden we praktische inzichten in de interactie met Vicuna-13B, voorbeelden van zijn mogelijkheden en best practices om de prestaties te optimaliseren en veelvoorkomende problemen op te lossen.
Klaar om dieper te duiken in de wereld van AI en machine learning? Versterk je skills met het krachtige deep-learningframework dat door AI-professionals wordt gebruikt. Volg vandaag nog de cursus Deep Learning met PyTorch.
Begin vandaag nog met je AI-reis!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

