Curso
Comprender la inteligencia artificial
2 h
421.7K
La irrupción de los grandes modelos de lenguaje ha transformado sectores enteros, llevando el potencial de tecnologías como GPT-3.5 y GPT-4 de OpenAI a multitud de aplicaciones. Sin embargo, su alto coste y las preocupaciones sobre la confidencialidad de los datos suelen frenar a posibles adoptantes. Ahí es donde entran los modelos de código abierto como Vicuna-13B, que ofrecen un rendimiento comparable sin el gasto ni el riesgo para la información sensible.
Si quieres saber más sobre GPT-3.5 y GPT-4, nuestro tutorial Using GPT-3.5 and GPT-4 via the OpenAI API in Python es un buen punto de partida para entender cómo trabajar con el paquete de Python de OpenAI y conversar con ChatGPT de forma programática.
Vicuna-13B es un modelo conversacional de código abierto, ajustado a partir de LLaMa 13B utilizando conversaciones compartidas por usuarios obtenidas de ShareGPT.
Una evaluación preliminar con GPT-4 como juez mostró que Vicuna-13B alcanzaba más del 90% de la calidad de chatGPT y Google Bard, superando además a otros modelos como LLaMa y Alpaca en más del 90% de los casos. A continuación se ilustra el flujo completo de ajuste fino y evaluación:
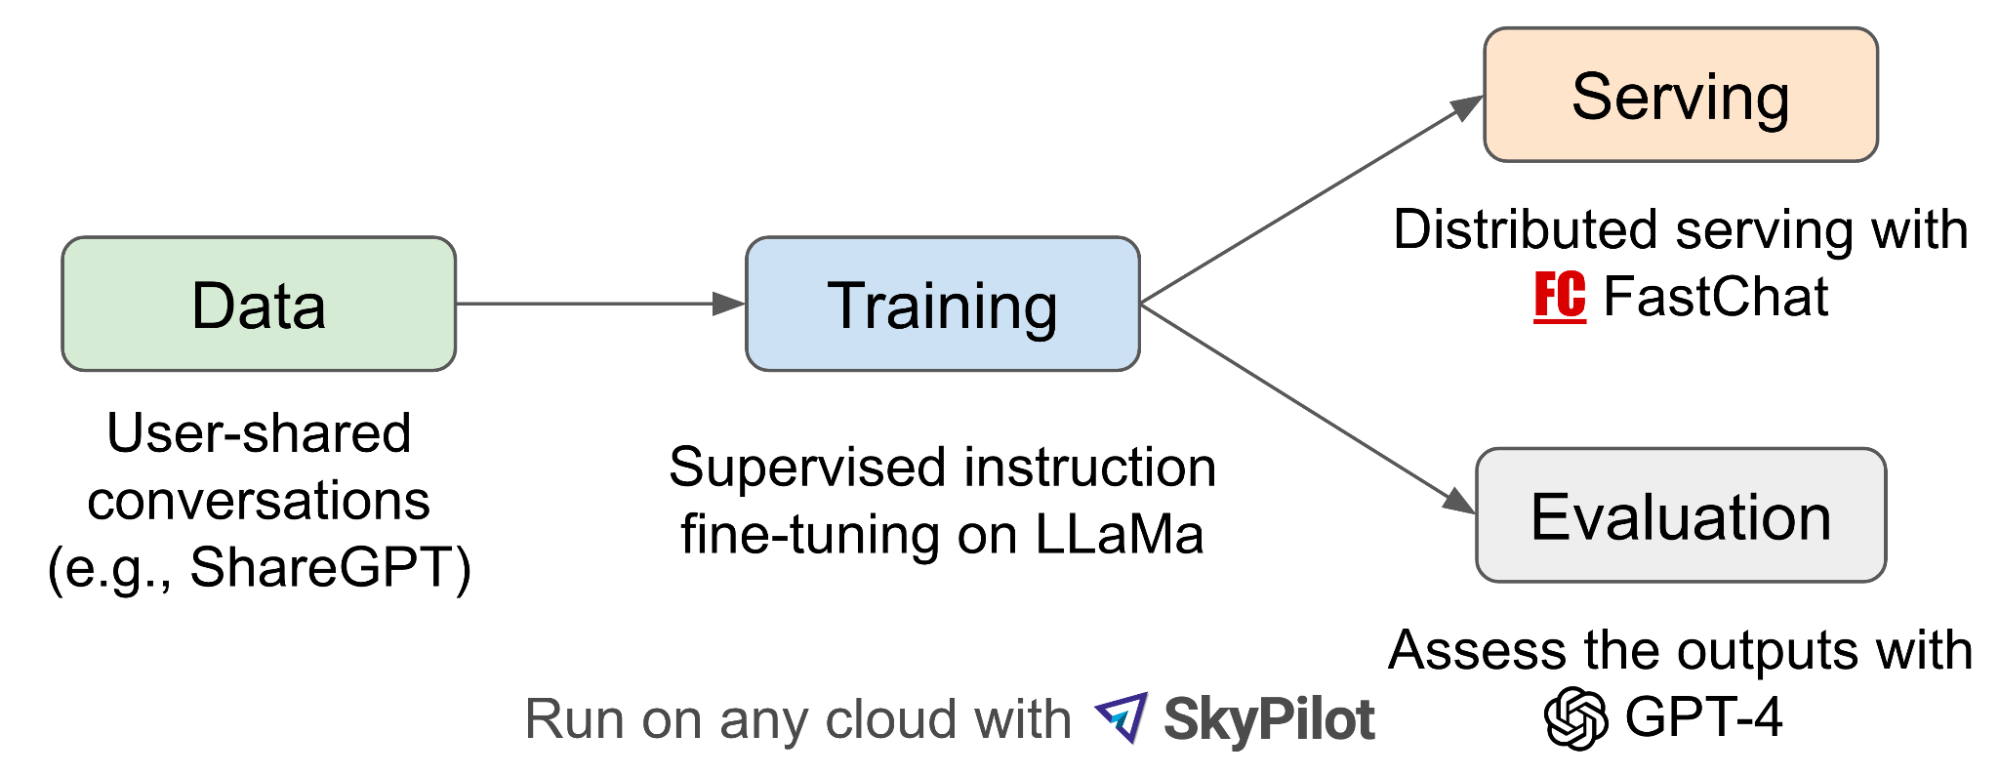
Flujo de ajuste fino y evaluación de Vicuna-13B (fuente)
Aunque esto pone de relieve la solidez de Vicuna-13B, también tiene limitaciones propias y no está especializado en tareas como matemáticas y razonamiento.
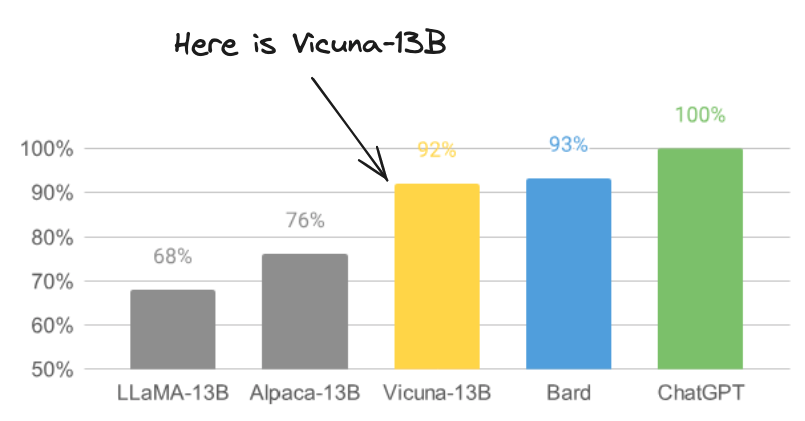
Imagen de LMSYSORG modificada por el autor
Como chatbot inteligente, las aplicaciones de Vicuna-13B son innumerables. A continuación se muestran algunos ejemplos en distintos sectores como atención al cliente, salud, educación, finanzas y viajes/hospitalidad.
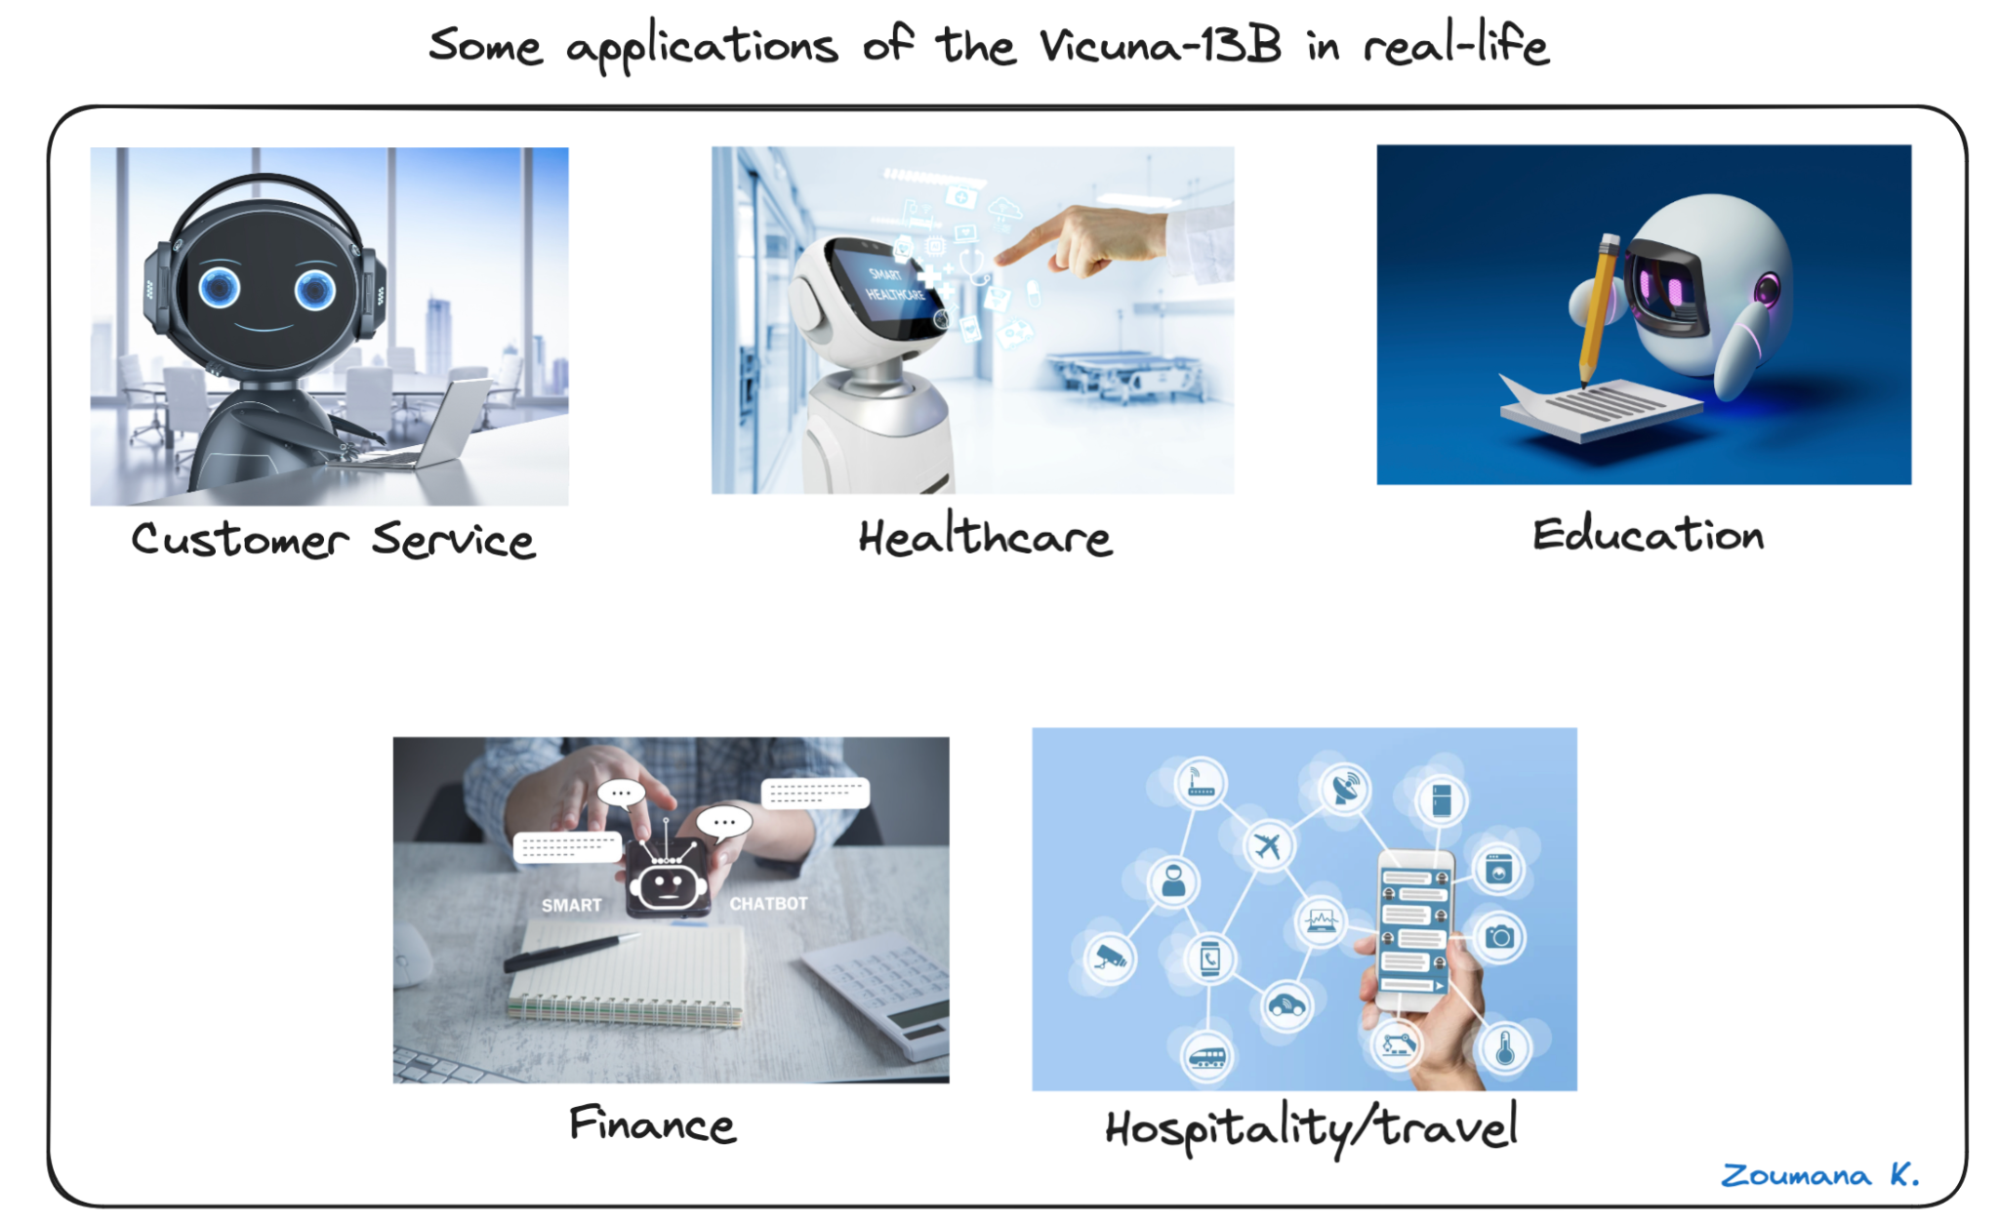
Cinco aplicaciones de Vicuna-13 en la vida real
La lista anterior no es exhaustiva. En nuestro artículo How NLP is changing the future of Data Science analizamos cómo el PLN impulsa el futuro de la ciencia de datos y el aprendizaje automático, sus aplicaciones futuras, riesgos y cómo mitigarlos.
A la vista de estas aplicaciones reales, no hay duda de que la demanda de agentes conversacionales con IA como Vicuna-13B es enorme en las principales industrias.
Por ello, dominar cómo implementar e integrar esta tecnología en los flujos de trabajo del sector se está convirtiendo en una competencia cada vez más valiosa, a medida que más empresas la utilizan para potenciar la relación con sus clientes, generar más oportunidades y, en general, mejorar el retorno de la inversión.
La buena noticia es que este tutorial está pensado justo para ayudarte a desarrollar las habilidades necesarias para ejecutar el modelo Vicuna-13B y poder integrarlo en cualquier flujo de sistemas de información de negocio.
Antes de ponernos manos a la obra con la ejecución del modelo Vicuna-13B, es importante preparar bien los requisitos previos, que incluyen:
Una vez cumplidos estos requisitos, comprenderemos mejor los formatos de entrada y salida y podremos ejecutar el modelo con éxito.
Comprender mejor el formato de entrada y salida de Vicuna-13B proporciona al desarrollador un conocimiento mínimo de los factores que pueden afectar a la toma de decisiones del modelo.
En esta sección se explican los principales parámetros de entrada necesarios, junto con el formato de salida esperado del modelo Vicuna-13B.
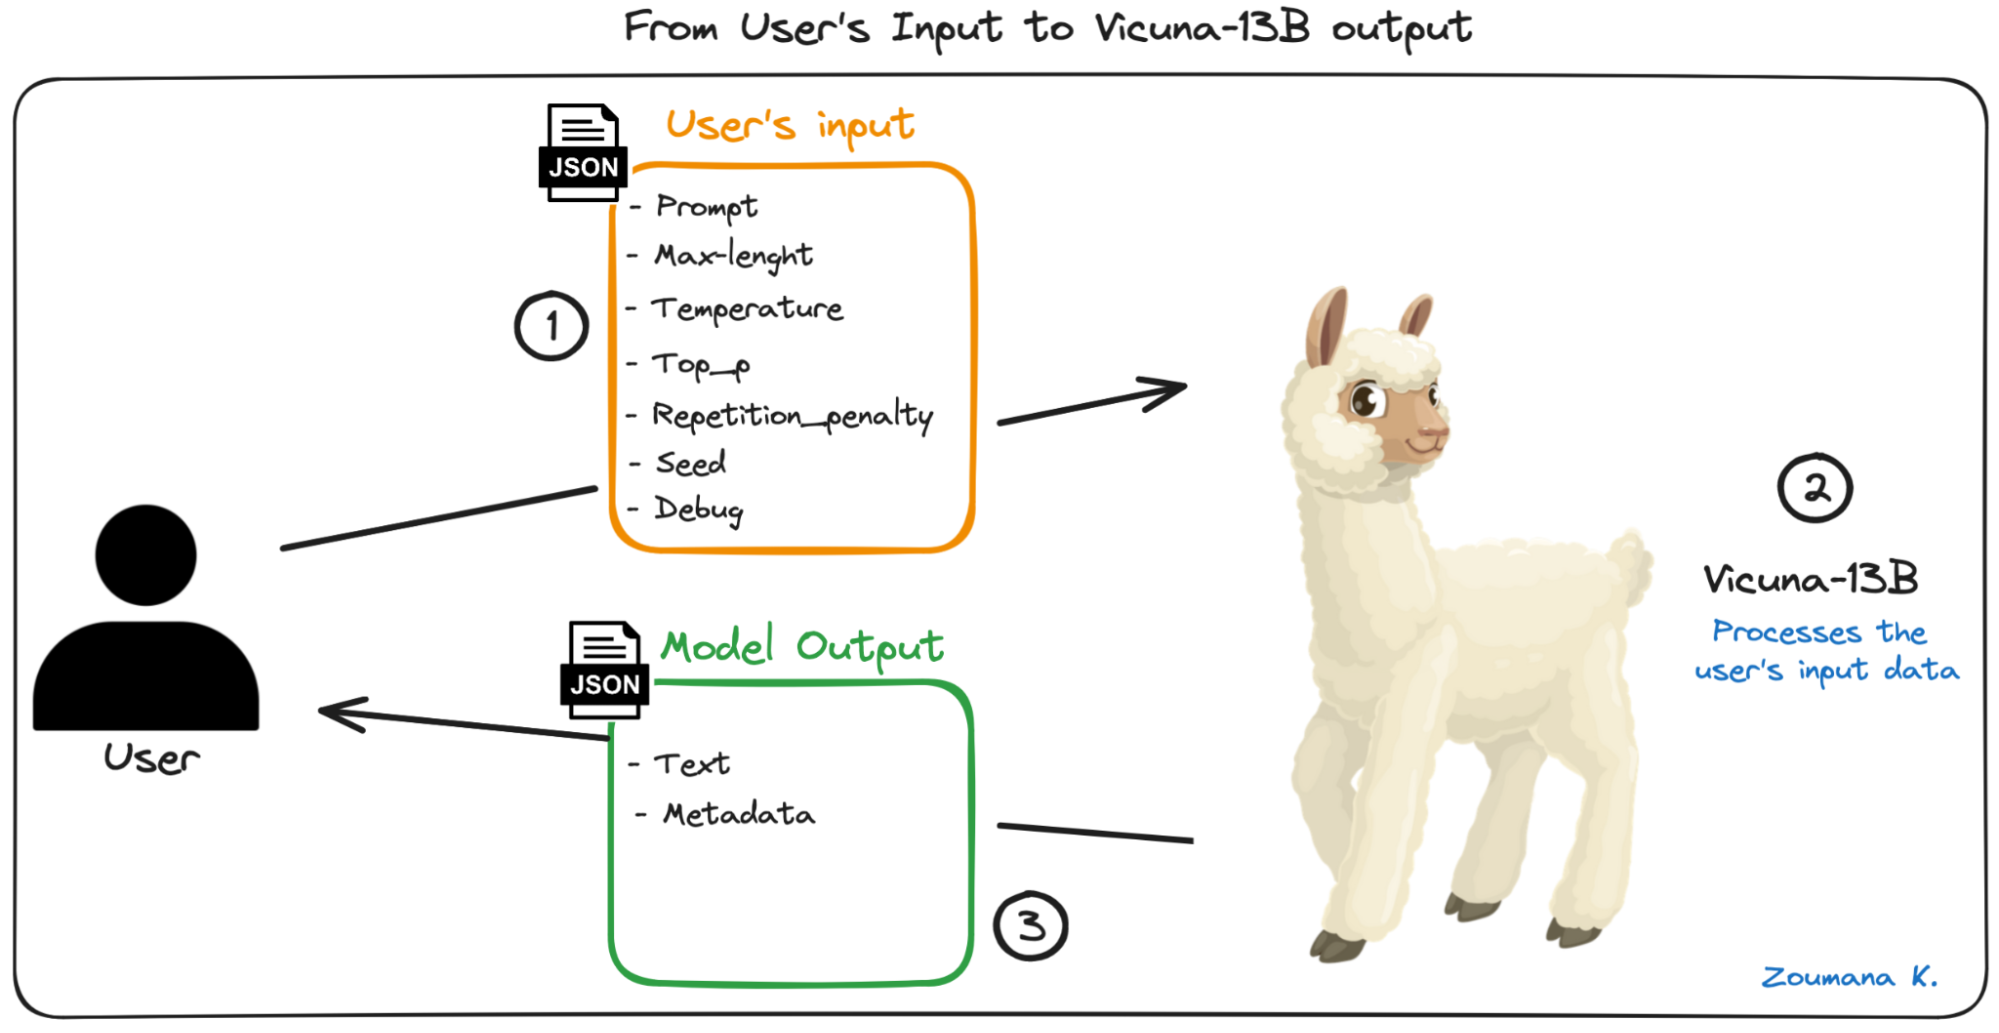
Flujo minimalista de extremo a extremo
Veamos el flujo anterior. Primero, el usuario envía la entrada deseada, que incluye el prompt, es decir, la solicitud de texto principal para la que quiere una respuesta.
El prompt se acompaña de los siguientes parámetros adicionales:
Tras enviar el prompt con los parámetros anteriores, el modelo Vicuna-13B realiza el procesamiento necesario para generar la salida requerida, que sigue el siguiente esquema:
Ahora que entendemos mejor las entradas y salidas, podemos identificar las bibliotecas principales para ejecutar el modelo Vicuna con éxito.
Todos los comandos de esta sección se ejecutan desde una terminal. Con la instrucción conda create, creamos un entorno virtual llamado vicuna-env.
conda create --name vicuna-envTras crear el entorno virtual, lo activamos con la instrucción conda activate de la siguiente forma:
conda activate vicuna-envEl comando anterior debería mostrar el nombre del entorno entre corchetes al inicio de la terminal, como sigue:
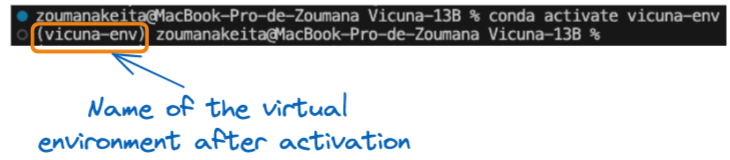
Nombre del entorno virtual tras la activación
Las bibliotecas anteriores pueden instalarse de dos formas. La primera es ejecutar pip install manualmente para cada una, lo que puede llevar mucho tiempo cuando hay muchas dependencias y no es óptimo a nivel industrial.
La segunda es la mejor opción: usar un archivo requirements.txt con todas las dependencias necesarias. A continuación tienes el contenido del archivo y la instalación con un único comando pip install.
# Contenido del archivo requirements.txt

llama-cpp-python==0.1.48
fastapi
uvicorn[standard]
Las tres bibliotecas se pueden instalar así:
pip install -r requirements.txtDesde la plataforma Hugging Face podemos descargar los pesos del modelo Vicuna, como se muestra a continuación:
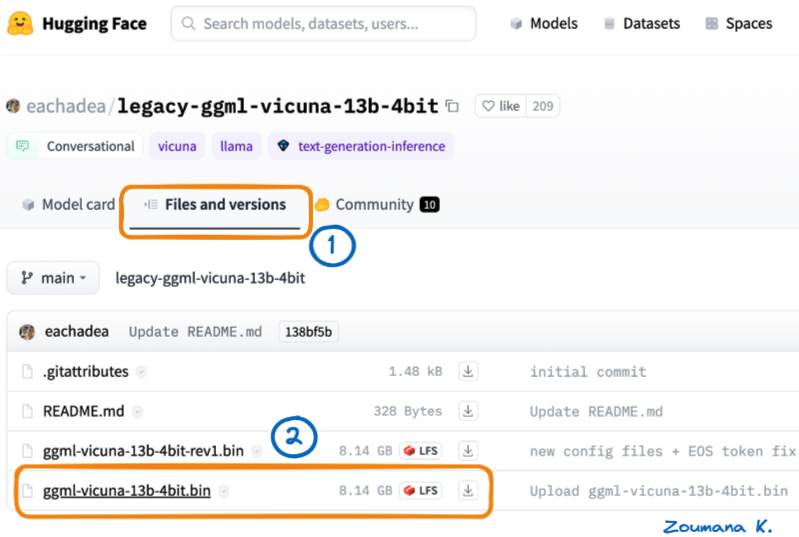
Dos pasos para descargar los pesos de Vicuna-13B desde Hugging Face
Para organizar mejor el código, podemos mover los pesos descargados del modelo a una carpeta nueva llamada model.
Aunque ya cumplimos los requisitos para ejecutar el modelo por línea de comandos, desplegar una API que interactúe con él es una opción mucho más práctica. Así el modelo será accesible para mucha más gente.
Para conseguirlo, necesitamos los siguientes pasos:
La estructura general del código fuente se muestra a continuación, y el código completo está disponible en GitHub.
------ model
         |------- ggml-vicuna-13b-4bit.bin

------ requirements.txt
------ vicuna_app.py
ggml-vicuna-13b-4bit.bin son los pesos del modelo descargados en la carpeta modelrequirements.txt contiene las dependencias para ejecutar el modelovicuna_app.py contiene el código Python para crear la API, que es el foco de esta sección.En nuestro caso, necesitamos dos rutas principales. Antes, importamos las bibliotecas relevantes, cargamos el modelo y creamos una instancia de FastAPI.
# Importar las bibliotecas
from fastapi import FastAPI, HTTPException
from llama_cpp import Llama

# Cargar el modelo
vicuna_model_path = "./model/ggml-vicuna-13b-4bit.bin"
vicuna_model = Llama(model_path=vicuna_model_path)

app = FastAPI()"/" devuelve el siguiente JSON "Message": "Welcome to the Vicuna Demo FastAPI" mediante la función home(), que no recibe parámetros.# Definir la ruta por defecto
@app.get("/")
def home():
return {"Message": "Welcome to the Vicuna Demo FastAPI"}"/vicuna_says", que ejecuta la función answer_prompt(). Recibe como parámetro el prompt del usuario y devuelve una respuesta JSON con el resultado del modelo Vicuna y metadatos adicionales.@app.post("/vicuna_says")
def answer_prompt(user_prompt):
if (not (user_prompt)):
raise HTTPException(status_code=400,
detail="Please Provide a valid text message")
response = vicuna_model(user_prompt)
return {"Answer": response}Por fin podemos ejecutar la API con la siguiente instrucción desde la línea de comandos, en la carpeta donde está el archivo vicuna_app.py.
uvicorn vicuna_app:app --reloaduvicorn: inicia el servidor Uvicorn.vicuna_app: corresponde al archivo Python vicuna_app.py. Es lo que va a la izquierda de los dos puntos.app: es el objeto creado dentro de vicuna_app.py con la instrucción app = FastAPI(). Si el archivo se llamara main.py, el comando sería uvicorn main:app --reload--reload: opción para reiniciar el servidor tras cambios en el código. Úsala solo en desarrollo, no en producción.Este es el resultado al ejecutar el comando anterior: el servidor está funcionando en localhost en el puerto 8000 (http://127.0.0.1:8000)
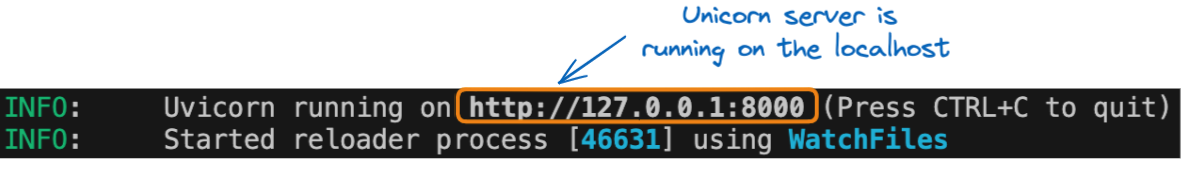
URL de la API ejecutándose en localhost
Acceder a la ruta por defecto es muy sencillo: solo tienes que escribir la siguiente URL en cualquier navegador.
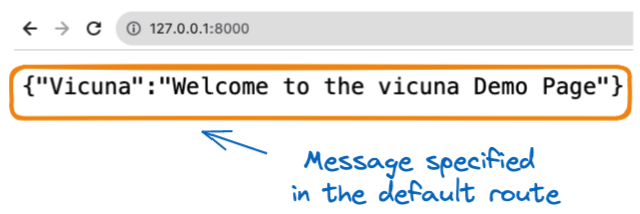
Respuesta de la ruta por defecto
Aquí viene lo interesante. La URL http://127.0.0.1:8000/docs proporciona un panel completo para interactuar con la API, y este es el resultado.
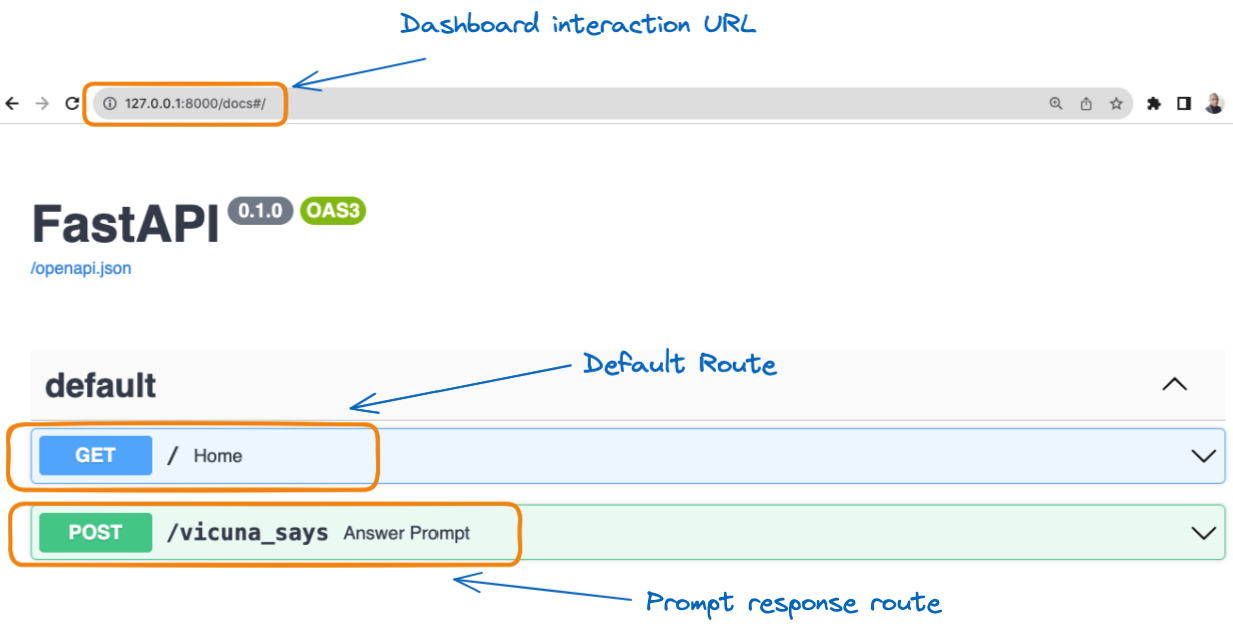
Visualización gráfica de las dos rutas
En la imagen anterior, al seleccionar /vicuna_says en el recuadro verde, obtenemos la guía completa para interactuar con nuestra API, como se muestra a continuación.
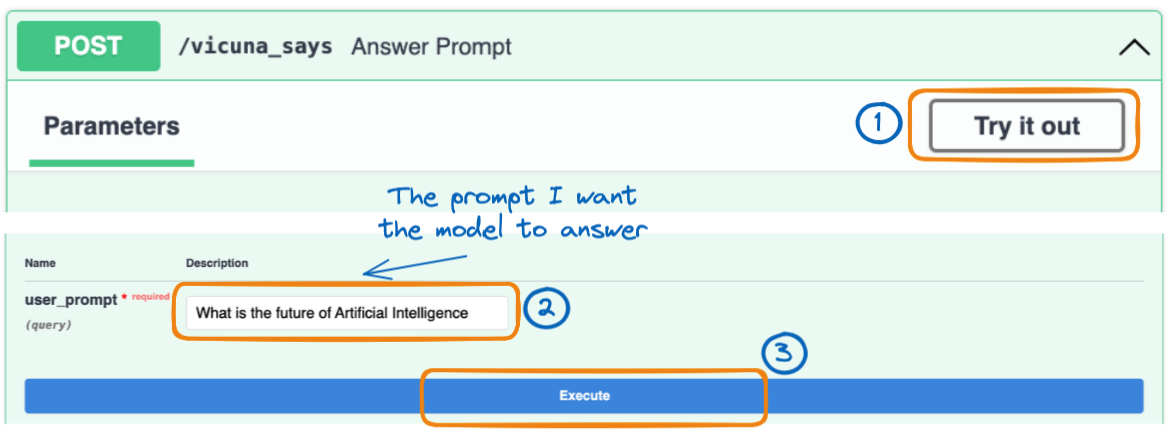
Los tres pasos principales para ejecutar el prompt del usuario
Solo tienes que seleccionar la pestaña Try it out y escribir el mensaje para el que quieres la predicción en el área text_message.
Por último, al pulsar el botón Execute obtenemos el siguiente resultado.
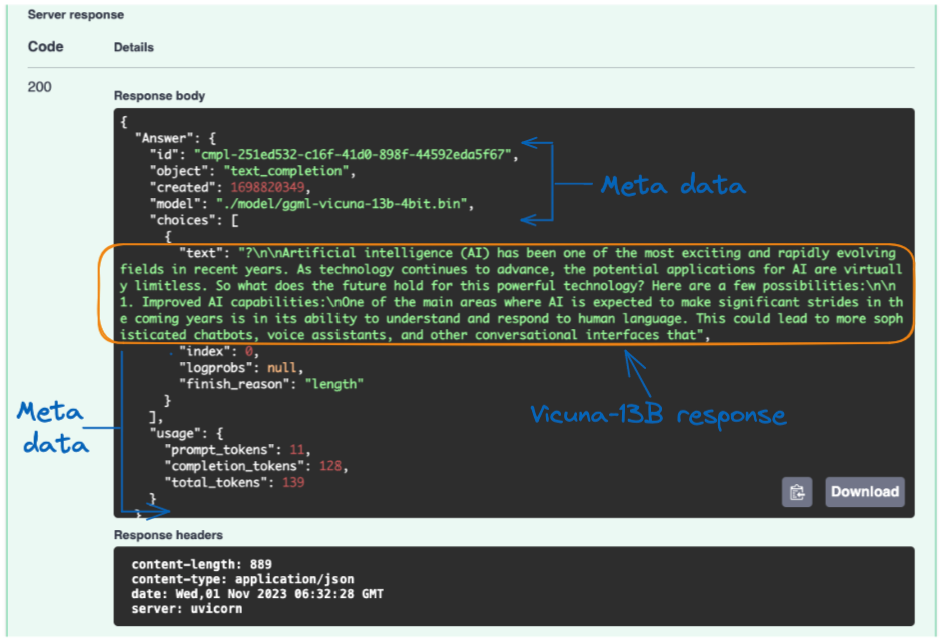
Respuesta del servidor del modelo Vicuna a la consulta del usuario
La respuesta del modelo Vicuna se proporciona en el campo "text", y el resultado es bastante impresionante.
También se incluyen metadatos adicionales, como el modelo utilizado, la fecha de creación de la respuesta, el número de tokens del prompt y el número de tokens de la respuesta, entre otros.
Desplegar un modelo tan potente mejora la experiencia del usuario y la eficiencia operativa de varias formas, entre ellas:
En definitiva, el despliegue facilita un uso más accesible, fiable y versátil de Vicuna-13B, ampliando su aplicabilidad para distintos usuarios y aplicaciones.
Al trabajar con el modelo Vicuna-13B, algunas buenas prácticas y consejos pueden ayudarte a optimizar la experiencia, mejorar resultados y resolver problemas comunes.
Siguiendo estas recomendaciones, asegurarás una experiencia más fluida y mejores resultados al trabajar con Vicuna-13B.
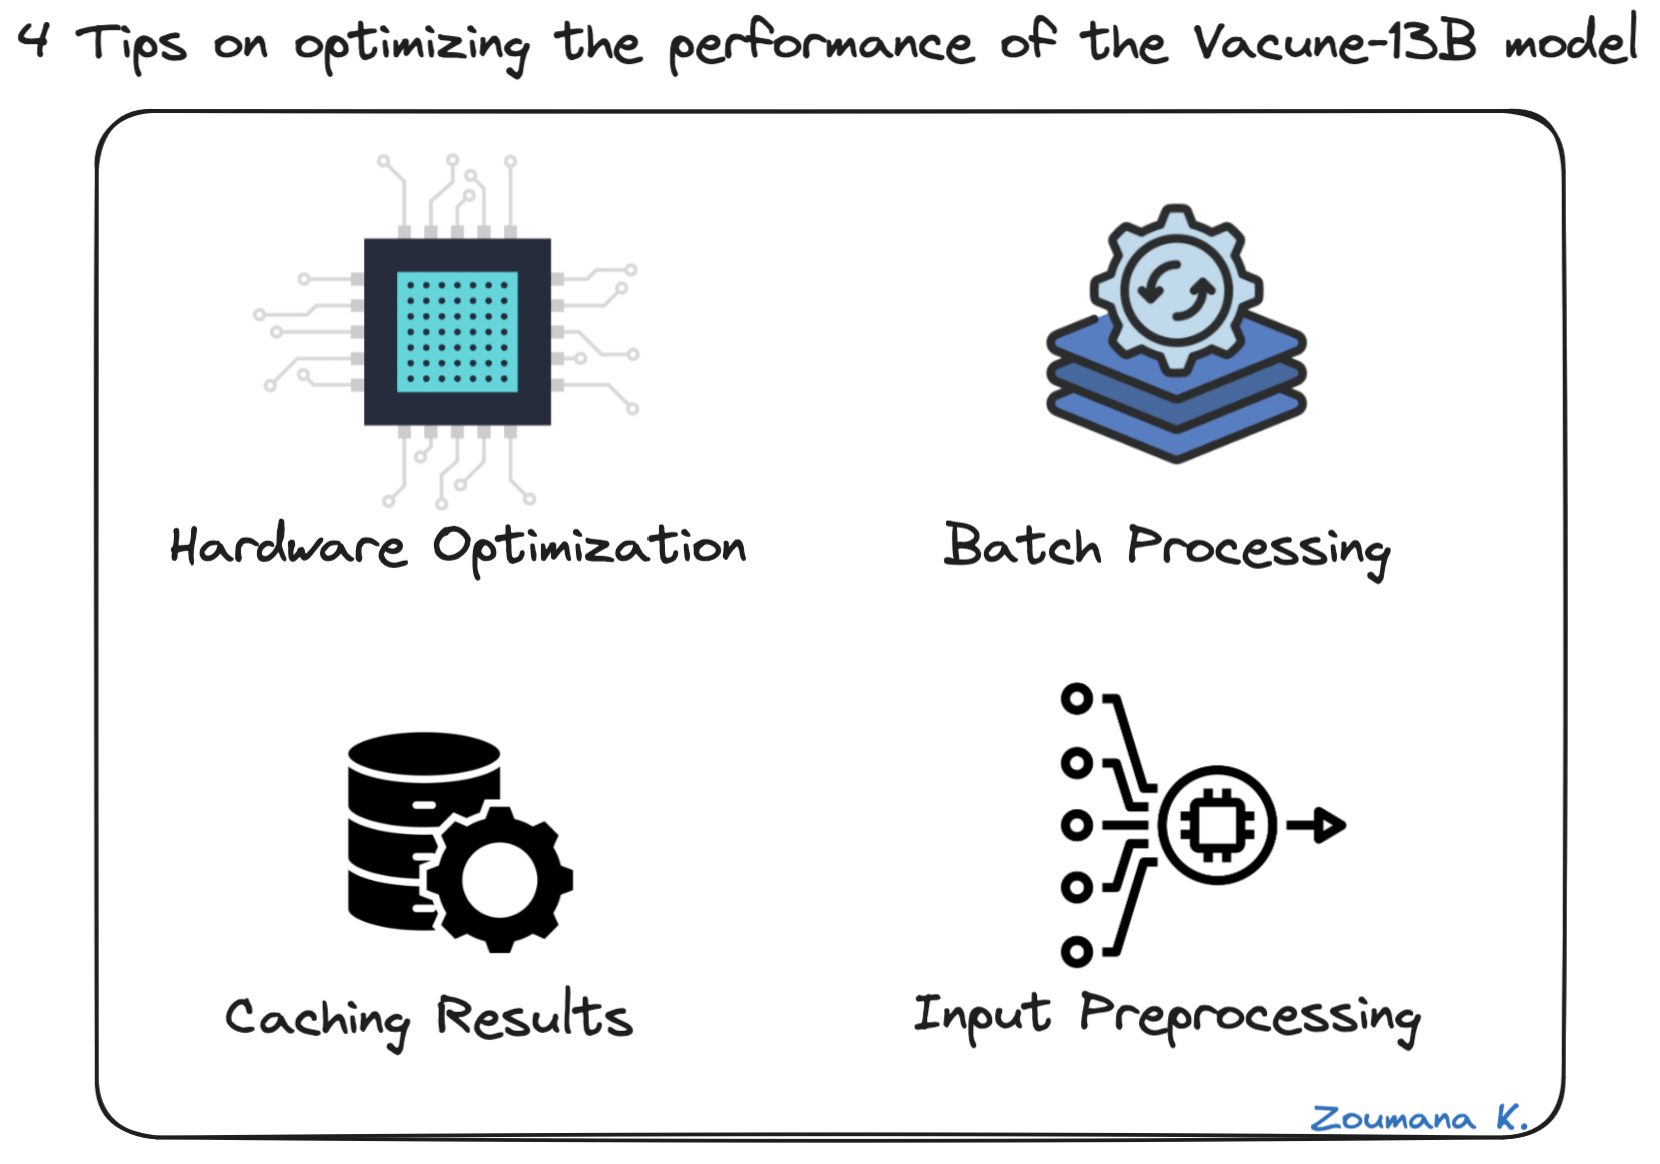
4 consejos para optimizar el rendimiento del modelo Vicuna-13B
Además de optimizar el rendimiento, conviene saber resolver incidencias habituales durante el uso de Vicuna-13B. Aquí tienes cuatro ejemplos:
Algunos problemas comunes y cómo resolverlos
En resumen, este artículo te ha ofrecido una visión completa sobre cómo preparar y utilizar el modelo Vicuna-13B. Hemos cubierto los requisitos previos necesarios, incluido hardware, software y la obtención de los pesos de LLaMa, imprescindibles para ejecutar el modelo con éxito.
Te hemos dado instrucciones detalladas para configurar el entorno de trabajo, instalar el software necesario y preparar los pesos de Vicuna-13B, destacando la importancia de los pesos en los modelos de lenguaje.
Además, hemos profundizado en el empaquetado y el despliegue de Vicuna-13B, y cómo el despliegue facilita su uso como interfaz web y API.
Por último, compartimos recomendaciones prácticas para interactuar con Vicuna-13B, ejemplos de sus capacidades y buenas prácticas para optimizar su rendimiento y solucionar problemas frecuentes.
¿Listo para profundizar en el mundo de la IA y el aprendizaje automático? Potencia tus habilidades con el framework de deep learning que usan los profesionales de IA. Únete hoy al curso Deep Learning with PyTorch.
¡Empieza hoy tu camino en IA!
Curso
programa
Curso
Tutorial
Moez Ali
13 min
Tutorial
Moez Ali
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
11 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Zoumana Keita
15 min