
Corso
Comprendere l'intelligenza artificiale
2 ore
426.1K
L’emergere dei large language model ha trasformato interi settori, portando la potenza di tecnologie come GPT-3.5 e GPT-4 di OpenAI in varie applicazioni. Tuttavia, l’alto costo e le preoccupazioni sulla riservatezza dei dati spesso scoraggiano i potenziali adottanti. È qui che entrano in gioco i modelli open source come Vicuna-13B, che offrono prestazioni simili senza i costi elevati e i rischi per le informazioni sensibili.
Per saperne di più su GPT-3.5 e GPT-4, il nostro tutorial Usare GPT-3.5 e GPT-4 tramite l’API di OpenAI in Python è un buon punto di partenza per capire come lavorare con il pacchetto OpenAI per Python e conversare con ChatGPT in modo programmatico.
Vicuna-13B è un modello conversazionale open source addestrato tramite fine-tuning del modello LLaMa 13B utilizzando conversazioni condivise dagli utenti raccolte da ShareGPT.
Una valutazione preliminare con GPT-4 come giudice ha mostrato che Vicuna-13B raggiunge oltre il 90% della qualità di chatGPT e Google Bard, superando poi altri modelli come LLaMa e Alpaca in oltre il 90% dei casi. Il flusso complessivo di fine-tuning e valutazione è illustrato di seguito:
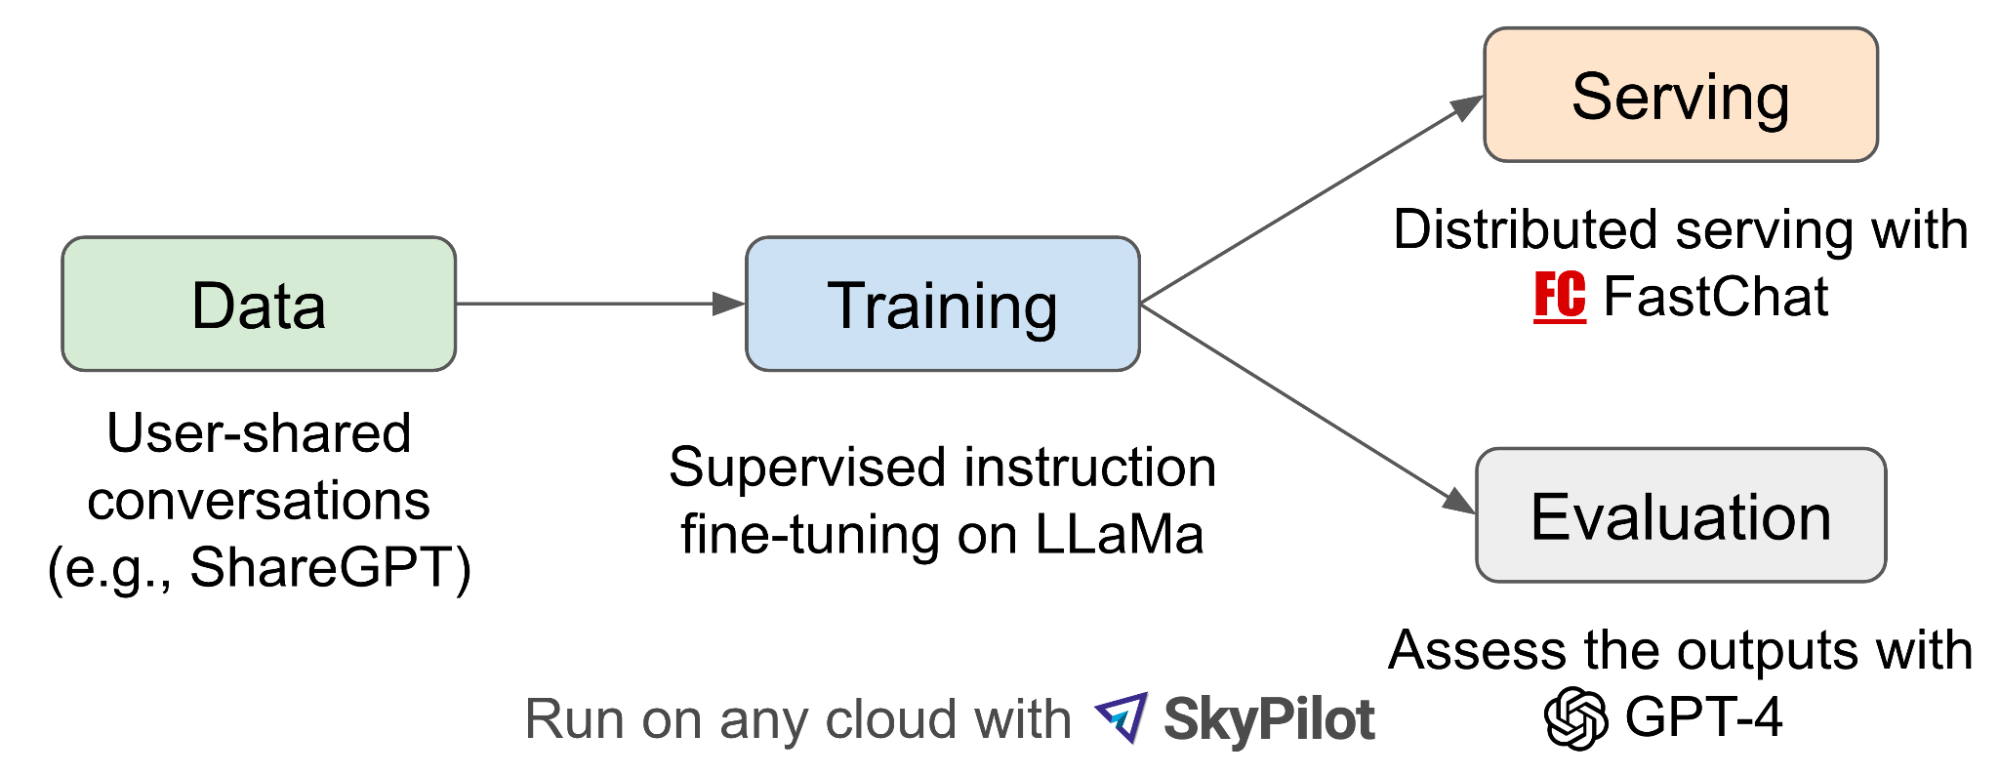
Flusso di fine-tuning e valutazione di Vicuna-13B (fonte)
Anche se questo evidenzia la forza di Vicuna-13B, il modello presenta dei limiti ed è poco adatto a compiti come matematica e ragionamento.
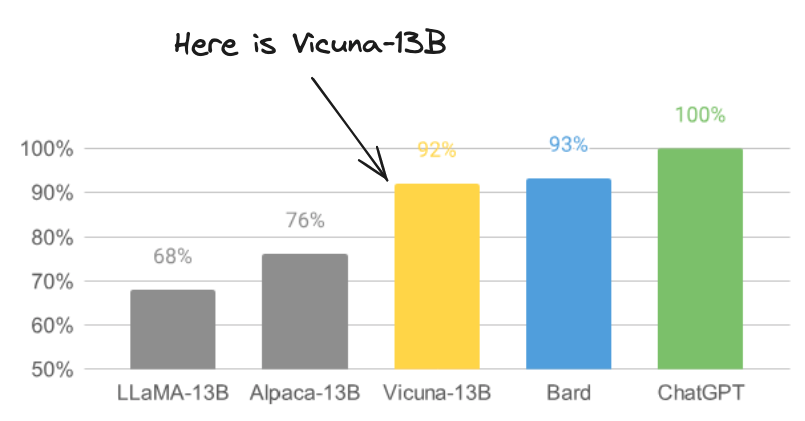
Immagine da LMSYSORG modificata dall’autore
In quanto chatbot intelligente, le applicazioni di Vicuna-13B sono innumerevoli, e alcune sono illustrate di seguito in diversi settori, come assistenza clienti, sanità, istruzione, finanza e viaggi/hospitality.
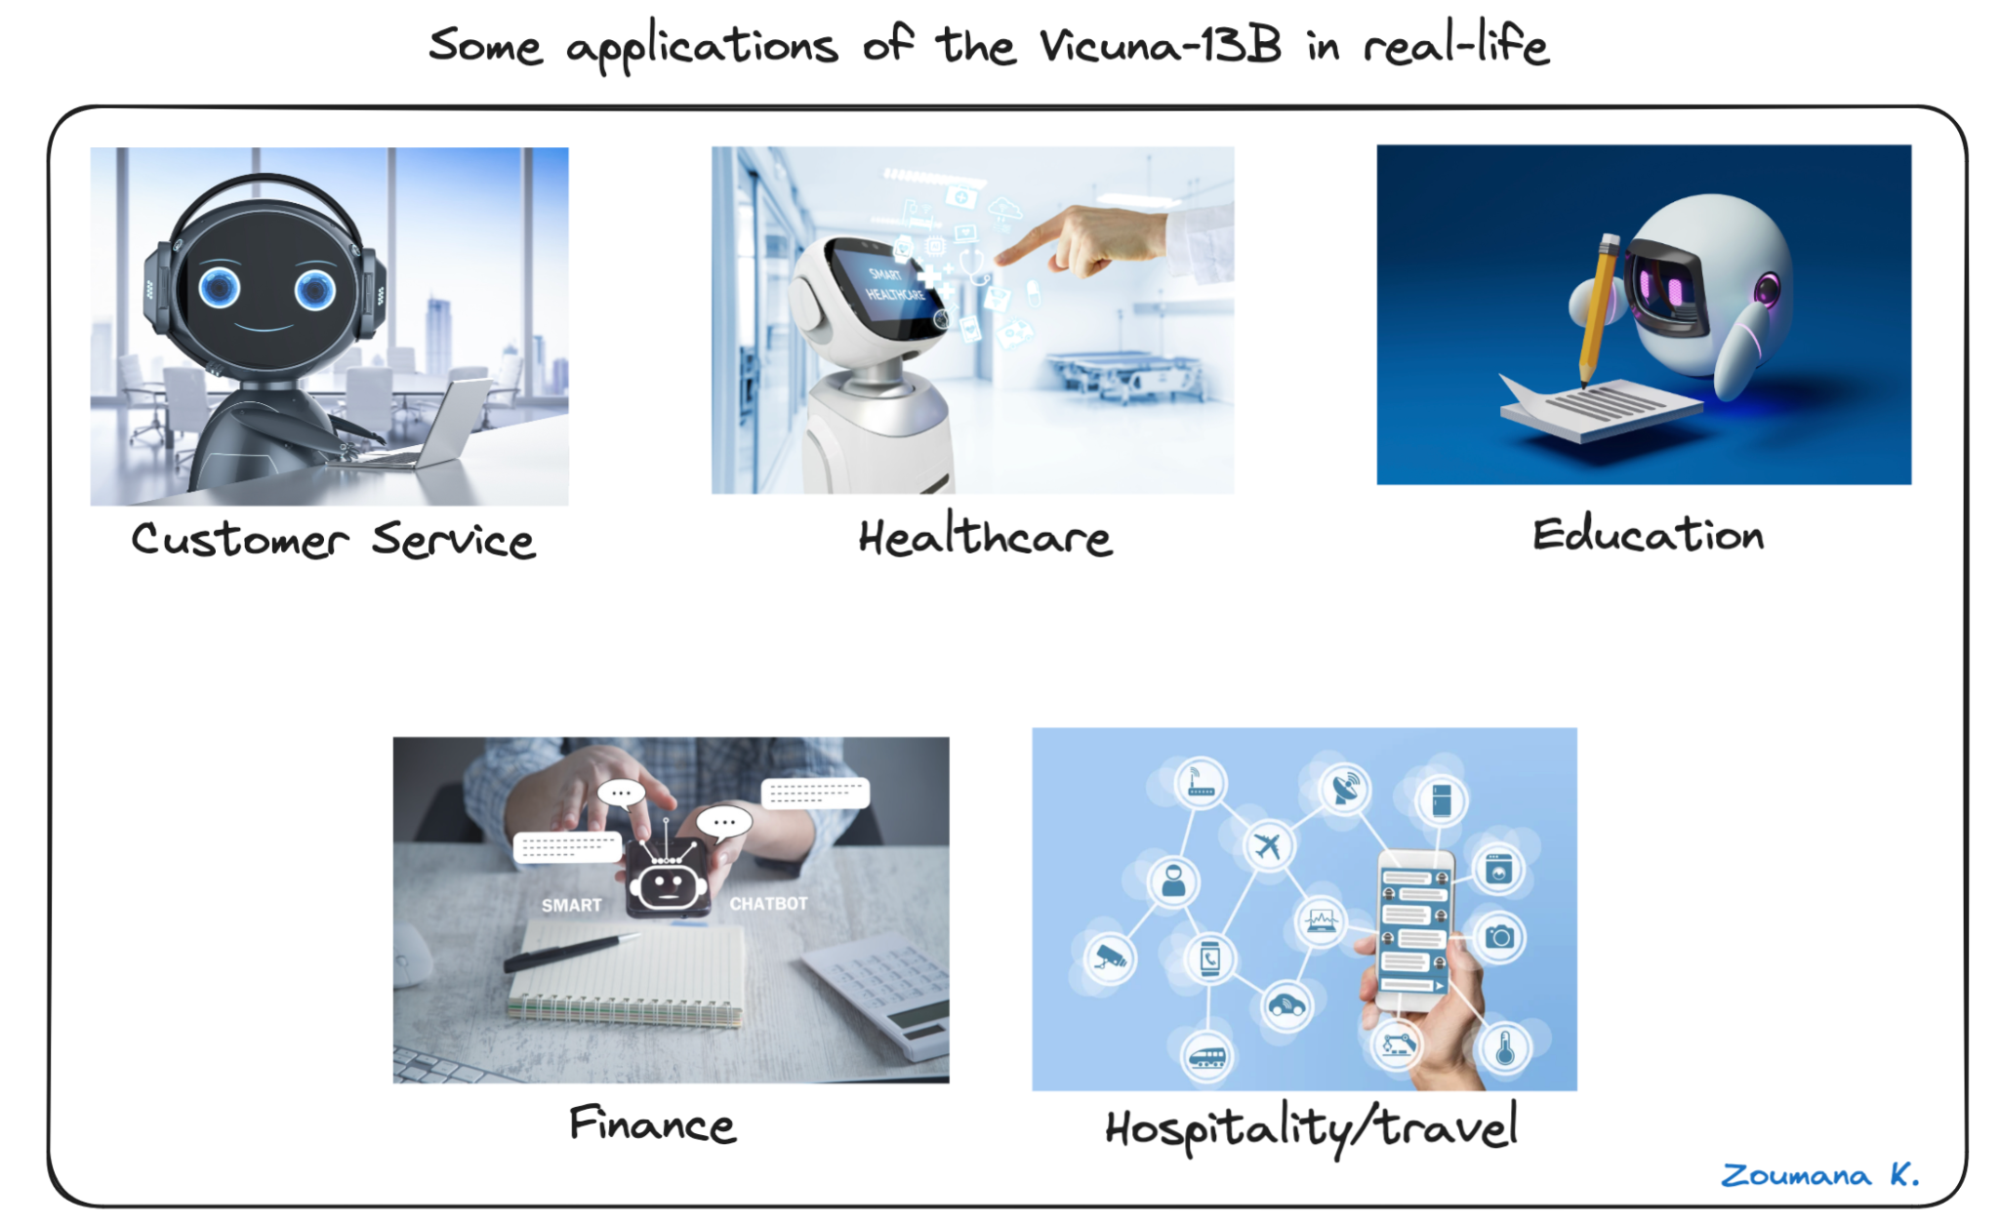
Cinque applicazioni diverse di Vicuna-13 nella vita reale
L’elenco sopra non è esaustivo, e il nostro articolo Come l’NLP sta cambiando il futuro della Data Science spiega come l’NLP stia guidando il futuro della data science e del machine learning, le sue applicazioni future, i rischi e come mitigarli.
Alla luce di queste applicazioni reali, non c’è dubbio che la domanda di agenti conversazionali basati su IA come Vicuna-13B sia enorme nei principali settori.
Di conseguenza, padroneggiare come implementare e integrare questa tecnologia nei flussi di lavoro aziendali sta diventando una competenza sempre più richiesta, man mano che più aziende la usano per potenziare il coinvolgimento dei clienti, generare più lead e aumentare il ritorno sugli investimenti.
La buona notizia è che l’obiettivo di questo tutorial è aiutarti a sviluppare le competenze necessarie per eseguire il modello Vicuna-13B e integrarlo in qualsiasi flusso di lavoro dei sistemi informativi aziendali.
Prima di entrare nel processo di esecuzione del modello Vicuna-13B, è importante impostare correttamente i prerequisiti, che includono:
Una volta soddisfatti questi requisiti, avremo una migliore comprensione dei formati di input e output e saremo in grado di eseguire con successo il modello.
Avere una migliore comprensione del formato di input e output di Vicuna-13B fornisce allo sviluppatore la conoscenza minima dei fattori che possono influenzare il processo decisionale del modello.
Questa sezione spiega i principali parametri richiesti in input insieme al formato di output atteso del modello Vicuna-13B.
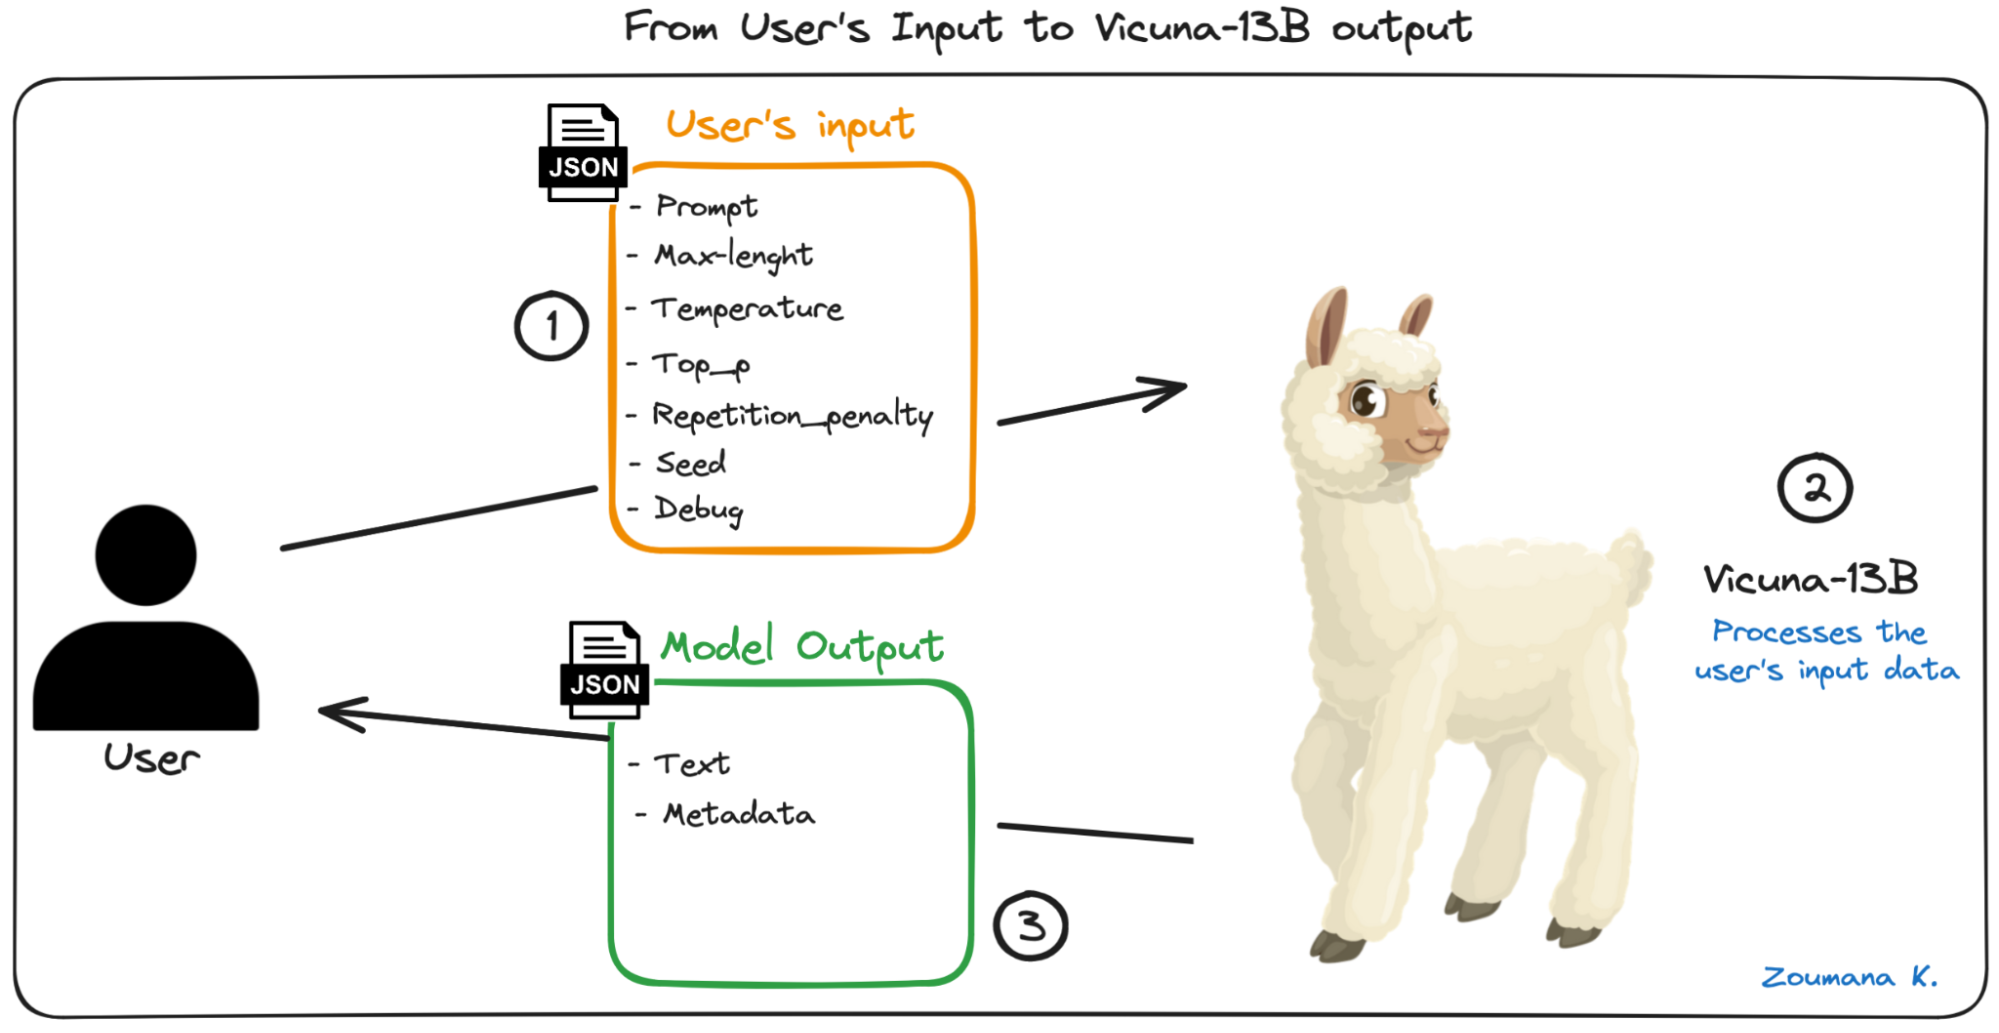
Workflow minimalista dell’end-to-end workflow
Vediamo di capire il workflow qui sopra. Per prima cosa, l’utente invia l’input desiderato, che include il prompt, ovvero la richiesta testuale principale per cui vuole una risposta.
Il prompt è fornito insieme ai seguenti parametri aggiuntivi:
Dopo aver inviato il prompt con i parametri sopra, il modello Vicuna-13B esegue l’elaborazione necessaria dietro le quinte per generare l’output richiesto, che corrisponde al seguente schema:
Ora che abbiamo compreso meglio input e output, possiamo procedere a identificare le principali librerie per eseguire con successo il modello vicuna.
Tutti i comandi di questa sezione si eseguono da terminale. Con il comando conda create, creiamo un ambiente virtuale chiamato vicuna-env.
conda create --name vicuna-envDopo aver creato con successo l’ambiente virtuale, lo attiviamo usando il comando conda activate, come segue:
conda activate vicuna-envIl comando sopra dovrebbe mostrare il nome dell’ambiente tra parentesi all’inizio del terminale, come segue:
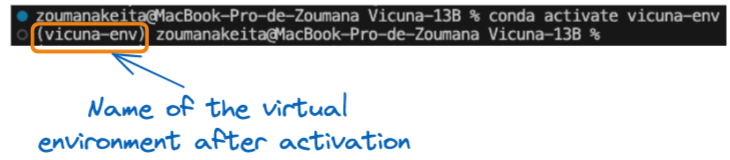
Nome dell’ambiente virtuale dopo l’attivazione
Le librerie sopra possono essere installate in due modi. Il primo è eseguire manualmente pip install per ogni libreria: può richiedere tempo quando le librerie sono molte e non è ottimale in contesti aziendali.
La seconda opzione è la migliore e usa un file requirements.txt contenente tutte le librerie richieste. Di seguito il contenuto del file requirements.txt, insieme all’installazione con un unico comando pip install.
# Content of the requirements.txt file

llama-cpp-python==0.1.48
fastapi
uvicorn[standard]
Tutte e tre le librerie possono essere installate come segue:
pip install -r requirements.txtDalla piattaforma Hugging Face, possiamo scaricare i pesi del modello Vicuna come mostrato di seguito:
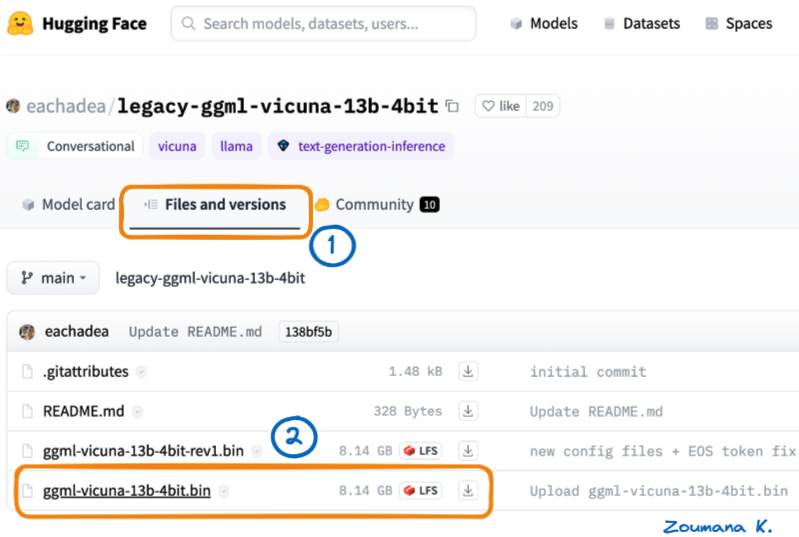
Due passaggi principali per scaricare i pesi di Vicuna-13B da Hugging Face
Per una migliore organizzazione del codice, possiamo spostare i pesi del modello scaricato in una nuova cartella model.
Sebbene i prerequisiti siano soddisfatti per eseguire il modello da riga di comando, distribuire un’API che interagisca con il modello è un approccio più pratico. Renderà il modello facilmente accessibile a un pubblico più ampio.
Per arrivare a questo livello, servono i seguenti passaggi:
La struttura complessiva del sorgente è riportata sotto e il codice completo è disponibile su GitHub.
------ model
         |------- ggml-vicuna-13b-4bit.bin

------ requirements.txt
------ vicuna_app.py
ggml-vicuna-13b-4bit.bin è il peso del modello scaricato nella cartella modelrequirements.txt contiene le dipendenze per eseguire il modellovicuna_app.py contiene il codice Python per creare l’API, che è il focus principale di questa sezione.Nel nostro caso, servono le due rotte principali seguenti. Prima, dobbiamo importare le librerie pertinenti, caricare il modello e creare un’istanza del modulo FastAPI.
# Import the libraries
from fastapi import FastAPI, HTTPException
from llama_cpp import Llama

# Load the model
vicuna_model_path = "./model/ggml-vicuna-13b-4bit.bin"
vicuna_model = Llama(model_path=vicuna_model_path)

app = FastAPI()"/” restituisce il seguente JSON “Message”: “Welcome to the Vicuna Demo FastAPI” tramite la funzione home(), che non accetta parametri.# Define the default route
@app.get("/")
def home():
return {"Message": "Welcome to the Vicuna Demo FastAPI"}/vicuna_says” responsabile dell’attivazione della funzione answer_prompt(), che prende come parametro il prompt dell’utente e restituisce una risposta JSON contenente il risultato del modello Vicuna e alcune metainformazioni aggiuntive.@app.post("/vicuna_says")
def answer_prompt(user_prompt):
if (not (user_prompt)):
raise HTTPException(status_code=400,
detail="Please Provide a valid text message")
response = vicuna_model(user_prompt)
return {"Answer": response}Possiamo finalmente eseguire l’API con il seguente comando da riga di comando, nella cartella in cui si trova il file vicuna_app.py.
uvicorn vicuna_app:app --reloaduvicorn avvia il server Uvicorn.vicuna_app: corrisponde al file Python vicuna_app.py. È la parte a sinistra dei due punti “:”.app: corrisponde all’oggetto creato dentro il file vicuna_app.py con l’istruzione app = FastAPI(). Se il file si chiamasse main.py il comando sarebbe uvicorn main:app --reload--reload: opzione usata per riavviare il server dopo ogni modifica al codice. Tieni presente che va usata solo in fase di sviluppo, non in produzione.Ecco il risultato ottenuto eseguendo il comando precedente: si vede che il server è in esecuzione sul localhost sulla porta 8000 (http://127.0.0.1:8000)
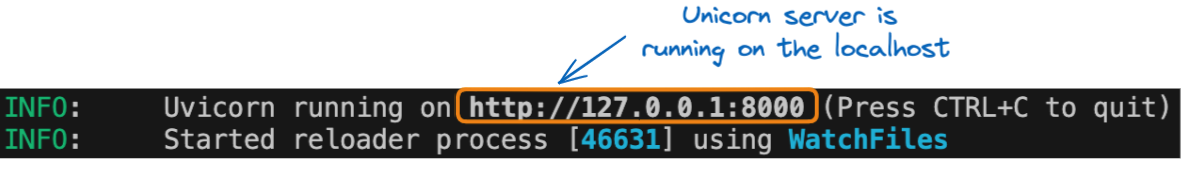
URL dell’API in esecuzione su localhost
Accedere alla rotta di default è semplice. Basta digitare il seguente URL in un qualsiasi browser.
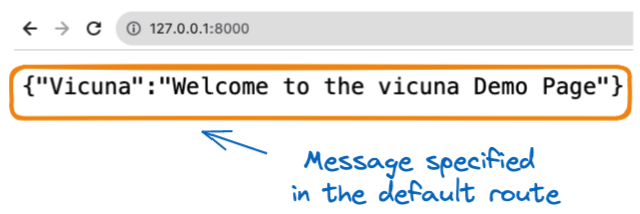
Risposta dalla rotta di default
E qui viene la parte interessante. L’URL http://127.0.0.1:8000/docs fornisce una dashboard completa per interagire con l’API, e sotto c’è il risultato.
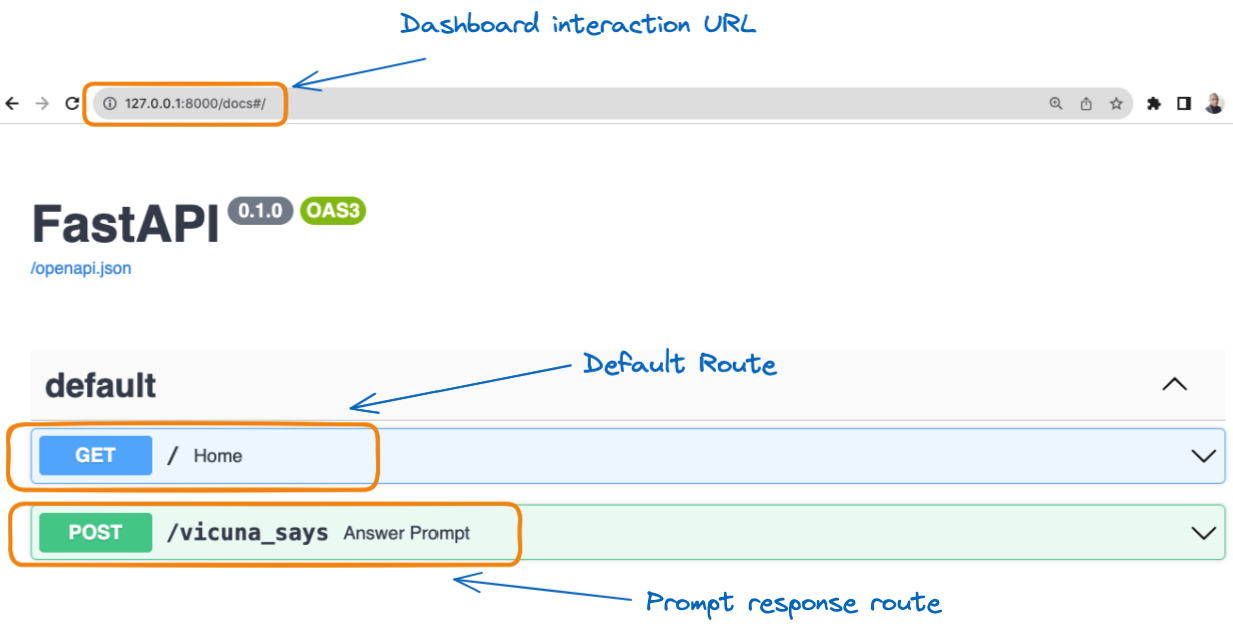
Visualizzazione grafica delle due rotte
Dall’immagine precedente, selezionando /vicuna_says nel riquadro verde otteniamo la guida completa per interagire con la nostra API, come mostrato di seguito.
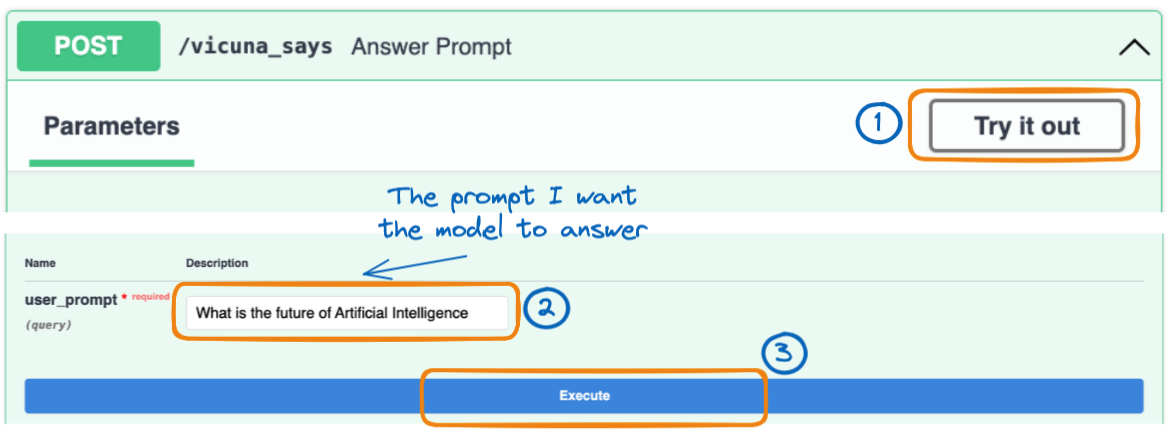
I tre passaggi principali per eseguire il prompt dell’utente
Seleziona la scheda Try it out e inserisci il messaggio per cui vuoi la predizione nel campo text_message.
Infine otteniamo il seguente risultato dopo aver selezionato il pulsante Execute.
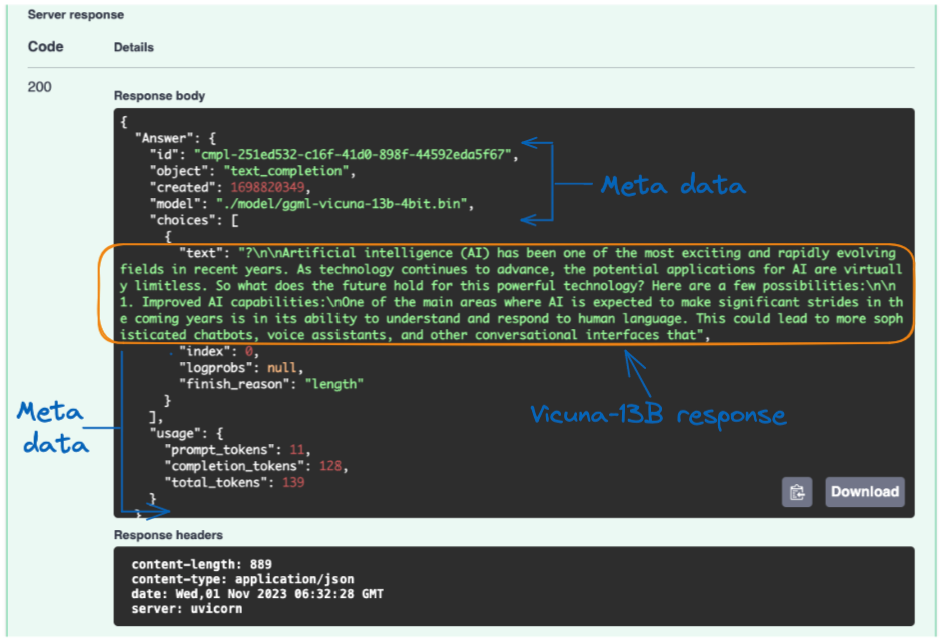
Risposta del server dal modello Vicuna alla richiesta dell’utente
La risposta del modello Vicuna è fornita nel campo “text”, e il risultato è davvero notevole.
Vengono fornite anche metainformazioni aggiuntive, come il modello utilizzato, la data di creazione della risposta, il numero di token nel prompt e il numero di token nella risposta, solo per citarne alcune.
Distribuire un modello così potente migliora l’esperienza utente e l’efficienza operativa in diversi modi significativi, tra cui ma non solo:
In generale, il deployment rende l’uso di vicuna-13B più accessibile, affidabile e versatile, ampliandone l’applicabilità per vari utenti e applicazioni.
Quando lavori con il modello Vicuna-13B, alcune best practice e suggerimenti possono aiutarti a ottimizzare l’esperienza, i risultati e a risolvere i problemi comuni.
Seguendo queste best practice e questi consigli, potrai assicurarti un’esperienza più fluida e risultati migliori quando lavori con il modello Vicuna-13B.
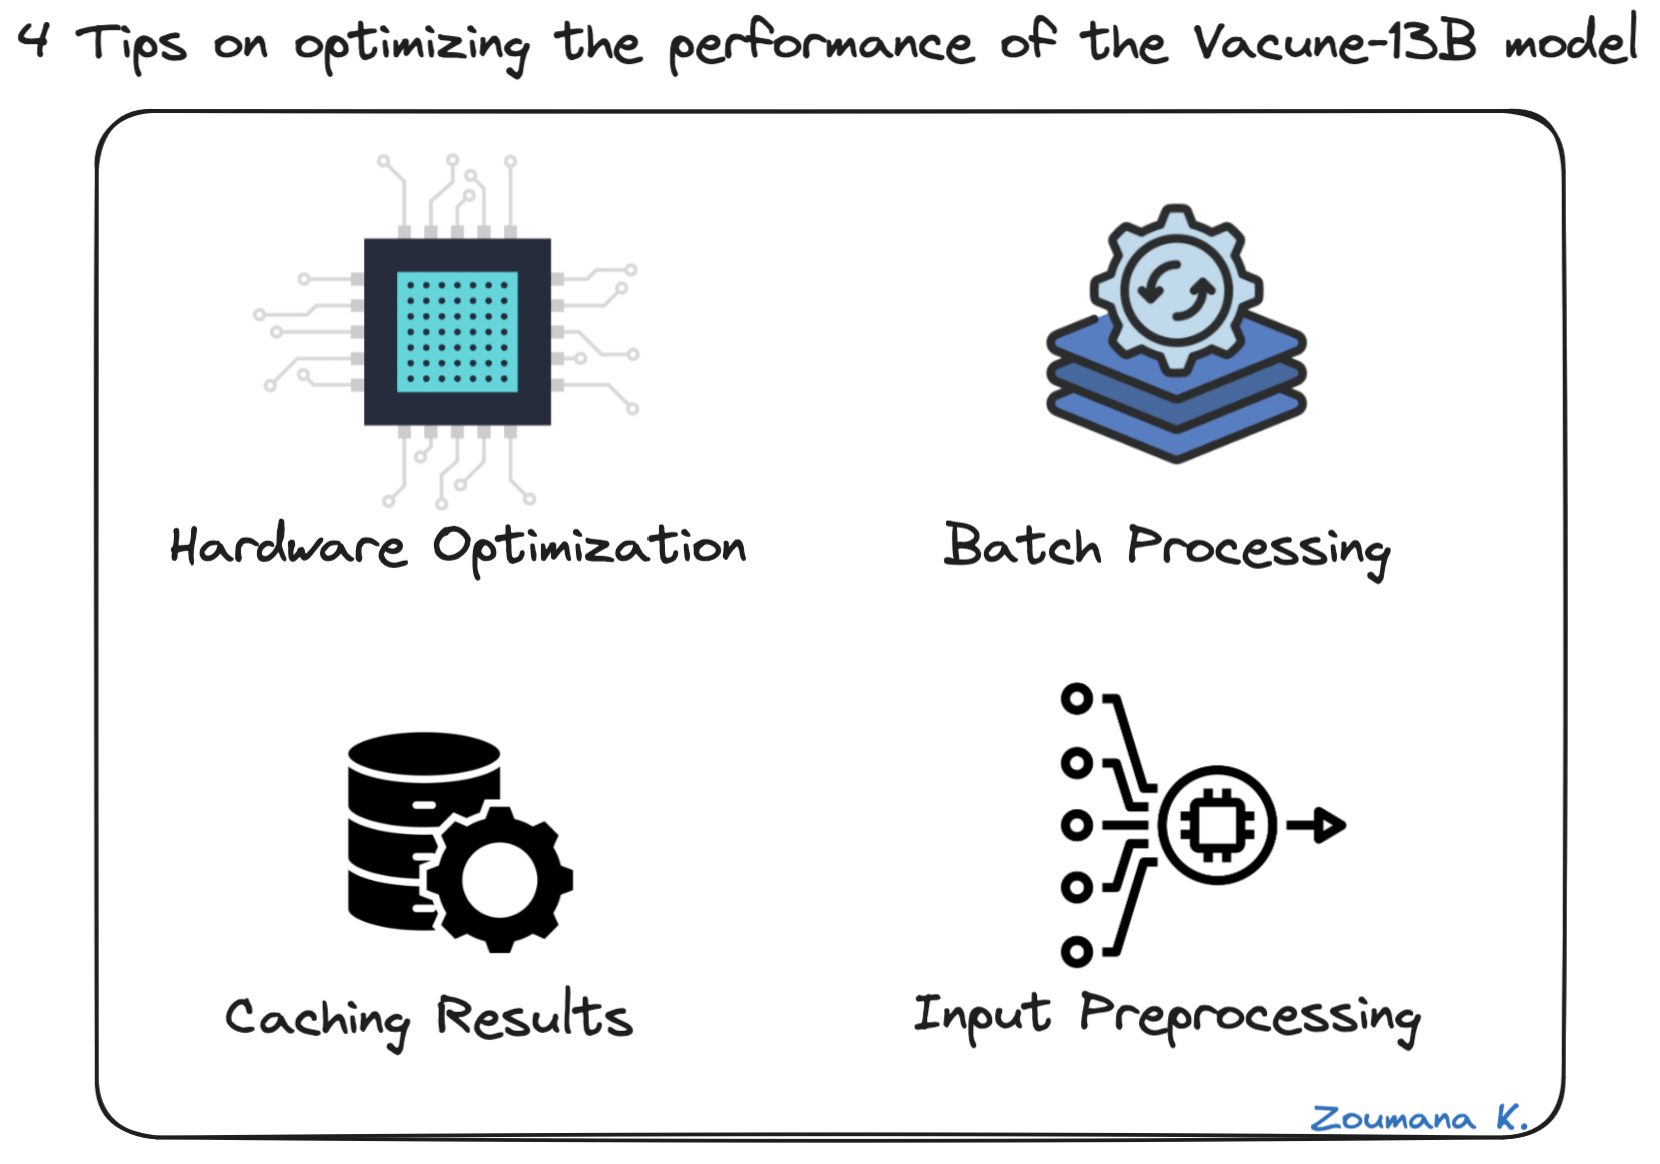
4 consigli per ottimizzare le prestazioni del modello Vicuna-13B
Oltre all’ottimizzazione delle prestazioni, è importante saper risolvere i problemi comuni che possono sorgere durante l’uso di Vicuna-13B; di seguito quattro esempi:
Alcuni problemi comuni di troubleshooting
In sintesi, questo articolo ha fornito una panoramica completa su come configurare e utilizzare il modello Vicuna-13B. Abbiamo coperto i prerequisiti necessari, tra cui hardware, software e l’ottenimento dei pesi LLaMa essenziali per eseguire correttamente il modello.
Sono state fornite istruzioni dettagliate per configurare l’ambiente di lavoro, installare il software richiesto e impostare i pesi di Vicuna-13B, sottolineando l’importanza dei pesi nei modelli linguistici.
Abbiamo inoltre approfondito il packaging e il deployment di Vicuna-13B, evidenziando come il deployment ne faciliti l’utilizzo come interfaccia web e API.
Infine, sono stati condivisi suggerimenti pratici per interagire con Vicuna-13B, esempi delle sue capacità e best practice per ottimizzarne le prestazioni e risolvere i problemi comuni.
Pronto a immergerti più a fondo nel mondo dell’IA e del machine learning? Migliora le tue competenze con il potente framework di deep learning usato dai professionisti dell’IA. Iscriviti oggi al corso Deep Learning con PyTorch.
Inizia oggi il tuo percorso nell’IA!
Corso
Programma
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



