
Kurs
Künstliche Intelligenz verstehen
2 Std.
421.7K
Das Aufkommen großer Sprachmodelle hat ganze Branchen verändert und die Leistungsfähigkeit von Technologien wie OpenAIs GPT-3.5 und GPT-4 in unterschiedlichste Anwendungen gebracht. Hohe Kosten und Bedenken rund um den Schutz vertraulicher Daten schrecken potenzielle Nutzer jedoch oft ab. Genau hier punkten Open-Source-Modelle wie Vicuna-13B: Sie bieten vergleichbare Leistung ohne hohe Ausgaben und mit geringerem Risiko für sensible Informationen.
Wenn du mehr über GPT-3.5 und GPT-4 erfahren möchtest, ist unser Tutorial Using GPT-3.5 and GPT-4 via the OpenAI API in Python ein guter Einstieg, um zu verstehen, wie du mit dem OpenAI-Python-Paket programmatisch Gespräche mit ChatGPT führst.
Vicuna-13B ist ein Open-Source-Dialogmodell, das durch Feintuning des LLaMa-13B-Modells mit von Nutzern geteilten Unterhaltungen von ShareGPT trainiert wurde.
Eine erste Evaluation mit GPT-4 als Bewerter zeigte, dass Vicuna-13B mehr als 90% der Qualität von ChatGPT und Google Bard erreicht und Modelle wie LLaMa und Alpaca in über 90% der Fälle übertrifft. Der gesamte Fine-Tuning- und Evaluations-Workflow ist unten dargestellt:
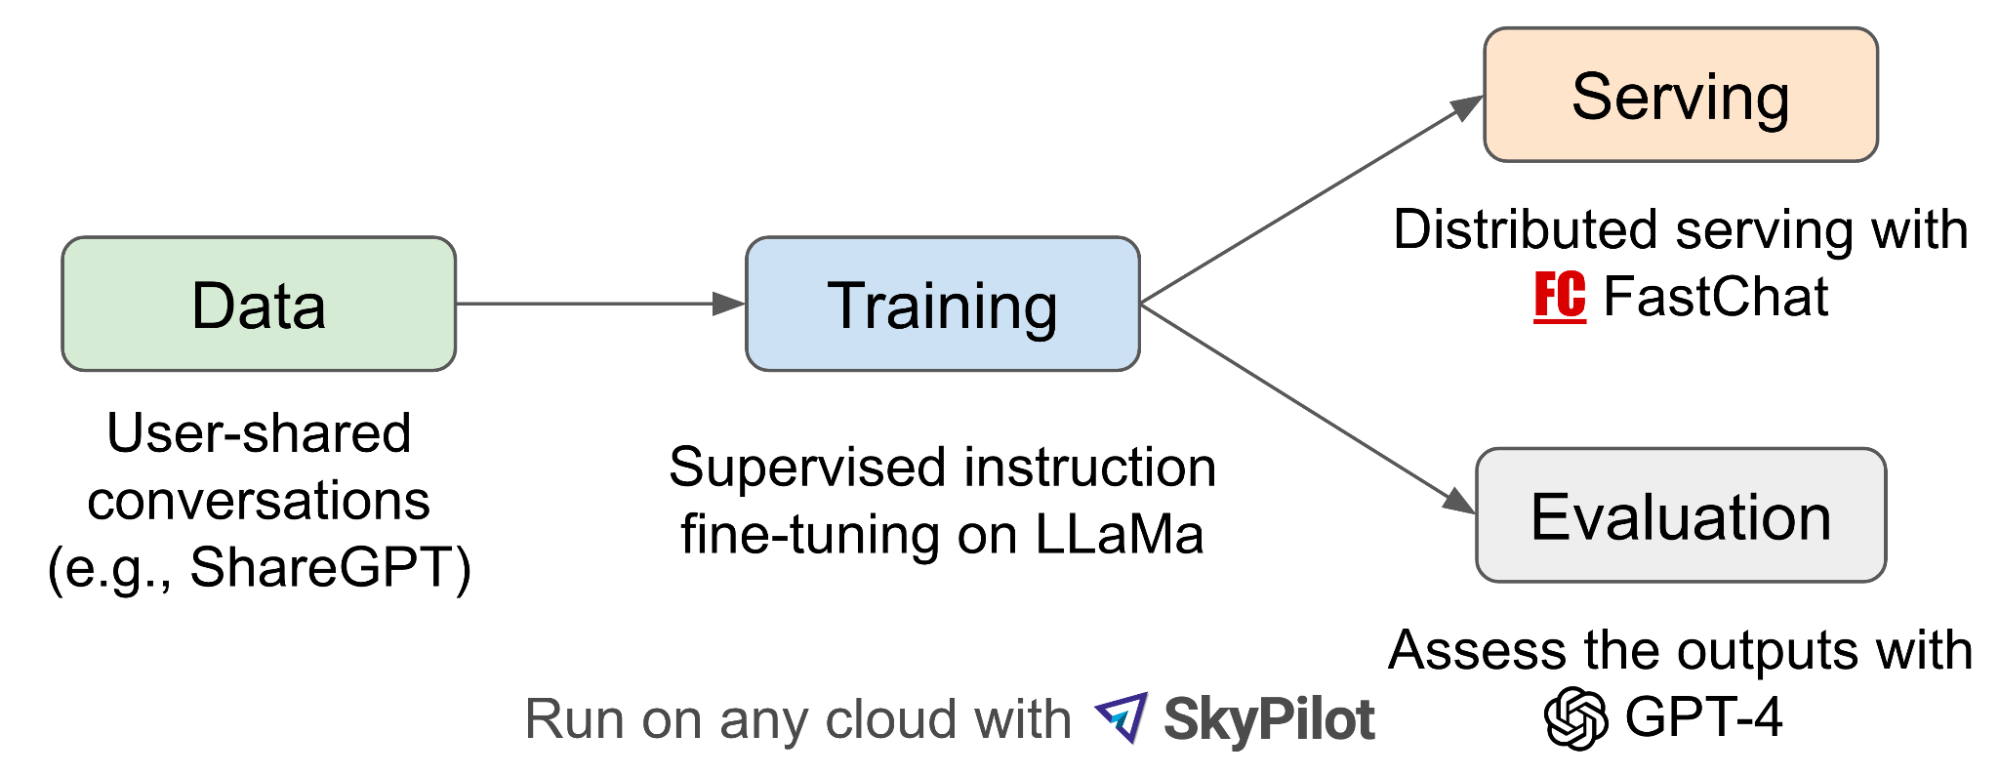
Vicuna-13B Fine-Tuning- und Evaluations-Workflow (Quelle)
Das unterstreicht die Stärken von Vicuna-13B, dennoch hat das Modell auch Grenzen und ist insbesondere bei Aufgaben wie Mathematik und komplexem Schließen nicht führend.
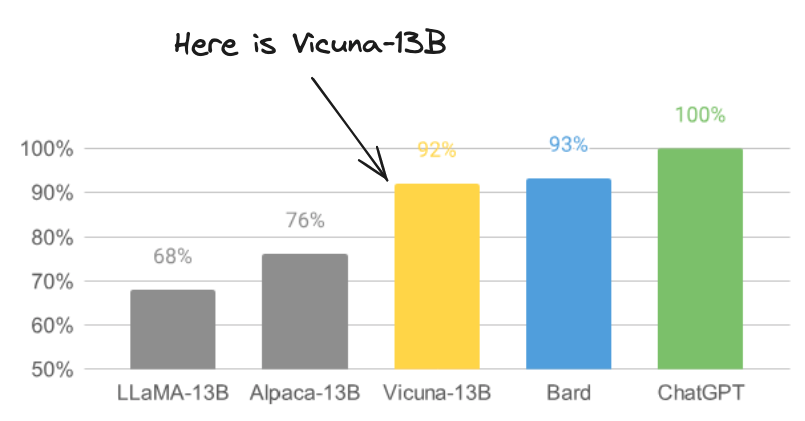
Bild von LMSYSORG, bearbeitet vom Autor
Als intelligenter Chatbot sind die Einsatzmöglichkeiten von Vicuna-13B nahezu unbegrenzt. Einige Beispiele aus verschiedenen Branchen wie Kundenservice, Gesundheitswesen, Bildung, Finanzwesen sowie Reise- und Gastgewerbe siehst du unten.
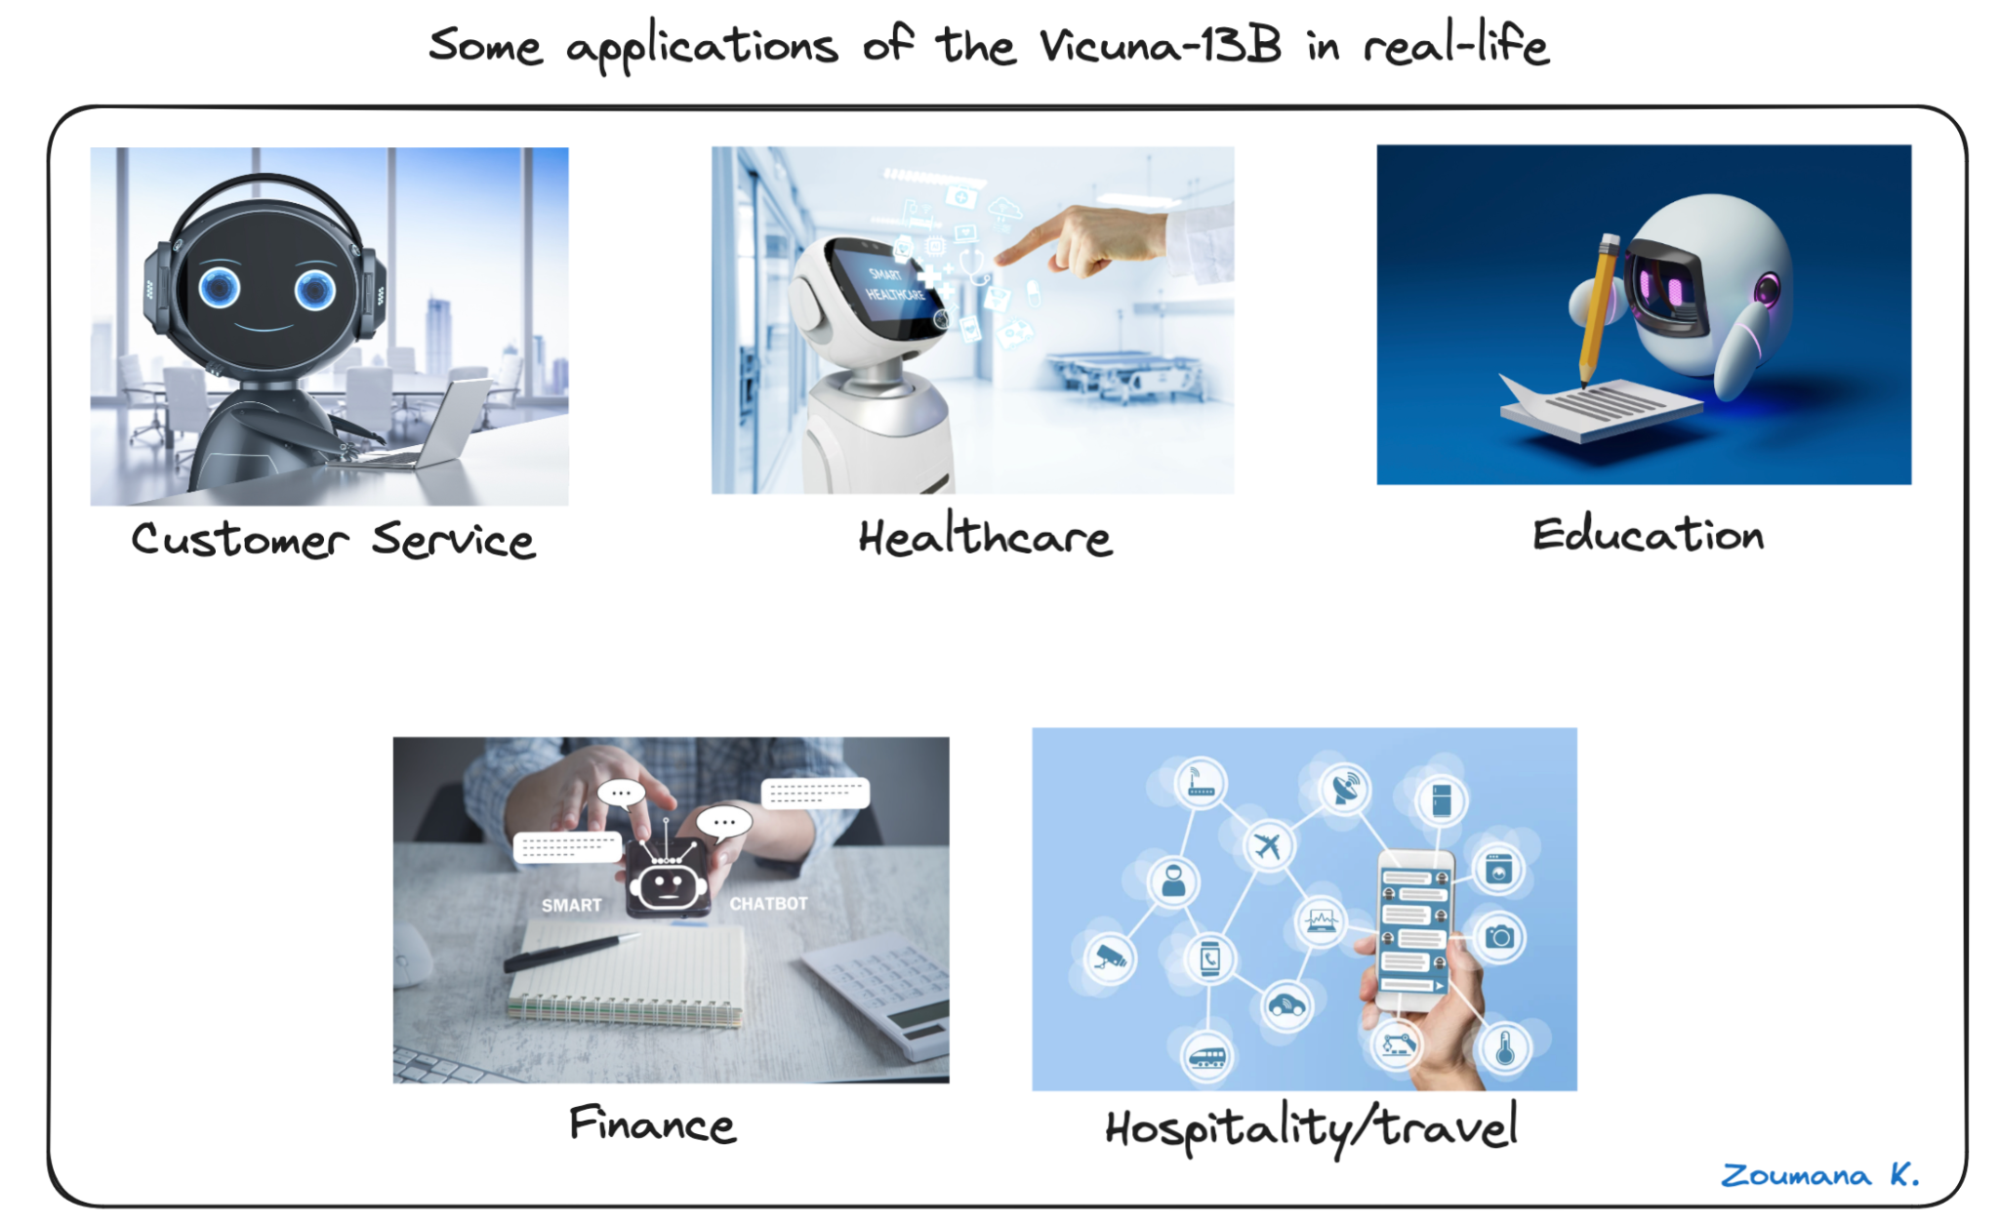
Fünf verschiedene Anwendungen von Vicuna-13 im echten Leben
Die Liste ist längst nicht vollständig. In unserem Artikel How NLP is changing the future of Data Science erfährst du, wie NLP die Zukunft von Data Science und Machine Learning prägt, welche Anwendungen sich abzeichnen, welche Risiken bestehen und wie man sie mindert.
Angesichts dieser Praxisbeispiele ist klar: Die Nachfrage nach KI-gestützten Dialogagenten wie Vicuna-13B ist in vielen Schlüsselbranchen enorm.
Wer solche Technologien implementieren und in bestehende Workflows integrieren kann, verschafft sich einen handfesten Vorteil. Immer mehr Unternehmen nutzen diese Lösungen, um Kundenerlebnisse zu verbessern, mehr Leads zu generieren und ihre Rendite zu steigern.
Gute Nachrichten: Genau dafür ist dieses Tutorial gedacht. Es hilft dir, die nötigen Kompetenzen aufzubauen, um das Vicuna-13B-Modell auszuführen und in beliebige Geschäftsprozesse einzubinden.
Bevor wir das Vicuna-13B-Modell ausführen, müssen wir die Voraussetzungen sauber einrichten. Dazu gehören:
Sind diese Punkte erfüllt, verstehen wir die Ein- und Ausgabeformate besser und können das Modell erfolgreich starten.
Ein gutes Verständnis der Ein- und Ausgabeformate von Vicuna-13B gibt Entwicklerinnen und Entwicklern ein Fundament, um Faktoren zu erkennen, die die Entscheidungen des Modells beeinflussen.
In diesem Abschnitt erklären wir die wichtigsten Eingabeparameter sowie das erwartete Ausgabeformat des Vicuna-13B-Modells.
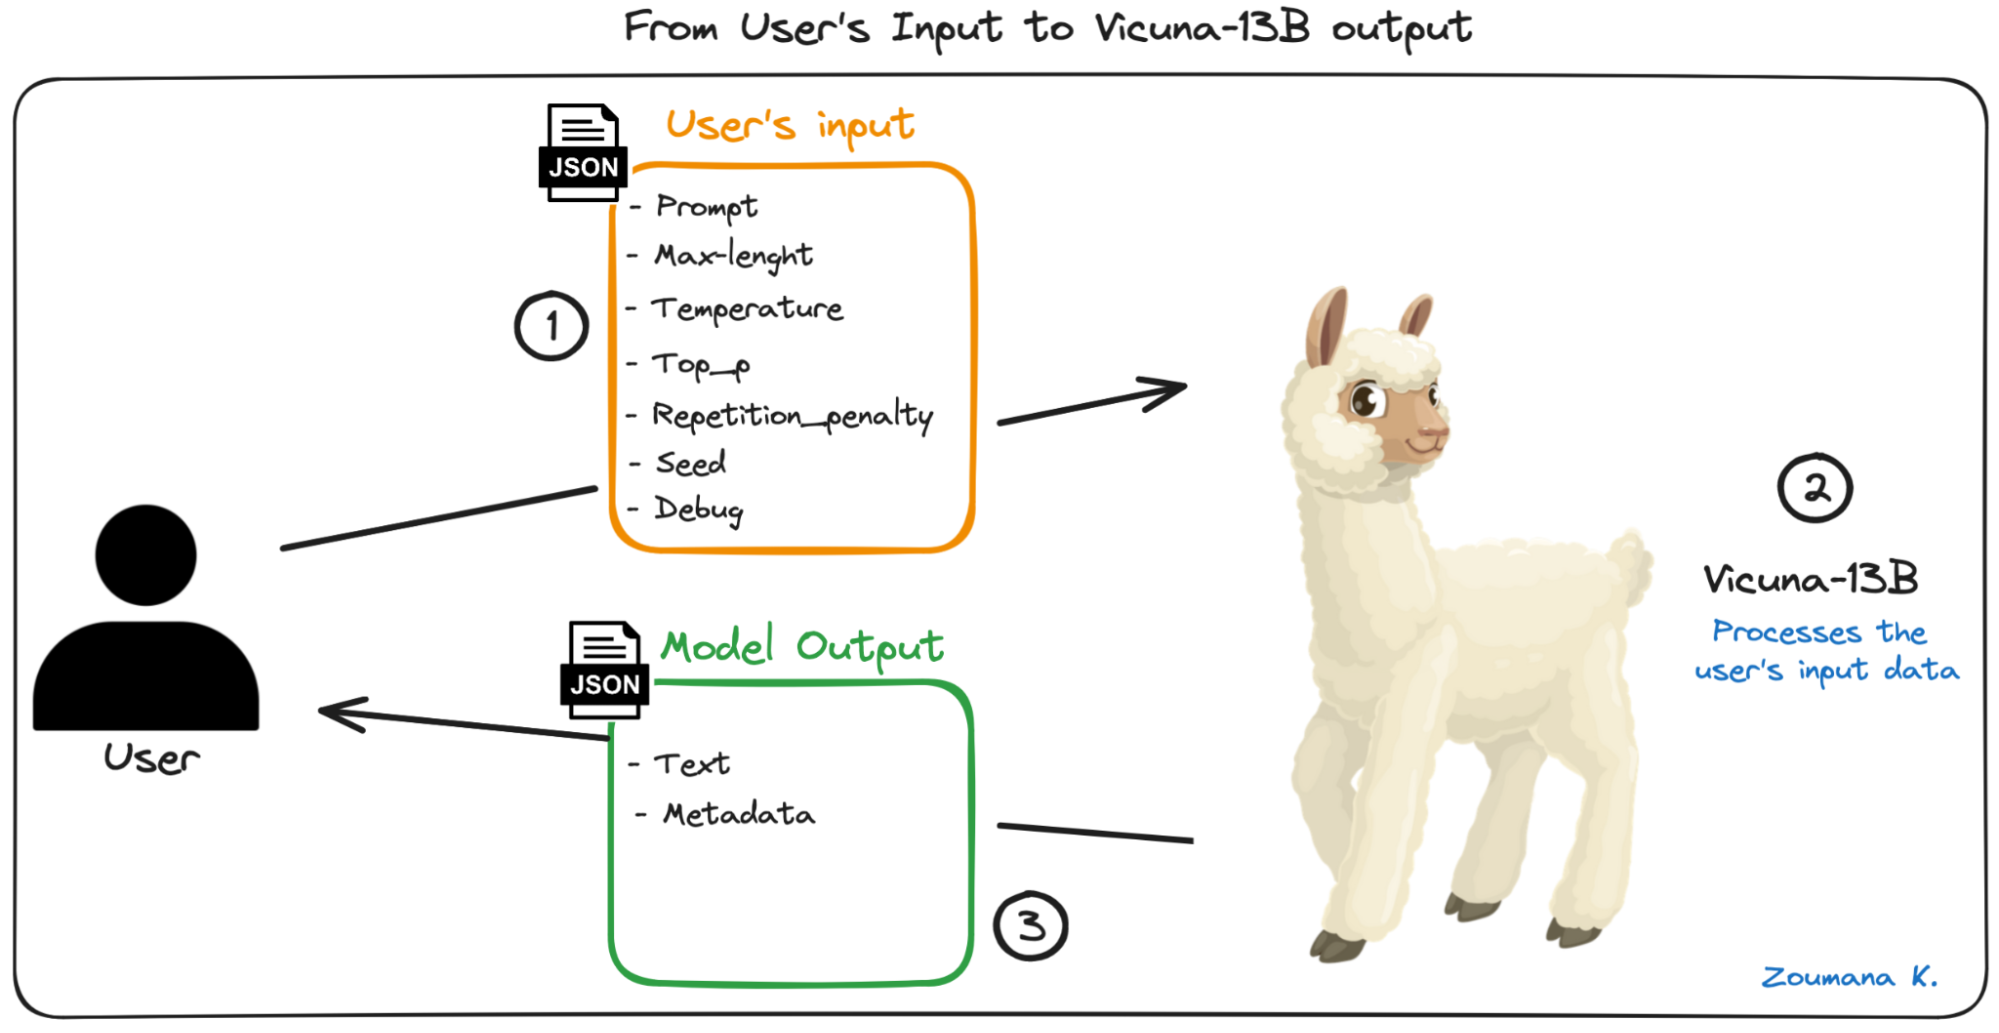
Minimalistischer End-to-End-Workflow
So funktioniert der Ablauf: Zuerst übergibt der oder die Nutzende die gewünschte Eingabe, darunter den Prompt – also die eigentliche Textanfrage, auf die eine Antwort gewünscht ist.
Zusätzlich zum Prompt können folgende Parameter angegeben werden:
Nach dem Absenden des Prompts mitsamt Parametern generiert Vicuna-13B die Ausgabe. Sie folgt im Wesentlichen diesem Schema:
Mit dem Verständnis von Ein- und Ausgabe können wir nun die zentralen Bibliotheken identifizieren, um das Vicuna-Modell erfolgreich auszuführen.
Alle Befehle in diesem Abschnitt laufen im Terminal. Mit dem Befehl conda create legen wir eine virtuelle Umgebung namens vicuna-env an.
conda create --name vicuna-envNach erfolgreicher Erstellung aktivieren wir die Umgebung mit conda activate wie folgt:
conda activate vicuna-envDanach sollte der Name der Umgebung in Klammern am Anfang der Terminalzeile erscheinen, zum Beispiel so:
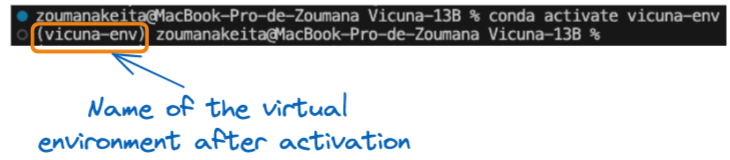
Name der virtuellen Umgebung nach der Aktivierung
Die Bibliotheken kannst du auf zwei Arten installieren. Variante eins: Jede Bibliothek mit pip install separat installieren. Das ist bei vielen Paketen zeitaufwändig und in professionellen Setups nicht ideal.
Variante zwei ist die bessere Wahl: Ein requirements.txt-File mit allen benötigten Paketen nutzen. Unten siehst du den Inhalt der requirements.txt und die Installation mit einem einzigen pip install-Befehl.
# Content of the requirements.txt file

llama-cpp-python==0.1.48
fastapi
uvicorn[standard]
Alle drei Bibliotheken installierst du so:
pip install -r requirements.txtÜber die Plattform Hugging Face kannst du die Gewichte des Vicuna-Modells wie unten gezeigt herunterladen:
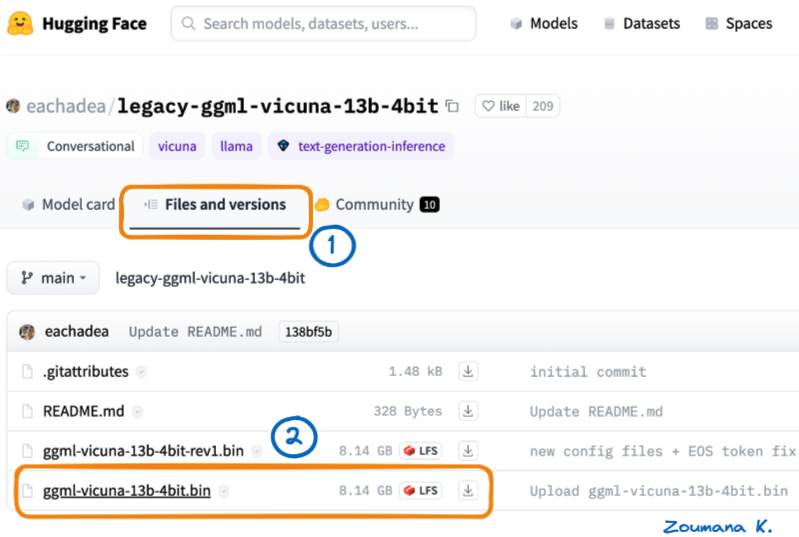
Zwei Schritte, um das Vicuna-13B-Gewicht von Hugging Face herunterzuladen
Zur besseren Strukturierung kannst du die heruntergeladene Gewichtsdatei in einen neuen Ordner model verschieben.
Auch wenn sich das Modell über die Kommandozeile ausführen lässt, ist eine API-Schnittstelle in der Praxis oft sinnvoller. So wird das Modell für deutlich mehr Nutzerinnen und Nutzer leicht zugänglich.
Dafür sind folgende Schritte nötig:
Die Struktur des Quellcodes siehst du unten. Der vollständige Code liegt auf GitHub.
------ model
         |------- ggml-vicuna-13b-4bit.bin

------ requirements.txt
------ vicuna_app.py
ggml-vicuna-13b-4bit.bin ist die heruntergeladene Gewichtsdatei im Ordner model.requirements.txt enthält die Abhängigkeiten zur Ausführung des Modells.vicuna_app.py enthält den Python-Code zur Erstellung der API – darauf liegt hier der Fokus.Wir benötigen zwei Hauptrouten. Zuvor importieren wir die Bibliotheken, laden das Modell und erstellen eine FastAPI-Instanz.
# Import the libraries
from fastapi import FastAPI, HTTPException
from llama_cpp import Llama

# Load the model
vicuna_model_path = "./model/ggml-vicuna-13b-4bit.bin"
vicuna_model = Llama(model_path=vicuna_model_path)

app = FastAPI()"/" liefert über die Funktion home() ohne Parameter das JSON "Message": "Welcome to the Vicuna Demo FastAPI" zurück.# Define the default route
@app.get("/")
def home():
return {"Message": "Welcome to the Vicuna Demo FastAPI"}"/vicuna_says" ruft die Funktion answer_prompt() auf. Sie nimmt den Prompt der Nutzerin bzw. des Nutzers entgegen und gibt eine JSON-Antwort mit dem Ergebnis des Vicuna-Modells sowie zusätzlichen Metadaten zurück.@app.post("/vicuna_says")
def answer_prompt(user_prompt):
if (not (user_prompt)):
raise HTTPException(status_code=400,
detail="Please Provide a valid text message")
response = vicuna_model(user_prompt)
return {"Answer": response}Die API startest du im Verzeichnis der Datei vicuna_app.py mit folgendem Befehl:
uvicorn vicuna_app:app --reloaduvicorn startet den Uvicorn-Server.vicuna_app: Entspricht der Python-Datei vicuna_app.py. Sie steht links vom Doppelpunkt.app: Ist das in vicuna_app.py erstellte Objekt app = FastAPI(). Hieße die Datei main.py, wäre der Befehl uvicorn main:app --reload.--reload: Option, die den Server nach Codeänderungen automatisch neu startet – nur für Entwicklung, nicht für Produktion.So sieht die Ausgabe des Befehls aus. Der Server läuft lokal auf Port 8000 (http://127.0.0.1:8000).
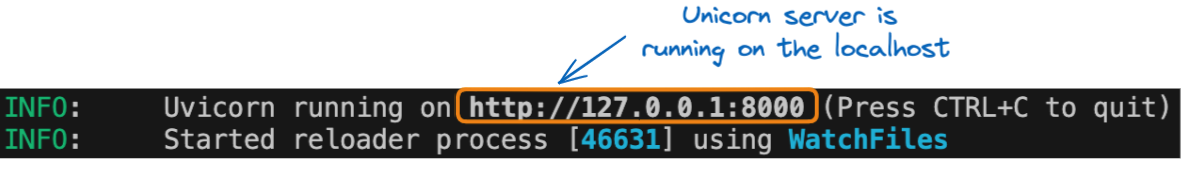
URL der lokal laufenden API
Die Default-Route rufst du einfach im Browser über folgende URL auf.
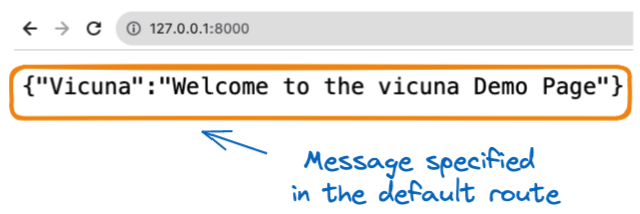
Antwort der Default-Route
Spannend wird es unter http://127.0.0.1:8000/docs. Dort findest du ein komplettes Interface zur Interaktion mit der API. Das Ergebnis siehst du unten.
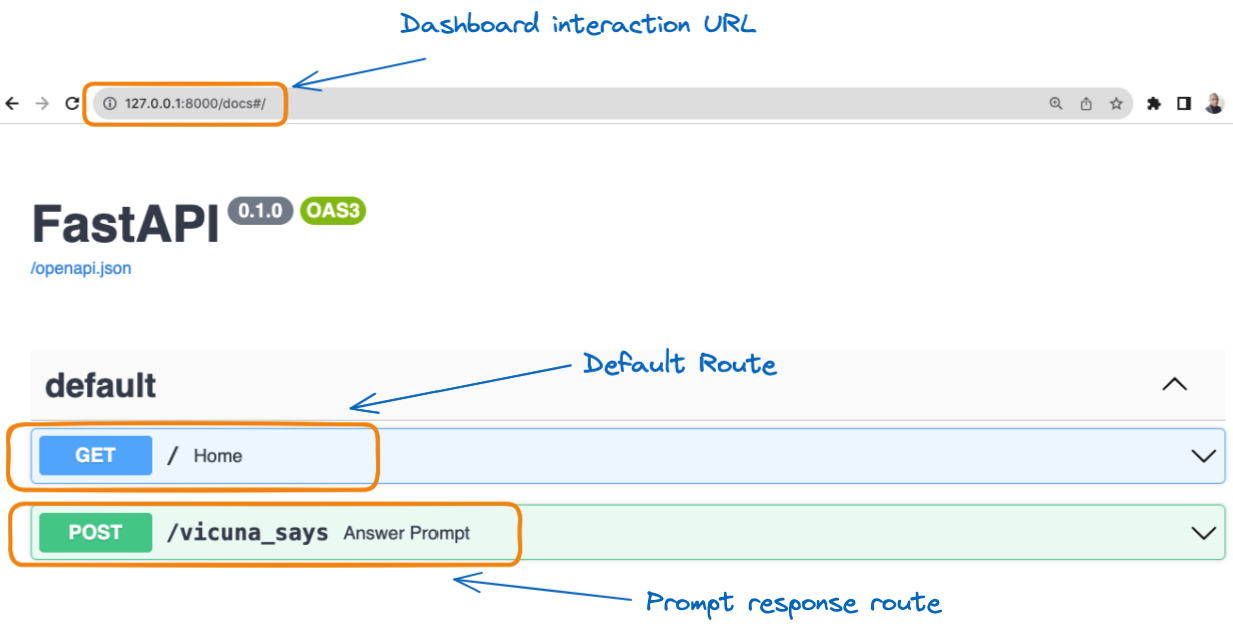
Grafische Darstellung der beiden Routen
Wählst du im vorherigen Bild /vicuna_says im grünen Kasten, erhältst du eine Anleitung zur Interaktion mit der API, wie unten gezeigt.
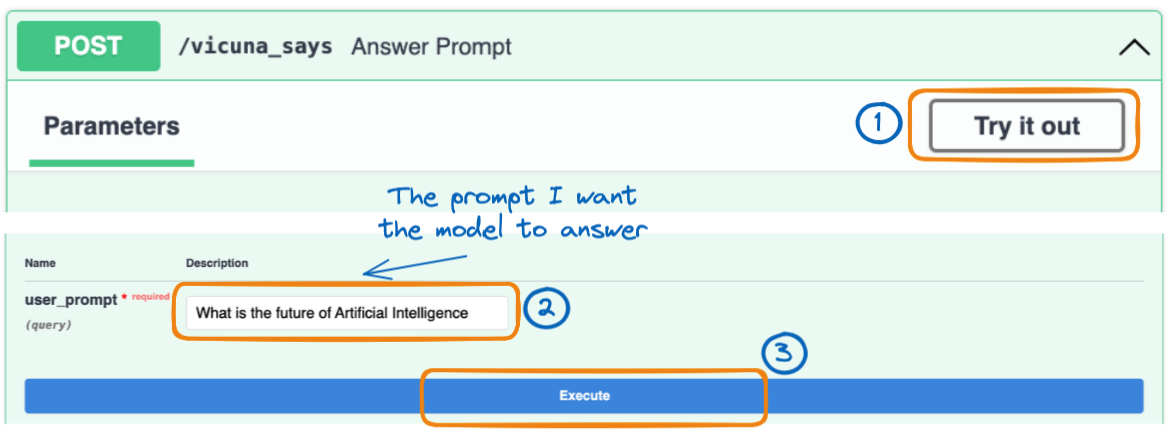
Die drei Schritte zur Ausführung des Nutzerprompts
Klicke auf Try it out und gib im Feld text_message die Nachricht ein, für die du eine Antwort möchtest.
Nach Klick auf Execute erhältst du das folgende Ergebnis.
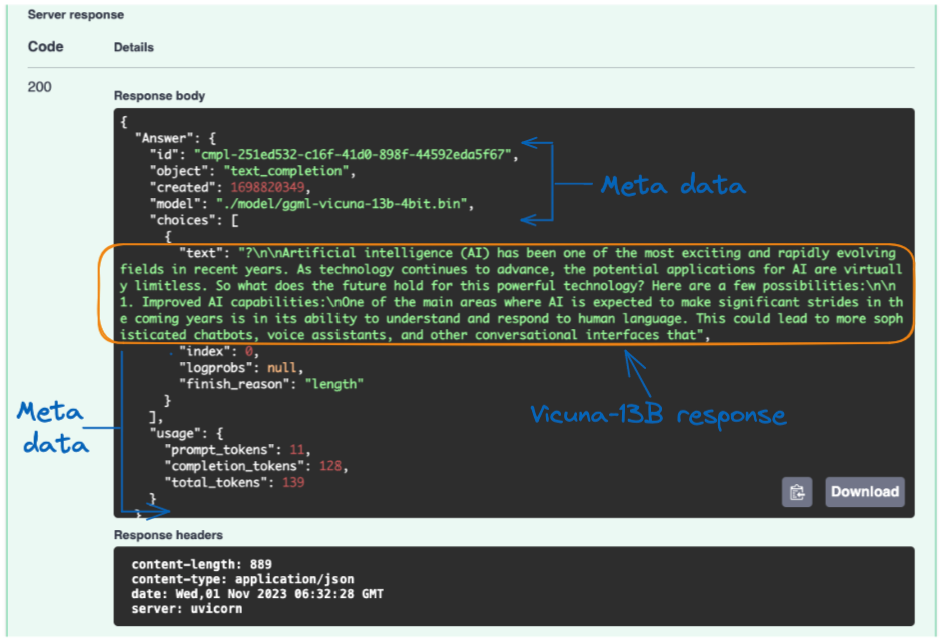
Serverantwort des Vicuna-Modells auf die Nutzeranfrage
Die Antwort des Vicuna-Modells steht im Feld „text“ – und sie kann sich sehen lassen.
Zusätzliche Metadaten wie das verwendete Modell, das Erstellungsdatum der Antwort, die Anzahl der Tokens im Prompt und in der Antwort sind ebenfalls enthalten.
Die Bereitstellung eines so leistungsfähigen Modells verbessert Nutzererlebnis und Effizienz auf mehreren Ebenen, unter anderem:
Kurz gesagt: Ein Deployment macht die Arbeit mit Vicuna-13B zugänglicher, zuverlässiger und vielseitiger – und damit für verschiedenste Nutzergruppen und Anwendungen attraktiver.
Beim Arbeiten mit Vicuna-13B helfen dir einige Best Practices und Tipps, Performance zu optimieren, bessere Ergebnisse zu erzielen und typische Probleme schnell zu beheben.
Mit diesen Empfehlungen sorgst du für einen reibungsloseren Ablauf und überzeugendere Resultate.
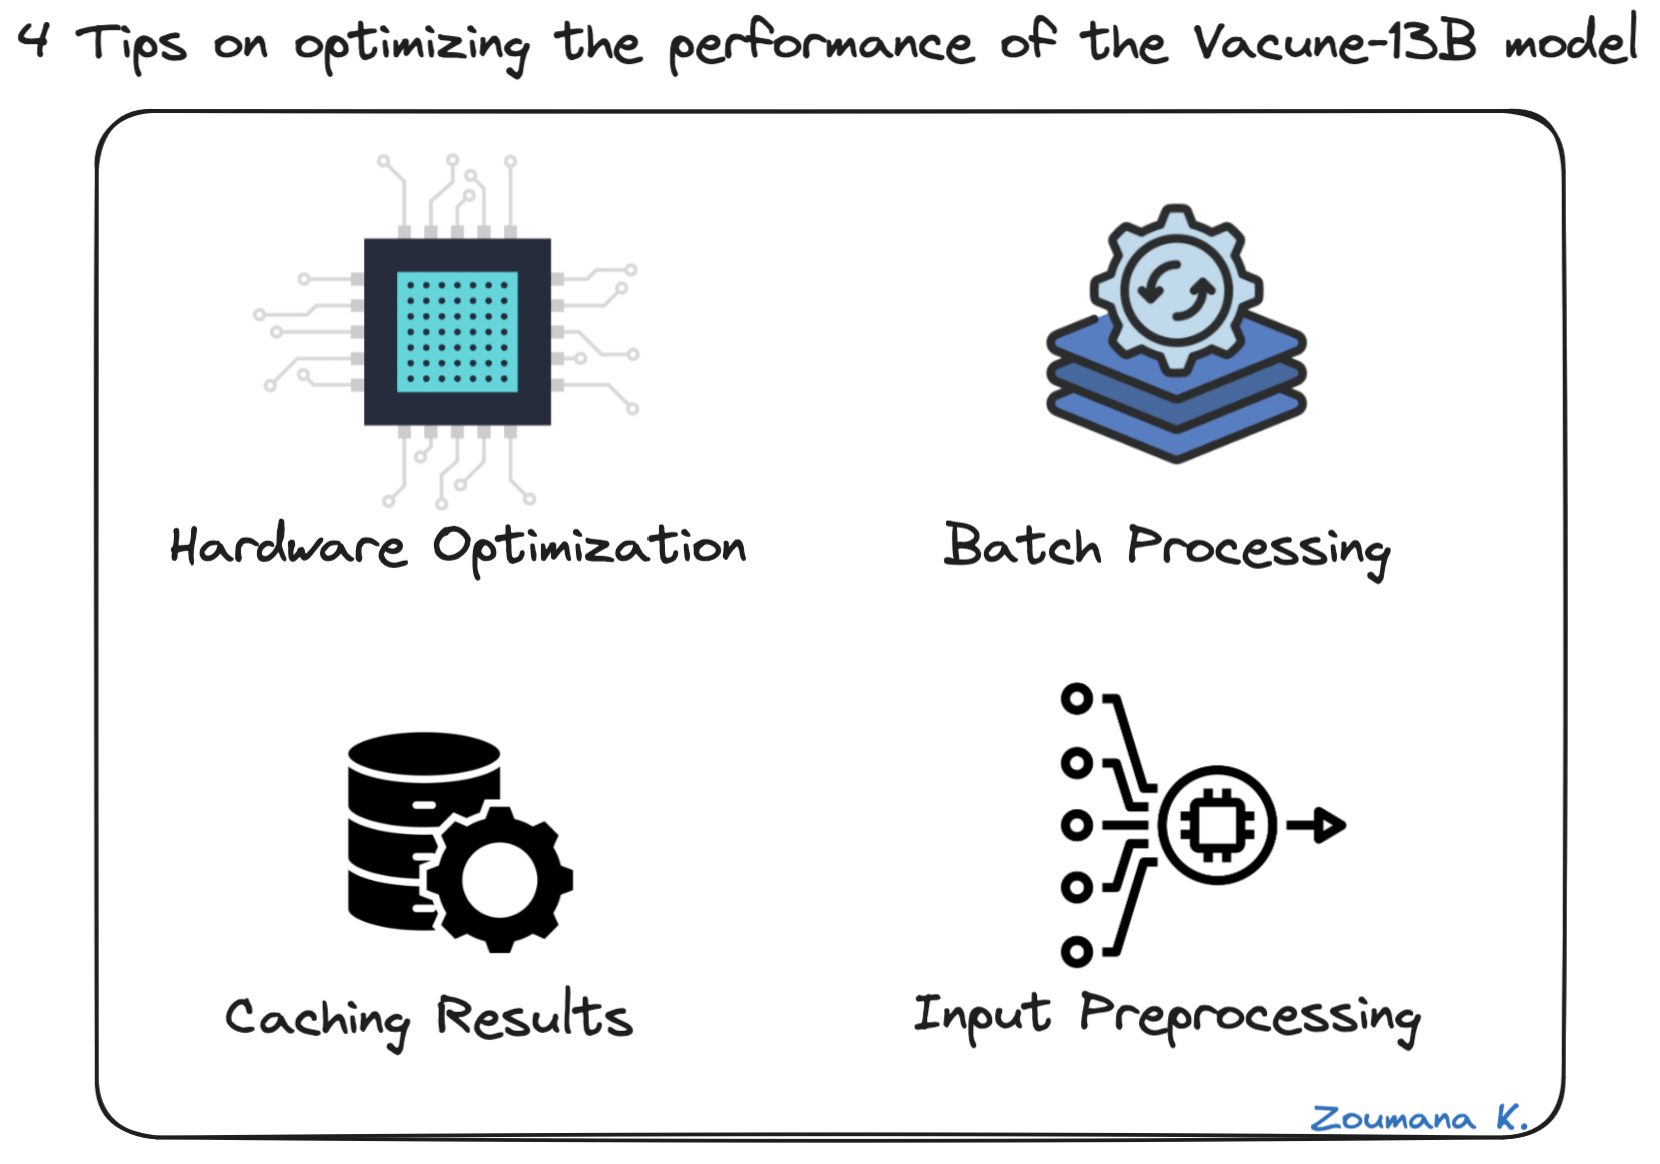
4 Tipps zur Performance-Optimierung von Vicuna-13B
Neben der Optimierung ist es wichtig, typische Fehlerbilder schnell zu erkennen. Vier Beispiele:
Häufige Troubleshooting-Themen
Zusammengefasst hast du in diesem Artikel eine umfassende Einführung in Einrichtung und Nutzung des Vicuna-13B-Modells erhalten. Wir haben die Voraussetzungen besprochen – von Hardware und Software bis zur Beschaffung der für den Betrieb nötigen LLaMa-Gewichte.
Du hast eine Schritt-für-Schritt-Anleitung zur Einrichtung der Arbeitsumgebung, zur Installation der Software und zum Einrichten der Gewichte von Vicuna-13B bekommen – inklusive der Bedeutung von Gewichten bei Sprachmodellen.
Außerdem haben wir Packaging und Deployment beleuchtet und gezeigt, wie eine Bereitstellung die Nutzung über Web-Interface und API erleichtert.
Zum Schluss gab es praktische Hinweise zur Interaktion mit Vicuna-13B, Beispiele seiner Fähigkeiten sowie Best Practices zur Performance-Optimierung und zum Troubleshooting.
Bist du bereit, tiefer in die Welt der KI und des Machine Learnings einzusteigen? Stärke deine Kompetenzen mit dem leistungsstarken Deep-Learning-Framework der Profis. Starte jetzt mit dem Kurs Deep Learning with PyTorch.
Starte heute deine KI-Reise!
Kurs
Lernpfad
Kurs