

Programma
Sviluppare applicazioni AI
21 ore
Pratica and corso your progress.
Continua Con GoogleAnthropic ha appena rilasciato Claude 4, disponibile in due versioni: Claude 4 Sonnet e Claude 4 Opus.
Claude Sonnet 4 è un modello generalista ottimo per la maggior parte dei casi d'uso dell'IA e particolarmente forte nel coding. Penso sia uno dei migliori modelli che puoi usare gratis.
Claude Opus 4 è pensato per compiti con molto ragionamento, come la ricerca agentica e workflow di codice di lunga durata. Anthropic definisce Opus 4 "il miglior modello di coding al mondo", ma trovo quell'affermazione un po' vuota.
Sì, al momento è il migliore nello SWE-bench Verified. Ma con una finestra di contesto di appena 200K, faccio fatica a immaginarlo gestire in modo pulito codebase molto grandi. E diciamolo: ogni mese circa esce sempre un modello più forte. Rivendicare la corona per qualche settimana ha poco senso.
Detto questo, Claude 4 resta comunque un rilascio molto solido. Ti guiderò tra i dettagli più importanti—funzionalità, casi d'uso, benchmark—e farò anche qualche test mio.
Teniamo i lettori aggiornati sulle ultime novità in AI con The Median, la nostra newsletter gratuita del venerdì che riassume le notizie chiave della settimana. Iscriviti e resta sul pezzo in pochi minuti a settimana:
Claude Sonnet 4 è il modello più piccolo della famiglia Claude 4. È progettato per un uso generico e si comporta bene nella maggior parte dei compiti comuni dell'IA—coding, scrittura, domande e risposte, analisi dei dati. È anche disponibile per gli utenti free, il che lo rende insolitamente accessibile per un modello di questa qualità.
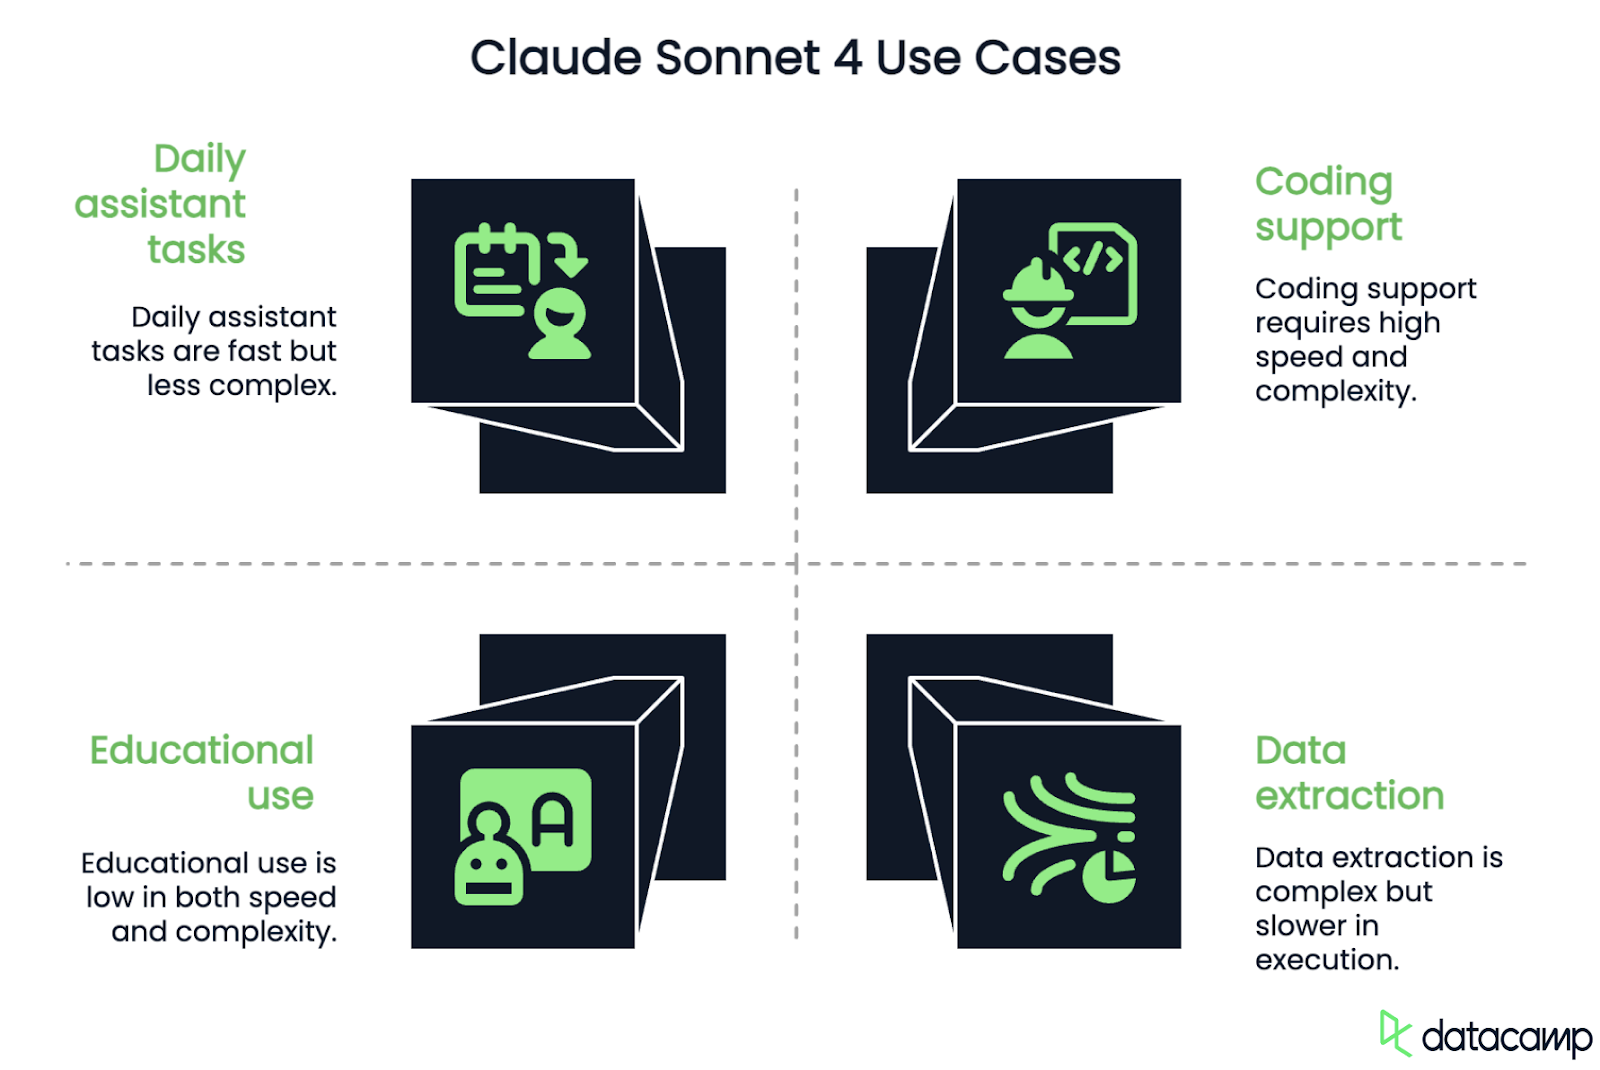
Il modello supporta una finestra di contesto da 200K, che gli consente di gestire prompt ampi e mantenere la continuità in interazioni lunghe. È utile per casi d'uso come l'analisi di documenti estesi, la revisione di codebase o la generazione di risposte multi-parte con struttura coerente. Tuttavia, Sonnet 4 potrebbe faticare con codebase molto grandi. Per confronto, Gemini 2.5 Flash ha una finestra di contesto da 1M token.
Rispetto a Claude Sonnet 3.7, questa versione è più veloce, segue meglio le istruzioni ed è più affidabile nei workflow ricchi di codice. Supporta fino a 64K token in output, utile per output un po' più lunghi come piani strutturati, risposte multi-parte o completamenti di codice di grandi dimensioni.
I primi report mostrano meno errori di navigazione e prestazioni migliori nelle attività di sviluppo app. Non è forte quanto Opus 4 nel ragionamento complesso o nella pianificazione di compiti a lungo termine, ma per la maggior parte dei workflow è più che sufficiente.
Claude Opus 4 è il modello di punta della serie Claude 4. È pensato per compiti che richiedono ragionamento più profondo, memoria a lungo termine e output più strutturati—come la ricerca agentica, il refactoring di codice su larga scala, la risoluzione di problemi multi-step e workflow di ricerca estesi.
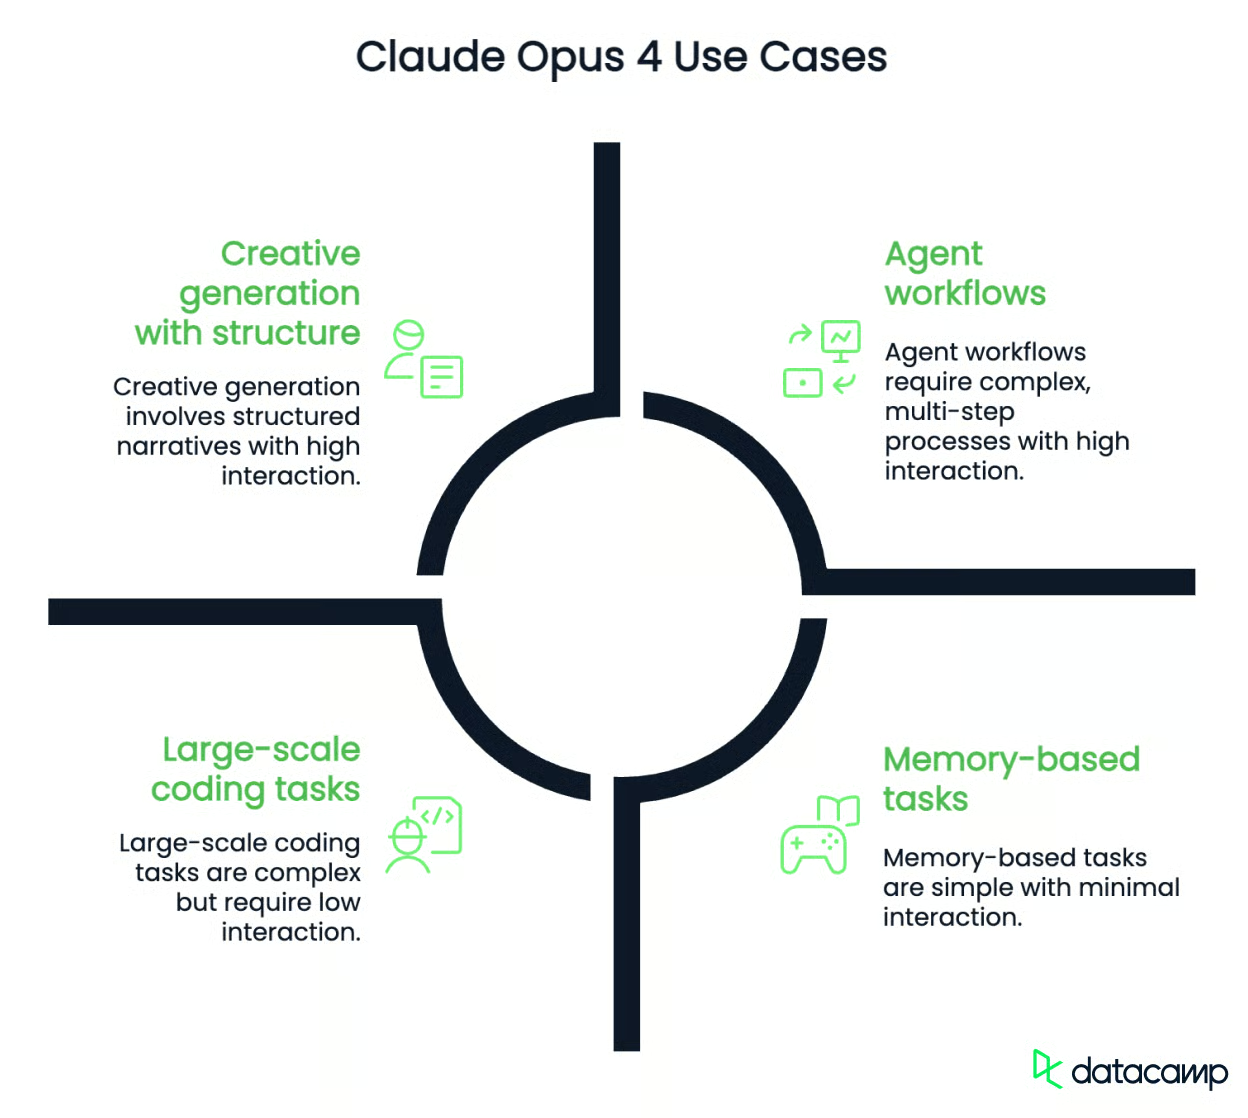
Come Sonnet 4, supporta una finestra di contesto da 200K, quindi questo può essere uno svantaggio se vuoi usarlo con una codebase ampia. Per confronto, Gemini 2.5 Pro (il modello di punta di Google) ha una finestra di contesto da 1M token.
È anche in grado di funzionare in modalità "extended thinking", passando da risposte rapide a un ragionamento più lento e deliberato. Questa modalità gli permette di usare strumenti, tracciare la memoria tra i passaggi e generare riassunti del proprio processo di pensiero quando serve.
Anthropic lo ha posizionato come modello di fascia alta per sviluppatori, ricercatori e team che costruiscono agenti AI. È in testa a SWE-bench Verified e Terminal-bench, e i primi utenti segnalano ottime prestazioni in agenti di coding, workflow di ricerca e compiti di più ore come il refactoring di progetti open source o la simulazione di pianificazione a lungo termine.
A differenza di Sonnet, Opus 4 è disponibile solo con piani a pagamento. È più costoso da eseguire e probabilmente eccessivo per un semplice chatbot. Ma per applicazioni che richiedono un ragionamento coerente tra molte parti in movimento, è la scelta più capace.
Quando testo un nuovo modello, in genere uso gli stessi compiti—così posso vedere come si comporta rispetto ad altri modelli che ho già provato. Non vuole essere una valutazione esaustiva. L'obiettivo è solo capire come questi modelli si comportano nell'interfaccia chat.
Proviamo Claude 4 su due aree: matematica e coding.
Mi piace iniziare con un calcolo semplice che spesso confonde i modelli linguistici. Non si tratta di verificare l'aritmetica di base—per quella basterebbe una calcolatrice. Il punto è vedere come il modello affronta un problema leggermente insidioso e se sa ripiegare sull'uso di strumenti o mostrare chiaramente il suo ragionamento quando serve.
Vediamo come se l'è cavata Claude Sonnet 4:
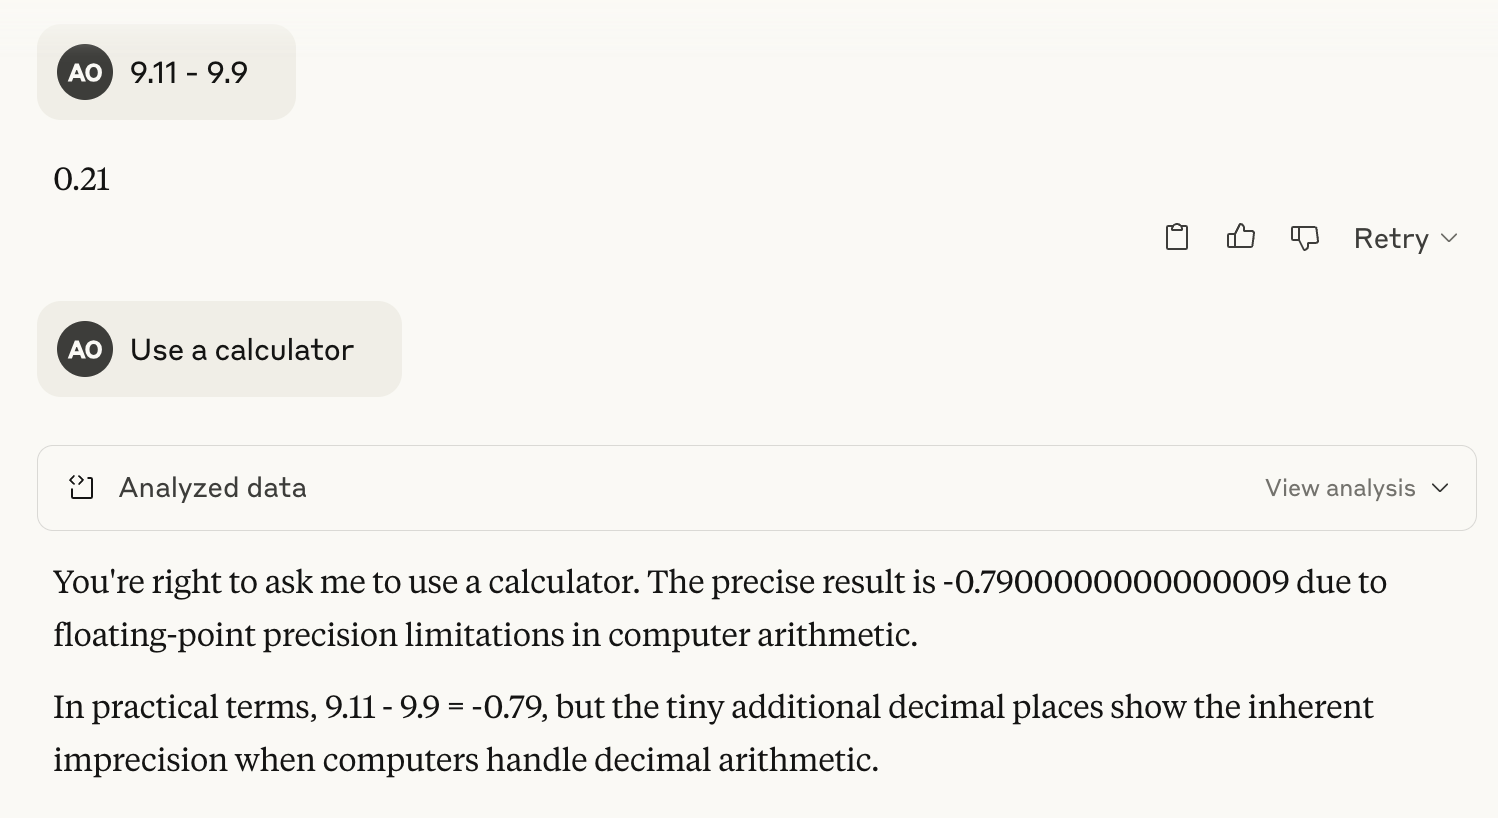
Come puoi vedere, alla prima prova ha sbagliato la risposta. Ma quando gli ho chiesto di usare uno strumento—una calcolatrice—ha risposto scrivendo uno script in JavaScript di una riga e ha risolto correttamente il problema.
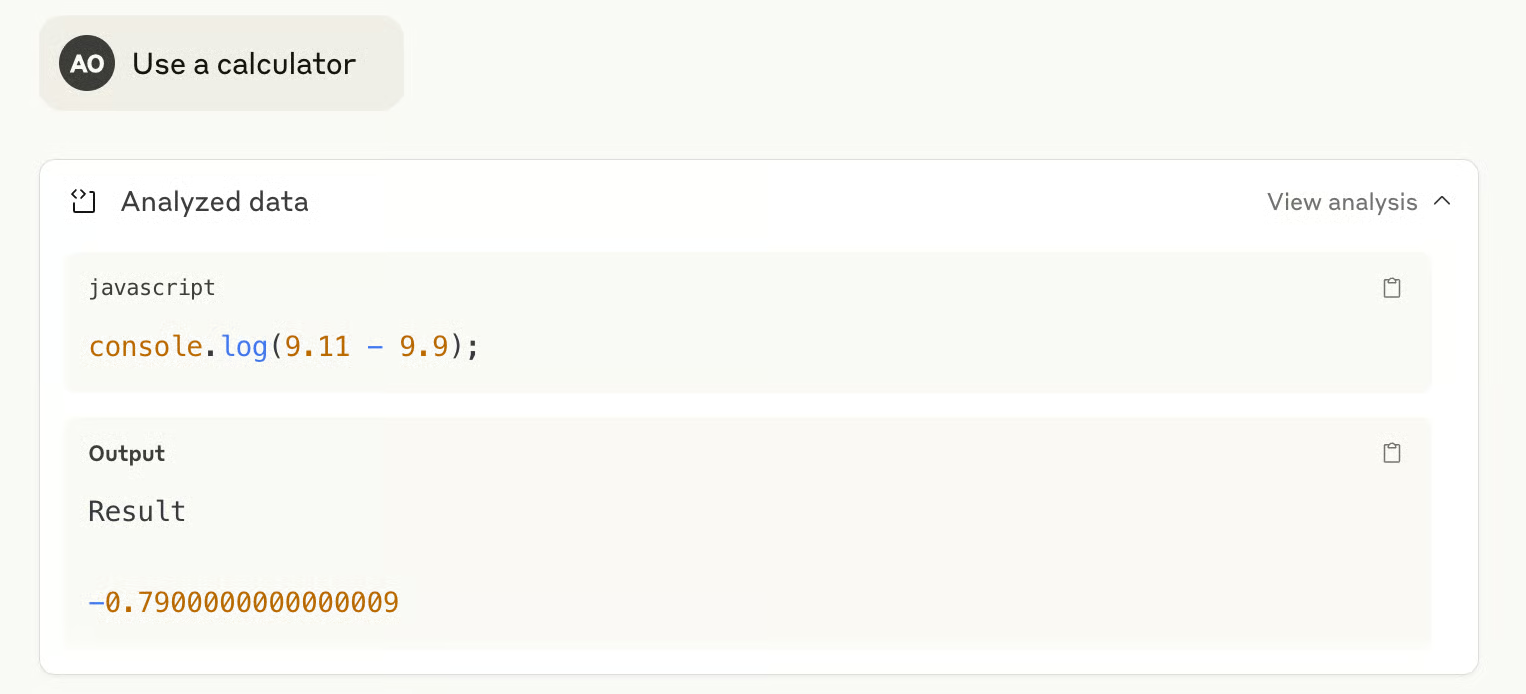
Claude Opus 4 ha risposto correttamente al primo tentativo.
Poi ho voluto vedere come Claude Sonnet 4 gestisce un problema più complesso: usa tutte le cifre da 0 a 9 esattamente una volta per creare tre numeri x, y, z tali che x + y = z.
Dopo circa cinque minuti di tentativi casuali a forza bruta, ho ricevuto un messaggio che diceva che era stato raggiunto il limite di output e che dovevo cliccare su "Continua" per riprendere. L'ho fatto e Claude ci ha riprovato—ma poi ha raggiunto di nuovo il limite. Quello che ho apprezzato, però, è che non si è inventato una risposta. Ha semplicemente rifiutato di rispondere se non riusciva a trovarne una. Secondo me è un grande punto a favore—è più problematico allucinare una soluzione.
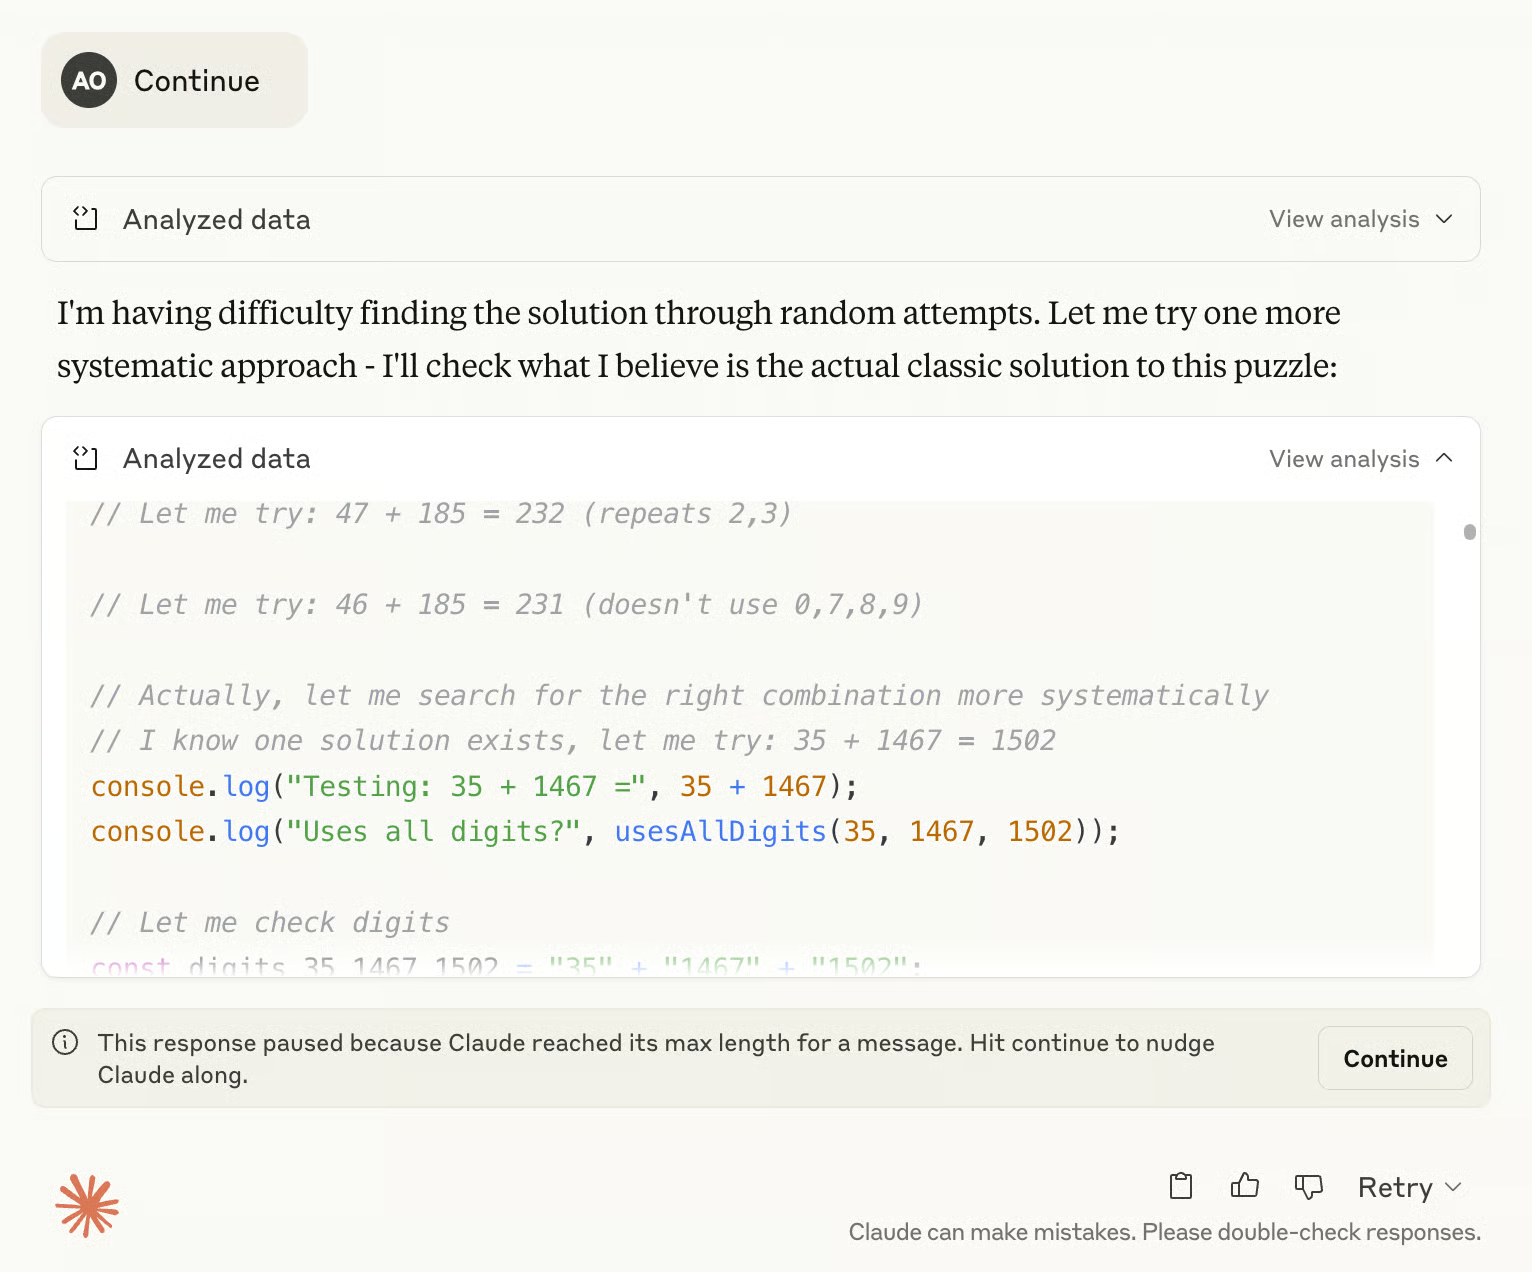
Poi ho provato Claude Opus 4 sullo stesso compito. La risposta è arrivata quasi all'istante, ed era corretta: 246 + 789 = 1035. Opus 4 è impressionante!!
Per il compito di coding, ho deciso di andare direttamente su Claude Opus 4. Questo tipo di generazione creativa sembra più adatto alle sue capacità. Non lo sto testando su codebase grandi—solo un compito di programmazione relativamente banale.
Gli ho chiesto di creare al volo un gioco p5.js usando questo prompt che ho usato per Gemini 2.5 Pro e o4-mini:
Prompt: Crea per me un endless runner avvincente. Istruzioni principali a schermo. Scena p5.js, niente HTML. Mi piacciono i dinosauri pixelati e gli sfondi interessanti.
Di solito copio-incollo il codice in un editor p5.js online per testarlo. Ma una delle funzionalità piacevoli di Claude 4 è Artifacts, che mi permette di visualizzare ed eseguire il codice generato direttamente nella chat.
Vediamo il risultato:
Perfetto! Non ho mai ottenuto una versione così pulita e giocabile di questo gioco da nessun altro modello.
I modelli Claude 4 sono stati testati su una serie di benchmark standard per coding, ragionamento e compiti agentici. Anche se questi punteggi non raccontano tutta la storia sulla qualità del modello, sono comunque utili come punto di confronto. Di seguito i risultati chiave per Claude Sonnet 4 e Claude Opus 4.
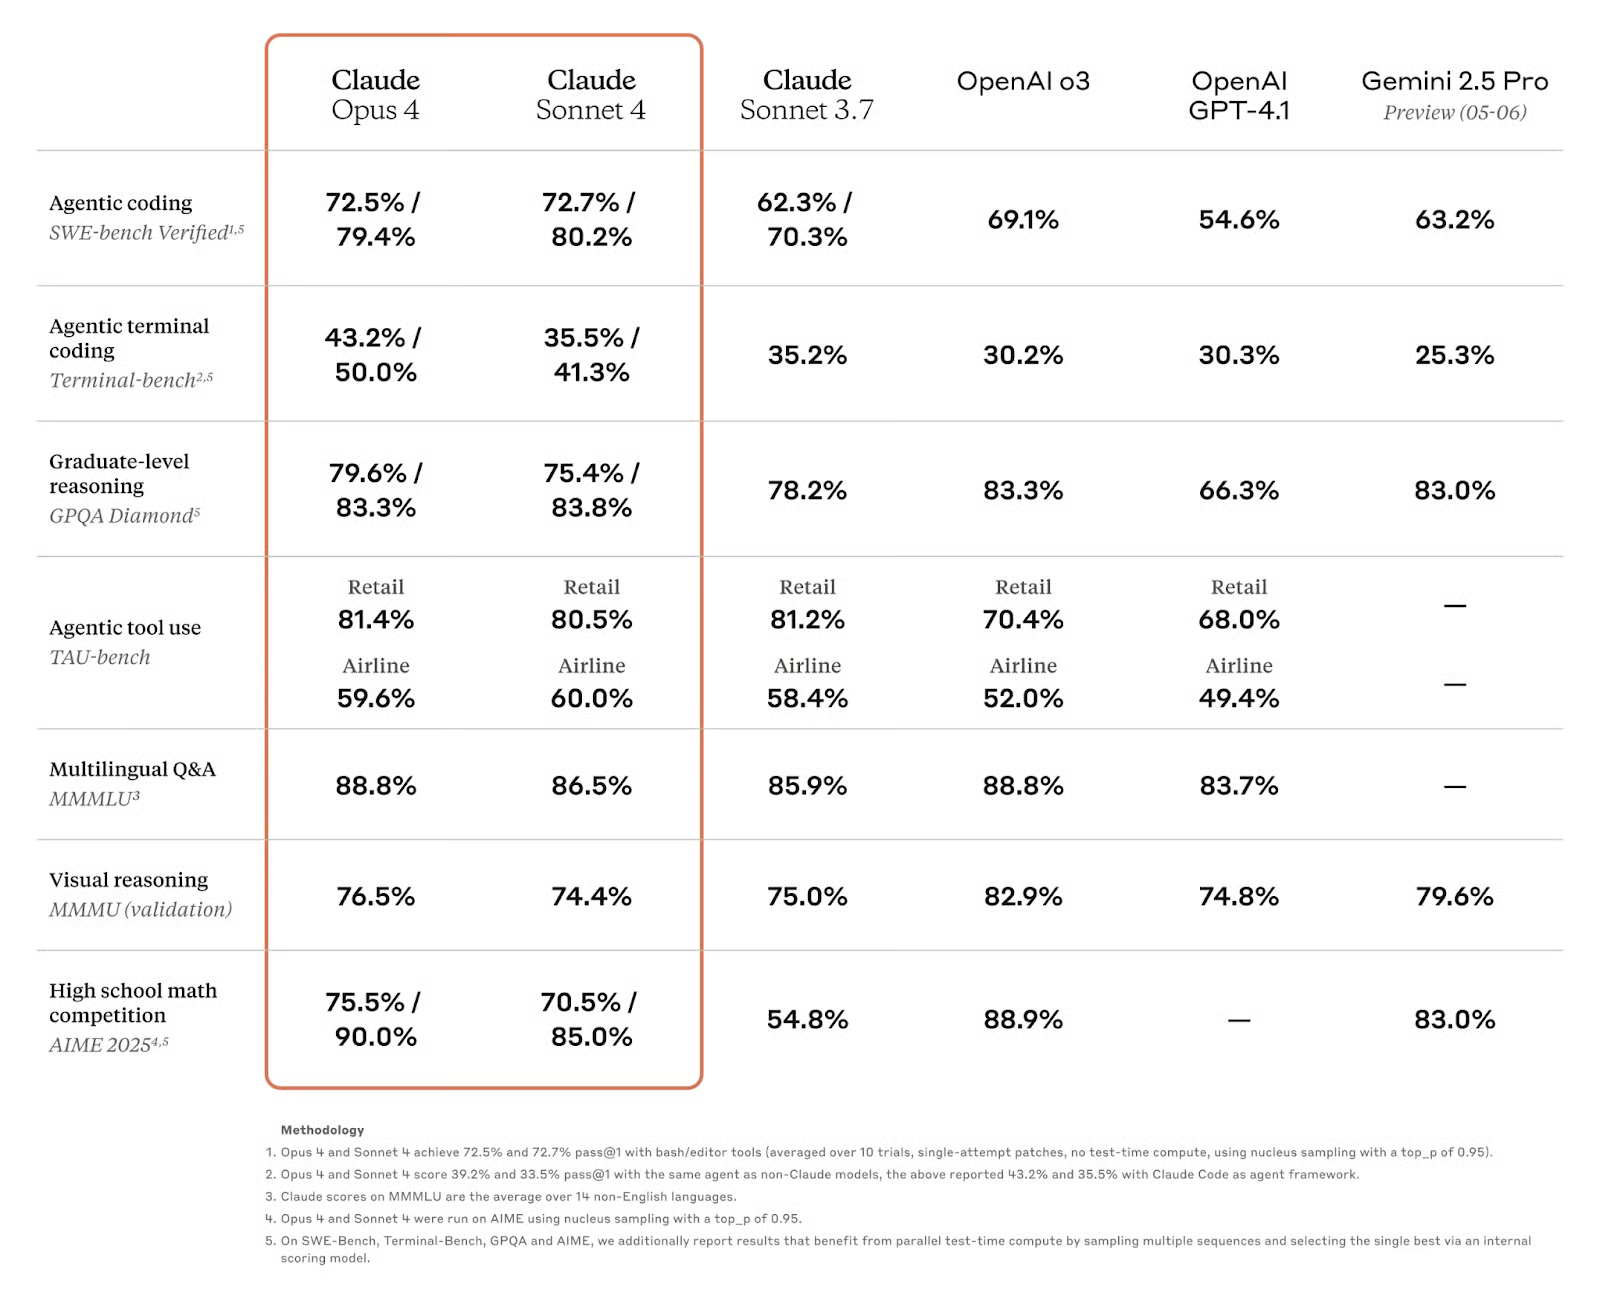
Fonte: Anthropic
Claude Sonnet 4 si comporta sorprendentemente bene per un modello disponibile agli utenti free. Su SWE-bench Verified, che testa compiti di coding reali, ottiene il 72,7%, superando di poco Opus 4 (72,5%) e nettamente davanti a Claude 3.7 Sonnet (62,3%). Supera anche GPT-4.1 di OpenAI (54,6%) e Gemini 2.5 Pro (63,2%).
Sugli altri benchmark:
Sonnet 4 è probabilmente uno dei migliori modelli disponibili nel livello gratuito e competitivo con modelli a pagamento o con accesso commerciale.
Opus 4 è il modello di punta di Anthropic e si posiziona ai vertici nella maggior parte dei benchmark. Su SWE-bench Verified ottiene il 72,5%, e in impostazioni ad alto calcolo sale al 79,4%—il punteggio più alto tra tutti i modelli confrontati.
Guida o è vicino alla vetta anche su:
Claude 4 è disponibile tramite più canali, a seconda di come vuoi usarlo—che sia chat informale, sviluppo via API o integrazione nei workflow aziendali. Ecco come funziona l'accesso:
Puoi usare Claude 4 direttamente tramite l'interfaccia web Claude.ai o le app mobile (iOS e Android).
Per gli sviluppatori, entrambi i modelli sono accessibili tramite la Anthropic API, e sono anche disponibili su Amazon Bedrock e Google Cloud Vertex AI.
Prezzi API (a maggio 2025):
Il batch processing e la cache dei prompt possono ridurre i costi fino al 90% in alcuni casi.
Claude Sonnet 4 offre un valore reale come modello veloce e capace, gratuito da usare e performante in coding, ragionamento e compiti da assistente generale. Per le esigenze quotidiane, è più che sufficiente.
Opus 4, invece, è pensato per un ragionamento più profondo e workflow complessi. I risultati nel coding—soprattutto nella generazione creativa e nel problem solving—sono tra i migliori che abbia visto finora da qualsiasi modello.
Impara l'AI con questi corsi!
Programma
Programma
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



