
अब तक जिन मॉडलों का मैंने परीक्षण किया, उनमें से कोई भी पहली कोशिश में स्टार्टिंग स्क्रीन सही नहीं बना पाया—अधिकांश सीधे गेमप्ले पर कूद गए। Claude Opus 4 ने वास्तव में निर्देशों के साथ एक उचित स्टार्ट स्क्रीन दिखाई, जो सुखद आश्चर्य था।
हालाँकि, एक विज़ुअल बग था: पिक्सेलेटेड डायनासोर स्क्रीन पर चलते समय एक उलझाऊ ट्रेल छोड़ रहा था। फ़्रेमों के बीच पिक्सेल सही तरह से क्लियर नहीं हो रहे थे, जिससे गेमप्ले बिगड़ रहा था। मैंने यह बताया और Opus 4 से इसे ठीक करने को कहा।
कमाल! किसी भी अन्य मॉडल से मुझे इस गेम का इतना साफ़-सुथरा और खेलने योग्य वर्ज़न नहीं मिला।
Claude 4 बेंचमार्क्स
Claude 4 मॉडलों का कोडिंग, रीज़निंग, और एजेंटिक टास्क्स में मानक बेंचमार्क्स की एक शृंखला पर परीक्षण किया गया। ये स्कोर मॉडल की गुणवत्ता की पूरी कहानी नहीं बताते, फिर भी तुलना के एक बिंदु के रूप में उपयोगी हैं। नीचे Claude Sonnet 4 और Claude Opus 4 के प्रमुख परिणाम दिए गए हैं।
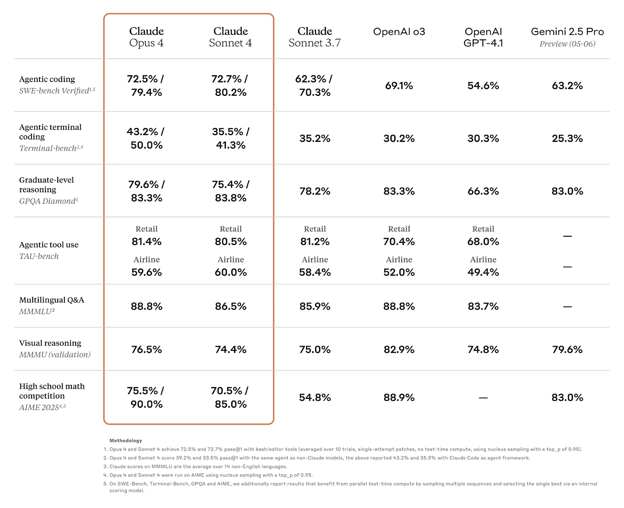
स्रोत: Anthropic
Claude Sonnet 4
मुफ्त उपयोगकर्ताओं के लिए उपलब्ध मॉडल के लिए Claude Sonnet 4 आश्चर्यजनक रूप से अच्छा प्रदर्शन करता है। वास्तविक दुनिया के कोडिंग टास्क का परीक्षण करने वाले SWE-bench Verified पर यह 72.7% स्कोर करता है, जो Opus 4 (72.5%) से थोड़ा आगे है और Claude 3.7 Sonnet (62.3%) से काफी आगे। यह OpenAI के GPT-4.1 (54.6%) और Gemini 2.5 Pro (63.2%) से भी बेहतर है।
अन्य बेंचमार्क्स पर:
- TerminalBench (CLI-आधारित कोडिंग): 35.5% – GPT-4.1 (30.3%) और Gemini (25.3%) से आगे
- GPQA Diamond (स्नातकोत्तर-स्तरीय रीज़निंग): 75.4% – मजबूत, हालांकि OpenAI o3 और Gemini से थोड़ा नीचे
- TAU-bench (एजेंटिक टूल उपयोग): 80.5% रिटेल / 60.0% एयरलाइन – Opus 4 के समकक्ष और GPT-4.1 व o3 से आगे
- MMLU (बहुभाषी QA): 86.5% – Opus और o3 से ज़रा पीछे, पर अब भी ठोस
- MMMU (विज़ुअल रीज़निंग): 74.4% – मॉडल लाइनअप में सबसे कम स्कोर
- AIME (गणित प्रतियोगिता): 70.5% – Sonnet 3.7 से बेहतर, पर पर्याप्त प्रतिस्पर्धी नहीं
Sonnet 4 संभवतः वर्तमान में उपलब्ध सर्वोत्तम फ्री-टियर मॉडलों में से एक है और उन मॉडलों से प्रतिस्पर्धी है जिनके लिए भुगतान या वाणिज्यिक एक्सेस चाहिए।
Claude Opus 4
Opus 4 Anthropic का फ़्लैगशिप मॉडल है, और यह अधिकांश बेंचमार्क्स में शीर्ष पर या उसके क़रीब प्रदर्शन करता है। SWE-bench Verified पर इसका स्कोर 72.5% है, और हाई-कम्प्यूट सेटिंग्स में यह 79.4% तक पहुँच जाता है—तुलना किए गए सभी मॉडलों में सबसे ऊँचा।
यह इन पर भी अग्रणी है या शीर्ष के क़रीब रैंक करता है:
- TerminalBench (एजेंटिक CLI कोडिंग): 43.2% (हाई-कम्प्यूट मोड में 50.0%) – चार्ट में सबसे मजबूत स्कोर
- GPQA Diamond (स्नातकोत्तर-स्तरीय रीज़निंग): 79.6% (83.3%) – ठोस, OpenAI o3 और Gemini 2.5 Pro से थोड़ा पीछे
- TAU-bench (एजेंटिक टूल उपयोग): 81.4% रिटेल / 59.6% एयरलाइन – Sonnet 4 और 3.7 के बराबर
- MMLU (बहुभाषी QA): 88.8% – OpenAI o3 के समकक्ष
- MMMU (विज़ुअल रीज़निंग): 76.5% – o3 और Gemini 2.5 Pro से पीछे
- AIME (गणित प्रतियोगिता): 75.5% (90.0% हाई-कम्प्यूट) – Claude Sonnet 4 से काफ़ी ऊपर
Claude 4 तक कैसे पहुँचें
आप Claude 4 को कई चैनलों के माध्यम से एक्सेस कर सकते हैं, इस पर निर्भर करता है कि आप इसे कैसे उपयोग करना चाहते हैं—चाहे कैज़ुअल चैट हो, API के ज़रिए डेवलपमेंट, या एंटरप्राइज़ वर्कफ़्लो में इंटीग्रेशन। एक्सेस इस प्रकार काम करता है:
चैट एक्सेस
आप Claude 4 को सीधे Claude.ai वेब इंटरफ़ेस या मोबाइल ऐप्स (iOS और Android) के माध्यम से उपयोग कर सकते हैं।
- Claude Sonnet 4 सभी उपयोगकर्ताओं के लिए उपलब्ध है, जिसमें फ्री टियर वाले भी शामिल हैं। यह इसे उन सबसे सक्षम मॉडलों में से एक बनाता है जिन्हें आप बिना भुगतान के आज़मा सकते हैं।
- Claude Opus 4 केवल Pro, Max, Team, या Enterprise प्लान्स के भुगतान करने वाले उपयोगकर्ताओं के लिए उपलब्ध है।
API एक्सेस
डेवलपर्स के लिए, दोनों मॉडल Anthropic API के माध्यम से, और Amazon Bedrock तथा Google Cloud Vertex AI पर उपलब्ध हैं।
API प्राइसिंग (मई 2025 तक):
- Claude Opus 4: प्रति मिलियन इनपुट टोकन $15, प्रति मिलियन आउटपुट टोकन $75
- Claude Sonnet 4: प्रति मिलियन इनपुट टोकन $3, प्रति मिलियन आउटपुट टोकन $15
बैच प्रोसेसिंग और प्रॉम्प्ट कैशिंग कुछ मामलों में लागत को 90% तक घटा सकते हैं।
निष्कर्ष
Claude Sonnet 4 एक तेज़, सक्षम मॉडल के रूप में वास्तविक मूल्य देता है, जो मुफ्त में उपलब्ध है और कोडिंग, रीज़निंग, और सामान्य सहायक कार्यों में अच्छा प्रदर्शन करता है। रोज़मर्रा की अधिकांश ज़रूरतों के लिए, यह पर्याप्त से अधिक है।
दूसरी ओर, Opus 4 को गहरे तर्क और जटिल वर्कफ़्लोज़ के लिए बनाया गया है। कोडिंग परिणाम—खासकर क्रिएटिव जनरेशन और समस्या-समाधान में—अब तक किसी भी मॉडल से देखे गए सर्वश्रेष्ठ में रहे हैं।

मैं एक संपादक और लेखक हूँ जो AI ब्लॉग, ट्यूटोरियल, और समाचार कवर करता/करती हूँ, यह सुनिश्चित करते हुए कि सब कुछ ठोस कंटेंट रणनीति और SEO के सर्वोत्तम तरीकों के अनुरूप हो। मैंने Python, सांख्यिकी, प्रायिकता, और डेटा विज़ुअलाइज़ेशन पर डेटा साइंस पाठ्यक्रम लिखे हैं। मेरा एक पुरस्कृत उपन्यास भी प्रकाशित हो चुका है, और खाली समय में मैं पटकथा लेखन और फ़िल्म निर्देशन में समय बिताता/बिताती हूँ।
Anthropic ने अभी Claude 4 जारी किया है, जो दो वर्ज़न में आता है: Claude 4 Sonnet और Claude 4 Opus।
Claude Sonnet 4 एक जनरलिस्ट मॉडल है जो अधिकांश AI उपयोग मामलों के लिए बेहतरीन है और कोडिंग में विशेष रूप से मजबूत है। मुझे लगता है कि यह उन सर्वोत्तम मॉडलों में से एक है जिन्हें आप मुफ्त में उपयोग कर सकते हैं।
Claude Opus 4 को रीज़निंग-हेवी टास्क्स के लिए डिज़ाइन किया गया है, जैसे एजेंटिक सर्च और लंबे समय तक चलने वाले कोड वर्कफ़्लोज़। Anthropic Opus 4 को “दुनिया का सबसे अच्छा कोडिंग मॉडल” कहता है, लेकिन मुझे वह दावा थोड़ा खोखला लगता है।
हाँ, फिलहाल यह SWE-bench Verified बेंचमार्क पर शीर्ष प्रदर्शनकर्ता है। लेकिन केवल 200K कॉन्टेक्स्ट विंडो के साथ, मैं नहीं मानता कि यह बहुत बड़े कोडबेस को साफ़-सुथरे ढंग से संभाल पाएगा। और सच कहें तो: लगभग हर महीने कोई और अधिक शक्तिशाली मॉडल आ ही जाता है। कुछ हफ्तों के लिए ताज पहन लेने का बहुत मतलब नहीं बनता।
फिर भी, Claude 4 अब भी एक बहुत मजबूत रिलीज़ है। मैं आपको सबसे महत्वपूर्ण विवरणों—फीचर्स, उपयोग के मामले, बेंचमार्क्स—के बारे में बताऊंगा,और मैं अपने कुछ टेस्ट भी चलाऊंगा।
हम अपने पाठकों को AI की ताज़ा ख़बरों से अपडेट रखते हैं The Median के माध्यम से—हमारा मुफ्त शुक्रवार न्यूज़लेटर जो हफ्ते की अहम कहानियों को सरलता से समझाता है। सब्सक्राइब करें और हर हफ्ते कुछ ही मिनटों में अपडेट रहें:
Claude Sonnet 4
Claude 4 परिवार का छोटा मॉडल Sonnet 4 है। इसे सामान्य-उद्देश्य उपयोग के लिए बनाया गया है और यह अधिकांश आम AI टास्क—कोडिंग, लेखन, प्रश्नोत्तर, डेटा विश्लेषण—में अच्छा प्रदर्शन करता है। यह मुफ्त उपयोगकर्ताओं के लिए भी उपलब्ध है, जो इस गुणवत्ता के मॉडल के लिए असामान्य रूप से सुलभ बनाता है।
मॉडल 200K कॉन्टेक्स्ट विंडो सपोर्ट करता है, जो इसे बड़े प्रॉम्प्ट संभालने और लंबी बातचीत में निरंतरता बनाए रखने की अनुमति देता है। यह लंबे दस्तावेज़ों का विश्लेषण, कोडबेस की समीक्षा, या एकसमान संरचना वाले बहु-भाग उत्तर बनाने जैसे उपयोग मामलों में उपयोगी है। हालांकि, Sonnet 4 बड़े कोडबेस के साथ जूझ सकता है। तुलना के लिए, Gemini 2.5 Flash में 1M टोकन की कॉन्टेक्स्ट विंडो है।
की तुलना में Claude Sonnet 3.7, यह वर्ज़न तेज़ है, निर्देशों का बेहतर पालन करता है, और कोड-हेवी वर्कफ़्लो में अधिक भरोसेमंद है। यह 64K आउटपुट टोकन तक सपोर्ट करता है, जो संरचित योजनाओं, बहु-भाग उत्तरों, या बड़े कोड कम्प्लीशंस जैसे थोड़े लंबे आउटपुट में मदद करता है।
प्रारंभिक रिपोर्ट्स कम नेविगेशन त्रुटियाँ और ऐप डेवलपमेंट टास्क्स में बेहतर प्रदर्शन दिखाती हैं। जटिल तर्क-वितर्क या दीर्घकालिक टास्क प्लानिंग में यह Opus 4 जितना मजबूत नहीं है, लेकिन अधिकांश वर्कफ़्लोज़ के लिए यह पर्याप्त से अधिक है।
Claude Opus 4
Claude 4 श्रृंखला का फ़्लैगशिप मॉडल Opus 4 है। इसे ऐसे कार्यों के लिए बनाया गया है जिनमें गहरी तर्क क्षमता, दीर्घकालिक स्मृति, और अधिक संरचित आउटपुट की आवश्यकता होती है—जैसे एजेंटिक सर्च, बड़े पैमाने पर कोड रिफैक्टरिंग, बहु-चरणीय समस्या समाधान, और विस्तारित शोध वर्कफ़्लोज़।
Sonnet 4 की तरह, यह भी 200K कॉन्टेक्स्ट विंडो सपोर्ट करता है, इसलिए यदि आप इसे बड़े कोडबेस के साथ उपयोग करना चाहते हैं तो यह एक कमी हो सकती है। तुलना के लिए, Gemini 2.5 Pro (Google का फ़्लैगशिप मॉडल) 1M टोकन की कॉन्टेक्स्ट विंडो देता है।
यह “extended thinking” मोड में चलने में भी सक्षम है, जहाँ यह तेज़ उत्तरों से हटकर धीमे, अधिक सुनियोजित तर्क पर स्विच करता है। यह मोड टूल उपयोग करने, चरणों के पार मेमोरी ट्रैक करने, और आवश्यकता होने पर अपनी तर्क-प्रक्रिया के सार प्रस्तुत करने की अनुमति देता है।
Anthropic ने इसे डेवलपर्स, शोधकर्ताओं, और AI एजेंट्स बनाने वाली टीमों के लिए एक हाई-एंड मॉडल के रूप में प्रस्तुत किया है। यह SWE-bench Verified और Terminal-bench में अग्रणी है, और शुरुआती उपयोगकर्ता कोडिंग एजेंट्स, सर्च वर्कफ़्लोज़, और ओपन-सोर्स प्रोजेक्ट्स को रिफैक्टर करने या दीर्घकालिक योजना का सिमुलेशन जैसे कई-घंटों वाले कार्यों में मजबूत प्रदर्शन की रिपोर्ट करते हैं।
Sonnet के विपरीत, Opus 4 केवल पेड प्लान्स पर उपलब्ध है। इसे चलाना अधिक महंगा है, और साधारण चैटबॉट उपयोग के लिए संभवतः आवश्यकता से ज़्यादा शक्तिशाली है। लेकिन जिन अनुप्रयोगों में कई गतिशील हिस्सों के बीच सुसंगत तर्क की ज़रूरत होती है, उनके लिए यह अधिक सक्षम विकल्प है।
Claude 4 का परीक्षण
किसी नए मॉडल का परीक्षण करते समय, मैं आमतौर पर वही टास्क्स उपयोग करता हूँ—ताकि मैं देख सकूँ कि यह पहले टेस्ट किए गए अन्य मॉडलों की तुलना में कैसा है। यह कोई व्यापक मूल्यांकन नहीं है। लक्ष्य सिर्फ़ यह समझना है कि ये मॉडल चैट इंटरफ़ेस में कैसे व्यवहार करते हैं।
आइए Claude 4 को दो क्षेत्रों में आज़माएँ: गणित और कोडिंग।
गणित
मुझे एक सरल गणना से शुरू करना पसंद है जो अक्सर भाषा मॉडलों को उलझा देती है। यह बुनियादी अंकगणित जाँचने के बारे में नहीं है—इसके लिए तो मैं कैलकुलेटर का इस्तेमाल कर सकता हूँ। मकसद यह देखना है कि मॉडल थोड़ा पेचीदा सवाल को कैसे लेता है, और ज़रूरत पड़ने पर क्या यह टूल का सहारा ले सकता है या अपना तर्क साफ़-साफ़ दिखा सकता है।
देखते हैं Claude Sonnet 4 ने इसे कितना अच्छी तरह संभाला:
जैसा कि आप देख सकते हैं, पहली कोशिश में जवाब गलत था। लेकिन जब मैंने इसे टूल—एक कैलकुलेटर—का उपयोग करने को कहा, तो इसने JavaScript में एक-लाइन स्क्रिप्ट लिखकर समस्या सही ढंग से हल कर दी।
Claude Opus 4 ने पहली ही कोशिश में सही उत्तर दिया।
इसके बाद, मैं देखना चाहता था कि Claude Sonnet 4 एक अधिक जटिल समस्या को कितना अच्छी तरह संभालता है: 0 से 9 तक के सभी अंकों का ठीक एक-एक बार उपयोग करके तीन संख्याएँ x, y, z बनाइए ताकि x + y = z हो।
करीब पाँच मिनट तक रैंडम ब्रूट-फोर्स प्रयासों के बाद, मुझे संदेश मिला कि आउटपुट सीमा तक पहुँचा गया है और आगे बढ़ाने के लिए “Continue” पर क्लिक करना होगा। मैंने किया, और Claude ने फिर कोशिश की—लेकिन दोबारा सीमा पर जा लगा। अच्छी बात यह लगी कि इसने कोई मनगढ़ंत उत्तर नहीं दे दिया। अगर उत्तर नहीं मिला तो बस देने से मना कर दिया। मेरे विचार से यह बड़ी जीत है—हैलुसिनेट किया हुआ समाधान देना अधिक समस्याग्रस्त होता।
फिर मैंने वही टास्क Claude Opus 4 को दिया। जवाब लगभग तुरंत आ गया, और सही था: 246 + 789 = 1035। Opus 4 प्रभावशाली है!!
कोडिंग
कोडिंग टास्क के लिए, मैंने सीधे Claude Opus 4 पर जाने का फैसला किया। इस तरह की क्रिएटिव जनरेशन इसकी क्षमताओं के अधिक अनुरूप लगती है। मैं यहाँ बड़े कोडबेस पर टेस्ट नहीं कर रहा—बस एक अपेक्षाकृत साधारण कोडिंग टास्क।
मैंने इसे p5.js में एक त्वरित गेम बनाने को कहा—वही प्रॉम्प्ट जो मैंने Gemini 2.5 Pro और o4-mini के लिए इस्तेमाल किया था:
प्रॉम्प्ट: मेरे लिए एक आकर्षक एंडलेस रनर गेम बनाइए। स्क्रीन पर मुख्य निर्देश हों। p5.js सीन, कोई HTML नहीं। मुझे पिक्सेलेटेड डायनासोर और दिलचस्प बैकग्राउंड पसंद हैं।
आम तौर पर, मैं कोड को ऑनलाइन p5.js एडिटर में कॉपी-पेस्ट कर के टेस्ट करता। लेकिन Claude 4 की एक अच्छी सुविधा Artifacts है, जो मुझे सीधे चैट के अंदर कोड आउटपुट देखने और चलाने देती है।
आइए परिणाम देखें: