
Chưa mô hình nào tôi từng thử làm đúng màn hình bắt đầu ngay lần đầu—đa số nhảy thẳng vào chơi. Claude Opus 4 thực sự hiển thị màn hình bắt đầu kèm hướng dẫn, khá bất ngờ.
Tuy vậy, có một lỗi hiển thị: chú khủng long pixel để lại một vệt nhiễu khi di chuyển trên màn hình. Các pixel không được xóa đúng giữa các khung hình, làm hỏng trải nghiệm chơi. Tôi nêu vấn đề này và yêu cầu Opus 4 sửa.
Hoàn hảo! Tôi chưa từng nhận được phiên bản game sạch và chơi ngon như vậy từ bất kỳ mô hình nào khác.
Điểm chuẩn Claude 4
Các mô hình Claude 4 được kiểm tra trên nhiều bộ điểm chuẩn tiêu chuẩn về lập trình, suy luận và tác vụ theo tác nhân. Dù các điểm số này không phản ánh đầy đủ chất lượng mô hình, chúng vẫn hữu ích để so sánh. Dưới đây là kết quả chính cho Claude Sonnet 4 và Claude Opus 4.
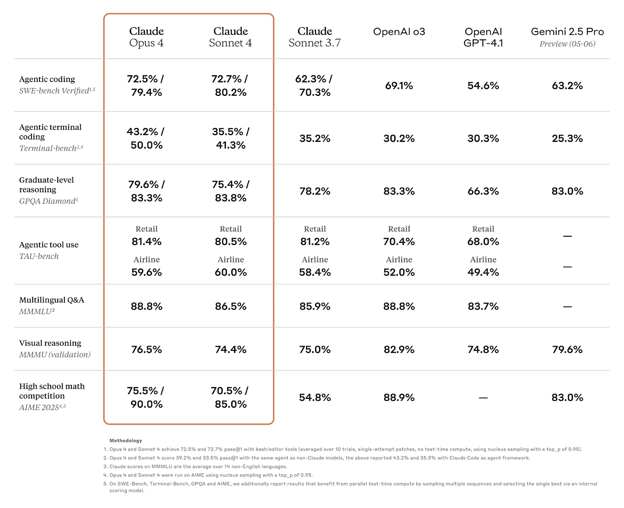
Nguồn: Anthropic
Claude Sonnet 4
Claude Sonnet 4 đạt kết quả đáng ngạc nhiên với một mô hình khả dụng cho người dùng miễn phí. Trên SWE-bench Verified, kiểm tra các tác vụ lập trình thực tế, nó đạt 72,7%, nhỉnh hơn Opus 4 (72,5%) và vượt xa Claude 3.7 Sonnet (62,3%). Nó cũng vượt OpenAI GPT-4.1 (54,6%) và Gemini 2.5 Pro (63,2%).
Ở các điểm chuẩn khác:
- TerminalBench (lập trình dựa trên CLI): 35,5% – vượt GPT-4.1 (30,3%) và Gemini (25,3%)
- GPQA Diamond (suy luận trình độ sau đại học): 75,4% – mạnh, dù thấp hơn một chút so với OpenAI o3 và Gemini
- TAU-bench (sử dụng công cụ theo tác nhân): 80,5% Bán lẻ / 60,0% Hàng không – tương đương Opus 4 và vượt GPT-4.1 và o3
- MMLU (hỏi đáp đa ngôn ngữ): 86,5% – chỉ sau Opus và o3, nhưng vẫn vững
- MMMU (suy luận thị giác): 74,4% – thấp nhất trong dãy mô hình
- AIME (thi toán): 70,5% – tốt hơn Sonnet 3.7, nhưng chưa đủ cạnh tranh
Sonnet 4 có thể coi là một trong những mô hình tầng miễn phí mạnh nhất hiện có và có sức cạnh tranh với các mô hình yêu cầu trả phí hoặc quyền truy cập thương mại.
Claude Opus 4
Opus 4 là mô hình chủ lực của Anthropic, đạt hoặc tiệm cận top trên hầu hết các điểm chuẩn. Trên SWE-bench Verified, nó đạt 72,5%, và trong thiết lập tính toán cao, con số đó nhảy lên 79,4%—cao nhất trong các mô hình so sánh.
Nó cũng dẫn đầu hoặc thuộc nhóm đầu ở:
- TerminalBench (lập trình CLI theo tác nhân): 43,2% (50,0% ở chế độ tính toán cao) – mạnh nhất trong bảng
- GPQA Diamond (suy luận trình độ sau đại học): 79,6% (83,3%) – vững, hơi sau OpenAI o3 và Gemini 2.5 Pro
- TAU-bench (sử dụng công cụ theo tác nhân): 81,4% Bán lẻ / 59,6% Hàng không – ngang Sonnet 4 và 3.7
- MMLU (hỏi đáp đa ngôn ngữ): 88,8% – ngang với OpenAI o3
- MMMU (suy luận thị giác): 76,5% – sau o3 và Gemini 2.5 Pro
- AIME (thi toán): 75,5% (90,0% tính toán cao) – vượt đáng kể Claude Sonnet 4
Cách truy cập Claude 4
Claude 4 khả dụng qua nhiều kênh, tùy cách bạn muốn sử dụng—trò chuyện thông thường, phát triển qua API, hoặc tích hợp vào quy trình doanh nghiệp. Cách truy cập như sau:
Truy cập qua chat
Bạn có thể dùng Claude 4 trực tiếp qua Claude.ai trên web hoặc ứng dụng di động (iOS và Android).
- Claude Sonnet 4 khả dụng cho mọi người dùng, kể cả tầng miễn phí. Điều này khiến nó trở thành một trong những mô hình mạnh nhất bạn có thể thử mà không phải trả tiền.
- Claude Opus 4 chỉ khả dụng cho người dùng trả phí ở các gói Pro, Max, Team hoặc Enterprise.
Truy cập qua API
Với nhà phát triển, cả hai mô hình có thể truy cập qua Anthropic API, và cũng có trên Amazon Bedrock, và Google Cloud Vertex AI.
Giá API (tháng 5/2025):
- Claude Opus 4: 15 USD mỗi triệu token đầu vào, 75 USD mỗi triệu token đầu ra
- Claude Sonnet 4: 3 USD mỗi triệu token đầu vào, 15 USD mỗi triệu token đầu ra
Xử lý theo lô và lưu đệm prompt có thể giảm chi phí tới 90% trong một số trường hợp.
Kết luận
Claude Sonnet 4 mang lại giá trị thực với tốc độ nhanh, năng lực tốt, miễn phí sử dụng và thể hiện tốt ở lập trình, suy luận, cũng như các tác vụ trợ lý tổng quát. Với nhu cầu hằng ngày, như vậy là quá đủ.
Opus 4 thì được xây dựng cho suy luận sâu và quy trình phức tạp. Kết quả lập trình—đặc biệt ở sáng tạo và giải quyết vấn đề—là một trong những gì tốt nhất tôi từng thấy từ bất kỳ mô hình nào cho đến nay.
Tôi là biên tập viên và tác giả phụ trách blog, hướng dẫn và tin tức về AI, bảo đảm mọi nội dung phù hợp với chiến lược nội dung vững chắc và các thực tiễn SEO tốt nhất. Tôi đã viết các khóa học khoa học dữ liệu về Python, thống kê, xác suất và trực quan hóa dữ liệu. Tôi cũng đã xuất bản một tiểu thuyết đoạt giải và dành thời gian rảnh cho việc viết kịch bản và đạo diễn phim.
Anthropic vừa ra mắt Claude 4, với hai phiên bản: Claude 4 Sonnet và Claude 4 Opus.
Claude Sonnet 4 là một mô hình đa dụng, phù hợp với hầu hết các trường hợp dùng AI và đặc biệt mạnh về lập trình. Tôi cho rằng đây là một trong những mô hình tốt nhất mà bạn có thể dùng miễn phí.
Claude Opus 4 được thiết kế cho các tác vụ đòi hỏi suy luận nặng như tìm kiếm theo tác nhân và quy trình mã chạy dài. Anthropic gọi Opus 4 là “mô hình lập trình tốt nhất thế giới”, nhưng tôi thấy tuyên bố đó hơi rỗng tuếch.
Đúng là hiện tại nó dẫn đầu trên điểm chuẩn SWE-bench Verified. Nhưng với cửa sổ ngữ cảnh chỉ 200K, tôi khó hình dung nó xử lý gọn gàng các codebase rất lớn. Và thẳng thắn mà nói: cứ mỗi tháng lại có một mô hình mạnh hơn ra mắt. Giữ “ngôi vương” vài tuần thì cũng chẳng nói lên nhiều điều.
Dù vậy, Claude 4 vẫn là một bản phát hành rất mạnh. Tôi sẽ dẫn bạn qua những điểm quan trọng nhất—tính năng, trường hợp sử dụng, điểm chuẩn—và cũng sẽ tự chạy vài bài kiểm thử.
Chúng tôi luôn cập nhật cho độc giả những tin mới nhất về AI qua The Median, bản tin thứ Sáu miễn phí tóm lược các câu chuyện chính trong tuần. Đăng ký để không bỏ lỡ, chỉ mất vài phút mỗi tuần:
Claude Sonnet 4
Claude Sonnet 4 là mô hình nhỏ hơn trong họ Claude 4. Nó được thiết kế cho mục đích tổng quát và hoạt động tốt trên hầu hết các tác vụ AI phổ biến—lập trình, viết, trả lời câu hỏi, phân tích dữ liệu. Nó còn khả dụng cho người dùng miễn phí, điều khá hiếm với một mô hình chất lượng như vậy.
Mô hình hỗ trợ cửa sổ ngữ cảnh 200K, cho phép xử lý prompt lớn và duy trì mạch hội thoại dài. Điều đó hữu ích cho các trường hợp như phân tích tài liệu dài, rà soát codebase, hoặc tạo phản hồi nhiều phần với cấu trúc nhất quán. Tuy nhiên, Sonnet 4 có thể gặp khó với codebase lớn. So sánh, Gemini 2.5 Flash có cửa sổ ngữ cảnh 1 triệu token.
So với Claude Sonnet 3.7, phiên bản này nhanh hơn, theo chỉ dẫn tốt hơn, và đáng tin cậy hơn trong các quy trình nặng về mã. Nó hỗ trợ đầu ra tới 64K token, hữu ích cho những nội dung dài hơn một chút như kế hoạch có cấu trúc, câu trả lời nhiều phần, hoặc hoàn thiện mã lớn.
Báo cáo ban đầu cho thấy ít lỗi điều hướng hơn và hiệu năng tốt hơn trên các tác vụ phát triển ứng dụng. Về suy luận phức tạp hoặc lập kế hoạch tác vụ dài hạn, nó không mạnh bằng Opus 4, nhưng với đa số quy trình làm việc, như vậy là quá đủ.
Claude Opus 4
Claude Opus 4 là mô hình đầu bảng trong dòng Claude 4. Nó được xây dựng cho các tác vụ cần suy luận sâu, trí nhớ dài hạn và đầu ra có cấu trúc hơn—như tìm kiếm theo tác nhân, tái cấu trúc mã quy mô lớn, giải quyết vấn đề nhiều bước, và quy trình nghiên cứu kéo dài.
Giống Sonnet 4, nó hỗ trợ cửa sổ ngữ cảnh 200K, nên đây có thể là bất lợi nếu bạn muốn dùng với codebase lớn. So sánh, Gemini 2.5 Pro (mô hình đầu bảng của Google) có cửa sổ ngữ cảnh 1 triệu token.
Nó cũng có thể chạy ở chế độ “tư duy mở rộng”, chuyển từ phản hồi nhanh sang suy luận chậm rãi, cẩn trọng hơn. Chế độ này cho phép nó sử dụng công cụ, theo dõi bộ nhớ qua các bước, và tạo tóm tắt cho chính quá trình tư duy của mình khi cần.
Anthropic định vị đây là mô hình cao cấp cho nhà phát triển, nhà nghiên cứu và các đội ngũ xây dựng tác nhân AI. Nó dẫn đầu trên SWE-bench Verified và Terminal-bench, và người dùng sớm báo cáo hiệu năng mạnh trong các tác nhân lập trình, quy trình tìm kiếm, và các tác vụ nhiều giờ như tái cấu trúc dự án mã nguồn mở hoặc mô phỏng lập kế hoạch dài hạn.
Khác với Sonnet, Opus 4 chỉ khả dụng trong các gói trả phí. Chi phí vận hành cao hơn, và có lẽ quá mức cần thiết cho các chatbot đơn giản. Nhưng với các ứng dụng cần suy luận nhất quán giữa nhiều thành phần chuyển động, đây là lựa chọn mạnh mẽ hơn.
Kiểm thử Claude 4
Khi thử một mô hình mới, tôi thường dùng cùng một tập tác vụ—như vậy có thể so sánh với các mô hình tôi đã thử trước đó. Đây không phải đánh giá toàn diện. Mục tiêu chỉ là cảm nhận cách các mô hình này ứng xử trong giao diện chat.
Hãy thử Claude 4 ở hai mảng: toán và lập trình.
Toán
Tôi thích bắt đầu với một phép tính đơn giản nhưng hay gây nhầm lẫn cho các mô hình ngôn ngữ. Không phải để kiểm tra số học cơ bản—tôi có thể dùng máy tính cho việc đó. Mục đích là xem mô hình tiếp cận một bài toán hơi “mẹo” như thế nào, và liệu nó có thể quay về dùng công cụ hay trình bày rõ ràng lập luận khi cần không.
Xem Claude Sonnet 4 xử lý ra sao:
Như bạn thấy, lần đầu nó trả lời sai. Nhưng khi tôi yêu cầu dùng một công cụ—máy tính—nó phản hồi bằng cách viết một đoạn script một dòng bằng JavaScript và giải đúng bài toán.
Claude Opus 4 trả lời đúng ngay lần đầu.
Tiếp theo, tôi muốn xem Claude Sonnet 4 xử lý một bài phức tạp hơn thế nào: dùng tất cả các chữ số từ 0 đến 9 đúng một lần để lập ba số x, y, z sao cho x + y = z.
Sau khoảng năm phút thử vét cạn ngẫu nhiên, tôi nhận được thông báo đạt giới hạn đầu ra và cần bấm “Tiếp tục” để chạy lại. Tôi làm vậy, và Claude thử tiếp—nhưng rồi lại đụng giới hạn. Điều tôi trân trọng là nó không bịa đáp án. Nếu không tìm ra, nó đơn giản từ chối trả lời. Theo tôi, đó là một điểm cộng lớn—hoang tưởng ra lời giải còn rắc rối hơn.
Sau đó tôi thử Claude Opus 4 với cùng bài toán. Đáp án trả về gần như tức thì và chính xác: 246 + 789 = 1035. Opus 4 thật ấn tượng!!
Lập trình
Với tác vụ lập trình, tôi quyết định đi thẳng tới Claude Opus 4. Kiểu sáng tạo này hợp với năng lực của nó hơn. Tôi không thử trên codebase lớn—chỉ là một tác vụ mã khá đơn giản.
Tôi yêu cầu tạo nhanh một trò chơi p5.js bằng prompt tôi đã dùng cho Gemini 2.5 Pro và o4-mini:
Prompt: Hãy tạo cho tôi một game endless runner hấp dẫn. Hiển thị hướng dẫn chính ngay trên màn hình. Khung cảnh p5.js, không dùng HTML. Tôi thích khủng long kiểu pixel và nền thú vị.
Bình thường, tôi sẽ sao chép mã vào trình chỉnh sửa p5.js trực tuyến để thử. Nhưng một tính năng hay trong Claude 4 là Artifacts, cho phép tôi xem và chạy mã trực tiếp trong cửa sổ chat.
Xem kết quả: