

Leerpad
AI-toepassingen ontwikkelen
21 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleAnthropic heeft zojuist Claude 4 uitgebracht, in twee versies: Claude 4 Sonnet en Claude 4 Opus.
Claude Sonnet 4 is een generalistisch model dat uitstekend werkt voor de meeste AI-use-cases en vooral sterk is in coderen. Ik denk dat het een van de beste modellen is die je gratis kunt gebruiken.
Claude Opus 4 is ontworpen voor taken met veel redenering, zoals agentic search en langlopende codeworkflows. Anthropic noemt Opus 4 “het beste codemodel ter wereld”, maar die claim vind ik wat leeg.
Ja, het staat momenteel bovenaan de SWE-bench Verified-benchmark. Maar met een contextvenster van slechts 200K kan ik me niet voorstellen dat het heel grote codebases netjes afhandelt. En laten we eerlijk zijn: er komt ongeveer elke maand wel weer een sterker model uit. Een paar weken de kroon claimen is niet zo betekenisvol.
Dat gezegd hebbende: Claude 4 is nog steeds een heel sterke release. Ik neem je mee door de belangrijkste details—functies, use-cases, benchmarks—en ik doe ook een paar eigen tests.
We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week samenvat. Abonneer je en blijf scherp in een paar minuten per week:
Claude Sonnet 4 is het kleinere model in de Claude 4-familie. Het is ontworpen voor algemeen gebruik en presteert goed op de meeste gangbare AI-taken—coderen, schrijven, vraagbeantwoording, data-analyse. Het is ook beschikbaar voor gratis gebruikers, wat het ongewoon toegankelijk maakt voor een model van deze kwaliteit.
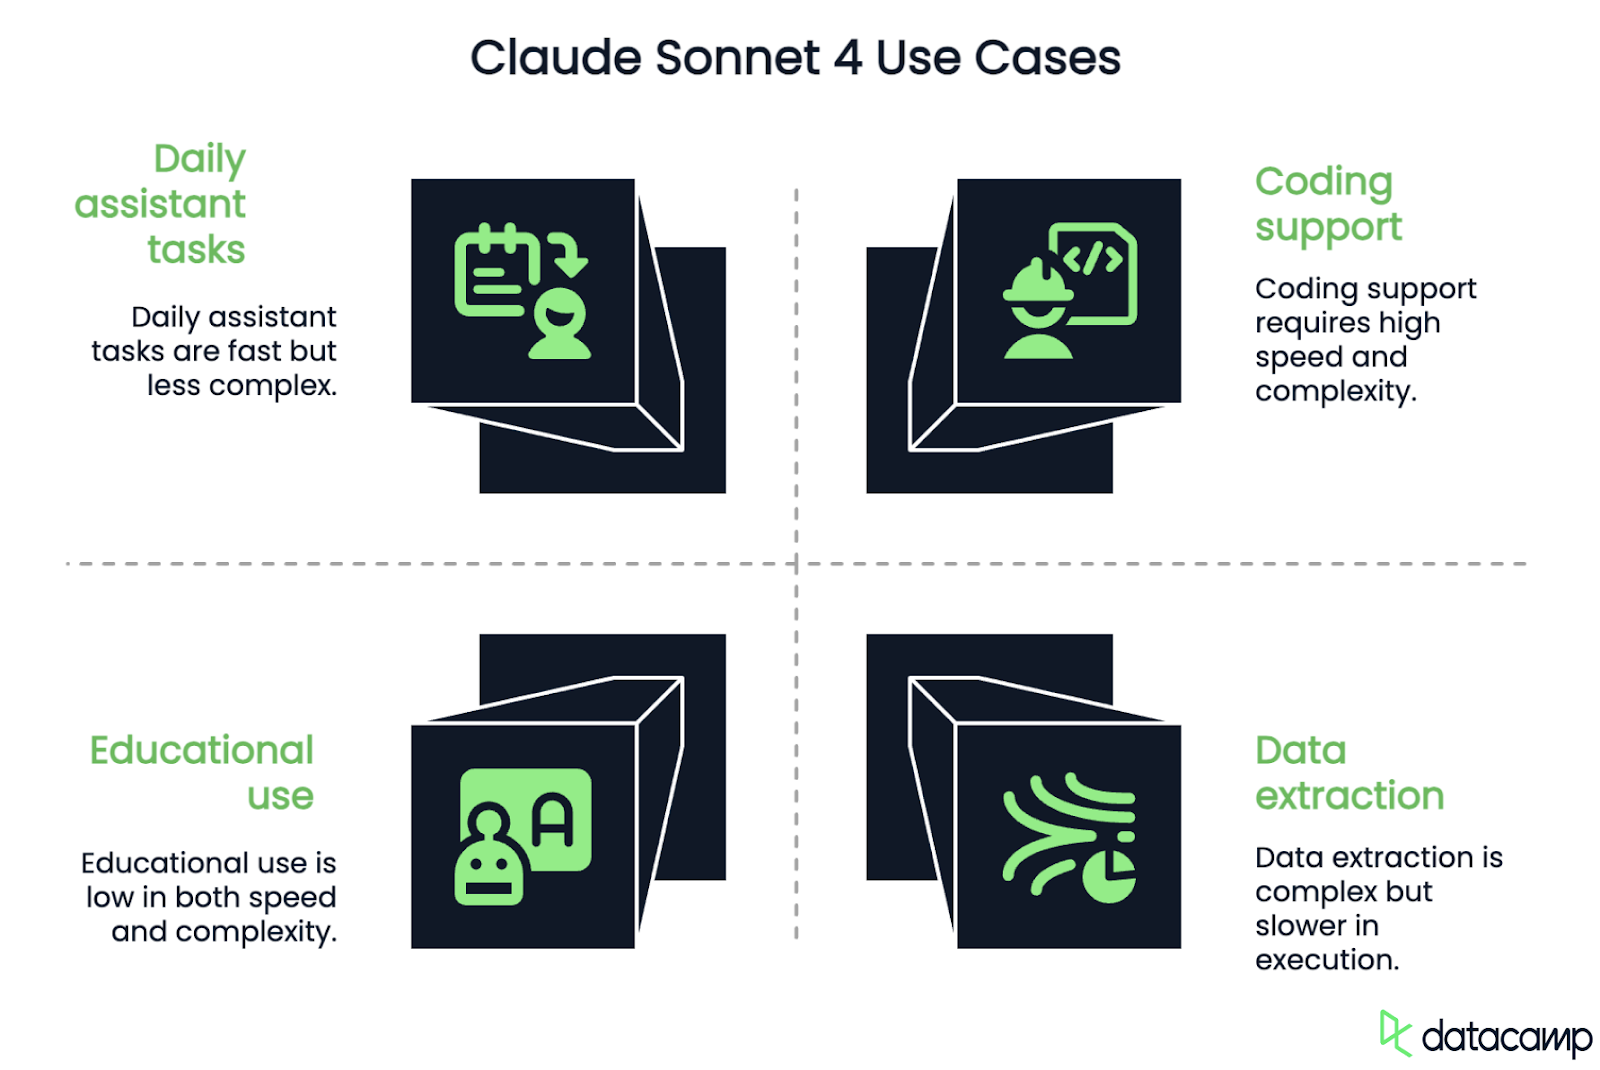
Het model ondersteunt een contextvenster van 200K, waarmee het grote prompts aankan en continuïteit over lange interacties behoudt. Dat is handig voor use-cases zoals het analyseren van lange documenten, het doorlopen van codebases of het genereren van meerledige antwoorden met consistente structuur. Toch kan Sonnet 4 moeite hebben met grote codebases. Ter vergelijking: Gemini 2.5 Flash heeft een contextvenster van 1M tokens.
Vergeleken met Claude Sonnet 3.7 is deze versie sneller, beter in het volgen van instructies en betrouwbaarder in code-intensieve workflows. Het ondersteunt tot 64K outputtokens, wat helpt bij iets langere outputs zoals gestructureerde plannen, meerledige antwoorden of grote code-completions.
Vroege berichten tonen minder navigatiefouten en betere prestaties bij app-ontwikkelingstaken. Het is niet zo sterk als Opus 4 bij complexe redenering of langetermijnplanning, maar voor de meeste workflows is het ruimschoots voldoende.
Claude Opus 4 is het vlaggenschipmodel in de Claude 4-serie. Het is gebouwd voor taken die diepere redenering, langetermijngeheugen en meer gestructureerde outputs vereisen—zoals agentic search, grootschalige coderefactoring, meerstapsprobleemoplossing en uitgebreide onderzoeksworkflows.
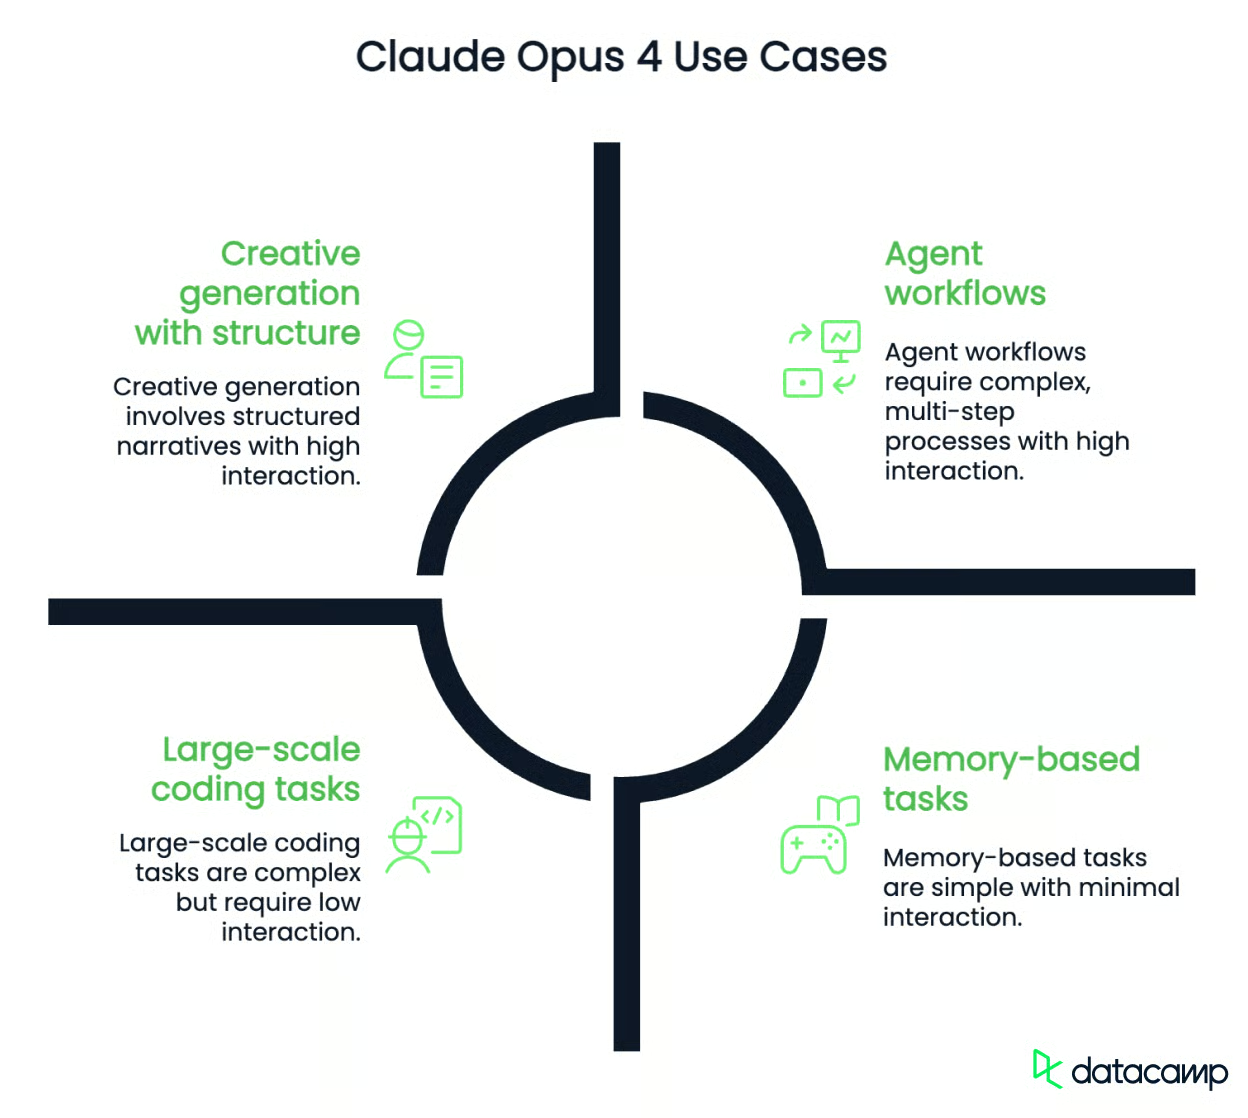
Net als Sonnet 4 ondersteunt het een contextvenster van 200K, dus dat kan een nadeel zijn als je het met een grote codebase wilt gebruiken. Ter vergelijking: Gemini 2.5 Pro (Google’s vlaggenschipmodel) heeft een contextvenster van 1M tokens.
Het kan ook draaien in “extended thinking”-modus, waarbij het overschakelt van snelle reacties naar langzamere, meer weloverwogen redenering. In deze modus kan het tools gebruiken, geheugen over stappen heen bijhouden en samenvattingen van zijn eigen denkproces genereren wanneer dat nodig is.
Anthropic positioneert het als een high-end model voor ontwikkelaars, onderzoekers en teams die AI-agents bouwen. Het leidt op SWE-bench Verified en Terminal-bench, en vroege gebruikers melden sterke prestaties in coding agents, zoekworkflows en meeruurstaken zoals het refactoren van open-sourceprojecten of het simuleren van langetermijnplanning.
In tegenstelling tot Sonnet is Opus 4 alleen beschikbaar in betaalde abonnementen. Het is duurder om te draaien en waarschijnlijk overkill voor een simpele chatbot. Maar voor toepassingen die consistente redenering nodig hebben over veel bewegende onderdelen, is het de capabelere keuze.
Bij het testen van een nieuw model gebruik ik meestal dezelfde taken—zo kan ik zien hoe het zich verhoudt tot andere modellen die ik eerder heb getest. Dit is niet bedoeld als een uitgebreide evaluatie. Het doel is vooral om gevoel te krijgen voor hoe deze modellen zich gedragen in de chatinterface.
Laten we Claude 4 proberen op twee gebieden: wiskunde en coderen.
Ik begin graag met een simpele berekening die taalmodellen vaak in de war brengt. Dit gaat niet om het controleren van basisrekenwerk—daar kan ik gewoon een rekenmachine voor gebruiken. Het punt is om te zien hoe het model een iets lastiger probleem benadert, en of het kan terugvallen op toolgebruik of zijn redenering duidelijk kan tonen als dat nodig is.
Laten we kijken hoe goed Claude Sonnet 4 het deed:
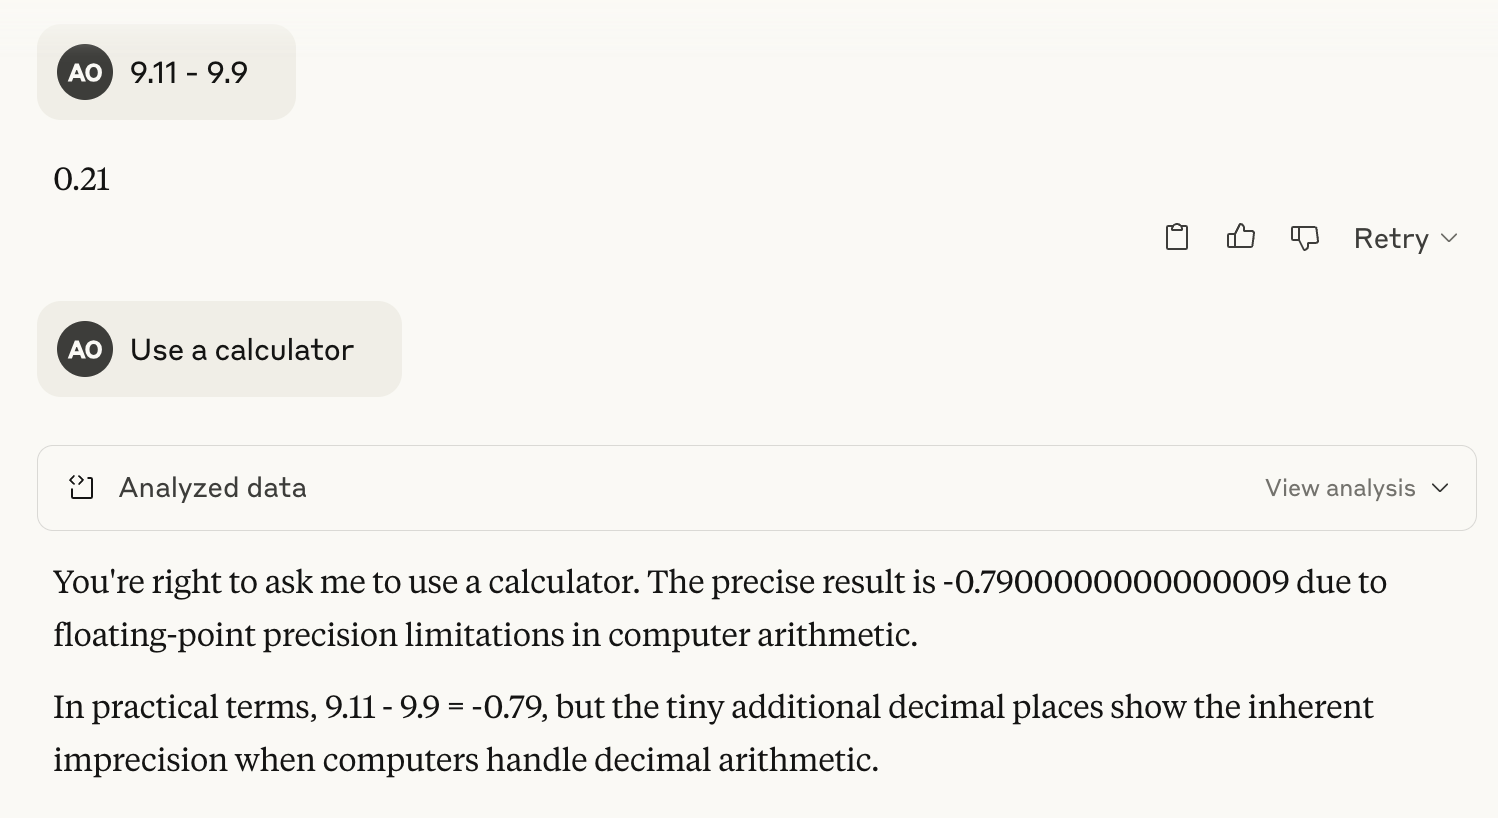
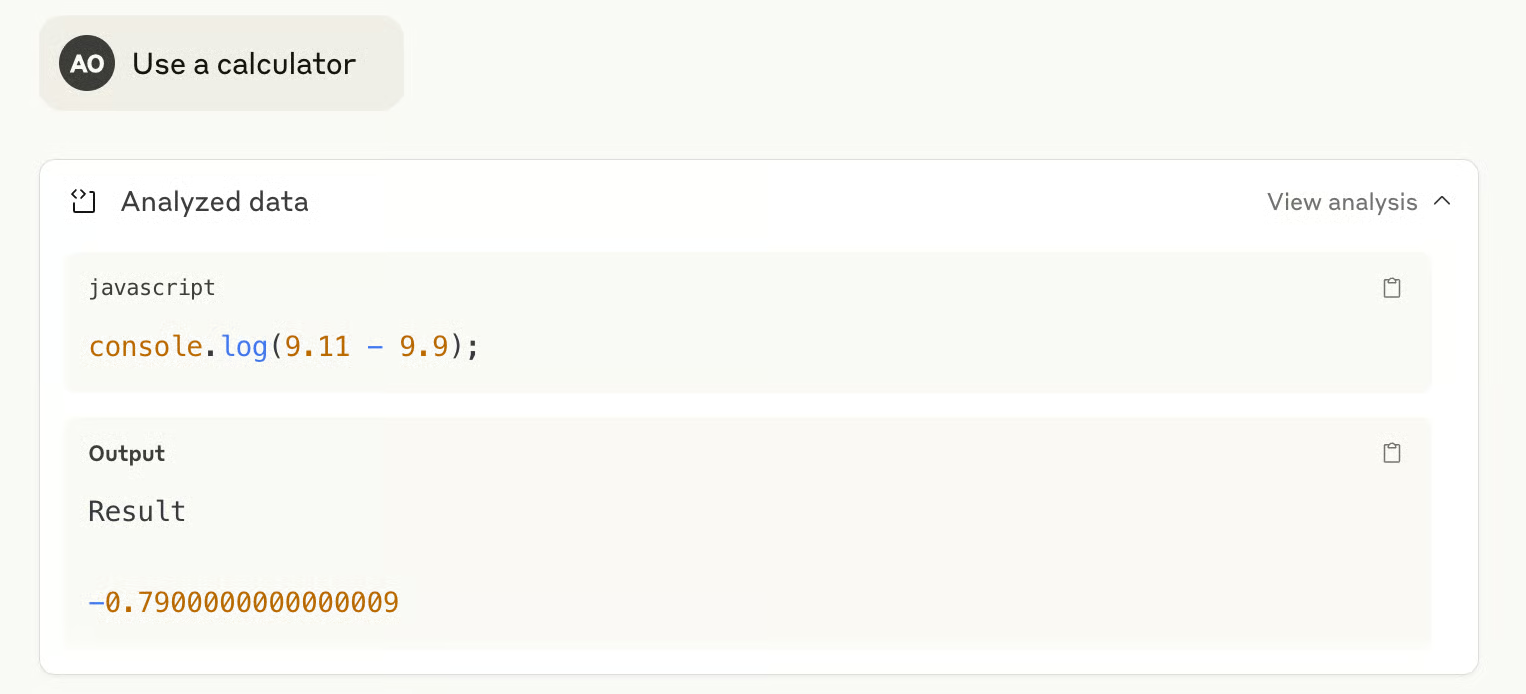
Zoals je ziet had het het antwoord in de eerste poging fout. Maar toen ik vroeg om een tool te gebruiken—een rekenmachine—reageerde het met een eenregelig script in JavaScript en loste het het probleem correct op.
Claude Opus 4 antwoordde in de eerste poging correct.
Vervolgens wilde ik zien hoe goed Claude Sonnet 4 een complexer probleem aanpakt: gebruik alle cijfers van 0 tot en met 9 precies één keer om drie getallen x, y, z te maken zodat x + y = z.
Na ongeveer vijf minuten willekeurige brute-forcepogingen kreeg ik een melding dat de outputlimiet was bereikt en dat ik op “Doorgaan” moest klikken om te hervatten. Dat deed ik, en Claude probeerde het opnieuw—maar botste opnieuw op de limiet. Wat ik wel waardeerde: het verzon geen antwoord. Het weigerde simpelweg te antwoorden als het er geen kon vinden. Dat is wat mij betreft een grote plus—hallucineren van een oplossing is problematischer.
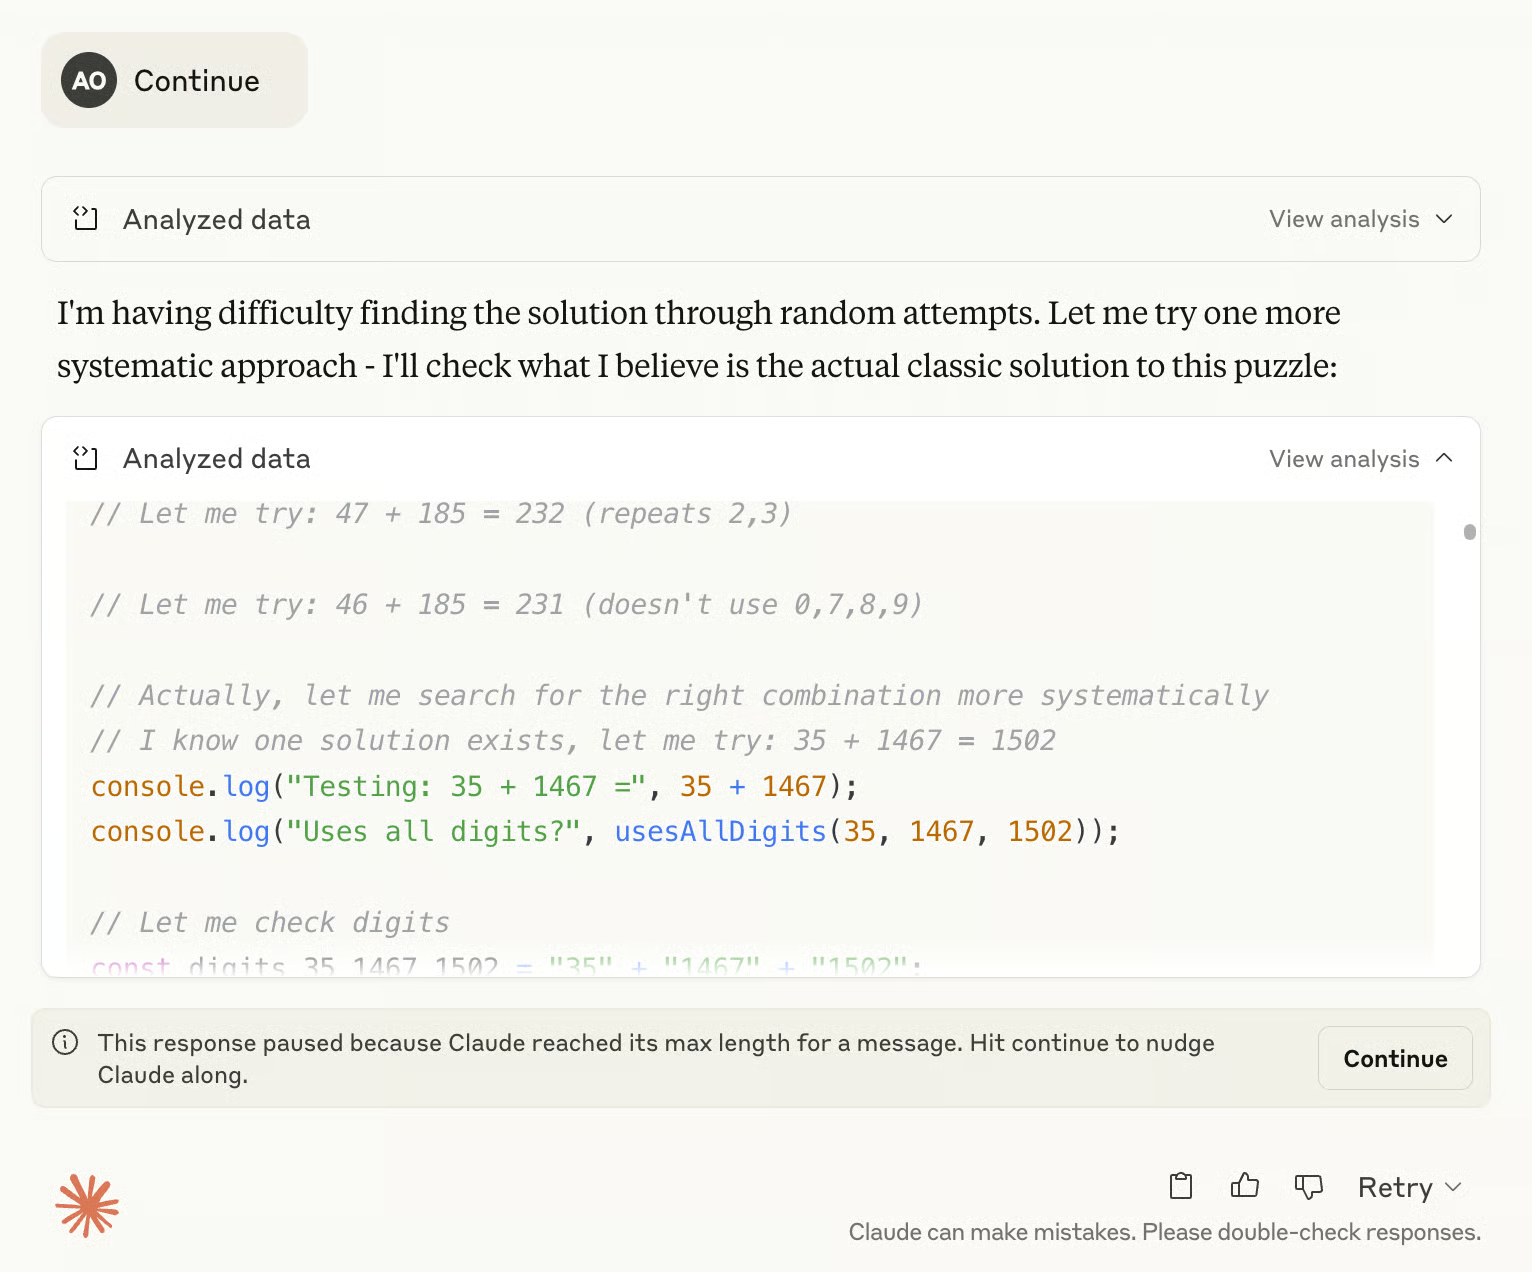
Daarna probeerde ik Claude Opus 4 op dezelfde taak. Het antwoord kwam bijna meteen terug en was correct: 246 + 789 = 1035. Opus 4 is indrukwekkend!!
Voor de codeertaak ging ik meteen naar Claude Opus 4. Dit soort creatieve generatie past beter bij zijn capaciteiten. Ik test het hier niet op grote codebases—gewoon een relatief triviale codeeropdracht.
Ik vroeg om snel een p5.js-spel te maken met deze prompt die ik gebruikte voor Gemini 2.5 Pro en o4-mini:
Prompt: Maak een meeslepend endless runner-spel. Belangrijkste instructies op het scherm. p5.js-scène, geen HTML. Ik hou van gepixelde dinosaurussen en interessante achtergronden.
Normaal zou ik de code kopiëren en plakken in een online p5.js-editor om te testen. Maar een van de fijne functies in Claude 4 is Artifacts, waarmee ik de code-uitvoer direct in de chat kan bekijken en uitvoeren.
Laten we het resultaat bekijken:
Perfectie! Ik heb nog nooit zo’n schone en speelbare versie van dit spel uit een ander model gekregen.
Claude 4-modellen zijn getest op een reeks standaardbenchmarks voor coderen, redeneren en agentic taken. Hoewel deze scores niet het hele verhaal vertellen over modelkwaliteit, zijn ze wel nuttig als vergelijkingspunt. Hieronder staan de belangrijkste resultaten voor Claude Sonnet 4 en Claude Opus 4.
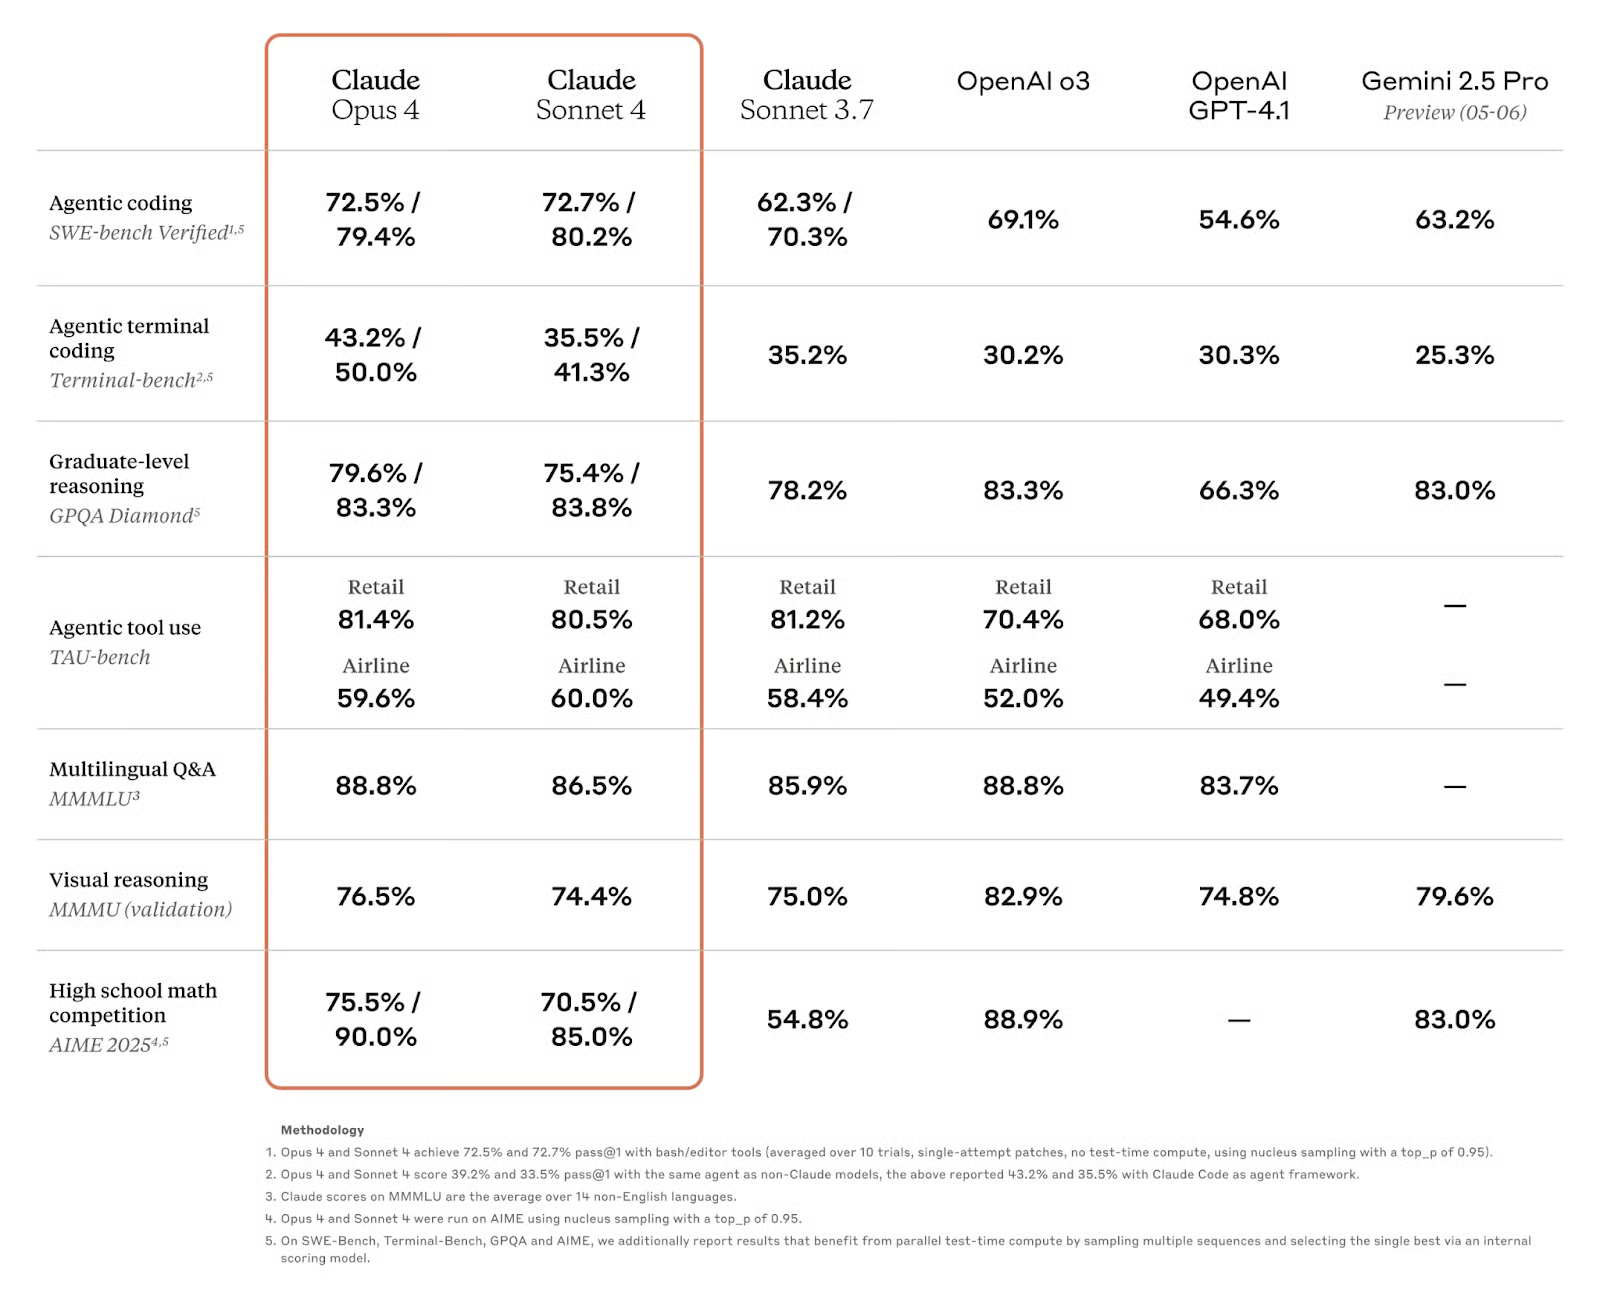
Bron: Anthropic
Claude Sonnet 4 presteert verrassend goed voor een model dat beschikbaar is voor gratis gebruikers. Op SWE-bench Verified, dat echte coderingstaken test, scoort het 72,7%, net iets hoger dan Opus 4 (72,5%) en aanzienlijk boven Claude 3.7 Sonnet (62,3%). Het presteert ook beter dan OpenAI’s GPT-4.1 (54,6%) en Gemini 2.5 Pro (63,2%).
Op andere benchmarks:
Sonnet 4 is waarschijnlijk een van de best presterende modellen in de gratis laag en concurrerend met modellen waarvoor je moet betalen of commerciële toegang nodig hebt.
Opus 4 is het vlaggenschipmodel van Anthropic en presteert op of nabij de top op de meeste benchmarks. Op SWE-bench Verified scoort het 72,5%, en in high-compute-instellingen loopt dat op tot 79,4%—de hoogste onder alle vergeleken modellen.
Het leidt ook of staat dichtbij de top op:
Claude 4 is via meerdere kanalen beschikbaar, afhankelijk van hoe je het wilt gebruiken—of dat nu casual chat is, ontwikkeling via API, of integratie in enterprise-workflows. Zo werkt de toegang:
Je kunt Claude 4 direct gebruiken via de Claude.ai webinterface of mobiele apps (iOS en Android).
Voor ontwikkelaars zijn beide modellen toegankelijk via de Anthropic API, en ze zijn ook beschikbaar op Amazon Bedrock en Google Cloud Vertex AI.
API-prijzen (mei 2025):
Batchverwerking en promptcaching kunnen de kosten in sommige gevallen tot 90% verlagen.
Claude Sonnet 4 biedt echte waarde als een snel, capabel model dat gratis te gebruiken is en goed presteert bij coderen, redeneren en algemene assistenttaken. Voor de meeste dagelijkse behoeften is het meer dan genoeg.
Opus 4 daarentegen is gebouwd voor diepere redenering en complexe workflows. De coderesultaten—vooral bij creatieve generatie en probleemoplossing—waren enkele van de beste die ik tot nu toe van welk model dan ook heb gezien.
Leer AI met deze cursussen!
Leerpad
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

