
Daha önce test ettiğim hiçbir model, başlangıç ekranını ilk denemede doğru yapmamıştı—çoğu doğrudan oyuna geçiyordu. Claude Opus 4 ise talimatların olduğu düzgün bir başlangıç ekranı gösterdi; bu güzel bir sürpriz oldu.
Ancak görsel bir hata vardı: pikselli dinozor ekranda hareket ederken kafa karıştırıcı bir iz bırakıyordu. Kareler arasında pikseller düzgün temizlenmiyordu, bu da oynanışı bozdu. Bunu belirttim ve Opus 4’ten düzeltmesini istedim.
Mükemmellik! Bu oyunun bu kadar temiz ve oynanabilir bir sürümünü başka hiçbir modelden alamamıştım.
Claude 4 Kıyaslamaları
Claude 4 modelleri, kodlama, akıl yürütme ve ajans benzeri görevler genelinde bir dizi standart kıyaslamada test edildi. Bu puanlar model kalitesinin tüm hikâyesini anlatmasa da, karşılaştırma için hâlâ faydalı. Aşağıda Claude Sonnet 4 ve Claude Opus 4 için temel sonuçlar yer alıyor.
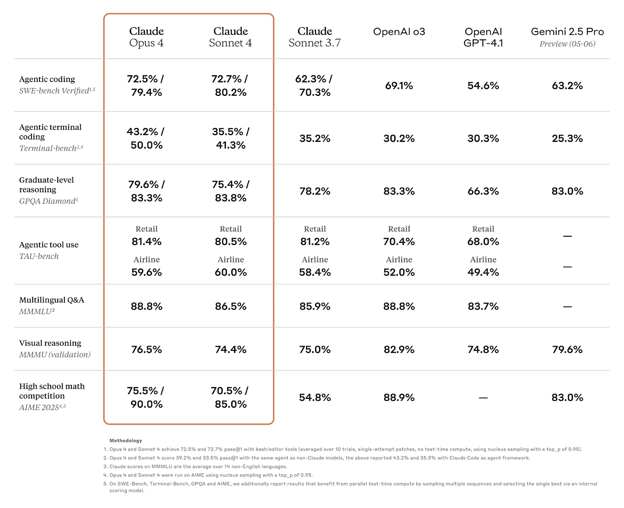
Kaynak: Anthropic
Claude Sonnet 4
Claude Sonnet 4, ücretsiz kullanıcılara sunulan bir model için şaşırtıcı derecede iyi performans gösteriyor. Gerçek dünya kodlama görevlerini test eden SWE-bench Verified’da %72,7 puan alıyor; Opus 4’ü (%72,5) az farkla geride bırakıyor ve Claude 3.7 Sonnet’in (%62,3) oldukça önünde. Ayrıca OpenAI’nin GPT-4.1’ini (%54,6) ve Gemini 2.5 Pro’yu (%63,2) geride bırakıyor.
Diğer kıyaslamalarda:
- TerminalBench (CLI tabanlı kodlama): %35,5 – GPT-4.1 (%30,3) ve Gemini (%25,3) önünde
- GPQA Diamond (lisansüstü düzey akıl yürütme): %75,4 – güçlü, fakat OpenAI o3 ve Gemini’nin biraz gerisinde
- TAU-bench (ajans benzeri araç kullanımı): %80,5 Perakende / %60,0 Havayolu – Opus 4 ile karşılaştırılabilir ve GPT-4.1 ile o3’ün önünde
- MMLU (çok dilli S&Y): %86,5 – Opus ve o3’ün hemen gerisinde ama yine de sağlam
- MMMU (görsel akıl yürütme): %74,4 – model serisi genelindeki en düşük skor
- AIME (matematik yarışması): %70,5 – Sonnet 3.7’den iyi, ancak yeterince rekabetçi değil
Sonnet 4, muhtemelen şu anda mevcut en iyi performans gösteren ücretsiz katman modellerinden biri ve ödeme veya ticari erişim gerektiren modellerle rekabet ediyor.
Claude Opus 4
Opus 4, Anthropic’in amiral gemisi modeli ve çoğu kıyaslamada en üstte ya da zirveye yakın performans gösteriyor. SWE-bench Verified’da %72,5 puan alıyor; yüksek hesaplama ayarlarında bu %79,4’e çıkıyor—karşılaştırılan tüm modeller arasında en yüksek.
Ayrıca şu alanlarda da lider ya da zirveye yakın:
- TerminalBench (ajans benzeri CLI kodlama): %43,2 (yüksek hesaplama modunda %50,0) – tablodaki en güçlü skor
- GPQA Diamond (lisansüstü düzey akıl yürütme): %79,6 (%83,3) – sağlam, OpenAI o3 ve Gemini 2.5 Pro’nun biraz gerisinde
- TAU-bench (ajans benzeri araç kullanımı): %81,4 Perakende / %59,6 Havayolu – Sonnet 4 ve 3.7 ile denk
- MMLU (çok dilli S&Y): %88,8 – OpenAI o3 ile başa baş
- MMMU (görsel akıl yürütme): %76,5 – o3 ve Gemini 2.5 Pro’nun gerisinde
- AIME (matematik yarışması): %75,5 (yüksek hesaplamada %90,0) – Claude Sonnet 4’ün belirgin şekilde üzerinde
Claude 4’e Nasıl Erişilir
Claude 4’e, nasıl kullanmak istediğinize bağlı olarak—gündelik sohbet, API üzerinden geliştirme veya kurumsal iş akışlarına entegrasyon—birden fazla kanaldan erişilebilir. Erişim şu şekilde çalışır:
Sohbet erişimi
Claude 4’ü doğrudan Claude.ai web arayüzü veya mobil uygulamalar (iOS ve Android) üzerinden kullanabilirsiniz.
- Claude Sonnet 4 tüm kullanıcılara, ücretsiz katman dahil, sunuluyor. Bu da onu, ödeme yapmadan deneyebileceğiniz en yetkin modellerden biri yapıyor.
- Claude Opus 4 yalnızca Pro, Max, Team veya Enterprise planlarında ödeme yapan kullanıcılara sunuluyor.
API erişimi
Geliştiriciler için, her iki modele de Anthropic API üzerinden erişilebilir; ayrıca Amazon Bedrock ve Google Cloud Vertex AI üzerinde de mevcutturlar.
API fiyatlandırması (Mayıs 2025 itibarıyla):
- Claude Opus 4: milyon başına $15 giriş belirteci, milyon başına $75 çıkış belirteci
- Claude Sonnet 4: milyon başına $3 giriş belirteci, milyon başına $15 çıkış belirteci
Toplu işleme ve istem önbellekleme, bazı durumlarda maliyetleri %90’a kadar azaltabilir.
Sonuç
Claude Sonnet 4, ücretsiz olarak kullanılabilen, hızlı ve yetkin bir model olarak gerçek bir değer sunuyor; kodlama, akıl yürütme ve genel asistan görevlerinde iyi performans gösteriyor. Günlük ihtiyaçların çoğu için fazlasıyla yeterli.
Öte yandan Opus 4, daha derin akıl yürütme ve karmaşık iş akışları için inşa edildi. Özellikle yaratıcı üretim ve problem çözmede elde ettiğim kodlama sonuçları, şimdiye kadar herhangi bir modelden gördüklerimin en iyileri arasındaydı.

Yapay zeka ile ilgili bloglar, eğitimler ve haberleri kapsayan bir editör ve yazarım; tüm içeriklerin güçlü bir içerik stratejisine ve SEO en iyi uygulamalarına uygun olmasını sağlıyorum. Python, istatistik, olasılık ve veri görselleştirme üzerine veri bilimi kursları yazdım. Ödüllü bir roman yayımladım ve boş zamanlarımı senaryo yazımı ile film yönetmenliğine ayırıyorum.



Anthropic kısa süre önce Claude 4’ü yayınladı; iki sürümle geliyor: Claude 4 Sonnet ve Claude 4 Opus.
Claude Sonnet 4 çoğu yapay zeka kullanım senaryosu için ideal, genel amaçlı bir model ve özellikle kodlamada çok güçlü. Bence ücretsiz kullanabileceğiniz en iyi modellerden biri.
Claude Opus 4 ise ajans benzeri arama ve uzun süreli kod iş akışları gibi yoğun akıl yürütme gerektiren görevler için tasarlandı. Anthropic, Opus 4’ü “dünyanın en iyi kodlama modeli” olarak tanımlıyor ama bu iddia bana biraz boş geliyor.
Evet, şu anda SWE-bench Verified kıyaslamasında en üstte. Ancak yalnızca 200B’lik bir bağlam penceresiyle çok büyük kod depolarını tertemiz idare edebileceğini hayal edemiyorum. Ve dürüst olalım: her ay daha da güçlü bir model çıkıyor. Birkaç hafta için taç giymenin pek anlamı yok.
Bununla birlikte, Claude 4 yine de çok güçlü bir sürüm. En önemli ayrıntılarda—özellikler, kullanım alanları, kıyaslamalar—size yol göstereceğim ve ayrıca kendi testlerimden birkaçını yapacağım.
Okurlarımızı yapay zekâdaki en son gelişmelerden haberdar etmek için, haftanın öne çıkan haberlerini özetleyen ve her Cuma ücretsiz olarak gönderdiğimiz The Median bültenini yayınlıyoruz. Abone olun; haftada sadece birkaç dakikada güncel kalın:
Claude Sonnet 4
Claude Sonnet 4, Claude 4 ailesindeki daha küçük modeldir. Genel amaçlı kullanım için tasarlanmıştır ve kodlama, yazma, soru yanıtlama, veri analizi gibi yaygın yapay zekâ görevlerinin çoğunda iyi performans gösterir. Ücretsiz kullanıcılara da sunulması, bu kalitede bir model için alışılmadık derecede erişilebilir kılıyor.
Model, 200B’lik bir bağlam penceresini destekler; bu da büyük girdileri ele almasına ve uzun etkileşimler boyunca süreklilik sağlamasına olanak tanır. Bu, uzun belgeleri analiz etmek, kod depolarını gözden geçirmek ya da tutarlı yapıda çok parçalı yanıtlar üretmek gibi kullanım senaryoları için faydalıdır. Ancak Sonnet 4 büyük kod depolarında zorlanabilir. Karşılaştırma için, Gemini 2.5 Flash 1M belirteçlik bir bağlam penceresine sahip.
Şuna kıyasla: Claude Sonnet 3.7, bu sürüm daha hızlı, talimatları daha iyi takip ediyor ve kod ağırlıklı iş akışlarında daha güvenilir. 64B’ye kadar çıktı belirteçlerini destekliyor; bu da yapılandırılmış planlar, çok parçalı yanıtlar veya büyük kod tamamlamaları gibi nispeten daha uzun çıktılarda yardımcı oluyor.
Erken raporlar daha az gezinme hatası ve uygulama geliştirme görevlerinde daha iyi performans gösterdiğini belirtiyor. Karmaşık akıl yürütme veya uzun vadeli görev planlamasında Opus 4 kadar güçlü değil, ancak çoğu iş akışı için fazlasıyla yeterli.
Claude Opus 4
Claude Opus 4, Claude 4 serisinin amiral gemisi modelidir. Daha derin akıl yürütme, uzun vadeli bellek ve daha yapılandırılmış çıktılar gerektiren görevler—ajans benzeri arama, büyük ölçekli kod yeniden düzenleme, çok adımlı problem çözme ve uzatılmış araştırma iş akışları gibi—için geliştirilmiştir.
Sonnet 4 gibi, 200B’lik bir bağlam penceresini destekliyor; bu da büyük bir kod deposuyla kullanmak istediğinizde dezavantaj olabilir. Karşılaştırma için, Gemini 2.5 Pro (Google’ın amiral gemisi modeli) 1M belirteçlik bir bağlam penceresine sahip.
Ayrıca “genişletilmiş düşünme” modunda çalışabilme özelliğine de sahip; bu modda hızlı yanıtlardan daha yavaş, daha kasıtlı akıl yürütmeye geçiyor. Bu mod, gerektiğinde araç kullanımı yapmasına, adımlar arasında belleği takip etmesine ve kendi düşünce süreçlerinin özetlerini üretmesine olanak tanıyor.
Anthropic, bu modeli geliştiriciler, araştırmacılar ve yapay zekâ ajanları inşa eden ekipler için üst düzey bir model olarak konumlandırıyor. SWE-bench Verified ve Terminal-bench’te önde; erken kullanıcılar kodlama ajanlarında, arama iş akışlarında ve açık kaynak projelerin yeniden düzenlenmesi veya uzun vadeli planlama simülasyonları gibi çok saatlik görevlerde güçlü performans bildirdi.
Sonnet’ten farklı olarak, Opus 4 yalnızca ücretli planlarda mevcut. Çalıştırması daha pahalı ve basit sohbet botu kullanımı için muhtemelen aşırı. Ancak çok sayıda hareketli parça arasında tutarlı akıl yürütme gerektiren uygulamalar için daha yetkin bir tercih.
Claude 4’ün Testi
Yeni bir modeli test ederken genellikle aynı görevleri kullanırım—böylece daha önce test ettiğim modellere kıyasla nasıl durduğunu görebilirim. Bu kapsamlı bir değerlendirme değil. Amaç, bu modellerin sohbet arayüzünde nasıl davrandığına dair bir fikir edinmek.
Claude 4’ü iki alanda deneyelim: matematik ve kodlama.
Matematik
Sıklıkla dil modellerini şaşırtan basit bir hesaplamayla başlamayı seviyorum. Bu, temel aritmetiği kontrol etmekle ilgili değil—onun için bir hesap makinesi kullanabilirdim. Mesele, modelin biraz hınzır bir sorunu nasıl ele aldığını ve gerektiğinde araç kullanımına başvurup başvuramadığını ya da akıl yürütmesini açıkça gösterip gösteremediğini görmek.
Bakalım Claude Sonnet 4 bunu ne kadar iyi halletti:
Gördüğünüz gibi, ilk denemede yanıtı yanlış verdi. Ancak bir araç—hesap makinesi—kullanmasını istediğimde, JavaScript ile tek satırlık bir betik yazarak yanıt verdi ve sorunu doğru çözdü.
Claude Opus 4 ise ilk denemede doğru cevapladı.
Sonra Claude Sonnet 4’ün daha karmaşık bir problemi ne kadar iyi ele aldığını görmek istedim: 0’dan 9’a kadar tüm rakamları tam olarak birer kez kullanarak üç sayı x, y, z oluşturun; öyle ki x + y = z olsun.
Yaklaşık beş dakikalık rastgele kaba kuvvet denemelerinden sonra, çıktı sınırına ulaşıldığını ve devam etmek için “Sürdür”e tıklamam gerektiğini belirten bir mesaj aldım. Öyle yaptım; Claude yeniden denedi—ama sonra yine sınıra takıldı. Yine de takdir ettiğim şey, bir cevap uydurmamasıydı. Bir yanıt bulamadıysa yanıtlamayı reddetti. Bu, bence büyük bir artı—halüsinasyon görerek bir çözüm uydurması daha sorunlu olurdu.
Aynı görevi bu kez Claude Opus 4 ile denedim. Yanıt neredeyse anında geldi ve doğruydu: 246 + 789 = 1035. Opus 4 etkileyici!!
Kodlama
Kodlama görevi için doğrudan Claude Opus 4’e geçmeye karar verdim. Bu tür yaratıcı üretim, yeteneklerine daha uygun görünüyor. Burada büyük kod depolarını test etmiyorum—görece önemsiz bir kodlama görevi.
Şu istemi kullanarak hızlı bir p5.js oyunu yapmasını istedim; bunu daha önce Gemini 2.5 Pro ve o4-mini için de kullanmıştım:
İstem: Bana etkileyici bir sonsuz koşucu oyunu yap. Ekranda temel talimatlar olsun. p5.js sahnesi, HTML olmasın. Pikselli dinozorları ve ilginç arka planları seviyorum.
Normalde kodu test etmek için çevrimiçi bir p5.js düzenleyicisine kopyalayıp yapıştırırdım. Ancak Claude 4’teki güzel özelliklerden biri olan Artifacts, kod çıktısını doğrudan sohbet içinde görmeme ve çalıştırmama olanak tanıyor.
Sonuca bakalım: