
Programma
Nozioni di base sull'intelligenza artificiale nel mondo degli affari
12 ore
I modelli di ragionamento stanno diventando sempre più importanti e diffusi, e se ne capisce il motivo. Se guardi il grafico qui sotto, noterai che il 37,2% degli utenti si affida a Claude per domande di programmazione e matematica, secondo l’Anthropic Economic Index. Questo ci dice una cosa: modelli di ragionamento solidi possono portare un reale valore al business, soprattutto mentre l’adozione dell’AI in ambito enterprise resta bassa.
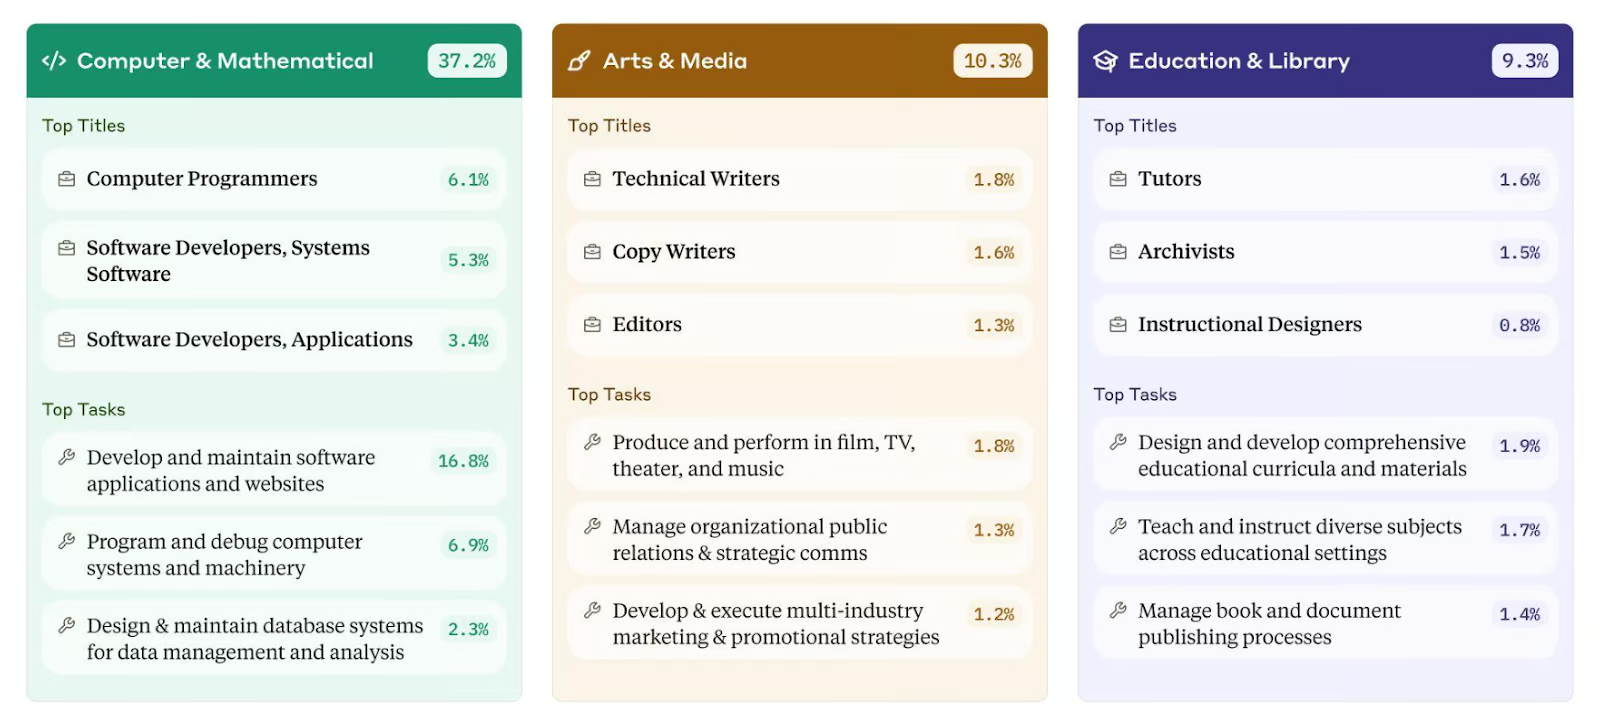
Fonte: Antrophic Economic Index
Allo stesso tempo, Claude 3.7 non è solo un modello di ragionamento: è un ibrido. Possiamo passare alla Thinking Mode (per compiti di ragionamento strutturato) e a una modalità chat standard per conversazione generale, scrittura e riassunti.
Claude 3.7 Sonnet è un aggiornamento molto più grande di quanto suggerisca il numero di versione. I dati dei benchmark confermano che supera Claude 3.5 Sonnet in ragionamento, coding ed esecuzione di compiti nel mondo reale.
Claude 3.7 Sonnet mostra un chiaro vantaggio nell’ingegneria del software, con un’accuratezza del 62,3% in SWE-bench Verified, un salto significativo rispetto al 49,0% di Claude 3.5 Sonnet. Usando uno scaffold personalizzato (un prompt strutturato o contesto aggiuntivo che aiuta a guidare la risposta del modello verso una soluzione più accurata), l’accuratezza sale al 70,3%, rendendolo il modello con le migliori prestazioni in questa categoria.
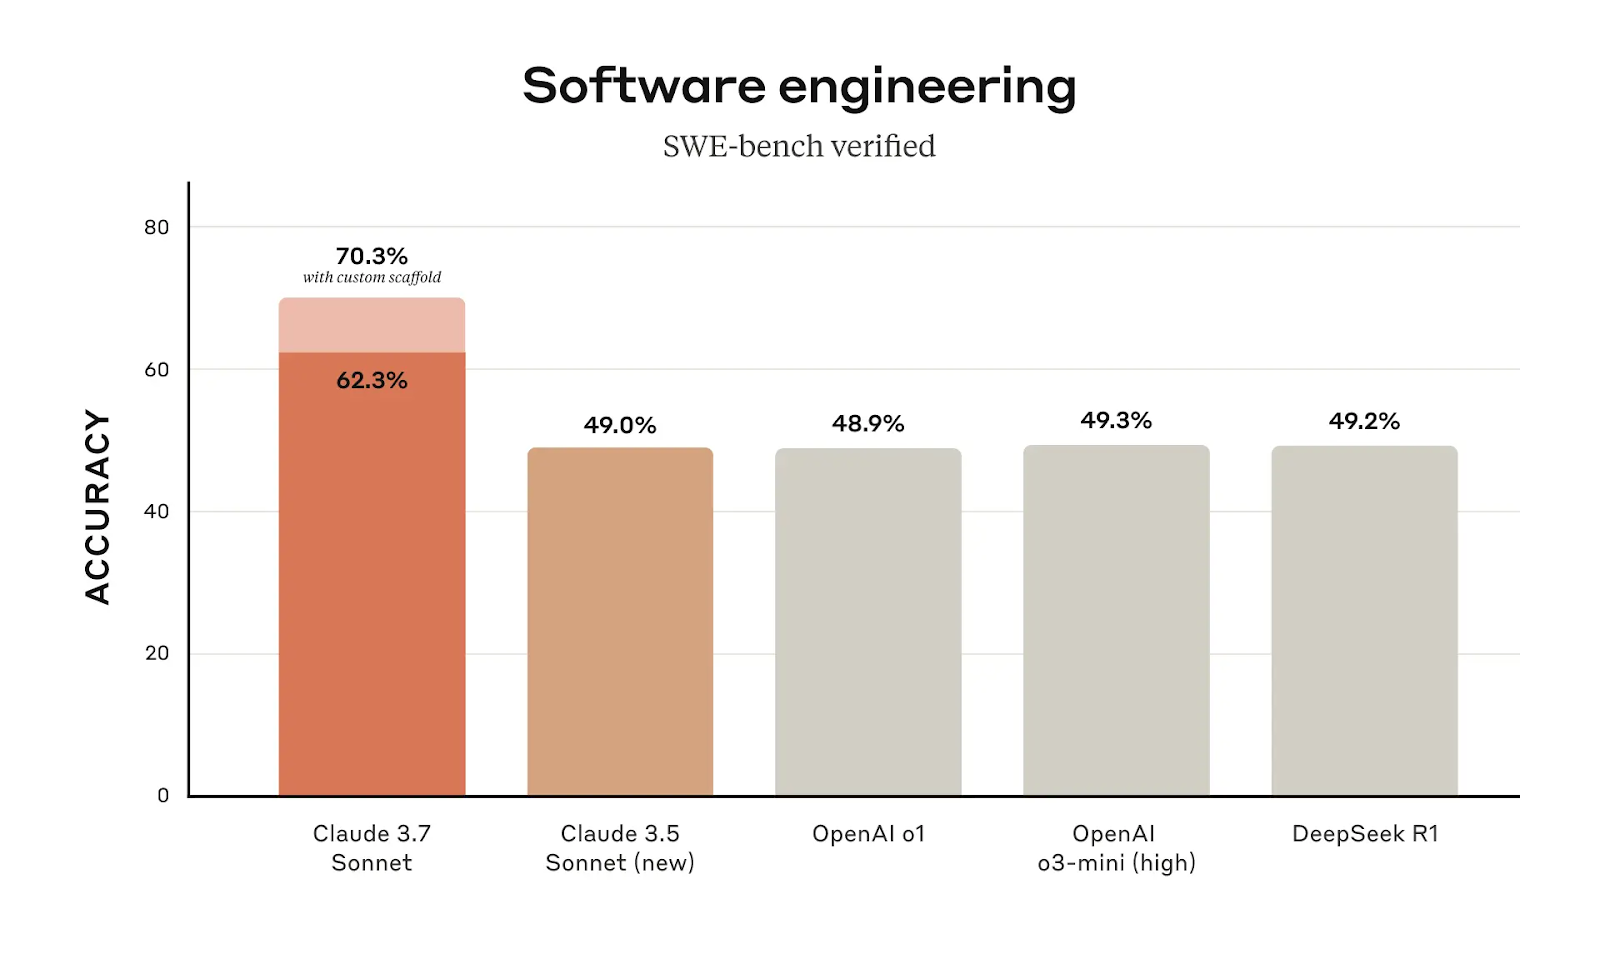
Fonte: Anthropic
Un miglioramento di quasi il 13% nell’accuratezza tra versioni del modello non è una semplice rifinitura. Suggerisce che Claude 3.7 Sonnet sia stato ottimizzato per una migliore comprensione ed esecuzione di compiti legati alla programmazione. Per chi usa Claude per ingegneria del software, debugging o automazione, l’aggiornamento fa una differenza tangibile.
Le prestazioni nell’uso agentico degli strumenti sono un’altra area in cui Claude 3.7 Sonnet supera il suo predecessore. Nei compiti legati al retail, raggiunge l’81,2% di accuratezza, in aumento rispetto al 71,5% di Claude 3.5 Sonnet. Nei compiti legati alle compagnie aeree, ottiene il 58,4%, un miglioramento di quasi dieci punti rispetto alla versione precedente.
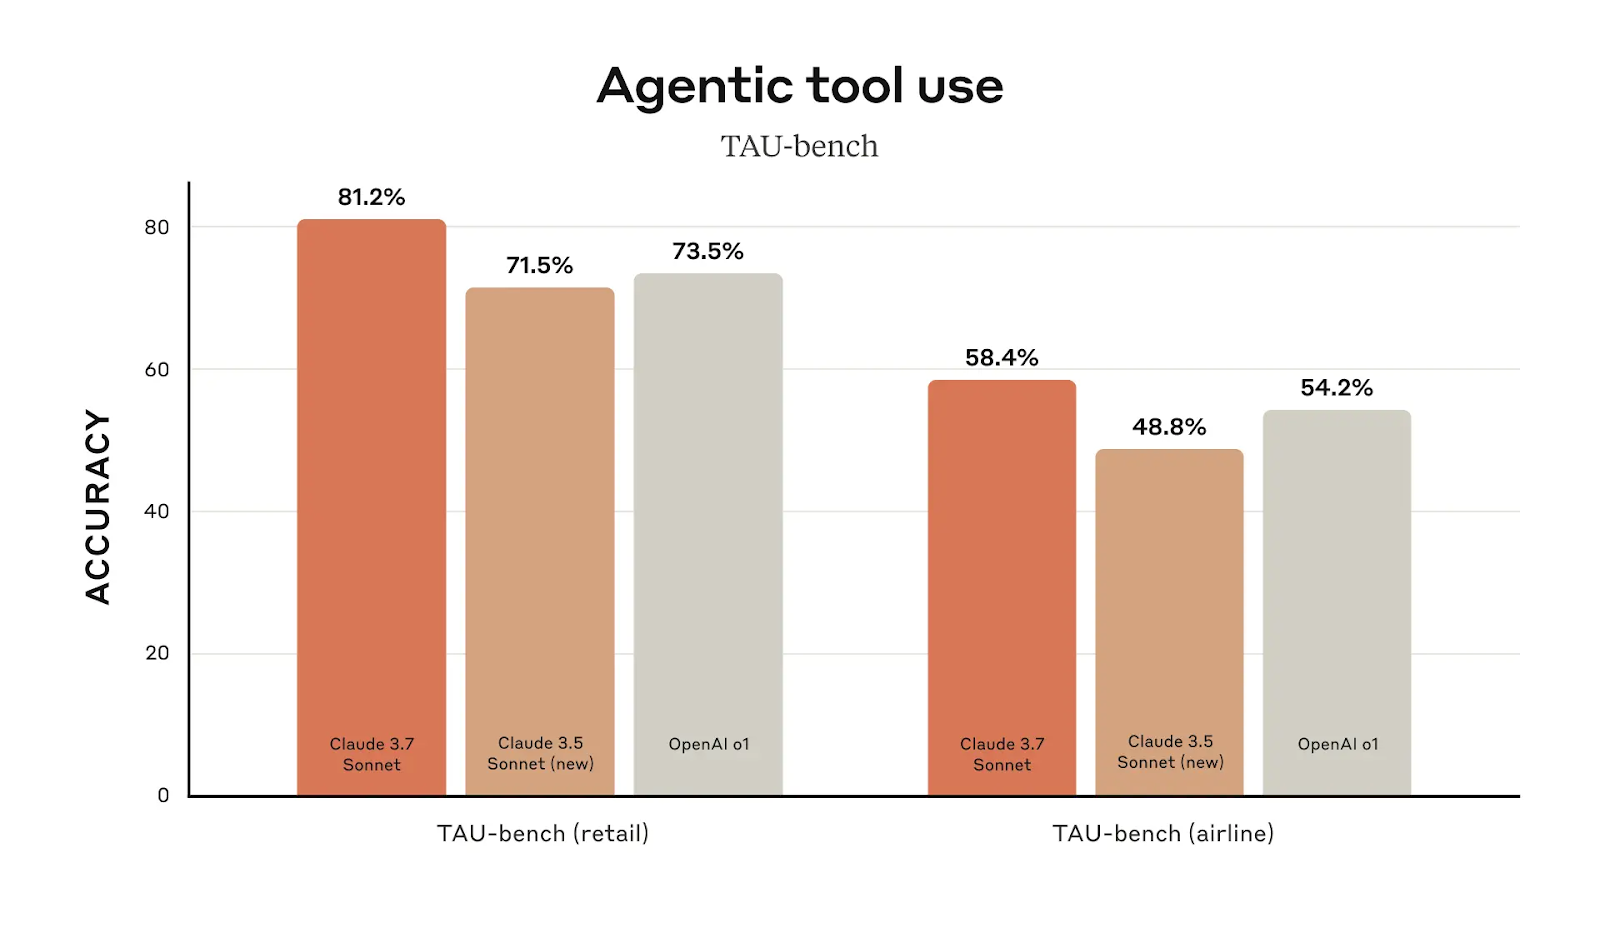
Fonte: Anthropic
Su tutti i benchmark, i maggiori guadagni arrivano dalla modalità di extended thinking, che consente a Claude 3.7 di performare a un livello molto più alto nei compiti di ragionamento complesso. Chi si affida all’AI per workflow strutturati, coding o problem solving vedrà una chiara differenza tra Claude 3.5 e Claude 3.7, soprattutto usando l’extended thinking.
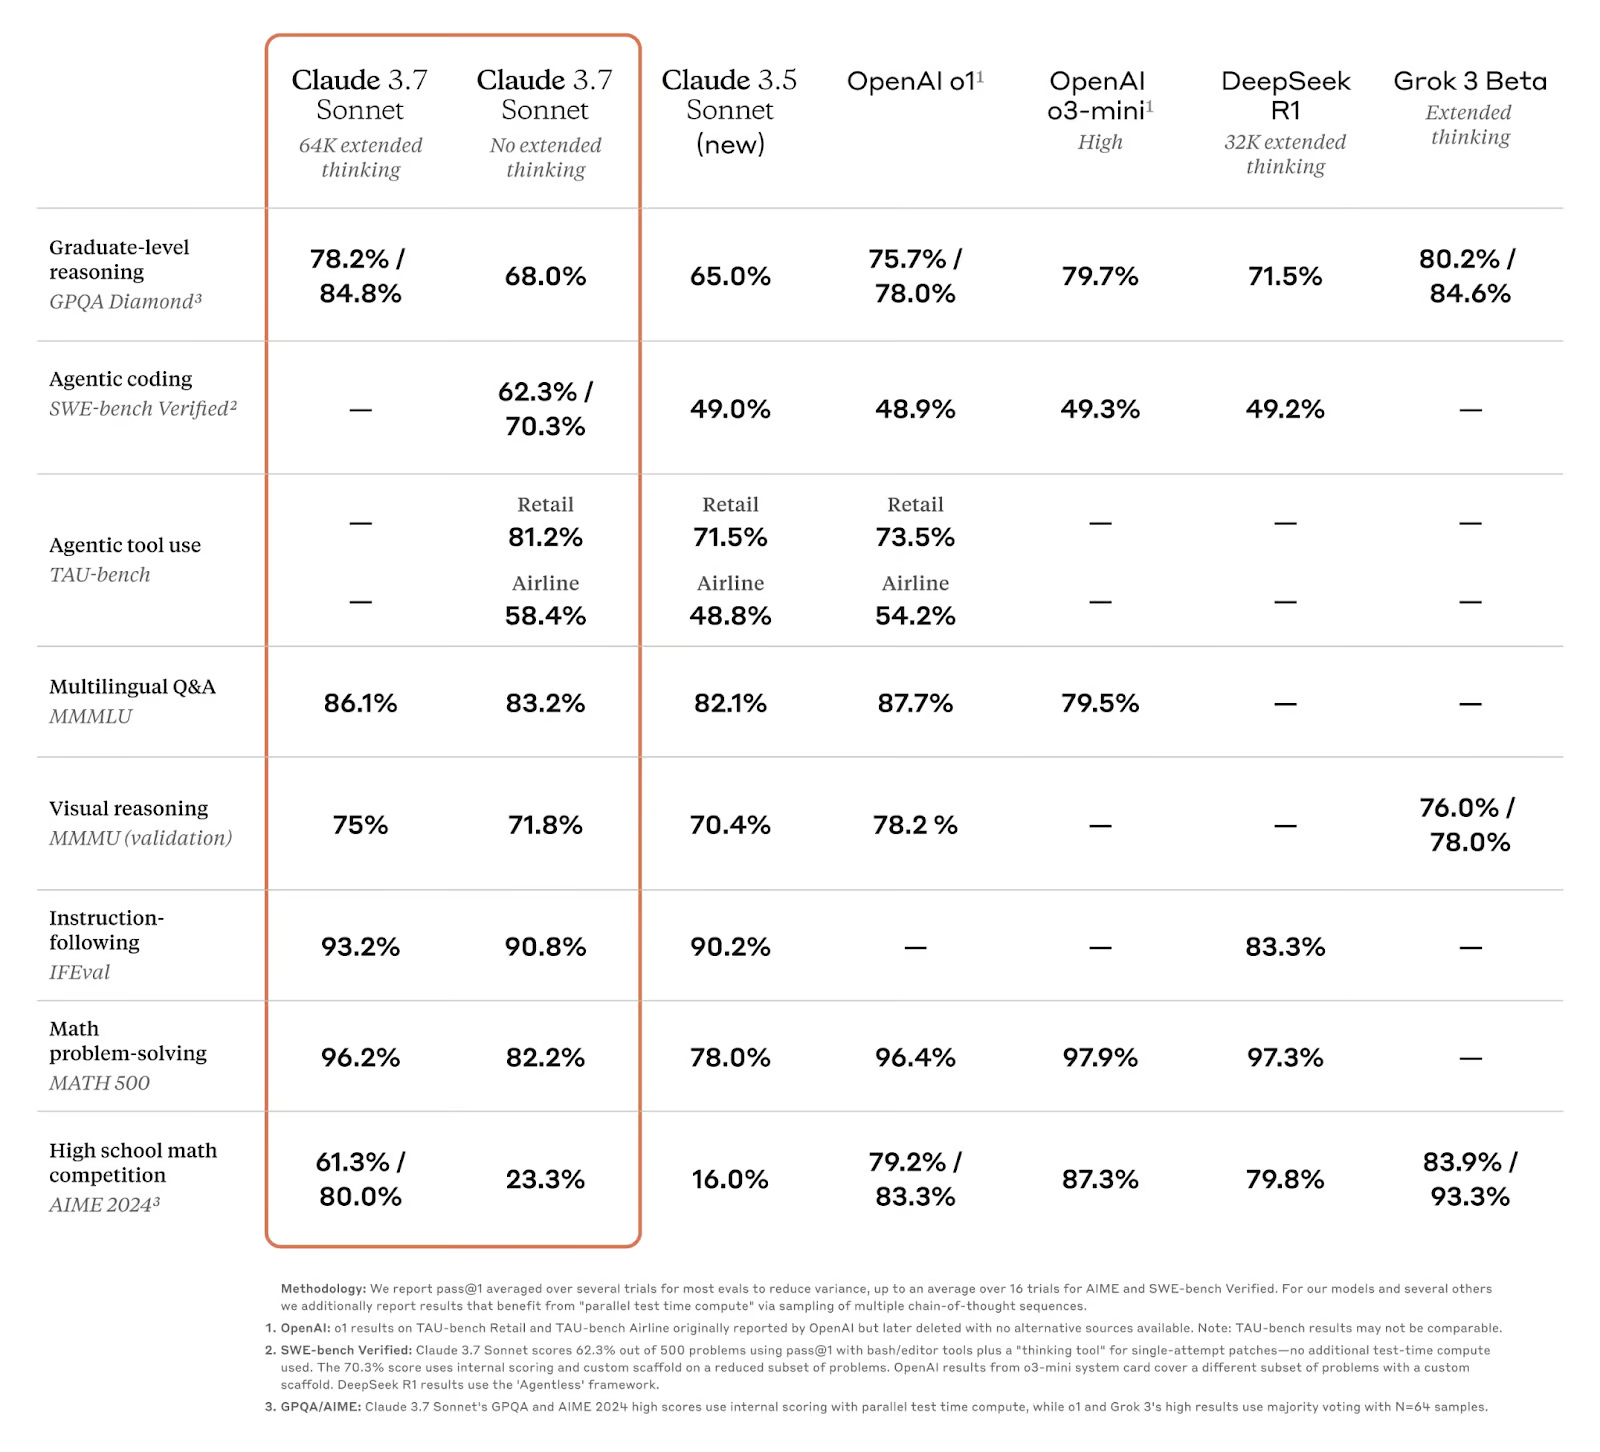
Fonte: Anthropic
La maggior parte di questi progressi deriva dall’extended thinking di Claude, quindi approfondiamo questo aspetto.
Quando attivata, la modalità di extended thinking aumenta il numero di passaggi di ragionamento che Claude esegue prima di finalizzare una risposta. Gli sviluppatori possono perfezionare questo processo impostando un thinking budget, che definisce quanti token il modello può usare mentre affronta un problema. Come mostrato nel grafico delle prestazioni AIME 2024 qui sotto, l’accuratezza migliora man mano che vengono allocati più token, seguendo un andamento logaritmico.
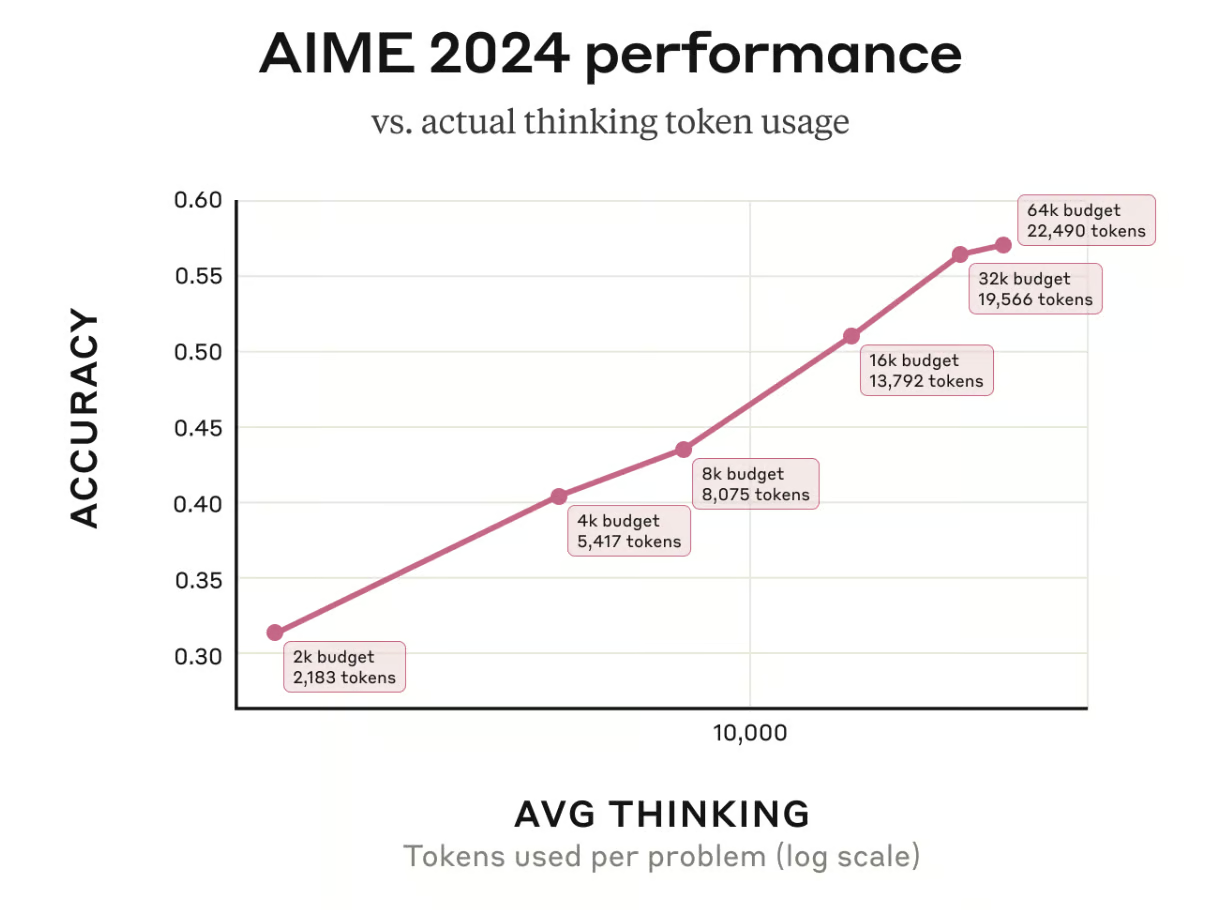
Fonte: Anthropic
Questo approccio rispecchia lo sforzo cognitivo umano: per i compiti semplici bastano risposte rapide, ma per quelli complessi un’analisi più profonda porta a risultati migliori. Ora Claude può decidere quando fermarsi, rivalutare e affinare il suo ragionamento invece di limitarsi a risposte immediate.
Uno degli aspetti più interessanti dell’extended thinking è che il processo di ragionamento di Claude è visibile all’utente. Tuttavia, questa funzionalità solleva alcune sfide. Pur offrendo uno sguardo sul ragionamento dell’AI, il flusso di pensiero mostrato potrebbe non allinearsi sempre perfettamente con il modo in cui il modello prende realmente le decisioni. Il “problema della fedeltà”—ovvero se i pensieri auto-riferiti di un’AI rappresentino accuratamente la sua meccanica interna—è ancora una questione aperta di ricerca.
La capacità di Claude 3.7 Sonnet di impegnarsi in un ragionamento iterativo di lungo periodo è testata in valutazioni come OSWorld e il gameplay di Pokémon Red. In Pokémon Red, per esempio, Claude 3.7 Sonnet raggiunge una progressione in gioco molto superiore alle versioni precedenti, superando più traguardi mentre i modelli più vecchi si bloccano nelle fasi iniziali.
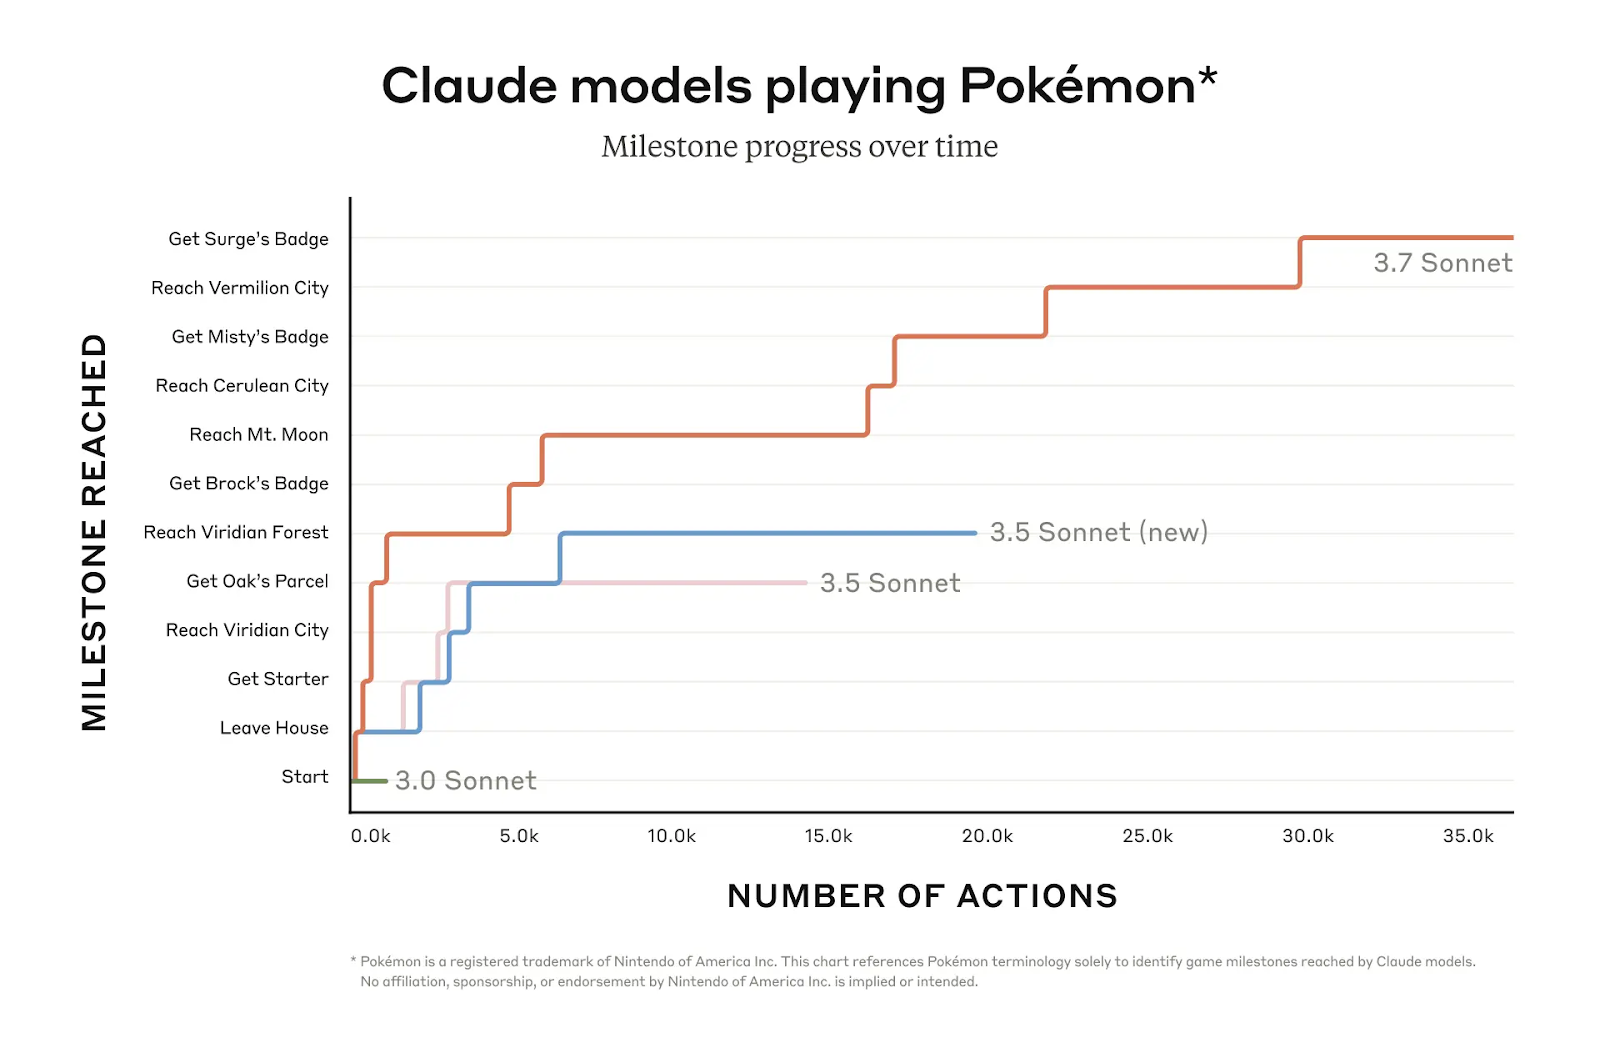
Fonte: Anthropic
Abbiamo visto come Claude 3.7 Sonnet si comporta rispetto alla sua versione precedente, ma come se la cava rispetto a o3-mini di OpenAI, DeepSeek-R1 o Grok 3?
Guardando i benchmark aggiornati, Claude 3.7 Sonnet si è posizionato tra i modelli con le migliori prestazioni, soprattutto nei compiti a forte componente di ragionamento, nel coding e nell’uso agentico degli strumenti.
Nel ragionamento a livello graduate (GPQA Diamond), Claude 3.7 Sonnet ottiene il 68,0% in modalità standard e l’84,8% in extended thinking, risultando uno dei modelli più forti in questa categoria. Supera o1 di OpenAI (78,0%) e DeepSeek-R1 (71,5%) di un margine significativo e Grok 3 Beta (84,6%) di un margine ridotto.
|
Benchmark |
Claude 3.7 Sonnet (Standard) |
Claude 3.7 Sonnet (Extended Thinking) |
OpenAI o1 |
OpenAI o3-mini (high) |
DeepSeek R1 |
Grok 3 Beta |
|
GPQA Diamond (Ragionamento a livello graduate) |
68.0% |
84.8% |
78.0% |
79.7% |
71.5% |
84.6% |
|
AIME 2024 (Gara di matematica per licei) |
23.3% |
80.0% |
83.3% |
87.3% |
79.8% |
93.3% |
|
Risoluzione di problemi matematici (MATH 500) |
82.2% |
96.2% |
96.4% |
97.9% |
97.3% |
- |
Il benchmark AIME 2024, che testa problemi di gare di matematica a livello liceale, mostra una tendenza simile. Claude 3.7 Sonnet fa un enorme salto rispetto alle versioni precedenti, ottenendo l’80,0% con l’extended thinking attivato. Pur superando di poco DeepSeek-R1 (79,8%), resta dietro a o3-mini di OpenAI (87,3%) e a Grok 3 Beta (93,3%).
Nella risoluzione di problemi matematici (MATH 500), Claude 3.7 Sonnet raggiunge il 96,2%, avvicinandosi molto a o3-mini di OpenAI (97,9%) e a DeepSeek R1 (97,3%).
Claude 3.7 Sonnet registra i maggiori guadagni nei benchmark di coding. Su SWE-bench Verified (che valuta i modelli di AI su compiti di ingegneria del software), Claude 3.7 Sonnet ottiene il 62,3%, salendo al 70,3% con uno scaffold personalizzato. Questo lo pone ben davanti a o1 (48,9%) e o3-mini (49,3%) di OpenAI, oltre che a DeepSeek R1 (49,2%), progettato proprio con il coding in mente. Questo conferma che Claude 3.7 è ora uno dei migliori modelli per i compiti legati alla programmazione.
|
Benchmark |
Claude 3.7 Sonnet (Standard) |
Claude 3.7 Sonnet (Custom Scaffold) |
OpenAI o1 |
OpenAI o3-mini (high) |
DeepSeek R1 |
|
SWE-bench Verified (Coding) |
62.3% |
70.3% |
48.9% |
49.3% |
49.2% |
|
TAU-bench Retail (Uso di strumenti) |
81.2% |
- |
73.5% |
- |
- |
|
TAU-bench Airline (Uso di strumenti) |
58.4% |
- |
54.2% |
- |
- |
Oltre al coding, Claude 3.7 Sonnet è in testa nell’uso agentico degli strumenti, il che lo rende una scelta solida per automazione ed esecuzione di workflow. Su TAU-bench (che testa la capacità dell’AI di interagire con strumenti esterni in ambienti strutturati), Claude 3.7 ottiene l’81,2% nei compiti legati al retail, superando OpenAI o1 (73,5%). Nei compiti legati alle compagnie aeree, Claude 3.7 raggiunge il 58,4%, superando ancora OpenAI o1 (54,2%).
Questo suggerisce che Claude 3.7 sia adatto ad applicazioni business e workflow strutturati, rappresentando una scelta valida per le aziende che vogliono integrare l’AI nei propri processi decisionali e operativi.
Claude 3.7 Sonnet è disponibile tramite più canali, tra cui l’interfaccia web di Anthropic, l’integrazione di Claude in varie app e l’accesso API per gli sviluppatori. Sebbene il modello rappresenti un aggiornamento importante, la sua disponibilità presenta alcune limitazioni—soprattutto se vuoi usare la Thinking Mode, attualmente bloccata dietro un piano a pagamento.
Per gli utenti generici, Claude 3.7 Sonnet è accessibile tramite il sito ufficiale di Anthropic (claude.ai) e l’app di Claude. È disponibile nel piano gratuito, ma con limitazioni:
Per abilitare la Thinking Mode, devi cliccare su Extended dal menu a discesa del modello:
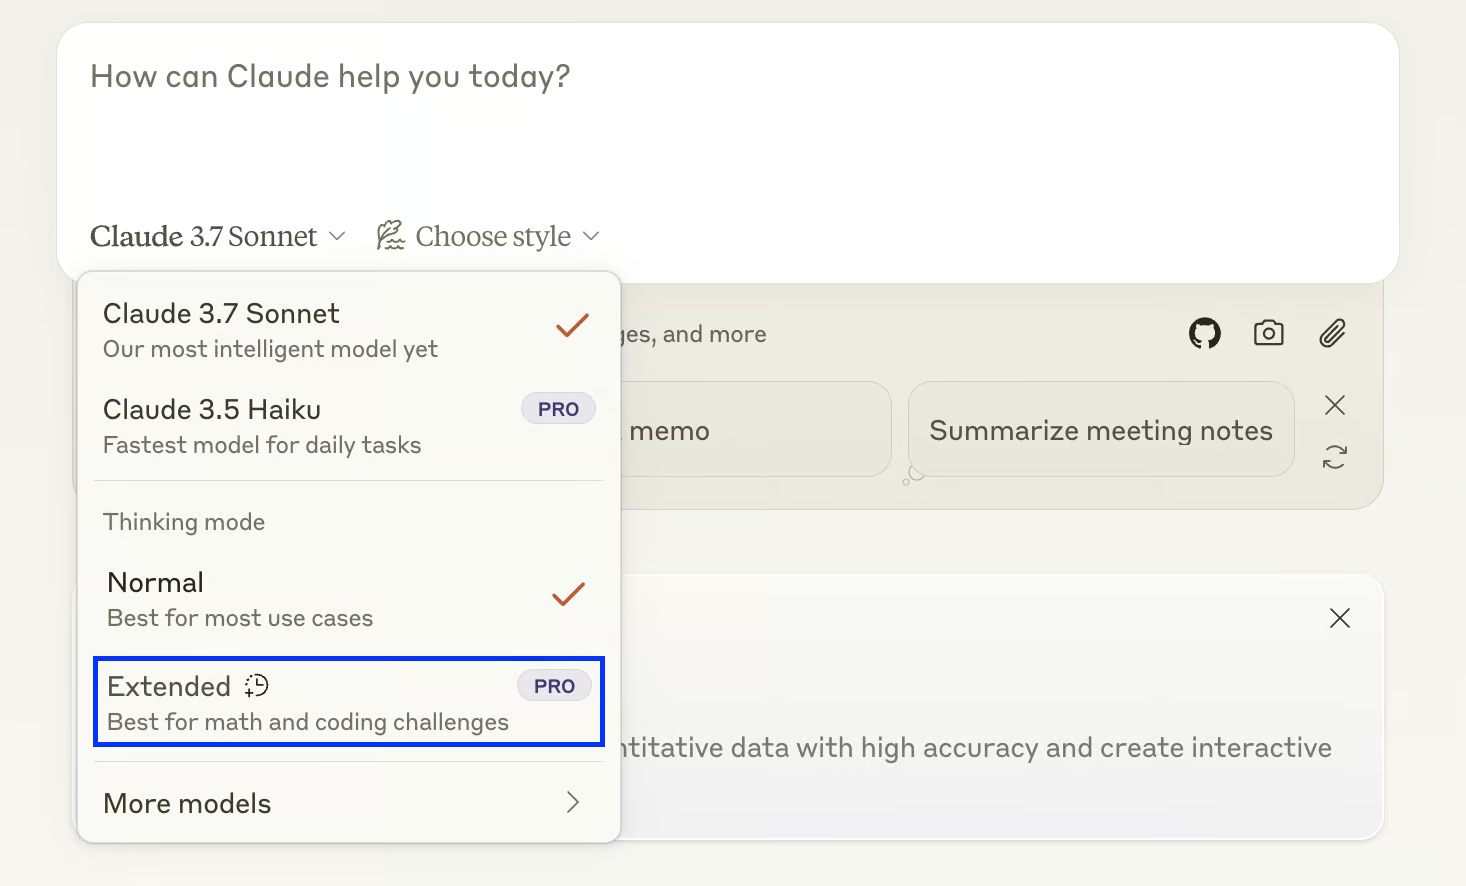
Gli sviluppatori possono integrare Claude 3.7 Sonnet nelle proprie applicazioni tramite l’API di Anthropic, accessibile dal portale sviluppatori di Anthropic. L’API prevede un modello di prezzo a consumo basato sui token.
Ecco una panoramica delle offerte API di Anthropic:
|
Funzionalità |
Claude 3.7 Sonnet |
Claude 3.5 Sonnet |
Claude 3.5 Haiku |
Claude 3 Opus |
Claude 3 Haiku |
|
Descrizione |
Il nostro modello più intelligente |
Il nostro precedente modello più intelligente |
Il nostro modello più veloce |
Modello potente per compiti complessi |
Il modello più veloce e compatto per una reattività quasi istantanea |
|
Punti di forza |
Massimo livello di intelligenza e capacità con extended thinking attivabile |
Alto livello di intelligenza e capacità |
Intelligenza a velocità elevatissime |
Intelligenza, fluidità e comprensione di primo livello |
Prestazioni mirate rapide e accurate |
|
Multilingue |
Sì |
Sì |
Sì |
Sì |
Sì |
|
Visione |
Sì |
Sì |
Sì |
Sì |
Sì |
|
Sì |
No |
No |
No |
No |
|
|
Nome modello API |
claude-3-7-sonnet-20250219 |
Versione aggiornata: claude-3-5-sonnet-20241022 Versione precedente: claude-3-5-sonnet-20240620 |
claude-3-5-haiku-20241022 |
claude-3-opus-20240229 |
claude-3-haiku-20240307 |
|
Latenza comparativa |
Veloce |
Veloce |
La più veloce |
Moderatamente veloce |
La più veloce |
|
Finestra di contesto |
200K |
200K |
200K |
200K |
200K |
|
Output massimo |
Normale: 8192 token Extended thinking:64000 token |
8192 token |
8192 token |
4096 token |
4096 token |
|
Costo (Input / Output per MTok) |
$3.00 / $15.00 |
$3.00 / $15.00 |
$0.80 / $4.00 |
$15.00 / $75.00 |
$0.25 / $1.25 |
|
Cut-off dei dati di training |
Ott 2024 |
Apr 2024 |
Lug 2024 |
Ago 2023 |
Ago 2023 |
Fonte: Anthropic
Ricorda di controllare sempre i prezzi API più recenti.
Anthropic ha appena compiuto la sua mossa più importante da tempo con Claude 3.7 Sonnet, un modello che la porta finalmente nello spazio dell’AI di ragionamento. In base ai benchmark, vediamo che è un concorrente legittimo di o3-mini di OpenAI, DeepSeek-R1 e Grok 3, con ottime prestazioni nel coding, nel problem solving strutturato e nell’uso agentico degli strumenti.
La possibilità di passare tra modalità generalista e di ragionamento lo rende più versatile, ma bloccare la Thinking Mode dietro un paywall sembra un passo falso, soprattutto con alternative gratuite disponibili. Resta comunque un grande passo avanti per Claude 3.7.
Pronto per il passo successivo? Guarda il nostro video sull’API di Claude 3.7 Sonnet in cui ti mostreremo come costruire il tuo assistente di ricerca multimodale.
Impara l’AI con questi corsi!
Programma
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



