
Corso
Introduzione ai modelli Claude
3 ore
14.9K
GPT-6 Astra è il modello di punta di frontiera di OpenAI, successore di GPT-5.6 Sol, ed è costruito attorno all’esecuzione agentica più che alla chat. OpenAI lo colloca su uso del computer, lavoro professionale e ingegneria del software, ed è il primo modello OpenAI a superare la soglia "Critical" in cybersecurity nel Preparedness Framework dell’azienda. Offre una finestra di contesto da 1.050.000 token con output massimo 128K e un cutoff della conoscenza al 30 aprile 2026.
Due aspetti spiccano nell’annuncio. In Codex, Astra mantiene appunti tra finestre di contesto invece di comprimerli in un riassunto, così le finestre precedenti restano ricercabili, e decide quando porre una domanda di chiarimento invece di indovinare sempre o chiedere sempre.
Per l’elenco completo delle funzioni, le tabelle dei benchmark e i dettagli di accesso, vedi la nostra guida a GPT-6 Astra. Vale anche la pena leggerla insieme alla nostra copertura del suo predecessore in GPT-5.6 Sol, Terra e Luna.
Claude Fable 5.1 è il modello di frontiera generalmente disponibile di Anthropic per ragionamento impegnativo e lavoro agentico a lungo orizzonte. Ha una finestra di contesto da 1M token con output massimo 128K, pensiero adattivo sempre attivo e un cutoff della conoscenza a giugno 2026. La documentazione di Anthropic indica una latenza più lenta rispetto a Claude Opus 5 e Claude Sonnet 5, entrambi con prezzo inferiore.
Claude Mythos 5.1 è lo stesso modello con salvaguardie diverse, disponibile su invito tramite Project Glasswing. La novità per tutti gli altri è il prezzo delle letture da cache, ridotto del 75% a $0,25 per milione di token, mentre i prezzi di listino restano invariati.
La nostra guida a Claude Fable 5.1 contiene l’analisi completa dei benchmark, e il nostro tutorial sull’API di Claude Fable 5.1 costruisce con esso un agente per sviluppatori consapevole del repository, inclusa un’analisi reale dei costi ai vari livelli di sforzo.
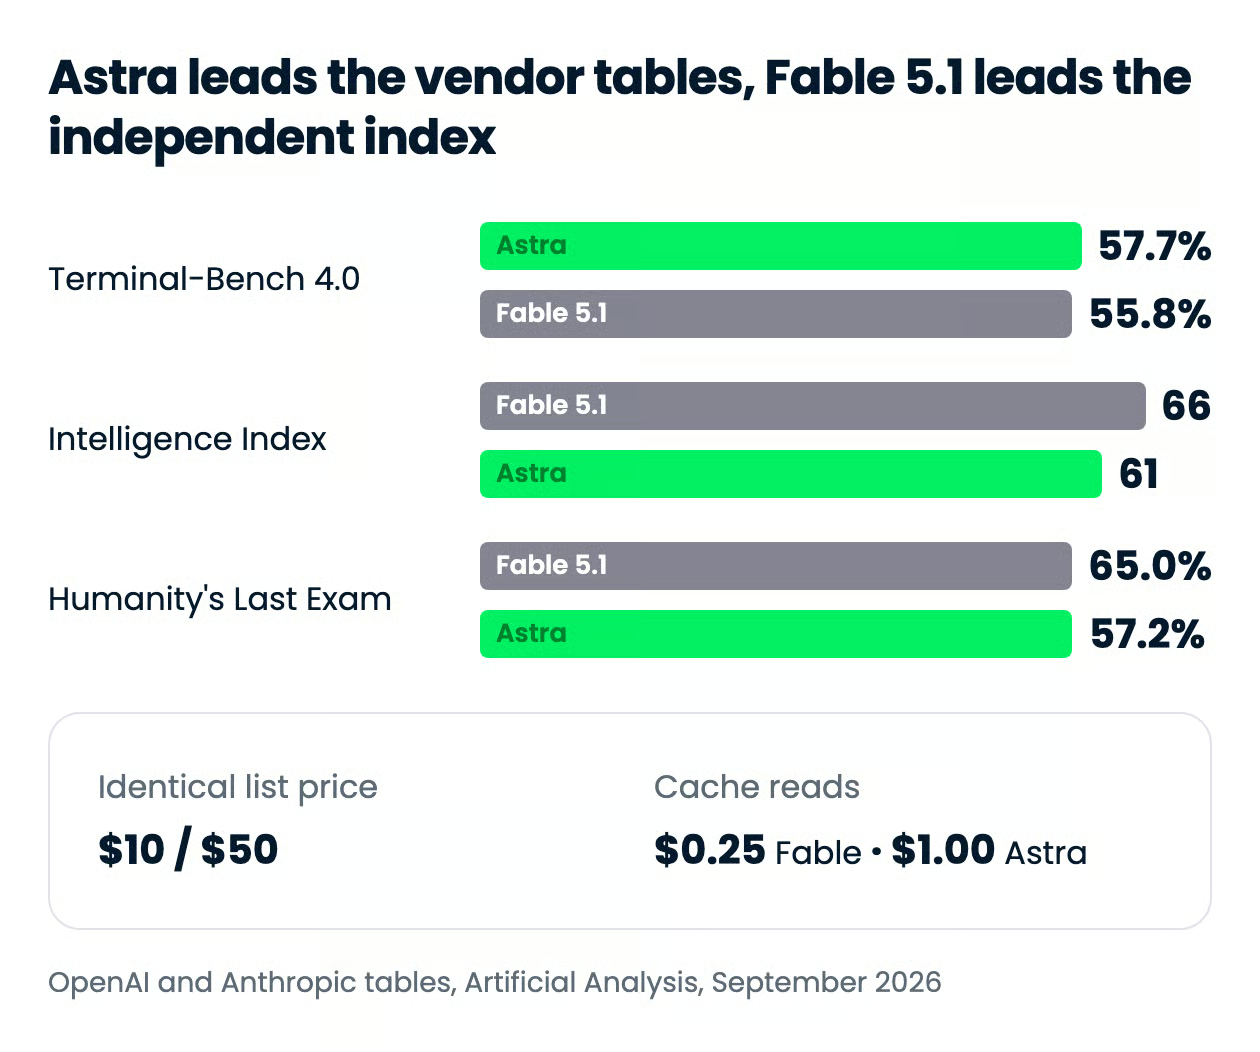
La versione breve: la tabella comparativa di OpenAI mostra Astra davanti a Fable 5.1 su quasi ogni riga pubblicata, mentre Artificial Analysis mostra il contrario su entrambi i suoi indici. A quale credere dipende da quanto peso dai a un vendor che valuta il proprio concorrente.
| Funzione | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Data di rilascio | 3 settembre 2026 | 1 settembre 2026 |
| ID modello API | gpt-6-astra |
claude-fable-5-1 |
| Finestra di contesto | 1,05M token | 1M token |
| Output massimo | 128K token | 128K token |
| Cutoff della conoscenza | 30 aprile 2026 | Giugno 2026 |
| Prezzo di listino per 1M token | $10 in / $50 out | $10 in / $50 out |
| Lettura input in cache per 1M | $1,00 ($2,00 oltre 272K) | $0,25 |
| Tariffe oltre 272K token in input | 2x input e cache, 1,5x output | Nessun sovrapprezzo |
| FrontierMath Tier 4 (v2) | 97,6% | 87,8% |
| Humanity's Last Exam, con tool | 57,2% | 65,0% |
| ScreenSpot-Pro (senza tool) | 92,7% | 87,3% (Fable 5, da Mythos) |
| AutomationBench | 41,4% | 31,4% |
| ExploitBench | 100% | 70% |
| AA Intelligence Index (sforzo max) | 61 | 66 |
| Costo AA per task Intelligence Index (max) | $1,67 | $3,76 |
| Area di forza | Uso del computer, matematica, cybersecurity, costo per task | Profondità di ragionamento, loop agentici dominati dalla cache |
Astra è in testa sui benchmark di coding che OpenAI ha scelto di pubblicare, ma i margini sono sottili e l’indice indipendente non concorda. Su Terminal-Bench 4.0, che testa ingegneria del software, configurazione di sistema e analisi dati in un terminale, OpenAI riporta 57,7% per Astra contro 55,8% per Fable 5.1. Anthropic pubblica lo stesso 55,8%, quindi almeno quella riga è incontestata.
Il divario si allarga su DeepSWE v1.1, dove Astra arriva al 74,1% contro 67,4%, e si riduce quasi del tutto su FrontierCode 1.1 Main, dove 53,3% contro 50,9% rientra nell’intervallo già occupato da Claude Fable 5 (53,5%) e Claude Opus 5 (53,4%).
| Benchmark | GPT-6 Astra | Claude Fable 5.1 | Note |
|---|---|---|---|
| Terminal-Bench 4.0 | 57,7% | 55,8% | La tabella di OpenAI indica 57,7% mentre la didascalia del grafico dice 57,9% |
| DeepSWE v1.1 | 74,1% | 67,4% | Dato riportato da OpenAI |
| FrontierCode 1.1 Main | 53,3% | 50,9% | Praticamente in parità con Fable 5 al 53,5% e Opus 5 al 53,4% |
| Migrazione database interna | 63,9% | 57,8% | Valutazione interna OpenAI, senza replica esterna |
| CursorBench 3.2.0 | Non pubblicato | 73,4% | Dato Anthropic; SpaceXAI ha confermato 73,4% a sforzo massimo |
| AA Coding Agent Index | 67 in Codex | 70 in Claude Code | Indipendente, ma con harness diversi |
L’ultima riga è quella a cui continuo a tornare. Artificial Analysis colloca Fable 5.1 in Claude Code a 70, il punteggio più alto sul suo Coding Agent Index, e Astra in Codex a 67, più o meno al livello di Claude Opus 5 e Claude Fable 5. Due caveat da prendere con le pinze:
Astra vince di misura le righe pubblicate sul coding e vince nettamente sull’efficienza, mentre Fable 5.1 detiene l’unico punteggio indipendente di agenti di coding che li supera entrambi.
Questa è la divisione più netta dell’intero confronto, e va in entrambe le direzioni. Astra prende le righe di matematica e scienza: 97,6% contro 87,8% su FrontierMath Tier 4 v2, 96,0% contro 93,7% su GPQA Diamond e 64,6% contro 52,6% su Terminal-Bench Science 0.1, il benchmark di ricerca agentica su cui Anthropic aveva impostato il proprio lancio.
Fable 5.1 si prende Humanity’s Last Exam con tool, 65,0% contro 57,2%, e non è una sfida ravvicinata. Artificial Analysis conferma indipendentemente la direzione del risultato, assegnando a Fable 5.1 un 66 sul suo Intelligence Index contro 61 per Astra, il punteggio più alto mai misurato.
Un caveat su quel 66. Artificial Analysis ha eseguito Fable 5.1 con il fallback lato server predefinito di Anthropic, che instrada le richieste segnalate come rischiose verso Claude Opus 4.8 o Claude Opus 5, e il fallback ha servito circa il 4% dei token in output sull’indice. Il punteggio è di Fable 5.1 come la maggior parte degli utenti lo chiamerà effettivamente, non del modello grezzo in isolamento.
Se il tuo lavoro è matematica o scienze fisiche a livello avanzato, Astra. Se è quel tipo di ragionamento ampio e difficile che Humanity’s Last Exam esplora, Fable 5.1.
Astra domina questa dimensione, soprattutto perché Anthropic non ha pubblicato numeri comparabili. OpenAI riporta 72,6% per Astra sul set offline di OSWorld 2.0 contro 70,2% per Claude Opus 5, e 92,7% su ScreenSpot-Pro contro 87,3% per Claude Fable 5. Le cifre di Anthropic per Fable 5.1, 77,9% partial e 41,7% strict, provengono da un rilascio di task e un setup di valutazione diversi.
I numeri sugli artefatti sono meno ambigui: 95,9% su BenchCAD contro 84,3%, e 41,4% contro 31,4% su AutomationBench.
Per agenti che cliccano software reale e producono slide o output CAD, Astra è la scelta più solida.
I numeri sull’allineamento di Astra sono l’aspetto più sottovalutato del lancio. Sull’indicatore interno di OpenAI per la sicurezza d’uso del computer, dove più basso è meglio, ottiene il 2,4% contro il 9,5% di Fable 5.1.
In cybersecurity è su un altro livello: 100% su ExploitBench e 86 sfide FrontierCyber risolte su 226 contro 34 per GPT-5.6 Sol nei test indipendenti di Irregular. Anthropic ha allentato Fable 5.1 a sufficienza per trovare vulnerabilità ma non per sfruttarle.
Due caveat, entrambi da prendere con le pinze:
Astra è sia l’agente più sicuro sia l’attaccante più capace, da cui le barriere all’accesso.
Le tariffe di listino sono identiche, quindi sul listino, l’unica differenza tra questi due modelli deriva da caching e contesto lungo. Questo quadro regge solo se entrambi i modelli usano lo stesso numero di token sullo stesso task, e non è così, ed è per questo che i valori misurati per task qui sotto contano più del listino.
| Tariffa | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Input, per 1M token | $10,00 | $10,00 |
| Output, per 1M token | $50,00 | $50,00 |
| Lettura input in cache, per 1M token | $1,00 | $0,25 |
| Scrittura cache (5 minuti), per 1M token | $12,50 | $12,50 |
| Sconto batch | 50% | 50% |
| Tariffe oltre 272K token in input | $20,00 in / $2,00 cache / $75,00 out | Nessun sovrapprezzo |
Input, output, scritture in cache e sconto batch coincidono al centesimo. La riga sulle letture da cache è l’eccezione, ed è un divario di 4x: Anthropic porta le letture da cache di Fable 5.1 a $0,25, mentre OpenAI prezza quelle di Astra a $1,00, uno sconto del 90% sulla tariffa di input.
Oltre 272K token in input, il divario sale a 8x, perché il sovrapprezzo di OpenAI raddoppia le letture da cache a $2,00 insieme all’input, mentre la documentazione prezzi di Anthropic mantiene l’intera finestra da 1M token a tariffe standard. Nota quanto sia basso tale soglia rispetto a quanto pubblicizza Astra: 272K è circa un quarto della sua finestra da 1,05M, quindi qualsiasi richiesta che usi più di un quarto del contesto fornito viene fatturata al livello superiore.
Le letture da cache sono la tariffa che si compone su un loop lungo, perché un agente rimanda lo stesso prompt di sistema, le definizioni degli strumenti e il contesto del repository a ogni turno. La nostra guida al prompt caching spiega la distinzione tra scrittura e lettura della cache, se ti è nuova.
Tutto in questa tabella è aritmetica a tariffa di listino su una forma fissa di token, non un risultato misurato. Risponde alla domanda “se entrambi i modelli usassero token identici, quanto addebiterebbe il listino?” La sezione successiva risponde a quanto spendono davvero.
| Workload | GPT-6 Astra | Claude Fable 5.1 | Differenza |
|---|---|---|---|
| Assistente bilanciato: 1M in / 250K out | $22,50 | $22,50 | $0, 0% |
| Retrieval, sotto soglia: 10M in / 1M out | $150 | $150 | $0, 0% |
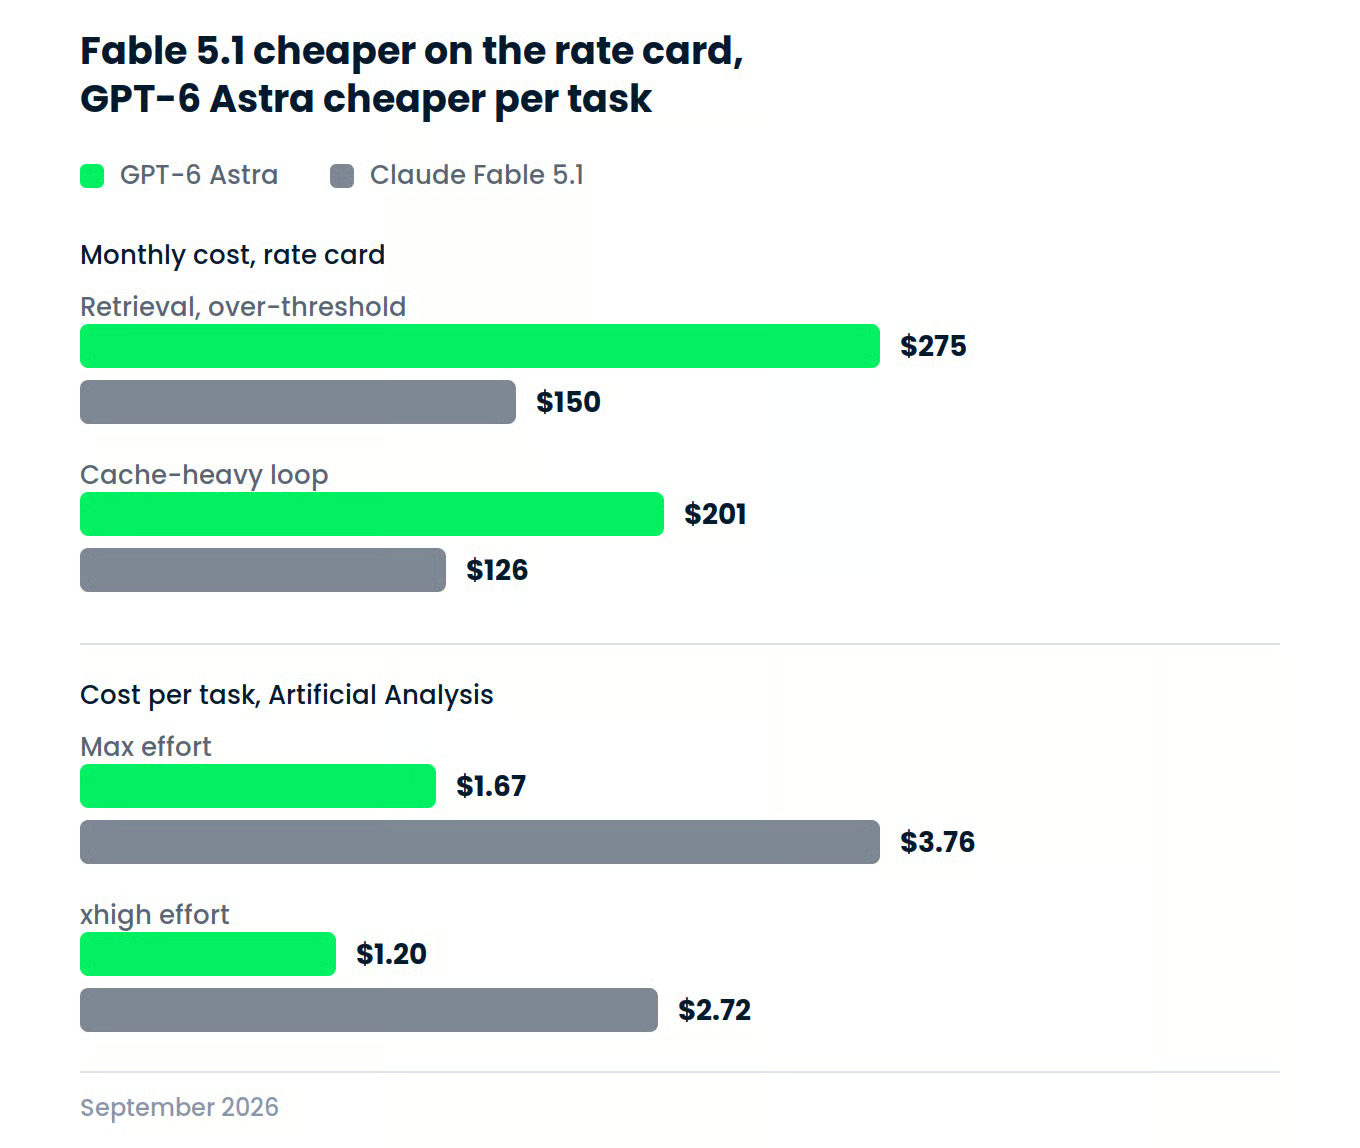
| Retrieval, oltre soglia: 10M in / 1M out | $275 | $150 | $125, 83% in più per Astra |
| Loop dominato dalla cache: prefisso 100K, 1.000 letture | $201 | $126 | $75, 59% in più per Astra |
La formula è la stessa per ogni riga: (volume ÷ 1M) × tariffa, sommata tra input fresco, letture da cache, scritture in cache e output. La riga sul loop pesante di cache assume un prefisso da 100K scritto una volta e riletto 1.000 volte, più 5K di input fresco e 1K di output per richiesta.
La riga sul retrieval oltre soglia è il punto chiave. Mantieni ogni richiesta sotto 272K token in input, e i due modelli costano esattamente gli stessi $150. Spingi gli stessi 10M token in richieste che superano ciascuna i 272K, e Astra sale a $275 mentre Fable 5.1 resta a $150, perché Anthropic prezza l’intera finestra da 1M token a tariffe standard.
Il loop pesante di cache è quello che incontrerà la maggior parte dei lettori. A 1.000 letture in cache di un prefisso da 100K, il divario di $0,75 per milione di token in cache si trasforma in $75 di differenza su un carico altrimenti identico. Nota però la forma di quel carico: è volutamente leggero in output, 1K token di output per richiesta contro 100K letture da cache. Questa è l’unica forma in cui il vantaggio di Fable 5.1 sulla cache decide la fattura.
Quando misuri il consumo reale di token invece di assumerlo, il quadro si ribalta. Artificial Analysis prezza ogni modello per task dell’Intelligence Index, e il suo metodo include già token di input, hit di cache, scrittura in cache, ragionamento e risposta, quindi la cache più economica di Fable 5.1 è già inclusa nel numero.
| Livello di sforzo | GPT-6 Astra: punteggio/costo per task | Claude Fable 5.1: punteggio/costo per task |
|---|---|---|
| max | 61 / $1,67 | 66 / $3,76 |
| xhigh | 61 / $1,20 | 65 / $2,72 |
A sforzo massimo, Fable 5.1 costa 2,25 volte Astra per lo stesso set di task allo stesso prezzo di listino. Artificial Analysis arriva alla stessa conclusione sul suo indice di coding, dove Astra eguaglia Fable 5 “a meno della metà del costo, grazie a notevoli guadagni di efficienza nei token”. L’intervallo di Astra scende fino a $0,46 per task a sforzo basso.
Qui Fable 5.1 non viene penalizzato dal listino, ma dal volume di output. Artificial Analysis ha misurato che usa circa 1,7x i token di output di Fable 5 a sforzo massimo, motivo per cui costa il 20% in più per task rispetto al suo predecessore nonostante il taglio alla cache. Senza il taglio, la cifra sarebbe circa $5,16, quindi lo sconto incide davvero, ma non abbastanza.
Stai pagando quel sovrapprezzo per qualcosa. Fable 5.1 ottiene 5 punti in più sullo stesso indice, e 4 punti in più a xhigh. Se 5 punti valgano 2,25x lo decidi tu, non io, ma la versione di questo confronto in cui prezzi di listino identici significano fatture identiche non regge al confronto con le misurazioni.
Le stesse didascalie di OpenAI puntano nella stessa direzione, per quel che vale un’autovalutazione del vendor. Stima il costo API per task di Astra circa il 31% sotto Fable 5.1 su Terminal-Bench Science 0.1, circa il 63% sotto su Terminal-Bench 4.0 e circa l’86% sotto su BenchCAD, misurati ai livelli di sforzo scelti da OpenAI per ciascun modello.
Astra ha vinto di poco il nostro test complessivo, anche se entrambi i modelli hanno consegnato una simulazione funzionante al primo tentativo.
Ho eseguito un compito difficile contro entrambi i modelli in condizioni identiche invece di diversi compiti superficiali. Il test scelto è una simulazione fisica da zero costruita come singolo file HTML, scelta perché sonda esattamente ciò che entrambi i vendor sostengono di aver migliorato: correttezza sostenuta lungo un build lungo, senza librerie di supporto.
Questa istanza è una versione aggiornata del test. La variante pubblicata usava un contenitore quadrato rotante, quindi questa esecuzione inserisce un esagono rotante con un ostacolo centrale contro-rotante e una massa proporzionale alle dimensioni, che aumenta la difficoltà mantenendo il contenimento un pass/fail inequivocabile. Ecco il prompt, incollato alla lettera in una chat nuova per ciascun modello:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Entrambi i modelli girano a sforzo di ragionamento alto, un tentativo ciascuno senza retry, nello stesso agente di coding con gli stessi strumenti. Il punteggio è un controllo pass/fail di eseguibilità, poi una rubrica da 1 a 5 su correttezza fisica, stabilità per 30 secondi e qualità visiva.
Astra ha superato il controllo di eseguibilità e ha ottenuto 5/5 su tutti e tre gli assi della rubrica. Ci è arrivato in 6 turni e 9 chiamate di tool, e il mix di tool è la parte interessante: ha scritto il file, lo ha riletto 5 volte, ha fatto due grep e due patch prima di dichiararlo pronto.
La simulazione è corretta. 44 sfere, massa scalata con l’area, contenimento mantenuto per tutti i 30 secondi mentre l’esagono ruota. Astra ha dimensionato l’ostacolo interno grande rispetto alla camera, così le sfere continuano a collidere con esso invece di stabilizzarsi in un punto che non può raggiungere.
Ha anche costruito un’intera pagina editoriale attorno alla simulazione, con un titolo serif, etichette monospace spaziolate e un pannello di telemetria che riporta in tempo reale le velocità di rotazione. Nessuno l’aveva chiesto, ma a mio avviso è venuto molto bene. Ha consegnato anche i controlli pausa e riavvio, non richiesti dal prompt, ma che hanno reso l’artefatto più facile da ispezionare.
Astra fa ruotare la camera a 0,09 rad/s e l’ostacolo a -0,16 rad/s, circa 3 volte più lentamente di Fable sul muro esterno e 5 volte più lentamente sull’ostacolo. Più facile da guardare, e un test più morbido del bordo in movimento rispetto a una rotazione più rapida. Dato che il prompt chiede un contenitore che ruota lentamente, va bene così.
| Misura | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Turni | 6 | 2 |
| Chiamate di tool | 9 | 1 |
| Eseguibilità | Pass | Pass |
| Correttezza fisica | 5 | 4 |
| Stabilità nel tempo | 5 | 5 |
| Qualità visiva | 5 | 4 |
| Punteggio rubrica | 5,0 | 4,3 |
Astra vince per qualità, e il margine è più ampio sulla presentazione che sulla fisica. Dove si separano è su cosa ciascun modello ha deciso fosse il lavoro. Astra ha letto il prompt come un brief da interpretare, aggiungendo controlli, un layout editoriale completo e una rotazione più lenta adatta alla visione. Fable l’ha letto come una specifica da soddisfare, l’ha soddisfatta in una sola scrittura e ha speso lo sforzo rimanente in un HUD diagnostico.
Questa è una singola esecuzione per modello, quindi trattala come un dato singolo, non come un benchmark. Riporta i turni, non i token o il costo, e sonda solo codice di simulazione da zero, non le dimensioni di uso del computer o ragionamento coperte sopra.
Poiché le tariffe di listino coincidono, la decisione dipende dalla forma del carico, dal consumo misurato di token e dall’agente di coding che già usi. I tre numeri che dovrebbero muoverti sono il gap 4x sulle letture da cache, la soglia del sovrapprezzo a 272K e il costo misurato per task di 2,25x.
| Superficie | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| App consumer | ChatGPT Plus, Pro, Business, Enterprise | Claude web, mobile, desktop (Pro, Max, Team, Enterprise) |
| API proprietaria | OpenAI API | Claude API |
| Piattaforme cloud | Amazon Bedrock, Microsoft Azure/Foundry | Amazon Bedrock, Google Cloud, Microsoft Azure/Foundry |
| Agenti di coding | Codex | Claude Code, Cursor |
| Router di terze parti | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID modello API | gpt-6-astra |
claude-fable-5-1 |
Due dettagli di accesso ti fermeranno prima della prima chiamata. Astra è disattivato di default per gli spazi Enterprise finché un amministratore non lo abilita, e Fable 5.1 richiede conservazione dei dati a 30 giorni e non è supportato su Priority Tier. La copertura cloud è quasi alla pari, con Google Cloud attualmente unica piattaforma che ha Fable 5.1 e non GPT-6 Astra.
Ogni modello è nativo del proprio harness, Astra in Codex e Fable 5.1 in Claude Code, dove passi con /model claude-fable-5-1 o il flag --model. Tramite API lo scambio è una stringa, anche se gli SDK differiscono.
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
Tre cambiamenti in Fable 5.1 romperanno codice scritto per Fable 5: la selezione forzata dei tool ora restituisce un 400, i modelli precedenti non possono leggere i blocchi di thinking e i blocchi di thinking sono vincolati all’esatta cronologia precedente. Il nostro tutorial sull’API di Claude Fable 5.1 tratta tutti e tre i punti, e la nostra guida per principianti all’API di OpenAI copre l’equivalente dall’altra parte.
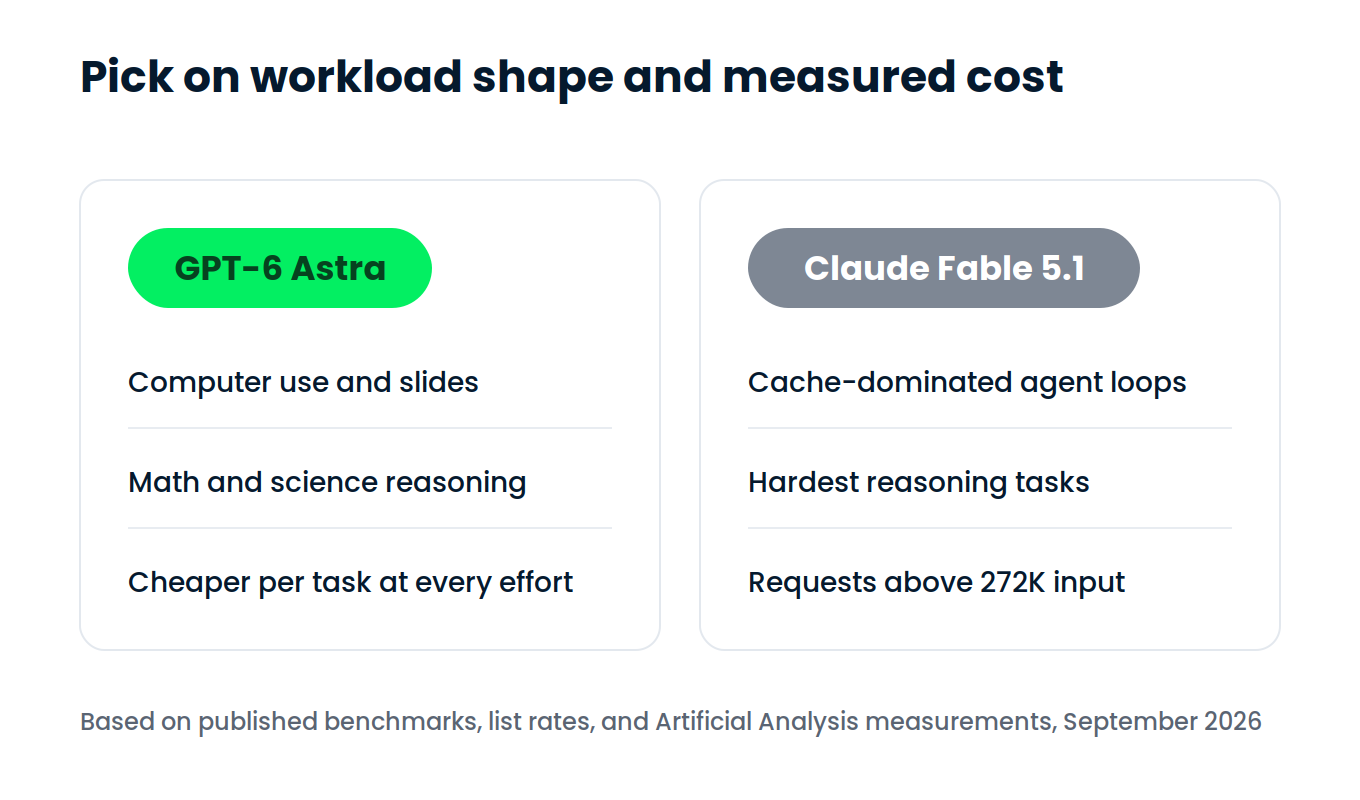
Scegli in base alla forma del carico e al costo misurato, non alle tabelle dei benchmark. GPT-6 Astra è più forte per agenti che cliccano attraverso software, fanno matematica o producono artefatti pronti per il cliente, e sembra il più economico per task nonostante il listino identico. Claude Fable 5.1 ti dà il miglior punteggio indipendente di ragionamento disponibile e costa meno su richieste molto grandi e su loop dominati dalla cache.
Il listino è la trappola in questo confronto. Due modelli a $10 e $50 sembrano intercambiabili sul prezzo, e l’unico divario visibile, le letture da cache, favorisce Anthropic di 4x. Poi misuri quanto ciascuno spende davvero per finire un task, e Astra arriva al 44% del costo di Fable 5.1. Non l’avrei previsto dalle pagine prezzi, ed è l’unica cosa che verificherei sul tuo traffico prima di decidere.
Se vuoi lavorare con uno dei due modelli invece di leggerne, ti consiglio il nostro corso Introduzione ai modelli Claude per il lato Anthropic e Lavorare con l’API di OpenAI per il lato OpenAI.
Impara l’IA con DataCamp!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



