Vai al contenuto principale

Sviluppo software con Devin: sicurezza, deployment, manutenzione (Parte 4)

Scopri come usare Devin per aggiungere l’autenticazione reale degli utenti con NextAuth, monitorare gli errori con Sentry e distribuire il frontend su Vercel con URL di anteprima.
Aggiornato 29 set 2026  · 12 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Bentornato! Ci siamo quasi: Slack cinguetta, Jira ha ticket, i test sono verdi e la nostra CI blocca ogni PR raffazzonata. La parte quattro è l’ultimo sprint in cui trasformeremo il playground di fp-ts in qualcosa che potremmo, in teoria, mostrare al pubblico.

Puoi accedere a tutti i tutorial della serie su Devin qui:

  1. Setup e prima pull request (Parte 1)
  2. Consegna di una vertical slice con Devin (Parte 2)
  3. Integrazioni, test e CI/CD (Parte 3) 
  4. Sicurezza, deployment, manutenzione (Parte 4)

Ecco il piano per questo quarto tutorial:

  • Auth: basta UUID anonimi; inseriremo le credenziali NextAuth, cookie JWT e un GqlAuthGuard così i progressi sono legati a utenti reali.
  • Occhi sulla produzione: una riga di codice Sentry nella web app, una nella Nest API, e ogni eccezione finisce in dashboard.
  • Deploy con un pulsante: il front-end va live su Vercel con URL di anteprima su ogni PR. (L’API rimarrà in locale per ora, simuleremo la prod con Docker.)

Rifletteremo anche su questo pair programming con Devin per capire dove brilla e dove un umano deve ancora sistemare le ultime cose prima che il mondo veda il repo. Pronto per l’ultimo tratto?

Da UUID anonimo a utenti reali

Cosa ho chiesto a Devin

In breve, ho chiesto a Devin di eliminare il flusso con UUID anonimi e di fornirmi uno stack auth reale:

  • NextAuth v6 credentials provider in apps/web
  • NestJS AuthModule con hashing Argon2 e cookie JWT
  • Migrazione Prisma che aggiunge una tabella User e cambia Progress.sessionId → userId (non nullo)
  • Copiare eventuali righe di progresso con UUID esistenti su un utente segnaposto così gli studenti mantengono i badge
  • Non passare da Postgres a SQLite

Cosa è tornato (quasi tutto bene)

Ecco un riepilogo dei risultati:

Layer

Output di Devin

Database

Rimossa la tabella Session; aggiunto un modello User con campi email, hash, streak e timestamp. Lo script di migrazione ha retrocompilato ogni vecchia riga sessionId in un pseudo-utente chiamato legacy-<uuid>@anon.local.

Backend

AuthModule, AuthService, GraphQL AuthResolver, JwtStrategy e un GqlAuthGuard. Tutto in stile Nest, 100% tipizzato.

Frontend

AuthProvider React context, LoginForm, RegisterForm, una modale che si apre sulle route protette e un pulsante di logout nell’header della dashboard.

Sicurezza

Argon2 (12 round), validazione DTO via class-validator, JWT salvati in localStorage, guard su ogni resolver dei progressi.

Test

Unit test per AuthService.register/login e un test e2e di mutation che verifica che il guard rifiuti i token mancanti. (L’ho sollecitato una seconda volta per aggiungere i test)

Un’altra migrazione SQLite

Indovina cosa ho visto ricomparire nella finestrella dei pensieri di Devin.

Migrazione riuscita da PostgreSQL a SQLite per lo sviluppo locale 🥳

Esattamente ciò che gli avevo detto di non fare. Lo schema Prisma è stato riscritto per SQLite, e sono state cambiate le stringhe di connessione e i tipi (da TIMESTAMP a DATETIME). L’ho colto a metà sessione:

  1. Messa in pausa la sessione.
  2. git checkout main apps/api/prisma/schema.prisma (ripristina lo schema Postgres).
  3. Eliminato il nuovo file dev.db.
  4. npm run prisma:migrate --workspace=apps/api per riapplicare le migrazioni Postgres.
  5. Ripresa la sessione di Devin; ha rilevato il revert e ha proseguito senza obiezioni.

Danni: 0,8 ACU e circa dieci minuti.

Checklist dei breaking change per i compagni di squadra

Apprezzo molto le istruzioni che Devin inserisce nelle PR. Qui ci ha detto di:

# 1  Install new deps
npm install --workspaces

# 2  Run the Postgres migration
npm run prisma:migrate --workspace=apps/api

# 3  Restart everything
npm run dev:api   &   npm run dev:web

Istante dell’architettura

Nella wiki, ho trovato questo utile diagramma del nostro nuovo sistema di autenticazione:
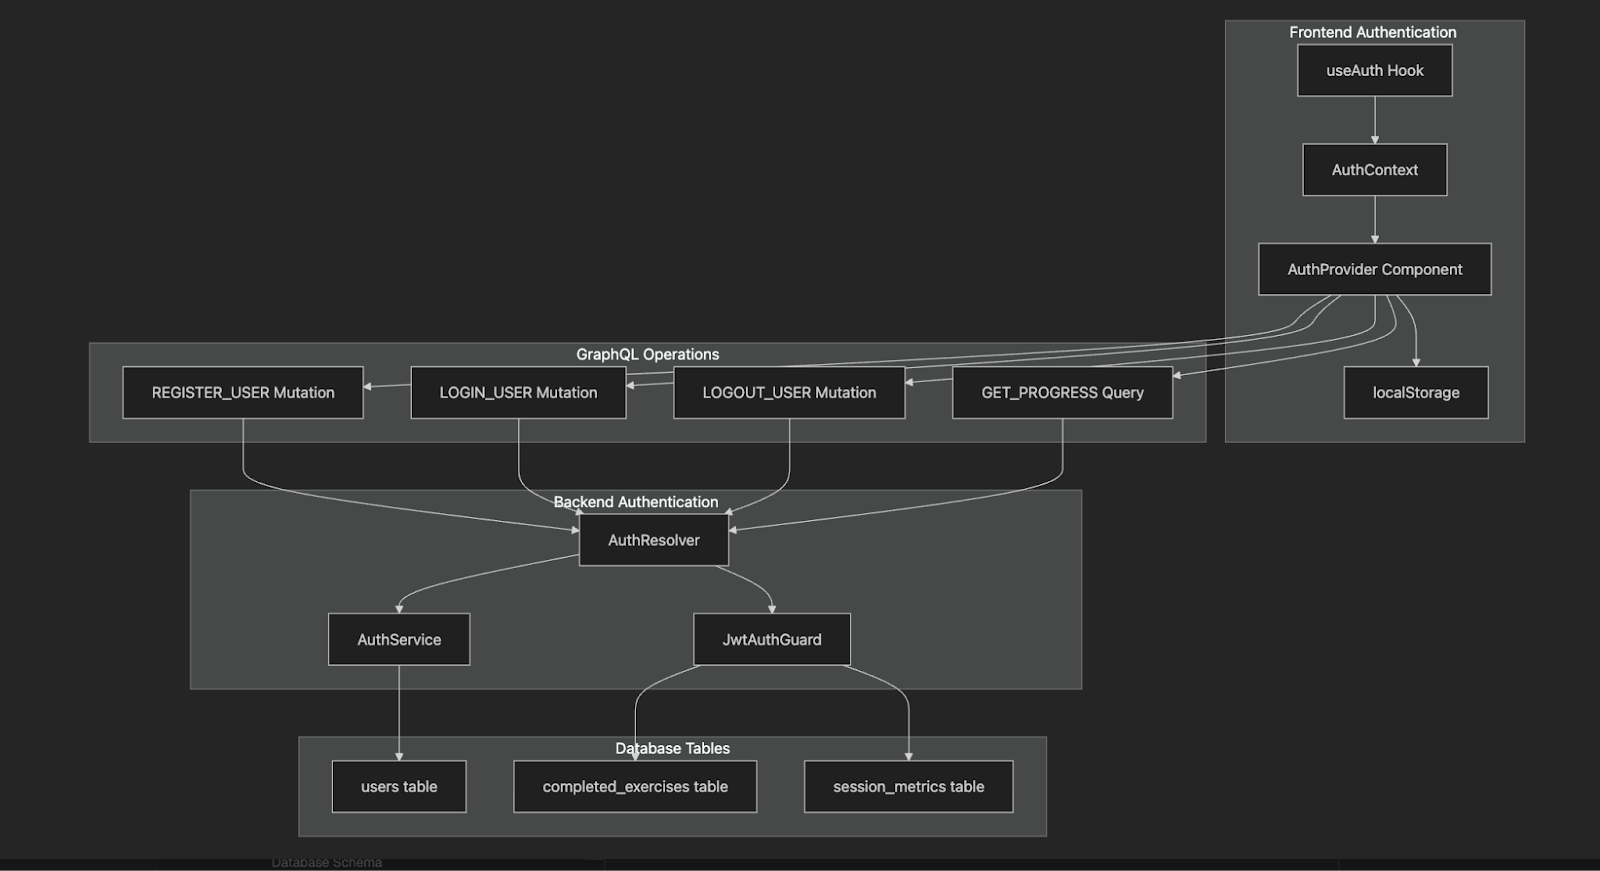
Diagramma di Devin per il nostro nuovo sistema di autenticazione

Con utenti reali in campo e il database saldamente di nuovo su Postgres, siamo finalmente pronti a tracciare i veri progressi degli studenti, pubblicare build di anteprima su Vercel e intercettare gli errori a runtime con Sentry.

Con accessi sicuri a posto, il passo successivo ovvio era mostrare al mondo qualcosa di cliccabile. Abbiamo deciso di distribuire per ora solo il front-end Next.js. API e Postgres resteranno sulla mia macchina locale finché non sceglieremo un host che rientri nel budget.

Collegamento manuale dell’account (0 ACU)

Collegare Devin al mio account personale Vercel tramite integrazioni native non è ancora possibile. Quindi l’ho fatto manualmente, dal dashboard Vercel:

  1. Accesso a Vercel e clic su “New Project → Import Git Repository”.
  2. Selezionato il repo fp-ts-exercises, lasciato il comando di build come npm run build --workspace apps/web, e premuto Deploy.
  3. Copiati i risultanti VERCEL_PROJECT_ID e VERCEL_TOKEN nei GitHub Secrets.

Lasciare che Devin aggiorni il workflow CI (0,4 ACU)

Seguendo il mio prompt, Devin ha aggiunto un singolo job in fondo al workflow esistente e un piccolo step shell che fa curl dell’URL generato su Slack:

- name: Deploy to Vercel
  if: ${{ success() && github.event_name == 'pull_request' }}
  run: npx vercel deploy --prod --token ${{ secrets.VERCEL_TOKEN }}
  env:
    VERCEL_ORG_ID: ${{ secrets.VERCEL_ORG_ID }}
    VERCEL_PROJECT_ID: ${{ secrets.VERCEL_PROJECT_ID }}

Risultato

Push di un branch → CI verde → ping su Slack:

✅ Preview ready: https://fp-ts-exercises-git-my-branch.vercel.app

Aprendo il link, ho visto il nostro playground, l’intero flusso di auth e la dashboard dello studente. Nessuna modifica di ambiente necessaria lato Vercel, perché il front-end parla con la mia API locale su http://localhost:4000.

Uno sguardo al sistema di secrets di Devin

Prima dell’integrazione con Sentry, ho dato un’occhiata al sistema di secrets di Devin per capire se usarlo. Devin offre un vault “Secrets” integrato per fornire all’agente chiavi API, URL del DB o token OAuth senza inserirli in Git e senza esporli in chat. Pensalo come un equivalente leggero dei GitHub Actions secrets o delle Environment Variables di Vercel, ma con ambito limitato ai workspace cloud di Devin.

Funzione

Come funziona

Note

Ambito

I secrets coprono tre ambiti: org, repo e session.

Puoi renderli disponibili a livello di organizzazione, in tutte le tue sessioni.

Se vuoi aggiungere secrets per un singolo repo, puoi specificarli quando imposti il repo.Se vuoi che i secrets siano specifici della sessione, puoi fornirli nelle impostazioni della sessione. 

Crittografia

Archiviati lato server con AES-256 e TLS 1.3+ in transito

Tutti i dati dei clienti sono crittografati con una chiave KMS personalizzata (Key Management Service), gestita da AWS.

Nessun costo in ACU

Aggiungere, modificare o eliminare un secret è un’azione di control plane: 0 ACU. Solo i task che usano il secret consumano crediti di calcolo.

Un buon posto in cui mettere token di lunga durata.

Accesso nei prompt

Usa $.<NAME> nel prompt o in un comando. Devin lo risolve prima di eseguire la shell.

Esempio: DATABASE_URL=$.POSTGRES_URL

Limiti di dimensione

4 KB per chiave, 100 chiavi per team sul tier Core.

Abbastanza per cert PEM o chiavi private.

Aggiungere un secret

Ecco i passaggi da seguire per aggiungere un secret:

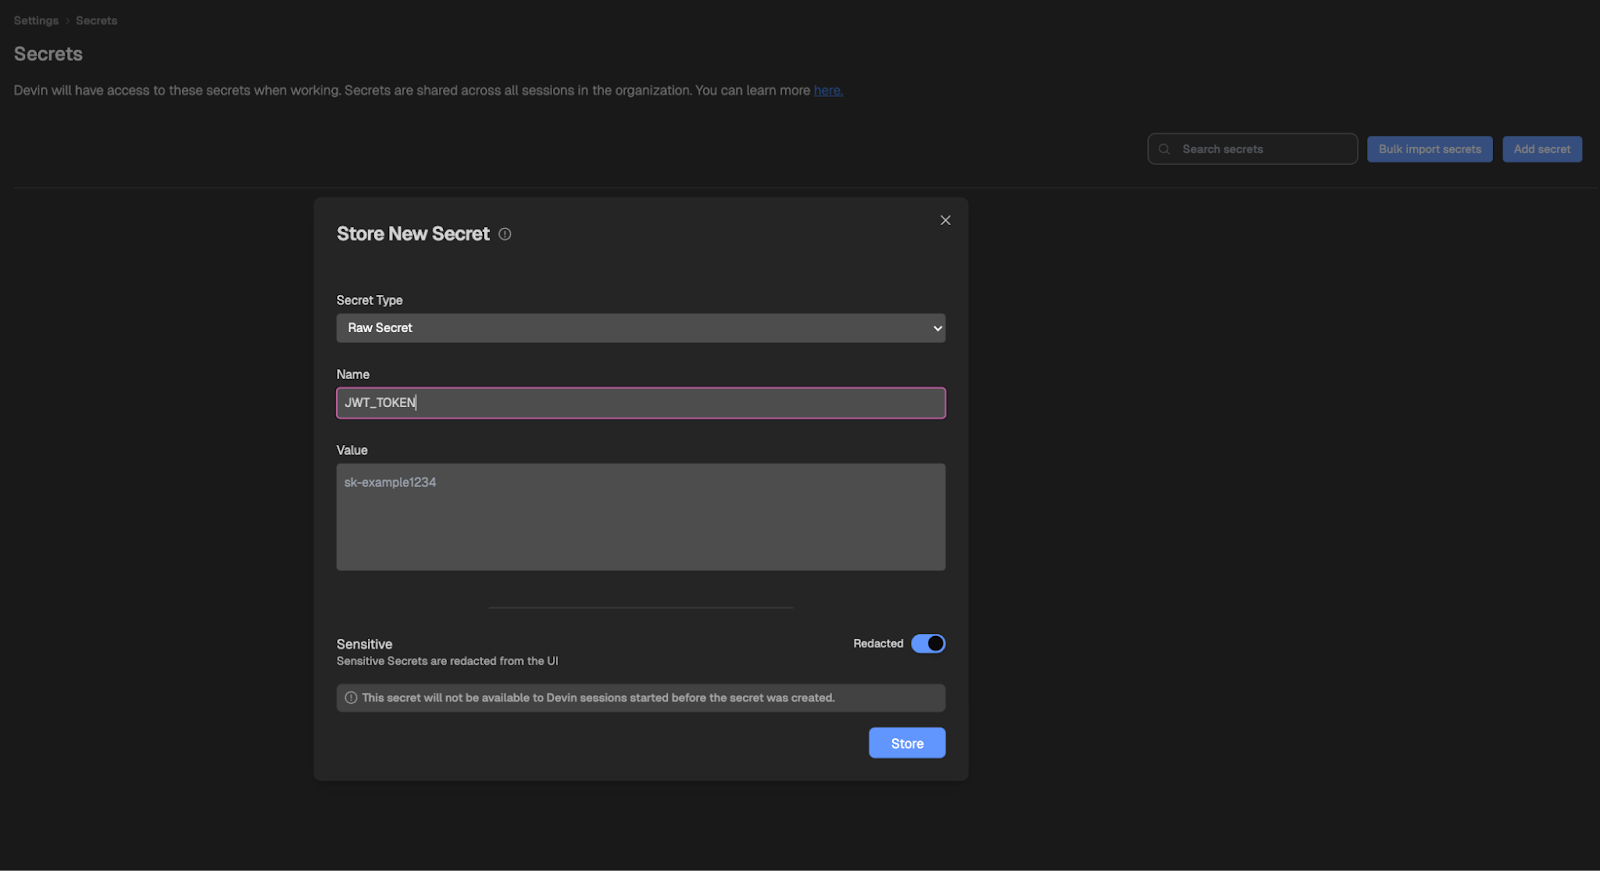
  1. Apri Team → Secrets nel dashboard di Devin.
  2. Clicca “Add Secret” e inserisci un nome (SENTRY_DSN_WEB) e il valore.
  3. Devin conferma il salvataggio; la chiave è ora disponibile come $.SENTRY_DSN_WEB.

archivia un nuovo secret in devin

Usare un secret in un task

Task: aggiorna l’init di Sentry per l’API; imposta il DSN su $SECRET.SENTRY_DSN_API

Devin sostituisce il valore quando scrive main.ts. Nella scheda shell vedrai il DSN letterale, ma il log della chat lo maschera.

Pro e contro

Pro:

  • Nessun rischio di far trapelare chiavi nelle PR o nei log Timelapse.
  • I secrets con ambito organizzazione funzionano tra le sessioni: un upload, molti utilizzi.
  • Costo zero di crediti per archiviare o recuperare.

Contro:

  • Le chiavi non sono disponibili in locale a meno di copiarle in .env. I test fuori da Devin richiedono setup manuale.
  • Nessun ambito per ambiente (es., “solo in produzione”). Tutte le sessioni ottengono tutti i secrets.

Quando usarlo

Trovo più semplice usare il vault di Devin quando Devin stesso ha bisogno della chiave (es., push su Vercel, accesso a un registry privato o collegare Sentry durante la build). Continuerei a usare .env / i GitHub Actions secrets per tutto ciò che gira anche nella tua shell di sviluppo locale o nei runner CI.

Integrazione di Devin con Sentry

Ecco il prompt che ho usato: Aggiungi Sentry a entrambe le app così ogni eccezione compare nella mia dashboard. Usa variabili d’ambiente in .env. Nessun altro cambiamento di comportamento.”

Il lavoro di Devin (0,6 ACU, una sessione)

Ecco un riepilogo del risultato:

Stack

File modificati

Codice chiave

Next.js (web)

apps/web/sentry.client.config.tsx apps/web/sentry.server.config.ts e un import in app/layout.tsx

ts import * as Sentry from '@sentry/nextjs'; Sentry.init({ dsn: process.env.SENTRY_DSN_WEB, tracesSampleRate: 1.0 });

NestJS (API)

apps/api/src/sentry.ts e due righe in main.ts

ts import * as Sentry from '@sentry/node'; Sentry.init({ dsn: process.env.SENTRY_DSN_API }); app.useGlobalFilters(new Sentry.GqlExceptionFilter());

Impianto Env

Aggiunti segnaposto a .env.example

SENTRY_DSN_WEB=   SENTRY_DSN_API=

Test

Aggiunto uno spy Jest per verificare che Sentry.captureException venga chiamato su un errore forzato.


I miei passaggi manuali

Ecco i passaggi che ho eseguito:

  1. Copiati i DSN dal mio progetto Sentry in .env.
  2. Riavviati entrambi i server di sviluppo.
  3. Richiamato http://localhost:4000/graphql con una query volutamente errata per verificare il funzionamento. Un issue è apparso su Sentry in pochi secondi.

Perché ho saltato la funzione secrets di Devin

Ecco perché ho saltato la funzione secrets di Devin:

  • Modello mentale più semplice: stesso file .env ovunque.
  • Più facile eseguire build di anteprima su Vercel (quelle env var sono già impostate lì).
  • Nessun consumo di ACU per le operazioni sullo store dei secrets.

Riflessioni: dove Devin brilla e dove inciampa

Quattro parti di tutorial fa, questo repo era un mucchio impolverato di esercizi fp-ts—ora ha:

  • Codebase modernizzata: dipendenze più recenti, config TS strict, regole lint & Prettier (Parte 1).
  • Playground nel browser: Next.js 14 + editor Sandpack con feedback Vitest live (Parte 2).
  • Backend NestJS + Postgres: API GraphQL, migrazioni Prisma, tracking progressi da anonimi → JWT (Parti 2 & 4).
  • Pipeline a semaforo verde: workflow CI che fa lint, type-check, esegue Jest & Playwright e blocca ogni PR fallita (Parte 3).
  • Integrazioni di team: ping di stato su Slack, analisi con etichette Jira e URL di anteprima su ogni branch (Parte 3).
  • Osservabilità in produzione: Sentry collegato sia sul web sia sull’API, che cattura ogni eccezione (Parte 4).
  • Deploy di anteprima: Vercel genera un URL condivisibile per ogni pull request (Parte 4).

Abbiamo speso circa ≈ 70 ACU in totale (~157$ sul piano Core) e circa due giorni di lavoro di revisione pratica.

Cosa Devin fa spaventosamente bene

Ecco dove penso che Devin sia molto bravo:

Area

Perché mi ha colpito

Infrastruttura boilerplate

Impalcature AuthModule, Dockerfile, workflow YAML: generati in minuti, senza bug.

Codice idiomatico del framework

Decorator NestJS, configurazione NextAuth, migrazioni Prisma tutte in linea con la documentazione ufficiale.

Impianto di test

Suite di unit e Playwright compilano e girano subito—nessuno stub per edge case mancante.

Dove un umano batte ancora l’agente

Qui è dove penso che Devin debba ancora migliorare:

Punto dolente

Esempio

Finitura delle feature cross-layer

Editor Sandpack hard-coded su test di stub; non ha colto il nome del componente SandpackTests.

Persistenza della config

È tornato al default su SQLite 5 volte, anche dopo “Deve rimanere su Postgres”.

Naming / pulizia

I titoli delle PR deviano, i file obsoleti restano a meno che non dica a Devin di eliminarli.

Gusto & UX

La dashboard era passabile, ma spaziatura, testi e colori richiedevano ancora rifinitura manuale.

La mia opinione

La documentazione di Devin non ha mai promesso un product builder. Delinea un punto di forza molto più ristretto e, col senno di poi, avrei dovuto restarci dentro. La pagina ufficiale “Quali sono i punti di forza di Devin?” elenca quattro utilizzi principali:
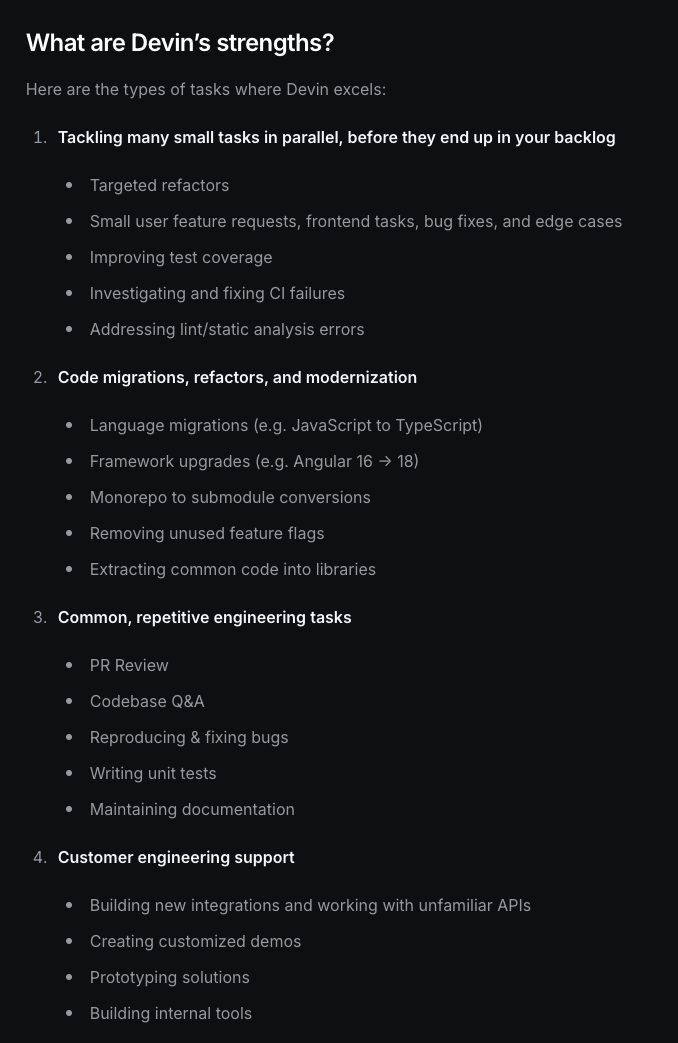
punti di forza di devin

La documentazione definisce lo sviluppo di feature che attraversano UI, API e flussi dati come “sperimentale”. Sono descritte come attività ampie e aperte in cui l’agente potrebbe “richiedere una significativa revisione e iterazione umana”. È esattamente ciò che abbiamo visto quando Sandpack aveva test hard-coded o quando la dashboard sembrava bella ma non calcolava realmente i dati.

Quindi, come regola generale:

Usa Devin per tutto ciò che uno sviluppatore senior potrebbe automatizzare con uno script, e tieni il volante per i task che richiedono senso del prodotto.

Conclusione

Siamo arrivati alla fine del nostro tutorial in quattro parti:

  1. Setup e prima pull request (Parte 1)
  2. Consegna di una vertical slice con Devin (Parte 2) 
  3. Integrazioni, test e CI/CD (Parte 3) 
  4. Sicurezza, deployment, manutenzione (Parte 4)

Ecco alcuni prossimi passi che possiamo intraprendere da qui:

  1. Ospitare l’API così le build di anteprima (e i futuri utenti) colpiscono un backend reale.
  2. Assicurarsi che le funzionalità core funzionino e correggere i 30 bug che so che ci sono
  3. Rifinire la UI
  4. Aggiungere più contenuti ed esercizi
  5. Rilasciare per l’uso pubblico!

Se segui lo stesso percorso, ricorda: puoi lasciare che l’agente getti il cemento, ma la casa la devi progettare tu. Buon coding!


Marie Fayard's photo
Author
Marie Fayard

Sono una tech lead orientata al prodotto, specializzata nel far crescere startup nelle fasi iniziali, dal primo prototipo al product-market fit e oltre. Sono instancabilmente curiosa di come le persone usano la tecnologia e adoro lavorare a stretto contatto con founder e team cross‑funzionali per dare vita a idee ambiziose. Quando non costruisco prodotti, inseguo l’ispirazione in angoli nuovi del mondo o scarico le tensioni in una sala yoga.

Argomenti
AI Agents
Intelligenza artificiale

Costruisci agenti AI con questi corsi:

Corso

Introduzione agli AI Agents

1 ore 30 min
142.5K
Scopri le basi degli agenti AI, come funzionano e come si usano nella vita di tutti i giorni, senza bisogno di programmare.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

Mostra AltroMostra Altro

