
Corso
Introduzione agli AI Agents
1 ore 30 min
142.5K
Bentornato! Alla fine del secondo tutorial avevamo un playground fp-ts a tema pastello, un backend NestJS + PostgreSQL e il tracciamento dei progressi tramite UUID anonimi.
Puoi accedere a tutti i tutorial della serie su Devin qui:
Quello che abbiamo fatto finora va benissimo per lavorare in solitaria, ma è il momento di vedere quanto bene Devin si integra con i flussi di lavoro di un team. In questo terzo tutorial vedremo:
Niente autenticazione e niente deploy in produzione per ora: arriveranno nella Parte 4!
Collegare Devin ai tuoi canali di comunicazione e al flusso dei ticket è un'operazione completamente manuale e si fa dall'interfaccia di Devin.
Puoi connetterti a Slack dalla scheda delle integrazioni nelle impostazioni di Devin o installare l'app "Devin AI" dalla Slack App Directory.
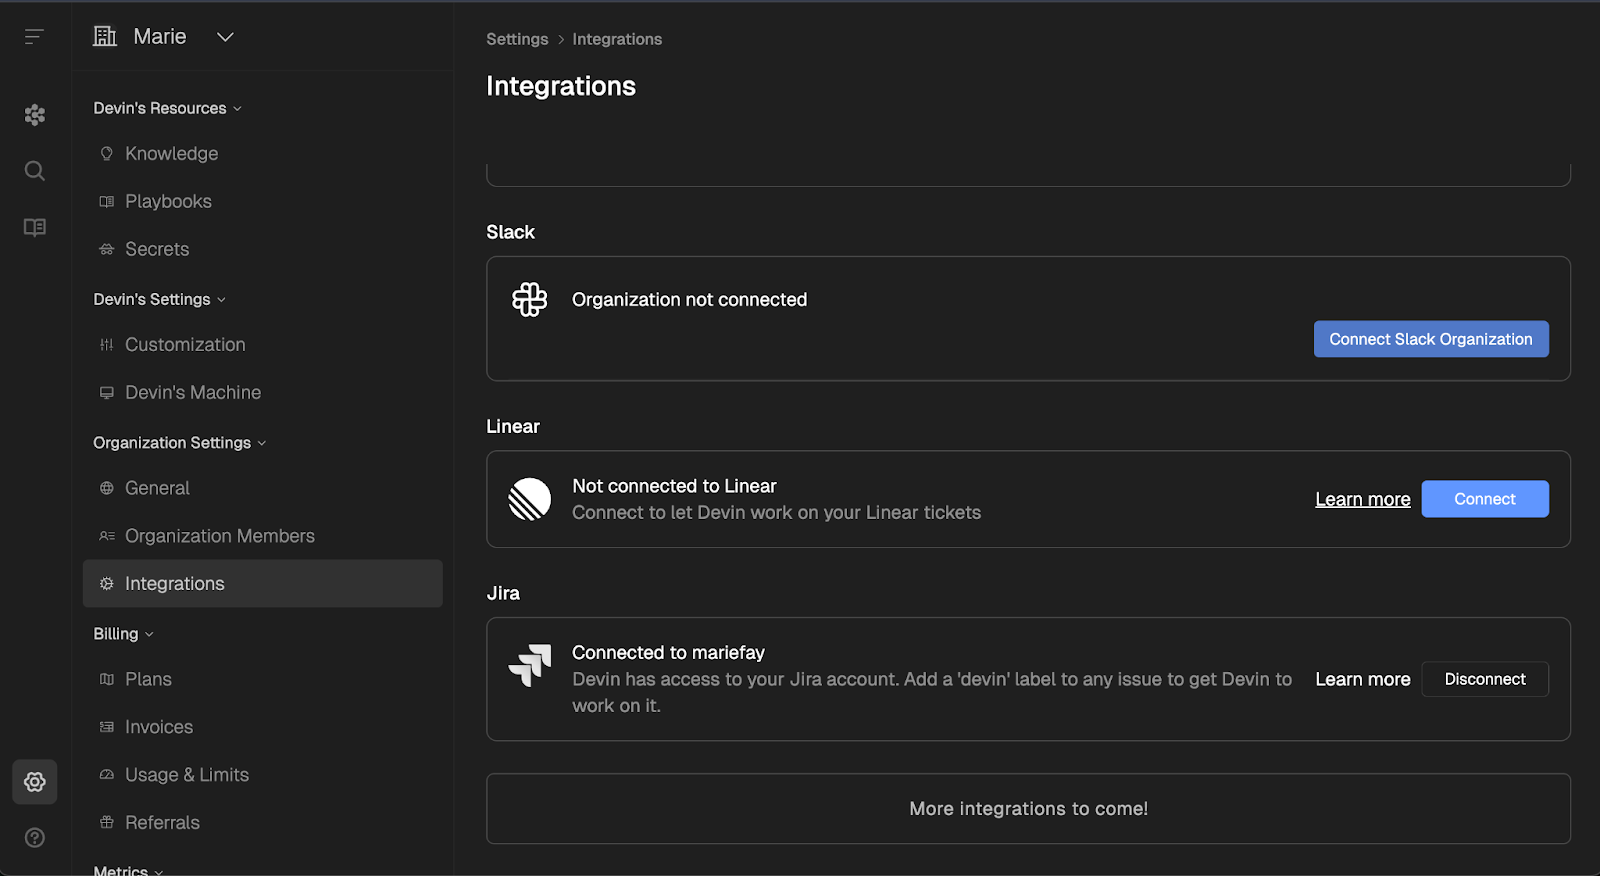
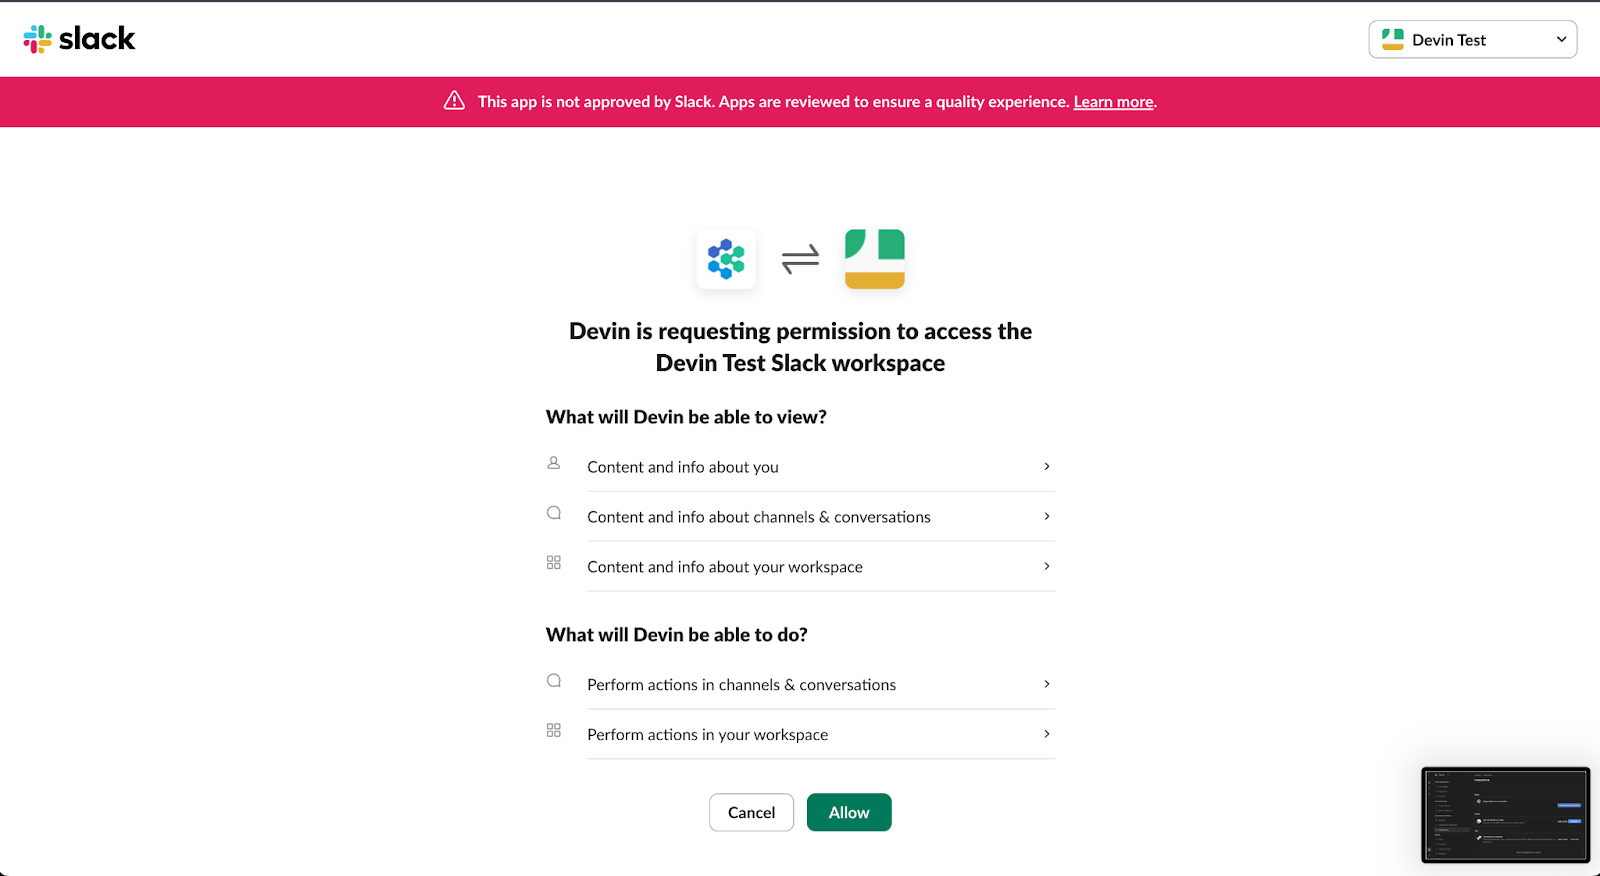
Nella finestra OAuth l'app mostra ancora "Non approvata da Slack". Cognition afferma che la loro revisione di sicurezza è in corso e che la funzionalità non ne risente.
Poi scegli un canale:
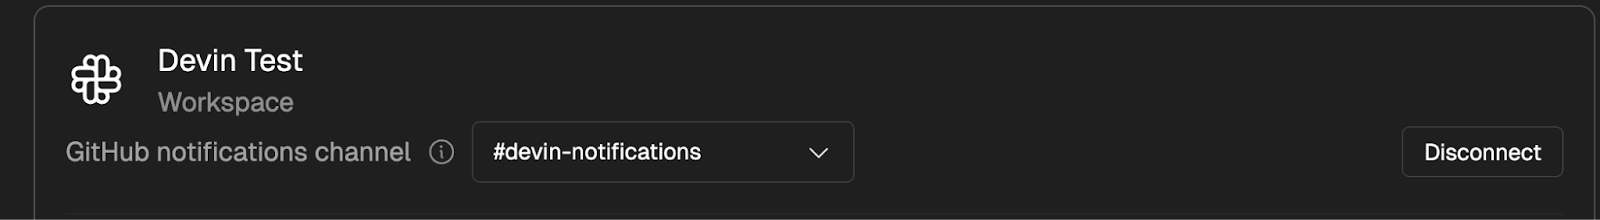
Puoi chattare con Devin con una semplice menzione:
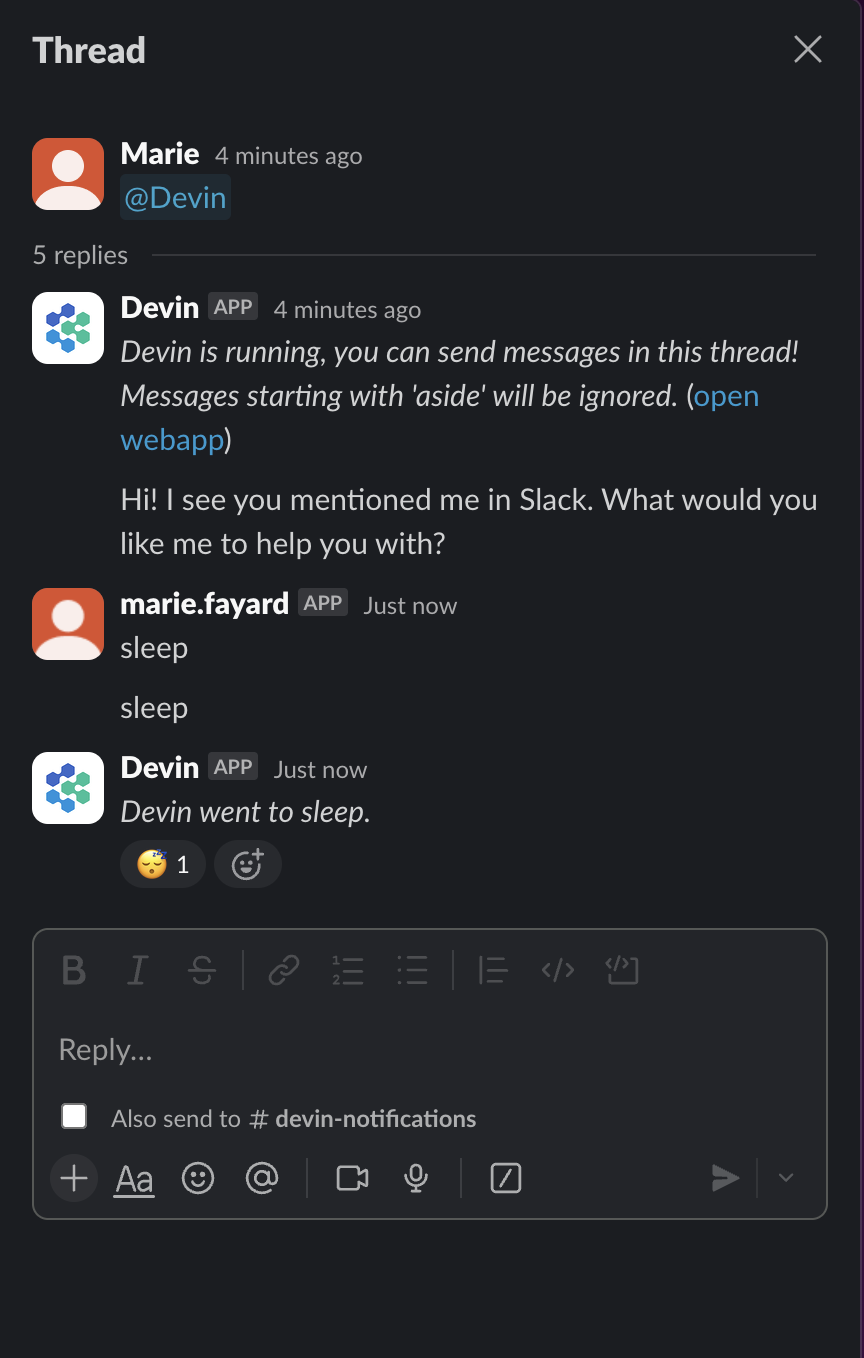
E parte una sessione che puoi aprire nell'interfaccia:
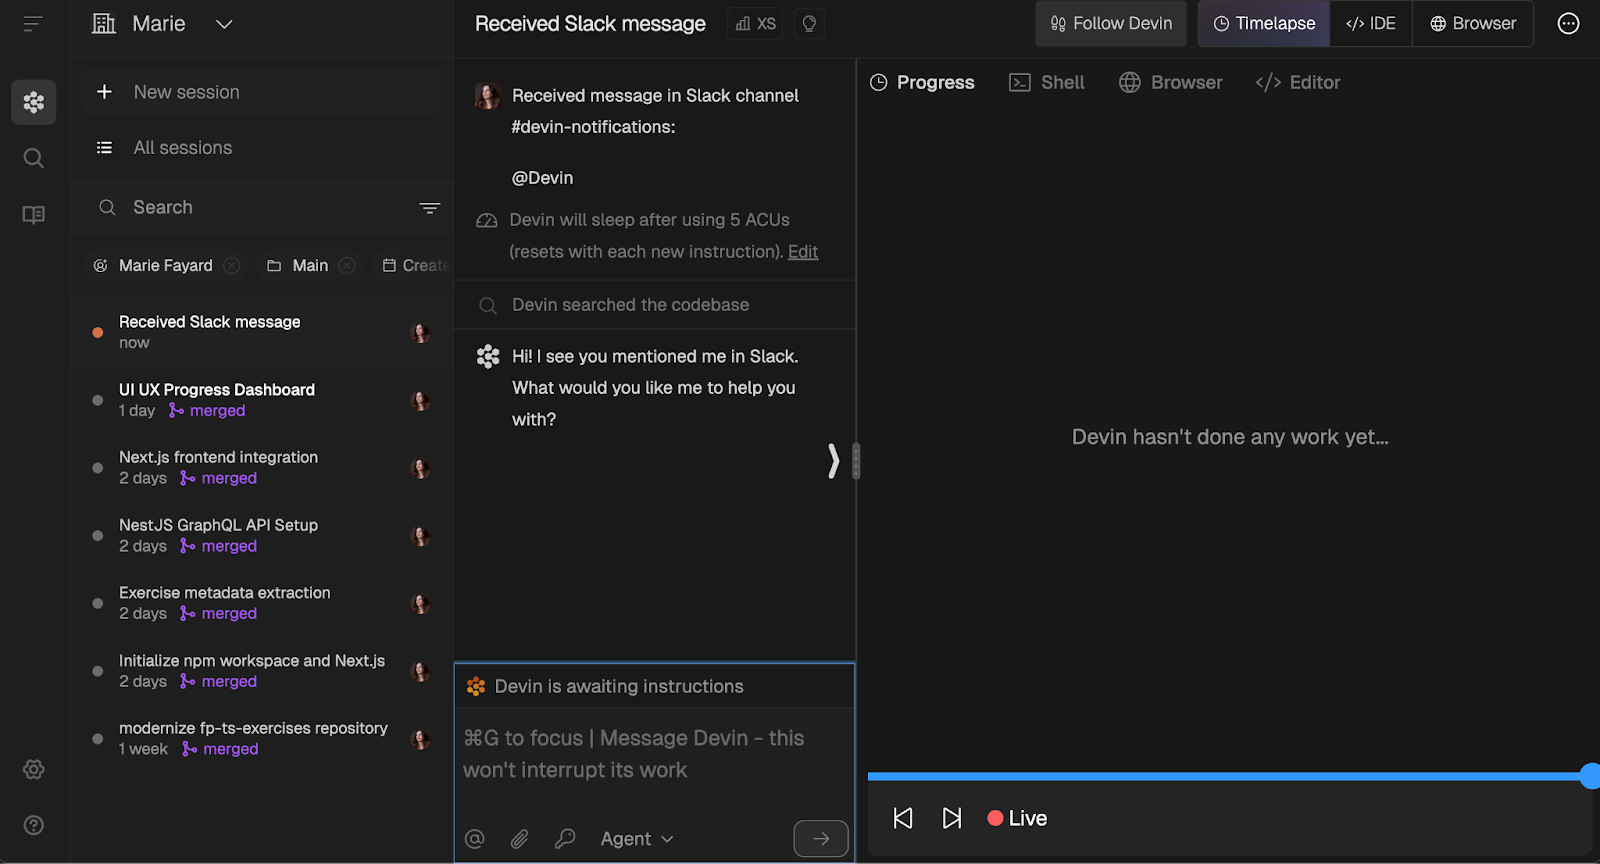
Per impostazione predefinita, ricevi le notifiche sugli aggiornamenti delle PR nel canale che preferisci, ma ci sono diverse impostazioni che puoi regolare nei parametri di ogni sessione.
Per integrarti con Jira, devi creare un utente bot dedicato (ad esempio, devin-bot@…) e collegarne le credenziali in Devin → Team ▸ Integrations ▸ Jira.
Dal tuo account personale, puoi quindi creare un nuovo ticket e aggiungere l'etichetta devin.
Devin pubblica un commento di analisi con un piano e un prompt "Avviare la sessione?". Scrivi "sì" per farlo procedere con il codice oppure rimuovi l'etichetta per lasciare il ticket solo agli umani.
Nota: Devin non sposta automaticamente le card sulla tua board. Tu o il tuo PM dovete comunque trascinarle su In corso o Fatto. Così il controllo del flusso resta in mano umana.
Una volta collegati Slack e Jira, ho provato un vero esperimento di "agente come compagno di squadra" e ho assegnato a Devin ticket reali per vedere se riusciva a implementarli senza essere guidato passo passo.
Ecco il mio workflow:
devin, che è il segnale per l'analisi di Devin.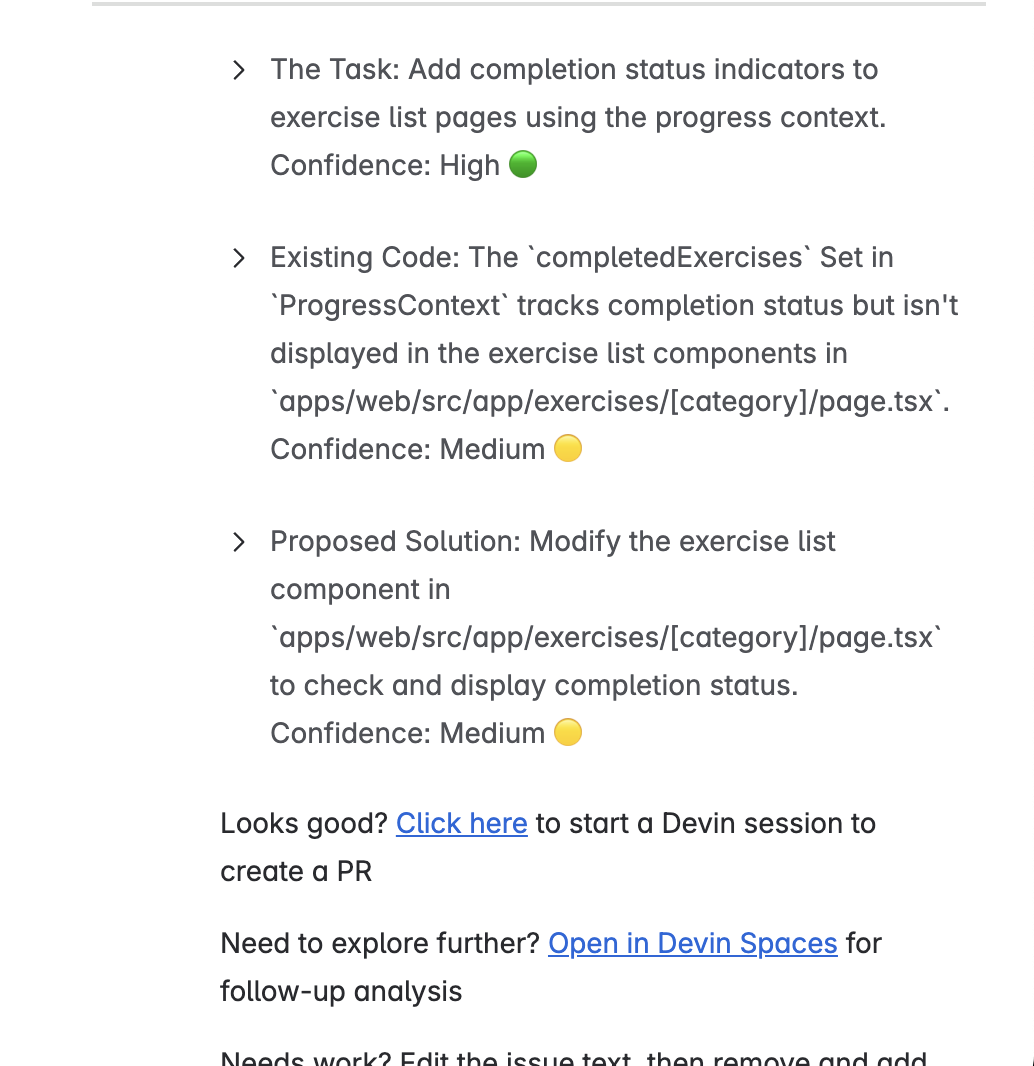
Ecco un riepilogo di cosa è successo con cinque ticket reali:
Queste sono le cose che avrebbero bisogno di miglioramenti:
Devin su Jira è promettente: due ticket chiusi alla perfezione, uno con lievi incoraggiamenti, e anche nel caso peggiore ha fatto perdere solo tempo, non un rollback. Ma la coerenza ancora non c'è, quindi scope ristretto e vincoli espliciti sono i tuoi alleati.
Con chat e ticket a regime, il passo successivo è assicurarsi che il codice rotto non passi inosservato. Ho chiesto a Devin due cose: unit test per il backend e test end-to-end con Playwright che imitino un learner che modifica un esercizio nel browser.
Ho chiesto a Devin suite di test Jest che coprissero il resolver GraphQL, il service layer e i modelli Prisma. Quando ho chiesto una stima degli ACU, ha risposto 20 ACU!!
Ho pensato fosse un errore e ho lanciato comunque il task. È costato 1,1 ACU ed è stato il task eseguito meglio finora.
Questo è stato leggermente più costoso e ha richiesto 2,3 ACU.
Il flusso registrato: apri /learn/option-01 → modifica il codice → aspetta la ✓ → ricarica la pagina → la ✓ persiste.
Alla prima esecuzione, circa il 70% delle asserzioni è fallito. C'erano molte anomalie di resize, conteggi obsoleti in dashboard e persino il percorso felice era instabile.
Nonostante nel mio prompt ci fosse il comando "Ignora i test falliti, li sistemeremo dopo", Devin ha continuato a patchare il codice finché la suite non è diventata per lo più verde (utile, ma non ciò che avevo chiesto).
Abbiamo ancora alcuni test falliti perché ci sono diversi bug nel sistema. Ma va bene così: sistemeremo in seguito per rendere verdi tutti questi test.
Con unit test ed end-to-end al loro posto, l'ultimo passo era assicurarsi che ogni pull request eseguisse automaticamente quei controlli. Ho chiesto a Devin un workflow essenziale, senza artefatti, senza gate di copertura, solo lint → type-check → test.
Devin ha consegnato una pipeline sorprendentemente curata al primo colpo, senza bisogno di follow-up:
Devin ha pushato il workflow, ha atteso che il controllo finisse su GitHub e solo allora ha deciso che fosse concluso. Devo dire che 0,4 ACU per una pipeline pienamente funzionante è difficile da battere. YAML è chiaramente il luogo felice di Devin.
Con questo workflow unito, ogni PR deve passare lint, compilazione e entrambe le suite di test prima che qualcuno prema il pulsante verde!
Devin include una "Wiki" incorporata che può convivere accanto al tuo codice. È una knowledge base leggera e auto-generata da cui l'agente può sia leggere che scrivere mentre lavora. Dopo aver collegato Slack, Jira e CI, questa Wiki è un buon posto per le note architetturali. Vale la pena darci un'occhiata!
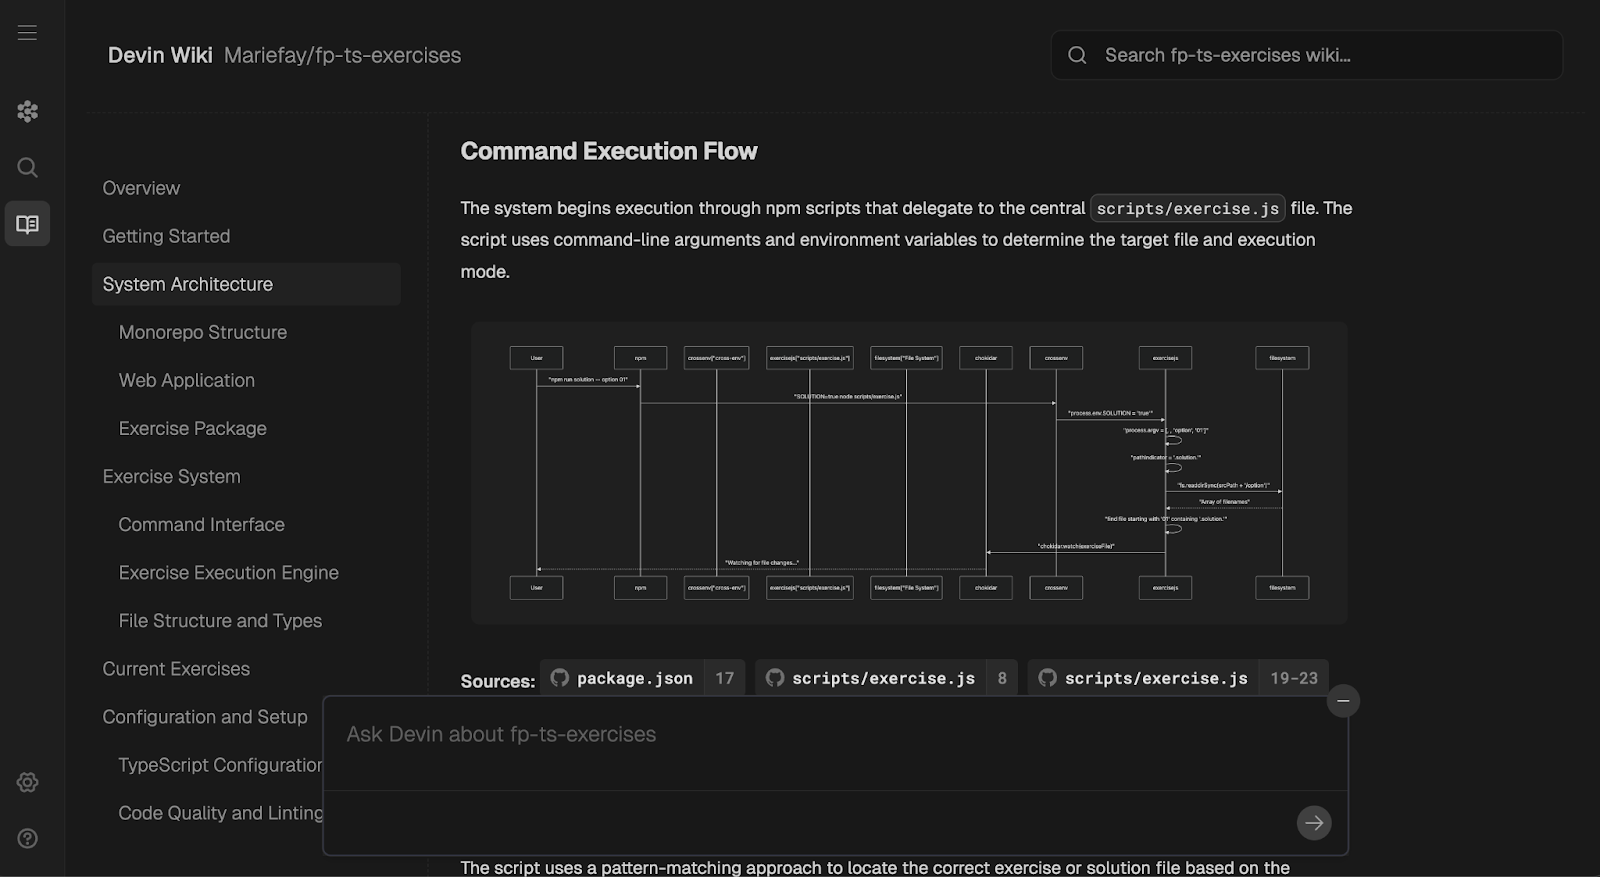
Per quanto ne so, non è modificabile manualmente e devi affidarti a Devin per mantenere aggiornata la Wiki.
Quando tutte le integrazioni, i test e la pipeline erano attivi, ho fatto i conti di spesa e tempo:
Quindi, circa 2 ore di lavoro umano per portare ticket, test e CI. Di sicuro più veloce di come l'avrei fatto io.
A questo punto, però, sono combattuto. Ci sono ancora molti bug e, se avessi scritto io l'intero codebase, probabilmente potrei correggere i problemi più rapidamente di quanto Devin bruci crediti.
Ma è stato Devin a scrivere la maggior parte dell'app, quindi l'agente in realtà "conosce" la struttura meglio di me. Tuttavia, fatica a sostituire valori hardcoded con quelli dinamici, lascia fili sciolti nel codice in ogni file e ha bisogno che io stia davanti al laptop a fare da babysitter a tutte le sue azioni.
Ho trovato anche il processo un po' frustrante, ma non allo stesso modo di quando inseguo un bug che non riesco a capire. C'è un'enorme differenza (almeno per me) tra essere frustrato perché il codice non funziona ed essere frustrato perché un agente AI non riesce a seguire istruzioni basilari. La seconda è davvero esasperante.
Penso che Devin possa essere molto utile se usato bene, ma come tutti gli agenti AI là fuori non può sostituire un ingegnere software. Va bene usarlo per alcuni task, ma non credo sia adatto o sostenibile usarlo per ogni ticket.
Siamo collegati a Slack e Jira, i test sono verdi e il gate di CI blocca ogni PR approssimativa. Ma per un vero lancio in produzione, ci mancano ancora quattro pilastri:
GqlAuthGuard in NestJS così i progressi sono legati a utenti reali.prod quando la main diventa verde.Questa è l'agenda per la Parte 4, il tratto finale in cui scopriremo se Devin può mettere in sicurezza, distribuire e sorvegliare l'app quasi senza intervento umano. Fissa il database su Postgres (di nuovo!), limita quegli ACU e ci vediamo nell'ultimo capitolo.
Se sei pronto a continuare, fai clic sull'ultimo elemento dell'elenco qui sotto per andare al quarto tutorial:
Costruisci agenti AI con questi corsi:
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



