Corso
Introduzione a Python
4 ore
7M
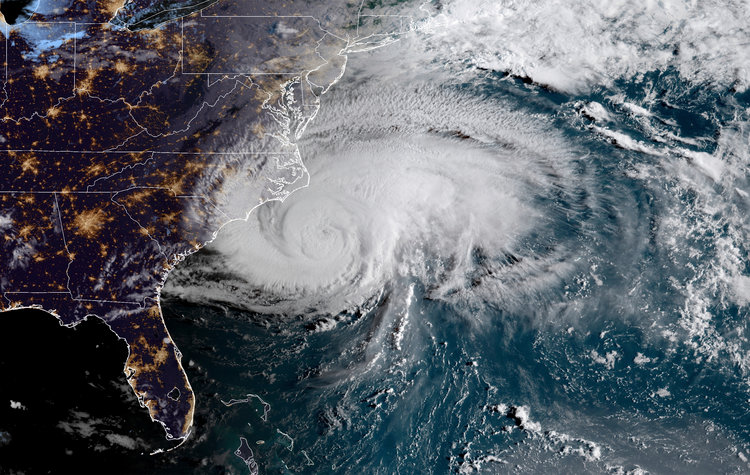
In questo tutorial conoscerai due pacchetti molto usati per lavorare con i dati geospaziali: geopandas e Shapely. Poi applicherai questi due pacchetti per leggere i dati geospaziali usando Python e tracciare il percorso dell’uragano Florence dal 30 agosto al 18 settembre.
Dati spaziali, dati geospaziali, dati GIS o geodati sono nomi per dati numerici che identificano la posizione geografica di un oggetto fisico come un edificio, una strada, un paese, una città, uno stato, ecc., secondo un sistema di coordinate geografiche. Dai dati spaziali puoi ricavare non solo la posizione ma anche la lunghezza, la dimensione, l’area o la forma di qualsiasi oggetto. Un esempio di dati spaziali che puoi ottenere sono: coordinate di un oggetto come latitudine, longitudine ed elevazione. I Sistemi Informativi Geografici (GIS) o altre applicazioni software specializzate possono essere usati per accedere, visualizzare, manipolare e analizzare i dati geospaziali.
I dati geospaziali hanno un’infinità di applicazioni nella vita di tutti i giorni. Un esempio è l’app Mappe che usi per spostarti da una posizione all’altra. Un altro che potresti vedere ogni giorno è sul canale meteo.
Esatto, i dati geospaziali servono a rappresentare le informazioni di posizione di qualcosa rispetto a ciò che lo circonda: la tua casa sulla mappa della città, l’uragano sulla mappa del mondo e così via. In questo tutorial quindi osserverai il distruttivo uragano Florence e ne seguirai la traiettoria.
Non saltare avanti. Questa è una parte importante. Se non sei sicuro di aver soddisfatto i requisiti, ricontrolla. Prima di tutto, assicurati di aver installato tutti i pacchetti qui sotto.
Installa tutti i pacchetti seguendo l’ordine sopra per assicurarti che tutto funzioni. Alcuni pacchetti sono prerequisiti di altri, per esempio: per installare GeoPandas serve Shapely, e per installare Shapely devono essere installati RTree, GDAL e Fiona. Il modo più semplice per installare un pacchetto è: pip install PACKAGE_NAME
Se usi Windows e non riesci a installare i pacchetti in questo modo, consulta questo sito per scaricare i relativi pacchetti ed eseguire pip install PATH_TO_PACKAGE.
Come saprai, il terribile uragano Florence è appena passato su parte della East Coast degli Stati Uniti, causando danni stimati in 17 miliardi di USD. Questo tutorial ti aiuterà a scoprire da dove è arrivato, quando e dove si è intensificato, a capire meglio questo disastro naturale e ad analizzarlo in Python. Esistono molti siti che forniscono informazioni su questo uragano. Per esempio, questo sito offre dati su diverse tempeste e uragani negli Stati Uniti dal 1902 al 2018, quindi c’è una marea di dati su cui potrai lavorare anche in seguito. Per questo tutorial userai solo i dati dell’uragano Florence
Userai anche i dati geospaziali della mappa degli USA reperiti online. Il post di Eric Celeste contiene tutti i tipi di file di confine per contee e stati degli USA. I dati usati in questo tutorial sono gli US States, 5m, file GeoJSON.
 # Load all importance packages
import geopandas
import numpy as np
import pandas as pd
from shapely.geometry import Point

import missingno as msn

import seaborn as sns
import matplotlib.pyplot as plt

% matplotlib inline
Per prima cosa, diamo un’occhiata al primo geospatial dataframe: US States Geodata
# Getting to know GEOJSON file:
country = geopandas.read_file("data/gz_2010_us_040_00_5m.json")
country.head()
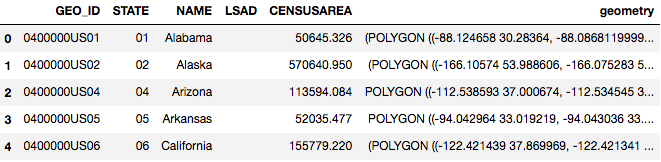
Verificando il tipo di dataframe appena caricato, puoi vedere che è un GeoDataFrame, che ha tutte le caratteristiche tipiche di un DataFrame di Pandas.
type(country)
geopandas.geodataframe.GeoDataFrame
Controllando il tipo di dato della colonna che contiene le coordinate: è una GeoSeries.
type(country.geometry)
geopandas.geoseries.GeoSeries
Ogni valore nella GeoSeries è un oggetto Shapely. Può essere:
Ogni oggetto può rappresentare un diverso tipo di oggetto fisico: Point per un edificio, Line per una strada, Polygon per una città e MultiPolygon per uno stato con più città al suo interno. Per maggiori informazioni su ciascun oggetto geometrico, leggi questo articolo: https://shapely.readthedocs.io/en/stable/manual.html#geometric-objects
type(country.geometry[0])
shapely.geometry.multipolygon.MultiPolygon
Come un DataFrame di Pandas, anche un GeoDataFrame ha l’attributo plot, che sfrutta la geometria presente nel dataframe per tracciare una mappa:
country.plot()
<matplotlib.axes._subplots.AxesSubplot at 0x1cfe68c1358>
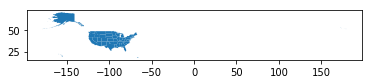
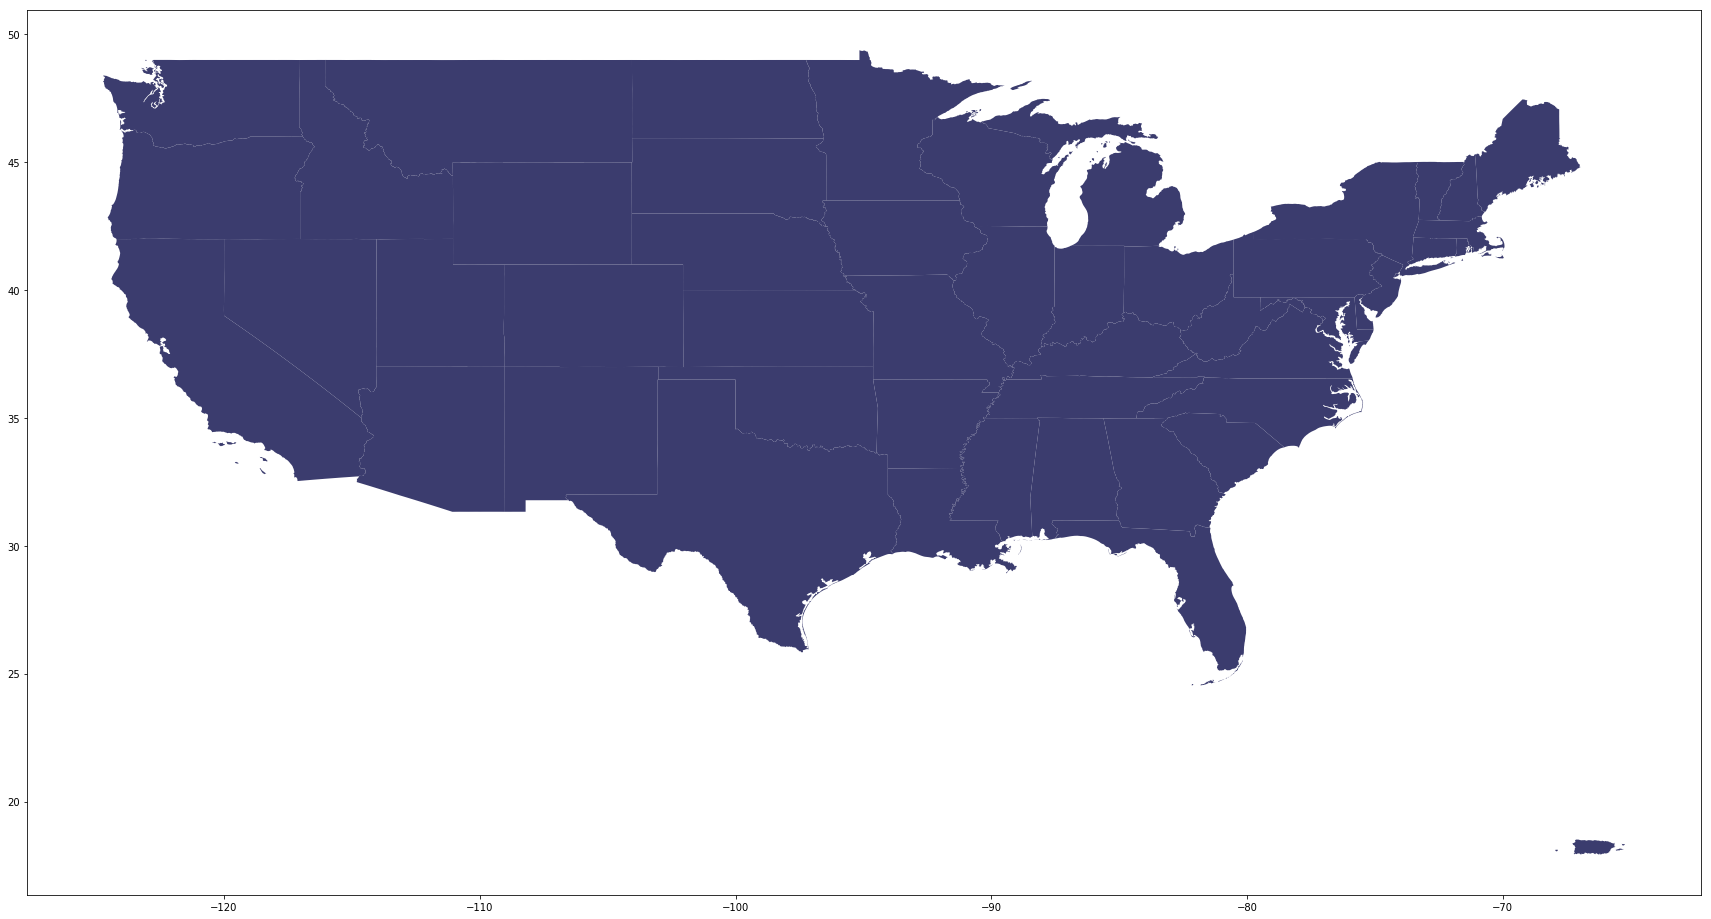
Come puoi vedere, la mappa degli USA è relativamente piccola rispetto al riquadro. È perché le informazioni includono Alaska, Hawaii e Portorico, che sono sparsi. Per gli scopi di questo tutorial, puoi escludere Alaska e Hawaii dato che l’uragano non si è avvicinato a questi due stati. Puoi anche impostare dimensioni e colore della figura per personalizzare il grafico:
# Exclude Alaska and Hawaii for now
country[country['NAME'].isin(['Alaska','Hawaii']) == False].plot(figsize=(30,20), color='#3B3C6E');
Niente di complicato, vero? Ora che hai la mappa degli USA, carichiamo i dati dell’uragano:
florence = pd.read_csv('data/florence.csv')
florence.head()
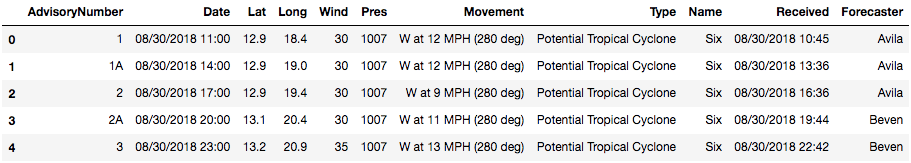
Questa è sempre la prima cosa da fare quando carichi un dataset:
florence.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 105 entries, 0 to 104
Data columns (total 11 columns):
AdvisoryNumber    105 non-null object
Date              105 non-null object
Lat               105 non-null float64
Long              105 non-null float64
Wind              105 non-null int64
Pres              105 non-null int64
Movement          105 non-null object
Type              105 non-null object
Name              105 non-null object
Received          105 non-null object
Forecaster        104 non-null object
dtypes: float64(2), int64(2), object(7)
memory usage: 9.1+ KB
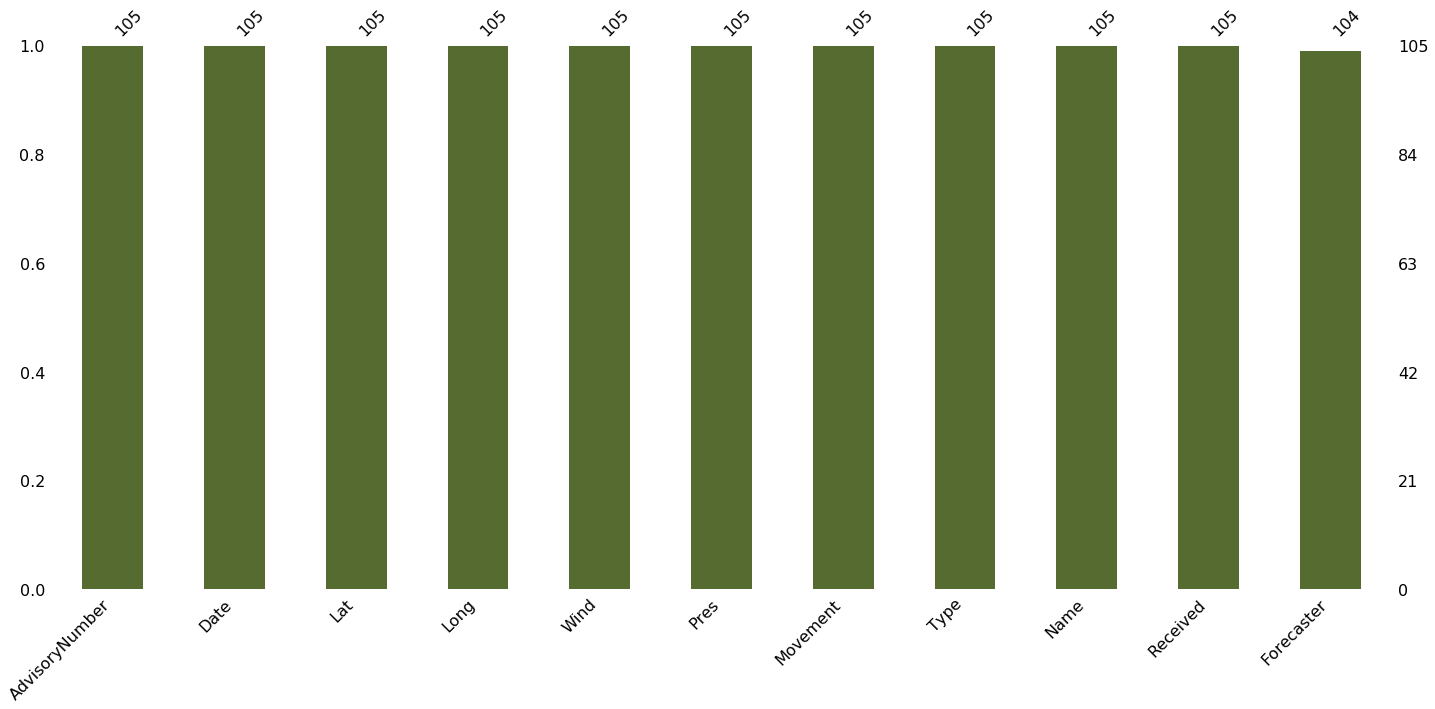
Controlliamo i valori mancanti con il pacchetto missingno. È un pacchetto utile che usa la visualizzazione per mostrare i dati mancanti. Come puoi vedere sotto, c’è un solo valore mancante nella colonna "Forecaster" che non ti serve per questo tutorial. Puoi quindi ignorarlo per ora.
# Notice you can always adjust the color of the visualization
msn.bar(florence, color='darkolivegreen');
Diamo un’occhiata ad alcune informazioni statistiche; alcune possono essere molto utili, come la velocità media del vento, la velocità massima e minima del vento di questo uragano, ecc.
# Statistical information
florence.describe()
| Lat | Long | Wind | Pres | |
|---|---|---|---|---|
| count | 105.000000 | 105.000000 | 105.000000 | 105.000000 |
| mean | 25.931429 | 56.938095 | 74.428571 | 981.571429 |
| std | 7.975917 | 20.878865 | 36.560765 | 22.780667 |
| min | 12.900000 | 18.400000 | 25.000000 | 939.000000 |
| 25% | 18.900000 | 41.000000 | 40.000000 | 956.000000 |
| 50% | 25.100000 | 60.000000 | 70.000000 | 989.000000 |
| 75% | 33.600000 | 76.400000 | 105.000000 | 1002.000000 |
| max | 42.600000 | 82.900000 | 140.000000 | 1008.000000 |
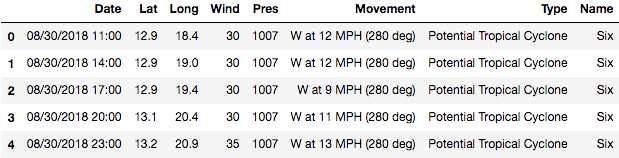
Per la maggior parte dei dati è necessario fare pulizia e tenere solo ciò che serve. Qui ti servono solo il tempo, le coordinate: latitudine e longitudine, la velocità del vento, la pressione e il nome. Movement e Type sono opzionali, ma il resto può essere eliminato.
# dropping all unused features:
florence = florence.drop(['AdvisoryNumber', 'Forecaster', 'Received'], axis=1)
florence.head()
In genere, se tracci i dati da soli, non serve prestare particolare attenzione alle coordinate. Tuttavia, se vuoi che appaiano come su una mappa, è importante controllare longitudine e latitudine. Qui la longitudine è ovest: devi aggiungere il segno "-" davanti al numero per tracciare correttamente i dati:
# Add "-" in front of the number to correctly plot the data:
florence['Long'] = 0 - florence['Long']
florence.head()
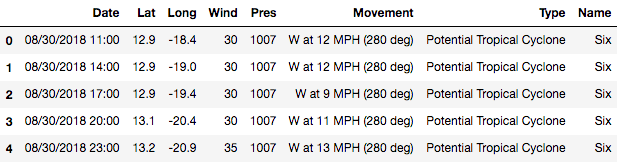
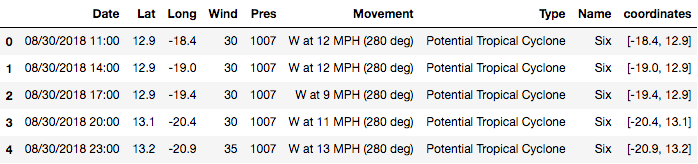
Poi puoi combinare Latitudine e Longitudine per creare le coordinate dell’uragano, che verranno quindi trasformate in GeoPoint per la visualizzazione.
# Combining Lattitude and Longitude to create hurricane coordinates:
florence['coordinates'] = florence[['Long', 'Lat']].values.tolist()
florence.head()
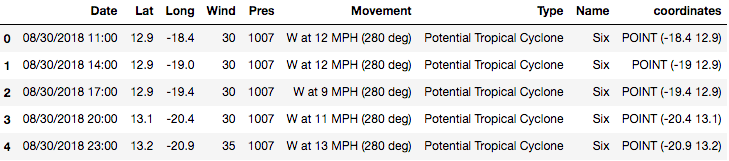
# Change the coordinates to a geoPoint
florence['coordinates'] = florence['coordinates'].apply(Point)
florence.head()
Controlliamo il tipo del dataframe florence e della colonna coordinates dei dati florence. È un DataFrame di pandas e una Series di pandas.
type(florence)
pandas.core.frame.DataFrame
type(florence['coordinates'])
pandas.core.series.Series
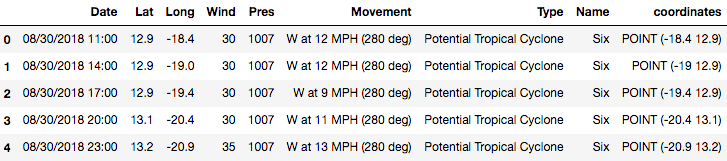
Dopo aver convertito i dati in dati geospaziali, controlleremo di nuovo il tipo del dataframe florence e della colonna coordinates. Ora sono un GeoDataFrame e una GeoSeries.
# Convert the count df to geodf
florence = geopandas.GeoDataFrame(florence, geometry='coordinates')
florence.head()
type(florence)
geopandas.geodataframe.GeoDataFrame
type(florence['coordinates'])
geopandas.geoseries.GeoSeries
Nota che, anche se ora sono un GeoDataFrame e una GeoSeries, si comportano comunque come un normale DataFrame e una Series. Ciò significa che puoi ancora eseguire filtraggi, groupby sul dataframe o estrarre i valori minimo, massimo o medio della colonna.
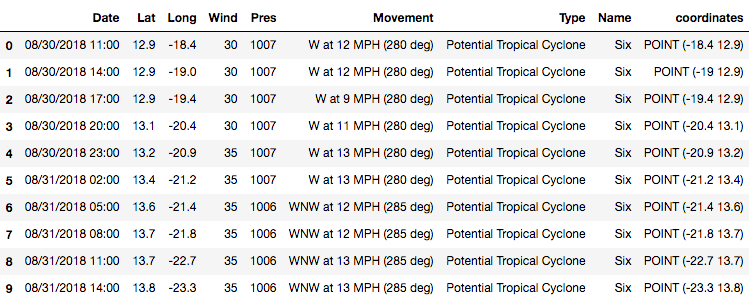
# Filtering from before the hurricane was named.
florence[florence['Name']=='Six']
# Groupping by name to see how many names it has in the data set:
florence.groupby('Name').Type.count()
Name
FLORENCE     6
Florence    85
SIX          4
Six         10
Name: Type, dtype: int64
Trovare la velocità media del vento dell’uragano Florence:
print("Mean wind speed of Hurricane Florence is {} mph and it can go up to {} mph maximum".format(round(florence.Wind.mean(),4),
                                                                                         florence.Wind.max()))
Mean wind speed of Hurricane Florence is 74.4286 mph and it can go up to 140 mph maximum
Quindi la velocità media del vento dell’uragano Florence è di 74,43 miglia orarie (119,78 km orari) e la massima è 140 miglia orarie (225,308 km orari). Per rendere l’idea di quanto sia spaventosa questa velocità, il sito Beaufort Wind Scale, sviluppato dalla Royal Navy britannica, mostra l’aspetto degli effetti del vento sull’acqua e sulla terraferma. Con una velocità tra 48 e 55 miglia orarie, può già spezzare e sradicare alberi e causare "danni strutturali considerevoli".
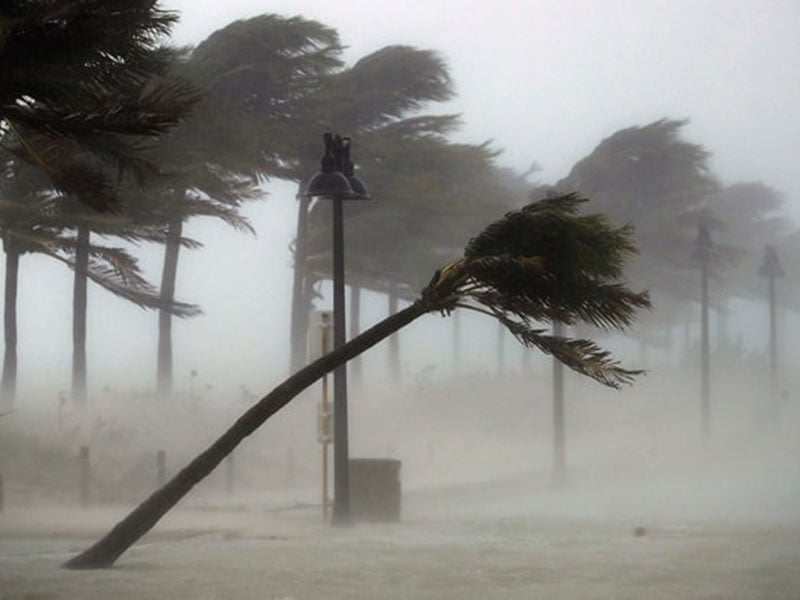
Non vorresti essere lì in quel momento.
Come per un DataFrame di pandas, anche un GeoDataFrame ha l’attributo .plot. Tuttavia, questo attributo usa le coordinate all’interno del GeoDataFrame per rappresentarle sulla mappa. Vediamo:
florence.plot(figsize=(20,10));
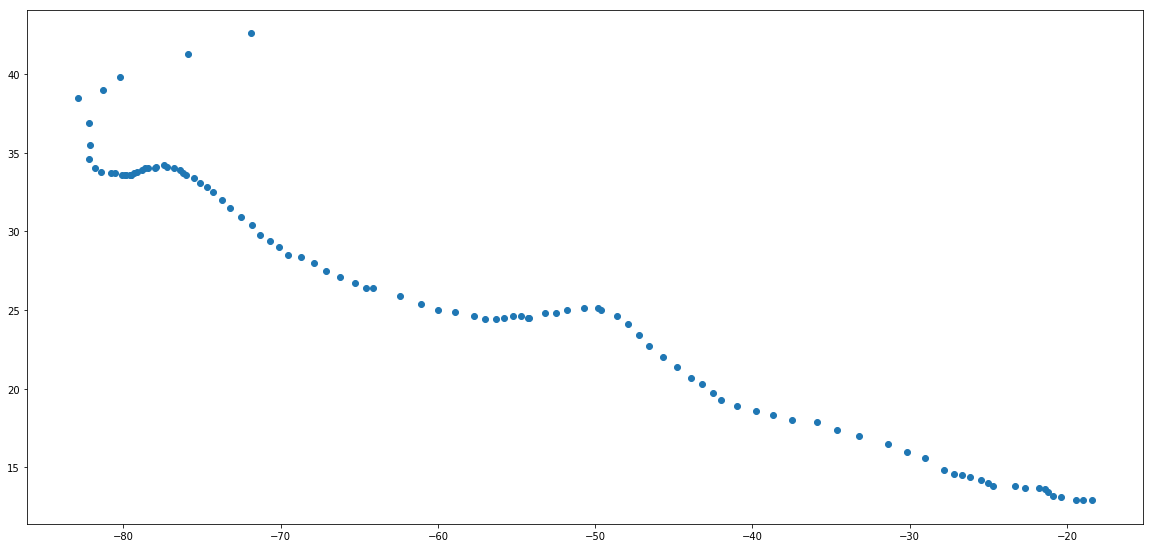
Che è successo? Vedi solo un mucchio di punti senza riferimenti. C’è qualcosa che non va?
No, è tutto a posto. Poiché questo dataframe contiene solo le informazioni di coordinata (posizione) dell’uragano Florence a ogni istante, possiamo solo tracciare la posizione su una mappa vuota.
Il passo successivo è quindi sovrapporre la posizione dell’uragano sulla mappa degli USA per vedere dove ha colpito e quanto fosse forte in quel momento. Per farlo userai le coordinate della mappa degli USA (i dati caricati all’inizio) come base e ci sovrapporrai le posizioni dell’uragano Florence.
 # Plotting to see the hurricane overlay the US map:
fig, ax = plt.subplots(1, figsize=(30,20))
base = country[country['NAME'].isin(['Alaska','Hawaii']) == False].plot(ax=ax, color='#3B3C6E')

# plotting the hurricane position on top with red color to stand out:
florence.plot(ax=base, color='darkred', marker="*", markersize=10);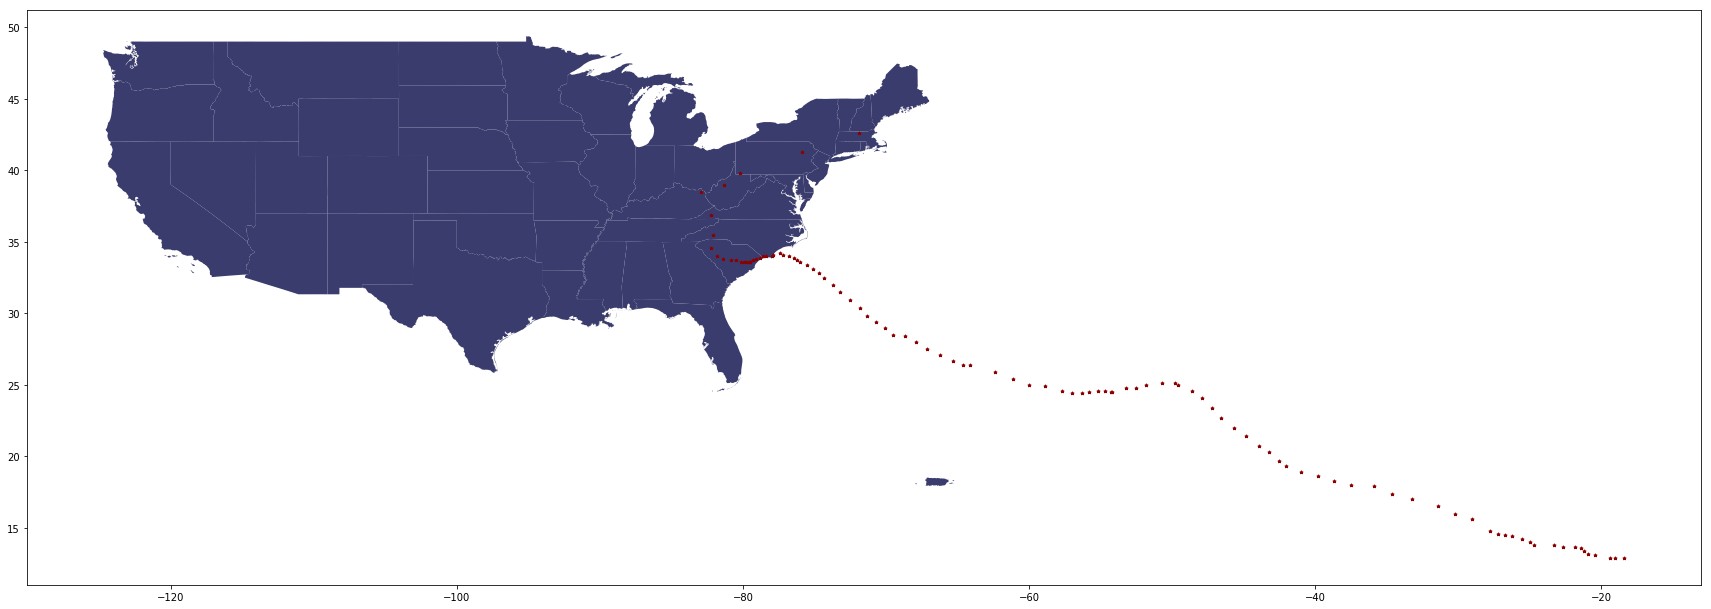
Ottimo! Ora completiamo con qualche dettaglio in più, come:
 fig, ax = plt.subplots(1, figsize=(20,20))
base = country[country['NAME'].isin(['Alaska','Hawaii']) == False].plot(ax=ax, color='#3B3C6E')
florence.plot(ax=base, column='Wind', marker="<", markersize=10, cmap='cool', label="Wind speed(mph)")
_ = ax.axis('off')
plt.legend()
ax.set_title("Hurricane Florence in US Map", fontsize=25)
plt.savefig('Hurricane_footage.png',bbox_inches='tight');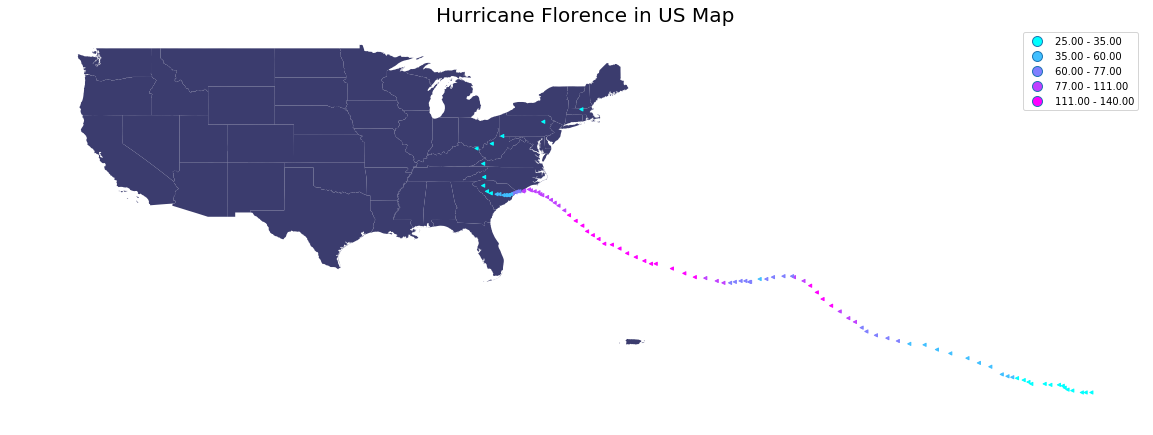
L’uragano è stato più forte quando era al largo vicino alla costa orientale. Avvicinandosi alla terraferma ha iniziato a perdere forza, ma con velocità del vento tra 60 e 77 miglia orarie può comunque causare danni terribili.
Ottimo lavoro! Hai imparato alcuni passaggi necessari per lavorare con i dati geospaziali in Python. Hai anche visto come tracciare i dati geospaziali e personalizzare forma, colore e sovrapposizione dei grafici per raccontare una storia. Se vuoi esercitarti, online trovi una marea di dati geospaziali su cui fare pratica. Un esempio è il sito meteo che ho indicato sopra.
Per le fonti, dai un’occhiata a questo libro: “Python Geospatial Development Essentials” di Karim Bahgat (2015) per una guida più approfondita.
Se vuoi metterti in contatto con me, puoi scrivermi a dqvu.ubc@gmail.com o collegarti con me su LinkedIn. Buono studio e stai al sicuro!
Se vuoi saperne di più sui dati geospaziali in Python, segui il corso di DataCamp Visualizing Geospatial Data in Python.
Qui sotto trovi i dati usati in questo tutorial:
Scopri di più su Python
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



