
Last chance! 50% off DataCamp Premium
Sale ends in
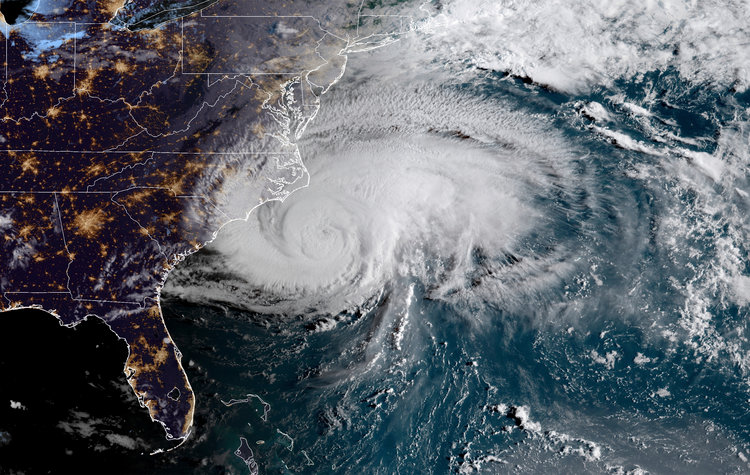
इस ट्यूटोरियल में, आप भू-स्थानिक डेटा के साथ काम करने के लिए लोकप्रिय दो पैकेजों से परिचित होंगे: geopandas और Shapely। फिर आप इन दोनों पैकेजों का उपयोग करके भू-स्थानिक डेटा को Python का उपयोग करते हुए पढ़ेंगे और 30 अगस्त से 18 सितंबर तक हरिकेन फ्लोरेंस के निशान का प्लॉट बनाएंगे।
Spatial data, Geospatial data, GIS data या geodata, ये सभी ऐसे संख्यात्मक डेटा के नाम हैं जो किसी भौतिक वस्तु जैसे इमारत, सड़क, कस्बा, शहर, देश आदि के भौगोलिक स्थान की पहचान भौगोलिक निर्देशांक प्रणाली के अनुसार करते हैं। स्थानिक डेटा से आप न केवल लोकेशन, बल्कि किसी भी वस्तु की लंबाई, आकार, क्षेत्रफल या आकृति भी जान सकते हैं। स्थानिक डेटा के उदाहरण के तौर पर आपको वस्तु के निर्देशांक मिल सकते हैं, जैसे अक्षांश, देशांतर और ऊँचाई। Geographic Information Systems (GIS) या अन्य विशेष सॉफ्टवेयर एप्लिकेशन का उपयोग भू-स्थानिक डेटा तक पहुँचने, उसे देखने, संसाधित करने और विश्लेषित करने के लिए किया जा सकता है।
भू-स्थानिक डेटा का हमारे दैनिक जीवन में बहुत व्यापक उपयोग है। एक उदाहरण वह Maps एप्लिकेशन है जिसका उपयोग आप एक स्थान से दूसरे स्थान तक नेविगेट करने के लिए करते हैं। दूसरा उदाहरण जिसे आप रोज़ देखते होंगे, वह मौसम चैनल है।
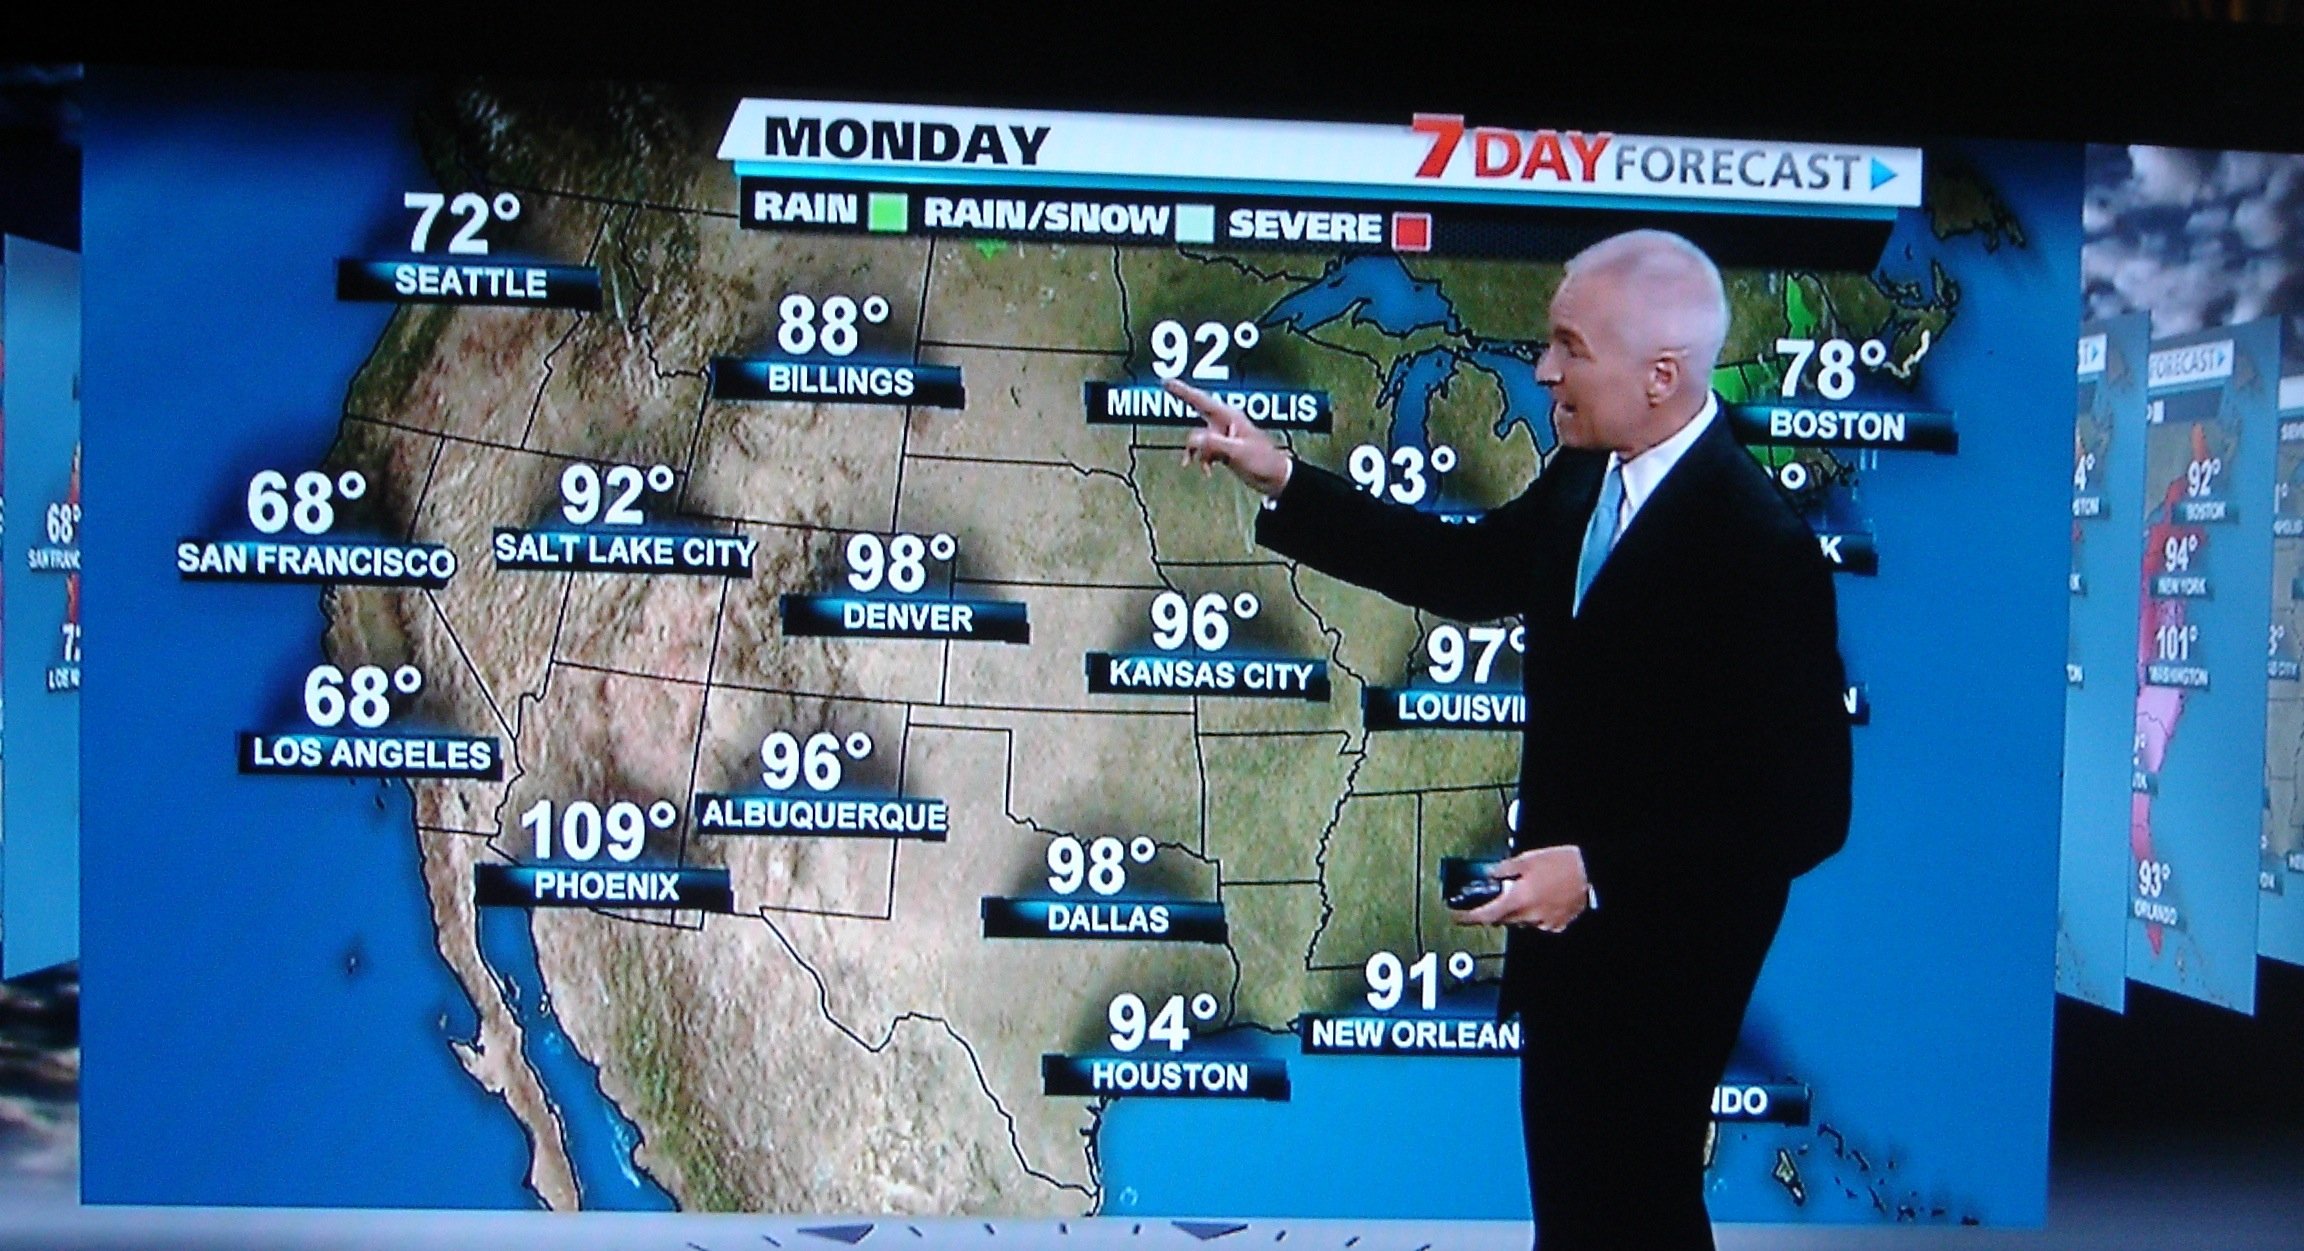
हाँ, भू-स्थानिक डेटा का उपयोग किसी वस्तु की स्थिति संबंधी जानकारी को उसके आसपास की अन्य चीज़ों के संदर्भ में दर्शाने के लिए किया जाता है: शहर के नक्शे पर आपका घर, विश्व मानचित्र पर हरिकेन, आदि। तो इस ट्यूटोरियल में, आप विध्वंसक हरिकेन फ्लोरेंस पर नज़र डालेंगे और उसके लोकेशन को ट्रैक करेंगे।
आगे न बढ़ें। यह एक महत्वपूर्ण भाग है। यदि आपको यकीन नहीं है कि आपने आवश्यकताएँ पूरी कर ली हैं, तो बस दोबारा जाँच लें। सबसे पहले, आपको नीचे दिए गए सभी पैकेज इंस्टॉल करने होंगे।
सब कुछ सही तरह से काम करे, यह सुनिश्चित करने के लिए ऊपर दिए क्रम में सभी पैकेज इंस्टॉल करें। कुछ पैकेज अन्य के लिए पूर्व-आवश्यक हैं, उदाहरण के लिए: GeoPandas को इंस्टॉल करने के लिए Shapely चाहिए, और Shapely इंस्टॉल करने के लिए RTree, GDAL, और Fiona पहले से इंस्टॉल होने चाहिए। किसी पैकेज को इंस्टॉल करने का सबसे आसान तरीका है: pip install PACKAGE_NAME
यदि आप Windows उपयोग कर रहे हैं और इस तरह पैकेज इंस्टॉल नहीं हो रहा, तो इस वेबसाइट को देखें, संबंधित पैकेज डाउनलोड करें और pip install PATH_TO_PACKAGE चलाएँ।
जैसा कि आप जानते हैं, भयावह हरिकेन फ्लोरेंस हाल ही में संयुक्त राज्य के पूर्वी तट के एक हिस्से से गुज़रा, जिससे अनुमानित 17 अरब USD का नुकसान हुआ। यह ट्यूटोरियल आपको यह पता लगाने में मदद करेगा कि यह कहाँ से आया, कब और कहाँ यह अधिक शक्तिशाली हुआ, और इस प्राकृतिक आपदा के बारे में अधिक समझ विकसित करते हुए इसे Python में विश्लेषित करेगा। इस हरिकेन के बारे में जानकारी देने वाली कई वेबसाइटें हैं। उदाहरण के लिए, इस वेबसाइट ने 1902 से 2018 तक अमेरिका में कई तूफानों और हरिकेनों के लिए डेटा प्रदान किया है, इसलिए आगे काम करने के लिए आपके पास ढेर सारा डेटा उपलब्ध है। इस ट्यूटोरियल के लिए, आप केवल हरिकेन फ्लोरेंस डेटा का उपयोग करेंगे।
आप इंटरनेट से अमेरिका के मानचित्र का भू-स्थानिक डेटा भी उपयोग करेंगे। Eric Celeste के ब्लॉग पोस्ट में अमेरिका की काउंटी और राज्यों के लिए सभी प्रकार की सीमा संबंधी डेटा फ़ाइलें हैं। इस ट्यूटोरियल में उपयोग किया गया डेटा US States, 5m, GeoJSON फ़ाइल है।
 # Load all importance packages
import geopandas
import numpy as np
import pandas as pd
from shapely.geometry import Point

import missingno as msn

import seaborn as sns
import matplotlib.pyplot as plt

% matplotlib inline
सबसे पहले, आइए पहले भू-स्थानिक डाटाफ़्रेम पर नज़र डालते हैं: US States Geodata
# Getting to know GEOJSON file:
country = geopandas.read_file("data/gz_2010_us_040_00_5m.json")
country.head()
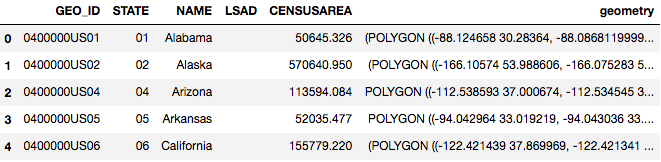
अभी-अभी आपने जो डाटाफ़्रेम लोड किया है, उसका प्रकार जाँचते हुए आप देख सकते हैं कि यह Geo Data Frame है, जिसमें Pandas DataFrame की सभी सामान्य विशेषताएँ होती हैं।
type(country)
geopandas.geodataframe.GeoDataFrame
निर्देशांक रखने वाले कॉलम के डेटा टाइप की जाँच: यह GeoSeries है।
type(country.geometry)
geopandas.geoseries.GeoSeries
GeoSeries की प्रत्येक वैल्यू एक Shapely ऑब्जेक्ट होती है। यह हो सकती है:
प्रत्येक ऑब्जेक्ट का उपयोग अलग-अलग प्रकार की भौतिक वस्तु के लिए किया जा सकता है: जैसे इमारत के लिए Point, सड़क के लिए Line, शहर के लिए Polygon, और कई शहरों वाले देश के लिए MultiPolygon। प्रत्येक ज्यामितीय ऑब्जेक्ट के बारे में अधिक जानकारी के लिए यह लेख पढ़ें: https://shapely.readthedocs.io/en/stable/manual.html#geometric-objects
type(country.geometry[0])
shapely.geometry.multipolygon.MultiPolygon
Pandas DataFrame की तरह, GeoDataFrame में भी plot एट्रिब्यूट होता है, जो डाटाफ़्रेम के भीतर मौजूद geometry का उपयोग करके मानचित्र प्लॉट करता है:
country.plot()
<matplotlib.axes._subplots.AxesSubplot at 0x1cfe68c1358>
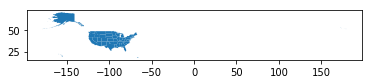
जैसा कि आप देख सकते हैं, US का मानचित्र फ़्रेम की तुलना में अपेक्षाकृत छोटा है। इसका कारण यह है कि जानकारी में अलास्का, हवाई और प्यूर्टो रिको शामिल हैं, जो बिखरे हुए हैं। इस ट्यूटोरियल के उद्देश्य से, आप अलास्का और हवाई को बाहर कर सकते हैं क्योंकि हरिकेन उन दोनों राज्यों के पास नहीं गया था। आप अपने प्लॉट को कस्टमाइज़ करने के लिए फ़िगर साइज और रंग भी जोड़ सकते हैं:
# Exclude Alaska and Hawaii for now
country[country['NAME'].isin(['Alaska','Hawaii']) == False].plot(figsize=(30,20), color='#3B3C6E');
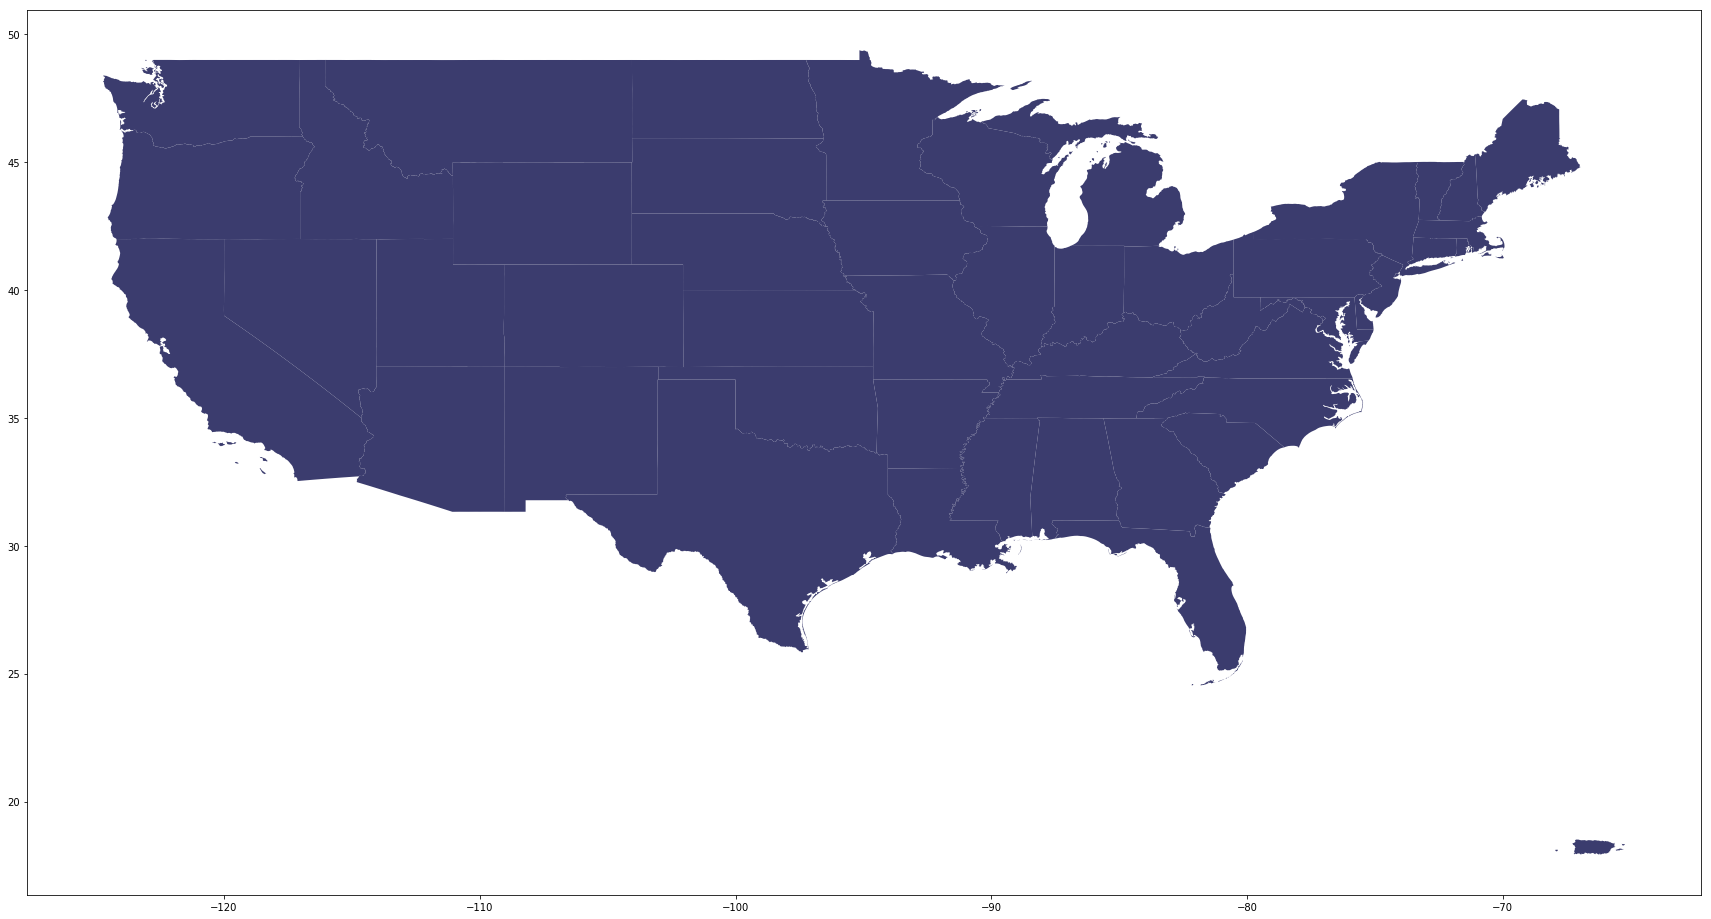
ज़्यादा मुश्किल नहीं, है न! अब जब आपके पास US का मानचित्र है, तो आइए हरिकेन डेटा लोड करते हैं:
florence = pd.read_csv('data/florence.csv')
florence.head()
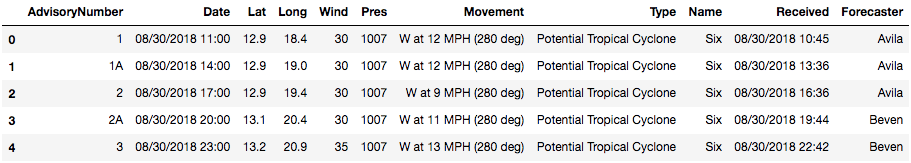
जब भी आप कोई डेटासेट लोड करते हैं, यह हमेशा पहला कदम होता है:
florence.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 105 entries, 0 to 104
Data columns (total 11 columns):
AdvisoryNumber    105 non-null object
Date              105 non-null object
Lat               105 non-null float64
Long              105 non-null float64
Wind              105 non-null int64
Pres              105 non-null int64
Movement          105 non-null object
Type              105 non-null object
Name              105 non-null object
Received          105 non-null object
Forecaster        104 non-null object
dtypes: float64(2), int64(2), object(7)
memory usage: 9.1+ KB
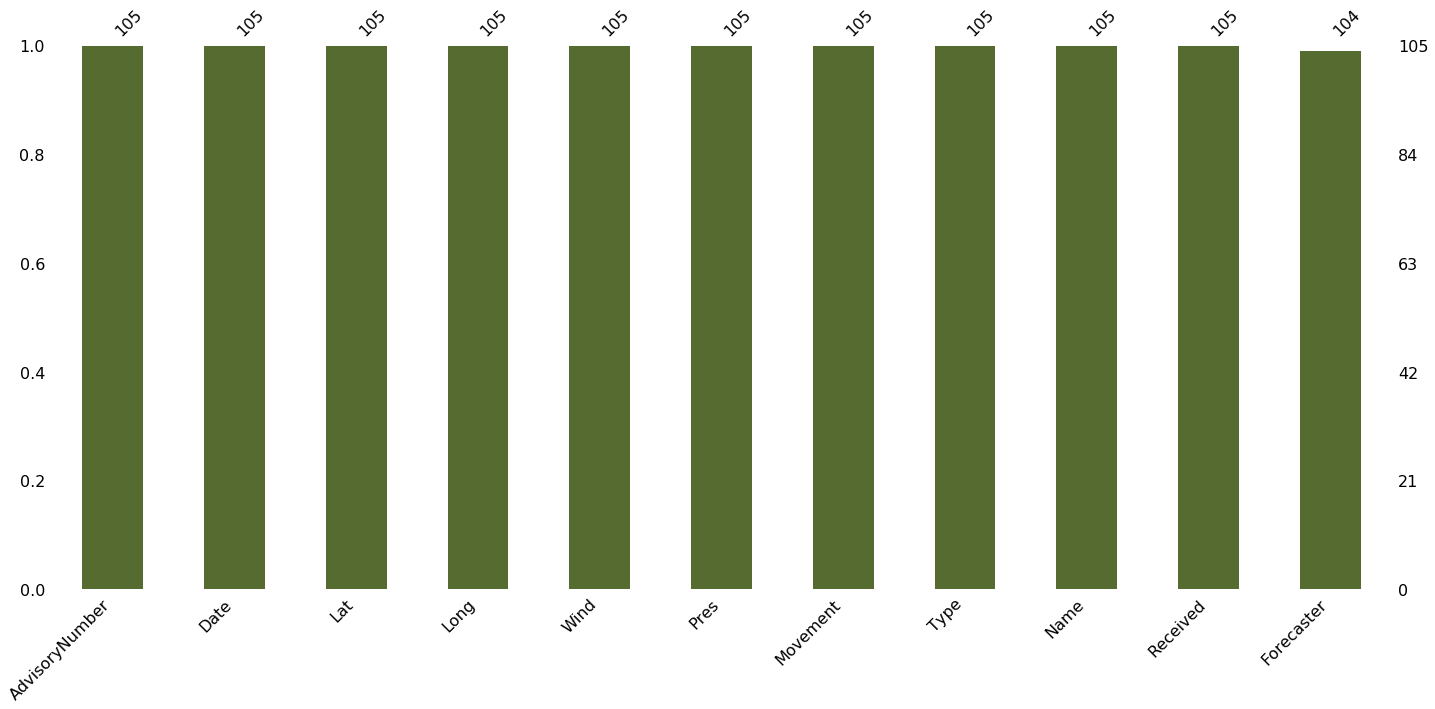
missingno पैकेज का उपयोग करके मिसिंग वैल्यू जाँचना। यह एक उपयोगी पैकेज है जो विज़ुअलाइज़ेशन के माध्यम से मिसिंग डेटा दिखाता है। जैसा कि आप नीचे देख सकते हैं, "Forecaster" कॉलम में केवल एक मिसिंग वैल्यू है, जिसकी आपको इस ट्यूटोरियल में आवश्यकता नहीं है। इसलिए फिलहाल आप इसे नज़रअंदाज़ कर सकते हैं।
# Notice you can always adjust the color of the visualization
msn.bar(florence, color='darkolivegreen');
कुछ सांख्यिकीय जानकारी देखें; कुछ बहुत उपयोगी हो सकती हैं, जैसे औसत पवन गति, इस हरिकेन की अधिकतम और न्यूनतम पवन गति, आदि।
# Statistical information
florence.describe()
| Lat | Long | Wind | Pres | |
|---|---|---|---|---|
| count | 105.000000 | 105.000000 | 105.000000 | 105.000000 |
| mean | 25.931429 | 56.938095 | 74.428571 | 981.571429 |
| std | 7.975917 | 20.878865 | 36.560765 | 22.780667 |
| min | 12.900000 | 18.400000 | 25.000000 | 939.000000 |
| 25% | 18.900000 | 41.000000 | 40.000000 | 956.000000 |
| 50% | 25.100000 | 60.000000 | 70.000000 | 989.000000 |
| 75% | 33.600000 | 76.400000 | 105.000000 | 1002.000000 |
| max | 42.600000 | 82.900000 | 140.000000 | 1008.000000 |
अधिकांश डेटा के लिए, आपको सफ़ाई करनी होगी और केवल वही लेना होगा जिसकी आपको ज़रूरत है। यहाँ, आपको केवल समय, निर्देशांक: अक्षांश और देशांतर, पवन गति, दाब, और नाम चाहिए। Movement और Type वैकल्पिक हैं, लेकिन बाकी को हटाया जा सकता है।
# dropping all unused features:
florence = florence.drop(['AdvisoryNumber', 'Forecaster', 'Received'], axis=1)
florence.head()
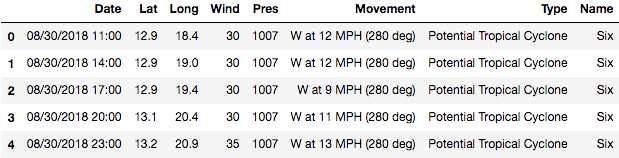
आम तौर पर, यदि आप केवल डेटा को ही प्लॉट करते हैं, तो निर्देशांकों के लिए अतिरिक्त सावधानी की आवश्यकता नहीं होती। हालांकि, यदि आप चाहते हैं कि यह मानचित्र पर जैसा दिखता है वैसा दिखे, तो देशांतर और अक्षांश की जाँच करना महत्वपूर्ण है। यहाँ देशांतर पश्चिम में है, आपको डेटा को सही ढंग से प्लॉट करने के लिए संख्या के आगे "-" जोड़ना होगा:
# Add "-" in front of the number to correctly plot the data:
florence['Long'] = 0 - florence['Long']
florence.head()
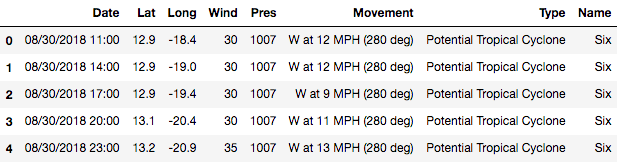
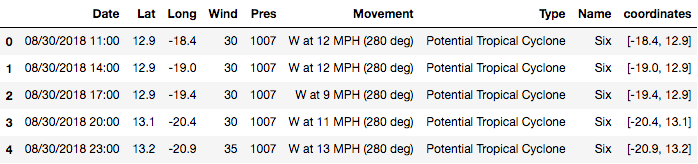
फिर आप अक्षांश और देशांतर को मिलाकर हरिकेन के निर्देशांक बना सकते हैं, जिन्हें बाद में विज़ुअलाइज़ेशन के लिए GeoPoint में बदला जाएगा।
# Combining Lattitude and Longitude to create hurricane coordinates:
florence['coordinates'] = florence[['Long', 'Lat']].values.tolist()
florence.head()
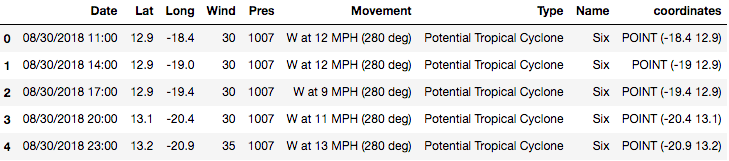
# Change the coordinates to a geoPoint
florence['coordinates'] = florence['coordinates'].apply(Point)
florence.head()
florence डाटाफ़्रेम और florence डेटा के coordinates कॉलम के प्रकार की जाँच। ये pandas DataFrame और pandas Series हैं।
type(florence)
pandas.core.frame.DataFrame
type(florence['coordinates'])
pandas.core.series.Series
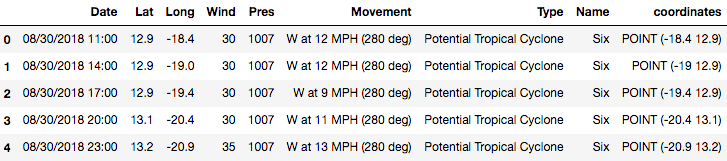
डेटा को भू-स्थानिक डेटा में बदलने के बाद, हम florence डाटाफ़्रेम और Florence डेटा के coordinates कॉलम के प्रकार को फिर से जाँचेंगे। अब ये Geo DataFrame और GeoSeries हैं।
# Convert the count df to geodf
florence = geopandas.GeoDataFrame(florence, geometry='coordinates')
florence.head()
type(florence)
geopandas.geodataframe.GeoDataFrame
type(florence['coordinates'])
geopandas.geoseries.GeoSeries
ध्यान दें कि भले ही अब यह Geo DataFrame और Geo Series है, फिर भी यह एक सामान्य DataFrame और Series की तरह ही व्यवहार करता है। यानी आप अब भी डाटाफ़्रेम पर फ़िल्टरिंग, groupby कर सकते हैं या कॉलम के न्यूनतम, अधिकतम, या औसत मान निकाल सकते हैं।
# Filtering from before the hurricane was named.
florence[florence['Name']=='Six']
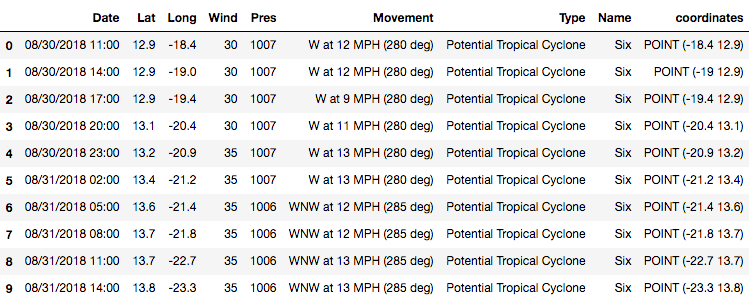
# Groupping by name to see how many names it has in the data set:
florence.groupby('Name').Type.count()
Name
FLORENCE     6
Florence    85
SIX          4
Six         10
Name: Type, dtype: int64
हरिकेन फ्लोरेंस की औसत पवन गति निकालना:
print("Mean wind speed of Hurricane Florence is {} mph and it can go up to {} mph maximum".format(round(florence.Wind.mean(),4),
                                                                                         florence.Wind.max()))
Mean wind speed of Hurricane Florence is 74.4286 mph and it can go up to 140 mph maximum
तो हरिकेन फ्लोरेंस की औसत पवन गति 74.43 मील प्रति घंटा (119.78 किमी प्रति घंटा) है और अधिकतम 140 मील प्रति घंटा (225.308 किमी प्रति घंटा) है। यह पवन गति कितनी भयावह हो सकती है, इसे समझने के लिए, U.K Royal Navy द्वारा विकसित Beaufort Wind Scale पानी और भूमि पर हवा के प्रभाव का रूप दिखाती है। 48 से 55 मील प्रति घंटा की गति पर भी, यह पेड़ों को तोड़ और उखाड़ सकती है, और "काफी संरचनात्मक क्षति" पहुँचा सकती है।
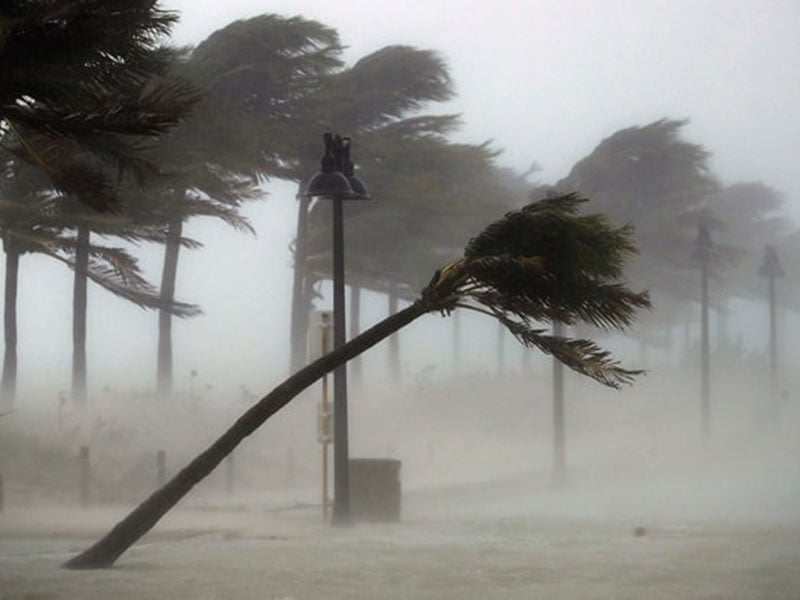
आप उस समय वहाँ होना नहीं चाहेंगे।
pandas DataFrame की तरह, GeoDataFrame में भी .plot एट्रिब्यूट होता है। हालाँकि, यह एट्रिब्यूट GeoDataFrame के भीतर मौजूद निर्देशांकों का उपयोग करके मानचित्रण करता है। आइए देखें:
florence.plot(figsize=(20,10));
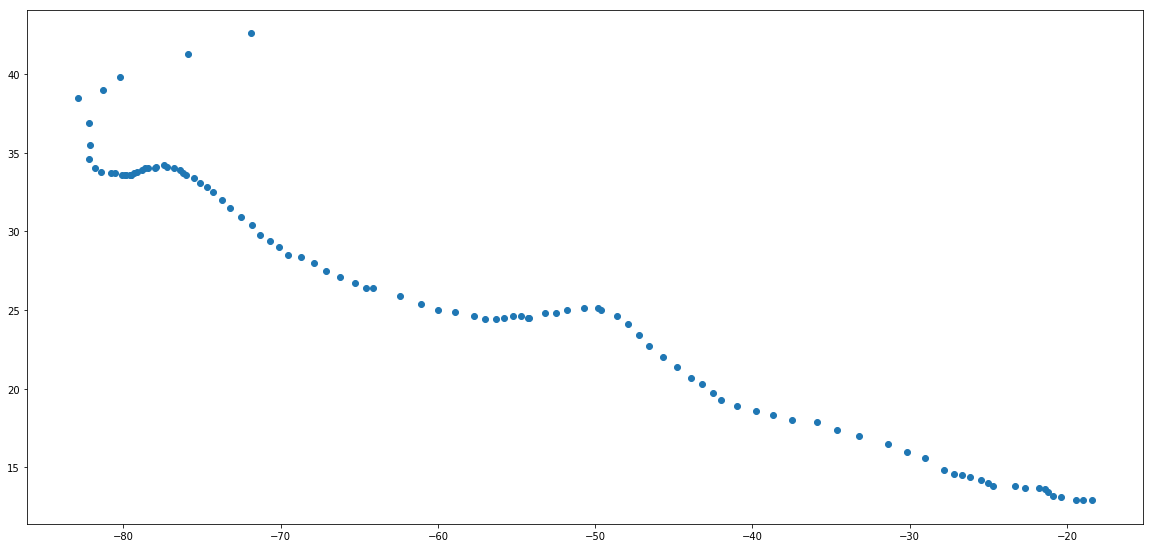
क्या हुआ? आपको बिना किसी नेविगेशन के बस बिंदुओं का एक समूह दिखाई दे रहा है। क्या कुछ गलत है?
नहीं, सब ठीक है। क्योंकि इस डाटाफ़्रेम में हर समय-बिंदु पर हरिकेन फ्लोरेंस की केवल निर्देशांक (लोकेशन) जानकारी है, इसलिए हम केवल खाली मानचित्र पर स्थिति ही प्लॉट कर सकते हैं।
तो, अगला कदम US मानचित्र पर हरिकेन की स्थिति को प्लॉट करना है ताकि देखें कि यह कहाँ टकराया और उस समय इसकी ताकत कितनी थी। ऐसा करने के लिए, आप US मानचित्र के निर्देशांकों (शुरुआत में लोड किया गया डेटा) को बेस के रूप में उपयोग करेंगे और उसके ऊपर हरिकेन फ्लोरेंस की स्थिति प्लॉट करेंगे।
 # Plotting to see the hurricane overlay the US map:
fig, ax = plt.subplots(1, figsize=(30,20))
base = country[country['NAME'].isin(['Alaska','Hawaii']) == False].plot(ax=ax, color='#3B3C6E')

# plotting the hurricane position on top with red color to stand out:
florence.plot(ax=base, color='darkred', marker="*", markersize=10);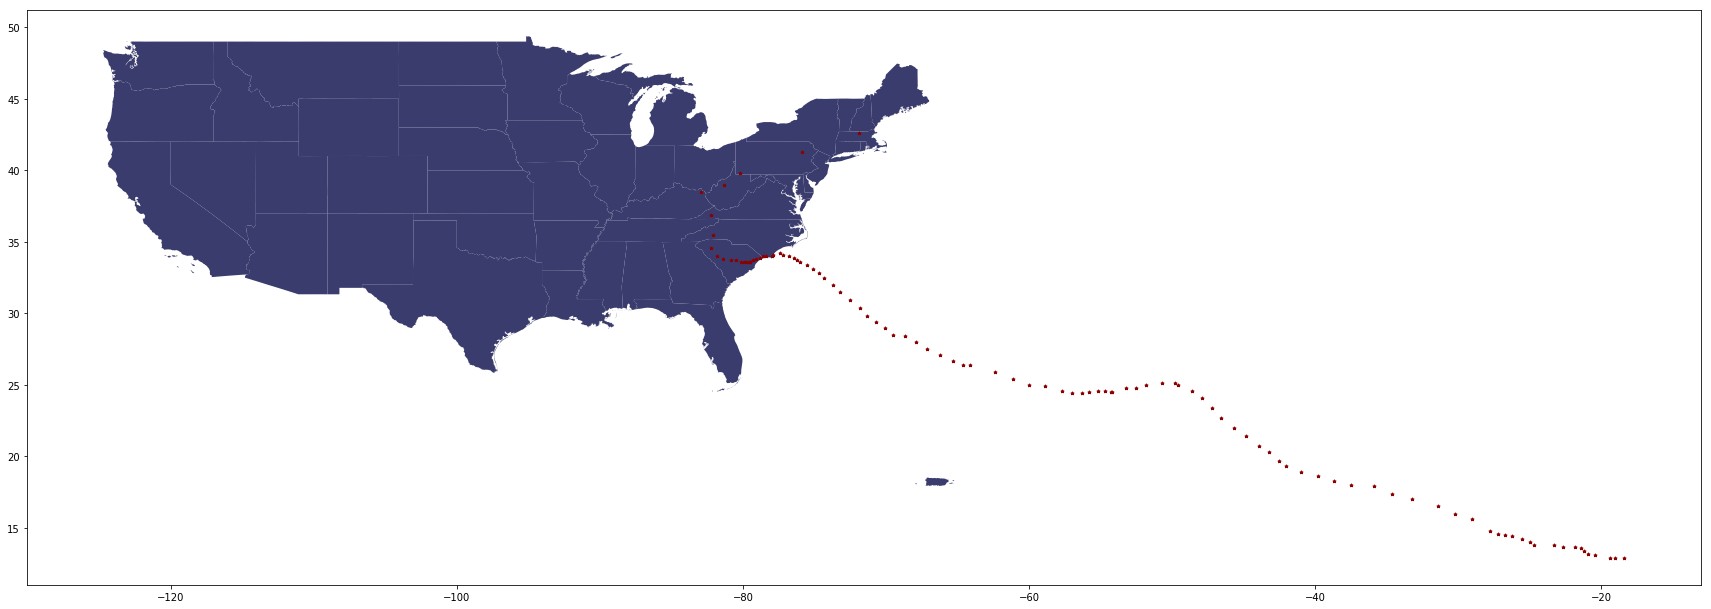
बहुत बढ़िया दिख रहा है! अब, हम इसे कुछ और विवरणों के साथ पूरा करेंगे, जैसे:
 fig, ax = plt.subplots(1, figsize=(20,20))
base = country[country['NAME'].isin(['Alaska','Hawaii']) == False].plot(ax=ax, color='#3B3C6E')
florence.plot(ax=base, column='Wind', marker="<", markersize=10, cmap='cool', label="Wind speed(mph)")
_ = ax.axis('off')
plt.legend()
ax.set_title("Hurricane Florence in US Map", fontsize=25)
plt.savefig('Hurricane_footage.png',bbox_inches='tight');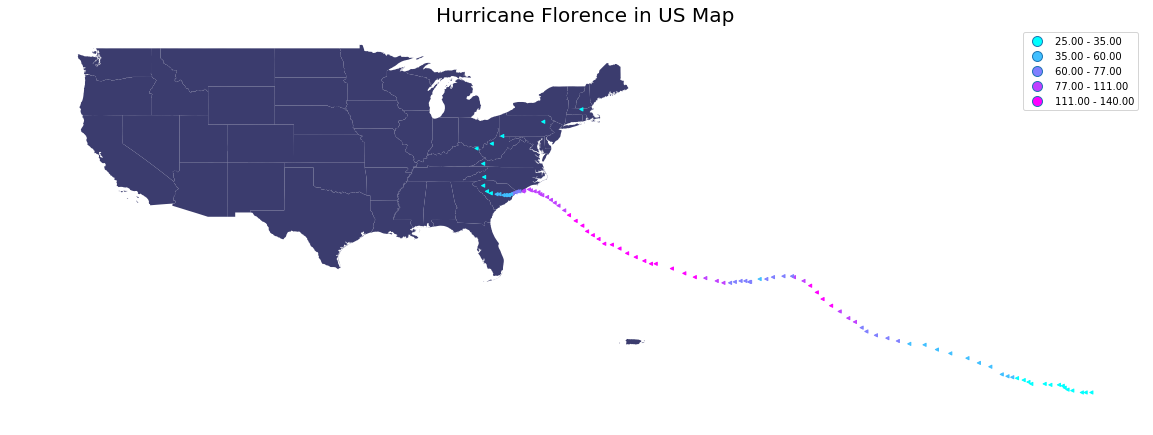
तो हरिकेन अपनी अधिकतम ताकत तब पर था जब वह पूर्वी तट के पास अपतटीय क्षेत्र में था। जैसे-जैसे वह भूमि के करीब आया, उसकी ताकत कम होने लगी, लेकिन 60 से 77 मील प्रति घंटा की पवन गति की सीमा में भी, यह भयंकर नुकसान पहुँचा सकता है।
शानदार काम! आपने Python में भू-स्थानिक डेटा के साथ काम करने के कुछ ज़रूरी चरण सीख लिए हैं। आपने यह भी सीखा कि भू-स्थानिक डेटा को कैसे प्लॉट किया जाए और किसी कहानी को दिखाने के लिए प्लॉट्स के आकार, रंग और ओवरले को कैसे कस्टमाइज़ किया जाए। यदि आप अपने कौशल का अभ्यास करना चाहते हैं, तो आज़माने के लिए ऑनलाइन ढेर सारा भू-स्थानिक डेटा उपलब्ध है। एक उदाहरण ऊपर दिया गया मौसम संबंधी वेबसाइट है।
स्रोतों के लिए, कृपया इस पुस्तक पर नज़र डालें: Karim Bahgat (2015) द्वारा “Python Geospatial Development Essentials” गहन मार्गदर्शन के लिए।
यदि आप मुझसे संपर्क करना चाहें, तो आप मुझे dqvu.ubc@gmail.com पर ईमेल भेज सकते हैं या LinkedIn के माध्यम से जुड़ सकते हैं। सीखने का आनंद लें और सुरक्षित रहें!
यदि आप Python में भू-स्थानिक डेटा के बारे में और सीखना चाहते हैं, तो DataCamp का Visualizing Geospatial Data in Python कोर्स लें।
नीचे इस ट्यूटोरियल में उपयोग किया गया डेटा है:
Python के बारे में और जानें
कोर्स
कोर्स
कोर्स