트랙
개발자를 위한 AI 엔지니어 보조
26시간
다른 모델을 위해 만들어진 코딩 에이전트 안에 오픈 웨이트 모델을 돌려 본 적이 있다면, 그다지 좋은 생각이 아니라는 걸 아실 겁니다.
대개 모델이 도구 스키마를 잘못 해석하고, 멈출 때까지 같은 실패한 명령을 반복 실행합니다. 에이전트가 원래 설계된 모델로 돌아가면, 똑같은 작업이 문제없이 진행되지요. 문제는 보통 모델 자체가 아니라, 그 주위를 감싸는 에이전트 하니스에 있습니다. 프롬프트와 도구 형식이 다른 모델에 맞춰 튜닝되어 있기 때문입니다.
Open Interpreter는 Claude Code나 Kimi Code처럼 각 모델이 튜닝된 하니스를 에뮬레이션하여 이를 해결합니다. 터미널에서 실행되는 오픈 소스 AI 코딩 에이전트로, 현재 버전은 여러분이 기억하는 파이썬 기반 컴퓨터 어시스턴트가 아니라 OpenAI의 Codex를 기반으로 한 러스트 프로젝트입니다.
이 글에서는 설치 방법, 모델 및 하니스 설정, 실제 코딩 워크플로우, 그리고 Open Interpreter가 Claude Code, OpenCode, Codex와 어떻게 비교되는지 살펴보겠습니다.
AI 에이전트가 처음이신가요? 오후 한나절 만에 기본기를 익히는 Introduction to AI Agents 과정을 수강해 보세요.
Open Interpreter는 AI 모델이 여러분의 프로젝트와 개발자가 사용하는 도구에 접근할 수 있도록 해줍니다.
해야 할 일을 평이한 영어로만 설명하면, 에이전트가 코드를 작업합니다. 다음을 다룰 수 있습니다.
이 프로젝트는 Apache 2.0 라이선스의 오픈 소스입니다. 또한 특정 모델 제공자에 제한되지 않습니다. 호스팅된 모델, 오픈 웨이트 모델, 로컬에서 실행되는 모델을 연결할 수 있습니다.
메인 리포지토리는 2026년 9월 기준으로 GitHub 스타 68,000개 이상을 보유하고 있습니다.
Open Interpreter는 다음과 같은 루프로 작동합니다.
일부 단계는 권한 설정에 따라 사전 승인이 필요합니다. 보안 섹션에서 다루겠습니다.
보다 시각적인 개요는 아래와 같습니다.
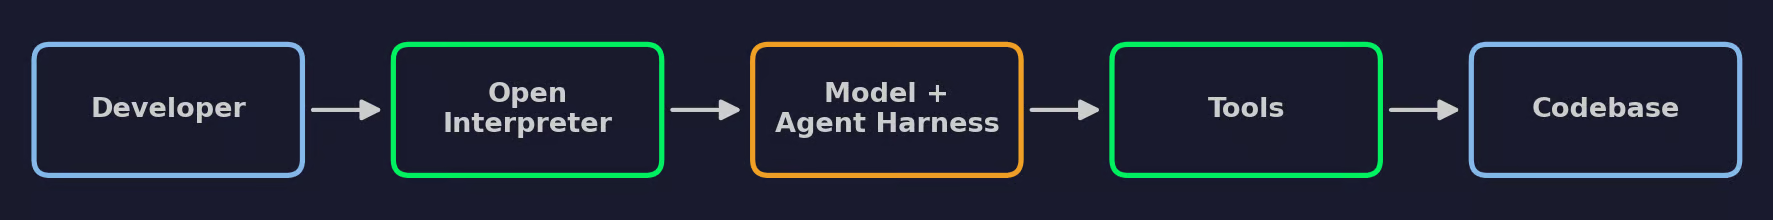
Open Interpreter의 동작 방식
기억해야 할 점은, 여러분이 모델과 직접 대화하지 않는다는 것입니다. Open Interpreter가 작업을 활성 하니스의 프롬프트와 도구 정의로 포맷해 모델에 보냅니다. 모델이 도구 호출을 요청하면, Open Interpreter가 코드베이스에 대해 이를 실행합니다. 그런 다음 결과가 다음 단계 처리를 위해 모델로 다시 전달됩니다.
모델과 하니스는 별도의 레이어이므로, 나머지 설정을 건드리지 않고도 어느 한쪽만 교체할 수 있습니다.
Open Interpreter는 독립 실행형 바이너리로 설치되므로 Python이나 pip가 필요 없습니다.
예전 블로그 글에서 pip install open-interpreter를 실행하라고 안내한다면, 레거시 파이썬 버전을 설명하는 것입니다. 그 커맨드로는 이 글에서 다루는 러스트 기반 코딩 에이전트를 설치할 수 없습니다.
머신에 Git도 설치해 두면 좋습니다. Git 없이도 실행되지만, Git이 있으면 리포지토리 인식 세션과 diff를 사용할 수 있습니다.
터미널에서 설치 스크립트를 실행하세요.
curl -fsSL https://www.openinterpreter.com/install | sh스크립트는 플랫폼에 맞는 릴리스를 다운로드하고 interpreter 명령을 ~/.local/bin에 배치합니다.
PowerShell을 열고 다음을 실행하세요.
irm https://www.openinterpreter.com/install.ps1 | iexLinux 스타일 구성을 선호한다면 WSL도 지원됩니다. 그 경우 WSL 터미널에서 macOS 및 Linux용 명령을 실행하세요.
터미널을 재시작해 새로운 PATH를 반영한 뒤, 버전을 확인하세요.
interpreter --version버전 번호가 보이면 설치가 완료된 것입니다.
Open Interpreter 버전 확인
아무 디렉터리에서나 세션을 시작합니다.
interpreter같은 명령의 짧은 별칭인 i를 입력해도 됩니다.
Open Interpreter는 평이한 영어로 작업을 설명하는 터미널 UI를 엽니다. 첫 실행 시 모델 제공자 연결을 요청합니다. 다음 섹션에서는 Ollama를 통해 로컬 모델을 사용할 것이므로, 지금은 이 단계를 건너뛸 수 있습니다.
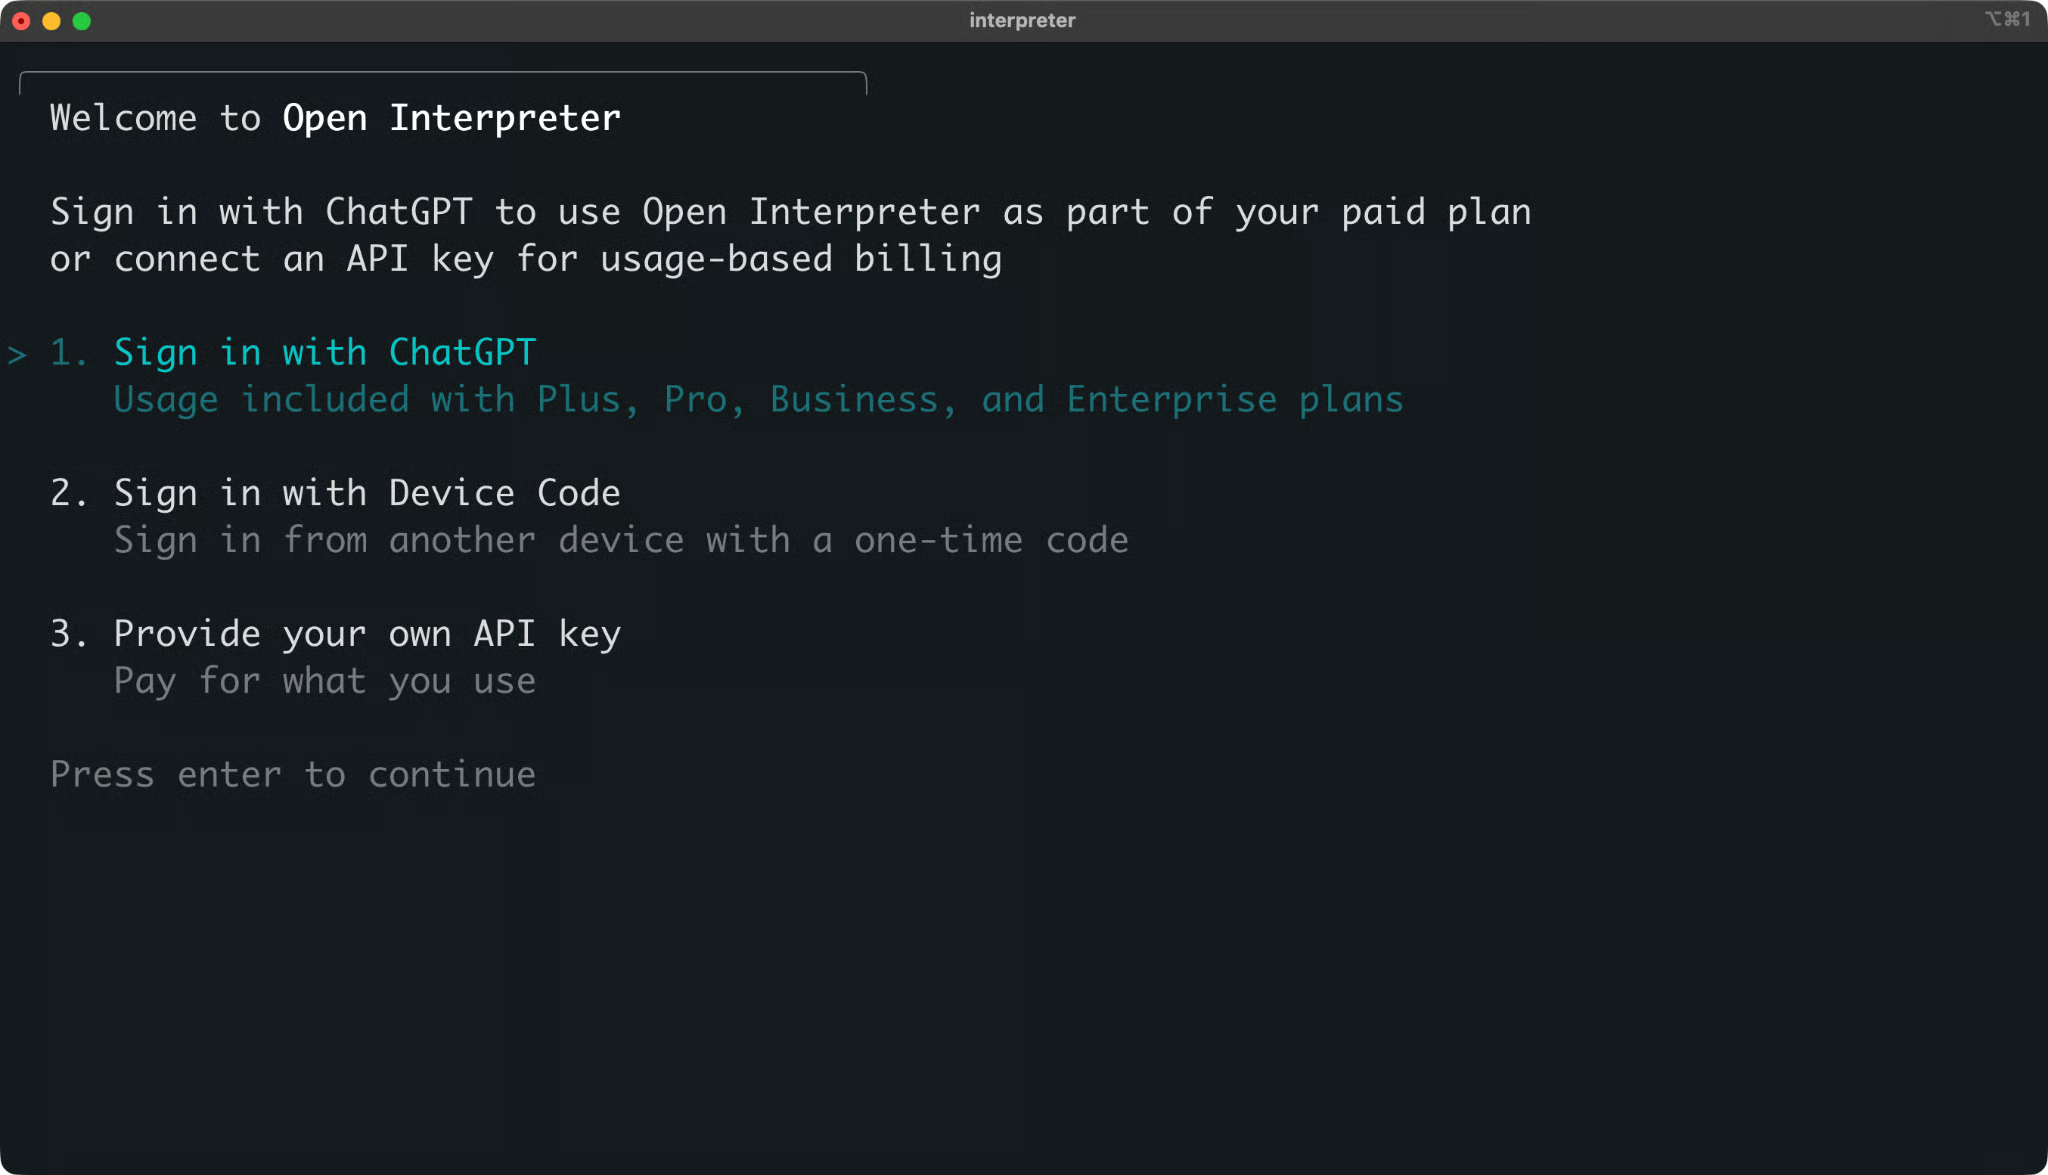
Open Interpreter 대화형 세션
세션을 종료하려면 /exit를 입력하세요.
코딩 에이전트를 가장 빨리 이해하는 방법은 작업을 하나 맡겨 보고 어떻게 처리하는지 보는 것입니다.
이 섹션 전체에서 작은 습관 추적기 프로젝트를 사용하겠습니다. 함수 하나, 테스트 파일 하나, 그리고 버그 하나가 있습니다.
이 프로젝트는 어떤 습관의 연속된 일수 중 최장 스트릭을 계산합니다. 예를 들어 며칠 연속으로 운동했는지를 계산합니다.
프로젝트 폴더와 가상 환경부터 시작하세요.
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytesthabits.py를 다음 코드로 생성하세요.
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
다음으로 test_habits.py를 생성합니다.
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
이 함수에는 버그가 있습니다. 지적하지는 않겠습니다. 찾아내는 것은 에이전트의 몫이니까요.
가상 환경과 캐시 파일이 리포지토리에 포함되지 않도록 .gitignore 파일을 추가하세요.
.venv/
__pycache__/
.pytest_cache/
이제 프로젝트를 커밋합니다.
git init
git add .
git commit -m "Initial commit"
이 커밋은 깔끔한 시작점을 제공합니다. 이후 에이전트가 정확히 무엇을 바꿨는지 확인하는 데 사용합니다.
버그를 확인하기 위해 테스트를 실행하세요.
python -m pytest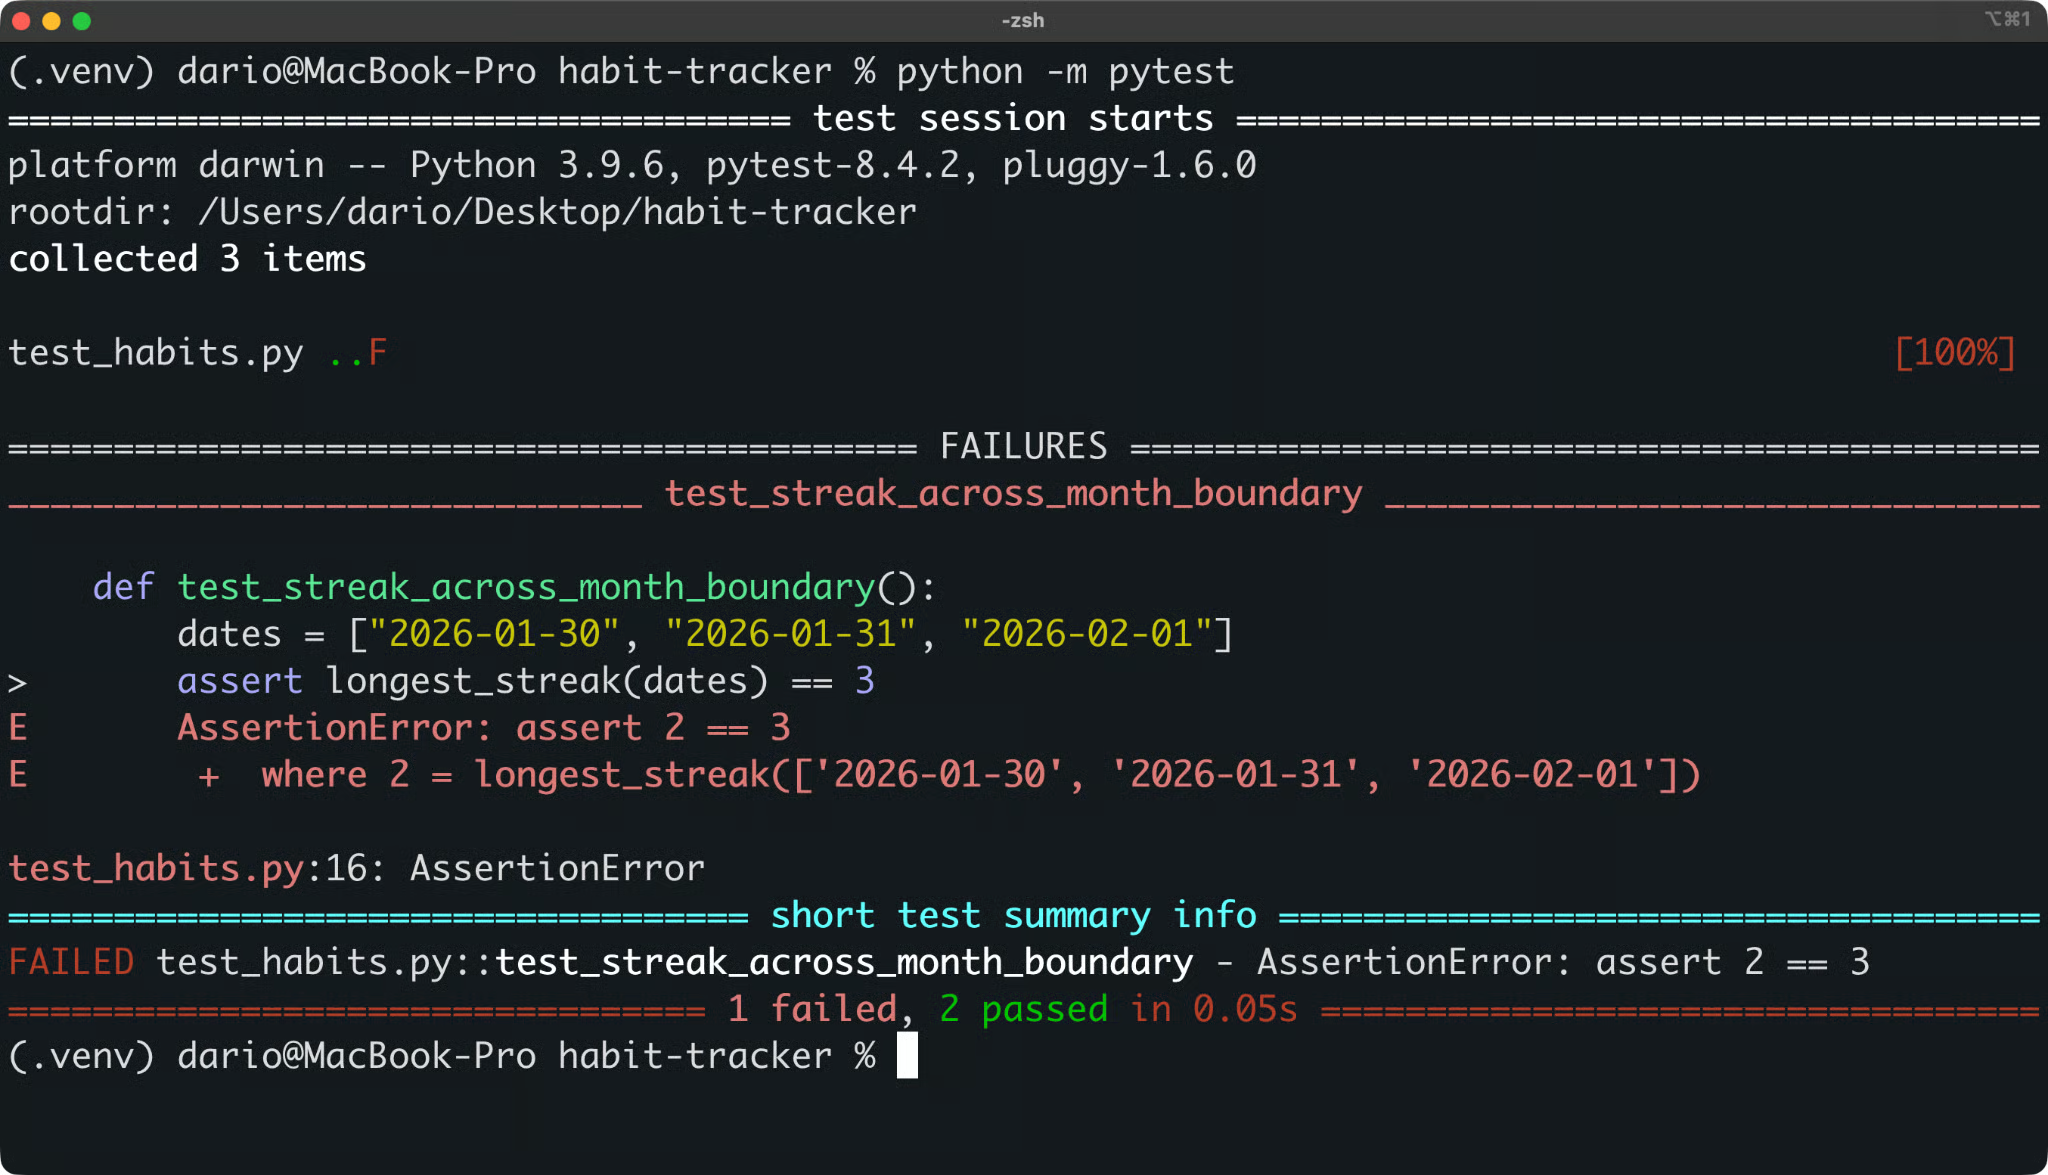
습관 추적기 테스트 결과
두 테스트는 통과하고, 하나는 실패합니다. 이것이 Open Interpreter가 해결해야 할 문제입니다.
먼저 Ollama를 설치하고 실행해야 합니다. 또한 도구 호출을 지원하는 모델이 필요하므로, 다음을 pull하세요.
ollama pull qwen3-coder:30b그런 다음 프로젝트 폴더에서 Open Interpreter를 시작합니다. 가상 환경에 설치된 pytest를 에이전트가 사용할 수 있도록 같은 터미널을 사용하세요.
interpreter --oss --local-provider ollama -m qwen3-coder:30b각 플래그는 다음을 의미합니다.
--oss: 로컬 오픈 소스 제공자를 사용
--local-provider ollama: LM Studio 대신 Ollama를 선택
-m qwen3-coder:30b: 이번 실행에 사용할 모델 지정
활성 제공자, 모델, 샌드박스 모드, 승인 정책을 확인하려면 /status를 실행하세요.
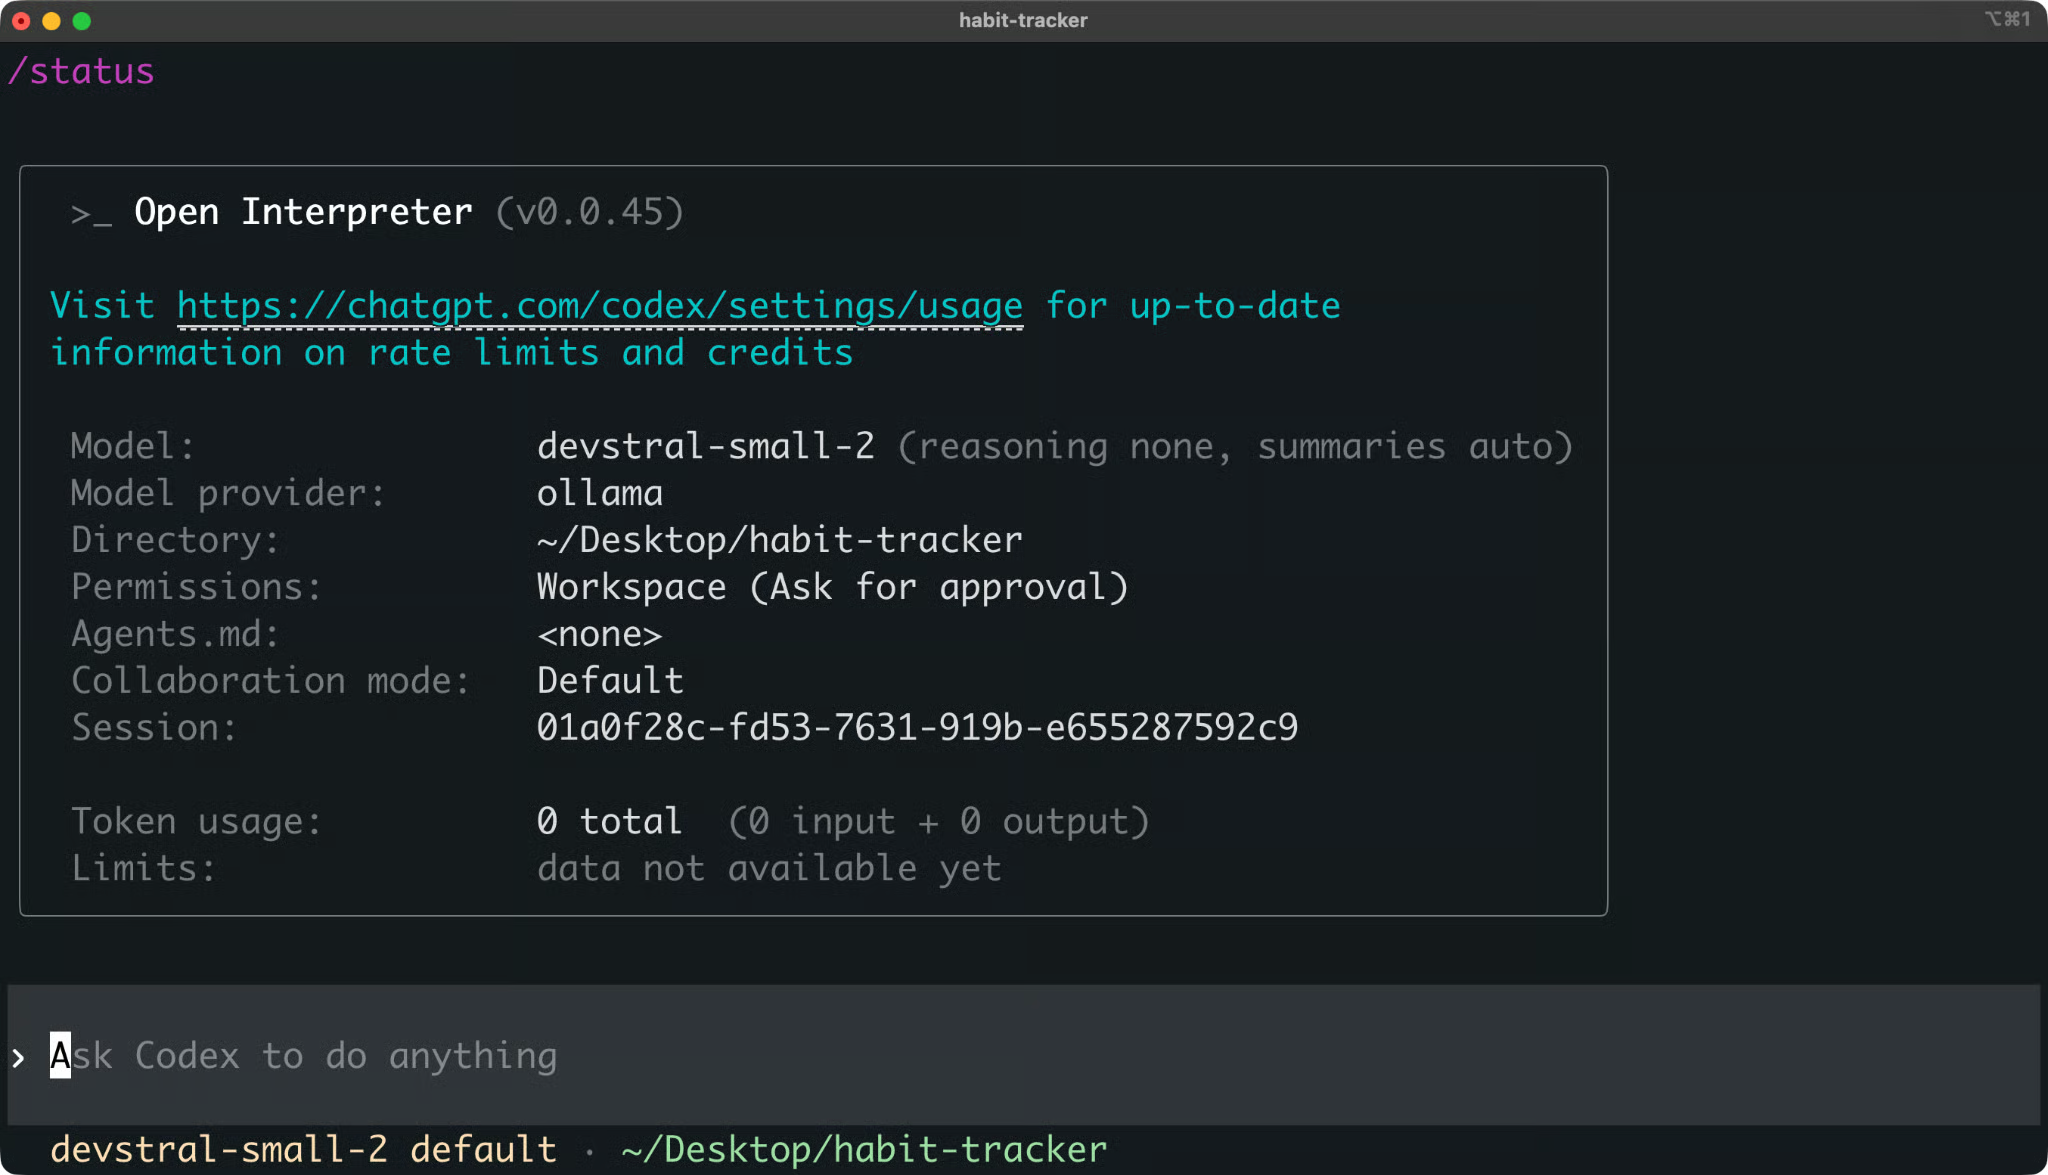
로컬 Ollama 모델과의 Open Interpreter 세션
아직 에이전트가 아무 것도 수정하길 원하지 않습니다. 먼저 진단을 요청하세요.
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.에이전트는 보통 답변 전에 파일을 읽고 테스트를 실행합니다. 명령은 샌드박스 안에서 실행되며, 에이전트가 샌드박스 범위를 넘어서는 접근이 필요할 경우 먼저 승인을 요청합니다.
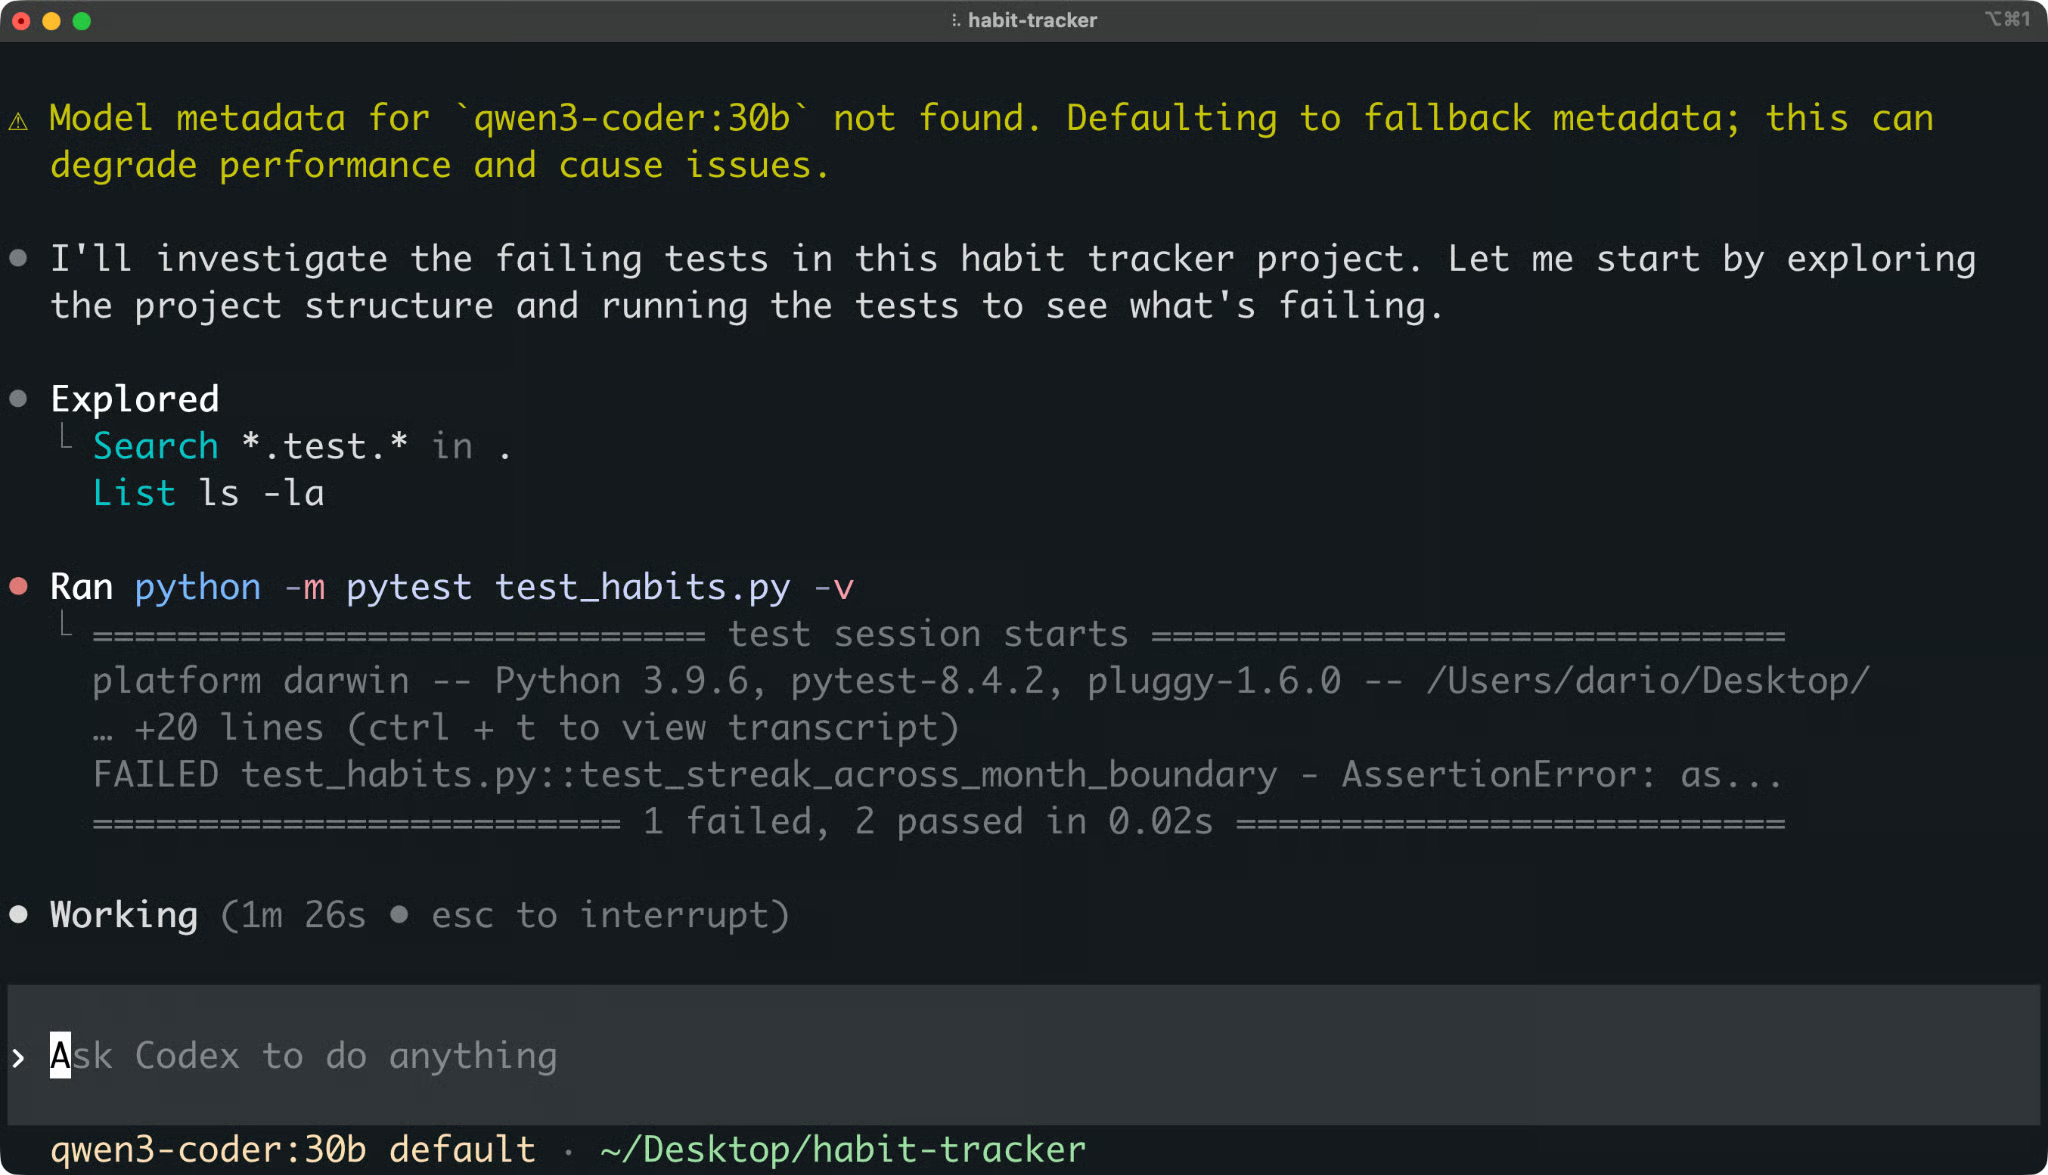
Open Interpreter 출력
무엇이든 승인하기 전에 설명을 읽어보세요.
올바른 진단은 함수가 월 중 "일(day)"만 비교하기 때문에 새 달로 넘어가면 스트릭이 끊긴다는 것입니다. 좋은 수정은 전체 날짜를 비교하는 것으로, 예를 들어 파이썬의 datetime 모듈에서 date.fromisoformat()을 사용하는 방식입니다.
진단이 틀렸다면, 에이전트가 코드를 수정하기 전에 같은 세션에서 바로잡으세요.
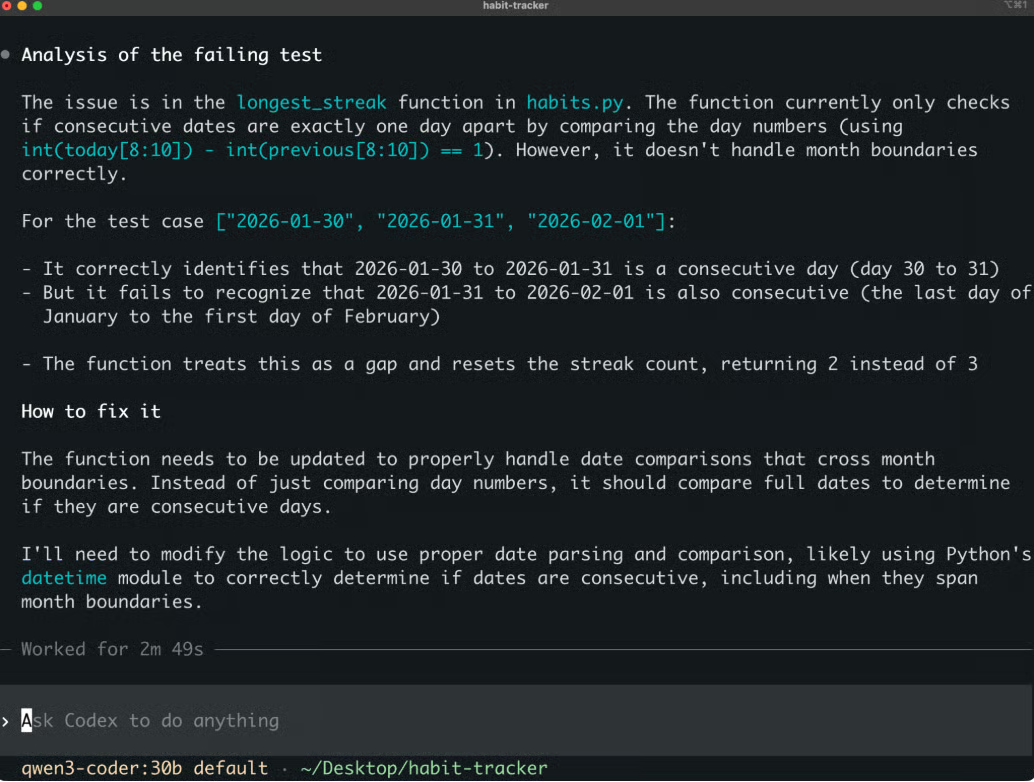
Open Interpreter의 수정 제안
계획이 마음에 든다면, 수정안을 적용하세요.
Apply the fix to habits.py, then run the tests.에이전트가 파일을 수정하고 pytest를 다시 실행합니다. 세 가지 테스트가 모두 통과하는 것을 확인하면 됩니다.
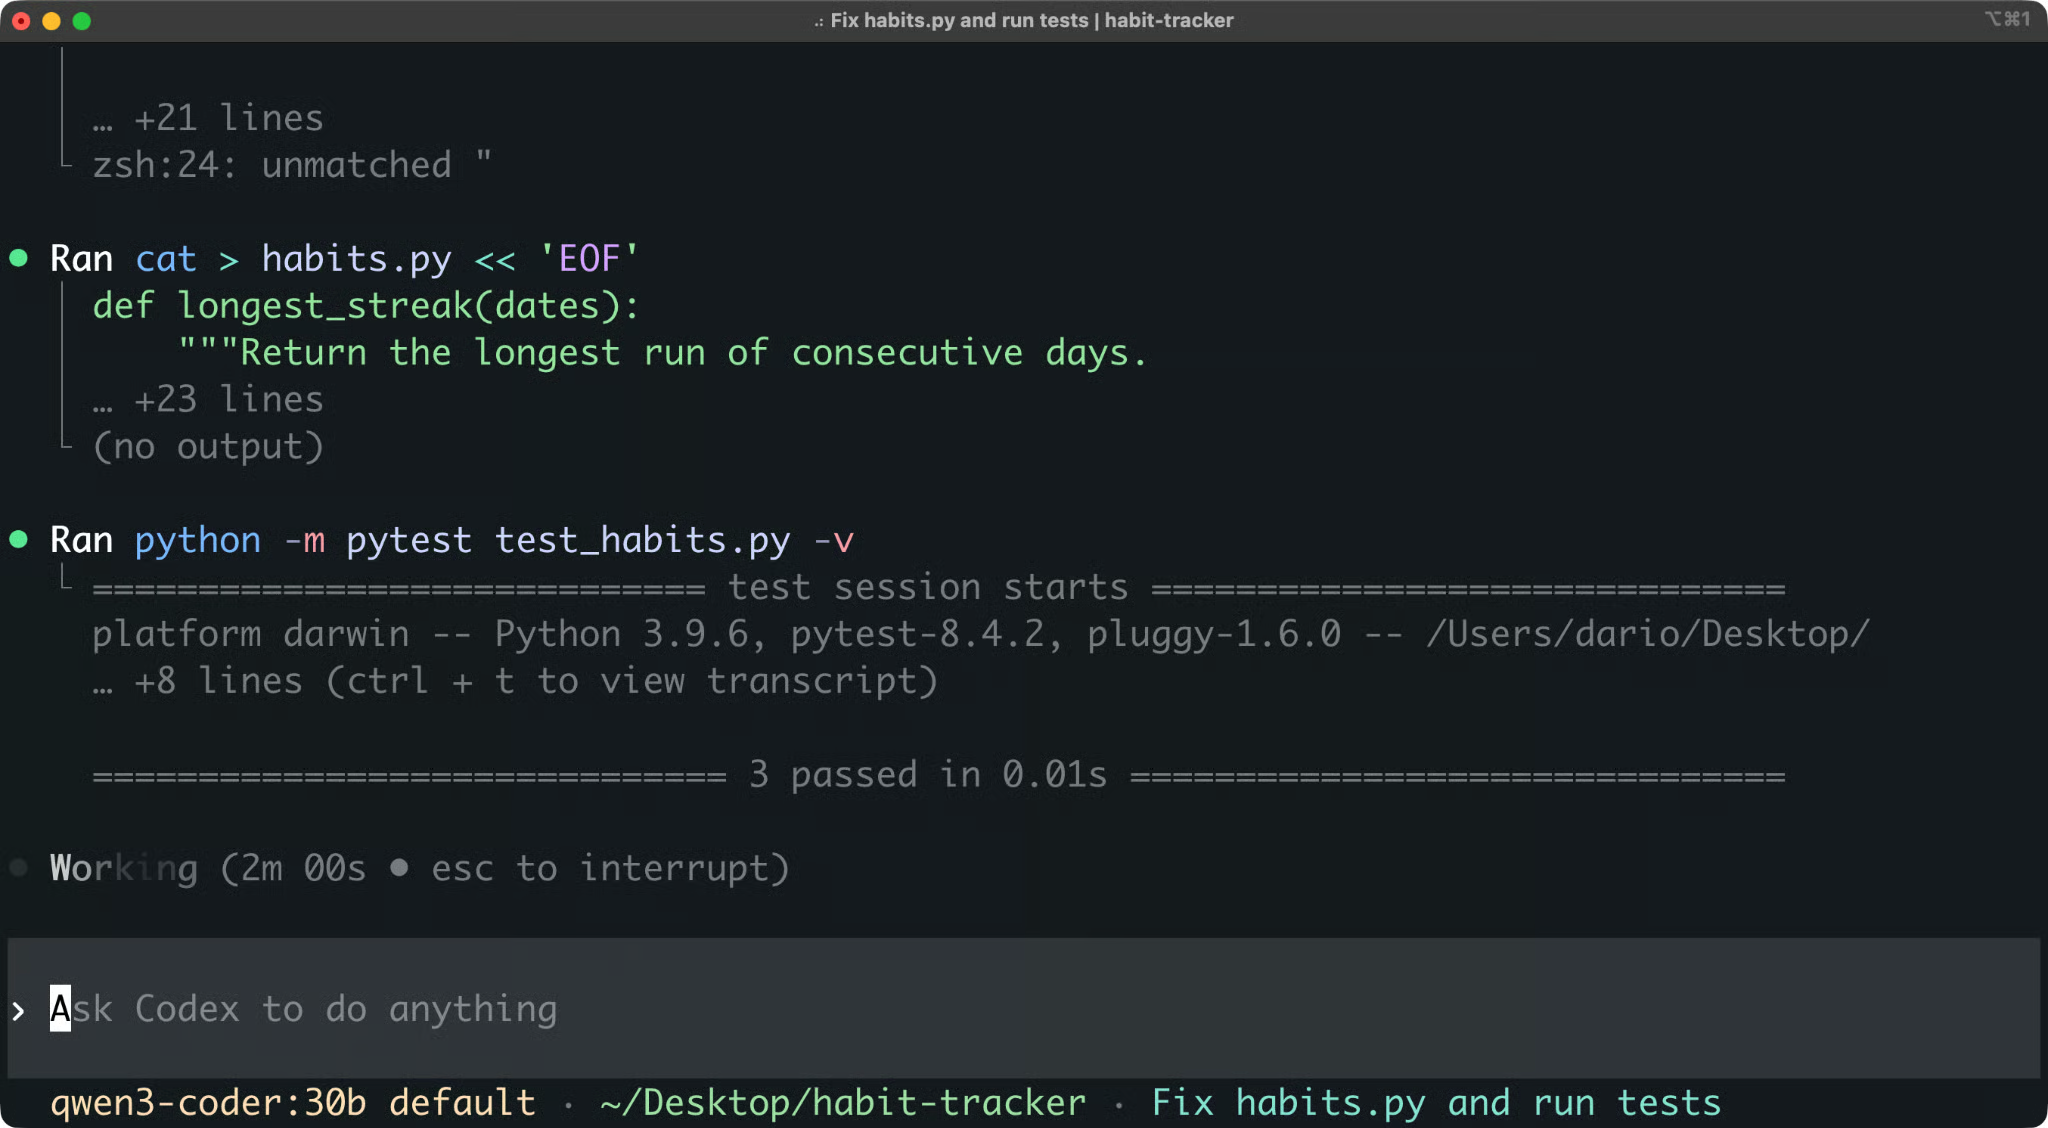
수정 후 모든 테스트 통과
테스트가 통과했다고 해서 코드의 버그가 반드시 해결된 것은 아닙니다. 테스트가 버그를 우회하도록 업데이트되었을 수도 있으니, 여전히 코드를 검토해야 합니다.
세션 안에서 /diff를 실행해 워킹 트리 변경을 확인하세요. 종료 후 git diff를 실행해도 됩니다.
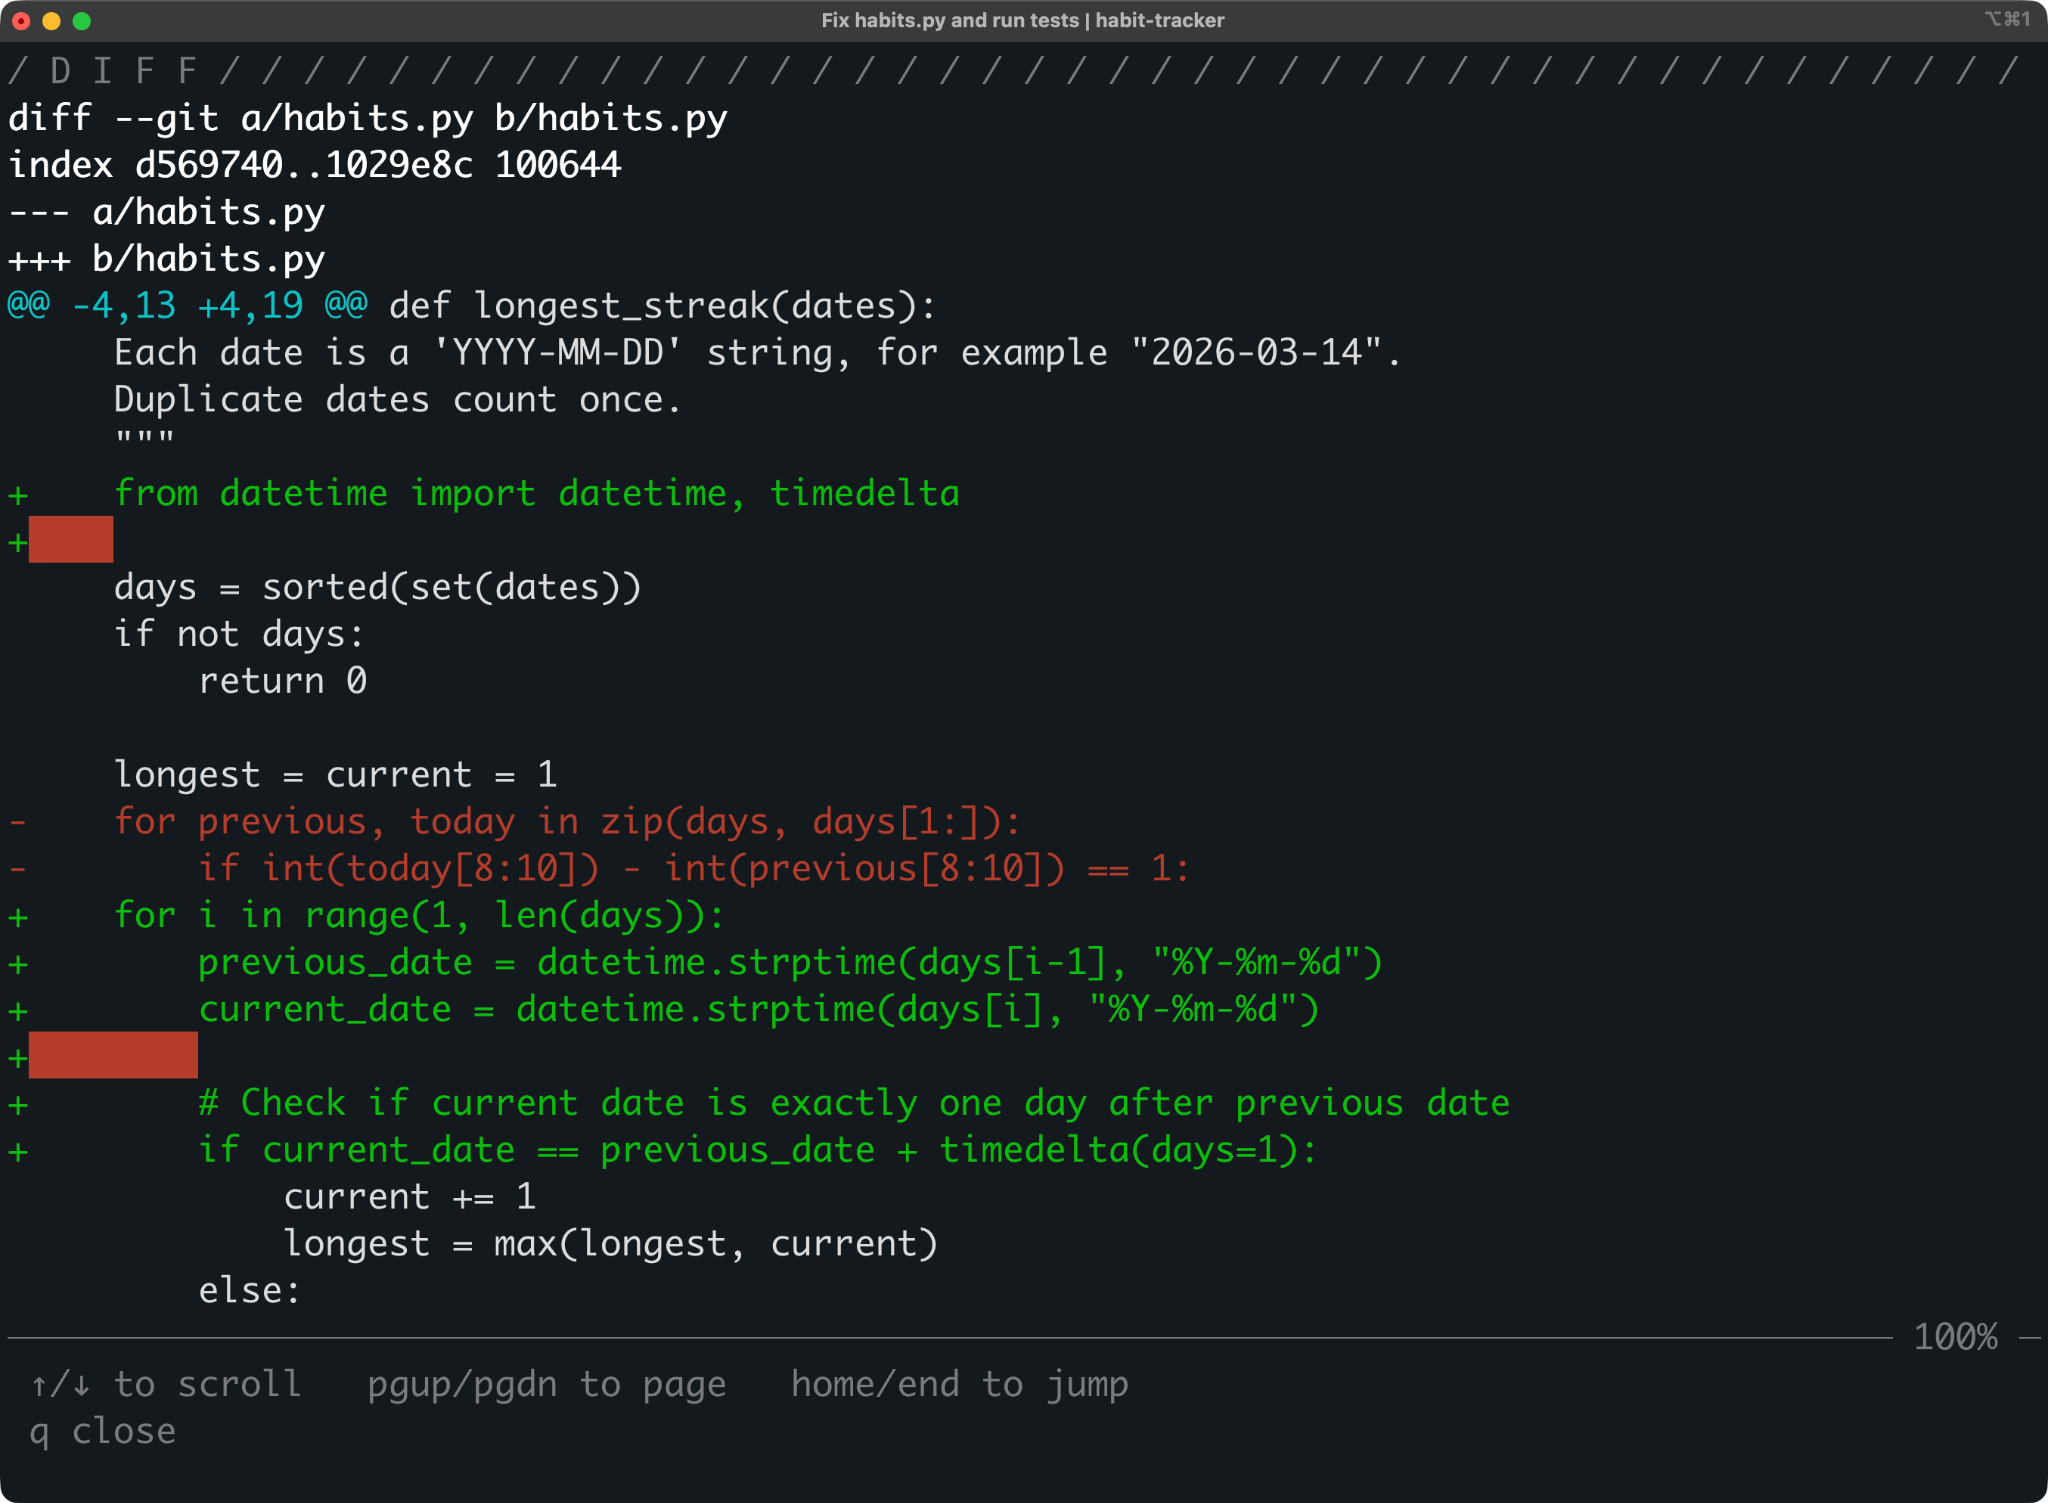
Open Interpreter가 만든 변경 사항의 diff
구체적인 diff는 모델에 따라 다르므로, 여러분의 결과가 위와 줄 단위로 일치하지 않을 수 있습니다. 변경이 마음에 들면 커밋하고, 마음에 들지 않으면 원본 파일을 복원하세요.
git restore habits.py바로 이런 흐름입니다. 문제를 설명하면, 에이전트가 조사하고 수정하며, 커밋 전에는 모든 변경을 여러분이 검토합니다.
Open Interpreter는 모델을 직접 가져와야 합니다.
모든 요청은 다음 세 레이어를 거칩니다.
| Layer | Example | What it controls |
|---|---|---|
| Provider | ollama | Where requests go and how you authenticate |
| Model | devstral-small-2 | The model that does the work |
| Harness | native | The prompts, tools, and message format around the model |
Request layers
연결할 수 있는 것은 다음과 같습니다.
제공자 목록은 공개 모델 카탈로그에서 생성되며, 도구 호출을 지원하는 모델만 유지합니다. 기대한 모델이 보이지 않는다면 보통 그 때문입니다.
ollama-cloud에 유의하세요. 별도의 호스팅 제공자이므로 요청이 여러분의 머신을 떠납니다. 로컬에서 모델을 실행하는 것은 내장 ollama 제공자뿐입니다.
세 수준에서 모델을 바꿀 수 있습니다.
세션 내: /model을 실행해 제공자, 모델, 추론 강도를 선택
단일 실행: 앞 절에서처럼 -m 플래그로 지정
기본값으로: 설정 파일에 지정
언제든 /status로 활성 제공자와 모델을 확인할 수 있습니다.
Open Interpreter는 ~/.openinterpreter/config.toml에서 설정을 읽습니다. 앞 절의 Ollama 구성을 기본값으로 만들려면 다음 두 줄을 추가하세요.
model_provider = "ollama"
model = "qwen3-coder:30b"
그 후에는 플래그 없이도 interpreter가 해당 모델로 시작합니다.
호스팅 제공자는 환경 변수에서 API 키를 읽습니다. 예를 들어 DeepSeek은 DEEPSEEK_API_KEY를 기대합니다.
export DEEPSEEK_API_KEY="your-api-key"OpenAI 호환 엔드포인트를 커스텀 제공자로 추가할 수도 있습니다.
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
wire_api 설정은 엔드포인트가 기대하는 요청 형식을 Open Interpreter에 알려줍니다. OpenAI 호환 Chat Completions는 chat, OpenAI Responses API는 responses, Anthropic 스타일 엔드포인트는 messages를 사용하세요.
신뢰된 프로젝트는 사용자 설정을 덮어쓰는 자체 .openinterpreter/config.toml을 가질 수도 있습니다. 커맨드 라인 플래그는 둘 다를 덮어씁니다. 어떤 값이 우선하는지 확실치 않다면 /debug-config로 최종 설정과 출처를 확인하세요.
모델은 에이전트가 코드를 얼마나 잘 이해하는지를, 하니스는 모델이 작업과 도구를 어떻게 인식하는지를 좌우합니다.
둘 다 필요합니다. 좋은 모델이라도 맞지 않는 하니스에서는 잘못된 도구 호출을 보내고 결과를 오해합니다. 반대로 좋은 하니스만으로 코드를 이해하지 못하는 모델을 보완할 수는 없습니다.
그래서 Open Interpreter는 모델을 고를 때 하니스도 함께 선택합니다. 예를 들어:
Claude 계열 모델은 claude-code 하니스를 사용
Kimi 모델은 kimi-code를 사용
Qwen 모델은 qwen-code를 사용
DeepSeek 모델은 claude-code-bare를 사용
다른 모델 계열의 경우 /harness로 직접 하니스를 선택할 수 있습니다.
약한 결과가 항상 약한 모델을 의미하지는 않는다는 점을 기억하세요. 모델을 바꾸기 전에, 같은 모델에 다른 하니스를 적용해 보세요. 다음 섹션에서 자세히 다룹니다.
하니스 에뮬레이션은 현재 버전의 Open Interpreter가 존재하는 주된 이유입니다.
에이전트 하니스는 모델을 에이전트로 바꿔 주는 주변 요소 전부를 말합니다. 다음을 포함합니다.
쉽게 말해, 하니스는 모델이 작업을 어떻게 바라보고, 그 결정이 어떻게 액션으로 이어지는지를 결정합니다.
Open Interpreter에는 기본 제공 하니스 모드가 있습니다. 가장 자주 쓰게 될 것은 다음과 같습니다.
native: Codex에서 이어받은 Open Interpreter 자체 하니스
claude-code: Anthropic의 Claude Code 프롬프트와 도구 표면을 에뮬레이션
kimi-code: Moonshot이 Kimi 모델에 권장하는 Kimi Code 하니스의 러스트 재구현
qwen-code: Alibaba의 Qwen 모델용 Qwen Code CLI 에뮬레이션
swe-agent: GitHub 이슈 해결을 위해 만들어진 연구용 에이전트 SWE-agent 에뮬레이션
전체 목록에는 claude-code-bare, kimi-cli, deepseek-tui, zcode, minimal 같은 변형도 있습니다. 세션에서 /harness를 실행해 사용 중인 버전이 지원하는 항목을 확인하세요.
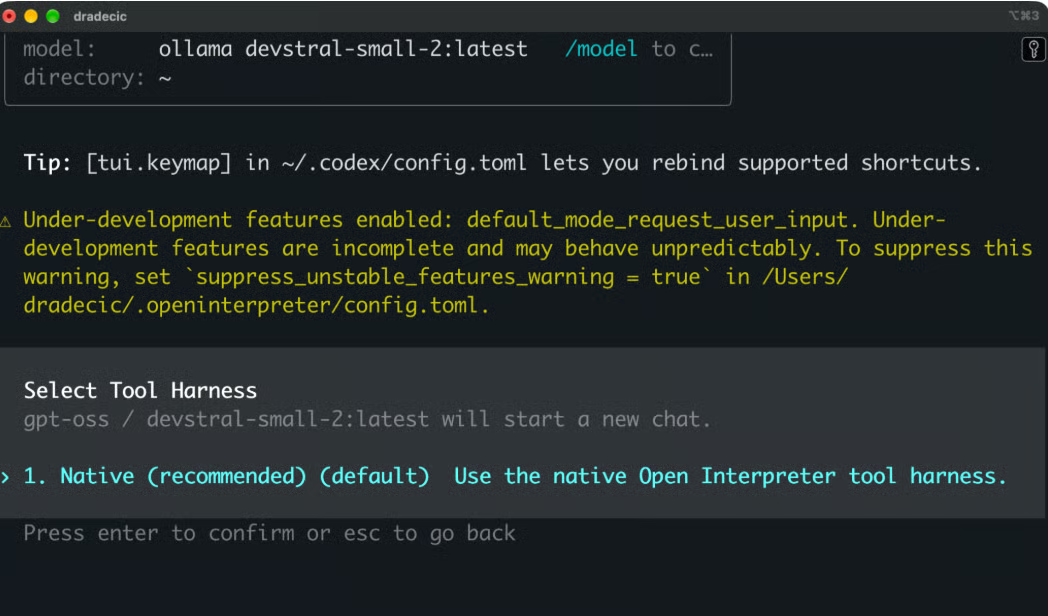
세션 도중 /harness로 하니스를 전환하거나, ~/.openinterpreter/config.toml에 기본값을 설정할 수 있습니다.
harness = "kimi-code"
harness_guidance = true
harness_guidance 설정은 하니스가 허용하는 경우 신뢰성 가이던스를 추가합니다. 더 엄격한 에뮬레이션을 원하면 false로 설정하세요. harness를 비워 두면, 앞 절에서 본 것처럼 모델 계열에 따라 Open Interpreter가 자동으로 선택합니다.
대부분의 모델 벤더는 특정 에이전트 설정 안에서 코딩 모델을 튜닝하고, 그에 맞는 권장 하니스를 함께 공개합니다.
모델은 그 하니스에 익숙해집니다. 프롬프트 스타일, 도구 이름, 파일 편집 형식, 도구 결과가 돌아오는 방식 등을 학습합니다.
예를 들어, 검색·치환 편집에 맞게 튜닝된 모델을 전체 패치 파일을 기대하는 하니스에서 실행한다고 해봅시다. 모델은 어떤 변경이 필요한지 알지만, 계속해서 잘못된 형식으로 변경을 설명합니다. 에이전트 루프는 진전 없이 토큰만 소모합니다.
도구 결과도 마찬가지입니다. 하니스가 모델이 본 적 없는 형식으로 결과를 돌려주면, 모델은 그것을 잘못 해석합니다. 턴 사이에 하니스가 모델의 추론을 지우면, 사고하는 모델은 자신의 계획을 놓칩니다.
즉, 같은 모델이라도 하니스에 따라 성능이 좋아 보일 수도, 나빠 보일 수도 있습니다. 가중치는 그대로인데 말이죠. 그래서 코딩 벤치마크는 보통 각 실행에 사용된 하니스를 함께 명시합니다.
최전선 모델은 낯선 하니스에서도 회복하는 경향이 있지만, 더 작고 저렴한 모델은 대개 그렇지 못합니다. Open Interpreter는 모든 모델을 하나의 형식에 끼워 맞추지 않고, 모델에 맞춰 형식을 바꿔 줍니다.
이 데모 프로젝트로 직접 시험해 볼 수 있습니다. git restore habits.py로 원본을 복구하고, /harness로 하니스를 바꾼 뒤, 같은 프롬프트를 다시 주어 보세요. 그러고 나서 단계 수와 편집 형식이 어떻게 달라지는지 비교하세요.
이 글에서 대부분의 기능을 이미 보셨습니다. 일상적인 개발에서 각 기능이 무엇을 제공하는지 정리합니다.
Open Interpreter는 Git 리포지토리 내부에서 동작합니다. 프로젝트 구조를 읽고, 어떤 것을 변경했는지 추적합니다.
두 개의 슬래시 명령이 도움이 됩니다. /diff는 워킹 트리 변경을 보여주고, /review는 커밋 전에 현재 변경에 버그나 회귀가 없는지 에이전트에게 점검하도록 합니다. 대화형 UI 없이 동일한 리뷰를 실행할 수도 있습니다.
interpreter exec review --uncommitted세션도 저장됩니다. 작업 도중 중단했다면 interpreter resume --last로 중단한 지점부터 이어서 진행합니다.
에이전트는 여러분이 직접 실행하는 것과 같은 명령을 실행합니다. 예를 들어 테스트 스위트, 린터, 빌드 스크립트, 패키지 매니저 등입니다. 모두 macOS, Linux, Windows의 네이티브 샌드박스에서 실행됩니다.
오래 실행되는 명령은 백그라운드에서 돌릴 수 있습니다. /ps로 목록을 확인하고 /stop으로 종료하세요.
스크립트와 CI 파이프라인에서는 interpreter exec로 대화형 UI 없이 작업을 실행하세요.
interpreter exec "fix the failing test"/model로 언제든 제공자와 모델을 바꿀 수 있습니다. 구성이든, AGENTS.md든, 스킬이든 전환 후에도 그대로 적용됩니다.
프로필을 활용하면 좋습니다. 예를 들어 일상 작업에는 저렴한 모델을, 코드 리뷰에는 더 강력한 모델을 쓰고 싶다고 합시다. 설정에 둘 다 정의해 둘 수 있습니다.
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
필요할 때 interpreter --profile review로 시작하면 됩니다.
/harness는 모델을 바꾸지 않고도 모델이 작업을 바라보는 방식을 바꿉니다. 모델이 도구 호출에 애를 먹을 때, 더 큰 모델로 옮기기 전에 가장 먼저 시도해 보세요.
Model Context Protocol(MCP)은 문서 서버나 데이터베이스처럼 에이전트가 원래 염두에 두지 않았던 도구와 연결합니다. 설정에서 서버를 추가하세요.
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"/mcp로 구성된 서버와 그 도구를 볼 수 있습니다. default_tools_approval_mode는 해당 서버의 도구를 사용하기 전에 에이전트가 확인을 요청하도록 합니다.
반대로도 작동합니다. interpreter mcp-server는 Open Interpreter를 MCP 서버로 노출하고, interpreter acp는 에이전트 클라이언트 프로토콜(ACP)을 지원하는 에디터 안에서 실행합니다. ACP는 에디터와 코딩 에이전트를 연결하는 오픈 표준입니다.
AGENTS.md는 리포지토리에 있는 Markdown 파일로, 에이전트가 매 작업마다 읽는 프로젝트 규칙을 담습니다. 습관 추적기에서는 다음과 같을 수 있습니다.
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies./init을 실행해 에이전트가 첫 버전을 작성하게 할 수도 있습니다.
스킬은 재사용 가능한 워크플로우로, 프로젝트 내부 .agents/skills나 사용자용 ~/.agents/skills 폴더에 패키징됩니다. 작업이 해당 스킬과 일치하면 에이전트가 자동으로 스킬을 사용합니다. /skills로 사용 가능한 스킬을 확인하세요.
둘 다 공유 포맷이므로, 이를 지원하는 다른 코딩 에이전트에서도 동일한 파일을 사용할 수 있습니다. Open Interpreter는 세션의 특정 시점에 자체 명령을 실행하는 훅도 지원합니다. /hooks로 검토하고 신뢰할 수 있습니다.
두 가지 설정이 에이전트의 권한을 제어합니다.
샌드박스 모드: read-only, workspace-write, danger-full-access
승인 정책: untrusted, on-request, never
샌드박스는 가능한 범위를, 승인 정책은 사전 확인 시점을 결정합니다. workspace-write와 on-request를 함께 사용하면 에이전트가 프로젝트를 수정하고 테스트를 실행할 수 있지만, 그 범위를 넘어서는 접근이 필요할 때는 먼저 묻습니다.
둘 다 /permissions나 -s, -a 플래그로 변경할 수 있습니다. 두 설정을 모두 우회하는 --yolo 플래그도 있는데, 문서에서 위험하다고 표시되어 있습니다. 자세한 내용은 보안 섹션에서 더 다루겠습니다.
Open Interpreter는 저비용 모델을 위해 만들어진 코딩 에이전트라고 스스로를 설명합니다.
대형 독점 코딩 에이전트는 대개 벤더의 자체 모델을 중심으로 구축됩니다. Open Interpreter는 하나의 에이전트로 독점 모델, 호스팅된 오픈 웨이트 모델, 로컬 모델을 모두 다룰 수 있게 해줍니다.
Kimi, DeepSeek, GLM, Qwen 같은 오픈 웨이트 모델은 공개된 웨이트를 갖습니다. 서드파티 제공자를 통해서나 직접 하드웨어에서 사용할 수 있습니다.
이는 두 가지 장점을 줍니다. 호스팅된 오픈 웨이트 모델은 보통 최전선 독점 모델보다 토큰당 비용이 낮습니다. 또한 동일한 모델이 웨이트만 있으면 어디서든 실행되므로, 한 호스트에 묶이지 않습니다.
Open Interpreter는 Kimi K3, DeepSeek, GLM에 대한 제공자 가이드를 별도로 제공하며, 이들 모델 계열에 맞는 하니스를 자동으로 선택합니다.
Ollama와 LM Studio는 내장 제공자이므로, API 키나 토큰당 비용 없이 여러분의 머신에서 모델을 실행할 수 있습니다.
대신 하드웨어가 비용입니다. 제가 MacBook Pro M1 Max(통합 메모리 64GB)에서 devstral-small-2를 테스트했을 때, 모델만으로 26GB를 사용했습니다. 기본 Ollama 컨텍스트 윈도우는 에이전트 루프에 비해 너무 작았고, 128k 토큰에서는 메모리 사용량이 오르내리다가 세션이 멈추곤 했습니다.
코딩 에이전트는 큰 컨텍스트 윈도우가 필요합니다. 시스템 프롬프트, 도구 정의, 파일 내용, 명령 출력이 모두 들어가야 하기 때문입니다. Ollama는 Codex 스타일 에이전트에 최소 64k 토큰을 권장합니다. 그리고 컨텍스트 윈도우가 커질수록 모델 자체 메모리 외에 추가 메모리가 더 듭니다.
Open Interpreter는 사용자의 컴퓨터에서 실행되지만, 모델은 그럴 필요가 없습니다.
코드가 어디로 가는지는 제공자에 따라 달라집니다:
구성, 세션, 로그는 어떤 경우든 ~/.openinterpreter 아래에 로컬로 저장됩니다.
더 세밀한 제어가 필요하면, 자체 추론 서버를 가리키는 커스텀 제공자를 추가할 수 있습니다. OpenAI 호환 API가 있는 서버라면 모두 동작하며, 예를 들어 회사의 GPU에 배포된 vLLM이 해당됩니다. 이렇게 하면 인프라는 여러분의 것이면서 호스팅 환경을 구성할 수 있습니다.
오픈 모델이라고 해서 도구 호출에 모두 능숙한 것은 아닙니다. 도구 사용이 약하면 잘못된 호출, 루프, 조기 중단, 명령 출력 무시 같은 현상으로 나타납니다.
적절한 하네스가 도움이 되지만, 다단계 작업을 계획하지 못하는 모델 자체를 고칠 수는 없습니다. 작은 로컬 모델일수록 이런 문제가 두드러집니다.
새 모델을 실제 프로젝트에 적용하기 전에, 이 글에서 보여준 습관 추적기 같은 작은 저장소로 시험해 보세요. 약점이 보이면 더 큰 모델로 바꾸기 전에 다른 하네스를 시도해 보세요.
옵션을 간단히 정리하면 다음과 같습니다:
| 추론 실행 위치 | 비용 | 코드가 로컬을 벗어나나요? | |
|---|---|---|---|
| 독점 호스팅 모델 | 벤더의 서버 | 토큰 기준 또는 구독 | 예 |
| 오픈 웨이트 호스팅 모델 | 제공자의 서버 | 토큰 기준, 보통 더 저렴함 | 예 |
| 오픈 웨이트 로컬 모델 | 사용자 하드웨어 | 하드웨어 및 전기 | 아니요 |
로컬 및 오픈 모델을 위한 Open Interpreter 옵션
Open Interpreter는 다른 터미널 코딩 에이전트와 유사한 점이 많습니다. 차이는 도구의 소유권과 어떤 모델을 위해 만들어졌는지에 있습니다.
Claude Code는 Anthropic의 터미널 코딩 에이전트입니다. 첫 번째 차이는 소유권입니다. Claude Code는 독점이고, Open Interpreter는 Apache 2.0 라이선스의 오픈 소스입니다. Open Interpreter의 모든 부분을 읽고 수정할 수 있습니다.
두 번째 차이는 모델 선택입니다. Claude Code는 Claude 모델을 위해 만들어졌습니다. 다른 제공자의 Anthropic 호환 엔드포인트를 지정할 수는 있지만, 하네스는 Claude에 맞춰진 상태를 유지합니다. Open Interpreter는 모델 선택을 핵심 기능으로 다룹니다.
하네스 비교가 흥미로운 지점입니다. Claude Code 자체가 Open Interpreter가 에뮬레이션하는 하네스 중 하나입니다. claude-code 모드에서는 어떤 모델이든 Open Interpreter 런타임 안에서 Claude Code 스타일의 프롬프트와 도구를 사용합니다. UI와 슬래시 명령은 여전히 Open Interpreter의 것이므로, 모델만 바꾼 같은 제품은 아닙니다.
두 도구 모두 터미널 우선입니다. 각자 대화형 세션과 스크립트 및 CI를 위한 비대화형 모드를 갖습니다. 프로젝트 지침의 경우 Claude Code는 CLAUDE.md를 읽고, Open Interpreter는 공유 형식인 AGENTS.md를 사용합니다.
Claude Code는 더 큰 생태계를 갖추고 있습니다. IDE 확장, 데스크톱 및 웹 앱, 플러그인 마켓플레이스, 서브에이전트, SDK가 함께 제공됩니다. Open Interpreter는 더 젊은 프로젝트이며, 자체 생태계 대신 MCP, 스킬, AGENTS.md, Agent Client Protocol 같은 공유 표준에 의존합니다.
Claude 모델과 함께 가장 다듬어진 경험을 원한다면 Claude Code가 더 안전한 선택입니다. 다른 모델을 사용하거나 독점 도구를 피하고 싶다면 Open Interpreter를 선택하세요.
OpenCode가 가장 비슷합니다. 둘 다 오픈 소스이고, 터미널 우선이며, 다양한 모델 제공자와 작동하도록 만들어졌습니다.
문서상으로는 모델 지원도 유사합니다. OpenCode는 75개 이상의 제공자를 지원하고, Open Interpreter는 공개 모델 카탈로그에서 제공자 목록을 생성합니다. 둘 다 Ollama를 통해 로컬 모델을 실행합니다.
터미널 경험은 더 다릅니다. OpenCode는 자체 TUI와 Language Server Protocol(LSP) 통합을 갖추고 있어, 타입 오류 같은 코드 진단을 모델에 다시 전달합니다. Open Interpreter의 TUI는 Codex에서 비롯되었습니다.
구성 측면에서 OpenCode는 opencode.json 파일을 사용하고, Open Interpreter는 프로필과 함께 config.toml을 사용합니다.
에이전트 아키텍처가 주요 차이입니다. OpenCode는 클라이언트-서버로 동작하며, TUI는 로컬 서버의 한 클라이언트이고 다른 클라이언트도 연결할 수 있습니다. 내장된 build와 plan 에이전트를 갖추고, 커스텀 에이전트와 서브에이전트를 지원합니다. 각 모델군에 맞게 시스템 프롬프트를 조정하지만, 도구와 루프는 OpenCode 고유입니다. Open Interpreter는 더 나아가 도구 스키마와 메시지 형식을 포함해 전체 하네스를 교체합니다. 최신 빌드에는 opencode 하네스 모드도 포함됩니다.
개발 측면에서 OpenCode는 팀과 커뮤니티가 구축한 독자적인 코드베이스입니다. Open Interpreter는 Codex 포크 위에 구축되어 런타임의 상당 부분을 업스트림에서 가져옵니다. 이는 트레이드오프입니다. Open Interpreter는 Codex의 샌드박스와 런타임을 그대로 활용하는 반면, OpenCode는 전체 스택을 직접 제어합니다.
이 둘은 일반적인 의미의 경쟁자가 아닙니다. Open Interpreter는 Codex의 포크입니다.
Rust 런타임, TUI, 샌드박싱, 승인, AGENTS.md, 스킬, MCP, exec 모드, 대부분의 슬래시 명령을 공유합니다. 제가 Open Interpreter를 실행했을 때, 세션 재개 힌트가 여전히 codex resume라고 표시되기도 했습니다.
Codex는 OpenAI의 에이전트로, OpenAI 모델을 중심으로 구축되었습니다. --oss와 커스텀 제공자를 통해 로컬 모델을 지원하지만, 기본 경험은 OpenAI를 겨냥합니다.
Open Interpreter는 몇 가지 방향으로 Codex를 확장합니다:
하네스 에뮬레이션: 각 모델군에 맞게 프롬프트, 도구 스키마, 메시지 형식을 바꿉니다
제공자 지원: 생성된 제공자 카탈로그가 있으며 Kimi K3, DeepSeek, GLM에 대한 전용 가이드를 제공합니다
Chat Completions: --chat-completions 플래그로 OpenAI 호환 제공자를 어디든 실행합니다
Codex SDK 오버라이드: Codex SDK로 구축한 앱을 Open Interpreter를 통해 대신 실행할 수 있습니다
Open Interpreter는 구성과 세션을 ~/.openinterpreter 아래에 저장해, Codex 설치와 충돌하지 않습니다.
주로 OpenAI 모델을 사용한다면 Codex가 더 나은 선택입니다. 다른 모델을 쓴다면, Open Interpreter가 동일한 워크플로를 제공하면서 해당 모델에 대한 지원이 더 좋습니다.
간단한 요약입니다:
| 라이선스 | 모델 | 하네스 접근법 | 구성 | |
|---|---|---|---|---|
| Open Interpreter | 오픈 소스(Apache 2.0) | 어떤 제공자든, 호스팅 또는 로컬 | 모델별 하네스 에뮬레이션 | config.toml |
| Claude Code | 독점 | Claude 모델용 구축 | Claude Code 고유 하네스 | settings.json 및 CLAUDE.md |
| OpenCode | 오픈 소스(MIT) | 75+ 제공자, 호스팅 또는 로컬 | 모델별 프롬프트가 있는 단일 하네스 | opencode.json |
| Codex | 오픈 소스(Apache 2.0) | --oss와 함께 OpenAI 모델용 구축 | Codex 고유 하네스 | config.toml |
다른 AI 코딩 에이전트와 비교한 Open Interpreter
챗봇이 할 수 있는 최악은 나쁜 답을 주는 것뿐이며, 무시하면 됩니다. 코딩 에이전트는 머신에서 명령을 실행하고, 파일을 읽고 쓰며, 네트워크에도 접근할 수 있습니다. 모델의 잘못된 결정이나 프롬프트 인젝션은 실제 피해를 유발할 수 있습니다. 프롬프트 인젝션은 에이전트가 읽는 콘텐츠(예: README 파일이나 웹페이지)에 숨겨진 지시를 의미합니다.
Open Interpreter는 Codex 런타임에서 보안 모델을 상속합니다. 가능한 범위를 제한하는 샌드박스와, 에이전트가 사전에 질문해야 하는 시점을 결정하는 승인 정책의 두 층으로 구성됩니다.
에이전트가 실행하는 모든 명령은 macOS, Linux, Windows에서 OS 수준의 샌드박스를 거칩니다. 샌드박스 모드는 세 가지입니다:
read-only: 파일은 읽을 수 있지만 변경은 불가
workspace-write: 프로젝트 폴더 내부에서 파일을 수정하고 명령을 실행할 수 있음
danger-full-access: 샌드박스 없음
workspace-write 모드에서는 파일 쓰기가 활성 워크스페이스로 제한됩니다. 에이전트는 코드를 수정할 수 있지만, 머신의 다른 위치의 파일은 편집할 수 없습니다.
workspace-write 모드에서는 기본적으로 명령에 네트워크 접근 권한이 없습니다. 이는 다운로드를 차단하고 에이전트가 코드를 전송하는 것을 막습니다.
일부 작업은 네트워크가 필요합니다. 예를 들어 패키지 설치가 그렇습니다. 구성에서 네트워크 접근을 켤 수 있습니다:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
정말 필요한 프로젝트에서만 켜세요.
승인 정책은 에이전트가 멈추고 묻는 시점을 결정합니다:
untrusted: 신뢰 목록에 없는 명령을 실행하기 전에 확인합니다
on-request: 작업에 샌드박스 이상의 접근이 필요할 때 묻습니다
never: 묻지 않습니다
버전 관리되는 프로젝트에는 workspace-write와 on-request 조합이 좋은 기본값입니다. 에이전트가 프로젝트 내부에서 작업하고, 그 이상으로 나아가기 전에는 묻습니다. 문제가 생겨도 Git으로 되돌릴 수 있습니다.
--yolo 플래그는 샌드박스와 승인을 모두 끕니다. 컨테이너나 VM 같은 일회성 환경에서만 사용하세요.
에이전트가 실행하는 명령은 셸 환경을 상속합니다. API 키가 환경 변수에 있다면, 그 명령에서 볼 수 있습니다.
shell_environment_policy로 이를 제한할 수 있습니다:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
core 설정은 HOME, PATH 같은 기본 변수만 전달하고, exclude는 패턴과 일치하는 항목을 제거합니다.
파일도 또 다른 위험 요소입니다. 에이전트는 read-only 모드에서도 프로젝트의 .env 파일을 읽을 수 있습니다. 호스팅 제공자를 사용할 경우, 에이전트가 읽는 모든 것이 제공자의 서버로 전송됩니다.
여기서 기억해야 할 점은 샌드박스가 피해를 제한하지만, 보장이라기보다는 안전망으로 취급해야 한다는 것입니다.
에이전트를 자율 실행하기 전에 /status를 실행해 샌드박스 모드와 승인 정책을 확인하세요.
pip install로 시작하는 Open Interpreter 글을 발견하더라도 틀린 것은 아닙니다. 다른 프로젝트를 설명하는 것입니다.
원래 Open Interpreter는 2023년에 파이썬 프로젝트로 출시되었습니다. 언어 모델이 사용자 머신에서 Python, JavaScript, 셸 코드를 실행할 수 있게 했으며, ChatGPT의 Code Interpreter에 대한 오픈 소스 대안으로 알려졌습니다. 이후 버전에서는 컴퓨터 제어가 추가되어, 모델이 데스크톱과도 상호작용할 수 있었습니다.
현재 메인 프로젝트는 Codex 기반의 Rust 리라이트입니다. 일반적인 컴퓨터 제어가 아니라 코딩 에이전트와 하네스 에뮬레이션에 초점을 맞춥니다.
파이썬 버전이 사라진 것은 아닙니다. endolith/open-interpreter에서 커뮤니티 포크로 이어지고 있습니다.
두 버전 모두 동일한 이름, 동일한 GitHub 저장소 히스토리, 동일한 interpreter 명령을 사용하므로 혼동하기 쉽습니다.
하지만 아주 분명한 구분법은 다음과 같습니다:
pip install open-interpreter: 레거시 파이썬 버전
curl 또는 PowerShell 설치 프로그램: 현재 Rust 버전
Open Interpreter가 모든 환경에 맞는 도구는 아닙니다. 합리적인 경우와 맞지 않는 경우를 정리했습니다.
오픈 소스: Apache 2.0 라이선스이므로 전체 코드베이스를 읽고, 감사하고, 포크할 수 있습니다
모델 선택: 하나의 에이전트에서 호스팅, 오픈 웨이트, 로컬 모델을 사용할 수 있고, 세션 중간에도 전환할 수 있습니다
다양한 에이전트 하네스: 모델이 튜닝된 성능에 더 가깝게 접근하며, 이런 기능을 제공하는 코딩 에이전트는 드뭅니다
터미널 네이티브 개발: 기존 셸과 Git 워크플로에 자연스럽게 녹아들고, exec 모드는 스크립트와 CI에서도 동작합니다
오픈 및 저비용 모델: 프로젝트가 이를 중심으로 구축되어 있으며, 전용 제공자 가이드와 매칭되는 하네스를 제공합니다
확장성: MCP, 스킬, 훅, AGENTS.md, Agent Client Protocol, Codex SDK 오버라이드로 다른 도구와 연결할 수 있습니다
모델 품질 편차: 에이전트의 성능은 결국 모델에 달려 있으며, 다단계 작업을 계획하지 못하는 모델은 어떤 하네스로도 개선할 수 없습니다
로컬 모델의 높은 하드웨어 요구: 제 테스트에서 devstral-small-2만으로도 26GB 메모리를 사용했으며, 코딩 에이전트에 필요한 대용량 컨텍스트 윈도우 이전 수치입니다
설정의 진입 장벽: 제공자, 컨텍스트 윈도우, 하네스, 샌드박스 설정을 직접 관리해야 합니다. Ollama 모델의 메타데이터 경고나 남아 있는 Codex 브랜딩 같은 거친 부분도 있습니다
명령 실행의 위험성: 샌드박스와 승인이 위험을 줄여주지만, 제거하지는 못합니다
코드는 여전히 검토가 필요: 테스트 통과가 올바른 수정임을 보장하지 않으므로, 모든 변경(diff)을 직접 읽어야 합니다
Open Interpreter는 선택한 모델과 함께 동작하는 오픈 소스 코딩 에이전트로, 모델이 호스팅이든, 오픈 웨이트든, 로컬에서 실행 중이든 상관없이 사용할 수 있습니다.
워크플로는 단순합니다. 모델과 하네스를 고르고, 에이전트를 프로젝트에 지정한 뒤, 작업이 끝날 때까지 검사, 편집, 명령 실행을 맡깁니다. 이후 작업물을 검토합니다.
하네스 에뮬레이션이 경쟁 제품과의 차별점입니다. Open Interpreter는 모든 모델을 하나의 에이전트 설정에 억지로 끼워 넣지 않습니다. 모델에 맞게 설정을 바꾸며, 이것이 성패를 가를 수 있습니다. 작업 품질은 모델이, 수정 가능 범위는 권한이 결정합니다. 어떤 변경이 코드베이스에 반영되기 전 마지막 점검은 여러분의 검토입니다.
AI 엔지니어 인증을 받고 싶다면, Associate AI Engineer for Developers 트랙에 등록해 본인의 속도에 맞춰 AI 세계로 전환해 보세요.
DataCamp로 배우기
트랙
트랙
트랙