Cursus
Associate AI Engineer pour développeurs
26 h
Si vous avez déjà exécuté un modèle open-weight dans un agent de codage conçu pour un autre modèle, vous savez que ce n’est pas l’idéal.
Le modèle interprète souvent mal les schémas d’outils et relance la même commande en échec jusqu’à ce que vous l’arrêtiez. Dès que vous revenez au modèle pour lequel l’agent a été conçu, la même tâche passe sans problème. Le souci vient rarement du modèle, mais plutôt du harnais de l’agent autour de lui, dont les prompts et les formats d’outils ont été optimisés pour un autre.
Open Interpreter résout ce problème en émulant le harnais pour lequel chaque modèle a été ajusté, comme Claude Code ou Kimi Code. C’est un agent de codage IA open source qui s’exécute depuis votre terminal, et la version actuelle est un projet Rust construit sur OpenAI’s Codex, pas l’assistant informatique en Python dont vous vous souvenez peut-être.
Dans cet article, je vous guide à travers l’installation, la configuration du modèle et du harnais, un flux de travail de codage concret, et la comparaison d’Open Interpreter avec Claude Code, OpenCode et Codex.
Nouveau aux agents d’IA ? Inscrivez-vous à notre cours Introduction to AI Agents et maîtrisez les fondamentaux en une après-midi.
Open Interpreter donne à un modèle d’IA l’accès à votre projet et aux outils qu’un développeur utiliserait dessus.
Vous n’avez qu’à décrire une tâche en anglais simple, et l’agent travaille sur votre code. Il sait travailler avec :
Le projet est open source sous licence Apache 2.0. Il n’est pas non plus limité à un seul fournisseur de modèles. Vous pouvez le connecter à des modèles hébergés, des modèles open-weight ou des modèles qui tournent localement sur votre machine.
Le dépôt principal compte plus de 68 000 étoiles GitHub en septembre 2026.
Open Interpreter fonctionne en boucle :
Selon les paramètres d’autorisations, certaines étapes exigent d’abord votre approbation. Je les détaillerai dans la section sécurité.
Voici un aperçu plus visuel :
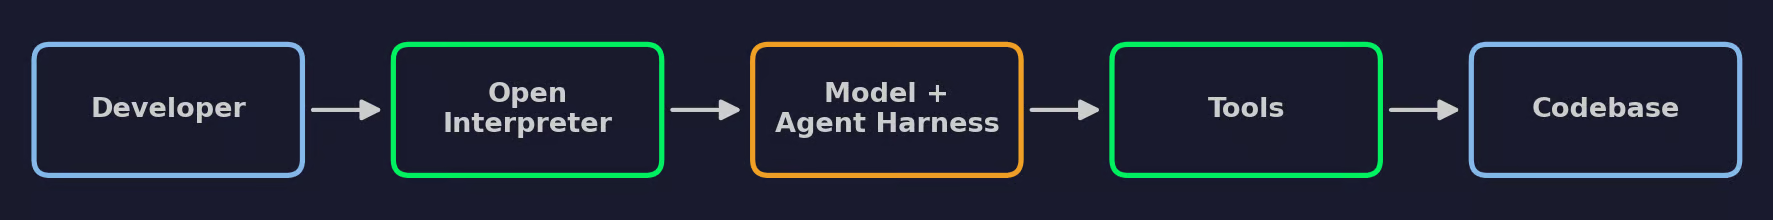
Comment fonctionne Open Interpreter
À retenir : vous ne parlez pas directement au modèle. Open Interpreter envoie votre tâche au modèle, formatée avec les prompts et les définitions d’outils du harnais actif. Le modèle demande des appels d’outils, et Open Interpreter les exécute sur votre codebase. Les résultats repartent ensuite vers le modèle pour l’étape suivante.
Comme le modèle et le harnais sont des couches distinctes, vous pouvez changer l’un ou l’autre sans toucher au reste de la configuration.
Open Interpreter s’installe sous forme de binaire autonome ; vous n’avez donc pas besoin de Python ni de pip.
Si un ancien article de blog vous demande d’exécuter pip install open-interpreter, il décrit l’ancienne version Python. Cette commande ne vous donnera pas l’agent de codage basé sur Rust décrit ici.
Vous aurez aussi intérêt à installer Git. Open Interpreter peut tourner sans, mais Git lui apporte une session consciente du dépôt et des diffs.
Exécutez le script d’installation depuis votre terminal :
curl -fsSL https://www.openinterpreter.com/install | shLe script télécharge la bonne release pour votre plateforme et place la commande interpreter dans ~/.local/bin.
Ouvrez PowerShell et lancez :
irm https://www.openinterpreter.com/install.ps1 | iexWSL est également pris en charge si vous préférez une configuration de type Linux. Dans ce cas, exécutez la commande macOS/Linux dans votre terminal WSL.
Redémarrez votre terminal pour qu’il prenne en compte le nouveau PATH, puis vérifiez la version :
interpreter --versionSi vous voyez un numéro de version, l’installation a réussi.
Vérification de version d’Open Interpreter
Démarrez une session depuis n’importe quel répertoire :
interpreterVous pouvez aussi taper i, un alias court pour la même commande.
Open Interpreter ouvre une interface terminal où vous décrivez les tâches en anglais simple. Au premier démarrage, il vous demande de connecter un fournisseur de modèles. J’utiliserai un modèle local via Ollama dans la section suivante ; vous pouvez donc ignorer cette étape pour l’instant.
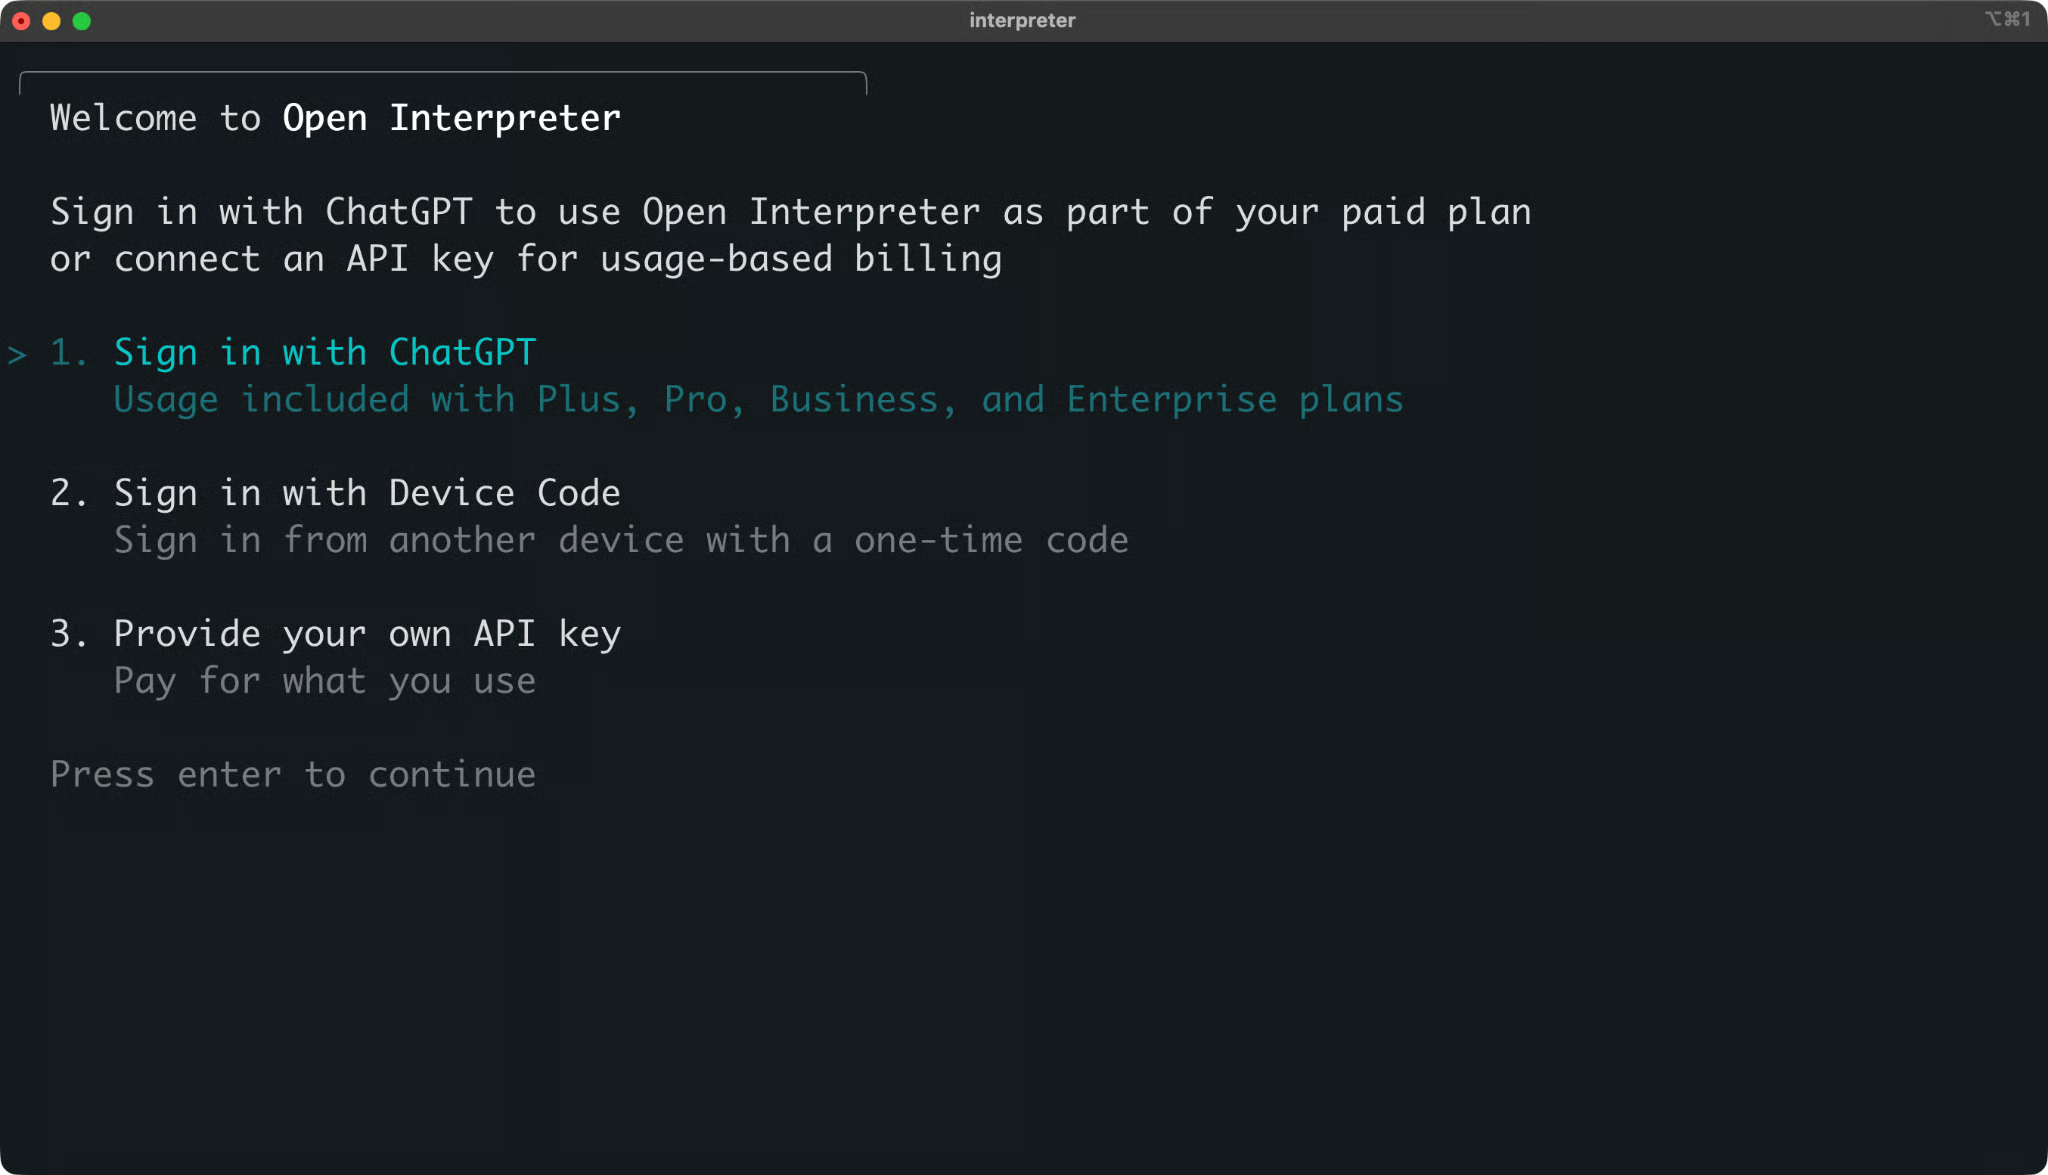
Session interactive Open Interpreter
Pour quitter la session, tapez /exit.
Le moyen le plus rapide de comprendre un agent de codage est de lui donner une tâche et d’observer ce qu’il en fait.
J’utiliserai un petit projet de suivi d’habitudes pour toute cette section. Il contient une fonction, un fichier de test et un bug.
Le projet calcule la plus longue série de jours consécutifs pour une habitude. Par exemple, le nombre de jours d’affilée où vous avez fait du sport.
Commencez par un dossier de projet et un environnement virtuel :
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
Créez habits.py avec le code suivant :
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
Créez ensuite test_habits.py :
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
La fonction a un bug. Je ne le pointerai pas, car c’est le rôle de l’agent de le trouver.
Ajoutez un fichier .gitignore pour exclure l’environnement virtuel et les caches du dépôt :
.venv/
__pycache__/
.pytest_cache/
Validez maintenant le projet :
git init
git add .
git commit -m "Initial commit"
Ce commit vous donne un point de départ propre. Plus tard, vous l’utiliserez pour voir exactement ce que l’agent a modifié.
Lancez les tests pour confirmer le bug :
python -m pytest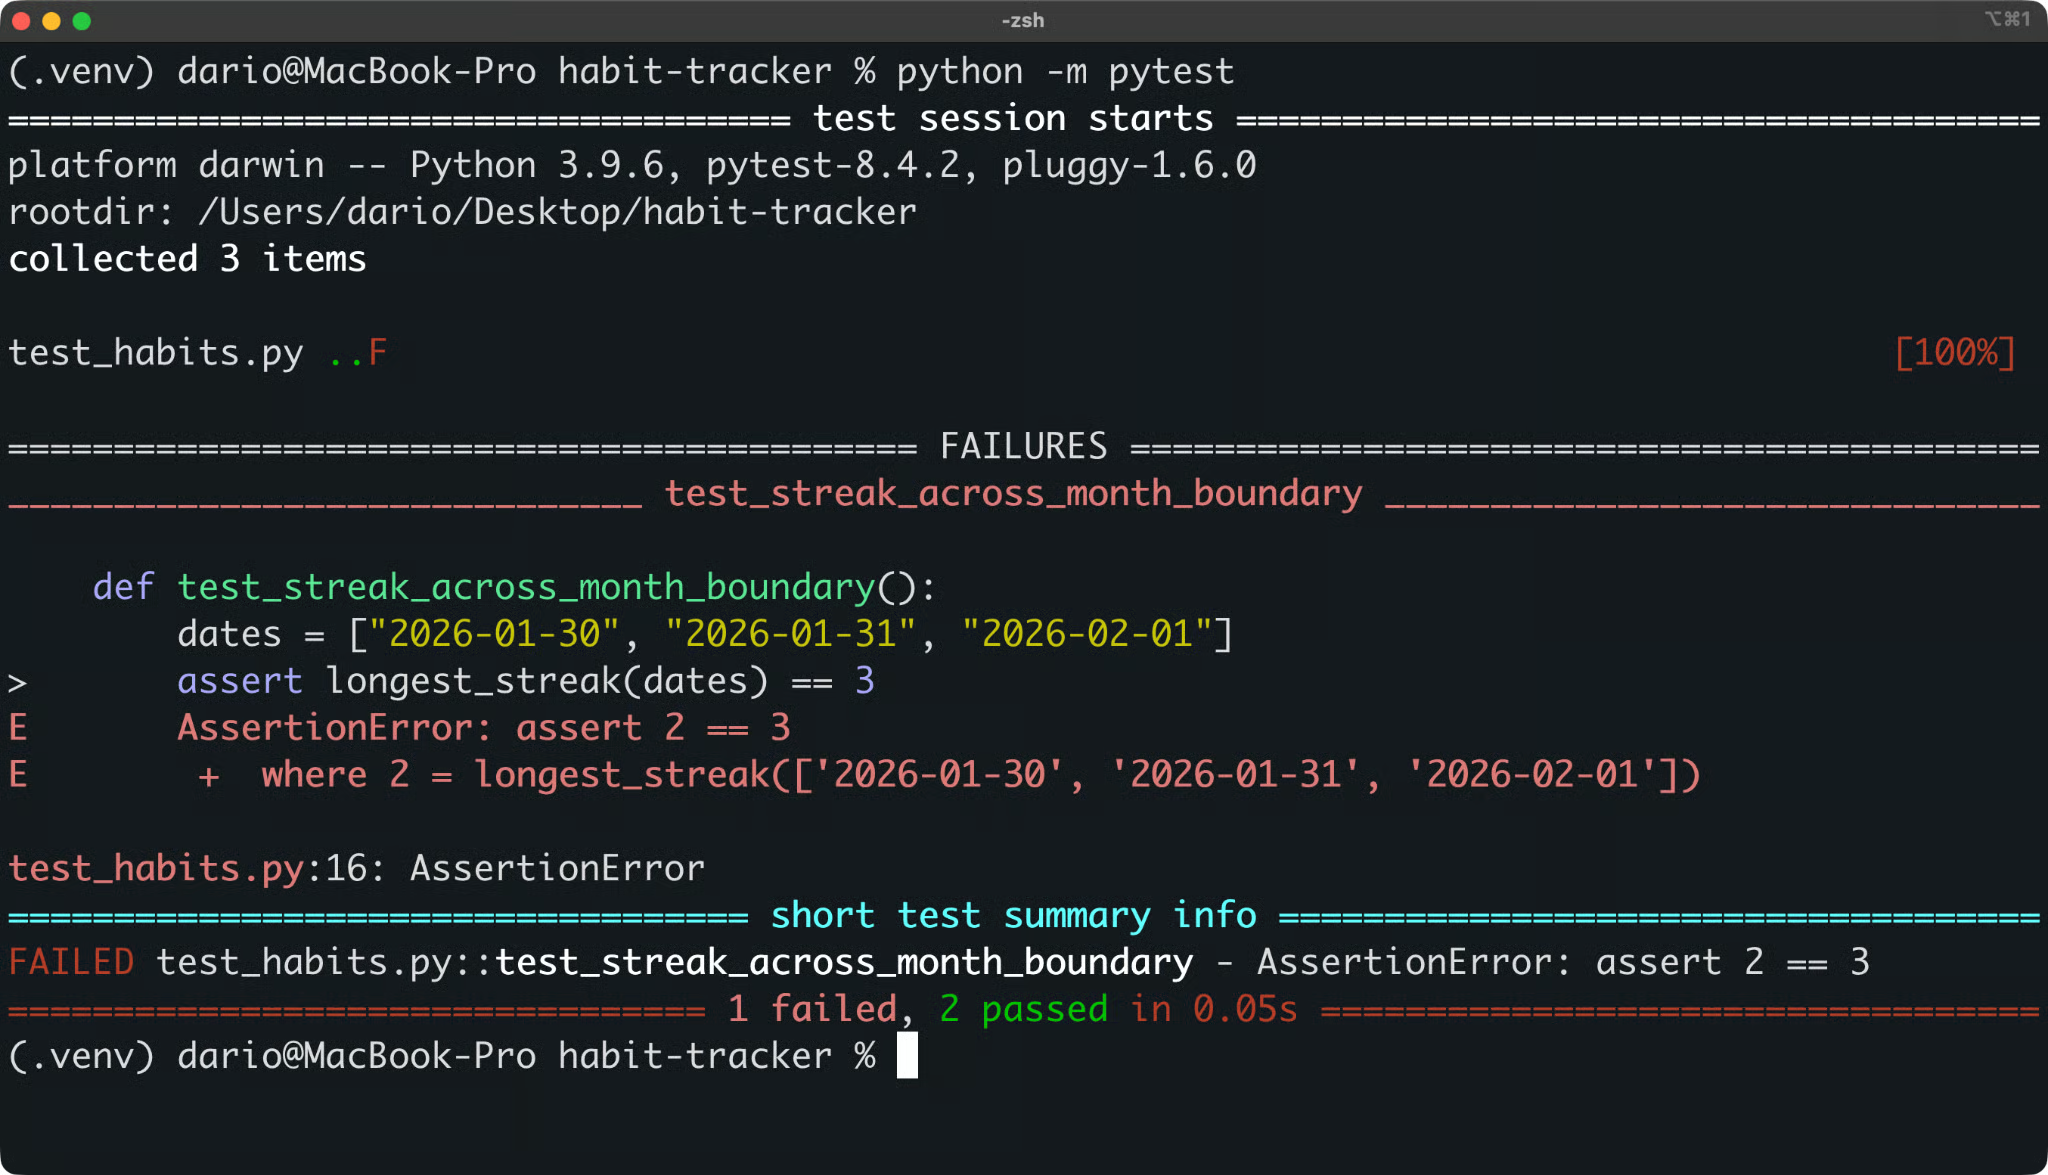
Résultat des tests du suiveur d’habitudes
Deux tests passent et un échoue. C’est le problème qu’Open Interpreter doit résoudre.
Vous aurez besoin d’Ollama installé et en cours d’exécution. Il vous faudra aussi un modèle qui gère les appels d’outils ; récupérez‑le :
ollama pull qwen3-coder:30bDémarrez ensuite Open Interpreter depuis le dossier du projet. Utilisez le même terminal afin que l’agent puisse utiliser l’installation de pytest de votre environnement virtuel :
interpreter --oss --local-provider ollama -m qwen3-coder:30bVoici ce que fait chaque option :
--oss : utilise un fournisseur local open source
--local-provider ollama : choisit Ollama plutôt que LM Studio
-m qwen3-coder:30b : définit le modèle pour cette exécution
Exécutez /status pour confirmer le fournisseur actif, le modèle, le mode sandbox et la politique d’approbation.
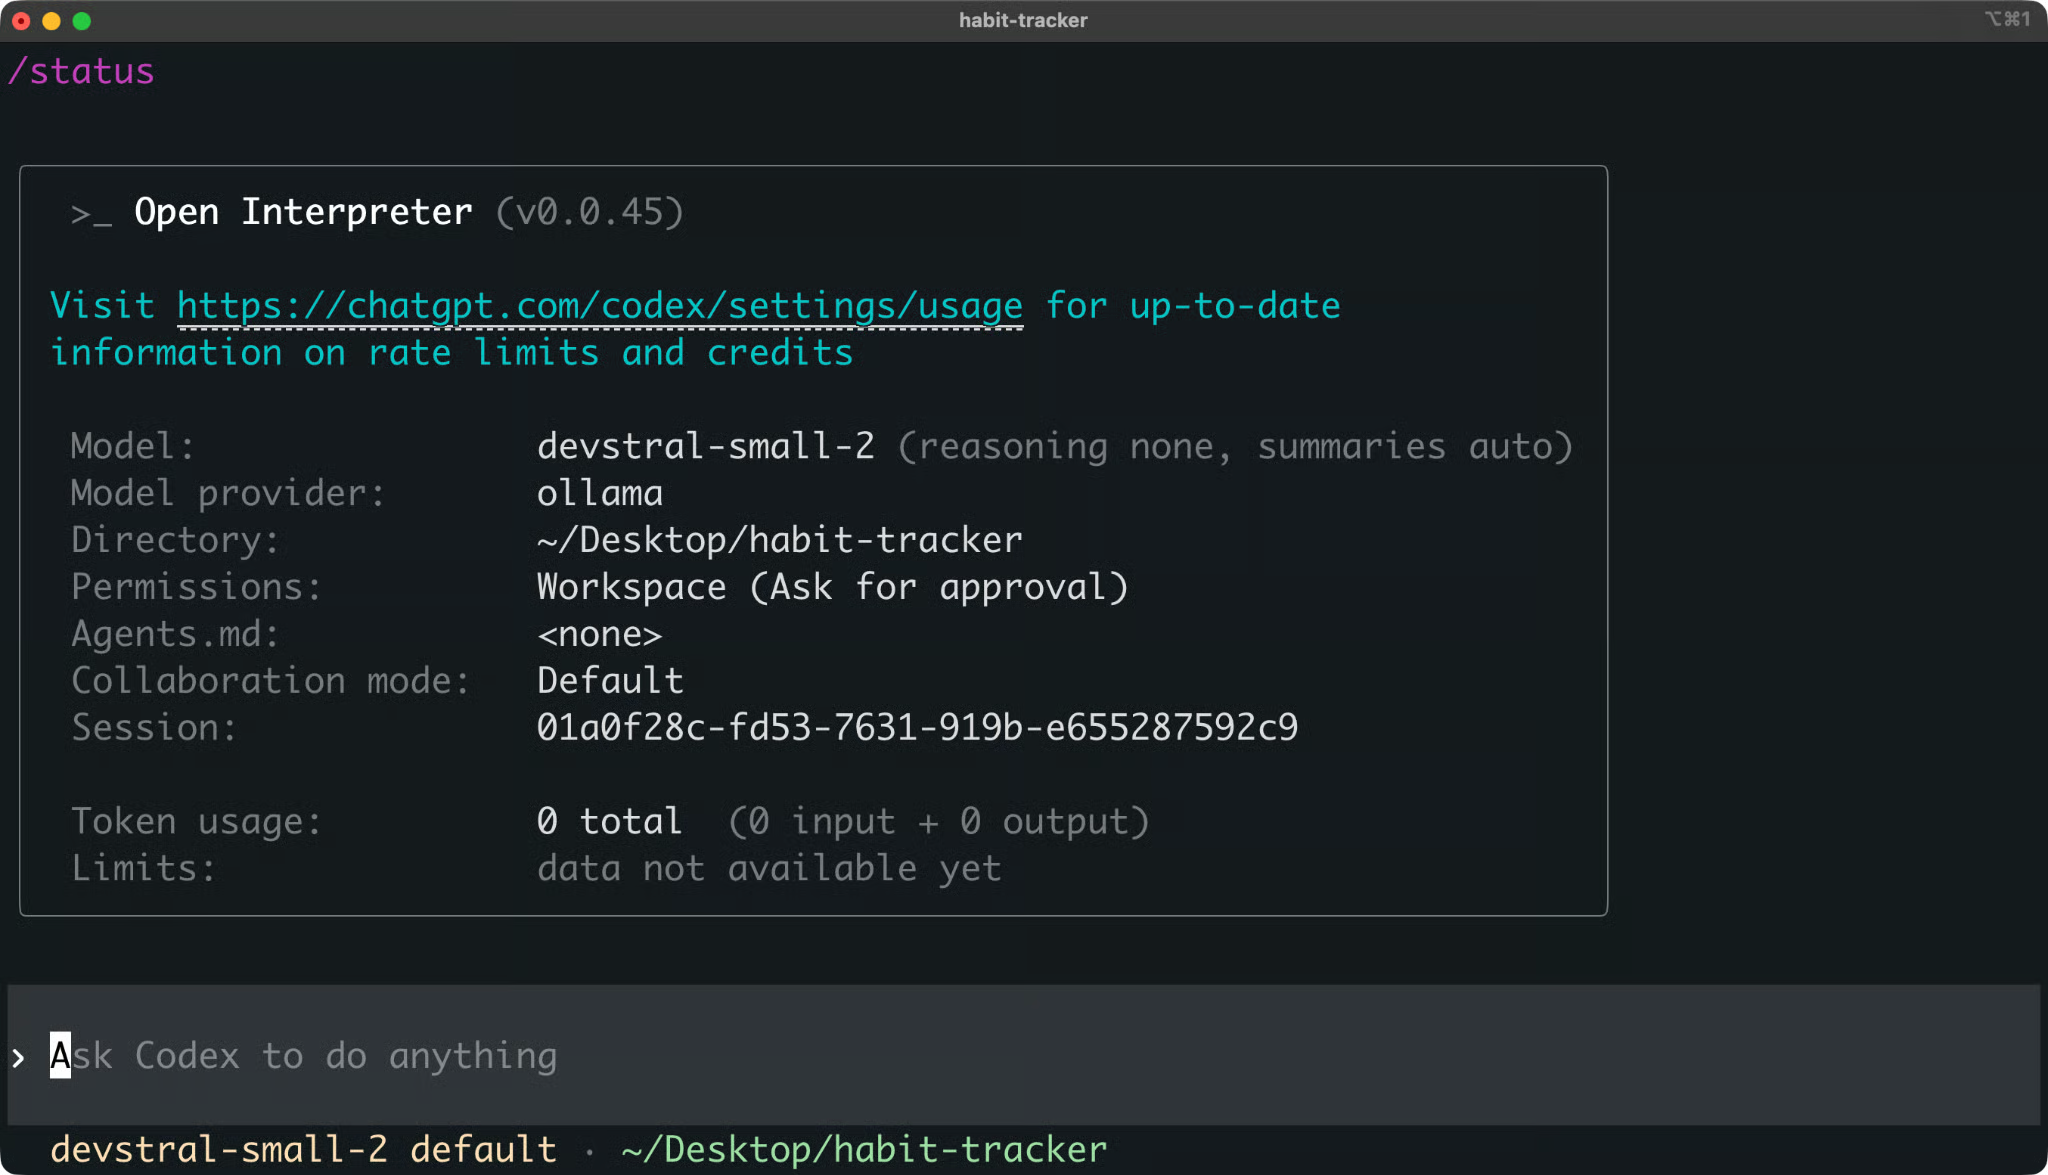
Session Open Interpreter avec un modèle Ollama local
Vous ne voulez pas que l’agent modifie quoi que ce soit pour le moment. Demandez d’abord un diagnostic :
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.L’agent lira généralement les fichiers et exécutera les tests avant de répondre. Les commandes s’exécutent dans le bac à sable et, si l’agent a besoin de plus d’accès que le sandbox ne l’autorise, il vous demandera d’abord votre approbation.
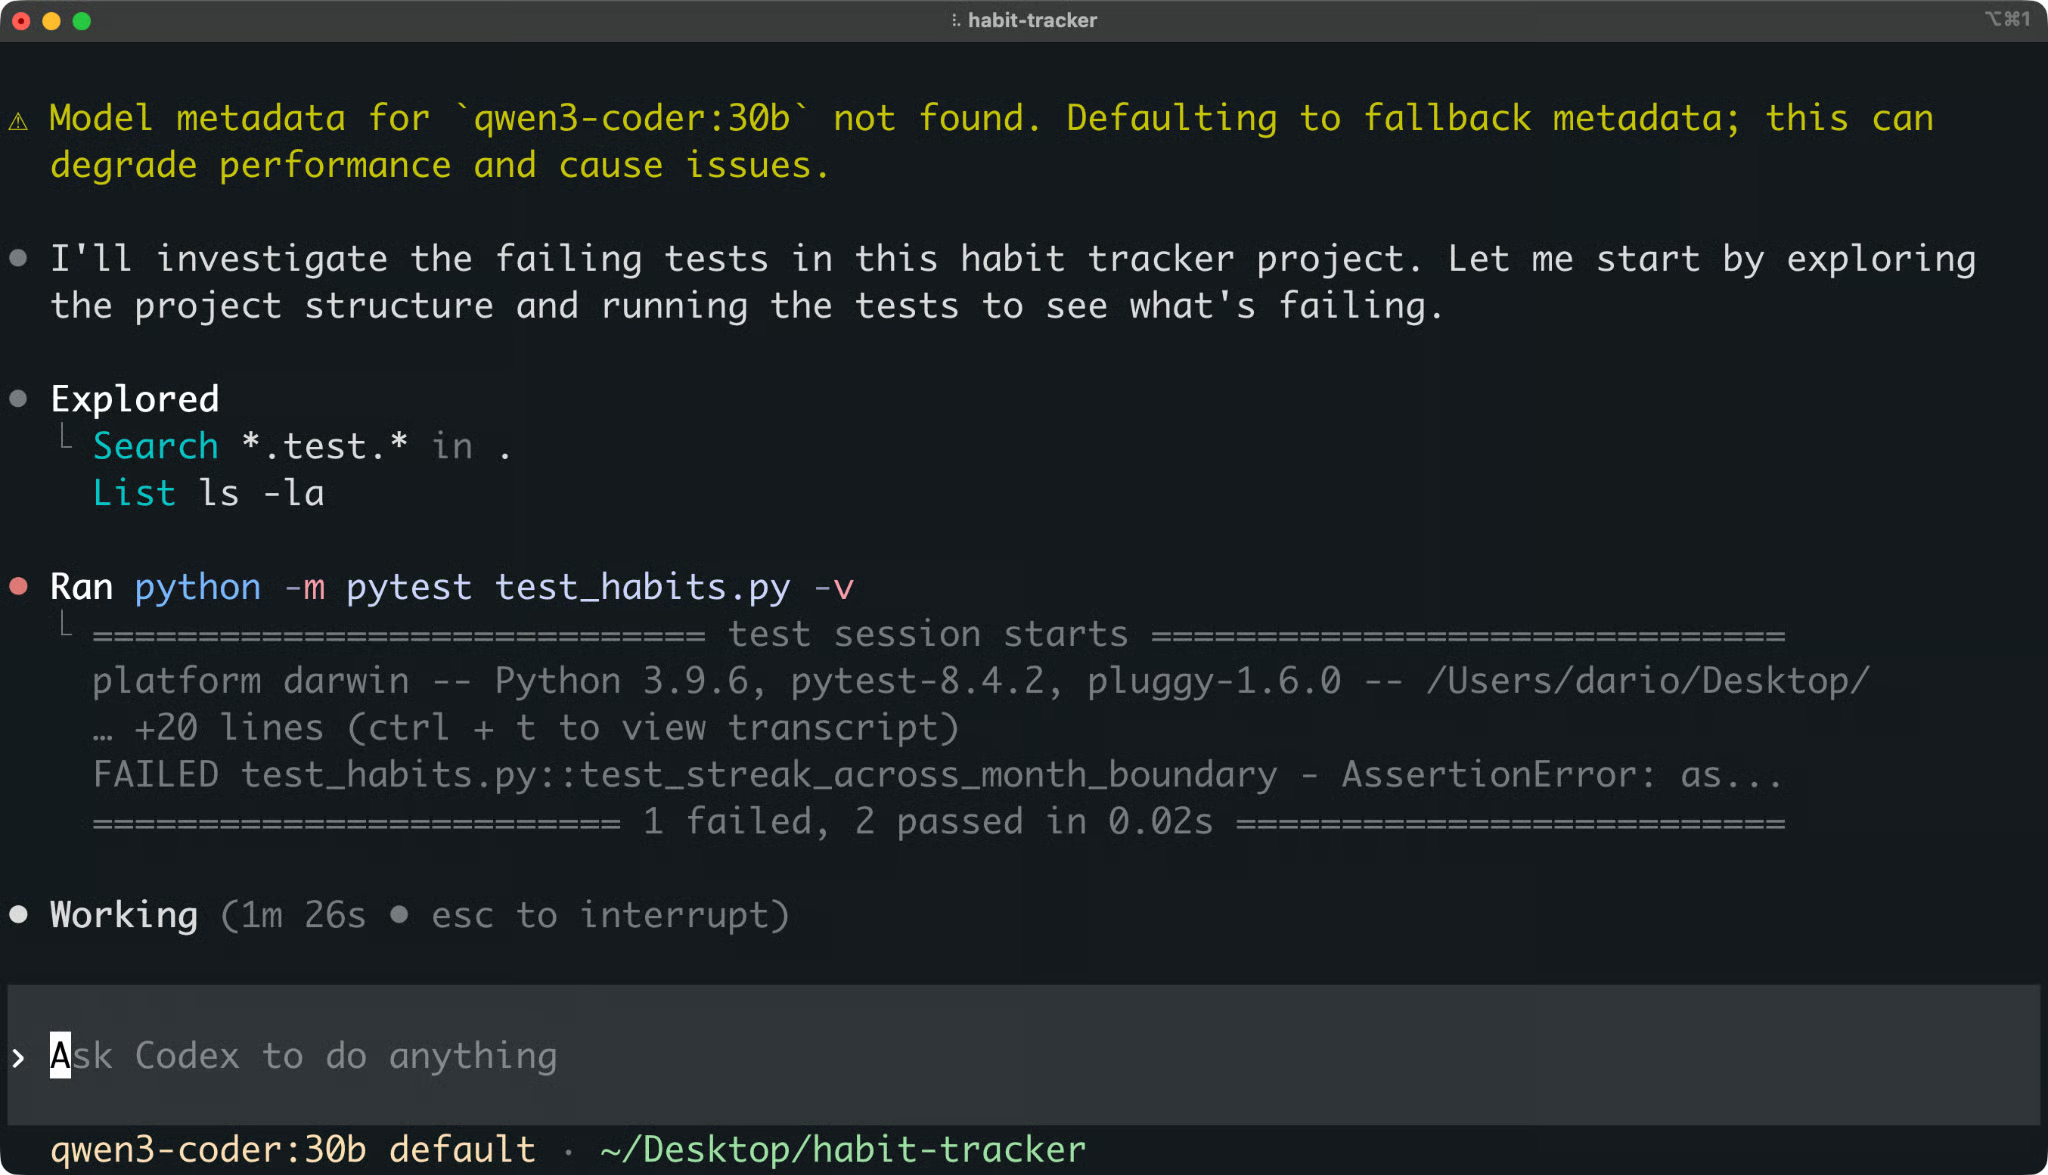
Sortie d’Open Interpreter
Lisez l’explication avant d’approuver quoi que ce soit.
Un diagnostic correct indique que la fonction compare uniquement le jour du mois, si bien qu’une série se brise lorsqu’elle franchit un nouveau mois. Un bon correctif compare des dates complètes, par exemple avec date.fromisoformat() du module datetime de Python.
Si le diagnostic est erroné, corrigez‑le dans la même session avant que l’agent n’édite le code.
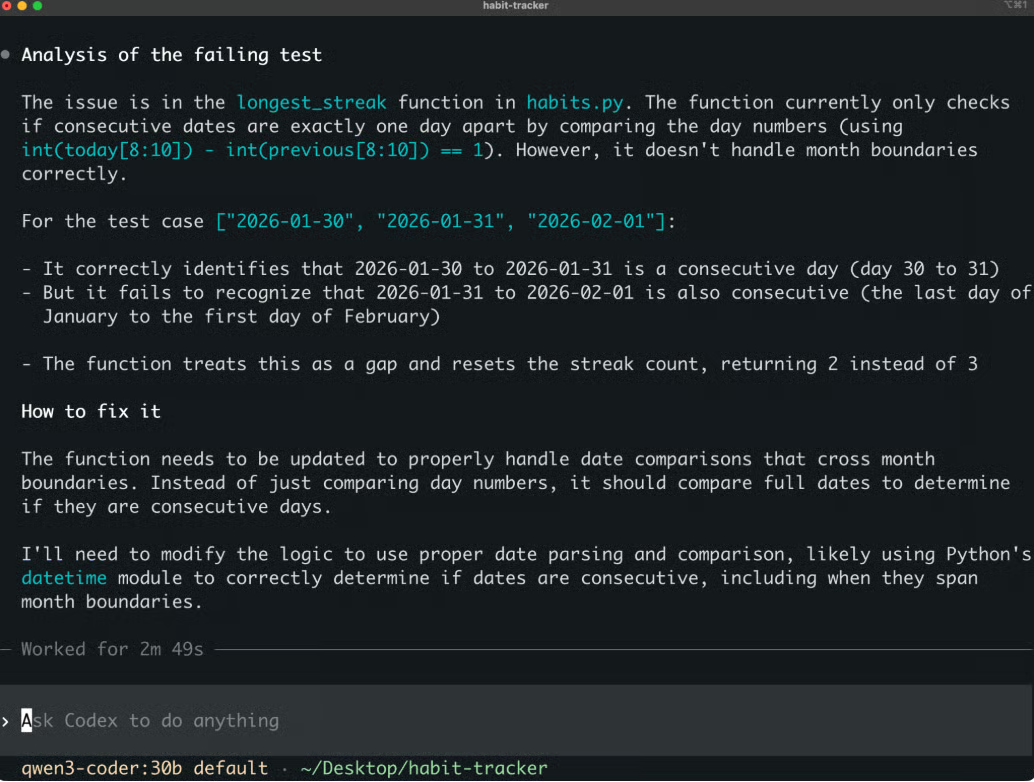
Proposition de correctif d’Open Interpreter
Une fois le plan validé, appliquez le correctif :
Apply the fix to habits.py, then run the tests.L’agent modifie le fichier et relance pytest. Vous voulez voir les trois tests passer.
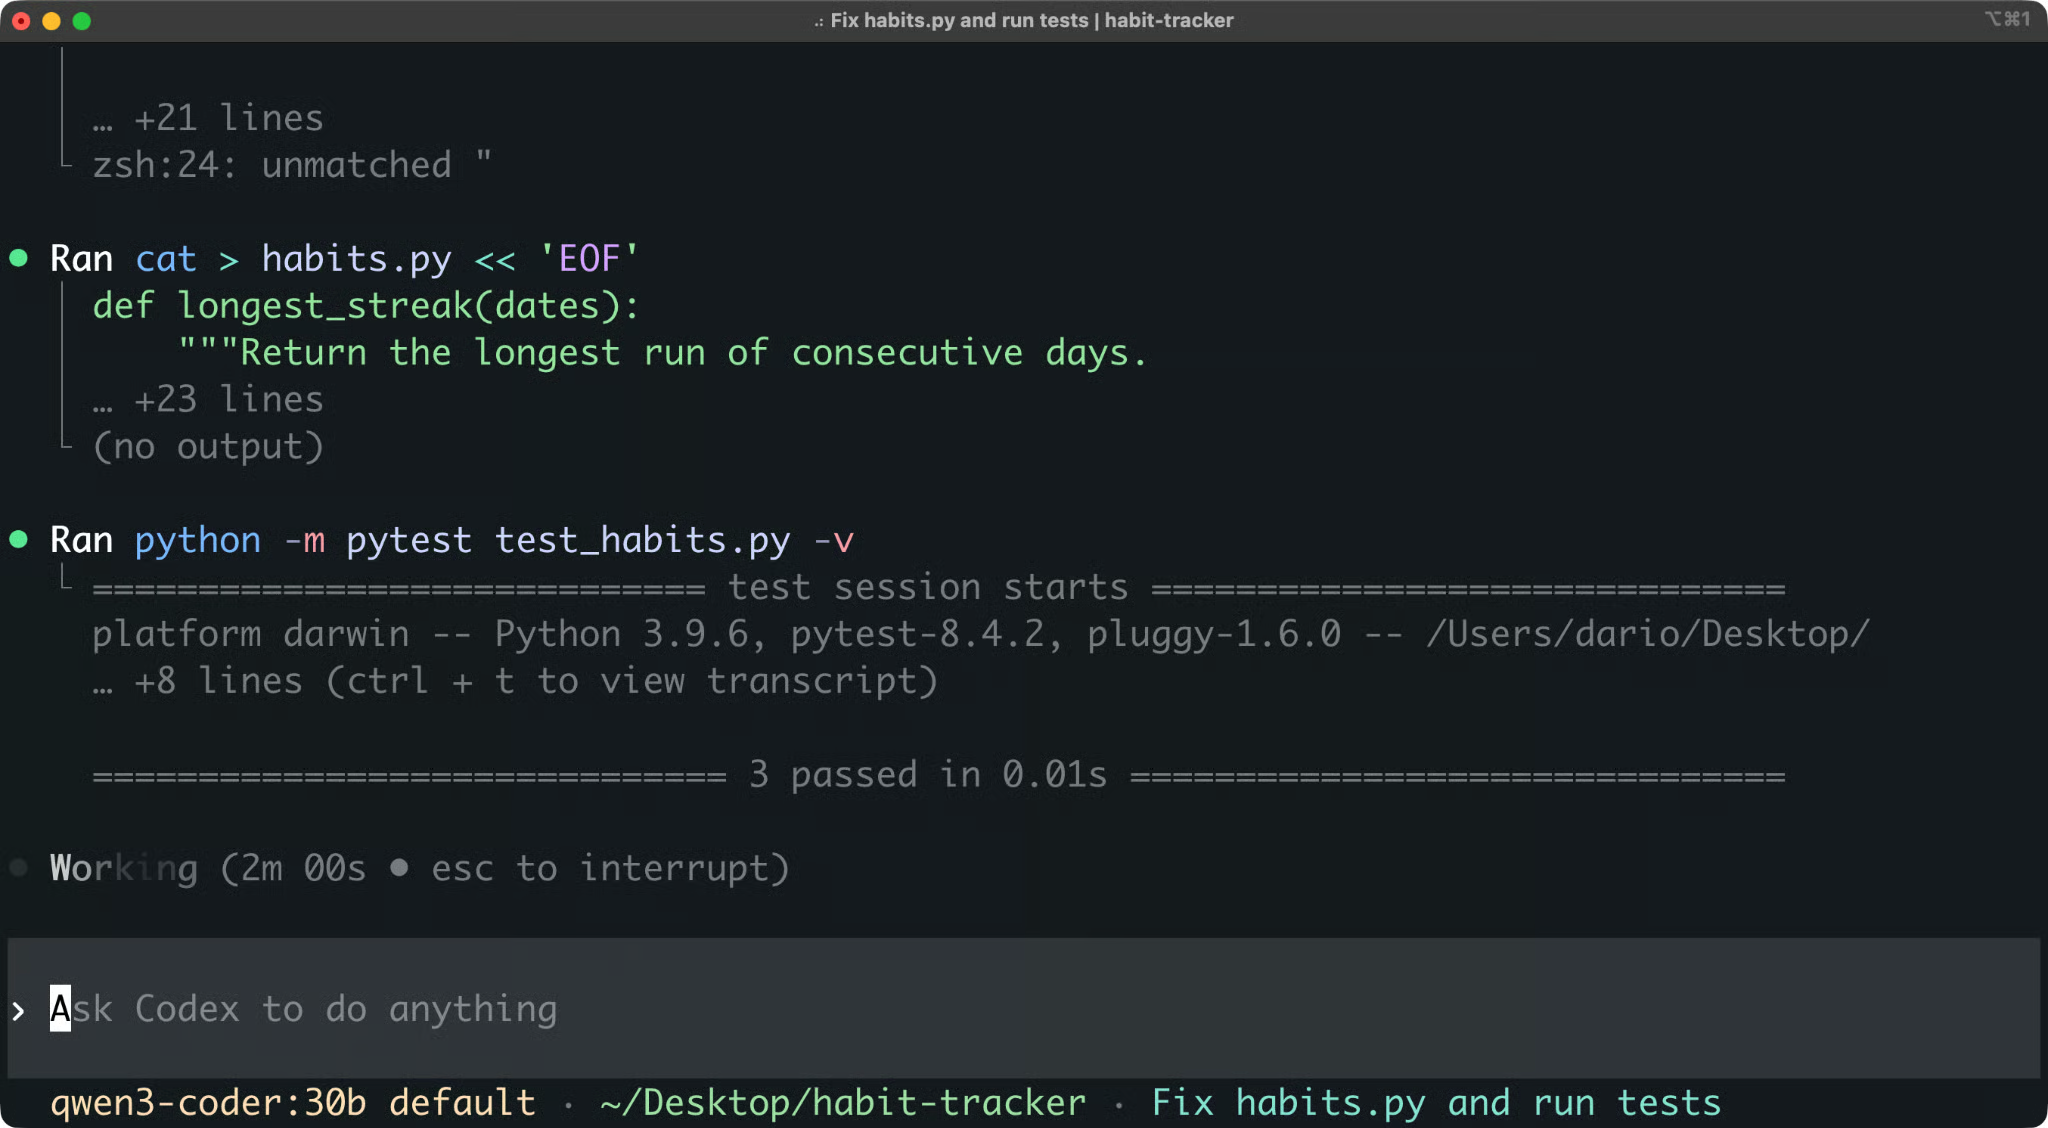
Tous les tests passent après le correctif
Des tests au vert ne signifient pas forcément que le bug est résolu dans votre code. Le test a peut‑être été ajusté pour contourner le bug. Vous devez tout de même relire le code.
Exécutez /diff dans la session pour voir les changements du working tree. Vous pouvez aussi lancer git diff après avoir quitté.
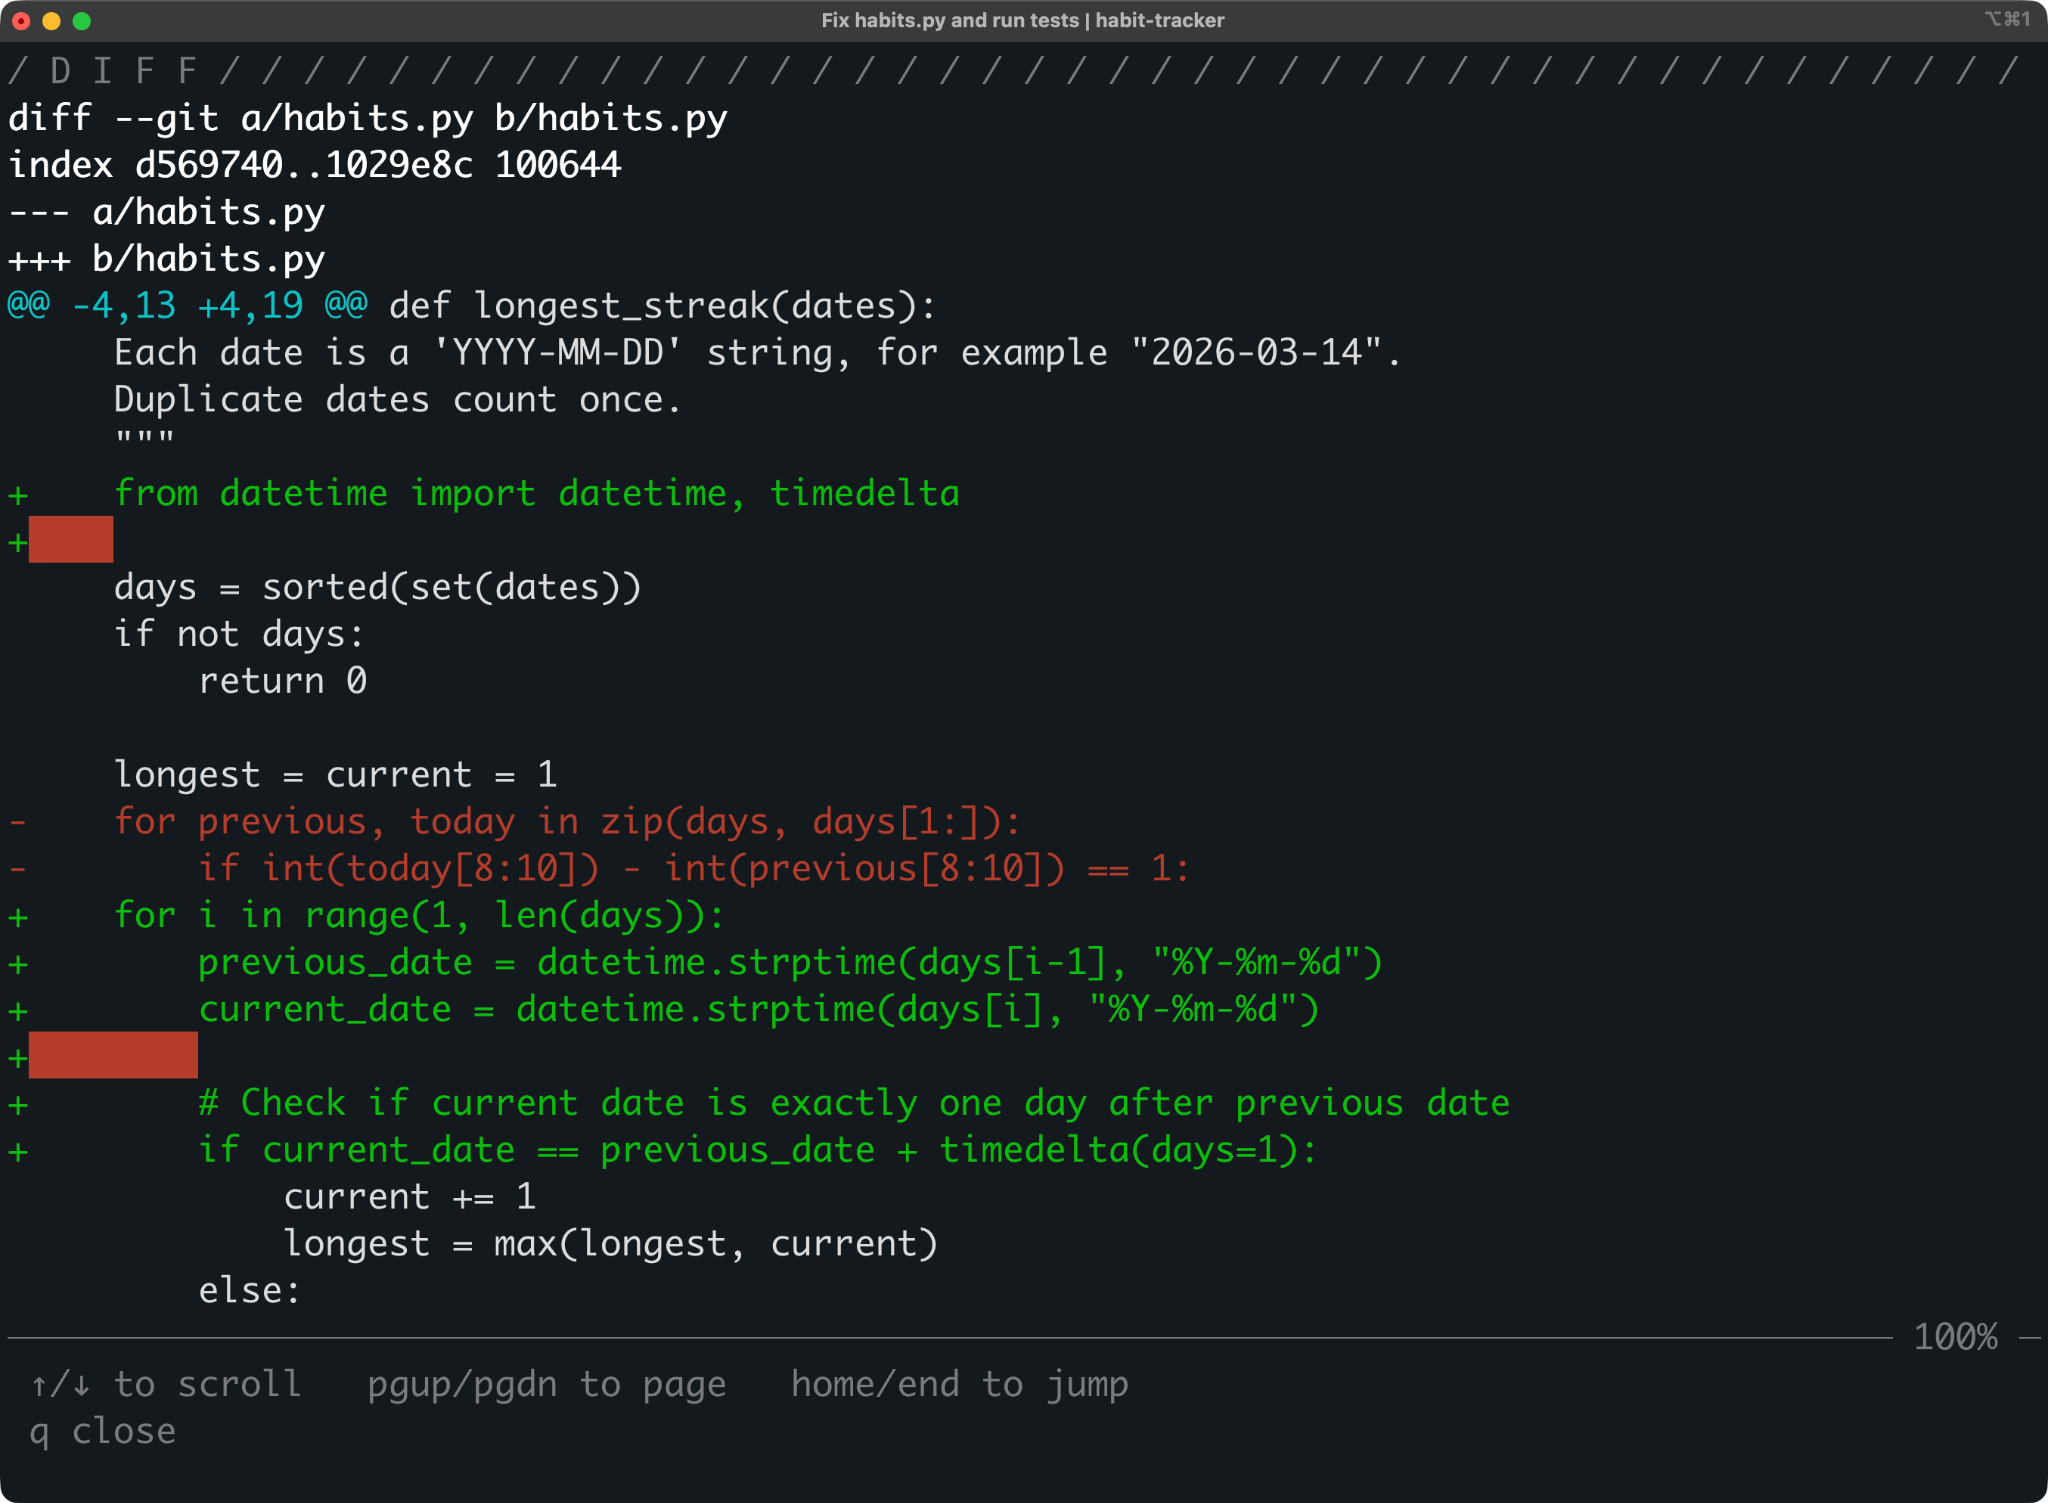
Le diff des changements effectués par Open Interpreter
Le diff exact dépend du modèle, donc le vôtre peut différer ligne par ligne. Si la modification vous convient, validez‑la ; sinon, restaurez le fichier d’origine :
git restore habits.pyEt voilà l’idée : vous décrivez le problème, l’agent enquête et le corrige, et vous relisez chaque changement avant qu’il n’entre dans votre code.
Open Interpreter vous demande d’apporter votre propre modèle.
Chaque requête passe par trois couches :
| Couche | Exemple | Ce qu’elle contrôle |
|---|---|---|
| Fournisseur | ollama | Où vont les requêtes et comment vous vous authentifiez |
| Modèle | devstral-small-2 | Le modèle qui fait le travail |
| Harnais | native | Les prompts, outils et le format de messages autour du modèle |
Couches d’une requête
Voici ce que vous pouvez connecter :
La liste des fournisseurs est générée depuis un catalogue public de modèles, et elle ne retient que ceux qui prennent en charge l’appel d’outils. Si un modèle attendu manque, c’est généralement la raison.
Attention à ollama-cloud. C’est un fournisseur hébergé distinct ; vos requêtes quittent donc votre machine. Seul le fournisseur intégré ollama exécute des modèles localement.
Vous pouvez changer de modèle à trois niveaux :
Dans une session : exécutez /model pour choisir le fournisseur, le modèle et l’effort de raisonnement
Pour une seule exécution : passez l’option -m, comme dans la section précédente
Par défaut : définissez‑le dans votre fichier de configuration
Vous pouvez exécuter /status à tout moment pour voir quel fournisseur et quel modèle sont actifs.
Open Interpreter lit ses paramètres depuis ~/.openinterpreter/config.toml. Pour faire de la configuration Ollama de la section précédente votre valeur par défaut, ajoutez ces deux lignes :
model_provider = "ollama"
model = "qwen3-coder:30b"
Ensuite, interpreter démarre avec ce modèle, sans options supplémentaires.
Les fournisseurs hébergés lisent leurs clés API depuis des variables d’environnement. Par exemple, DeepSeek attend DEEPSEEK_API_KEY :
export DEEPSEEK_API_KEY="your-api-key"Vous pouvez aussi ajouter n’importe quel endpoint compatible OpenAI comme fournisseur personnalisé :
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
Le paramètre wire_api indique à Open Interpreter le format attendu par l’endpoint. Utilisez chat pour les Chat Completions compatibles OpenAI, responses pour l’API Responses d’OpenAI, et messages pour les endpoints de type Anthropic.
Un projet de confiance peut aussi avoir son propre .openinterpreter/config.toml, qui surcharge votre config utilisateur. Les options en ligne de commande priment sur les deux. Si vous ne savez pas quelle valeur l’emporte, exécutez /debug-config pour voir les paramètres effectifs et leur origine.
Le modèle détermine la qualité de compréhension de votre code. Le harnais décide comment le modèle perçoit la tâche et les outils.
Vous avez besoin des deux. Un bon modèle dans un harnais inadapté envoie des appels d’outils mal formés et interprète mal les résultats. Et un bon harnais ne compensera pas un modèle qui ne comprend pas le code.
C’est pourquoi Open Interpreter choisit un harnais quand vous choisissez un modèle. Par exemple :
Les modèles Claude utilisent le harnais claude-code
Les modèles Kimi utilisent kimi-code
Les modèles Qwen utilisent qwen-code
Les modèles DeepSeek utilisent claude-code-bare
Pour d’autres familles de modèles, vous pouvez choisir le harnais vous‑même avec /harness.
À retenir : un résultat décevant ne signifie pas toujours que le modèle est faible. Avant de changer de modèle, essayez le même modèle avec un autre harnais, ce que je détaille dans la section suivante.
L’émulation de harnais est la raison principale d’être de la version actuelle d’Open Interpreter.
Un harnais d’agent est tout ce qui entoure le modèle pour en faire un agent. Il comprend :
En clair, le harnais décide comment le modèle voit la tâche et comment ses décisions se traduisent en actions.
Open Interpreter propose un ensemble de modes de harnais intégrés. Voici ceux que vous utiliserez le plus :
native : le harnais propre à Open Interpreter, hérité de Codex
claude-code : émule les prompts et la surface d’outils de Claude Code d’Anthropic
kimi-code : réimplémentation Rust du harnais Kimi Code recommandé par Moonshot pour ses modèles Kimi
qwen-code : émule la CLI Qwen Code d’Alibaba pour les modèles Qwen
swe-agent : émule SWE-agent, un agent de recherche conçu pour résoudre des issues GitHub
La liste complète inclut aussi des variantes comme claude-code-bare, kimi-cli, deepseek-tui, zcode et minimal. Exécutez /harness dans une session pour voir ce que votre version prend en charge.
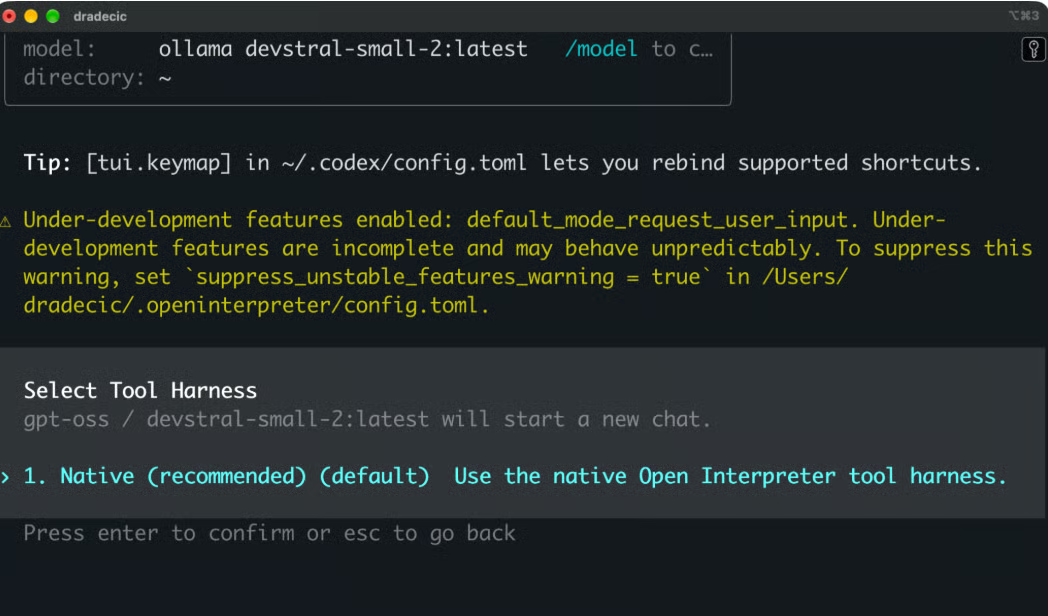
Vous pouvez changer de harnais en cours de session avec /harness, ou définir une valeur par défaut dans ~/.openinterpreter/config.toml :
harness = "kimi-code"
harness_guidance = true
Le paramètre harness_guidance ajoute une guidance de fiabilité lorsque le harnais le permet. Passez‑le à false si vous voulez une émulation plus stricte. Si vous ne définissez pas harness, Open Interpreter en choisit un selon la famille de modèles, comme vu précédemment.
La plupart des éditeurs ajustent leurs modèles de codage dans un environnement d’agent spécifique et publient un harnais recommandé avec.
Le modèle s’habitue à ce harnais. Il apprend son style de prompt, ses noms d’outils, son format d’édition de fichiers et la façon dont les résultats d’outils reviennent.
Supposons que vous exécutiez un modèle ajusté pour des éditions « chercher/remplacer » dans un harnais qui attend des fichiers de patch complets. Le modèle sait quoi changer, mais décrit le changement dans le mauvais format. La boucle de l’agent consomme des tokens sans progresser.
Les résultats d’outils suivent la même logique. Si le harnais renvoie des résultats dans un format inconnu du modèle, celui‑ci les interprète mal. Si le harnais efface le raisonnement du modèle entre les tours, un modèle « pensant » perd le fil de son propre plan.
Conclusion : le même modèle peut paraître excellent dans un agent et médiocre dans un autre, sans changement de poids. C’est aussi pourquoi les benchmarks de codage indiquent généralement le harnais utilisé pour chaque run.
Les modèles de pointe ont tendance à se remettre d’un harnais inhabituel, mais les modèles plus petits et moins chers y parviennent rarement. Open Interpreter n’impose pas un format unique à tous les modèles ; il adapte le format au modèle.
Vous pouvez le tester vous‑même avec le projet de démo. Restaurez le fichier d’origine avec git restore habits.py, changez le harnais avec /harness, puis donnez à l’agent le même prompt. Comparez ensuite le nombre d’étapes et le format de ses éditions.
Vous avez déjà aperçu la plupart de ces fonctionnalités. Voici ce qu’elles vous apportent au quotidien.
Open Interpreter travaille dans votre dépôt Git. Il lit la structure du projet et suit ce qu’il a modifié.
Deux commandes « slash » aident ici. /diff affiche les changements du working tree, et /review demande à l’agent de vérifier les changements actuels pour détecter bugs et régressions avant de valider. Vous pouvez lancer la même revue sans ouvrir de session :
interpreter exec review --uncommittedLes sessions sont aussi sauvegardées. Si vous vous arrêtez en cours de tâche, interpreter resume --last reprend là où vous étiez.
L’agent exécute les mêmes commandes que vous : suites de tests, linters, scripts de build, gestionnaires de paquets, etc. Tout tourne dans un bac à sable natif sous macOS, Linux et Windows.
Les commandes longues peuvent tourner en arrière‑plan. Utilisez /ps pour les lister et /stop pour les arrêter.
Pour les scripts et pipelines CI, interpreter exec lance une tâche sans l’interface interactive :
interpreter exec "fix the failing test"Vous pouvez changer de fournisseur et de modèle à tout moment avec /model. Votre configuration, AGENTS.md et vos skills restent valables après le changement.
Les profils sont utiles ici. Disons que vous voulez un modèle économique pour les tâches courantes et un plus puissant pour les revues de code. Vous pouvez définir les deux dans votre configuration :
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
Démarrez ensuite avec interpreter --profile review quand vous en avez besoin.
/harness modifie la façon dont le modèle perçoit la tâche sans changer le modèle. C’est la première chose à essayer quand un modèle peine avec les appels d’outils, avant de passer à un modèle plus grand.
Le Model Context Protocol (MCP) connecte l’agent à des outils pour lesquels il n’a pas été conçu, comme des serveurs de documentation ou des bases de données. Vous ajoutez des serveurs dans votre configuration :
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
Exécutez /mcp pour voir les serveurs configurés et leurs outils. Le paramètre default_tools_approval_mode fait que l’agent demande avant d’utiliser un outil de ce serveur.
Cela fonctionne aussi dans l’autre sens. interpreter mcp-server expose Open Interpreter comme serveur MCP, et interpreter acp l’exécute dans les éditeurs compatibles avec l’Agent Client Protocol, une norme ouverte pour connecter éditeurs et agents de codage.
AGENTS.md est un fichier Markdown dans votre dépôt, avec des règles de projet que l’agent lit à chaque tâche. Pour le suiveur d’habitudes, il pourrait ressembler à ceci :
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
Vous pouvez aussi exécuter /init, et l’agent écrira une première version pour vous.
Les skills sont des workflows réutilisables, packagés en dossiers dans .agents/skills dans votre projet ou ~/.agents/skills pour votre utilisateur. L’agent détecte automatiquement une skill quand une tâche y correspond. Exécutez /skills pour voir celles disponibles.
Ces formats sont partagés ; les mêmes fichiers fonctionnent avec d’autres agents de codage compatibles. Open Interpreter gère aussi des hooks, qui exécutent vos propres commandes à des moments précis d’une session. Vous les revoyez et les approuvez avec /hooks.
Deux paramètres contrôlent ce que l’agent peut faire :
Mode sandbox : read-only, workspace-write ou danger-full-access
Politique d’approbation : untrusted, on-request ou never
Le sandbox définit ce qui est possible, et la politique d’approbation définit quand l’agent demande d’abord. Avec workspace-write et on-request, l’agent peut modifier votre projet et exécuter des tests, mais il demande avant de dépasser ce périmètre.
Vous pouvez changer les deux avec /permissions ou avec les options -s et -a. Il existe aussi une option --yolo qui contourne les deux ; la documentation la qualifie de dangereuse. Je détaillerai ces réglages dans la section sécurité.
Open Interpreter se présente comme un agent de codage conçu pour les modèles à faible coût.
Les plus grands agents de codage propriétaires sont conçus autour des modèles de leur éditeur. Open Interpreter vous offre un seul agent qui fonctionne avec des modèles propriétaires, des modèles open‑weight hébergés et des modèles locaux.
Les modèles open‑weight comme Kimi, DeepSeek, GLM et Qwen publient leurs poids. Vous pouvez les utiliser via un fournisseur tiers ou sur votre propre matériel.
Cela vous donne deux avantages : les modèles open‑weight hébergés coûtent généralement moins cher par token que les modèles propriétaires de pointe. Et vous n’êtes pas limité à un seul hébergeur, puisque le même modèle tourne partout où ses poids sont pris en charge.
Open Interpreter propose des guides dédiés pour Kimi K3, DeepSeek et GLM. Il choisit également le harnais adapté à ces familles de modèles.
Ollama et LM Studio sont des fournisseurs intégrés ; vous pouvez donc exécuter un modèle sur votre machine sans clé API ni coûts au token.
Le coût est matériel. Quand j’ai testé devstral-small-2 sur mon MacBook Pro M1 Max avec 64 Go de mémoire unifiée, le modèle seul en utilisait 26 Go. La fenêtre de contexte par défaut d’Ollama était trop petite pour la boucle d’agent, et à 128k tokens, l’usage mémoire montait et descendait jusqu’à bloquer la session.
Les agents de codage ont besoin d’une grande fenêtre de contexte, car le prompt système, les définitions d’outils, le contenu des fichiers et la sortie des commandes doivent tous tenir. Ollama recommande au moins 64k tokens pour les agents de type Codex. Et une fenêtre plus grande consomme davantage de mémoire en plus du modèle lui‑même.
Open Interpreter tourne sur votre machine, mais le modèle n’a pas à le faire.
L’endroit où va votre code dépend du fournisseur :
Votre configuration, vos sessions et vos logs sont stockés localement sous ~/.openinterpreter quoi qu’il arrive.
Si vous avez besoin de plus de contrôle, vous pouvez ajouter un fournisseur personnalisé pointant vers votre propre serveur d’inférence. Tout serveur avec une API compatible OpenAI fonctionne, par exemple un déploiement vLLM sur les GPU de votre entreprise. Ainsi, vous obtenez une configuration hébergée dont l’infrastructure vous appartient.
Les modèles open ne sont pas tous aussi bons avec l’appel d’outils. Vous verrez une faiblesse se traduire par des appels mal formés, des boucles, des arrêts prématurés ou une ignorance de la sortie des commandes.
Le bon harnais aide, mais il ne corrigera pas un modèle qui ne sait pas planifier une tâche multi‑étapes. Les petits modèles locaux sont les plus touchés.
Avant de diriger un nouveau modèle sur un vrai projet, testez‑le sur un petit dépôt comme le suiveur d’habitudes présenté ici. En cas de faiblesse, essayez un autre harnais avant de passer à un modèle plus grand.
Récapitulatif rapide de vos options :
| Où tourne l’inférence | Coût | Votre code quitte la machine ? | |
|---|---|---|---|
| Modèle propriétaire hébergé | Serveur du fournisseur | Au token ou par abonnement | Oui |
| Modèle open‑weight hébergé | Serveur du provider | Au token, généralement plus bas | Oui |
| Modèle open‑weight local | Votre matériel | Matériel et électricité | Non |
Options Open Interpreter pour les modèles locaux et open
Open Interpreter partage beaucoup de choses avec d’autres agents de codage en terminal. Les différences tiennent à la gouvernance de l’outil et aux modèles visés.
Claude Code est l’agent de codage en terminal d’Anthropic. Première différence : la propriété — Claude Code est propriétaire, tandis qu’Open Interpreter est open source sous licence Apache 2.0. Vous pouvez lire et modifier chaque partie d’Open Interpreter.
Le choix du modèle est la deuxième : Claude Code est conçu pour les modèles Claude. Vous pouvez le pointer vers des endpoints compatibles Anthropic d’autres fournisseurs, mais son harnais reste optimisé pour Claude. Open Interpreter fait du choix du modèle une fonctionnalité centrale.
La comparaison des harnais est intéressante. Claude Code est lui‑même l’un des harnais qu’Open Interpreter émule. Avec le mode claude-code, n’importe quel modèle reçoit des prompts et outils de type Claude Code dans l’environnement d’Open Interpreter. L’UI et les commandes « slash » restent celles d’Open Interpreter ; ce n’est donc pas le même produit avec un autre modèle.
Les deux outils sont « terminal‑first ». Chacun propose une session interactive et un mode non interactif pour scripts et CI. Pour les instructions de projet, Claude Code lit CLAUDE.md, tandis qu’Open Interpreter utilise le format partagé AGENTS.md.
Claude Code dispose d’un écosystème plus vaste : extensions IDE, applications desktop et web, marketplace de plugins, sous‑agents et SDK. Open Interpreter est plus jeune et s’appuie sur des standards partagés comme MCP, les skills, AGENTS.md et l’Agent Client Protocol plutôt que sur son propre écosystème.
Si vous travaillez avec les modèles Claude et recherchez l’expérience la plus aboutie, Claude Code est le choix le plus sûr. Si vous souhaitez exécuter d’autres modèles ou éviter un outil propriétaire, optez pour Open Interpreter.
OpenCode est le plus proche. Les deux sont open source, centrés sur le terminal, et conçus pour fonctionner avec une longue liste de fournisseurs de modèles.
Le support des modèles est similaire sur le papier. OpenCode prend en charge plus de 75 fournisseurs, et Open Interpreter génère sa liste depuis un catalogue public. Les deux exécutent des modèles locaux via Ollama.
L’expérience terminal diffère davantage. OpenCode a sa propre TUI avec intégration LSP (Language Server Protocol), qui renvoie au modèle des diagnostics de code comme des erreurs de typage. La TUI d’Open Interpreter vient de Codex.
Côté configuration, OpenCode utilise un fichier opencode.json, et Open Interpreter un config.toml avec profils.
L’architecture d’agent est la principale différence. OpenCode tourne en client‑serveur, où la TUI est un client d’un serveur local auquel d’autres clients peuvent se connecter. Il inclut des agents build et plan, et prend en charge des agents personnalisés et des sous‑agents. Il ajuste son prompt système selon la famille de modèles, mais les outils et la boucle restent ceux d’OpenCode. Open Interpreter va plus loin et remplace tout le harnais, y compris les schémas d’outils et le format des messages. Les builds récents incluent même un mode de harnais opencode.
Côté développement, OpenCode est son propre codebase, construit par son équipe et sa communauté. Open Interpreter s’appuie sur un fork de Codex, donc une grande partie de son runtime vient de l’amont. C’est un compromis : Open Interpreter bénéficie gratuitement du sandbox et du runtime de Codex, tandis qu’OpenCode contrôle toute sa pile.
Ces deux‑là ne sont pas des concurrents au sens classique. Open Interpreter est un fork de Codex.
Ils partagent le runtime Rust, la TUI, le sandbox, les approbations, AGENTS.md, les skills, MCP, le mode exec et la plupart des commandes « slash ». Lors de mes tests, l’indice de reprise de session affichait encore codex resume.
Codex est l’agent d’OpenAI, conçu autour des modèles OpenAI. Il prend en charge les modèles locaux avec --oss et les fournisseurs personnalisés, mais l’expérience par défaut cible OpenAI.
Open Interpreter étend Codex dans plusieurs directions :
Émulation de harnais : il adapte prompts, schémas d’outils et format de messages à chaque famille de modèles
Support fournisseurs : il dispose d’un catalogue généré et de guides dédiés pour Kimi K3, DeepSeek et GLM
Chat Completions : l’option --chat-completions fait tourner tout fournisseur compatible OpenAI
Override du SDK Codex : les applications construites sur le SDK Codex peuvent tourner via Open Interpreter à la place
Open Interpreter stocke aussi sa configuration et ses sessions sous ~/.openinterpreter, évitant tout conflit avec une installation Codex.
Si vous utilisez surtout les modèles OpenAI, Codex est un meilleur choix. Si vous utilisez d’autres modèles, Open Interpreter vous offre le même flux de travail avec un meilleur support pour eux.
Voici un bref récapitulatif :
| Licence | Modèles | Approche harnais | Config | |
|---|---|---|---|---|
| Open Interpreter | Open source (Apache 2.0) | N’importe quel fournisseur, hébergé ou local | Émule le harnais selon le modèle | config.toml |
| Claude Code | Propriétaire | Conçu pour les modèles Claude | Harnais propre à Claude Code | settings.json et CLAUDE.md |
| OpenCode | Open source (MIT) | 75+ fournisseurs, hébergés ou locaux | Un harnais avec des prompts spécifiques aux modèles | opencode.json |
| Codex | Open source (Apache 2.0) | Conçu pour les modèles OpenAI avec --oss | Harnais propre à Codex | config.toml |
Open Interpreter comparé aux autres agents de codage IA
Le pire qu’un chatbot puisse faire est de donner une mauvaise réponse, que vous pouvez ignorer. Un agent de codage exécute des commandes sur votre machine, lit et écrit des fichiers, et peut accéder au réseau. Une mauvaise décision du modèle, ou une injection de prompt, peut faire de vrais dégâts. Une injection de prompt signifie des instructions cachées dans le contenu lu par l’agent, comme un README ou une page web.
Open Interpreter hérite de son modèle de sécurité du runtime Codex. Il comporte deux couches : un sandbox qui limite ce qui est possible, et une politique d’approbation qui décide quand l’agent doit vous demander d’abord.
Chaque commande exécutée par l’agent passe par un bac à sable au niveau du système d’exploitation sur macOS, Linux et Windows. Trois modes existent :
read-only : l’agent peut lire des fichiers, mais ne peut rien modifier
workspace-write : l’agent peut modifier des fichiers et exécuter des commandes dans le dossier de votre projet
danger-full-access : aucun sandbox
Avec workspace-write, les écritures sont limitées à l’espace de travail actif. L’agent peut corriger votre code, mais pas modifier des fichiers ailleurs sur votre machine.
En mode workspace-write, les commandes n’ont pas d’accès réseau par défaut. Cela bloque les téléchargements et empêche l’agent d’envoyer votre code ailleurs.
Certaines tâches nécessitent le réseau, par exemple installer un paquet. Vous pouvez activer l’accès réseau dans votre configuration :
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
N’activez‑le que pour les projets où c’est nécessaire.
La politique d’approbation décide quand l’agent s’arrête pour demander :
untrusted : demande avant d’exécuter des commandes hors liste de confiance
on-request : demande quand une tâche exige plus que ce que permet le sandbox
never : ne demande jamais
Pour les projets sous contrôle de version, workspace-write avec on-request est un bon défaut. L’agent travaille dans votre projet et demande avant d’aller plus loin. Git vous donne une marche arrière si besoin.
L’option --yolo désactive à la fois le sandbox et les approbations. N’utilisez‑la que dans un environnement jetable, comme un conteneur ou une VM.
Les commandes de l’agent héritent de l’environnement de votre shell. Si vos clés API sont dans des variables d’environnement, ces commandes peuvent les voir.
Vous pouvez limiter cela avec shell_environment_policy :
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
Le réglage core ne transmet que des variables basiques comme HOME et PATH, et exclude retire tout ce qui correspond aux motifs.
Les fichiers posent un autre risque. L’agent peut lire un fichier .env de votre projet même en mode read-only. Avec un fournisseur hébergé, tout ce que l’agent lit part sur les serveurs du fournisseur.
À retenir : le sandbox limite les dommages, mais considérez‑le comme un filet de sécurité, pas une garantie.
Avant de laisser l’agent tourner seul, exécutez /status et vérifiez le mode sandbox et la politique d’approbation.
Si vous tombez sur un article Open Interpreter qui commence par pip install, il n’a pas tort. Il décrit un autre projet.
La version initiale d’Open Interpreter a été lancée en 2023 en Python. Elle permettait aux modèles de langage d’exécuter du code Python, JavaScript et shell sur votre machine, et était perçue comme une alternative open source au Code Interpreter de ChatGPT. Les versions ultérieures ont ajouté le contrôle de l’ordinateur, pour que le modèle interagisse aussi avec votre bureau.
Le projet principal actuel est une réécriture en Rust basée sur Codex. Il se concentre sur les agents de codage et l’émulation de harnais, pas sur le contrôle général de l’ordinateur.
La version Python n’a pas disparu. Elle continue comme fork communautaire sur endolith/open-interpreter.
Les deux versions partagent le même nom, l’historique GitHub et la même commande interpreter, d’où la facilité de les confondre.
Un indice imparable toutefois :
pip install open-interpreter : l’ancienne version Python
curl ou installeur PowerShell : la version Rust actuelle
Open Interpreter n’est pas l’outil idéal pour tous les contextes. Voici quand il a du sens et quand il en a moins.
Open source : sous licence Apache 2.0, vous pouvez lire, auditer et forker tout le code
Choix du modèle : utilisez des modèles hébergés, open‑weight et locaux depuis un seul agent, et basculez en cours de session
Multiples harnais d’agent : vous vous approchez des performances pour lesquelles le modèle a été ajusté — rare chez les autres agents
Développement natif terminal : s’intègre à votre shell et à Git, et le mode exec fonctionne en scripts et CI
Modèles ouverts et moins chers : le projet est pensé autour d’eux, avec des guides dédiés et des harnais adaptés
Extensibilité : MCP, skills, hooks, AGENTS.md, Agent Client Protocol et override du SDK Codex pour le connecter à d’autres outils
Qualité des modèles variable : l’agent vaut ce que vaut le modèle derrière lui, et aucun harnais ne rattrape un modèle incapable de planifier
Les modèles locaux exigent du matériel : dans mes tests, devstral-small-2 utilisait 26 Go de mémoire, sans compter la grande fenêtre de contexte requise
La configuration demande plus d’efforts : vous gérez fournisseurs, fenêtres de contexte, harnais et sandbox. Il reste des aspérités, comme des traces de branding Codex et des avertissements de métadonnées pour des modèles Ollama
L’exécution de commandes comporte un risque : le sandbox et les approbations réduisent le risque, sans l’éliminer
Le code doit encore être relu : des tests qui passent ne garantissent pas un correctif exact ; relisez chaque diff
Open Interpreter est un agent de codage open source qui fonctionne avec le modèle de votre choix, qu’il soit hébergé, open‑weight ou exécuté sur votre machine.
Le flux de travail est simple : vous choisissez un modèle et un harnais, vous pointez l’agent sur un projet, et vous le laissez inspecter, éditer et exécuter des commandes jusqu’à la fin de la tâche. Puis vous relisez son travail.
L’émulation de harnais fait sa différence. Open Interpreter n’impose pas un seul setup d’agent à tous les modèles. Il adapte le setup au modèle, et cela change tout. Le modèle détermine la qualité du résultat, et les permissions déterminent ce que l’agent peut modifier. Votre relecture est le dernier contrôle avant qu’un changement n’atteigne votre codebase.
Pour obtenir une certification d’ingénieur IA, inscrivez‑vous à notre parcours Associate AI Engineer for Developers et entrez dans le monde de l’IA à votre rythme.
Formez‑vous avec DataCamp
Cursus
Cursus
Cursus
blog
blog
Kurtis Pykes
9 min
blog
Kurtis Pykes
15 min
blog
Lynn Heidmann
Tutoriel
Tutoriel
Matt Crabtree
5 min