Ścieżka
Inżynier AI Associate dla programistów
26 godz.
Jeśli kiedykolwiek uruchamiałeś model open-weight w agencie do kodowania zbudowanym dla innego modelu, wiesz, że to nie jest najlepszy pomysł.
Model zwykle błędnie interpretuje schematy narzędzi i uruchamia w kółko tę samą nieudaną komendę, dopóki go nie zatrzymasz. Gdy wrócisz do modelu, dla którego agent został zbudowany, to samo zadanie przechodzi bez problemów. Problem zazwyczaj nie leży w modelu, lecz w harnessie agenta wokół niego, ponieważ jego prompty i formaty narzędzi były dostrojone do kogoś innego.
Open Interpreter rozwiązuje to, emulując harness, dla którego dostrojono każdy model, na przykład Claude Code lub Kimi Code. To otwartoźródłowy agent do kodowania AI uruchamiany z terminala, a bieżąca wersja to projekt w Rust oparty na Codexie OpenAI, a nie asystent komputerowy w Pythonie, którego możesz pamiętać.
W tym artykule przeprowadzę cię przez instalację, konfigurację modelu i harnessu, praktyczny workflow kodowania oraz porównam Open Interpreter z Claude Code, OpenCode i Codex.
Dopiero zaczynasz z agentami AI? Zapisz się na nasz Introduction to AI Agents i poznaj podstawy w jedno popołudnie.
Open Interpreter daje modelowi AI dostęp do twojego projektu i narzędzi, których używałby deweloper.
Wystarczy, że opiszesz zadanie prostym angielskim, a agent pracuje nad twoim kodem. Potrafi pracować z:
Projekt jest open source na licencji Apache 2.0. Nie jest też ograniczony do jednego dostawcy modeli. Możesz podłączyć modele hostowane, modele open-weight albo modele uruchamiane lokalnie na twojej maszynie.
Główne repozytorium ma ponad 68 tys. gwiazdek na GitHubie (wrzesień 2026).
Open Interpreter działa w pętli:
Niektóre z tych kroków mogą wymagać twojej zgody, zależnie od ustawień uprawnień. Omówię je w sekcji o bezpieczeństwie.
Oto bardziej wizualny przegląd:
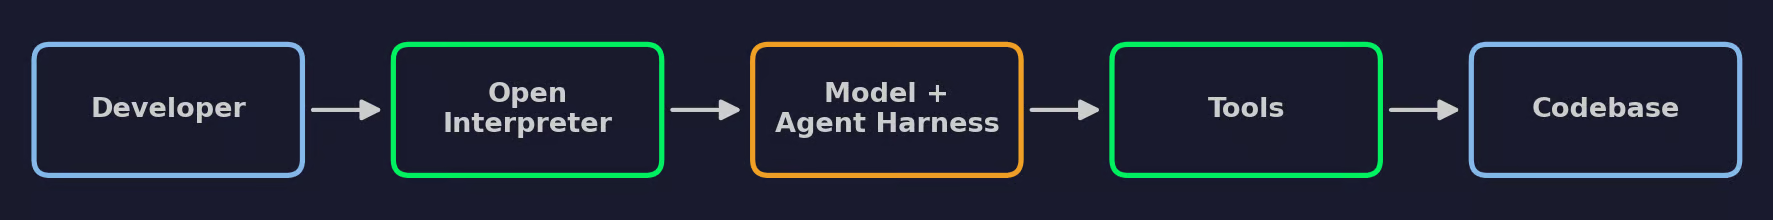
Jak działa Open Interpreter
Warto zapamiętać, że nie rozmawiasz bezpośrednio z modelem. Open Interpreter wysyła twoje zadanie do modelu sformatowane promptami i definicjami narzędzi aktywnego harnessu. Model prosi o wywołania narzędzi, a Open Interpreter uruchamia je na twojej bazie kodu. Potem wyniki wracają do modelu do kolejnego kroku.
Ponieważ model i harness to oddzielne warstwy, możesz zmienić dowolną z nich bez naruszania reszty konfiguracji.
Open Interpreter instalujesz jako samodzielny plik binarny, więc nie potrzebujesz Pythona ani pipa.
Jeśli starszy wpis na blogu każe ci uruchomić pip install open-interpreter, opisuje on przestarzałą wersję w Pythonie. To polecenie nie zainstaluje opisanego tu agenta do kodowania opartego na Ruście.
Przyda ci się też Git. Open Interpreter działa bez niego, ale Git daje sesję świadomą repozytorium i diffy.
Uruchom skrypt instalacyjny w terminalu:
curl -fsSL https://www.openinterpreter.com/install | shSkrypt pobierze właściwe wydanie dla twojej platformy i umieści polecenie interpreter w ~/.local/bin.
Otwórz PowerShell i uruchom:
irm https://www.openinterpreter.com/install.ps1 | iexWSL też jest wspierany, jeśli wolisz konfigurację w stylu Linuksa. Wtedy uruchom komendę dla macOS i Linuksa w terminalu WSL.
Zrestartuj terminal, aby podłapał nowy PATH, potem sprawdź wersję:
interpreter --versionJeśli widzisz numer wersji, instalacja się powiodła.
Sprawdzenie wersji Open Interpreter
Uruchom sesję z dowolnego katalogu:
interpreterMożesz też wpisać i, co jest krótkim aliasem tego samego polecenia.
Open Interpreter otwiera interfejs terminalowy, w którym opisujesz zadania prostym angielskim. Przy pierwszym uruchomieniu poprosi o podłączenie dostawcy modeli. W kolejnej sekcji użyję lokalnego modelu przez Ollamę, więc na razie możesz ten krok pominąć.
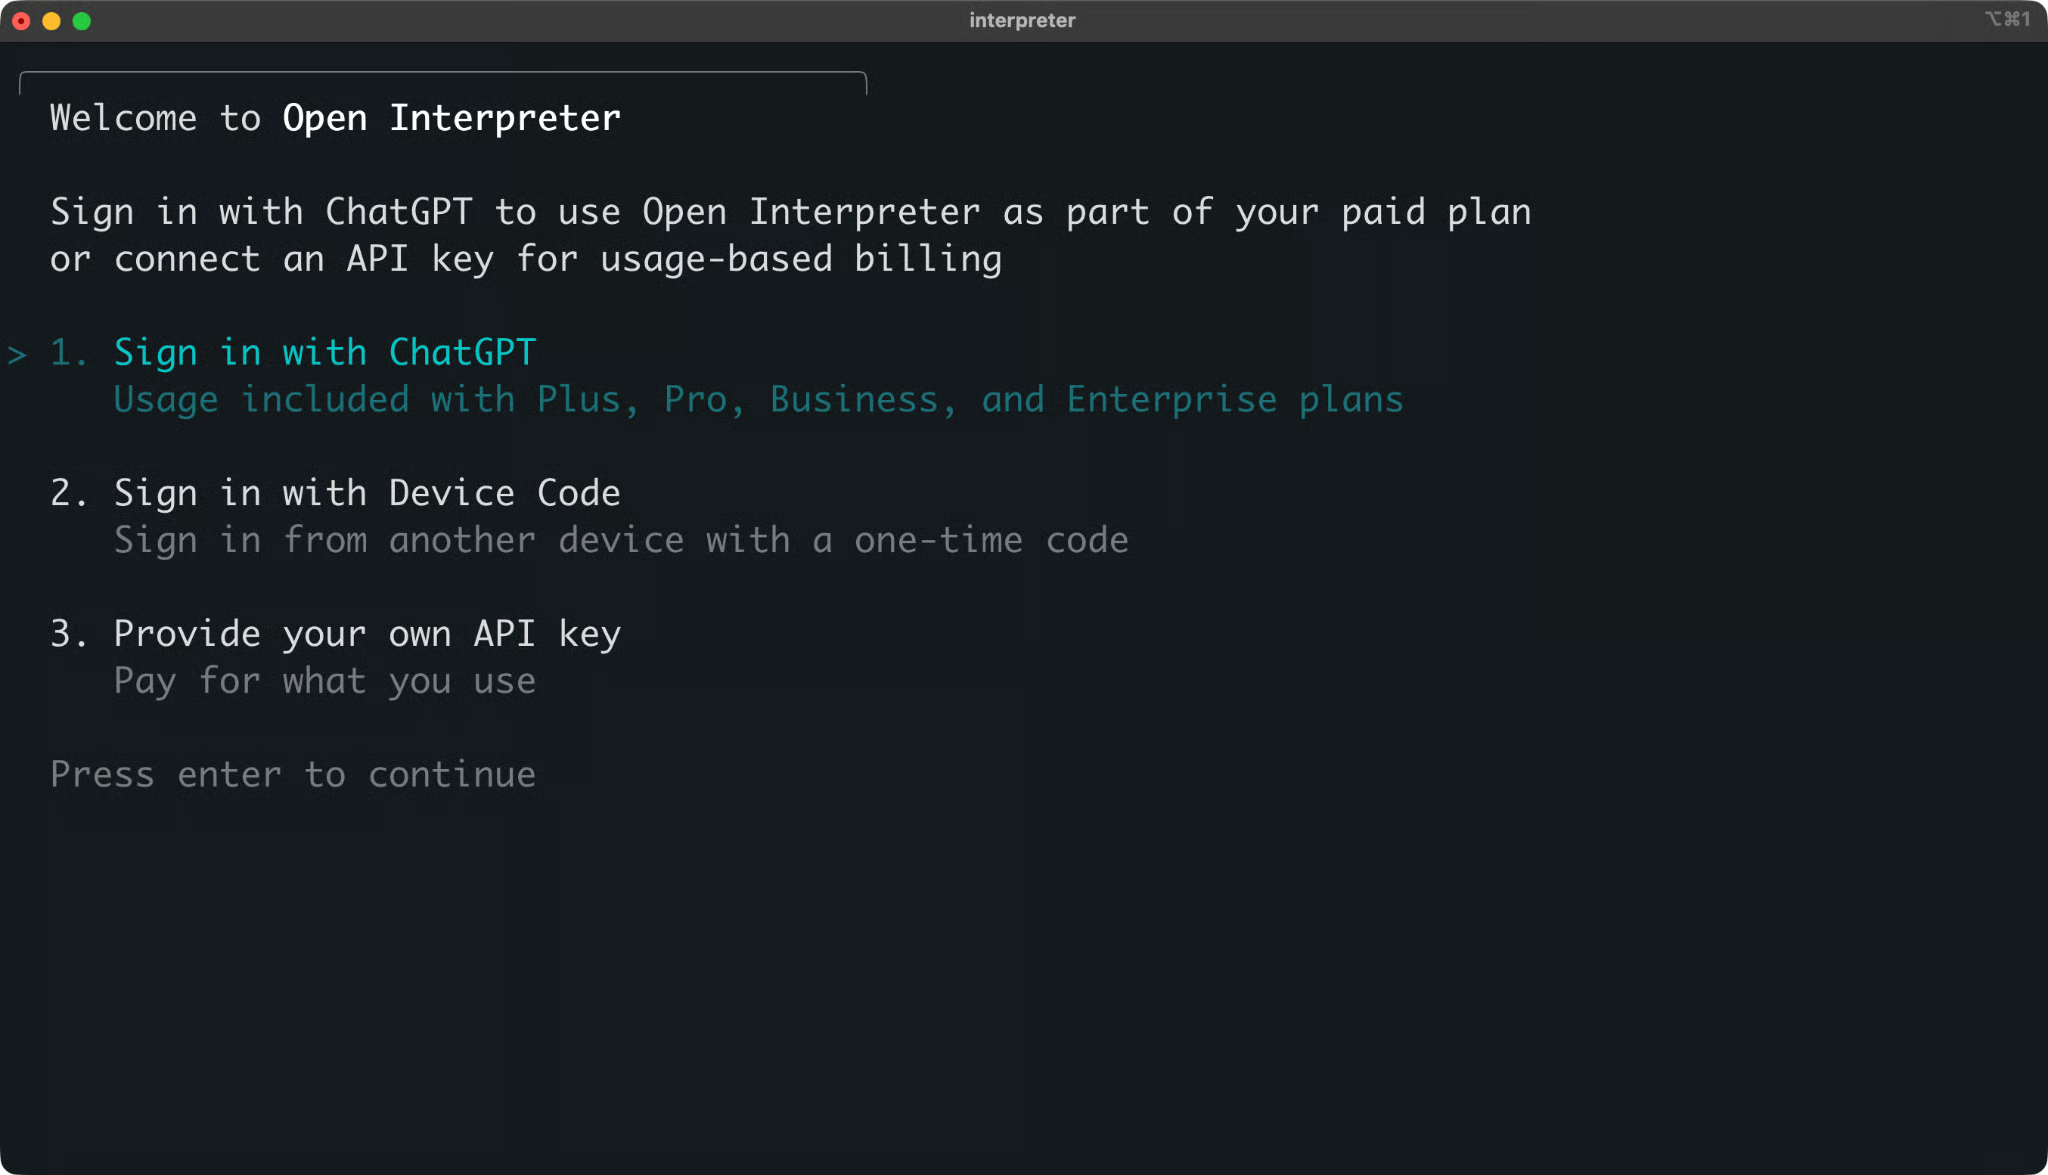
Interaktywna sesja Open Interpreter
Aby wyjść z sesji, wpisz /exit.
Najszybszy sposób, by zrozumieć agenta do kodowania, to dać mu zadanie i zobaczyć, co z nim zrobi.
W całej tej sekcji użyję małego projektu do śledzenia nawyków. Ma jedną funkcję, jeden plik testowy i jeden błąd.
Projekt oblicza najdłuższą serię kolejnych dni dla nawyku. Na przykład, zlicza, ile dni z rzędu ćwiczyłeś.
Zacznij od folderu projektu i wirtualnego środowiska:
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
Utwórz habits.py z poniższym kodem:
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
Następnie utwórz test_habits.py:
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
Funkcja ma błąd. Nie będę go wskazywać, bo znalezienie go to zadanie agenta.
Dodaj plik .gitignore, aby wirtualne środowisko i pliki cache nie trafiały do repozytorium:
.venv/
__pycache__/
.pytest_cache/
Teraz zacommituj projekt:
git init
git add .
git commit -m "Initial commit"
Ten commit daje ci czysty punkt startu. Później użyjesz go, aby dokładnie zobaczyć, co agent zmienił.
Uruchom testy, aby potwierdzić błąd:
python -m pytest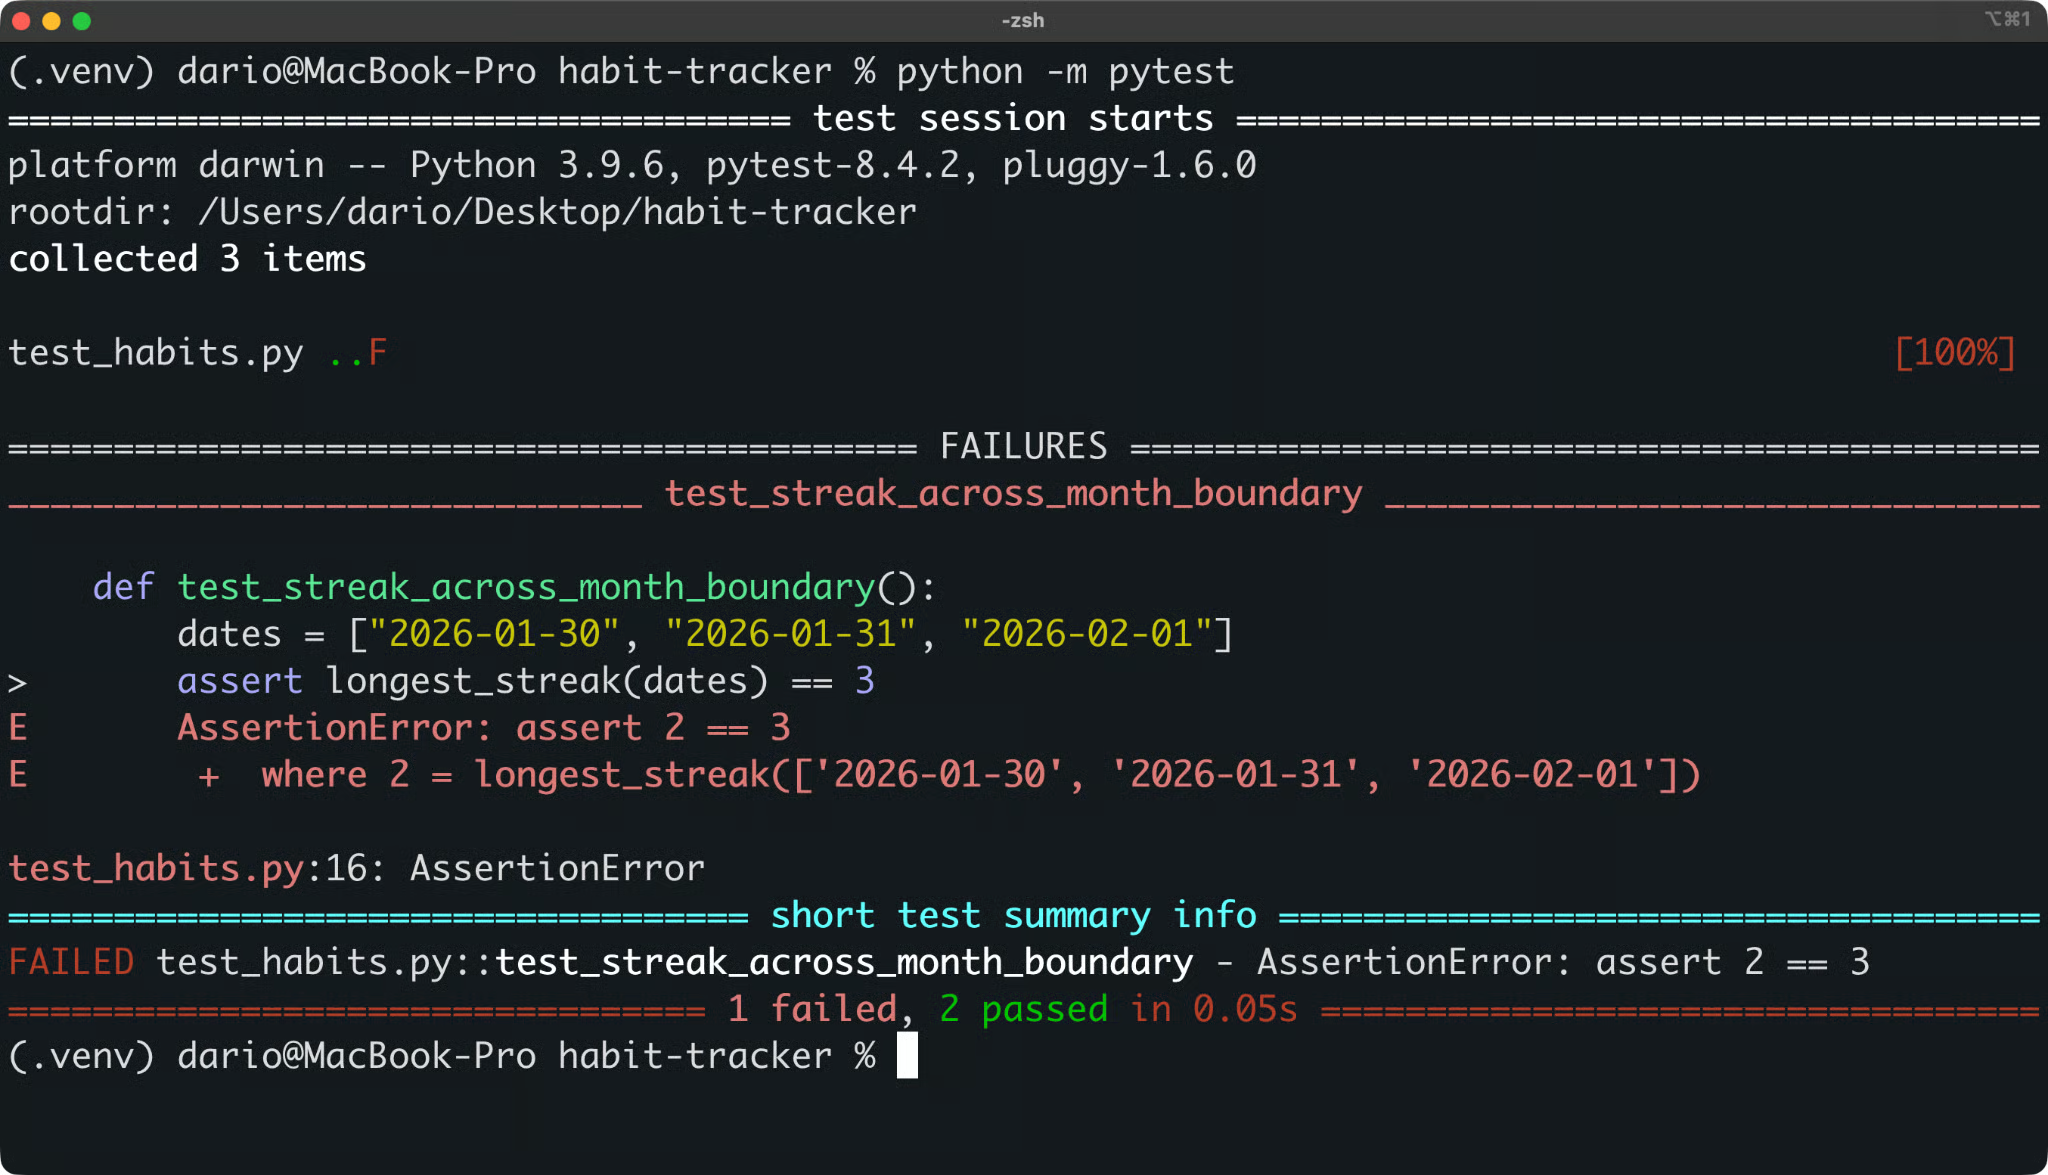
Wynik testów trackera nawyków
Dwa testy przechodzą, a jeden pada. To problem, który ma rozwiązać Open Interpreter.
Potrzebujesz zainstalowanej i uruchomionej Ollamy. Potrzebujesz też modelu, który wspiera wywołania narzędzi, więc pobierz go:
ollama pull qwen3-coder:30bNastępnie uruchom Open Interpreter z folderu projektu. Użyj tego samego terminala, aby agent mógł korzystać z instalacji pytest w twoim wirtualnym środowisku:
interpreter --oss --local-provider ollama -m qwen3-coder:30bOto co robią poszczególne flagi:
--oss: używa lokalnego dostawcy open source
--local-provider ollama: wybiera Ollamę zamiast LM Studio
-m qwen3-coder:30b: ustawia model dla tego uruchomienia
Uruchom /status, aby potwierdzić aktywnego dostawcę, model, tryb sandboxa i politykę zatwierdzania.
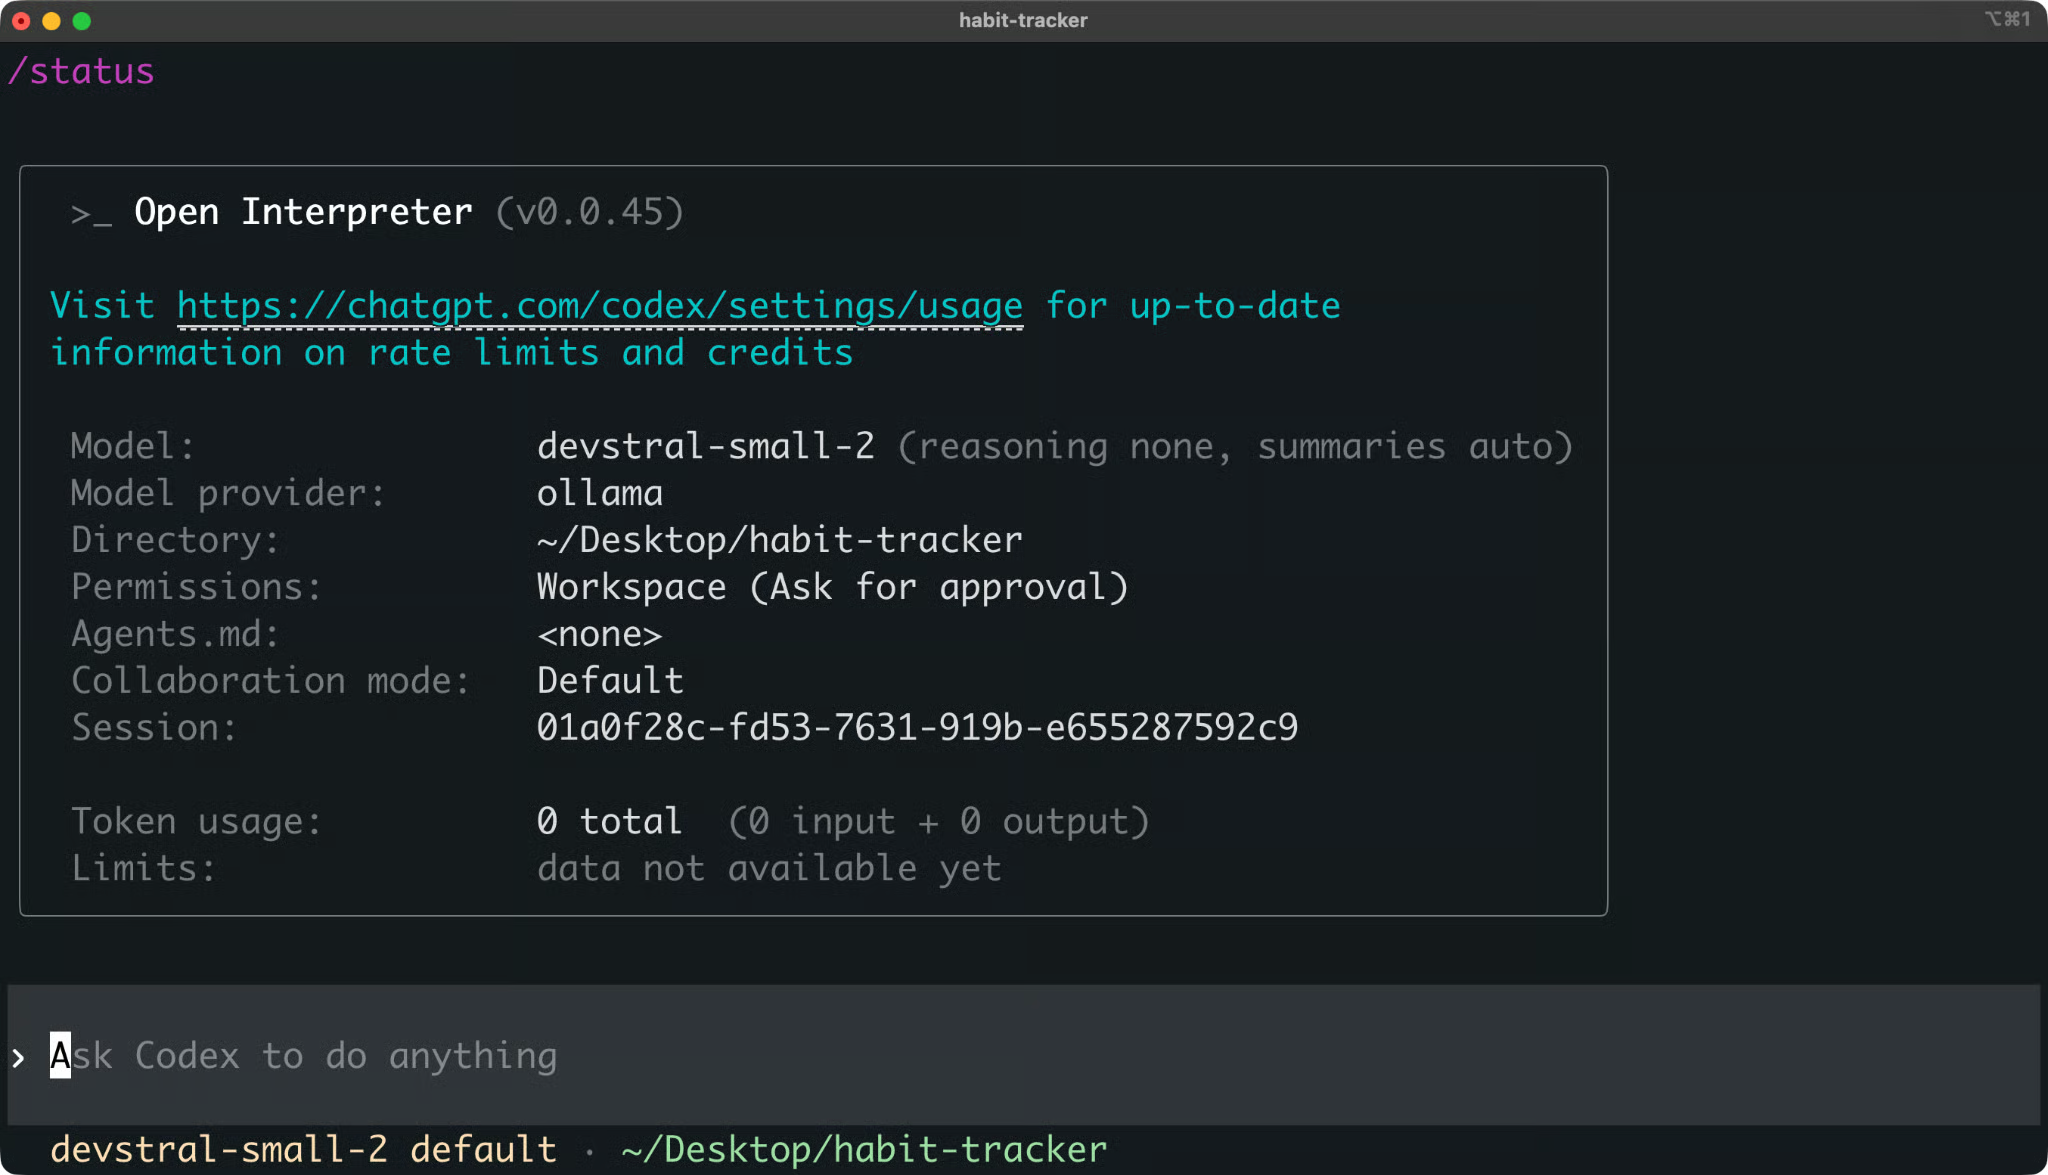
Sesja Open Interpreter z lokalnym modelem Ollama
Nie chcesz jeszcze, by agent cokolwiek edytował. Najpierw poproś o diagnozę:
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.Agent zwykle przeczyta pliki i uruchomi testy, zanim odpowie. Polecenia działają w sandboxie, a jeśli agent potrzebuje większego dostępu niż pozwala sandbox, najpierw poprosi o twoją zgodę.
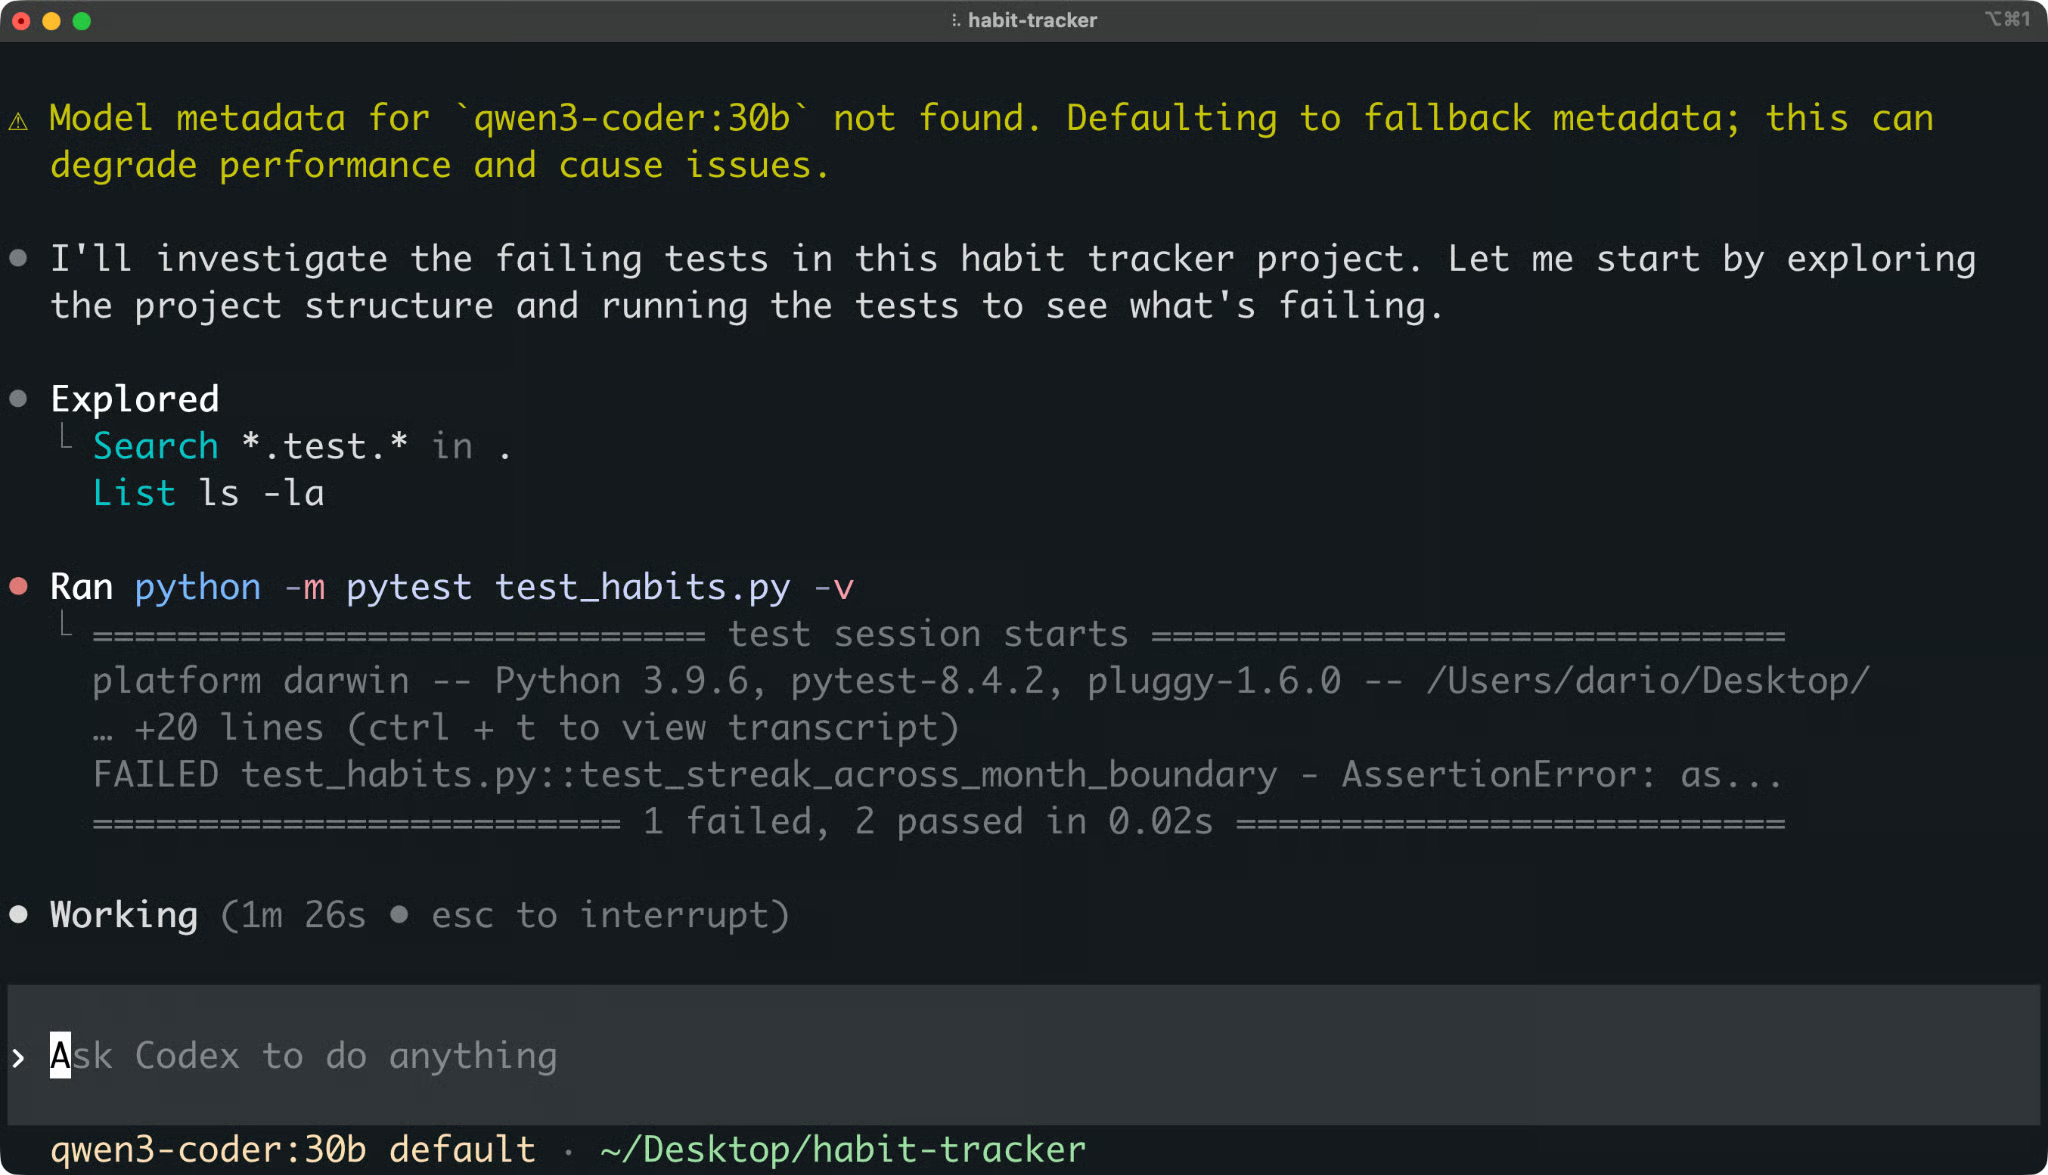
Output Open Interpreter
Przeczytaj wyjaśnienie, zanim cokolwiek zaakceptujesz.
Poprawna diagnoza mówi, że funkcja porównuje tylko dzień miesiąca, więc seria przerywa się przy przejściu do nowego miesiąca. Dobra poprawka porównuje pełne daty, np. za pomocą date.fromisoformat() z modułu datetime Pythona.
Jeśli diagnoza jest błędna, popraw ją w tej samej sesji, zanim agent edytuje kod.
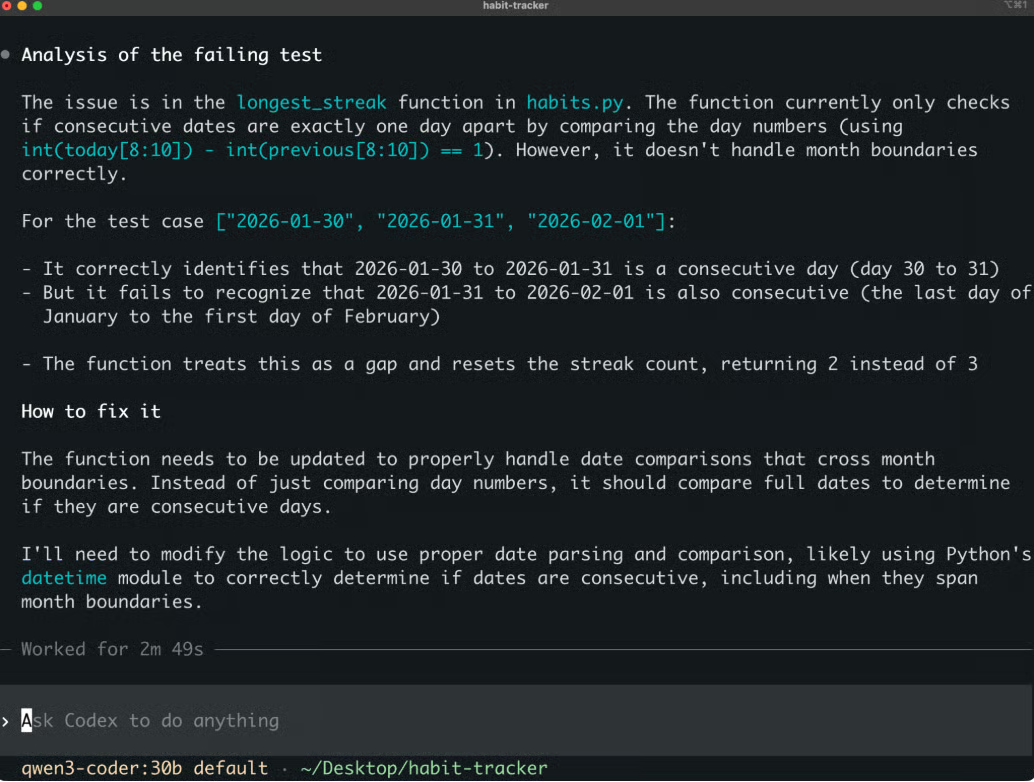
Propozycja poprawki w Open Interpreter
Gdy plan ci odpowiada, wdroż poprawkę:
Apply the fix to habits.py, then run the tests.Agent edytuje plik i ponownie uruchamia pytest. Chcesz zobaczyć, że wszystkie trzy testy przechodzą.
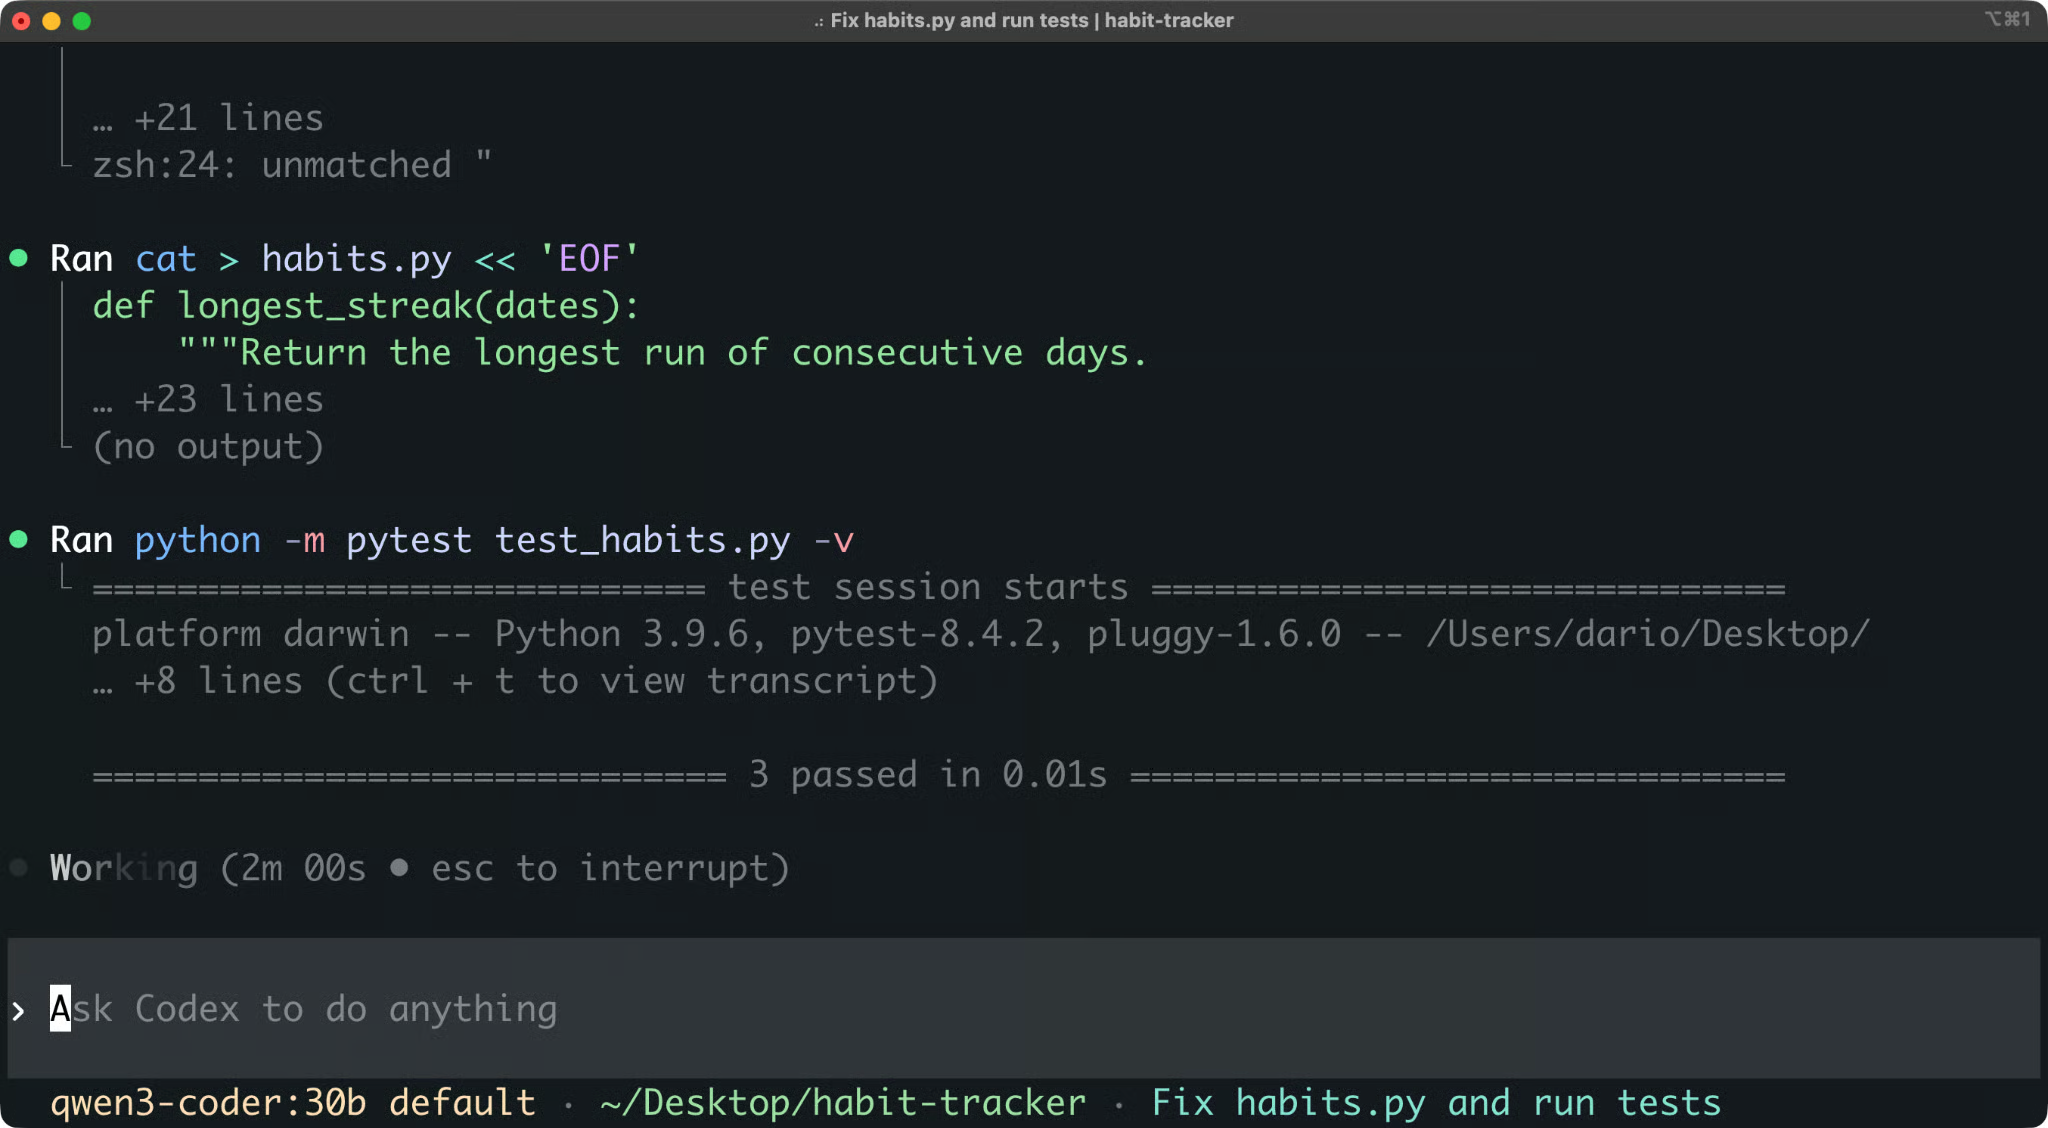
Wszystkie testy przechodzą po poprawce
Zaliczony test nie musi oznaczać, że błąd w twoim kodzie został usunięty. Może test został zaktualizowany, by obejść błąd. Nadal musisz przejrzeć kod.
Uruchom /diff w sesji, aby zobaczyć zmiany w working tree. Możesz też uruchomić git diff po wyjściu.
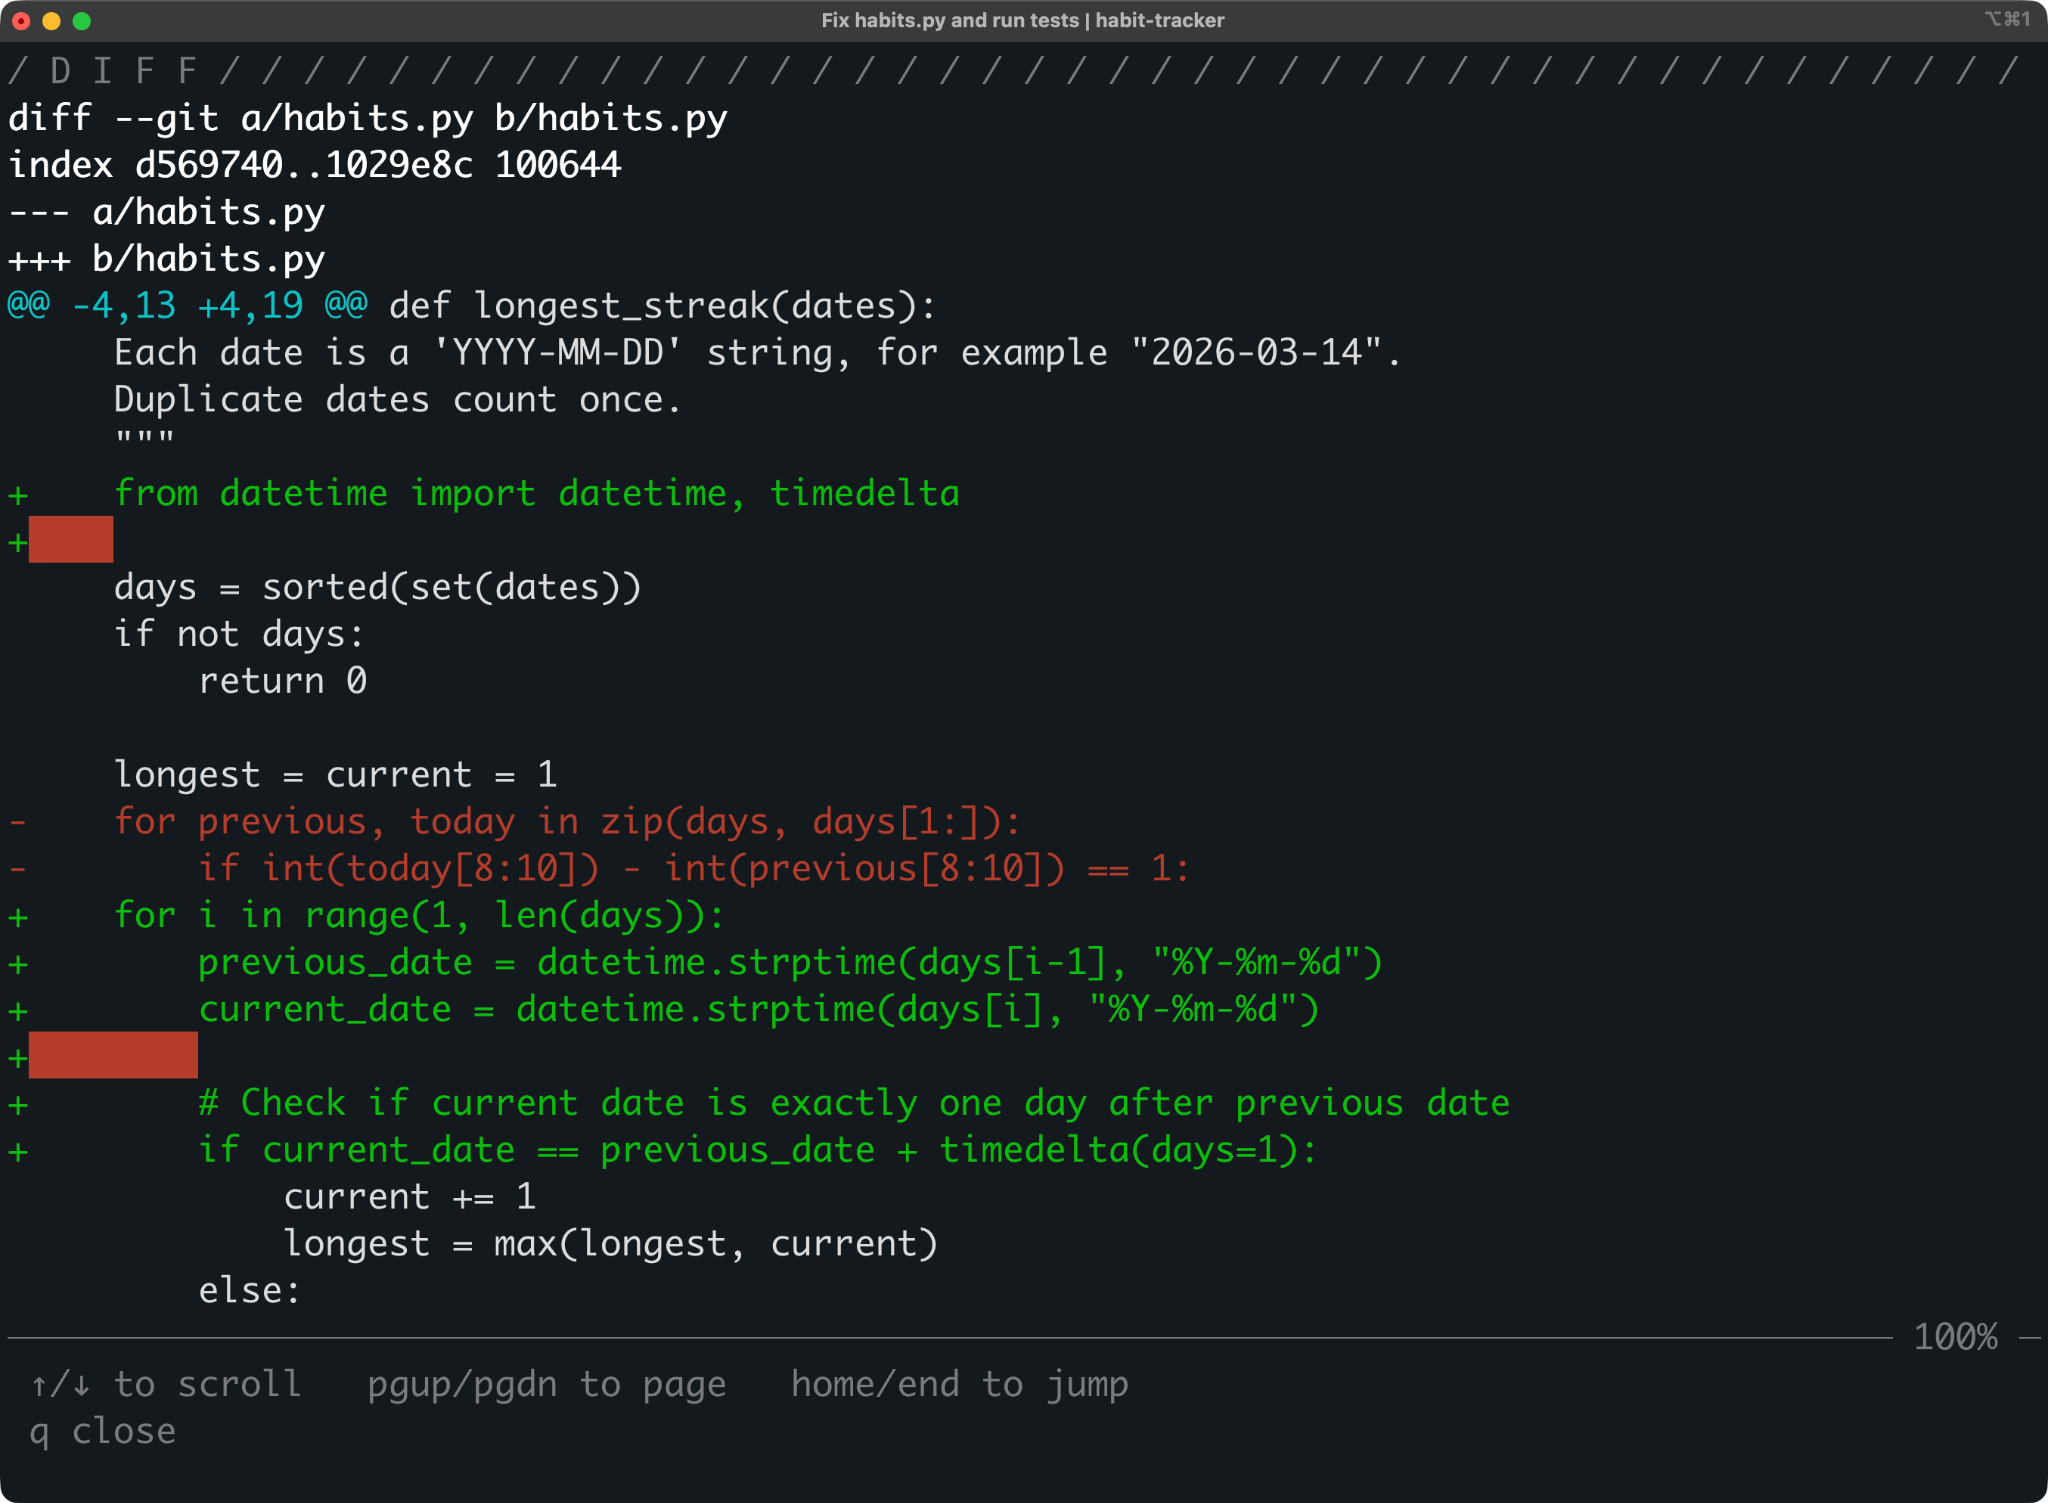
Diff zmian wprowadzonych przez Open Interpreter
Dokładny diff zależy od modelu, więc twój może nie pasować linia w linię do powyższego. Jeśli zmiana ci się podoba — zacommituj, a jeśli nie — przywróć oryginalny plik:
git restore habits.pyI o to chodzi. Opisujesz problem, agent go bada i naprawia, a ty przeglądasz każdą zmianę, zanim trafi do twojego kodu.
Open Interpreter wymaga, byś dostarczył własny model.
Każde żądanie przechodzi przez trzy warstwy:
| Warstwa | Przykład | Co kontroluje |
|---|---|---|
| Dostawca | ollama | Gdzie trafiają żądania i jak się uwierzytelniasz |
| Model | devstral-small-2 | Model, który wykonuje pracę |
| Harness | native | Prompty, narzędzia i format wiadomości wokół modelu |
Warstwy żądania
Oto, co możesz podłączyć:
Lista dostawców jest generowana z publicznego katalogu modeli i uwzględnia tylko modele wspierające wywołania narzędzi. Jeśli brakuje modelu, którego się spodziewasz, to zwykle dlatego.
Uważaj na ollama-cloud. To oddzielny, hostowany dostawca, więc twoje żądania opuszczają maszynę. Tylko wbudowany dostawca ollama uruchamia modele lokalnie.
Możesz zmienić model na trzech poziomach:
W trakcie sesji: uruchom /model, aby wybrać dostawcę, model i nakład pracy na rozumowanie
Dla jednego uruchomienia: przekaż flagę -m, jak w poprzedniej sekcji
Jako domyślny: ustaw go w pliku konfiguracyjnym
W każdej chwili możesz uruchomić /status, aby zobaczyć aktywnego dostawcę i model.
Open Interpreter czyta ustawienia z ~/.openinterpreter/config.toml. Aby ustawić domyślnie konfigurację z poprzedniej sekcji z Ollamą, dodaj te dwie linie:
model_provider = "ollama"
model = "qwen3-coder:30b"
Po tym interpreter startuje z tym modelem i nie potrzebujesz żadnych flag.
Dostawcy hostowani czytają klucze API ze zmiennych środowiskowych. Na przykład, DeepSeek oczekuje DEEPSEEK_API_KEY:
export DEEPSEEK_API_KEY="your-api-key"Możesz też dodać dowolny endpoint kompatybilny z OpenAI jako własnego dostawcę:
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
Ustawienie wire_api mówi Open Interpreter, jakiego formatu żądań oczekuje endpoint. Użyj chat dla Chat Completions kompatybilnego z OpenAI, responses dla OpenAI Responses API i messages dla endpointów w stylu Anthropic.
Zaufany projekt może mieć też własny .openinterpreter/config.toml, który nadpisuje twoją konfigurację użytkownika. Flagi wiersza poleceń nadpisują obie. Jeśli nie masz pewności, która wartość wygrywa, uruchom /debug-config, aby zobaczyć efektywne ustawienia i ich źródła.
Model decyduje, jak dobrze agent rozumie twój kod. Harness decyduje, jak model widzi zadanie i narzędzia.
Potrzebujesz obu. Dobry model w niedopasowanym harnessie wysyła źle sformatowane wywołania narzędzi i błędnie odczytuje wyniki. A dobry harness nie nadrobi modelu, który nie rozumie kodu.
Dlatego Open Interpreter wybiera harness, gdy wybierasz model. Na przykład:
Modele Claude dostają harness claude-code
Modele Kimi dostają kimi-code
Modele Qwen dostają qwen-code
Modele DeepSeek dostają claude-code-bare
Dla innych rodzin modeli możesz wybrać harness samodzielnie poleceniem /harness.
Pamiętaj, że słaby rezultat nie zawsze oznacza słaby model. Zanim zmienisz model, spróbuj tego samego modelu z innym harnessem — omówię to szerzej w kolejnej sekcji.
Emulacja harnessów to główny powód istnienia bieżącej wersji Open Interpreter.
Harness agenta to wszystko wokół modelu, co zmienia go w agenta. Obejmuje:
Mówiąc prościej, harness decyduje, jak model widzi zadanie i jak jego decyzje zamieniają się w działania.
Open Interpreter ma zestaw wbudowanych trybów harnessów. Najczęściej użyjesz tych:
native: własny harness Open Interpreter, odziedziczony po Codexie
claude-code: emuluje prompty i powierzchnię narzędzi Claude Code od Anthropica
kimi-code: implementacja w Ruście harnessu Kimi Code, zalecanego przez Moonshot dla modeli Kimi
qwen-code: emuluje CLI Qwen Code od Alibaby dla modeli Qwen
swe-agent: emuluje SWE-agent, badawczego agenta stworzonego do rozwiązywania issue na GitHubie
Pełna lista zawiera też warianty, jak claude-code-bare, kimi-cli, deepseek-tui, zcode i minimal. Uruchom /harness w sesji, by zobaczyć, co wspiera twoja wersja.
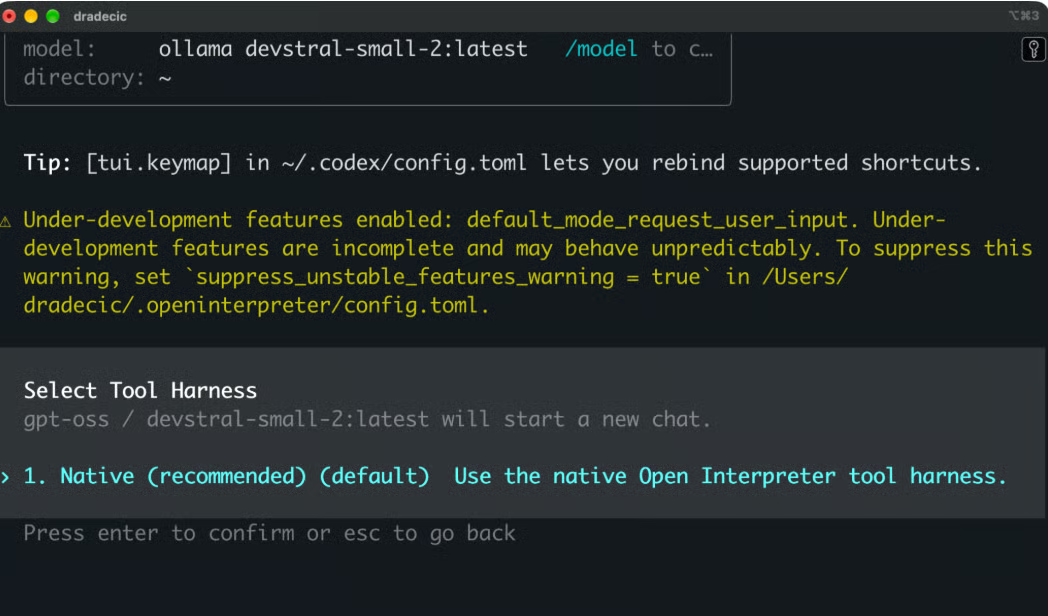
Możesz przełączać harnessy w trakcie sesji komendą /harness lub ustawić domyślny w ~/.openinterpreter/config.toml:
harness = "kimi-code"
harness_guidance = true
Ustawienie harness_guidance dodaje wskazówki poprawiające niezawodność tam, gdzie harness na to pozwala. Ustaw false, jeśli chcesz ściślejszej emulacji. Jeśli nie ustawisz harness, Open Interpreter wybierze go na podstawie rodziny modelu, jak widziałeś w poprzedniej sekcji.
Większość dostawców stroi modele do kodowania w konkretnym środowisku agenta i publikuje zalecany harness.
Model przyzwyczaja się do tego harnessu. Uczy się jego stylu promptów, nazw narzędzi, formatu edycji plików i sposobu, w jaki wracają wyniki narzędzi.
Załóżmy, że uruchamiasz model dostrojony do edycji „szukaj i zamień” wewnątrz harnessu oczekującego pełnych plików z łatką. Model wie, jaką zmianę wprowadzić, ale wciąż opisuje ją w złym formacie. Pętla agenta zużywa tokeny bez postępu.
Z wynikami narzędzi jest podobnie. Jeśli harness zwraca wyniki w formacie, którego model nie widział, model je błędnie odczytuje. Jeśli harness usuwa rozumowanie modelu między turami, model „myślący” gubi swój plan.
To znaczy, że ten sam model może wyglądać dobrze w jednym agencie i źle w innym, bez zmiany wag. Dlatego wyniki benchmarków kodowania zwykle podają harness użyty w danym uruchomieniu.
Modele frontier zwykle wychodzą z kłopotów w obcym harnessie, ale mniejsze i tańsze często nie. Open Interpreter nie wciska każdego modelu w jeden format, lecz dopasowuje format do modelu.
Możesz to przetestować na projekcie demo. Przywróć oryginalny plik poleceniem git restore habits.py, przełącz harness poleceniem /harness i podaj agentowi ten sam prompt. Potem porównaj liczbę kroków i format edycji.
Większość z nich widziałeś już w artykule. Oto co dają w codziennym developmentcie.
Open Interpreter działa w twoim repozytorium Gita. Czyta strukturę projektu i śledzi, co zmienił.
Pomagają tu dwie komendy na slashu. /diff pokazuje zmiany w working tree, a /review prosi agenta o sprawdzenie bieżących zmian pod kątem bugów i regresji przed commitem. Tę samą recenzję uruchomisz bez otwierania sesji:
interpreter exec review --uncommittedSesje też są zapisywane. Jeśli przerwiesz zadanie w połowie, interpreter resume --last wznowi je, gdzie skończyłeś.
Agent uruchamia te same polecenia, co ty, np. zestawy testów, lintery, skrypty builda i menedżery pakietów. Wszystkie działają w natywnym sandboxie na macOS, Linuksie i Windowsie.
Długo działające polecenia mogą działać w tle. Użyj /ps, by je wypisać, i /stop, by je zakończyć.
Do skryptów i CI, interpreter exec uruchamia zadanie bez interaktywnego UI:
interpreter exec "fix the failing test"Możesz zmieniać dostawców i modele w dowolnym momencie komendą /model. Twoja konfiguracja, AGENTS.md i umiejętności nadal obowiązują po przełączeniu.
Przydatne są profile. Załóżmy, że chcesz taniego modelu do rutynowej pracy i mocniejszego do przeglądów kodu. Zdefiniujesz oba w konfiguracji:
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
Potem uruchamiasz interpreter --profile review, gdy go potrzebujesz.
/harness zmienia sposób, w jaki model widzi zadanie, bez zmiany samego modelu. To pierwsza rzecz do sprawdzenia, gdy model ma problemy z wywołaniami narzędzi, zanim przejdziesz na większy model.
Model Context Protocol (MCP) łączy agenta z narzędziami, do których nie był zaprojektowany, jak serwery dokumentacji czy bazy danych. Dodajesz serwery w konfiguracji:
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
Uruchom /mcp, aby zobaczyć skonfigurowane serwery i ich narzędzia. Ustawienie default_tools_approval_mode sprawia, że agent pyta, zanim użyje narzędzia z tego serwera.
Działa też w drugą stronę. interpreter mcp-server wystawia Open Interpreter jako serwer MCP, a interpreter acp uruchamia go w edytorach wspierających Agent Client Protocol — otwarty standard łączenia edytorów z agentami do kodowania.
AGENTS.md to plik Markdown w twoim repozytorium z zasadami projektu, które agent czyta przy każdym zadaniu. Dla trackera nawyków mógłby wyglądać tak:
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
Możesz też uruchomić /init, a agent zapisze dla ciebie pierwszą wersję.
Umiejętności (skills) to reużywalne workflowy, spakowane jako foldery w .agents/skills w twoim projekcie lub ~/.agents/skills dla użytkownika. Agent automatycznie podłapie umiejętność, gdy zadanie do niej pasuje. Uruchom /skills, aby zobaczyć dostępne.
Oba formaty są współdzielone, więc te same pliki działają z innymi agentami do kodowania, które je wspierają. Open Interpreter wspiera też hooki, które uruchamiają twoje polecenia w określonych momentach sesji. Przeglądasz je i ufasz im komendą /hooks.
Dwa ustawienia kontrolują, co agent może robić:
Tryb sandboxa: read-only, workspace-write lub danger-full-access
Polityka zatwierdzania: untrusted, on-request lub never
Sandbox decyduje, co jest możliwe, a polityka zatwierdzania — kiedy agent najpierw pyta. Z workspace-write i on-request agent może edytować projekt i uruchamiać testy, ale pyta, gdy potrzebuje dostępu wykraczającego poza to.
Oba ustawienia zmienisz komendą /permissions lub flagami -s i -a. Jest też flaga --yolo, która omija oba — dokumentacja oznacza ją jako niebezpieczną. Szczegóły opiszę w sekcji o bezpieczeństwie.
Open Interpreter określa się jako agent do kodowania zbudowany z myślą o tanich modelach.
Największe proprietarne agenty do kodowania są zbudowane wokół własnych modeli sprzedawcy. Open Interpreter daje ci jednego agenta działającego z modelami proprietarnymi, hostowanymi modelami open-weight i modelami lokalnymi.
Modele open-weight, jak Kimi, DeepSeek, GLM i Qwen, mają publiczne wagi. Możesz ich używać przez zewnętrznego dostawcę lub na własnym sprzęcie.
To daje dwie korzyści. Hostowane modele open-weight zwykle kosztują mniej za token niż modele frontier proprietarne. I nie jesteś ograniczony do jednego hosta, bo ten sam model działa wszędzie tam, gdzie działają jego wagi.
Open Interpreter ma dedykowane przewodniki dla Kimi K3, DeepSeek i GLM. Dobiera też pasujący harness dla tych rodzin modeli.
Ollama i LM Studio to wbudowani dostawcy, więc możesz uruchomić model na własnej maszynie bez klucza API i bez kosztu za token.
Kosztem jest sprzęt. Gdy testowałem devstral-small-2 na MacBooku Pro M1 Max z 64 GB pamięci zunifikowanej, sam model zajmował 26 GB. Domyślne okno kontekstu Ollamy było za małe dla pętli agenta, a przy 128k tokenów użycie pamięci rosnąco-opadało, aż sesja stanęła.
Agenci do kodowania potrzebują dużego okna kontekstu, bo muszą się zmieścić prompt systemowy, definicje narzędzi, treść plików i output poleceń. Ollama zaleca co najmniej 64k tokenów dla agentów w stylu Codex. A większe okno kontekstu zużywa więcej pamięci ponad to, co zajmuje model.
Open Interpreter działa na twojej maszynie, ale model nie musi.
To, dokąd trafia twój kod, zależy od dostawcy:
Twoja konfiguracja, sesje i logi są przechowywane lokalnie w ~/.openinterpreter niezależnie od tego.
Jeśli potrzebujesz większej kontroli, możesz dodać własnego dostawcę wskazującego na twój serwer inferencyjny. Działa każdy serwer z API kompatybilnym z OpenAI, np. wdrożenie vLLM na GPU twojej firmy. Dzięki temu masz hostowane rozwiązanie, ale infrastruktura jest twoja.
Modele open nie są równie dobre w wywoływaniu narzędzi. Zobaczysz słabe użycie narzędzi jako błędne wywołania, pętle, przedwczesne zatrzymania lub ignorowanie outputu poleceń.
Odpowiedni harness pomaga, ale nie naprawi modelu, który nie potrafi zaplanować zadania wieloetapowego. Najwięcej problemów mają mniejsze modele lokalne.
Zanim skierujesz nowy model na prawdziwy projekt, przetestuj go na małym repozytorium, jak tracker nawyków z tego artykułu. Jeśli pokaże słabości, spróbuj innego harnessu, zanim przeskoczysz na większy model.
Oto szybkie podsumowanie opcji:
| Gdzie działa inferencja | Koszt | Kod opuszcza twoją maszynę? | |
|---|---|---|---|
| Proprietarny model hostowany | Serwer dostawcy | Za token lub subskrypcja | Tak |
| Model open-weight hostowany | Serwer dostawcy | Za token, zwykle niższy | Tak |
| Model open-weight lokalny | Twój sprzęt | Sprzęt i prąd | Nie |
Opcje Open Interpreter dla modeli lokalnych i open
Open Interpreter ma wiele wspólnego z innymi agentami terminalowymi do kodowania. Różnice dotyczą właściciela narzędzia i tego, pod jakie modele jest zbudowane.
Claude Code to terminalowy agent do kodowania od Anthropica. Pierwsza różnica to własność — Claude Code jest proprietarny, a Open Interpreter jest open source na licencji Apache 2.0. Możesz czytać i zmieniać każdą część Open Interpreter.
Druga różnica to wybór modelu. Claude Code jest zbudowany dla modeli Claude. Możesz wskazać endpointy kompatybilne z Anthropic od innych dostawców, ale jego harness pozostaje dostrojony pod Claude. Open Interpreter traktuje wybór modelu jako funkcję kluczową.
Porównanie harnessów jest najciekawsze. Claude Code jest jednym z harnessów emulowanych przez Open Interpreter. W trybie claude-code każdy model dostaje prompty i narzędzia w stylu Claude Code w środowisku Open Interpreter. UI i komendy na slashu wciąż są Open Interpreter, więc to nie ten sam produkt z innym modelem.
Oba narzędzia są terminal-first. Każde ma sesję interaktywną i tryb nieinteraktywny do skryptów i CI. Do instrukcji projektowych Claude Code czyta CLAUDE.md, a Open Interpreter używa współdzielonego formatu AGENTS.md.
Claude Code ma większy ekosystem. Dostarcza rozszerzenia do IDE, aplikacje desktopowe i webowe, marketplace pluginów, subagentów i SDK. Open Interpreter jest młodszy i opiera się na otwartych standardach, jak MCP, umiejętności, AGENTS.md i Agent Client Protocol, zamiast własnego ekosystemu.
Jeśli pracujesz z modelami Claude i chcesz najbardziej dopracowanego doświadczenia, bezpieczniejszym wyborem jest Claude Code. Jeśli chcesz używać innych modeli lub unikać proprietarnego narzędzia, wybierz Open Interpreter.
OpenCode to najbliższe porównanie. Oba są open source, terminal-first i zbudowane do pracy z długą listą dostawców modeli.
Wsparcie modeli na papierze jest podobne. OpenCode wspiera ponad 75 dostawców, a Open Interpreter generuje listę dostawców z publicznego katalogu modeli. Oba uruchamiają modele lokalne przez Ollamę.
Różni się bardziej doświadczenie w terminalu. OpenCode ma własne TUI z integracją Language Server Protocol (LSP), która zwraca do modelu diagnostykę kodu, jak błędy typów. TUI Open Interpreter pochodzi z Codexa.
Jeśli chodzi o konfigurację, OpenCode używa pliku opencode.json, a Open Interpreter — config.toml z profilami.
Architektura agenta to główna różnica. OpenCode działa jako klient i serwer, gdzie TUI jest jednym klientem lokalnego serwera, do którego mogą łączyć się inne klienty. Ma wbudowanych agentów build i plan oraz wspiera customowych agentów i subagentów. Dostosowuje prompt systemowy dla rodziny modelu, ale narzędzia i pętla pozostają własne OpenCode. Open Interpreter idzie dalej i podmienia cały harness, w tym schematy narzędzi i format wiadomości. Nowsze buildy zawierają nawet tryb harnessu opencode.
Po stronie developmentu OpenCode to własna baza kodu, budowana przez zespół i społeczność. Open Interpreter opiera się na forku Codexa, więc duża część runtime pochodzi upstream. To kompromis. Open Interpreter dostaje sandbox i runtime Codexa „za darmo”, podczas gdy OpenCode kontroluje cały stack.
To nie są konkurenci w zwykłym sensie. Open Interpreter to fork Codexa.
Dzielą runtime w Ruście, TUI, sandbox, zatwierdzenia, AGENTS.md, umiejętności, MCP, tryb exec i większość komend na slashu. Gdy uruchamiałem Open Interpreter, podpowiedź wznowienia sesji wciąż mówiła codex resume.
Codex to agent OpenAI, zbudowany wokół modeli OpenAI. Wspiera modele lokalne flagą --oss i customowych dostawców, ale domyślne doświadczenie celuje w OpenAI.
Open Interpreter rozszerza Codexa w kilku kierunkach:
Emulacja harnessu: zmienia prompty, schematy narzędzi i format wiadomości, by dopasować je do rodziny modelu
Wsparcie dostawców: ma generowany katalog dostawców i dedykowane przewodniki dla Kimi K3, DeepSeek i GLM
Chat Completions: flaga --chat-completions obsługuje każdego dostawcę kompatybilnego z OpenAI
Nadpisanie SDK Codexa: aplikacje zbudowane na Codex SDK mogą działać zamiast tego przez Open Interpreter
Open Interpreter przechowuje też konfigurację i sesje w ~/.openinterpreter, więc nie koliduje z instalacją Codexa.
Jeśli głównie używasz modeli OpenAI, lepszym wyborem będzie Codex. Jeśli używasz innych modeli, Open Interpreter daje ten sam workflow z lepszym wsparciem dla nich.
Oto szybkie podsumowanie:
| Licencja | Modele | Podejście do harnessu | Konfiguracja | |
|---|---|---|---|---|
| Open Interpreter | Open source (Apache 2.0) | Dowolny dostawca, hostowany lub lokalny | Emuluje harness per model | config.toml |
| Claude Code | Proprietarna | Zbudowany dla modeli Claude | Własny harness Claude Code | settings.json i CLAUDE.md |
| OpenCode | Open source (MIT) | 75+ dostawców, hostowane lub lokalne | Jeden harness z promptami specyficznymi dla modelu | opencode.json |
| Codex | Open source (Apache 2.0) | Zbudowany dla modeli OpenAI z --oss | Własny harness Codexa | config.toml |
Porównanie Open Interpreter z innymi agentami do kodowania AI
Najgorsze, co może zrobić chatbot, to dać złą odpowiedź, którą możesz zignorować. Agent do kodowania uruchamia polecenia na twojej maszynie, czyta i zapisuje pliki, i może łączyć się z siecią. Zła decyzja modelu albo injection promptu może faktycznie zaszkodzić. Injection promptu to instrukcje ukryte w treści, którą agent czyta, jak plik README czy strona WWW.
Open Interpreter dziedziczy model bezpieczeństwa z runtime Codexa. Ma dwie warstwy — sandbox ograniczający możliwości oraz politykę zatwierdzania decydującą, kiedy agent prosi cię najpierw.
Każde polecenie uruchamiane przez agenta przechodzi przez sandbox na poziomie systemu operacyjnego na macOS, Linuksie i Windowsie. Są trzy tryby sandboxa:
read-only: agent może czytać pliki, ale niczego nie zmienia
workspace-write: agent może edytować pliki i uruchamiać polecenia w folderze twojego projektu
danger-full-access: brak sandboxa
W workspace-write zapisy plików są ograniczone do aktywnego workspace. Agent może naprawiać twój kod, ale nie może edytować plików poza twoim projektem.
W trybie workspace-write polecenia domyślnie nie mają dostępu do sieci. To blokuje pobrania i powstrzymuje agenta przed wysłaniem twojego kodu gdziekolwiek.
Niektóre zadania potrzebują sieci, np. instalacja pakietu. Możesz włączyć dostęp do sieci w konfiguracji:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
Włączaj go tylko w projektach, w których jest potrzebny.
Polityka zatwierdzania decyduje, kiedy agent się zatrzymuje i pyta:
untrusted: pyta, zanim uruchomi polecenia spoza listy zaufanych
on-request: pyta, gdy zadanie potrzebuje większego dostępu niż pozwala sandbox
never: nigdy nie pyta
Dla projektów pod kontrolą wersji, dobrym domyślnym jest workspace-write z on-request. Agent działa w twoim projekcie i pyta, zanim wyjdzie poza. Git daje ci drogę odwrotu, gdy coś pójdzie źle.
Flaga --yolo wyłącza zarówno sandbox, jak i zatwierdzenia. Używaj jej tylko w środowiskach jednorazowych, jak kontener czy VM.
Polecenia uruchamiane przez agenta dziedziczą środowisko twojej powłoki. Jeśli twoje klucze API są w zmiennych środowiskowych, te polecenia je widzą.
Możesz to ograniczyć ustawieniem shell_environment_policy:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
Ustawienie core przekazuje tylko podstawowe zmienne jak HOME i PATH, a exclude usuwa wszystko, co pasuje do wzorców.
Ryzykiem są też pliki. Agent może czytać plik .env w twoim projekcie nawet w trybie read-only. Przy dostawcy hostowanym wszystko, co agent przeczyta, trafia na serwery dostawcy.
Pamiętaj, że sandbox ogranicza szkody, ale traktuj go jako siatkę bezpieczeństwa, nie gwarancję.
Zanim pozwolisz agentowi działać samodzielnie, uruchom /status i sprawdź tryb sandboxa oraz politykę zatwierdzania.
Jeśli trafisz na artykuł o Open Interpreter, który zaczyna się od pip install, nie jest błędny. Opisuje inny projekt.
Oryginalny Open Interpreter wystartował w 2023 jako projekt w Pythonie. Pozwalał modelom językowym uruchamiać na twojej maszynie kod w Pythonie, JavaScripcie i shellu, a ludzie znali go jako otwartą alternatywę dla Code Interpreter w ChatGPT. Późniejsze wersje dodały kontrolę komputera, więc model mógł też pracować z twoim pulpitem.
Bieżący główny projekt to przepisanie w Ruście oparte na Codexie. Skupia się na agentach do kodowania i emulacji harnessów, a nie ogólnej kontroli komputera.
Wersja w Pythonie nie zniknęła. Kontynuowana jest jako fork społecznościowy w endolith/open-interpreter.
Obie wersje używają tej samej nazwy, tej samej historii repozytorium GitHub i tej samej komendy interpreter, więc łatwo je pomylić.
Ale bardzo prosty wyróżnik to:
pip install open-interpreter: przestarzała wersja w Pythonie
curl lub instalator PowerShell: obecna wersja w Ruście
Open Interpreter nie jest dobrym narzędziem dla każdego setupu. Oto gdzie ma sens, a gdzie nie.
Open source: licencja Apache 2.0, więc możesz czytać, audytować i forkować cały kod
Wybór modelu: używasz modeli hostowanych, open-weight i lokalnych w jednym agencie i przełączasz je w trakcie sesji
Wiele harnessów agenta: zbliżasz się do wydajności, pod którą strojeny był model — niewiele innych agentów to oferuje
Development natywny dla terminala: pasuje do twojego workflow powłoki i Gita, a tryb exec działa w skryptach i CI
Otwarte i tańsze modele: projekt jest wokół nich zbudowany, z dedykowanymi przewodnikami i dopasowanymi harnesami
Rozszerzalność: MCP, umiejętności, hooki, AGENTS.md, Agent Client Protocol i override SDK Codexa pozwalają łączyć go z innymi narzędziami
Jakość modeli się różni: agent jest tak dobry, jak model za nim, a żaden harness nie naprawi modelu, który nie potrafi zaplanować wieloetapowego zadania
Modele lokalne potrzebują mocnego sprzętu: w moich testach sam devstral-small-2 zajmował 26 GB pamięci, zanim doliczyć duże okno kontekstu potrzebne agentowi
Konfiguracja wymaga więcej pracy: sam zarządzasz dostawcami, oknami kontekstu, harnesami i sandboxem. Są też ostre krawędzie, jak pozostałości brandingu Codexa czy ostrzeżenia o metadanych dla modeli Ollamy
Wykonywanie poleceń to ryzyko: sandbox i zatwierdzenia zmniejszają ryzyko, ale go nie usuwają
Kod nadal wymaga przeglądu: zaliczone testy nie gwarantują poprawnej poprawki, więc musisz czytać każdy diff
Open Interpreter to otwartoźródłowy agent do kodowania, który działa z wybranym przez ciebie modelem — czy to hostowanym, open-weight, czy uruchomionym lokalnie na twojej maszynie.
Workflow jest prosty. Wybierasz model i harness, kierujesz agenta na projekt i pozwalasz mu badać, edytować i uruchamiać polecenia, aż zadanie będzie gotowe. Potem przeglądasz jego pracę.
Emulacja harnessów odróżnia go od konkurentów. Open Interpreter nie wciska każdego modelu w jednego agenta. Zmienia setup, by dopasować go do modelu — a to może robić różnicę. O tym, jak dobra jest praca, decyduje też model, a uprawnienia decydują, co agent może zmieniać. Twój przegląd to ostatnia kontrola, zanim jakakolwiek zmiana trafi do bazy kodu.
Jeśli chcesz zdobyć certyfikację inżyniera AI, zapisz się na naszą ścieżkę Associate AI Engineer for Developers i wejdź w świat AI we własnym tempie.
Ucz się z DataCamp
Ścieżka
Ścieżka
Ścieżka