Lernpfad
Associate AI Engineer für Entwickler
26 Std.
Wenn du schon einmal ein Open-Weight-Modell in einem Coding-Agenten für ein anderes Modell ausgeführt hast, weißt du: Keine gute Idee.
Das Modell interpretiert Tool-Schemata oft falsch und wiederholt denselben fehlgeschlagenen Befehl, bis du abbrichst. Wechselst du zurück zum vorgesehenen Modell, läuft dieselbe Aufgabe problemlos durch. Meist liegt es nicht am Modell, sondern am Agent-Harness darum herum: Prompts und Toolformate sind auf jemand anderen abgestimmt.
Open Interpreter löst das, indem es das Harness emuliert, für das jedes Modell trainiert wurde — etwa Claude Code oder Kimi Code. Es ist ein Open-Source-KI-Coding-Agent, der im Terminal läuft. Die aktuelle Version ist ein Rust-Projekt auf Basis von OpenAI's Codex, nicht der Python-basierte Computerassistent, an den du dich vielleicht erinnerst.
In diesem Artikel zeige ich dir Installation, Modell- und Harness-Setup, einen praxisnahen Coding-Workflow und wie Open Interpreter im Vergleich zu Claude Code, OpenCode und Codex abschneidet.
Neu bei KI-Agenten? Melde dich zu unserem Introduction to AI Agents Kurs an und lerne die Grundlagen an einem Nachmittag.
Open Interpreter gibt einem KI-Modell Zugriff auf dein Projekt und die Tools, mit denen ein Developer es bearbeitet.
Du beschreibst eine Aufgabe in einfachem Englisch, der Agent arbeitet am Code. Er kann mit Folgendem umgehen:
Das Projekt ist Open Source unter der Apache-2.0-Lizenz. Es ist auch nicht auf einen Anbieter beschränkt. Du kannst gehostete Modelle, Open-Weight-Modelle oder lokal laufende Modelle auf deinem Rechner anbinden.
Das Haupt-Repository hat im September 2026 über 68.000 GitHub Stars.
Open Interpreter arbeitet in einer Schleife:
Einige Schritte brauchen vorab deine Freigabe — je nach Berechtigungen. Details dazu im Sicherheitsabschnitt.
Hier ist eine visuelle Übersicht:
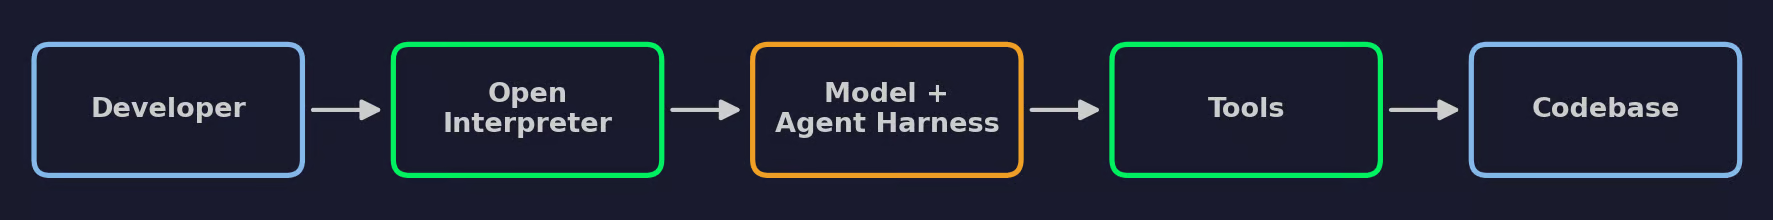
Funktionsweise von Open Interpreter
Wichtig ist: Du sprichst nicht direkt mit dem Modell. Open Interpreter sendet deine Aufgabe ans Modell — formatiert mit den Prompts und Tool-Definitionen des aktiven Harness. Das Modell fordert Tool-Aufrufe an, Open Interpreter führt sie gegen deine Codebase aus. Die Ergebnisse gehen fürs nächste Schritt zurück ans Modell.
Da Modell und Harness getrennte Schichten sind, kannst du beides unabhängig wechseln, ohne den Rest anzufassen.
Open Interpreter wird als eigenständiges Binary installiert — du brauchst weder Python noch pip.
Falls ein älterer Blogpost pip install open-interpreter empfiehlt, beschreibt er die Legacy-Python-Version. Dieser Befehl liefert nicht den Rust-basierten Coding-Agenten, um den es hier geht.
Git solltest du ebenfalls installiert haben. Open Interpreter läuft zwar ohne, aber mit Git bekommt es eine Repository-gestützte Session und Diffs.
Führe das Install-Skript im Terminal aus:
curl -fsSL https://www.openinterpreter.com/install | shDas Skript lädt das passende Release für deine Plattform und legt den interpreter Befehl unter ~/.local/bin ab.
Öffne PowerShell und führe aus:
irm https://www.openinterpreter.com/install.ps1 | iexWSL wird ebenfalls unterstützt, falls du ein Linux-ähnliches Setup bevorzugst. In diesem Fall führst du den macOS/Linux-Befehl im WSL-Terminal aus.
Starte dein Terminal neu, damit der neue PATH geladen wird, und prüfe dann die Version:
interpreter --versionWenn eine Versionsnummer erscheint, hat die Installation funktioniert.
Open Interpreter Versionscheck
Starte eine Session in einem beliebigen Verzeichnis:
interpreterDu kannst auch i tippen — ein kurzes Alias für denselben Befehl.
Open Interpreter öffnet eine Terminal-UI, in der du Aufgaben in einfachem Englisch beschreibst. Beim ersten Start fragt es nach einem Modellanbieter. Ich nutze im nächsten Abschnitt ein lokales Modell über Ollama — diesen Schritt kannst du vorerst überspringen.
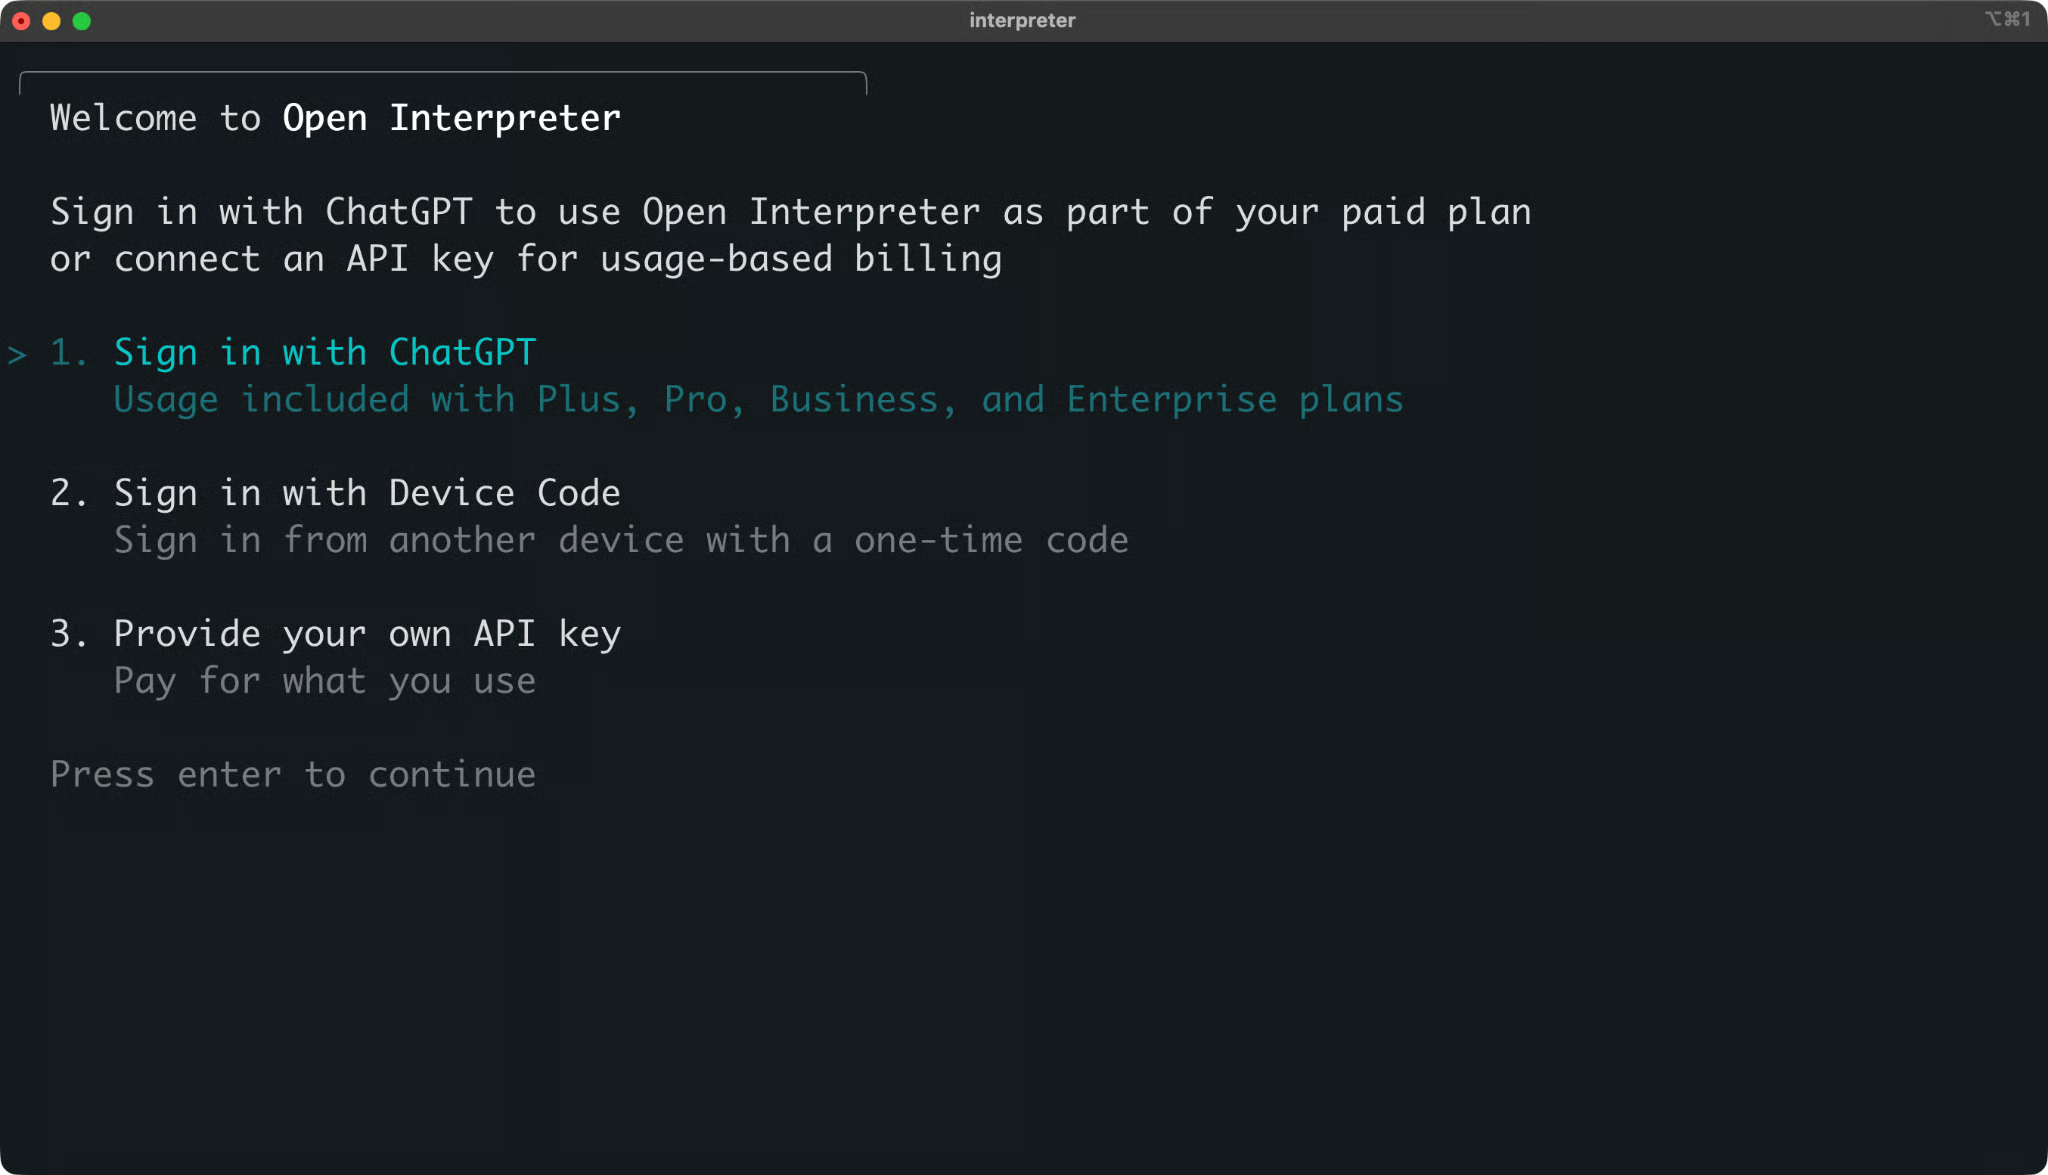
Interaktive Session in Open Interpreter
Um die Session zu verlassen, tippe /exit.
Am schnellsten verstehst du einen Coding-Agenten, wenn du ihm eine Aufgabe gibst und beobachtest, was passiert.
Ich nutze dafür ein kleines Habit-Tracker-Projekt: eine Funktion, eine Testdatei und ein Bug.
Das Projekt berechnet die längste Serie aufeinanderfolgender Tage für eine Gewohnheit — zum Beispiel, wie viele Tage in Folge du trainiert hast.
Starte mit einem Projektordner und einer virtuellen Umgebung:
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
Erstelle habits.py mit folgendem Code:
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
Lege dann test_habits.py an:
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
Die Funktion hat einen Bug. Ich verrate ihn nicht — das Finden ist die Aufgabe des Agenten.
Füge eine .gitignore hinzu, damit virtuelle Umgebung und Caches nicht ins Repo gelangen:
.venv/
__pycache__/
.pytest_cache/
Jetzt committen:
git init
git add .
git commit -m "Initial commit"
Dieser Commit ist dein sauberer Ausgangspunkt. Später siehst du damit exakt, was der Agent geändert hat.
Führe die Tests aus, um den Bug zu bestätigen:
python -m pytest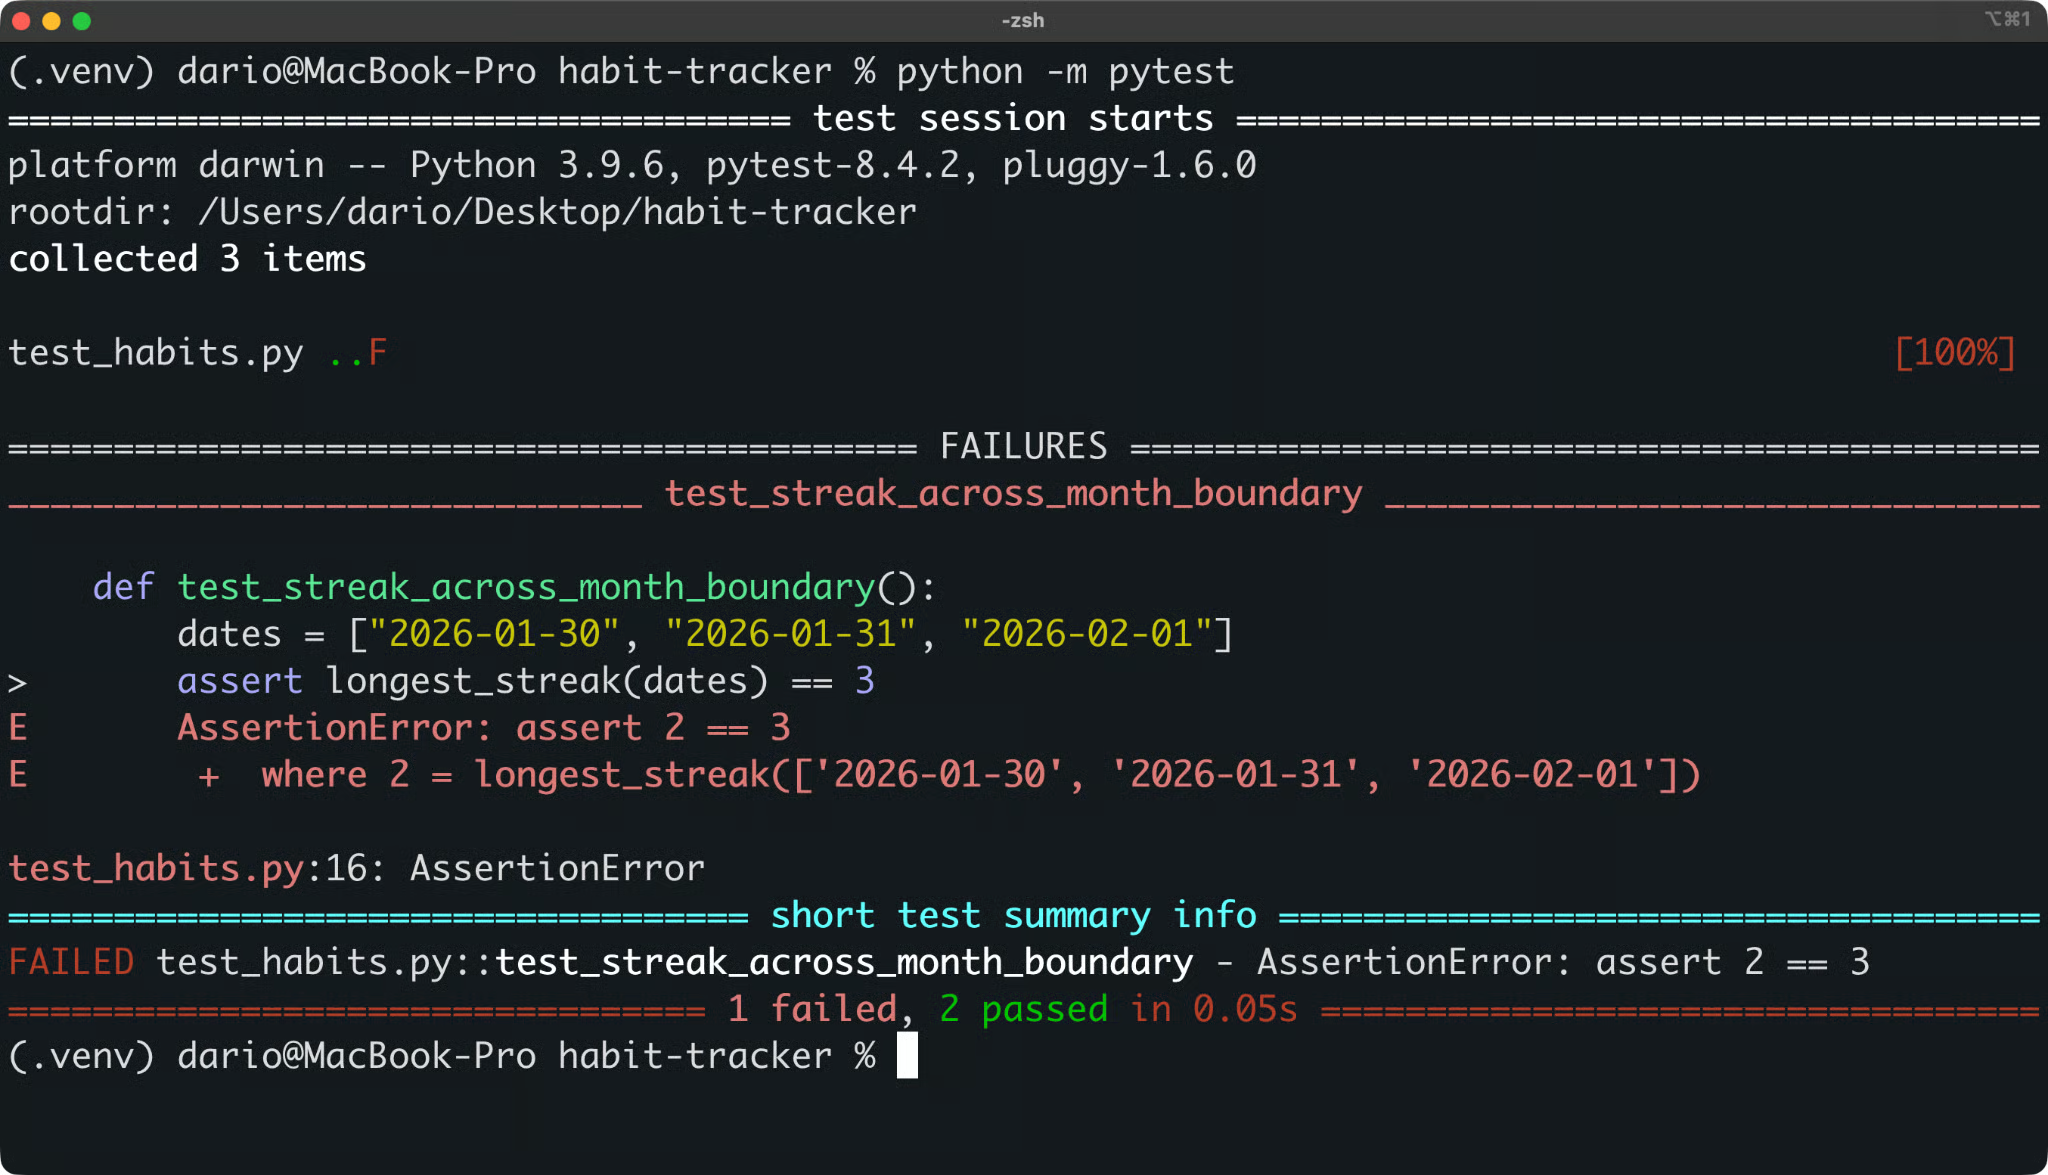
Testergebnis Habit-Tracker
Zwei Tests bestehen, einer fällt durch. Das ist das Problem, das Open Interpreter lösen soll.
Du brauchst Ollama installiert und laufend. Zudem brauchst du ein Modell mit Tool-Calling-Unterstützung. Ziehe es mit:
ollama pull qwen3-coder:30bStarte dann Open Interpreter im Projektordner. Nutze dasselbe Terminal, damit der Agent die pytest-Installation aus deiner virtuellen Umgebung verwenden kann:
interpreter --oss --local-provider ollama -m qwen3-coder:30bDas bedeuten die Flags:
--oss: Nutzt einen lokalen Open-Source-Provider
--local-provider ollama: Wählt Ollama statt LM Studio
-m qwen3-coder:30b: Setzt das Modell für diesen Lauf
Führe /status aus, um Provider, Modell, Sandbox-Modus und Freigaberichtlinie zu prüfen.
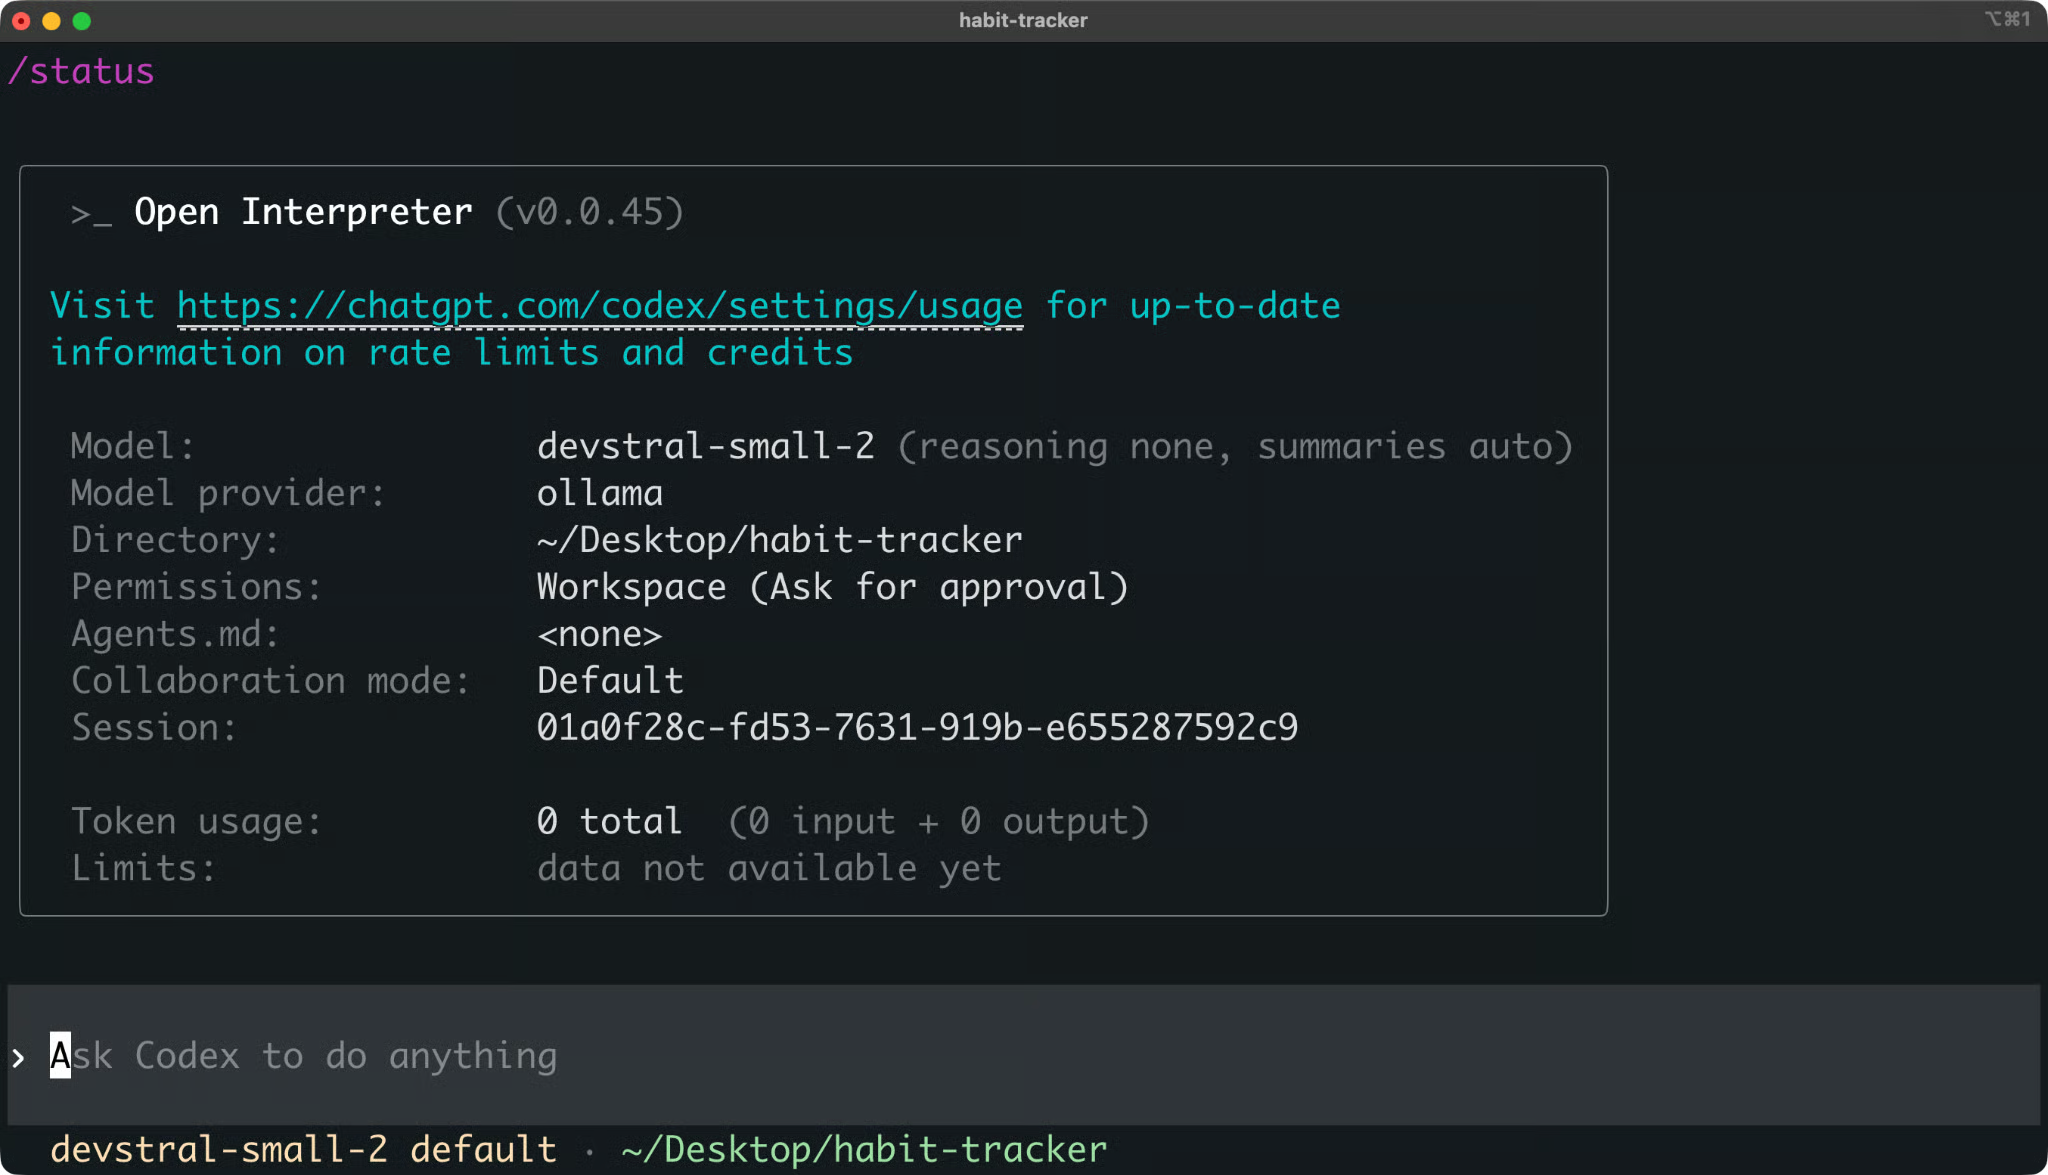
Open Interpreter Session mit lokalem Ollama-Modell
Noch sollen keine Dateien geändert werden. Bitte zuerst um eine Diagnose:
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.Der Agent liest in der Regel erst die Dateien und führt die Tests aus. Kommandos laufen in der Sandbox. Benötigt der Agent mehr Zugriff, fragt er vorher nach deiner Zustimmung.
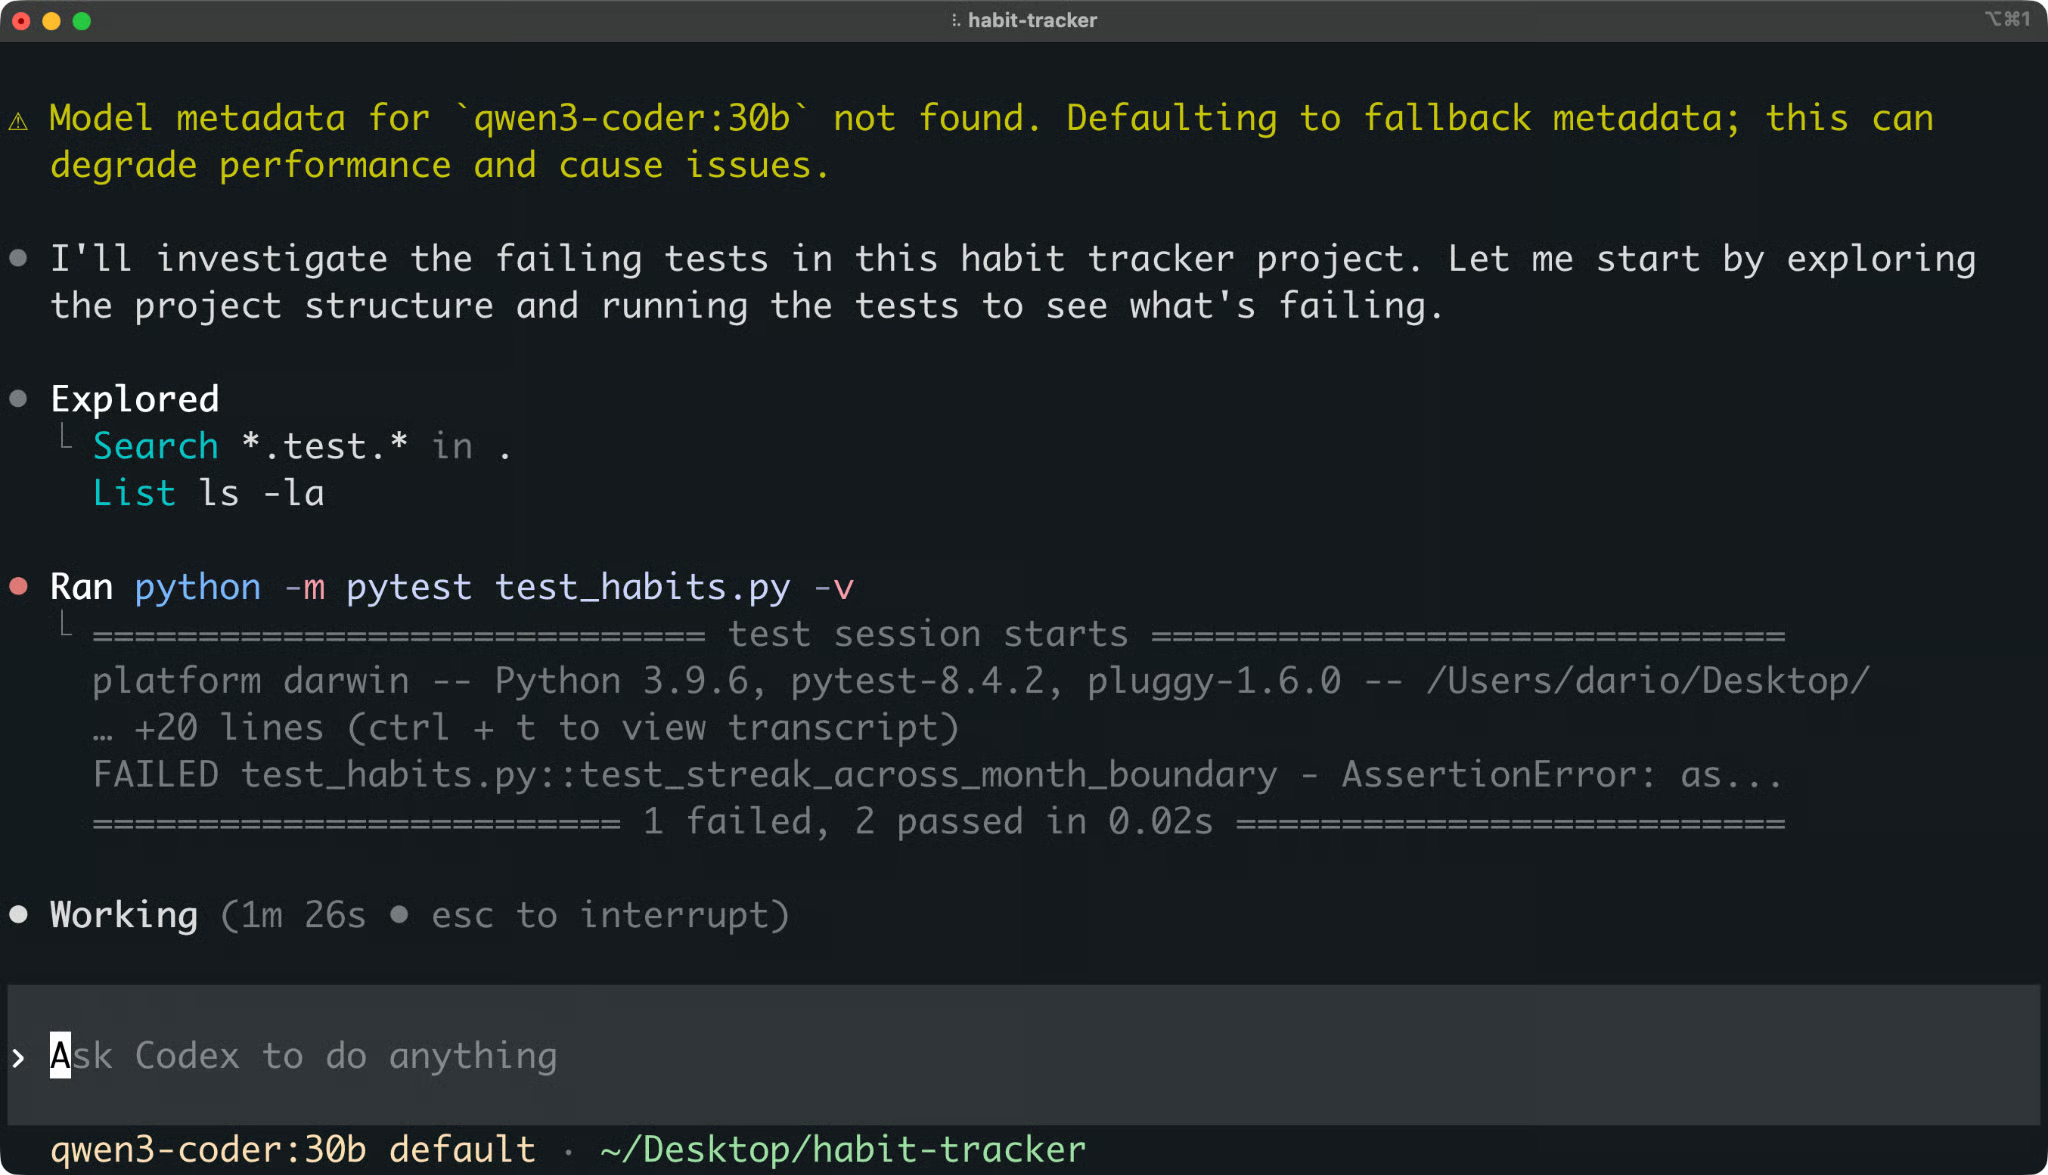
Open Interpreter Ausgabe
Lies die Erklärung, bevor du etwas freigibst.
Eine korrekte Diagnose: Die Funktion vergleicht nur den Tag im Monat, wodurch eine Serie beim Monatswechsel abreißt. Ein guter Fix vergleicht volle Datumswerte, z. B. mit date.fromisoformat() aus Pythons datetime-Modul.
Ist die Diagnose falsch, korrigiere sie in derselben Session, bevor der Agent Code ändert.
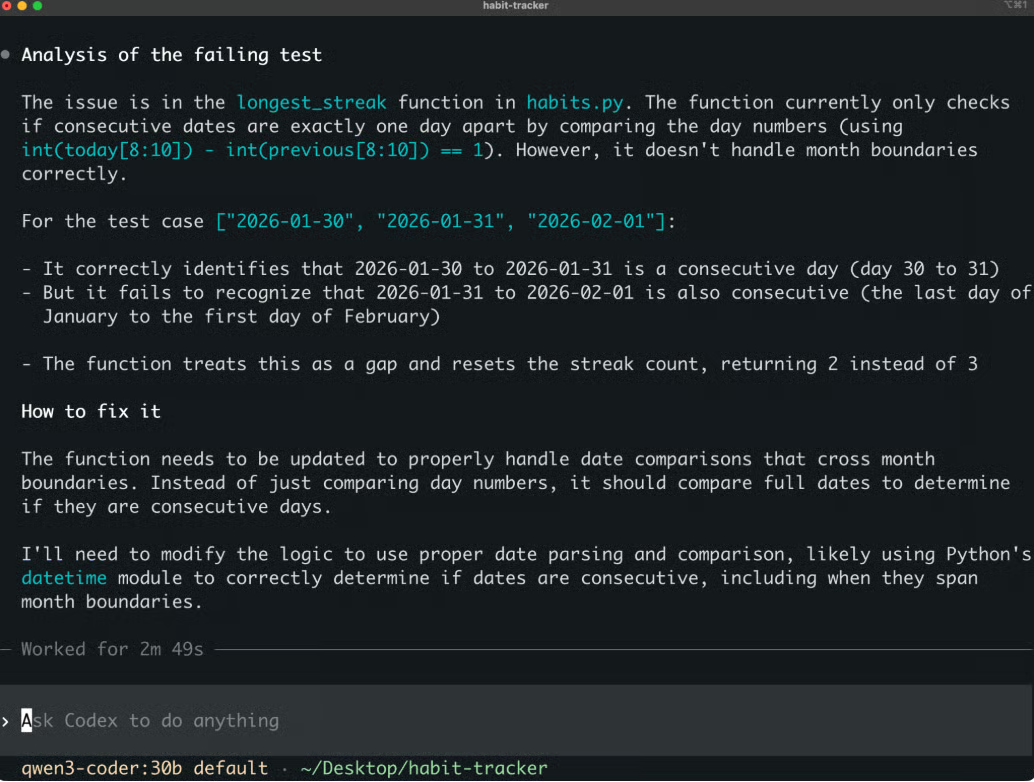
Vorgeschlagener Fix von Open Interpreter
Bist du mit dem Plan zufrieden, setze den Fix um:
Apply the fix to habits.py, then run the tests.Der Agent bearbeitet die Datei und führt pytest erneut aus. Ziel: Alle drei Tests bestehen.
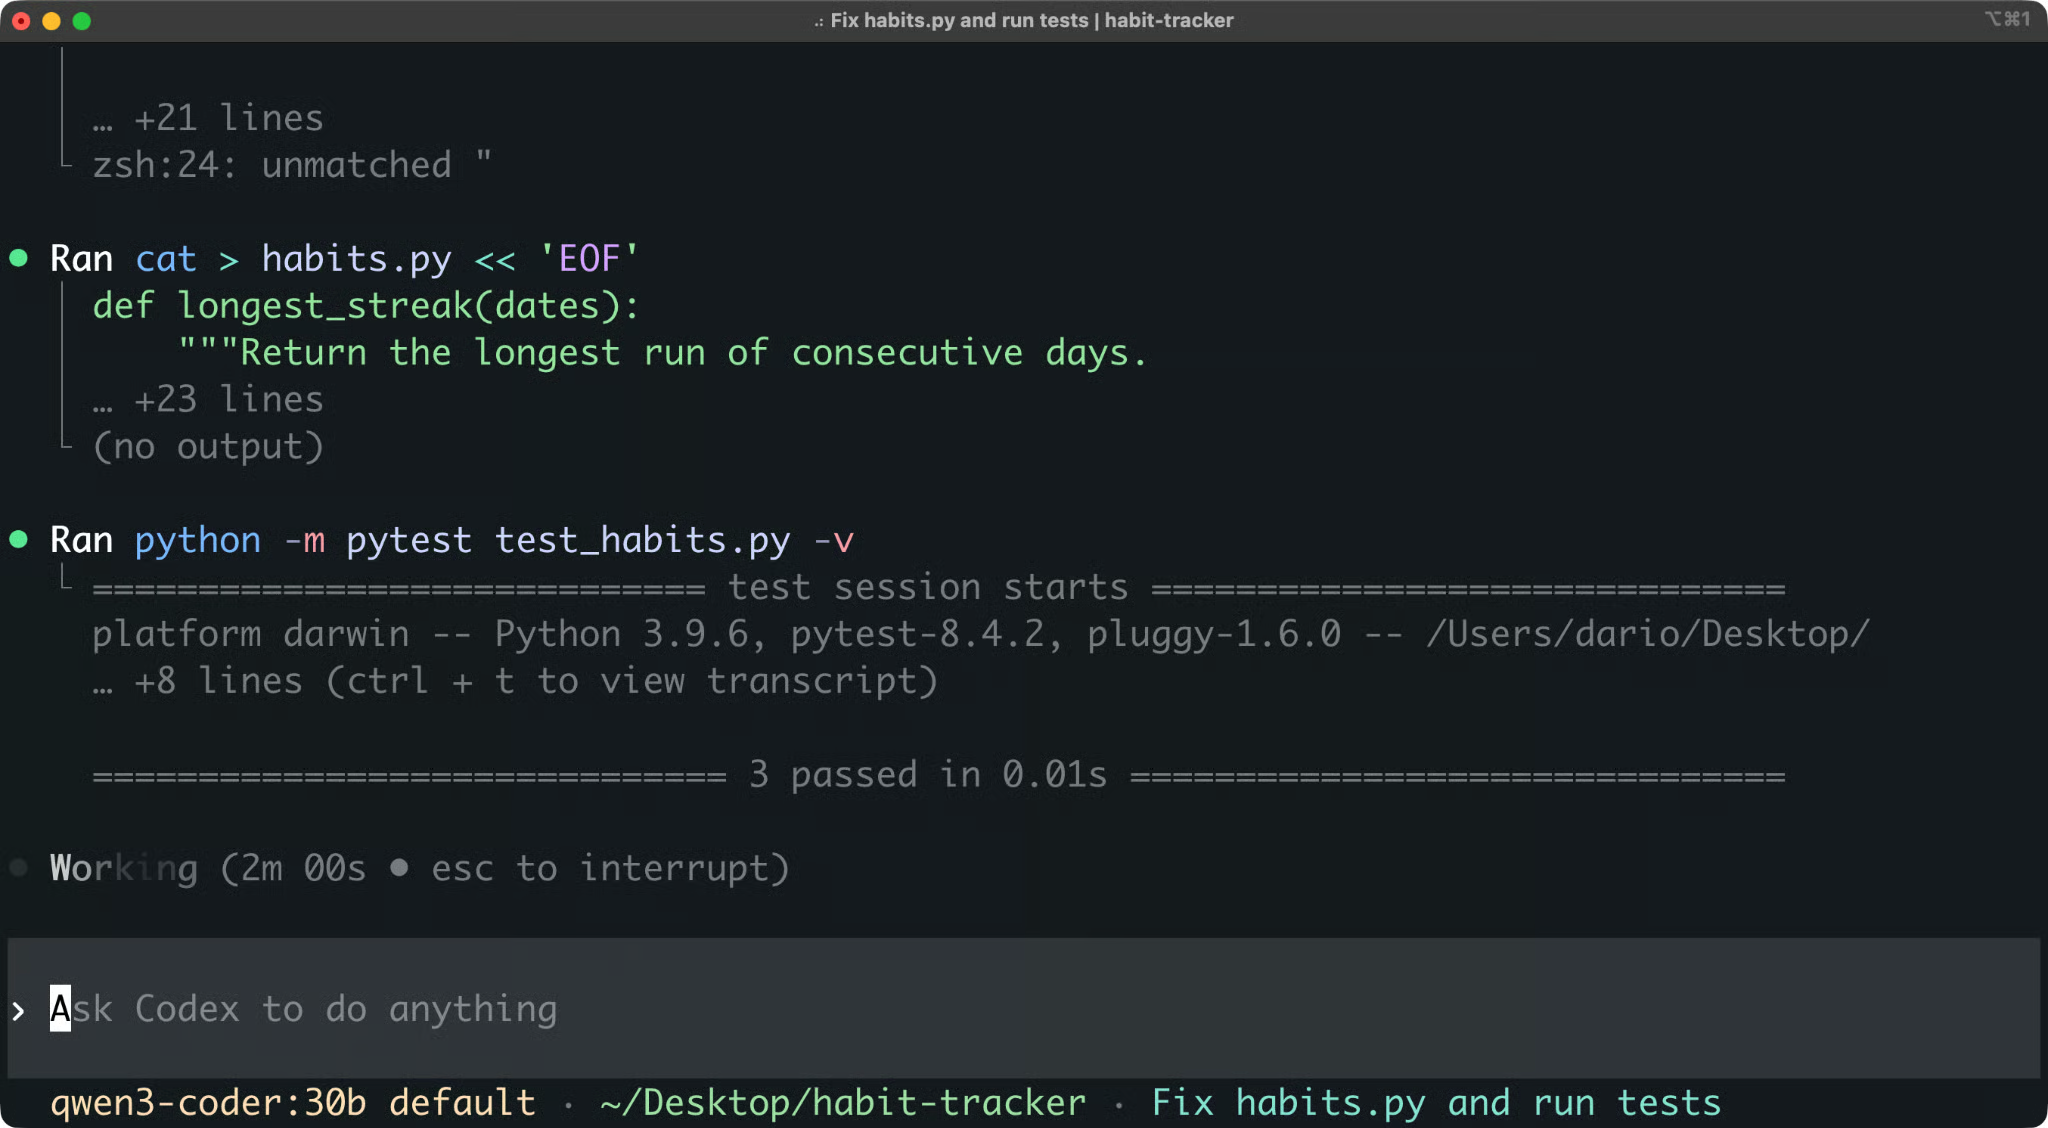
Alle Tests bestehen nach dem Fix
Ein grüner Test heißt nicht automatisch, dass der Bug behoben ist — vielleicht wurde der Test angepasst. Du musst den Code trotzdem prüfen.
Führe /diff in der Session aus, um Working-Tree-Änderungen zu sehen. Oder git diff nach dem Beenden.
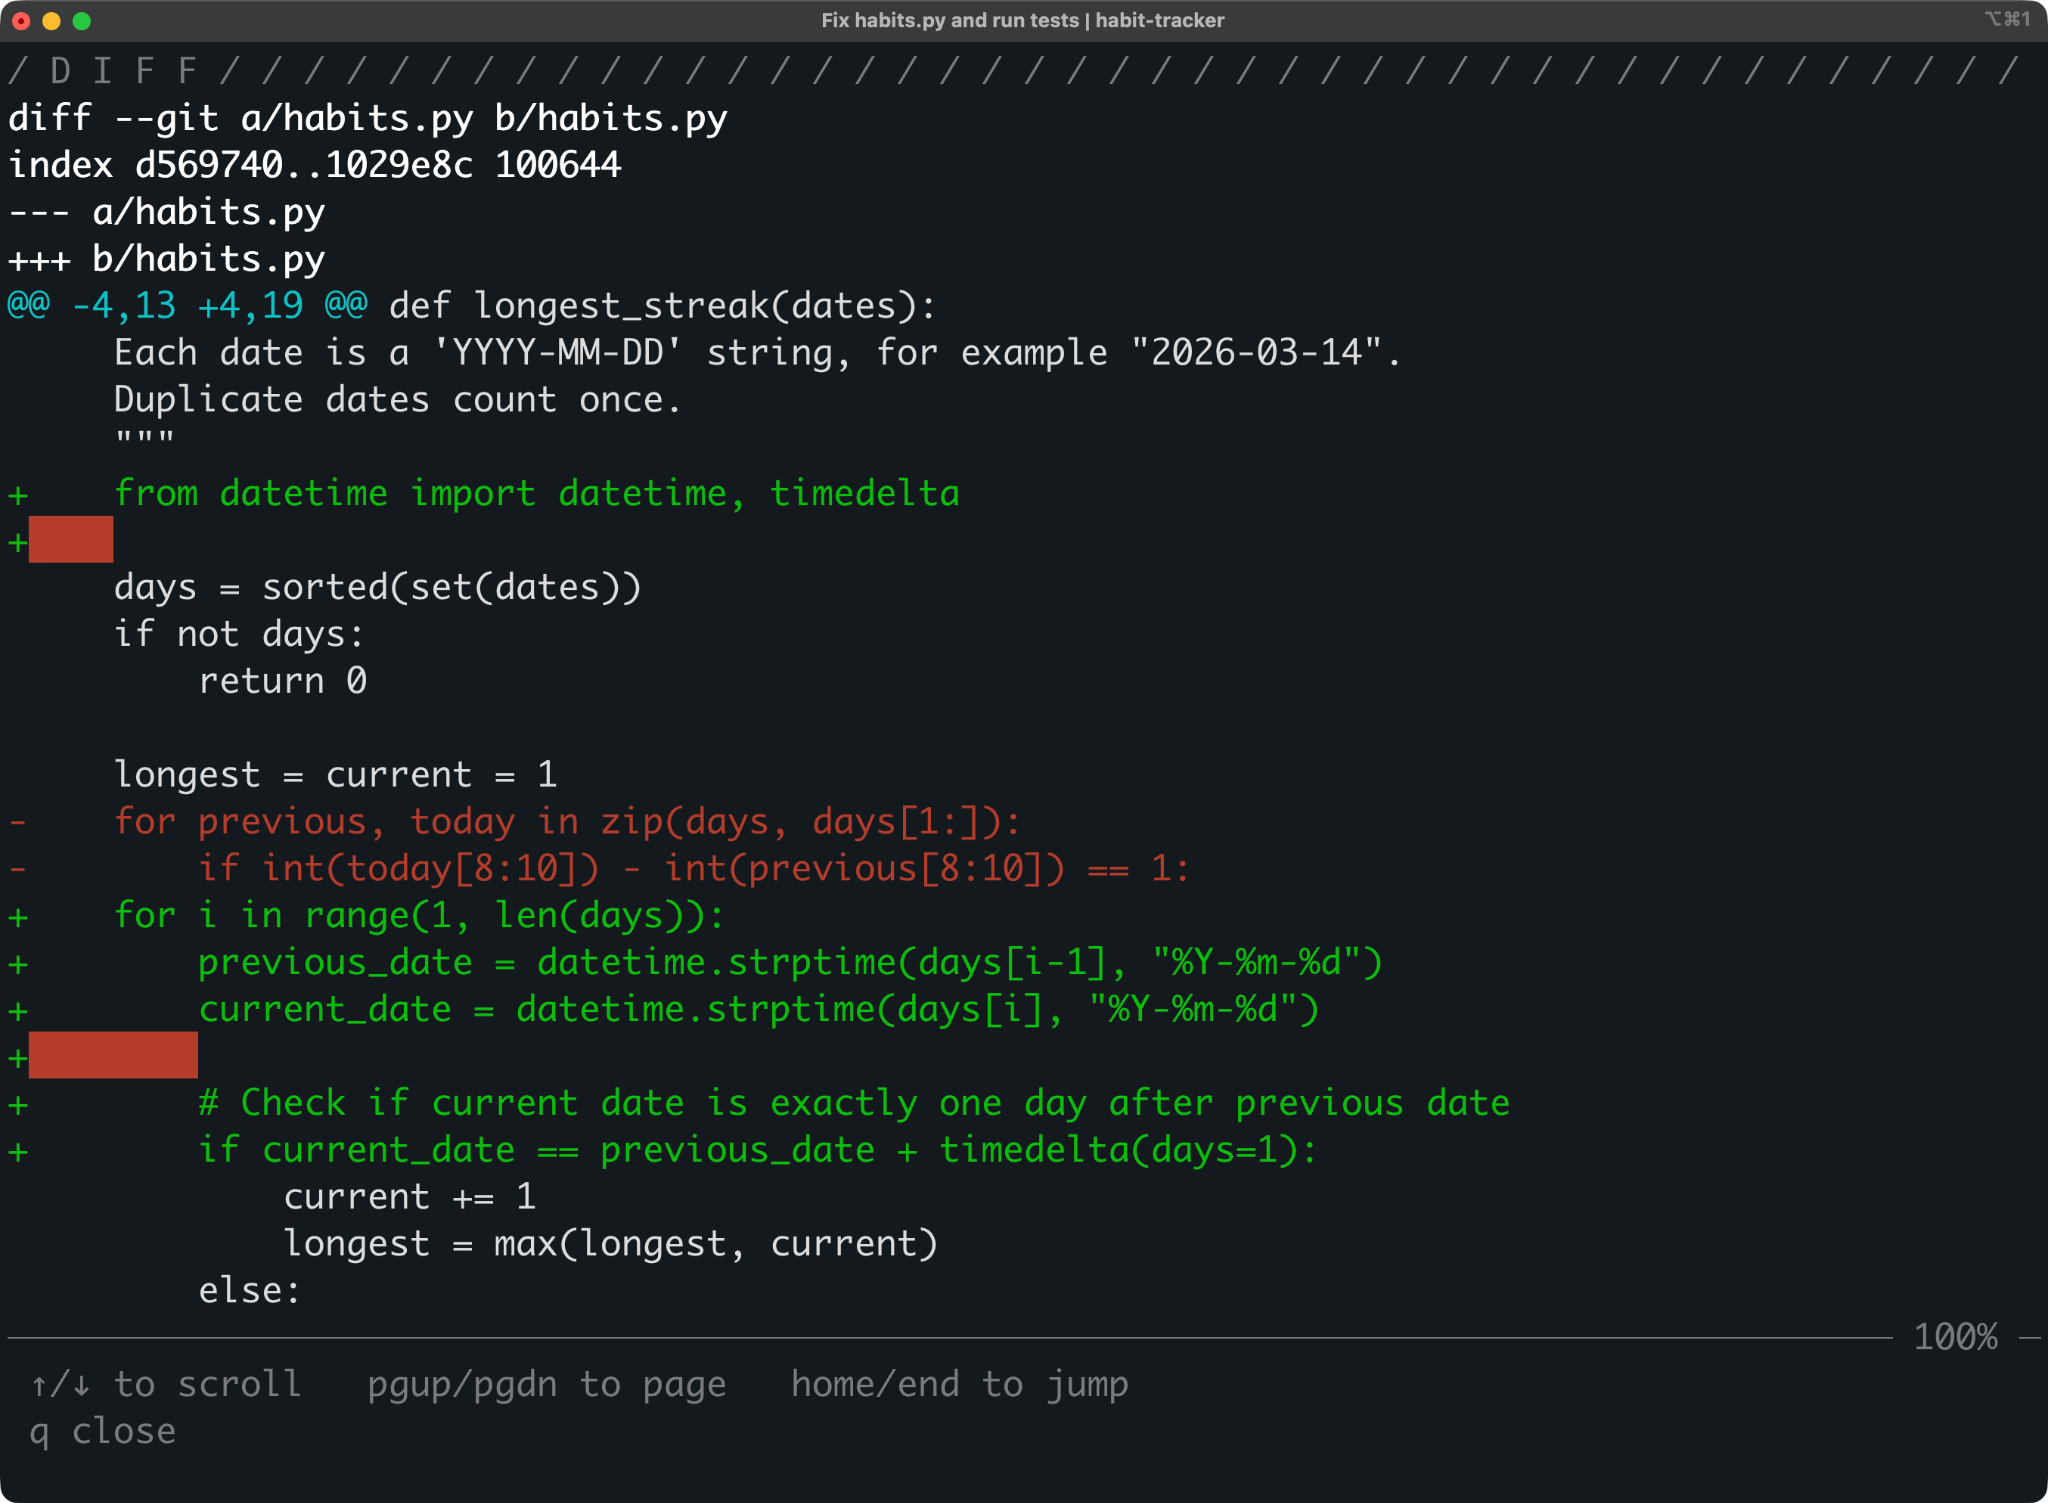
Diff der von Open Interpreter vorgenommenen Änderungen
Der genaue Diff hängt vom Modell ab, deiner kann also abweichen. Gefällt dir die Änderung, committe sie. Wenn nicht, stelle die Originaldatei wieder her:
git restore habits.pyUnd das ist die Idee: Du beschreibst das Problem, der Agent untersucht und fixt, und du prüfst jede Änderung, bevor sie Teil deines Codes wird.
Open Interpreter verlangt, dass du dein eigenes Modell mitbringst.
Jede Anfrage durchläuft drei Schichten:
| Schicht | Beispiel | Wofür sie zuständig ist |
|---|---|---|
| Provider | ollama | Wohin Anfragen gehen und wie du dich authentifizierst |
| Modell | devstral-small-2 | Das Modell, das die Arbeit erledigt |
| Harness | native | Prompts, Tools und Nachrichtenformat rund ums Modell |
Request-Schichten
Das kannst du anbinden:
Die Providerliste wird aus einem öffentlichen Modellkatalog generiert und behält nur Modelle mit Tool-Calling. Fehlt ein erwartetes Modell, liegt es meist daran.
Achte auf ollama-cloud. Das ist ein separater gehosteter Provider — deine Anfragen verlassen dann den Rechner. Nur der eingebaute ollama-Provider führt Modelle lokal aus.
Du kannst das Modell auf drei Ebenen ändern:
In der Session: Mit /model Provider, Modell und Reasoning-Aufwand wählen
Für einen einzelnen Lauf: Per -m-Flag, wie im vorigen Abschnitt
Als Standard: In der Konfigurationsdatei festlegen
Mit /status siehst du jederzeit, welcher Provider und welches Modell aktiv sind.
Open Interpreter liest Einstellungen aus ~/.openinterpreter/config.toml. Um das Ollama-Setup aus dem vorigen Abschnitt zum Standard zu machen, füge hinzu:
model_provider = "ollama"
model = "qwen3-coder:30b"
Danach startet interpreter mit diesem Modell — ganz ohne Flags.
Gehostete Provider lesen ihre API-Keys aus Umgebungsvariablen. DeepSeek erwartet z. B. DEEPSEEK_API_KEY:
export DEEPSEEK_API_KEY="your-api-key"Du kannst auch jeden OpenAI-kompatiblen Endpoint als Custom-Provider hinzufügen:
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
Die Einstellung wire_api sagt Open Interpreter, welches Request-Format der Endpoint erwartet. Nutze chat für OpenAI-kompatible Chat Completions, responses für die OpenAI Responses API und messages für Anthropic-ähnliche Endpunkte.
Ein vertrautes Projekt kann auch eine eigene .openinterpreter/config.toml haben, die deine User-Konfiguration überschreibt. Kommandozeilen-Flags überschreiben beide. Bist du unsicher, welcher Wert greift, nutze /debug-config, um die effektiven Settings und ihre Herkunft zu sehen.
Das Modell bestimmt, wie gut der Agent deinen Code versteht. Das Harness bestimmt, wie das Modell Aufgabe und Tools wahrnimmt.
Du brauchst beides. Ein starkes Modell in einem unpassenden Harness erzeugt fehlerhafte Tool-Calls und liest Resultate falsch. Und ein gutes Harness kann kein Modell ersetzen, das den Code nicht versteht.
Darum wählt Open Interpreter beim Modell auch ein Harness. Zum Beispiel:
Claude-Modelle bekommen das claude-code Harness
Kimi-Modelle bekommen kimi-code
Qwen-Modelle bekommen qwen-code
DeepSeek-Modelle bekommen claude-code-bare
Für andere Modellfamilien kannst du das Harness mit /harness selbst wählen.
Merke: Ein schwaches Ergebnis heißt nicht automatisch ein schwaches Modell. Teste dasselbe Modell erst mit einem anderen Harness, bevor du wechselst — Details im nächsten Abschnitt.
Harness-Emulation ist der Hauptgrund für die aktuelle Open-Interpreter-Version.
Ein Agent-Harness ist alles rund ums Modell, was es zum Agenten macht. Dazu gehören:
Kurz: Das Harness bestimmt, wie das Modell die Aufgabe sieht und wie seine Entscheidungen zu Aktionen werden.
Open Interpreter bringt mehrere Harness-Modi mit. Diese nutzt du am häufigsten:
native: Eigenes Harness von Open Interpreter, aus Codex geerbt
claude-code: Emuliert Prompts und Tool-Oberfläche von Anthropic's Claude Code
kimi-code: Rust-Neuimplementation des von Moonshot empfohlenen Kimi Code Harness
qwen-code: Emuliert Alibabas Qwen Code CLI für Qwen-Modelle
swe-agent: Emuliert SWE-agent, einen Forschungsagenten zum Lösen von GitHub-Issues
Die vollständige Liste enthält Varianten wie claude-code-bare, kimi-cli, deepseek-tui, zcode und minimal. Führe /harness in einer Session aus, um die unterstützten Modi zu sehen.
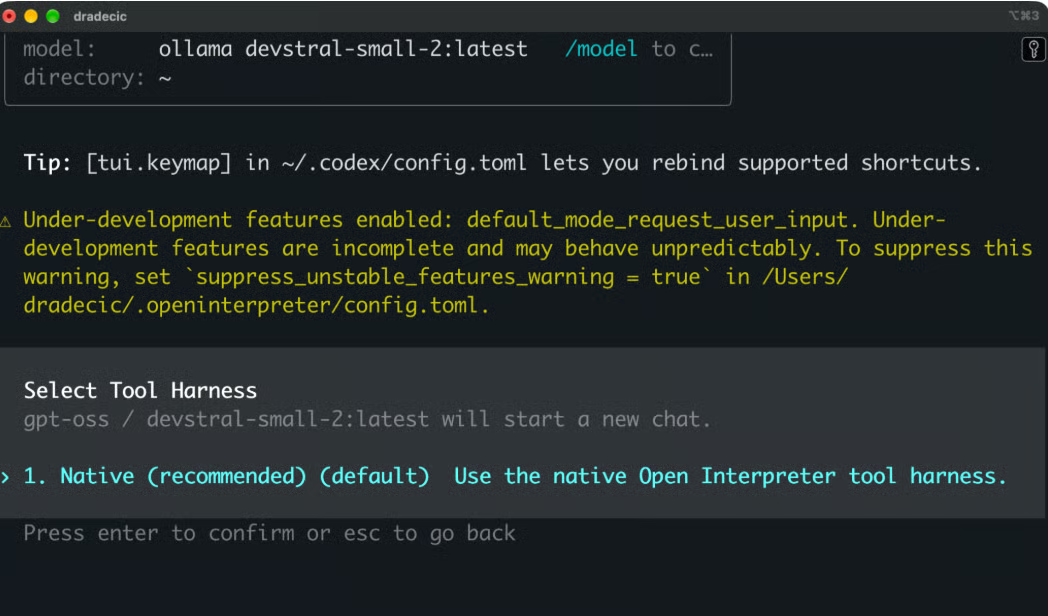
Du kannst das Harness mit /harness während der Session wechseln oder in ~/.openinterpreter/config.toml voreinstellen:
harness = "kimi-code"
harness_guidance = true
Die Einstellung harness_guidance fügt dort Zuverlässigkeits-Guidance hinzu, wo das Harness es erlaubt. Setze sie auf false, wenn du strengere Emulation willst. Lässt du harness leer, wählt Open Interpreter anhand der Modellfamilie — wie zuvor gezeigt.
Die meisten Anbieter stimmen ihre Coding-Modelle auf ein konkretes Agent-Setup ab und veröffentlichen ein empfohlenes Harness dazu.
Das Modell gewöhnt sich an dieses Harness: Prompt-Stil, Tool-Namen, Edit-Format, Art der Rückgaben.
Beispiel: Du nutzt ein auf Suchen-und-Ersetzen trainiertes Modell in einem Harness, das vollständige Patch-Dateien erwartet. Das Modell weiß, welche Änderung nötig ist, beschreibt sie aber ständig im falschen Format. Die Agent-Schleife verbraucht Tokens ohne Fortschritt.
Gleiches gilt für Tool-Ergebnisse. Liefert das Harness ein unbekanntes Format, liest das Modell es falsch. Wenn das Harness das Denken des Modells zwischen Zügen entfernt, verliert ein „denkendes“ Modell seinen Plan.
So kann dasselbe Modell in einem Agent gut und in einem anderen schlecht wirken — ganz ohne Gewichtsänderung. Deshalb nennen Benchmark-Ergebnisse meist auch das verwendete Harness.
Spitzenmodelle kompensieren ungewohnte Harnesses eher, kleinere und günstigere Modelle meist nicht. Open Interpreter zwingt Modelle nicht in ein Format, sondern passt das Format ans Modell an.
Teste das selbst mit dem Demo-Projekt: Stelle die Originaldatei mit git restore habits.py wieder her, wechsle das Harness mit /harness und gib denselben Prompt erneut. Vergleiche dann Schritte und Edit-Formate.
Die meisten hast du schon gesehen. Hier ihr Nutzen im Alltag.
Open Interpreter arbeitet in deinem Git-Repository. Es liest die Struktur und verfolgt eigene Änderungen.
Zwei Slash-Commands helfen: /diff zeigt Working-Tree-Änderungen, /review bittet den Agenten vor dem Commit um einen Bug-/Regression-Check der aktuellen Änderungen. Dasselbe Review geht auch ohne Session:
interpreter exec review --uncommittedSessions werden gespeichert. Brichst du mittendrin ab, setzt interpreter resume --last dort fort.
Der Agent führt dieselben Kommandos aus wie du: Test-Suites, Linter, Build-Skripte, Paketmanager. Alles läuft in nativer Sandbox auf macOS, Linux und Windows.
Lange laufende Kommandos können im Hintergrund laufen. Nutze /ps zum Auflisten und /stop zum Beenden.
Für Skripte und CI führt interpreter exec eine Aufgabe ohne UI aus:
interpreter exec "fix the failing test"Mit /model wechselst du jederzeit Provider und Modelle. Deine Konfiguration, AGENTS.md und Skills bleiben gültig.
Praktisch sind Profile. Zum Beispiel ein günstiges Modell für Routine und ein stärkeres für Code-Reviews. Definiere beides in der Config:
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
Starte dann bei Bedarf mit interpreter --profile review.
/harness ändert, wie das Modell die Aufgabe sieht — ohne das Modell zu wechseln. Das ist der erste Hebel, wenn Tool-Calls haken, bevor du zu einem größeren Modell greifst.
Das Model Context Protocol (MCP) verbindet den Agenten mit Tools, für die er nicht gebaut wurde — z. B. Doku-Server oder Datenbanken. Du fügst Server in der Config hinzu:
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
Mit /mcp siehst du konfigurierte Server und Tools. default_tools_approval_mode sorgt dafür, dass der Agent vor Nutzung eines Tools von dort fragt.
Es geht auch umgekehrt. interpreter mcp-server stellt Open Interpreter selbst als MCP-Server bereit, und interpreter acp bindet ihn in Editoren ein, die das Agent Client Protocol unterstützen — einen offenen Standard, um Editoren mit Coding-Agenten zu verbinden.
AGENTS.md ist eine Markdown-Datei im Repo mit Projektregeln, die der Agent bei jeder Aufgabe liest. Für den Habit-Tracker könnte sie so aussehen:
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
Du kannst auch /init ausführen — der Agent schreibt dir eine erste Version.
Skills sind wiederverwendbare Workflows als Ordner in .agents/skills im Projekt oder ~/.agents/skills für den User. Passt eine Aufgabe, greift der Agent automatisch zu. Mit /skills siehst du, was verfügbar ist.
Beides sind geteilte Formate — dieselben Dateien funktionieren bei anderen Coding-Agenten, die sie unterstützen. Open Interpreter unterstützt außerdem Hooks, die deine eigenen Kommandos an definierten Punkten in einer Session ausführen. Du prüfst und vertraust sie mit /hooks.
Zwei Einstellungen steuern, was der Agent darf:
Sandbox-Modus: read-only, workspace-write oder danger-full-access
Freigaberichtlinie: untrusted, on-request oder never
Die Sandbox bestimmt, was möglich ist. Die Freigaben regeln, wann der Agent vorher fragt. Mit workspace-write und on-request kann der Agent dein Projekt bearbeiten und Tests ausführen, fragt aber vor weitergehendem Zugriff.
Beides änderst du mit /permissions oder den Flags -s und -a. Es gibt auch --yolo, das beides umgeht — laut Doku gefährlich. Mehr dazu im Sicherheitsabschnitt.
Open Interpreter versteht sich als Coding-Agent für kostengünstige Modelle.
Die großen proprietären Coding-Agenten sind um die hauseigenen Modelle gebaut. Open Interpreter bietet dir einen Agenten, der mit proprietären, gehosteten Open-Weight- und lokalen Modellen arbeitet.
Open-Weight-Modelle wie Kimi, DeepSeek, GLM und Qwen haben öffentliche Gewichte. Du kannst sie über Drittanbieter oder auf eigener Hardware nutzen.
Das hat zwei Vorteile: Gehostete Open-Weight-Modelle sind meist günstiger pro Token als proprietäre Spitzenmodelle. Und du bist nicht an einen Host gebunden, weil dasselbe Modell überall läuft, wo seine Gewichte laufen.
Open Interpreter hat eigene Provider-Guides für Kimi K3, DeepSeek und GLM und wählt passende Harnesses für diese Familien.
Ollama und LM Studio sind eingebaute Provider — du kannst also ein Modell lokal ohne API-Key und ohne Tokenkosten ausführen.
Die Kosten liegen in der Hardware. In meinem Test belegte devstral-small-2 auf einem MacBook Pro M1 Max mit 64 GB Unified Memory allein 26 GB. Das Standard-Kontextfenster von Ollama war für die Agent-Schleife zu klein, und bei 128k Tokens schwankte der Speicher, bis die Session hängen blieb.
Coding-Agenten brauchen ein großes Kontextfenster, da System-Prompt, Tool-Definitionen, Dateiinhalte und Kommandausgaben hineinpassen müssen. Ollama empfiehlt mindestens 64k Tokens für Codex-ähnliche Agenten. Ein größeres Kontextfenster benötigt zusätzlich Speicher — on top des Modells.
Open Interpreter läuft auf deinem Rechner — das Modell muss es nicht.
Wohin dein Code geht, hängt vom Provider ab:
Deine Konfiguration, Sessions und Logs liegen immer lokal unter ~/.openinterpreter.
Wenn du mehr Kontrolle brauchst, füge einen Custom-Provider hinzu, der auf deinen eigenen Inferenz-Server zeigt — jeder OpenAI-kompatible API-Server funktioniert, etwa eine vLLM-Installation auf euren GPUs. So bekommst du ein gehostetes Setup auf eigener Infrastruktur.
Offene Modelle sind unterschiedlich gut im Tool-Calling. Schwächen zeigen sich als fehlerhafte Aufrufe, Schleifen, verfrühte Stopps oder ignorierte Ausgaben.
Das richtige Harness hilft, aber es repariert kein Modell, das keine mehrschrittigen Aufgaben planen kann. Kleinere lokale Modelle haben hier am meisten Mühe.
Bevor du ein neues Modell auf ein echtes Projekt loslässt, teste es auf einem kleinen Repo wie dem Habit-Tracker. Zeigt es Schwächen, probiere ein anderes Harness, bevor du ein größeres Modell wählst.
Hier eine schnelle Zusammenfassung deiner Optionen:
| Wo läuft die Inferenz | Kosten | Verlässt Code deinen Rechner? | |
|---|---|---|---|
| Proprietäres gehostetes Modell | Server des Anbieters | Pro Token oder Abo | Ja |
| Open-Weight gehostetes Modell | Server des Providers | Pro Token, meist günstiger | Ja |
| Open-Weight lokales Modell | Deine Hardware | Hardware und Strom | Nein |
Optionen von Open Interpreter für lokale und offene Modelle
Open Interpreter teilt viel mit anderen Terminal-Agenten. Unterschiede liegen in der Eigentümerschaft und den Zielmodellen.
Claude Code ist Anthropic's Terminal-Coding-Agent. Erster Unterschied: Eigentum — Claude Code ist proprietär, Open Interpreter ist Open Source (Apache 2.0). Du kannst bei Open Interpreter alles lesen und ändern.
Zweiter Unterschied: Modellwahl. Claude Code ist für Claude-Modelle gebaut. Du kannst andere Anthropic-kompatible Endpunkte nutzen, aber das Harness bleibt auf Claude abgestimmt. Open Interpreter macht die Modellwahl zum Kernfeature.
Spannend wird der Harness-Vergleich: Claude Code ist eines der Harnesses, die Open Interpreter emuliert. Mit claude-code bekommen beliebige Modelle Claude-Code-ähnliche Prompts und Tools in der Open-Interpreter-Laufzeit. Die UI und Slash-Commands bleiben Open Interpreter — es ist also nicht dasselbe Produkt mit anderem Modell.
Beide Tools sind Terminal-first. Beide haben interaktive Sessions und einen Non-Interactive-Modus für Skripte und CI. Für Projektanweisungen liest Claude Code CLAUDE.md, Open Interpreter nutzt das gemeinsame AGENTS.md-Format.
Claude Code hat ein größeres Ökosystem: IDE-Extensions, Desktop- und Web-Apps, Plugin-Marktplatz, Subagenten und ein SDK. Open Interpreter ist jünger und setzt auf offene Standards wie MCP, Skills, AGENTS.md und das Agent Client Protocol statt auf ein eigenes Ökosystem.
Wenn du mit Claude-Modellen arbeitest und die polierteste Erfahrung willst, ist Claude Code die sichere Wahl. Willst du andere Modelle nutzen oder proprietäre Tools meiden, nimm Open Interpreter.
OpenCode ist am ähnlichsten: beides Open Source, Terminal-first, mit breiter Modellanbieter-Unterstützung.
Modell-Support ist auf dem Papier ähnlich. OpenCode unterstützt 75+ Provider, Open Interpreter generiert seine Providerliste aus einem öffentlichen Katalog. Beide können lokale Modelle via Ollama.
Im Terminal unterscheiden sie sich stärker. OpenCode hat eine eigene TUI mit LSP-Integration und gibt Code-Diagnostics wie Typfehler ans Modell zurück. Open Interpreters TUI stammt aus Codex.
Bei der Konfiguration nutzt OpenCode opencode.json, Open Interpreter config.toml mit Profilen.
Der größte Unterschied ist die Agent-Architektur. OpenCode läuft als Client-Server — die TUI ist ein Client eines lokalen Servers, an den sich weitere Clients hängen. Es hat eingebaute build und plan Agenten und unterstützt Custom- und Subagenten. Es passt den System-Prompt je Modellfamilie an, Tools und Loop bleiben aber OpenCode-eigen. Open Interpreter geht weiter und tauscht das gesamte Harness — inklusive Tool-Schemata und Nachrichtenformat. Neuere Builds enthalten sogar einen opencode-Harness-Modus.
Auf Entwicklungsseite ist OpenCode ein eigenständiger Code-Stack der Community. Open Interpreter baut auf einem Codex-Fork — ein großer Teil der Laufzeit kommt von upstream. Trade-off: Open Interpreter bekommt Sandbox und Runtime von Codex „gratis“, während OpenCode die volle Kontrolle hat.
Keine klassischen Konkurrenten: Open Interpreter ist ein Fork von Codex.
Sie teilen sich die Rust-Laufzeit, die TUI, Sandboxing, Freigaben, AGENTS.md, Skills, MCP, exec-Modus und die meisten Slash-Commands. Als ich Open Interpreter nutzte, zeigte der Resume-Hinweis noch codex resume.
Codex ist OpenAI's Agent — rund um OpenAI-Modelle. Es unterstützt lokale Modelle mit --oss und Custom-Provider, aber die Default-Erfahrung zielt auf OpenAI.
Open Interpreter erweitert Codex in mehrere Richtungen:
Harness-Emulation: Passt Prompts, Tool-Schemata und Nachrichtenformat je Modellfamilie an
Provider-Support: Generierter Provider-Katalog und eigene Guides für Kimi K3, DeepSeek, GLM
Chat Completions: Das Flag --chat-completions unterstützt beliebige OpenAI-kompatible Provider
Codex SDK Override: Apps auf dem Codex SDK können stattdessen über Open Interpreter laufen
Open Interpreter speichert Config und Sessions unter ~/.openinterpreter und kollidiert so nicht mit einer Codex-Installation.
Wenn du hauptsächlich OpenAI-Modelle nutzt, ist Codex die bessere Wahl. Nutzt du andere Modelle, bietet dir Open Interpreter denselben Workflow — mit besserem Support dafür.
Kurz zusammengefasst:
| Lizenz | Modelle | Harness-Ansatz | Konfig | |
|---|---|---|---|---|
| Open Interpreter | Open Source (Apache 2.0) | Beliebige Provider, gehostet oder lokal | Emuliert Harness pro Modell | config.toml |
| Claude Code | Proprietär | Für Claude-Modelle gebaut | Eigenes Claude-Code-Harness | settings.json und CLAUDE.md |
| OpenCode | Open Source (MIT) | 75+ Provider, gehostet oder lokal | Ein Harness mit modell-spezifischen Prompts | opencode.json |
| Codex | Open Source (Apache 2.0) | Für OpenAI-Modelle, mit --oss | Eigenes Codex-Harness | config.toml |
Open Interpreter im Vergleich zu anderen KI-Coding-Agenten
Das Schlimmste, was ein Chatbot tun kann, ist eine schlechte Antwort — die du ignorierst. Ein Coding-Agent führt Befehle auf deinem Rechner aus, liest und schreibt Dateien und kann ins Netz. Eine Fehlentscheidung des Modells oder eine Prompt-Injection kann echten Schaden anrichten. Prompt-Injection sind Anweisungen, die in gelesenen Inhalten versteckt sind — z. B. in einer README oder Webseite.
Open Interpreter erbt sein Sicherheitsmodell von der Codex-Laufzeit. Es gibt zwei Ebenen: eine Sandbox, die Möglichkeiten begrenzt, und eine Freigaberichtlinie, die entscheidet, wann der Agent zuerst fragt.
Jeder vom Agenten ausgeführte Befehl läuft durch ein OS-Level-Sandboxing auf macOS, Linux und Windows. Es gibt drei Modi:
read-only: Der Agent kann lesen, aber nichts ändern
workspace-write: Der Agent kann Dateien bearbeiten und Befehle im Projektordner ausführen
danger-full-access: Keine Sandbox
Mit workspace-write sind Schreibvorgänge auf den aktiven Workspace beschränkt. Der Agent kann deinen Code fixen, aber nicht anderswo Dateien ändern.
Im Modus workspace-write haben Kommandos standardmäßig keinen Netzwerkzugang. Das blockiert Downloads und verhindert, dass der Agent Code versendet.
Manche Aufgaben brauchen das Netz, z. B. Paketinstallation. Du kannst den Netzwerkzugang in der Config aktivieren:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
Aktiviere es nur für Projekte, die es benötigen.
Die Freigaberichtlinie entscheidet, wann der Agent stoppt und fragt:
untrusted: Fragt vor Befehlen, die nicht auf der Trusted-Liste stehen
on-request: Fragt, wenn eine Aufgabe mehr Zugriff braucht als die Sandbox erlaubt
never: Fragt nie
Für versionierte Projekte ist workspace-write mit on-request ein guter Standard. Der Agent arbeitet im Projekt und fragt, bevor er weitergeht. Mit Git kannst du jederzeit zurückrollen.
Das Flag --yolo schaltet sowohl Sandbox als auch Freigaben aus. Nutze es nur in Wegwerf-Umgebungen wie Containern oder VMs.
Vom Agent ausgeführte Kommandos erben deine Shell-Umgebung. Liegen API-Keys in Umgebungsvariablen, können Kommandos sie sehen.
Du kannst das mit shell_environment_policy begrenzen:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
core übergibt nur Basisvariablen wie HOME und PATH, exclude entfernt alles, was auf die Muster passt.
Dateien sind ein weiteres Risiko. Der Agent kann eine .env im Projekt auch in read-only lesen. Bei einem gehosteten Provider geht alles Gelesene auf dessen Server.
Merke: Die Sandbox begrenzt den Schaden, ist aber ein Sicherheitsnetz — keine Garantie.
Bevor du den Agenten allein laufen lässt, führe /status aus und prüfe Sandbox-Modus und Freigaberichtlinie.
Findest du einen Artikel zu Open Interpreter, der mit pip install startet, ist das nicht falsch — nur ein anderes Projekt.
Die ursprüngliche Version startete 2023 als Python-Projekt. Es ließ Sprachmodelle Python, JavaScript und Shell-Code auf deinem Rechner ausführen — bekannt als Open-Source-Alternative zu ChatGPT's Code Interpreter. Später kam Computersteuerung dazu, sodass das Modell auch deinen Desktop bedienen konnte.
Das aktuelle Hauptprojekt ist ein Rust-Rewrite auf Basis von Codex. Fokus: Coding-Agenten und Harness-Emulation, nicht allgemeine Computersteuerung.
Die Python-Version ist nicht verschwunden. Sie lebt als Community-Fork weiter unter endolith/open-interpreter.
Beide Versionen nutzen denselben Namen, dieselbe GitHub-Historie und denselben interpreter-Befehl — Verwechslungsgefahr ist hoch.
Ein klarer Hinweis ist jedoch:
pip install open-interpreter: Legacy-Python-Version
curl oder PowerShell Installer: Aktuelle Rust-Version
Open Interpreter passt nicht zu jedem Setup. Hier spielt es seine Stärken aus — und hier weniger.
Open Source: Apache 2.0 — du kannst den kompletten Code lesen, auditieren und forken
Modellwahl: Gehostete, Open-Weight- und lokale Modelle in einem Agent — Wechsel auch mitten in der Session
Mehrere Agent-Harnesses: Näher an der Performance, für die das Modell getunt wurde — das bieten nur wenige Agenten
Terminal-natives Arbeiten: Passt in Shell- und Git-Workflow, exec-Modus für Skripte und CI
Offene und günstigere Modelle: Das Projekt ist um sie herum gebaut — mit eigenen Provider-Guides und passenden Harnesses
Erweiterbarkeit: MCP, Skills, Hooks, AGENTS.md, Agent Client Protocol und Codex SDK Override für Integrationen
Modellqualität variiert: Der Agent ist nur so gut wie das Modell — kein Harness repariert fehlende Planungsfähigkeit
Lokale Modelle brauchen starke Hardware: In meinen Tests belegte devstral-small-2 allein 26 GB RAM — noch ohne großes Kontextfenster
Setup erfordert mehr Handarbeit: Du managst Provider, Kontextfenster, Harnesses und Sandbox. Es gibt Rauheiten wie übriggeblandete Codex-Branding-Hinweise und Metadaten-Warnungen bei Ollama-Modellen
Kommandoausführung birgt Risiko: Sandbox und Freigaben reduzieren, aber eliminieren es nicht
Code braucht weiterhin Review: Grüne Tests garantieren keinen korrekten Fix — lies jeden Diff
Open Interpreter ist ein Open-Source-Coding-Agent, der mit dem Modell deiner Wahl arbeitet — gehostet, Open-Weight oder lokal.
Der Workflow ist einfach: Du wählst Modell und Harness, richtest den Agenten auf ein Projekt und lässt ihn inspizieren, editieren und Kommandos ausführen, bis die Aufgabe erledigt ist. Danach prüfst du seine Arbeit.
Harness-Emulation ist der Unterschied zu vielen Wettbewerbern: Open Interpreter zwingt Modelle nicht in ein Setup, sondern passt das Setup ans Modell an — und das kann entscheidend sein. Die Modellwahl bestimmt die Arbeitsqualität, die Berechtigungen bestimmen, was der Agent ändern darf. Dein Review ist der letzte Check, bevor Änderungen in deine Codebasis gelangen.
Wenn du eine KI-Engineer-Zertifizierung machen willst, melde dich zu unserem Associate AI Engineer for Developers Lernpfad an und steige in deinem Tempo in die KI-Welt ein.
Lerne mit DataCamp
Lernpfad
Lernpfad
Lernpfad
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Moez Ali
6 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Mark Pedigo
10 Min.


