Traseu de învățare
Inginer AI asociat pentru dezvoltatori
26 ore
Dacă ai rulat vreodată un model open-weight într-un agent de programare construit pentru alt model, știi că nu e cea mai bună idee.
Modelul, de obicei, citește greșit schemele uneltelor și rulează același comandă eșuată până când îl oprești. După ce revii la modelul pentru care a fost construit agentul, aceeași sarcină trece fără probleme. De regulă, problema nu e în model, ci în harness-ul agentului din jurul lui, pentru că prompturile și formatele de tool-uri au fost ajustate pentru altcineva.
Open Interpreter rezolvă asta prin emularea harness-ului pentru care a fost ajustat fiecare model, cum ar fi Claude Code sau Kimi Code. Este un agent de programare AI open-source care rulează din terminalul tău, iar versiunea actuală este un proiect Rust construit pe OpenAI Codex, nu asistentul de computer bazat pe Python pe care s-ar putea să ți-l amintești.
În acest articol, te ghidez prin instalare, configurarea modelului și a harness-ului, un flux de lucru practic de codare și cum se compară Open Interpreter cu Claude Code, OpenCode și Codex.
Ești nou în agenții AI? Înscrie-te la cursul nostru Introducere în agenții AI și învață elementele de bază într-o după-amiază.
Open Interpreter oferă unui model AI acces la proiectul tău și la uneltele pe care le-ar folosi un dezvoltator în el.
Trebuie doar să descrii o sarcină în engleză simplă, iar agentul lucrează pe codul tău. Poate lucra cu:
Proiectul este open source sub licența Apache 2.0. Nu este nici limitat la un singur furnizor de modele. Îl poți conecta la modele găzduite, modele open-weight sau modele care rulează local pe propria ta mașină.
Repository-ul principal are peste 68.000 de stele pe GitHub în septembrie 2026.
Open Interpreter funcționează într-o buclă:
Unele dintre aceste etape îți cer aprobare în prealabil, în funcție de setările de permisiuni. Le acopăr în secțiunea de securitate.
Iată o prezentare mai vizuală:
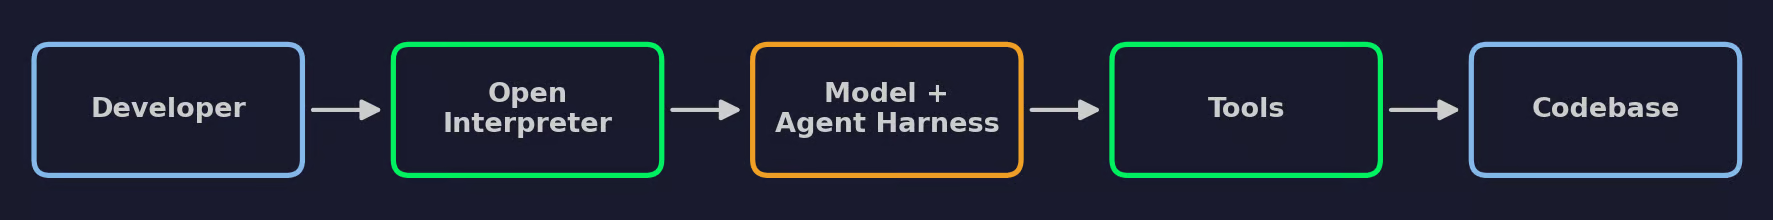
Cum funcționează Open Interpreter
Important de ținut minte: nu vorbești direct cu modelul. Open Interpreter trimite sarcina ta către model, formatată cu prompturile și definițiile de unelte ale harness-ului activ. Modelul cere apeluri de tool-uri, iar Open Interpreter le rulează pe baza codului tău. Apoi rezultatele se întorc la model pentru pasul următor.
Deoarece modelul și harness-ul sunt straturi separate, poți schimba oricare dintre ele fără să atingi restul configurării.
Open Interpreter se instalează ca un binar standalone, deci nu ai nevoie de Python sau pip.
Dacă un articol vechi de blog îți spune să rulezi pip install open-interpreter, descrie versiunea Python veche. Acea comandă nu îți va oferi agentul de programare bazat pe Rust pe care îl acopăr în acest articol.
Îți va trebui și Git pe mașina ta. Open Interpreter rulează și fără el, dar Git îi oferă o sesiune conștientă de repository și diffs.
Rulează scriptul de instalare din terminal:
curl -fsSL https://www.openinterpreter.com/install | shScriptul descarcă versiunea potrivită pentru platforma ta și plasează comanda interpreter în ~/.local/bin.
Deschide PowerShell și rulează:
irm https://www.openinterpreter.com/install.ps1 | iexWSL este de asemenea suportat dacă preferi o configurare în stil Linux. În acest caz, rulează comanda pentru macOS și Linux în terminalul tău WSL.
Repornește terminalul ca să preia noul PATH, apoi verifică versiunea:
interpreter --versionDacă vezi un număr de versiune, instalarea a reușit.
Verificarea versiunii Open Interpreter
Pornește o sesiune din orice director:
interpreterPoți scrie și i, care este un alias scurt pentru aceeași comandă.
Open Interpreter deschide o interfață de terminal unde descrii sarcini în engleză simplă. Prima dată când îl pornești, îți cere să conectezi un furnizor de modele. În secțiunea următoare voi folosi un model local prin Ollama, deci poți sări peste acest pas deocamdată.
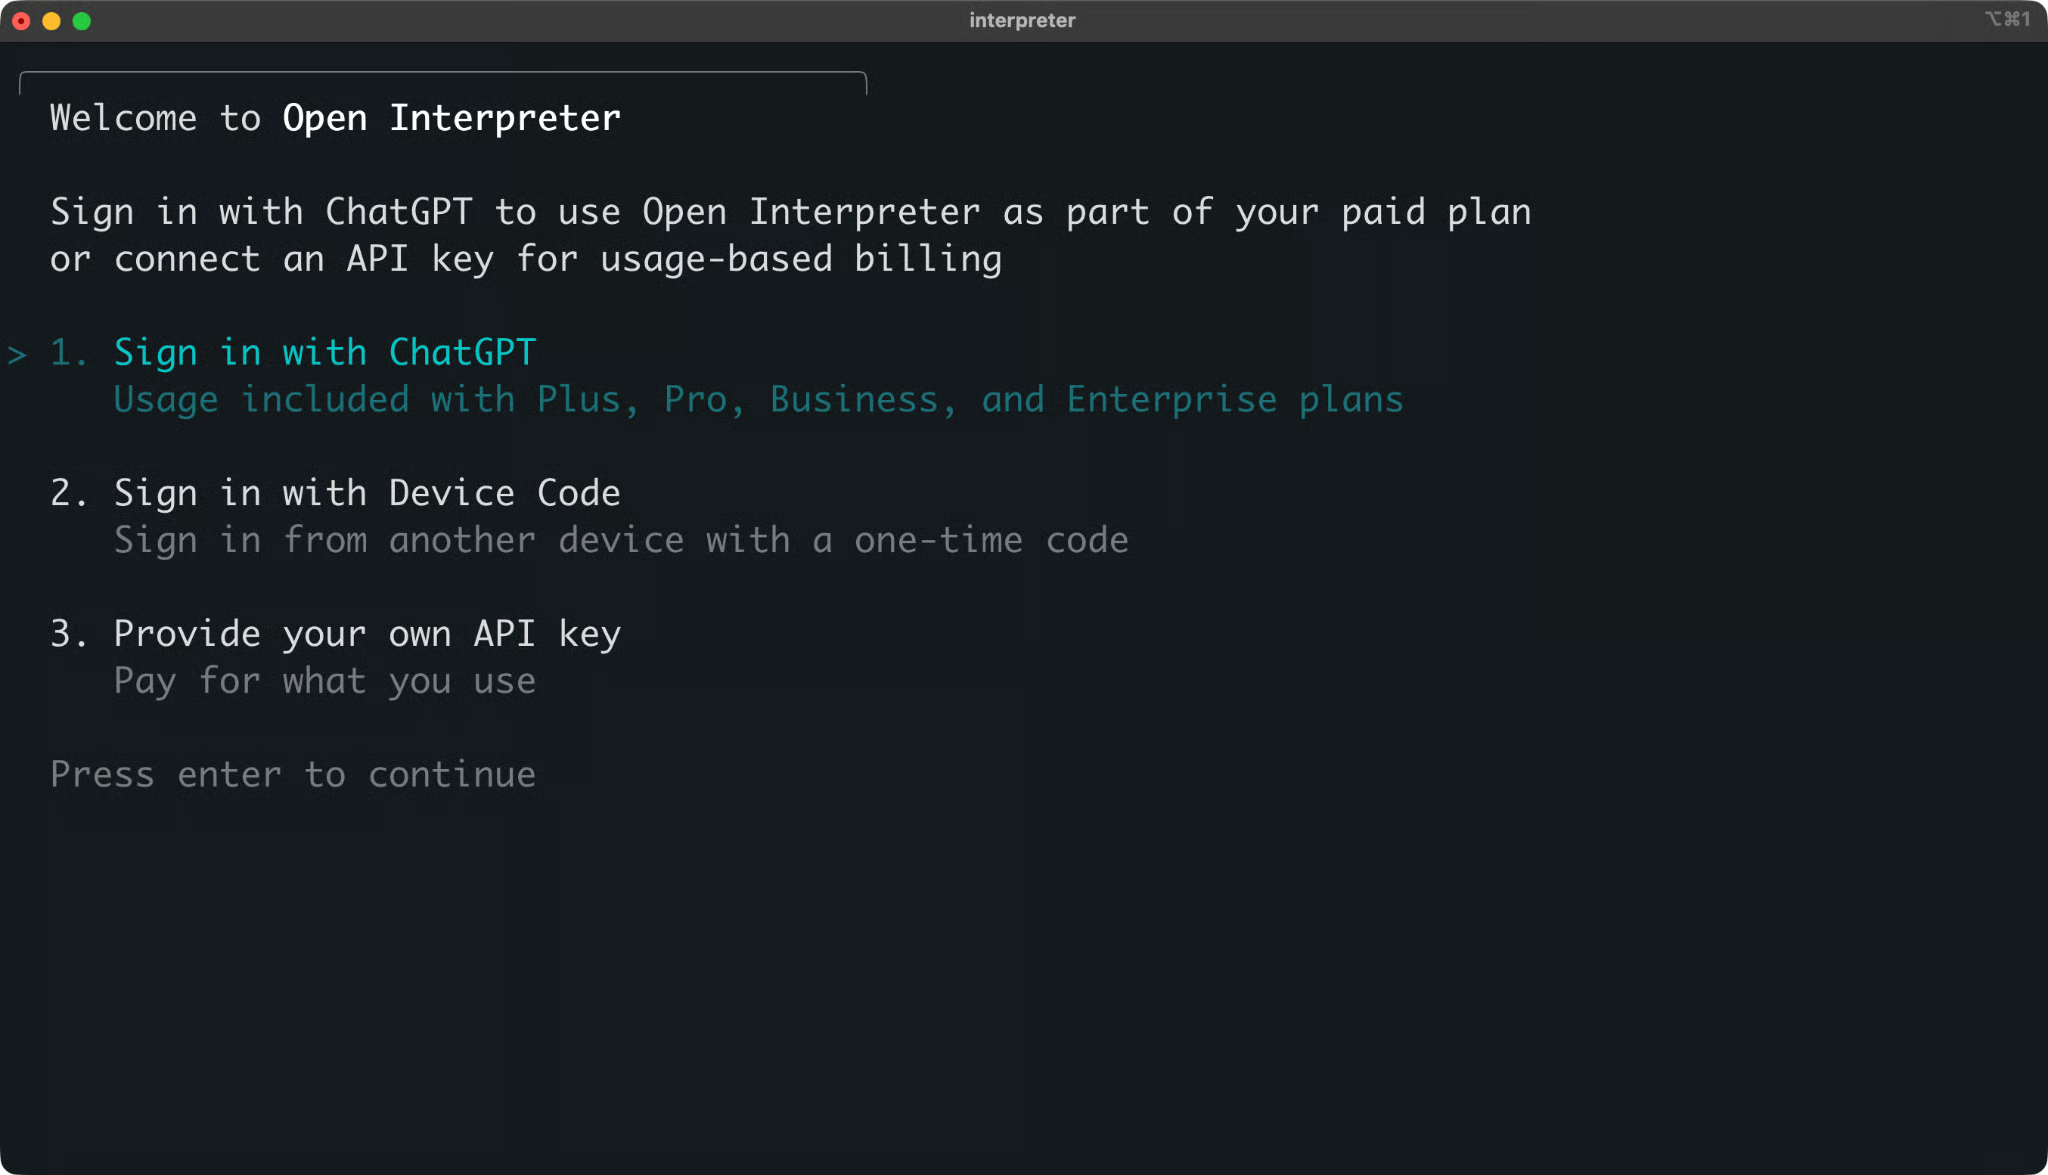
Sesiune interactivă Open Interpreter
Pentru a ieși din sesiune, tastează /exit.
Cel mai rapid mod de a înțelege un agent de programare este să-i dai o sarcină și să vezi ce face cu ea.
Voi folosi un mic proiect de habit tracker pentru toată această secțiune. Are o singură funcție, un singur fișier de test și un singur bug.
Proiectul calculează cea mai lungă serie de zile consecutive pentru un obicei. De exemplu, numără câte zile la rând ai făcut mișcare.
Începe cu un folder de proiect și un mediu virtual:
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
Creează habits.py cu următorul cod:
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
Apoi creează test_habits.py:
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
Funcția are un bug. Nu îl voi indica, pentru că găsirea lui este treaba agentului.
Adaugă un fișier .gitignore astfel încât mediul virtual și fișierele de cache să rămână în afara repository-ului:
.venv/
__pycache__/
.pytest_cache/
Acum fă commit proiectului:
git init
git add .
git commit -m "Initial commit"
Acest commit îți oferă un punct de plecare curat. Mai târziu îl vei folosi ca să vezi exact ce a schimbat agentul.
Rulează testele pentru a confirma bug-ul:
python -m pytest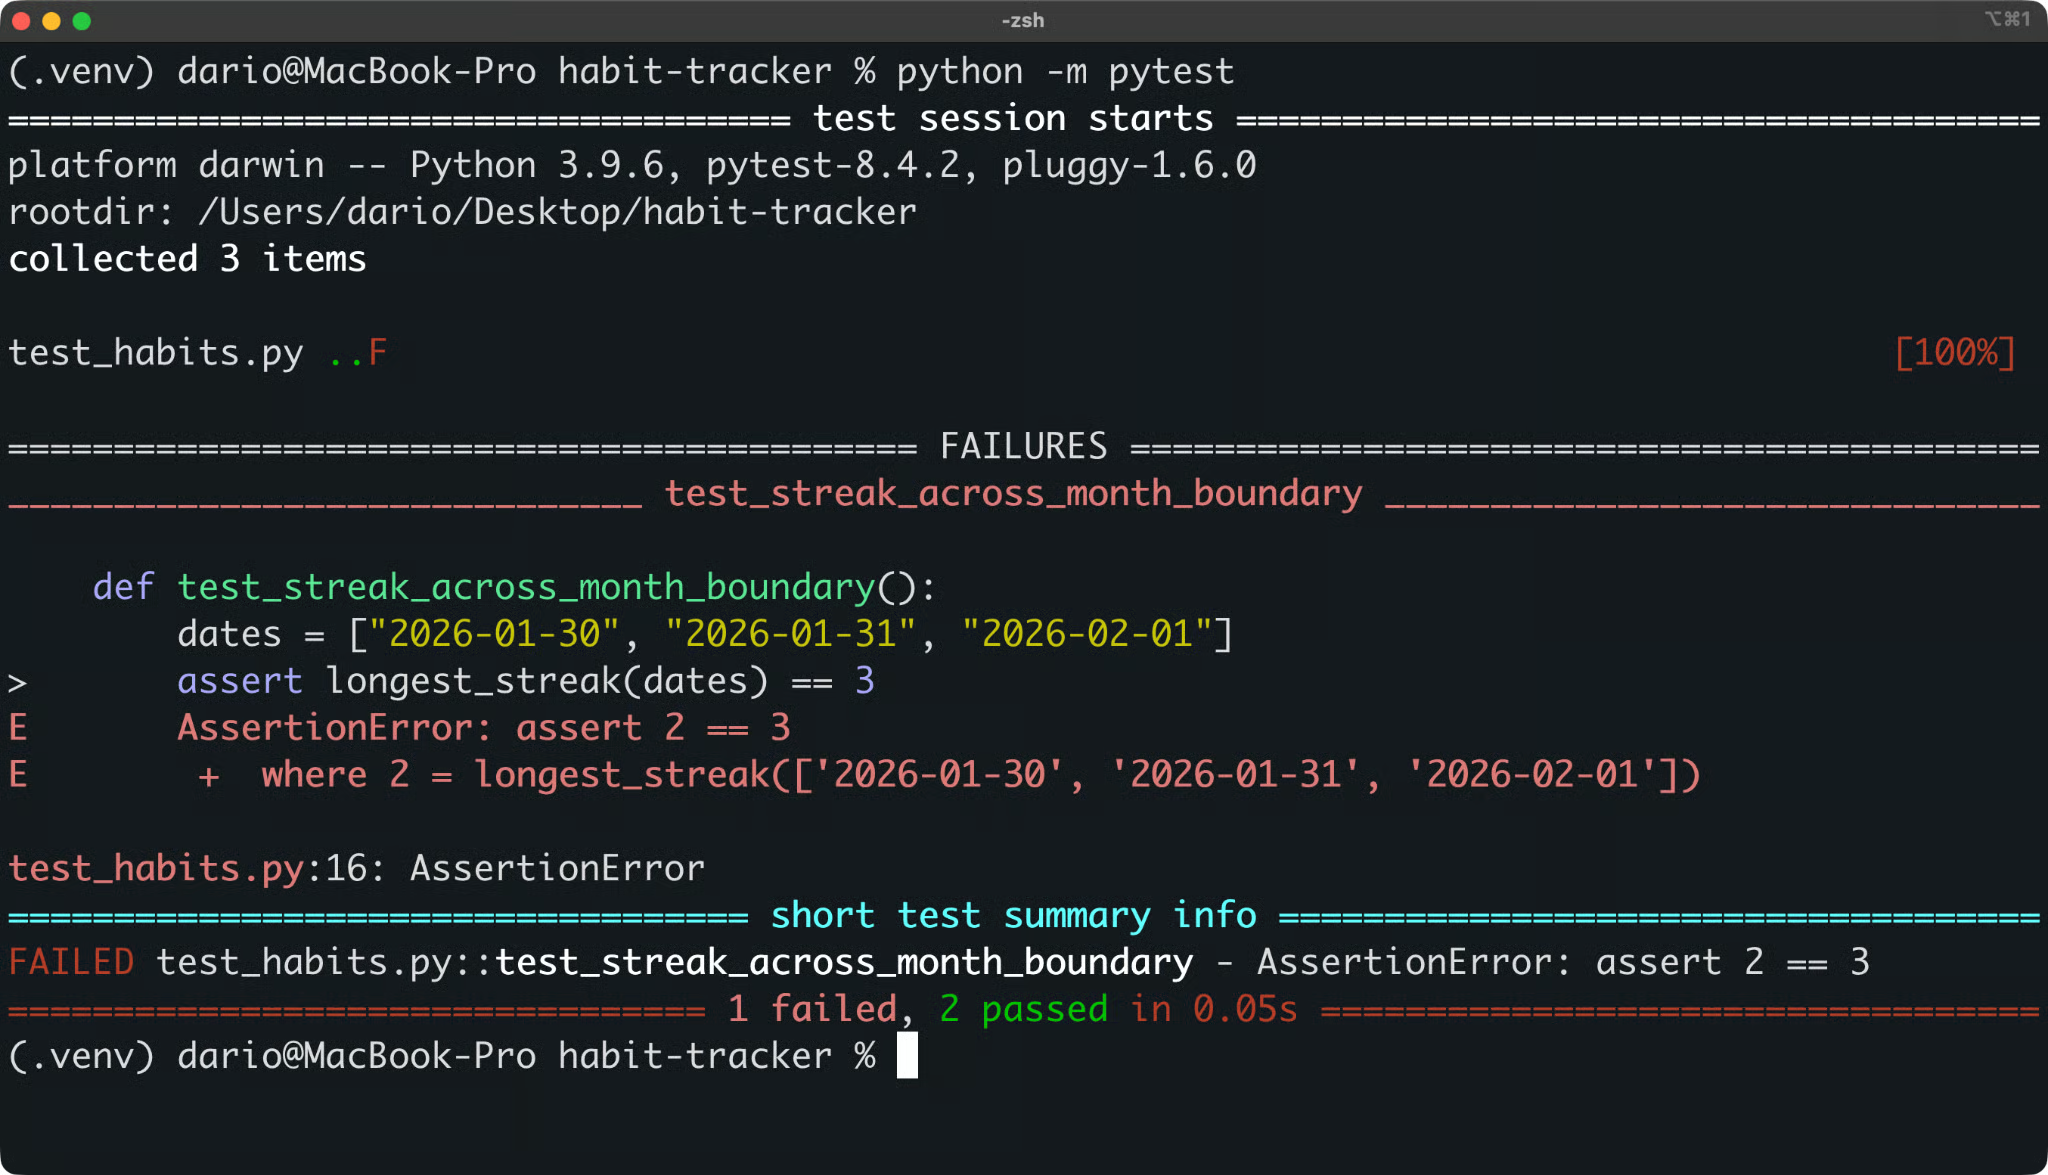
Rezultatul testelor pentru habit tracker
Două teste trec și unul eșuează. Asta este problema pe care Open Interpreter trebuie s-o rezolve.
Vei avea nevoie de Ollama instalat și în execuție. Îți va trebui și un model care suportă tool calling, așa că descarcă-l:
ollama pull qwen3-coder:30bApoi pornește Open Interpreter din folderul proiectului. Folosește același terminal, ca agentul să poată folosi instalarea pytest din mediul tău virtual:
interpreter --oss --local-provider ollama -m qwen3-coder:30bCe face fiecare flag:
--oss: Folosește un furnizor local open source
--local-provider ollama: Alege Ollama în loc de LM Studio
-m qwen3-coder:30b: Setează modelul pentru această rulare
Rulează /status pentru a confirma furnizorul activ, modelul, modul sandbox și politica de aprobare.
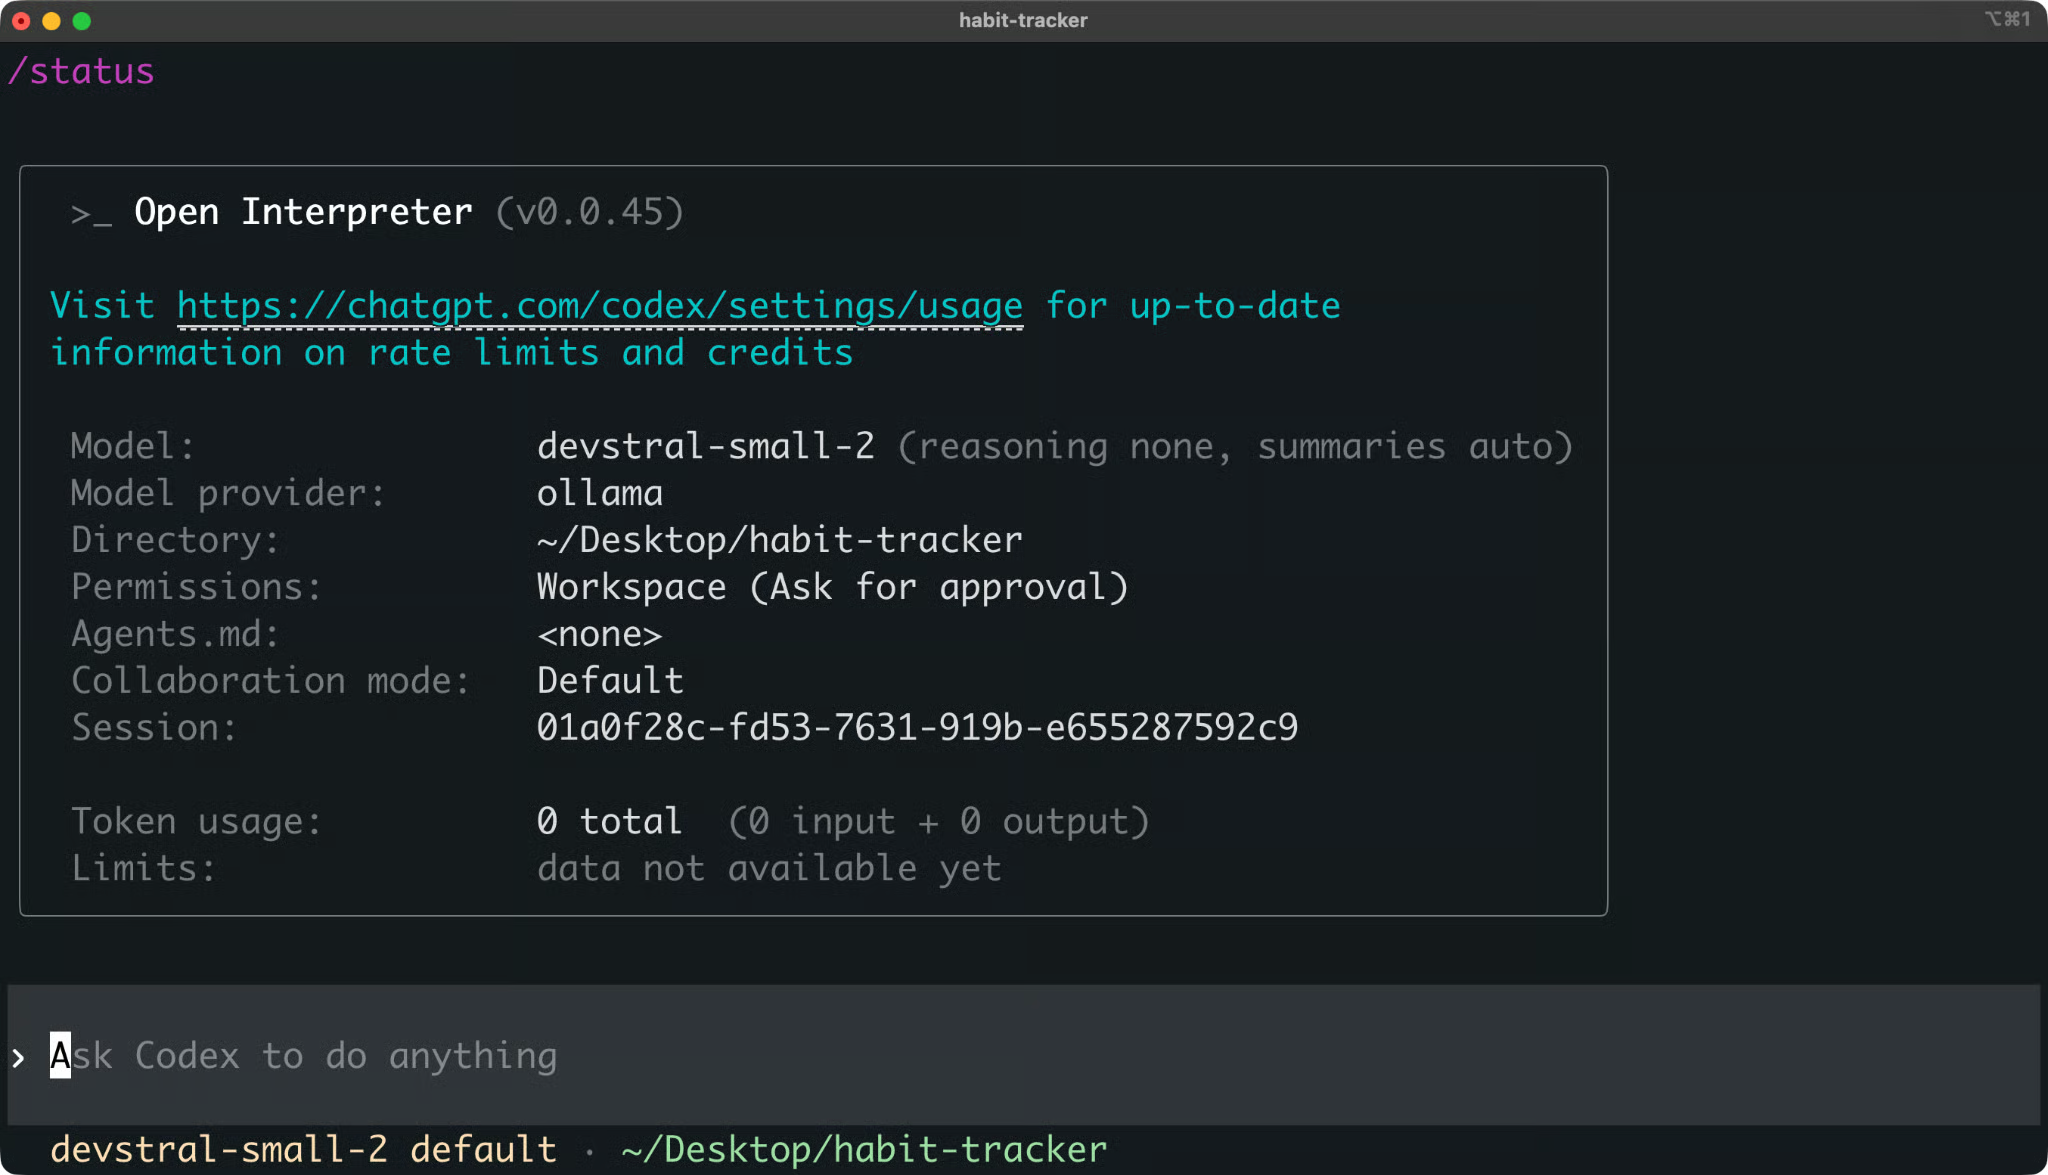
Sesiune Open Interpreter cu un model Ollama local
Nu vrei ca agentul să editeze nimic încă. Cere mai întâi un diagnostic:
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.De obicei, agentul va citi fișierele și va rula testele înainte să răspundă. Comenzile rulează în sandbox, iar dacă agentul are nevoie de mai mult acces decât permite sandbox-ul, îți cere mai întâi aprobarea.
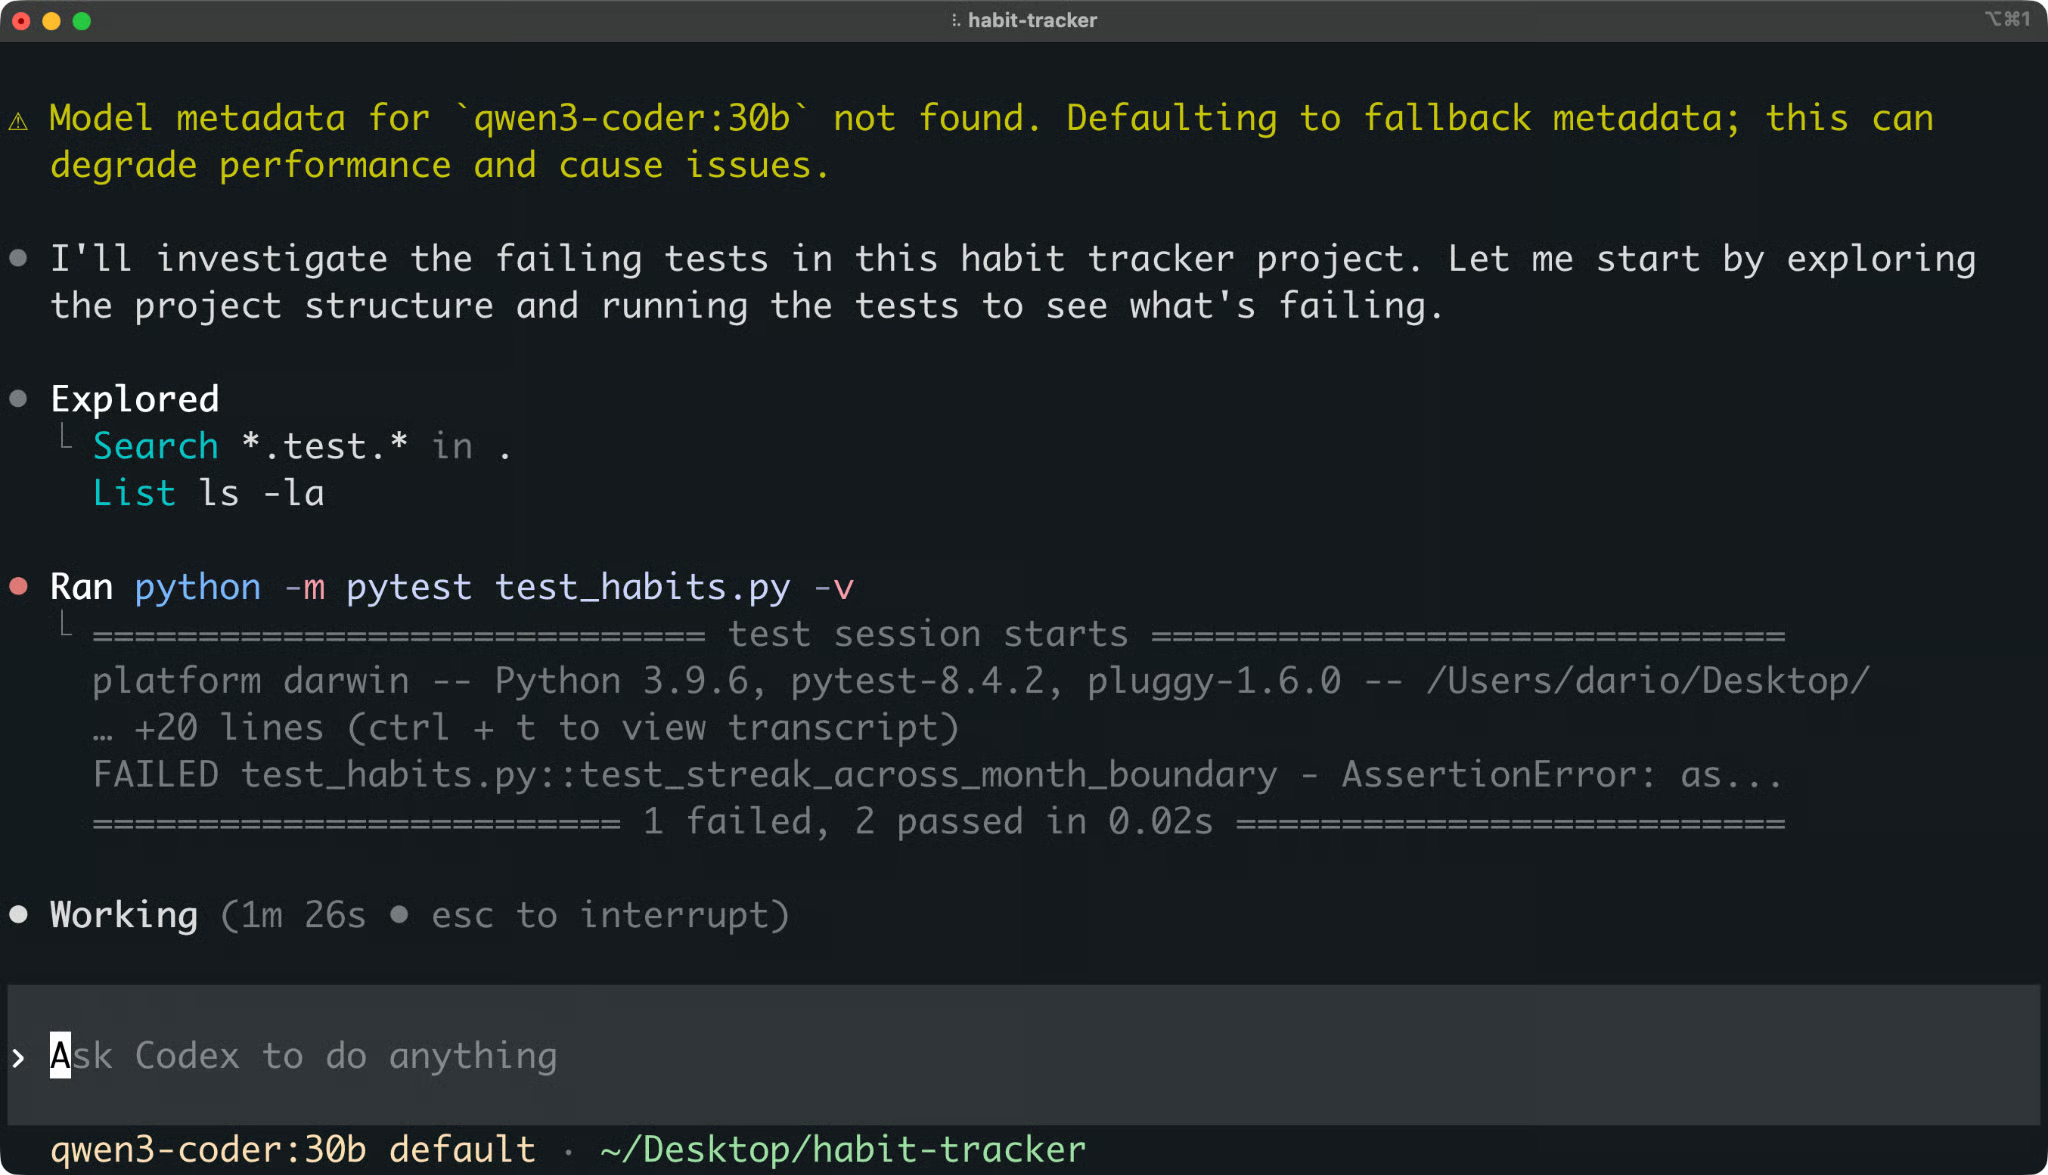
Output Open Interpreter
Citește explicația înainte să aprobi orice.
Un diagnostic corect spune că funcția compară doar ziua din lună, astfel încât o serie se întrerupe când trece într-o lună nouă. Un fix bun compară date complete, de exemplu cu date.fromisoformat() din modulul datetime al Python.
Dacă diagnosticul este greșit, corectează-l în aceeași sesiune înainte ca agentul să editeze orice cod.
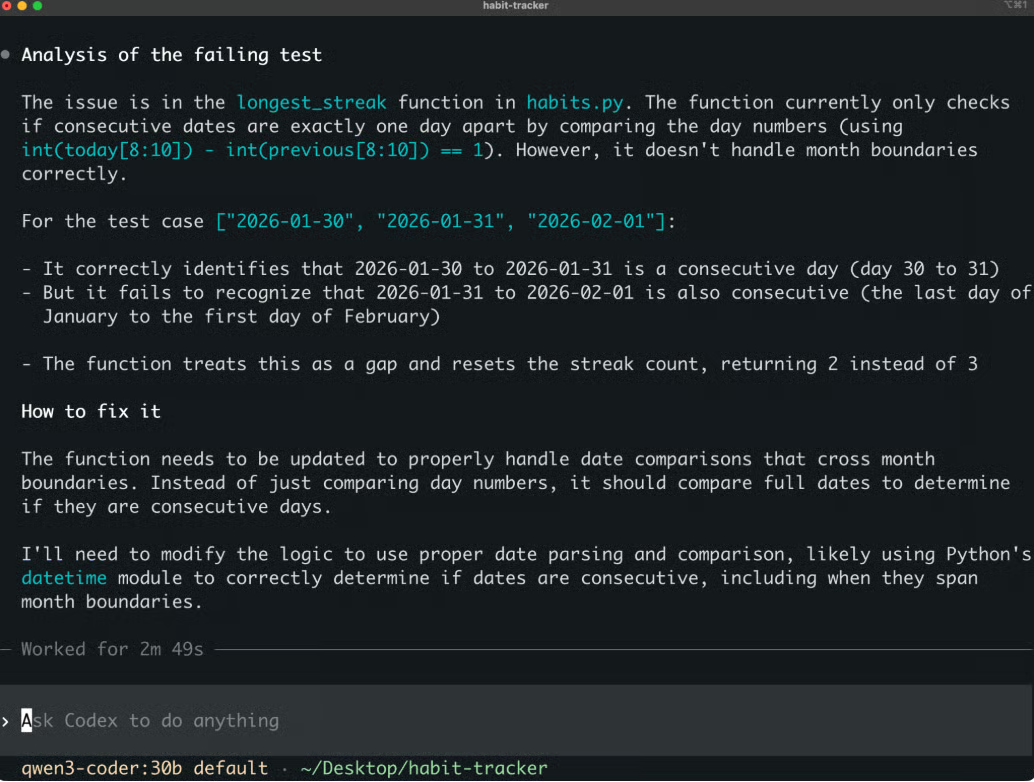
Propunere de fix Open Interpreter
După ce ești mulțumit de plan, implementează fixul:
Apply the fix to habits.py, then run the tests.Agentul editează fișierul și rulează din nou pytest. Vrei să vezi toate cele trei teste trecând.
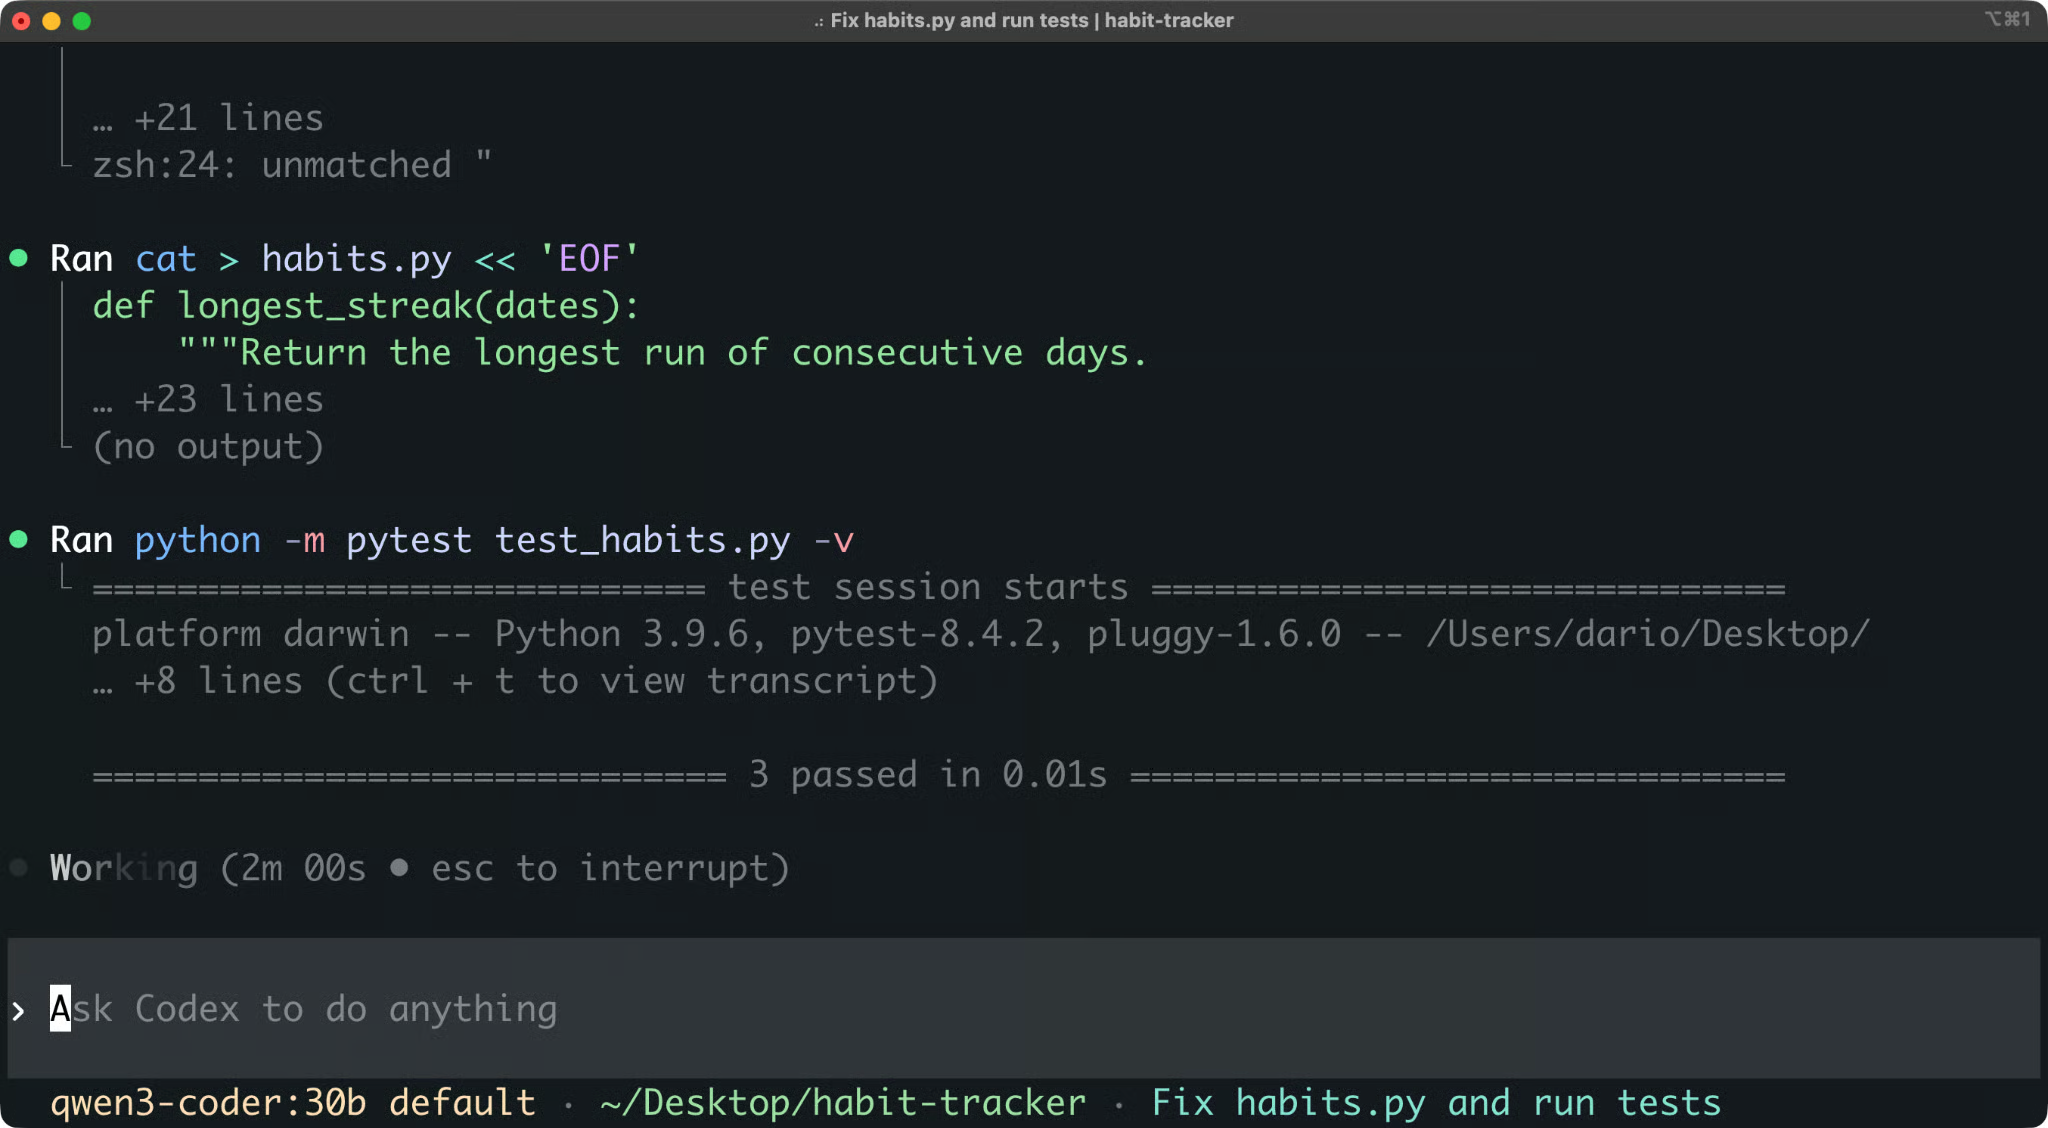
Toate testele trec după fix
Faptul că testele trec nu înseamnă neapărat că bug-ul din codul tău e rezolvat. Poate testul a fost actualizat ca să ocolească bug-ul. Tot trebuie să revizuiești codul.
Rulează /diff în sesiune pentru a vedea modificările din working tree. Poți rula și git diff după ce ieși.
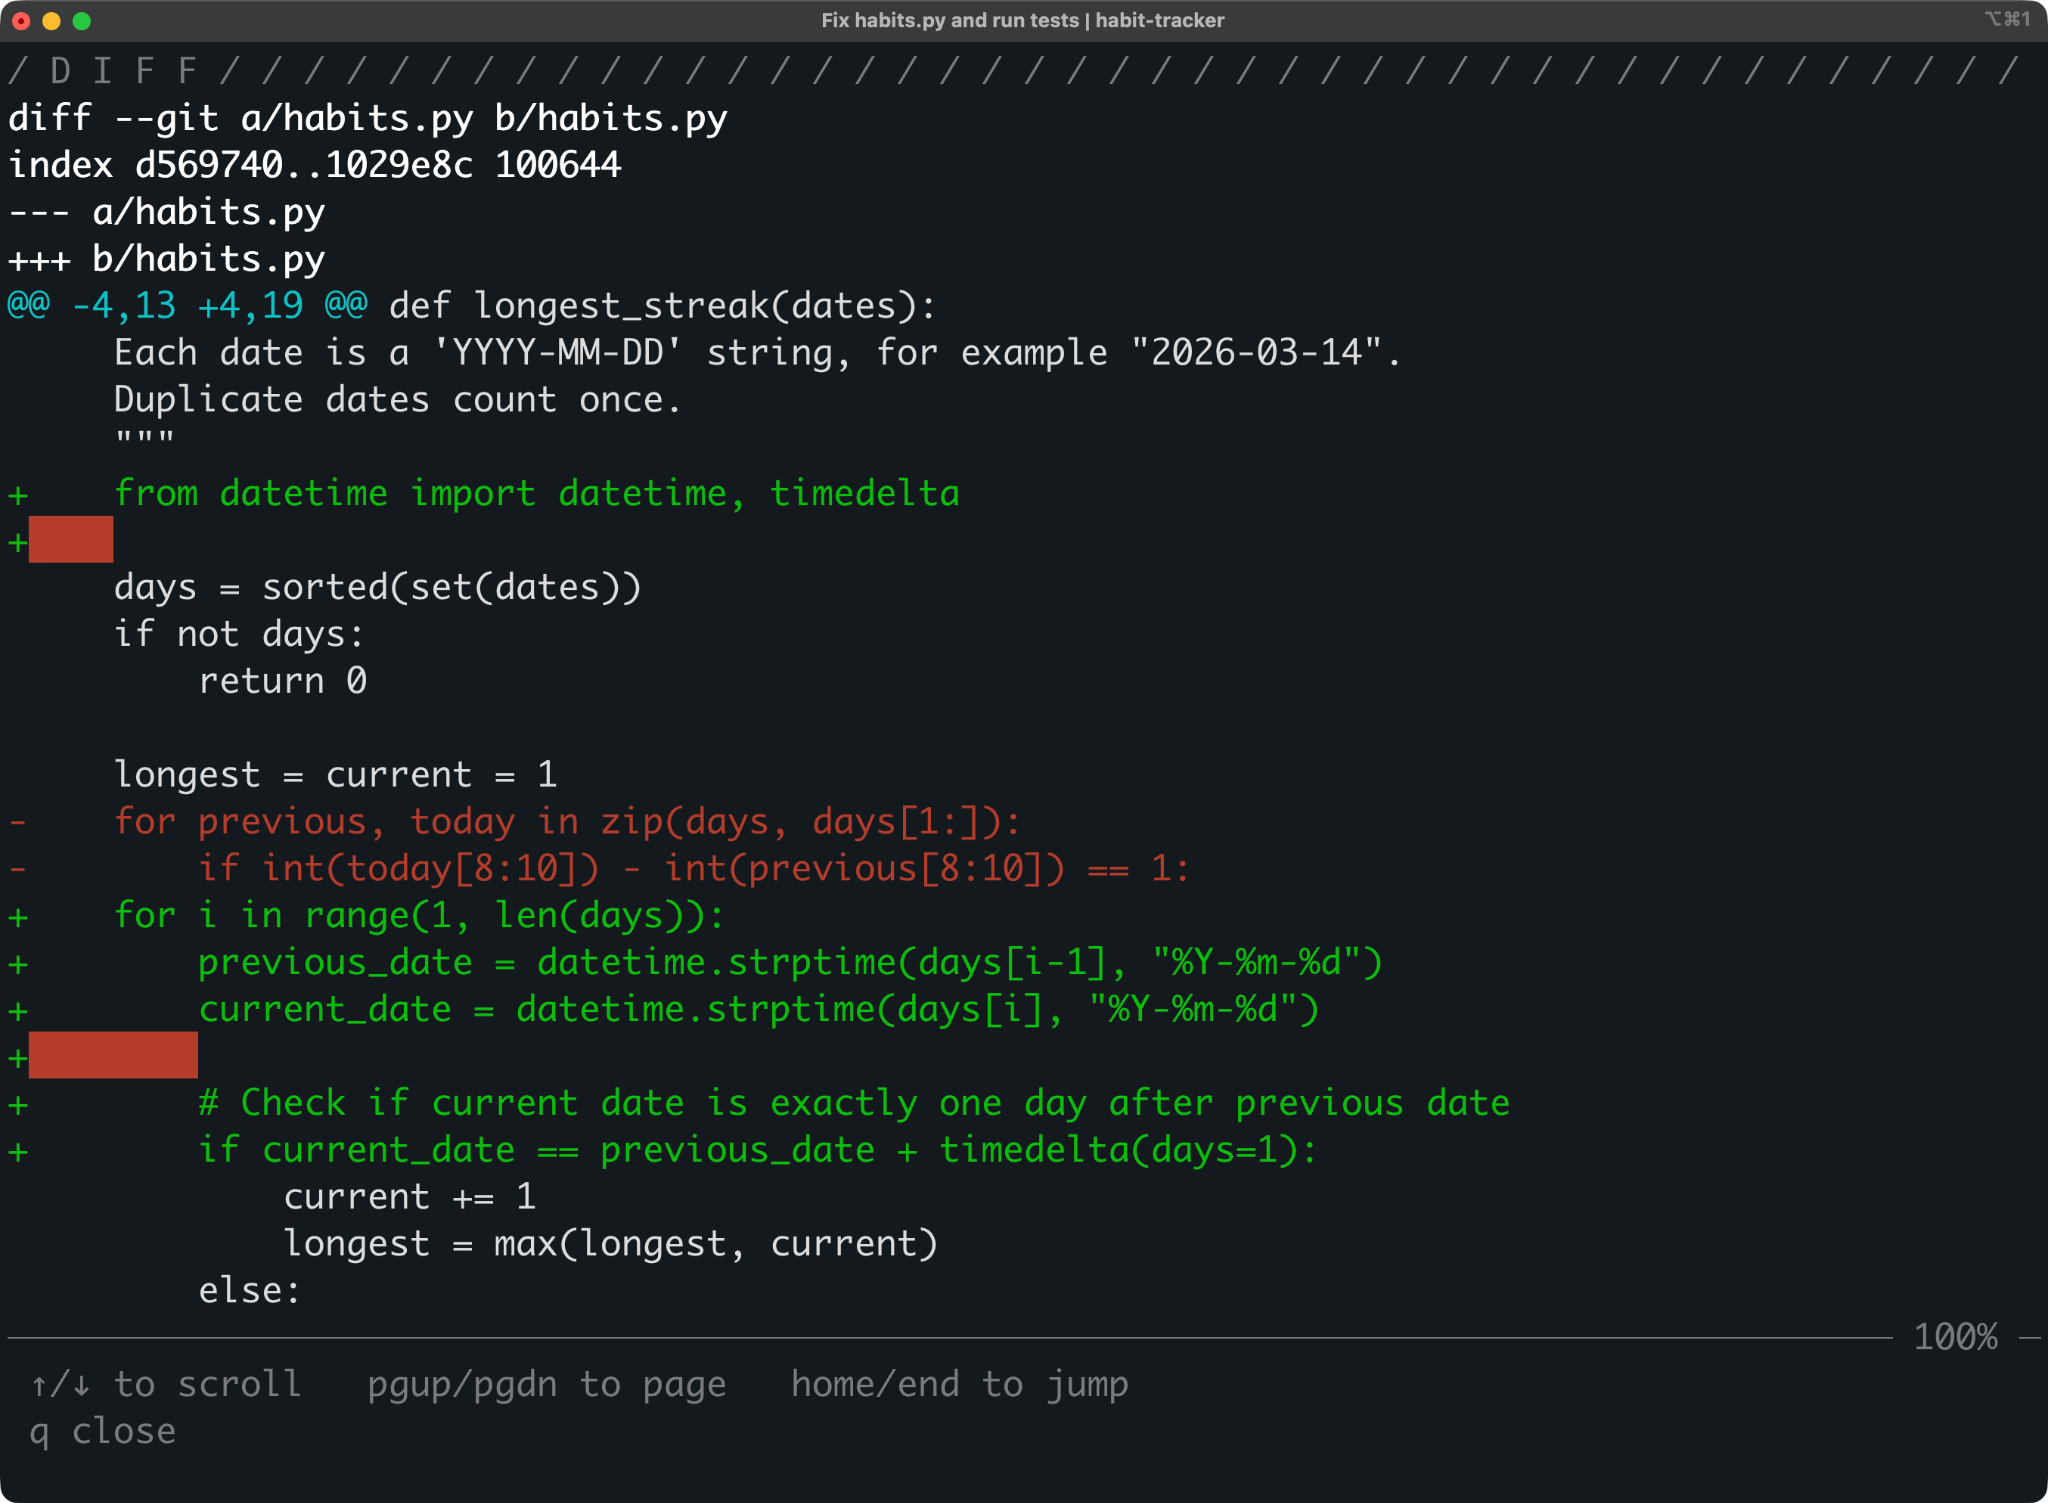
Diff-ul modificărilor făcute de Open Interpreter
Diff-ul exact depinde de model, deci al tău s-ar putea să nu se potrivească linie cu linie cu cel de mai sus. Dacă îți place schimbarea, fă commit, iar dacă nu, restaurează fișierul original:
git restore habits.pyȘi asta e ideea. Tu descrii problema, agentul o investighează și o repară, iar tu revizuiești fiecare schimbare înainte să devină parte din codul tău.
Open Interpreter cere să aduci propriul tău model.
Fiecare cerere trece prin aceste trei straturi:
| Strat | Exemplu | Ce controlează |
|---|---|---|
| Provider | ollama | Unde merg cererile și cum te autentifici |
| Model | devstral-small-2 | Modelul care face munca |
| Harness | native | Prompturile, uneltele și formatul mesajelor din jurul modelului |
Straturi ale cererii
Iată ce poți conecta:
Lista de provideri este generată dintr-un catalog public de modele și păstrează doar modelele care suportă tool calling. Dacă lipsește un model la care te aștepți, de obicei acesta este motivul.
Ai grijă la ollama-cloud. Este un furnizor găzduit separat, deci cererile tale părăsesc mașina. Doar furnizorul integrat ollama rulează modele local.
Poți schimba modelul la trei niveluri:
Într-o sesiune: Rulează /model pentru a alege providerul, modelul și efortul de reasoning
Pentru o singură rulare: Pasează flag-ul -m, ca în secțiunea anterioară
Ca implicit: Setează-l în fișierul tău de configurare
Poți rula /status oricând pentru a vedea ce provider și model sunt active.
Open Interpreter citește setările din ~/.openinterpreter/config.toml. Pentru a face implicită configurarea Ollama din secțiunea anterioară, adaugă aceste două linii:
model_provider = "ollama"
model = "qwen3-coder:30b"
După asta, interpreter pornește cu acest model și nu mai ai nevoie de flag-uri.
Providerii găzduiți citesc cheile API din variabile de mediu. De exemplu, DeepSeek se așteaptă la DEEPSEEK_API_KEY:
export DEEPSEEK_API_KEY="your-api-key"Poți adăuga și orice endpoint compatibil OpenAI ca provider personalizat:
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
Setarea wire_api îi spune lui Open Interpreter ce format de cerere așteaptă endpoint-ul. Folosește chat pentru Chat Completions compatibil cu OpenAI, responses pentru OpenAI Responses API și messages pentru endpoint-uri în stil Anthropic.
Un proiect de încredere poate avea și propriul .openinterpreter/config.toml, care suprascrie configurarea utilizatorului. Flag-urile din linia de comandă le suprascriu pe ambele. Dacă nu ești sigur ce valoare are prioritate, rulează /debug-config pentru a vedea setările efective și sursa lor.
Modelul decide cât de bine înțelege agentul codul tău. Harness-ul decide cum vede modelul sarcina și uneltele.
Ai nevoie de ambele. Un model bun într-un harness nepotrivit trimite apeluri de tool-uri greșit formate și citește eronat rezultatele. Iar un harness bun nu poate compensa un model care nu înțelege codul.
De aceea Open Interpreter alege un harness când alegi un model. De exemplu:
Modelele Claude primesc harness-ul claude-code
Modelele Kimi primesc kimi-code
Modelele Qwen primesc qwen-code
Modelele DeepSeek primesc claude-code-bare
Pentru alte familii de modele, poți alege singur harness-ul cu /harness.
Merită reținut că un rezultat slab nu înseamnă mereu un model slab. Înainte să schimbi modelul, încearcă același model cu un alt harness, pe care îl voi detalia în secțiunea următoare.
Emularea harness-ului este motivul principal pentru care există versiunea actuală a Open Interpreter.
Un harness de agent este tot ce e în jurul modelului și îl transformă într-un agent. Include:
Pe scurt, harness-ul decide cum vede modelul sarcina și cum se transformă deciziile lui în acțiuni.
Open Interpreter are un set de moduri de harness integrate. Acestea sunt cele pe care le vei folosi cel mai des:
native: Harness-ul propriu al Open Interpreter, moștenit de la Codex
claude-code: Emulează prompturile și suprafața de unelte a Claude Code de la Anthropic
kimi-code: O reimplementare în Rust a harness-ului Kimi Code pe care Moonshot îl recomandă pentru modelele Kimi
qwen-code: Emulează Qwen Code CLI de la Alibaba pentru modelele Qwen
swe-agent: Emulează SWE-agent, un agent de cercetare construit pentru a rezolva issues pe GitHub
Lista completă are și variante precum claude-code-bare, kimi-cli, deepseek-tui, zcode și minimal. Rulează /harness într-o sesiune ca să vezi ce suportă versiunea ta.
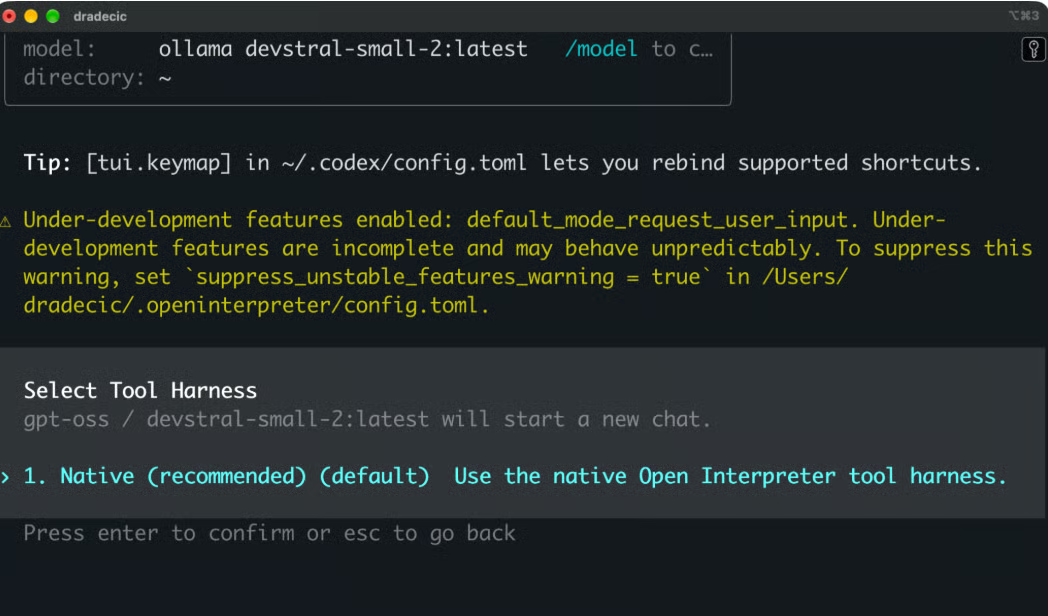
Poți comuta harness-urile în timpul sesiunii cu /harness sau seta un implicit în ~/.openinterpreter/config.toml:
harness = "kimi-code"
harness_guidance = true
Setarea harness_guidance adaugă un ghidaj de fiabilitate acolo unde harness-ul îl permite. Pune-o pe false dacă vrei o emulare mai strictă. Dacă lași harness nedefinit, Open Interpreter alege unul în funcție de familia modelului, cum ai văzut în secțiunea anterioară.
Majoritatea vânzătorilor își ajustează modelele de programare într-o anumită configurație de agent și publică un harness recomandat pentru ele.
Modelul se obișnuiește cu acel harness. Învață stilul promptului, numele uneltelor, formatul editărilor de fișiere și modul în care revin rezultatele uneltelor.
Să zicem că rulezi un model ajustat pentru editări de tip căutare-și-înlocuire într-un harness care așteaptă fișiere patch complete. Modelul știe ce schimbare să facă, dar continuă să o descrie în formatul greșit. Bucla agentului consumă tokeni fără progres.
La fel e și cu rezultatele uneltelor. Dacă harness-ul returnează rezultate într-un format pe care modelul nu l-a văzut, modelul le citește greșit. Dacă harness-ul șterge raționamentul modelului între ture, un model care gândește își pierde firul propriului plan.
Asta înseamnă că același model poate arăta bine într-un agent și prost în altul, fără nicio schimbare a greutăților. Este și motivul pentru care rezultatele benchmark-urilor de programare numesc de obicei harness-ul folosit pentru fiecare rulare.
Modelele de vârf tind să se redreseze dintr-un harness nefamiliar, dar modelele mai mici și mai ieftine, de obicei, nu. Open Interpreter nu forțează fiecare model într-un singur format, ci schimbă formatul pentru a se potrivi modelului.
Poți testa asta singur cu proiectul demo. Restaurează fișierul original cu git restore habits.py, schimbă harness-ul cu /harness și dă agentului același prompt din nou. Apoi compară câți pași face și cum își formatează editările.
Ai văzut deja majoritatea acestor funcții în articol. Iată ce îți oferă fiecare în dezvoltarea de zi cu zi.
Open Interpreter lucrează în interiorul repository-ului tău Git. Citește structura proiectului și urmărește ce a schimbat.
Două comenzi cu slash ajută aici. /diff arată modificările din working tree, iar /review cere agentului să verifice modificările curente pentru bug-uri și regresii înainte de a face commit. Poți rula aceeași revizuire fără a deschide o sesiune:
interpreter exec review --uncommittedȘi sesiunile sunt salvate. Dacă te oprești la mijlocul unei sarcini, interpreter resume --last o reia de unde ai rămas.
Agentul rulează aceleași comenzi pe care le-ai rula și tu, de exemplu suite de teste, lintere, scripturi de build și package manageri. Toate rulează în sandboxing nativ pe macOS, Linux și Windows.
Comenzile de lungă durată pot rula în fundal. Folosește /ps pentru a le lista și /stop pentru a le opri.
Pentru scripturi și pipeline-uri CI, interpreter exec rulează o sarcină fără UI-ul interactiv:
interpreter exec "fix the failing test"Poți schimba provideri și modele oricând cu /model. Configurația ta, AGENTS.md și skill-urile se aplică în continuare după schimbare.
Profilele sunt utile aici. Să zicem că vrei un model ieftin pentru munca de rutină și unul mai puternic pentru code reviews. Le poți defini pe ambele în configurare:
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
Apoi pornești cu interpreter --profile review atunci când ai nevoie.
/harness schimbă modul în care modelul vede sarcina fără a schimba modelul. Este primul lucru de încercat când un model are dificultăți cu apelurile de unelte, înainte să treci la un model mai mare.
Model Context Protocol (MCP) conectează agentul la unelte pentru care nu a fost proiectat inițial, cum ar fi servere de documentație sau baze de date. Adaugi servere în configurare:
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
Rulează /mcp pentru a vedea serverele configurate și uneltele lor. Setarea default_tools_approval_mode face ca agentul să întrebe înainte să folosească o unealtă de la acel server.
Funcționează și invers. interpreter mcp-server expune Open Interpreter ca server MCP, iar interpreter acp îl rulează în editori care suportă Agent Client Protocol, un standard deschis pentru conectarea editorilor la agenți de programare.
AGENTS.md este un fișier Markdown în repository-ul tău cu reguli de proiect pe care agentul le citește la fiecare sarcină. Pentru habit tracker, ar putea arăta așa:
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
Poți rula și /init, iar agentul îți scrie o primă versiune.
Skill-urile sunt fluxuri de lucru reutilizabile, împachetate ca foldere în .agents/skills din proiectul tău sau în ~/.agents/skills pentru utilizatorul tău. Agentul preia automat un skill când o sarcină se potrivește cu el. Rulează /skills pentru a vedea care sunt disponibile.
Ambele sunt formate partajate, deci aceleași fișiere funcționează și cu alți agenți de programare care le suportă. Open Interpreter suportă și hooks, care îți rulează propriile comenzi în puncte stabilite ale unei sesiuni. Le revizuiești și le acorzi încredere cu /hooks.
Două setări controlează ce poate face agentul:
Modul sandbox: read-only, workspace-write sau danger-full-access
Politica de aprobare: untrusted, on-request sau never
Sandbox-ul decide ce e posibil, iar politica de aprobare decide când agentul întreabă înainte. Cu workspace-write și on-request, agentul poate edita proiectul tău și rula teste, dar te întreabă înainte când are nevoie de acces dincolo de atât.
Poți schimba ambele cu /permissions sau cu flag-urile -s și -a. Există și un flag --yolo care ocolește ambele, iar documentația îl marchează drept periculos. Voi acoperi aceste setări mai în detaliu în secțiunea de securitate.
Open Interpreter se descrie ca un agent de programare construit pentru modele cu cost redus.
Cei mai mari agenți proprietari de programare sunt construiți în jurul propriilor modele ale vânzătorului. Open Interpreter îți oferă un singur agent care funcționează cu modele proprietare, modele open-weight găzduite și modele locale.
Modelele open-weight precum Kimi, DeepSeek, GLM și Qwen au greutăți publice. Le poți folosi printr-un furnizor terț sau pe propriul tău hardware.
Asta îți oferă două avantaje. Modelele open-weight găzduite costă de obicei mai puțin pe token decât modelele proprietare de vârf. Și nu ești limitat la o singură gazdă, pentru că același model rulează oriunde îi rulează greutățile.
Open Interpreter are ghiduri dedicate de provider pentru Kimi K3, DeepSeek și GLM. Alege și harness-ul potrivit pentru aceste familii de modele.
Ollama și LM Studio sunt provideri integrați, astfel încât poți rula un model pe propria mașină fără cheie API sau costuri per token.
Costul este hardware-ul. Când am testat devstral-small-2 pe MacBook Pro M1 Max cu 64GB memorie unificată, modelul singur a ocupat 26 GB din ea. Fereastra de context implicită a Ollama a fost prea mică pentru bucla agentului, iar la 128k tokeni, utilizarea memoriei continua să crească și să scadă până când sesiunea s-a blocat.
Agenții de programare au nevoie de o fereastră de context mare, pentru că system prompt-ul, definițiile de unelte, conținutul fișierelor și ieșirea comenzilor trebuie să încapă toate. Ollama recomandă cel puțin 64k tokeni pentru agenți de tip Codex. Iar o fereastră de context mai mare folosește mai multă memorie peste modelul propriu-zis.
Open Interpreter rulează pe mașina ta, dar modelul nu e obligatoriu să ruleze local.
Unde ajunge codul tău depinde de furnizor:
Configurația, sesiunile și jurnalele sunt stocate local, în ~/.openinterpreter, indiferent de caz.
Dacă ai nevoie de mai mult control, poți adăuga un furnizor personalizat care să indice către propriul tău server de inferență. Orice server cu un API compatibil OpenAI funcționează, de exemplu un deployment vLLM pe GPU-urile companiei tale. Astfel, obții o configurare găzduită în care infrastructura îți aparține.
Modelele deschise nu sunt la fel de bune la apelarea uneltelor. Vei observa utilizare slabă a uneltelor manifestată prin apeluri malformate, bucle, opriri premature sau ignorarea rezultatului comenzilor.
Un harness potrivit ajută, dar nu poate remedia un model care nu poate planifica o sarcină în mai mulți pași. Modelele locale mai mici au cele mai multe probleme aici.
Înainte să pui un model nou pe un proiect real, testează-l pe un depozit mic, cum e aplicația de urmărire a obiceiurilor pe care am arătat-o în acest articol. Dacă arată vreo slăbiciune, încearcă un alt harness înainte să treci la un model mai mare.
Iată un scurt rezumat al opțiunilor:
| Unde rulează inferența | Cost | Codul părăsește mașina ta? | |
|---|---|---|---|
| Model proprietar găzduit | Serverul vânzătorului | Per token sau abonament | Da |
| Model cu greutăți deschise găzduit | Serverul furnizorului | Per token, de obicei mai mic | Da |
| Model cu greutăți deschise local | Hardware-ul tău | Hardware și electricitate | Nu |
Opțiunile Open Interpreter pentru modele locale și deschise
Open Interpreter are multe în comun cu alți agenți de codare în terminal. Diferențele țin de cine deține unealta și pentru ce modele este construită.
Claude Code este agentul de codare în terminal al Anthropic. Prima diferență este proprietatea — Claude Code este proprietar, în timp ce Open Interpreter este open source sub licența Apache 2.0. Poți citi și schimba fiecare parte din Open Interpreter.
A doua diferență este alegerea modelului. Claude Code este construit pentru modelele Claude. Îl poți îndrepta către endpointuri compatibile Anthropic de la alți furnizori, dar harnessul rămâne reglat pentru Claude. Open Interpreter tratează alegerea modelului ca pe o funcționalitate de bază.
Compararea harnessurilor e partea interesantă. Claude Code este el însuși unul dintre harnessurile pe care Open Interpreter le emulează. Cu modul claude-code, orice model primește prompturi și unelte în stil Claude Code în runtime-ul Open Interpreter. Interfața și comenzile slash rămân ale Open Interpreter, deci nu e același produs cu un model diferit.
Ambele unelte sunt orientate spre terminal. Fiecare are o sesiune interactivă și un mod neinteractiv pentru scripturi și CI. Pentru instrucțiunile proiectului, Claude Code citește CLAUDE.md, iar Open Interpreter folosește formatul comun AGENTS.md.
Claude Code are un ecosistem mai mare. Vine cu extensii pentru IDE, aplicații desktop și web, un marketplace de pluginuri, subagenți și un SDK. Open Interpreter este mai tânăr și se bazează pe standarde comune precum MCP, skills, AGENTS.md și Agent Client Protocol, în locul propriului ecosistem.
Dacă lucrezi cu modelele Claude și vrei cea mai finisată experiență, Claude Code e alegerea mai sigură. Dacă vrei să rulezi alte modele sau să eviți o unealtă proprietară, mergi pe Open Interpreter.
OpenCode este cea mai apropiată variantă. Ambele sunt open source, cu prioritate pe terminal și construite să funcționeze cu o listă lungă de furnizori de modele.
Suportul pentru modele e similar pe hârtie. OpenCode suportă peste 75 de furnizori, iar Open Interpreter își generează lista de furnizori dintr-un catalog public de modele. Ambele rulează modele locale prin Ollama.
Experiența în terminal diferă mai mult. OpenCode are propriul TUI cu integrare Language Server Protocol (LSP), care trimite înapoi către model diagnosticări de cod precum erorile de tip. TUI-ul Open Interpreter vine din Codex.
La configurare, OpenCode folosește un fișier opencode.json, iar Open Interpreter folosește config.toml cu profiluri.
Arhitectura agentului este diferența principală. OpenCode rulează ca client și server, unde TUI este un client al unui server local la care se pot conecta și alți clienți. Are agenți integrați build și plan și suportă agenți personalizați și subagenți. Își ajustează promptul de sistem pentru fiecare familie de modele, dar uneltele și bucla rămân ale OpenCode. Open Interpreter merge mai departe și înlocuiește întregul harness, inclusiv schemele uneltelor și formatul mesajelor. Buildurile mai noi includ chiar un mod de harness opencode.
Pe partea de dezvoltare, OpenCode este propriul său cod, construit de echipă și comunitate. Open Interpreter se bazează pe un fork Codex, deci o mare parte din runtime vine din upstream. E un compromis. Open Interpreter primește gratuit sandboxul și runtime-ul lui Codex, în timp ce OpenCode controlează întregul său stack.
Aceste două nu sunt concurenți în sensul obișnuit. Open Interpreter este un fork al Codex.
Împart același runtime în Rust, TUI, sandboxing, aprobări, AGENTS.md, skills, MCP, modul exec și majoritatea comenzilor slash. Când am rulat Open Interpreter, indiciul de reluare a sesiunii încă spunea codex resume.
Codex este agentul OpenAI, construit în jurul modelelor OpenAI. Suportă modele locale cu --oss și furnizori personalizați, dar experiența implicită țintește OpenAI.
Open Interpreter extinde Codex în câteva direcții:
Emulare de harness: Schimbă prompturile, schemele uneltelor și formatul mesajelor pentru a se potrivi fiecărei familii de modele
Suport pentru furnizori: Are un catalog generat de furnizori și ghiduri dedicate pentru Kimi K3, DeepSeek și GLM
Chat Completions: Flagul --chat-completions rulează orice furnizor compatibil OpenAI
Suprascriere SDK Codex: Aplicațiile construite pe SDK-ul Codex pot rula în schimb prin Open Interpreter
Open Interpreter își stochează de asemenea configurația și sesiunile în ~/.openinterpreter, astfel încât să nu intre în conflict cu o instalare Codex.
Dacă folosești în principal modelele OpenAI, Codex e o alegere mai bună. Dacă folosești alte modele, Open Interpreter îți oferă același flux de lucru cu suport mai bun pentru ele.
Iată un scurt rezumat:
| Licență | Modele | Abordare harness | Config | |
|---|---|---|---|---|
| Open Interpreter | Open source (Apache 2.0) | Orice furnizor, găzduit sau local | Emulează harnessul per model | config.toml |
| Claude Code | Proprietar | Construit pentru modelele Claude | Harnessul propriu al Claude Code | settings.json și CLAUDE.md |
| OpenCode | Open source (MIT) | 75+ furnizori, găzduit sau local | Un singur harness cu prompturi specifice modelului | opencode.json |
| Codex | Open source (Apache 2.0) | Construit pentru modelele OpenAI cu --oss | Harnessul propriu al Codex | config.toml |
Open Interpreter comparat cu alți agenți AI de codare
Cel mai rău lucru pe care îl poate face un chatbot este să-ți dea un răspuns prost, pe care îl poți ignora. Un agent de codare rulează comenzi pe mașina ta, citește și scrie fișiere și poate accesa rețeaua. O decizie proastă a modelului sau o injecție de prompt poate produce daune reale. Injecția de prompt înseamnă instrucțiuni ascunse în conținutul pe care agentul îl citește, cum ar fi un fișier README sau o pagină web.
Open Interpreter își moștenește modelul de securitate din runtime-ul Codex. Are două straturi — un sandbox care limitează ce e posibil și o politică de aprobare care decide când agentul te întreabă înainte.
Fiecare comandă pe care o rulează agentul trece printr-un sandbox la nivel de OS pe macOS, Linux și Windows. Există trei moduri de sandbox:
read-only: Agentul poate citi fișiere, dar nu poate schimba nimic
workspace-write: Agentul poate edita fișiere și rula comenzi în interiorul dosarului proiectului
danger-full-access: Fără niciun sandbox
Cu workspace-write, scrierile în fișiere sunt limitate la workspace-ul activ. Agentul îți poate repara codul, dar nu poate edita fișiere din alte zone ale mașinii.
În modul workspace-write, comenzile nu au acces la rețea în mod implicit. Asta blochează descărcările și împiedică agentul să-ți trimită codul în altă parte.
Unele sarcini au nevoie de rețea, de exemplu instalarea unui pachet. Poți activa accesul la rețea în configul tău:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
Activează-l doar pentru proiectele în care ai nevoie.
Politica de aprobare decide când agentul se oprește și întreabă:
untrusted: Întreabă înainte să ruleze comenzi care nu sunt pe lista de încredere
on-request: Întreabă atunci când o sarcină are nevoie de mai mult acces decât permite sandboxul
never: Nu întreabă niciodată
Pentru proiecte sub control al versiunilor, workspace-write cu on-request e un implicit bun. Agentul lucrează în interiorul proiectului și întreabă înainte să meargă mai departe. Git îți oferă o cale de întoarcere dacă ceva nu merge bine.
Flagul --yolo dezactivează atât sandboxul, cât și aprobările. Folosește-l doar într-un mediu consumabil, ca un container sau o VM.
Comenzile rulate de agent moștenesc mediul shell-ului tău. Dacă cheile API sunt în variabile de mediu, acele comenzi le pot vedea.
Poți limita asta cu shell_environment_policy:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
Setarea core transmite doar variabile de bază precum HOME și PATH, iar exclude elimină orice se potrivește cu modelele.
Fișierele sunt un alt risc. Agentul poate citi un fișier .env din proiect chiar și în modul read-only. Cu un furnizor găzduit, orice citește agentul ajunge pe serverele furnizorului.
Reține că sandboxul limitează daunele, dar ar trebui să îl tratezi ca pe o plasă de siguranță, nu ca pe o garanție.
Înainte să lași agentul să ruleze de unul singur, rulează /status și verifică modul de sandbox și politica de aprobare.
Dacă găsești un articol despre Open Interpreter care începe cu pip install, nu greșește. Descrie un alt proiect.
Open Interpreter original a apărut în 2023 ca proiect Python. Permitea modelelor lingvistice să ruleze cod Python, JavaScript și shell pe mașina ta, fiind cunoscut ca o alternativă open-source la Code Interpreter-ul ChatGPT. Versiunile ulterioare au adăugat controlul computerului, astfel încât modelul putea lucra și cu desktopul tău.
Proiectul principal actual este o rescriere în Rust bazată pe Codex. Se concentrează pe agenți de codare și pe emularea harnessului, nu pe control general al computerului.
Versiunea Python nu a dispărut. Continuă ca un fork al comunității la endolith/open-interpreter.
Ambele versiuni folosesc același nume, același istoric al repository-ului GitHub și aceeași comandă interpreter, așa că sunt ușor de confundat.
Dar un indiciu foarte evident este:
pip install open-interpreter: Versiunea Python legacy
curl sau installer PowerShell: Versiunea curentă în Rust
Open Interpreter nu e unealta potrivită pentru orice setup. Iată unde are sens și unde nu.
Open source: Este licențiat sub Apache 2.0, deci poți citi, audita și face fork întregului cod
Alegerea modelului: Poți folosi modele găzduite, cu greutăți deschise și locale dintr-un singur agent și poți comuta între ele în timpul sesiunii
Multiple harnessuri de agent: Te apropii de performanța pentru care a fost reglat modelul, lucru pe care puțini alți agenți de codare îl oferă
Dezvoltare nativă în terminal: Se integrează în shell-ul și fluxul tău Git existente, iar modul exec funcționează în scripturi și CI
Modele deschise și mai ieftine: Proiectul e construit în jurul lor, cu ghiduri dedicate pentru furnizori și harnessuri potrivite
Extensibilitate: MCP, skills, hooks, AGENTS.md, Agent Client Protocol și suprascrierea SDK-ului Codex îți permit să-l conectezi la alte unelte
Calitatea modelului variază: Agentul e la fel de bun ca modelul din spatele lui, iar niciun harness nu repară un model care nu poate planifica o sarcină în mai mulți pași
Modelele locale cer hardware serios: În testele mele, doar devstral-small-2 a ocupat 26 GB de memorie, înainte de fereastra mare de context de care are nevoie un agent de codare
Configurarea cere mai multă muncă: Gestionezi singur furnizorii, ferestrele de context, harnessurile și setările de sandbox. Există și colțuri aspre, cum ar fi brandingul Codex rămas și avertismente de metadata pentru modelele Ollama
Execuția comenzilor e un risc: Sandboxul și aprobările reduc riscul, dar nu îl elimină
Codul tot are nevoie de review: Testele care trec nu garantează o corecție corectă, așa că trebuie să citești fiecare diff
Open Interpreter este un agent de codare open-source care funcționează cu modelul pe care îl alegi, fie că acel model e găzduit, are greutăți deschise sau rulează pe propria ta mașină.
Fluxul de lucru e simplu. Alegi un model și un harness, îndrepți agentul către un proiect și îl lași să inspecteze, să editeze și să ruleze comenzi până când sarcina e gata. Apoi îți verifici munca lui.
Emularea harnessului îl diferențiază de concurenți. Open Interpreter nu forțează fiecare model într-o singură configurare de agent. Schimbă configurarea ca să se potrivească modelului, iar asta poate face diferența. Modelul decide și cât de bună e munca, iar permisiunile decid ce poate modifica agentul. Review-ul tău e ultimul control înainte ca orice schimbare să ajungă în codul tău.
Dacă vrei să obții o certificare de inginer AI, înscrie-te în programul nostru Associate AI Engineer for Developers și fă trecerea în lumea AI în ritmul tău.
Învață cu DataCamp
Traseu de învățare
Traseu de învățare
Traseu de învățare