学习路径
面向开发者的 AI 工程师助理
26 小时
如果您曾在为某个模型打造的编码代理中运行过另一种开源权重模型,您就会知道这并不是个好主意。
模型通常会误读工具模式,并不断重复同一个失败的命令,直到您终止它。等您换回该代理原本适配的模型,同样的任务就能顺利完成。问题往往不在模型本身,而在其外层的代理挂架,因为挂架中的提示词和工具格式是为别的模型调校的。
Open Interpreter 通过模拟每个模型所调校的挂架来解决这个问题,例如 Claude Code 或 Kimi Code。它是一个从终端运行的开源 AI 编码代理,目前版本是基于 OpenAI 的 Codex 构建的 Rust 项目,不是您可能记得的那个基于 Python 的电脑助理。
本文将带您完成安装、模型与挂架设置、上手实战的编码流程,以及 Open Interpreter 与 Claude Code、OpenCode 和 Codex 的比较。
刚接触 AI 代理?报名我们的《AI 代理入门》课程,一个下午学会基础知识。
Open Interpreter 让一个 AI 模型可以访问您的项目以及开发者会使用的工具。
您只需用英文描述任务,代理就会开始处理您的代码。它可以操作:
该项目以 Apache 2.0 许可开源。它也不局限于某一家模型提供方。您可以连接托管模型、开源权重模型,或在本机本地运行的模型。
截至 2026 年 9 月,主代码库在 GitHub 上已获 68,000+ 颗星标。
Open Interpreter 以循环方式工作:
其中一些步骤可能需要您事先批准,取决于权限设置。我会在安全部分介绍。
下面是更直观的概览:
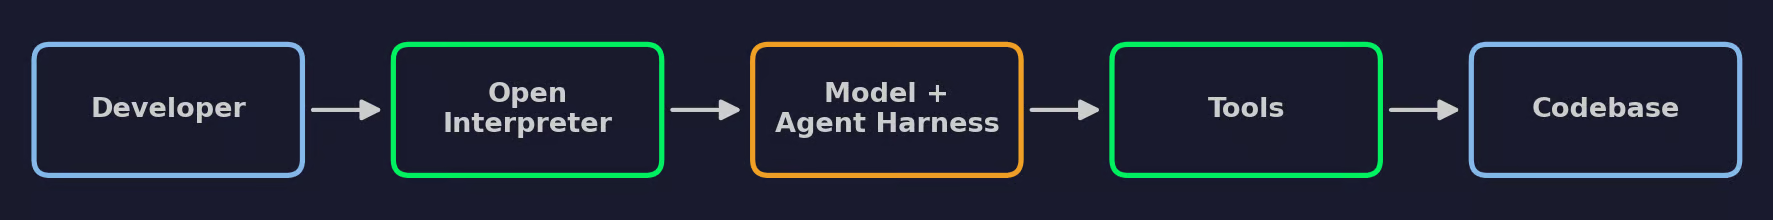
Open Interpreter 的工作原理
需要记住的是,您并不直接与模型对话。Open Interpreter 会将您的任务按当前挂架的提示词与工具定义格式化后发送给模型。模型请求调用工具,Open Interpreter 在您的代码库上执行这些调用,然后将结果返回给模型进入下一步。
由于模型与挂架是分离的层,您可以更换其中任意一层,而不影响其余设置。
Open Interpreter 以独立二进制形式安装,因此无需 Python 或 pip。
如果看到较早的博客建议运行 pip install open-interpreter,那说的是旧版 Python 项目。该命令不会安装本文介绍的基于 Rust 的编码代理。
您还需要在本机安装 Git。Open Interpreter 即使没有 Git 也能运行,但有了 Git,它可以开启“仓库感知”的会话并生成差异。
在终端中运行安装脚本:
curl -fsSL https://www.openinterpreter.com/install | sh脚本会为您的平台下载正确的发行包,并将 interpreter 命令放到 ~/.local/bin。
打开 PowerShell 并运行:
irm https://www.openinterpreter.com/install.ps1 | iex如果您更喜欢 Linux 风格的环境,也可以使用 WSL。在这种情况下,在 WSL 终端内运行 macOS 与 Linux 的安装命令。
重启终端以载入新的 PATH,然后检查版本:
interpreter --version如果看到版本号,说明安装成功。
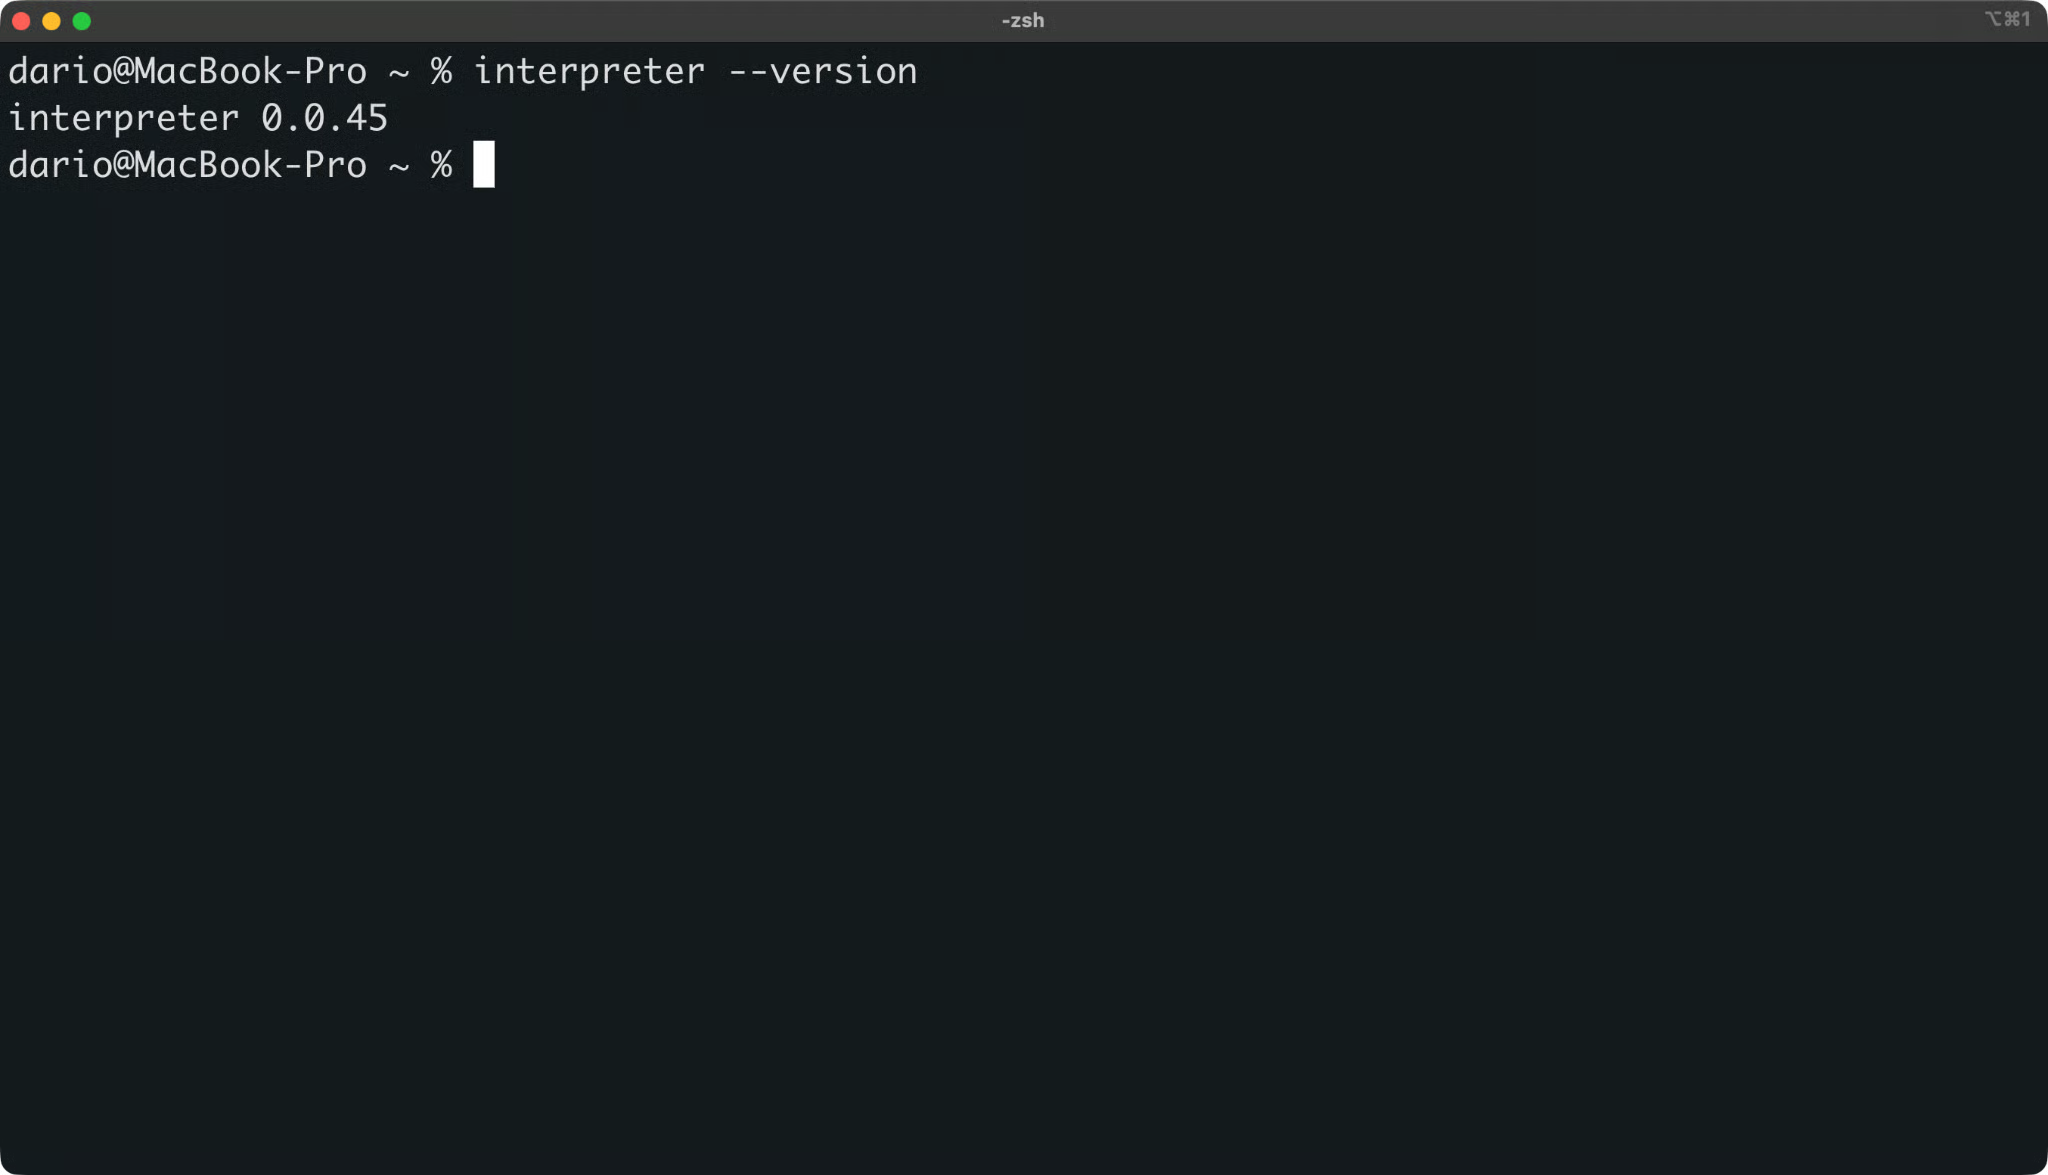
Open Interpreter 版本检查
在任意目录启动会话:
interpreter您也可以输入 i,它是同一命令的简写别名。
Open Interpreter 会打开一个终端界面,您用英文描述任务即可。首次启动时,会提示您连接一个模型提供方。下一节我将通过 Ollama 使用本地模型,您现在可以先跳过这一步。
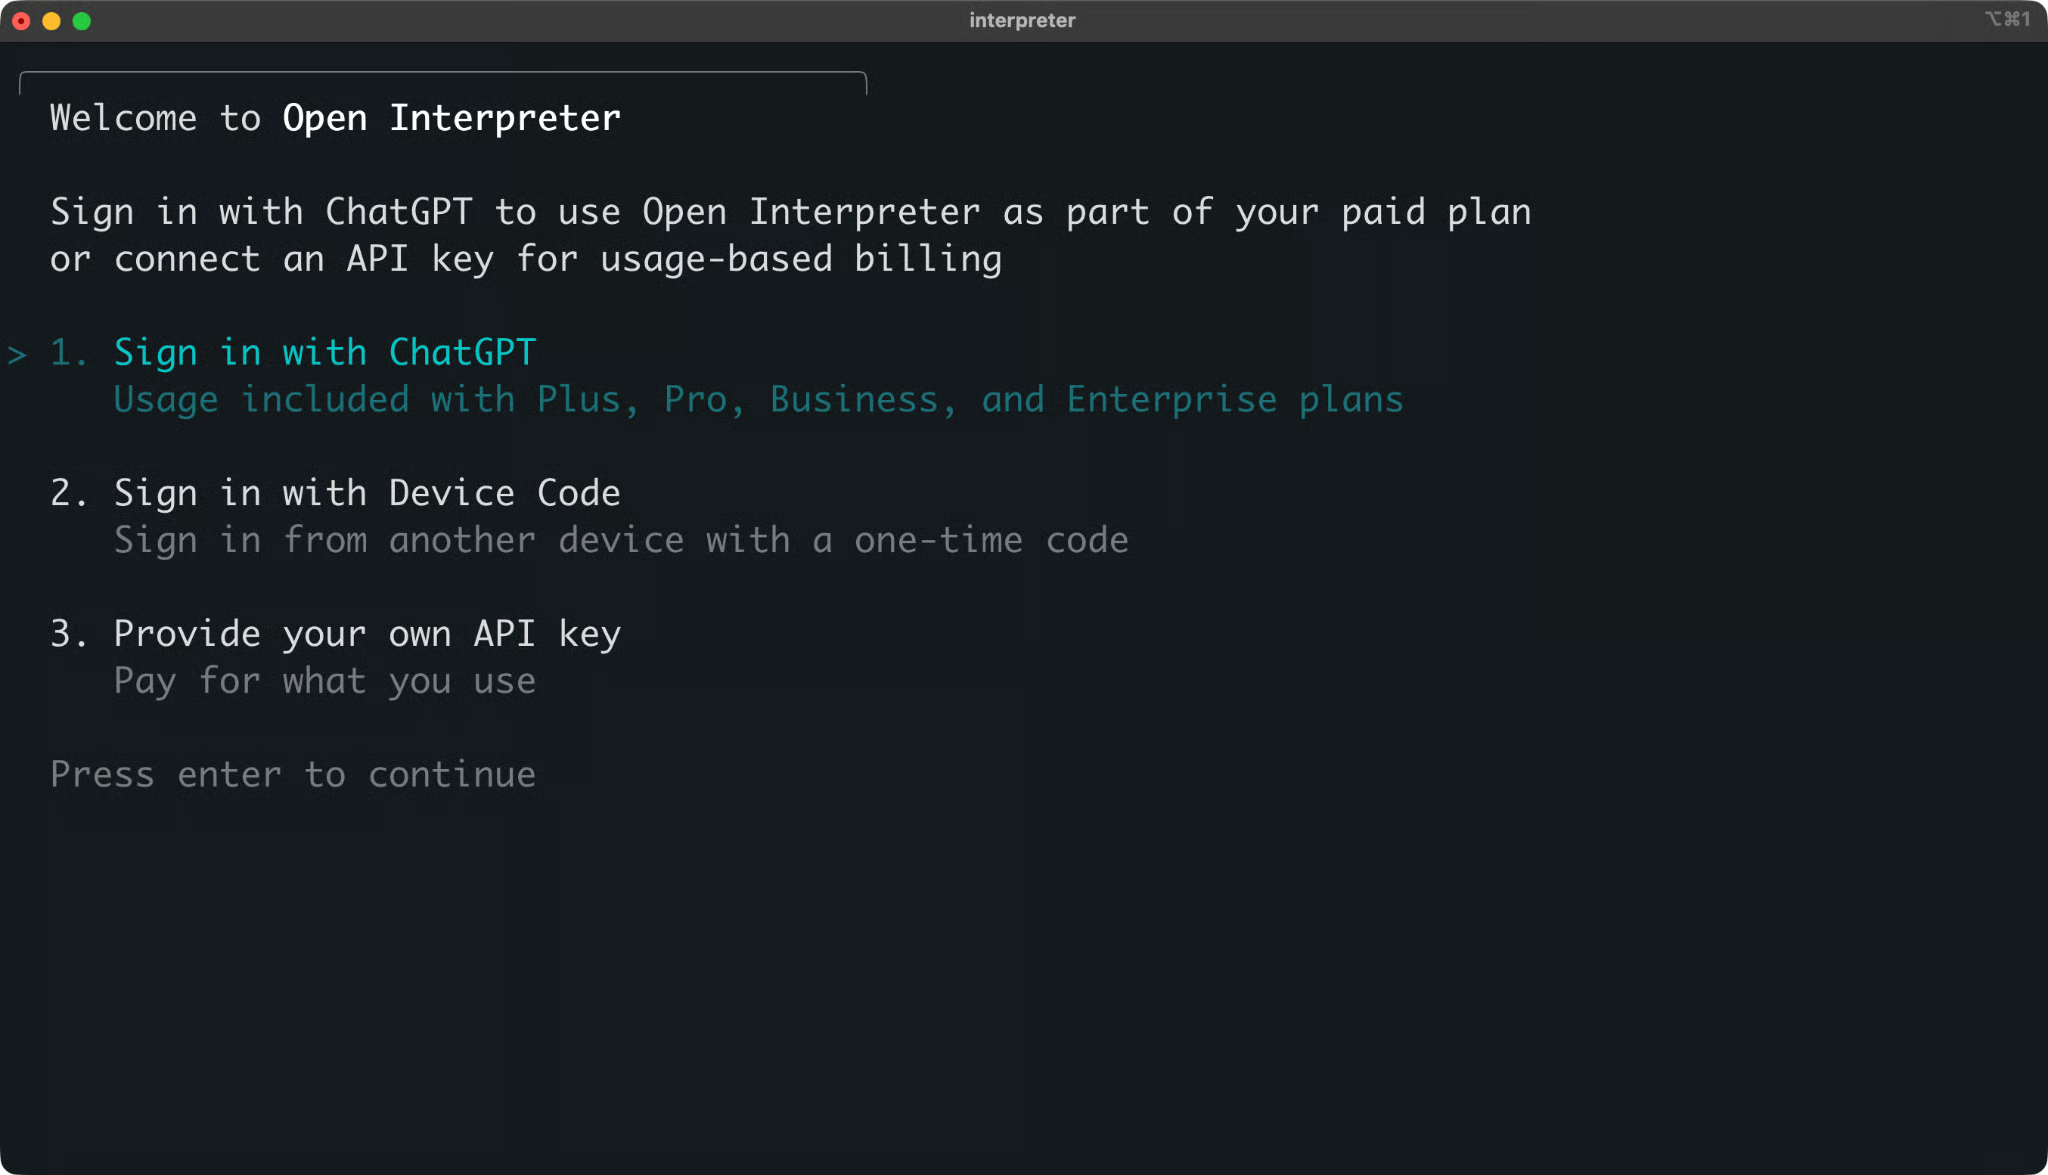
Open Interpreter 交互式会话
要退出会话,输入 /exit。
理解编码代理最快的方法,就是给它一个任务,看它如何处理。
本节我将使用一个小型习惯记录器项目。它只有一个函数、一个测试文件和一个缺陷。
该项目用于计算某个习惯的连续天数最长连续段。例如,统计您连续几天进行锻炼。
先创建项目文件夹和虚拟环境:
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
创建 habits.py 并写入以下代码:
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
然后创建 test_habits.py:
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
该函数存在一个缺陷。我不会点明,因为这是代理要完成的工作。
添加 .gitignore 文件,避免将虚拟环境与缓存文件纳入仓库:
.venv/
__pycache__/
.pytest_cache/
现在提交项目:
git init
git add .
git commit -m "Initial commit"
此提交为您提供一个干净的起点。稍后您将用它来精确查看代理做了哪些更改。
运行测试以确认缺陷:
python -m pytest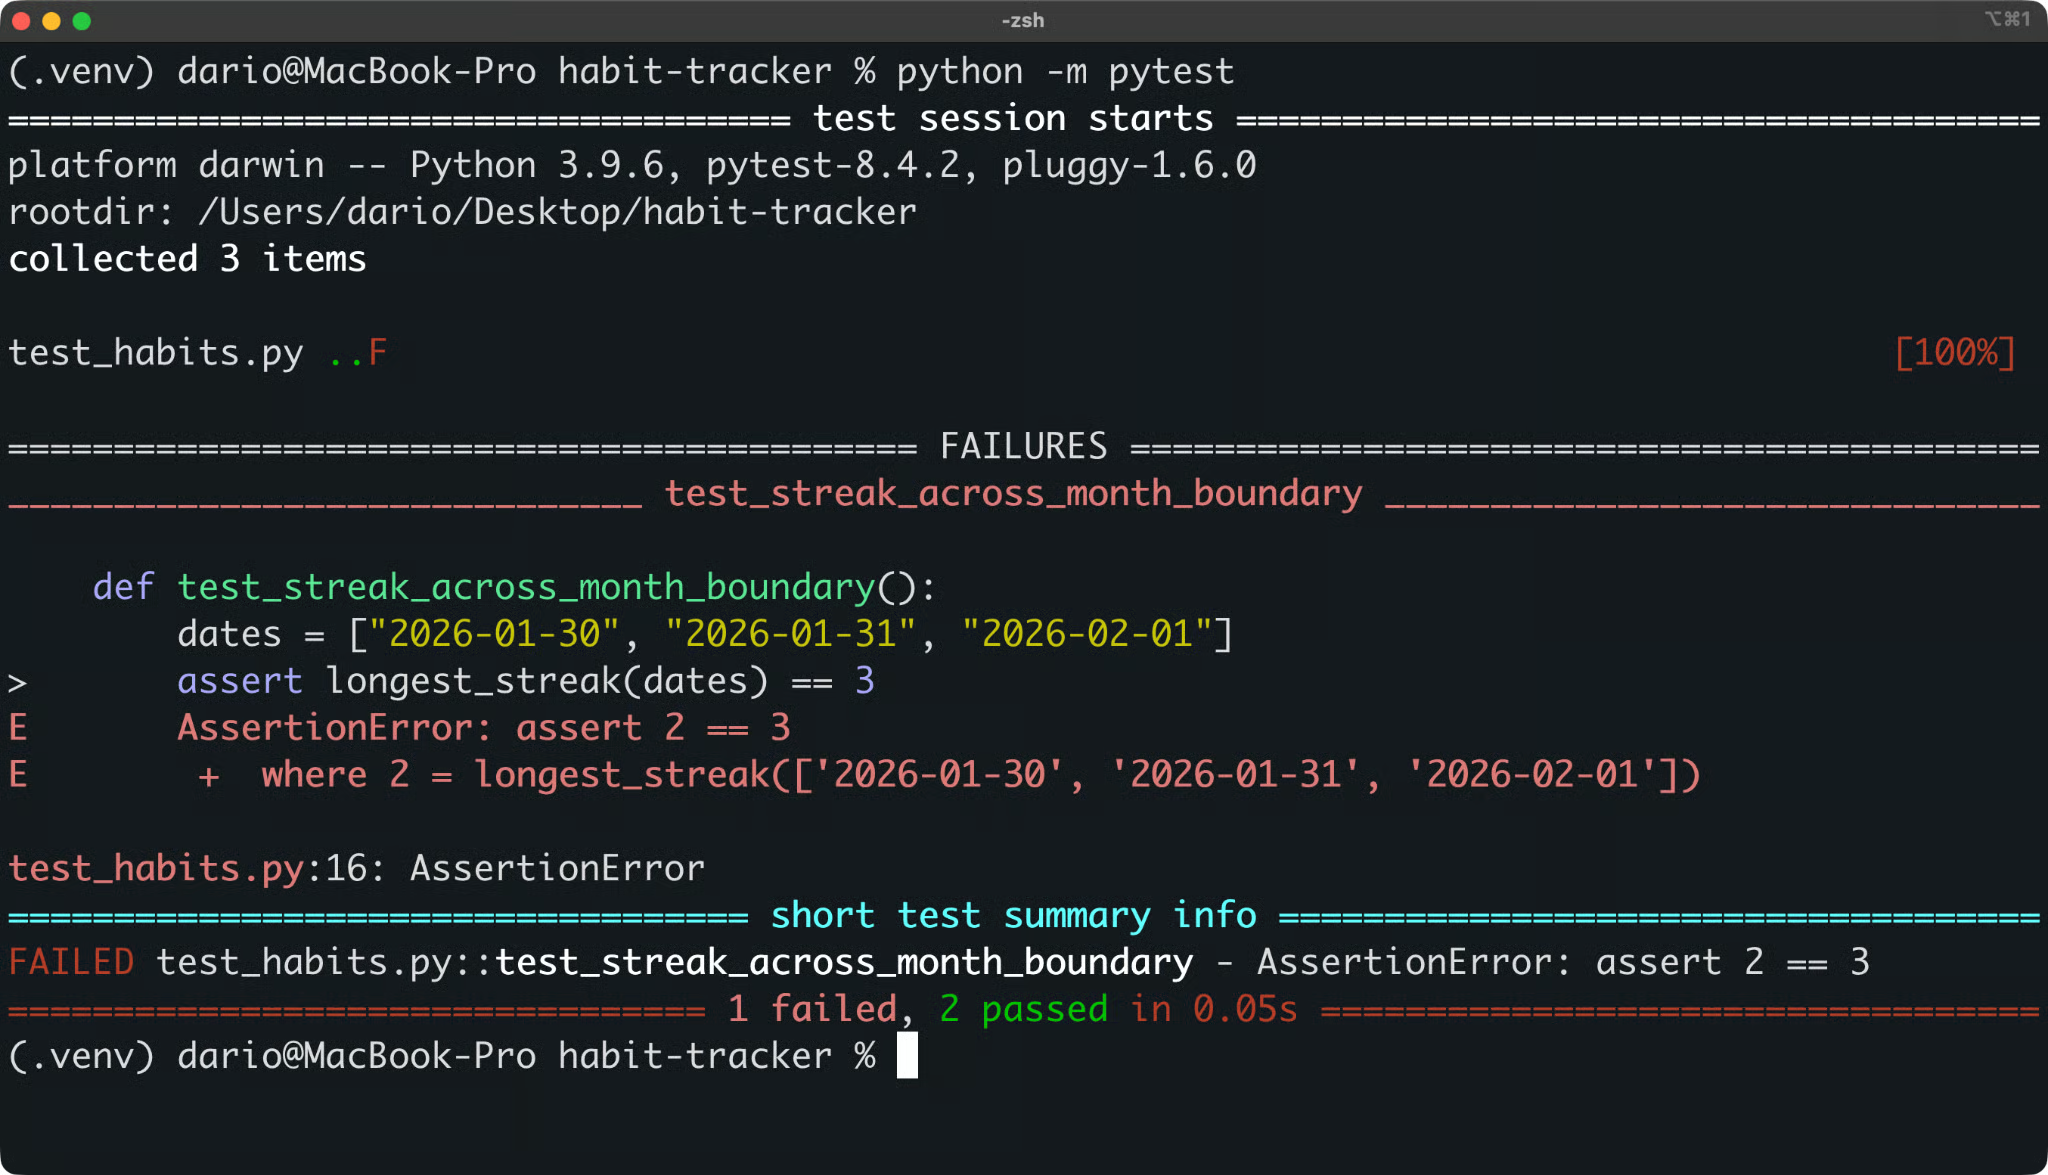
习惯记录器测试结果
两项测试通过,一项失败。这就是 Open Interpreter 需要解决的问题。
您需要安装并运行 Ollama。还需要一个支持工具调用的模型,拉取它:
ollama pull qwen3-coder:30b然后从项目文件夹启动 Open Interpreter。使用同一个终端,这样代理可以使用您虚拟环境里安装的 pytest:
interpreter --oss --local-provider ollama -m qwen3-coder:30b各个参数的含义如下:
--oss: 使用本地开源提供方
--local-provider ollama: 选择 Ollama(而非 LM Studio)
-m qwen3-coder:30b: 设置本次运行的模型
运行 /status 查看当前提供方、模型、沙箱模式与审批策略。
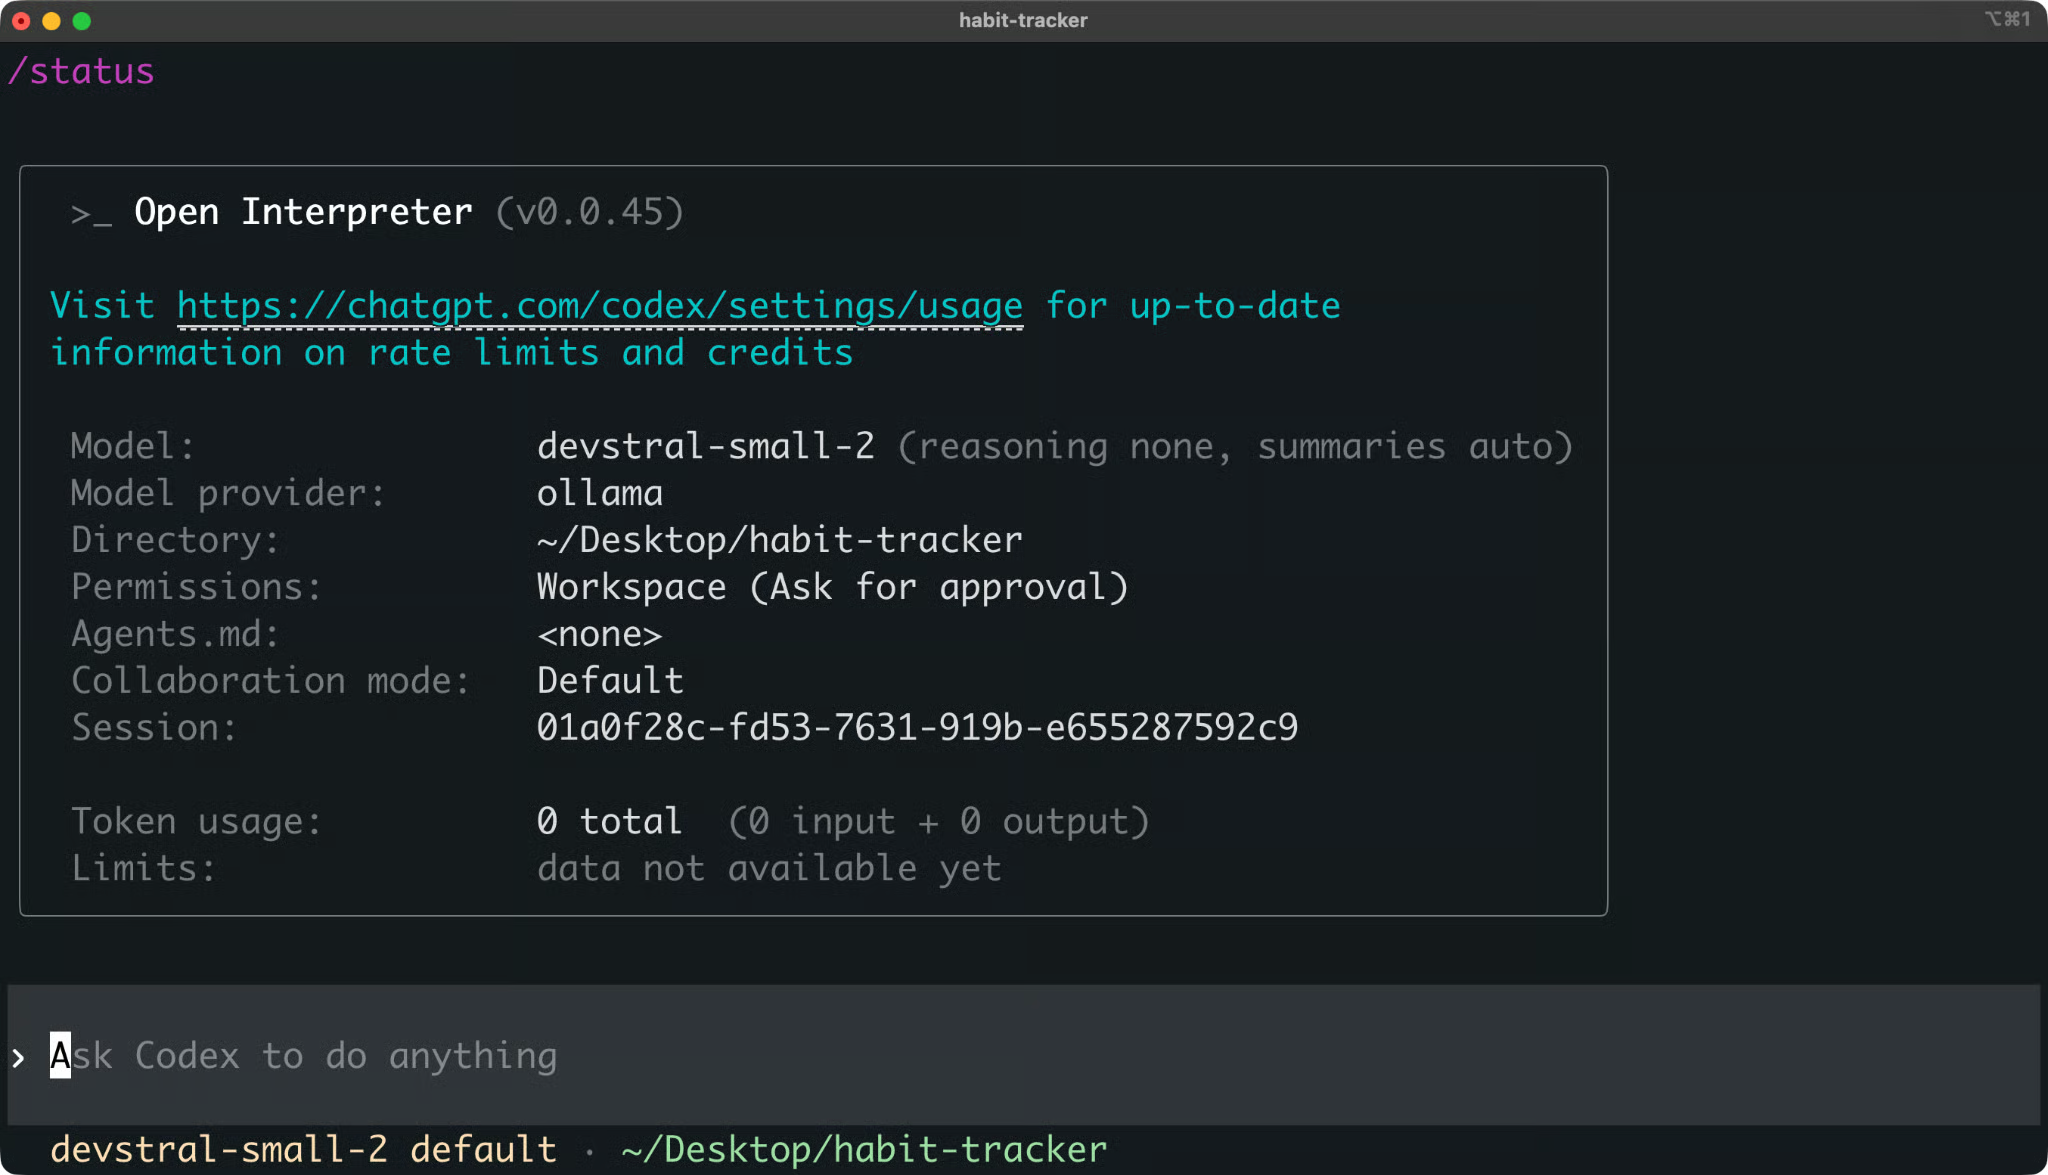
使用本地 Ollama 模型的 Open Interpreter 会话
您并不希望代理立刻修改任何内容。先让它诊断:
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.代理通常会在回答前读取文件并运行测试。命令在沙箱内执行,如果需要超出沙箱权限的访问,会先征求您的批准。
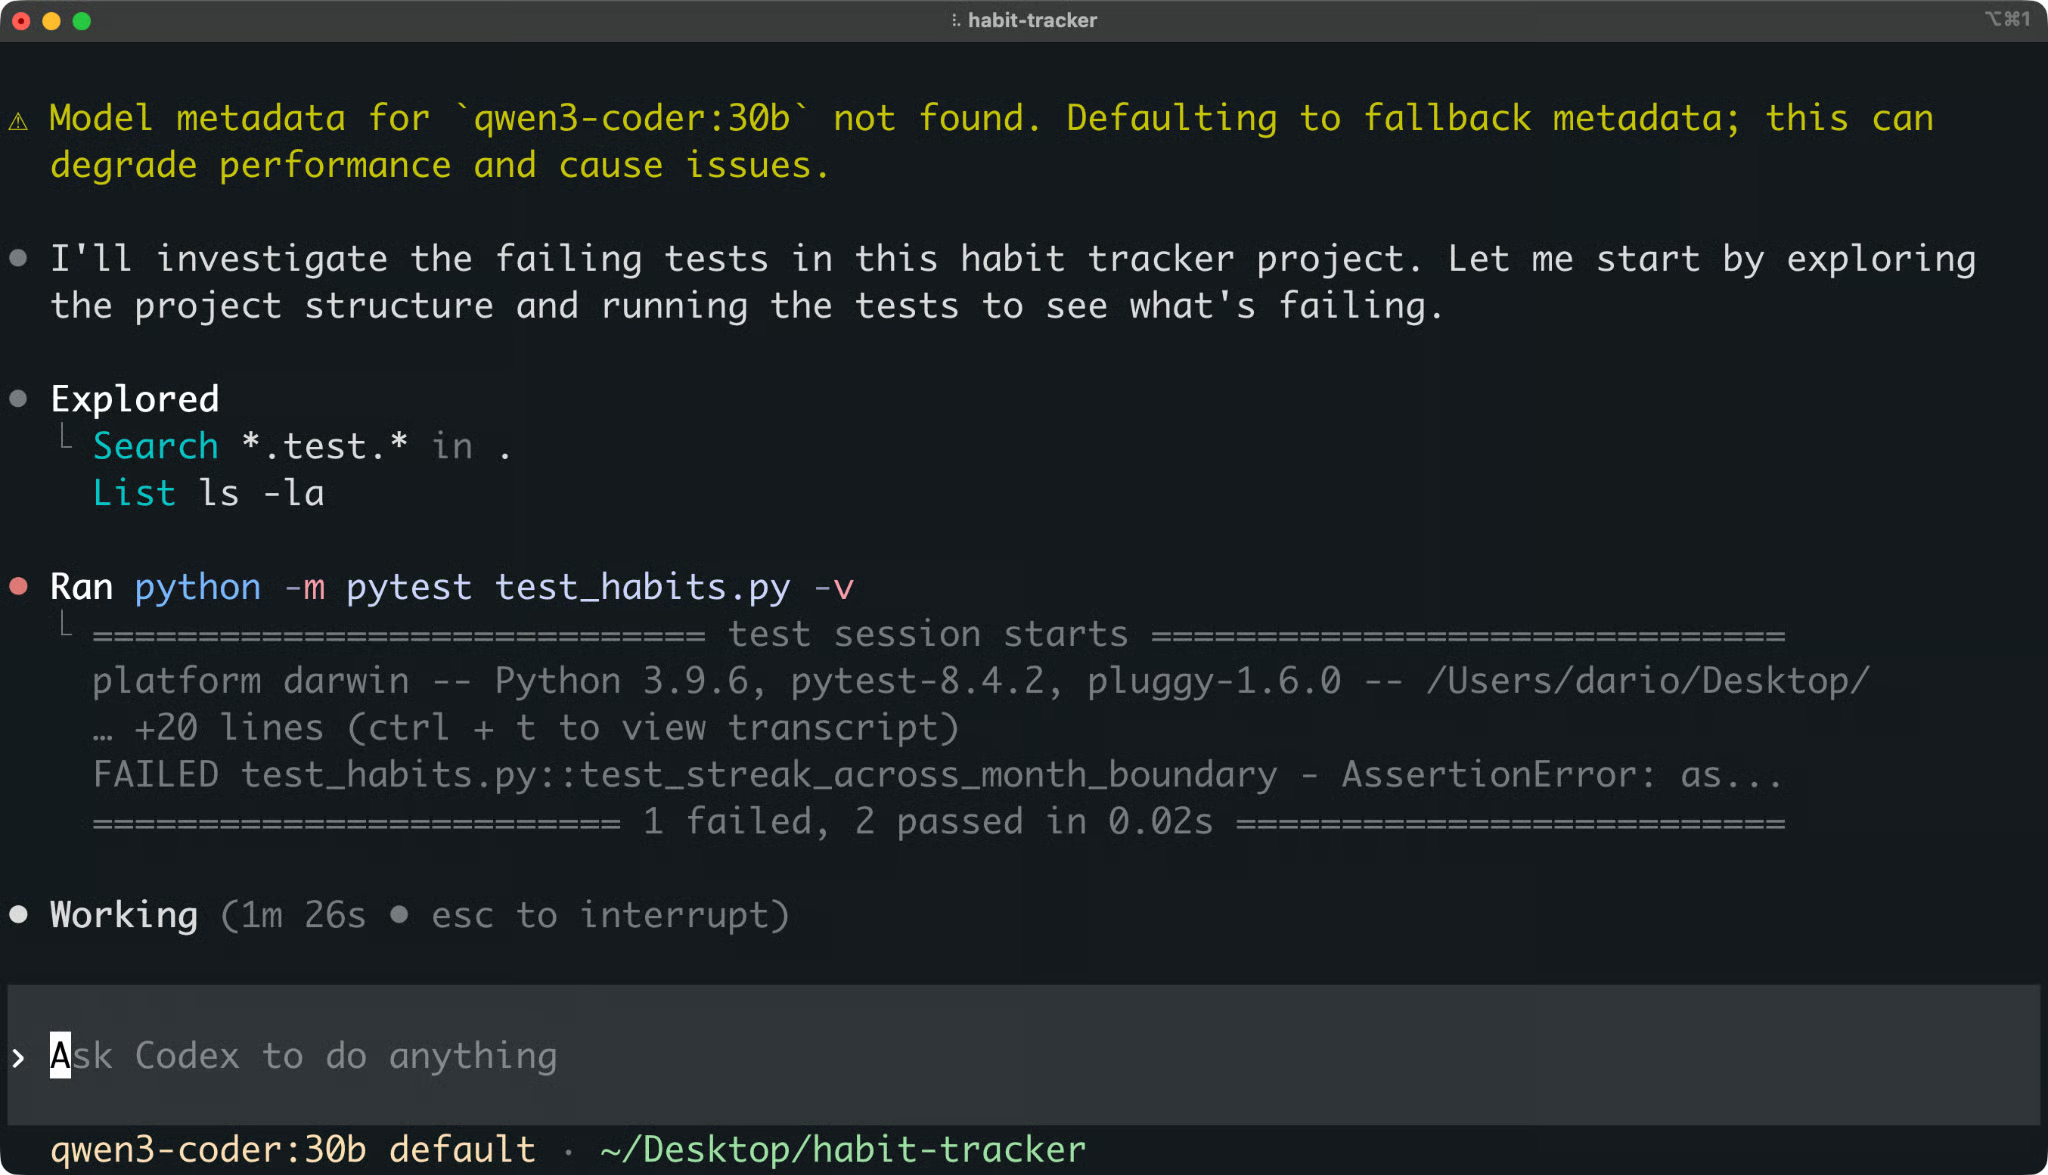
Open Interpreter 输出
在批准任何操作前,请先阅读其解释。
正确的诊断应指出,该函数只比较了“日”,因此一旦跨月就会被判定为中断。合理的修复是比较完整日期,例如使用 Python datetime 模块中的 date.fromisoformat()。
如果诊断错误,请在同一会话中先纠正,再让代理编辑任何代码。
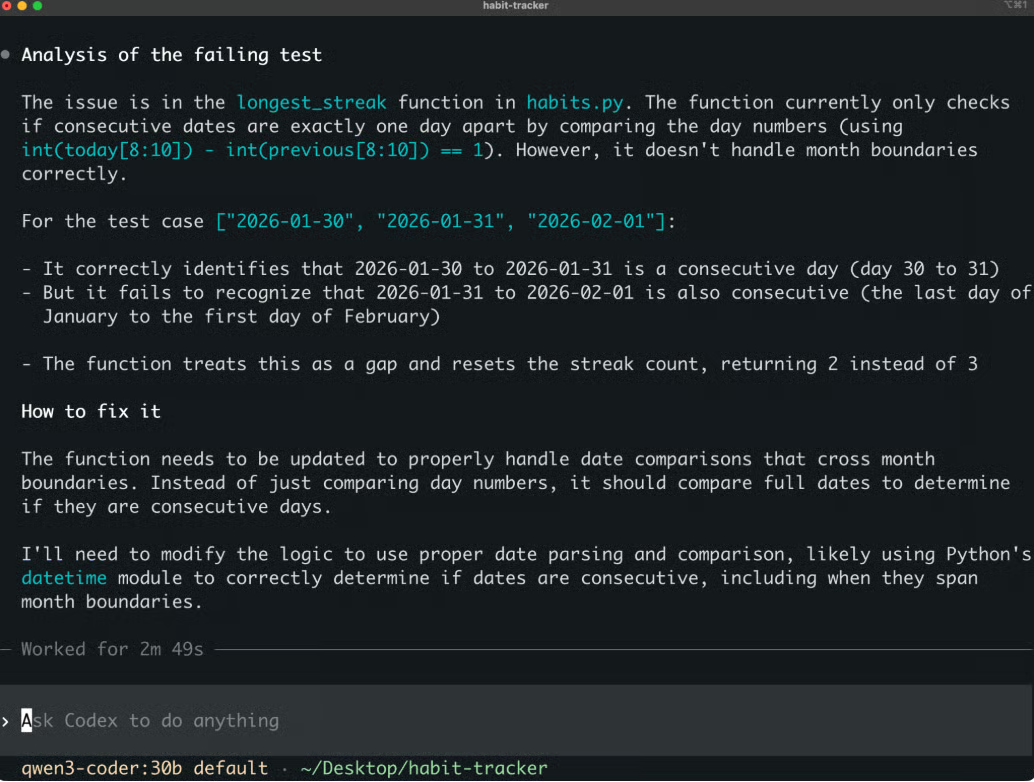
Open Interpreter 修复方案
当您认可方案后,实施修复:
Apply the fix to habits.py, then run the tests.代理会编辑文件并重新运行 pytest。您希望看到三项测试都通过。
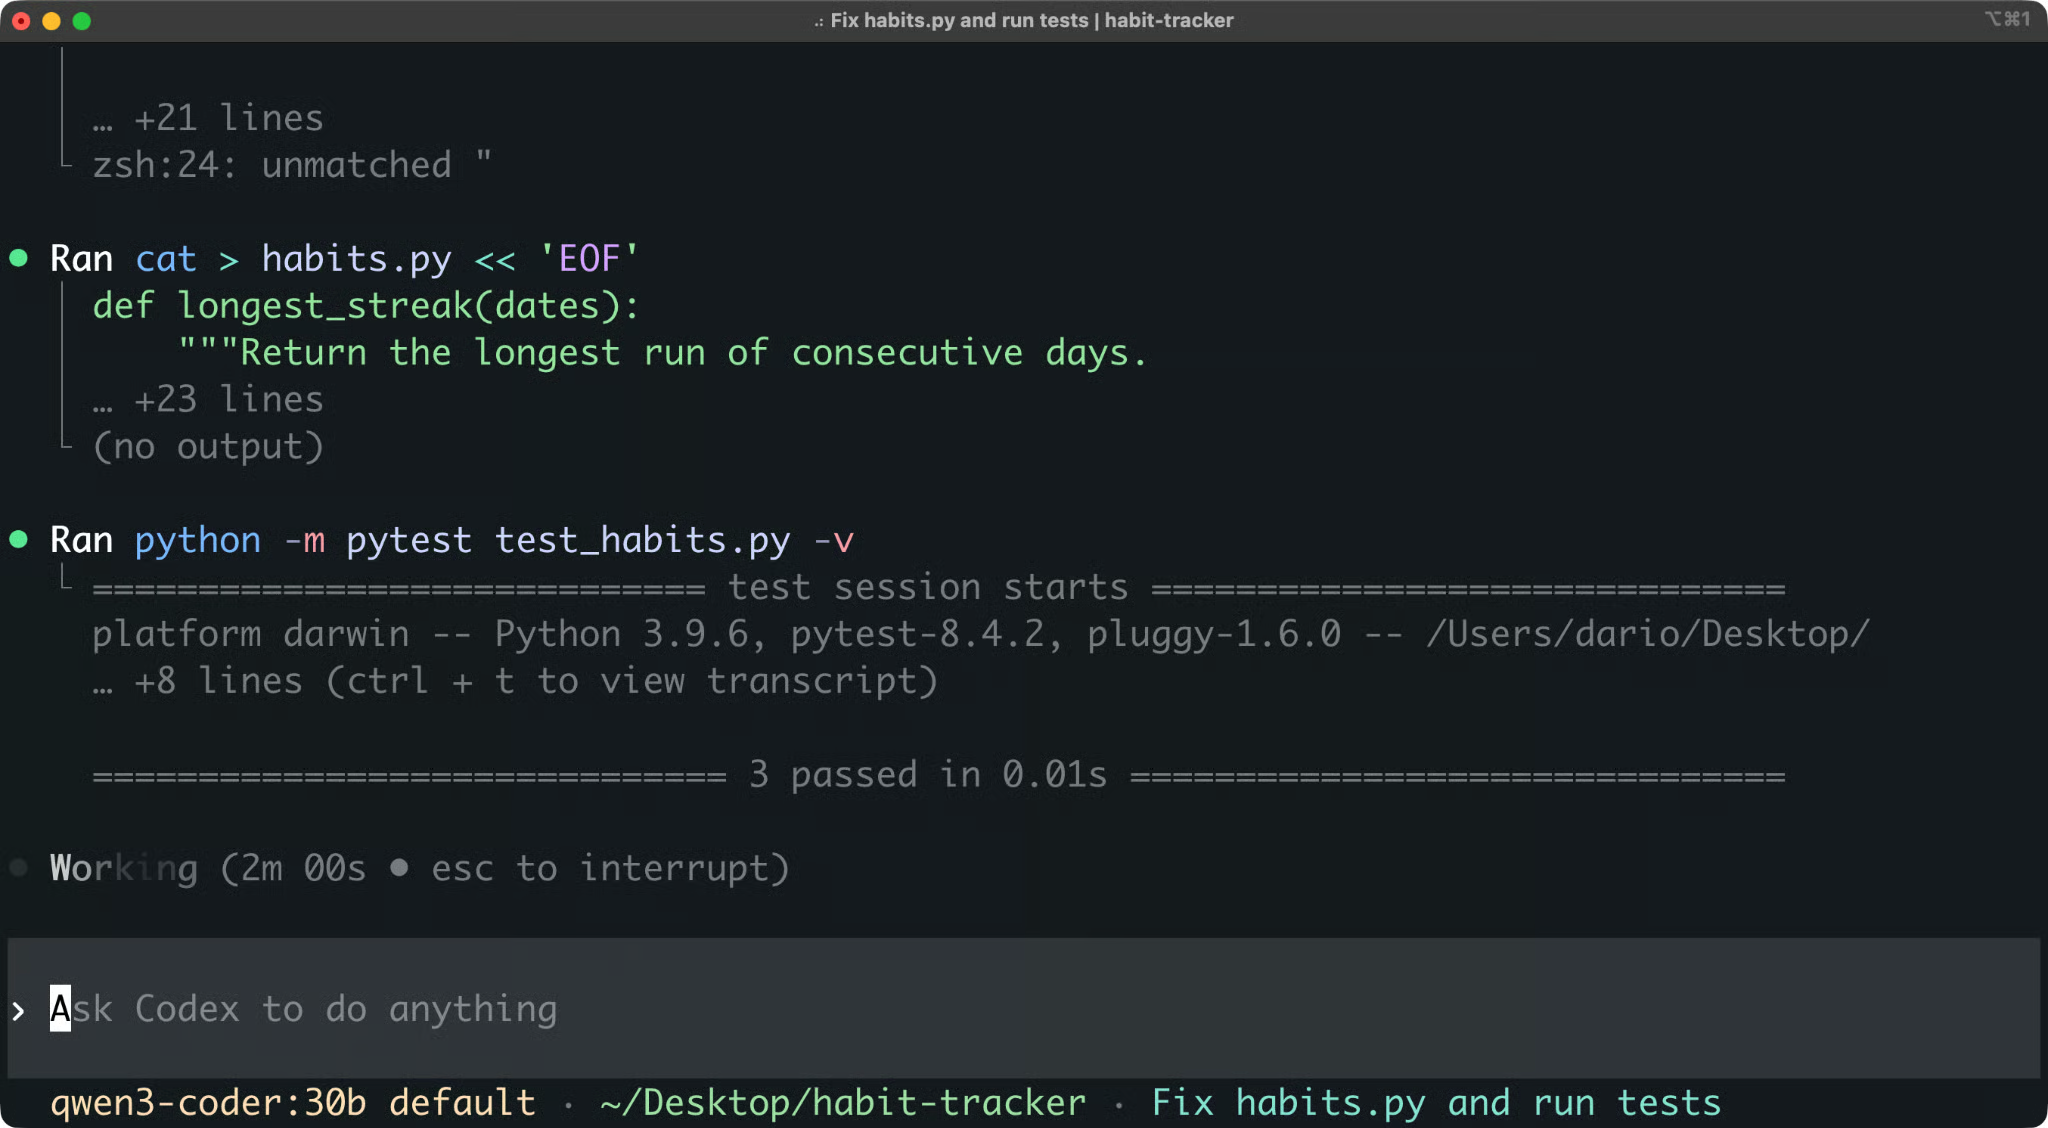
修复后所有测试均通过
测试通过并不一定意味着代码缺陷被真正修复。也许测试被改写成了变通方案。您仍需审查代码。
在会话内运行 /diff 查看工作区变更。退出后也可以运行 git diff。
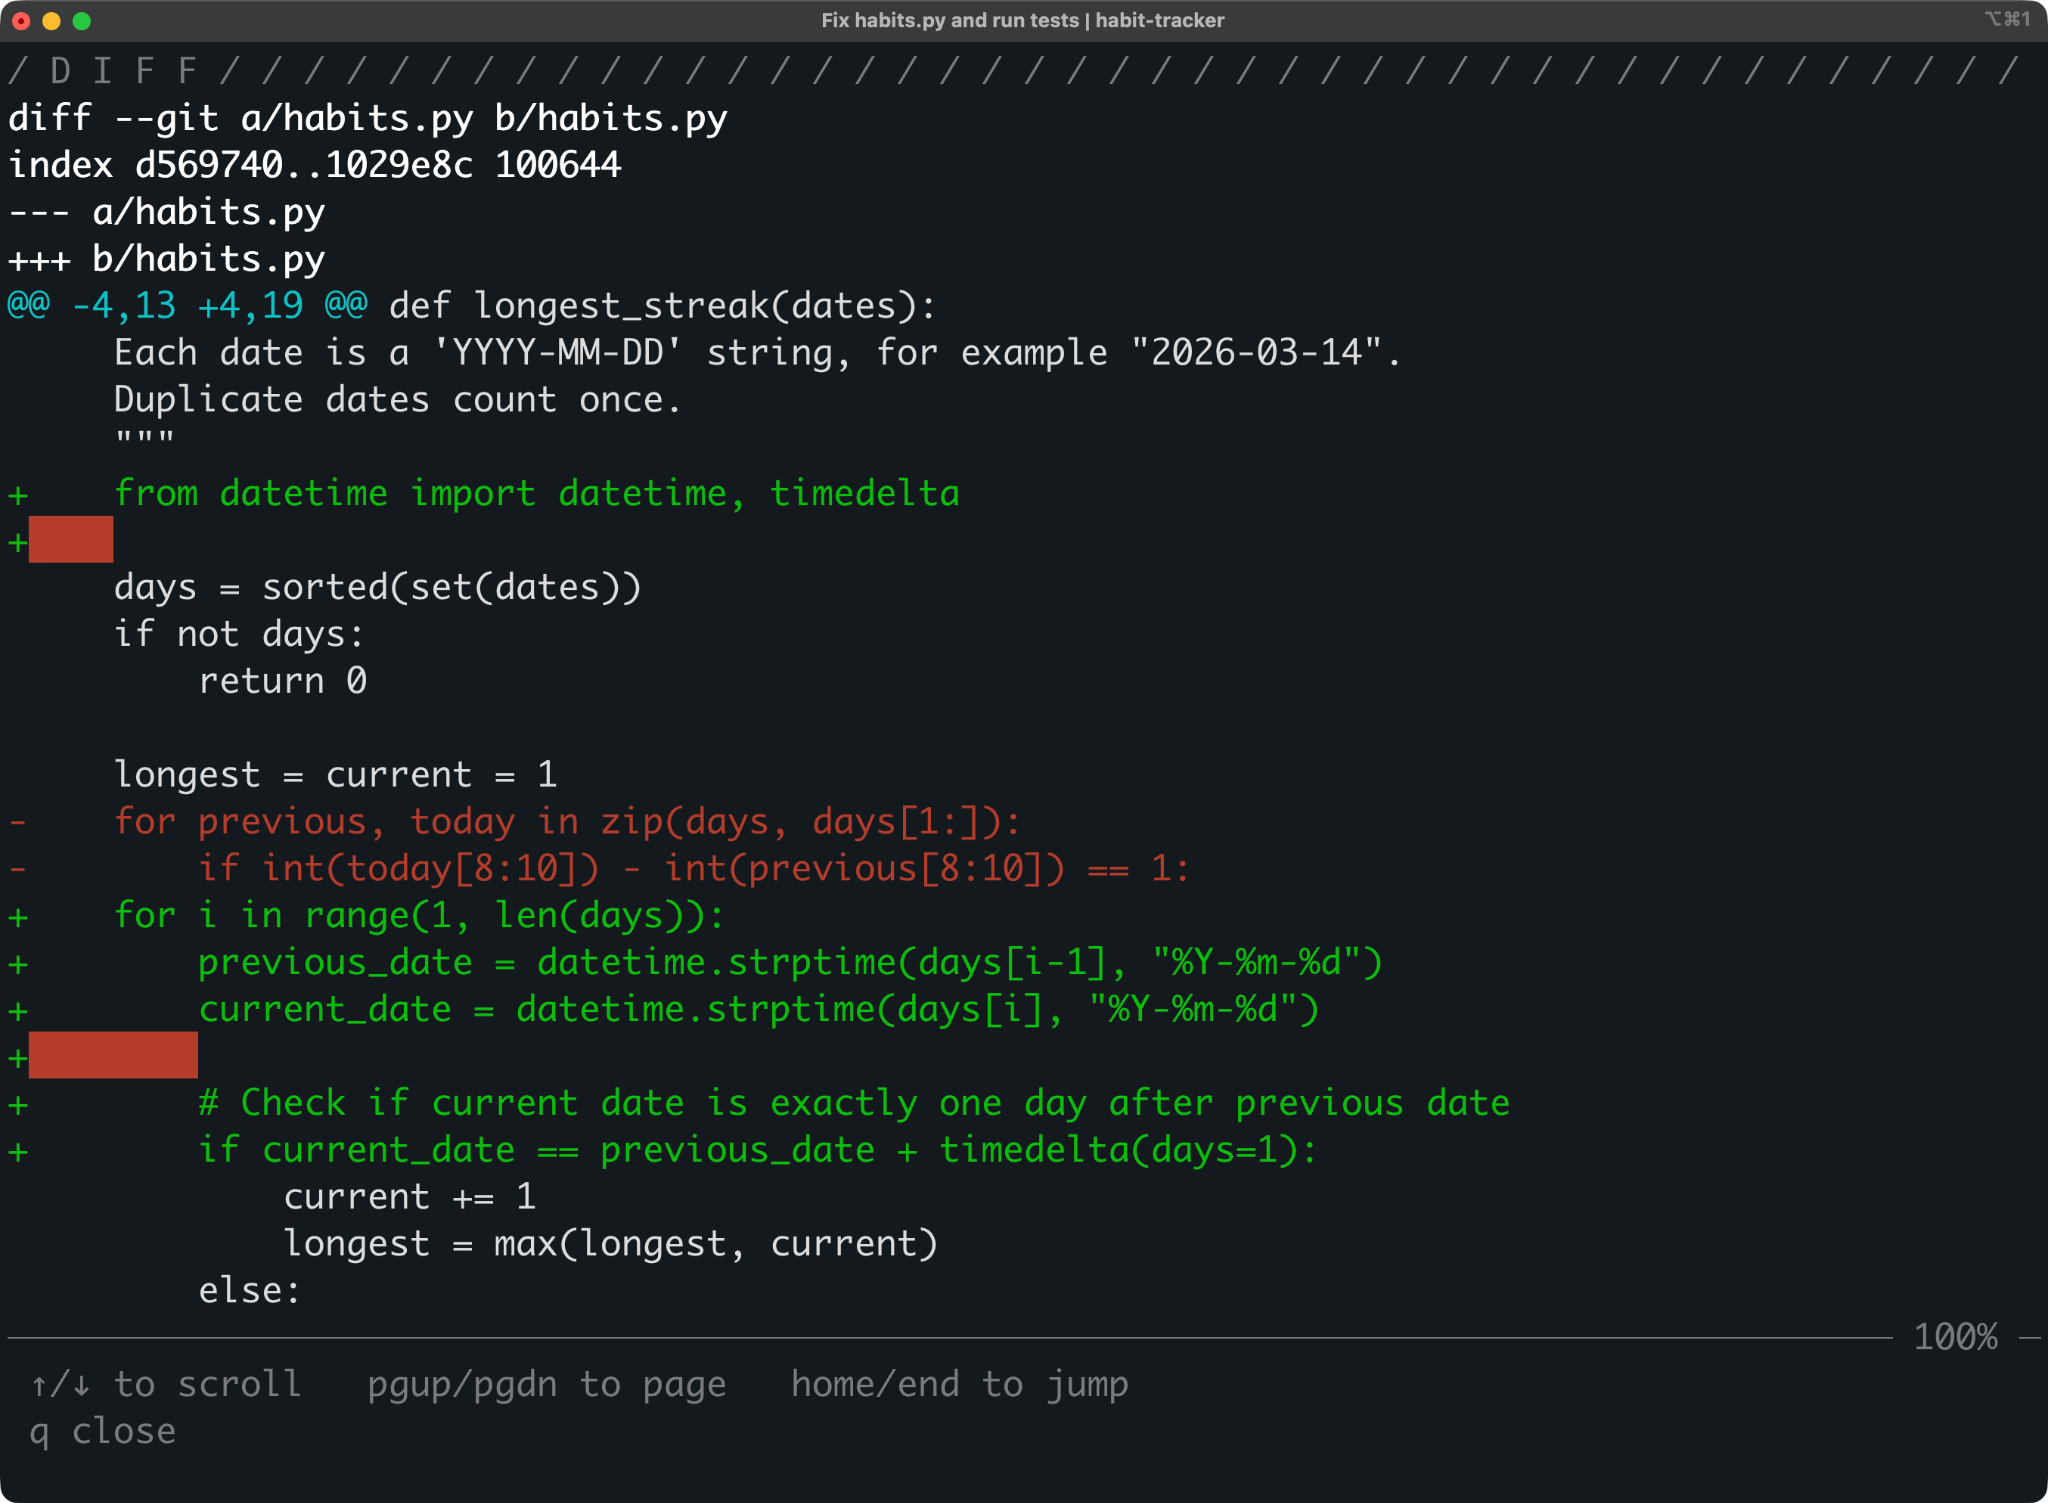
Open Interpreter 所做更改的 diff
具体 diff 取决于模型,所以您的结果可能与上方不完全一致。如果您认可更改,请提交;若不认可,恢复原文件:
git restore habits.py这就是理念所在。您描述问题,代理调查并修复,您在更改合入代码库前审阅每一处改动。
Open Interpreter 需要您自备模型。
每个请求都会经过三层:
| 层 | 示例 | 控制内容 |
|---|---|---|
| 提供方 | ollama | 请求发送到哪里以及如何认证 |
| 模型 | devstral-small-2 | 执行工作的模型 |
| 挂架 | native | 围绕模型的提示词、工具和消息格式 |
请求分层
您可以连接:
提供方列表来自公共模型目录,仅保留支持工具调用的模型。如果某个预期的模型不在列表里,原因通常在此。
注意 ollama-cloud,它是一个独立的托管提供方,您的请求会离开本机。只有内置的 ollama 才在本地运行模型。
您可以在三个层面更换模型:
会话内:运行 /model 选择提供方、模型和推理强度
单次运行:像上一节那样传入 -m 参数
设为默认:在配置文件中设置
随时运行 /status 查看当前提供方与模型。
Open Interpreter 从 ~/.openinterpreter/config.toml 读取设置。要把上一节的 Ollama 设置为默认,添加如下两行:
model_provider = "ollama"
model = "qwen3-coder:30b"
之后,直接运行 interpreter 即以该模型启动,无需任何参数。
托管提供方通过环境变量读取其 API Key。例如,DeepSeek 期望 DEEPSEEK_API_KEY:
export DEEPSEEK_API_KEY="your-api-key"您也可以将任意兼容 OpenAI 的端点添加为自定义提供方:
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
wire_api 用于告知 Open Interpreter 该端点期望的请求格式。OpenAI 兼容的 Chat Completions 用 chat,OpenAI Responses API 用 responses,Anthropic 风格端点用 messages。
受信任项目还可以包含自己的 .openinterpreter/config.toml,会覆盖用户配置。命令行参数优先级最高,会覆盖两者。如果不确定最终生效值,运行 /debug-config 查看有效设置及其来源。
模型决定代理对您代码的理解程度;挂架决定模型如何看待任务与工具。
两者缺一不可。优秀的模型若置于不匹配的挂架中,会发出格式错误的工具调用并误读结果;而好的挂架无法弥补一个不懂代码的模型。
因此在选择模型时,Open Interpreter 也会选择相应的挂架。例如:
Claude 系列模型使用 claude-code 挂架
Kimi 系列使用 kimi-code
Qwen 系列使用 qwen-code
DeepSeek 系列使用 claude-code-bare
针对其他模型家族,您可以通过 /harness 自行选择挂架。
需要记住的是,结果不佳并不总意味着模型弱。在切换模型前,先尝试为同一模型更换不同挂架。下一节将详细介绍。
挂架仿真是当前版本 Open Interpreter 存在的主要原因。
代理挂架指围绕模型的一切,使其成为“代理”。包括:
通俗地说,挂架决定模型如何看待任务,以及它的决策如何转化为动作。
Open Interpreter 内置一组挂架模式。以下是最常用的几种:
native:Open Interpreter 自家的挂架,继承自 Codex
claude-code:模拟 Anthropic 的 Claude Code 的提示词与工具界面
kimi-code:Moonshot 推荐给 Kimi 模型的 Kimi Code 挂架的 Rust 重实现
qwen-code:为 Qwen 模型模拟阿里巴巴的 Qwen Code CLI
swe-agent:模拟 SWE-agent,这是一个用于解决 GitHub issue 的研究代理
完整列表还包括 claude-code-bare、kimi-cli、deepseek-tui、zcode、minimal 等变体。在会话中运行 /harness 查看您的版本支持哪些模式。
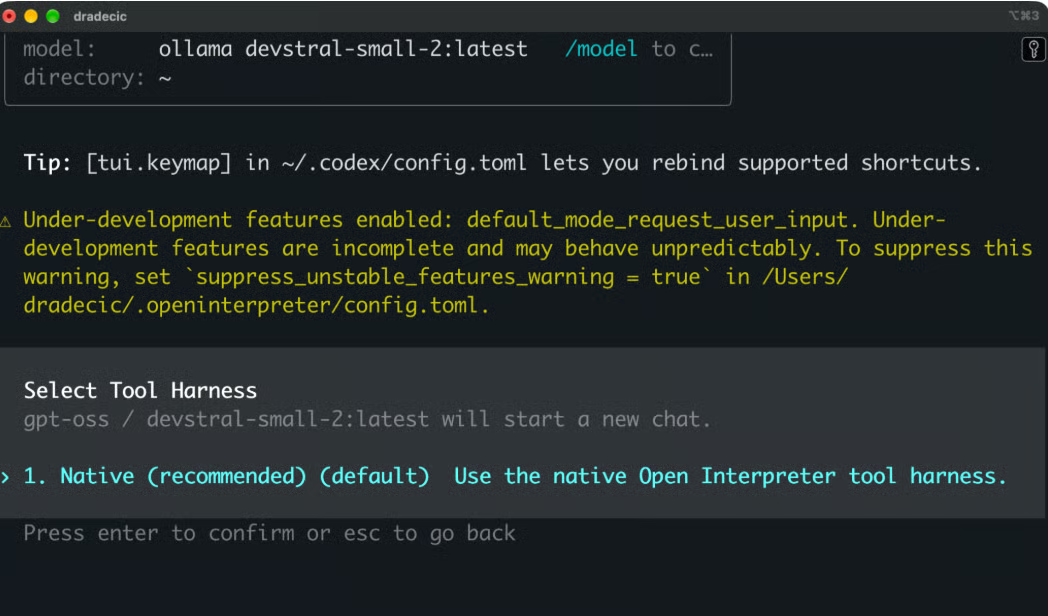
您可以在会话中通过 /harness 切换挂架,或在 ~/.openinterpreter/config.toml 中设置默认值:
harness = "kimi-code"
harness_guidance = true
harness_guidance 会在挂架允许时添加可靠性引导。如果您想要更严格的仿真效果,将其设为 false。若不设置 harness,Open Interpreter 会根据模型家族自动选择,就像上一节所示。
大多数模型厂商会在特定的代理设置中调校其编码模型,并发布与之配套的推荐挂架。
模型会习惯这个挂架。它会“学会”这种提示词风格、工具名称、文件编辑格式,以及工具结果返回的方式。
例如,您在一个期望“查找替换式”编辑的挂架里,运行了一个为“完整补丁文件”而调校的模型。模型知道要做什么更改,却始终用错误的格式来描述。代理循环消耗 token 却毫无进展。
工具结果也一样。如果挂架返回的结果格式是模型未见过的,模型就会误读;如果挂架在回合间清除了模型的推理内容,偏好“思考”的模型会失去自己的计划。
这意味着,同一个模型在不同代理中表现可能天差地别,尽管权重毫无改变。这也是编码基准测试通常会标注每次运行所用挂架的原因。
前沿模型往往能从陌生挂架中“自我恢复”,但更小更廉价的模型通常做不到。Open Interpreter 并不强迫每个模型适配一种格式,而是反过来调整格式以适配模型。
您可以用该演示项目亲自测试。先用 git restore habits.py 恢复原文件,再通过 /harness 切换挂架,并用相同提示语重新运行代理。然后比较它用了多少步、采用了怎样的编辑格式。
多数功能您已在文中见过。下面是它们在日常开发中的价值。
Open Interpreter 在您的 Git 仓库内工作。它读取项目结构并跟踪自身改动。
两个斜杠命令很有用:/diff 展示工作区变更,/review 要求代理在提交前检查当前改动的缺陷与回归。无需开启会话也能运行同样的检查:
interpreter exec review --uncommitted会话也会被保存。如果您在任务中途停止,使用 interpreter resume --last 可原地继续。
代理会运行与您相同的命令,例如测试套件、linter、构建脚本、包管理器等。所有命令在 macOS、Linux、Windows 的原生沙箱中执行。
长时间运行的命令可在后台执行。使用 /ps 列出它们,用 /stop 结束。
在脚本与 CI 中,使用 interpreter exec 无需交互界面即可运行任务:
interpreter exec "fix the failing test"您可以随时通过 /model 切换提供方与模型。切换后,您的配置、AGENTS.md 与技能依然生效。
配置文件中的“配置集(Profile)”很有用。比如您想用廉价模型做日常工作,用更强模型做代码评审。可以在配置中同时定义:
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
需要时用 interpreter --profile review 启动。
/harness 能在不更换模型的情况下,改变模型“看待任务”的方式。当模型在工具调用上吃力时,在改用更大模型之前,先尝试切换挂架。
模型上下文协议(MCP)将代理连接到其原本未设计对接的工具,例如文档服务器或数据库。您可以在配置中添加服务器:
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
运行 /mcp 查看已配置的服务器及其工具。default_tools_approval_mode 会让代理在使用该服务器的工具前先询问。
反过来也行。interpreter mcp-server 将 Open Interpreter 暴露为 MCP 服务器,interpreter acp 可在支持 Agent Client Protocol 的编辑器中运行它,后者是连接编辑器与编码代理的开放标准。
AGENTS.md 是您仓库中的一个 Markdown 文件,包含代理每个任务都会读取的项目规则。对于习惯记录器,它可以是:
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
您也可以运行 /init,由代理为您写出第一版。
“技能”是可复用的工作流,打包为 .agents/skills(项目级)或 ~/.agents/skills(用户级)中的文件夹。任务匹配时,代理会自动启用对应技能。运行 /skills 查看可用技能。
两者均为共享格式,因此同一份文件可用于其他支持它们的编码代理。Open Interpreter 还支持“hook”,可在会话指定节点运行自定义命令。通过 /hooks 进行审阅与信任。
两个设置决定代理的能力边界:
沙箱模式:read-only、workspace-write 或 danger-full-access
审批策略: untrusted、on-request 或 never
沙箱决定“能做什么”,审批策略决定“何时先询问”。在 workspace-write 配合 on-request 的情况下,代理可以编辑您的项目并运行测试,但在需要更高访问权限前会先征求同意。
可通过 /permissions 或 -s、-a 参数更改二者。另有 --yolo 参数可绕过两者,文档将其标注为危险。安全部分我会更详细说明。
Open Interpreter 自称是为低成本模型打造的编码代理。
大型专有编码代理通常围绕自家模型构建。Open Interpreter 则提供一个代理,可同时适配专有模型、托管的开源权重模型与本地模型。
Kimi、DeepSeek、GLM、Qwen 等开源权重模型公开了权重。您既可通过第三方提供方使用,也可在自有硬件上运行。
这带来两点好处:托管的开源权重模型每 token 成本通常低于前沿专有模型;而且您不受限于某一家主机,因为同一个模型在任何能运行其权重的地方都能跑起来。
Open Interpreter 为 Kimi K3、DeepSeek、GLM 提供了专门的提供方指南,也会为这些模型家族选择匹配的挂架。
Ollama 与 LM Studio 是内置提供方,您可以在本机运行模型,无需 API Key,也没有按 token 计费。
代价是硬件。当我在配有 64GB 统一内存的 MacBook Pro M1 Max 上测试 devstral-small-2 时,仅模型就占用了 26GB。Ollama 的默认上下文窗口对于代理循环太小;将其设为 128k token 后,内存占用持续起伏,最终会话停滞。
编码代理需要大的上下文窗口,因为系统提示词、工具定义、文件内容和命令输出都要装进去。Ollama 建议 Codex 风格代理至少使用 64k token 的窗口。更大的上下文窗口还会在模型之外额外占用更多内存。
Open Interpreter 在您的机器上运行,但模型不一定如此。
您的代码会去往哪里,取决于提供方:
无论如何,您的配置、会话与日志都会本地存储在 ~/.openinterpreter 下。
如需更高控制力,您可以添加指向自家推理服务器的自定义提供方。任何兼容 OpenAI API 的服务器都可以,比如在公司 GPU 上部署的 vLLM。这样您得到的是“托管式”的架构,但基础设施属于您自己。
开源模型的工具调用能力参差不齐。较差的工具使用会表现为调用格式错误、循环、过早停止,或忽视命令输出。
合适的挂架有帮助,但无法拯救一个无法规划多步骤任务的模型。体量较小的本地模型问题最明显。
在让新模型用于真实项目之前,先在小型仓库(如本文的习惯记录器)上测试。如果出现弱项,在换更大模型前,先尝试不同挂架。
以下是选项速览:
| 推理运行位置 | 成本 | 代码是否离开本机? | |
|---|---|---|---|
| 专有托管模型 | 厂商服务器 | 按 token 或订阅 | 是 |
| 开源权重托管模型 | 提供方服务器 | 按 token,通常更低 | 是 |
| 开源权重本地模型 | 您的硬件 | 硬件与电力 | 否 |
Open Interpreter 面向本地与开源模型的选项
Open Interpreter 与其他终端型编码代理有很多共通点。差异主要在于工具归属与模型适配对象。
Claude Code 是 Anthropic 的终端编码代理。首先在归属上不同——Claude Code 是专有软件,而 Open Interpreter 以 Apache 2.0 许可开源。您可以阅读并修改 Open Interpreter 的每个部分。
其次是模型选择。Claude Code 为 Claude 模型打造。您可以将其指向其他提供方的 Anthropic 兼容端点,但其挂架仍为 Claude 调校。Open Interpreter 则将模型选择视为核心特性。
挂架比较更有意思。Claude Code 本身就是 Open Interpreter 可仿真的挂架之一。启用 claude-code 模式后,任何模型都能在 Open Interpreter 运行时中获得 Claude Code 风格的提示词与工具。界面与斜杠命令仍是 Open Interpreter 的,因此它并不是“同款产品 + 不同模型”。
两款工具都以终端为先。各自拥有交互式会话与脚本/CI 的非交互模式。项目说明文件方面,Claude Code 读取 CLAUDE.md,Open Interpreter 使用共享的 AGENTS.md 格式。
Claude Code 生态更大:IDE 扩展、桌面与 Web 应用、插件市场、子代理与 SDK 一应俱全。Open Interpreter 较年轻,更多依赖 MCP、技能、AGENTS.md、Agent Client Protocol 等共享标准,而非自有生态。
若您主要使用 Claude 模型并追求最打磨完善的体验,Claude Code 更稳妥。若您希望运行其他模型或避免专有工具,选择 Open Interpreter。
OpenCode 与其最为接近。两者皆为开源、终端优先,并支持长名单的模型提供方。
纸面上的模型支持相近。OpenCode 支持 75+ 提供方,Open Interpreter 则从公共模型目录生成提供方列表。两者都通过 Ollama 运行本地模型。
终端体验差异更大。OpenCode 拥有自己的 TUI 并集成 LSP(语言服务器协议),可将类型错误等诊断反馈给模型。Open Interpreter 的 TUI 源自 Codex。
配置方面,OpenCode 使用 opencode.json,Open Interpreter 使用带有配置集的 config.toml。
代理架构是主要差异。OpenCode 以“客户端-服务器”方式运行,TUI 是本地服务器的一个客户端,其他客户端也可连接。它内置 build 与 plan 代理,并支持自定义代理与子代理。它会为不同模型家族调整系统提示词,但工具与循环仍是 OpenCode 自家的。Open Interpreter 走得更远,会替换整个挂架,包括工具 schema 与消息格式。新版甚至包含一个 opencode 挂架模式。
开发层面,OpenCode 由其团队与社区独立开发。Open Interpreter 则基于 Codex 分支,运行时的大部分来自上游。这是一种权衡:Open Interpreter“白拿”了 Codex 的沙箱与运行时,而 OpenCode 则完全掌控自有技术栈。
二者并非传统意义上的竞品。Open Interpreter 是 Codex 的一个分支。
两者共享 Rust 运行时、TUI、沙箱、审批、AGENTS.md、技能、MCP、exec 模式和多数斜杠命令。我运行 Open Interpreter 时,会话恢复提示仍显示 codex resume。
Codex 是 OpenAI 的代理,围绕 OpenAI 模型构建。它支持使用 --oss 运行本地模型与自定义提供方,但默认体验瞄准 OpenAI。
Open Interpreter 在几个方向上扩展了 Codex:
挂架仿真: 针对不同模型家族更换提示词、工具 schema 与消息格式
提供方支持: 具备生成的提供方目录,并为 Kimi K3、DeepSeek、GLM 提供专门指南
Chat Completions: --chat-completions 参数可运行任意兼容 OpenAI 的提供方
Codex SDK 覆盖: 基于 Codex SDK 构建的应用可通过 Open Interpreter 来运行
Open Interpreter 也会将配置与会话存放在 ~/.openinterpreter,因此不会与 Codex 安装产生冲突。
如果您主要使用 OpenAI 模型,Codex 更合适;若您使用其他模型,Open Interpreter 能提供相同工作流,同时对这些模型支持更好。
下面是快速回顾:
| 许可 | 模型 | 挂架方案 | 配置 | |
|---|---|---|---|---|
| Open Interpreter | 开源(Apache 2.0) | 任意提供方,托管或本地 | 按模型仿真挂架 | config.toml |
| Claude Code | 专有 | 为 Claude 模型打造 | Claude Code 自有挂架 | settings.json 与 CLAUDE.md |
| OpenCode | 开源(MIT) | 75+ 提供方,托管或本地 | 一套挂架,按模型家族微调提示词 | opencode.json |
| Codex | 开源(Apache 2.0) | 为 OpenAI 模型打造,支持 --oss | Codex 自有挂架 | config.toml |
Open Interpreter 与其他 AI 编码代理对比
聊天机器人最糟也只是给出坏答案,您可以忽略。但编码代理会在您的机器上运行命令、读写文件并可访问网络。模型的错误决策或提示注入都可能造成实际损害。提示注入指的是隐藏在代理读取内容中的指令,例如 README 或网页。
Open Interpreter 继承了 Codex 运行时的安全模型。它有两层机制——限制“能做什么”的沙箱,以及决定“何时先询问”的审批策略。
代理运行的每条命令都会通过操作系统级沙箱(macOS、Linux、Windows)。沙箱模式有三种:
read-only:代理可读文件,但不可更改任何内容
workspace-write:代理可在项目文件夹内编辑文件并运行命令
danger-full-access:无沙箱限制
在 workspace-write 模式下,文件写入仅限于活动工作区。代理可以修复您的代码,但不能编辑机器上其他位置的文件。
在 workspace-write 模式下,命令默认无网络访问。这会阻止下载,并避免代理将您的代码发送到外部。
某些任务需要网络,例如安装依赖。您可以在配置中开启网络访问:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
仅在需要的项目中开启。
审批策略决定代理何时暂停并询问:
untrusted:在运行不在信任列表中的命令前先询问
on-request:当任务需要超出沙箱允许的访问时询问
never:从不询问
对纳入版本控制的项目而言,workspace-write 搭配 on-request 是较好的默认值。代理在项目范围内工作,超出范围前会先询问;若出问题,Git 也能帮您回退。
--yolo 参数会同时关闭沙箱与审批。仅在一次性环境(如容器或虚拟机)中使用。
代理运行的命令会继承您的 shell 环境。如果 API Key 存放在环境变量中,这些命令可以读取到它们。
您可以用 shell_environment_policy 加以限制:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
core 仅传递基础变量(如 HOME、PATH),exclude 排除匹配模式的变量。
文件也是风险点。即便在 read-only 模式下,代理也能读取项目中的 .env 文件。若使用托管提供方,代理读取到的任何内容都会发送至该提供方的服务器。
需要记住的是,沙箱能降低风险,但请将其视作安全网而非绝对保证。
在让代理自行运行前,先用 /status 检查沙箱模式与审批策略。
如果您看到一篇以 pip install 开头的 Open Interpreter 文章,它并没错,只是讲述的是不同的项目。
最初的 Open Interpreter 于 2023 年以 Python 项目推出。它允许语言模型在您的机器上运行 Python、JavaScript 与 shell 代码,被视作 ChatGPT Code Interpreter 的开源替代。后续版本增加了电脑控制能力,使模型也能操作桌面。
当前主项目是基于 Codex 的 Rust 重写,专注于编码代理与挂架仿真,而非通用的电脑控制。
Python 版本并未消失,它以社区分支继续维护,地址为 endolith/open-interpreter。
两版项目名称相同、共享同一 GitHub 仓库历史,并使用相同的 interpreter 命令,因此很容易混淆。
但有个非常直观的判断方法:
pip install open-interpreter:旧版 Python 项目
curl 或 PowerShell 安装脚本:当前 Rust 版本
Open Interpreter 并非每种场景的最佳工具。以下是适用与不适用的情况。
开源: 采用 Apache 2.0 许可,您可以阅读、审计并分叉整个代码库
模型选择: 在单一代理中使用托管、开源权重与本地模型,并可在会话中切换
多种代理挂架: 更接近模型被调校时的表现,少有其他编码代理能提供
终端原生开发: 无缝融入您的 Shell 与 Git 工作流,exec 模式适用于脚本与 CI
开放且更低成本的模型: 项目围绕它们打造,提供专门的提供方指南与匹配挂架
可扩展性: MCP、技能、hook、AGENTS.md、Agent Client Protocol,以及 Codex SDK 覆盖,让其能连接其他工具
模型质量不一: 代理的上限取决于背后的模型;再好的挂架也无法拯救不会规划多步骤任务的模型
本地模型需要强劲硬件: 我的测试中,仅 devstral-small-2 就占 26GB 内存,尚未算上编码代理需要的大上下文窗口
设置工作更多: 您需要自行管理提供方、上下文窗口、挂架与沙箱设置。也有一些粗糙之处,如残留的 Codex 品牌标识,以及针对 Ollama 模型的元数据警告
命令执行存在风险: 沙箱与审批可以降低风险,但不能完全消除
代码仍需审阅: 测试通过不代表修复一定正确,您仍需阅读每个 diff
Open Interpreter 是一个开源编码代理,可与您选择的模型协同工作,无论该模型是托管、开源权重,还是在您自己的机器上运行。
工作流很简单。您选择模型与挂架,指向一个项目,让代理进行检查、编辑并运行命令,直到任务完成。然后您审阅它的成果。
挂架仿真使其与竞品不同。Open Interpreter 并不强迫所有模型适配同一代理设置,而是调整设置以适配模型,这可能成为成败关键。模型决定工作质量,权限决定代理能修改什么。您的审阅是改动进入代码库前的最后一道关。
如果您想获得 AI 工程师认证,请报名我们的 面向开发者的副高级 AI 工程师学习路径,循序渐进迈入 AI 世界。
与 DataCamp 一起学习
学习路径
学习路径
学习路径