Leerpad
Associate AI Engineer voor ontwikkelaars
26 uur
Als je ooit een open-weight model hebt gedraaid in een codingagent die voor een ander model is gebouwd, weet je dat dat geen geweldig idee is.
Het model leest toolschema’s meestal verkeerd en voert hetzelfde mislukte commando uit totdat jij het stopt. Ga je terug naar het model waarvoor de agent is gebouwd, dan loopt dezelfde taak zonder problemen door. Het probleem zit meestal niet in het model, maar in de agent-harness eromheen, omdat de prompts en toolformaten voor iemand anders zijn afgestemd.
Open Interpreter lost dit op door de harness te emuleren waarvoor elk model is getuned, zoals Claude Code of Kimi Code. Het is een open-source AI-codingagent die je vanuit je terminal draait, en de huidige versie is een Rust-project dat op OpenAI’s Codex is gebouwd, niet de Python-gebaseerde computerassistent die je je misschien herinnert.
In dit artikel neem ik je mee door installatie, model- en harness-setup, een hands-on codingworkflow, en hoe Open Interpreter zich verhoudt tot Claude Code, OpenCode en Codex.
Nieuw met AI-agents? Schrijf je in voor onze Introduction to AI Agents-cursus en leer de basis in één middag.
Open Interpreter geeft een AI-model toegang tot je project en de tools die een developer daarvoor zou gebruiken.
Je hoeft een taak alleen in gewoon Engels te beschrijven, en de agent werkt aan je code. Hij kan werken met:
Het project is open source onder de Apache 2.0-licentie. Het is ook niet beperkt tot één modelprovider. Je kunt het verbinden met gehoste modellen, open-weight modellen of modellen die lokaal op je eigen machine draaien.
De hoofdrepository heeft meer dan 68.000 GitHub-sterren, per september 2026.
Open Interpreter werkt in een loop:
Sommige stappen vereisen eerst je goedkeuring, afhankelijk van de machtigingen. Die behandel ik in de beveiligingssectie.
Hier is een visueler overzicht:
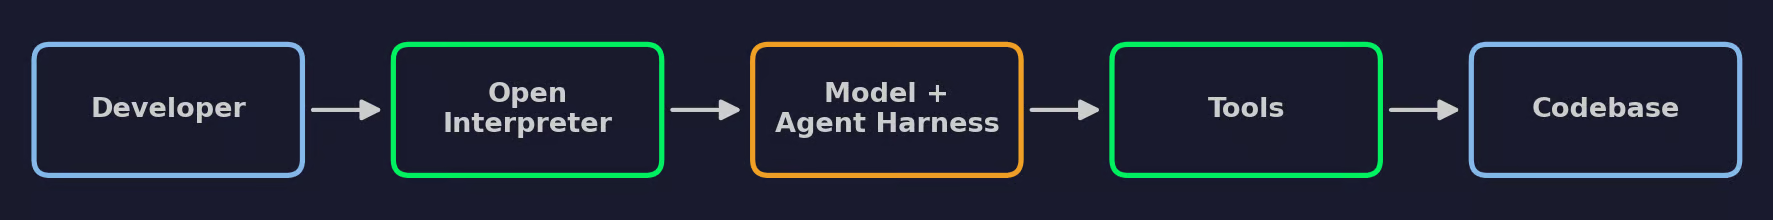
Hoe Open Interpreter werkt
Onthoud hierbij dat je niet rechtstreeks met het model praat. Open Interpreter stuurt jouw taak naar het model, geformatteerd met de prompts en tooldefinities van de actieve harness. Het model vraagt om tool-calls, en Open Interpreter draait die op jouw codebase. Vervolgens gaan de resultaten terug naar het model voor de volgende stap.
Omdat het model en de harness aparte lagen zijn, kun je elk van beide wijzigen zonder iets anders in de setup aan te passen.
Open Interpreter installeert als een zelfstandige binary, dus je hebt geen Python of pip nodig.
Als een ouder blog je vertelt pip install open-interpreter te draaien, beschrijft dat de legacy Python-versie. Dat commando levert je niet de Rust-gebaseerde codingagent die ik in dit artikel bespreek.
Je wilt ook Git op je machine. Open Interpreter draait zonder, maar met Git krijgt hij een repository-bewuste sessie en diffs.
Draai het installatiescript vanuit je terminal:
curl -fsSL https://www.openinterpreter.com/install | shHet script downloadt de juiste release voor jouw platform en plaatst het interpreter-commando in ~/.local/bin.
Open PowerShell en draai:
irm https://www.openinterpreter.com/install.ps1 | iexWSL wordt ook ondersteund als je een Linux-achtige setup wilt. Draai in dat geval het macOS- en Linux-commando in je WSL-terminal.
Start je terminal opnieuw zodat de nieuwe PATH wordt opgepikt, en check dan de versie:
interpreter --versionZie je een versienummer, dan is de installatie gelukt.
Open Interpreter versiecheck
Start een sessie vanuit een willekeurige map:
interpreterJe kunt ook i typen, een korte alias voor hetzelfde commando.
Open Interpreter opent een terminal-UI waarin je taken in gewoon Engels beschrijft. De eerste keer dat je het start, vraagt het je een modelprovider te koppelen. Ik gebruik in de volgende sectie een lokaal model via Ollama, dus je kunt deze stap nu overslaan.
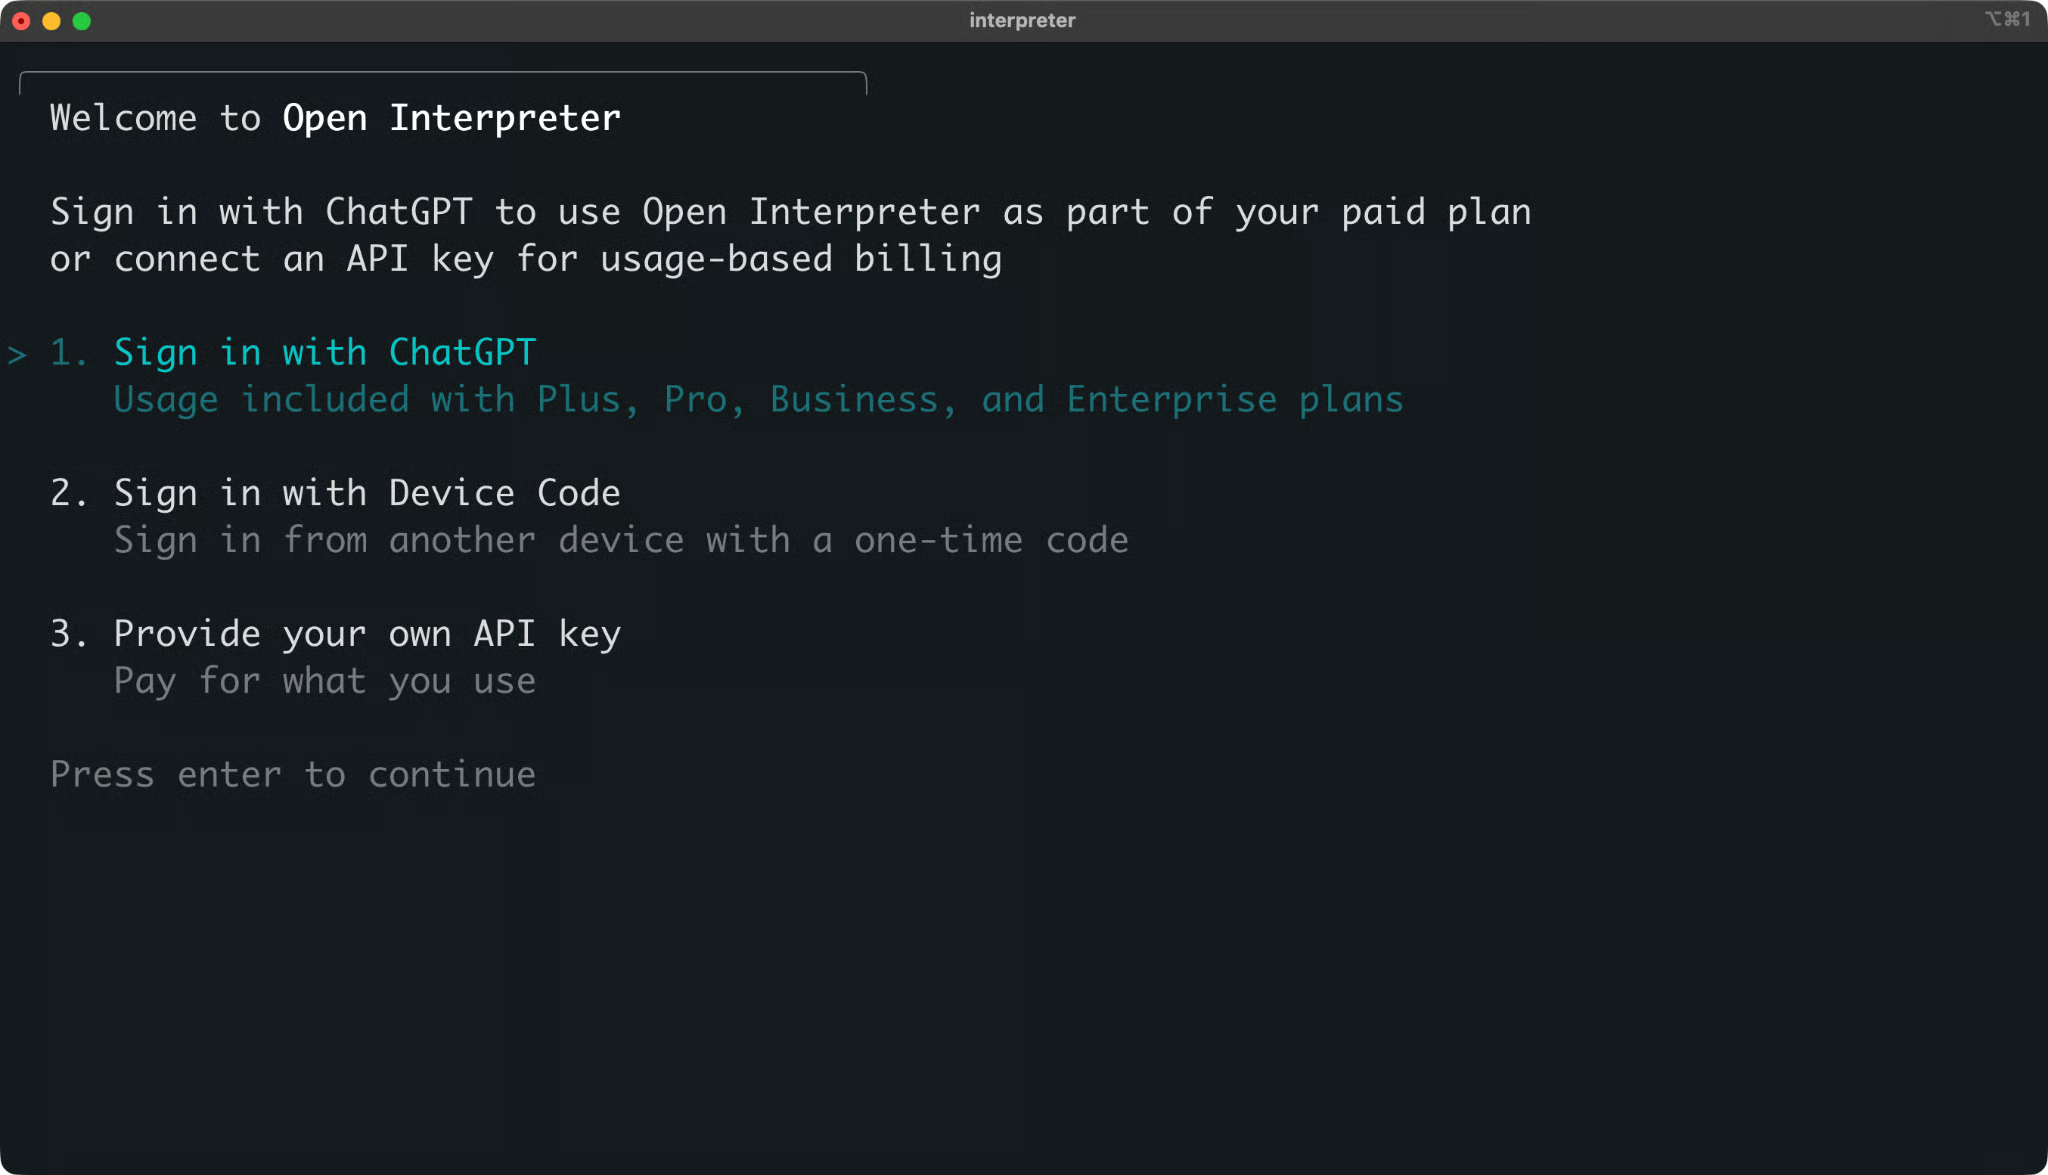
Open Interpreter interactieve sessie
Typ /exit om de sessie te verlaten.
De snelste manier om een codingagent te begrijpen is hem een taak geven en zien wat hij ermee doet.
Ik gebruik voor deze hele sectie een klein habit-trackerproject. Het heeft één functie, één testbestand en één bug.
Het project berekent de langste reeks aaneengesloten dagen voor een gewoonte. Het telt bijvoorbeeld hoeveel dagen op rij je hebt gesport.
Begin met een projectmap en een virtuele omgeving:
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
Maak habits.py met de volgende code:
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
Maak daarna test_habits.py aan:
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
De functie heeft een bug. Ik wijs hem niet aan, want hem vinden is de taak van de agent.
Voeg een .gitignore-bestand toe zodat de virtuele omgeving en cachebestanden buiten de repository blijven:
.venv/
__pycache__/
.pytest_cache/
Commit nu het project:
git init
git add .
git commit -m "Initial commit"
Deze commit geeft je een schoon startpunt. Later gebruik je hem om precies te zien wat de agent heeft veranderd.
Draai de tests om de bug te bevestigen:
python -m pytest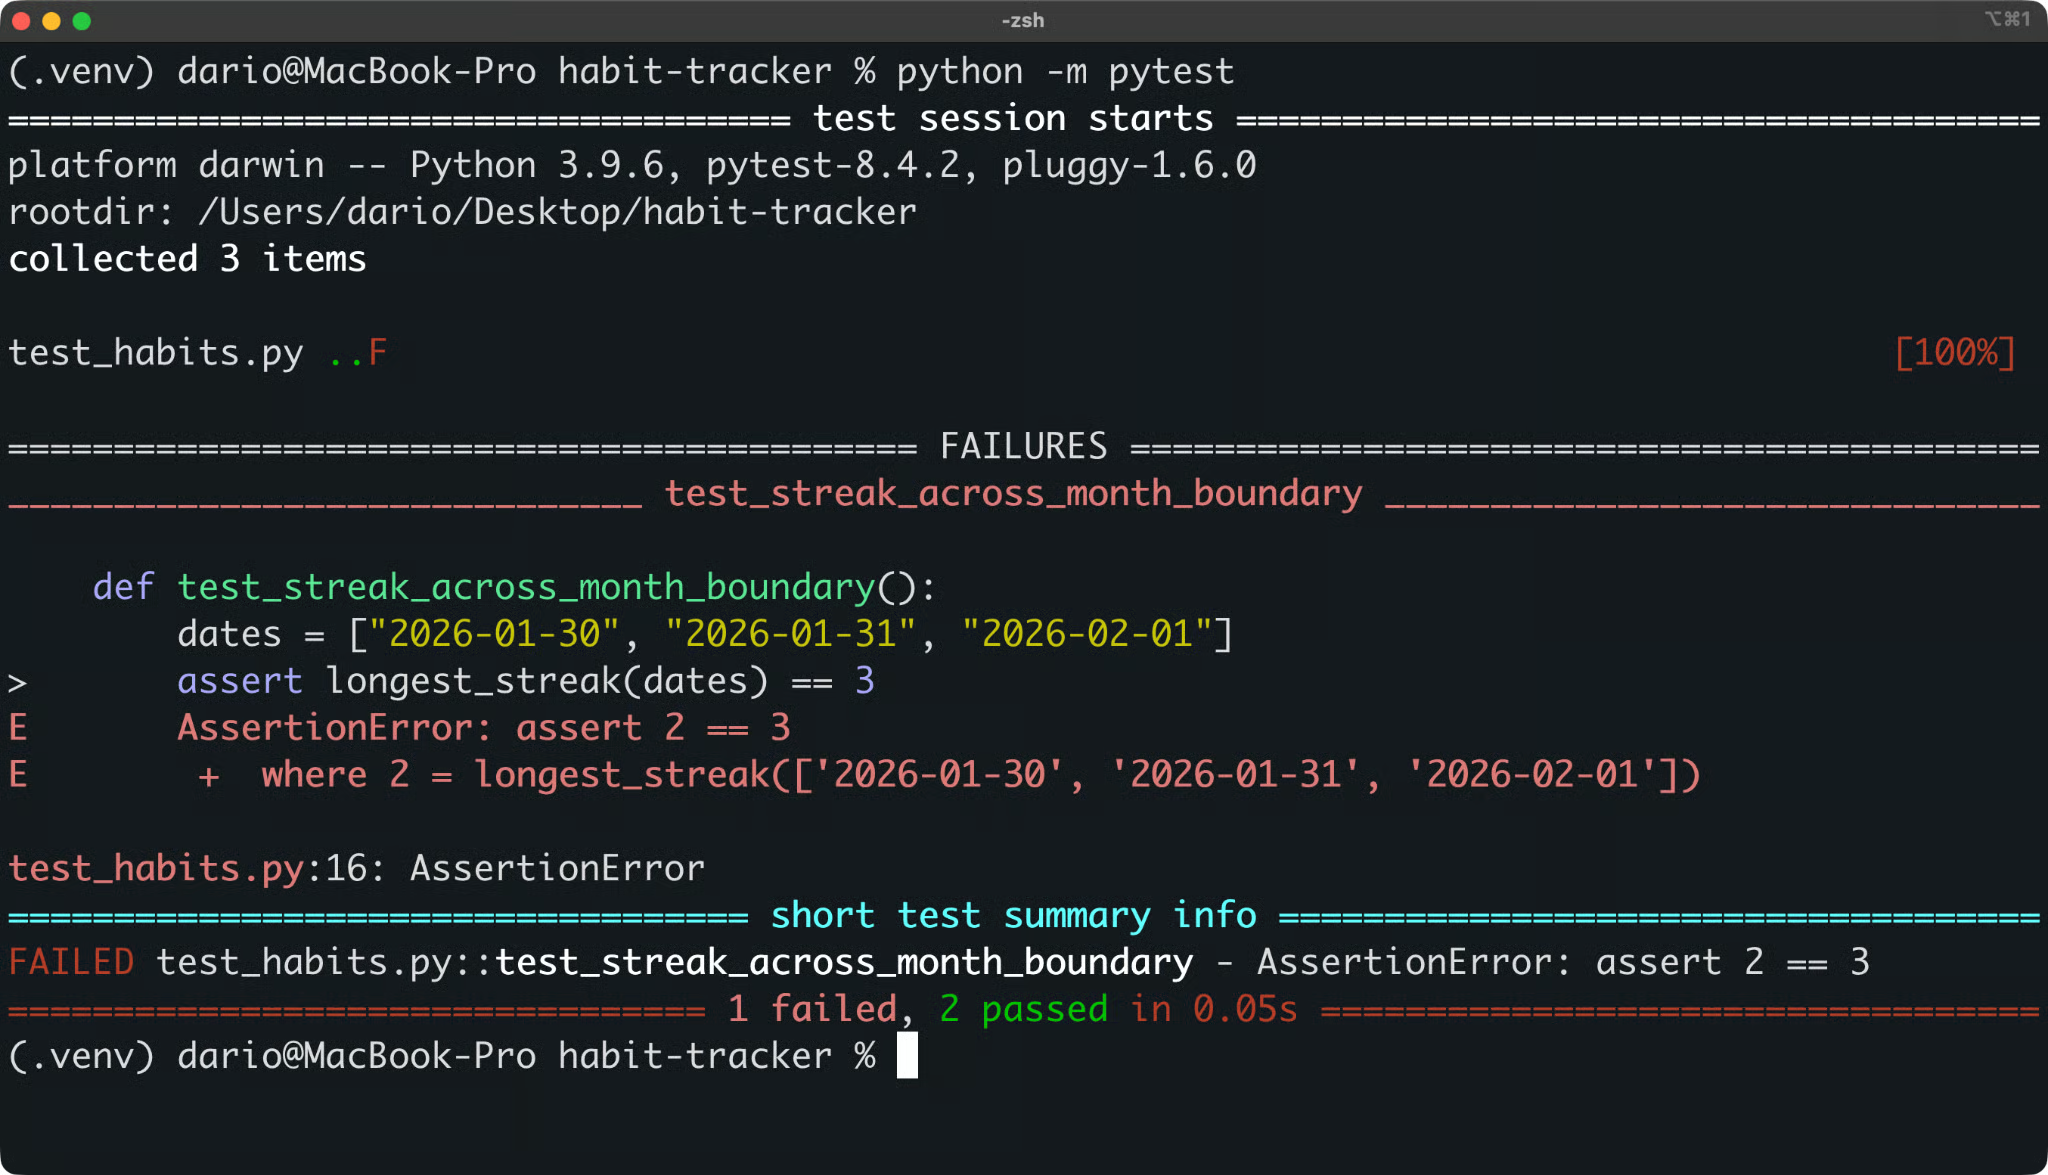
Testresultaat habit-tracker
Twee tests slagen en één faalt. Dat is het probleem dat Open Interpreter moet oplossen.
Je hebt Ollama nodig, geïnstalleerd en draaiend. Je hebt ook een model nodig dat tool-calling ondersteunt, dus pull het:
ollama pull qwen3-coder:30bStart daarna Open Interpreter vanuit de projectmap. Gebruik dezelfde terminal, zodat de agent de pytest-installatie uit je virtuele omgeving kan gebruiken:
interpreter --oss --local-provider ollama -m qwen3-coder:30bDit doet elke flag:
--oss: gebruikt een lokale open-sourceprovider
--local-provider ollama: kiest Ollama boven LM Studio
-m qwen3-coder:30b: stelt het model in voor deze run
Draai /status om de actieve provider, het model, de sandboxmodus en het goedkeuringsbeleid te bevestigen.
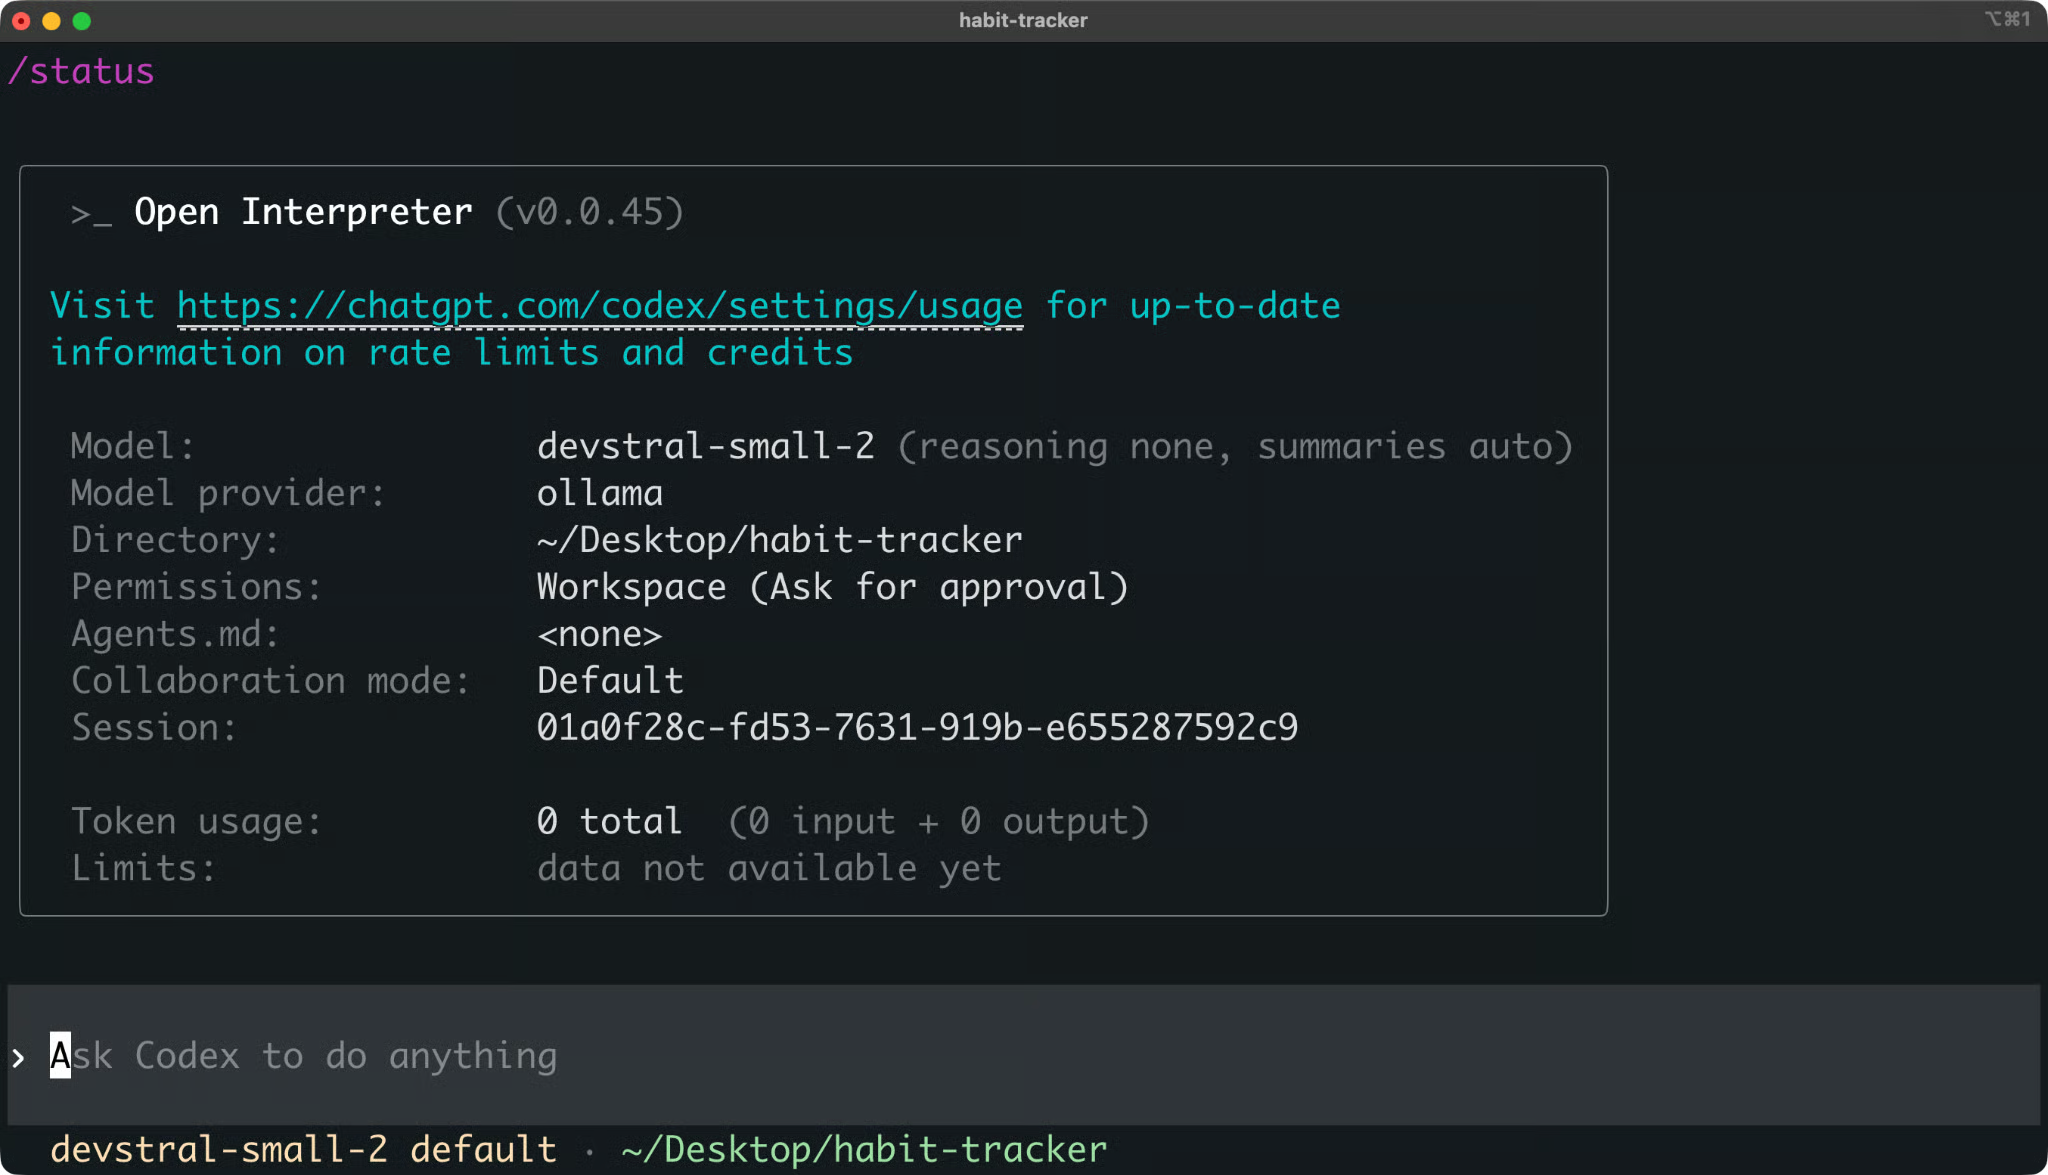
Open Interpreter-sessie met een lokaal Ollama-model
Je wilt niet dat de agent nu al iets bewerkt. Vraag eerst om een diagnose:
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.De agent leest meestal de bestanden en draait de tests voordat hij antwoordt. Commando’s draaien in de sandbox, en als de agent meer toegang nodig heeft dan de sandbox toestaat, vraagt hij eerst om jouw goedkeuring.
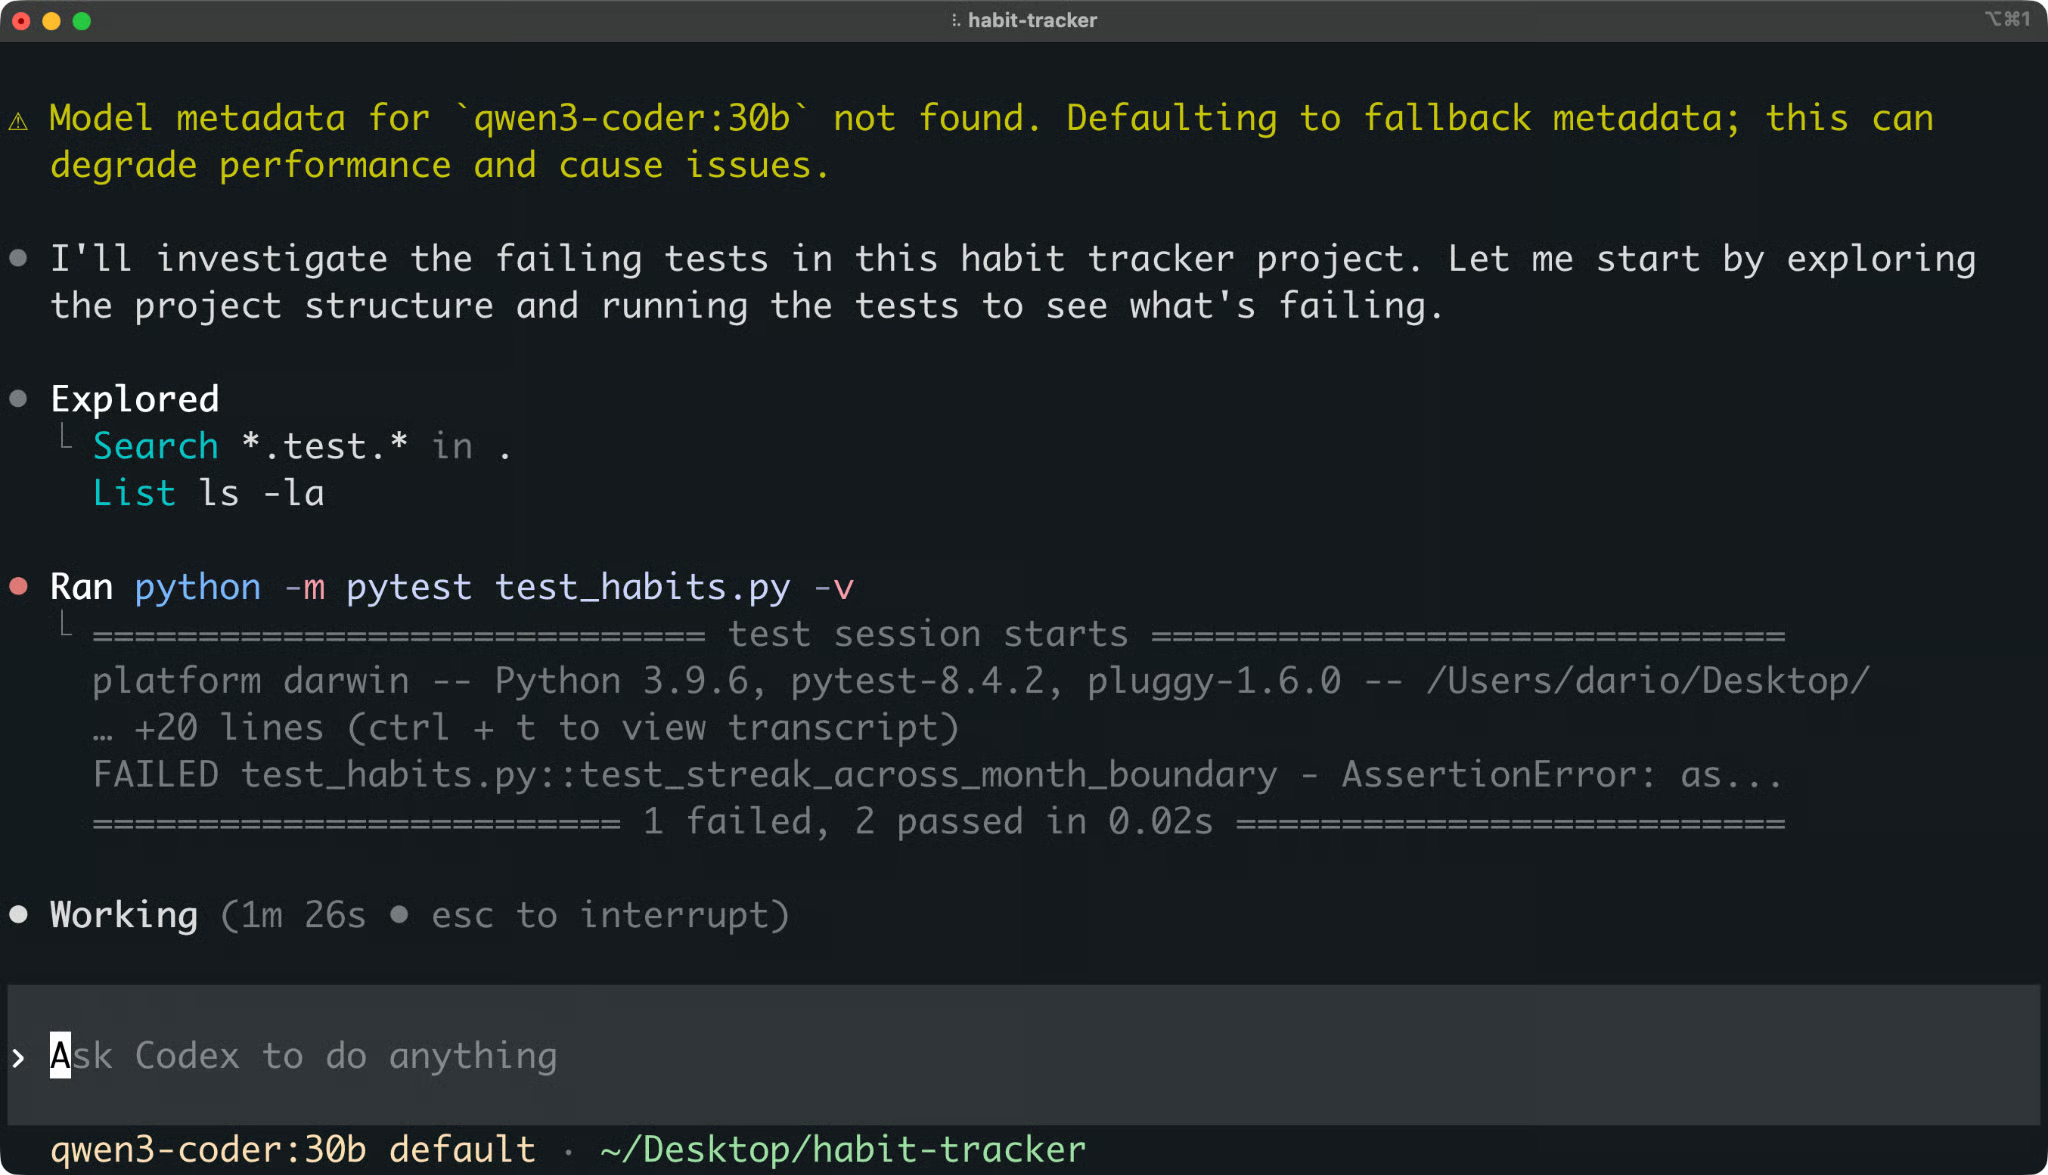
Open Interpreter-output
Lees de uitleg voordat je iets goedkeurt.
Een correcte diagnose zegt dat de functie alleen de dag van de maand vergelijkt, waardoor een reeks wordt onderbroken zodra die de grens naar een nieuwe maand passeert. Een goede fix vergelijkt volledige datums, bijvoorbeeld met date.fromisoformat() uit Pythons datetime-module.
Is de diagnose onjuist, corrigeer die dan in dezelfde sessie voordat de agent code bewerkt.
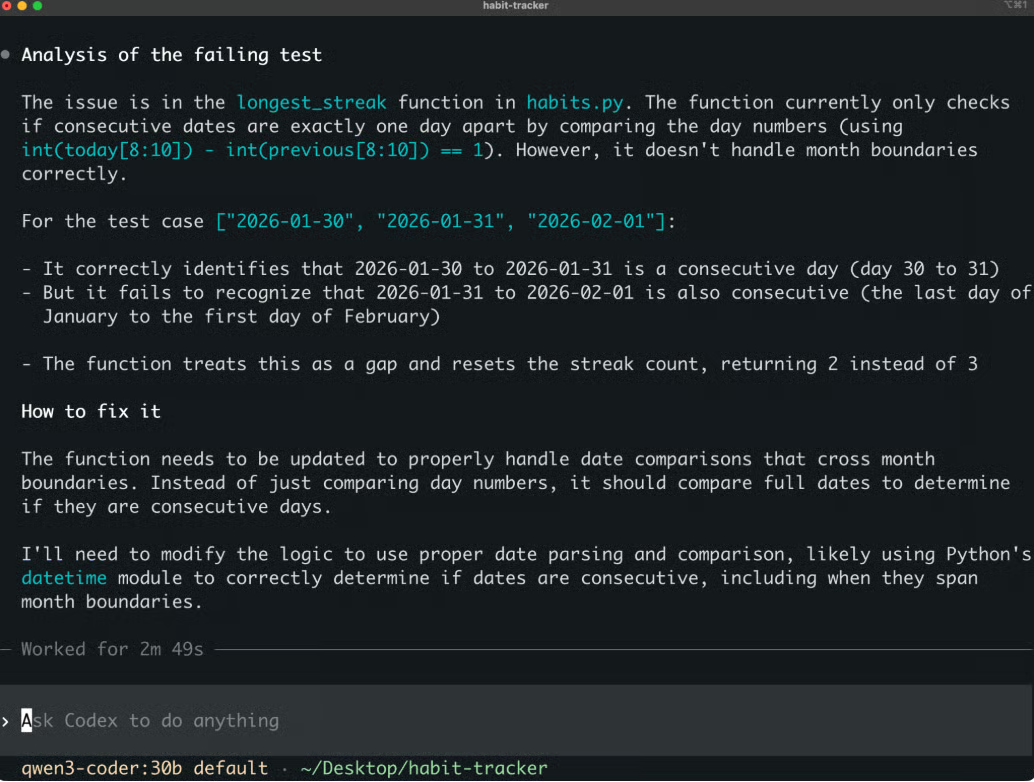
Voorstel voor Open Interpreter-fix
Ben je blij met het plan, implementeer dan de fix:
Apply the fix to habits.py, then run the tests.De agent bewerkt het bestand en draait pytest opnieuw. Je wilt alle drie tests zien slagen.
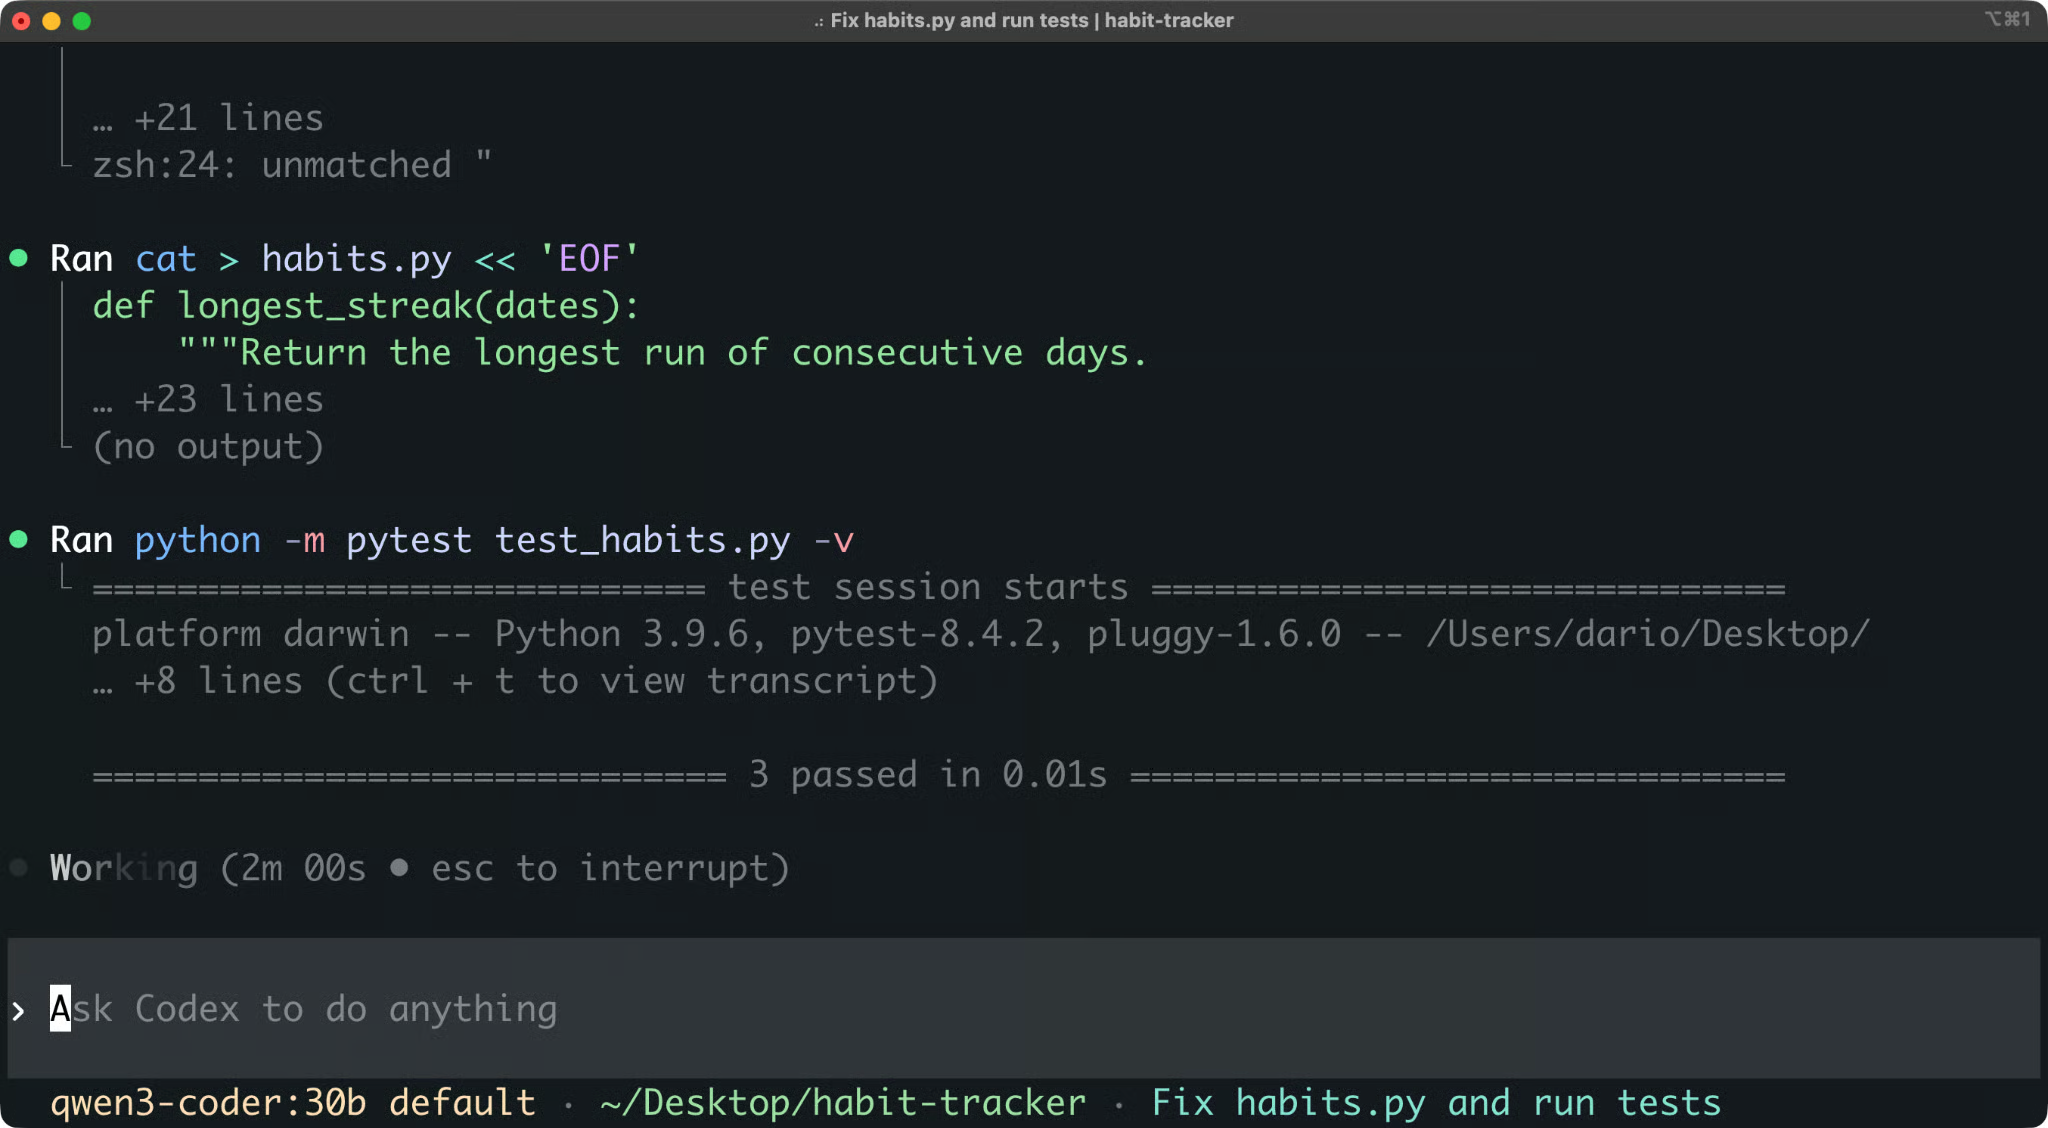
Alle tests slagen na de fix
Een geslaagde test betekent niet per se dat de bug in je code is opgelost. Misschien is de test bijgewerkt om de bug te omzeilen. Je moet de code alsnog reviewen.
Draai /diff in de sessie om de wijzigingen in de working tree te zien. Je kunt ook git diff draaien nadat je afsluit.
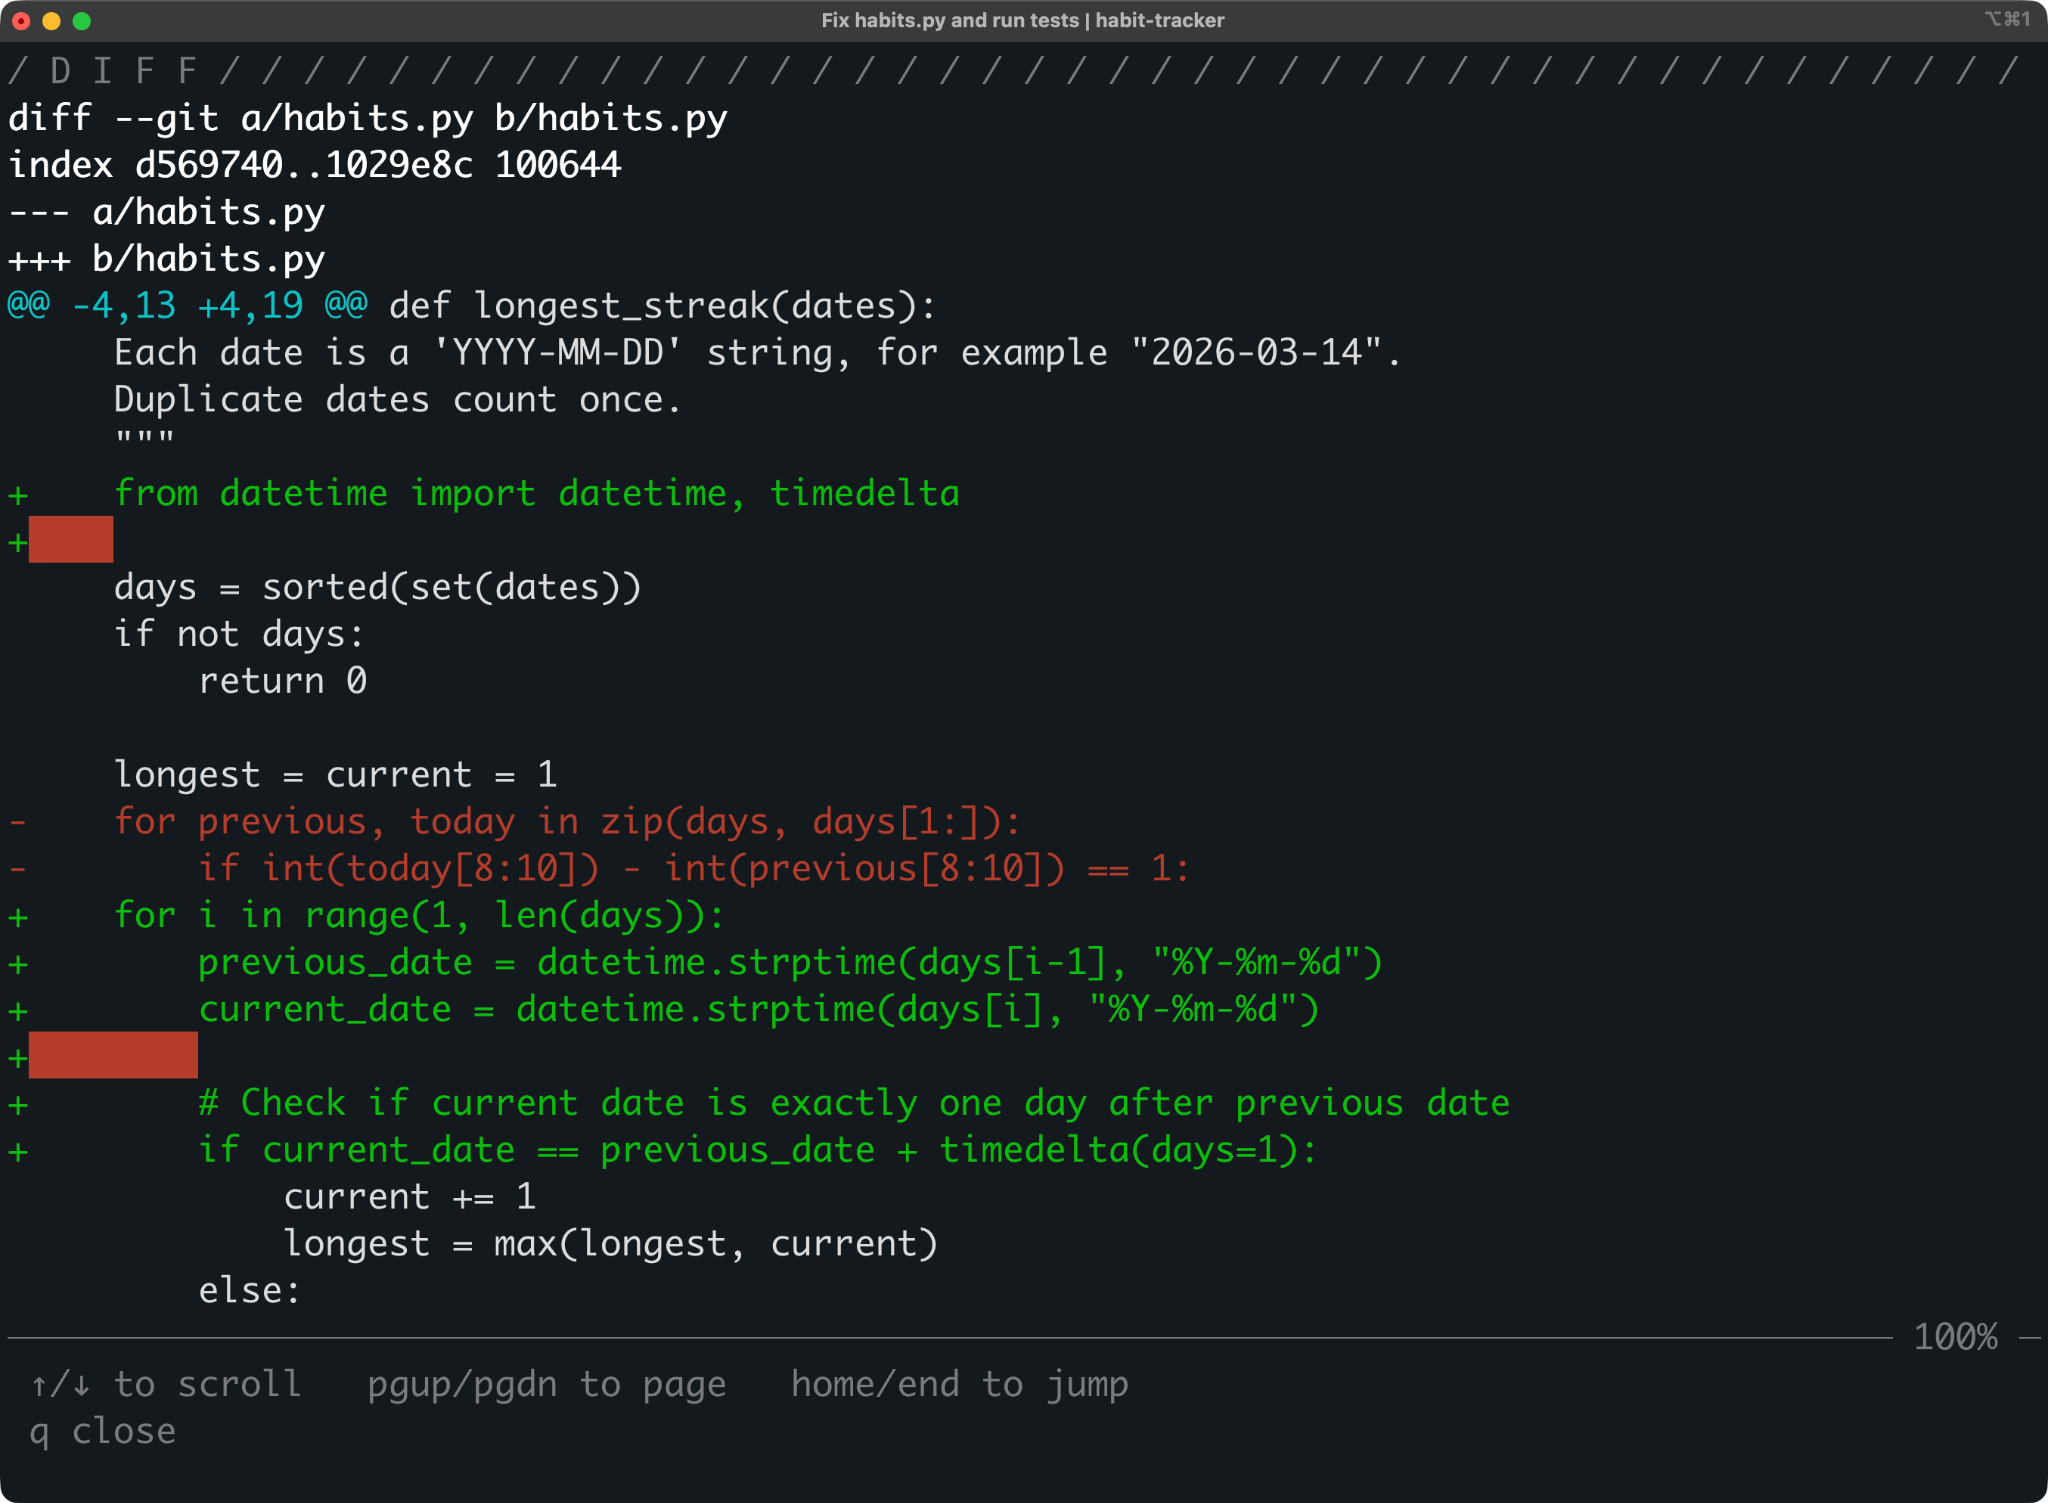
De diff van wijzigingen door Open Interpreter
De exacte diff hangt van het model af, dus die van jou komt mogelijk niet regel-voor-regel overeen met bovenstaande. Bevalt de wijziging, commit hem dan; bevalt hij niet, herstel dan het oorspronkelijke bestand:
git restore habits.pyEn dat is het idee. Jij beschrijft het probleem, de agent onderzoekt en fixt het, en jij beoordeelt elke wijziging voordat die deel wordt van je code.
Open Interpreter vereist dat je je eigen model meeneemt.
Elke aanvraag gaat door deze drie lagen:
| Laag | Voorbeeld | Wat het bepaalt |
|---|---|---|
| Provider | ollama | Waar aanvragen naartoe gaan en hoe je je authenticatie regelt |
| Model | devstral-small-2 | Het model dat het werk doet |
| Harness | native | De prompts, tools en het berichtformaat rondom het model |
Aanvraaglagen
Dit kun je koppelen:
De providerlijst wordt gegenereerd uit een publieke modelcatalogus, en bevat alleen modellen die tool-calling ondersteunen. Als een verwacht model ontbreekt, is dat meestal de reden.
Let op ollama-cloud. Dat is een aparte gehoste provider, dus je aanvragen verlaten je machine. Alleen de ingebouwde provider ollama draait modellen lokaal.
Je kunt het model op drie niveaus wijzigen:
Binnen een sessie: draai /model om de provider, het model en de reasoning-inspanning te kiezen
Voor één run: geef de -m-flag mee, zoals in de vorige sectie
Als standaard: stel het in je configbestand in
Je kunt /status altijd draaien om te zien welke provider en welk model actief zijn.
Open Interpreter leest zijn instellingen uit ~/.openinterpreter/config.toml. Om de Ollama-setup uit de vorige sectie je standaard te maken, voeg je deze twee regels toe:
model_provider = "ollama"
model = "qwen3-coder:30b"
Daarna start interpreter met dit model en heb je geen flags nodig.
Gehoste providers lezen hun API-sleutels uit omgevingsvariabelen. DeepSeek verwacht bijvoorbeeld DEEPSEEK_API_KEY:
export DEEPSEEK_API_KEY="your-api-key"Je kunt ook elke OpenAI-compatibele endpoint als custom provider toevoegen:
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
De instelling wire_api vertelt Open Interpreter welk aanvraagformaat de endpoint verwacht. Gebruik chat voor OpenAI-compatibele Chat Completions, responses voor de OpenAI Responses API en messages voor Anthropic-achtige endpoints.
Een vertrouwd project kan ook een eigen .openinterpreter/config.toml hebben, die je gebruikersconfig overschrijft. Command-line flags overschrijven beide. Weet je niet welke waarde wint, draai dan /debug-config om de effectieve instellingen en hun herkomst te zien.
Het model bepaalt hoe goed de agent je code begrijpt. De harness bepaalt hoe het model de taak en de tools ziet.
Je hebt beide nodig. Een goed model in een niet-passende harness stuurt misvormde tool-calls en leest resultaten verkeerd. En een goede harness kan niet compenseren voor een model dat de code niet begrijpt.
Daarom kiest Open Interpreter een harness wanneer jij een model kiest. Bijvoorbeeld:
Claude-modellen krijgen de claude-code-harness
Kimi-modellen krijgen kimi-code
Qwen-modellen krijgen qwen-code
DeepSeek-modellen krijgen claude-code-bare
Voor andere modelfamilies kun je zelf de harness kiezen met /harness.
Onthoud hierbij dat een zwak resultaat niet altijd een zwak model betekent. Probeer, voordat je van model wisselt, hetzelfde model met een andere harness. Dat behandel ik uitgebreid in de volgende sectie.
Harness-emulatie is de hoofdreden dat de huidige versie van Open Interpreter bestaat.
Een agent-harness is alles rondom het model dat het in een agent verandert. Het omvat:
Simpel gezegd: de harness bepaalt hoe het model de taak ziet en hoe z’n beslissingen in acties worden omgezet.
Open Interpreter heeft een set ingebouwde harness-modi. Dit zijn de meest gebruikte:
native: Open Interpreters eigen harness, geërfd van Codex
claude-code: emuleert de prompts en tool-oppervlakte van Anthropic’s Claude Code
kimi-code: een Rust-herimplementatie van de Kimi Code-harness die Moonshot voor zijn Kimi-modellen aanbeveelt
qwen-code: emuleert Alibaba’s Qwen Code CLI voor Qwen-modellen
swe-agent: emuleert SWE-agent, een researchagent gebouwd om GitHub-issues op te lossen
De volledige lijst bevat ook varianten als claude-code-bare, kimi-cli, deepseek-tui, zcode en minimal. Draai /harness in een sessie om te zien wat jouw versie ondersteunt.
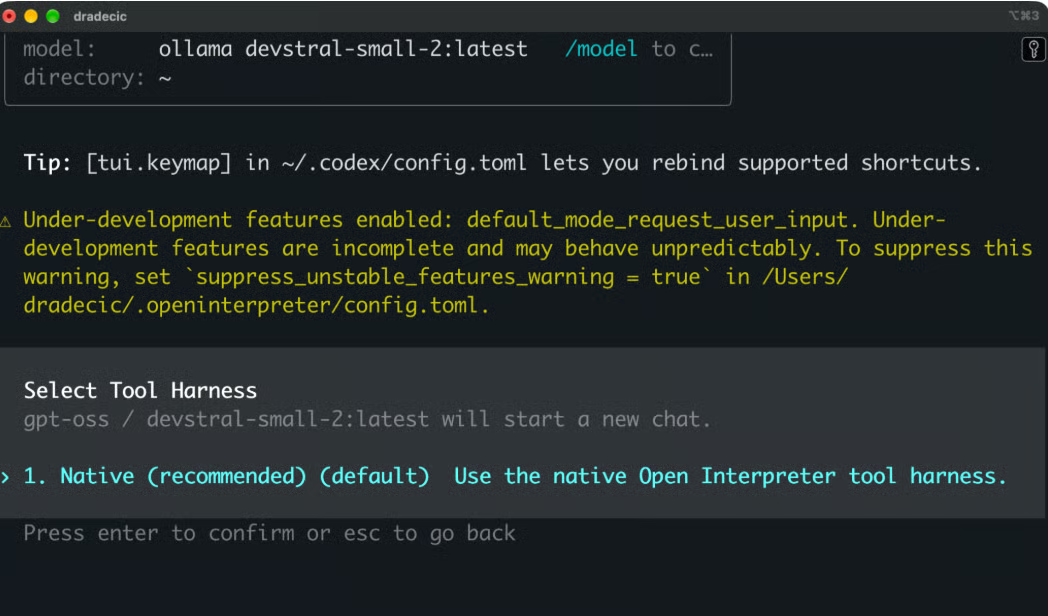
Je kunt halverwege een sessie van harness wisselen met /harness, of een standaard instellen in ~/.openinterpreter/config.toml:
harness = "kimi-code"
harness_guidance = true
De instelling harness_guidance voegt een reliability guidance toe waar de harness dat toelaat. Zet hem op false als je striktere emulatie wilt. Laat je harness leeg, dan kiest Open Interpreter er een op basis van de modelfamilie, zoals je in de vorige sectie zag.
De meeste modelvendors tunen hun codingmodellen binnen een specifieke agent-setup, en publiceren een aanbevolen harness die daarbij hoort.
Het model raakt gewend aan die harness. Het leert de promptstijl, de toolnamen, het bestandsbewerkingsformaat en de manier waarop toolresultaten terugkomen.
Stel dat je een model draait dat is getuned voor zoek-en-vervang-edits binnen een harness die volledige patchbestanden verwacht. Het model weet welke wijziging nodig is, maar blijft de wijziging in het verkeerde formaat beschrijven. De agentloop verbruikt tokens zonder voortgang.
Met toolresultaten werkt het net zo. Als de harness resultaten teruggeeft in een formaat dat het model niet kent, leest het model ze verkeerd. Als de harness de redenering van het model tussen beurten verwijdert, raakt een “denkend” model zijn eigen plan kwijt.
Dit betekent dat hetzelfde model in de ene agent goed kan lijken en in een andere slecht, zonder wijziging in de gewichten. Daarom noemen codingbenchmarks meestal ook de harness die voor elke run is gebruikt.
Frontiermodellen herstellen meestal van een onbekende harness, maar kleinere en goedkopere modellen doen dat vaak niet. Open Interpreter dwingt niet elk model in één formaat, maar past het formaat aan het model aan.
Je kunt dit zelf testen met het demoproject. Herstel het oorspronkelijke bestand met git restore habits.py, wissel de harness met /harness, en geef de agent dezelfde prompt opnieuw. Vergelijk vervolgens hoeveel stappen het kost en hoe hij zijn edits formatteert.
De meeste van deze functies heb je al gezien in het artikel. Dit levert elk onderdeel je op in je dagelijkse ontwikkeling.
Open Interpreter werkt binnen je Git-repository. Het leest de projectstructuur en houdt bij wat het heeft gewijzigd.
Twee slash-commando’s helpen hierbij. /diff toont de working-tree-wijzigingen, en /review vraagt de agent om de huidige wijzigingen te controleren op bugs en regressies voordat je commit. Je kunt dezelfde review draaien zonder een sessie te openen:
interpreter exec review --uncommittedSessies worden ook opgeslagen. Stop je midden in een taak, dan pakt interpreter resume --last hem op waar je gebleven was.
De agent draait dezelfde commando’s als jij, bijvoorbeeld testsuites, linters, buildscripts en pakketmanagers. Ze draaien allemaal binnen native sandboxing op macOS, Linux en Windows.
Langlopende commando’s kunnen op de achtergrond draaien. Gebruik /ps om ze te tonen en /stop om ze te beëindigen.
Voor scripts en CI-pipelines draait interpreter exec een taak zonder de interactieve UI:
interpreter exec "fix the failing test"Je kunt op elk moment van provider en model wisselen met /model. Je config, AGENTS.md en skills blijven ook na de switch gelden.
Profielen zijn hierbij handig. Stel dat je een goedkoop model wilt voor routinetaken en een sterker model voor code-reviews. Je kunt beide in je config definiëren:
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
Start dan met interpreter --profile review wanneer je het nodig hebt.
/harness verandert hoe het model de taak ziet zonder het model te wijzigen. Dit is het eerste wat je probeert als een model moeite heeft met tool-calls, vóórdat je overstapt op een groter model.
Het Model Context Protocol (MCP) verbindt de agent met tools waarvoor hij oorspronkelijk niet is ontworpen, zoals documentatieservers of databases. Je voegt servers toe in je config:
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
Draai /mcp om de geconfigureerde servers en hun tools te zien. De instelling default_tools_approval_mode zorgt dat de agent eerst vraagt voordat hij een tool van die server gebruikt.
Het werkt ook andersom. interpreter mcp-server stelt Open Interpreter beschikbaar als een MCP-server, en interpreter acp draait hem binnen editors die het Agent Client Protocol ondersteunen, een open standaard om editors met codingagents te verbinden.
AGENTS.md is een Markdown-bestand in je repository met projectregels die de agent bij elke taak leest. Voor de habit-tracker kan het er zo uitzien:
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
Je kunt ook /init draaien, en de agent schrijft een eerste versie voor je.
Skills zijn herbruikbare workflows, verpakt als mappen in .agents/skills binnen je project of ~/.agents/skills voor je gebruiker. De agent pikt een skill automatisch op wanneer een taak erop matcht. Draai /skills om te zien welke beschikbaar zijn.
Beide zijn gedeelde formaten, dus dezelfde bestanden werken met andere codingagents die ze ondersteunen. Open Interpreter ondersteunt ook hooks, die je eigen commando’s op vaste punten in een sessie draaien. Je beoordeelt en vertrouwt ze met /hooks.
Twee instellingen bepalen wat de agent kan doen:
Sandboxmodus: read-only, workspace-write of danger-full-access
Goedkeuringsbeleid: untrusted, on-request of never
De sandbox bepaalt wat mogelijk is, en het goedkeuringsbeleid bepaalt wanneer de agent eerst vraagt. Met workspace-write en on-request kan de agent je project bewerken en tests draaien, maar vraagt hij eerst wanneer hij toegang daarbuiten nodig heeft.
Je kunt beide wijzigen met /permissions of met de flags -s en -a. Er is ook een --yolo-flag die beide omzeilt; de documentatie noemt die gevaarlijk. Ik behandel deze instellingen uitgebreider in de beveiligingssectie.
Open Interpreter omschrijft zichzelf als een codingagent die is gebouwd voor goedkope modellen.
De grootste proprietary codingagents zijn gebouwd rondom het eigen model van de vendor. Open Interpreter geeft je één agent die werkt met proprietary modellen, gehoste open-weight modellen én lokale modellen.
Open-weight modellen zoals Kimi, DeepSeek, GLM en Qwen hebben publieke gewichten. Je kunt ze gebruiken via een derde partij of op je eigen hardware.
Dat geeft je twee voordelen. Gehoste open-weight modellen kosten meestal minder per token dan frontier proprietary modellen. En je bent niet beperkt tot één host, want hetzelfde model draait overal waar zijn gewichten dat toelaten.
Open Interpreter heeft aparte providergidsen voor Kimi K3, DeepSeek en GLM. Het kiest ook de bijpassende harness voor deze modelfamilies.
Ollama en LM Studio zijn ingebouwde providers, dus je kunt een model op je eigen machine draaien zonder API-sleutel of kosten per token.
De prijs is hardware. Toen ik devstral-small-2 testte op mijn MacBook Pro M1 Max met 64 GB unified memory, nam het model alleen al 26 GB in. Het standaard Ollama-contextvenster was te klein voor de agentloop, en bij 128k tokens bleef het geheugengebruik stijgen en dalen totdat de sessie vastliep.
Codingagents hebben een groot contextvenster nodig, omdat de system prompt, tooldefinities, bestandsinhoud en command-output allemaal moeten passen. Ollama raadt minstens 64k tokens aan voor Codex-achtige agents. En een groter contextvenster gebruikt bovenop het model zelf extra geheugen.
Open Interpreter draait op jouw machine, maar het model hoeft dat niet te doen.
Waar je code naartoe gaat, hangt af van de provider:
Je config, sessies en logs worden hoe dan ook lokaal opgeslagen onder ~/.openinterpreter.
Heb je meer controle nodig, dan kun je een custom provider toevoegen die naar je eigen inference-server wijst. Elke server met een OpenAI-compatibele API werkt, bijvoorbeeld een vLLM-deployment op de GPU’s van je bedrijf. Zo krijg je een gehoste setup waar de infrastructuur van jou is.
Open modellen zijn niet allemaal even goed in tool-calling. Je ziet zwak toolgebruik terug als misvormde calls, loops, voortijdige stops of genegeerde command-output.
De juiste harness helpt, maar lost geen model op dat geen meerstaps taak kan plannen. Vooral kleinere lokale modellen hebben hier de meeste problemen.
Voordat je een nieuw model op een echt project loslaat, test het op een kleine repository zoals de habit-tracker in dit artikel. Als het zwaktes toont, probeer dan een andere harness voordat je opschaalt naar een groter model.
Hier is een korte samenvatting van je opties:
| Waar inferentie draait | Kosten | Verlaat je code je machine? | |
|---|---|---|---|
| Proprietary gehost model | Server van de vendor | Per token of abonnement | Ja |
| Open-weight gehost model | Server van de provider | Per token, meestal lager | Ja |
| Open-weight lokaal model | Jouw hardware | Hardware en elektriciteit | Nee |
Open Interpreter-opties voor lokale en open modellen
Open Interpreter deelt veel met andere terminal-codingagents. De verschillen zitten in wie de tool bezit en voor welke modellen hij is gebouwd.
Claude Code is de terminal-codingagent van Anthropic. Het eerste verschil is eigenaarschap: Claude Code is proprietary, terwijl Open Interpreter open source is onder de Apache 2.0-licentie. Je kunt elk onderdeel van Open Interpreter lezen en aanpassen.
Modelkeuze is het tweede verschil. Claude Code is gebouwd voor Claude-modellen. Je kunt hem richten op Anthropic-compatibele endpoints van andere providers, maar zijn harness blijft voor Claude afgestemd. Open Interpreter behandelt modelkeuze als kernfunctie.
De harnessvergelijking is waar het interessant wordt. Claude Code is zelf een van de harnesses die Open Interpreter emuleert. Met de modus claude-code krijgen alle modellen Claude Code-achtige prompts en tools binnen de runtime van Open Interpreter. De UI en slash-commando’s blijven die van Open Interpreter, dus het is niet hetzelfde product met een ander model.
Beide tools zijn terminal-first. Elke tool heeft een interactieve sessie en een niet-interactieve modus voor scripts en CI. Voor projectinstructies leest Claude Code CLAUDE.md, terwijl Open Interpreter het gedeelde AGENTS.md-formaat gebruikt.
Claude Code heeft een groter ecosysteem. Het wordt geleverd met IDE-extensies, desktop- en webapps, een plugin-marktplaats, subagents en een SDK. Open Interpreter is jonger en leunt op gedeelde standaarden zoals MCP, skills, AGENTS.md en het Agent Client Protocol in plaats van een eigen ecosysteem.
Werk je met Claude-modellen en wil je de meest gepolijste ervaring, dan is Claude Code de veiligere keuze. Wil je andere modellen draaien of een proprietary tool vermijden, kies dan voor Open Interpreter.
OpenCode is de meest vergelijkbare. Beide zijn open source, terminal-first en gebouwd om met een lange lijst modelproviders te werken.
Modelondersteuning is op papier vergelijkbaar. OpenCode ondersteunt meer dan 75 providers, en Open Interpreter genereert z’n providerlijst uit een publieke modelcatalogus. Beide draaien lokale modellen via Ollama.
De terminalervaring verschilt meer. OpenCode heeft een eigen TUI met Language Server Protocol (LSP)-integratie, die coderingsdiagnostiek zoals typefouten terugvoert naar het model. De TUI van Open Interpreter komt van Codex.
Qua configuratie gebruikt OpenCode een opencode.json-bestand, en Open Interpreter gebruikt config.toml met profielen.
De agentarchitectuur is het belangrijkste verschil. OpenCode draait als client en server, waarbij de TUI één client is van een lokale server waar ook andere clients op kunnen aansluiten. Het heeft ingebouwde build- en plan-agents en ondersteunt custom agents en subagents. Het past zijn system prompt aan per modelfamilie, maar de tools en de loop blijven van OpenCode zelf. Open Interpreter gaat verder en wisselt de hele harness, inclusief toolschema’s en berichtformaat. Nieuwere builds bevatten zelfs een opencode-harnessmodus.
Aan de ontwikkelkant is OpenCode een eigen codebase, gebouwd door het team en de community. Open Interpreter bouwt op een fork van Codex, dus een groot deel van de runtime komt upstream. Dat is een trade-off. Open Interpreter krijgt de sandbox en runtime van Codex “gratis”, terwijl OpenCode zijn hele stack controleert.
Deze twee zijn geen concurrenten in de gebruikelijke zin. Open Interpreter is een fork van Codex.
Ze delen de Rust-runtime, de TUI, sandboxing, goedkeuringen, AGENTS.md, skills, MCP, exec-modus en de meeste slash-commando’s. Toen ik Open Interpreter draaide, zei de sessiehervattingshint nog steeds codex resume.
Codex is de agent van OpenAI, gebouwd rond OpenAI-modellen. Het ondersteunt lokale modellen met --oss en custom providers, maar de standaardervaring richt zich op OpenAI.
Open Interpreter breidt Codex op een paar punten uit:
Harness-emulatie: het verandert prompts, toolschema’s en berichtformaat per modelfamilie
Providerondersteuning: het heeft een gegenereerde providercatalogus en aparte gidsen voor Kimi K3, DeepSeek en GLM
Chat Completions: de --chat-completions-flag draait elke OpenAI-compatibele provider
Codex SDK-override: apps gebouwd op de Codex SDK kunnen in plaats daarvan via Open Interpreter draaien
Open Interpreter slaat zijn config en sessies ook op onder ~/.openinterpreter, zodat het niet botst met een Codex-installatie.
Gebruik je vooral OpenAI-modellen, dan is Codex de betere keuze. Gebruik je andere modellen, dan geeft Open Interpreter je dezelfde workflow met betere ondersteuning daarvoor.
Hier is een korte samenvatting:
| Licentie | Modellen | Harness-aanpak | Config | |
|---|---|---|---|---|
| Open Interpreter | Open source (Apache 2.0) | Elke provider, gehost of lokaal | Emuleert harness per model | config.toml |
| Claude Code | Proprietary | Gebouwd voor Claude-modellen | Eigen harness van Claude Code | settings.json en CLAUDE.md |
| OpenCode | Open source (MIT) | 75+ providers, gehost of lokaal | Eén harness met model-specifieke prompts | opencode.json |
| Codex | Open source (Apache 2.0) | Gebouwd voor OpenAI-modellen met --oss | Eigen harness van Codex | config.toml |
Open Interpreter vergeleken met andere AI-codingagents
Het ergste wat een chatbot kan doen is je een slecht antwoord geven, dat je kunt negeren. Een codingagent draait commando’s op je machine, leest en schrijft bestanden en kan het netwerk bereiken. Een slechte beslissing van het model, of een promptinjection, kan echte schade veroorzaken. Promptinjection betekent instructies die verborgen zitten in content die de agent leest, zoals een README-bestand of een webpagina.
Open Interpreter erft zijn beveiligingsmodel van de Codex-runtime. Het heeft twee lagen: een sandbox die bepaalt wat mogelijk is, en een goedkeuringsbeleid dat bepaalt wanneer de agent jou eerst vraagt.
Elk commando dat de agent draait, gaat op macOS, Linux en Windows door een OS-niveau sandbox. Er zijn drie sandboxmodi:
read-only: de agent kan bestanden lezen, maar niets wijzigen
workspace-write: de agent kan bestanden bewerken en commando’s draaien binnen je projectmap
danger-full-access: geen sandbox
Met workspace-write zijn bestandswrites beperkt tot de actieve workspace. De agent kan je code fixen, maar geen bestanden elders op je machine bewerken.
In workspace-write-modus hebben commando’s standaard geen netwerktoegang. Dit blokkeert downloads en voorkomt dat de agent je code ergens heen stuurt.
Sommige taken hebben netwerk nodig, bijvoorbeeld het installeren van een package. Je kunt netwerktoegang inschakelen in je config:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
Schakel dit alleen in voor projecten waar je het nodig hebt.
Het goedkeuringsbeleid bepaalt wanneer de agent stopt en vraagt:
untrusted: vraagt voordat hij commando’s draait die niet op de vertrouwde lijst staan
on-request: vraagt wanneer een taak meer toegang nodig heeft dan de sandbox toestaat
never: vraagt nooit
Voor versiebeheerprojecten is workspace-write met on-request een goede standaard. De agent werkt binnen je project en vraagt voordat hij verder gaat. Git geeft je een weg terug als er iets misgaat.
De --yolo-flag zet zowel de sandbox als de goedkeuringen uit. Gebruik die alleen in een wegwerpomgeving, zoals een container of VM.
Commando’s die de agent draait, erven je shell-omgeving. Als je API-sleutels in omgevingsvariabelen staan, kunnen die commando’s ze zien.
Je kunt dit beperken met shell_environment_policy:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
De instelling core geeft alleen basisvariabelen door zoals HOME en PATH, en exclude verwijdert alles dat aan de patronen voldoet.
Bestanden vormen een ander risico. De agent kan een .env-bestand in je project lezen, zelfs in read-only-modus. Met een gehoste provider gaat alles wat de agent leest naar de servers van die provider.
Onthoud dat de sandbox schade beperkt, maar beschouw hem als een vangnet, geen garantie.
Voordat je de agent zelfstandig laat draaien, voer /status uit en controleer de sandboxmodus en het goedkeuringsbeleid.
Vind je een Open Interpreter-artikel dat begint met pip install, dan is dat niet fout. Het beschrijft een ander project.
De oorspronkelijke Open Interpreter lanceerde in 2023 als een Python-project. Het liet taalmodellen Python-, JavaScript- en shellcode op je machine draaien, en stond bekend als een open-source alternatief voor ChatGPT’s Code Interpreter. Latere versies voegden computerbediening toe, zodat het model ook met je desktop kon werken.
Het huidige hoofdproject is een herschrijving in Rust op basis van Codex. Het richt zich op codingagents en harness-emulatie, niet op algemene computerbediening.
De Python-versie is niet verdwenen. Die gaat verder als communityfork op endolith/open-interpreter.
Beide versies gebruiken dezelfde naam, dezelfde GitHub-repositorygeschiedenis en hetzelfde interpreter-commando, dus ze zijn makkelijk te verwarren.
Maar een heel duidelijk kenmerk is:
pip install open-interpreter: de legacy Python-versie
curl of PowerShell-installer: de huidige Rust-versie
Open Interpreter is niet in elke setup de juiste tool. Hier loont het, en hier niet.
Open source: gelicentieerd onder Apache 2.0, dus je kunt de hele codebase lezen, auditen en forken
Modelkeuze: je kunt gehoste, open-weight en lokale modellen vanuit één agent gebruiken en er midden in een sessie tussen wisselen
Meerdere agent-harnesses: je komt dichter bij de performance waarvoor een model is getuned, iets wat weinig andere codingagents bieden
Terminal-native ontwikkeling: het past in je bestaande shell- en Git-workflow, en exec-modus werkt in scripts en CI
Open en goedkopere modellen: het project is rondom hen gebouwd, met aparte providergidsen en bijpassende harnesses
Extensibiliteit: MCP, skills, hooks, AGENTS.md, het Agent Client Protocol en de Codex SDK-override laten je het met andere tools verbinden
Modelkwaliteit varieert: de agent is zo goed als het model erachter, en geen harness repareert een model dat geen meerstapstaak kan plannen
Lokale modellen vergen stevige hardware: in mijn tests gebruikte devstral-small-2 alleen al 26 GB geheugen, nog vóór het grote contextvenster dat een codingagent nodig heeft
Setup kost meer werk: je beheert providers, contextvensters, harnesses en sandboxinstellingen zelf. Er zijn ook rafelrandjes, zoals achtergebleven Codex-branding en metadatawaarschuwingen bij Ollama-modellen
Commando-uitvoering is een risico: de sandbox en goedkeuringen verkleinen het risico, maar nemen het niet weg
Code moet nog steeds gereviewd worden: slagen van tests garandeert geen correcte fix, dus je moet elke diff lezen
Open Interpreter is een open-source codingagent die werkt met het model dat jij kiest, of dat nu gehost is, open-weight, of op je eigen machine draait.
De workflow is simpel. Je kiest een model en een harness, wijst de agent op een project, en laat hem inspecteren, bewerken en commando’s draaien totdat de taak klaar is. Daarna review jij z’n werk.
Harness-emulatie maakt hem anders dan de concurrentie. Open Interpreter dwingt niet elk model in één agent-setup, maar past de setup aan het model aan — en dat kan het verschil maken. Het model bepaalt ook hoe goed het werk is, en machtigingen bepalen wat de agent kan aanpassen. Jouw review is de laatste check voordat een wijziging je codebase bereikt.
Wil je een AI-engineer-certificering, schrijf je dan in voor ons Associate AI Engineer for Developers-traject en stap op je eigen tempo over naar de wereld van AI.
Leer met DataCamp
Leerpad
Leerpad
Leerpad
blog
Adel Nehme
15 min

