लर्निंग पाथ
डेवलपर्स के लिए एसोसिएट AI इंजीनियर
26 घंटा
यदि आपने कभी किसी कोडिंग एजेंट में ओपन‑वेट मॉडल चलाया है जो किसी दूसरे मॉडल के लिए बनाया गया था, तो आप जानते हैं कि यह अच्छा विचार नहीं होता।
मॉडल आमतौर पर टूल स्कीमा को गलत पढ़ता है और एक ही असफल कमांड तब तक चलाता रहता है जब तक आप उसे रोक न दें। जब आप उस मॉडल पर वापस जाते हैं जिसके लिए एजेंट बना था, वही काम बिना किसी दिक्कत के हो जाता है। समस्या अक्सर मॉडल में नहीं, बल्कि उसके चारों ओर बने एजेंट हार्नेस में होती है, क्योंकि उसके प्रॉम्प्ट और टूल फॉर्मैट किसी और के लिए ट्यून किए गए होते हैं।
Open Interpreter इसे इस तरह हल करता है कि वह हर उस हार्नेस की नकल करता है जिसके लिए मॉडल ट्यून किया गया था, जैसे Claude Code या Kimi Code। यह आपके टर्मिनल से चलने वाला ओपन‑सोर्स एआई कोडिंग एजेंट है, और वर्तमान संस्करण OpenAI के Codex पर बना एक Rust प्रोजेक्ट है—वह Python‑आधारित कंप्यूटर असिस्टेंट नहीं जिसे आप याद कर सकते हैं।
इस लेख में, मैं आपको इंस्टॉलेशन, मॉडल और हार्नेस सेटअप, एक हाथ‑से‑हाथ कोडिंग वर्कफ़्लो, और Open Interpreter की Claude Code, OpenCode, और Codex से तुलना के बारे में बताऊंगा।
क्या आप एआई एजेंट्स में नए हैं? हमारे Introduction to AI Agents कोर्स में दाखिला लें और एक दोपहर में बुनियादी बातें सीखें।
Open Interpreter किसी एआई मॉडल को आपके प्रोजेक्ट और उन टूल्स तक पहुंच देता है जिन्हें एक डेवलपर इस्तेमाल करता है।
आपको बस सामान्य अंग्रेज़ी में काम बताना होता है, और एजेंट आपके कोड पर काम करता है। यह इनके साथ काम कर सकता है:
यह प्रोजेक्ट Apache 2.0 लाइसेंस के तहत ओपन सोर्स है। यह किसी एक मॉडल प्रोवाइडर तक सीमित भी नहीं है। आप इसे होस्टेड मॉडल्स, ओपन‑वेट मॉडल्स, या अपने मशीन पर लोकली चलने वाले मॉडल्स से जोड़ सकते हैं।
सितंबर 2026 तक मुख्य रिपोजिटरी के 68,000 से अधिक GitHub सितारे हैं।
Open Interpreter एक लूप में काम करता है:
इनमें से कुछ स्टेप्स को आपकी मंजूरी पहले चाहिए होती है, जो परमिशन सेटिंग्स पर निर्भर करता है। इन्हें मैं सुरक्षा सेक्शन में कवर करूंगा।
यहाँ एक अधिक दृश्य अवलोकन है:
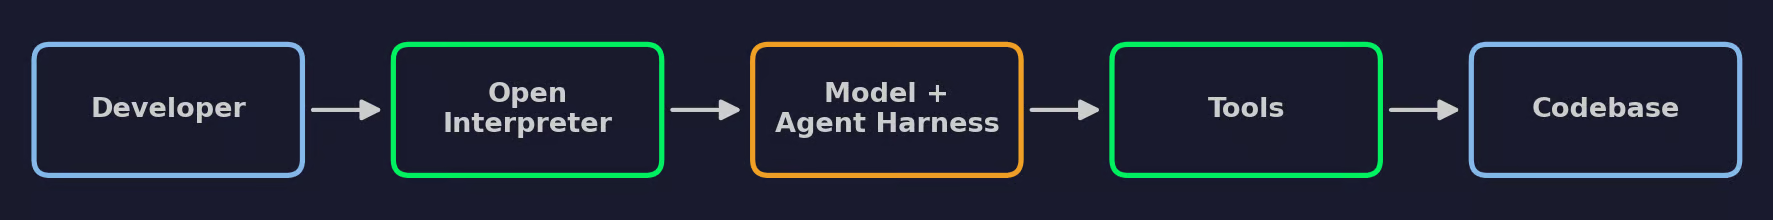
Open Interpreter कैसे काम करता है
यह याद रखने वाली बात है कि आप सीधे मॉडल से बात नहीं करते। Open Interpreter आपका कार्य सक्रिय हार्नेस के प्रॉम्प्ट और टूल डिफिनिशन के साथ फॉर्मैट करके मॉडल को भेजता है। मॉडल टूल कॉल्स मांगता है, और Open Interpreter उन्हें आपके कोडबेस पर चलाता है। फिर नतीजे अगले स्टेप के लिए मॉडल के पास वापस जाते हैं।
क्योंकि मॉडल और हार्नेस अलग‑अलग लेयर्स हैं, आप बाकी सेटअप में कुछ बदले बिना इनमें से किसी एक को बदल सकते हैं।
Open Interpreter एक स्टैंडअलोन बाइनरी के रूप में इंस्टॉल होता है, इसलिए आपको Python या pip की जरूरत नहीं है।
यदि कोई पुरानी ब्लॉग पोस्ट आपको pip install open-interpreter चलाने को कहती है, तो वह लीगेसी Python संस्करण का वर्णन कर रही है। वह कमांड आपको इस लेख में कवर किए गए Rust‑आधारित कोडिंग एजेंट तक नहीं ले जाएगी।
आप अपनी मशीन पर Git भी रखना चाहेंगे। Open Interpreter इसके बिना भी चलता है, लेकिन Git इसे रिपोजिटरी‑अवेयर सेशन और डिफ्स देता है।
अपने टर्मिनल से इंस्टॉल स्क्रिप्ट चलाएँ:
curl -fsSL https://www.openinterpreter.com/install | shस्क्रिप्ट आपके प्लेटफ़ॉर्म के लिए सही रिलीज़ डाउनलोड करती है और interpreter कमांड को ~/.local/bin में रखती है।
PowerShell खोलें और चलाएँ:
irm https://www.openinterpreter.com/install.ps1 | iexयदि आप Linux‑स्टाइल सेटअप पसंद करते हैं तो WSL भी समर्थित है। उस स्थिति में, अपने WSL टर्मिनल के अंदर macOS और Linux वाला कमांड चलाएँ।
अपना टर्मिनल पुनः प्रारंभ करें ताकि नया PATH सेट हो जाए, फिर वर्ज़न जाँचें:
interpreter --versionयदि आपको वर्ज़न नंबर दिखता है, तो इंस्टॉल सफल रहा।
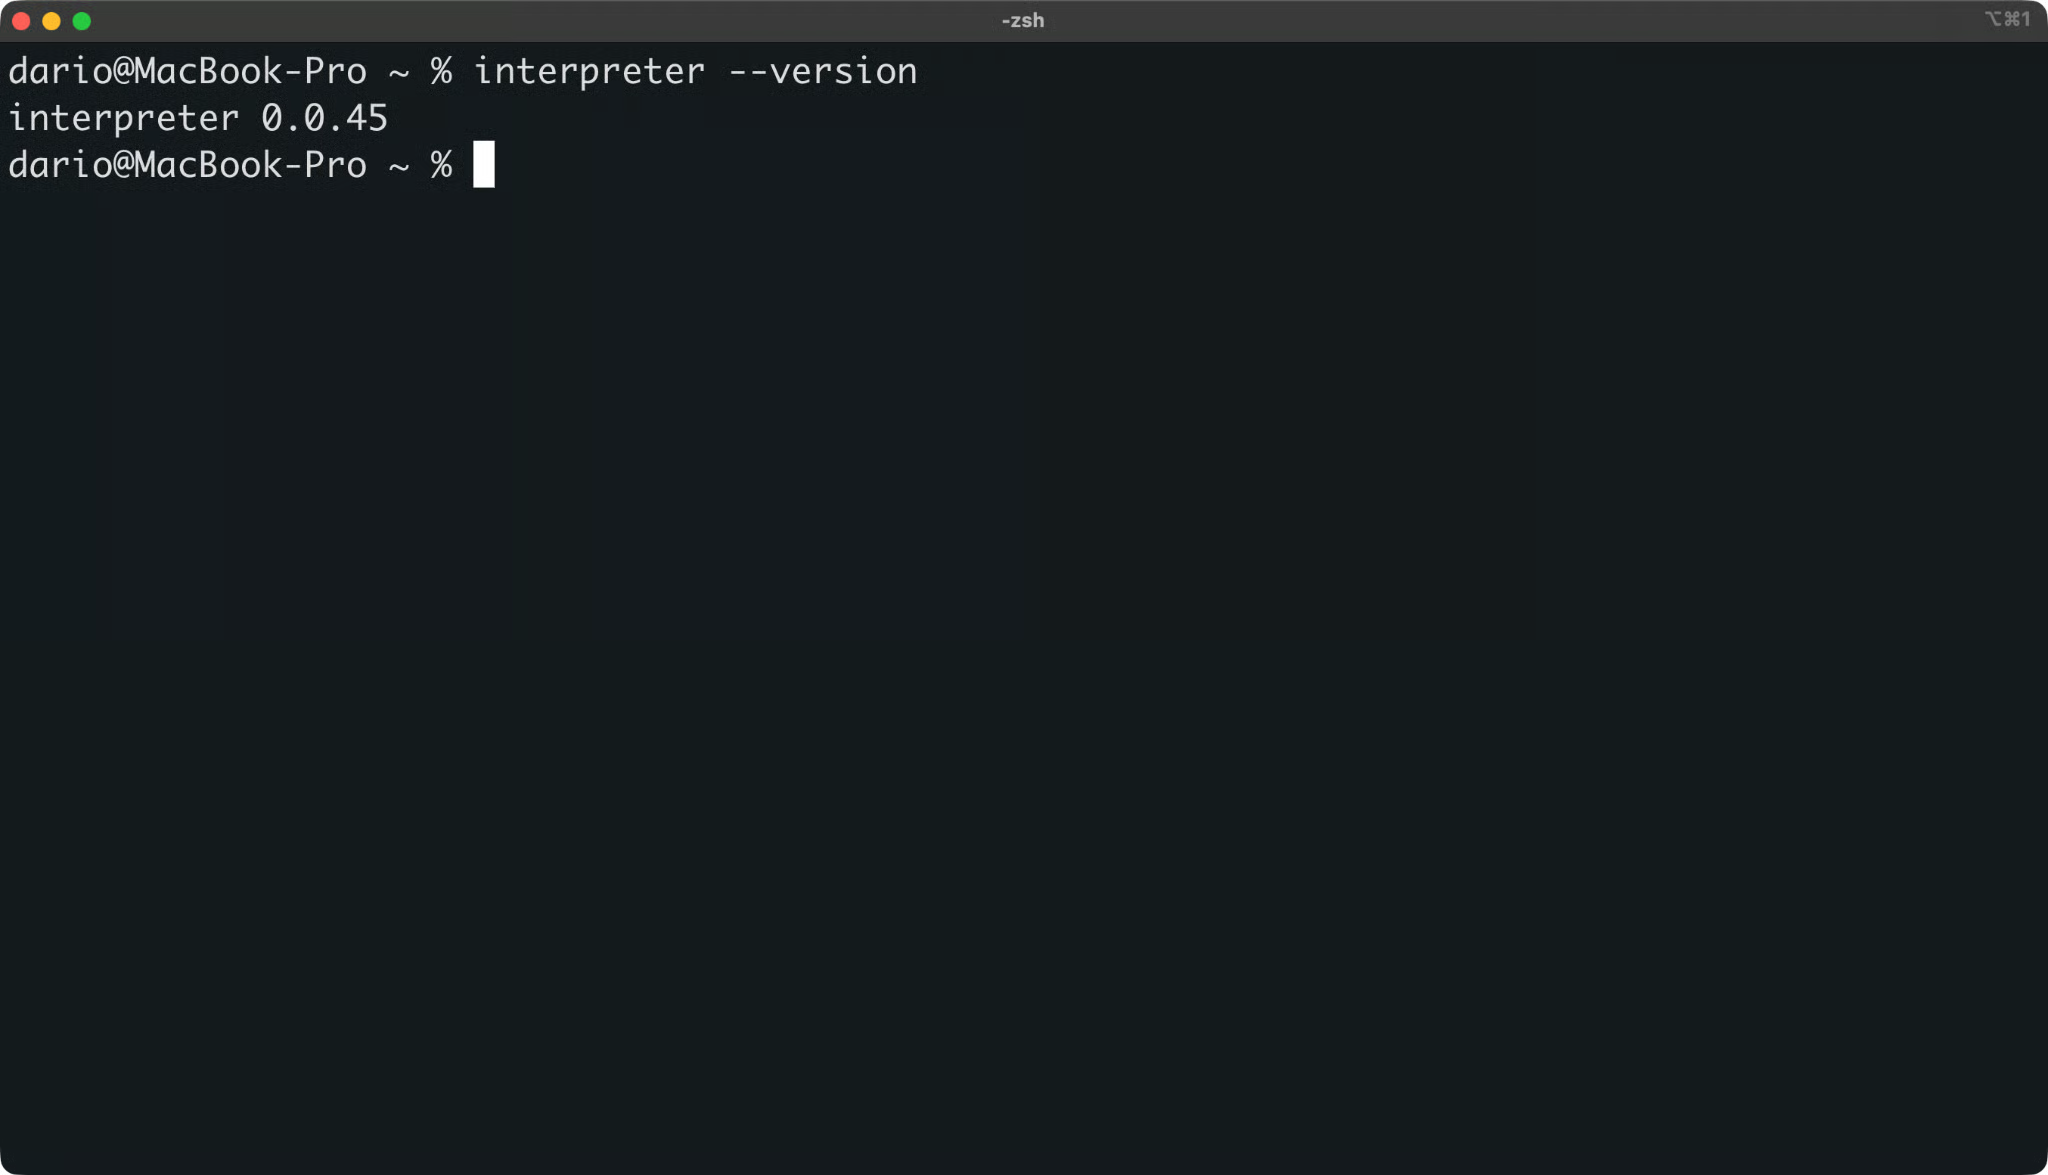
Open Interpreter वर्ज़न जाँच
किसी भी डायरेक्टरी से सेशन शुरू करें:
interpreterआप i भी टाइप कर सकते हैं, जो इसी कमांड का शॉर्ट एलियस है।
Open Interpreter एक टर्मिनल UI खोलता है जहाँ आप साधारण अंग्रेज़ी में टास्क बताते हैं। पहली बार शुरू करने पर, यह आपसे एक मॉडल प्रोवाइडर से कनेक्ट करने को कहेगा। मैं अगले सेक्शन में Ollama के ज़रिए लोकल मॉडल इस्तेमाल करूँगा, इसलिए अभी यह स्टेप छोड़ सकते हैं।
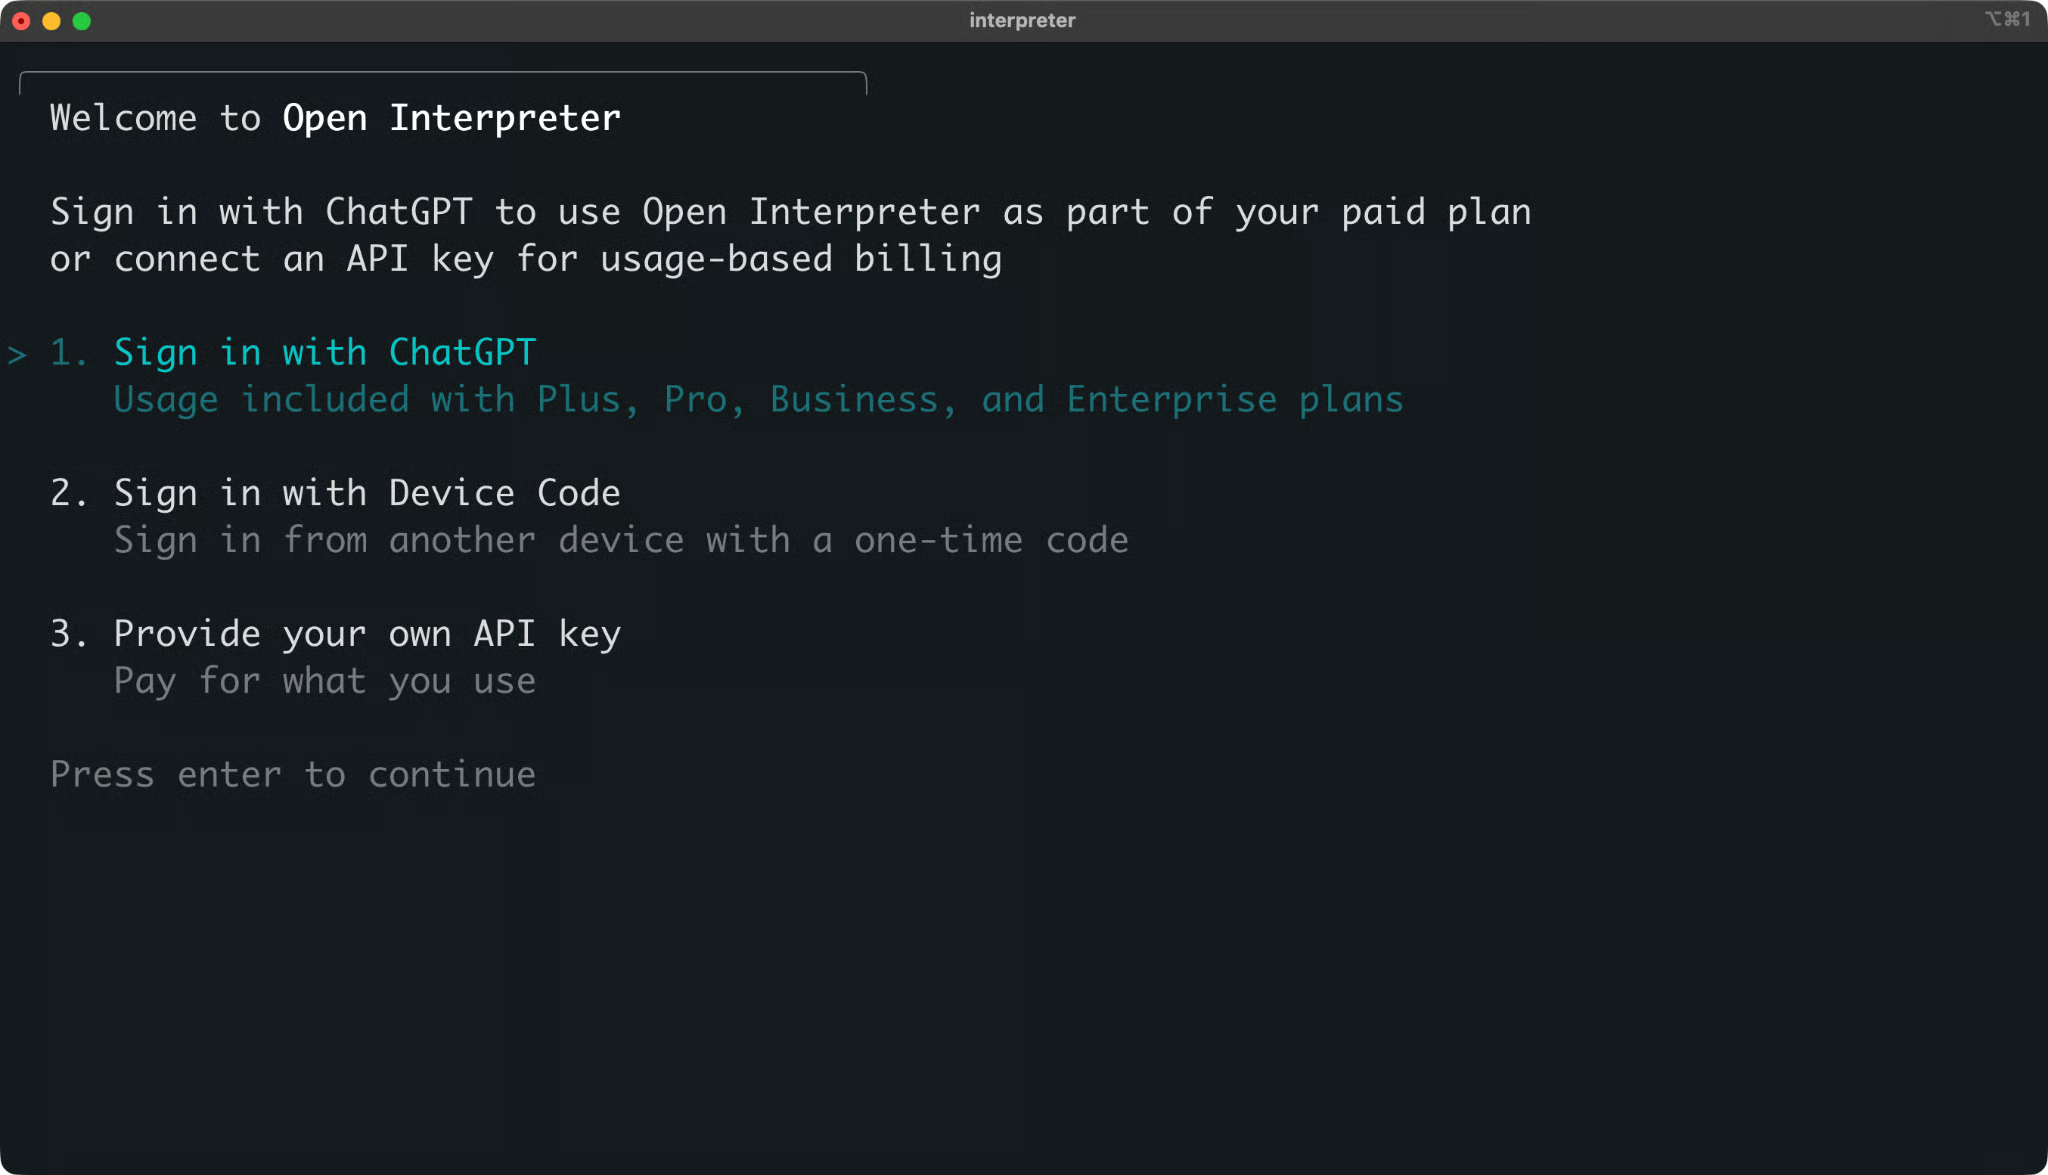
Open Interpreter इंटरैक्टिव सेशन
सेशन से बाहर निकलने के लिए /exit टाइप करें।
किसी कोडिंग एजेंट को समझने का सबसे तेज़ तरीका है उसे एक काम देना और देखना कि वह उसके साथ क्या करता है।
मैं इस पूरे सेक्शन के लिए एक छोटा हैबिट ट्रैकर प्रोजेक्ट इस्तेमाल करूँगा। इसमें एक फ़ंक्शन, एक टेस्ट फाइल, और एक बग है।
प्रोजेक्ट किसी आदत के लगातार दिनों की सबसे लंबी स्ट्रीक निकालता है। उदाहरण के लिए, यह गिनता है कि आपने कितने दिन लगातार व्यायाम किया।
प्रोजेक्ट फ़ोल्डर और एक वर्चुअल एन्वायरनमेंट से शुरू करें:
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
निम्न कोड के साथ habits.py बनाएँ:
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
फिर test_habits.py बनाएँ:
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
फ़ंक्शन में एक बग है। मैं उसे नहीं बताऊँगा, क्योंकि उसे ढूँढना एजेंट का काम है।
एक .gitignore फाइल जोड़ें ताकि वर्चुअल एन्वायरनमेंट और कैश फाइलें रिपोजिटरी से बाहर रहें:
.venv/
__pycache__/
.pytest_cache/
अब प्रोजेक्ट कमिट करें:
git init
git add .
git commit -m "Initial commit"
यह कमिट आपको एक साफ़ शुरुआती बिंदु देता है। बाद में, आप देख पाएँगे कि एजेंट ने क्या बदला।
टेस्ट चलाकर बग की पुष्टि करें:
python -m pytest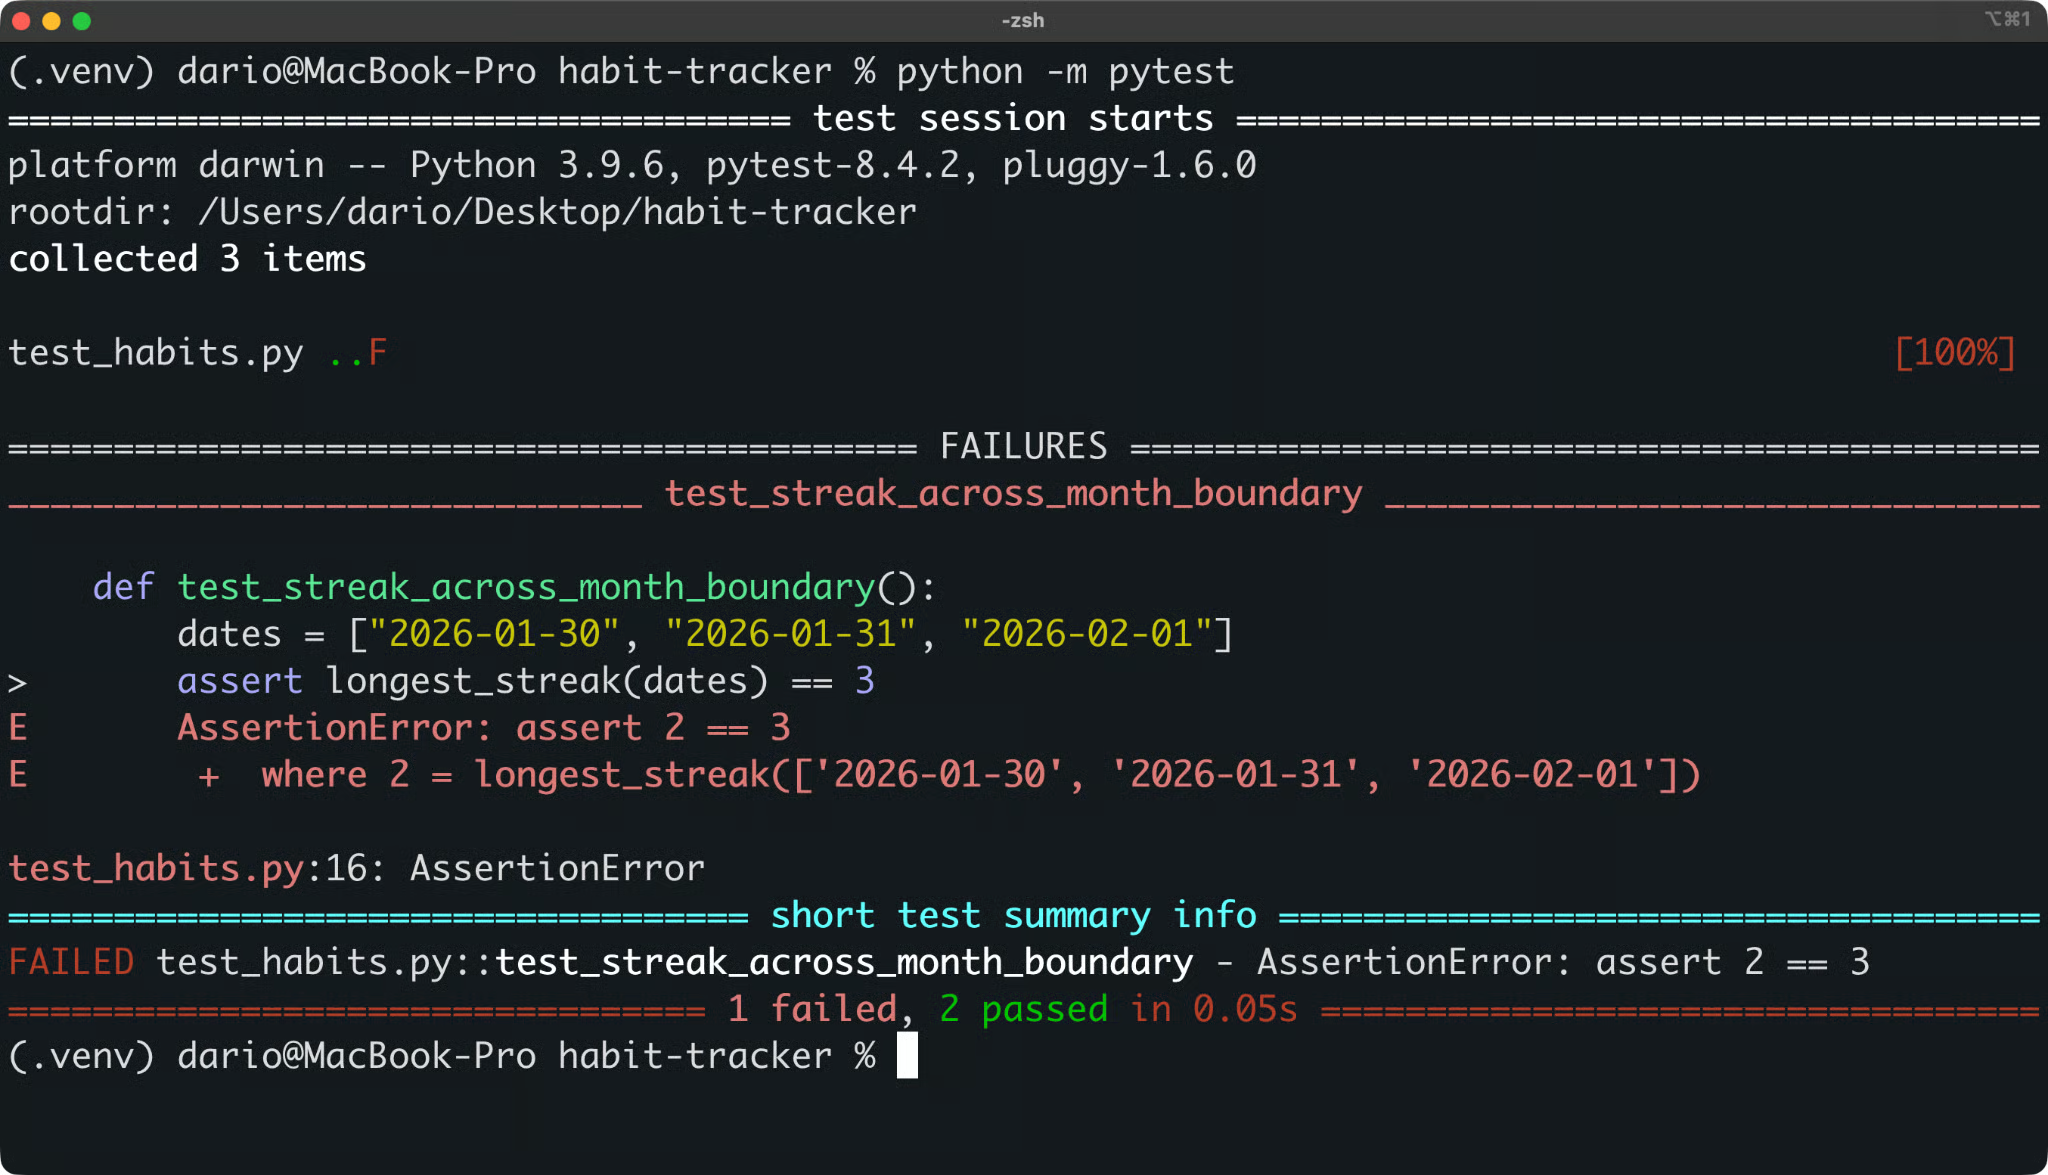
हैबिट ट्रैकर टेस्ट परिणाम
दो टेस्ट पास हैं, और एक फेल। यही समस्या Open Interpreter को हल करनी है।
आपको Ollama इंस्टॉल और रनिंग चाहिए। आपको एक ऐसा मॉडल भी चाहिए जो टूल कॉलिंग सपोर्ट करता हो, तो उसे पुल करें:
ollama pull qwen3-coder:30bफिर प्रोजेक्ट फ़ोल्डर से Open Interpreter शुरू करें। वही टर्मिनल इस्तेमाल करें, ताकि एजेंट आपके वर्चुअल एन्वायरनमेंट से pytest इंस्टॉल का उपयोग कर सके:
interpreter --oss --local-provider ollama -m qwen3-coder:30bप्रत्येक फ़्लैग यह करता है:
--oss: लोकल ओपन सोर्स प्रोवाइडर का उपयोग करता है
--local-provider ollama: LM Studio के बजाय Ollama चुनता है
-m qwen3-coder:30b: इस रन के लिए मॉडल सेट करता है
सक्रिय प्रोवाइडर, मॉडल, सैंडबॉक्स मोड और अप्रूवल पॉलिसी की पुष्टि के लिए /status चलाएँ।
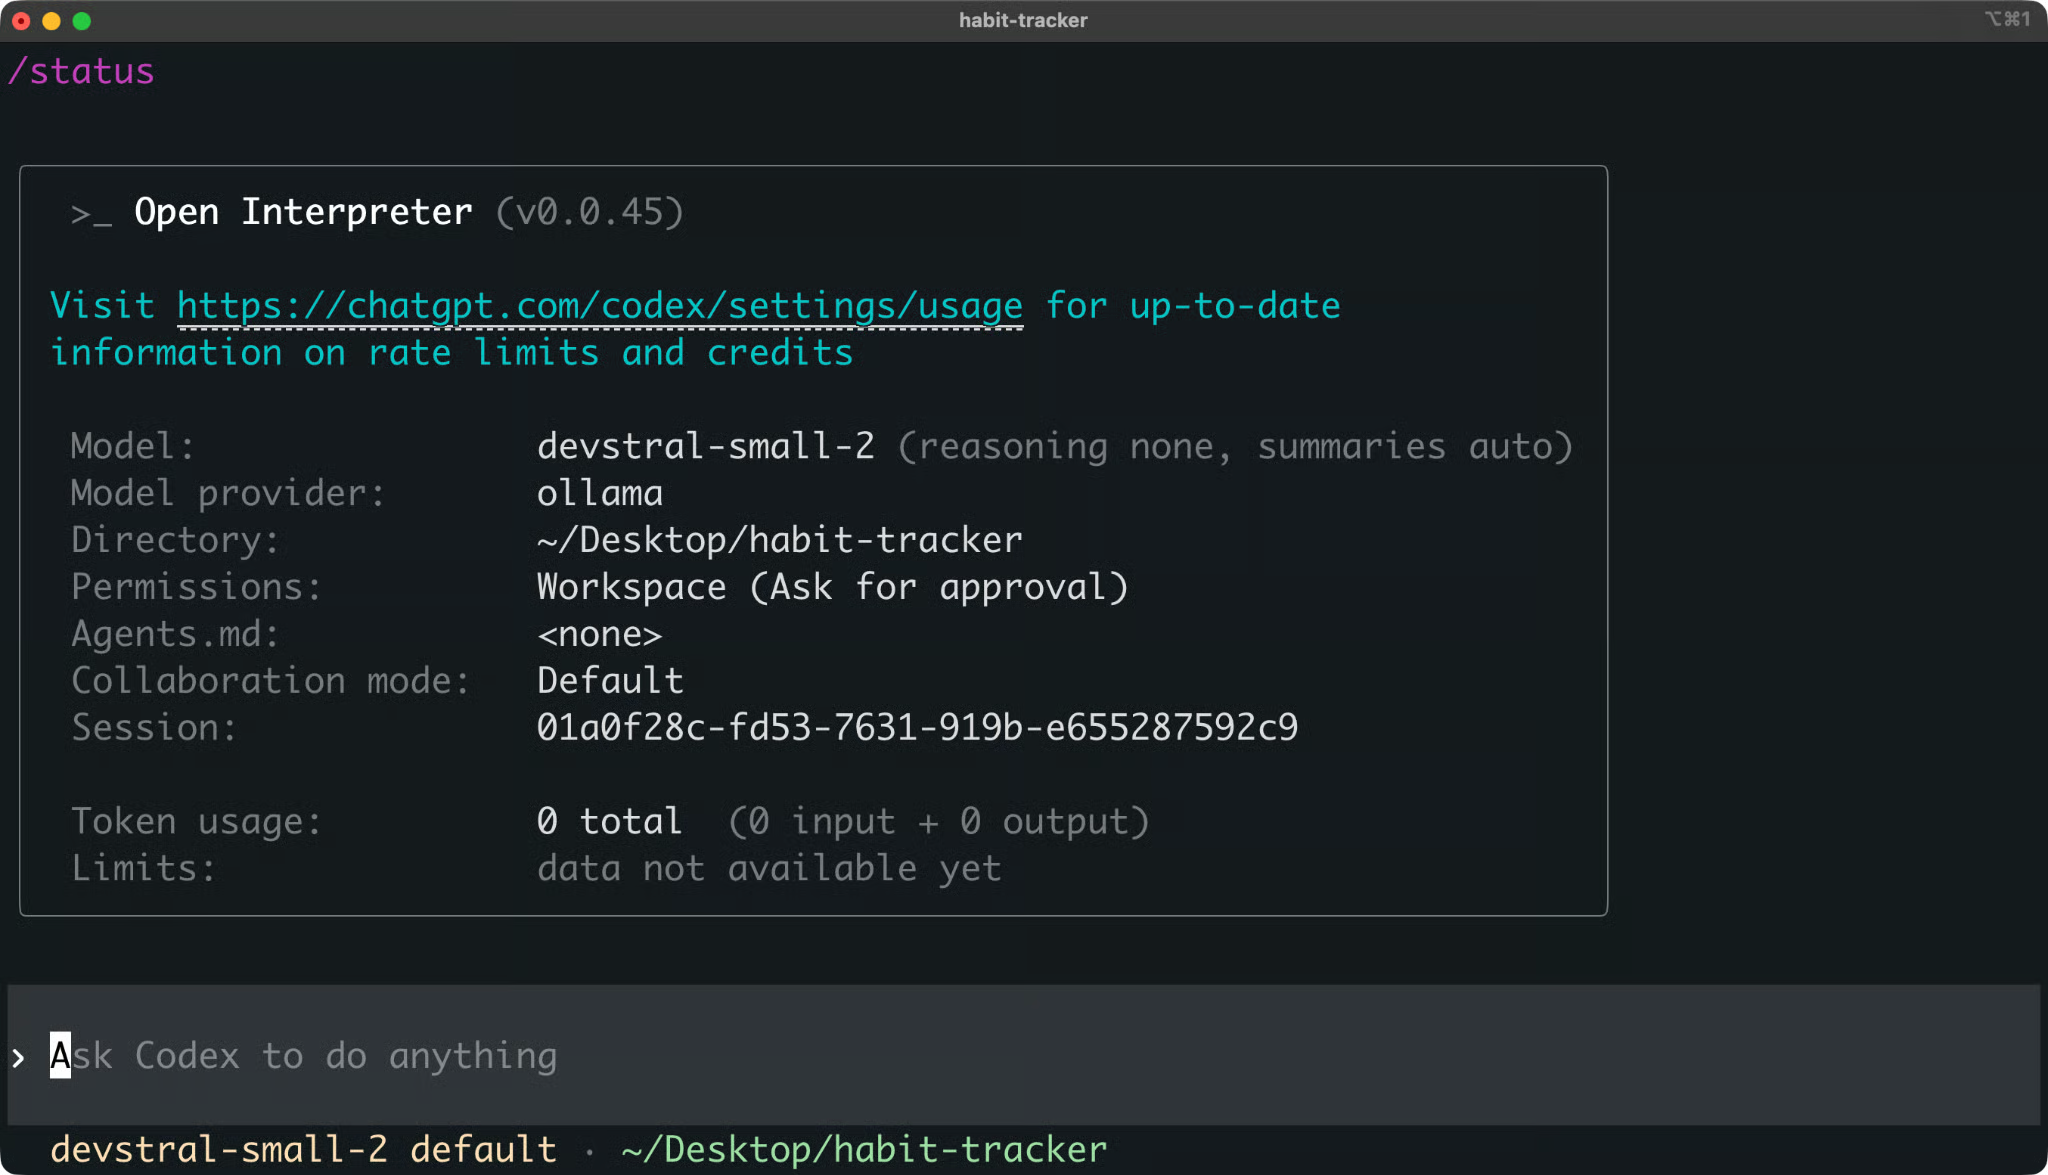
लोकल Ollama मॉडल के साथ Open Interpreter सेशन
आप अभी एजेंट से कुछ एडिट नहीं कराना चाहते। पहले डायग्नोसिस माँगें:
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.एजेंट आमतौर पर जवाब देने से पहले फाइलें पढ़ेगा और टेस्ट चलाएगा। कमांड्स सैंडबॉक्स के अंदर चलती हैं, और यदि एजेंट को सैंडबॉक्स से अधिक एक्सेस चाहिए, तो वह पहले आपकी मंजूरी माँगता है।
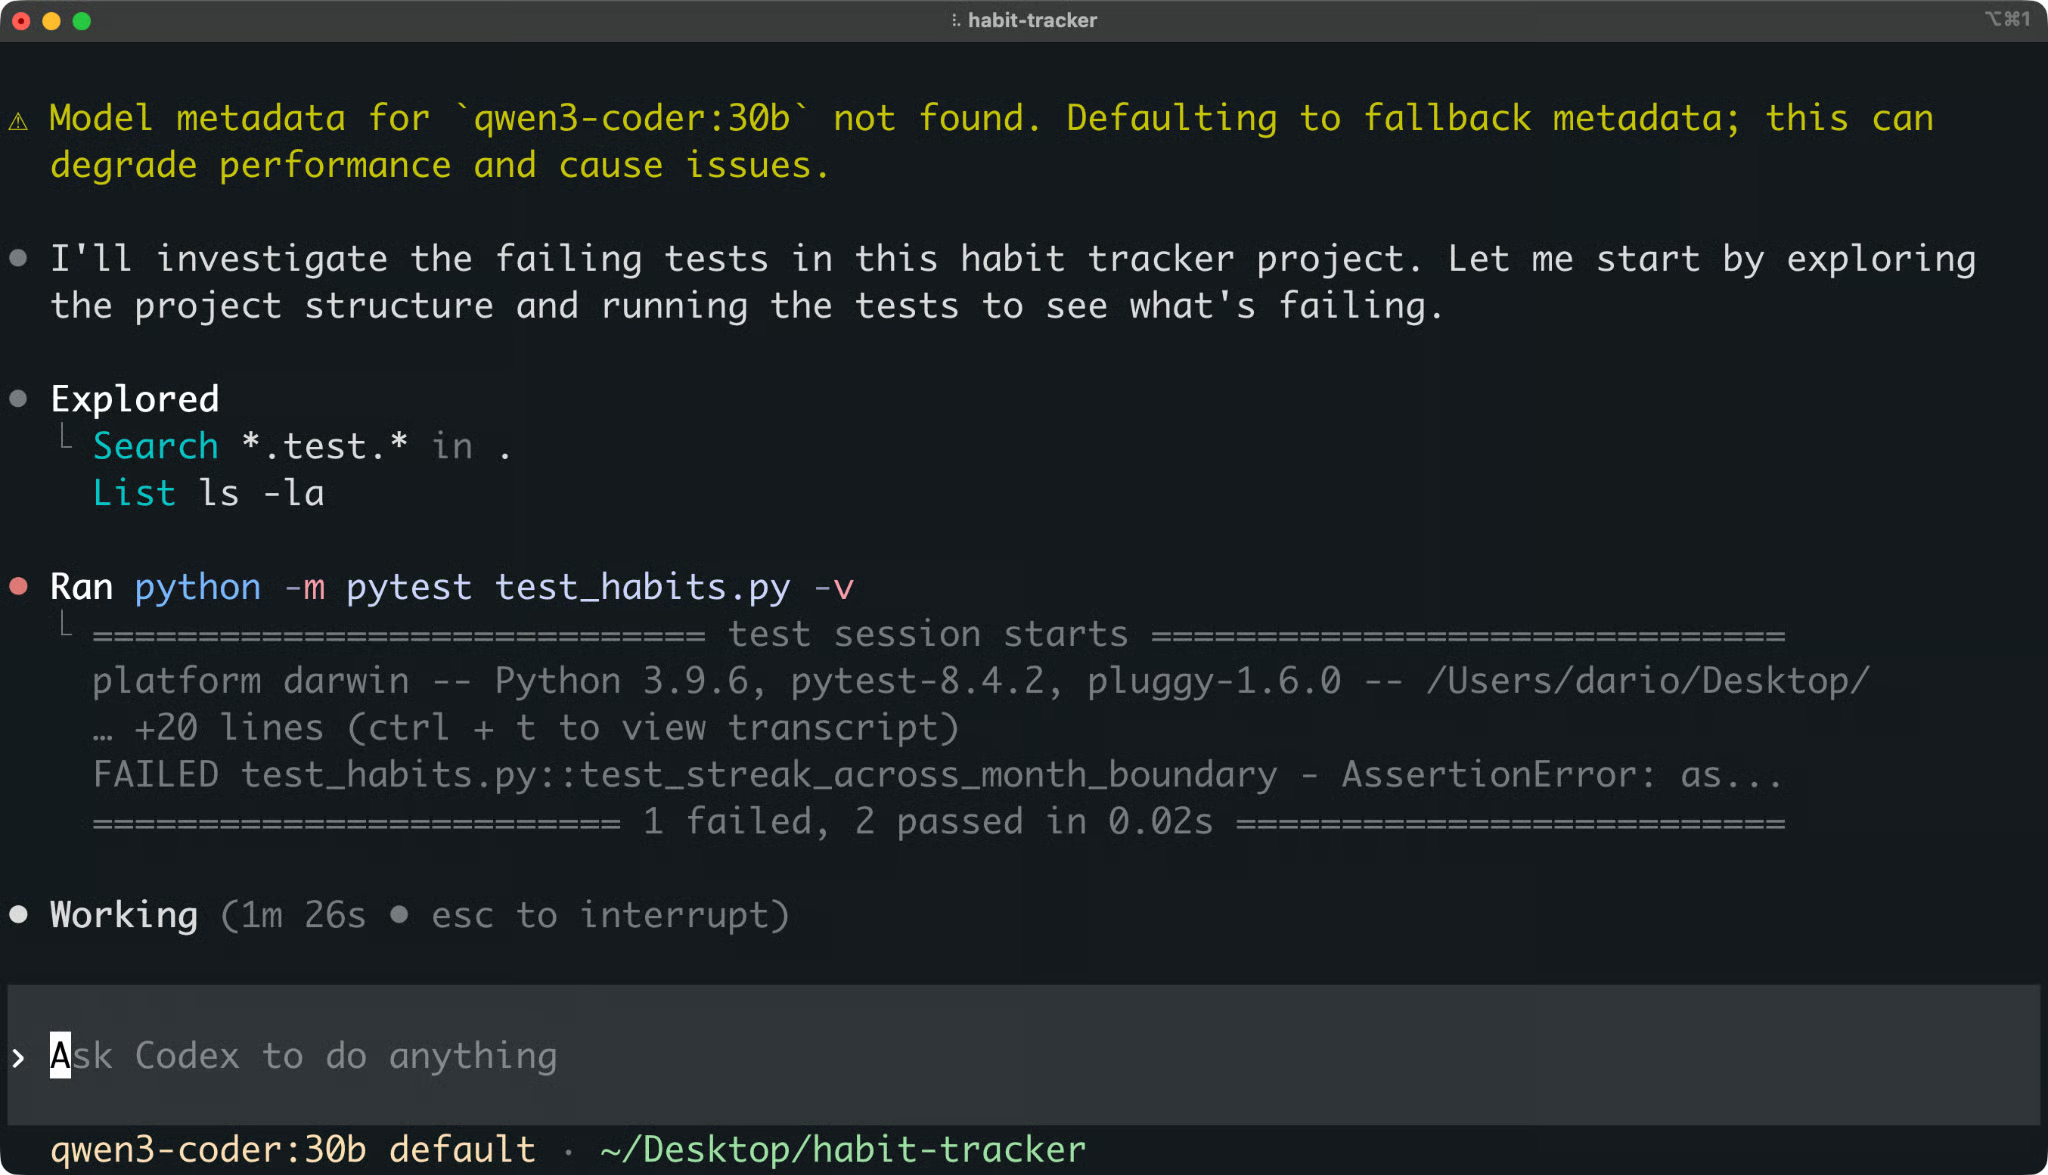
Open Interpreter आउटपुट
कुछ भी मंजूर करने से पहले व्याख्या पढ़ें।
सही डायग्नोसिस कहेगा कि फ़ंक्शन केवल महीने के दिन की तुलना करता है, इसलिए स्ट्रीक नए महीने में जाते ही टूट जाती है। एक अच्छा फिक्स पूरी तारीखों की तुलना करता है, उदाहरण के लिए Python के datetime मॉड्यूल में date.fromisoformat() के साथ।
यदि डायग्नोसिस गलत है, तो उसी सेशन में एजेंट द्वारा कोई कोड एडिट करने से पहले उसे सुधारें।
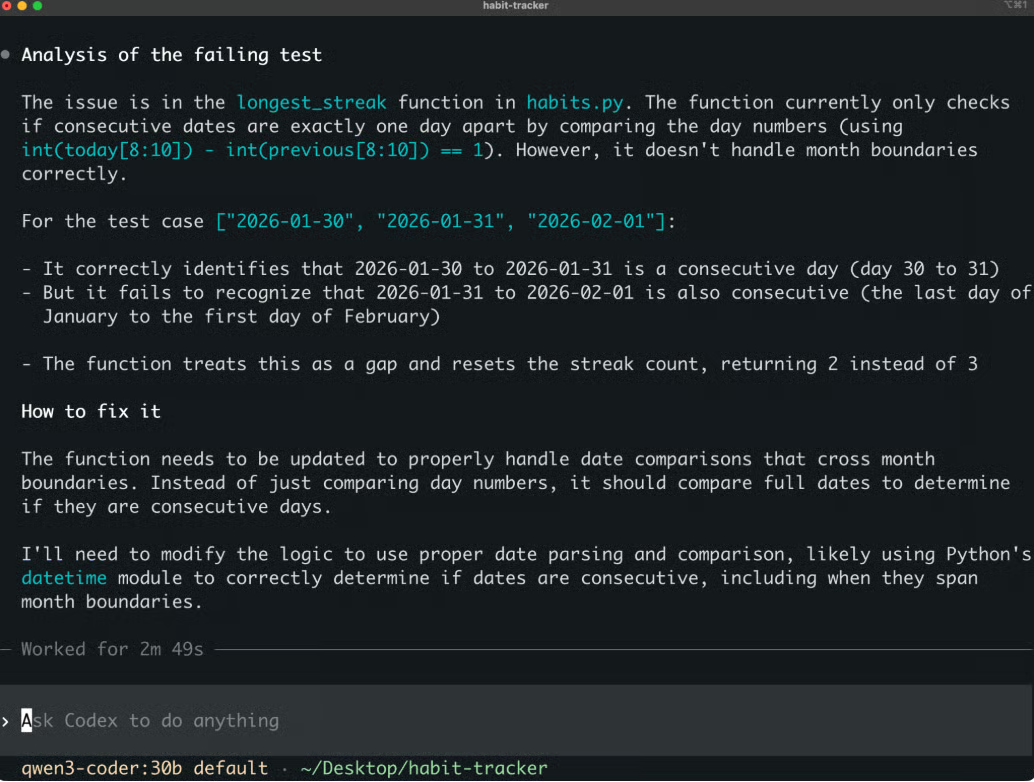
Open Interpreter द्वारा सुझाया गया फिक्स
जब योजना से आप संतुष्ट हों, फिक्स लागू कराएँ:
Apply the fix to habits.py, then run the tests.एजेंट फाइल एडिट करता है और pytest फिर से चलाता है। आपको तीनों टेस्ट पास होते हुए देखने चाहिए।
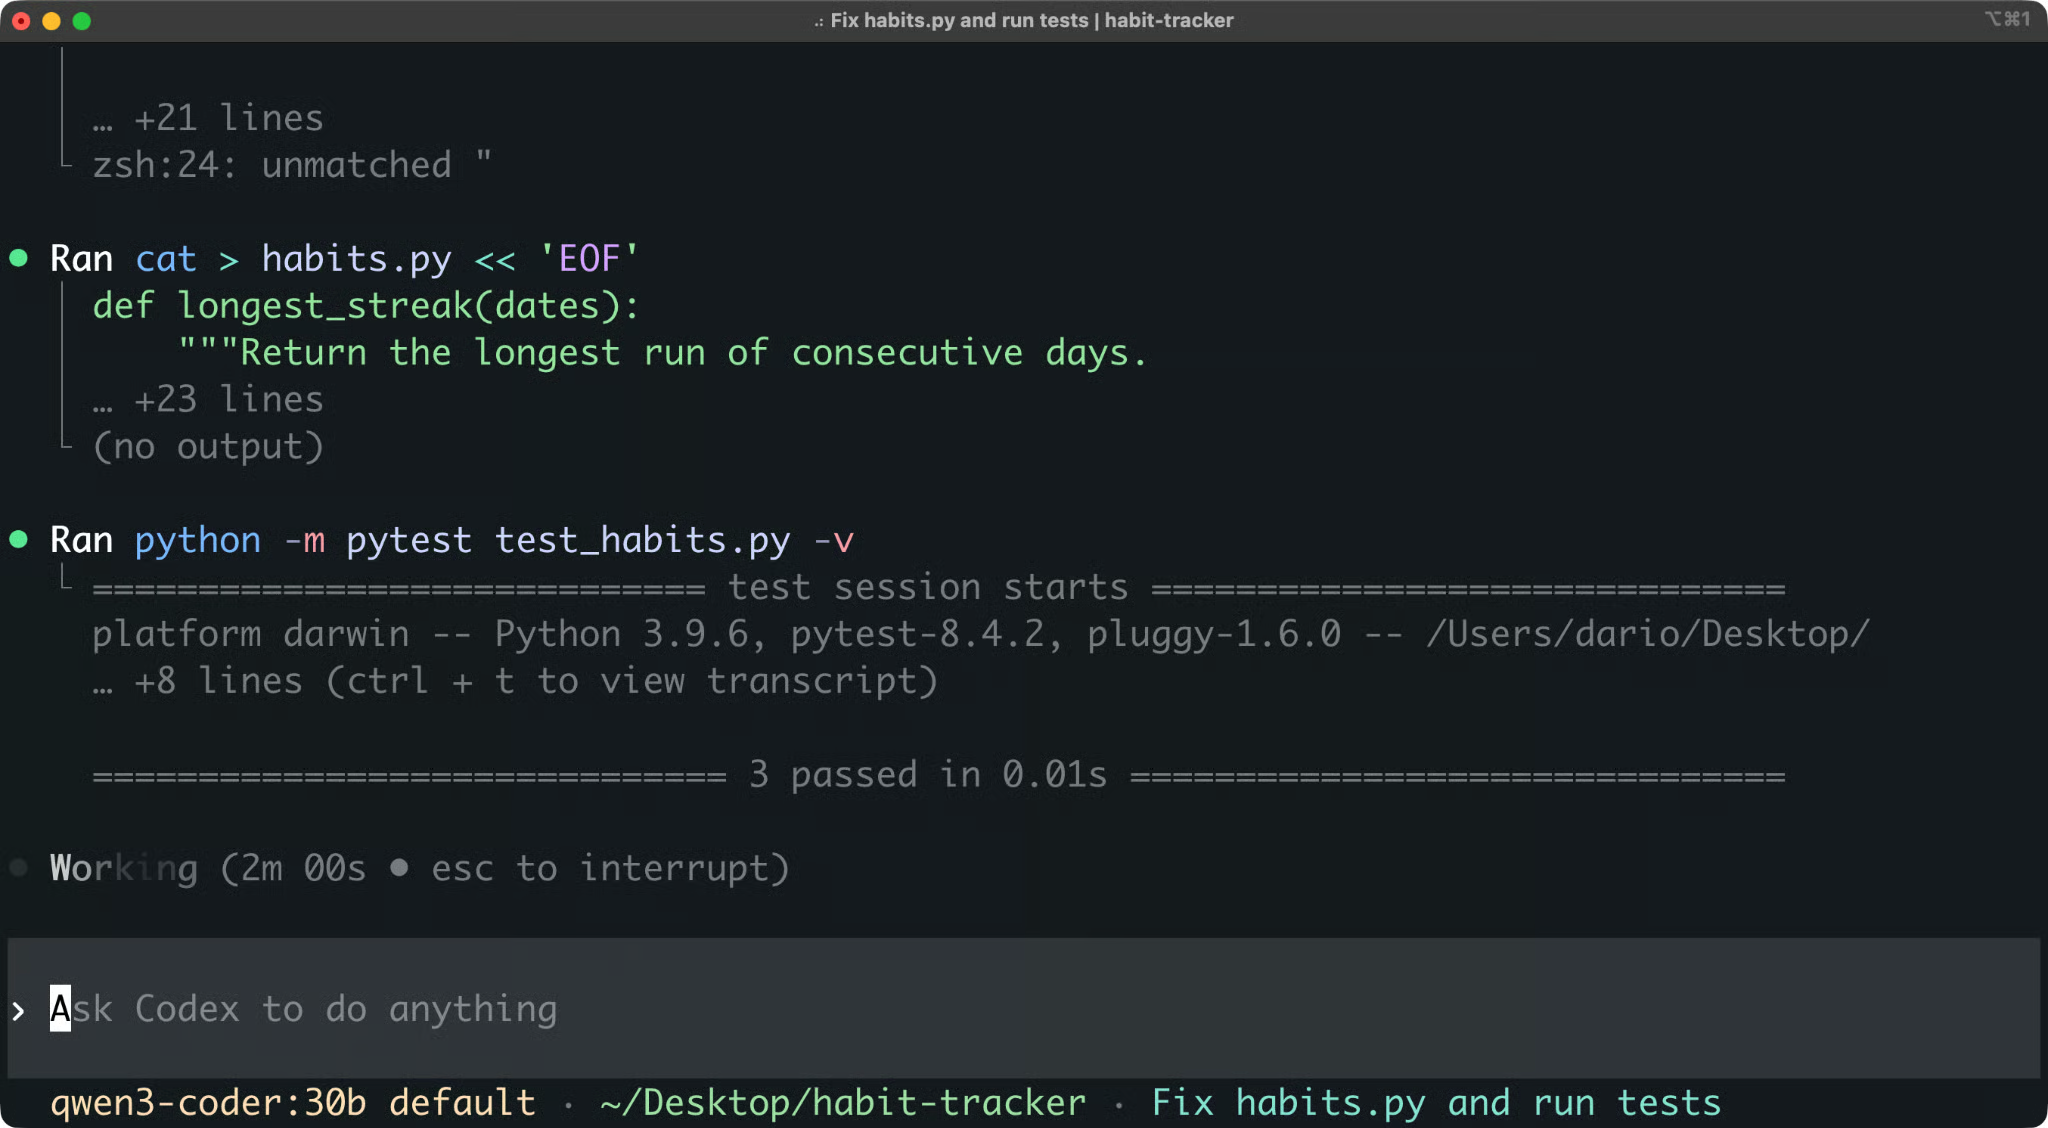
फिक्स के बाद सभी टेस्ट पास
टेस्ट पास होना ज़रूरी नहीं कि आपके कोड का बग हल हो गया। हो सकता है टेस्ट को ही वर्कअराउंड में बदला गया हो। आपको कोड की समीक्षा अभी भी करनी है।
वर्किंग‑ट्री बदलाव देखने के लिए सेशन के अंदर /diff चलाएँ। आप बाहर निकलने के बाद git diff भी चला सकते हैं।
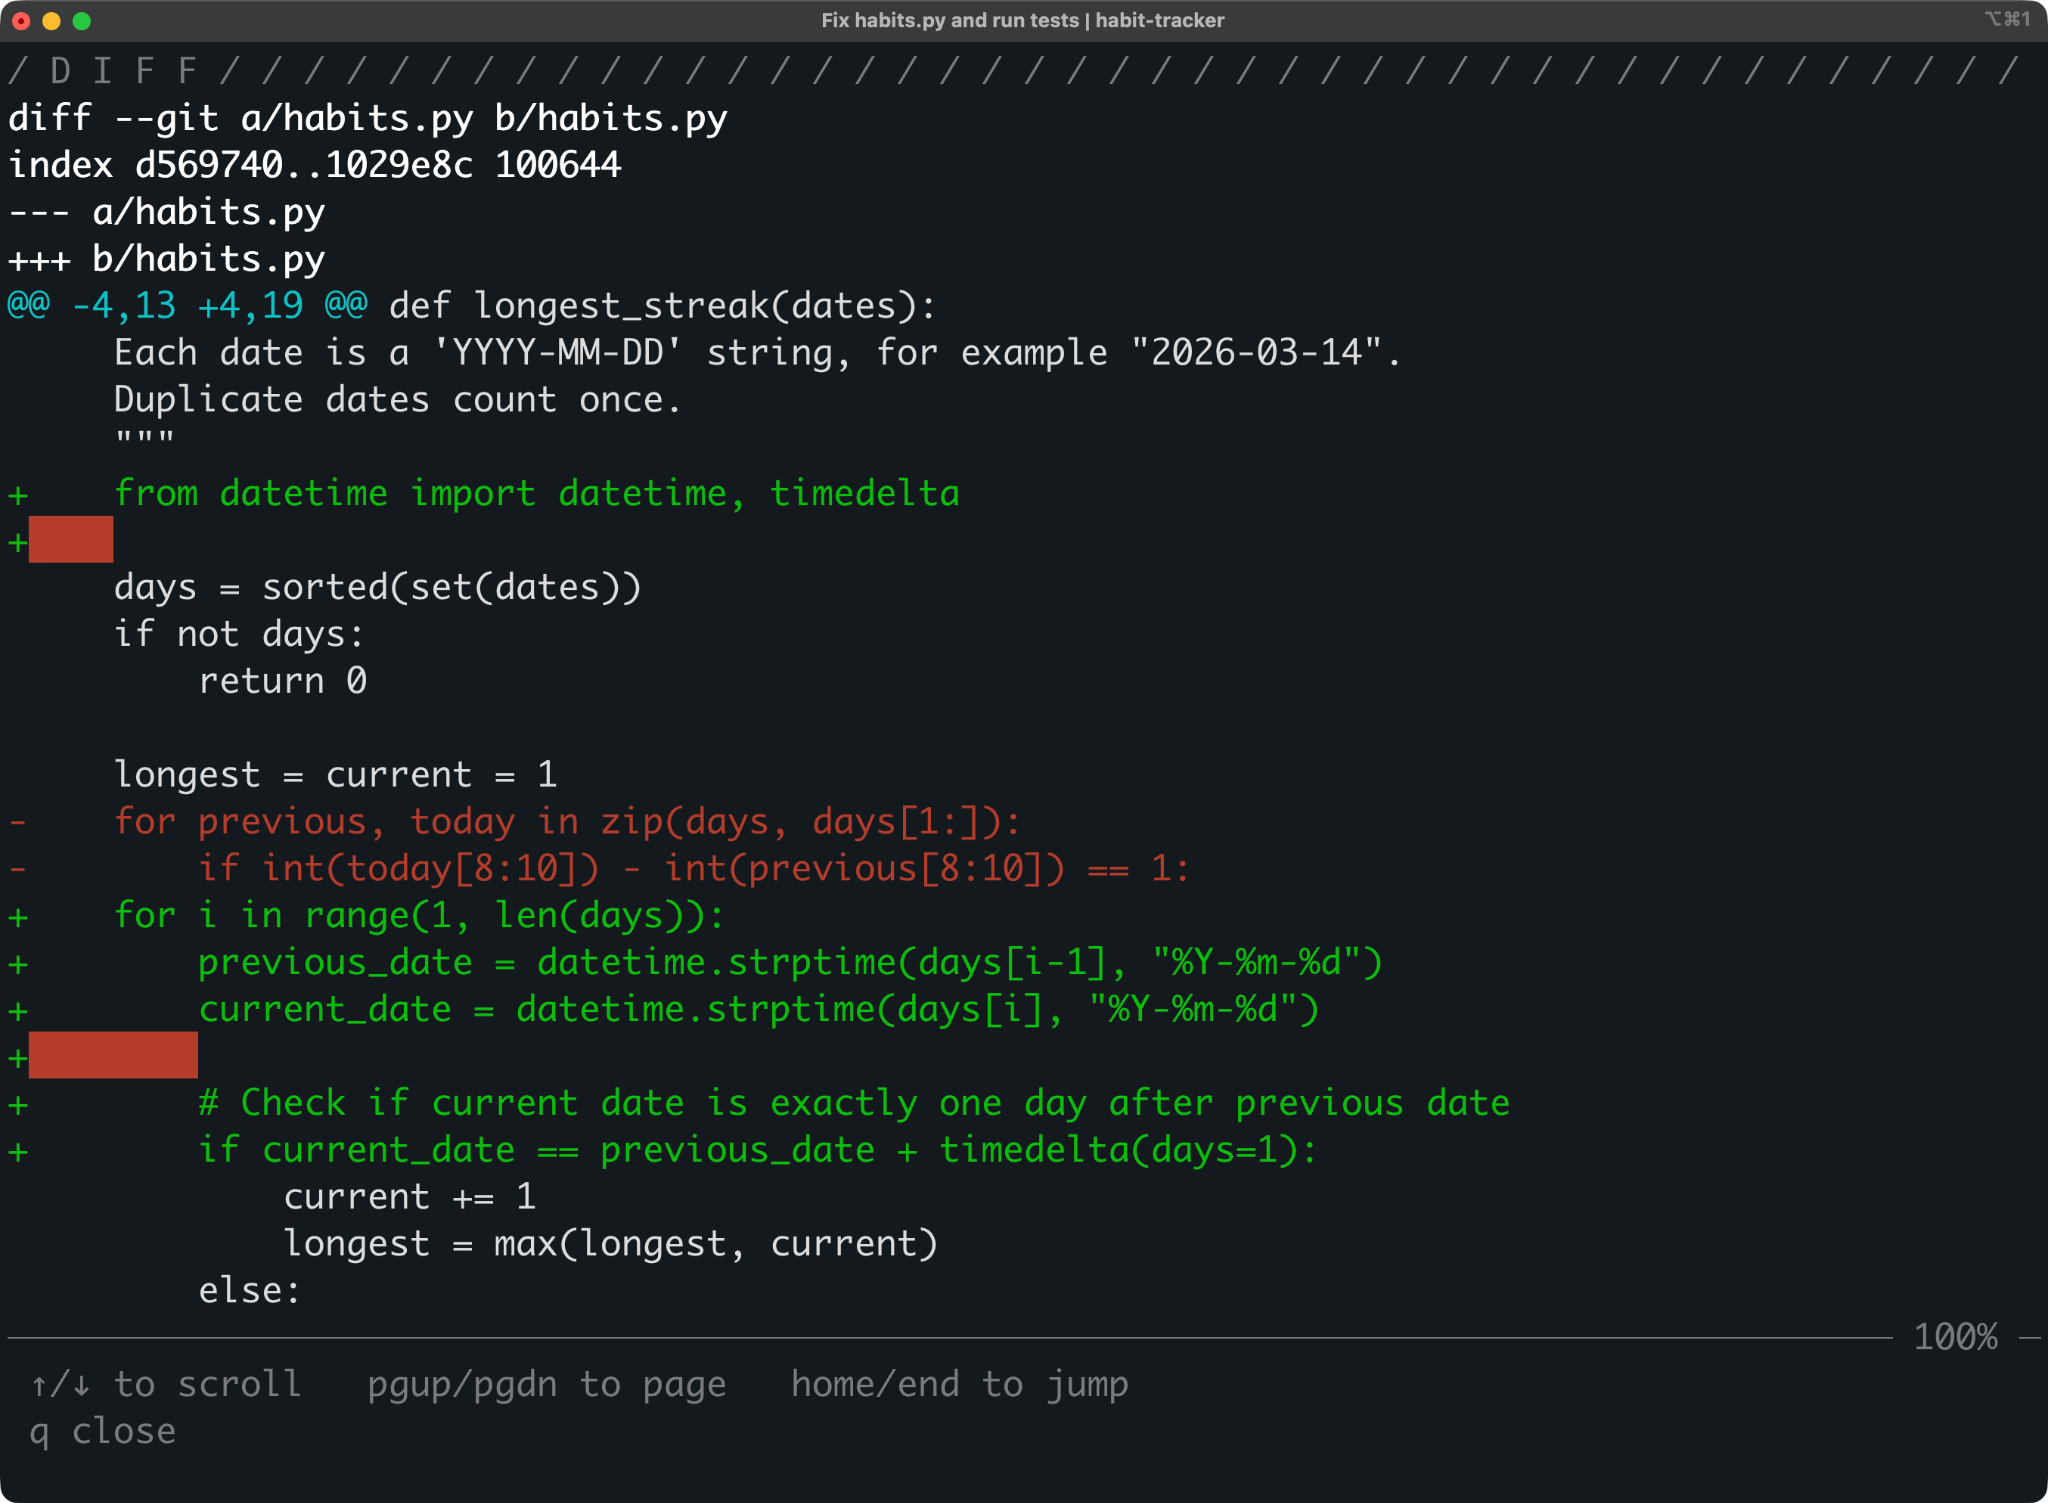
Open Interpreter द्वारा किए गए बदलावों का डिफ
सटीक डिफ मॉडल पर निर्भर करता है, इसलिए आपका ऊपर वाले से लाइन‑दर‑लाइन मेल न भी खाए। यदि बदलाव पसंद हो, तो कमिट करें, और यदि नहीं, तो मूल फाइल बहाल करें:
git restore habits.pyयही विचार है। आप समस्या बताते हैं, एजेंट जाँचता और ठीक करता है, और आप हर बदलाव की समीक्षा करते हैं, उसके आपके कोड का हिस्सा बनने से पहले।
Open Interpreter आपसे अपना मॉडल लाने की अपेक्षा करता है।
हर रिक्वेस्ट इन तीन लेयर्स से होकर जाती है:
| लेयर | उदाहरण | यह क्या नियंत्रित करता है |
|---|---|---|
| प्रोवाइडर | ollama | रिक्वेस्ट कहाँ जाती हैं और आप कैसे ऑथेंटिकेट करते हैं |
| मॉडल | devstral-small-2 | वह मॉडल जो काम करता है |
| हार्नेस | native | मॉडल के चारों ओर प्रॉम्प्ट, टूल्स और मैसेज फॉर्मैट |
रिक्वेस्ट लेयर्स
आप ये कनेक्ट कर सकते हैं:
प्रोवाइडर सूची एक सार्वजनिक मॉडल कैटलॉग से बनती है, और यह केवल उन मॉडल्स को रखती है जो टूल कॉलिंग सपोर्ट करते हैं। यदि कोई अपेक्षित मॉडल गायब है, तो आमतौर पर यही कारण होता है।
ध्यान रखें कि ollama-cloud पर नज़र रहे। यह अलग होस्टेड प्रोवाइडर है, इसलिए आपकी रिक्वेस्ट आपकी मशीन से बाहर जाती हैं। केवल बिल्ट‑इन ollama प्रोवाइडर मॉडल्स को लोकली चलाता है।
आप तीन स्तरों पर मॉडल बदल सकते हैं:
सेशन के अंदर: /model चलाकर प्रोवाइडर, मॉडल और reasoning effort चुनें
एकल रन के लिए: पिछले सेक्शन की तरह -m फ़्लैग पास करें
डिफ़ॉल्ट के रूप में: अपनी कॉन्फ़िग फाइल में सेट करें
आप किसी भी समय /status चलाकर देख सकते हैं कि कौन सा प्रोवाइडर और मॉडल सक्रिय है।
Open Interpreter अपनी सेटिंग्स ~/.openinterpreter/config.toml से पढ़ता है। पिछली सेक्शन वाला Ollama सेटअप अपना डिफ़ॉल्ट बनाने के लिए ये दो लाइनें जोड़ें:
model_provider = "ollama"
model = "qwen3-coder:30b"
इसके बाद, interpreter इसी मॉडल के साथ शुरू होगा और आपको कोई फ़्लैग नहीं चाहिए होगा।
होस्टेड प्रोवाइडर्स अपनी API कीज़ एन्वायरनमेंट वेरिएबल्स से पढ़ते हैं। उदाहरण के लिए, DeepSeek को DEEPSEEK_API_KEY चाहिए:
export DEEPSEEK_API_KEY="your-api-key"आप किसी भी OpenAI‑कम्पैटिबल एंडपॉइंट को कस्टम प्रोवाइडर के रूप में भी जोड़ सकते हैं:
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
wire_api सेटिंग Open Interpreter को बताती है कि एंडपॉइंट किस रिक्वेस्ट फॉर्मैट की अपेक्षा करता है। OpenAI‑कम्पैटिबल Chat Completions के लिए chat उपयोग करें, OpenAI Responses API के लिए responses, और Anthropic‑स्टाइल एंडपॉइंट्स के लिए messages।
किसी विश्वसनीय प्रोजेक्ट में अपना .openinterpreter/config.toml भी हो सकता है, जो आपकी यूज़र कॉन्फ़िग को ओवरराइड करता है। कमांड‑लाइन फ़्लैग दोनों को ओवरराइड करते हैं। यदि यकीन न हो कि कौन‑सा मान प्रभावी है, तो /debug-config चलाकर प्रभावी सेटिंग्स और उनके स्रोत देखें।
मॉडल तय करता है कि एजेंट आपका कोड कितनी अच्छी तरह समझता है। हार्नेस तय करता है कि मॉडल टास्क और टूल्स को कैसे देखता है।
दोनों चाहिए। गलत हार्नेस में अच्छा मॉडल भी बिगड़े हुए टूल कॉल भेजता है और नतीजों को गलत पढ़ता है। और अच्छा हार्नेस ऐसे मॉडल की कमी पूरी नहीं कर सकता जो कोड समझ ही न पाए।
इसीलिए Open Interpreter जब आप मॉडल चुनते हैं तो एक हार्नेस भी चुनता है। उदाहरण के लिए:
Claude मॉडल्स को claude-code हार्नेस मिलता है
Kimi मॉडल्स को kimi-code मिलता है
Qwen मॉडल्स को qwen-code मिलता है
DeepSeek मॉडल्स को claude-code-bare मिलता है
अन्य मॉडल फ़ैमिलीज़ के लिए, आप /harness के साथ खुद हार्नेस चुन सकते हैं।
याद रखने की बात यह है कि कमज़ोर नतीजा हमेशा कमज़ोर मॉडल का मतलब नहीं होता। मॉडल बदलने से पहले, उसी मॉडल को किसी दूसरे हार्नेस के साथ आज़माएँ—इसे मैं अगले सेक्शन में विस्तार से कवर करूँगा।
हार्नेस इम्यूलेशन वर्तमान Open Interpreter संस्करण के अस्तित्व का मुख्य कारण है।
एजेंट हार्नेस मॉडल के चारों ओर की हर चीज़ है जो उसे एजेंट में बदलती है। इसमें शामिल हैं:
सरल भाषा में, हार्नेस तय करता है कि मॉडल काम को कैसे देखता है और उसके फैसले कार्रवाइयों में कैसे बदलते हैं।
Open Interpreter में बिल्ट‑इन हार्नेस मोड्स का सेट है। आप ज़्यादातर इन्हें इस्तेमाल करेंगे:
native: Open Interpreter का अपना हार्नेस, Codex से प्राप्त
claude-code: Anthropic के Claude Code के प्रॉम्प्ट्स और टूल सरफेस की नकल करता है
kimi-code: Moonshot द्वारा Kimi मॉडल्स के लिए अनुशंसित Kimi Code हार्नेस का Rust री‑इम्प्लीमेंटेशन
qwen-code: Alibaba के Qwen मॉडल्स के लिए Qwen Code CLI की नकल करता है
swe-agent: SWE-agent की नकल करता है, जो GitHub इश्यू हल करने के लिए बनाया गया एक शोध एजेंट है
पूरी सूची में claude-code-bare, kimi-cli, deepseek-tui, zcode, और minimal जैसे वेरिएंट भी हैं। आपका संस्करण क्या सपोर्ट करता है, यह देखने के लिए सेशन में /harness चलाएँ।
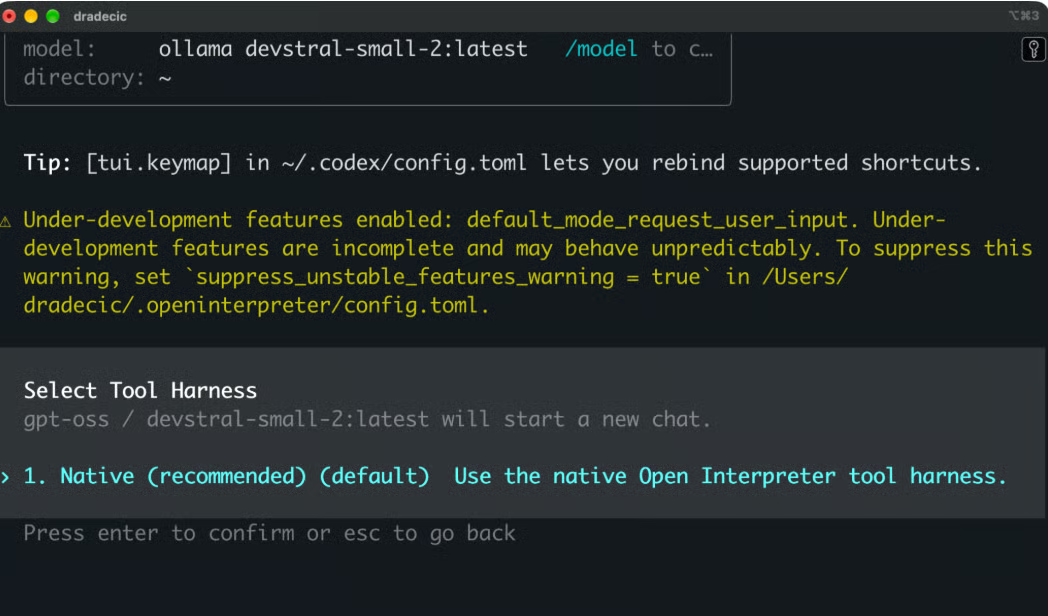
आप /harness के साथ सेशन के बीच में हार्नेस बदल सकते हैं, या ~/.openinterpreter/config.toml में डिफ़ॉल्ट सेट कर सकते हैं:
harness = "kimi-code"
harness_guidance = true
harness_guidance सेटिंग जहाँ हार्नेस अनुमति देता है, वहाँ एक रिलायबिलिटी गाइडेंस जोड़ती है। यदि आप और कड़ाई से इम्यूलेशन चाहते हैं तो इसे false कर दें। यदि आप harness सेट नहीं करते, तो Open Interpreter मॉडल फ़ैमिली के आधार पर एक चुनता है, जैसा आपने पिछले सेक्शन में देखा।
ज़्यादातर मॉडल वेंडर्स अपने कोडिंग मॉडल्स को एक विशेष एजेंट सेटअप के अंदर ट्यून करते हैं, और वे उसके साथ जाने के लिए एक अनुशंसित हार्नेस प्रकाशित करते हैं।
मॉडल उस हार्नेस का आदी हो जाता है। वह उसके प्रॉम्प्ट स्टाइल, टूल नाम, फाइल एडिट फॉर्मैट, और टूल नतीजों के वापस आने के तरीके को सीखता है।
मान लीजिए आप एक ऐसे हार्नेस में मॉडल चलाते हैं जो फुल पैच फाइल्स की अपेक्षा करता है, जबकि मॉडल सर्च‑एंड‑रिप्लेस एडिट्स के लिए ट्यून है। मॉडल जानता है कि कौन‑सा बदलाव करना है, पर वही बदलाव गलत फॉर्मैट में बताता रहता है। एजेंट लूप बिना प्रगति के टोकन खर्च करता जाता है।
टूल नतीजों के साथ भी यही होता है। यदि हार्नेस नतीजे ऐसे फॉर्मैट में लौटाता है जो मॉडल ने नहीं देखा, तो मॉडल उन्हें गलत पढ़ता है। यदि हार्नेस टर्न्स के बीच मॉडल की रीजनिंग हटा देता है, तो सोचने वाला मॉडल अपनी ही योजना का धागा खो देता है।
इसका मतलब है कि वही मॉडल, बिना किसी वेट बदलाव के, एक एजेंट में अच्छा और दूसरे में कमज़ोर दिख सकता है। यही कारण है कि कोडिंग बेंचमार्क परिणाम आमतौर पर हर रन के लिए उपयोग किए गए हार्नेस का नाम बताते हैं।
फ्रंटियर मॉडल्स अनजान हार्नेस से अक्सर उबर लेते हैं, लेकिन छोटे और सस्ते मॉडल्स आमतौर पर नहीं। Open Interpreter हर मॉडल को एक ही फॉर्मैट में ठूँसता नहीं, बल्कि फॉर्मैट को मॉडल के अनुसार बदलता है।
आप इसे डेमो प्रोजेक्ट के साथ खुद टेस्ट कर सकते हैं। git restore habits.py के साथ मूल फाइल बहाल करें, /harness से हार्नेस बदलें, और एजेंट को वही प्रॉम्प्ट फिर दें। फिर तुलना करें कि उसे कितने स्टेप लगते हैं और वह अपने एडिट्स को कैसे फॉर्मैट करता है।
आपने इस लेख में इनमें से अधिकांश विशेषताएँ देख ली हैं। रोज़मर्रा के डेवलपमेंट में प्रत्येक से आपको क्या मिलता है, यह रहा।
Open Interpreter आपके Git रिपोजिटरी के अंदर काम करता है। यह प्रोजेक्ट स्ट्रक्चर पढ़ता है और जो बदलाव किया उसे ट्रैक करता है।
यहाँ दो स्लैश कमांड मददगार हैं। /diff कार्यरत ट्री के बदलाव दिखाता है, और /review कमिट से पहले वर्तमान बदलावों को बग और रिग्रेशन के लिए जाँचने को एजेंट से कहता है। बिना इंटरैक्टिव सेशन खोले भी आप यही रिव्यू चला सकते हैं:
interpreter exec review --uncommittedसेशन्स सेव भी होते हैं। यदि आप किसी काम के बीच में रुकते हैं, तो interpreter resume --last वहीं से आगे बढ़ा देता है।
एजेंट वही कमांड्स चलाता है जो आप चलाते हैं, जैसे टेस्ट सूट्स, लिंटर्स, बिल्ड स्क्रिप्ट्स और पैकेज मैनेजर्स। ये सब macOS, Linux और Windows पर नेटिव सैंडबॉक्सिंग के अंदर चलते हैं।
लंबे समय तक चलने वाले कमांड्स बैकग्राउंड में चल सकते हैं। /ps से उन्हें सूचीबद्ध करें और /stop से बंद करें।
स्क्रिप्ट्स और CI पाइपलाइन्स के लिए, interpreter exec इंटरैक्टिव UI के बिना कोई टास्क चलाता है:
interpreter exec "fix the failing test"आप किसी भी समय /model से प्रोवाइडर और मॉडल बदल सकते हैं। आपका कॉन्फ़िग, AGENTS.md, और स्किल्स स्विच के बाद भी लागू रहते हैं।
यहाँ प्रोफ़ाइल्स मददगार हैं। मान लें आपको रूटीन काम के लिए सस्ता मॉडल और कोड रिव्यू के लिए मज़बूत मॉडल चाहिए। आप दोनों को अपनी कॉन्फ़िग में परिभाषित कर सकते हैं:
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
फिर जब जरूरत हो, interpreter --profile review के साथ शुरू करें।
/harness मॉडल बदले बिना यह बदलता है कि मॉडल टास्क को कैसे देखता है। जब कोई मॉडल टूल कॉल्स में जूझता है, तो बड़े मॉडल पर जाने से पहले यही पहली चीज़ आज़माएँ।
Model Context Protocol (MCP) एजेंट को उन टूल्स से जोड़ता है जिनके साथ इसे काम करने के लिए डिज़ाइन नहीं किया गया था, जैसे डॉक्यूमेंटेशन सर्वर या डेटाबेस। आप अपने कॉन्फ़िग में सर्वर जोड़ते हैं:
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
/mcp चलाकर कॉन्फ़िगर किए गए सर्वर और उनके टूल्स देखें। default_tools_approval_mode सेटिंग एजेंट को उस सर्वर के टूल का उपयोग करने से पहले पूछने को कहती है।
यह उल्टा भी काम करता है। interpreter mcp-server Open Interpreter को एक MCP सर्वर के रूप में एक्सपोज़ करता है, और interpreter acp इसे उन एडिटर्स के अंदर चलाता है जो Agent Client Protocol सपोर्ट करते हैं—यह एडिटर्स को कोडिंग एजेंट्स से जोड़ने का एक ओपन स्टैंडर्ड है।
AGENTS.md आपकी रिपोजिटरी में एक Markdown फाइल है जिसमें प्रोजेक्ट नियम होते हैं जिन्हें एजेंट हर टास्क पर पढ़ता है। हैबिट ट्रैकर के लिए, यह कुछ ऐसा दिख सकता है:
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
आप /init भी चला सकते हैं, और एजेंट आपके लिए पहला संस्करण लिख देता है।
स्किल्स पुन: उपयोग योग्य वर्कफ़्लोज़ हैं, जिन्हें आपके प्रोजेक्ट के अंदर .agents/skills या आपके यूज़र के लिए ~/.agents/skills में फ़ोल्डर्स के रूप में पैक किया जाता है। जैसे ही कोई टास्क किसी स्किल से मेल खाता है, एजेंट उसे स्वतः उठा लेता है। कौन‑कौन सी उपलब्ध हैं यह देखने के लिए /skills चलाएँ।
दोनों साझा फॉर्मैट हैं, इसलिए ये ही फाइलें अन्य कोडिंग एजेंट्स के साथ भी काम करती हैं जो इन्हें सपोर्ट करते हैं। Open Interpreter हुक्स भी सपोर्ट करता है, जो सेशन के तय बिंदुओं पर आपके अपने कमांड्स चलाते हैं। आप /hooks के साथ उनकी समीक्षा और भरोसा तय करते हैं।
दो सेटिंग्स तय करती हैं कि एजेंट क्या कर सकता है:
सैंडबॉक्स मोड: read-only, workspace-write, या danger-full-access
अप्रूवल पॉलिसी: untrusted, on-request, या never
सैंडबॉक्स तय करता है कि क्या संभव है, और अप्रूवल पॉलिसी तय करती है कि एजेंट कब पहले पूछे। workspace-write और on-request के साथ, एजेंट आपका प्रोजेक्ट एडिट कर सकता है और टेस्ट चला सकता है, लेकिन उससे आगे की पहुँच से पहले पूछता है।
आप दोनों को /permissions से या -s और -a फ़्लैग्स से बदल सकते हैं। एक --yolo फ़्लैग भी है जो दोनों को बायपास करता है, और डॉक्यूमेंटेशन इसे खतरनाक बताता है। मैं इन सेटिंग्स को सुरक्षा सेक्शन में विस्तार से कवर करूँगा।
Open Interpreter खुद को कम‑लागत मॉडल्स के लिए बना कोडिंग एजेंट बताता है।
सबसे बड़े प्रोपाइरटेरी कोडिंग एजेंट अपने वेंडर के मॉडल्स के इर्द‑गिर्द बने होते हैं। Open Interpreter आपको एक ऐसा एजेंट देता है जो प्रोपाइरटेरी मॉडल्स, होस्टेड ओपन‑वेट मॉडल्स, और लोकल मॉडल्स—सबके साथ काम करता है।
Kimi, DeepSeek, GLM और Qwen जैसे ओपन‑वेट मॉडल्स के वेट्स सार्वजनिक होते हैं। आप उन्हें किसी थर्ड‑पार्टी प्रोवाइडर के जरिए या अपने हार्डवेयर पर उपयोग कर सकते हैं।
इससे आपको दो फायदे मिलते हैं। होस्टेड ओपन‑वेट मॉडल्स आमतौर पर फ्रंटियर प्रोपाइरटेरी मॉडल्स की तुलना में प्रति टोकन कम लागत के होते हैं। और आप एक होस्ट तक सीमित नहीं हैं, क्योंकि वही मॉडल जहाँ भी उसके वेट्स चलें वहाँ चल सकता है।
Open Interpreter में Kimi K3, DeepSeek, और GLM के लिए समर्पित प्रोवाइडर गाइड हैं। यह इन मॉडल फ़ैमिलीज़ के लिए मेल खाता हार्नेस भी चुनता है।
Ollama और LM Studio बिल्ट‑इन प्रोवाइडर्स हैं, इसलिए आप बिना API की या प्रति‑टोकन लागत के अपने मशीन पर मॉडल चला सकते हैं।
लागत हार्डवेयर की होती है। जब मैंने अपने MacBook Pro M1 Max (64GB यूनिफाइड मेमोरी) पर devstral-small-2 का परीक्षण किया, तो केवल मॉडल ने ही 26 GB ले लिए। एजेंट लूप के लिए डिफ़ॉल्ट Ollama कॉन्टेक्स्ट विंडो बहुत छोटी थी, और 128k टोकन्स पर, मेमोरी उपयोग चढ़ता‑उतरता रहा जब तक सेशन रुक नहीं गया।
कोडिंग एजेंट्स को बड़ा कॉन्टेक्स्ट विंडो चाहिए, क्योंकि सिस्टम प्रॉम्प्ट, टूल डिफिनिशन, फाइल कंटेंट और कमांड आउटपुट—सबको फिट होना पड़ता है। Codex‑स्टाइल एजेंट्स के लिए Ollama कम से कम 64k टोकन्स की सिफारिश करता है। और बड़ा कॉन्टेक्स्ट विंडो, मॉडल के ऊपर, और मेमोरी लेता है।
Open Interpreter आपके मशीन पर चलता है, लेकिन मॉडल का चलना आवश्यक नहीं है।
आपका कोड कहाँ जाता है, यह प्रोवाइडर पर निर्भर करता है:
आपका कॉन्फ़िग, सेशंस और लॉग्स हर हाल में लोकल रूप से ~/.openinterpreter के अंतर्गत स्टोर होते हैं।
यदि आपको और नियंत्रण चाहिए, तो आप एक कस्टम प्रोवाइडर जोड़ सकते हैं जो आपके अपने इन्फ़ेरेंस सर्वर की ओर पॉइंट करे। कोई भी सर्वर जिसमें OpenAI-कम्पैटिबल API हो, काम करेगा—उदाहरण के लिए आपकी कंपनी के GPUs पर vLLM डिप्लॉयमेंट। इस तरह, आपको एक होस्टेड सेटअप मिलता है जिसकी इन्फ्रास्ट्रक्चर आपकी अपनी होती है।
ओपन मॉडल्स टूल कॉलिंग में समान रूप से अच्छे नहीं होते। कमजोर टूल उपयोग बिगड़े हुए कॉल्स, लूप्स, समय से पहले रुकना या कमांड आउटपुट को नज़रअंदाज़ करने के रूप में दिखेगा।
सही हार्नेस मदद करता है, लेकिन वह ऐसे मॉडल को नहीं सुधार सकता जो मल्टी-स्टेप टास्क की योजना नहीं बना पाता। छोटे लोकल मॉडल्स में यहाँ सबसे ज़्यादा दिक्कत आती है।
किसी नए मॉडल को असली प्रोजेक्ट पर लगाने से पहले, उसे किसी छोटे रिपॉज़िटरी पर टेस्ट करें—जैसे इस लेख में दिखाया गया हैबिट ट्रैकर। यदि कोई कमजोरी दिखे, तो बड़े मॉडल पर जाने से पहले अलग हार्नेस आज़माएँ।
यहाँ आपके विकल्पों का एक त्वरित रिकैप है:
| इन्फ़ेरेंस कहाँ चलता है | लागत | क्या कोड आपकी मशीन से बाहर जाता है? | |
|---|---|---|---|
| प्रोप्राइटरी होस्टेड मॉडल | वेंडर का सर्वर | प्रति टोकन या सब्सक्रिप्शन | हाँ |
| ओपन-वेट होस्टेड मॉडल | प्रोवाइडर का सर्वर | प्रति टोकन, आमतौर पर कम | हाँ |
| ओपन-वेट लोकल मॉडल | आपका हार्डवेयर | हार्डवेयर और बिजली | नहीं |
लोकल और ओपन मॉडल्स के लिए Open Interpreter के विकल्प
Open Interpreter अन्य टर्मिनल कोडिंग एजेंट्स से बहुत कुछ साझा करता है। फर्क इस बात में है कि टूल का मालिक कौन है और यह किन मॉडल्स के लिए बनाया गया है।
Claude Code Anthropic का टर्मिनल कोडिंग एजेंट है। पहला अंतर स्वामित्व है—Claude Code प्रोप्राइटरी है, जबकि Open Interpreter Apache 2.0 लाइसेंस के तहत ओपन सोर्स है। आप Open Interpreter के हर हिस्से को पढ़ और बदल सकते हैं।
दूसरा अंतर मॉडल चयन का है। Claude Code, Claude मॉडल्स के लिए बना है। आप इसे अन्य प्रोवाइडर्स के Anthropic-कम्पैटिबल एंडपॉइंट्स की ओर पॉइंट कर सकते हैं, लेकिन इसका हार्नेस Claude के लिए ही ट्यून रहता है। Open Interpreter मॉडल चयन को मुख्य फ़ीचर की तरह लेता है।
हार्नेस तुलना सबसे दिलचस्प है। Claude Code स्वयं उन हार्नेस में से एक है जिसकी नकल Open Interpreter करता है। claude-code मोड के साथ, कोई भी मॉडल Open Interpreter के रनटाइम के अंदर Claude Code-शैली के प्रॉम्प्ट्स और टूल्स पाता है। UI और स्लैश कमांड अब भी Open Interpreter के हैं, इसलिए यह सिर्फ अलग मॉडल के साथ वही उत्पाद नहीं है।
दोनों टूल्स टर्मिनल-फर्स्ट हैं। प्रत्येक में एक इंटरैक्टिव सत्र और स्क्रिप्ट्स व CI के लिए एक नॉन-इंटरैक्टिव मोड है। प्रोजेक्ट निर्देशों के लिए, Claude Code CLAUDE.md पढ़ता है, जबकि Open Interpreter साझा AGENTS.md फॉर्मेट का उपयोग करता है।
Claude Code का इकोसिस्टम बड़ा है। यह IDE एक्सटेंशन्स, डेस्कटॉप और वेब ऐप्स, प्लगइन मार्केटप्लेस, सबएजेंट्स और SDK के साथ आता है। Open Interpreter नया है, और यह अपने इकोसिस्टम के बजाय MCP, स्किल्स, AGENTS.md और Agent Client Protocol जैसे साझा मानकों पर निर्भर करता है।
यदि आप Claude मॉडल्स के साथ काम करते हैं और सबसे पॉलिश्ड अनुभव चाहते हैं, तो Claude Code सुरक्षित विकल्प है। यदि आप अन्य मॉडल्स चलाना या प्रोप्राइटरी टूल से बचना चाहते हैं, तो Open Interpreter चुनें।
OpenCode सबसे नज़दीकी मेल है। दोनों ओपन सोर्स हैं, टर्मिनल-फर्स्ट दृष्टिकोण रखते हैं, और कई मॉडल प्रोवाइडर्स की लंबी सूची के साथ काम करने के लिए बने हैं।
कागज़ पर मॉडल सपोर्ट समान है। OpenCode 75 से अधिक प्रोवाइडर्स को सपोर्ट करता है, और Open Interpreter अपना प्रोवाइडर लिस्ट पब्लिक मॉडल कैटलॉग से जनरेट करता है। दोनों Ollama के माध्यम से लोकल मॉडल्स चलाते हैं।
टर्मिनल अनुभव में ज़्यादा फर्क है। OpenCode का अपना TUI है जिसमें Language Server Protocol (LSP) इंटीग्रेशन है, जो टाइप एरर्स जैसी कोड डायग्नोस्टिक्स मॉडल को वापस फीड करता है। Open Interpreter का TUI Codex से आता है।
कॉन्फ़िगरेशन के लिहाज से, OpenCode opencode.json फ़ाइल का उपयोग करता है, और Open Interpreter प्रोफाइल्स के साथ config.toml का।
एजेंट आर्किटेक्चर मुख्य अंतर है। OpenCode क्लाइंट और सर्वर के रूप में चलता है, जहाँ TUI एक लोकल सर्वर का क्लाइंट है जिससे अन्य क्लाइंट्स भी जुड़ सकते हैं। इसमें बिल्ट-इन build और plan एजेंट्स हैं, और यह कस्टम एजेंट्स और सबएजेंट्स को सपोर्ट करता है। यह हर मॉडल फैमिली के लिए सिस्टम प्रॉम्प्ट समायोजित करता है, लेकिन टूल्स और लूप OpenCode के अपने रहते हैं। Open Interpreter आगे जाता है और पूरा हार्नेस बदल देता है, जिसमें टूल स्कीमा और मैसेज फॉर्मेट शामिल हैं। नए बिल्ड्स में opencode हार्नेस मोड भी शामिल है।
डेवलपमेंट पक्ष पर, OpenCode अपना अलग कोडबेस है, जो इसकी टीम और समुदाय द्वारा बनाया गया है। Open Interpreter एक Codex फोर्क पर आधारित है, इसलिए इसके रनटाइम का बड़ा हिस्सा अपस्ट्रीम से आता है। यह एक ट्रेड-ऑफ़ है। Open Interpreter को Codex का सैंडबॉक्स और रनटाइम मुफ़्त में मिल जाता है, जबकि OpenCode अपने पूरे स्टैक पर नियंत्रण रखता है।
ये दोनों सामान्य अर्थ में प्रतिद्वंद्वी नहीं हैं। Open Interpreter Codex का फोर्क है।
ये Rust रनटाइम, TUI, सैंडबॉक्सिंग, अप्रूवल्स, AGENTS.md, स्किल्स, MCP, exec मोड, और ज़्यादातर स्लैश कमांड्स साझा करते हैं। जब मैंने Open Interpreter चलाया, सेशन रेज़्यूमे हिंट अब भी codex resume कह रहा था।
Codex OpenAI का एजेंट है, जो OpenAI मॉडल्स के इर्द-गिर्द बना है। यह --oss और कस्टम प्रोवाइडर्स के साथ लोकल मॉडल्स को सपोर्ट करता है, लेकिन डिफ़ॉल्ट अनुभव OpenAI को लक्षित करता है।
Open Interpreter कुछ पहलुओं में Codex का विस्तार करता है:
हार्नेस एम्यूलेशन: यह हर मॉडल फैमिली के अनुसार प्रॉम्प्ट्स, टूल स्कीमा और मैसेज फॉर्मेट बदल देता है
प्रोवाइडर सपोर्ट: इसमें जनरेटेड प्रोवाइडर कैटलॉग है और Kimi K3, DeepSeek, और GLM के लिए समर्पित गाइड्स हैं
Chat Completions: --chat-completions फ़्लैग किसी भी OpenAI-कम्पैटिबल प्रोवाइडर को चलाता है
Codex SDK ओवरराइड: Codex SDK पर बने ऐप्स इसके बजाय Open Interpreter के माध्यम से चल सकते हैं
Open Interpreter अपना कॉन्फ़िग और सेशंस भी ~/.openinterpreter के अंतर्गत स्टोर करता है, इसलिए यह Codex इंस्टॉल से नहीं टकराता।
यदि आप ज़्यादातर OpenAI मॉडल्स का उपयोग करते हैं, तो Codex बेहतर विकल्प है। यदि आप अन्य मॉडल्स का उपयोग करते हैं, तो Open Interpreter वही वर्कफ़्लो उनके लिए बेहतर सपोर्ट के साथ देता है।
यहाँ एक त्वरित रिकैप है:
| लाइसेंस | मॉडल्स | हार्नेस दृष्टिकोण | कॉन्फ़िग | |
|---|---|---|---|---|
| Open Interpreter | ओपन सोर्स (Apache 2.0) | कोई भी प्रोवाइडर, होस्टेड या लोकल | हर मॉडल के अनुसार हार्नेस एम्यूलेट करता है | config.toml |
| Claude Code | प्रोप्राइटरी | Claude मॉडल्स के लिए बनाया गया | Claude Code का अपना हार्नेस | settings.json और CLAUDE.md |
| OpenCode | ओपन सोर्स (MIT) | 75+ प्रोवाइडर्स, होस्टेड या लोकल | एक हार्नेस, मॉडल-विशिष्ट प्रॉम्प्ट्स के साथ | opencode.json |
| Codex | ओपन सोर्स (Apache 2.0) | OpenAI मॉडल्स के लिए, --oss के साथ | Codex का अपना हार्नेस | config.toml |
Open Interpreter की तुलना अन्य AI कोडिंग एजेंट्स से
सबसे बुरा जो एक चैटबॉट कर सकता है, वह है आपको खराब उत्तर देना—जिसे आप नज़रअंदाज़ कर सकते हैं। एक कोडिंग एजेंट आपकी मशीन पर कमांड्स चलाता है, फ़ाइलें पढ़ता-लिखता है, और नेटवर्क तक पहुँच सकता है। मॉडल का गलत फ़ैसला, या प्रॉम्प्ट इंजेक्शन, वास्तविक नुकसान कर सकता है। प्रॉम्प्ट इंजेक्शन का मतलब है वह निर्देश जो एजेंट द्वारा पढ़ी जा रही सामग्री में छिपे हों, जैसे README फ़ाइल या वेब पेज।
Open Interpreter, Codex रनटाइम से अपना सुरक्षा मॉडल प्राप्त करता है। इसमें दो परतें हैं—एक सैंडबॉक्स जो संभावनाओं को सीमित करता है, और एक अप्रूवल पॉलिसी जो तय करती है कि एजेंट कब पहले आपसे पूछे।
एजेंट द्वारा चलाया गया हर कमांड macOS, Linux और Windows पर OS-स्तरीय सैंडबॉक्स से होकर गुजरता है। सैंडबॉक्स के तीन मोड होते हैं:
read-only: एजेंट फ़ाइलें पढ़ सकता है, लेकिन कुछ बदल नहीं सकता
workspace-write: एजेंट आपके प्रोजेक्ट फ़ोल्डर के अंदर फ़ाइलें एडिट कर सकता है और कमांड्स चला सकता है
danger-full-access: बिल्कुल भी सैंडबॉक्स नहीं
workspace-write के साथ, फ़ाइल लिखना सक्रिय वर्कस्पेस तक सीमित है। एजेंट आपका कोड ठीक कर सकता है, लेकिन आपकी मशीन पर अन्य जगहों की फ़ाइलें एडिट नहीं कर सकता।
workspace-write मोड में, कमांड्स को डिफ़ॉल्ट रूप से नेटवर्क एक्सेस नहीं होता। यह डाउनलोड्स को ब्लॉक करता है और एजेंट को आपका कोड कहीं भेजने से रोकता है।
कुछ कार्यों को नेटवर्क की ज़रूरत होती है, जैसे कोई पैकेज इंस्टॉल करना। आप अपने कॉन्फ़िग में नेटवर्क एक्सेस ऑन कर सकते हैं:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
इसे केवल उन्हीं प्रोजेक्ट्स के लिए ऑन करें जहाँ इसकी ज़रूरत हो।
अप्रूवल पॉलिसी तय करती है कि एजेंट कब रुके और पूछे:
untrusted: उन कमांड्स से पहले पूछता है जो ट्रस्टेड सूची में नहीं हैं
on-request: तब पूछता है जब किसी कार्य को सैंडबॉक्स से अधिक एक्सेस चाहिए
never: कभी नहीं पूछता
वर्ज़न-कंट्रोल्ड प्रोजेक्ट्स के लिए, workspace-write के साथ on-request अच्छा डिफ़ॉल्ट है। एजेंट आपके प्रोजेक्ट के अंदर काम करता है और आगे बढ़ने से पहले पूछता है। Git कुछ गलत होने पर वापसी का रास्ता देता है।
--yolo फ़्लैग सैंडबॉक्स और अप्रूवल्स दोनों को बंद कर देता है। इसे केवल डिस्पोज़ेबल एनवायरनमेंट—जैसे कंटेनर या VM—में उपयोग करें।
एजेंट द्वारा चलाए गए कमांड्स आपके शेल एनवायरनमेंट को इनहेरिट करते हैं। यदि आपकी API कुंजियाँ एनवायरनमेंट वेरिएबल्स में हैं, तो वे कमांड्स उन्हें देख सकते हैं।
आप इसे shell_environment_policy से सीमित कर सकते हैं:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
core सेटिंग केवल बुनियादी वेरिएबल्स जैसे HOME और PATH पास करती है, और exclude उन सबको हटाता है जो पैटर्न से मेल खाते हैं।
फ़ाइलें एक और जोखिम हैं। एजेंट आपके प्रोजेक्ट में मौजूद .env फ़ाइल को read-only मोड में भी पढ़ सकता है। होस्टेड प्रोवाइडर के साथ, एजेंट जो कुछ भी पढ़ता है, वह उस प्रोवाइडर के सर्वर्स पर जाता है।
यह याद रखने वाली बात है कि सैंडबॉक्स नुकसान को सीमित करता है, लेकिन इसे सुरक्षा जाल की तरह समझें—गारंटी की तरह नहीं।
एजेंट को अपने आप चलने देने से पहले, /status चलाएँ और सैंडबॉक्स मोड तथा अप्रूवल पॉलिसी जाँचें।
यदि आपको कोई ऐसा Open Interpreter आर्टिकल मिले जो pip install से शुरू होता है, तो वह गलत नहीं है। वह एक अलग प्रोजेक्ट का वर्णन कर रहा है।
मूल Open Interpreter 2023 में एक Python प्रोजेक्ट के रूप में लॉन्च हुआ। इसने भाषा मॉडल्स को आपकी मशीन पर Python, JavaScript और शेल कोड चलाने दिया, और लोग इसे ChatGPT के Code Interpreter के ओपन-सोर्स विकल्प के रूप में जानते थे। बाद के वर्ज़न्स में कंप्यूटर कंट्रोल जोड़ा गया, ताकि मॉडल आपके डेस्कटॉप के साथ भी काम कर सके।
वर्तमान मुख्य प्रोजेक्ट Codex पर आधारित एक Rust रीराइट है। यह जनरल कंप्यूटर कंट्रोल के बजाय कोडिंग एजेंट्स और हार्नेस एम्यूलेशन पर केंद्रित है।
Python संस्करण गायब नहीं हुआ। यह समुदाय फोर्क के रूप में endolith/open-interpreter पर जारी है।
दोनों संस्करण एक ही नाम, एक ही GitHub रिपॉज़िटरी इतिहास और एक ही interpreter कमांड का उपयोग करते हैं, इसलिए इन्हें गड़बड़ करना आसान है।
लेकिन एक बहुत स्पष्ट संकेत है:
pip install open-interpreter: लेगेसी Python संस्करण
curl या PowerShell इंस्टॉलर: वर्तमान Rust संस्करण
Open Interpreter हर सेटअप के लिए सही टूल नहीं है। यह कहाँ समझ में आता है और कहाँ नहीं—यहाँ बताया गया है।
ओपन सोर्स: यह Apache 2.0 के अंतर्गत लाइसेंस्ड है, इसलिए आप पूरे कोडबेस को पढ़, ऑडिट और फोर्क कर सकते हैं
मॉडल चयन: आप एक ही एजेंट से होस्टेड, ओपन-वेट और लोकल मॉडल्स का उपयोग कर सकते हैं, और सेशन के बीच में भी उनके बीच स्विच कर सकते हैं
मल्टिपल एजेंट हार्नेस: आपको उस प्रदर्शन के करीब ले जाता है जिसके लिए मॉडल ट्यून किया गया था—जो कम ही अन्य कोडिंग एजेंट देते हैं
टर्मिनल-नेटिव डेवलपमेंट: यह आपके मौजूदा शेल और Git वर्कफ़्लो में फिट होता है, और exec मोड स्क्रिप्ट्स और CI में काम करता है
ओपन और कम-लागत मॉडल्स: प्रोजेक्ट इनके इर्द-गिर्द बना है, समर्पित प्रोवाइडर गाइड्स और मिलते-जुलते हार्नेस के साथ
विस्तारयोग्यता: MCP, स्किल्स, हुक्स, AGENTS.md, Agent Client Protocol, और Codex SDK ओवरराइड इसे अन्य टूल्स से जोड़ने देते हैं
मॉडल गुणवत्ता बदलती रहती है: एजेंट उतना ही अच्छा है जितना उसके पीछे का मॉडल, और कोई हार्नेस उस मॉडल को नहीं सुधार सकता जो मल्टी-स्टेप टास्क की योजना नहीं बना पाता
लोकल मॉडल्स को भारी हार्डवेयर चाहिए: मेरे परीक्षणों में, अकेला devstral-small-2 26 GB मेमोरी ले गया—उस बड़े कॉन्टेक्स्ट विंडो से पहले जिसकी एक कोडिंग एजेंट को ज़रूरत होती है
सेटअप में ज़्यादा मेहनत लगती है: आपको प्रोवाइडर्स, कॉन्टेक्स्ट विंडोज़, हार्नेस और सैंडबॉक्स सेटिंग्स खुद मैनेज करनी होती हैं। कुछ खुरदुरे हिस्से भी हैं, जैसे बचे हुए Codex ब्रांडिंग और Ollama मॉडल्स के लिए मेटाडेटा वार्निंग्स
कमांड निष्पादन एक जोखिम है: सैंडबॉक्स और अप्रूवल्स जोखिम घटाते हैं, लेकिन हटाते नहीं
कोड को अब भी रिव्यू चाहिए: पास होते टेस्ट सही फ़िक्स की गारंटी नहीं देते, इसलिए आपको हर डिफ़ पढ़ना होगा
Open Interpreter एक ओपन-सोर्स कोडिंग एजेंट है जो आपके चुने हुए मॉडल के साथ काम करता है—चाहे वह मॉडल होस्टेड हो, ओपन-वेट हो, या आपकी अपनी मशीन पर चल रहा हो।
वर्कफ़्लो सरल है। आप एक मॉडल और एक हार्नेस चुनते हैं, एजेंट को किसी प्रोजेक्ट पर पॉइंट करते हैं, और उसे तब तक निरीक्षण, संपादन और कमांड्स चलाने देते हैं जब तक कार्य पूरा न हो जाए। फिर आप उसके काम की समीक्षा करते हैं।
हार्नेस एम्यूलेशन इसे प्रतिस्पर्धियों से अलग बनाता है। Open Interpreter हर मॉडल को एक ही एजेंट सेटअप में बाँधता नहीं है। यह सेटअप को मॉडल के अनुसार बदलता है—और यही फ़र्क ला सकता है। काम कितना अच्छा होगा, यह मॉडल तय करता है, और एजेंट क्या संशोधित कर सकता है, यह परमिशन्स तय करती हैं। आपके कोडबेस तक कोई बदलाव पहुँचने से पहले आपकी समीक्षा आख़िरी जाँच है।
यदि आप AI इंजीनियर सर्टिफ़िकेशन लेना चाहते हैं, तो हमारे Associate AI Engineer for Developers ट्रैक में नामांकन करें और अपनी गति से AI की दुनिया में कदम रखें।
DataCamp के साथ सीखें
लर्निंग पाथ
लर्निंग पाथ
लर्निंग पाथ