Programa
Associate AI Engineer para desarrolladores
26 h
Si alguna vez has ejecutado un modelo open‑weight dentro de un agente de código diseñado para otro modelo, sabrás que no es la mejor idea.
Suele interpretar mal los esquemas de herramientas y repite el mismo comando fallido hasta que lo detienes. Cuando vuelves al modelo para el que se creó el agente, la misma tarea sale sin problemas. Normalmente el problema no está en el modelo, sino en el harness del agente a su alrededor, ya que sus prompts y formatos de herramientas están ajustados para otro.
Open Interpreter lo soluciona emulando el harness para el que se afinó cada modelo, como Claude Code o Kimi Code. Es un agente de codificación de IA de código abierto que se ejecuta desde tu terminal, y la versión actual es un proyecto en Rust construido sobre Codex de OpenAI, no el asistente de ordenador en Python que quizá recuerdes.
En este artículo, te guiaré por la instalación, la configuración de modelos y harnesses, un flujo de trabajo práctico de programación y cómo se compara Open Interpreter con Claude Code, OpenCode y Codex.
¿Eres nuevo en los agentes de IA? Apúntate a nuestro curso de Introducción a los agentes de IA y aprende los fundamentos en una tarde.
Open Interpreter da a un modelo de IA acceso a tu proyecto y a las herramientas que usaría una persona desarrolladora.
Solo tienes que describir una tarea en inglés sencillo y el agente trabaja sobre tu código. Puede trabajar con:
El proyecto es de código abierto bajo licencia Apache 2.0. Tampoco está limitado a un único proveedor de modelos. Puedes conectarlo a modelos hospedados, modelos open‑weight o modelos que se ejecuten localmente en tu máquina.
El repositorio principal tiene más de 68.000 estrellas en GitHub a septiembre de 2026.
Open Interpreter trabaja en bucle:
Algunos de estos pasos requieren tu aprobación previa, según la configuración de permisos. Los veremos en la sección de seguridad.
Aquí tienes un resumen más visual:
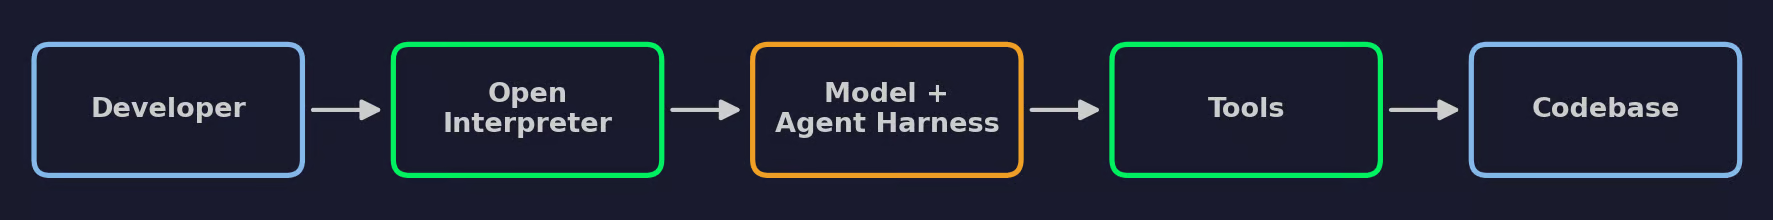
Cómo funciona Open Interpreter
Lo importante aquí es que no hablas directamente con el modelo. Open Interpreter envía tu tarea al modelo, formateada con los prompts y las definiciones de herramientas del harness activo. El modelo solicita llamadas a herramientas y Open Interpreter las ejecuta sobre tu base de código. Luego, los resultados vuelven al modelo para el siguiente paso.
Como el modelo y el harness son capas separadas, puedes cambiar cualquiera de las dos sin tocar el resto de la configuración.
Open Interpreter se instala como un binario independiente, así que no necesitas Python ni pip.
Si un artículo antiguo te dice que ejecutes pip install open-interpreter, se refiere a la versión heredada en Python. Ese comando no te dará el agente de codificación en Rust que cubro en este artículo.
También querrás tener Git en tu máquina. Open Interpreter funciona sin él, pero con Git la sesión entiende el repositorio y puede mostrar diffs.
Ejecuta el script de instalación desde tu terminal:
curl -fsSL https://www.openinterpreter.com/install | shEl script descarga la versión adecuada para tu plataforma y coloca el comando interpreter en ~/.local/bin.
Abre PowerShell y ejecuta:
irm https://www.openinterpreter.com/install.ps1 | iexWSL también es compatible si prefieres una configuración tipo Linux. En ese caso, ejecuta el comando de macOS y Linux dentro de tu terminal WSL.
Reinicia tu terminal para que recoja el nuevo PATH y luego comprueba la versión:
interpreter --versionSi ves un número de versión, la instalación ha funcionado.
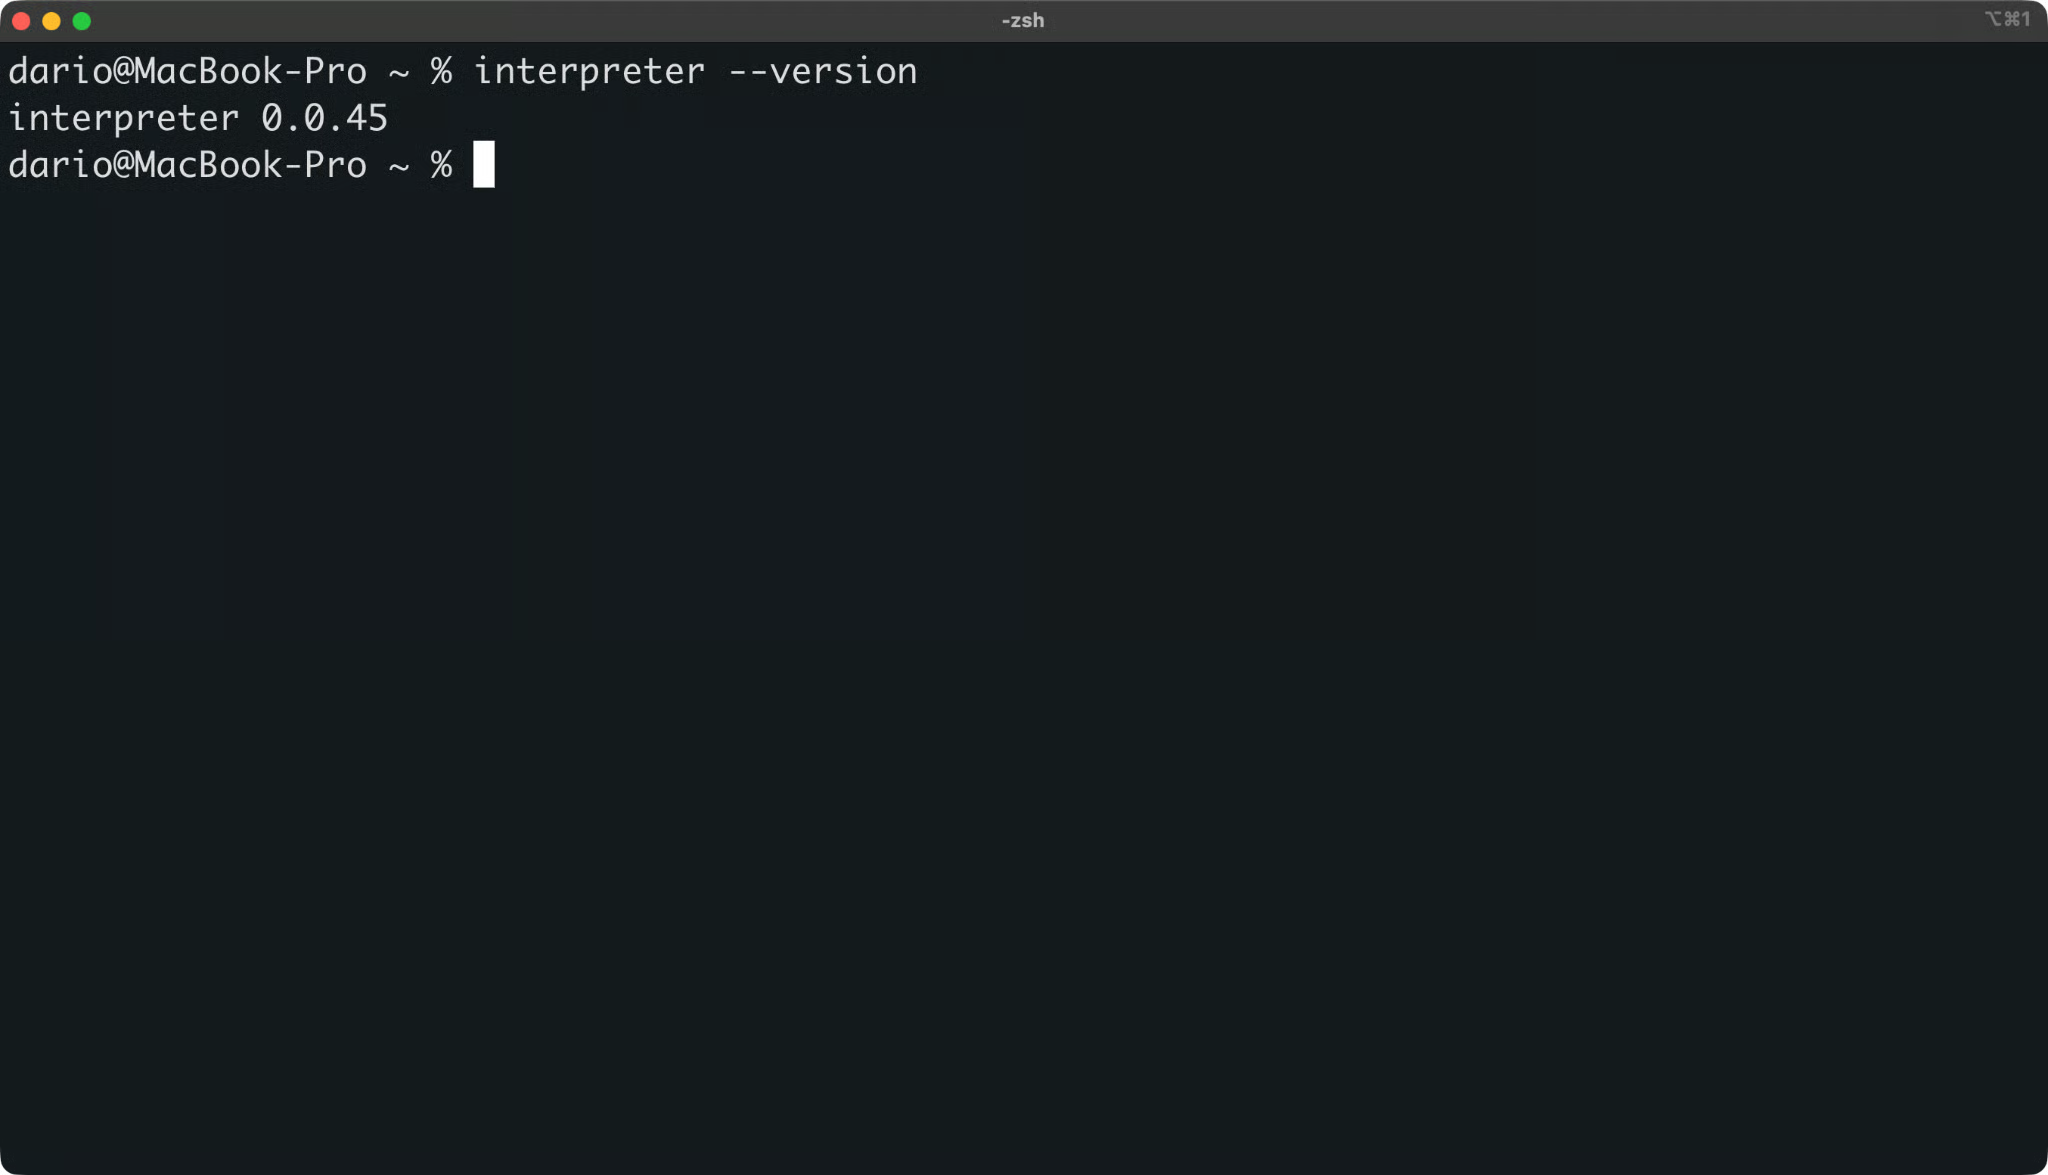
Comprobación de versión de Open Interpreter
Inicia una sesión desde cualquier directorio:
interpreterTambién puedes escribir i, que es un alias corto del mismo comando.
Open Interpreter abre una interfaz de terminal en la que describes tareas en inglés sencillo. La primera vez que lo inicies, te pedirá conectar un proveedor de modelo. En la siguiente sección usaré un modelo local vía Ollama, así que puedes saltarte este paso por ahora.
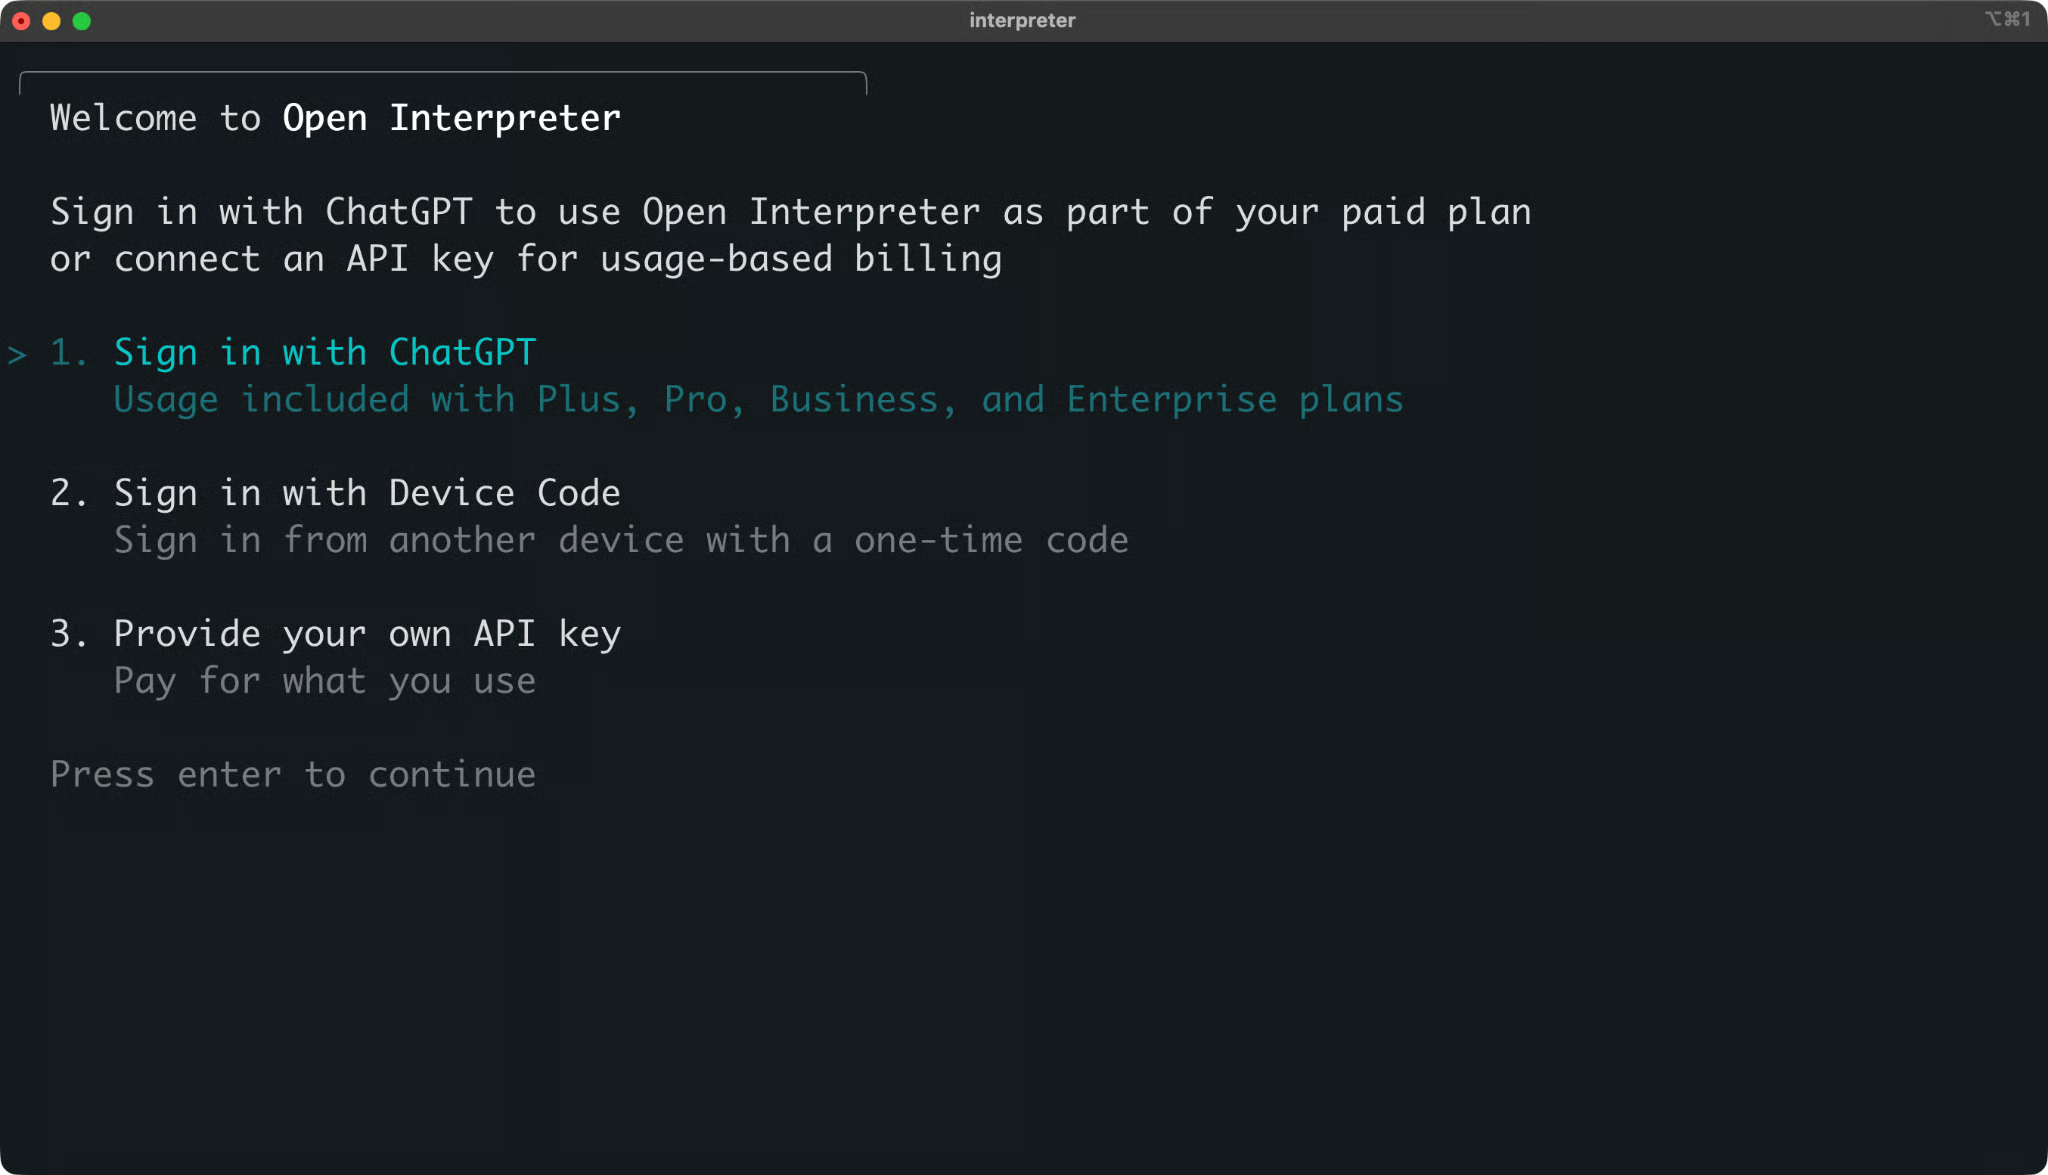
Sesión interactiva de Open Interpreter
Para salir de la sesión, escribe /exit.
La forma más rápida de entender un agente de codificación es darle una tarea y ver qué hace con ella.
Usaré un pequeño proyecto de seguimiento de hábitos para toda esta sección. Tiene una función, un archivo de tests y un bug.
El proyecto calcula la racha más larga de días consecutivos para un hábito. Por ejemplo, cuenta cuántos días seguidos hiciste ejercicio.
Empieza con una carpeta de proyecto y un entorno virtual:
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
Crea habits.py con el siguiente código:
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
Luego crea test_habits.py:
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
La función tiene un bug. No lo señalaré: encontrarlo es trabajo del agente.
Añade un archivo .gitignore para que el entorno virtual y las cachés no entren en el repositorio:
.venv/
__pycache__/
.pytest_cache/
Ahora haz commit del proyecto:
git init
git add .
git commit -m "Initial commit"
Este commit te da un punto de partida limpio. Más tarde lo usarás para ver exactamente qué cambió el agente.
Ejecuta los tests para confirmar el bug:
python -m pytest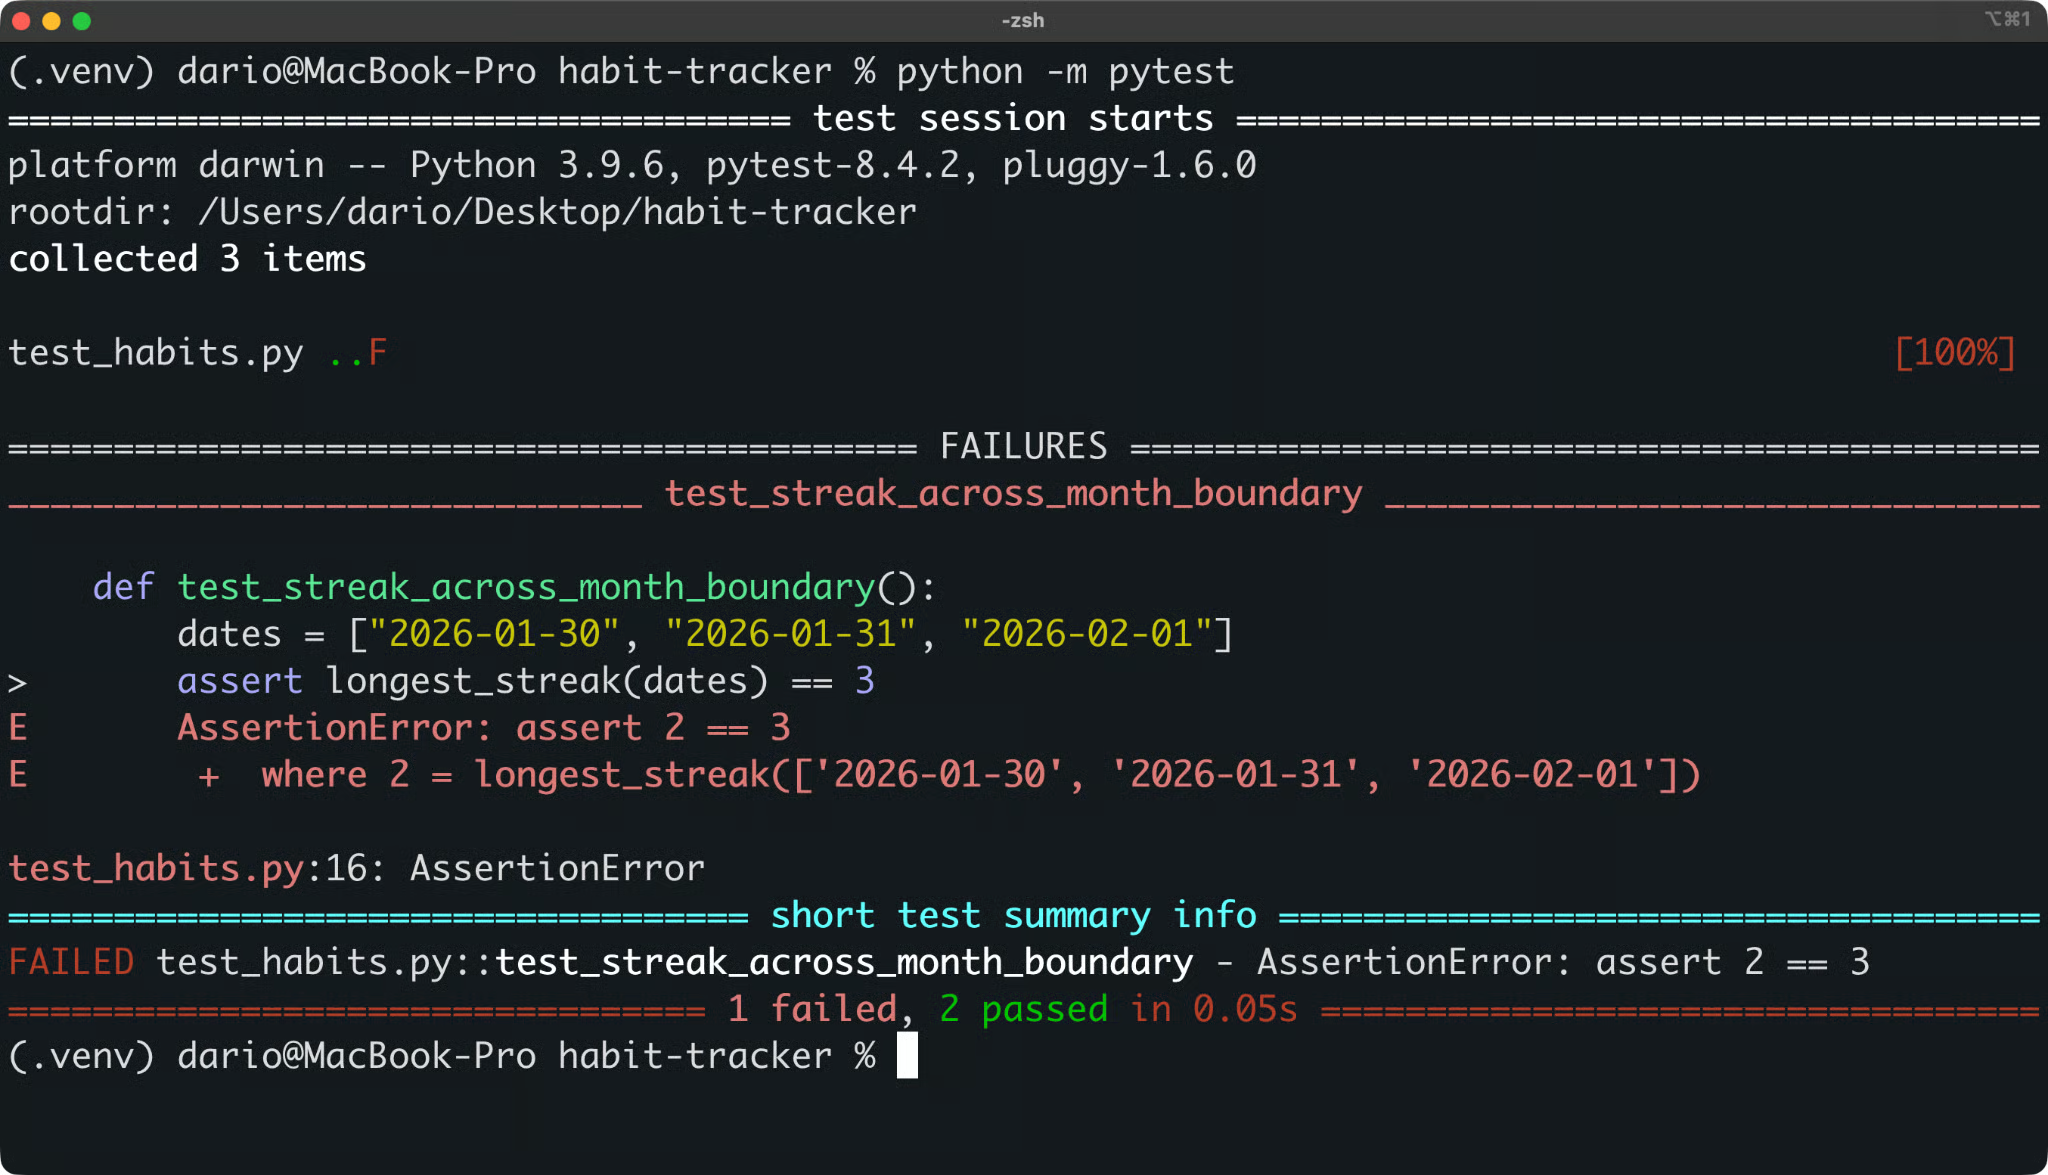
Resultado de tests del rastreador de hábitos
Dos tests pasan y uno falla. Ese es el problema que tiene que resolver Open Interpreter.
Necesitarás Ollama instalado y en ejecución. También necesitarás un modelo que soporte llamadas a herramientas, así que descárgalo:
ollama pull qwen3-coder:30bLuego inicia Open Interpreter desde la carpeta del proyecto. Usa la misma terminal, para que el agente pueda usar la instalación de pytest de tu entorno virtual:
interpreter --oss --local-provider ollama -m qwen3-coder:30bEsto es lo que hace cada flag:
--oss: usa un proveedor local de código abierto
--local-provider ollama: elige Ollama en lugar de LM Studio
-m qwen3-coder:30b: establece el modelo para esta ejecución
Ejecuta /status para confirmar el proveedor activo, el modelo, el modo de sandbox y la política de aprobaciones.
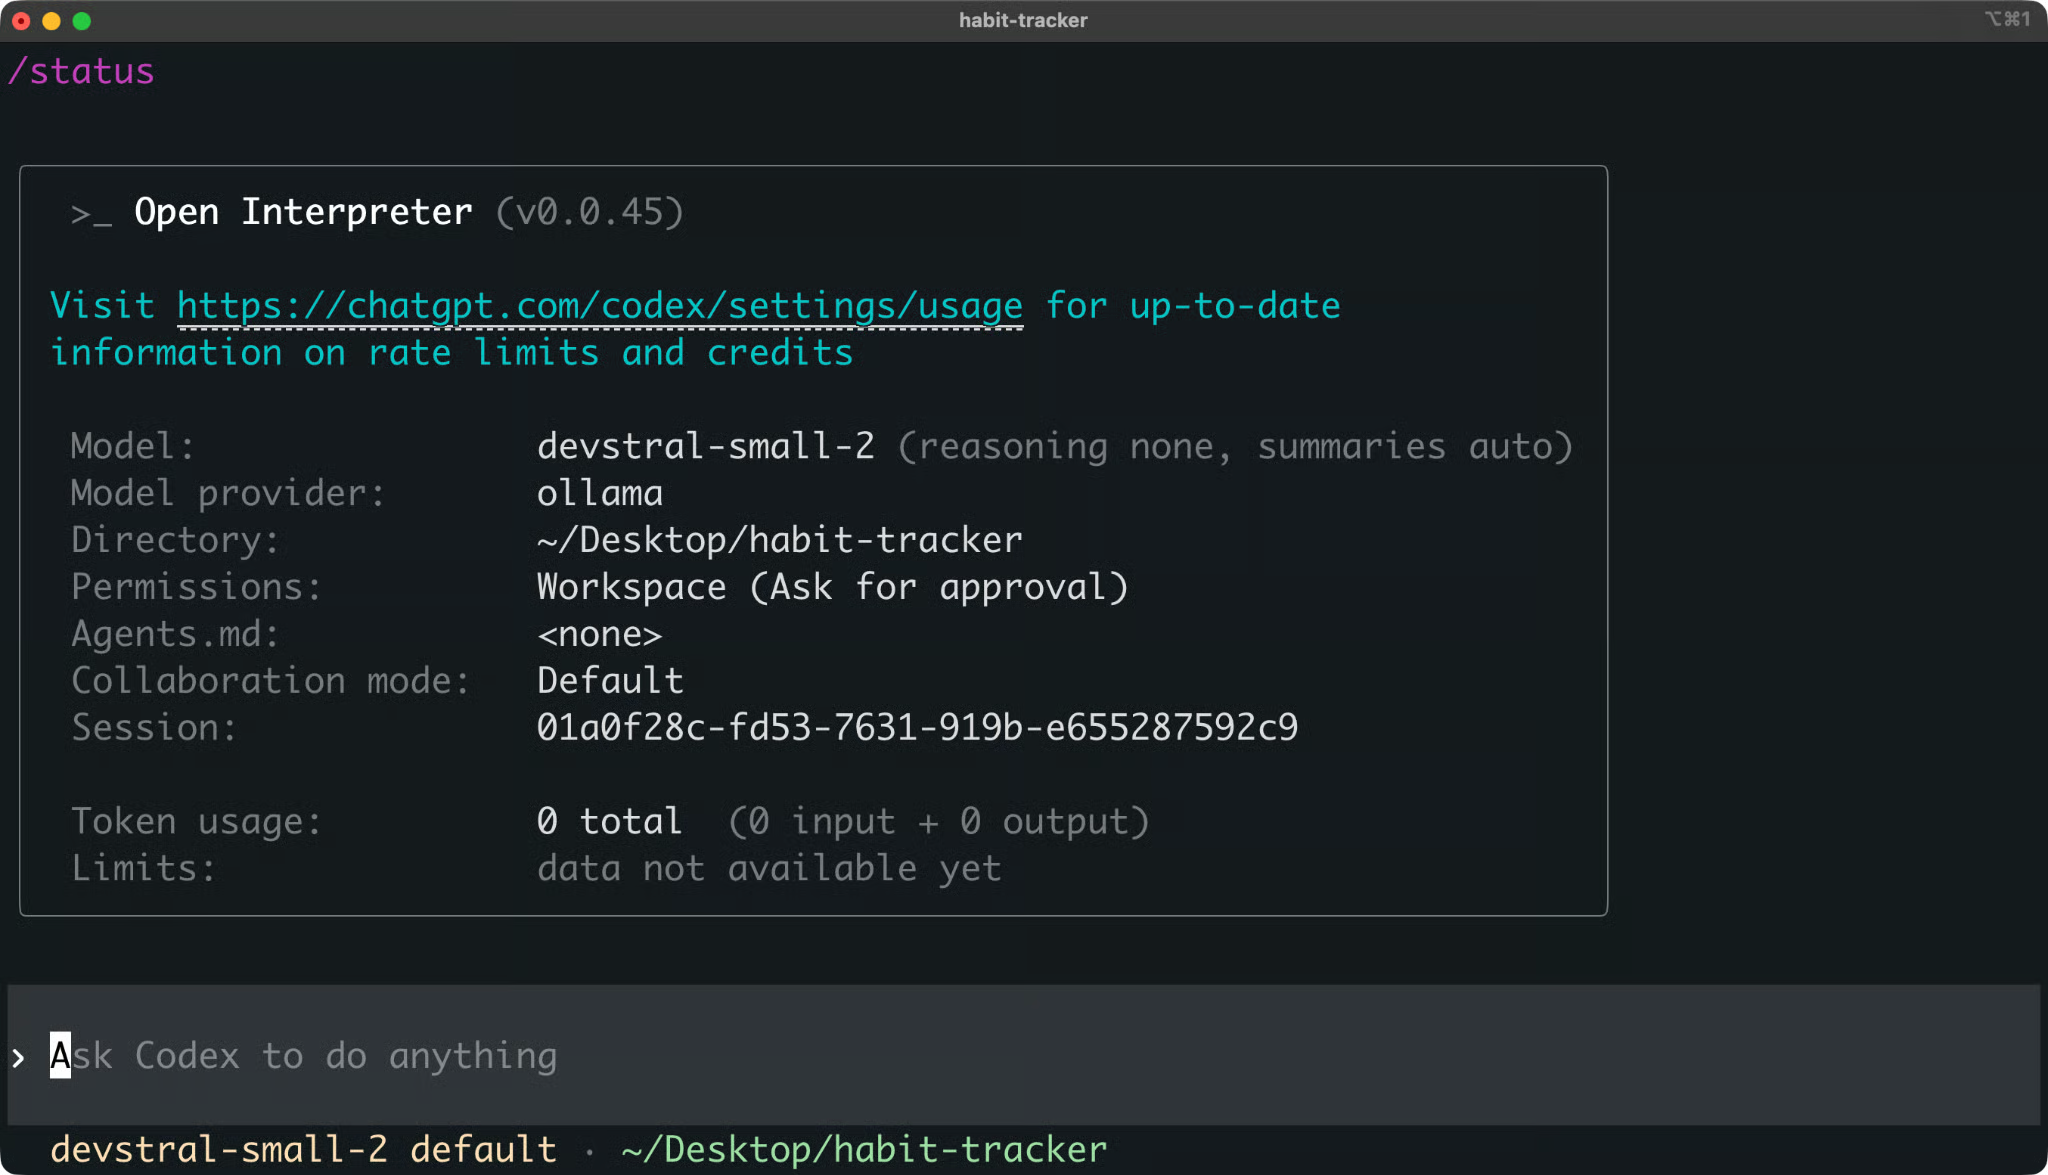
Sesión de Open Interpreter con un modelo local de Ollama
Aún no quieres que el agente edite nada. Pide primero un diagnóstico:
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.El agente normalmente leerá los archivos y ejecutará los tests antes de responder. Los comandos se ejecutan en sandbox y, si el agente necesita más acceso del que permite el sandbox, te pedirá aprobación primero.
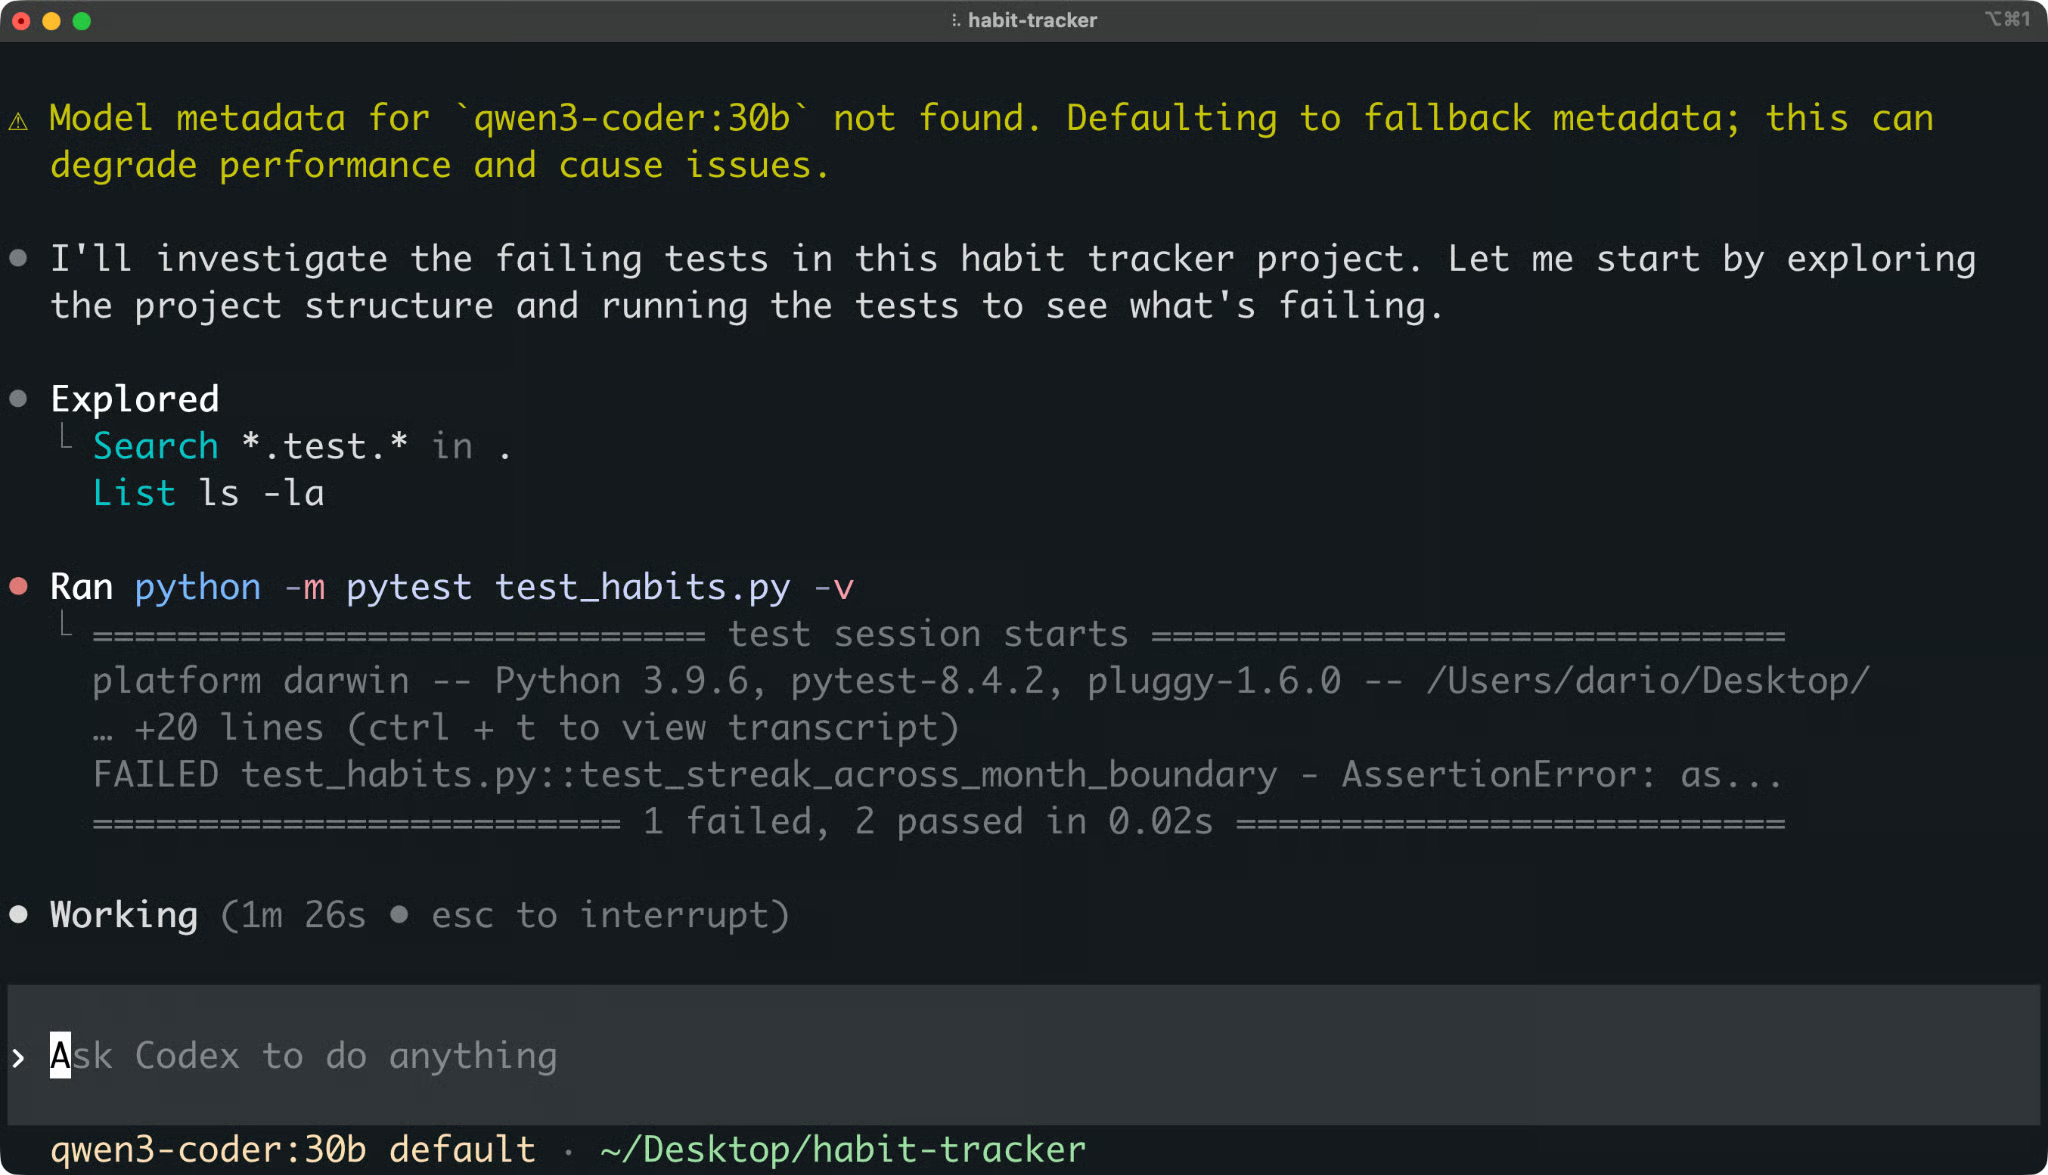
Salida de Open Interpreter
Lee la explicación antes de aprobar nada.
Un diagnóstico correcto dirá que la función compara solo el día del mes, así que una racha se rompe al cruzar de mes. Una buena solución compara fechas completas, por ejemplo con date.fromisoformat() del módulo datetime de Python.
Si el diagnóstico es erróneo, corrígelo en la misma sesión antes de que el agente edite código.
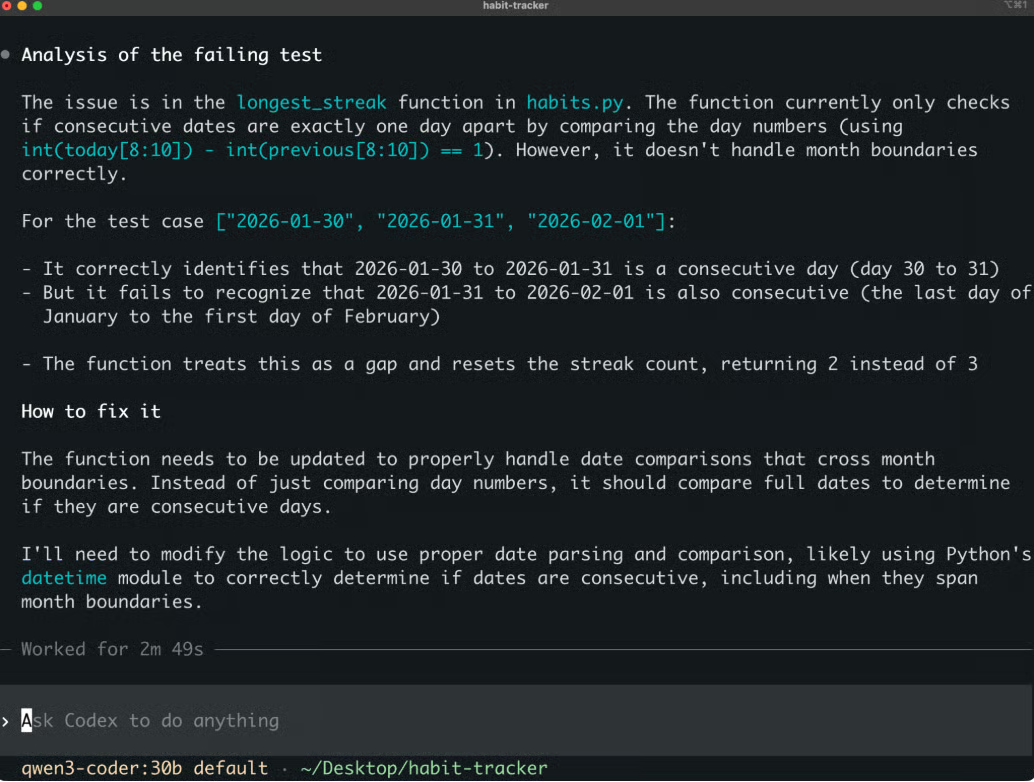
Propuesta de corrección de Open Interpreter
Cuando estés conforme con el plan, implementa la corrección:
Apply the fix to habits.py, then run the tests.El agente edita el archivo y vuelve a ejecutar pytest. Quieres ver los tres tests en verde.
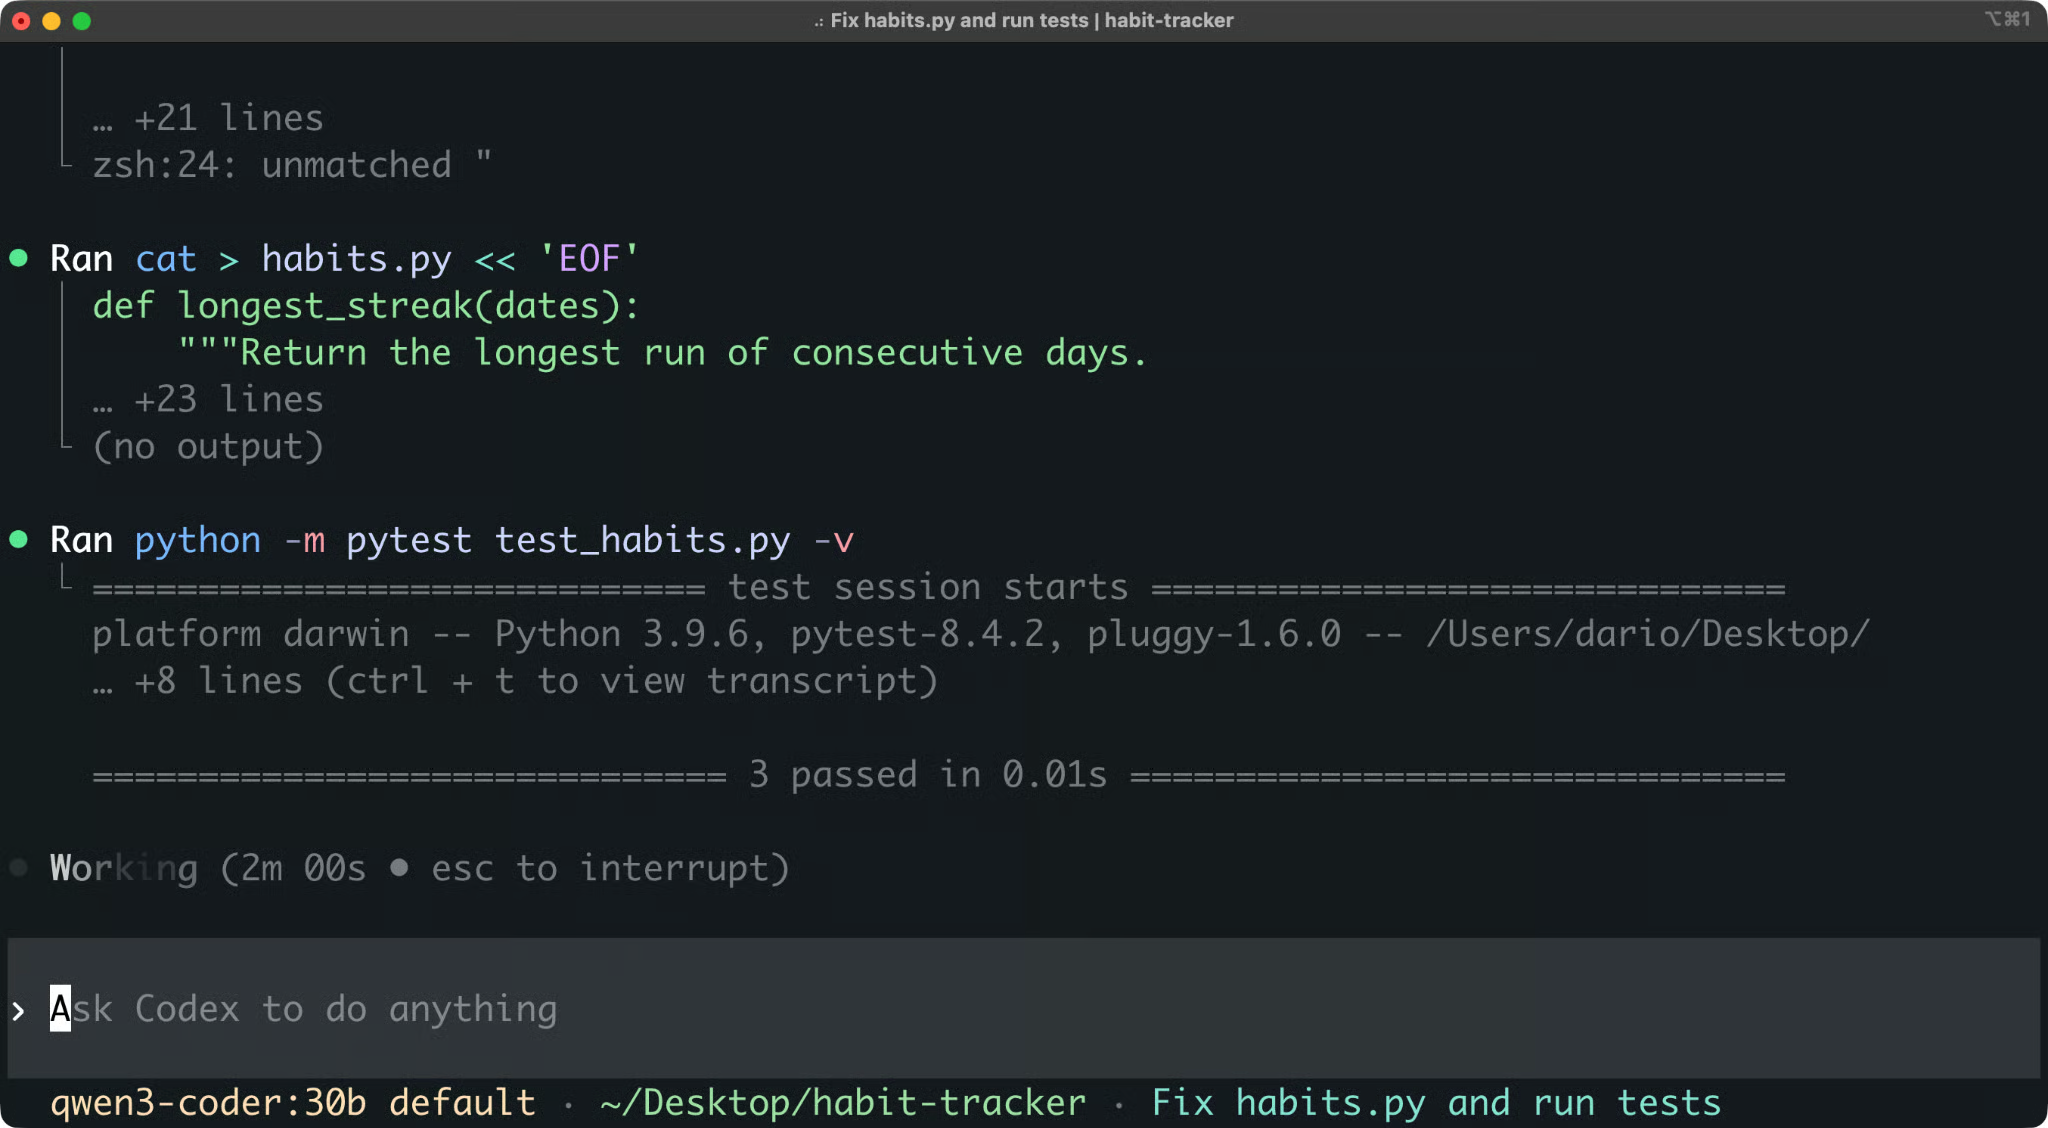
Todos los tests pasan tras la corrección
Que pasen los tests no siempre significa que el bug esté realmente resuelto. Puede que el test se haya modificado para sortear el bug. Aun así debes revisar el código.
Ejecuta /diff dentro de la sesión para ver los cambios del working tree. También puedes ejecutar git diff después de salir.
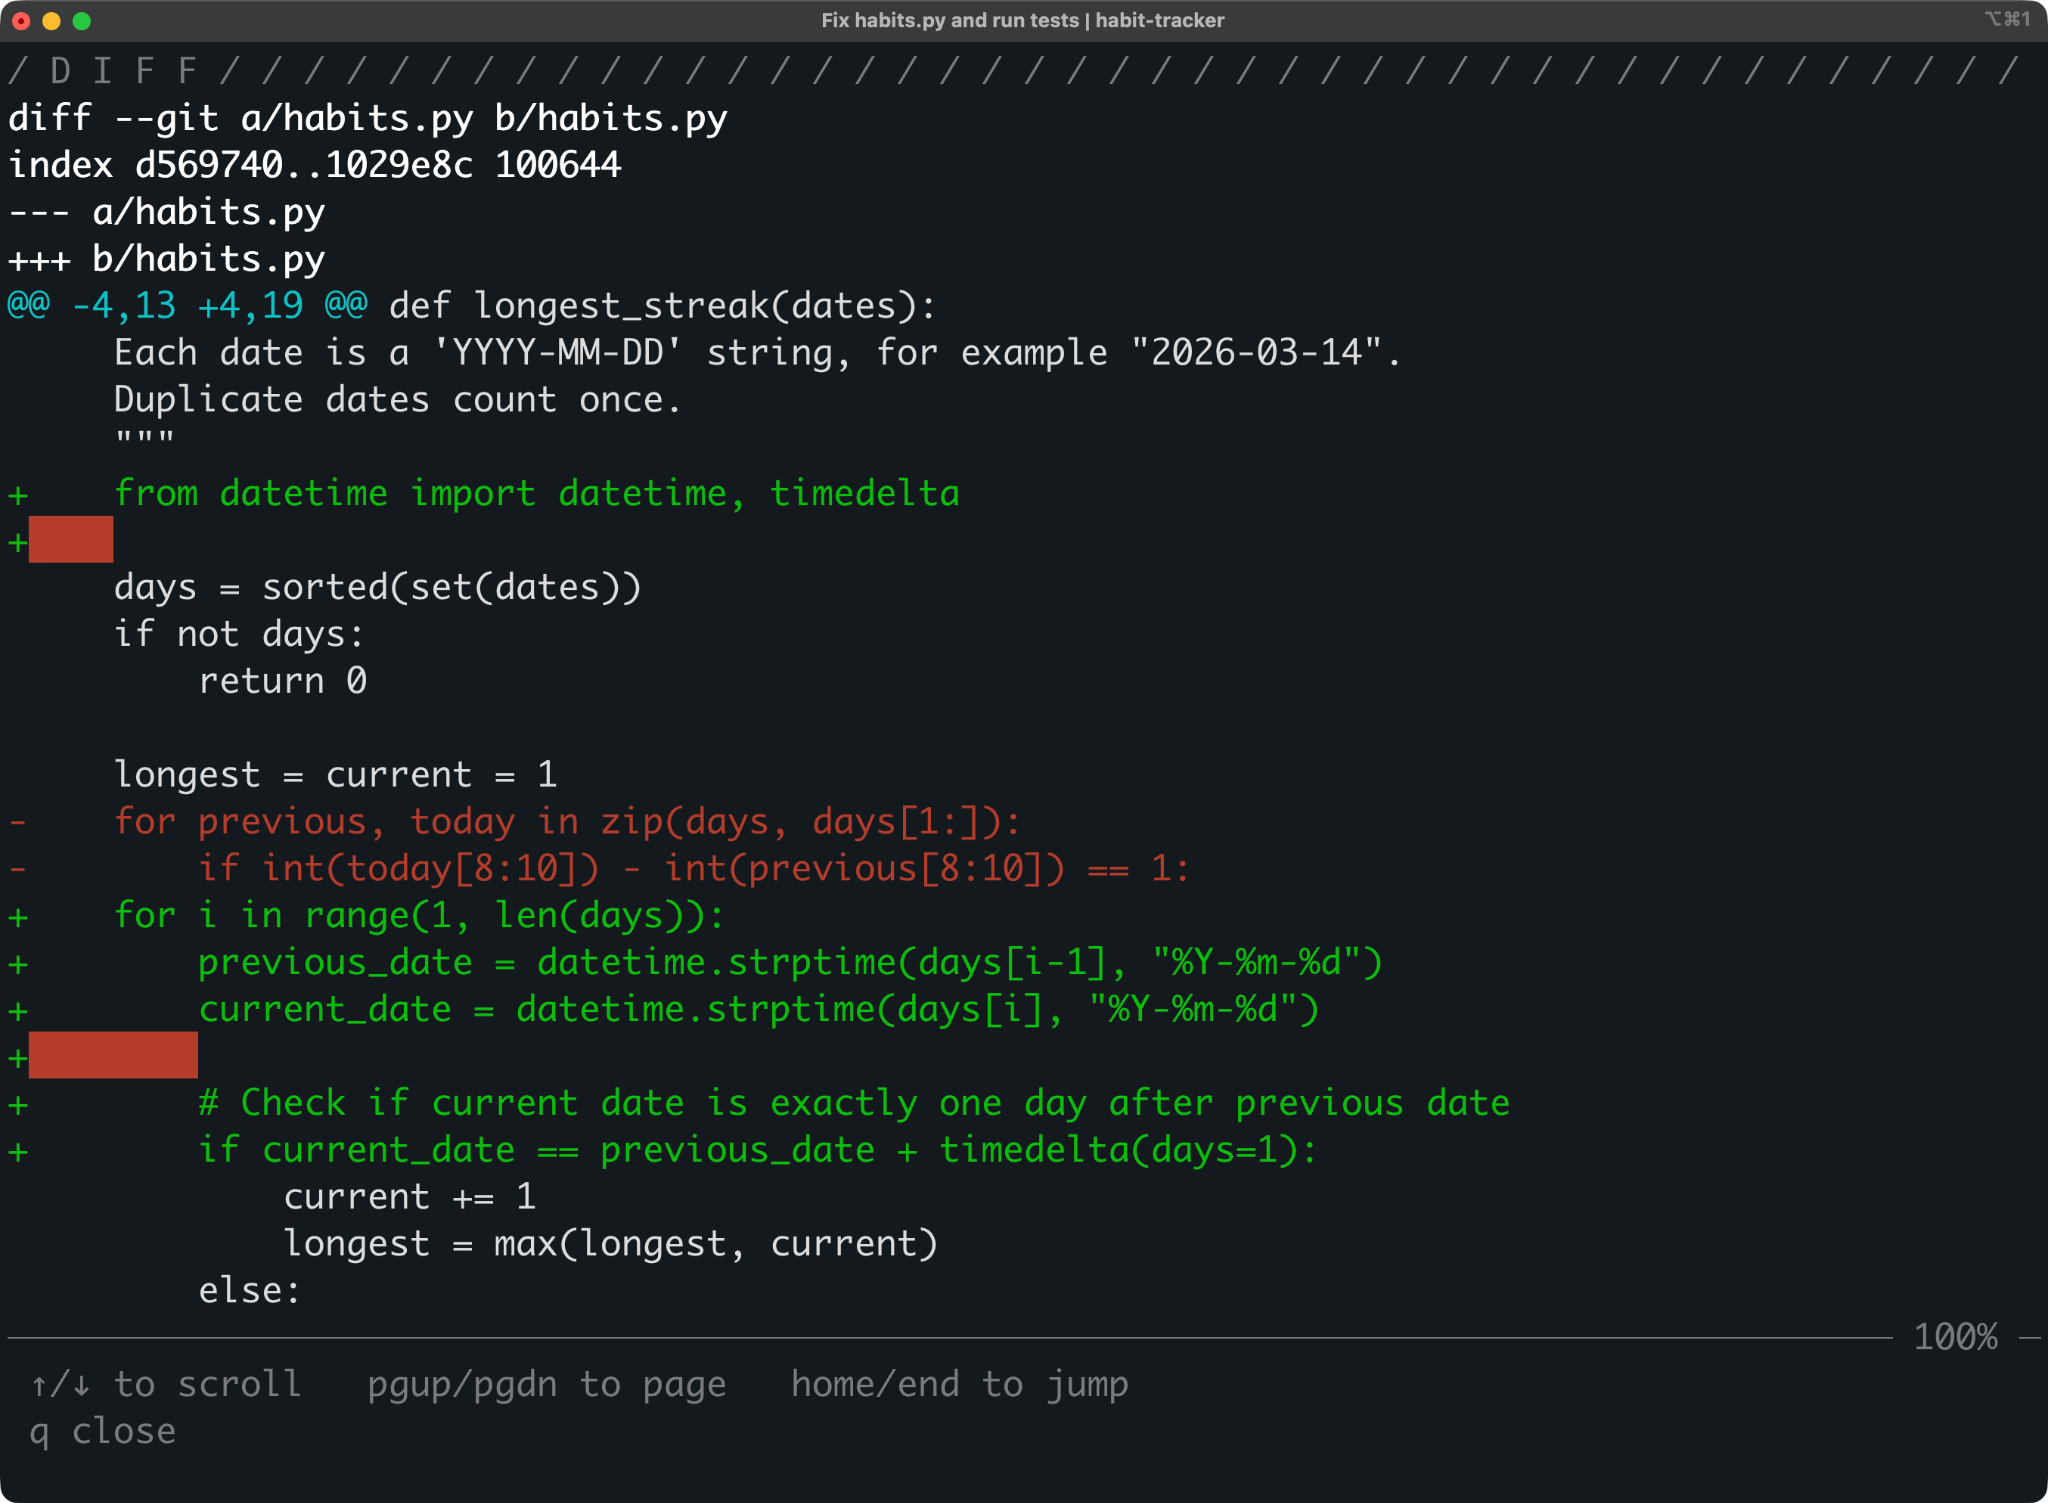
El diff de los cambios hechos por Open Interpreter
El diff exacto depende del modelo, así que el tuyo puede no coincidir línea por línea con el de arriba. Si te convence el cambio, haz commit, y si no, restaura el archivo original:
git restore habits.pyY esa es la idea. Tú describes el problema, el agente lo investiga y lo soluciona, y tú revisas cada cambio antes de que pase a tu código.
Open Interpreter requiere que traigas tu propio modelo.
Cada solicitud pasa por estas tres capas:
| Capa | Ejemplo | Qué controla |
|---|---|---|
| Proveedor | ollama | A dónde van las solicitudes y cómo te autenticas |
| Modelo | devstral-small-2 | El modelo que hace el trabajo |
| Harness | native | Los prompts, herramientas y el formato de mensajes alrededor del modelo |
Capas de una solicitud
Esto es lo que puedes conectar:
La lista de proveedores se genera a partir de un catálogo público de modelos y solo mantiene los que soportan llamadas a herramientas. Si falta un modelo que esperabas, suele ser por eso.
Ojo con ollama-cloud. Es un proveedor hospedado aparte, por lo que tus solicitudes salen de tu máquina. Solo el proveedor integrado ollama ejecuta modelos en local.
Puedes cambiar el modelo en tres niveles:
Dentro de una sesión: ejecuta /model para elegir proveedor, modelo y esfuerzo de razonamiento
Para una sola ejecución: pasa el flag -m, como en la sección anterior
Como predeterminado: configúralo en tu archivo de configuración
Puedes ejecutar /status en cualquier momento para ver qué proveedor y modelo están activos.
Open Interpreter lee su configuración de ~/.openinterpreter/config.toml. Para fijar por defecto la configuración de Ollama de la sección anterior, añade estas dos líneas:
model_provider = "ollama"
model = "qwen3-coder:30b"
Después de eso, interpreter se inicia con este modelo y no necesitas flags.
Los proveedores hospedados leen sus claves de API de variables de entorno. Por ejemplo, DeepSeek espera DEEPSEEK_API_KEY:
export DEEPSEEK_API_KEY="your-api-key"También puedes añadir cualquier endpoint compatible con OpenAI como proveedor personalizado:
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
El ajuste wire_api indica a Open Interpreter qué formato de solicitud espera el endpoint. Usa chat para Chat Completions compatibles con OpenAI, responses para la API de Responses de OpenAI y messages para endpoints de estilo Anthropic.
Un proyecto de confianza también puede tener su propio .openinterpreter/config.toml, que anula tu configuración de usuario. Los flags de línea de comandos anulan ambas. Si no tienes claro qué valor prevalece, ejecuta /debug-config para ver la configuración efectiva y su origen.
El modelo decide qué bien entiende el agente tu código. El harness decide cómo ve la tarea y las herramientas.
Necesitas ambos. Un buen modelo dentro de un harness inadecuado envía llamadas a herramientas mal formadas y malinterpreta resultados. Y un buen harness no compensa un modelo que no entiende el código.
Por eso Open Interpreter elige un harness cuando eliges un modelo. Por ejemplo:
Los modelos Claude reciben el harness claude-code
Los modelos Kimi usan kimi-code
Los modelos Qwen usan qwen-code
Los modelos DeepSeek usan claude-code-bare
Para otras familias de modelos, puedes elegir el harness con /harness.
Ten en cuenta que un resultado flojo no siempre significa un modelo flojo. Antes de cambiar de modelo, prueba el mismo con otro harness, que detallo en la siguiente sección.
La emulación de harness es la principal razón de ser de la versión actual de Open Interpreter.
Un harness de agente es todo lo que rodea al modelo y lo convierte en agente. Incluye:
En pocas palabras, el harness decide cómo ve el modelo la tarea y cómo se traducen sus decisiones en acciones.
Open Interpreter tiene varios modos de harness integrados. Estos son los que más usarás:
native: el harness propio de Open Interpreter, heredado de Codex
claude-code: emula los prompts y la superficie de herramientas de Claude Code de Anthropic
kimi-code: una reimplementación en Rust del harness Kimi Code que Moonshot recomienda para sus modelos Kimi
qwen-code: emula la CLI de Qwen Code de Alibaba para modelos Qwen
swe-agent: emula SWE-agent, un agente de investigación creado para resolver issues de GitHub
La lista completa también incluye variantes como claude-code-bare, kimi-cli, deepseek-tui, zcode y minimal. Ejecuta /harness en una sesión para ver qué admite tu versión.
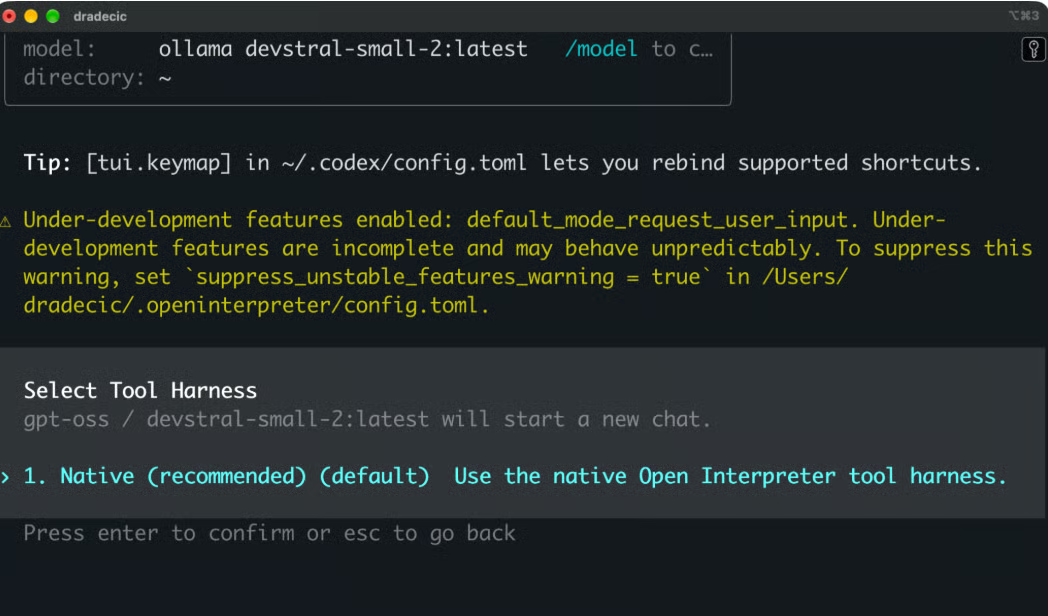
Puedes cambiar de harness a mitad de sesión con /harness, o fijar uno por defecto en ~/.openinterpreter/config.toml:
harness = "kimi-code"
harness_guidance = true
El ajuste harness_guidance añade guidance de fiabilidad donde el harness lo permite. Ponlo en false si quieres una emulación más estricta. Si dejas harness sin definir, Open Interpreter elige uno según la familia del modelo, como viste antes.
La mayoría de proveedores afinan sus modelos de programación dentro de una configuración de agente concreta y publican un harness recomendado para acompañarlos.
El modelo se acostumbra a ese harness. Aprende su estilo de prompt, los nombres de herramientas, el formato de edición de archivos y cómo vuelven los resultados de las herramientas.
Imagina que ejecutas un modelo afinado para ediciones de buscar‑y‑reemplazar dentro de un harness que espera archivos patch completos. El modelo sabe qué cambio hacer, pero lo describe en el formato equivocado una y otra vez. El bucle del agente consume tokens sin avanzar.
Con los resultados de herramientas pasa igual. Si el harness devuelve resultados en un formato desconocido para el modelo, este los interpreta mal. Si el harness borra el razonamiento del modelo entre turnos, un modelo que “piensa” pierde el hilo de su propio plan.
Esto hace que el mismo modelo pueda rendir bien en un agente y mal en otro, sin cambiar sus weights. Por eso los benchmarks de programación suelen indicar el harness usado en cada ejecución.
Los modelos punteros tienden a recuperarse ante un harness desconocido, pero los más pequeños y baratos suelen no hacerlo. Open Interpreter no fuerza a todos los modelos a un único formato, sino que cambia el formato para adaptarse al modelo.
Puedes probarlo tú con el proyecto de demo. Restaura el archivo original con git restore habits.py, cambia el harness con /harness y dale al agente el mismo prompt de nuevo. Luego compara cuántos pasos tarda y cómo formatea sus ediciones.
Ya has visto la mayoría en el artículo. Esto es lo que te aportan en el día a día del desarrollo.
Open Interpreter trabaja dentro de tu repositorio Git. Lee la estructura del proyecto y rastrea lo que ha cambiado.
Dos comandos con barra ayudan aquí. /diff muestra los cambios del working tree y /review pide al agente que revise los cambios actuales en busca de bugs y regresiones antes de hacer commit. Puedes ejecutar la misma revisión sin abrir sesión:
interpreter exec review --uncommittedLas sesiones también se guardan. Si paras a mitad de una tarea, interpreter resume --last la retoma donde lo dejaste.
El agente ejecuta los mismos comandos que tú, por ejemplo baterías de tests, linters, scripts de build y gestores de paquetes. Todo corre en sandboxing nativo en macOS, Linux y Windows.
Los comandos de larga duración pueden ejecutarse en segundo plano. Usa /ps para listarlos y /stop para pararlos.
Para scripts y pipelines de CI, interpreter exec ejecuta una tarea sin la interfaz interactiva:
interpreter exec "fix the failing test"Puedes cambiar de proveedor y modelo en cualquier momento con /model. Tu configuración, AGENTS.md y las skills siguen aplicando tras el cambio.
Los perfiles ayudan aquí. Digamos que quieres un modelo económico para tareas rutinarias y otro más potente para revisiones de código. Puedes definir ambos en tu configuración:
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
Luego inicia con interpreter --profile review cuando lo necesites.
/harness cambia cómo el modelo ve la tarea sin cambiar el modelo. Es lo primero que debes probar cuando un modelo se atasca con las llamadas a herramientas, antes de pasar a uno más grande.
Model Context Protocol (MCP) conecta el agente con herramientas para las que no fue diseñado, como servidores de documentación o bases de datos. Añades servidores en tu configuración:
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
Ejecuta /mcp para ver los servidores configurados y sus herramientas. El ajuste default_tools_approval_mode hace que el agente pregunte antes de usar una herramienta de ese servidor.
También funciona al revés. interpreter mcp-server expone Open Interpreter como servidor MCP, y interpreter acp lo ejecuta dentro de editores compatibles con Agent Client Protocol, un estándar abierto para conectar editores con agentes de programación.
AGENTS.md es un archivo Markdown en tu repositorio con normas del proyecto que el agente lee en cada tarea. Para el rastreador de hábitos, podría ser así:
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
También puedes ejecutar /init y el agente escribirá una primera versión por ti.
Las skills son flujos de trabajo reutilizables, empaquetados como carpetas en .agents/skills dentro de tu proyecto o ~/.agents/skills a nivel de usuario. El agente detecta una skill automáticamente cuando una tarea encaja con ella. Ejecuta /skills para ver cuáles hay disponibles.
Ambos son formatos compartidos, así que los mismos archivos funcionan con otros agentes de programación que los soporten. Open Interpreter también admite hooks, que ejecutan tus propios comandos en puntos concretos de una sesión. Los revisas y confías en ellos con /hooks.
Dos ajustes controlan lo que puede hacer el agente:
Modo de sandbox: read-only, workspace-write o danger-full-access
Política de aprobaciones: untrusted, on-request o never
El sandbox decide qué es posible y la política de aprobaciones decide cuándo el agente te pregunta antes. Con workspace-write y on-request, el agente puede editar tu proyecto y ejecutar tests, pero pregunta antes de necesitar acceso más allá de eso.
Puedes cambiar ambos con /permissions o con los flags -s y -a. También existe --yolo, que omite ambos, y la documentación lo marca como peligroso. Trataré estos ajustes con más detalle en la sección de seguridad.
Open Interpreter se define como un agente de codificación pensado para modelos de bajo coste.
Los agentes propietarios más grandes están construidos alrededor de los modelos de su propio proveedor. Open Interpreter te da un único agente que funciona con modelos propietarios, modelos open‑weight hospedados y modelos locales.
Modelos open‑weight como Kimi, DeepSeek, GLM y Qwen publican sus weights. Puedes usarlos a través de un proveedor de terceros o en tu propio hardware.
Eso te da dos ventajas. Los modelos open‑weight hospedados suelen costar menos por token que los modelos propietarios punteros. Y no estás limitado a un host, porque el mismo modelo corre allí donde corren sus weights.
Open Interpreter tiene guías específicas de proveedor para Kimi K3, DeepSeek y GLM. También elige el harness correspondiente para estas familias de modelos.
Ollama y LM Studio son proveedores integrados, así que puedes ejecutar un modelo en tu propia máquina sin clave de API ni costes por token.
El coste es el hardware. Cuando probé devstral-small-2 en mi MacBook Pro M1 Max con 64 GB de memoria unificada, solo el modelo ocupó 26 GB. La ventana de contexto por defecto de Ollama era demasiado pequeña para el bucle del agente y, a 128k tokens, el uso de memoria subía y bajaba hasta que la sesión se bloqueaba.
Los agentes de programación necesitan una ventana de contexto grande, porque el prompt del sistema, las definiciones de herramientas, el contenido de archivos y la salida de comandos deben caber. Ollama recomienda al menos 64k tokens para agentes tipo Codex. Y una ventana de contexto mayor usa más memoria además del propio modelo.
Open Interpreter se ejecuta en tu máquina, pero el modelo no tiene por qué hacerlo.
A dónde va tu código depende del proveedor:
Tu configuración, sesiones y logs se almacenan localmente en ~/.openinterpreter en cualquier caso.
Si necesitas más control, puedes añadir un proveedor personalizado que apunte a tu propio servidor de inferencia. Cualquier servidor con API compatible con OpenAI sirve, por ejemplo un despliegue vLLM en las GPU de tu empresa. Así obtienes un entorno hospedado donde la infraestructura es tuya.
No todos los modelos open rinden igual con las llamadas a herramientas. Verás un uso deficiente traducido en llamadas mal formadas, bucles, paradas prematuras o ignorar la salida de comandos.
El harness adecuado ayuda, pero no arregla un modelo incapaz de planificar tareas de varios pasos. Los modelos locales más pequeños son los que más problemas dan aquí.
Antes de apuntar un modelo nuevo a un proyecto real, pruébalo en un repositorio pequeño como el rastreador de hábitos que hemos visto. Si muestra debilidades, prueba con otro harness antes de saltar a un modelo más grande.
Aquí tienes un resumen rápido de tus opciones:
| Dónde corre la inferencia | Coste | ¿Tu código sale de tu máquina? | |
|---|---|---|---|
| Modelo propietario hospedado | Servidor del proveedor | Por token o suscripción | Sí |
| Modelo open‑weight hospedado | Servidor del proveedor | Por token, normalmente menor | Sí |
| Modelo open‑weight local | Tu hardware | Hardware y electricidad | No |
Opciones de Open Interpreter para modelos locales y open
Open Interpreter comparte mucho con otros agentes de terminal. Las diferencias están en quién es dueño de la herramienta y para qué modelos está pensada.
Claude Code es el agente de terminal de Anthropic. La primera diferencia es la propiedad: Claude Code es propietario, mientras que Open Interpreter es de código abierto bajo licencia Apache 2.0. Puedes leer y modificar cada parte de Open Interpreter.
La segunda diferencia es la elección de modelos. Claude Code está hecho para modelos Claude. Puedes apuntarlo a endpoints compatibles de otros proveedores, pero su harness sigue afinado para Claude. Open Interpreter trata la elección de modelos como una función central.
La comparación de harnesses es donde se pone interesante. Claude Code es, en sí, uno de los harnesses que Open Interpreter emula. Con el modo claude-code, cualquier modelo recibe prompts y herramientas al estilo Claude Code dentro del runtime de Open Interpreter. La UI y los comandos con barra siguen siendo de Open Interpreter, así que no es el mismo producto con otro modelo.
Ambas herramientas son terminal‑first. Cada una tiene sesión interactiva y modo no interactivo para scripts y CI. Para instrucciones de proyecto, Claude Code lee CLAUDE.md, mientras Open Interpreter usa el formato compartido AGENTS.md.
Claude Code tiene un ecosistema mayor. Viene con extensiones para IDE, apps de escritorio y web, un marketplace de plugins, subagentes y un SDK. Open Interpreter es más joven y se apoya en estándares compartidos como MCP, skills, AGENTS.md y Agent Client Protocol en lugar de su propio ecosistema.
Si trabajas con modelos Claude y quieres la experiencia más pulida, Claude Code es la opción más segura. Si quieres usar otros modelos o evitar una herramienta propietaria, elige Open Interpreter.
OpenCode es el más parecido. Ambos son open source, terminal‑first y compatibles con una larga lista de proveedores de modelos.
El soporte de modelos es similar sobre el papel. OpenCode admite más de 75 proveedores y Open Interpreter genera su lista de proveedores a partir de un catálogo público. Ambos ejecutan modelos locales mediante Ollama.
La experiencia en terminal difiere más. OpenCode tiene su propia TUI con integración LSP (Language Server Protocol), que devuelve al modelo diagnósticos como errores de tipos. La TUI de Open Interpreter proviene de Codex.
En configuración, OpenCode usa opencode.json y Open Interpreter config.toml con perfiles.
La arquitectura del agente es la gran diferencia. OpenCode funciona como cliente y servidor: la TUI es un cliente de un servidor local al que pueden conectarse otros clientes. Incluye agentes build y plan integrados, y admite agentes y subagentes personalizados. Ajusta su prompt del sistema para cada familia de modelos, pero las herramientas y el bucle siguen siendo los de OpenCode. Open Interpreter va más allá y cambia el harness completo, incluidos esquemas de herramientas y formato de mensajes. Las builds más recientes incluso incluyen un modo de harness opencode.
En desarrollo, OpenCode es su propio código, mantenido por su equipo y comunidad. Open Interpreter se construye sobre un fork de Codex, así que gran parte de su runtime viene de upstream. Es un trade‑off: Open Interpreter hereda gratis el sandbox y el runtime de Codex, mientras que OpenCode controla todo su stack.
No son competidores en el sentido habitual. Open Interpreter es un fork de Codex.
Comparten runtime en Rust, TUI, sandboxing, aprobaciones, AGENTS.md, skills, MCP, modo exec y la mayoría de comandos con barra. Cuando ejecuté Open Interpreter, la pista para reanudar la sesión aún decía codex resume.
Codex es el agente de OpenAI, construido alrededor de modelos de OpenAI. Admite modelos locales con --oss y proveedores personalizados, pero la experiencia por defecto se centra en OpenAI.
Open Interpreter amplía Codex en varias direcciones:
Emulación de harness: cambia prompts, esquemas de herramientas y formato de mensajes para encajar con cada familia de modelos
Soporte de proveedores: cuenta con un catálogo generado de proveedores y guías dedicadas para Kimi K3, DeepSeek y GLM
Chat Completions: el flag --chat-completions ejecuta cualquier proveedor compatible con OpenAI
Anulación del SDK de Codex: las apps construidas sobre el SDK de Codex pueden ejecutarse a través de Open Interpreter
Open Interpreter también guarda su configuración y sesiones en ~/.openinterpreter, así que no choca con una instalación de Codex.
Si usas sobre todo modelos de OpenAI, Codex es mejor opción. Si usas otros modelos, Open Interpreter te da el mismo flujo con mejor soporte para ellos.
Aquí tienes un resumen rápido:
| Licencia | Modelos | Enfoque de harness | Config | |
|---|---|---|---|---|
| Open Interpreter | Código abierto (Apache 2.0) | Cualquier proveedor, hospedado o local | Emula el harness por modelo | config.toml |
| Claude Code | Propietario | Diseñado para modelos Claude | Harness propio de Claude Code | settings.json y CLAUDE.md |
| OpenCode | Código abierto (MIT) | 75+ proveedores, hospedados o locales | Un harness con prompts específicos por modelo | opencode.json |
| Codex | Código abierto (Apache 2.0) | Diseñado para modelos de OpenAI con --oss | Harness propio de Codex | config.toml |
Open Interpreter comparado con otros agentes de codificación con IA
Lo peor que puede hacer un chatbot es darte una mala respuesta, que puedes ignorar. Un agente de codificación ejecuta comandos en tu máquina, lee y escribe archivos, y puede acceder a la red. Una mala decisión del modelo o un ataque de prompt injection pueden causar daños reales. Prompt injection son instrucciones ocultas en contenido que el agente lee, como un README o una página web.
Open Interpreter hereda su modelo de seguridad del runtime de Codex. Tiene dos capas: un sandbox que limita lo posible y una política de aprobaciones que decide cuándo el agente te pregunta primero.
Cada comando que ejecuta el agente pasa por un sandbox a nivel de SO en macOS, Linux y Windows. Hay tres modos:
read-only: el agente puede leer archivos, pero no cambiarlos
workspace-write: el agente puede editar archivos y ejecutar comandos dentro de la carpeta del proyecto
danger-full-access: sin sandbox
Con workspace-write, las escrituras se limitan al workspace activo. El agente puede arreglar tu código, pero no editar archivos fuera de tu proyecto.
En modo workspace-write, los comandos no tienen acceso a red por defecto. Esto bloquea descargas e impide que el agente envíe tu código a ningún sitio.
Algunas tareas necesitan red, por ejemplo instalar un paquete. Puedes activarla en tu configuración:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
Actívala solo para proyectos que lo requieran.
La política de aprobaciones decide cuándo se detiene el agente y te pregunta:
untrusted: pregunta antes de ejecutar comandos que no estén en la lista de confianza
on-request: pregunta cuando una tarea requiere más acceso del permitido por el sandbox
never: nunca pregunta
Para proyectos bajo control de versiones, workspace-write con on-request es un buen punto de partida. El agente trabaja dentro de tu proyecto y te pide permiso antes de ir más allá. Git te da una vía para deshacer si algo sale mal.
El flag --yolo desactiva tanto el sandbox como las aprobaciones. Úsalo solo en entornos desechables, como un contenedor o una VM.
Los comandos que ejecuta el agente heredan el entorno de tu shell. Si tus claves de API están en variables de entorno, esos comandos pueden verlas.
Puedes limitarlo con shell_environment_policy:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
El ajuste core solo pasa variables básicas como HOME y PATH, y exclude elimina lo que coincida con esos patrones.
Los archivos son otro riesgo. El agente puede leer un .env en tu proyecto incluso en modo read-only. Con un proveedor hospedado, todo lo que lea el agente va a los servidores de ese proveedor.
Recuerda que el sandbox limita el daño, pero debes verlo como una red de seguridad, no una garantía.
Antes de dejar que el agente corra por su cuenta, ejecuta /status y comprueba el modo de sandbox y la política de aprobaciones.
Si encuentras un artículo de Open Interpreter que empieza con pip install, no está mal: describe otro proyecto.
El Open Interpreter original se lanzó en 2023 como proyecto en Python. Permitía a modelos de lenguaje ejecutar código Python, JavaScript y shell en tu máquina, y se conocía como alternativa open source al Code Interpreter de ChatGPT. Versiones posteriores añadieron control del ordenador, para que el modelo también manejara tu escritorio.
El proyecto principal actual es una reescritura en Rust basada en Codex. Se centra en agentes de codificación y en la emulación de harnesses, no en el control general del ordenador.
La versión Python no ha desaparecido. Continúa como fork de la comunidad en endolith/open-interpreter.
Ambas versiones usan el mismo nombre, el mismo historial del repositorio de GitHub y el mismo comando interpreter, así que es fácil confundirlas.
Pero hay una pista muy clara:
pip install open-interpreter: la versión heredada en Python
curl o instalador de PowerShell: la versión actual en Rust
Open Interpreter no es la herramienta adecuada para todos los escenarios. Aquí es donde tiene sentido y donde no.
Código abierto: con licencia Apache 2.0, puedes leer, auditar y hacer fork de toda la base de código
Elección de modelo: puedes usar modelos hospedados, open‑weight y locales desde un único agente, y cambiar entre ellos a mitad de sesión
Múltiples harnesses de agente: te acercas al rendimiento para el que se afinó un modelo, algo que pocos agentes ofrecen
Desarrollo nativo en terminal: encaja con tu shell y flujo de trabajo con Git, y el modo exec funciona en scripts y CI
Modelos abiertos y de menor coste: el proyecto se construye alrededor de ellos, con guías de proveedores dedicadas y harnesses a juego
Extensibilidad: MCP, skills, hooks, AGENTS.md, Agent Client Protocol y la anulación del SDK de Codex permiten conectarlo con otras herramientas
La calidad del modelo varía: el agente es tan bueno como el modelo detrás, y ningún harness arregla un modelo que no planifica tareas de varios pasos
Los modelos locales requieren hardware potente: en mis pruebas, devstral-small-2 por sí solo ocupó 26 GB de memoria, antes de la gran ventana de contexto que necesita un agente
La puesta en marcha requiere más trabajo: gestionas proveedores, ventanas de contexto, harnesses y ajustes de sandbox por tu cuenta. También hay aristas, como restos de marca Codex y avisos de metadatos para modelos de Ollama
La ejecución de comandos conlleva riesgo: el sandbox y las aprobaciones lo reducen, pero no lo eliminan
El código sigue necesitando revisión: que pasen los tests no garantiza una corrección adecuada, así que debes leer cada diff
Open Interpreter es un agente de codificación de código abierto que funciona con el modelo que elijas, ya sea hospedado, open‑weight o en tu propia máquina.
El flujo es sencillo. Eliges un modelo y un harness, apuntas el agente a un proyecto y lo dejas inspeccionar, editar y ejecutar comandos hasta terminar la tarea. Luego revisas su trabajo.
La emulación de harness lo diferencia de la competencia. Open Interpreter no fuerza a todos los modelos a un único agente: cambia la configuración para adaptarse al modelo, y eso puede marcar la diferencia. El modelo determina la calidad del trabajo y los permisos lo que el agente puede modificar. Tu revisión es el último control antes de que cualquier cambio llegue a tu base de código.
Si quieres obtener una certificación de ingeniero/a de IA, inscríbete en nuestro itinerario Associate AI Engineer for Developers y da el salto al mundo de la IA a tu ritmo.
Aprende con DataCamp
Programa
Programa
Programa
blog
Abid Ali Awan
9 min
Tutorial
Adel Nehme
9 min
Tutorial
Zoumana Keita
14 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Zoumana Keita
12 min
Tutorial
Dimitri Didmanidze
8 min