Programa
Associate AI Engineer para desenvolvedores
26 h
Se você já tentou rodar um modelo open-weight dentro de um agente de código criado para outro modelo, sabe que não é uma boa ideia.
O modelo geralmente interpreta errado os esquemas de ferramentas e insiste no mesmo comando que falhou até você interromper. Quando você volta ao modelo para o qual o agente foi feito, a mesma tarefa passa sem problemas. Normalmente, o problema não está no modelo, mas no harness do agente ao redor dele, já que os prompts e formatos de ferramentas foram ajustados para outro alvo.
O Open Interpreter resolve isso emulando o harness para o qual cada modelo foi ajustado, como o Claude Code ou o Kimi Code. É um agente de código de IA open source que roda no seu terminal. A versão atual é um projeto em Rust construído sobre o Codex da OpenAI, não o assistente de computador em Python que você talvez lembre.
Neste artigo, vou mostrar a instalação, a configuração de modelo e harness, um fluxo de trabalho prático de codificação e como o Open Interpreter se compara ao Claude Code, OpenCode e Codex.
Está começando com agentes de IA? Inscreva-se no nosso curso de introdução a agentes de IA e aprenda os fundamentos em uma tarde.
Open Interpreter dá a um modelo de IA acesso ao seu projeto e às ferramentas que um desenvolvedor usaria nele.
Basta descrever a tarefa em inglês claro que o agente trabalha no seu código. Ele consegue operar com:
O projeto é open source sob a licença Apache 2.0. E não fica preso a um único provedor de modelos. Você pode conectá-lo a modelos hospedados, modelos open-weight ou modelos que rodam localmente na sua máquina.
O repositório principal tem mais de 68.000 estrelas no GitHub em setembro de 2026.
O Open Interpreter trabalha em um loop:
Algumas dessas etapas dependem da sua aprovação, conforme as permissões. Vou falar disso na seção de segurança.
Aqui vai uma visão mais visual:
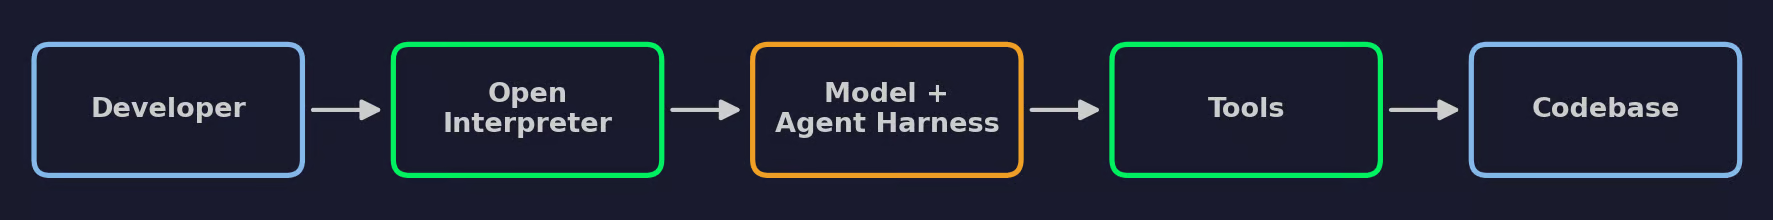
Como o Open Interpreter funciona
O ponto-chave é que você não conversa diretamente com o modelo. O Open Interpreter envia sua tarefa ao modelo, formatada com os prompts e as definições de ferramentas do harness ativo. O modelo solicita chamadas de ferramenta, e o Open Interpreter as executa na sua base de código. Depois, os resultados voltam ao modelo para o próximo passo.
Como modelo e harness são camadas separadas, você pode trocar qualquer um sem mexer no restante da configuração.
O Open Interpreter instala como um binário standalone, então você não precisa de Python ou pip.
Se algum post antigo mandar rodar pip install open-interpreter, ele está descrevendo a versão legada em Python. Esse comando não vai instalar o agente de código em Rust que eu mostro aqui.
Também vale ter o Git na sua máquina. O Open Interpreter roda sem ele, mas com Git a sessão fica ciente do repositório e mostra diffs.
Execute o script de instalação no terminal:
curl -fsSL https://www.openinterpreter.com/install | shO script baixa a release certa para sua plataforma e coloca o comando interpreter em ~/.local/bin.
Abra o PowerShell e rode:
irm https://www.openinterpreter.com/install.ps1 | iexO WSL também é suportado se você preferir um setup estilo Linux. Nesse caso, rode o comando de macOS e Linux dentro do seu terminal WSL.
Reinicie o terminal para atualizar o PATH e confira a versão:
interpreter --versionSe aparecer um número de versão, deu certo.
Verificação da versão do Open Interpreter
Comece uma sessão de qualquer diretório:
interpreterVocê também pode digitar i, que é um alias curto para o mesmo comando.
O Open Interpreter abre uma interface no terminal onde você descreve tarefas em inglês simples. Na primeira execução, ele pede para conectar um provedor de modelo. Vou usar um modelo local via Ollama na próxima seção, então você pode pular isso por enquanto.
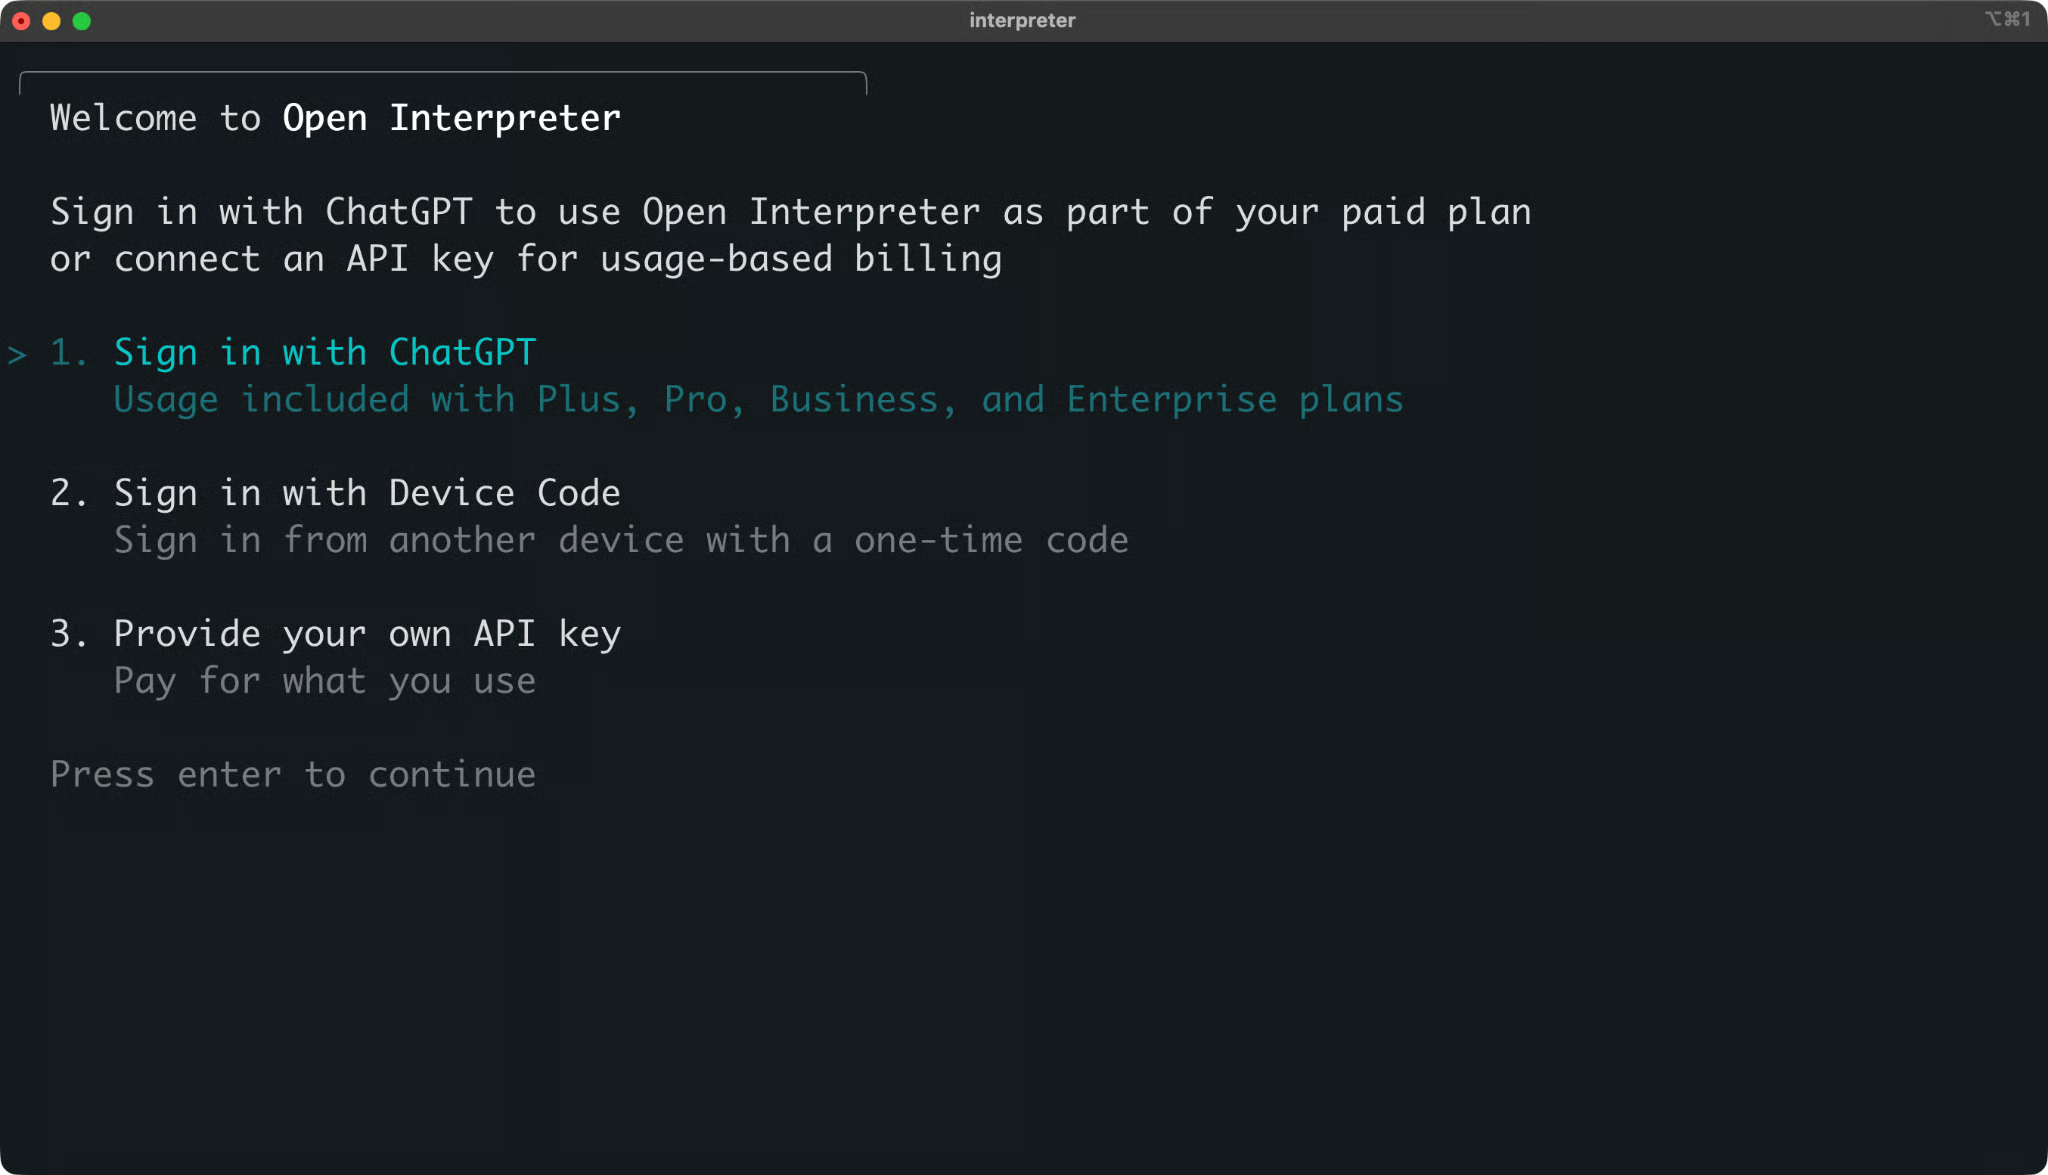
Sessão interativa do Open Interpreter
Para sair da sessão, digite /exit.
A forma mais rápida de entender um agente de código é dar uma tarefa e ver o que ele faz.
Vou usar um pequeno projeto de controle de hábitos nesta seção inteira. Ele tem uma função, um arquivo de teste e um bug.
O projeto calcula a sequência mais longa de dias consecutivos para um hábito. Por exemplo, quantos dias seguidos você se exercitou.
Comece com uma pasta de projeto e um ambiente virtual:
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
Crie o habits.py com o código a seguir:
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
Depois crie o test_habits.py:
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
A função tem um bug. Não vou apontá-lo, porque encontrar é trabalho do agente.
Adicione um .gitignore para manter o ambiente virtual e caches fora do repositório:
.venv/
__pycache__/
.pytest_cache/
Agora faça o commit do projeto:
git init
git add .
git commit -m "Initial commit"
Esse commit dá um ponto de partida limpo. Depois, você vai usá-lo para ver exatamente o que o agente mudou.
Rode os testes para confirmar o bug:
python -m pytest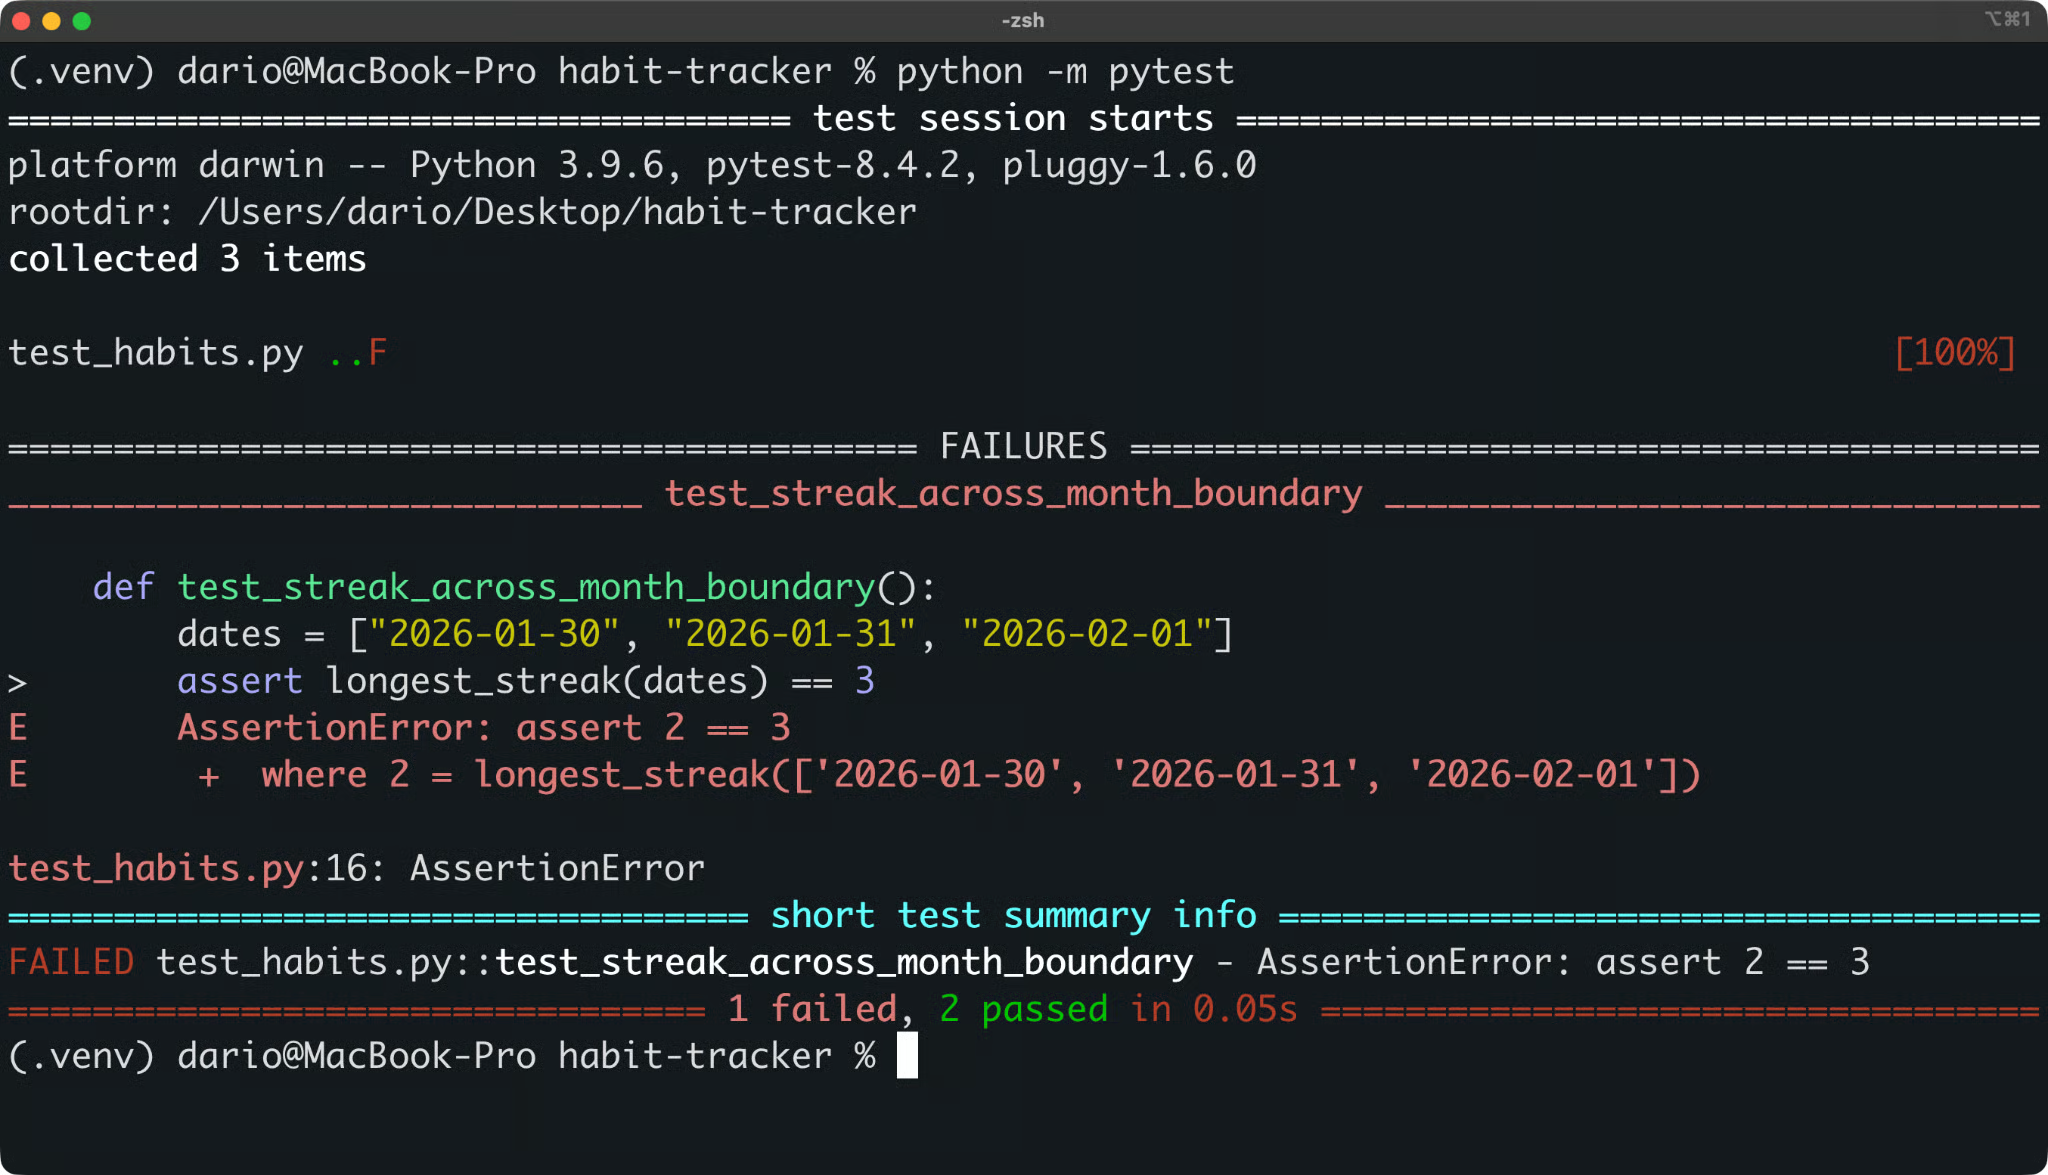
Resultado dos testes do habit tracker
Dois testes passam e um falha. É isso que o Open Interpreter precisa resolver.
Você vai precisar do Ollama instalado e rodando. Também precisa de um modelo que suporte tool calling, então faça o pull:
ollama pull qwen3-coder:30bDepois inicie o Open Interpreter a partir da pasta do projeto. Use o mesmo terminal para o agente aproveitar o pytest do seu ambiente virtual:
interpreter --oss --local-provider ollama -m qwen3-coder:30bO que cada flag faz:
--oss: usa um provedor local open source
--local-provider ollama: escolhe Ollama em vez de LM Studio
-m qwen3-coder:30b: define o modelo para essa execução
Rode /status para confirmar o provedor ativo, o modelo, o modo de sandbox e a política de aprovação.
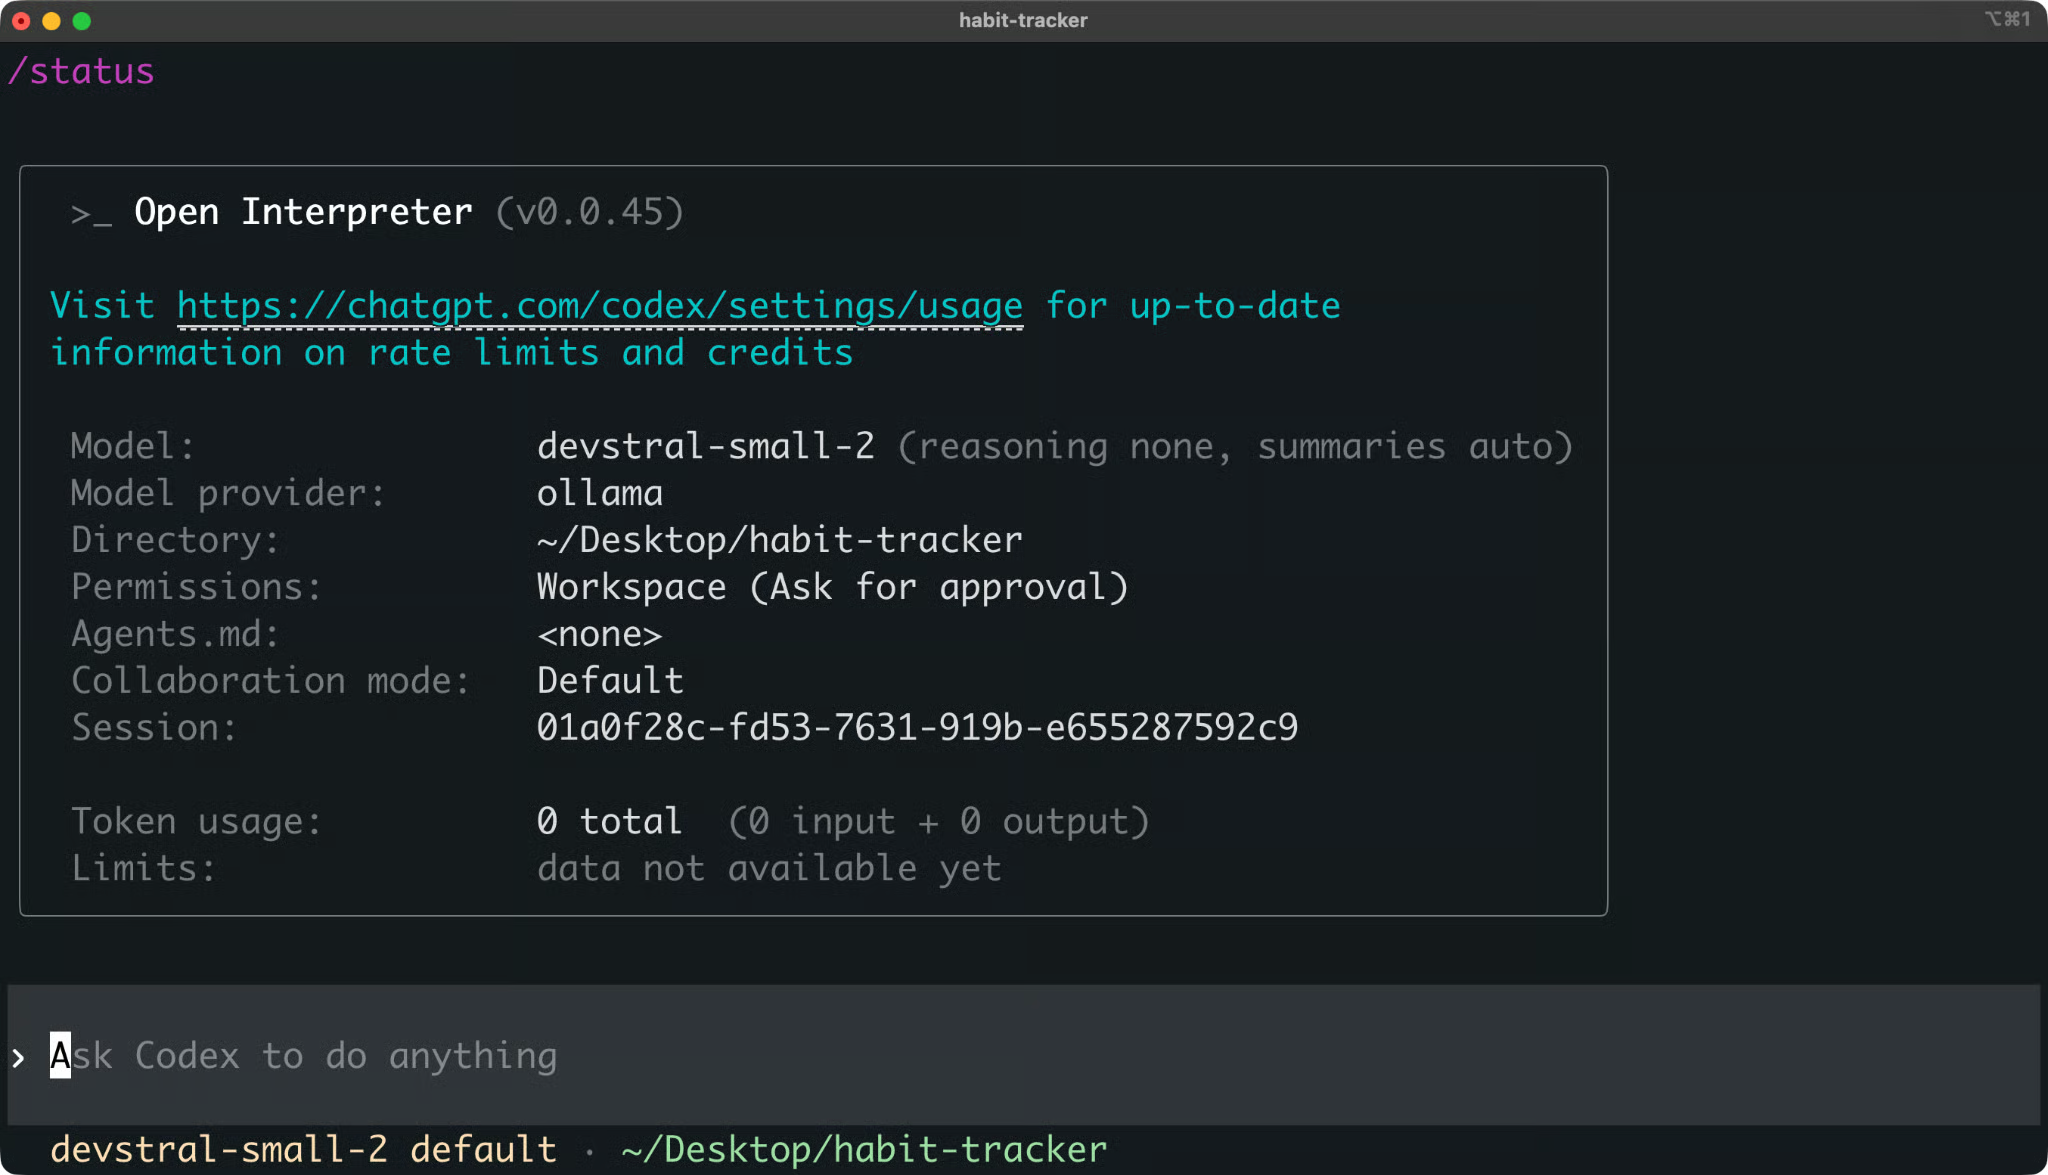
Sessão do Open Interpreter com modelo local via Ollama
Você não quer que o agente edite nada ainda. Peça um diagnóstico primeiro:
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.O agente normalmente lê os arquivos e roda os testes antes de responder. Os comandos rodam no sandbox e, se o agente precisar de mais acesso do que o sandbox permite, ele pede sua aprovação antes.
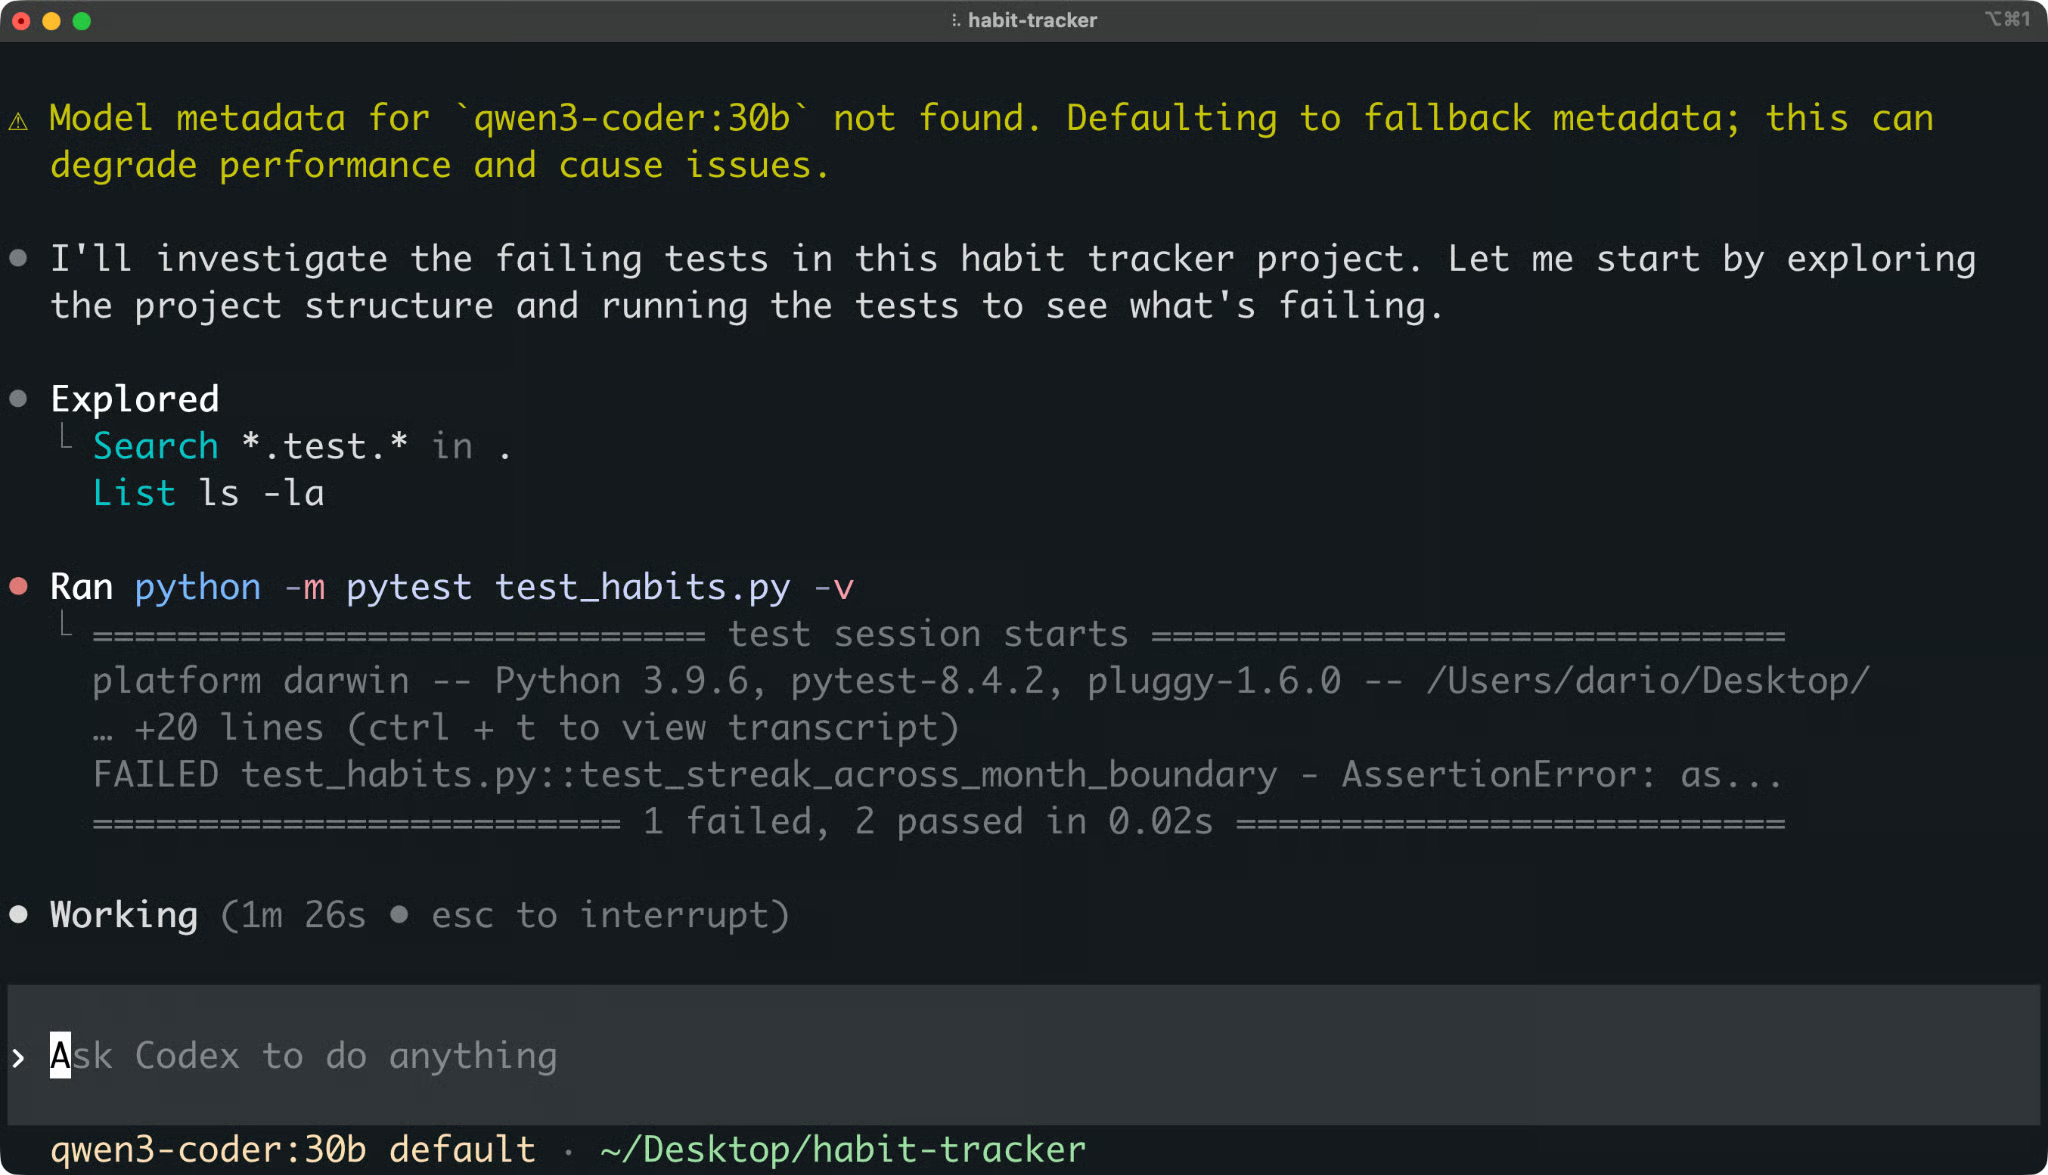
Saída do Open Interpreter
Leia a explicação antes de aprovar qualquer coisa.
Um diagnóstico correto diz que a função compara apenas o dia do mês, então a sequência se quebra ao virar o mês. Uma boa correção compara datas completas, por exemplo com date.fromisoformat() do módulo datetime do Python.
Se o diagnóstico estiver errado, corrija na mesma sessão antes de o agente editar qualquer código.
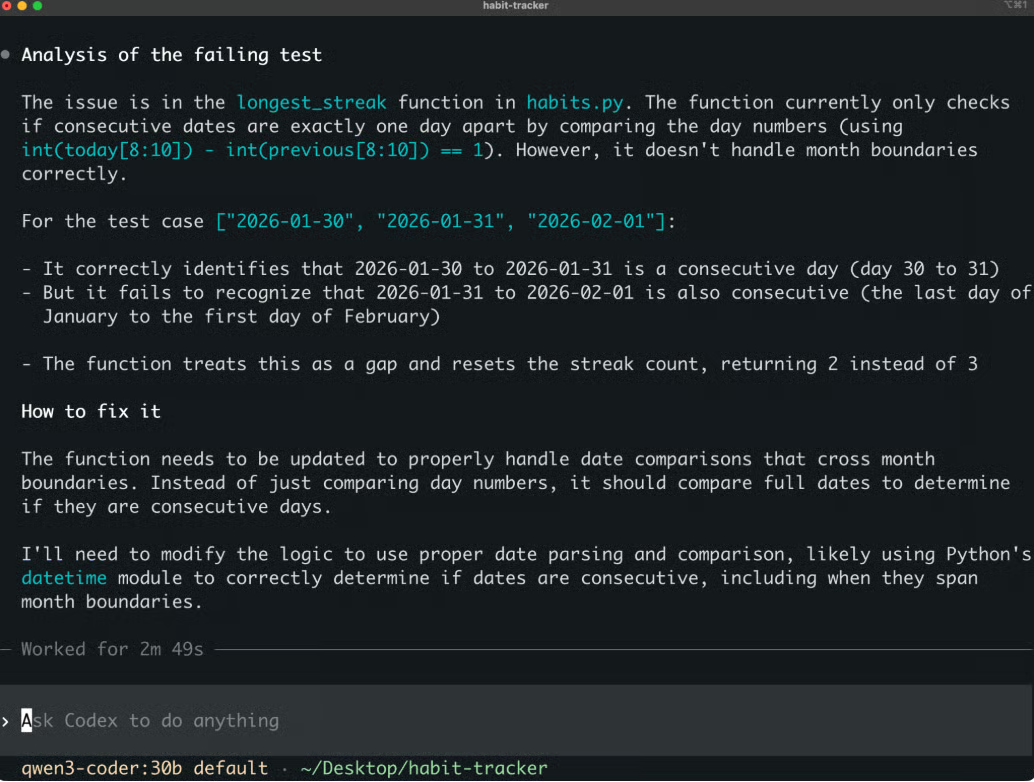
Proposta de correção do Open Interpreter
Quando estiver satisfeito com o plano, implemente a correção:
Apply the fix to habits.py, then run the tests.O agente edita o arquivo e roda o pytest novamente. Você quer ver os três testes passando.
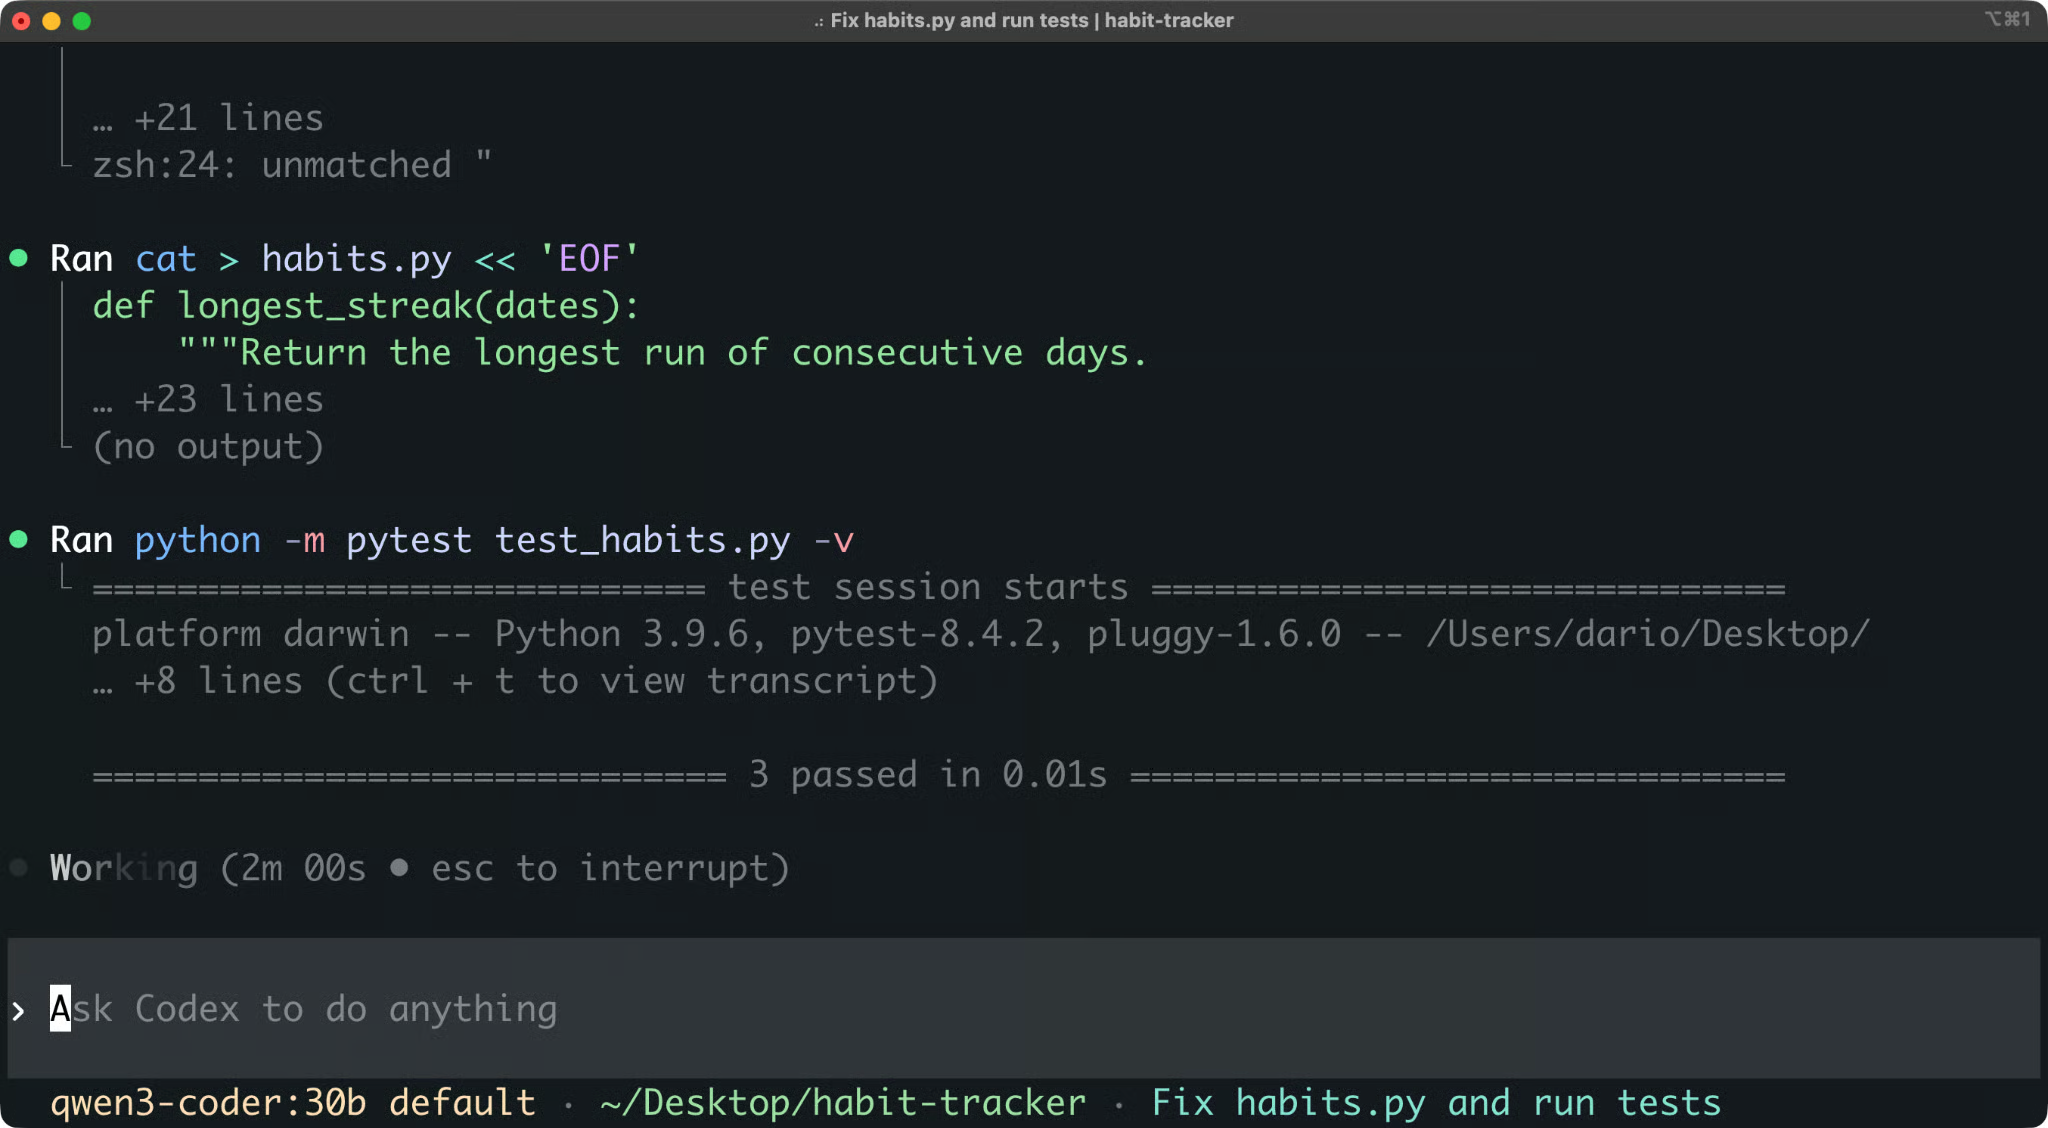
Todos os testes passam após a correção
Teste passando não garante que o bug foi de fato resolvido. Talvez o teste tenha sido alterado para contornar o bug. Você ainda precisa revisar o código.
Rode /diff dentro da sessão para ver as mudanças no working tree. Você também pode rodar git diff depois de sair.
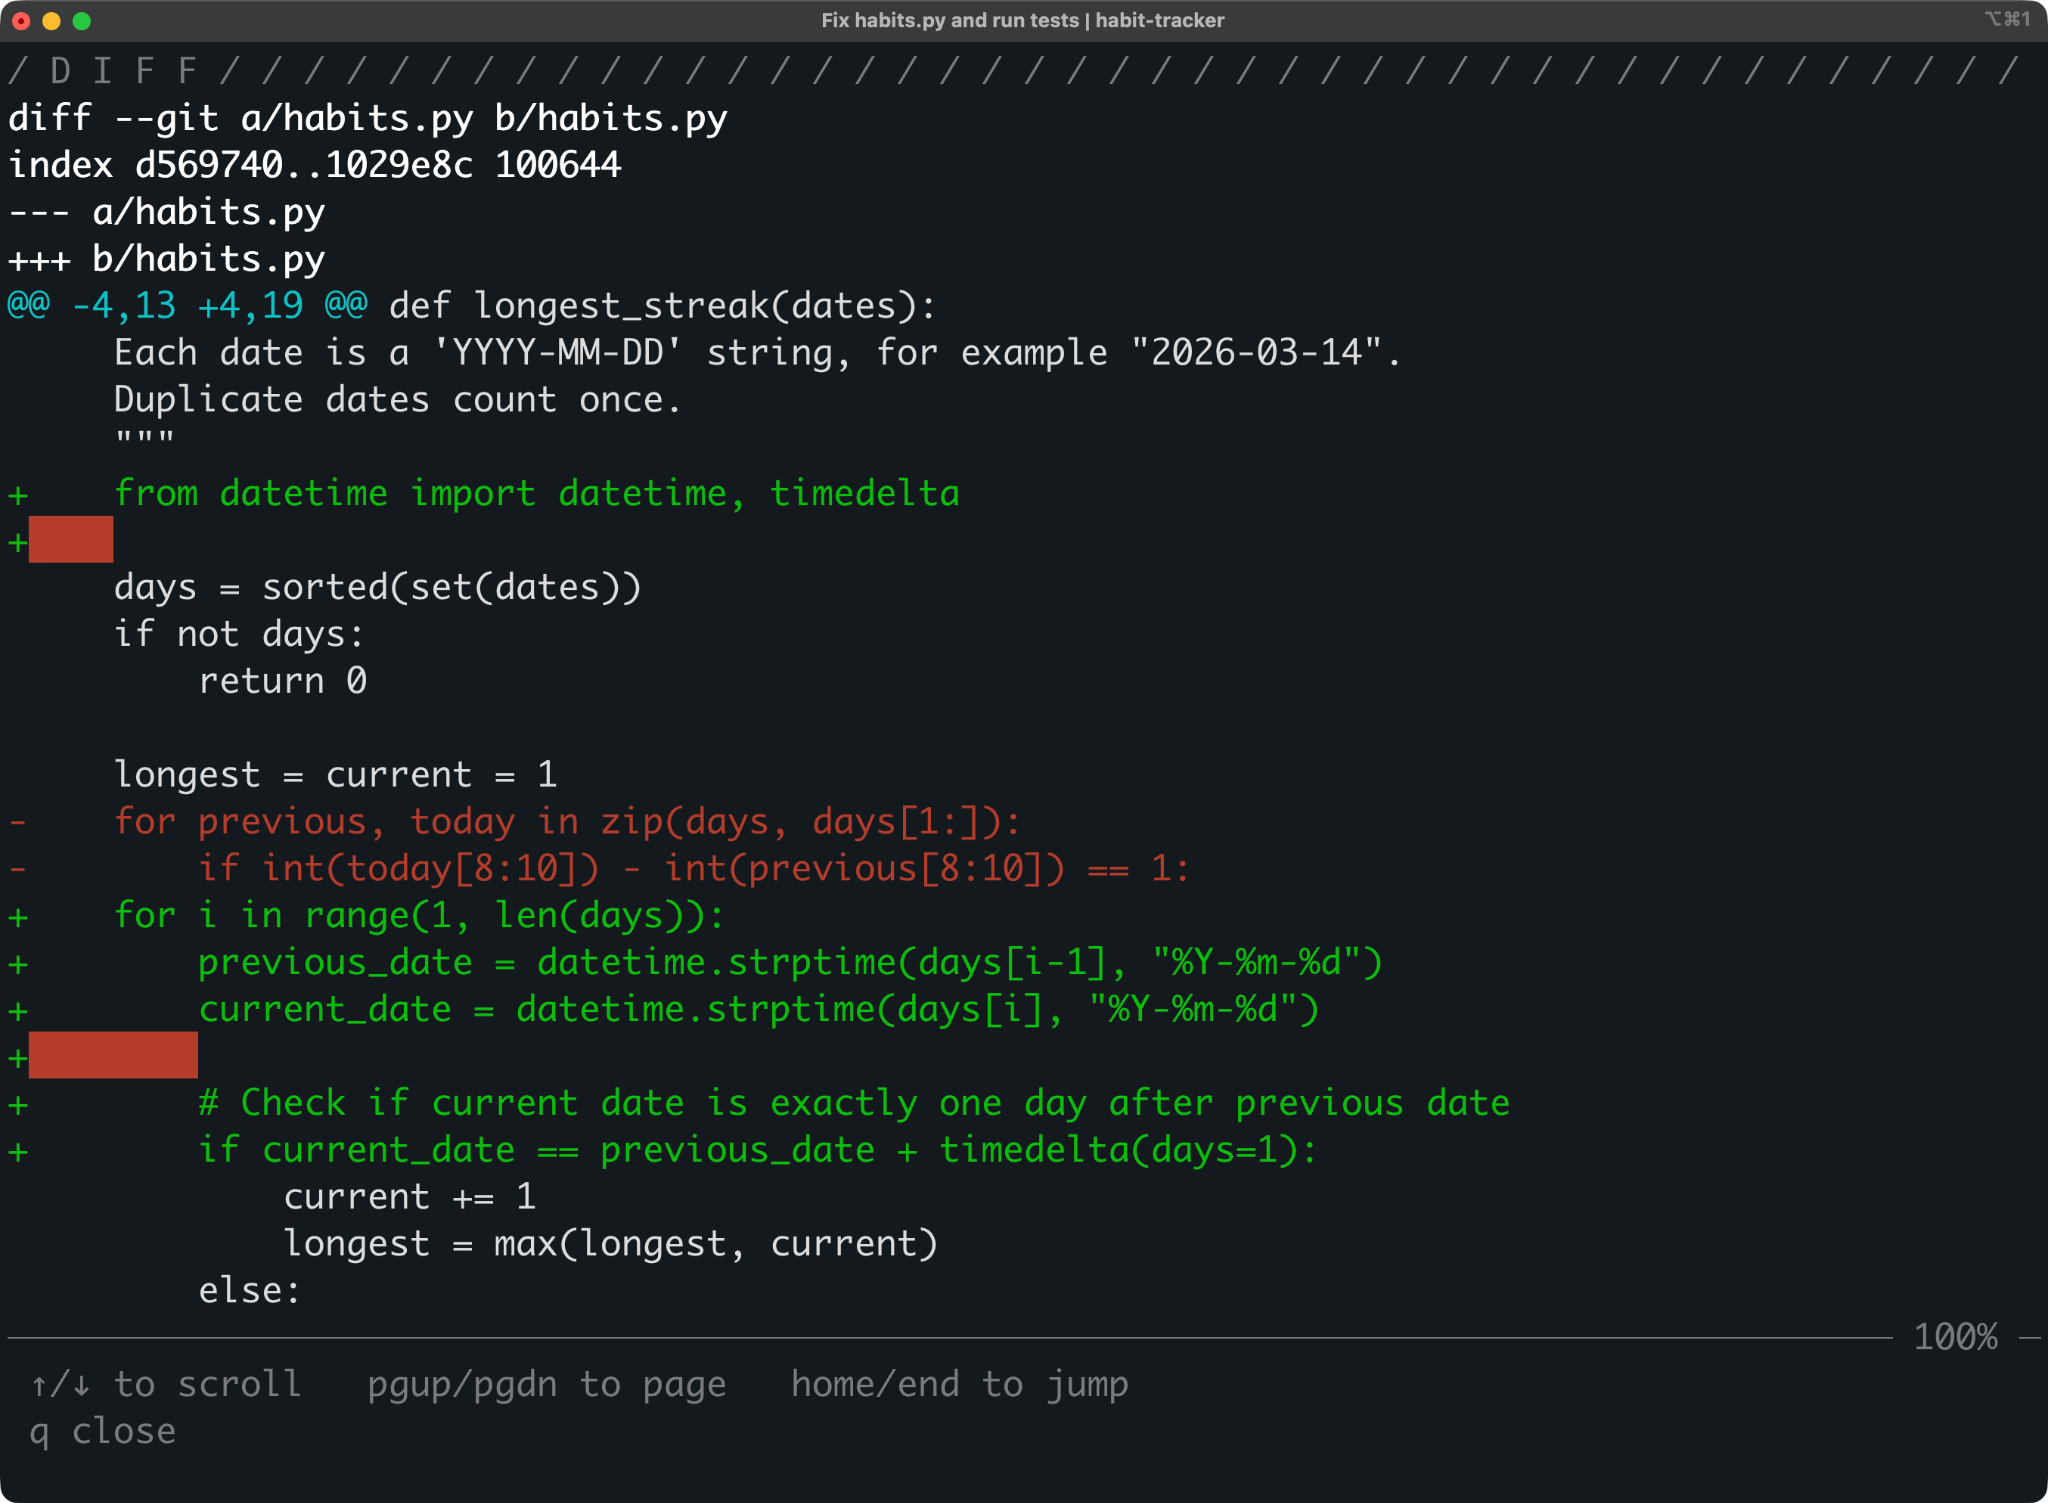
Diff das mudanças feitas pelo Open Interpreter
O diff exato depende do modelo, então o seu pode não bater linha a linha com o acima. Se você gostar da mudança, faça o commit; se não, restaure o arquivo original:
git restore habits.pyE essa é a dinâmica. Você descreve o problema, o agente investiga e corrige, e você revisa cada mudança antes de ela entrar no seu código.
O Open Interpreter exige que você traga o seu próprio modelo.
Cada requisição passa por três camadas:
| Camada | Exemplo | O que controla |
|---|---|---|
| Provedor | ollama | Para onde vão as requisições e como você autentica |
| Modelo | devstral-small-2 | O modelo que faz o trabalho |
| Harness | native | Os prompts, ferramentas e formato de mensagens ao redor do modelo |
Camadas da requisição
Veja o que você pode conectar:
A lista de provedores é gerada de um catálogo público de modelos e só mantém modelos que suportam tool calling. Se um modelo esperado não aparecer, geralmente é por isso.
Atenção ao ollama-cloud. É um provedor hospedado separado, então suas requisições saem da sua máquina. Apenas o provedor nativo ollama roda modelos localmente.
Você pode mudar o modelo em três níveis:
Dentro de uma sessão: rode /model para escolher provedor, modelo e esforço de raciocínio
Para uma execução: passe a flag -m, como na seção anterior
Como padrão: defina no seu arquivo de configuração
Você pode rodar /status a qualquer momento para ver o provedor e o modelo ativos.
O Open Interpreter lê as configurações de ~/.openinterpreter/config.toml. Para tornar padrão o setup do Ollama da seção anterior, adicione estas duas linhas:
model_provider = "ollama"
model = "qwen3-coder:30b"
Depois disso, interpreter inicia com esse modelo, sem flags.
Provedores hospedados leem suas chaves de API de variáveis de ambiente. Por exemplo, o DeepSeek espera DEEPSEEK_API_KEY:
export DEEPSEEK_API_KEY="your-api-key"Você também pode adicionar qualquer endpoint compatível com OpenAI como provedor customizado:
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
A configuração wire_api indica ao Open Interpreter qual formato de requisição o endpoint espera. Use chat para Chat Completions compatível com OpenAI, responses para a OpenAI Responses API e messages para endpoints no estilo Anthropic.
Um projeto confiável também pode ter seu próprio .openinterpreter/config.toml, que substitui sua configuração de usuário. Flags de linha de comando sobrepõem ambos. Se não souber qual valor prevalece, rode /debug-config para ver as configurações efetivas e suas origens.
O modelo decide o quanto o agente entende seu código. O harness decide como o modelo enxerga a tarefa e as ferramentas.
Você precisa dos dois. Um bom modelo dentro de um harness incompatível envia chamadas de ferramenta malformadas e interpreta resultados errado. E um bom harness não compensa um modelo que não entende o código.
Por isso o Open Interpreter escolhe um harness quando você escolhe um modelo. Por exemplo:
Modelos Claude recebem o harness claude-code
Modelos Kimi recebem kimi-code
Modelos Qwen recebem qwen-code
Modelos DeepSeek recebem claude-code-bare
Para outras famílias de modelos, você pode escolher o harness com /harness.
Lembre que um resultado fraco nem sempre significa um modelo fraco. Antes de trocar de modelo, teste o mesmo modelo com outro harness — vou detalhar isso na próxima seção.
A emulação de harness é o principal motivo de existir a versão atual do Open Interpreter.
Um harness de agente é tudo ao redor do modelo que o transforma em agente. Inclui:
Em bom português, o harness decide como o modelo enxerga a tarefa e como as decisões viram ações.
O Open Interpreter tem modos de harness embutidos. Estes são os mais usados:
native: harness próprio do Open Interpreter, herdado do Codex
claude-code: emula os prompts e a superfície de ferramentas do Claude Code da Anthropic
kimi-code: reimplementação em Rust do harness Kimi Code recomendado pela Moonshot para seus modelos Kimi
qwen-code: emula o Qwen Code CLI da Alibaba para modelos Qwen
swe-agent: emula o SWE-agent, um agente de pesquisa feito para resolver issues no GitHub
A lista completa também tem variantes como claude-code-bare, kimi-cli, deepseek-tui, zcode e minimal. Rode /harness em uma sessão para ver o que sua versão suporta.
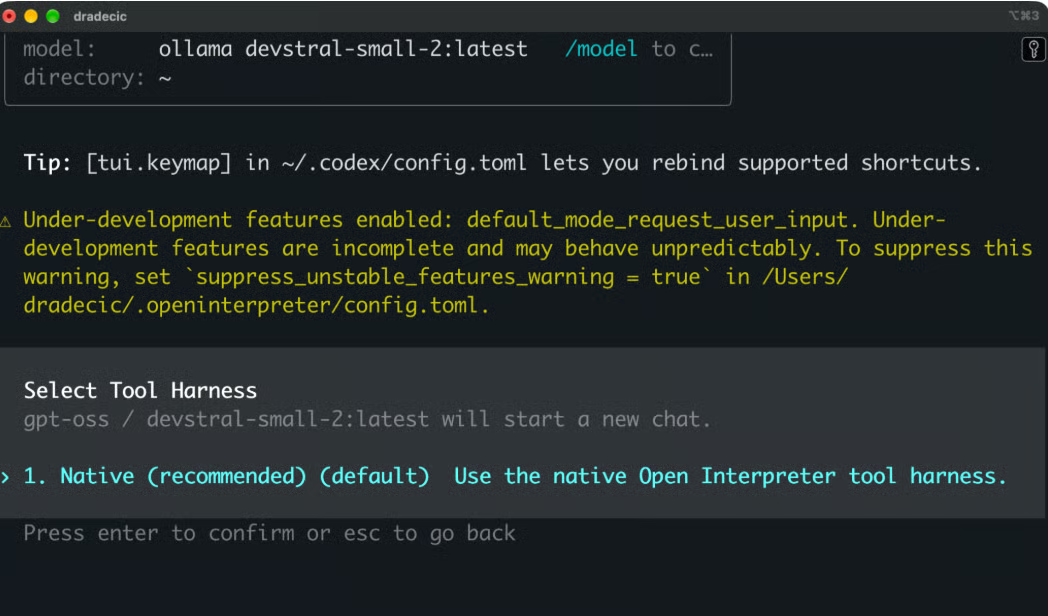
Você pode trocar de harness no meio da sessão com /harness ou definir um padrão em ~/.openinterpreter/config.toml:
harness = "kimi-code"
harness_guidance = true
A opção harness_guidance adiciona uma guidance de confiabilidade quando o harness permite. Defina como false se quiser uma emulação mais estrita. Se você não definir harness, o Open Interpreter escolhe com base na família do modelo, como vimos antes.
A maioria dos vendors ajusta seus modelos de código dentro de um setup específico de agente e publica um harness recomendado para acompanhá-los.
O modelo se acostuma a esse harness. Ele aprende o estilo de prompt, os nomes das ferramentas, o formato de edição de arquivo e a forma como os resultados retornam.
Suponha que você rode um modelo ajustado para edições de busca-e-substituição dentro de um harness que espera arquivos de patch completos. O modelo sabe qual mudança fazer, mas continua descrevendo a alteração no formato errado. O loop do agente gasta tokens sem avançar.
Com os resultados de ferramentas é igual. Se o harness devolve resultados em um formato que o modelo não viu, ele interpreta errado. Se o harness descarta o raciocínio do modelo entre turnos, um modelo que "pensa" perde o fio do próprio plano.
Isso significa que o mesmo modelo pode parecer ótimo em um agente e fraco em outro, sem mudar os pesos. Por isso benchmarks de código geralmente citam o harness usado em cada execução.
Modelos de ponta tendem a se virar com um harness desconhecido, mas modelos menores e baratos geralmente não. O Open Interpreter não força todo modelo a um único formato; ele ajusta o formato ao modelo.
Você pode testar isso no projeto demo. Restaure o arquivo original com git restore habits.py, troque o harness com /harness e dê o mesmo prompt ao agente. Depois compare quantos passos ele leva e como formata as edições.
Você já viu a maioria destes recursos no artigo. Aqui está o que cada um entrega no dia a dia de desenvolvimento.
O Open Interpreter trabalha dentro do seu repositório Git. Ele lê a estrutura do projeto e acompanha o que mudou.
Dois comandos com slash ajudam: /diff mostra as mudanças no working tree e /review pede para o agente checar as mudanças atuais por bugs e regressões antes do commit. Você pode rodar a mesma revisão sem abrir uma sessão:
interpreter exec review --uncommittedAs sessões também ficam salvas. Se você parar no meio de uma tarefa, interpreter resume --last retoma de onde parou.
O agente roda os mesmos comandos que você rodaria: suítes de teste, linters, scripts de build e gerenciadores de pacotes. Tudo roda em sandbox nativo no macOS, Linux e Windows.
Comandos longos podem rodar em background. Use /ps para listá-los e /stop para encerrá-los.
Para scripts e pipelines de CI, interpreter exec executa uma tarefa sem a interface interativa:
interpreter exec "fix the failing test"Você pode trocar de provedor e modelo a qualquer momento com /model. Sua configuração, AGENTS.md e skills continuam valendo após a troca.
Perfis ajudam muito. Digamos que você queira um modelo econômico para tarefas rotineiras e um mais forte para code reviews. Você pode definir ambos na config:
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
Depois é só iniciar com interpreter --profile review quando precisar.
/harness muda como o modelo enxerga a tarefa sem trocar o modelo. É a primeira coisa a tentar quando um modelo sofre com tool calls, antes de subir para um modelo maior.
O Model Context Protocol (MCP) conecta o agente a ferramentas para as quais ele não foi projetado, como servidores de documentação ou bancos de dados. Você adiciona servidores na config:
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
Rode /mcp para ver os servidores configurados e suas ferramentas. A opção default_tools_approval_mode faz o agente pedir antes de usar uma ferramenta desse servidor.
Também funciona ao contrário. interpreter mcp-server expõe o Open Interpreter como servidor MCP, e interpreter acp o executa em editores que suportam o Agent Client Protocol, um padrão aberto para conectar editores a agentes de código.
AGENTS.md é um arquivo Markdown no seu repositório com regras do projeto que o agente lê em toda tarefa. Para o habit tracker, poderia ser algo assim:
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
Você também pode rodar /init e o agente escreve a primeira versão para você.
Skills são fluxos de trabalho reutilizáveis, empacotados como pastas em .agents/skills no seu projeto ou em ~/.agents/skills para o usuário. O agente identifica uma skill automaticamente quando a tarefa combina com ela. Rode /skills para ver as disponíveis.
Ambos são formatos compartilhados, então os mesmos arquivos funcionam com outros agentes de código que os suportem. O Open Interpreter também suporta hooks, que rodam seus próprios comandos em pontos definidos da sessão. Você os revisa e confia via /hooks.
Duas configurações controlam o que o agente pode fazer:
Modo de sandbox: read-only, workspace-write ou danger-full-access
Política de aprovação: untrusted, on-request ou never
O sandbox define o que é possível e a política de aprovação define quando o agente pede antes. Com workspace-write e on-request, o agente pode editar seu projeto e rodar testes, mas pede antes de precisar de acesso além disso.
Você pode mudar ambos com /permissions ou com as flags -s e -a. Também existe a flag --yolo, que ignora ambos — e a documentação marca como perigosa. Vou detalhar essas opções na seção de segurança.
O Open Interpreter se descreve como um agente de código feito para modelos de baixo custo.
Os maiores agentes proprietários de código são construídos em torno dos modelos do próprio vendor. O Open Interpreter oferece um agente único que funciona com modelos proprietários, modelos open-weight hospedados e modelos locais.
Modelos open-weight como Kimi, DeepSeek, GLM e Qwen têm pesos públicos. Você pode usá-los via provedor terceirizado ou no seu próprio hardware.
Isso traz duas vantagens. Modelos open-weight hospedados geralmente custam menos por token que modelos proprietários de ponta. E você não fica preso a um host, porque o mesmo modelo roda onde seus pesos rodarem.
O Open Interpreter tem guias dedicados para Kimi K3, DeepSeek e GLM. Ele também escolhe o harness correspondente para essas famílias de modelos.
Ollama e LM Studio são provedores nativos, então você pode rodar um modelo na sua própria máquina sem chave de API ou custo por token.
O custo é hardware. Quando testei o devstral-small-2 no meu MacBook Pro M1 Max com 64 GB de memória unificada, só o modelo ocupou 26 GB. A janela de contexto padrão do Ollama era pequena demais para o loop do agente e, com 128k tokens, o uso de memória subia e descia até a sessão travar.
Agentes de código precisam de uma janela de contexto grande, porque o prompt de sistema, as definições de ferramentas, o conteúdo de arquivos e a saída de comandos têm que caber. O Ollama recomenda pelo menos 64k tokens para agentes no estilo Codex. E uma janela maior consome mais memória além do próprio modelo.
O Open Interpreter roda na sua máquina, mas o modelo não precisa rodar nela.
Para onde seu código vai depende do provedor:
Sua config, sessões e logs são sempre armazenados localmente em ~/.openinterpreter.
Se precisar de mais controle, você pode adicionar um provedor customizado apontando para seu próprio servidor de inferência. Qualquer servidor com API compatível com OpenAI funciona, por exemplo um deployment vLLM nas GPUs da sua empresa. Assim, você tem um setup hospedado com infraestrutura própria.
Modelos open não são igualmente bons em tool calling. Você vai ver uso fraco aparecer como chamadas malformadas, loops, interrupções precoces ou saída de comando ignorada.
O harness certo ajuda, mas não salva um modelo que não consegue planejar uma tarefa em várias etapas. Modelos locais menores sofrem mais aqui.
Antes de apontar um modelo novo para um projeto real, teste em um repositório pequeno como o habit tracker que mostrei. Se aparecerem fragilidades, tente outro harness antes de subir para um modelo maior.
Aqui vai um resumo rápido das opções:
| Onde roda a inferência | Custo | Seu código sai da sua máquina? | |
|---|---|---|---|
| Modelo proprietário hospedado | Servidor do fornecedor | Por token ou assinatura | Sim |
| Modelo open-weight hospedado | Servidor do provedor | Por token, geralmente menor | Sim |
| Modelo open-weight local | Seu hardware | Hardware e energia | Não |
Opções do Open Interpreter para modelos locais e open
O Open Interpreter tem muito em comum com outros agentes de código no terminal. As diferenças estão em quem é o dono da ferramenta e para quais modelos ela foi feita.
Claude Code é o agente de código no terminal da Anthropic. A primeira diferença é a propriedade — o Claude Code é proprietário, enquanto o Open Interpreter é open source sob a licença Apache 2.0. Você pode ler e modificar todas as partes do Open Interpreter.
A escolha de modelo é a segunda diferença. O Claude Code é construído para os modelos Claude. Você pode apontá-lo para endpoints compatíveis com Anthropic de outros provedores, mas o harness continua ajustado para Claude. O Open Interpreter trata a escolha de modelo como um recurso central.
A comparação de harness é onde fica interessante. O Claude Code é um dos harnesses que o Open Interpreter emula. Com o modo claude-code, qualquer modelo recebe prompts e ferramentas no estilo Claude Code dentro do runtime do Open Interpreter. A UI e os comandos com slash continuam sendo do Open Interpreter, então não é o mesmo produto com outro modelo.
Ambas as ferramentas são "terminal-first". Cada uma tem uma sessão interativa e um modo não interativo para scripts e CI. Para instruções de projeto, o Claude Code lê CLAUDE.md, enquanto o Open Interpreter usa o formato compartilhado AGENTS.md.
O Claude Code tem um ecossistema maior. Ele vem com extensões para IDE, apps desktop e web, marketplace de plugins, subagentes e um SDK. O Open Interpreter é mais novo e aposta em padrões abertos como MCP, skills, AGENTS.md e o Agent Client Protocol em vez de um ecossistema próprio.
Se você trabalha com modelos Claude e quer a experiência mais polida, o Claude Code é a escolha mais segura. Se você quer rodar outros modelos ou evitar uma ferramenta proprietária, vá de Open Interpreter.
OpenCode é o mais parecido. Ambos são open source, "terminal-first" e feitos para trabalhar com uma longa lista de provedores de modelos.
No papel, o suporte a modelos é semelhante. O OpenCode suporta mais de 75 provedores, e o Open Interpreter gera sua lista de provedores a partir de um catálogo público. Ambos rodam modelos locais via Ollama.
A experiência no terminal difere mais. O OpenCode tem seu próprio TUI com integração ao Language Server Protocol (LSP), que alimenta o modelo com diagnósticos de código como erros de tipo. O TUI do Open Interpreter vem do Codex.
Quanto à configuração, o OpenCode usa um arquivo opencode.json e o Open Interpreter usa config.toml com perfis.
A arquitetura do agente é a principal diferença. O OpenCode roda como cliente e servidor, onde o TUI é um cliente de um servidor local ao qual outros clientes também podem se conectar. Ele tem agentes build e plan embutidos e suporta agentes e subagentes customizados. Ajusta o prompt de sistema por família de modelo, mas as ferramentas e o loop continuam sendo do próprio OpenCode. O Open Interpreter vai além e troca todo o harness, incluindo esquemas de ferramentas e formato de mensagens. Builds mais novos incluem até um modo de harness opencode.
Do lado de desenvolvimento, o OpenCode tem codebase própria, construída pela equipe e comunidade. O Open Interpreter é baseado em um fork do Codex, então grande parte do runtime vem upstream. Isso é um trade-off. O Open Interpreter ganha o sandbox e o runtime do Codex de graça, enquanto o OpenCode controla toda a stack.
Esses dois não competem no sentido usual. O Open Interpreter é um fork do Codex.
Eles compartilham o runtime em Rust, o TUI, o sandbox, aprovações, AGENTS.md, skills, MCP, modo exec e a maioria dos comandos com slash. Quando rodei o Open Interpreter, a dica para retomar sessão ainda dizia codex resume.
O Codex é o agente da OpenAI, construído em torno de modelos da OpenAI. Ele suporta modelos locais com --oss e provedores customizados, mas a experiência padrão foca na OpenAI.
O Open Interpreter estende o Codex em alguns pontos:
Emulação de harness: troca prompts, esquemas de ferramentas e formato de mensagens para cada família de modelo
Suporte a provedores: tem um catálogo de provedores gerado e guias dedicados para Kimi K3, DeepSeek e GLM
Chat Completions: a flag --chat-completions roda qualquer provedor compatível com OpenAI
Override do Codex SDK: apps construídos sobre o Codex SDK podem rodar via Open Interpreter
O Open Interpreter também guarda config e sessões em ~/.openinterpreter, então não conflita com uma instalação do Codex.
Se você usa principalmente modelos da OpenAI, o Codex é a melhor escolha. Se usa outros modelos, o Open Interpreter entrega o mesmo fluxo com suporte melhor para eles.
Aqui vai um rápido resumo:
| Licença | Modelos | Abordagem de harness | Config | |
|---|---|---|---|---|
| Open Interpreter | Open source (Apache 2.0) | Qualquer provedor, hospedado ou local | Emula o harness por modelo | config.toml |
| Claude Code | Proprietária | Feito para modelos Claude | Harness próprio do Claude Code | settings.json e CLAUDE.md |
| OpenCode | Open source (MIT) | 75+ provedores, hospedado ou local | Um harness com prompts específicos por modelo | opencode.json |
| Codex | Open source (Apache 2.0) | Feito para modelos OpenAI com --oss | Harness próprio do Codex | config.toml |
Open Interpreter comparado a outros agentes de código com IA
O pior que um chatbot pode fazer é te dar uma resposta ruim — que você ignora. Um agente de código roda comandos na sua máquina, lê e escreve arquivos e pode acessar a rede. Uma decisão ruim do modelo, ou um prompt injection, pode causar danos reais. Prompt injection são instruções escondidas em conteúdo que o agente lê, como um README ou uma página web.
O Open Interpreter herda seu modelo de segurança do runtime do Codex. Ele tem duas camadas — um sandbox que limita o que é possível e uma política de aprovação que decide quando o agente te pergunta antes.
Todo comando executado pelo agente passa por um sandbox em nível de SO no macOS, Linux e Windows. Há três modos de sandbox:
read-only: o agente pode ler arquivos, mas não mudar nada
workspace-write: o agente pode editar arquivos e rodar comandos dentro da pasta do projeto
danger-full-access: sem sandbox algum
Com workspace-write, as escritas ficam limitadas ao workspace ativo. O agente corrige seu código, mas não pode editar arquivos fora do projeto.
No modo workspace-write, os comandos não têm acesso à rede por padrão. Isso bloqueia downloads e impede o agente de enviar seu código para fora.
Algumas tarefas precisam de rede, por exemplo instalar um pacote. Você pode ativar o acesso na config:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
Ative apenas para projetos onde precisar.
A política de aprovação decide quando o agente para e pergunta:
untrusted: pergunta antes de rodar comandos que não estão na lista de confiáveis
on-request: pergunta quando a tarefa precisa de mais acesso do que o sandbox permite
never: nunca pergunta
Para projetos versionados, workspace-write com on-request é um bom padrão. O agente trabalha dentro do projeto e pede antes de ir além. O Git oferece um caminho de volta se algo der errado.
A flag --yolo desliga tanto o sandbox quanto as aprovações. Use apenas em um ambiente descartável, como um container ou VM.
Os comandos do agente herdam o ambiente do seu shell. Se suas chaves de API estão em variáveis de ambiente, esses comandos conseguem vê-las.
Você pode limitar isso com shell_environment_policy:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
A opção core passa apenas variáveis básicas como HOME e PATH, e exclude remove o que bater com os padrões.
Arquivos também são risco. O agente pode ler um .env no seu projeto mesmo em modo read-only. Com provedor hospedado, qualquer coisa que o agente ler vai para os servidores do provedor.
Lembre que o sandbox limita danos, mas trate-o como rede de segurança, não como garantia.
Antes de deixar o agente rodar sozinho, use /status e confira modo de sandbox e política de aprovação.
Se você achar um artigo do Open Interpreter que começa com pip install, não está errado. Ele descreve outro projeto.
O Open Interpreter original foi lançado em 2023 como um projeto em Python. Ele permitia que modelos de linguagem rodassem Python, JavaScript e shell na sua máquina, e ficou conhecido como alternativa open source ao Code Interpreter do ChatGPT. Versões posteriores adicionaram controle do computador, para o modelo operar seu desktop também.
O projeto principal atual é uma reescrita em Rust baseada no Codex. Ele foca em agentes de código e emulação de harness, não em controle geral do computador.
A versão em Python não desapareceu. Continua como um fork da comunidade em endolith/open-interpreter.
As duas versões usam o mesmo nome, o mesmo histórico de repositório no GitHub e o mesmo comando interpreter, então é fácil confundir.
Mas um sinal bem óbvio é:
pip install open-interpreter: versão legada em Python
curl ou instalador PowerShell: versão atual em Rust
O Open Interpreter não é a ferramenta certa para todo cenário. Aqui está onde faz sentido — e onde não faz.
Open source: licenciado sob Apache 2.0, você pode ler, auditar e fazer fork de todo o codebase
Escolha de modelo: use modelos hospedados, open-weight e locais em um único agente e troque entre eles no meio da sessão
Vários harnesses de agente: você chega mais perto do desempenho para o qual o modelo foi ajustado — poucos outros agentes de código oferecem isso
Terminal-native: encaixa no seu fluxo de shell e Git, e o modo exec funciona em scripts e CI
Modelos abertos e de menor custo: o projeto é construído ao redor deles, com guias dedicados e harnesses correspondentes
Extensibilidade: MCP, skills, hooks, AGENTS.md, Agent Client Protocol e override do Codex SDK permitem integrar com outras ferramentas
Qualidade do modelo varia: o agente só é tão bom quanto o modelo por trás — nenhum harness conserta um modelo que não planeja tarefas em várias etapas
Modelos locais exigem hardware robusto: nos meus testes, só o devstral-small-2 ocupou 26 GB de memória — antes da janela de contexto grande que um agente de código precisa
Setup dá mais trabalho: você gerencia provedores, janelas de contexto, harnesses e sandbox. Há arestas, como restos de branding do Codex e avisos de metadata em modelos Ollama
Executar comandos é um risco: sandbox e aprovações reduzem o risco, mas não eliminam
Código ainda precisa de revisão: testes passando não garantem correção certa — leia cada diff
O Open Interpreter é um agente de código open source que funciona com o modelo que você escolher — seja ele hospedado, open-weight ou rodando na sua própria máquina.
O fluxo é simples. Você escolhe um modelo e um harness, aponta o agente para um projeto e deixa ele inspecionar, editar e rodar comandos até concluir a tarefa. Depois você revisa o trabalho.
A emulação de harness é o diferencial. O Open Interpreter não força todo modelo ao mesmo setup. Ele muda o setup para se ajustar ao modelo — e isso faz diferença. O modelo determina a qualidade do trabalho e as permissões definem o que o agente pode modificar. Sua revisão é o último cheque antes de qualquer mudança chegar ao seu código.
Se você quer obter uma certificação de engenheiro de IA, inscreva-se na nossa trilha Associate AI Engineer for Developers e faça a transição para o mundo da IA no seu ritmo.
Aprenda com a DataCamp
Programa
Programa
Programa
blog
Abid Ali Awan
8 min
blog
blog
Abid Ali Awan
9 min
blog
Khalid Abdelaty
15 min
blog
Richie Cotton
8 min
Tutorial
Zoumana Keita
14 min