Programma
Ingegnere AI associato per sviluppatori
26 ore
Se hai mai eseguito un modello open-weight dentro un agente di coding pensato per un modello diverso, sai che non è una grande idea.
Di solito il modello interpreta male gli schemi degli strumenti e ripete all’infinito lo stesso comando fallito finché non lo fermi. Tornando al modello per cui l’agente era stato costruito, lo stesso task passa senza problemi. Di solito il problema non è nel modello, ma nell’harness dell’agente attorno ad esso, perché i suoi prompt e i formati degli strumenti erano ottimizzati per qualcun altro.
Open Interpreter risolve questo emulando l’harness per cui ciascun modello è stato ottimizzato, come Claude Code o Kimi Code. È un agente di coding AI open-source che gira dal tuo terminale, e la versione attuale è un progetto in Rust costruito su Codex di OpenAI, non l’assistente per computer basato su Python che potresti ricordare.
In questo articolo ti guiderò attraverso installazione, configurazione di modello e harness, un flusso di lavoro pratico di coding e un confronto tra Open Interpreter, Claude Code, OpenCode e Codex.
Nuovo agli agenti AI? Iscriviti al nostro corso Introduzione agli agenti AI e impara le basi in un pomeriggio.
Open Interpreter dà a un modello AI accesso al tuo progetto e agli strumenti che uno sviluppatore userebbe su di esso.
Ti basta descrivere un task in inglese semplice, e l’agente lavora sul tuo codice. Può lavorare con:
Il progetto è open source con licenza Apache 2.0. Non è nemmeno limitato a un solo provider di modelli. Puoi collegarlo a modelli hosted, modelli open-weight o modelli che girano in locale sul tuo computer.
Il repository principale ha più di 68.000 stelle su GitHub a settembre 2026.
Open Interpreter lavora in un ciclo:
Alcuni di questi passaggi richiedono prima la tua approvazione, in base alle impostazioni dei permessi. Ne parlerò nella sezione sulla sicurezza.
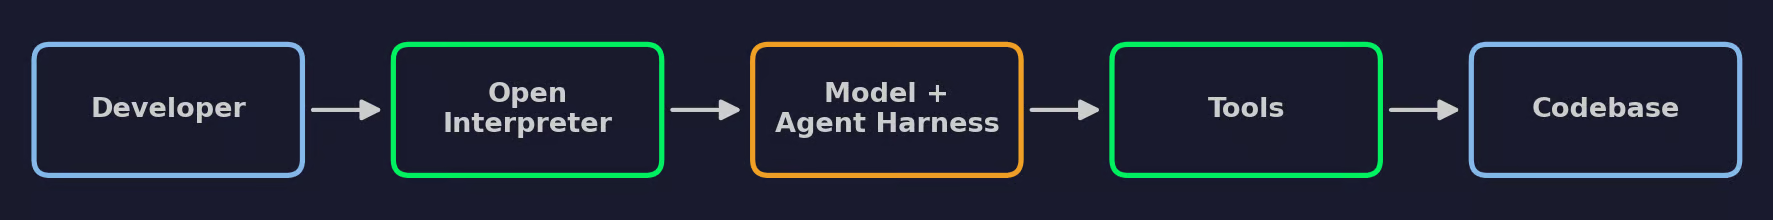
Ecco una panoramica più visiva:
Come funziona Open Interpreter
La cosa da ricordare è che non parli direttamente con il modello. Open Interpreter invia il tuo task al modello, formattato con i prompt e le definizioni degli strumenti dell’harness attivo. Il modello richiede chiamate agli strumenti e Open Interpreter le esegue sulla tua codebase. Poi i risultati tornano al modello per lo step successivo.
Dato che modello e harness sono layer separati, puoi cambiare l’uno o l’altro senza toccare il resto della configurazione.
Open Interpreter si installa come binario standalone, quindi non ti servono Python o pip.
Se un vecchio post sul blog ti dice di eseguire pip install open-interpreter, sta descrivendo la versione legacy in Python. Quel comando non ti darà l’agente di coding basato su Rust di cui parlo in questo articolo.
Ti servirà anche Git sulla macchina. Open Interpreter funziona anche senza, ma con Git ottiene una sessione consapevole del repository e i diff.
Esegui lo script di installazione dal terminale:
curl -fsSL https://www.openinterpreter.com/install | shLo script scarica la release giusta per la tua piattaforma e posiziona il comando interpreter in ~/.local/bin.
Apri PowerShell ed esegui:
irm https://www.openinterpreter.com/install.ps1 | iexWSL è supportato se preferisci un setup in stile Linux. In tal caso, esegui il comando per macOS e Linux dentro il terminale WSL.
Riavvia il terminale così da aggiornare il nuovo PATH, poi controlla la versione:
interpreter --versionSe vedi un numero di versione, l’installazione è andata a buon fine.
Verifica versione di Open Interpreter
Avvia una sessione da qualsiasi directory:
interpreterPuoi anche digitare i, un alias breve per lo stesso comando.
Open Interpreter apre un’interfaccia TUI nel terminale dove descrivi i task in inglese semplice. Al primo avvio, ti chiede di collegare un provider di modelli. Nel prossimo paragrafo userò un modello locale tramite Ollama, quindi puoi saltare questo passaggio per ora.
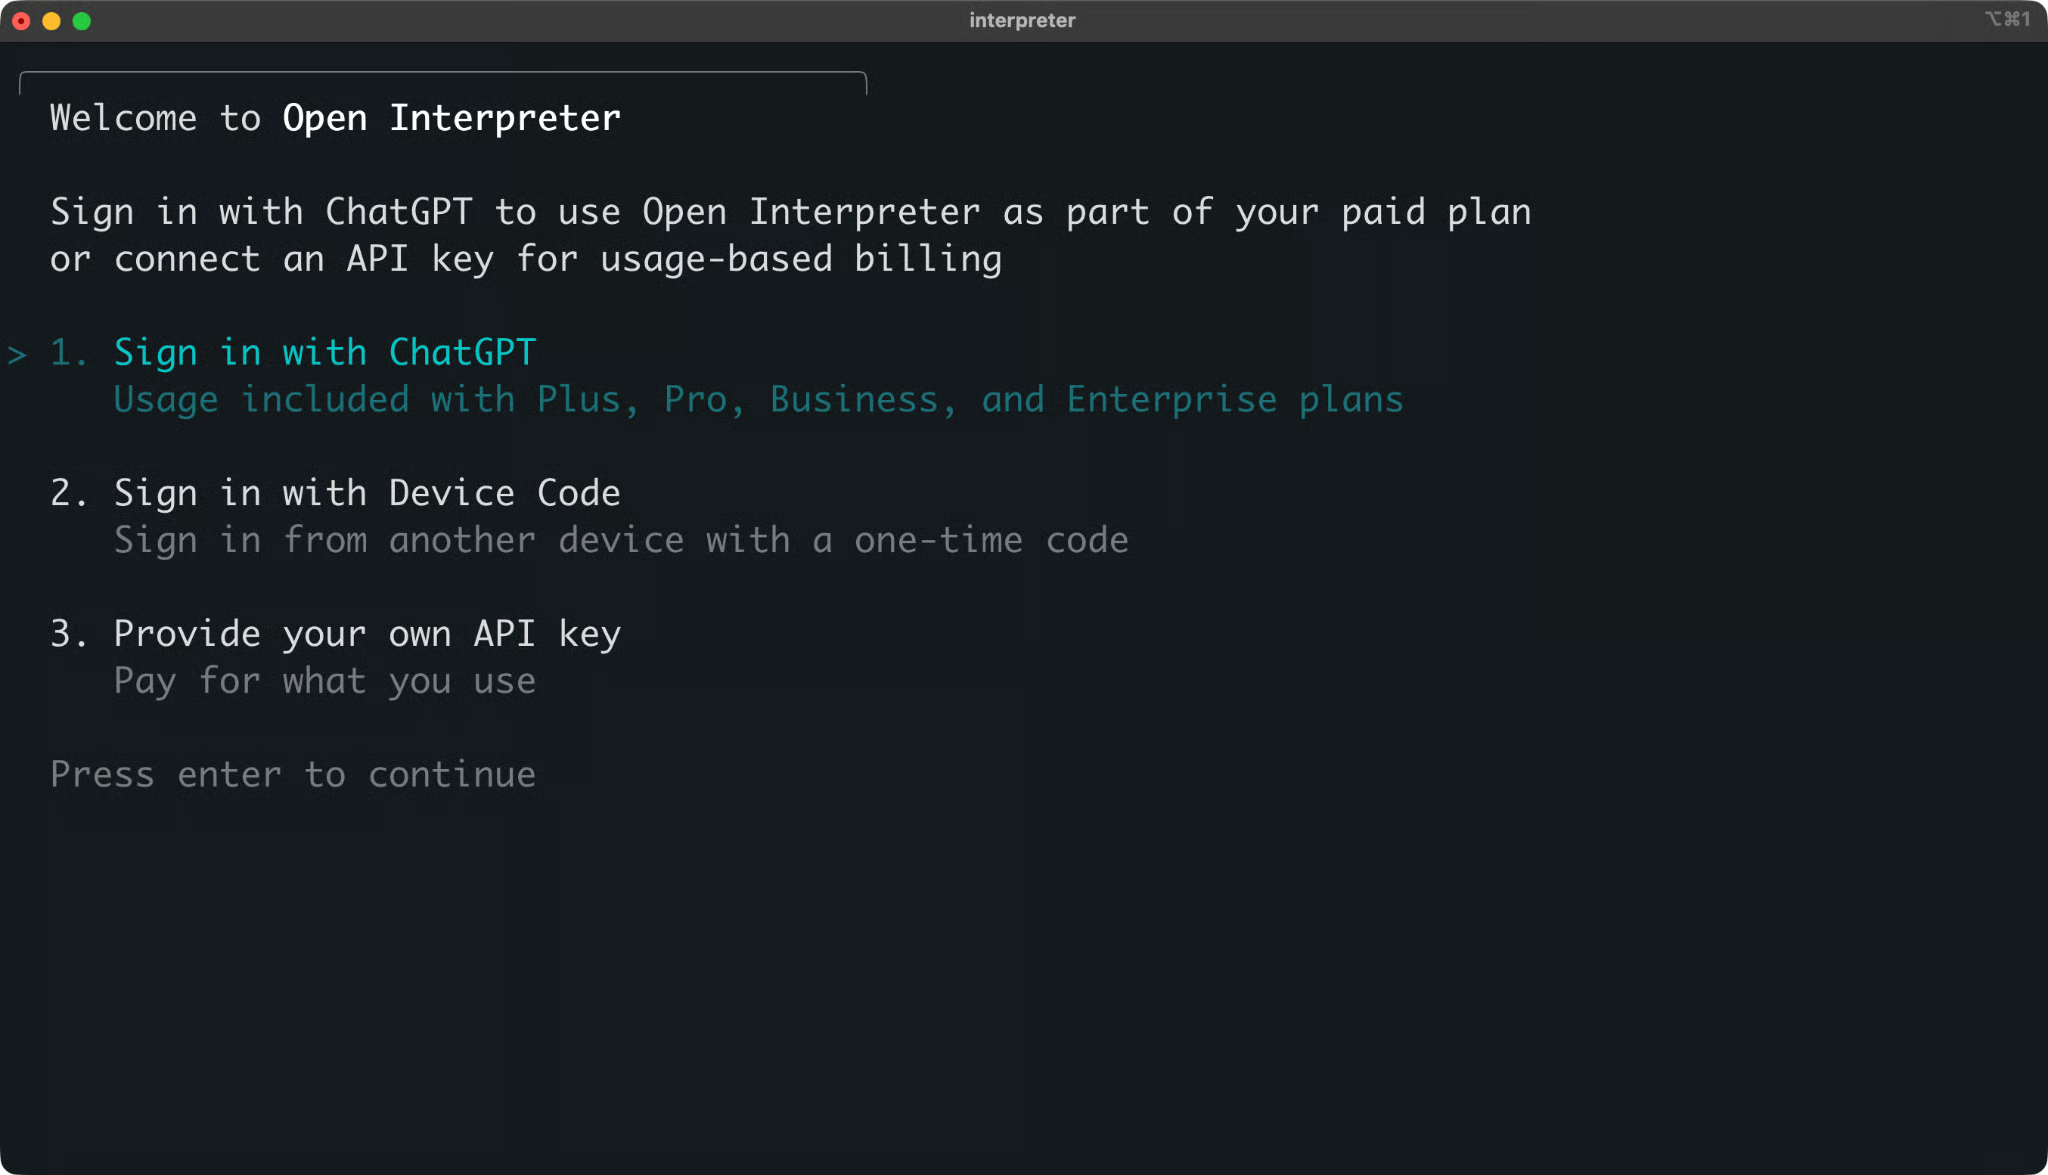
Sessione interattiva di Open Interpreter
Per uscire dalla sessione, digita /exit.
Il modo più rapido per capire un agente di coding è dargli un task e vedere cosa ne fa.
Userò un piccolo progetto di habit tracker per tutta questa sezione. Ha una funzione, un file di test e un bug.
Il progetto calcola la striscia (streak) più lunga di giorni consecutivi per un’abitudine. Per esempio, conta per quanti giorni di fila hai fatto esercizio.
Inizia con una cartella di progetto e un ambiente virtuale:
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
Crea habits.py con il seguente codice:
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
Poi crea test_habits.py:
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
La funzione ha un bug. Non lo segnalo, perché trovarlo è il compito dell’agente.
Aggiungi un file .gitignore così l’ambiente virtuale e i file di cache restano fuori dal repository:
.venv/
__pycache__/
.pytest_cache/
Ora effettua il commit del progetto:
git init
git add .
git commit -m "Initial commit"
Questo commit ti dà un punto di partenza pulito. Più tardi lo userai per vedere esattamente cosa ha cambiato l’agente.
Esegui i test per confermare il bug:
python -m pytest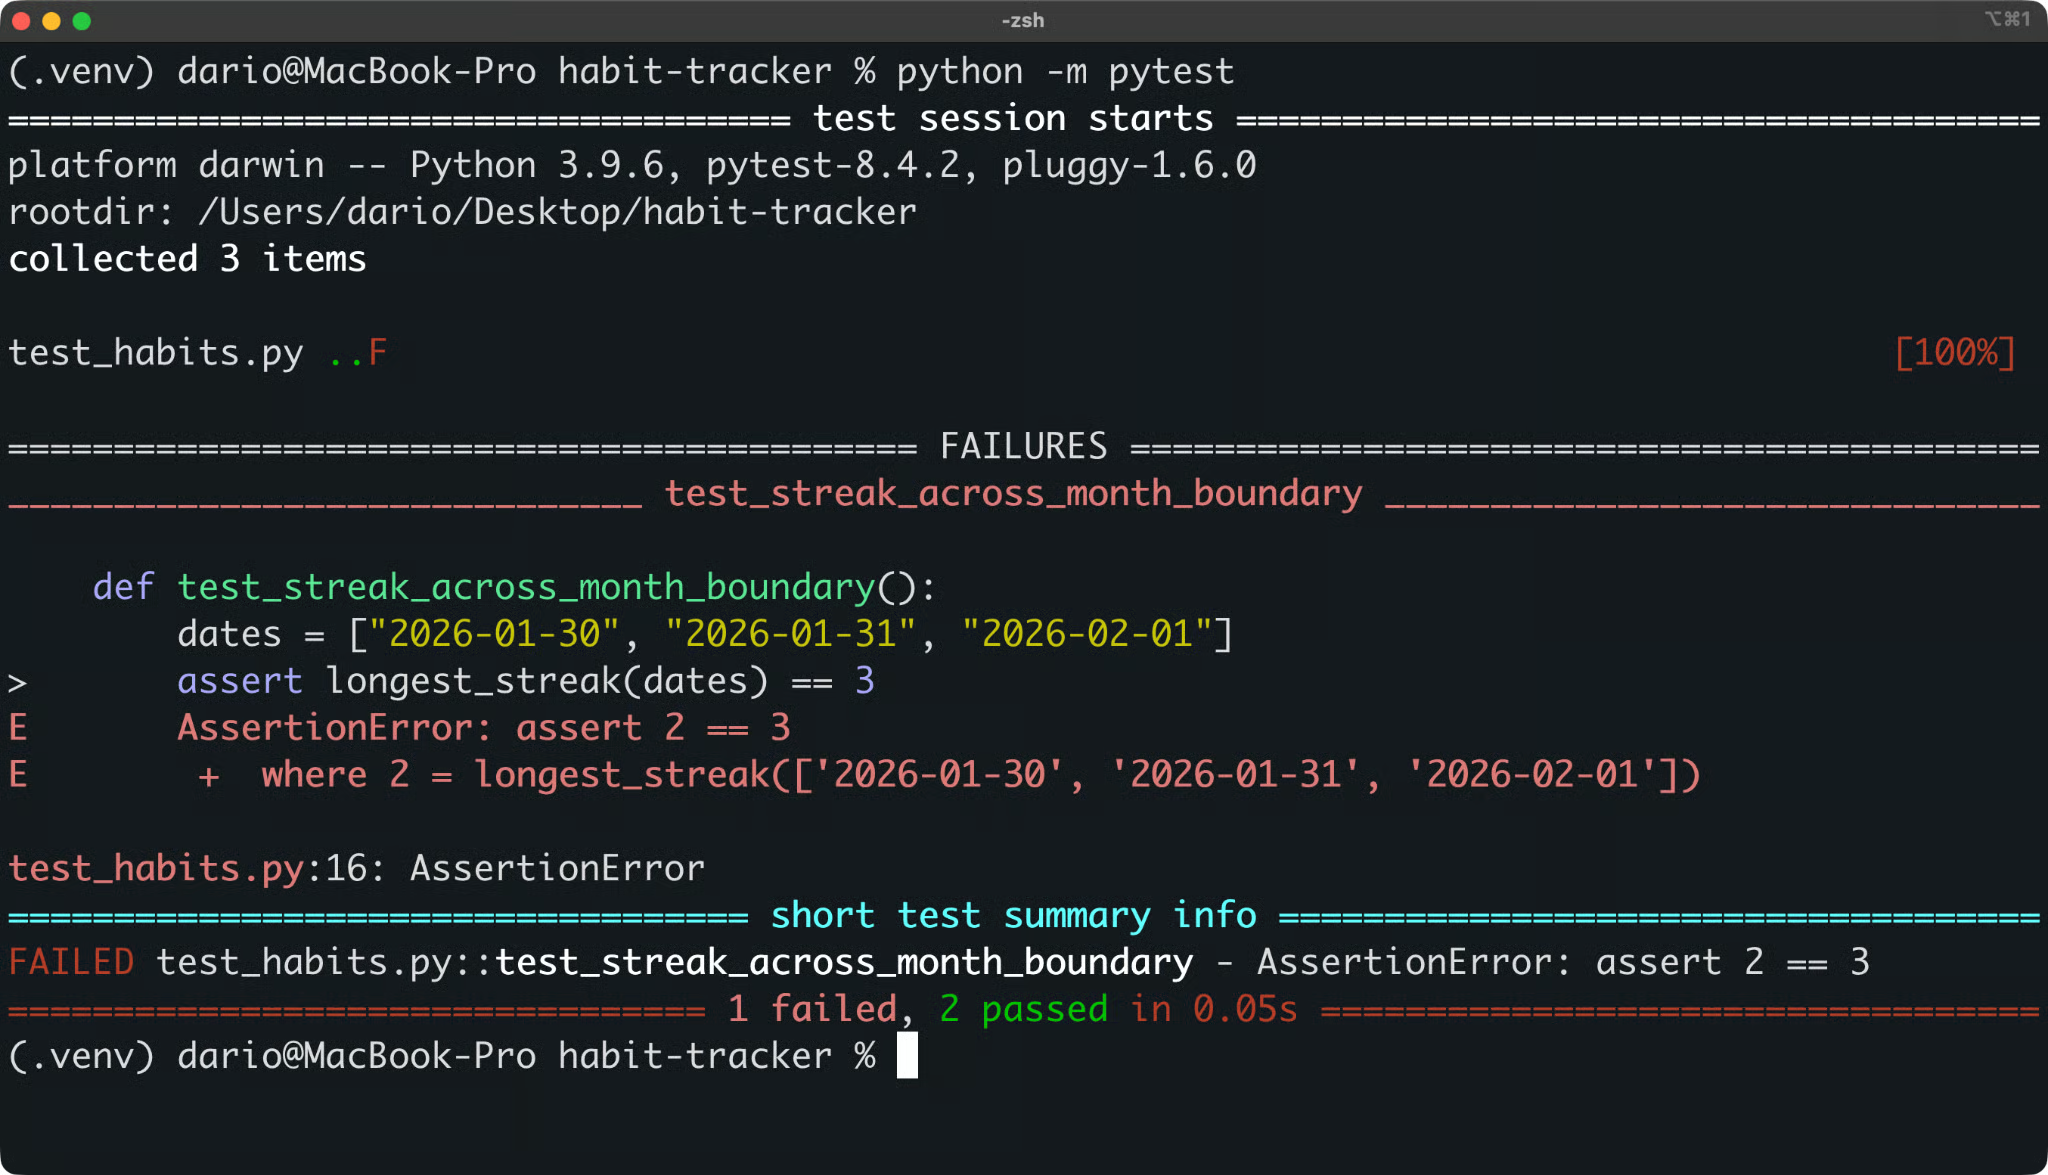
Risultato dei test dell’habits tracker
Due test passano e uno fallisce. È il problema che Open Interpreter deve risolvere.
Ti servirà Ollama installato e in esecuzione. Ti servirà anche un modello che supporta le tool call, quindi scaricalo:
ollama pull qwen3-coder:30bPoi avvia Open Interpreter dalla cartella del progetto. Usa lo stesso terminale, così l’agente può usare l’installazione di pytest del tuo ambiente virtuale:
interpreter --oss --local-provider ollama -m qwen3-coder:30bEcco cosa fa ogni flag:
--oss: usa un provider open source locale
--local-provider ollama: sceglie Ollama invece di LM Studio
-m qwen3-coder:30b: imposta il modello per questa esecuzione
Esegui /status per confermare provider attivo, modello, modalità sandbox e policy di approvazione.
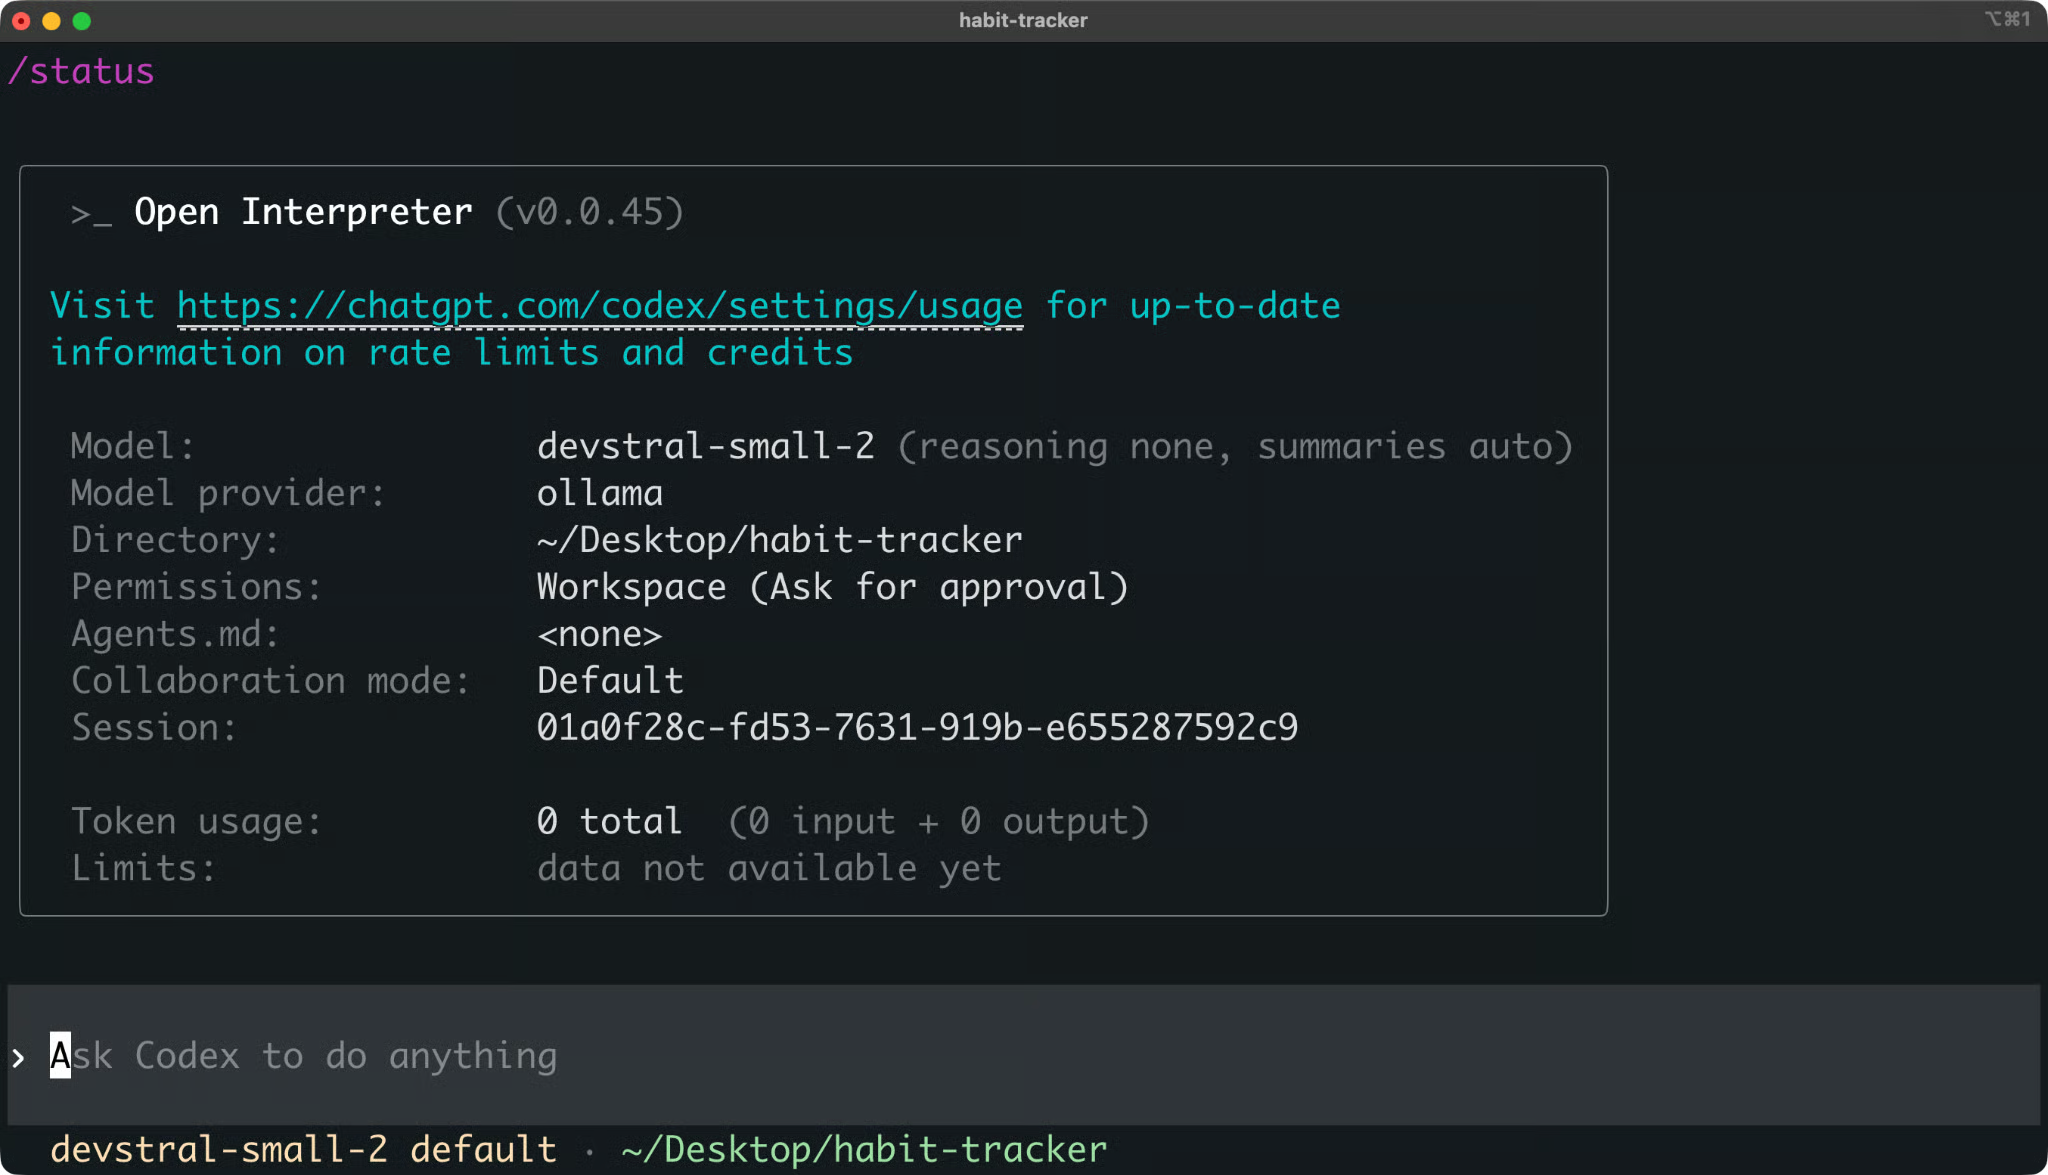
Sessione di Open Interpreter con un modello locale Ollama
Per ora non vuoi che l’agente modifichi nulla. Chiedi prima una diagnosi:
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.Di solito l’agente leggerà i file ed eseguirà i test prima di rispondere. I comandi girano dentro la sandbox, e se l’agente ha bisogno di più accesso di quanto la sandbox consenta, prima chiede la tua approvazione.
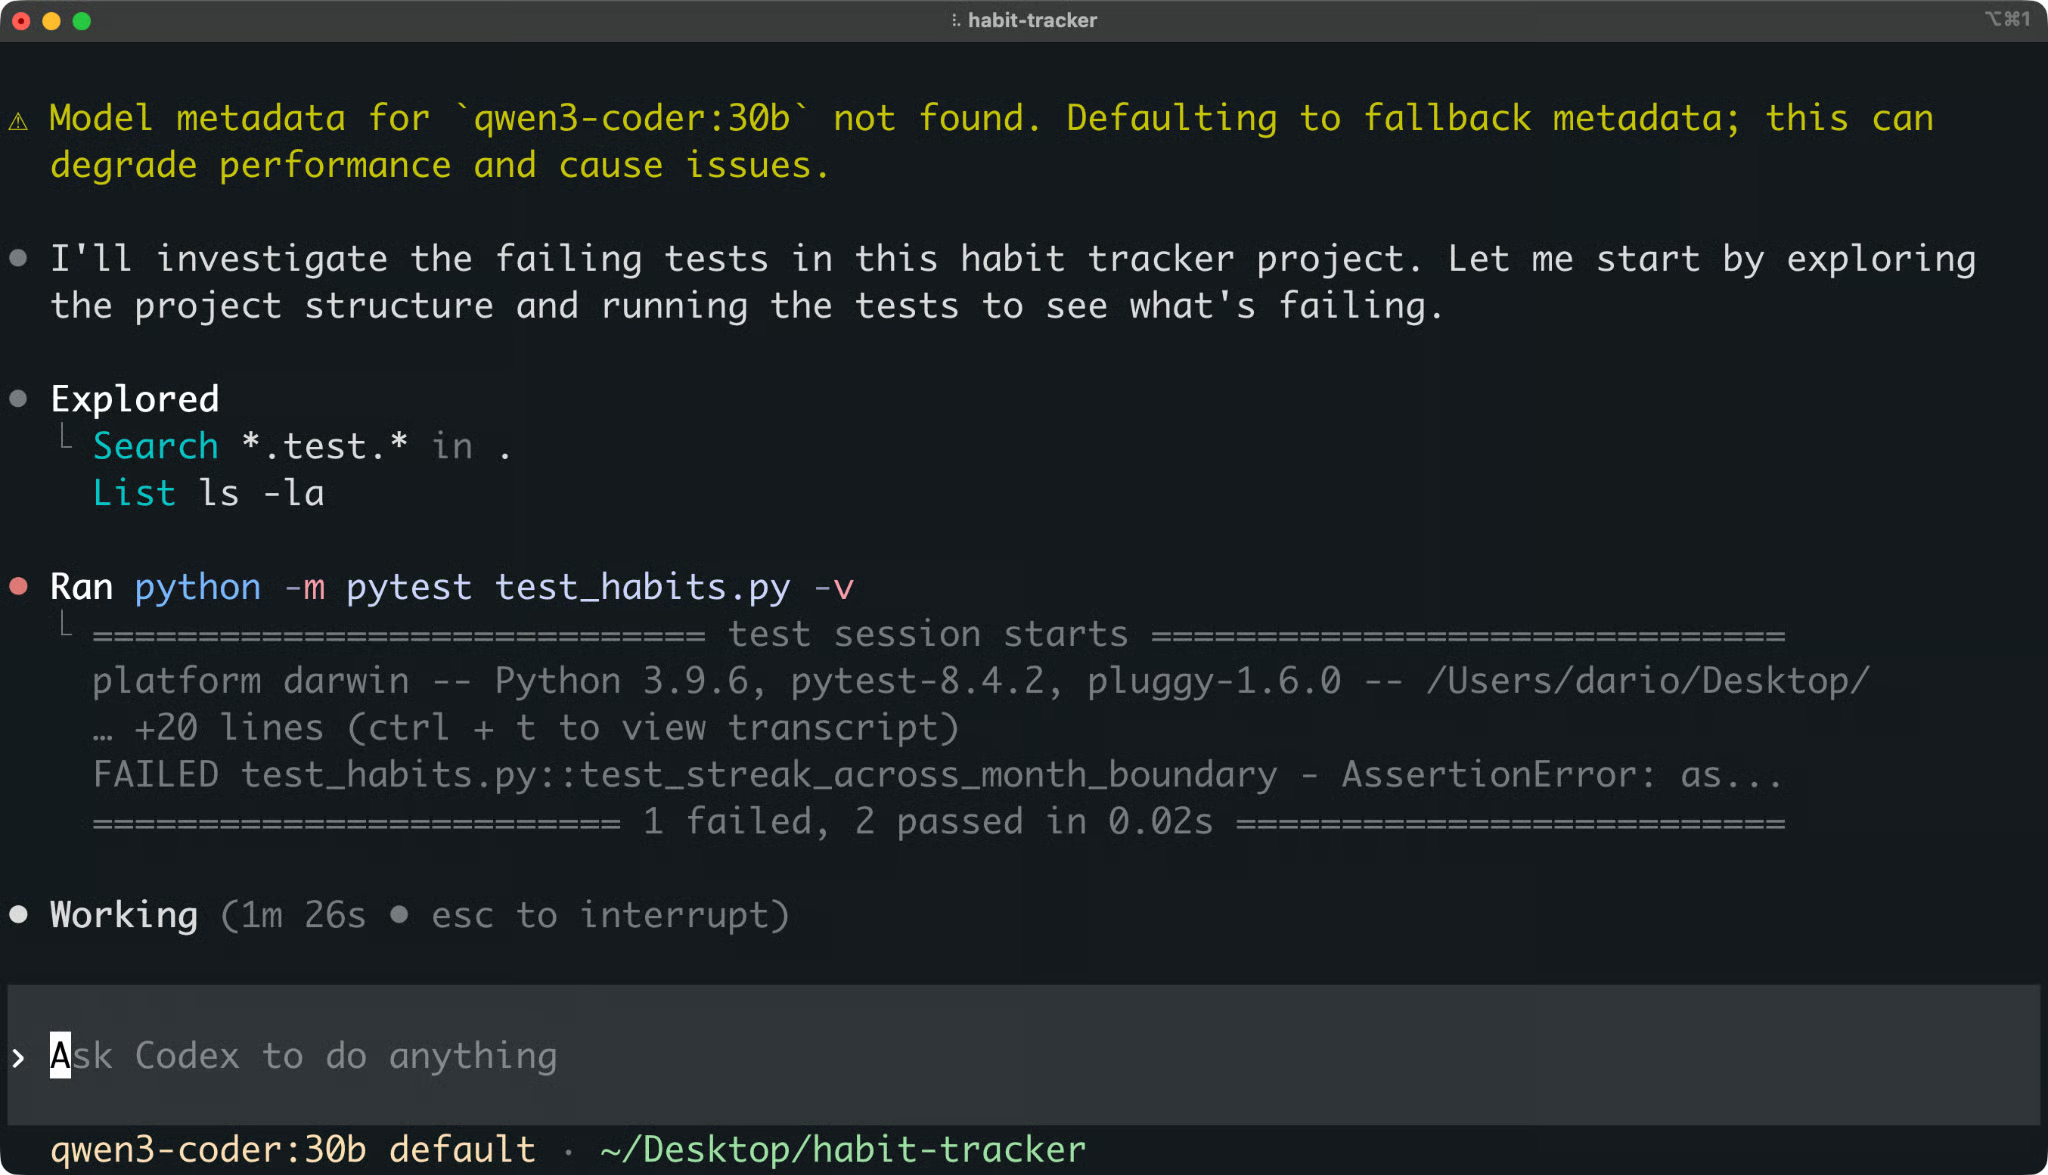
Output di Open Interpreter
Leggi la spiegazione prima di approvare qualsiasi cosa.
Una diagnosi corretta dice che la funzione confronta solo il giorno del mese, quindi una striscia si interrompe quando passa a un nuovo mese. Una buona correzione confronta le date complete, ad esempio con date.fromisoformat() dal modulo datetime di Python.
Se la diagnosi è sbagliata, correggila nella stessa sessione prima che l’agente modifichi il codice.
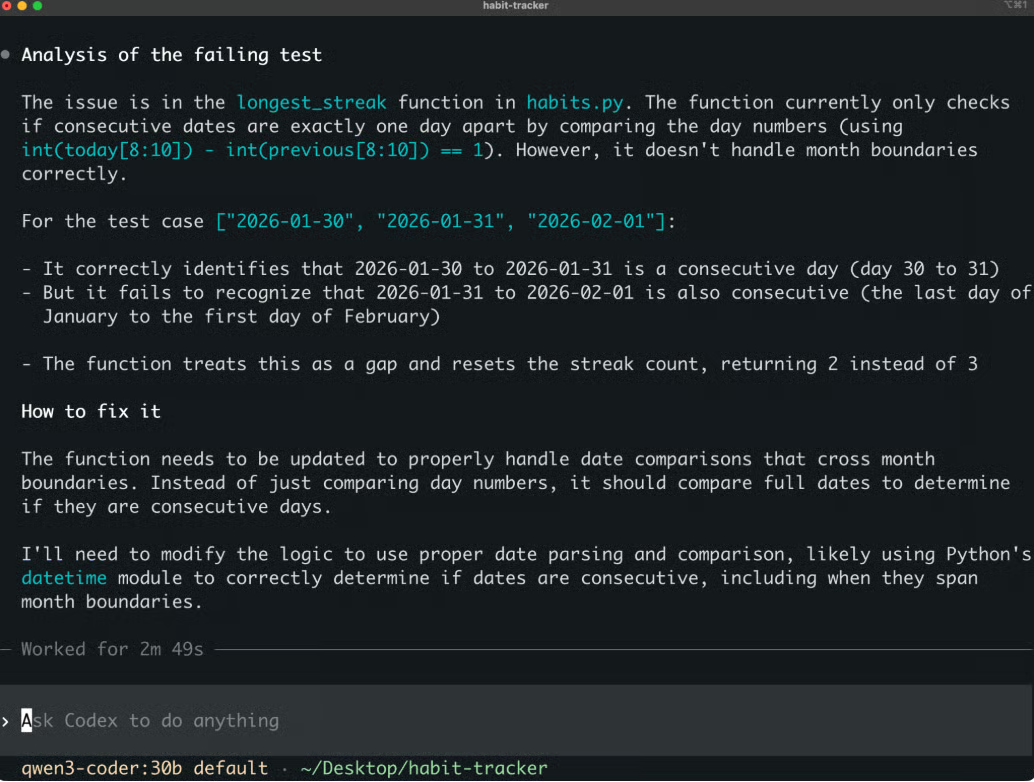
Proposta di fix di Open Interpreter
Quando sei soddisfatto del piano, implementa la correzione:
Apply the fix to habits.py, then run the tests.L’agente modifica il file e riesegue pytest. Vuoi vedere tutti e tre i test passare.
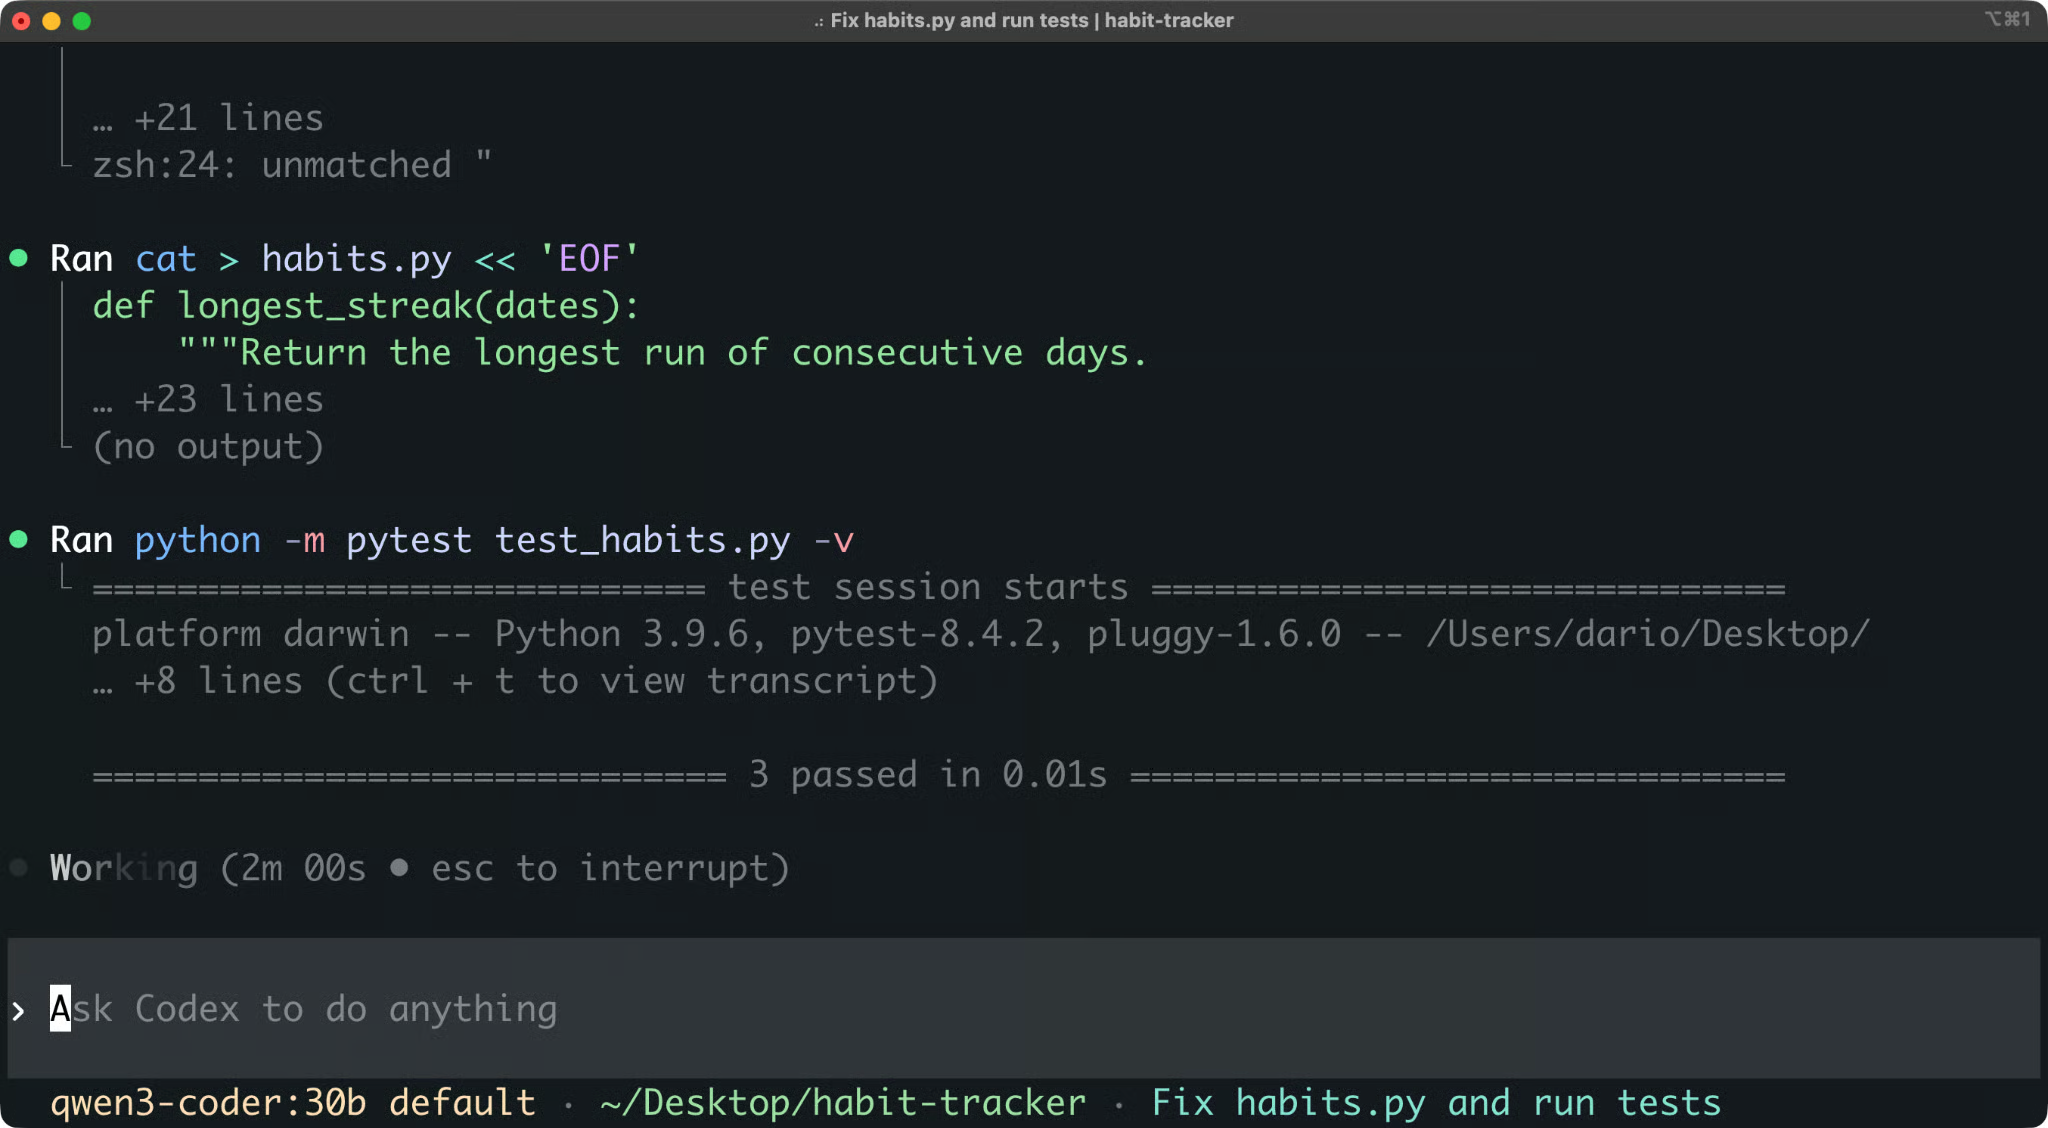
Tutti i test passano dopo la correzione
Il fatto che i test passino non significa necessariamente che il bug nel tuo codice sia risolto. Magari il test è stato aggiornato per aggirare il bug. Devi comunque rivedere il codice.
Esegui /diff dentro la sessione per vedere le modifiche nella working tree. Puoi anche eseguire git diff dopo essere uscito.
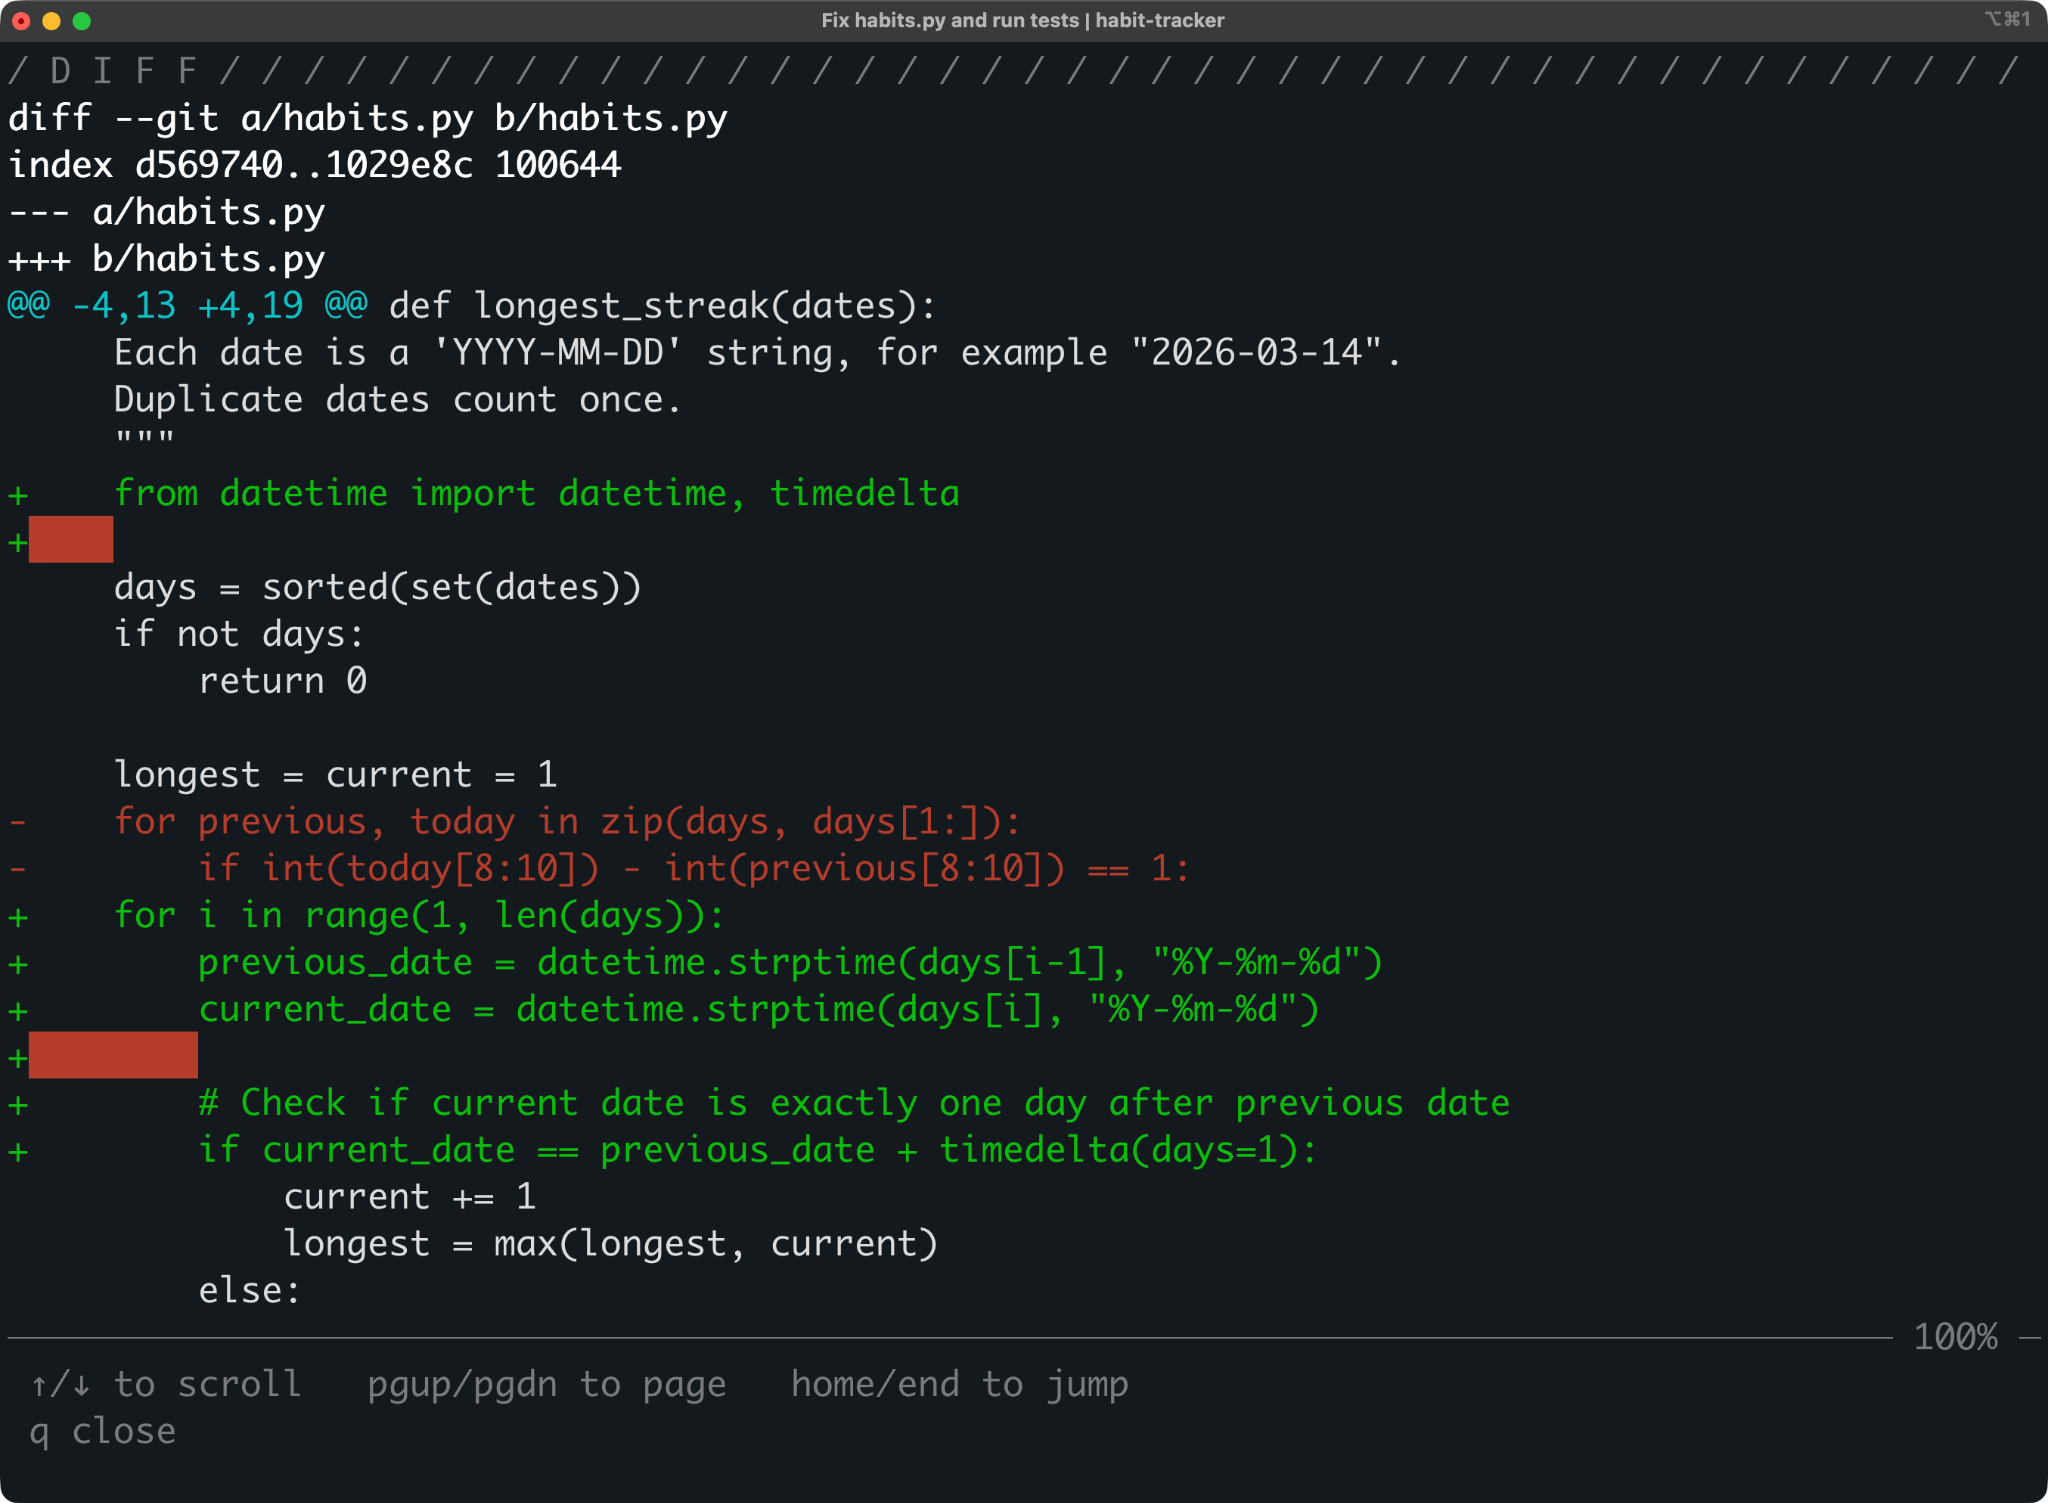
Il diff delle modifiche fatte da Open Interpreter
Il diff esatto dipende dal modello, quindi il tuo potrebbe non corrispondere riga per riga a quello sopra. Se la modifica ti piace, fai il commit; se non ti piace, ripristina il file originale:
git restore habits.pyEd è questo il concetto. Tu descrivi il problema, l’agente lo indaga e lo risolve, e tu rivedi ogni modifica prima che entri nel tuo codice.
Open Interpreter richiede che tu porti il tuo modello.
Ogni richiesta passa attraverso questi tre layer:
| Layer | Esempio | Cosa controlla |
|---|---|---|
| Provider | ollama | Dove vanno le richieste e come ti autentichi |
| Modello | devstral-small-2 | Il modello che fa il lavoro |
| Harness | native | I prompt, gli strumenti e il formato dei messaggi attorno al modello |
Layer della richiesta
Ecco cosa puoi collegare:
La lista dei provider è generata da un catalogo pubblico di modelli e mantiene solo quelli che supportano le tool call. Se manca un modello che ti aspetti, di solito è per questo motivo.
Attenzione a ollama-cloud. È un provider hosted separato, quindi le tue richieste escono dalla macchina. Solo il provider integrato ollama esegue i modelli in locale.
Puoi cambiare modello su tre livelli:
Dentro una sessione: esegui /model per scegliere provider, modello e livello di reasoning
Per una singola esecuzione: passa il flag -m, come nella sezione precedente
Come predefinito: impostalo nel file di configurazione
Puoi eseguire /status in qualsiasi momento per vedere quale provider e modello sono attivi.
Open Interpreter legge le sue impostazioni da ~/.openinterpreter/config.toml. Per rendere predefinito l’assetto con Ollama della sezione precedente, aggiungi queste due righe:
model_provider = "ollama"
model = "qwen3-coder:30b"
Dopo di ciò, interpreter parte con questo modello e non ti servono flag.
I provider hosted leggono le API key dalle variabili d’ambiente. Per esempio, DeepSeek si aspetta DEEPSEEK_API_KEY:
export DEEPSEEK_API_KEY="your-api-key"Puoi anche aggiungere qualsiasi endpoint compatibile con OpenAI come provider personalizzato:
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
L’impostazione wire_api dice a Open Interpreter quale formato di richiesta si aspetta l’endpoint. Usa chat per le Chat Completions compatibili con OpenAI, responses per le OpenAI Responses API e messages per endpoint in stile Anthropic.
Un progetto fidato può avere anche un proprio .openinterpreter/config.toml, che ha la precedenza sulla configurazione utente. I flag da riga di comando hanno la precedenza su entrambi. Se non sei sicuro di quale valore abbia effetto, esegui /debug-config per vedere le impostazioni effettive e la loro origine.
Il modello determina quanto bene l’agente comprende il tuo codice. L’harness determina come il modello vede il task e gli strumenti.
Servono entrambi. Un buon modello dentro un harness non adatto invia chiamate agli strumenti malformate e interpreta male i risultati. E un buon harness non può compensare un modello che non capisce il codice.
Per questo Open Interpreter sceglie un harness quando scegli un modello. Per esempio:
I modelli Claude ottengono l’harness claude-code
I modelli Kimi ottengono kimi-code
I modelli Qwen ottengono qwen-code
I modelli DeepSeek ottengono claude-code-bare
Per altre famiglie di modelli, puoi scegliere tu l’harness con /harness.
Ricorda che un risultato debole non significa sempre un modello debole. Prima di cambiare modello, prova lo stesso modello con un harness diverso, come vedrai in dettaglio nella prossima sezione.
L’emulazione dell’harness è il motivo principale per cui esiste la versione attuale di Open Interpreter.
Un harness di agente è tutto ciò che sta attorno al modello e lo trasforma in un agente. Include:
In parole semplici, l’harness decide come il modello vede il task e come le sue decisioni diventano azioni.
Open Interpreter ha una serie di modalità di harness integrate. Queste sono quelle che userai più spesso:
native: l’harness proprio di Open Interpreter, ereditato da Codex
claude-code: emula i prompt e la superficie degli strumenti di Claude Code di Anthropic
kimi-code: una reimplementazione in Rust dell’harness Kimi Code che Moonshot raccomanda per i suoi modelli Kimi
qwen-code: emula la CLI Qwen Code di Alibaba per i modelli Qwen
swe-agent: emula SWE-agent, un agente di ricerca pensato per risolvere issue su GitHub
L’elenco completo include anche varianti come claude-code-bare, kimi-cli, deepseek-tui, zcode e minimal. Esegui /harness in una sessione per vedere cosa supporta la tua versione.
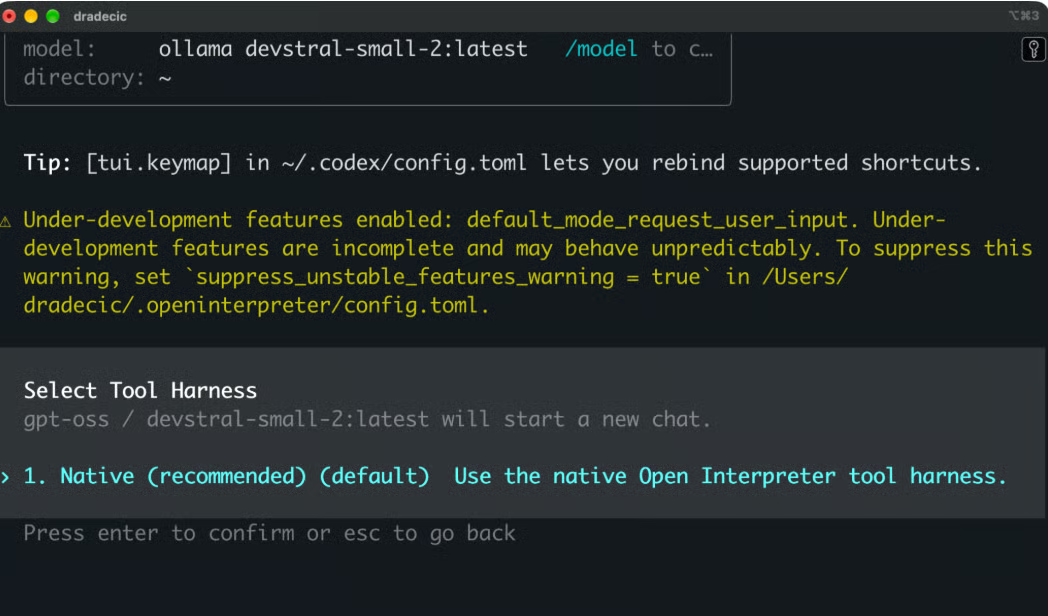
Puoi cambiare harness a sessione in corso con /harness, oppure impostarne uno predefinito in ~/.openinterpreter/config.toml:
harness = "kimi-code"
harness_guidance = true
L’impostazione harness_guidance aggiunge una guidance di affidabilità dove l’harness lo consente. Impostala a false se vuoi un’emulazione più rigorosa. Se lasci harness non impostato, Open Interpreter ne sceglie uno in base alla famiglia del modello, come visto nella sezione precedente.
La maggior parte dei vendor ottimizza i propri modelli di coding dentro un setup di agente specifico e pubblica un harness raccomandato da usare insieme.
Il modello si abitua a quell’harness. Impara lo stile dei prompt, i nomi degli strumenti, il formato delle modifiche ai file e il modo in cui tornano i risultati degli strumenti.
Metti che esegui un modello ottimizzato per modifiche di tipo search-and-replace dentro un harness che si aspetta patch complete. Il modello sa quale modifica fare, ma continua a descriverla nel formato sbagliato. Il loop dell’agente consuma token senza fare progressi.
I risultati degli strumenti seguono la stessa logica. Se l’harness restituisce risultati in un formato che il modello non ha visto, il modello li interpreta male. Se l’harness elimina il ragionamento del modello tra i turni, un modello che “pensa” perde il filo del proprio piano.
Questo significa che lo stesso modello può sembrare buono in un agente e scarso in un altro, senza cambiare i suoi pesi. È anche il motivo per cui i benchmark di coding di solito indicano l’harness usato in ogni esecuzione.
I modelli di frontiera tendono a recuperare con un harness non familiare, ma quelli più piccoli e più economici di solito no. Open Interpreter non forza ogni modello in un unico formato, ma cambia il formato per adattarsi al modello.
Puoi testarlo tu stesso con il progetto demo. Ripristina il file originale con git restore habits.py, cambia harness con /harness e dai all’agente lo stesso prompt. Poi confronta quanti step servono e come formatta le modifiche.
Hai già visto la maggior parte di queste funzionalità nell’articolo. Ecco cosa ti danno nello sviluppo quotidiano.
Open Interpreter lavora dentro il tuo repository Git. Legge la struttura del progetto e tiene traccia di ciò che ha cambiato.
Due comandi slash aiutano qui. /diff mostra le modifiche nella working tree e /review chiede all’agente di controllare le modifiche correnti per bug e regressioni prima del commit. Puoi eseguire la stessa review senza aprire una sessione:
interpreter exec review --uncommittedAnche le sessioni vengono salvate. Se ti fermi a metà di un task, interpreter resume --last lo riprende da dove l’avevi lasciato.
L’agente esegue gli stessi comandi che useresti tu, ad esempio suite di test, linter, script di build e gestori di pacchetti. Tutti girano dentro sandboxing nativo su macOS, Linux e Windows.
I comandi di lunga durata possono girare in background. Usa /ps per elencarli e /stop per terminarli.
Per script e pipeline CI, interpreter exec esegue un task senza l’interfaccia interattiva:
interpreter exec "fix the failing test"Puoi cambiare provider e modelli in qualsiasi momento con /model. La tua configurazione, AGENTS.md e le skill restano valide dopo il cambio.
Qui sono utili i profili. Diciamo che vuoi un modello economico per il lavoro di routine e uno più forte per le code review. Puoi definirli entrambi nella config:
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
Poi avvia con interpreter --profile review quando ti serve.
/harness cambia come il modello vede il task senza cambiare il modello. È la prima cosa da provare quando un modello fatica con le tool call, prima di passare a un modello più grande.
Il Model Context Protocol (MCP) collega l’agente a strumenti per cui non era stato progettato, come server di documentazione o database. Aggiungi i server nella config:
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
Esegui /mcp per vedere i server configurati e i loro strumenti. L’impostazione default_tools_approval_mode fa sì che l’agente chieda prima di usare uno strumento di quel server.
Funziona anche al contrario. interpreter mcp-server espone Open Interpreter come server MCP e interpreter acp lo esegue dentro editor che supportano l’Agent Client Protocol, uno standard aperto per collegare editor ad agenti di coding.
AGENTS.md è un file Markdown nel tuo repository con regole di progetto che l’agente legge su ogni task. Per l’habits tracker, potrebbe essere così:
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
Puoi anche eseguire /init e l’agente scrive una prima versione per te.
Le skill sono workflow riutilizzabili, confezionati come cartelle in .agents/skills dentro il tuo progetto o in ~/.agents/skills per l’utente. L’agente rileva automaticamente una skill quando un task la corrisponde. Esegui /skills per vedere quali sono disponibili.
Entrambi sono formati condivisi, quindi gli stessi file funzionano con altri agenti di coding che li supportano. Open Interpreter supporta anche gli hook, che eseguono i tuoi comandi in punti prestabiliti di una sessione. Li rivedi e li autorizzi con /hooks.
Due impostazioni controllano cosa può fare l’agente:
Modalità sandbox: read-only, workspace-write o danger-full-access
Policy di approvazione: untrusted, on-request o never
La sandbox decide cosa è possibile e la policy di approvazione decide quando l’agente chiede prima. Con workspace-write e on-request, l’agente può modificare il progetto ed eseguire i test, ma chiede prima di andare oltre.
Puoi cambiare entrambe con /permissions o con i flag -s e -a. C’è anche il flag --yolo che bypassa entrambe, e la documentazione lo etichetta come pericoloso. Tratterò queste impostazioni più in dettaglio nella sezione sicurezza.
Open Interpreter si descrive come un agente di coding pensato per modelli a basso costo.
I più grandi agenti di coding proprietari sono costruiti attorno ai modelli del proprio vendor. Open Interpreter ti offre un agente che funziona con modelli proprietari, modelli open-weight hosted e modelli locali.
I modelli open-weight come Kimi, DeepSeek, GLM e Qwen hanno pesi pubblici. Puoi usarli tramite un provider terzo o sul tuo hardware.
Questo offre due vantaggi. I modelli open-weight hosted di solito costano meno per token rispetto ai modelli proprietari di frontiera. E non sei limitato a un host, perché lo stesso modello gira ovunque girino i suoi pesi.
Open Interpreter ha guide dedicate ai provider per Kimi K3, DeepSeek e GLM. Sceglie anche l’harness corrispondente per queste famiglie di modelli.
Ollama e LM Studio sono provider integrati, quindi puoi eseguire un modello sulla tua macchina senza API key o costi per token.
Il costo è l’hardware. Quando ho testato devstral-small-2 sul mio MacBook Pro M1 Max con 64 GB di memoria unificata, il solo modello ne occupava 26 GB. La finestra di contesto predefinita di Ollama era troppo piccola per il loop dell’agente e, a 128k token, l’uso di memoria continuava a salire e scendere finché la sessione si è bloccata.
Gli agenti di coding hanno bisogno di una finestra di contesto ampia, perché il system prompt, le definizioni degli strumenti, i contenuti dei file e l’output dei comandi devono starci tutti. Ollama raccomanda almeno 64k token per agenti in stile Codex. E una finestra di contesto più grande usa più memoria oltre al modello stesso.
Open Interpreter gira sulla tua macchina, ma il modello non deve per forza farlo.
Dove va il tuo codice dipende dal provider:
La tua configurazione, le sessioni e i log sono archiviati localmente in ~/.openinterpreter in ogni caso.
Se ti serve più controllo, puoi aggiungere un provider personalizzato che punti a un tuo server di inferenza. Funziona qualsiasi server con API compatibile OpenAI, ad esempio un deployment vLLM sulle GPU della tua azienda. Così ottieni un setup hosted dove l’infrastruttura è tua.
I modelli open non sono tutti uguali nelle tool call. Vedrai un uso debole degli strumenti manifestarsi come chiamate malformate, loop, interruzioni premature o output dei comandi ignorato.
L’harness giusto aiuta, ma non può sistemare un modello che non sa pianificare un task multi-step. I modelli locali più piccoli hanno qui i problemi maggiori.
Prima di puntare un modello nuovo su un progetto reale, testalo su un piccolo repository come l’habits tracker mostrato in questo articolo. Se mostra debolezze, prova un harness diverso prima di passare a un modello più grande.
Ecco un rapido riepilogo delle opzioni:
| Dove gira l’inferenza | Costo | Il codice lascia la tua macchina? | |
|---|---|---|---|
| Modello proprietario hosted | Server del vendor | Per token o abbonamento | Sì |
| Modello open-weight hosted | Server del provider | Per token, di solito inferiore | Sì |
| Modello open-weight locale | Il tuo hardware | Hardware ed elettricità | No |
Opzioni di Open Interpreter per modelli locali e open
Open Interpreter condivide molto con altri agenti di coding da terminale. Le differenze stanno in chi possiede lo strumento e per quali modelli è costruito.
Claude Code è l’agente di coding da terminale di Anthropic. La prima differenza è la proprietà: Claude Code è proprietario, mentre Open Interpreter è open source con licenza Apache 2.0. Puoi leggere e modificare ogni parte di Open Interpreter.
La seconda differenza è la scelta del modello. Claude Code è costruito per i modelli Claude. Puoi puntarlo a endpoint compatibili con Anthropic di altri provider, ma il suo harness resta ottimizzato per Claude. Open Interpreter tratta la scelta del modello come una funzionalità centrale.
Il confronto sull’harness è la parte interessante. Claude Code è esso stesso uno degli harness che Open Interpreter emula. Con la modalità claude-code, qualsiasi modello ottiene prompt e strumenti in stile Claude Code dentro il runtime di Open Interpreter. L’interfaccia e i comandi slash restano quelli di Open Interpreter, quindi non è lo stesso prodotto con un modello diverso.
Entrambi gli strumenti sono terminal-first. Ciascuno ha una sessione interattiva e una modalità non interattiva per script e CI. Per le istruzioni di progetto, Claude Code legge CLAUDE.md, mentre Open Interpreter usa il formato condiviso AGENTS.md.
Claude Code ha un ecosistema più ampio. Arriva con estensioni per IDE, app desktop e web, un marketplace di plugin, subagenti e un SDK. Open Interpreter è più giovane e si affida a standard condivisi come MCP, skill, AGENTS.md e l’Agent Client Protocol invece del proprio ecosistema.
Se lavori con i modelli Claude e vuoi l’esperienza più curata, Claude Code è la scelta più sicura. Se vuoi usare altri modelli o evitare uno strumento proprietario, scegli Open Interpreter.
OpenCode è il confronto più vicino. Entrambi sono open source, terminal-first e costruiti per lavorare con una lunga lista di provider di modelli.
Il supporto dei modelli è simile sulla carta. OpenCode supporta più di 75 provider e Open Interpreter genera la sua lista di provider da un catalogo pubblico di modelli. Entrambi eseguono modelli locali tramite Ollama.
L’esperienza da terminale differisce di più. OpenCode ha una propria TUI con integrazione LSP (Language Server Protocol), che riporta al modello diagnostiche del codice come errori di tipo. La TUI di Open Interpreter deriva da Codex.
Quanto alla configurazione, OpenCode usa un file opencode.json e Open Interpreter usa config.toml con profili.
L’architettura dell’agente è la differenza principale. OpenCode gira come client e server, dove la TUI è un client di un server locale a cui possono collegarsi anche altri client. Ha agenti build e plan integrati e supporta agenti personalizzati e subagenti. Adatta il system prompt per ogni famiglia di modelli, ma gli strumenti e il loop restano quelli propri di OpenCode. Open Interpreter va oltre e sostituisce l’intero harness, inclusi gli schemi degli strumenti e il formato dei messaggi. Build più recenti includono persino una modalità di harness opencode.
Dal lato sviluppo, OpenCode è un proprio codebase, costruito dal suo team e dalla community. Open Interpreter si basa su un fork di Codex, quindi una grande parte del runtime arriva upstream. È un trade-off. Open Interpreter ottiene sandbox e runtime di Codex gratuitamente, mentre OpenCode controlla l’intero stack.
Questi due non sono concorrenti nel senso usuale. Open Interpreter è un fork di Codex.
Condividono il runtime in Rust, la TUI, sandboxing, approvazioni, AGENTS.md, skill, MCP, modalità exec e la maggior parte dei comandi slash. Quando ho eseguito Open Interpreter, il suggerimento per riprendere la sessione diceva ancora codex resume.
Codex è l’agente di OpenAI, costruito attorno ai modelli di OpenAI. Supporta modelli locali con --oss e provider personalizzati, ma l’esperienza predefinita è orientata a OpenAI.
Open Interpreter estende Codex in un paio di direzioni:
Emulazione dell’harness: cambia prompt, schemi degli strumenti e formato dei messaggi per adattarsi a ogni famiglia di modelli
Supporto dei provider: ha un catalogo di provider generato e guide dedicate per Kimi K3, DeepSeek e GLM
Chat Completions: il flag --chat-completions esegue qualsiasi provider compatibile con OpenAI
Override del Codex SDK: le app costruite sul Codex SDK possono girare invece tramite Open Interpreter
Open Interpreter salva anche configurazione e sessioni in ~/.openinterpreter, quindi non va in conflitto con un’installazione di Codex.
Se usi soprattutto modelli OpenAI, Codex è una scelta migliore. Se usi altri modelli, Open Interpreter ti dà lo stesso workflow con un supporto migliore per essi.
Ecco un rapido riepilogo:
| Licenza | Modelli | Approccio all’harness | Config | |
|---|---|---|---|---|
| Open Interpreter | Open source (Apache 2.0) | Qualsiasi provider, hosted o locale | Emula l’harness per modello | config.toml |
| Claude Code | Proprietaria | Costruito per i modelli Claude | Harness proprio di Claude Code | settings.json e CLAUDE.md |
| OpenCode | Open source (MIT) | 75+ provider, hosted o locali | Un solo harness con prompt specifici per modello | opencode.json |
| Codex | Open source (Apache 2.0) | Costruito per i modelli OpenAI con --oss | Harness proprio di Codex | config.toml |
Open Interpreter a confronto con altri agenti di coding AI
Il peggio che può fare un chatbot è darti una risposta sbagliata, che puoi ignorare. Un agente di coding esegue comandi sulla tua macchina, legge e scrive file e può raggiungere la rete. Una decisione sbagliata del modello, o una prompt injection, può causare danni reali. Prompt injection significa istruzioni nascoste nel contenuto che l’agente legge, come un README o una pagina web.
Open Interpreter eredita il suo modello di sicurezza dal runtime di Codex. Ha due layer: una sandbox che limita ciò che è possibile e una policy di approvazione che decide quando l’agente ti chiede prima.
Ogni comando eseguito dall’agente passa attraverso una sandbox a livello OS su macOS, Linux e Windows. Ci sono tre modalità di sandbox:
read-only: l’agente può leggere i file, ma non può cambiare nulla
workspace-write: l’agente può modificare file ed eseguire comandi dentro la cartella del progetto
danger-full-access: nessuna sandbox
Con workspace-write, le scritture di file sono limitate al workspace attivo. L’agente può sistemare il tuo codice, ma non può modificare file altrove sulla macchina.
In modalità workspace-write, i comandi non hanno accesso di rete per impostazione predefinita. Questo blocca i download e impedisce all’agente di inviare il tuo codice altrove.
Alcuni task richiedono la rete, ad esempio installare un pacchetto. Puoi attivare l’accesso di rete nella config:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
Attivalo solo per i progetti in cui serve.
La policy di approvazione decide quando l’agente si ferma e chiede:
untrusted: chiede prima di eseguire comandi che non sono nella lista dei fidati
on-request: chiede quando un task richiede più accesso di quanto consenta la sandbox
never: non chiede mai
Per progetti sotto controllo di versione, workspace-write con on-request è un buon predefinito. L’agente lavora dentro il progetto e chiede prima di andare oltre. Git ti offre un modo per tornare indietro se qualcosa va storto.
Il flag --yolo disattiva sia sandbox che approvazioni. Usalo solo in ambienti usa e getta, come un container o una VM.
I comandi eseguiti dall’agente ereditano il tuo ambiente della shell. Se le tue API key sono nelle variabili d’ambiente, quei comandi possono vederle.
Puoi limitarlo con shell_environment_policy:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
L’impostazione core passa solo variabili basilari come HOME e PATH, e exclude rimuove qualsiasi elemento corrisponda ai pattern.
I file sono un altro rischio. L’agente può leggere un file .env nel tuo progetto anche in modalità read-only. Con un provider hosted, qualsiasi cosa l’agente legga va ai server di quel provider.
Ricorda che la sandbox limita i danni, ma trattala comunque come una rete di sicurezza, non come una garanzia.
Prima di lasciare che l’agente giri da solo, esegui /status e controlla modalità sandbox e policy di approvazione.
Se trovi un articolo su Open Interpreter che inizia con pip install, non è sbagliato. Sta descrivendo un progetto diverso.
L’Open Interpreter originale è stato lanciato nel 2023 come progetto Python. Permetteva ai modelli linguistici di eseguire codice Python, JavaScript e shell sulla tua macchina, ed era conosciuto come alternativa open-source al Code Interpreter di ChatGPT. Le versioni successive hanno aggiunto il controllo del computer, così il modello poteva interagire anche con il desktop.
Il progetto principale attuale è una riscrittura in Rust basata su Codex. Si concentra su agenti di coding ed emulazione dell’harness, non sul controllo generale del computer.
La versione Python non è scomparsa. Continua come fork della community su endolith/open-interpreter.
Entrambe le versioni usano lo stesso nome, la stessa cronologia del repository GitHub e lo stesso comando interpreter, quindi è facile fare confusione.
Ma un indizio davvero evidente è:
pip install open-interpreter: la versione legacy in Python
installer curl o PowerShell: la versione attuale in Rust
Open Interpreter non è lo strumento giusto per ogni setup. Ecco dove ha senso e dove no.
Open source: è concesso in licenza Apache 2.0, quindi puoi leggere, auditare e fare fork dell’intero codebase
Scelta del modello: puoi usare modelli hosted, open-weight e locali con un solo agente e passare da uno all’altro durante la sessione
Più harness di agente: ti avvicini alle prestazioni per cui un modello è stato tarato, cosa che pochi altri agenti di coding offrono
Sviluppo nativo da terminale: si integra con la tua shell e workflow Git esistenti e la modalità exec funziona in script e CI
Modelli open e a basso costo: il progetto è costruito attorno a essi, con guide dedicate ai provider e harness corrispondenti
Estendibilità: MCP, skill, hook, AGENTS.md, l’Agent Client Protocol e l’override del Codex SDK ti permettono di collegarlo ad altri strumenti
La qualità del modello varia: l’agente è valido quanto il modello su cui si basa, e nessun harness aggiusta un modello che non sa pianificare task multi-step
I modelli locali richiedono hardware serio: nei miei test, il solo devstral-small-2 ha preso 26 GB di memoria, prima della finestra di contesto ampia che serve a un agente di coding
Il setup richiede più lavoro: gestisci tu provider, finestre di contesto, harness e impostazioni della sandbox. Ci sono anche spigolosità, come brand di Codex rimasti e warning sui metadata per modelli Ollama
L’esecuzione di comandi è un rischio: sandbox e approvazioni riducono il rischio, ma non lo eliminano
Il codice va comunque rivisto: test che passano non garantiscono una correzione corretta, quindi devi leggere ogni diff
Open Interpreter è un agente di coding open-source che funziona con il modello che scegli tu, che sia hosted, open-weight o in esecuzione sulla tua macchina.
Il workflow è semplice. Scegli un modello e un harness, punti l’agente a un progetto e lo lasci ispezionare, modificare ed eseguire comandi finché il task non è concluso. Poi rivedi il suo lavoro.
L’emulazione dell’harness lo distingue dai concorrenti. Open Interpreter non forza ogni modello dentro un unico setup di agente. Cambia il setup per adattarsi al modello, e questo può fare la differenza. Il modello decide anche la qualità del lavoro e i permessi decidono cosa l’agente può modificare. La tua revisione è l’ultimo controllo prima che qualsiasi modifica raggiunga la tua codebase.
Se vuoi ottenere una certificazione da AI engineer, iscriviti al percorso Associate AI Engineer for Developers e passa al mondo dell’AI ai tuoi ritmi.
Impara con DataCamp
Programma
Programma
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min