Lärstig
Associate AI Engineer för utvecklare
26 tim
Om du någon gång har kört en open-weight-modell i en kodningsagent som är byggd för en annan modell, vet du att det inte är någon bra idé.
Modellen misstolkar ofta verktygsscheman och kör samma felande kommando om och om igen tills du stoppar den. När du sedan går tillbaka till modellen agenten var byggd för, löser sig samma uppgift utan problem. Problemet ligger oftast inte i modellen, utan i den agent-harness som omger den, eftersom dess prompts och verktygsformat har trimmats för någon annan.
Open Interpreter löser detta genom att emulera den harness varje modell har trimmats för, som Claude Code eller Kimi Code. Det är en AI-kodningsagent med öppen källkod som körs från din terminal, och den nuvarande versionen är ett Rust-projekt byggt på OpenAI:s Codex, inte den Python-baserade datorassistent du kanske minns.
I den här artikeln går jag igenom installation, uppsättning av modell och harness, ett praktiskt arbetsflöde för kodning samt hur Open Interpreter står sig mot Claude Code, OpenCode och Codex.
Är du ny på AI-agenter? Anmäl dig till vår Introduction to AI Agents-kurs och lär dig grunderna på en eftermiddag.
Open Interpreter ger en AI-modell tillgång till ditt projekt och de verktyg en utvecklare skulle använda på det.
Du behöver bara beskriva en uppgift på enkel engelska, så arbetar agenten med din kod. Den kan arbeta med:
Projektet är öppen källkod under licensen Apache 2.0. Det är inte heller begränsat till en leverantör. Du kan koppla det till hostade modeller, open-weight-modeller eller modeller som körs lokalt på din egen maskin.
Huvudrepo:t har mer än 68 000 GitHub-stjärnor i september 2026.
Open Interpreter arbetar i en loop:
Vissa av dessa steg kräver ditt godkännande först, beroende på behörighetsinställningarna. Jag tar upp dem i säkerhetsavsnittet.
Här är en mer visuell översikt:
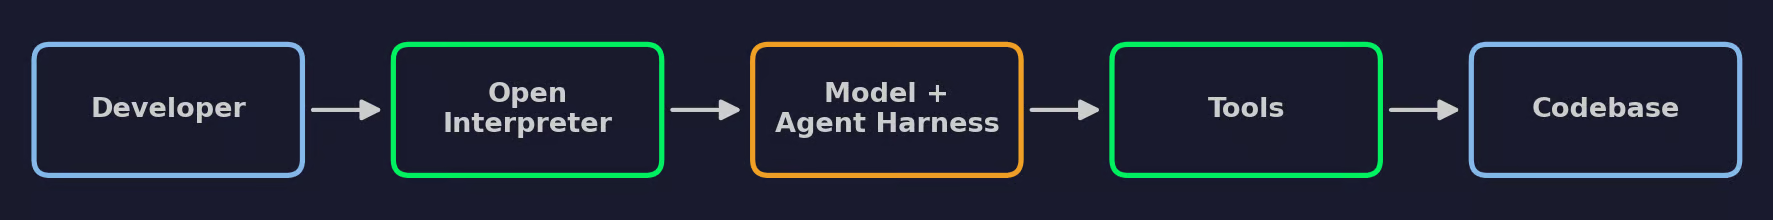
Hur Open Interpreter fungerar
Det viktiga att komma ihåg är att du inte pratar direkt med modellen. Open Interpreter skickar din uppgift till modellen, formaterad med prompts och verktygsdefinitioner från den aktiva harnessen. Modellen begär verktygsanrop, och Open Interpreter kör dem mot din kodbas. Resultaten går sedan tillbaka till modellen för nästa steg.
Eftersom modellen och harnessen är separata lager kan du byta ut endera utan att behöva göra om resten av uppsättningen.
Open Interpreter installeras som en fristående binär, så du behöver inte Python eller pip.
Om ett äldre blogginlägg säger åt dig att köra pip install open-interpreter, beskriver det den äldre Python-versionen. Det kommandot ger dig inte den Rust-baserade kodningsagent jag beskriver i den här artikeln.
Du vill också ha Git på din maskin. Open Interpreter kör utan det, men med Git får den en repositories-medveten session och diffs.
Kör installationsskriptet från din terminal:
curl -fsSL https://www.openinterpreter.com/install | shSkriptet laddar ned rätt release för din plattform och placerar kommandot interpreter i ~/.local/bin.
Öppna PowerShell och kör:
irm https://www.openinterpreter.com/install.ps1 | iexWSL stöds också om du föredrar en Linux-liknande uppsättning. Kör i så fall kommandot för macOS och Linux i din WSL-terminal.
Starta om din terminal så att den plockar upp den nya PATH, och kontrollera sedan versionen:
interpreter --versionOm du ser ett versionsnummer fungerade installationen.
Kontroll av Open Interpreter-version
Starta en session från valfri katalog:
interpreterDu kan också skriva i, vilket är en kort alias för samma kommando.
Open Interpreter öppnar ett terminalgränssnitt där du beskriver uppgifter på enkel engelska. Första gången du startar den ber den dig koppla en modellleverantör. Jag använder en lokal modell via Ollama i nästa avsnitt, så du kan hoppa över det steget nu.
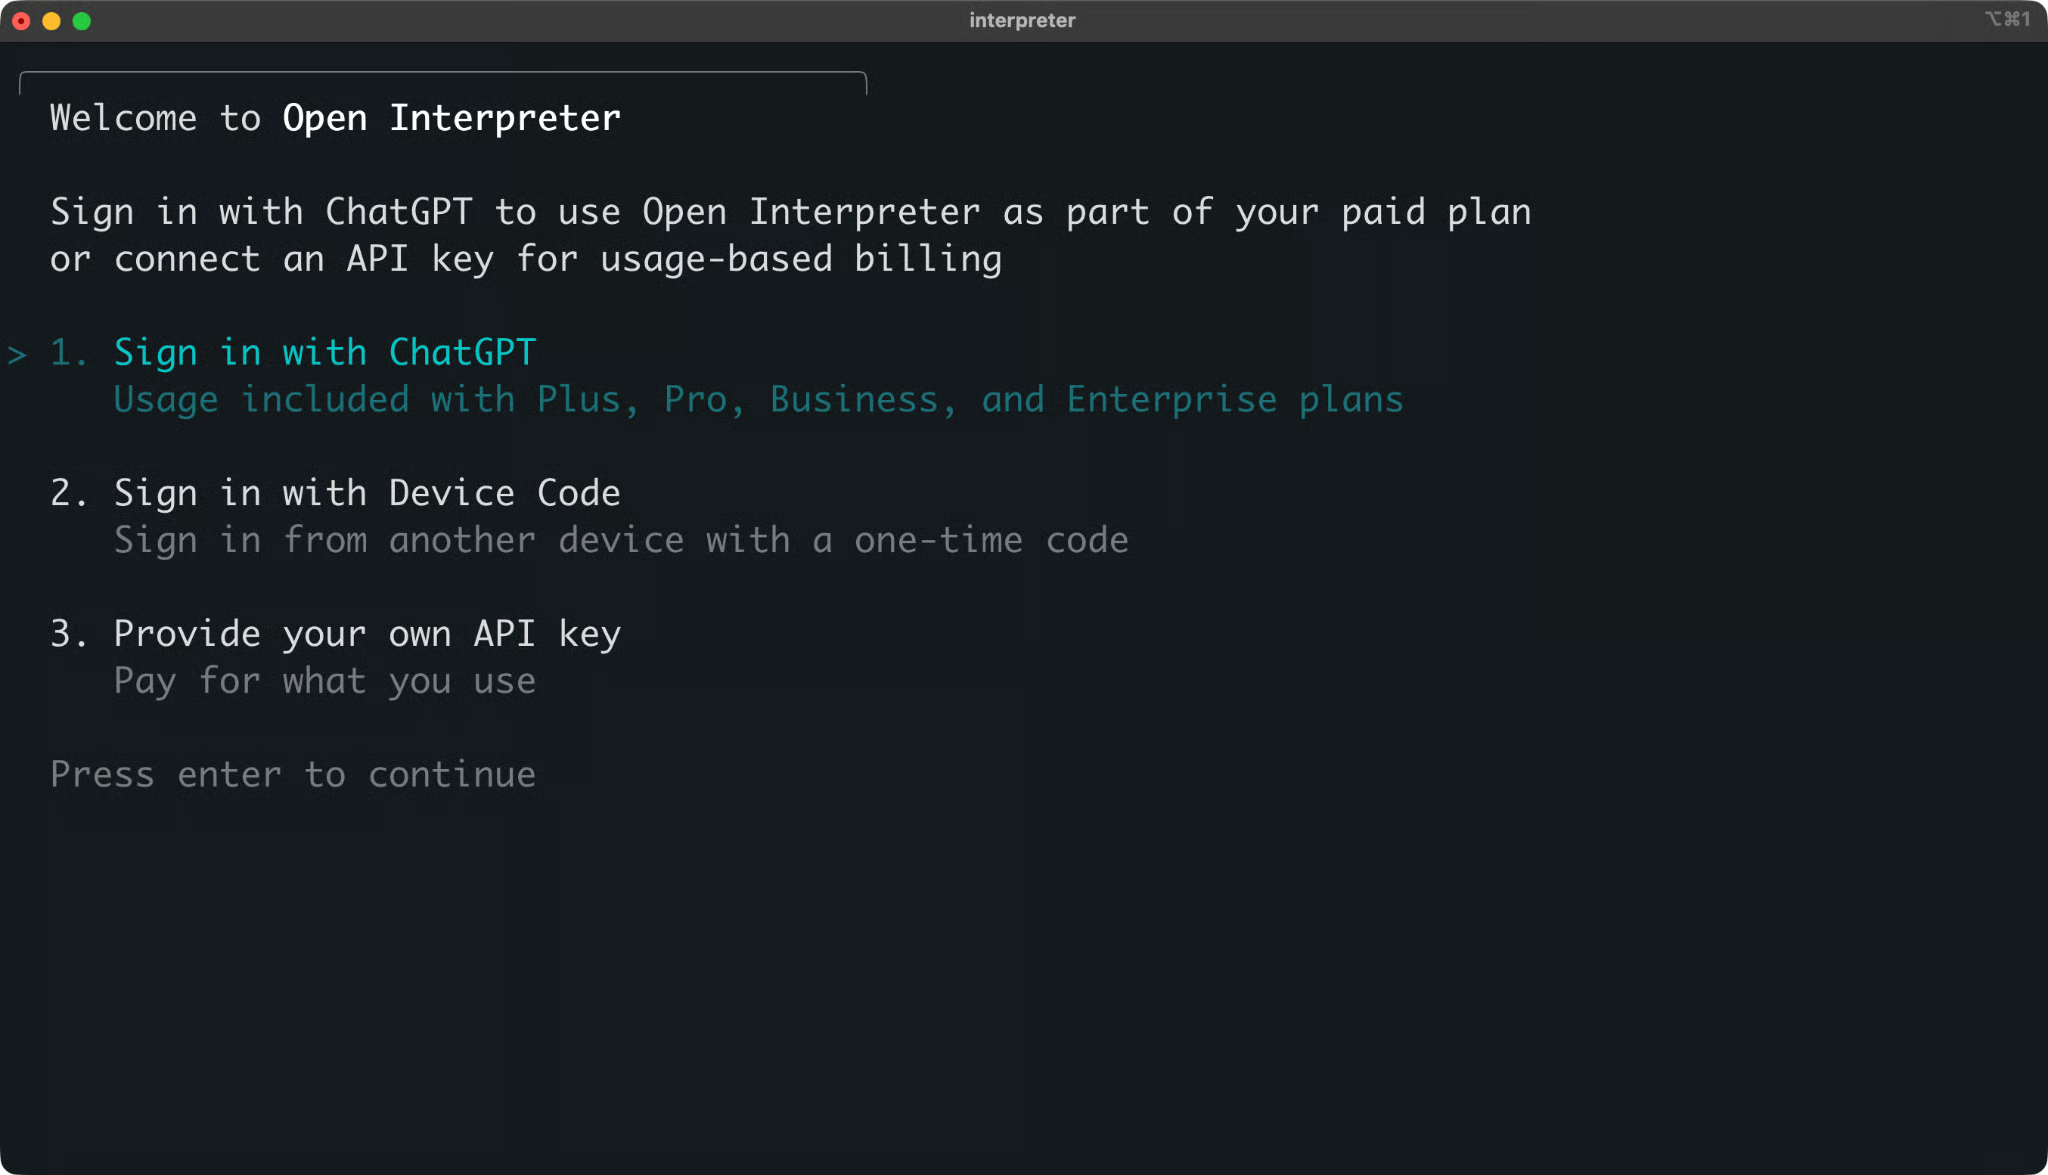
Interaktiv session i Open Interpreter
För att lämna sessionen, skriv /exit.
Det snabbaste sättet att förstå en kodningsagent är att ge den en uppgift och se vad den gör med den.
Jag använder ett litet projekt för en vanespårare i hela detta avsnitt. Det har en funktion, en testfil och en bugg.
Projektet beräknar den längsta sviten av sammanhängande dagar för en vana. Till exempel hur många dagar i rad du tränade.
Börja med en projektmapp och en virtuell miljö:
mkdir habit-tracker && cd habit-tracker
python3 -m venv .venv
source .venv/bin/activate
pip install pytest
Skapa habits.py med följande kod:
def longest_streak(dates):
    """Return the longest run of consecutive days.

    Each date is a 'YYYY-MM-DD' string, for example "2026-03-14".
    Duplicate dates count once.
    """
    days = sorted(set(dates))
    if not days:
        return 0

    longest = current = 1
    for previous, today in zip(days, days[1:]):
        if int(today[8:10]) - int(previous[8:10]) == 1:
            current += 1
            longest = max(longest, current)
        else:
            current = 1
    return longest
Skapa sedan test_habits.py:
from habits import longest_streak


def test_streak_within_one_month():
    dates = ["2026-03-01", "2026-03-02", "2026-03-03", "2026-03-10"]
    assert longest_streak(dates) == 3


def test_duplicate_dates_count_once():
    dates = ["2026-03-01", "2026-03-01", "2026-03-02"]
    assert longest_streak(dates) == 2


def test_streak_across_month_boundary():
    dates = ["2026-01-30", "2026-01-31", "2026-02-01"]
    assert longest_streak(dates) == 3
Funktionen har en bugg. Jag pekar inte ut den, för att hitta den är agentens jobb.
Lägg till en .gitignore-fil så att den virtuella miljön och cachefiler hålls utanför repositoryt:
.venv/
__pycache__/
.pytest_cache/
Checka nu in projektet:
git init
git add .
git commit -m "Initial commit"
Denna commit ger dig en ren startpunkt. Senare använder du den för att se exakt vad agenten ändrade.
Kör testerna för att bekräfta buggen:
python -m pytest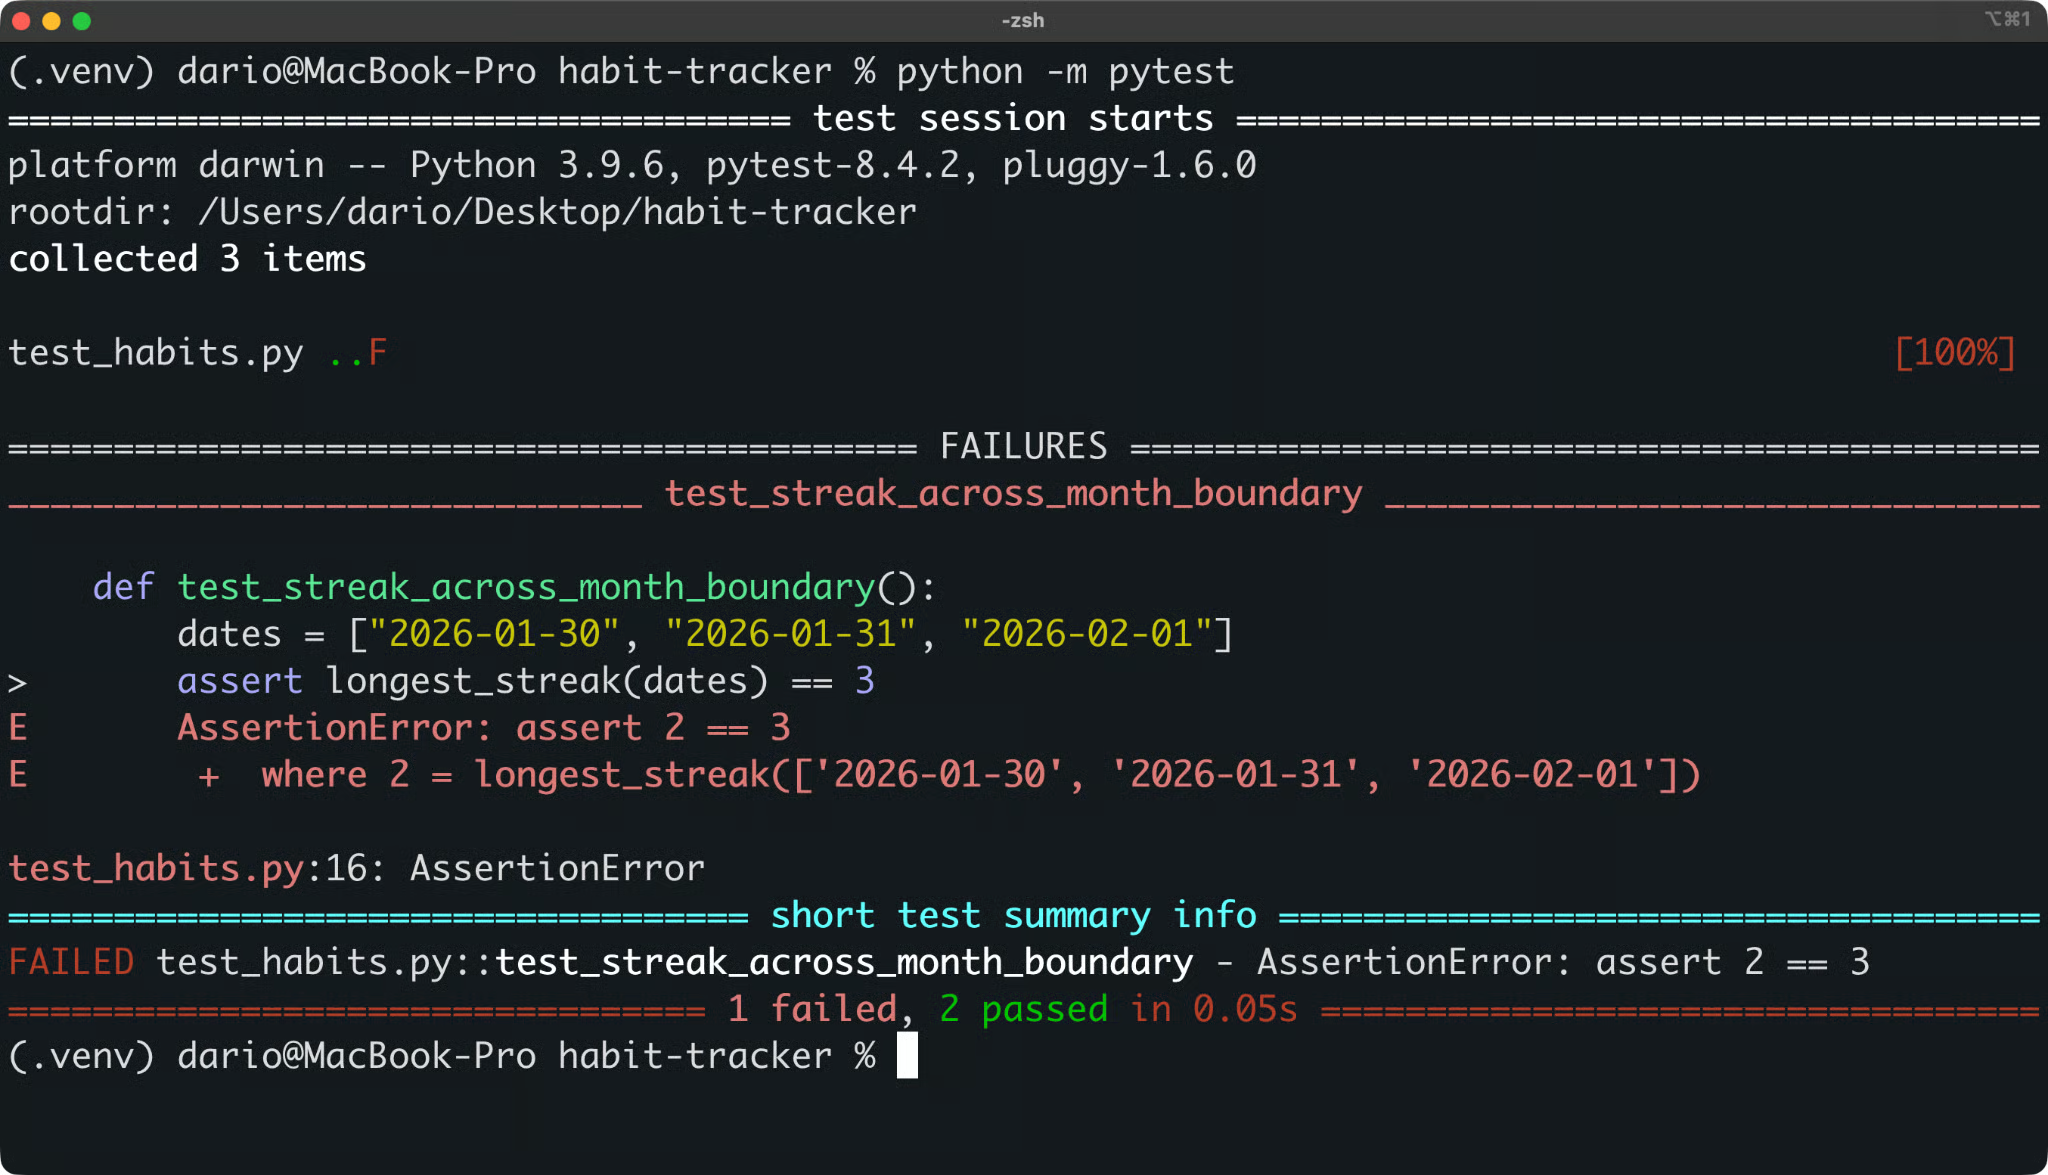
Testresultat för vanespåraren
Två tester går igenom, och ett fallerar. Det är problemet Open Interpreter ska lösa.
Du behöver ha Ollama installerat och igång. Du behöver också en modell som stöder verktygsanrop, så hämta den:
ollama pull qwen3-coder:30bStarta sedan Open Interpreter från projektmappen. Använd samma terminal, så att agenten kan använda pytest-installationen från din virtuella miljö:
interpreter --oss --local-provider ollama -m qwen3-coder:30bSå här fungerar varje flagga:
--oss: Använder en lokal leverantör med öppen källkod
--local-provider ollama: Väljer Ollama framför LM Studio
-m qwen3-coder:30b: Anger modellen för den här körningen
Kör /status för att bekräfta aktiv leverantör, modell, sandbox-läge och godkännandepolicy.
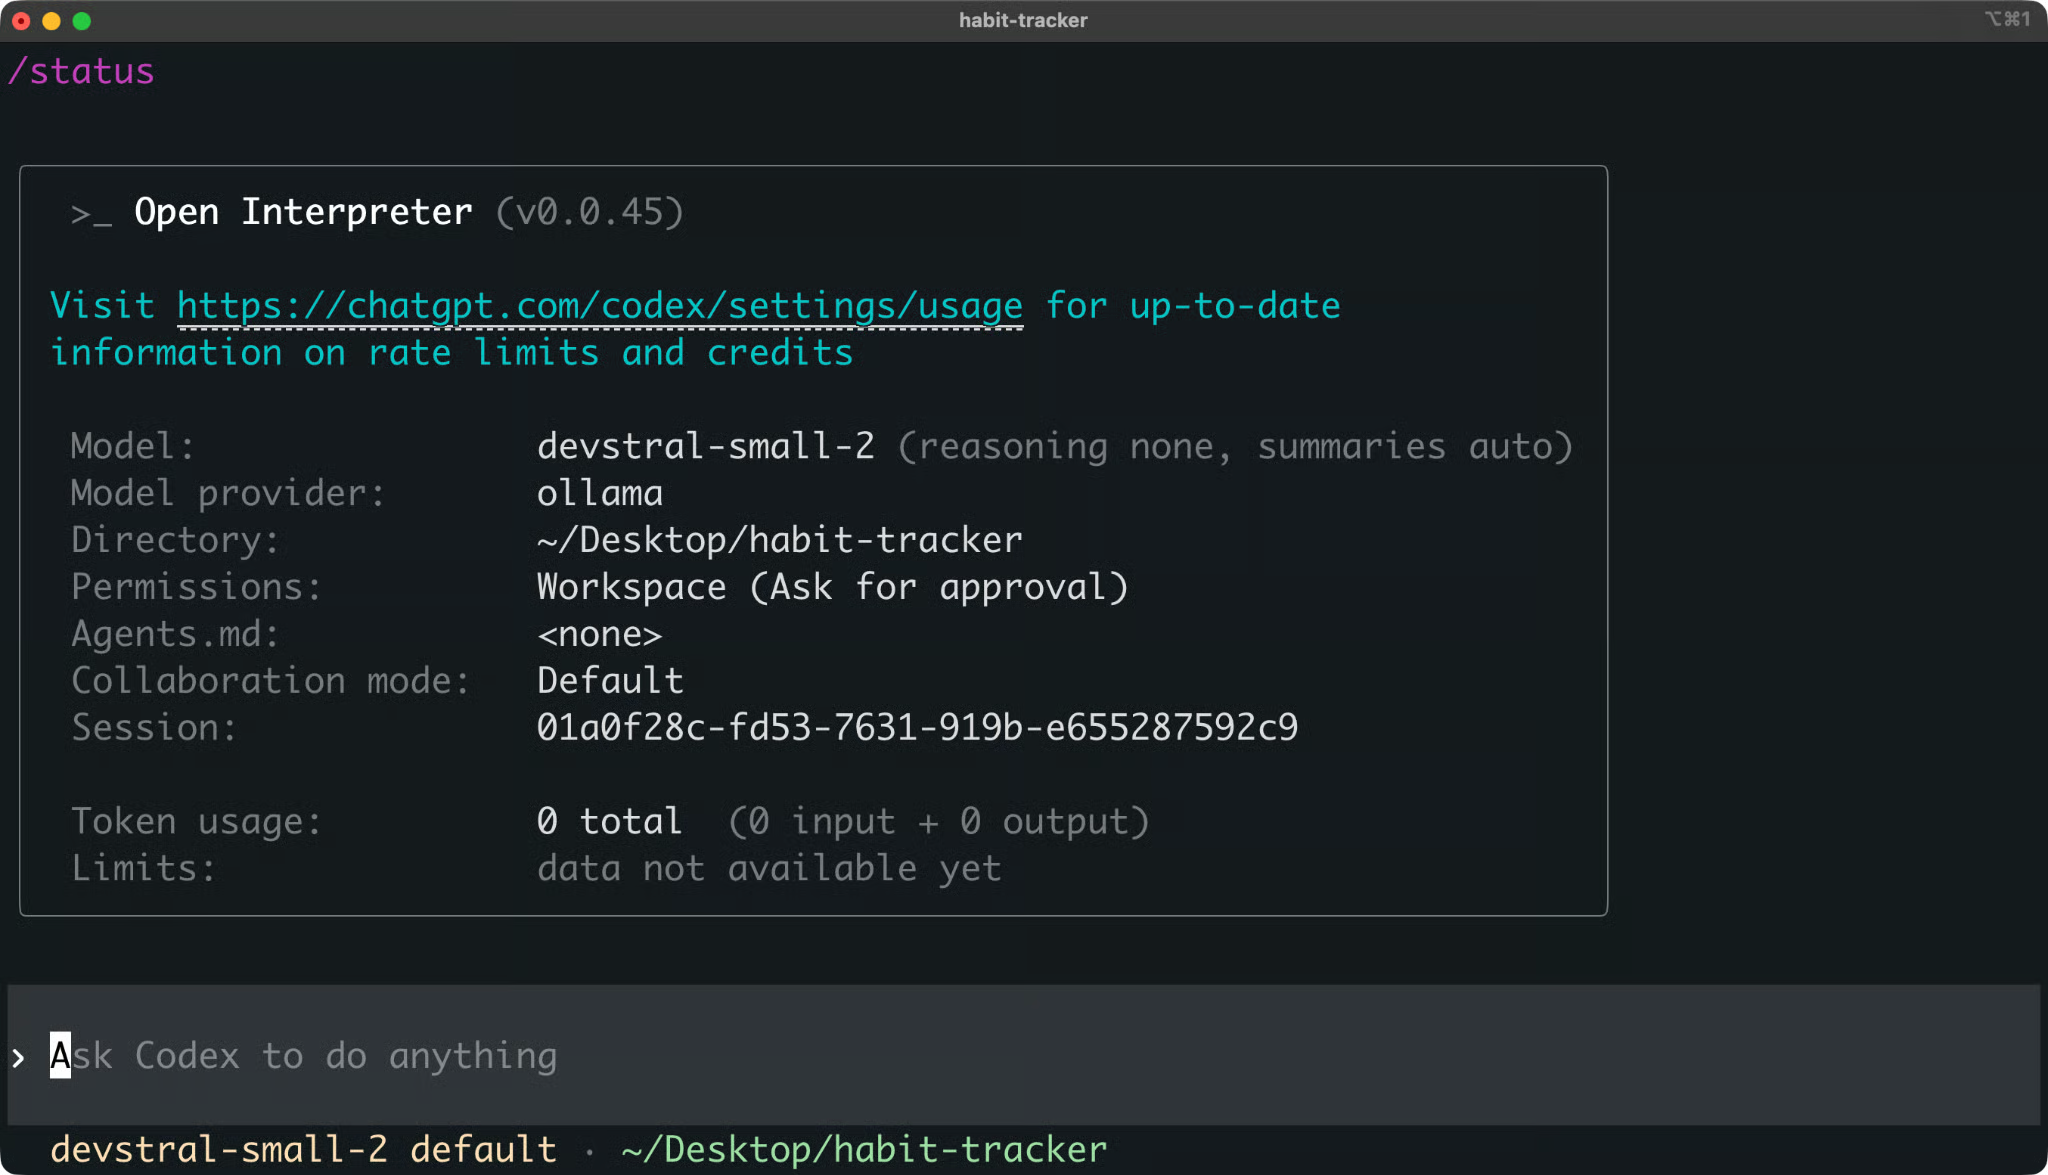
Open Interpreter-session med en lokal Ollama-modell
Du vill inte att agenten ska redigera något ännu. Be om en diagnos först:
The tests in this project are failing. Find the cause and explain how you'd fix it. Don't edit any files yet.Agenten brukar läsa filerna och köra testerna innan den svarar. Kommandon körs i sandlådan, och om agenten behöver mer åtkomst än vad sandlådan tillåter, ber den om ditt godkännande först.
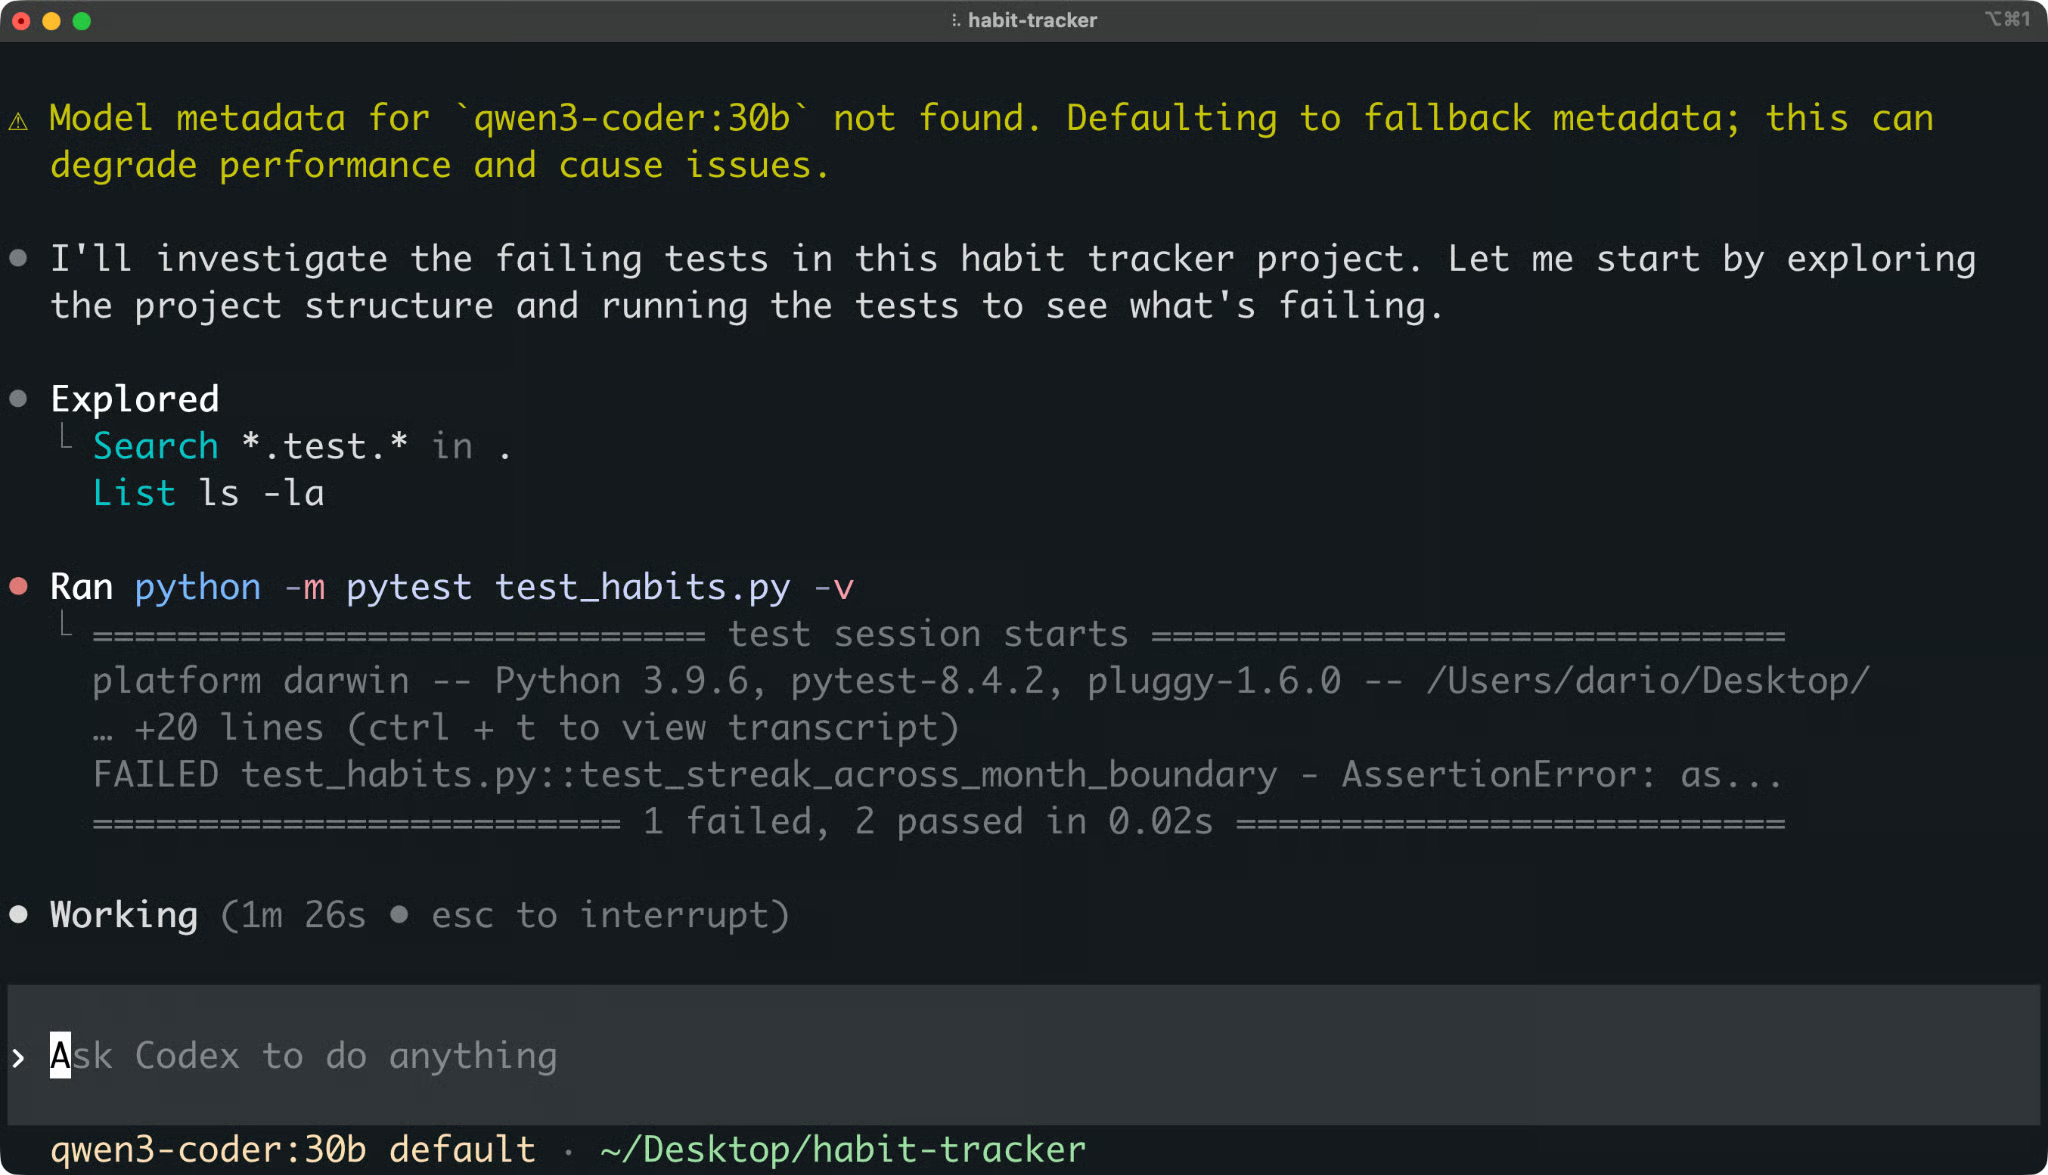
Open Interpreter-utdata
Läs förklaringen innan du godkänner något.
En korrekt diagnos säger att funktionen bara jämför dag i månaden, så en svit bryts när den passerar in i en ny månad. En bra fix jämför hela datum, till exempel med date.fromisoformat() från Pythons datetime-modul.
Om diagnosen är fel, korrigera den i samma session innan agenten redigerar någon kod.
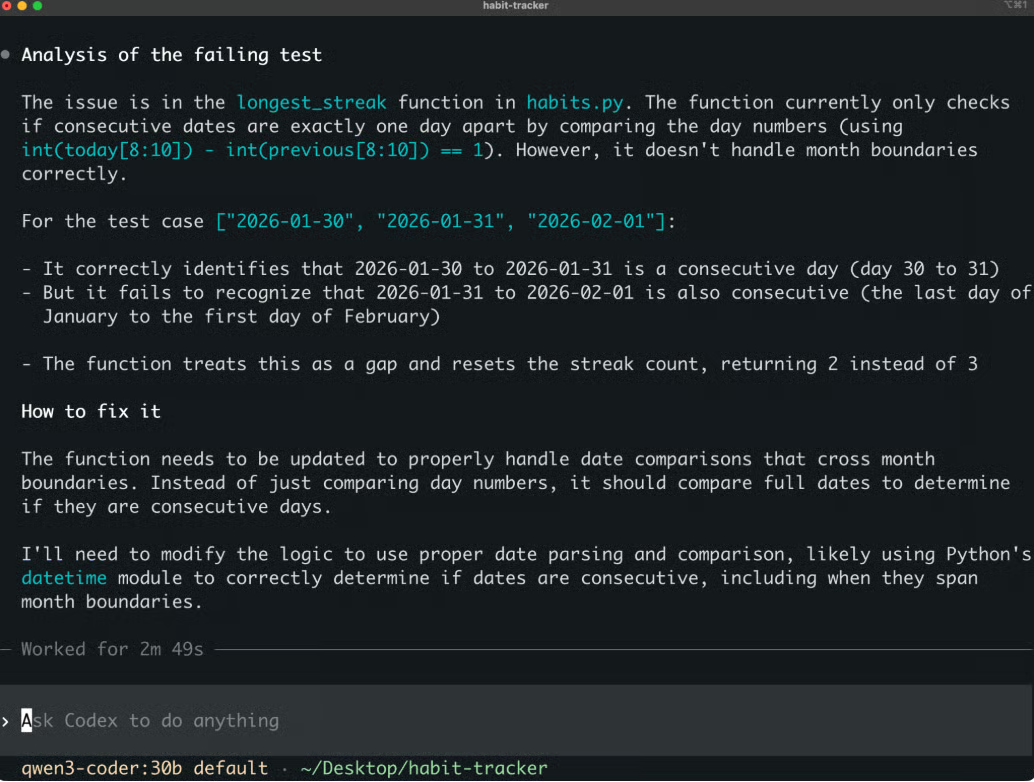
Förslag på fix från Open Interpreter
När du är nöjd med planen, implementera fixen:
Apply the fix to habits.py, then run the tests.Agenten redigerar filen och kör pytest igen. Du vill se att alla tre testerna passerar.
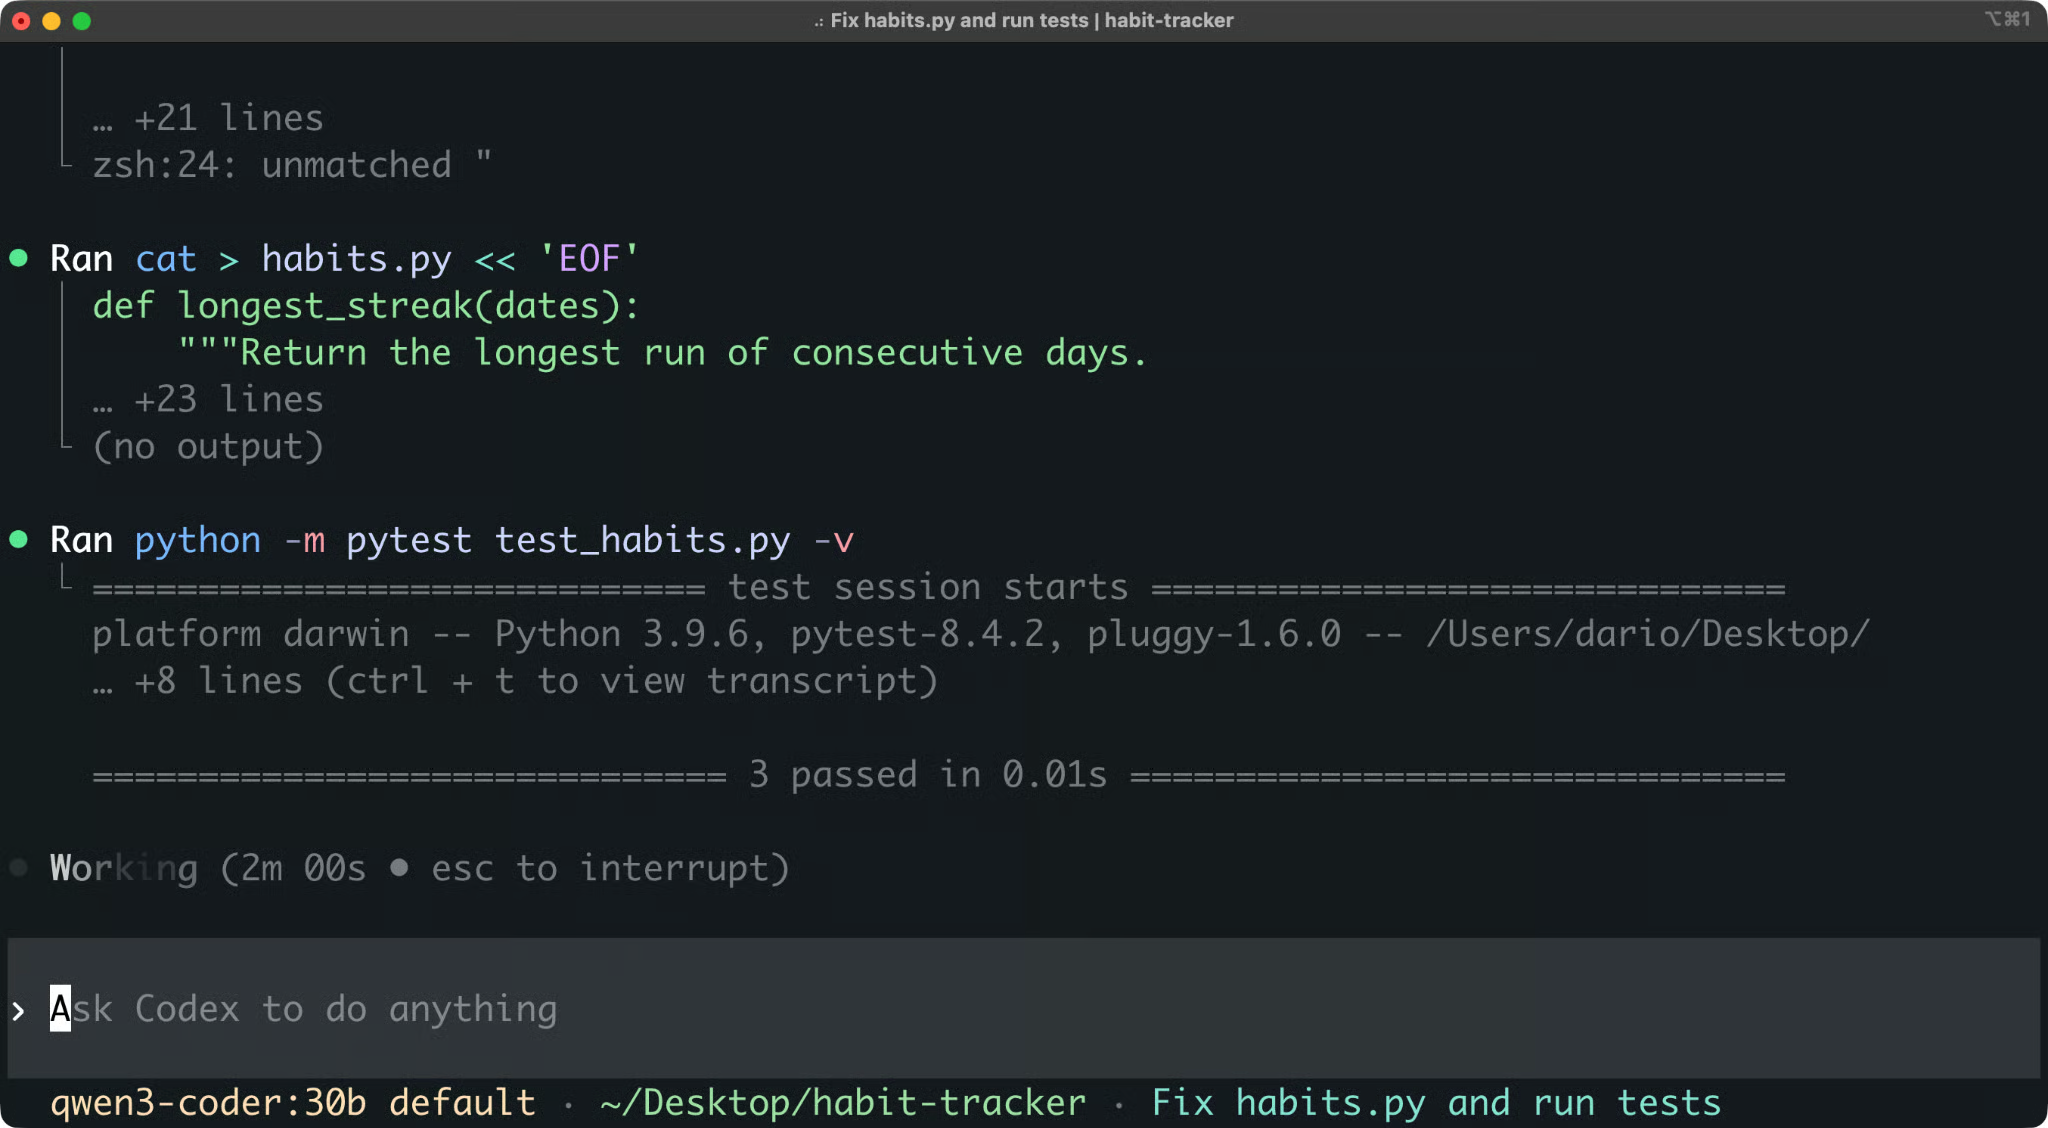
Alla tester går igenom efter fixen
Att ett test passerar betyder inte nödvändigtvis att buggen i din kod är löst. Kanske uppdaterades testet för att komma runt buggen. Du måste ändå granska koden.
Kör /diff i sessionen för att se ändringarna i working tree. Du kan också köra git diff efter att du avslutat.
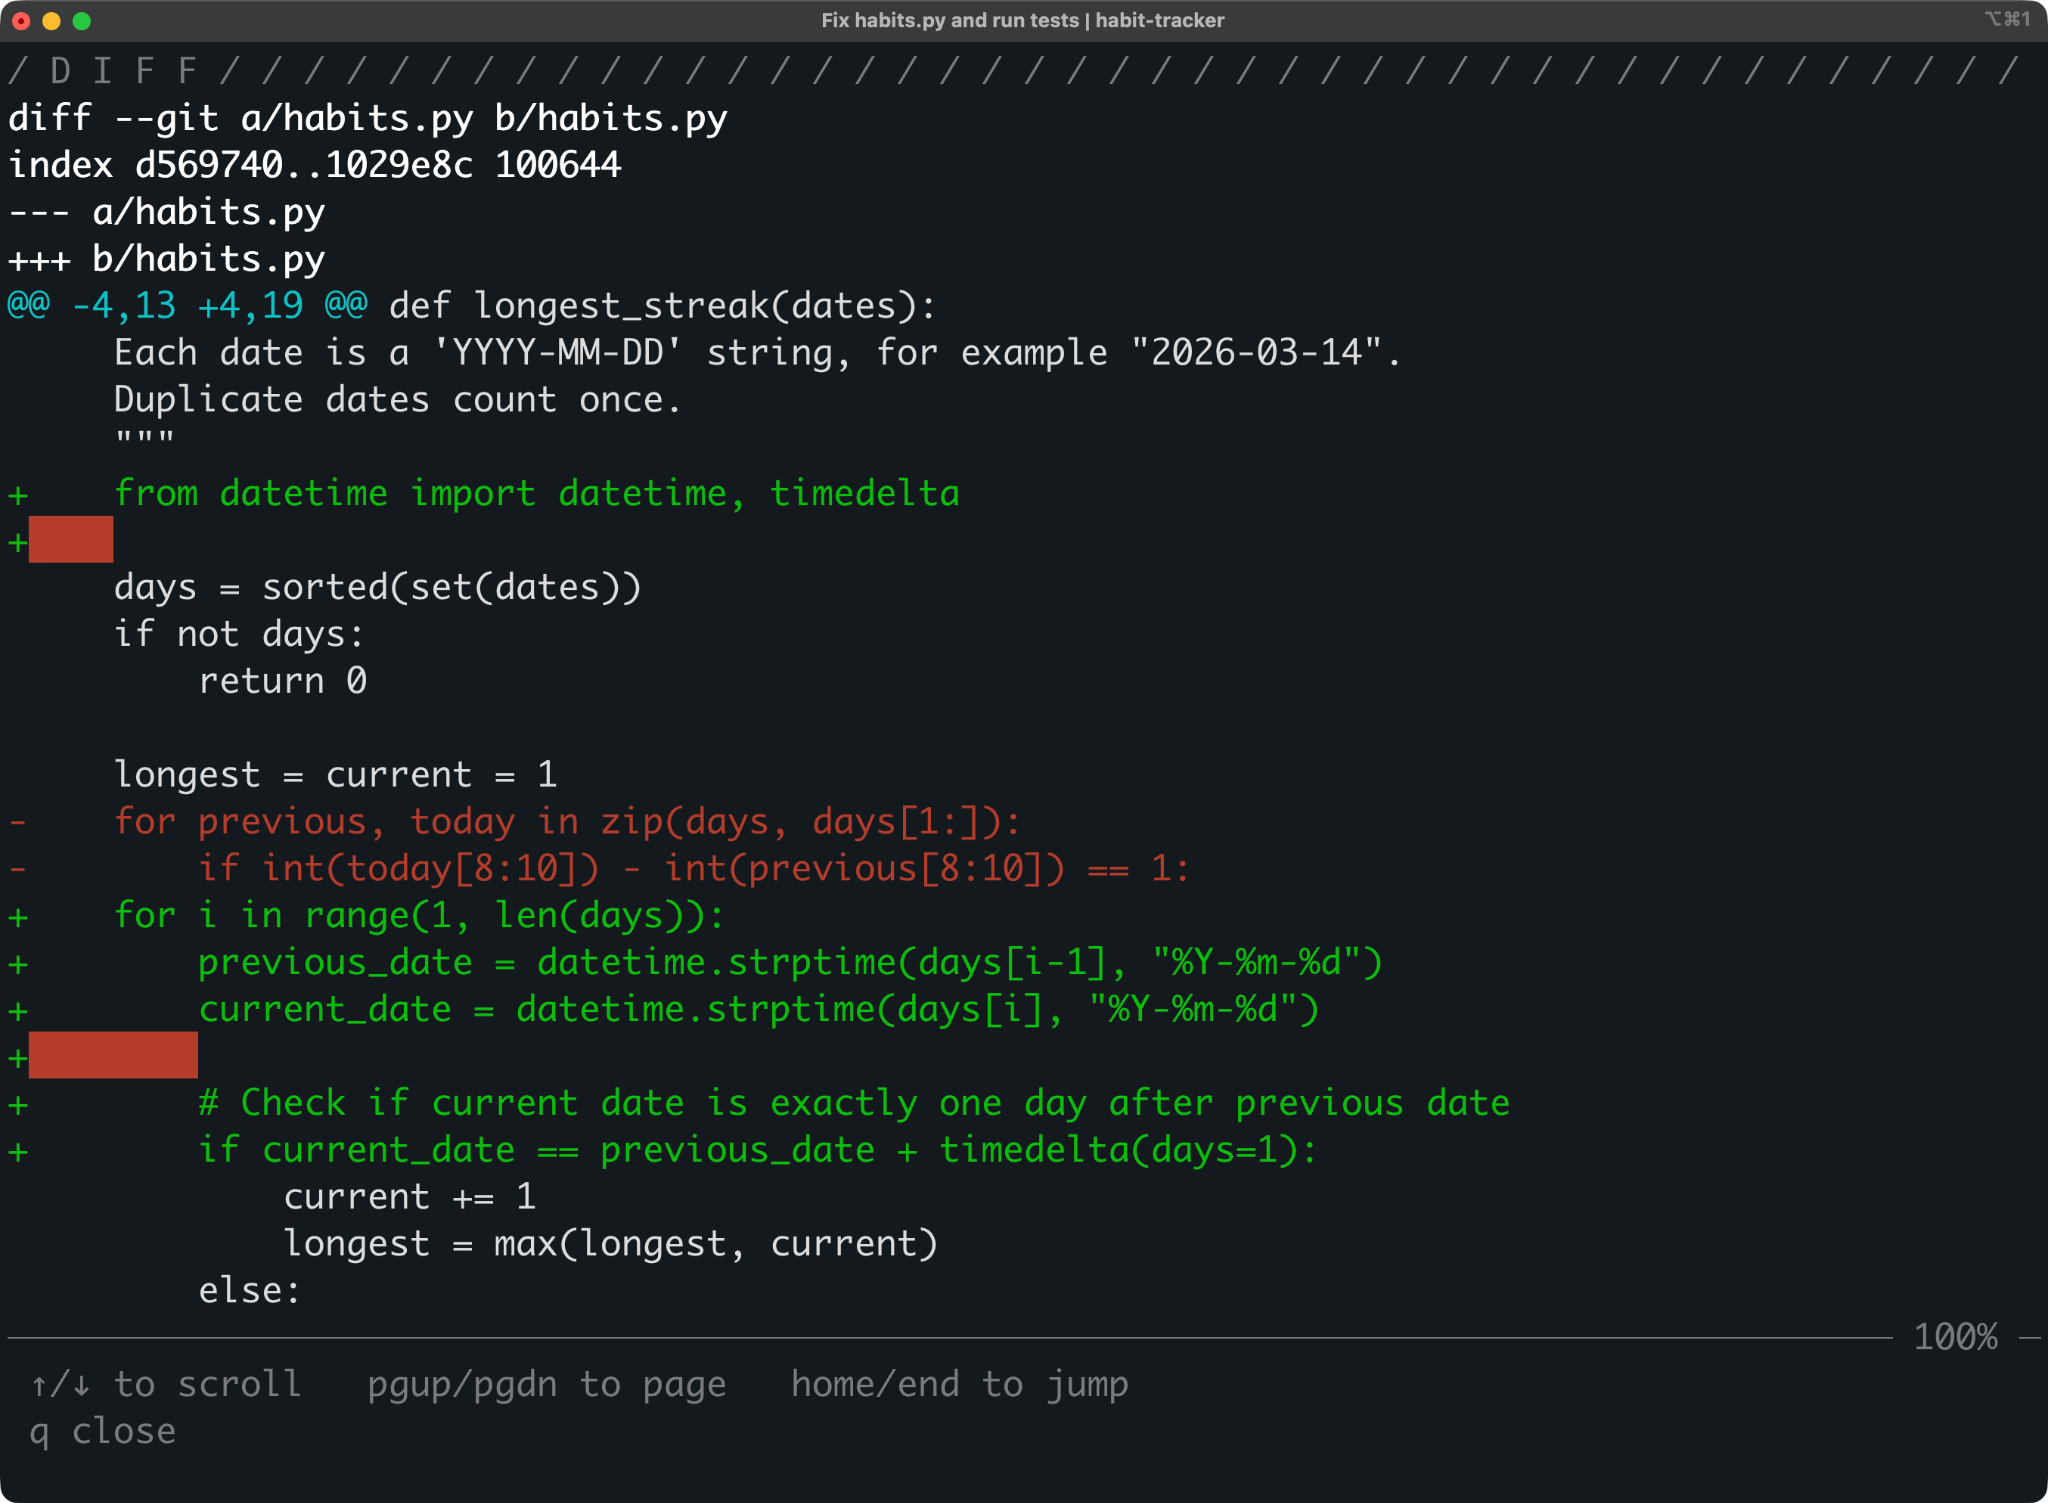
Diffen av ändringar gjorda av Open Interpreter
Den exakta diffen beror på modellen, så din kanske inte matchar den ovan rad för rad. Om du gillar ändringen, commit:a den, och om du inte gör det, återställ originalfilen:
git restore habits.pyOch det är idén. Du beskriver problemet, agenten undersöker och fixar det, och du granskar varje ändring innan den blir en del av din kod.
Open Interpreter kräver att du tar med din egen modell.
Varje begäran går igenom dessa tre lager:
| Lager | Exempel | Vad det styr |
|---|---|---|
| Leverantör | ollama | Vart begäranden går och hur du autentiserar |
| Modell | devstral-small-2 | Modellen som gör jobbet |
| Harness | native | Prompts, verktyg och meddelandeformat runt modellen |
Begärandelager
Det här kan du koppla in:
Leverantörslistan genereras från en offentlig modellkatalog, och den tar bara med modeller som stöder verktygsanrop. Om en modell du förväntar dig saknas är det oftast anledningen.
Kom ihåg att se upp för ollama-cloud. Det är en separat hostad leverantör, så dina begäranden lämnar din maskin. Endast den inbyggda ollama-leverantören kör modeller lokalt.
Du kan byta modell på tre nivåer:
I en session: Kör /model för att välja leverantör, modell och resonemangsinsats
För en enskild körning: Skicka flaggan -m, som i föregående avsnitt
Som standard: Sätt den i din konfigurationsfil
Du kan köra /status när som helst för att se vilken leverantör och modell som är aktiva.
Open Interpreter läser sina inställningar från ~/.openinterpreter/config.toml. För att göra Ollama-uppsättningen från föregående avsnitt till din standard, lägg till dessa två rader:
model_provider = "ollama"
model = "qwen3-coder:30b"
Efter det startar interpreter med den här modellen, och du behöver inga flaggor.
Hostade leverantörer läser sina API-nycklar från miljövariabler. Till exempel förväntar sig DeepSeek DEEPSEEK_API_KEY:
export DEEPSEEK_API_KEY="your-api-key"Du kan också lägga till en valfri OpenAI-kompatibel slutpunkt som en anpassad leverantör:
model_provider = "my-provider"
model = "my-model"

[model_providers.my-provider]
name = "My Provider"
base_url = "https://api.example.com/v1"
env_key = "MY_PROVIDER_API_KEY"
wire_api = "chat"
Inställningen wire_api talar om för Open Interpreter vilket begäranseformat slutpunkten förväntar sig. Använd chat för OpenAI-kompatibla Chat Completions, responses för OpenAI Responses API och messages för Anthropic-liknande slutpunkter.
Ett betrott projekt kan också ha sin egen .openinterpreter/config.toml, som åsidosätter din användarkonfig. Kommandoradsflaggor åsidosätter båda. Om du är osäker på vilket värde som gäller, kör /debug-config för att se de effektiva inställningarna och var de kommer ifrån.
Modellen avgör hur väl agenten förstår din kod. Harnessen avgör hur modellen ser uppgiften och verktygen.
Du behöver båda. En bra modell i en felmatchad harness skickar felaktiga verktygsanrop och misstolkar resultat. Och en bra harness kan inte kompensera för en modell som inte förstår koden.
Det är därför Open Interpreter väljer en harness när du väljer en modell. Till exempel:
Claude-modeller får harnessen claude-code
Kimi-modeller får kimi-code
Qwen-modeller får qwen-code
DeepSeek-modeller får claude-code-bare
För andra modellfamiljer kan du välja harness själv med /harness.
Kom ihåg att ett svagt resultat inte alltid betyder en svag modell. Innan du byter modell, prova samma modell med en annan harness, vilket jag går igenom i detalj i nästa avsnitt.
Harness-emulering är huvudskälet till att den nuvarande versionen av Open Interpreter finns.
En agent-harness är allt runt modellen som gör den till en agent. Den inkluderar:
På enkel svenska: harnessen avgör hur modellen ser uppgiften och hur dess beslut blir till handling.
Open Interpreter har en uppsättning inbyggda harness-lägen. Dessa är de du kommer att använda mest:
native: Open Interpreters egen harness, ärvd från Codex
claude-code: Emulerar prompts och verktygsytan i Anthropics Claude Code
kimi-code: En Rust-implementering av Kimi Code-harnessen som Moonshot rekommenderar för sina Kimi-modeller
qwen-code: Emulerar Alibabas Qwen Code CLI för Qwen-modeller
swe-agent: Emulerar SWE-agent, en forskningsagent byggd för att lösa GitHub-ärenden
Hela listan har också varianter som claude-code-bare, kimi-cli, deepseek-tui, zcode och minimal. Kör /harness i en session för att se vad din version stöder.
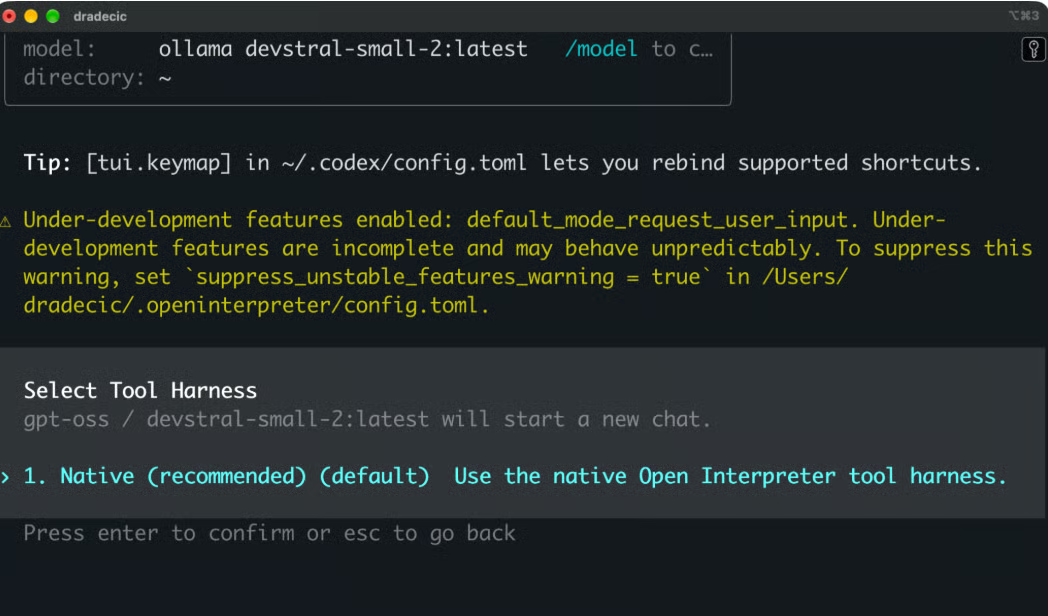
Du kan byta harness mitt i en session med /harness, eller ange en standard i ~/.openinterpreter/config.toml:
harness = "kimi-code"
harness_guidance = true
Inställningen harness_guidance lägger till en tillförlitlighetsstyrning där harnessen tillåter det. Sätt den till false om du vill ha striktare emulering. Om du lämnar harness oangedd väljer Open Interpreter en baserat på modellfamiljen, som du såg i föregående avsnitt.
De flesta modellleverantörer trimmar sina kodningsmodeller i en specifik agentuppsättning, och de publicerar en rekommenderad harness som passar till den.
Modellen vänjer sig vid den harnessen. Den lär sig promptstilen, verktygsnamnen, filredigeringsformatet och hur verktygsresultat kommer tillbaka.
Säg att du kör en modell som är trimmad för sök-och-ersätt-redigeringar i en harness som förväntar sig kompletta patchfiler. Modellen vet vilken ändring som ska göras, men fortsätter att beskriva ändringen i fel format. Agentloopen förbrukar tokens utan framsteg.
Verktygsresultat fungerar på samma sätt. Om harnessen returnerar resultat i ett format modellen inte har sett, misstolkar modellen dem. Om harnessen raderar modellens resonemang mellan varven tappar en tänkande modell bort sin egen plan.
Detta innebär att samma modell kan se bra ut i en agent och dålig i en annan, utan att vikterna ändras. Det är också därför resultat i kodningsbenchmarkar vanligtvis namnger vilken harness som användes för varje körning.
Frontier-modeller tenderar att återhämta sig från en obekant harness, men mindre och billigare modeller gör det vanligtvis inte. Open Interpreter tvingar inte varje modell in i ett format, utan ändrar formatet för att passa modellen.
Du kan testa detta själv med demoprojektet. Återställ originalfilen med git restore habits.py, byt harness med /harness och ge agenten samma prompt igen. Jämför sedan hur många steg det tar och hur den formaterar sina redigeringar.
Du har redan sett de flesta av dessa funktioner i artikeln. Så här hjälper de dig i vardaglig utveckling.
Open Interpreter arbetar inne i ditt Git-repo. Den läser projektstrukturen och spårar vad den har ändrat.
Två snedstreckskommando hjälper här. /diff visar working tree-ändringar, och /review ber agenten att granska de aktuella ändringarna efter buggar och regressioner innan du commit:ar. Du kan köra samma granskning utan att öppna en session:
interpreter exec review --uncommittedSessioner sparas också. Om du avbryter mitt i en uppgift plockar interpreter resume --last upp där du slutade.
Agenten kör samma kommandon som du skulle göra, till exempel testsviter, linters, byggskript och pakethanterare. Alla körs i inbyggd sandboxing på macOS, Linux och Windows.
Långkörande kommandon kan köras i bakgrunden. Använd /ps för att lista dem och /stop för att avsluta dem.
För skript och CI-pipelines kör interpreter exec en uppgift utan det interaktiva gränssnittet:
interpreter exec "fix the failing test"Du kan byta leverantörer och modeller när som helst med /model. Din konfiguration, AGENTS.md och skills gäller fortfarande efter bytet.
Profiler är hjälpsamma här. Säg att du vill ha en billig modell för rutinjobb och en starkare för kodgranskningar. Du kan definiera båda i din konfig:
[profiles.review]
model_provider = "deepseek"
model = "deepseek-v4-pro"
sandbox_mode = "read-only"
Starta sedan med interpreter --profile review när du behöver det.
/harness ändrar hur modellen ser uppgiften utan att byta modell. Det är det första du ska prova när en modell har svårt med verktygsanrop, innan du går upp till en större modell.
Model Context Protocol (MCP) kopplar agenten till verktyg den inte var designad för, som dokumentationsservrar eller databaser. Du lägger till servrar i din konfig:
[mcp_servers.docs]
command = "npx"
args = ["-y", "your-docs-mcp-server"]
default_tools_approval_mode = "prompt"
Kör /mcp för att se konfigurerade servrar och deras verktyg. Inställningen default_tools_approval_mode gör att agenten frågar innan den använder ett verktyg från den servern.
Det fungerar också åt andra hållet. interpreter mcp-server exponerar Open Interpreter som en MCP-server, och interpreter acp kör den i editorer som stöder Agent Client Protocol, en öppen standard för att koppla editorer till kodningsagenter.
AGENTS.md är en Markdown-fil i ditt repo med projektsregler som agenten läser vid varje uppgift. För vanespåraren kan den se ut så här:
# AGENTS.md
- Run the tests with python -m pytest before you finish a task.
- Use the Python standard library only. Don't add new dependencies.
Du kan också köra /init, så skriver agenten en första version åt dig.
Skills är återanvändbara arbetsflöden, paketerade som mappar i .agents/skills i ditt projekt eller ~/.agents/skills för din användare. Agenten snappar upp en skill automatiskt när en uppgift matchar den. Kör /skills för att se vilka som är tillgängliga.
Båda är delade format, så samma filer fungerar med andra kodningsagenter som stöder dem. Open Interpreter stöder också hooks, som kör dina egna kommandon vid bestämda punkter i en session. Du granskar och litar på dem med /hooks.
Två inställningar styr vad agenten kan göra:
Sandbox-läge: read-only, workspace-write eller danger-full-access
Godkännandepolicy: untrusted, on-request eller never
Sandlådan avgör vad som är möjligt, och godkännandepolicyn avgör när agenten frågar först. Med workspace-write och on-request kan agenten redigera ditt projekt och köra tester, men den frågar innan den behöver åtkomst utöver det.
Du kan ändra båda med /permissions eller med flaggorna -s och -a. Det finns också en --yolo-flagga som förbigår båda, och dokumentationen märker den som farlig. Jag tar upp dessa inställningar mer i detalj i säkerhetsavsnittet.
Open Interpreter beskriver sig själv som en kodningsagent byggd för lågkostnadsmodeller.
De största proprietära kodningsagenterna är byggda runt sin leverantörs egna modeller. Open Interpreter ger dig en agent som fungerar med proprietära modeller, hostade open-weight-modeller och lokala modeller.
Open-weight-modeller som Kimi, DeepSeek, GLM och Qwen har publika vikter. Du kan använda dem via en tredjepartsleverantör eller på din egen hårdvara.
Det ger två fördelar. Hostade open-weight-modeller kostar vanligtvis mindre per token än de främsta proprietära modellerna. Och du är inte begränsad till en värd, eftersom samma modell körs var som helst där dess vikter gör det.
Open Interpreter har dedikerade leverantörsguider för Kimi K3, DeepSeek och GLM. Den väljer också matchande harness för dessa modellfamiljer.
Ollama och LM Studio är inbyggda leverantörer, så du kan köra en modell på din egen maskin utan API-nyckel eller kostnad per token.
Kostnaden är hårdvara. När jag testade devstral-small-2 på min MacBook Pro M1 Max med 64 GB enhetligt minne tog modellen ensam 26 GB av det. Standardfönstret för Ollama-kontekst var för litet för agentloopen, och vid 128k tokens steg och föll minnesanvändningen tills sessionen fastnade.
Kodningsagenter behöver ett stort kontextfönster, eftersom systemprompt, verktygsdefinitioner, filinnehåll och kommandoutdata alla måste få plats. Ollama rekommenderar minst 64k tokens för Codex-liknande agenter. Och ett större kontextfönster använder mer minne ovanpå själva modellen.
Open Interpreter körs på din maskin, men modellen behöver inte göra det.
Vart din kod tar vägen beror på leverantören:
Din konfig, sessioner och loggar lagras lokalt under ~/.openinterpreter oavsett vad.
Om du behöver mer kontroll kan du lägga till en anpassad leverantör som pekar på din egen inferensserver. Valfri server med ett OpenAI-kompatibelt API fungerar, till exempel en vLLM-distribution på ditt företags GPU:er. På så vis får du en hostad uppsättning där infrastrukturen är din.
Öppna modeller är inte lika bra på verktygsanrop. Du ser svag verktygsanvändning som felaktiga anrop, loopar, tidiga stopp eller ignorerad kommandoutdata.
Rätt harness hjälper, men den kan inte laga en modell som inte kan planera en flerstegsuppgift. Mindre lokala modeller har flest problem här.
Innan du pekar en ny modell på ett riktigt projekt, testa den på ett litet repo som vanespåraren jag visade i artikeln. Om den visar svagheter, prova en annan harness innan du byter till en större modell.
Här är en snabb sammanställning av dina alternativ:
| Var inferensen körs | Kostnad | Lämnar koden din maskin? | |
|---|---|---|---|
| Proprietär hostad modell | Leverantörens server | Per token eller abonnemang | Ja |
| Open-weight hostad modell | Leverantörens server | Per token, vanligtvis lägre | Ja |
| Open-weight lokal modell | Din hårdvara | Hårdvara och el | Nej |
Open Interpreter-alternativ för lokala och öppna modeller
Open Interpreter delar mycket med andra terminalbaserade kodningsagenter. Skillnaderna ligger i vem som äger verktyget och vilka modeller det är byggt för.
Claude Code är Anthropics terminalagent för kodning. Den första skillnaden är ägarskap – Claude Code är proprietär, medan Open Interpreter är öppen källkod under Apache 2.0. Du kan läsa och ändra varje del av Open Interpreter.
Modellval är den andra skillnaden. Claude Code är byggd för Claude-modeller. Du kan peka den på Anthropic-kompatibla slutpunkter från andra leverantörer, men dess harness förblir trimmad för Claude. Open Interpreter behandlar modellval som en kärnfunktion.
Jämförelsen av harnessar är där det blir intressant. Claude Code är i sig en av de harnessar Open Interpreter emulerar. Med läget claude-code får vilken modell som helst Claude Code-stil på prompts och verktyg i Open Interpreters runtime. UI och snedstreckskommandon är fortfarande Open Interpreters, så det är inte samma produkt med en annan modell.
Båda verktygen är terminal-först. Varje har en interaktiv session och ett icke-interaktivt läge för skript och CI. För projektinstruktioner läser Claude Code CLAUDE.md, medan Open Interpreter använder det delade formatet AGENTS.md.
Claude Code har ett större ekosystem. Det kommer med IDE-tillägg, desktop- och webbappar, en plugin-marknadsplats, subagenter och ett SDK. Open Interpreter är yngre, och det förlitar sig på öppna standarder som MCP, skills, AGENTS.md och Agent Client Protocol i stället för ett eget ekosystem.
Om du jobbar med Claude-modeller och vill ha den mest polerade upplevelsen är Claude Code det säkrare valet. Om du vill köra andra modeller eller undvika ett proprietärt verktyg, välj Open Interpreter.
OpenCode är den närmaste motsvarigheten. Båda är öppen källkod, terminal-först och byggda för att fungera med en lång lista av modellleverantörer.
Modellstödet är likartat på pappret. OpenCode stöder mer än 75 leverantörer, och Open Interpreter genererar sin leverantörslista från en offentlig modellkatalog. Båda kör lokala modeller via Ollama.
Terminalupplevelsen skiljer sig mer. OpenCode har eget TUI med LSP-integration (Language Server Protocol), som matar tillbaka koddiagnostik som typfel till modellen. Open Interpreters TUI kommer från Codex.
När det gäller konfiguration använder OpenCode en opencode.json-fil, och Open Interpreter använder config.toml med profiler.
Agentarkitekturen är den stora skillnaden. OpenCode körs som klient och server, där TUI är en klient till en lokal server som andra klienter också kan ansluta till. Det har inbyggda agenter för build och plan, och stöder anpassade agenter och subagenter. Det justerar sin systemprompt för varje modellfamilj, men verktygen och loopen förblir OpenCodes egna. Open Interpreter går längre och byter hela harnessen, inklusive verktygsscheman och meddelandeformat. Nyare byggen inkluderar till och med ett läge opencode för harness.
På utvecklingssidan är OpenCode sin egen kodbas, byggd av sitt team och community. Open Interpreter bygger på en Codex-fork, så en stor del av dess runtime kommer uppströms ifrån. Det är en avvägning. Open Interpreter får Codex sandlåda och runtime gratis, medan OpenCode kontrollerar hela sin stack.
Dessa två är inte konkurrenter i vanlig mening. Open Interpreter är en fork av Codex.
De delar Rust-runtime, TUI, sandboxing, godkännanden, AGENTS.md, skills, MCP, exec-läge och de flesta snedstreckskommandon. När jag körde Open Interpreter stod det fortfarande codex resume i återupptagningstipset för sessionen.
Codex är OpenAIs agent, byggd runt OpenAI-modeller. Den stöder lokala modeller med --oss och anpassade leverantörer, men standardupplevelsen riktar in sig på OpenAI.
Open Interpreter utökar Codex i ett par riktningar:
Harness-emulering: Ändrar prompts, verktygsscheman och meddelandeformat för att passa varje modellfamilj
Leverantörsstöd: Har en genererad leverantörskatalog och dedikerade guider för Kimi K3, DeepSeek och GLM
Chat Completions: Flaggan --chat-completions kör valfri OpenAI-kompatibel leverantör
Codex SDK-override: Appar byggda på Codex SDK kan köras via Open Interpreter i stället
Open Interpreter lagrar också sin konfig och sina sessioner under ~/.openinterpreter, så den krockar inte med en Codex-installation.
Om du mest använder OpenAI-modeller är Codex ett bättre val. Om du använder andra modeller ger Open Interpreter dig samma arbetsflöde med bättre stöd för dem.
Här är en snabb sammanfattning:
| Licens | Modeller | Harness-ansats | Konfig | |
|---|---|---|---|---|
| Open Interpreter | Öppen källkod (Apache 2.0) | Valfri leverantör, hostad eller lokal | Emulerar harness per modell | config.toml |
| Claude Code | Proprietär | Byggd för Claude-modeller | Claude Codes egen harness | settings.json och CLAUDE.md |
| OpenCode | Öppen källkod (MIT) | 75+ leverantörer, hostad eller lokal | En harness med modellspecifika prompts | opencode.json |
| Codex | Öppen källkod (Apache 2.0) | Byggd för OpenAI-modeller med --oss | Codex egen harness | config.toml |
Open Interpreter jämfört med andra AI-kodningsagenter
Det värsta en chatbot kan göra är att ge dig ett dåligt svar, som du kan ignorera. En kodningsagent kör kommandon på din maskin, läser och skriver filer och kan nå nätverket. Ett dåligt beslut från modellen, eller en promptinjektion, kan orsaka faktisk skada. Promptinjektion betyder instruktioner dolda i innehåll agenten läser, såsom en README-fil eller en webbsida.
Open Interpreter ärver sin säkerhetsmodell från Codex runtime. Den har två lager – en sandlåda som begränsar vad som är möjligt, och en godkännandepolicy som avgör när agenten frågar dig först.
Varje kommando agenten kör går genom en OS-nivå-sandlåda på macOS, Linux och Windows. Det finns tre sandbox-lägen:
read-only: Agenten kan läsa filer, men inte ändra något
workspace-write: Agenten kan redigera filer och köra kommandon i din projektmapp
danger-full-access: Ingen sandlåda alls
Med workspace-write är filskrivningar begränsade till den aktiva arbetsytan. Agenten kan fixa din kod, men kan inte redigera filer på andra ställen på din maskin.
I läget workspace-write har kommandon ingen nätverksåtkomst som standard. Detta blockerar nedladdningar och hindrar agenten från att skicka din kod någonstans.
Vissa uppgifter behöver nätverk, till exempel att installera ett paket. Du kan slå på nätverksåtkomst i din konfig:
sandbox_mode = "workspace-write"

[sandbox_workspace_write]
network_access = true
Slå bara på det för projekt där du behöver det.
Godkännandepolicyn avgör när agenten stannar och frågar:
untrusted: Frågar innan den kör kommandon som inte finns på den betrodda listan
on-request: Frågar när en uppgift behöver mer åtkomst än vad sandlådan tillåter
never: Frågar aldrig
För versionskontrollerade projekt är workspace-write med on-request en bra standard. Agenten arbetar i ditt projekt och frågar innan den går längre. Git ger dig en väg tillbaka om något går fel.
Flaggan --yolo stänger av både sandlådan och godkännanden. Använd den bara i en förbrukningsmiljö, som en container eller en VM.
Kommandon som agenten kör ärver din shell-miljö. Om dina API-nycklar finns i miljövariabler kan de kommandona se dem.
Du kan begränsa detta med shell_environment_policy:
[shell_environment_policy]
inherit = "core"
exclude = ["AWS_*", "*_TOKEN"]
Inställningen core skickar bara vidare grundläggande variabler som HOME och PATH, och exclude tar bort allt som matchar mönstren.
Filer är en annan risk. Agenten kan läsa en .env-fil i ditt projekt även i read-only-läge. Med en hostad leverantör går allt agenten läser till den leverantörens servrar.
Kom ihåg att sandlådan begränsar skadan, men du bör ändå se den som ett skyddsnät, inte en garanti.
Innan du låter agenten köra själv, kör /status och kontrollera sandbox-läge och godkännandepolicy.
Om du hittar en artikel om Open Interpreter som börjar med pip install är den inte fel. Den beskriver ett annat projekt.
Den ursprungliga Open Interpreter lanserades 2023 som ett Python-projekt. Den lät språkmodeller köra Python-, JavaScript- och shell-kod på din maskin, och man kände den som ett open source-alternativ till ChatGPT:s Code Interpreter. Senare versioner lade till datorstyrning, så modellen kunde arbeta med ditt skrivbord också.
Det nuvarande huvudprojektet är en omskrivning i Rust baserad på Codex. Det fokuserar på kodningsagenter och harness-emulering, inte allmän datorstyrning.
Python-versionen försvann inte. Den fortsätter som en community-fork på endolith/open-interpreter.
Båda versionerna använder samma namn, samma GitHub-repohistorik och samma kommando interpreter, så det är lätt att blanda ihop dem.
Men ett väldigt tydligt kännetecken är:
pip install open-interpreter: Den äldre Python-versionen
curl eller PowerShell-installationsprogram: Den nuvarande Rust-versionen
Open Interpreter är inte rätt verktyg för varje uppsättning. Här passar det och här gör det inte det.
Öppen källkod: Licensierad under Apache 2.0, så du kan läsa, granska och forka hela kodbasen
Modellval: Du kan använda hostade, open-weight och lokala modeller från en och samma agent, och byta mellan dem mitt i en session
Flera agent-harnessar: Du kommer närmare den prestanda modellen har trimmats för, vilket få andra kodningsagenter erbjuder
Terminal-native utveckling: Passar in i ditt befintliga shell- och Git-arbetsflöde, och exec-läge fungerar i skript och CI
Öppna och billigare modeller: Projektet är byggt kring dem, med dedikerade leverantörsguider och matchande harnessar
Utbyggbarhet: MCP, skills, hooks, AGENTS.md, Agent Client Protocol och Codex SDK-override låter dig koppla det till andra verktyg
Modellkvalitet varierar: Agenten är bara så bra som modellen bakom, och ingen harness fixar en modell som inte kan planera en flerstegsuppgift
Lokala modeller kräver rejäl hårdvara: I mina tester tog devstral-small-2 ensam 26 GB minne, innan det stora kontextfönster en kodningsagent behöver
Uppsättning kräver mer arbete: Du hanterar leverantörer, kontextfönster, harnessar och sandbox-inställningar själv. Det finns också skarvar, som kvarvarande Codex-branding och metadata-varningar för Ollama-modeller
Kommandoexekvering är en risk: Sandlådan och godkännanden minskar risken, men tar inte bort den
Koden behöver fortfarande granskning: Godkända tester garanterar inte en korrekt fix, så du måste läsa varje diff
Open Interpreter är en kodningsagent med öppen källkod som fungerar med den modell du väljer, oavsett om modellen är hostad, open-weight eller körs på din egen maskin.
Arbetsflödet är enkelt. Du väljer en modell och en harness, pekar agenten mot ett projekt och låter den inspektera, redigera och köra kommandon tills uppgiften är klar. Sedan granskar du dess arbete.
Harness-emulering gör den annorlunda än konkurrenterna. Open Interpreter tvingar inte varje modell in i en och samma agentuppsättning. Den ändrar uppsättningen för att passa modellen, och det kan vara avgörande. Modellen avgör också hur bra arbetet blir, och behörigheter avgör vad agenten får ändra. Din granskning är sista kontrollen innan någon ändring når din kodbas.
Om du vill skaffa en AI-ingenjörscertifiering, anmäl dig till vårt Associate AI Engineer for Developers-spår och ta steget in i AI-världen i din egen takt.
Lär dig med DataCamp
Lärstig
Lärstig
Lärstig