Ga naar hoofdinhoud

14 essentiële tools voor data-engineering om in 2026 te gebruiken

Lees alles over toptools voor containerisatie, infrastructuur als code (IaC), workflowbeheer, datawarehousing, analytical engineering, batchverwerking en datastreaming.
Bijgewerkt 2 okt 2026  · 10 min lezen

Verken met AI

ChatGPTClaudePerplexity

Data engineers zijn verantwoordelijk voor het creëren van datapijplijnen die data kunnen binnenhalen, verwerken en afleveren naar verschillende eindpunten, zoals databases, datawarehouses en analyseplatforms. Door deze pijplijnen te bouwen en te onderhouden, stellen data engineers data scientists en analisten in staat om realtime data te raadplegen voor analyse en besluitvorming.

Van moderne data engineers wordt verwacht dat ze nog meer taken uitvoeren. Ze moeten ook datasolutions beheren en deployen, workflows managen, datawarehouses onderhouden, data transformeren en visualiseren, en diverse batch- en streamingtools gebruiken om verschillende soorten data te optimaliseren, in te laden en te verwerken.

Ontdek wat data-engineering is, hoe het verschilt van data science, de reikwijdte ervan en manieren om het te leren in onze gids What is Data Engineering?
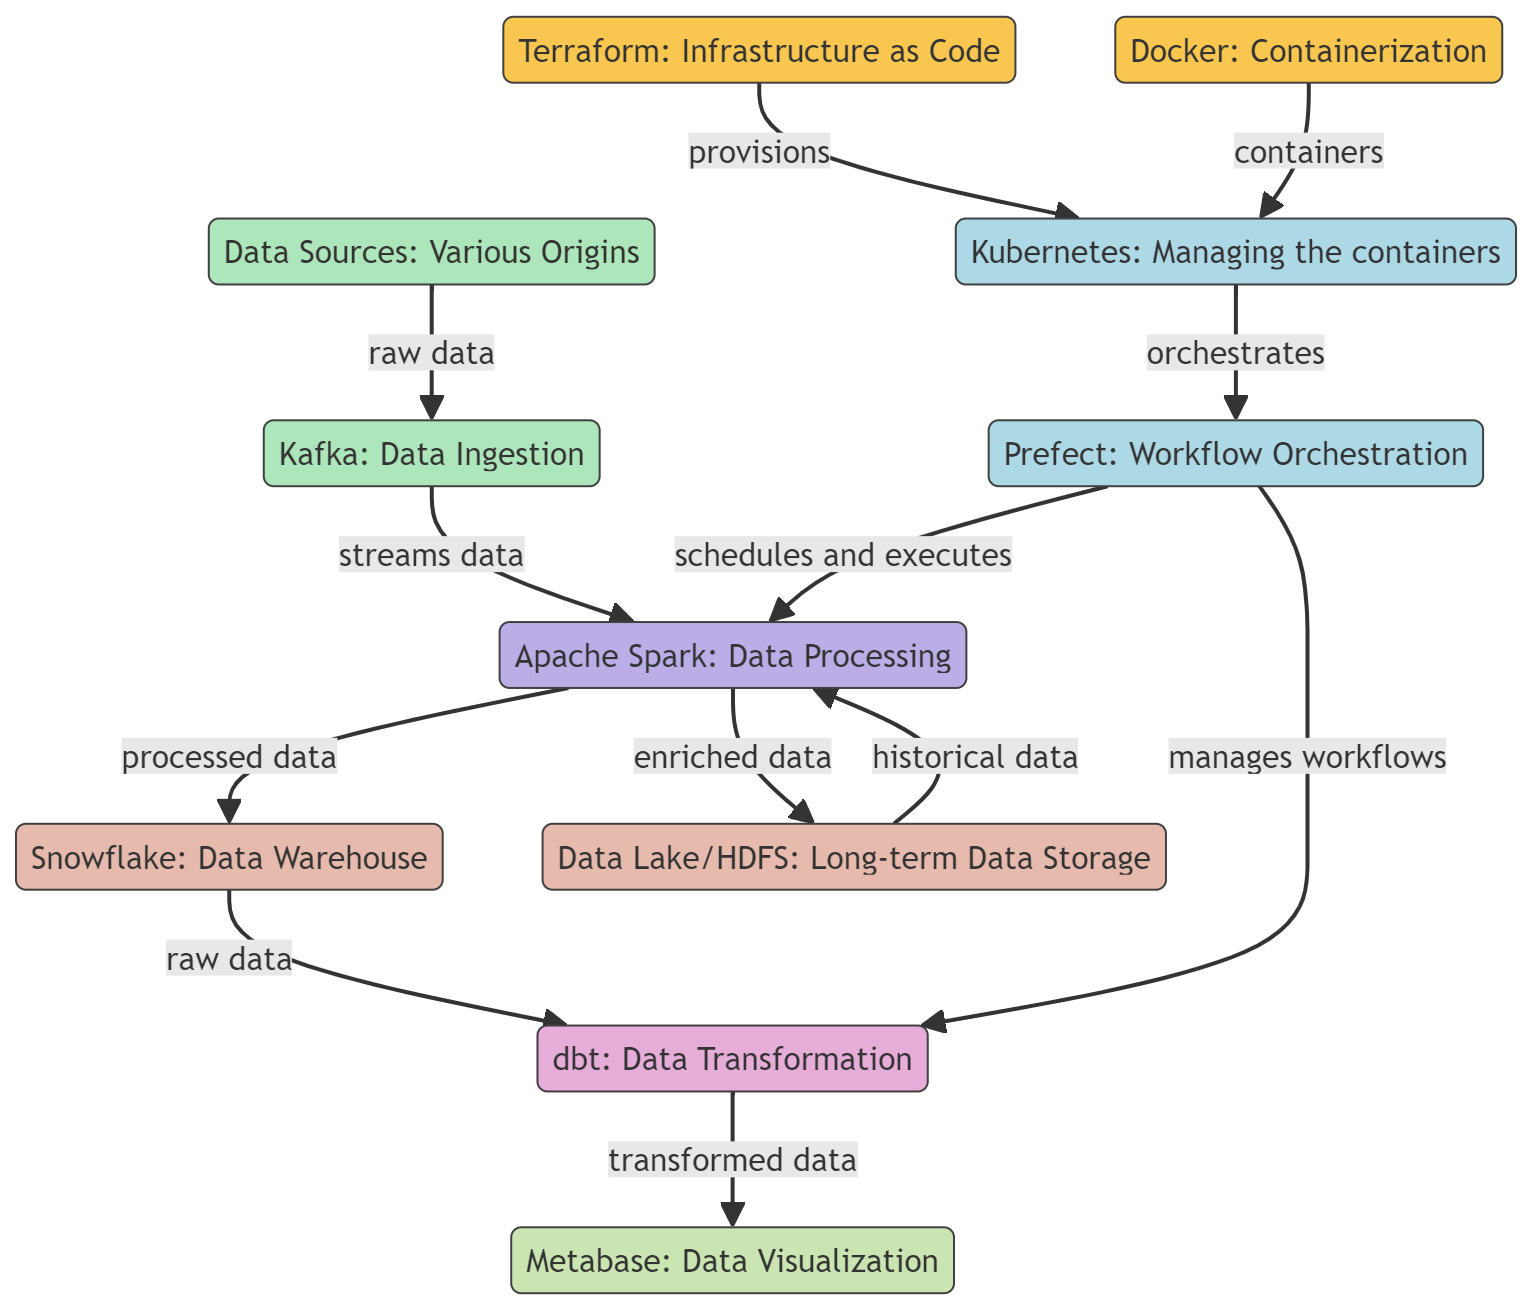
Tools voor data engineers

In deze post bekijken we de essentiële tools die populair zijn en soms onmisbaar voor data engineers. Deze tools worden gebruikt voor data-inname, -verwerking, -opslag, -transformatie en -visualisatie. Daarnaast kijken we naar tools voor containerisatie en workflowbeheer.

Leer essentiële vaardigheden voor data-engineering in onze blog How to Become a Data Engineer.

Containerisatietools

Containerisatietools bieden een gestandaardiseerde manier om applicaties te verpakken, te distribueren en te beheren in verschillende omgevingen. Dit zorgt voor consistentie, schaalbaarheid en efficiëntie van data-engineeringworkflows.

1. Docker

Docker is een populair containerisatieplatform dat vaak wordt gebruikt in data-engineering om datatools en applicaties te ontwikkelen, te leveren en uit te voeren. Het biedt een lichte, draagbare en consistente manier om datatools en applicaties te verpakken en te deployen, waardoor het een ideale keuze is voor data engineers.

Docker kan worden gebruikt om containers te maken en te beheren voor diverse datatools, zoals databases, datawarehouses, dataverwerkingsframeworks en datavisualisatietools. Bekijk onze tutorial Docker for Data Science om meer te leren.

2. Kubernetes

Kubernetes is een open-sourceplatform voor het automatiseren van de deployment, schaalvergroting en het beheer van gecontaineriseerde applicaties, inclusief die welke met Docker zijn gebouwd.

Docker is een tool om dataverwerkingsapplicaties, databases en analysetools in containers te verpakken. Zo blijven omgevingen consistent en worden applicaties geïsoleerd. Zodra de containers zijn gemaakt, neemt Kubernetes het beheer over door hun deployment af te handelen, te schalen op basis van de workload en hoge beschikbaarheid te waarborgen.

Lees meer over Containerization using Docker and Kubernetes in een apart artikel.

Infrastructure as Code-tools

Infrastructure as Code (IaC) stroomlijnt de uitrol en het onderhoud van cloudinfrastructuur met behulp van general-purpose programmeertalen of YAML-configuraties. Deze aanpak bevordert het creëren van consistente, reproduceerbare en geautomatiseerde omgevingen, wat soepelere overgangen tussen ontwikkel-, test- en productieomgevingen faciliteert.

3. Terraform

Terraform is een open-source infrastructure as code (IaC)-tool van HashiCorp. Het stelt data engineers in staat om datainfrastructuur, zoals databases en datapijplijnen, consistent en betrouwbaar te definiëren en te deployen met een declaratieve configuratietaal, die de gewenste eindtoestand van de infrastructuur beschrijft in plaats van de stappen om die toestand te bereiken.

Terraform ondersteunt versiebeheer, beheer van resources via code, team­samenwerking en integratie met diverse tools en platformen.

4. Pulumi

Pulumi is een open-source infrastructure-as-code-tool waarmee ontwikkelaars cloudinfrastructuur kunnen creëren, deployen en beheren met general-purpose programmeertalen zoals JavaScript, TypeScript, Java, Python, Go en C#. Het ondersteunt een breed scala aan cloudproviders, waaronder AWS, Azure, GCP en Kubernetes.

Het Pulumi-framework biedt een downloadbare command-line interface (CLI), software development kit (SDK) en deployment-engine om een robuust platform te leveren voor het inrichten, updaten en beheren van cloudinfrastructuur.

Workflow-orkestratietools

Workflow-orkestratietools automatiseren en beheren de uitvoering van complexe dataverwerkingsworkflows en zorgen ervoor dat taken in de juiste volgorde worden uitgevoerd, met beheer van afhankelijkheden.

5. Prefect

Prefect is een open-source workflow-orkestratietool voor moderne dataworkflows en ETL-processen (extract, transform, load). Het helpt data engineers en -scientists complexe datapijplijnen te automatiseren en te beheren, zodat data betrouwbaar en efficiënt van bron naar bestemming stroomt.

Prefect biedt een hybride uitvoeringsmodel dat de voordelen van cloudgebaseerd beheer combineert met de veiligheid en controle van lokale uitvoering. De gebruiksvriendelijke UI en rijke API maken het eenvoudig om dataworkflows te monitoren en te troubleshooten.

6. Luigi

Luigi is een open-source Python-pakket waarmee je complexe datapijplijnen van langlopende batchjobs bouwt. Het is ontwikkeld door Spotify voor het afhandelen van dependency-resolutie, workflowbeheer, visualisatie, foutafhandeling en commandline-integratie.

Luigi is ontworpen om verschillende taken te beheren, waaronder dataverwerking, datavalidatie en data-aggregatie, en kan worden gebruikt om zowel eenvoudige als geavanceerde dataworkflows te bouwen. Luigi kan worden geïntegreerd met diverse tools en platformen, zoals Apache Hadoop en Apache Spark, waardoor gebruikers datapijplijnen kunnen creëren om grote hoeveelheden data te verwerken en analyseren.

Datawarehouse-tools

Datawarehouses bieden cloudgebaseerde, sterk schaalbare oplossingen voor het opslaan, bevragen en beheren van grote datasets.

7. Snowflake

Snowflake is een cloudgebaseerd datawarehouse waarmee grote hoeveelheden data kunnen worden opgeslagen, verwerkt en analytisch bevraagd. Het is gebaseerd op een unieke architectuur die opslag en compute scheidt, zodat ze onafhankelijk kunnen schalen.

Snowflake kan het aantal compute-resources dynamisch aanpassen op basis van de vraag. Dit zorgt ervoor dat queries tijdig, efficiënt en kosteneffectief worden verwerkt. Het is compatibel met grote cloudproviders, zoals AWS, GCP en Azure.

Bekijk onze Introduction to Snowflake-cursus om deze tool in meer detail te verkennen.

8. PostgreSQL

PostgreSQL is een krachtig open-source relationeel databasemanagementsysteem (RDBMS) dat ook kan worden gebruikt als datawarehouse. Als datawarehouse biedt PostgreSQL een centrale repository voor het opslaan, beheren en analyseren van grote hoeveelheden gestructureerde data uit verschillende bronnen.

PostgreSQL biedt functies zoals partitionering, indexering en parallelle query-uitvoering, waardoor het complexe queries en grote datasets efficiënt kan verwerken.

Bedenk wel dat een PostgreSQL-datawarehouse een lokale oplossing is die mogelijk niet zo goed schaalt als sommige volledig beheerde oplossingen. Het vereist meer handmatig beheer en onderhoud in vergelijking met die oplossingen.

Lees meer in onze Beginner’s Guide to PostgreSQL.

Analytics-engineeringtools

Analytics-engineeringtools stroomlijnen de transformatie, het testen en de documentatie van data in het datawarehouse.

9. dbt

dbt (data build tool) is een open-source commandlinetool en framework dat is ontworpen om datatransformatieworkflows en modellering in een datawarehouseomgeving te faciliteren. Het ondersteunt alle grote datawarehouses, waaronder Redshift, BigQuery, Snowflake en PostgreSQL.

dbt is toegankelijk via dbt Core of dbt Cloud. dbt Cloud biedt een webgebaseerde gebruikersinterface, een door dbt Cloud aangedreven CLI, een gehoste omgeving, een planningsfunctie voor jobs in de app en integraties met andere tools.

Je leert de basis van dbt in onze cursus Introduction to dbt.

10. Metabase

Metabase is een open-source business intelligence (BI)- en analysetool waarmee gebruikers interactieve dashboards en analysereports kunnen maken en delen. Het is ontworpen om gebruiksvriendelijk te zijn, zodat niet-technische gebruikers data kunnen bevragen, resultaten visualiseren en inzichten opdoen zonder SQL of andere querytalen te hoeven kennen.

Het biedt eenvoudige setup, ondersteuning voor diverse databronnen, een intuïtieve interface, samenwerkingsfuncties, aanpasbare meldingen en robuuste beveiliging voor het verkennen, analyseren en delen van data.

Data-analyse en dashboarding maken deel uit van data science. Lees over de verschillen tussen een Data Scientist en een Data Engineer in dit artikel: Data Scientist vs Data Engineer.

Batchverwerkingstools

Deze tools voor data engineers maken efficiënte verwerking van grote datavolumes in batches mogelijk, met complexe rekentaken, data-analyse en machinelearning-toepassingen in gedistribueerde computingomgevingen.

11. Apache Spark

Apache Spark is een krachtig open-source gedistribueerd computingframework dat is ontworpen voor grootschalige dataverwerking en -analyse. Hoewel het bekendstaat om realtime streaming, blinkt Spark ook uit in batchverwerking en is het een waardevolle tool in data-engineeringworkflows.

Apache Spark biedt Resilient Distributed Datasets (RDD's), rijke API's voor verschillende programmeertalen, dataverwerking over meerdere nodes in een cluster en naadloze integratie met andere tools. Het is zeer schaalbaar en snel, waardoor het ideaal is voor batchverwerking in data-engineeringtaken.

12. Apache Hadoop

Apache Hadoop is een populair open-source framework voor gedistribueerde opslag en verwerking van grote datasets. De kern van het Hadoop-ecosysteem bestaat uit twee hoofdcomponenten: het Hadoop Distributed File System (HDFS) voor opslag en het MapReduce-programmeermodel voor verwerking.

Apache Hadoop is een krachtige en schaalbare tool voor data engineers, met kostenefficiënte opslag, fouttolerantie, gedistribueerde verwerkingsmogelijkheden en naadloze integratie met andere dataverwerkingstools.

Streamingtools

Streamingtools bieden een krachtige manier om realtime datapijplijnen te bouwen, waarmee continue inname, verwerking en analyse van streamingdata mogelijk wordt.

13. Apache Kafka

Apache Kafka is een gedistribueerd event-streamingplatform dat is ontworpen voor high-performance realtime dataverwerking en het stroomlijnen van grootschalige datapijplijnen. Het wordt gebruikt voor het bouwen van realtime datapijplijnen, streaminganalyse, dataintegratie en bedrijfskritische applicaties.

Kafka kan grote hoeveelheden data met lage latentie verwerken. Het slaat data gedistribueerd en fouttolerant op, zodat data beschikbaar blijft, zelfs bij hardwarestoringen of netwerkproblemen.

Kafka is zeer schaalbaar en ondersteunt meerdere subscribers. Het integreert ook goed met verschillende dataverwerkingstools en -frameworks, zoals Apache Spark, Apache Flink en Apache Storm.

Apache Flink is een open-source platform voor gedistribueerde stream- en batchverwerking. Het kan datastromen in realtime verwerken en is daarom een populaire keuze voor het bouwen van streamingdatapijplijnen en realtime analytics-applicaties.

Flink is een dataverwerkingstool die snelle en efficiënte realtime- en batchverwerkingsmogelijkheden biedt. Het ondersteunt meerdere API's (waaronder Java, Scala en Python), maakt naadloze integratie met andere dataverwerkingstools mogelijk en biedt efficiënt staatbeheer. Het is daarom een populaire keuze voor realtime analytics, fraudedetectie en IoT-toepassingen dankzij de mogelijkheid om data met hoge doorvoer en lage latentie te verwerken.

Conclusie

Daarmee is onze lijst compleet, maar dat hoeft niet het einde van je data-engineeringreis te zijn. Schrijf je in voor de Data Engineer in Python skill track om te leren over Python, SQL, databaseontwerp, cloud computing, opschonen van data en visualisatie. Als je de track afrondt, kun je het examen voor de Data Engineer Career Certification doen en een gecertificeerde professionele Data Engineer worden.

Data engineers spelen een cruciale rol bij het bouwen en onderhouden van de datapijplijnen die analytics en besluitvorming in organisaties voeden. Nu datavolumes en complexiteit exponentieel blijven groeien, moeten data engineers de juiste tools inzetten om data efficiënt in te nemen, te verwerken, op te slaan en als kwalitatieve data te leveren.

We hebben de top 14 tools voor data-engineering besproken voor containerisatie, inrichten van infrastructuur, workflow-automatisering, datawarehousing, analytics-engineering, batchverwerking en realtime streaming.

Als je nieuw bent in data-engineering, begin dan met het leren van Docker, Kubernetes, Terraform, Prefect, Snowflake, dbt, Apache Spark, Apache Kafka en meer.

Als je deze tools onder de knie hebt, bekijk dan The Top 21 Data Engineering Interview Questions, Answers, and Examples om je voor te bereiden op je volgende carrièrestap.


Abid Ali Awan's photo
Author
Abid Ali Awan
LinkedIn
Twitter

Als gecertificeerd data scientist haal ik met passie het maximale uit de nieuwste technologie om innovatieve machinelearning-toepassingen te bouwen. Met een sterke achtergrond in spraakherkenning, data-analyse en -rapportage, MLOps, conversationele AI en NLP heb ik mijn vaardigheden aangescherpt in het ontwikkelen van intelligente systemen die echt impact maken. Naast mijn technische expertise ben ik ook een sterke communicator met een talent om complexe concepten terug te brengen tot heldere, beknopte taal. Daardoor ben ik uitgegroeid tot een veelgelezen blogger over data science, waar ik mijn inzichten en ervaringen deel met een groeiende community van data-professionals. Op dit moment richt ik me op contentcreatie en redactie, waarbij ik met large language models werk aan krachtige en aansprekende content die zowel bedrijven als individuen helpt het beste uit hun data te halen.

Onderwerpen
Data-engineering

Begin vandaag nog aan je Data Engineer-reis!

Leerpad

Data-engineer in Python

40 uur
Leer de vaardigheden die je nodig hebt om data efficiënt te verzamelen, op te schonen en te beheren, en om pijplijnen te plannen en te monitoren, zodat je je kunt onderscheiden op het gebied van data-engineering.
Bekijk detailsRight Arrow
Start Cursus
Meer bekijkenRight Arrow
Gerelateerd

blog

AI vanaf nul leren in 2026: een complete gids van de experts

Ontdek alles wat je moet weten om in 2026 AI te leren, van tips om te beginnen tot handige resources en inzichten van industrie-experts.
Adel Nehme's photo

Adel Nehme

15 min

Meer BekijkenMeer Bekijken


